GPT-6.1 Sol 很慢怎么办:先分清原因,降档实测耗时减半
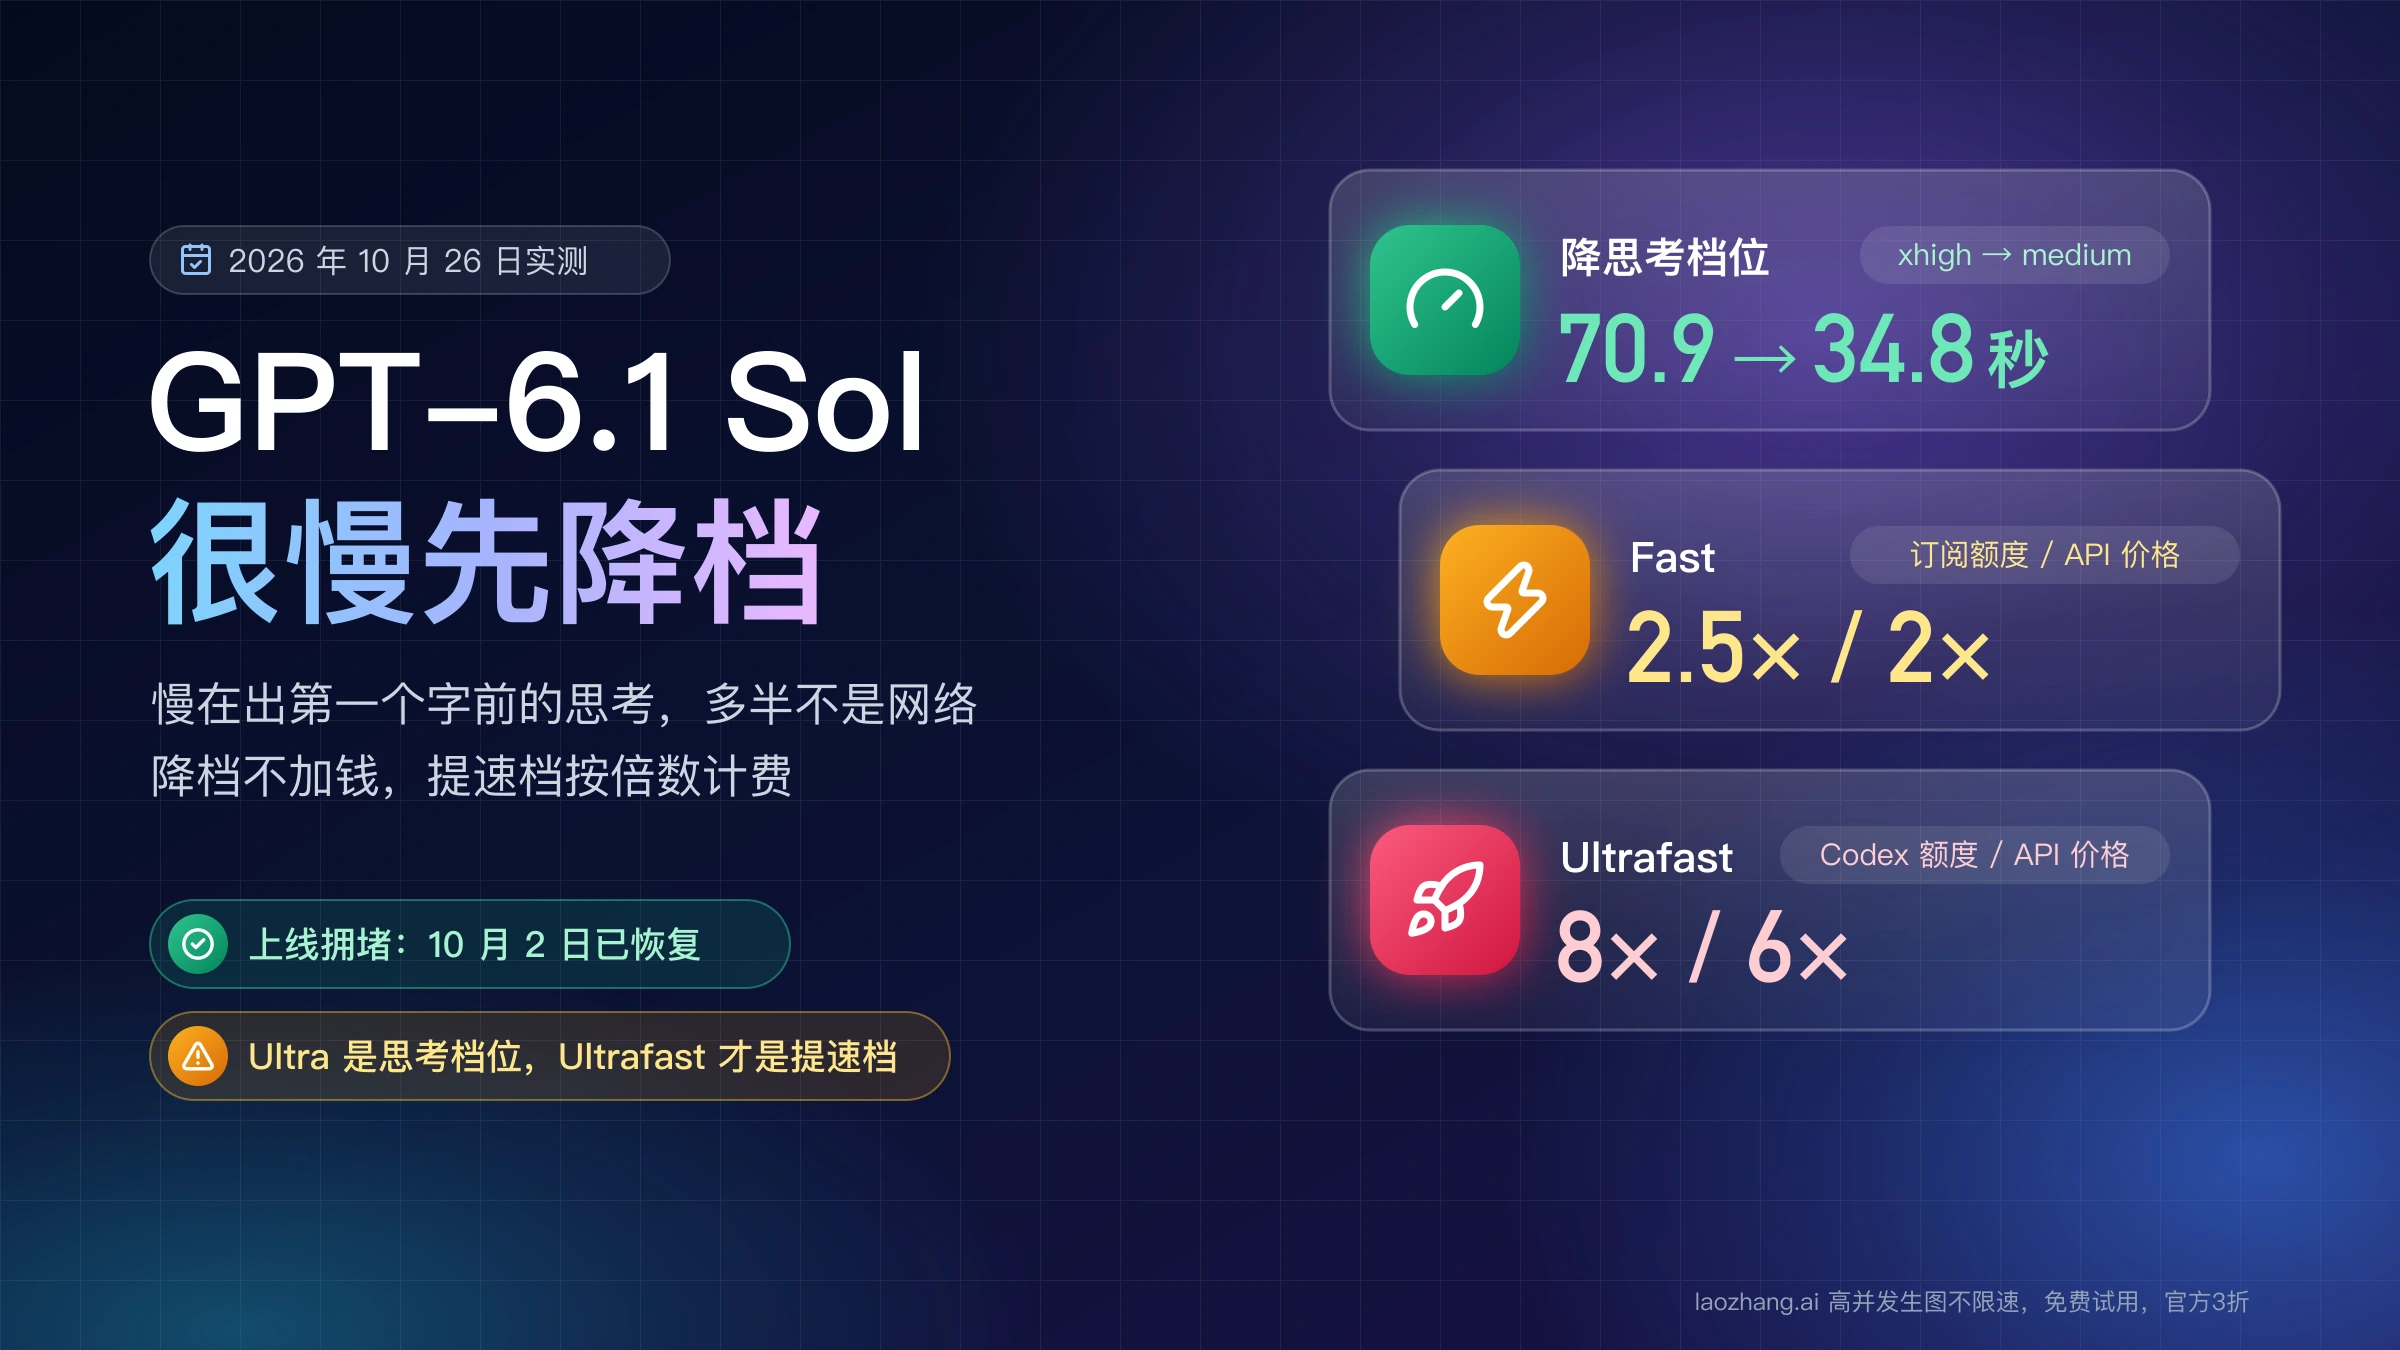
GPT-6.1 Sol 的慢主要在出字前的思考:2026 年 10 月 26 日实测,API 从 xhigh 降到 medium,耗时 70.9 秒减到 34.8 秒。
文章目录
在 Codex 或 ChatGPT 工作模式里切到 GPT-6.1 Sol 后,一条回复要等好几分钟;或者用 API 调 gpt-6.1-sol,明显比 gpt-6-sol 慢。截至 2026 年 10 月 26 日,这多半不是你的网络或配置出了问题。上线头两天(9 月 29 日到 10 月 1 日)的拥堵,OpenAI 的 Codex 负责人已经说恢复正常,10 月 5 日 OpenAI 又把 ChatGPT 登录下的默认速度调快了约 50%。现在还剩下的慢来自模型本身:它在出第一个字之前想得更久,而且 Artificial Analysis 在 OpenAI 官方 API 上测到的输出速度只有 GPT-6 Sol 的一半左右。
所以先改思考档位,再考虑花钱。Codex 里把 Extra High 或 Max 降到 Medium(简单任务用 Light,命令行里叫 Low),API 里把 reasoning_effort(Responses API 是 reasoning.effort)设成 medium 或 low,然后拿自己的任务重新计时。还不够快再开 Fast:Codex 里输入 /fast,订阅额度按标准速度的 2.5 倍消耗;API 里加 service_tier: "fast",价格是标准的 2 倍。如果任务不需要 6.1 Sol 的能力上限,换回 gpt-6-sol 也行。看到 "Selected model is at capacity" 则是容量不足,通常隔几分钟重试即可,和速度慢不是同一件事。
2026 年 10 月 26 日实际跑了两组测试。API 一组经 laozhang.ai 的 OpenAI 兼容中转调用,不是 OpenAI 直连,同一道编程题每个档位各跑 2 次:gpt-6.1-sol 从 xhigh 降到 medium,总耗时中位数从 70.9 秒降到 34.8 秒,答案全部通过隐藏测试。Codex CLI 一组只有一个 ChatGPT 登录账号,每种配置只跑 1 次。API 上没有测 Fast,Ultrafast 两边都没有测,涉及它们的内容来自 OpenAI 文档。这些结果只代表一道题、一天,不保证某个办法在你的任务上同样有效。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
GPT-6.1 Sol 什么时候开始慢的:9 月底拥堵,10 月 5 日订阅提速
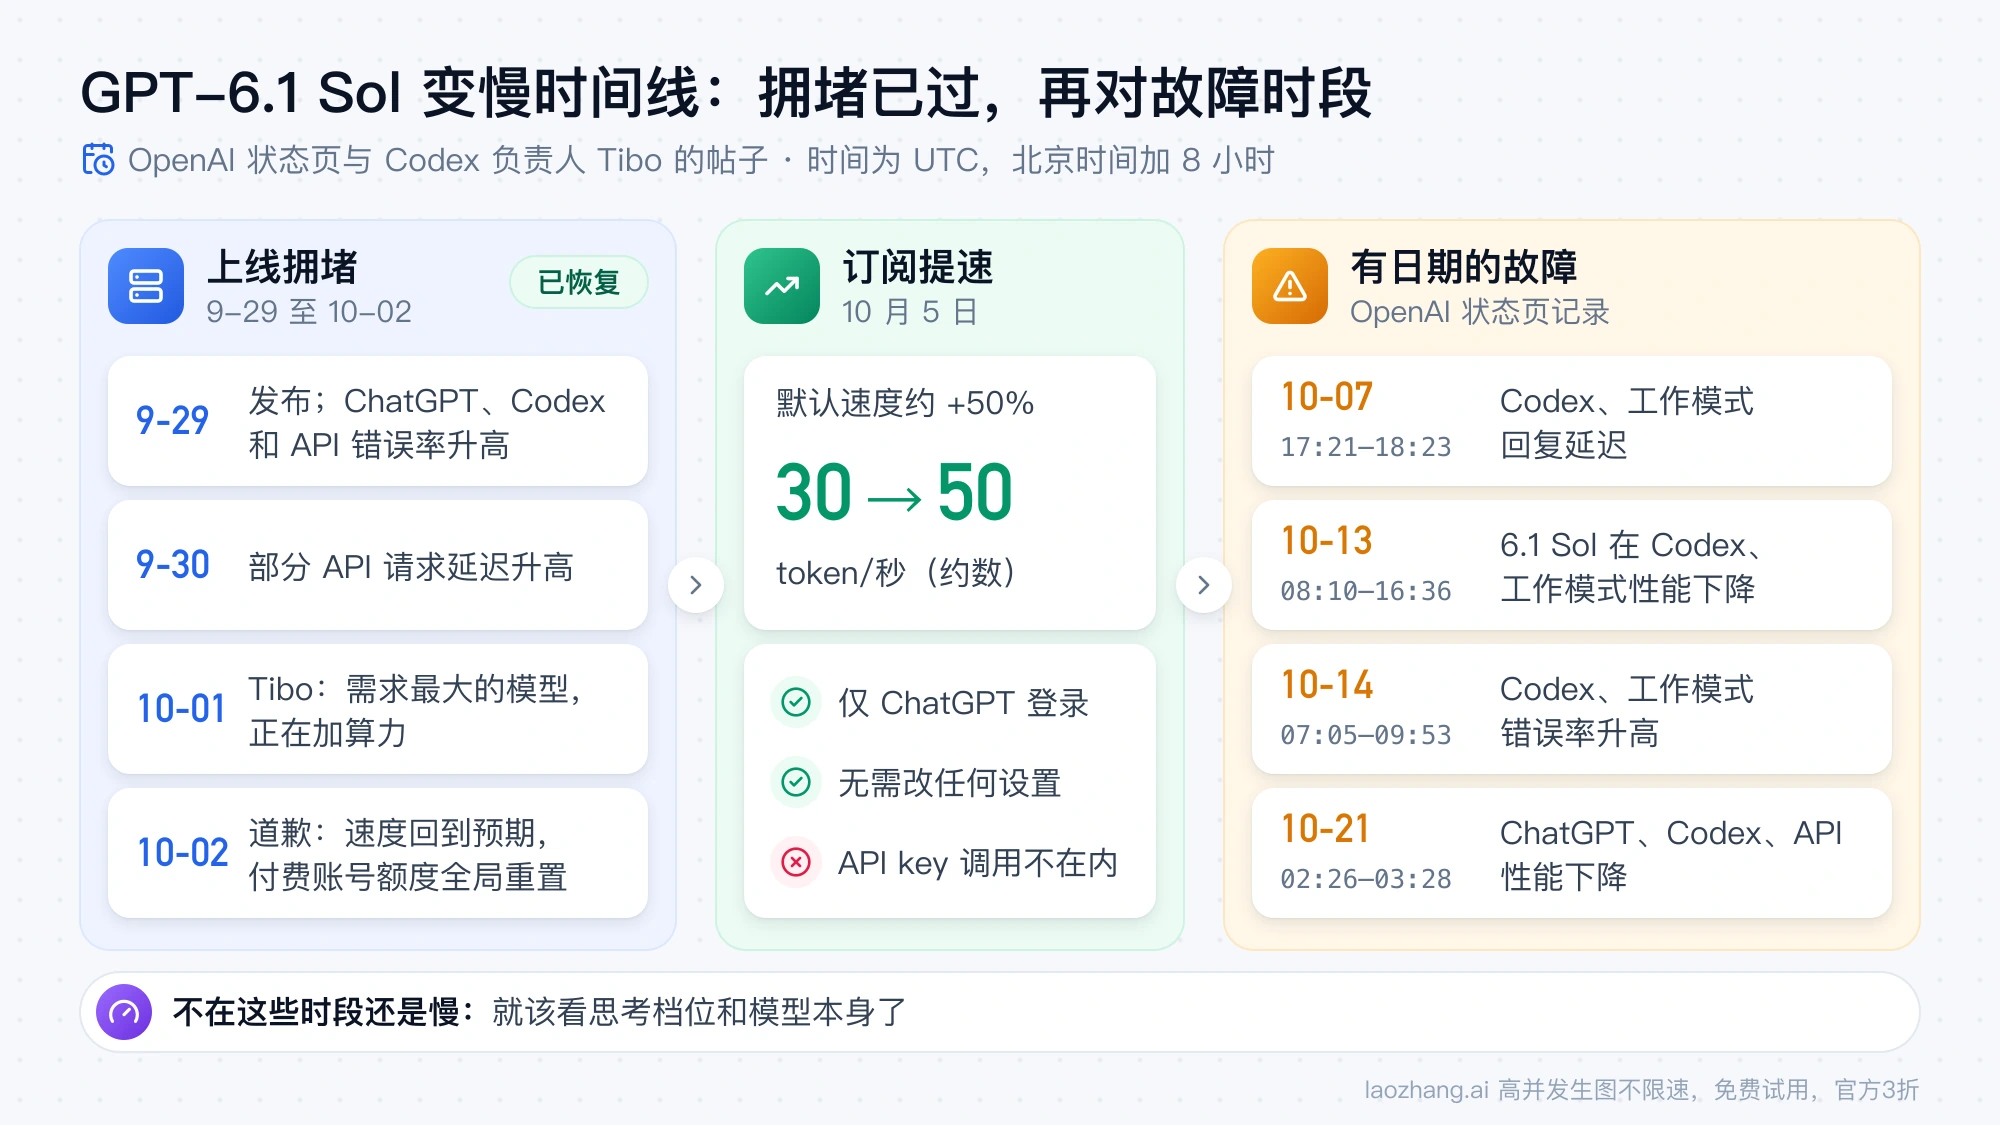
如果你的慢集中在 9 月 29 日到 10 月 1 日,那是上线拥堵,已经过去了。GPT-6.1 Sol 于 2026 年 9 月 29 日发布,Codex 负责人 Tibo(@thsottiaux)10 月 1 日在 X 上说,这几乎是 OpenAI 有史以来需求最大的模型,ChatGPT 和 Codex 一度负载很重,正在加算力;10 月 2 日他为"GPT-6.1 Sol 开局太慢"道歉,说速度已回到预期水平,并宣布对所有付费 ChatGPT 账号做一次全局额度重置。OpenAI 状态页同期也有记录:9 月 29 日 ChatGPT、Codex 和 API 错误率升高,9 月 30 日部分 API 请求延迟升高(OpenAI 状态页历史记录)。
10 月 5 日(UTC)是第二个分界点。Tibo 宣布把 GPT-6 Astra 和 GPT-6.1 Sol 在订阅下的默认速度调快约 50%,回复里补充说是从每秒约 30 个 token 提到约 50 个,覆盖所有用 ChatGPT 登录的产品和合作方工具(他点名了 OpenCode、Pi、Amp、Devin),用户不需要改任何设置(Tibo 在 X 上的提速公告)。这项改动只出现在他的帖子里,Codex 更新日志没有记录;它也只针对 ChatGPT 登录的流量,用 API key 调用不在范围内。Zenn 作者 oubakiou 在 10 月 6 日用同一道 Codex CLI 任务复测(订阅账号,每档 3 次取平均),和 9 月 30 日相比,high 从 19.7 分钟降到 7.4 分钟,xhigh 从 28.2 分钟降到 10.3 分钟,max 从 35.1 分钟降到 14.6 分钟,输出 token 数几乎没变(oubakiou 的 Zenn 复测文章)。作者也说明,他分不清提速前的慢有多少是默认速度、有多少是上线拥堵。
10 月 5 日之后的慢,先对一下有没有撞上有日期的故障。OpenAI 状态页记录的相关事故有:10 月 7 日 17:21–18:23(UTC)Codex 和工作模式回复延迟;10 月 13 日 08:10–16:36(UTC),标题直接是"GPT-6.1 Sol 在 Codex 和工作模式中性能下降",09:30 已缓解;10 月 14 日 07:05–09:53(UTC)Codex 和 ChatGPT 工作模式错误率升高;10 月 21 日 02:26–03:28(UTC)ChatGPT、Codex 和 API 性能下降。换算成北京时间要加 8 小时,比如 10 月 13 日那次是北京时间当天 16:10 到次日 00:36。不在这些时段里还是慢,就该看思考档位和模型本身了。
GPT-6.1 Sol 比 GPT-6 Sol 慢多少:主要差在出第一个字之前
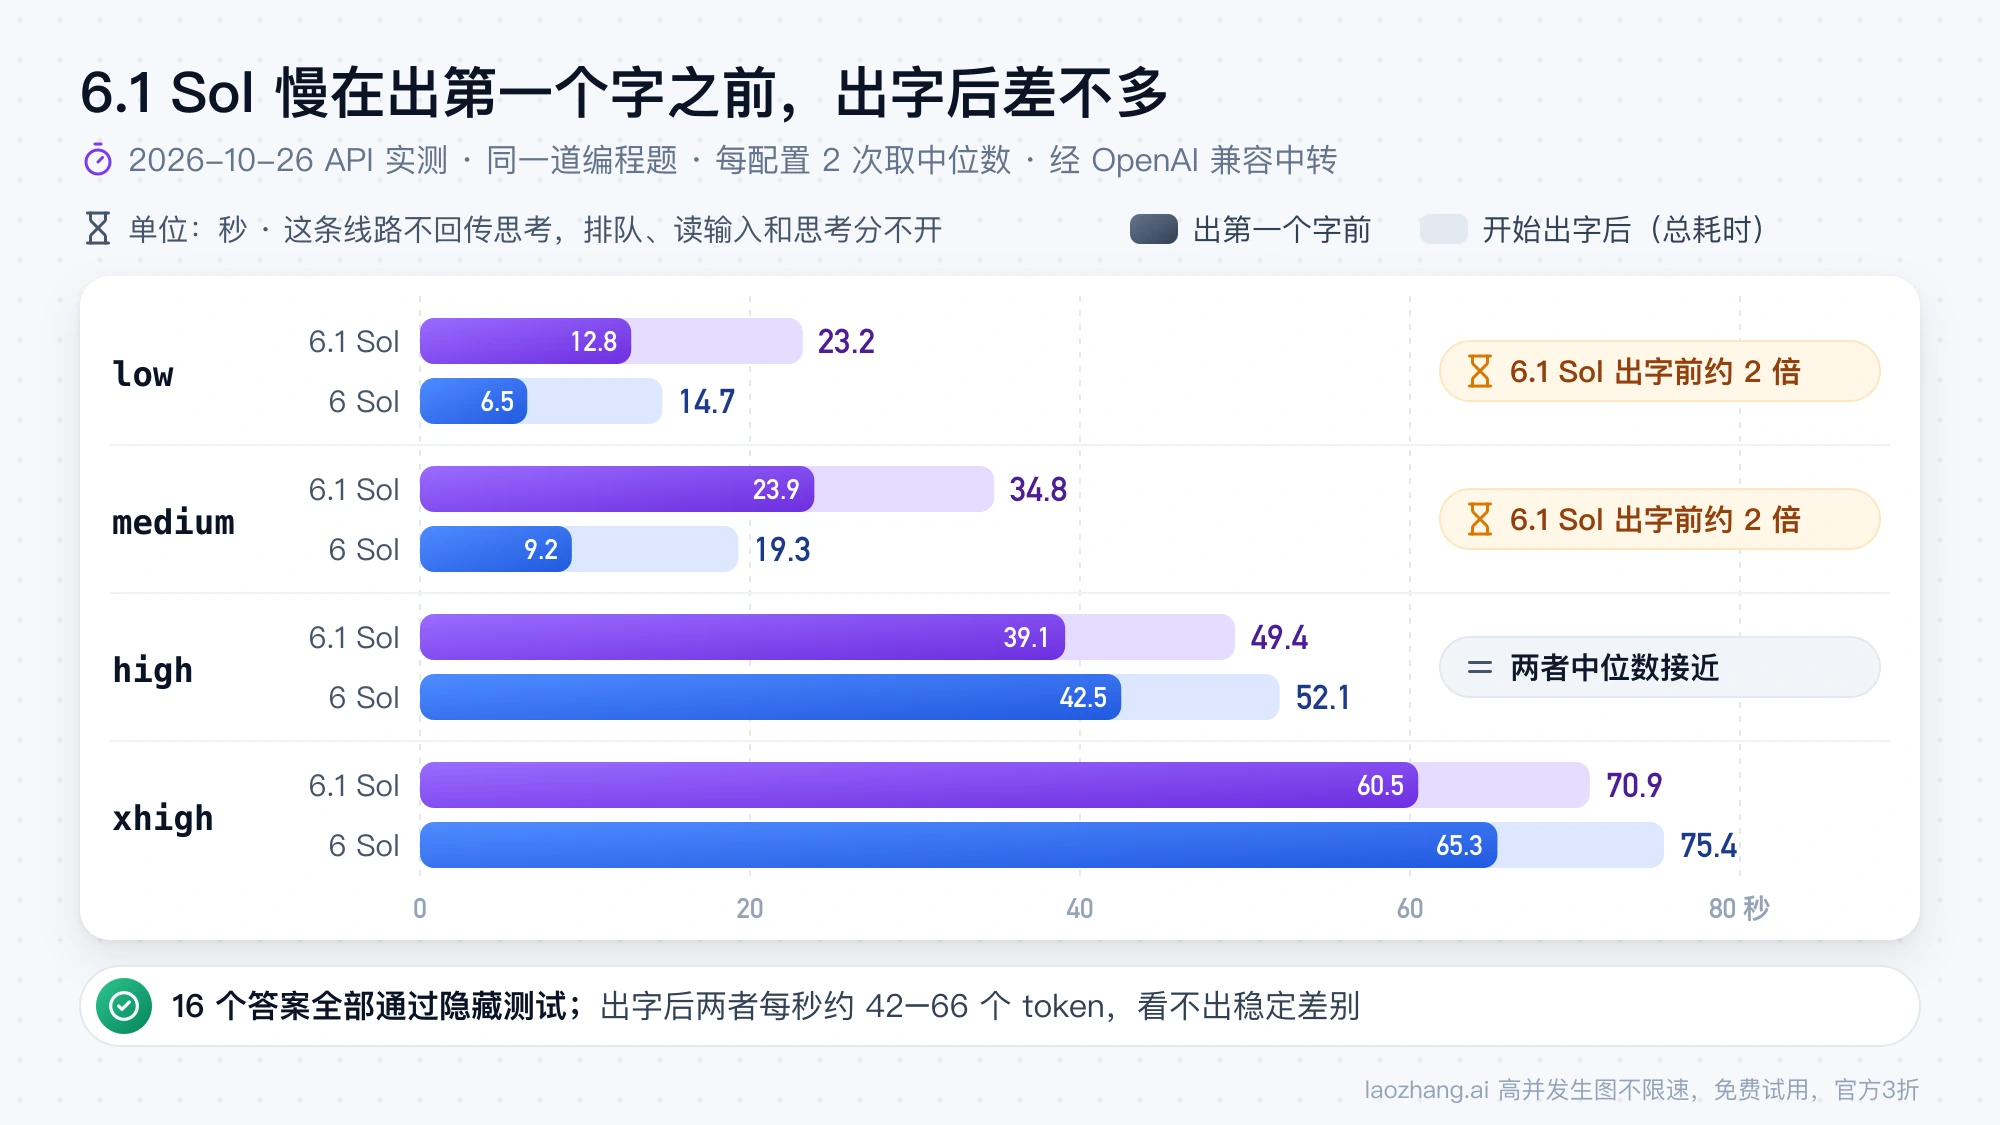
在同一道题、同一条中转线路上,GPT-6.1 Sol 开始输出答案后的流速和 GPT-6 Sol 差不多,慢在出第一个字之前的那段静默等待。2026 年 10 月 26 日 07:07–07:18(UTC),用流式方式经一条 OpenAI 兼容的 Chat Completions 中转(不是 OpenAI 直连),让两个模型各在 4 个档位下写同一个表达式求值函数(不许用 eval),每个配置跑 2 次,16 个答案都通过了 25 个隐藏测试。下表是中位数,"出第一个字前"指从发出请求到收到第一个答案 token 的时间,这条线路不回传思考过程,所以这段时间里排队、读输入和思考分不开。
| 思考档位 | gpt-6.1-sol 总耗时 | gpt-6.1-sol 出第一个字前 | gpt-6-sol 总耗时 | gpt-6-sol 出第一个字前 |
|---|---|---|---|---|
| low | 23.2 秒 | 12.8 秒 | 14.7 秒 | 6.5 秒 |
| medium | 34.8 秒 | 23.9 秒 | 19.3 秒 | 9.2 秒 |
| high | 49.4 秒 | 39.1 秒 | 52.1 秒 | 42.5 秒 |
| xhigh | 70.9 秒 | 60.5 秒 | 75.4 秒 | 65.3 秒 |
在 low 和 medium 档,6.1 Sol 出第一个字前要等大约 2 倍时间,medium 档的思考 token 也多(590 对 317)。到 high 和 xhigh,两者中位数接近,GPT-6 Sol 自己的波动反而很大:high 档两次分别是 12.9 秒和 72.0 秒才出第一个字,xhigh 档用掉的思考 token 是 6.1 Sol 的约 1.9 倍(4,524 对 2,398)。答案开始输出后,6.1 Sol 每秒 48.5–64.0 个可见 token,GPT-6 Sol 是 42.4–66.2 个,看不出稳定差别。
Artificial Analysis 的数据测的是另一件事:OpenAI 官方 API 直连、标准速度档,输出速度把思考 token 也算在内。截至 2026 年 10 月 26 日,它测到的结果如下(Artificial Analysis 的 GPT-6.1 Sol 模型页,各档位有单独页面):
| 思考档位 | GPT-6.1 Sol 输出速度 | GPT-6.1 Sol 首个答案 token | GPT-6 Sol 输出速度 | GPT-6 Sol 首个答案 token |
|---|---|---|---|---|
| Low | 50.8 tok/s | 2.64 秒 | 114.6 tok/s | 1.56 秒 |
| Medium | 53.5 tok/s | 4.20 秒 | 未公布 | 未公布 |
| High | 54.7 tok/s | 48.33 秒 | 112.1 tok/s | 13.66 秒 |
| Xhigh | 58.8 tok/s | 115.15 秒 | 未公布 | 未公布 |
| Max | 62.3 tok/s | 246.63 秒 | 112.5 tok/s | 108.21 秒 |
按这组数据,同一档位下 6.1 Sol 的输出速度是 GPT-6 Sol 的 0.44 倍(Low,50.8 ÷ 114.6)到 0.55 倍(Max,62.3 ÷ 112.5);作为参照,GPT-5.6 Sol 在 Max 档是 81.7 tok/s。Artificial Analysis 也写明,62 tok/s 的 6.1 Sol(Max)低于它统计的平均值 83。两组数据的线路、题目和计时口径都不同,绝对值不能直接比,但方向一致:6.1 Sol 在开口前花的时间更长。网上流传的"比 GPT-5.6 Sol 慢 4.6 倍""每秒约 20 个 token、比 GPT-6 Sol 慢 2.5 倍"这类数字,出自 Reddit、头条和 Threads 上的个人测试,设置各不相同,原始数据无法核对,不宜拿来和上面两张表直接对照。
我的慢属于哪一种:按症状对照原因和先查什么
先按你看到的现象找对应的一行,再去做"先查什么"那一列。原因一栏是根据日期、入口和档位推断的最可能情况,不是确诊。
| 你看到的情况 | 更可能的原因 | 先查什么、做什么 |
|---|---|---|
| 9 月 29 日到 10 月 1 日期间什么都慢 | 上线头两天的拥堵 | 已经恢复;现在还慢就看下面几行 |
| 半天没动静,一旦开始出字就很快 | 出第一个字前的思考,档位越高越久 | 看当前档位(CLI 用 /statusline),降到 Medium 或 Low 重测 |
| Max 或 Extra High 一个任务 10–30 分钟 | 高档位加长上下文,思考 token 成倍增加 | 先试 High;Artificial Analysis 测到 Max 降到 High 后,首个答案 token 的等待从 246.63 秒降到 48.33 秒 |
| 报 "Selected model is at capacity. Please try a different model." | 当时容量不足,不是额度用完 | 隔几分钟重试,详见 Codex Selected model is at capacity 怎么解决:不是额度用完 |
| 某个时段突然变慢、同时有报错 | 有日期的服务故障 | 打开 OpenAI 状态页,对照上一节的事故时段 |
| 用 API key 登录的 Codex 或第三方工具比 ChatGPT 登录慢 | 10 月 5 日的提速只覆盖 ChatGPT 登录流量 | 换成 ChatGPT 登录,或在 API 请求里用 Fast 档 |
| API 后台模式的长任务在 30 分钟左右"超时" | 本地轮询的超时比任务本身短 | 把轮询超时拉长,或降低档位 |
| 只有 Windows 桌面端慢,换什么模型都慢 | 桌面应用本身的开销 | 见 Codex Windows 应用变慢?先做 CLI 与桌面端路径检查 |
如果你同时觉得 6.1 Sol 的额度掉得特别快,那是另一个问题,额度怎么算、什么时候重置看 Codex 每周限额什么时候重置?恢复时间、即时重置与 28 天重置活动,想先知道一个任务实际用了多少 token,可以用 Codex token 和上下文用量怎么查:/status、/usage 与 API 账单 里的方法。
API 长任务那一行有一个具体案例。2026 年 10 月 14 日,一位开发者在 OpenAI 开发者论坛贴出对比:同一个约 229 KB 的提示词(输入超过 20 万 token)、Max 档、开网页搜索、Responses API 后台模式,GPT-5.6 Sol 用了 373 秒,GPT-6.1 Sol 用了 1,846 秒,输出 62,708 个 token,其中思考 token 52,552 个,大约是 5.6 Sol 的两倍;他的本地轮询程序设的是 1,800 秒超时,任务在 1,846 秒才完成。两次请求都写入了 49,583 个缓存 token,命中却是 0(OpenAI 开发者论坛上 6.1 Sol Max 比 5.6 Sol 慢的讨论)。这是单个用户的报告,但它说明在 Max 档跑长上下文时,20 到 30 分钟并不罕见,超时设置要按这个量级留余地。
让 GPT-6.1 Sol 快一点:降档、Fast、Ultrafast、换模型各有代价
最便宜的办法是降思考档位,它同时减少等待和 token;Fast、Ultrafast 是拿额度或钱换速度,换模型则是拿能力上限换速度。OpenAI 自己在 Codex 文档里也说,不同代模型的思考档位并不一一对应,建议拿熟悉的任务从低档试起;大多数任务用不到 Max 或 Ultra。截至 2026 年 10 月 26 日,各选项的情况如下,价格按每百万 token、输入 272K 以内计。
| 办法 | 能快多少(有据可查的部分) | 代价 | 谁能用 |
|---|---|---|---|
| 降思考档位 | API 实测一道题上 xhigh 降到 medium,总耗时约减半、结果相同;Artificial Analysis 测到 Max 降到 High,首个答案 token 等待少 80% | 难题可能答得差一些:Artificial Analysis 智能指数 Max 52、High 50、Medium 48、Low 42 | 所有入口 |
| Codex 的 Fast | OpenAI 没公布 6.1 Sol 的提速倍数(只给了 GPT-5.6 的 1.5 倍) | 订阅额度按 2.5 倍消耗;购买的 credits 和 Enterprise 按量计费按 2 倍 | 用 ChatGPT 登录的桌面应用、Codex CLI、IDE 扩展 |
API 的 Fast(service_tier: "fast") | 文档写"最高 2.5 倍",是通用说法,不是 6.1 Sol 的数字 | 价格 2 倍:输入 $4、缓存输入 $0.20、输出 $20 | API 请求 |
| Ultrafast(中文报道里的"极速版") | 没有 6.1 Sol 的公开数字;文档只写 GPT-6 Astra 在 Codex 里最高快 8 倍 | Codex:订阅额度 8 倍、credits 6 倍;API:价格 6 倍,输入 $12、缓存输入 $0.60、输出 $60 | Codex 里只有 Pro $500 和符合条件的 Enterprise、Edu;API 所有用户 |
| 换回 GPT-6 Sol | API 实测 low、medium 档总耗时明显更短,high、xhigh 档差不多;Artificial Analysis 测到输出速度约为 6.1 Sol 的 2 倍 | 能力更低:GPT-6 Sol 的 Max 档智能指数 48,和 6.1 Sol 的 Medium 持平 | 订阅和 API |
| 换 GPT-6 Luna | Artificial Analysis 测到 Max 档 136.5 tok/s | OpenAI 把它定位在目标明确、可重复的任务 | 订阅和 API |
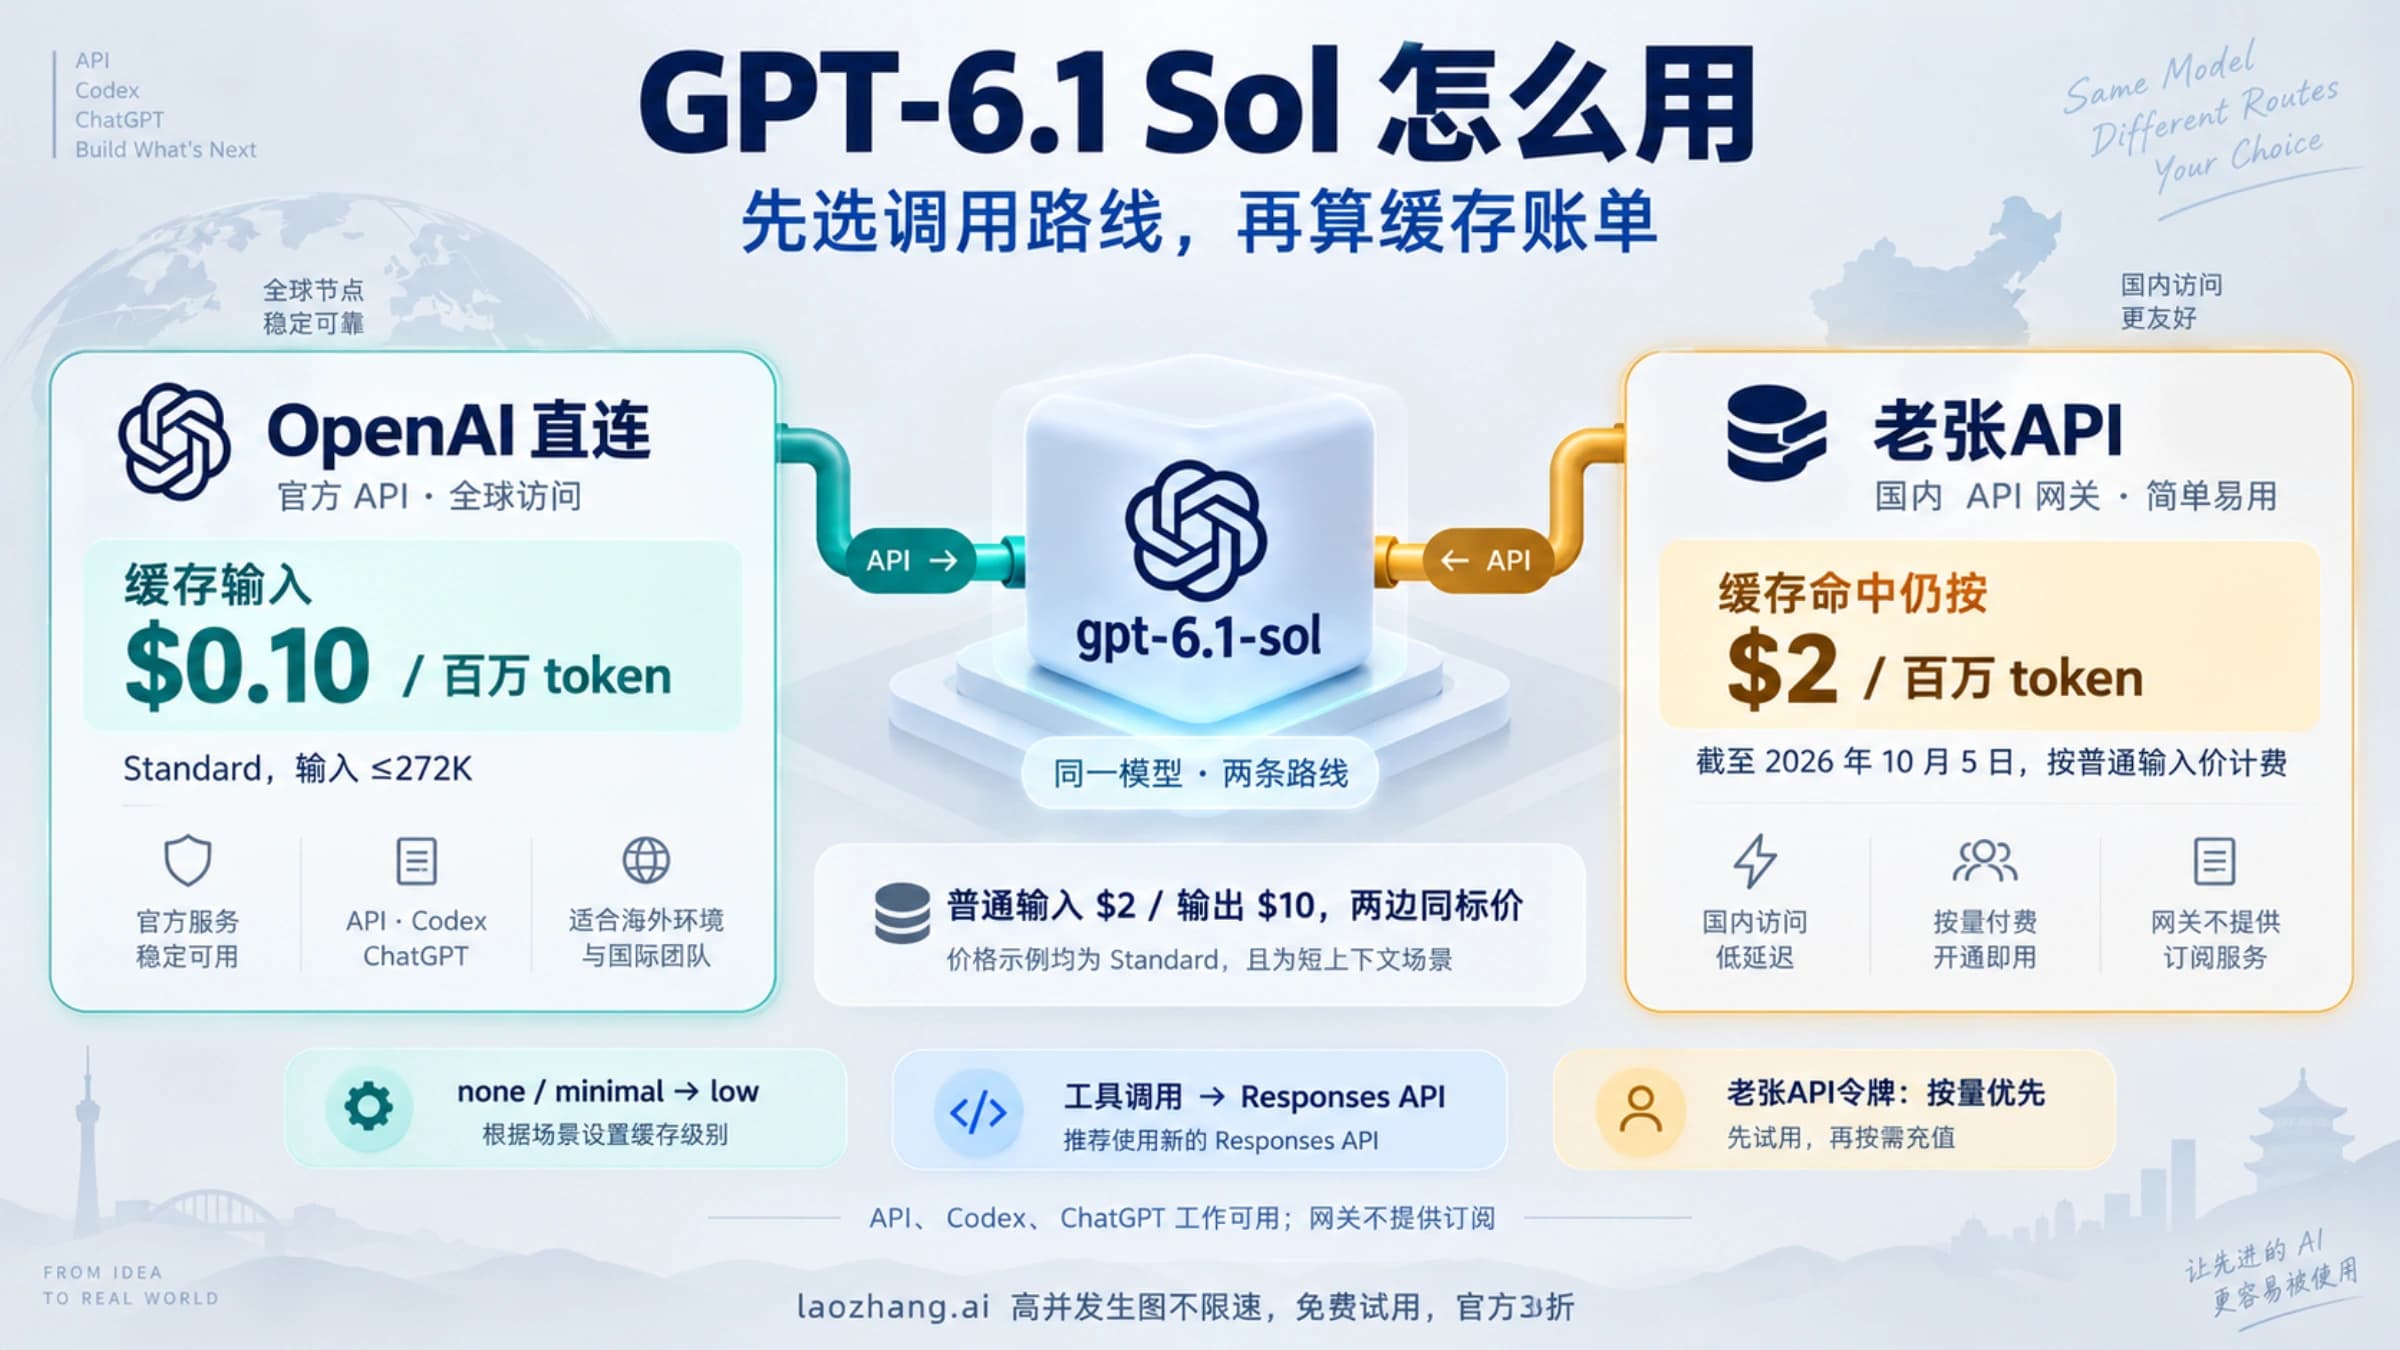
标准速度的 6.1 Sol 价格是输入 $2、缓存输入 $0.10、输出 $10,Fast 和 Ultrafast 都在这个基础上乘倍数,完整价格表和 Batch、Flex 档见 GPT-6.1 Sol 怎么用:价格变化、迁移改动与可用入口。Ultrafast 在 Codex 里不是加钱就能开:Plus 等其他自助套餐即使买了 credits 也用不了;Enterprise 默认关闭,要工作区所有者开启。
Codex 里怎么降档和开 Fast:/fast、config.toml 与桌面端 Advanced
在 Codex 里,思考档位和速度档是两个独立的开关,建议先只降档、计时一次,再决定要不要叠加 Fast。Fast 只在用 ChatGPT 登录时可用;如果你的 Codex 用的是 API key,它按 API 的 token 价格计费,ChatGPT 的额度倍数不适用。
- 命令行里输入
/model,选gpt-6.1-sol,再选思考档位(Low、Medium、High、Extra High);Max 和 Ultra 在 "More reasoning…" 里面。 - 输入
/fast切换 Fast,再用/statusline让底栏显示当前是不是 Fast,避免以为开了其实没开。 - 想让每次启动都用这套设置,写进
config.toml:
model = "gpt-6.1-sol"
model_reasoning_effort = "medium"
service_tier = "fast"

[features]
fast_mode = true- 在 ChatGPT 桌面应用或网页版工作模式里,用输入框下方的 Power 控件:往 Faster 方向拖是更快、更省的设置,往 Smarter 方向是更深的思考;打开 Advanced 可以直接指定模型、思考档位和速度。可选项和默认位置因套餐、客户端和工作区而异。
- 拿一个你熟悉的任务,在改动前后各跑一次,记下从发出到第一条回复、到任务完成的时间。
用脚本批量跑的话,codex exec 可以在命令里临时指定,不用改配置文件,比如 codex exec -m gpt-6.1-sol -c model_reasoning_effort="medium" -c service_tier="fast" --enable fast_mode "你的任务"。
2026 年 10 月 26 日 07:08–07:19(UTC),用 ChatGPT macOS 应用自带的 codex-cli 0.164.0-alpha.11.1(ChatGPT 登录)跑了同一道修 bug 任务:按 7 条规则修好一个计费脚本并补两个函数,事后用 36 个隐藏测试打分。每种配置只跑了 1 次,结果如下:
| 配置 | 总耗时 | 第一条回复前 | 隐藏测试 |
|---|---|---|---|
| gpt-6.1-sol,Low | 72.6 秒 | 11.8 秒 | 36/36 |
| gpt-6.1-sol,Medium | 70.4 秒 | 16.6 秒 | 36/36 |
| gpt-6.1-sol,High | 223.5 秒 | 159.2 秒 | 36/36 |
| gpt-6.1-sol,High + Fast | 63.9 秒 | 11.7 秒 | 36/36 |
| gpt-6-sol,High | 90.3 秒 | 12.1 秒 | 36/36 |
High 那一次是 07:19 的重试,距 07:12 的容量报错约 7 分钟,中间先跑完了 High + Fast 和 GPT-6 Sol 两组。它在第一条回复前等了 159 秒,之后又用了约 1 分钟就完成,日志里看不出这段等待是排队还是思考。所以这张表不能读成"Fast 快 3 倍":单次运行、又夹着一次异常等待,能说明的只是 High + Fast 这一次在 64 秒内完成、结果正确。这一时段一共尝试了 7 次(6 次 6.1 Sol、1 次 GPT-6 Sol),其中 6.1 Sol 有 2 次(07:08 和 07:12)在开跑 27 秒、36 秒时报 "Selected model is at capacity. Please try a different model.",文件没被改动;Low 约 2 分钟后、High 约 7 分钟后重试都完成了。
API 调 gpt-6.1-sol 怎么更快、不超时:effort、流式与 service_tier
API 上最先改的是思考档位。gpt-6.1-sol 不传 reasoning.effort 时默认是 medium;它不接受 none(gpt-6-sol 接受),所以最低从 low 试起。OpenAI 的推理指南对 xhigh 的说法是,只有当你的评测证明它值得多出来的延迟和成本时才用(OpenAI API 推理模型指南)。2026 年 10 月 26 日经中转实测的那道编程题,在 low 档也全部答对,每次回答按标价只要 $0.007–0.009,medium $0.012–0.014,high $0.019–0.020,xhigh $0.031;更难的任务可能需要更高档位,要用你自己的题来定。
{
  "model": "gpt-6.1-sol",
  "reasoning": { "effort": "medium" },
  "service_tier": "fast",
  "stream": true,
  "input": "你的任务"
}
这是 Responses API 的请求体;用 Chat Completions 时把 reasoning 那一行换成 "reasoning_effort": "medium",确定要付 Fast 的钱再加 service_tier(也可以写 "priority",或在项目设置里把 Service Tier 设成 Fast)。设了 Fast 要看响应里的 service_tier 字段:如果显示 default,说明这次被降回了标准档,也按标准价计费。OpenAI 的 Fast 文档还有一条爬坡规则:输入超过每分钟 100 万 token 之后,每 15 分钟增长不能超过 50%,否则部分请求会被降级(OpenAI API Fast mode 文档)。Ultrafast 写 service_tier: "ultrafast",有单独的速率限制(6.1 Sol 在 Build、Launch、Grow 三档分别是每分钟 100 万、400 万、4,000 万 token),工具调用多的智能体应用 OpenAI 强烈建议走 WebSocket(OpenAI API Ultrafast mode 文档)。
流式输出不会缩短总耗时,但能让你在答案一开始就看到内容,也能把"是不是卡住了"和"还在想"分开。如果线路不回传思考过程,第一个数据块要等思考结束才到,所以客户端的读取超时要比最长的思考时间更长;后台模式的轮询超时,Max 档跑长上下文时要留到半小时以上。OpenAI 推理指南还有一个缩短首字时间的提示:让模型先写一段简短的开场说明,再继续深入思考。
经 laozhang.ai 这类 OpenAI 兼容中转调用 gpt-6.1-sol 时,标价与官方一致、缓存命中按全价计费;2026 年 10 月 26 日探测时,它的响应不回传 service_tier 字段,所以经这条线路传 Fast 是否生效无法确认。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
“额度耐用是因为变慢”“变相涨价”说得对吗
这两种说法都只对一半,能核实的是代价,不是动机。OpenAI 公开的额度倍数只针对速度档:标准速度按 1 倍计,Fast 和 Ultrafast 按倍数多扣订阅额度。所以,如果你觉得 6.1 Sol 必须开 Fast 才能用,你多付的就是 Fast 的那个倍数,这笔账可以算清楚;要说"涨价",涨在这里。2026 年 10 月 26 日那组 Codex 单次测试里,GPT-6 Sol 的 High 用了 90.3 秒,6.1 Sol 的 High + Fast 用了 63.9 秒,两者结果都正确,但单次数据不足以证明"开 Fast 才追得上"或"追得过"。
"额度更耐用是因为慢"缺少证据。OpenAI 的公开文档里没有说订阅额度和回复速度有关;Zenn 的复测显示,10 月 5 日提速前后同一个任务的输出 token 数几乎不变(0.87–0.96 倍),high 及以上档位的耗时却缩短了一半以上,说明速度和工作量是两回事。API 按 token 计费,账更清楚:在 10 月 26 日 API 实测的那道编程题上,6.1 Sol 在 xhigh 档每次回答 $0.031,GPT-6 Sol 是 $0.049–0.055,因为后者多用了近一倍的思考 token;medium 档则反过来,6.1 Sol $0.012–0.014,GPT-6 Sol $0.008–0.009。哪个模型更贵,要看你常用的档位和任务。
要不要换回 GPT-6 Sol 或改用 Astra
要不要换,取决于你原来在 GPT-6 Sol 上用的是哪个档位。如果你过去用 GPT-6 Sol 的 Max,Artificial Analysis 的智能指数显示 6.1 Sol 的 Medium 就达到同样的 48 分,首个答案 token 的等待是 4.20 秒,而 GPT-6 Sol Max 是 108.21 秒;这种情况下,把 6.1 Sol 降到 Medium 比换回旧模型更合适。如果你一直用 low 或 medium 处理简单任务、最在意响应快,GPT-6 Sol 在 10 月 26 日 API 实测的 low、medium 档确实更快,换回去是合理的选择。
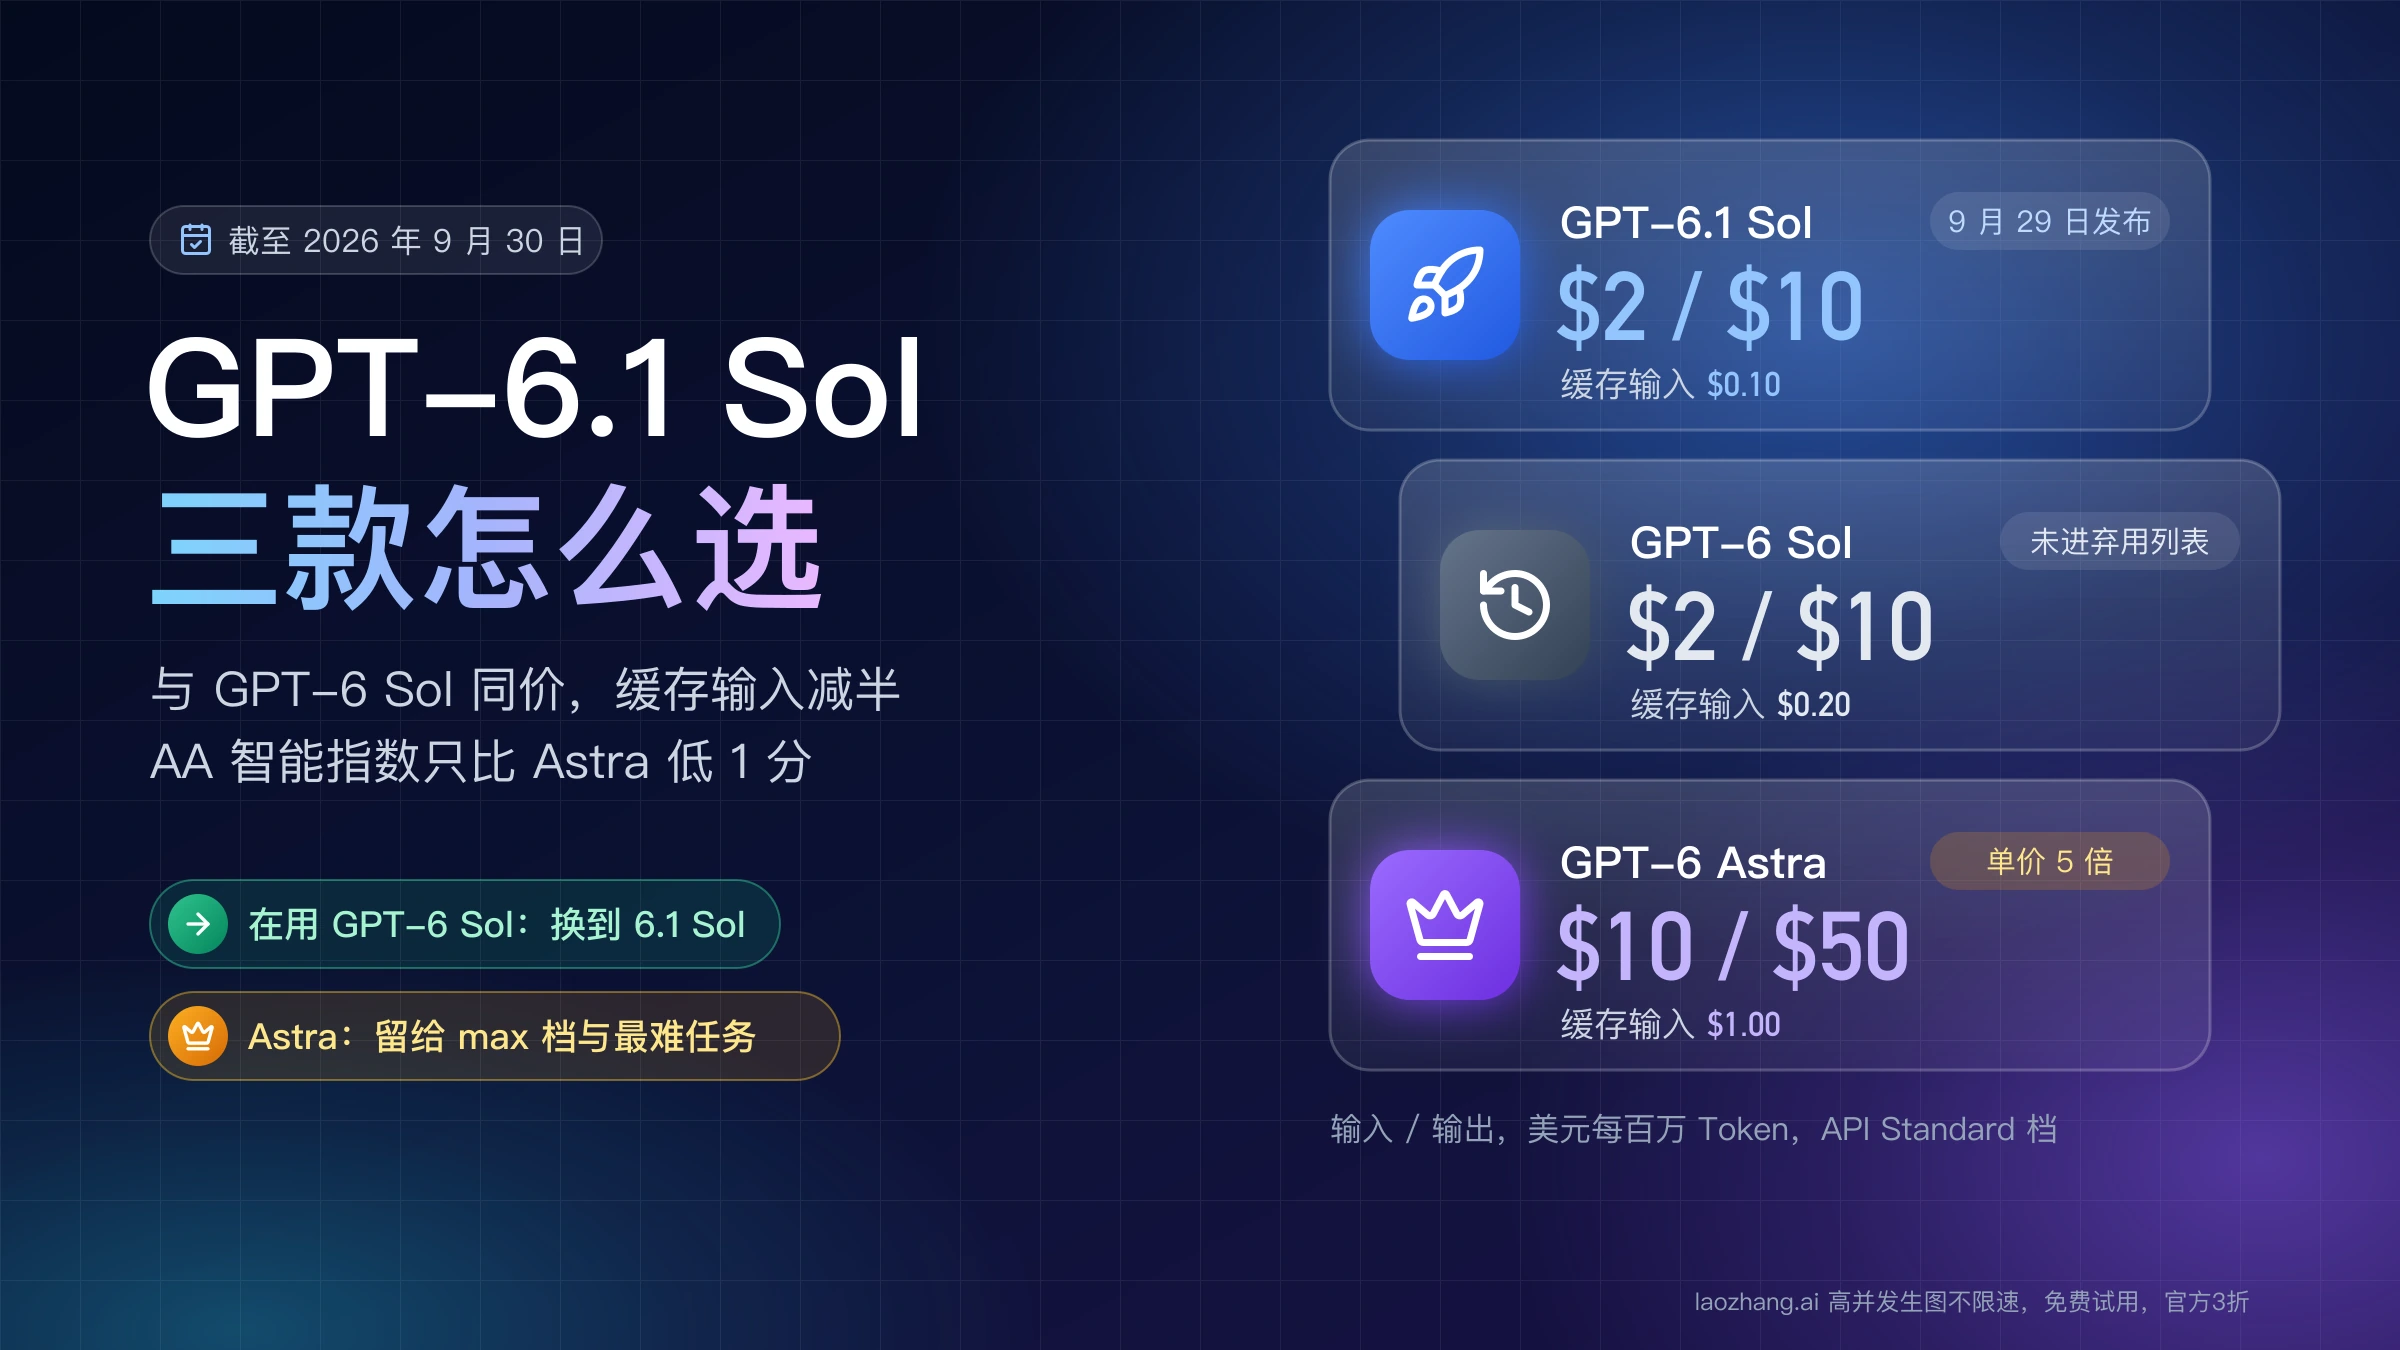
GPT-6 Astra 不是提速的办法:Artificial Analysis 测到它在 Max 档的输出速度是 66.7 tok/s、首个答案 token 要 278.25 秒,标准 token 价格还是 6.1 Sol 的 5 倍。它适合 6.1 Sol 在任何档位都做不好的最难任务。三个模型在能力、价格和适用任务上的完整比较,见 GPT-6.1 Sol、GPT-6 Sol、Astra 怎么选。
GPT-6.1 Sol 速度的其他问题
Ultra 和 Ultrafast 是一回事吗? 不是。截至 2026 年 10 月 26 日,Ultra 是 Codex 里的一个思考档位,它调用多个子代理并行处理一个大任务的不同部分,适合能拆成几块的任务,不是付费速度档。Ultrafast 是付费的速度档,中文报道里说的"极速版"指的就是它,在 Codex 里只对 Pro $500 和符合条件的 Enterprise、Edu 开放,API 上所有用户都能按 6 倍价格使用。
开了 Fast 还是很慢,是没生效吗?
先用 /statusline 确认底栏显示 Fast,并确认 Codex 是用 ChatGPT 登录的;用 API key 登录时 Codex 的 Fast 开关不适用。确认生效后仍慢,多半是思考档位太高:Fast 改的是服务速度档,不改思考档位,Max 档下要想的东西还是那么多。截至 2026 年 10 月 26 日,OpenAI 没有公布 GPT-6.1 Sol 开 Fast 后具体能快多少。
参考来源9
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月26日。
参考来源9
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月26日。
- 1.OpenAI 状态页历史记录status.openai.com/history
- 2.Tibo 在 X 上的提速公告x.com/thsottiaux/status/2107158998495748264
- 3.oubakiou 的 Zenn 复测文章zenn.dev/oubakiou/articles/a39f4bde8c7e74
- 4.Artificial Analysis 的 GPT-6.1 Sol 模型页artificialanalysis.ai/models/gpt-6-1-sol
- 5.OpenAI 状态页status.openai.com
- 6.OpenAI 开发者论坛上 6.1 Sol Max 比 5.6 Sol 慢的讨论community.openai.com/t/1406429
- 7.OpenAI API 推理模型指南developers.openai.com/api/docs/guides/reasoning
- 8.OpenAI API Fast mode 文档developers.openai.com/api/docs/guides/fast-mode
- 9.OpenAI API Ultrafast mode 文档developers.openai.com/api/docs/guides/ultrafast-mode