GPT-6.2 Sol vs 6.1 Sol vs Opus 5.5: тест 12 задач и что выбрать
GPT-6.2 Sol стоит как 6.1 Sol, а в тесте 18 ноября 2026 года решила те же 12 задач в 4,3 раза быстрее; Opus 5.5 вышел там в 5 раз дороже.
Содержание
GPT-6.2 Sol вышла 17 ноября 2026 года и стоит в API столько же, сколько GPT-6.1 Sol. Если вы работаете на gpt-6.1-sol, переводите запросы на gpt-6.2-sol и начинайте с уровня рассуждений (effort) medium: в индексе Artificial Analysis новая модель набирает больше баллов на каждом уровне, а в тесте 18 ноября 2026 года на 12 одинаковых задачах она решила все 12, как и 6.1 Sol, только в 4,3 раза быстрее и с выходом на треть короче. Исключение — агентская работа в Codex, где 6.1 Sol стояла на max. В агентском индексе AA (Coding Agent Index) лучший результат 6.2 Sol — 49,8 на xhigh, на 2,4 балла ниже, чем 52,2 у 6.1 Sol max, хотя задача обходится на 40 % дешевле. Такие проекты переводите после проверки на своих задачах и на xhigh, а не на max.
Claude Opus 5.5 вдвое дороже Sol за каждый токен и при этом тратит больше токенов, поэтому в том же тесте Opus на medium обошёлся в 5,1 раза дороже, чем 6.2 Sol на уровне по умолчанию, при том же результате. Массовую работу — код по спецификации с тестами, разбор логов и документов, обычные шаги агента — можно отдавать 6.2 Sol. Opus 5.5 стоит оставить там, где он пока впереди: долгие автономные сессии в Claude Code (58,2 против 49,8 в Coding Agent Index, но $12,61 против $0,90 за задачу) и самые трудные задачи на максимальном уровне.
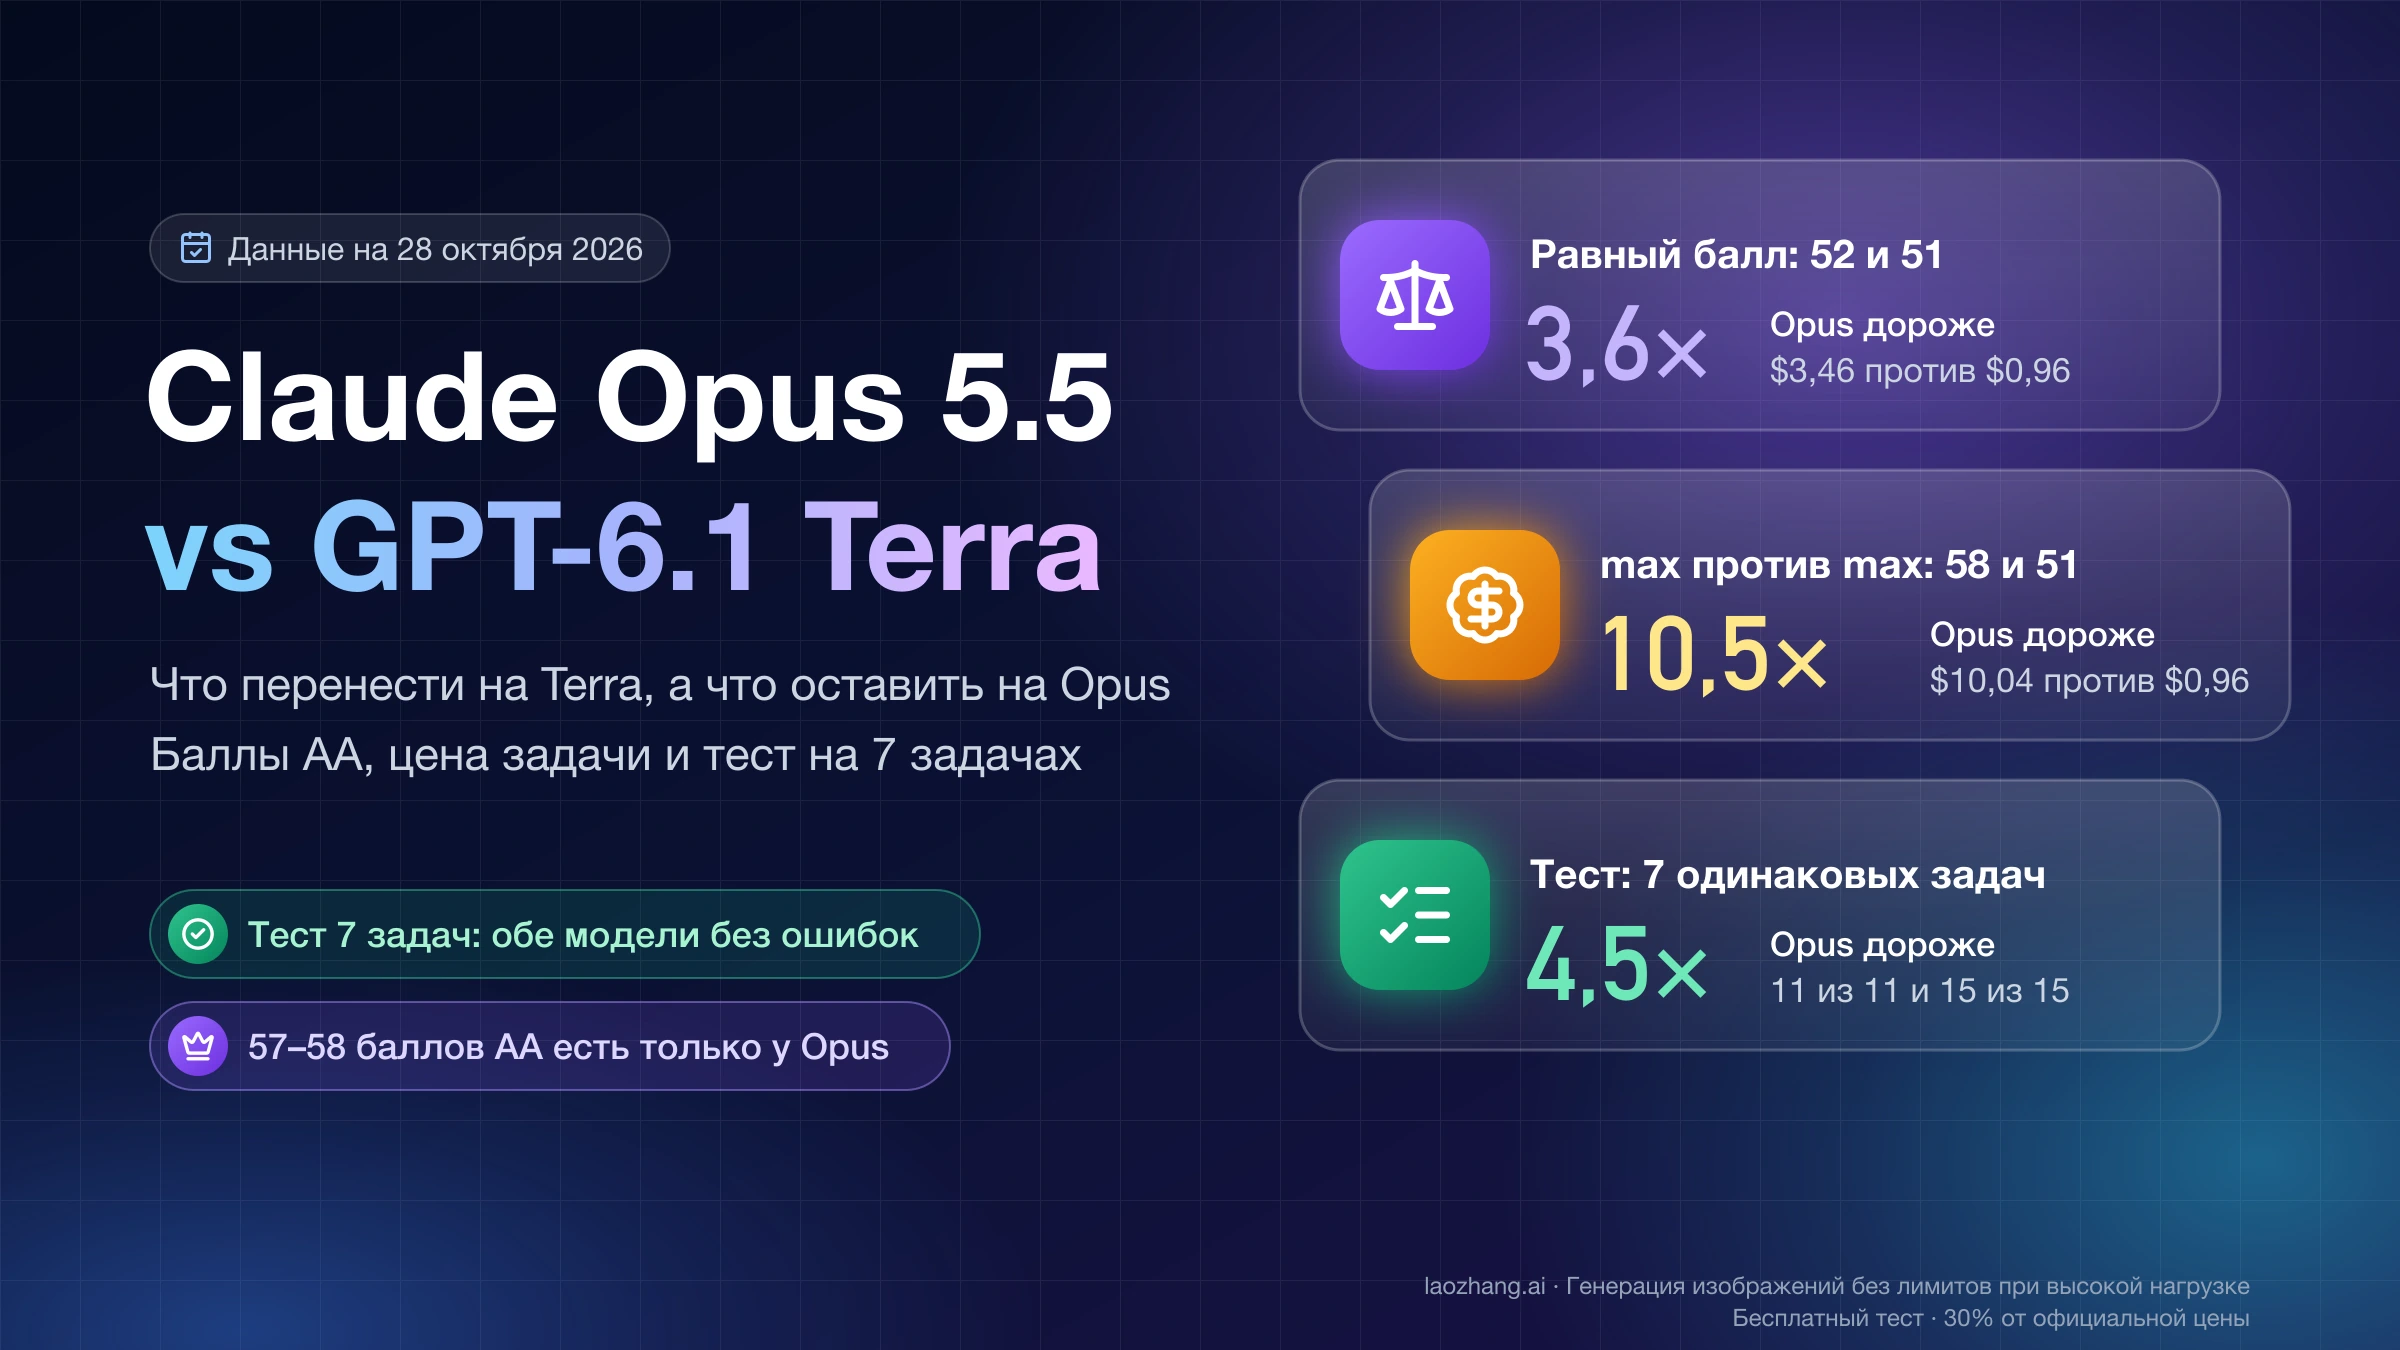
Формула «6.2 Sol обгоняет Opus 5.5 и стоит в разы дешевле» верна при сравнении на одном уровне рассуждений: на medium у Sol 53 балла индекса AA против 48 у Opus при шестой части цены задачи. На максимуме впереди Opus, 59 против 57. Цены OpenAI и данные AA ниже приведены по состоянию на 18 ноября 2026 года, цена Anthropic — на 12 ноября 2026 года, всё в долларах США.
Что выбрать по типу работы: 6.2 Sol по умолчанию, Opus для долгих агентов
Начинайте с GPT-6.2 Sol на medium почти для всего, что сейчас делает 6.1 Sol, и для той части работы Opus 5.5, где результат проверяется тестами или точным ответом. Повышайте уровень или переходите на Opus только там, где Sol начинает ошибаться на ваших проверках. Таблица — стартовая точка на 18 ноября 2026 года, основания для каждой строки разобраны в следующих разделах.
| Работа | С чего начать | Когда менять |
|---|---|---|
| Код по спецификации, функции с тестами, скрипты, ответы в API | GPT-6.2 Sol medium (уровень по умолчанию) | Проверки не проходят — high; не помогает и это — Opus 5.5 medium |
| Разбор длинных логов и документов, извлечение точных чисел | GPT-6.2 Sol medium | Ввод больше 272 000 токенов переводит весь запрос Sol на удвоенную цену ввода — сравните счёт с Opus |
| Агентская работа в Codex: многошаговые правки репозитория | GPT-6.2 Sol xhigh | Если на ваших задачах 6.1 Sol max заметно точнее — держите её в API, пока проверяете; max у 6.2 Sol в агентском индексе ниже xhigh и дороже |
| Долгие автономные сессии в Claude Code, трудный код, где ошибка стоит дорого | Opus 5.5 high или max | Чтобы снизить расходы, отдайте 6.2 Sol xhigh часть задач и сравните долю принятых результатов |
Сервис, который сейчас работает без рассуждений (none) | GPT-6.2 Sol low | none модель не принимает и возвращает ошибку 400 |
Если у вас смешанный поток задач, разделите его по типу работы, а не по модели целиком: большая часть запросов уходит на 6.2 Sol, а Opus получает только то, что не проходит проверку. Переключать модель внутри одного разговора в Responses API при этом не стоит — почему, сказано в разделе о том, что менять в запросах.
Цена GPT-6.2 Sol и 6.1 Sol одинаковая, Opus 5.5 вдвое дороже за токен
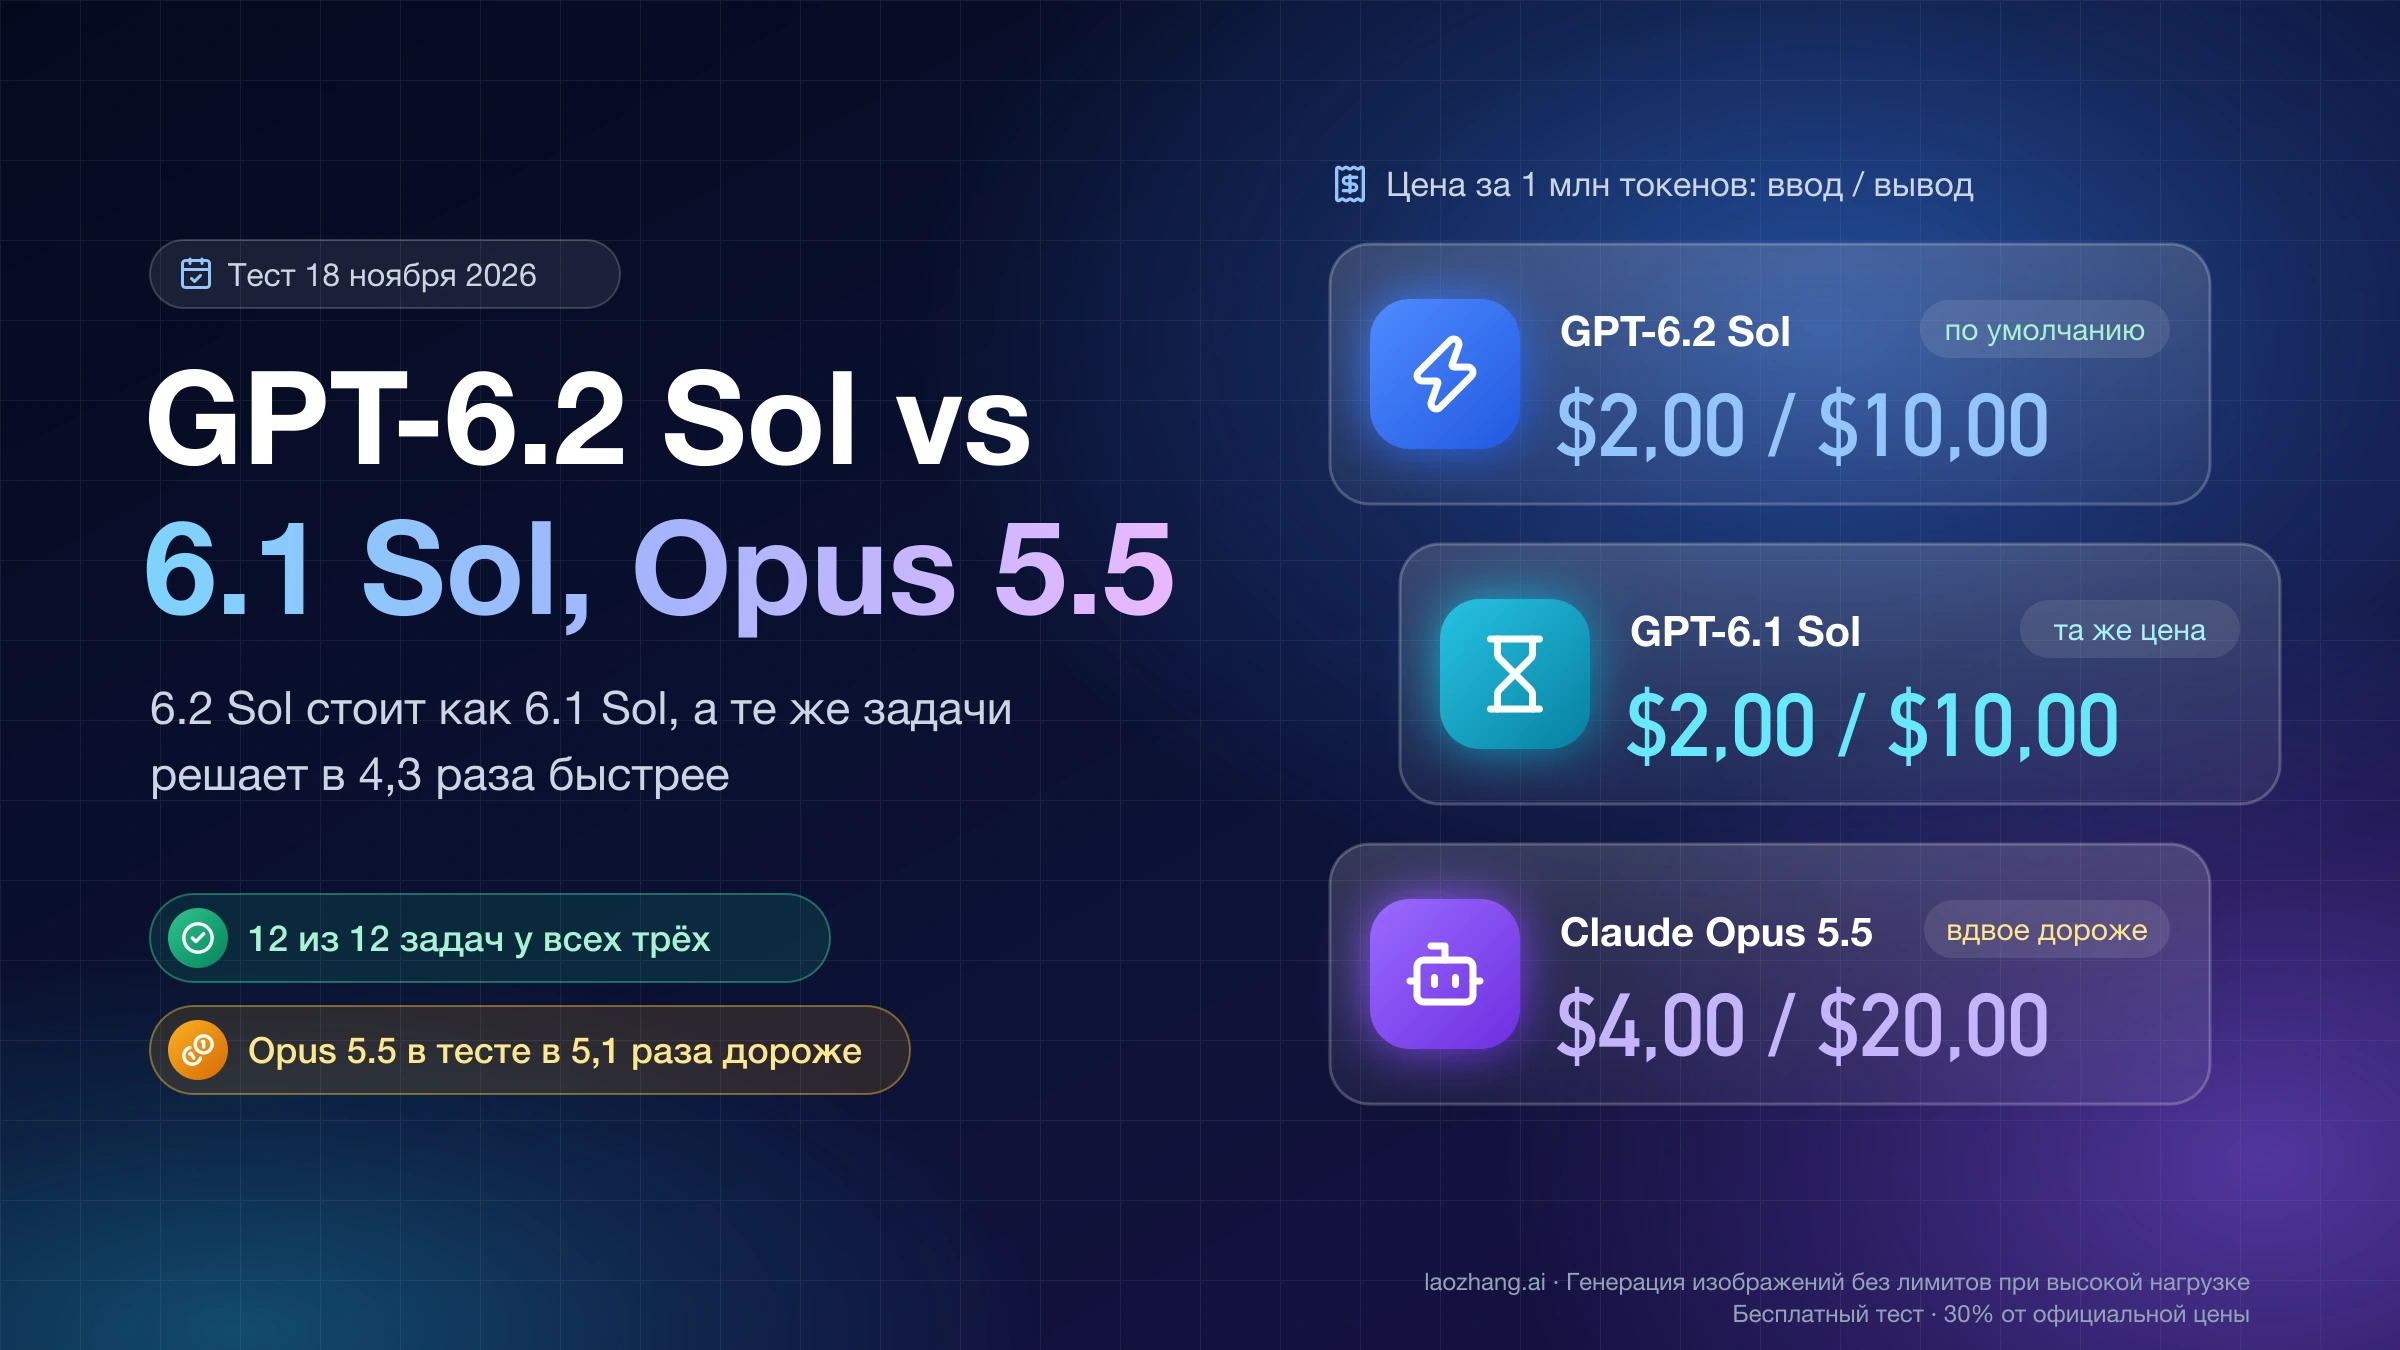
На странице цен OpenAI API по состоянию на 18 ноября 2026 года gpt-6.2-sol и gpt-6.1-sol стоят в тарифе Standard одинаково во всех колонках: $2,00 за 1 млн входных токенов, $10,00 за 1 млн выходных, $0,10 за кэшированный ввод. Claude Opus 5.5 по странице цен Claude API у Anthropic на 12 ноября 2026 года стоит $4 и $20, то есть ровно вдвое дороже и за ввод, и за вывод. Ставки ниже — за 1 млн токенов.
| Строка прайса | GPT-6.2 Sol | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|---|
| Ввод / вывод, Standard | $2,00 / $10,00 | $2,00 / $10,00 | $4,00 / $20,00 |
| Чтение из кэша | $0,10 | $0,10 | $0,20 |
| Запись в кэш | $2,50 (30 минут), $5,00 (12 часов) | $2,50 (30 минут), $5,00 (12 часов) | $5,00 (5 минут), $8,00 (1 час) |
| Ввод больше 272 000 токенов | весь запрос: $4,00 / $15,00 | весь запрос: $4,00 / $15,00 | без надбавки, $4,00 / $20,00 |
| Batch | $1,00 / $5,00 | $1,00 / $5,00 | $2,00 / $10,00 |
Длинный контекст сближает модели: когда ввод Sol превышает 272 000 токенов, по удвоенной ставке считается весь запрос, и цена ввода становится такой же, как у Opus, а разница остаётся только в выводе — $15 против $20. Контекстное окно GPT-6.2 Sol — 1 050 000 токенов, максимум ввода — 922 000, вывода — 128 000 (страница модели GPT-6.2 Sol).
Между двумя версиями Sol различаются только дополнительные режимы. Fast у обеих стоит $4 / $20, а Ultrafast у 6.2 Sol — $6 / $30, втрое дороже Standard, тогда как у 6.1 Sol — $12 / $60. Эта скидка временная: с 1 марта 2027 года Ultrafast у 6.2 Sol тоже станет шестикратным. Ещё одно отличие — фоновые задачи с отложенным завершением: скидка 30 % за окно в 2 часа и 40 % за окно в 8 часов указана для 6.2 Sol и отсутствует у 6.1 Sol. Поскольку цена токена у двух Sol одинаковая, вся экономия от перехода на 6.2 приходится на число токенов, которые модель тратит на задачу.
Тест 18 ноября 2026 года: 12 одинаковых задач, все модели решили все
На небольших задачах с проверяемым ответом все три модели оказались одинаково точными, а различались скоростью, числом выходных токенов и ценой. 18 ноября 2026 года 12 задач со скрытыми тестами или точным ответом — текстовая задача на арифметику, слияние интервалов, разбор длительностей, вычислитель выражений, разбор строки CSV, сравнение версий и диапазонов semver, вопрос по длинному документу и другие — были отправлены каждой модели по одному разу через шлюз laozhang.ai с тем же текстом запросов. GPT-6.2 Sol и GPT-6.1 Sol вызывались через /v1/chat/completions в тот же день: без параметра reasoning_effort, что соответствует medium, и с high. Ответы Opus 5.5 на medium и high для 8 задач получены 11 ноября 2026 года, для 4 — 18 ноября.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
| Конфигурация | Решено | Выходные токены | Время, сумма по 12 задачам | Стоимость по счёту | Стоимость без кэша |
|---|---|---|---|---|---|
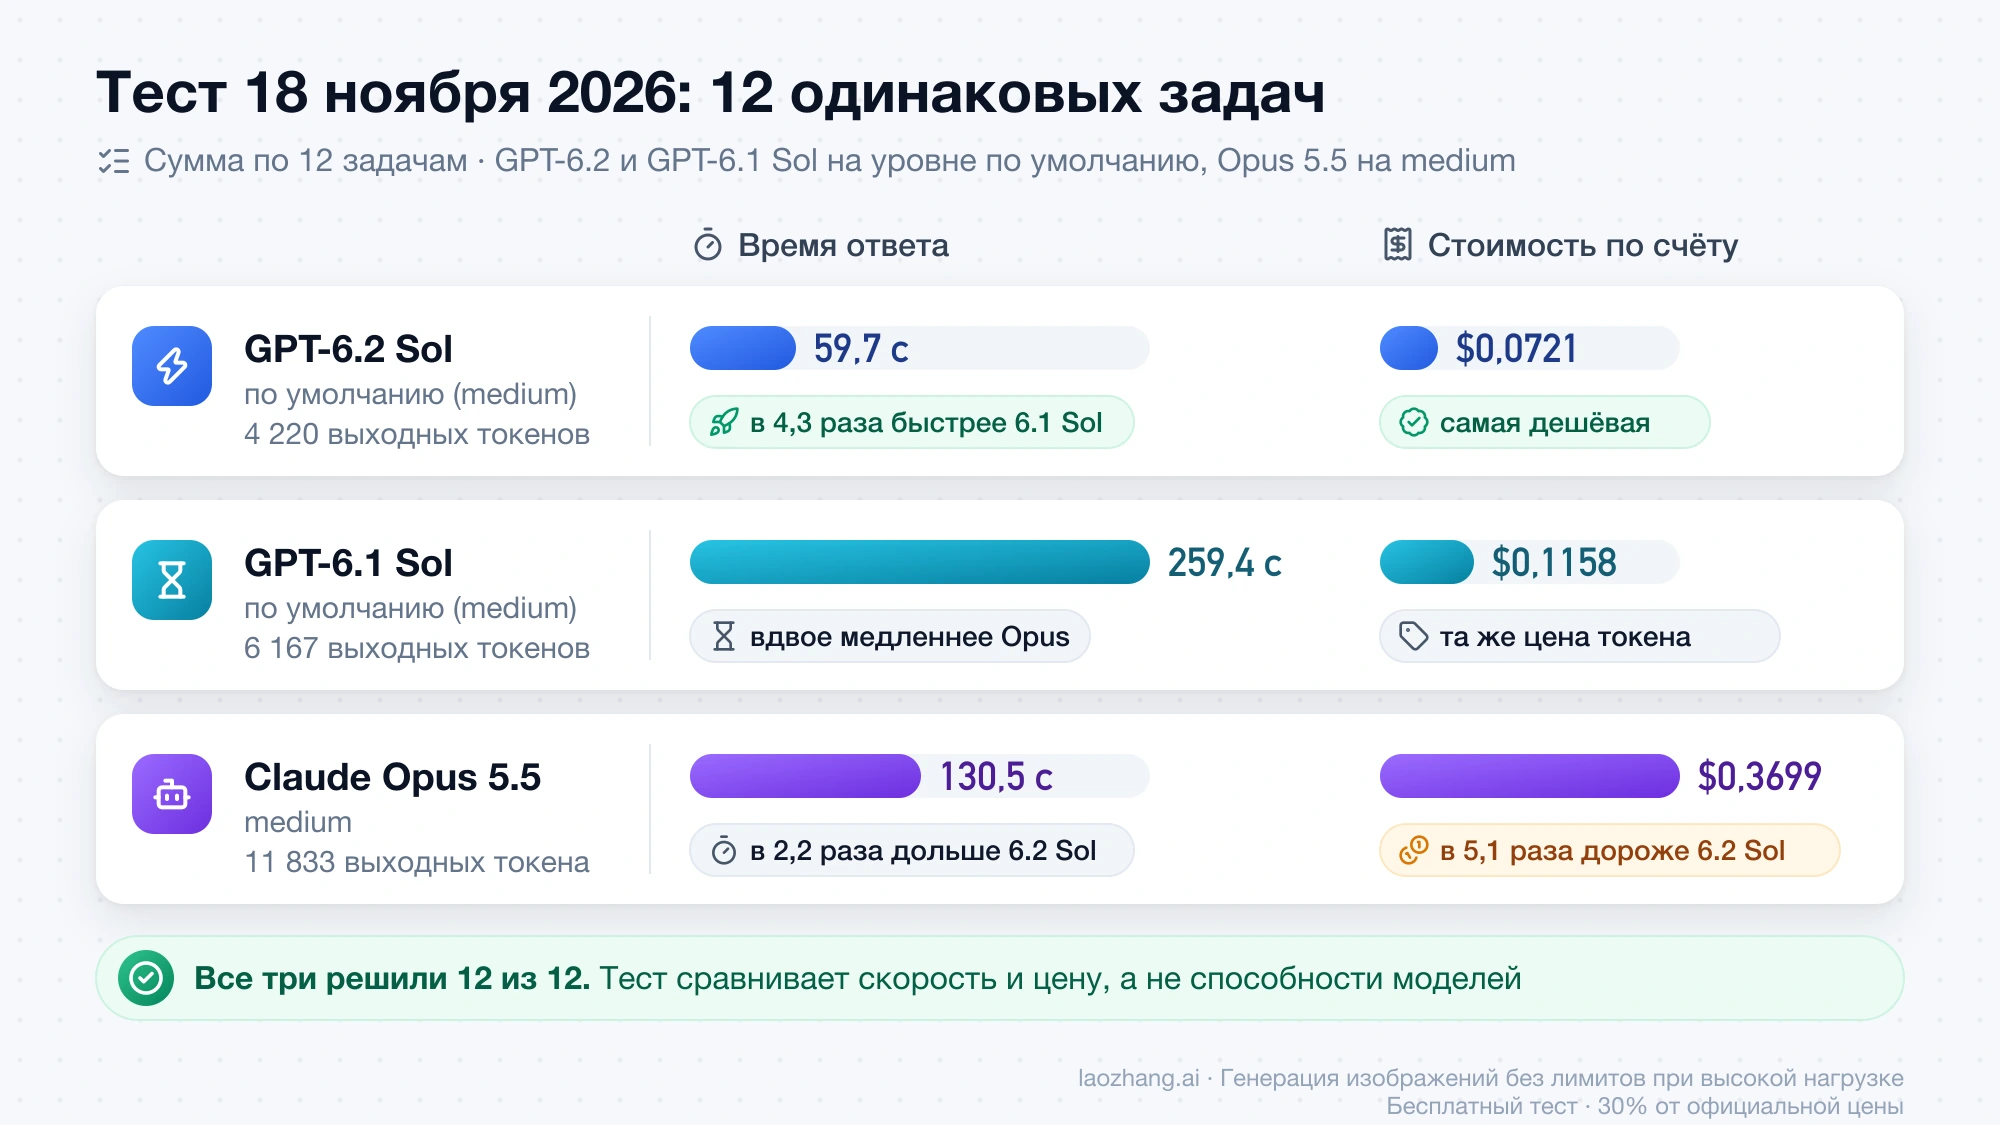
| GPT-6.2 Sol, по умолчанию | 12 из 12 | 4 220 | 59,7 с | $0,0721 | $0,0862 |
GPT-6.2 Sol, high | 12 из 12 | 6 765 | 76,6 с | $0,1217 | $0,1116 |
| GPT-6.1 Sol, по умолчанию | 12 из 12 | 6 167 | 259,4 с | $0,1158 | $0,1056 |
GPT-6.1 Sol, high | 12 из 12 | 10 380 | 363,1 с | $0,1579 | $0,1477 |
Claude Opus 5.5, medium | 12 из 12 | 11 833 | 130,5 с | $0,3699 | $0,3699 |
Claude Opus 5.5, high | 12 из 12 | 13 674 | 159,3 с | $0,4067 | $0,4067 |
«Стоимость по счёту» посчитана по прайсу из токенов, которые вернул шлюз, вместе с записью в кэш и чтением из него; «без кэша» — если бы весь ввод шёл по обычной цене. Для сравнения двух Sol честнее вторая колонка: одна задача 6.2 Sol на уровне по умолчанию прочитала из кэша 10 103 токена, потому что тот же запрос с high был отправлен незадолго до неё. Без кэша 6.2 Sol на уровне по умолчанию дешевле 6.1 Sol на 18 % ($0,0862 против $0,1056), на high — на 24 % ($0,1116 против $0,1477). По времени разрыв намного больше: 59,7 с против 259,4 с — в 4,3 раза, на high 76,6 с против 363,1 с — в 4,7 раза. Выходных токенов 6.2 Sol тратит на 32–35 % меньше.
Opus 5.5 на medium по сравнению с 6.2 Sol на уровне по умолчанию дал в 2,8 раза больше выходных токенов (11 833 против 4 220), работал в 2,2 раза дольше и стоил в 5,1 раза дороже по счёту ($0,3699 против $0,0721) или в 4,3 раза без учёта кэша. При этом Opus оказался вдвое быстрее 6.1 Sol на уровне по умолчанию — медлительность 6.1 Sol и способы её ускорить разобраны в материале «GPT-6.1 Sol медленно работает: замеры по effort и как ускорить».
У теста есть границы, и они важнее итоговых сумм. На каждую комбинацию модели и уровня отправлен один запрос, а задачи короткие и однократные: все три модели прошли их полностью, поэтому тест показывает скорость, расход токенов и цену, но не разницу в способностях. Время — это полное время ответа через шлюз, а не задержка у OpenAI или Anthropic. Стоимость — оценка по ценам из прайса, а не выписка. Ответы Opus за 11 ноября получены в потоковом режиме, за 18 ноября — без потока. Одна задача Opus на high засчитана после того, как функцию и тесты к ней разнесли по двум файлам.
Лог на 146 КБ: одинаково точно, а 6.2 и 6.1 почти равны по цене
Когда основная часть счёта — ввод, преимущество 6.2 Sol над 6.1 Sol сводится к скорости. В задаче на подсчёт по логу из 1 500 строк (146 КБ, нужно назвать 7 точных чисел) все конфигурации ответили правильно. GPT-6.2 Sol на уровне по умолчанию 18 ноября 2026 года уложилась в 13,6 с и $0,1581, GPT-6.1 Sol 16 ноября — в 45,7 с и $0,1654, Claude Opus 5.5 на medium 11 ноября — в 57,6 с и $0,4681. Обе Sol получили на вход 55 843 токена, и шлюз учёл почти весь ввод как запись в кэш по $2,50 за 1 млн: 55 840 × $2,50 / 1 млн ≈ $0,1396 плюс 1 845 выходных токенов × $10 / 1 млн ≈ $0,0185 дают $0,158 у 6.2 Sol.
Тот же текст у Opus превратился в 78 537 входных токенов — в 1,41 раза больше, потому что у моделей разные токенизаторы. Поэтому на одном и том же документе Opus дороже не вдвое, как в прайсе, а сильнее: 78 537 × $4 / 1 млн ≈ $0,314 за ввод плюс 7 699 × $20 / 1 млн ≈ $0,154 за вывод дают $0,468, почти в 3 раза больше, чем у 6.2 Sol. Ввод здесь далеко от порога 272 000 токенов, так что о цене длинного контекста этот замер ничего не говорит.
Индекс AA по уровням рассуждений: 6.2 Sol выше 6.1 Sol на 2–7 баллов
На каждом уровне рассуждений GPT-6.2 Sol набирает в Intelligence Index v5.0.1 от Artificial Analysis больше, чем GPT-6.1 Sol: на 6 баллов на low, на 7 на medium, на 5 на high, на 4 на xhigh и на 2 на max. Цена задачи индекса при этом почти та же или ниже. В таблице — балл и стоимость одной задачи индекса по сравнению Claude Opus 5.5 и GPT-6.2 Sol на Artificial Analysis на 18 ноября 2026 года; данные 6.1 Sol — по той же версии индекса на 4 ноября 2026 года, строка max — на 11 ноября.
| Уровень | GPT-6.2 Sol | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|---|
low | 41, $0,18 | 35, $0,16 | 35, $0,98 |
medium | 53, $0,41 | 46, $0,36 | 48, $2,45 |
high | 55, $0,56 | 50, $0,59 | 52, $3,46 |
xhigh | 56, $0,65 | 52, $0,76 | 57, $6,05 |
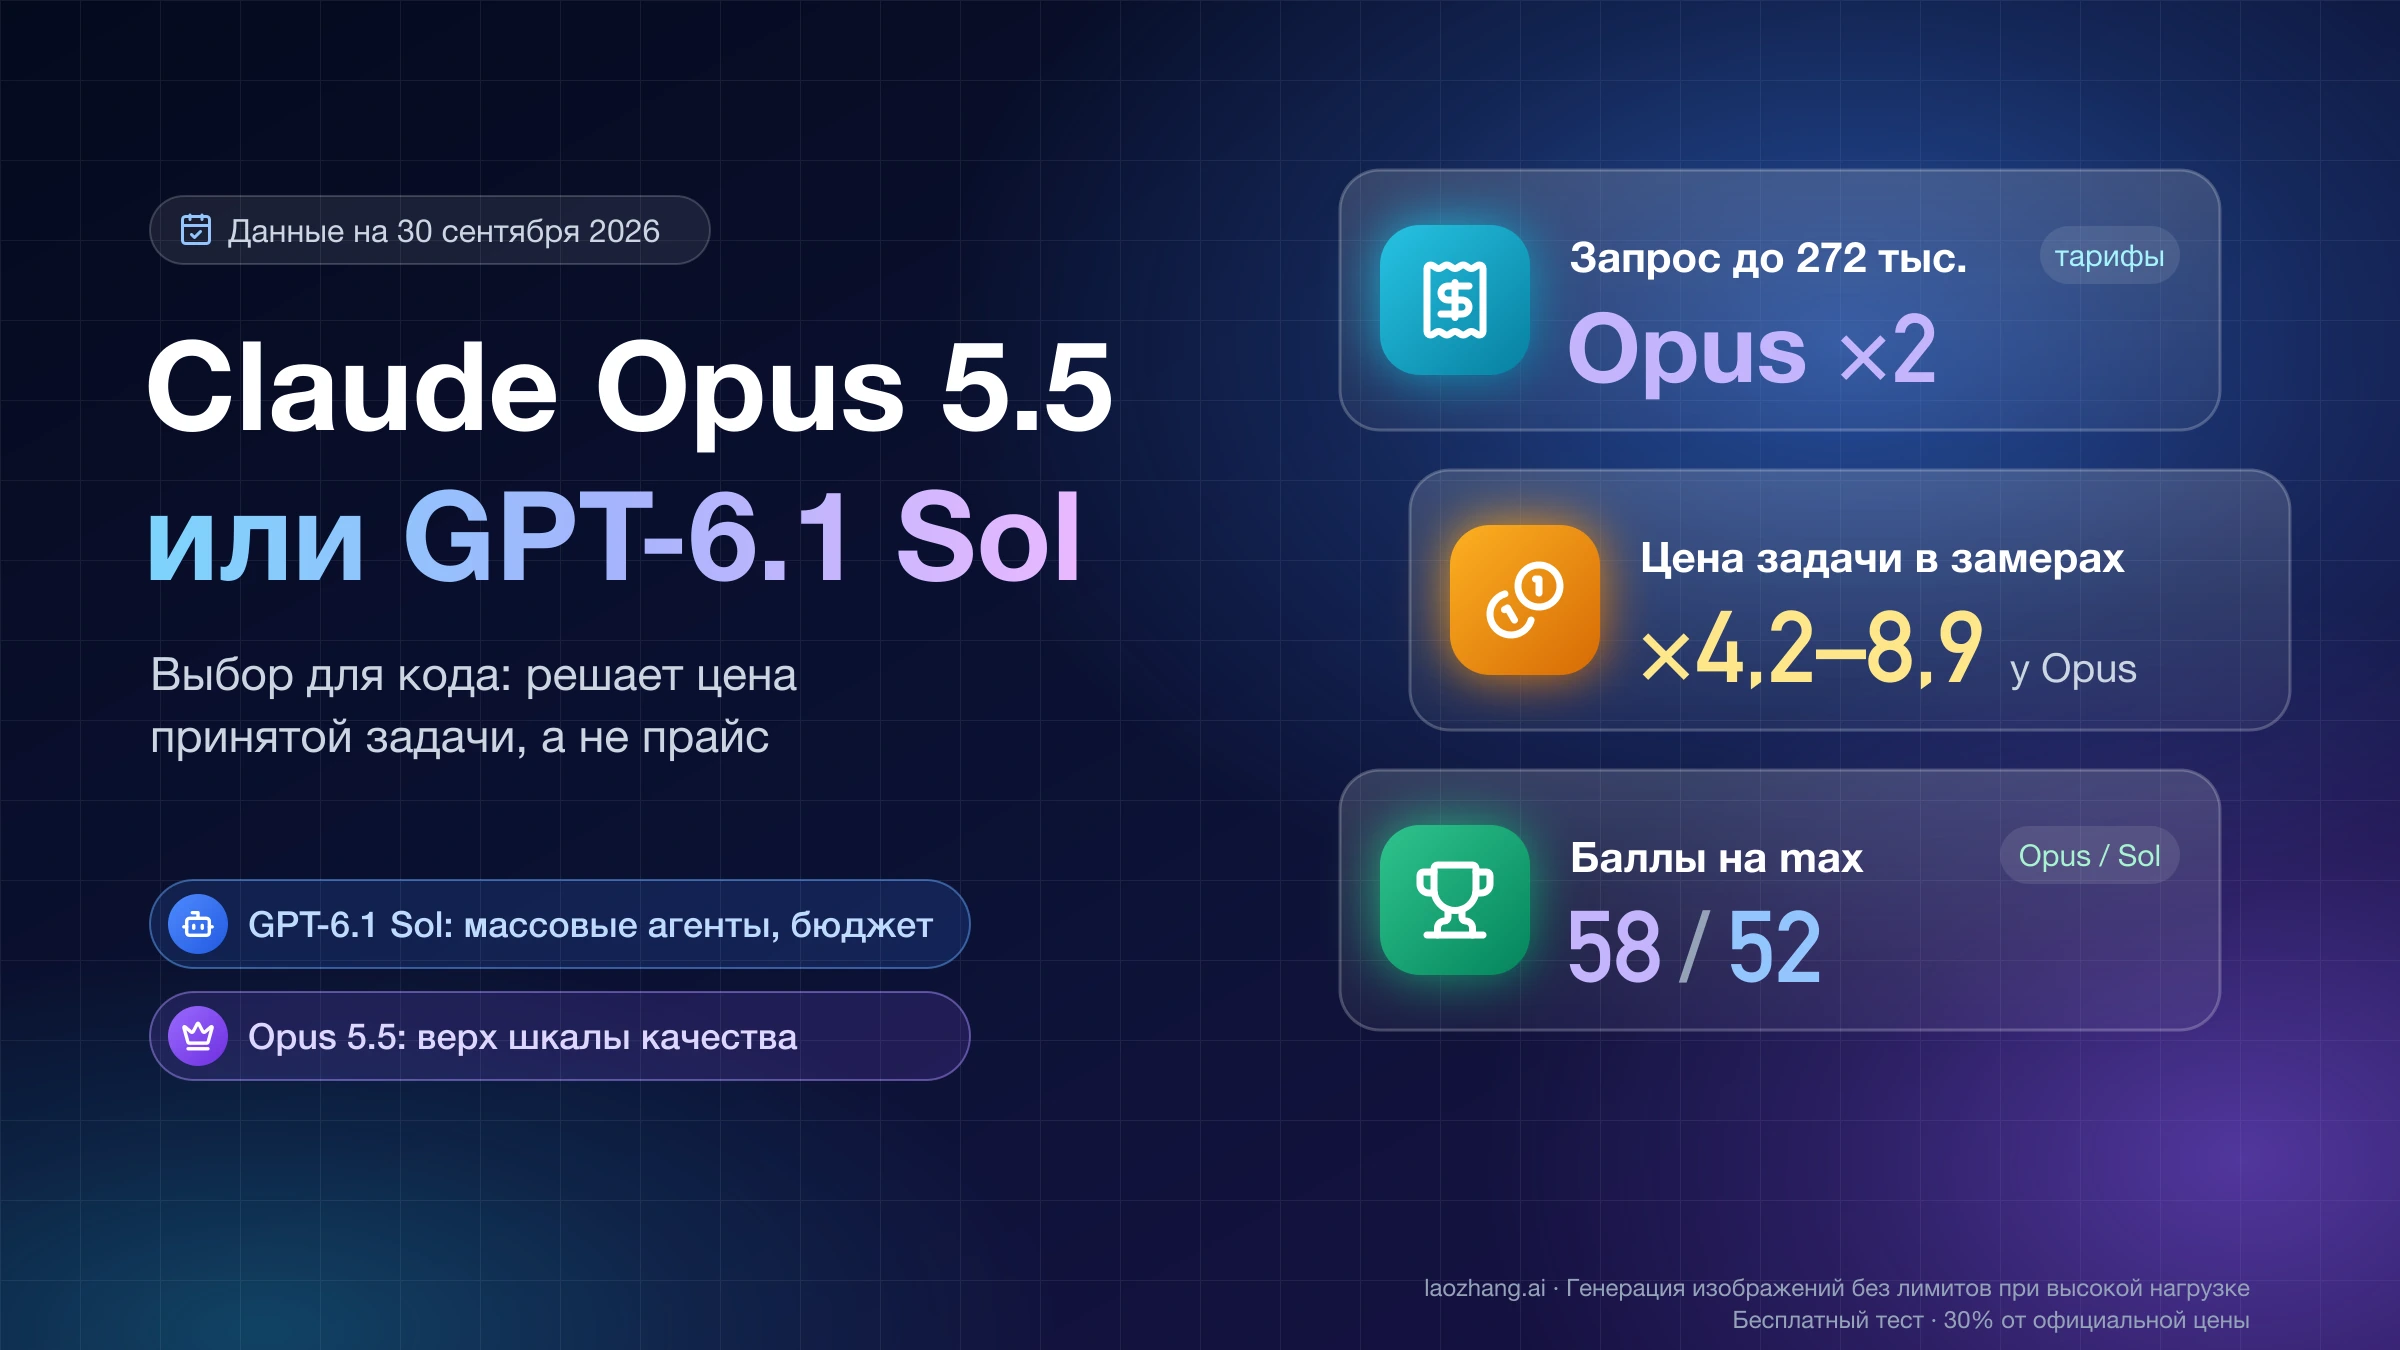
max | 57, $1,01 | 55, $1,27 | 59, $10,04 |
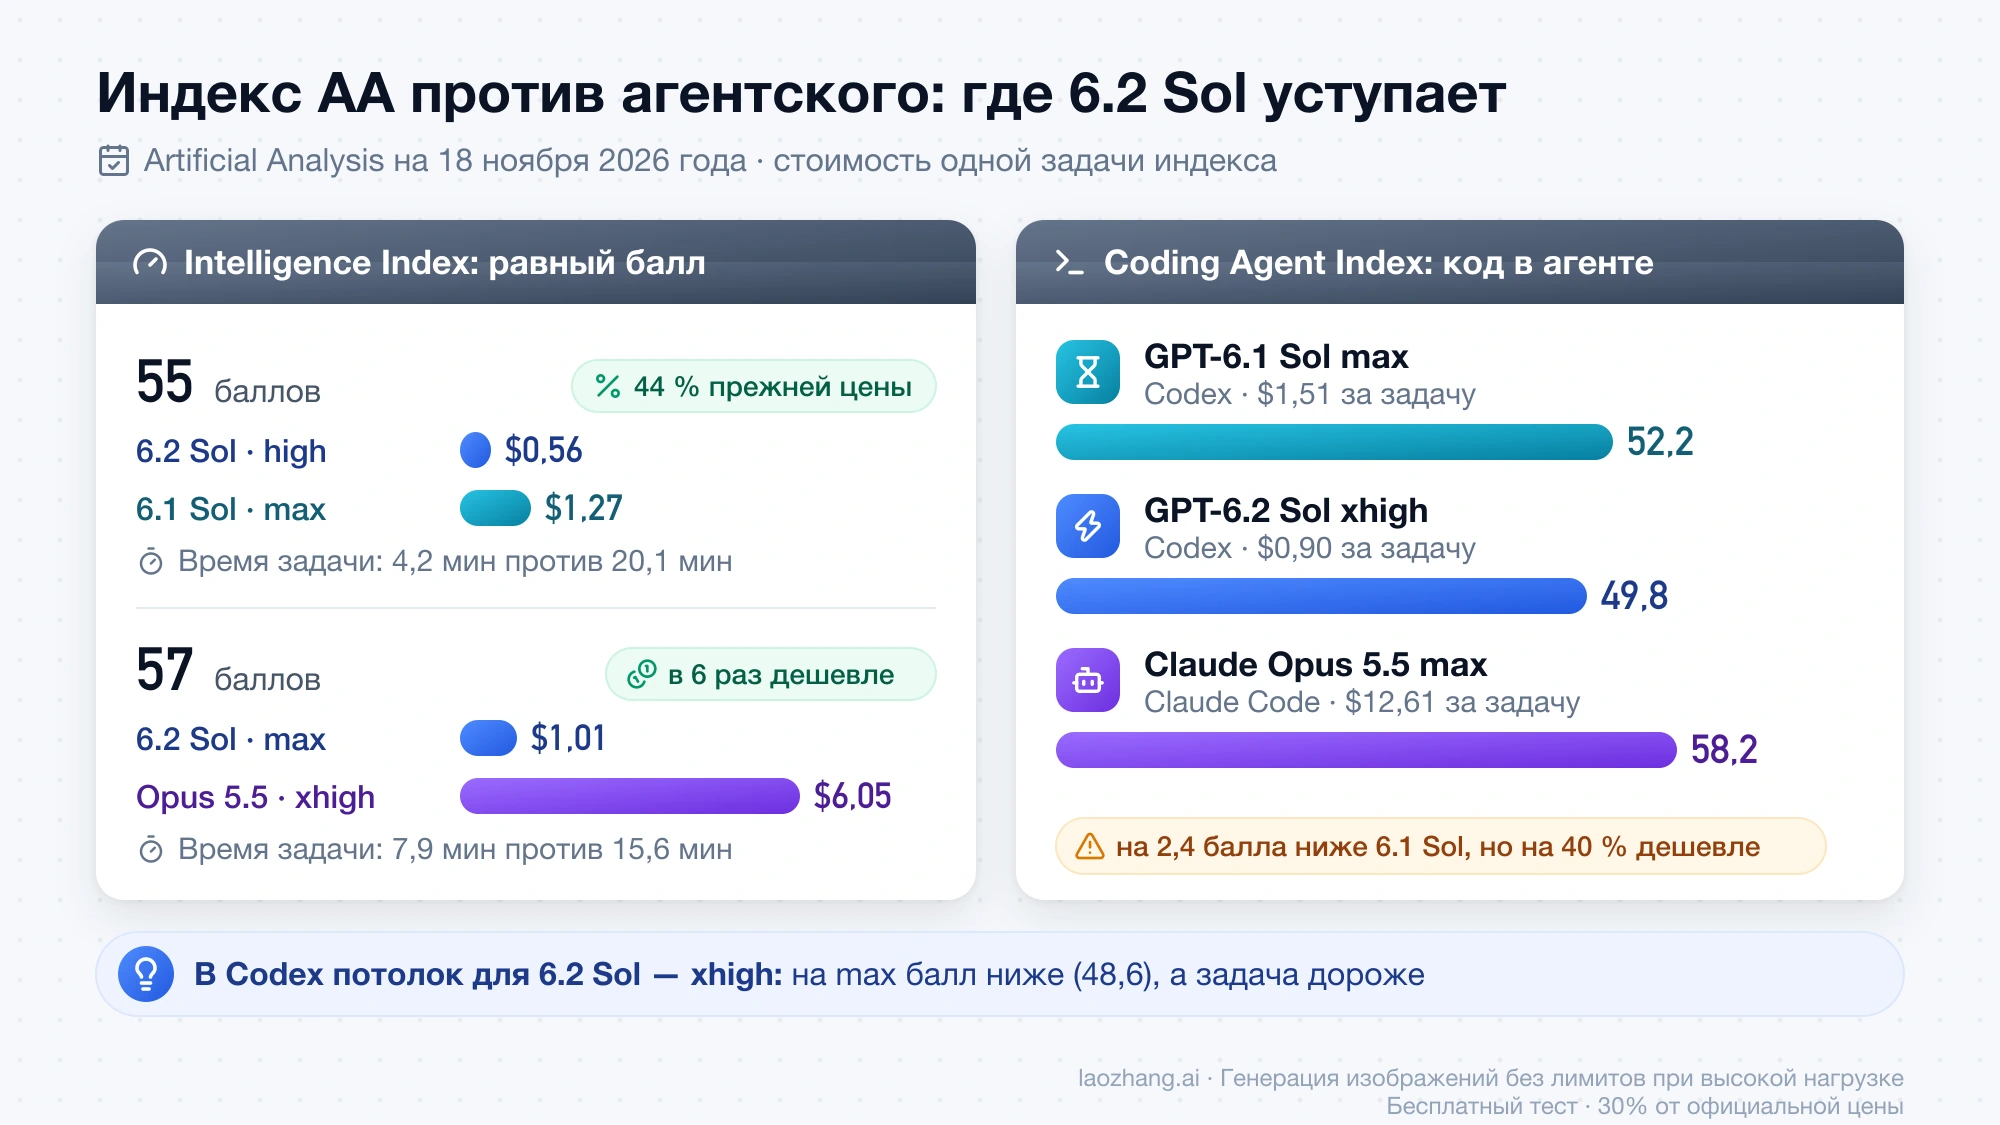
Самое полезное сравнение для перехода — 6.2 Sol high против 6.1 Sol max: у обеих 55 баллов, но задача новой модели стоит $0,56 против $1,27, то есть 44 % прежней цены, и занимает 4,2 минуты против 20,1. Если вы держали 6.1 Sol на max ради качества, на 6.2 Sol начните с high. У самой 6.2 Sol главный скачок происходит между low и medium — плюс 12 баллов за $0,23 к цене задачи, — а выше medium она добавляет 4 балла при росте цены в 2,5 раза. Поэтому medium разумен как уровень по умолчанию, а xhigh и max стоит включать для задач, где ошибка дороже времени.
Две пометки в каталоге AA легко принять за решения производителей. Строки Opus 5.5 подписаны там как «Default Fallback» — это обозначение конфигурации в каталоге AA, а не настройка Anthropic. А 18 ноября 2026 года AA пометила выпуск GPT-6.1 Sol как «deprecated» в своём списке моделей — это статус в каталоге AA, а не объявление OpenAI об отключении модели.
Правда ли 6.2 Sol хуже 6.1 в коде: 49,8 против 52,2 у агента Codex
В агентском коде — частично да, и именно отсюда цифра «52 → 49». В Coding Agent Index от Artificial Analysis, где модель работает внутри агента Codex CLI 0.166.0 или Claude Code на задачах FrontierCode 2.0, SWE-Atlas QnA и Terminal-Bench v4, лучший результат GPT-6.2 Sol — 49,8 на xhigh, а у GPT-6.1 Sol max — 52,2. Задача 6.2 Sol при этом стоит $0,90 против $1,51 и занимает 12,6 минуты против 21,9. Для 6.1 Sol в индексе есть только строка max, поэтому сравнить версии на одном уровне по этим данным нельзя.
| Агент и модель | Балл | Стоимость задачи | Время задачи |
|---|---|---|---|
Codex + GPT-6.1 Sol max | 52,2 | $1,51 | 21,9 мин |
Codex + GPT-6.2 Sol xhigh | 49,8 | $0,90 | 12,6 мин |
Codex + GPT-6.2 Sol max | 48,6 | $1,22 | 17,5 мин |
Codex + GPT-6.2 Sol high | 47,5 | $0,76 | 10,6 мин |
Codex + GPT-6.2 Sol medium | 45,4 | $0,57 | 8,4 мин |
Claude Code + Claude Opus 5.5 max | 58,2 | $12,61 | 65,3 мин |
Из таблицы следует практический вывод: в Codex 6.2 Sol на max набирает меньше, чем на xhigh, и обходится дороже, так что для агентской работы потолок — xhigh. Пользователи после выхода модели спорят о том же: ветка на r/codex с заголовком «6.2 Sol is worse than 6.1» набрала 305 голосов и 150 комментариев, VentureBeat вынес в заголовок отзыв «Essentially unusable», а в комментарии на Hacker News пишут, что расход на Sol упал с $2,6 на 6.1 до $1,2 на 6.2 при похожей точности, — и там же, что Opus 5.5 просто сильнее. Это отзывы отдельных пользователей, а не замеры.
Если ваш проект в Codex зависит от качества длинных агентских цепочек, сравните 6.2 Sol xhigh и 6.1 Sol max на нескольких своих задачах с тестами и посчитайте долю принятых правок, а не только счёт. 6.1 Sol на 18 ноября 2026 года остаётся в прайсе API, так что вернуться к ней можно без спешки. Что изменилось при переходе с GPT-6 Sol на 6.1 Sol, разобрано в материале «GPT-6.1 Sol: цена, доступ и что менять при переходе с GPT-6 Sol».
Обгоняет ли GPT-6.2 Sol Claude Opus 5.5: на одном уровне да, на максимуме нет
При равном балле индекса AA GPT-6.2 Sol в 6 раз дешевле Opus 5.5 за задачу: 57 баллов Sol набирает на max за $1,01 и 7,9 минуты, Opus — на xhigh за $6,05 и 15,6 минуты. Sol на medium (53 балла, $0,41) уже выше Opus на high (52 балла, $3,46). На вопрос, обгонит ли 6.2 Sol на low Opus на medium, индекс отвечает «нет» — 41 против 48, но Sol на medium обгоняет его при шестой части цены ($0,41 против $2,45).
Нюансы начинаются на верхних уровнях и в длинной агентской работе. Максимальный балл у Opus выше — 59 против 57. По отдельным тестам на max модели почти равны в Terminal-Bench 4.0 (60,1 % у Sol и 59,6 % у Opus), а в FrontierCode-AA 2.0 и HLE-Diamond впереди Opus: 46,4 % против 44,4 % и 67,9 % против 64,0 %. Сильнее всего разница в агентском индексе: Claude Code с Opus 5.5 на max набирает 58,2 против 49,8 у Codex с 6.2 Sol на xhigh, но задача стоит в 14 раз дороже ($12,61 против $0,90) и идёт в 5 раз дольше. Учтите, что здесь сравниваются связки агента и модели, а не модели сами по себе. Пользовательские отчёты показывают тот же разрыв в цене: в посте на X один и тот же запрос на 3D-сцену обошёлся в $2,07 и 30 минут на 6.2 Sol против $31,85 и 2 часов 45 минут на Opus 5.5.
Отдавая работу Opus модели 6.2 Sol, вы теряете несколько баллов точности на самых трудных задачах и в долгих автономных сессиях, а экономите примерно в 3–14 раз в зависимости от задачи: от трёхкратной разницы на длинном логе до четырнадцатикратной в агентском индексе. Для кода с тестами и задач с проверяемым ответом это обычно выгодный обмен: в тесте 18 ноября обе модели решили всё. Для многочасовых сессий в Claude Code, где одна неудачная правка стоит дороже всей экономии, Opus пока оправдан. Как Opus 5.5 сравнивался с прошлым поколением Sol, разобрано в материале «Claude Opus 5.5 или GPT-6.1 Sol (и GPT-6 Sol): выбор для кода», а способы подключить Opus 5.5, в том числе из России, — в статье «Claude Opus 5.5: как пользоваться, можно ли бесплатно и в России».
Что поменять в запросах при переходе на gpt-6.2-sol
Замена ID модели почти ничего не ломает, если вы уже на 6.1 Sol, но несколько изменений из руководства OpenAI по переходу на GPT-6.2 влияют на кэш и качество ответов в длинных разговорах. Каждый пункт ниже независим от остальных.
- Замените
noneнаlow: GPT-6.2 Sol, как и 6.1 Sol, этот уровень не принимает. 18 ноября 2026 года через laozhang.ai запрос сnoneвернул 400:Unsupported value: 'none' is not supported with the 'gpt-6.2-sol' model. Supported values are: 'low', 'medium', 'high', 'xhigh', and 'max'.OpenAI советует то же дляminimal, а новую интеграцию начинать сmedium. - Перенесите постоянные инструкции из
instructionsвinput. Начиная с GPT-6.2, Responses API ставит верхнеуровневое полеinstructionsпослеinput. Чтобы повторяющиеся инструкции попадали в кэш, они должны стоять в сообщении с рольюdeveloperпервым элементомinput. В проверке 18 ноября блокinstructionsна 9 000 токенов, отправленный три раза, не дал ни одного кэшированного токена — и через laozhang.ai, и напрямую в OpenAI. - Не редактируйте начало разговора. Если в Responses API изменить более раннюю часть разговора, сменить модель (в том числе на более слабую) или пользователя, модель теряет свои прежние рассуждения: качество может упасть, а токенов уйдёт больше. Меняйте настройки между ответами, не трогая предыдущие сообщения, и не переключайте 6.2 Sol и 6.1 Sol внутри одного диалога.
- Отправляйте вызовы инструментов (tool calling) и запросы с
maxчерез Responses API: по документации OpenAI инструменты у GPT-6.2 работают только там, аreasoning_effort: maxчерез Chat Completions 18 ноября не сработал. - Уберите из запросов Chat Completions
temperature,top_p,logprobsиtop_logprobs. - Указывайте в коде
gpt-6.2-sol. Через laozhang.ai ответы 6.2 Sol приходили с"model": "gpt-6.2-sol-2026-11-17", но датированной версии в документации OpenAI нет, и закреплять её нельзя.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
Частые вопросы о GPT-6.2 Sol, 6.1 Sol и Opus 5.5
Отключат ли GPT-6.1 Sol после выхода 6.2 Sol?
Даты отключения GPT-6.1 Sol в журнале изменений OpenAI API на 18 ноября 2026 года нет, и модель по-прежнему есть в прайсе API. Сторонние обзоры пишут, что в ChatGPT Work, Codex и API моделью по умолчанию стала 6.2 Sol, но останется ли 6.1 Sol доступной для выбора в Codex и ChatGPT, OpenAI не сообщала.
Не взять ли вместо 6.2 Sol модель GPT-6.2 Astra?
GPT-6.2 Astra, вышедшая в тот же день, стоит $8 / $40 за 1 млн токенов — вчетверо дороже Sol, и OpenAI предлагает её для самых требовательных задач. В Coding Agent Index от Artificial Analysis на 18 ноября 2026 года Codex с Astra на max набирает 53,5 при $5,12 за задачу, то есть выше 6.1 Sol max, но ниже Claude Code с Opus 5.5.
Источники6
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 18 нояб. 2026 г..
Источники6
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 18 нояб. 2026 г..
- 1.странице цен OpenAI APIdevelopers.openai.com/api/docs/pricing
- 2.странице цен Claude API у Anthropicplatform.claude.com/docs/en/about-claude/pricing
- 3.страница модели GPT-6.2 Soldevelopers.openai.com/api/docs/models/gpt-6.2-sol
- 4.сравнению Claude Opus 5.5 и GPT-6.2 Sol на Artificial Analysisartificialanalysis.ai/models/releases/comparisons/claude-opus-5-5-vs-gpt-6-2-sol
- 5.Coding Agent Index от Artificial Analysisartificialanalysis.ai/agents/coding
- 6.руководства OpenAI по переходу на GPT-6.2developers.openai.com/api/docs/guides/latest-model