Claude Fable 5.2 или Gemini 4 Carbon: цена задачи с 1 декабря
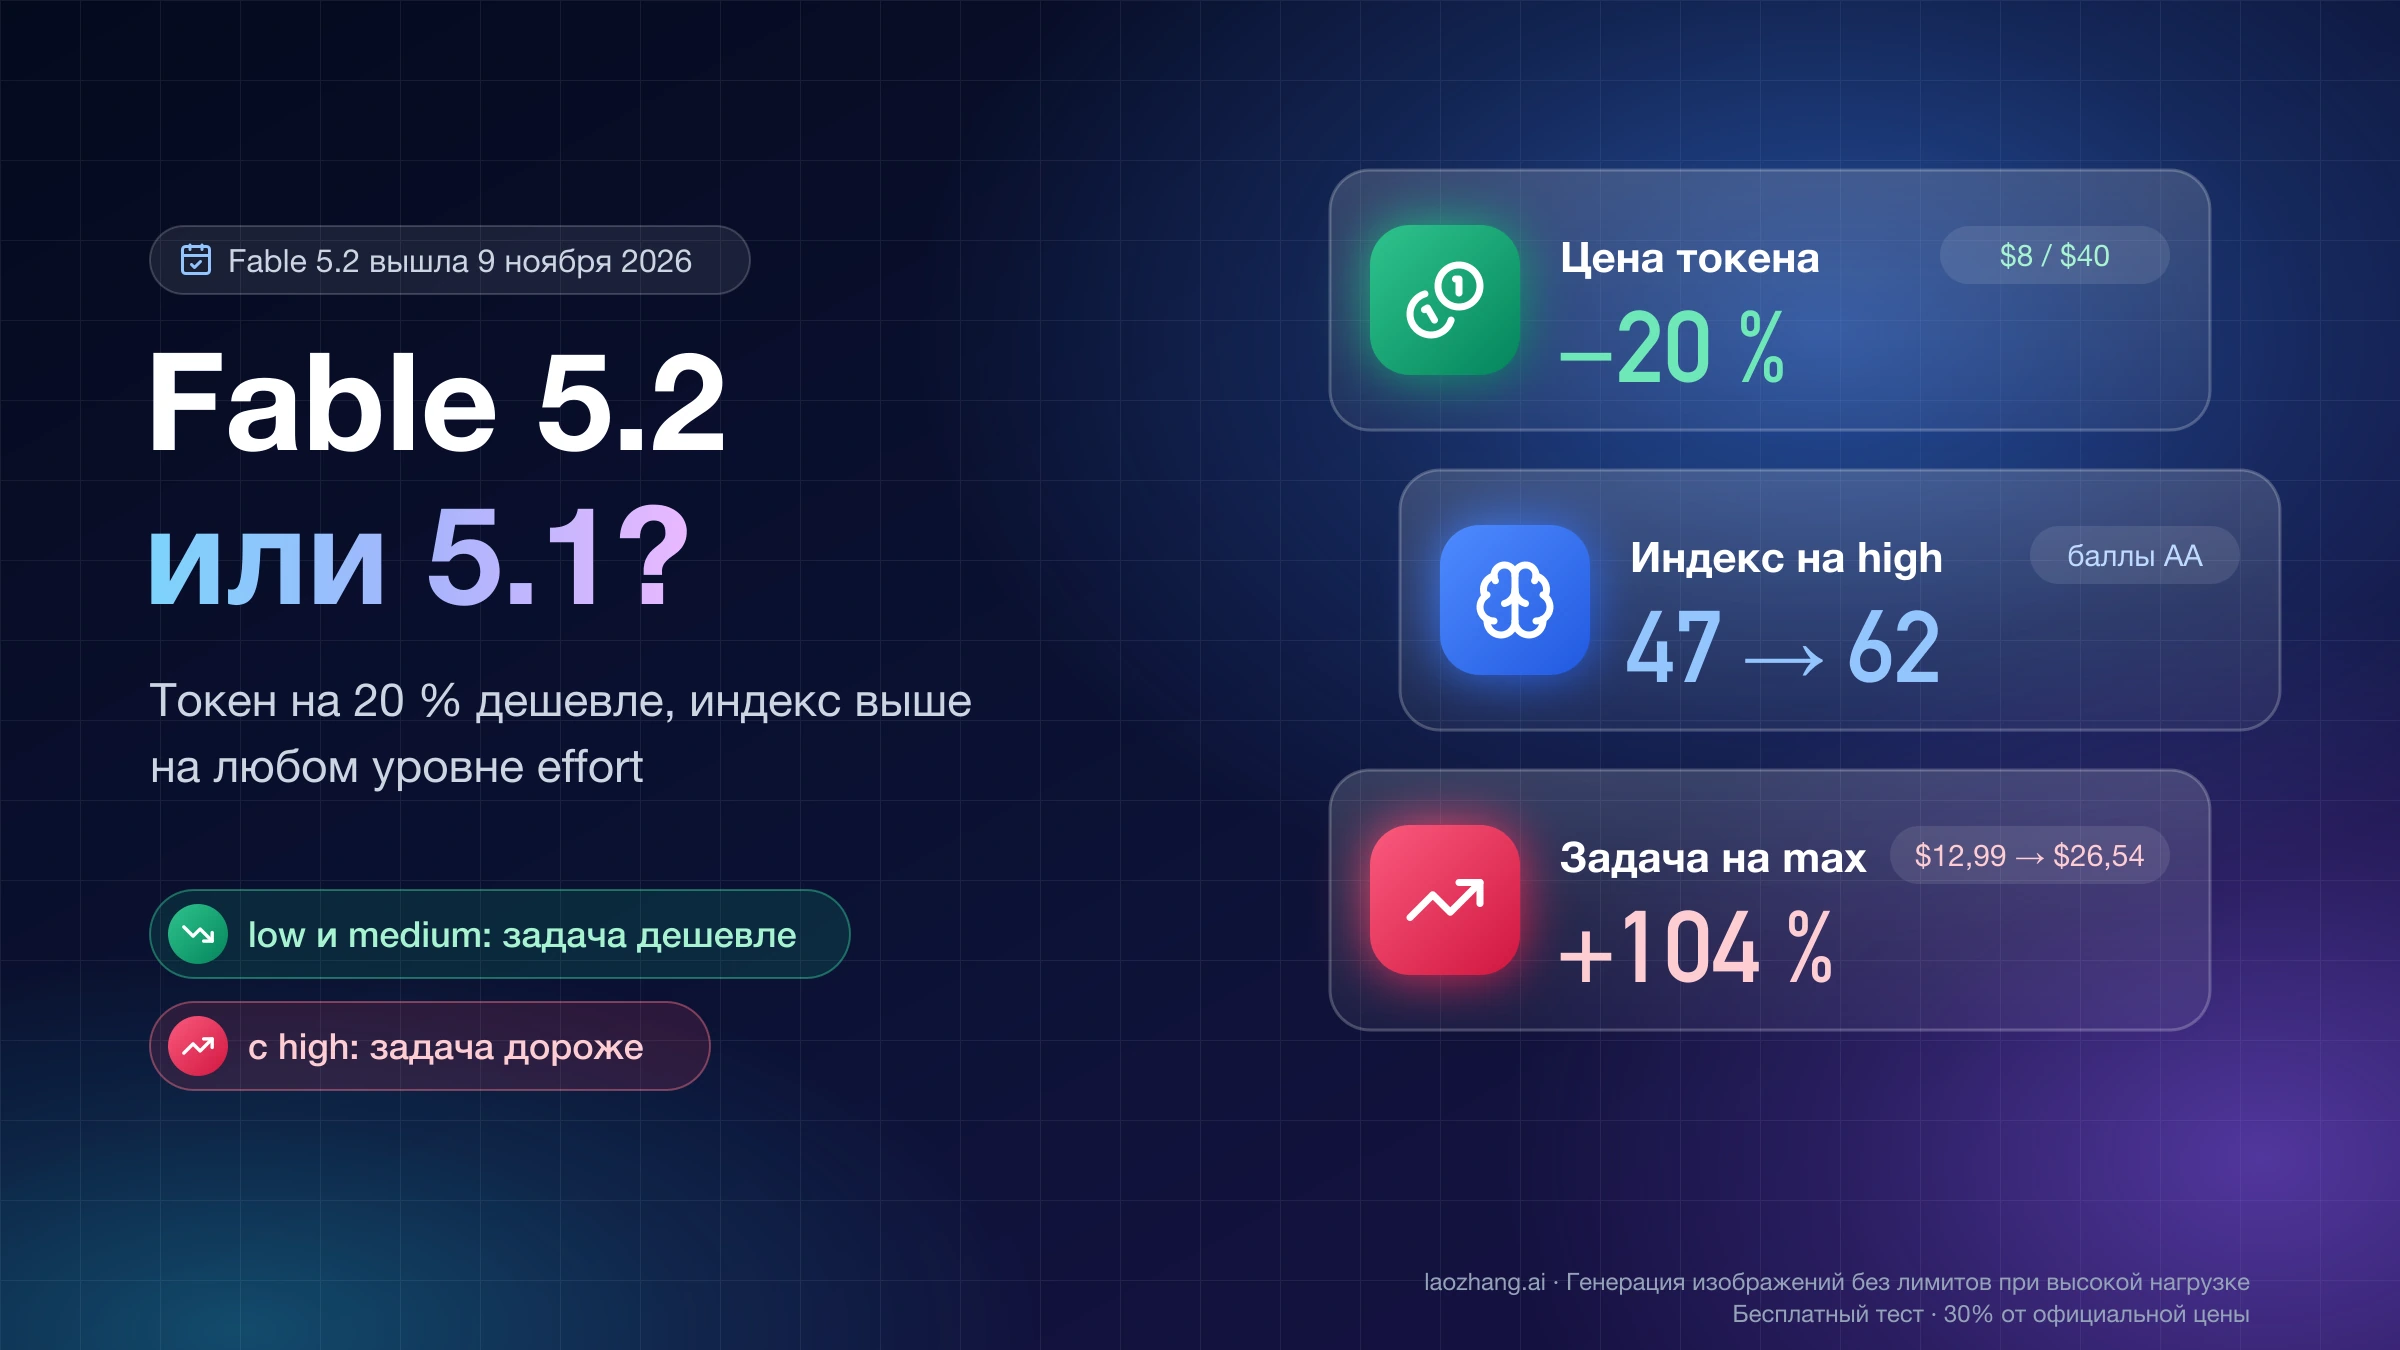
Gemini 4 Carbon вчетверо дешевле Claude Fable 5.2 за токен, но в тесте кода с 1 декабря обходится за задачу в 1,22 раза дороже и работает втрое дольше.
Содержание
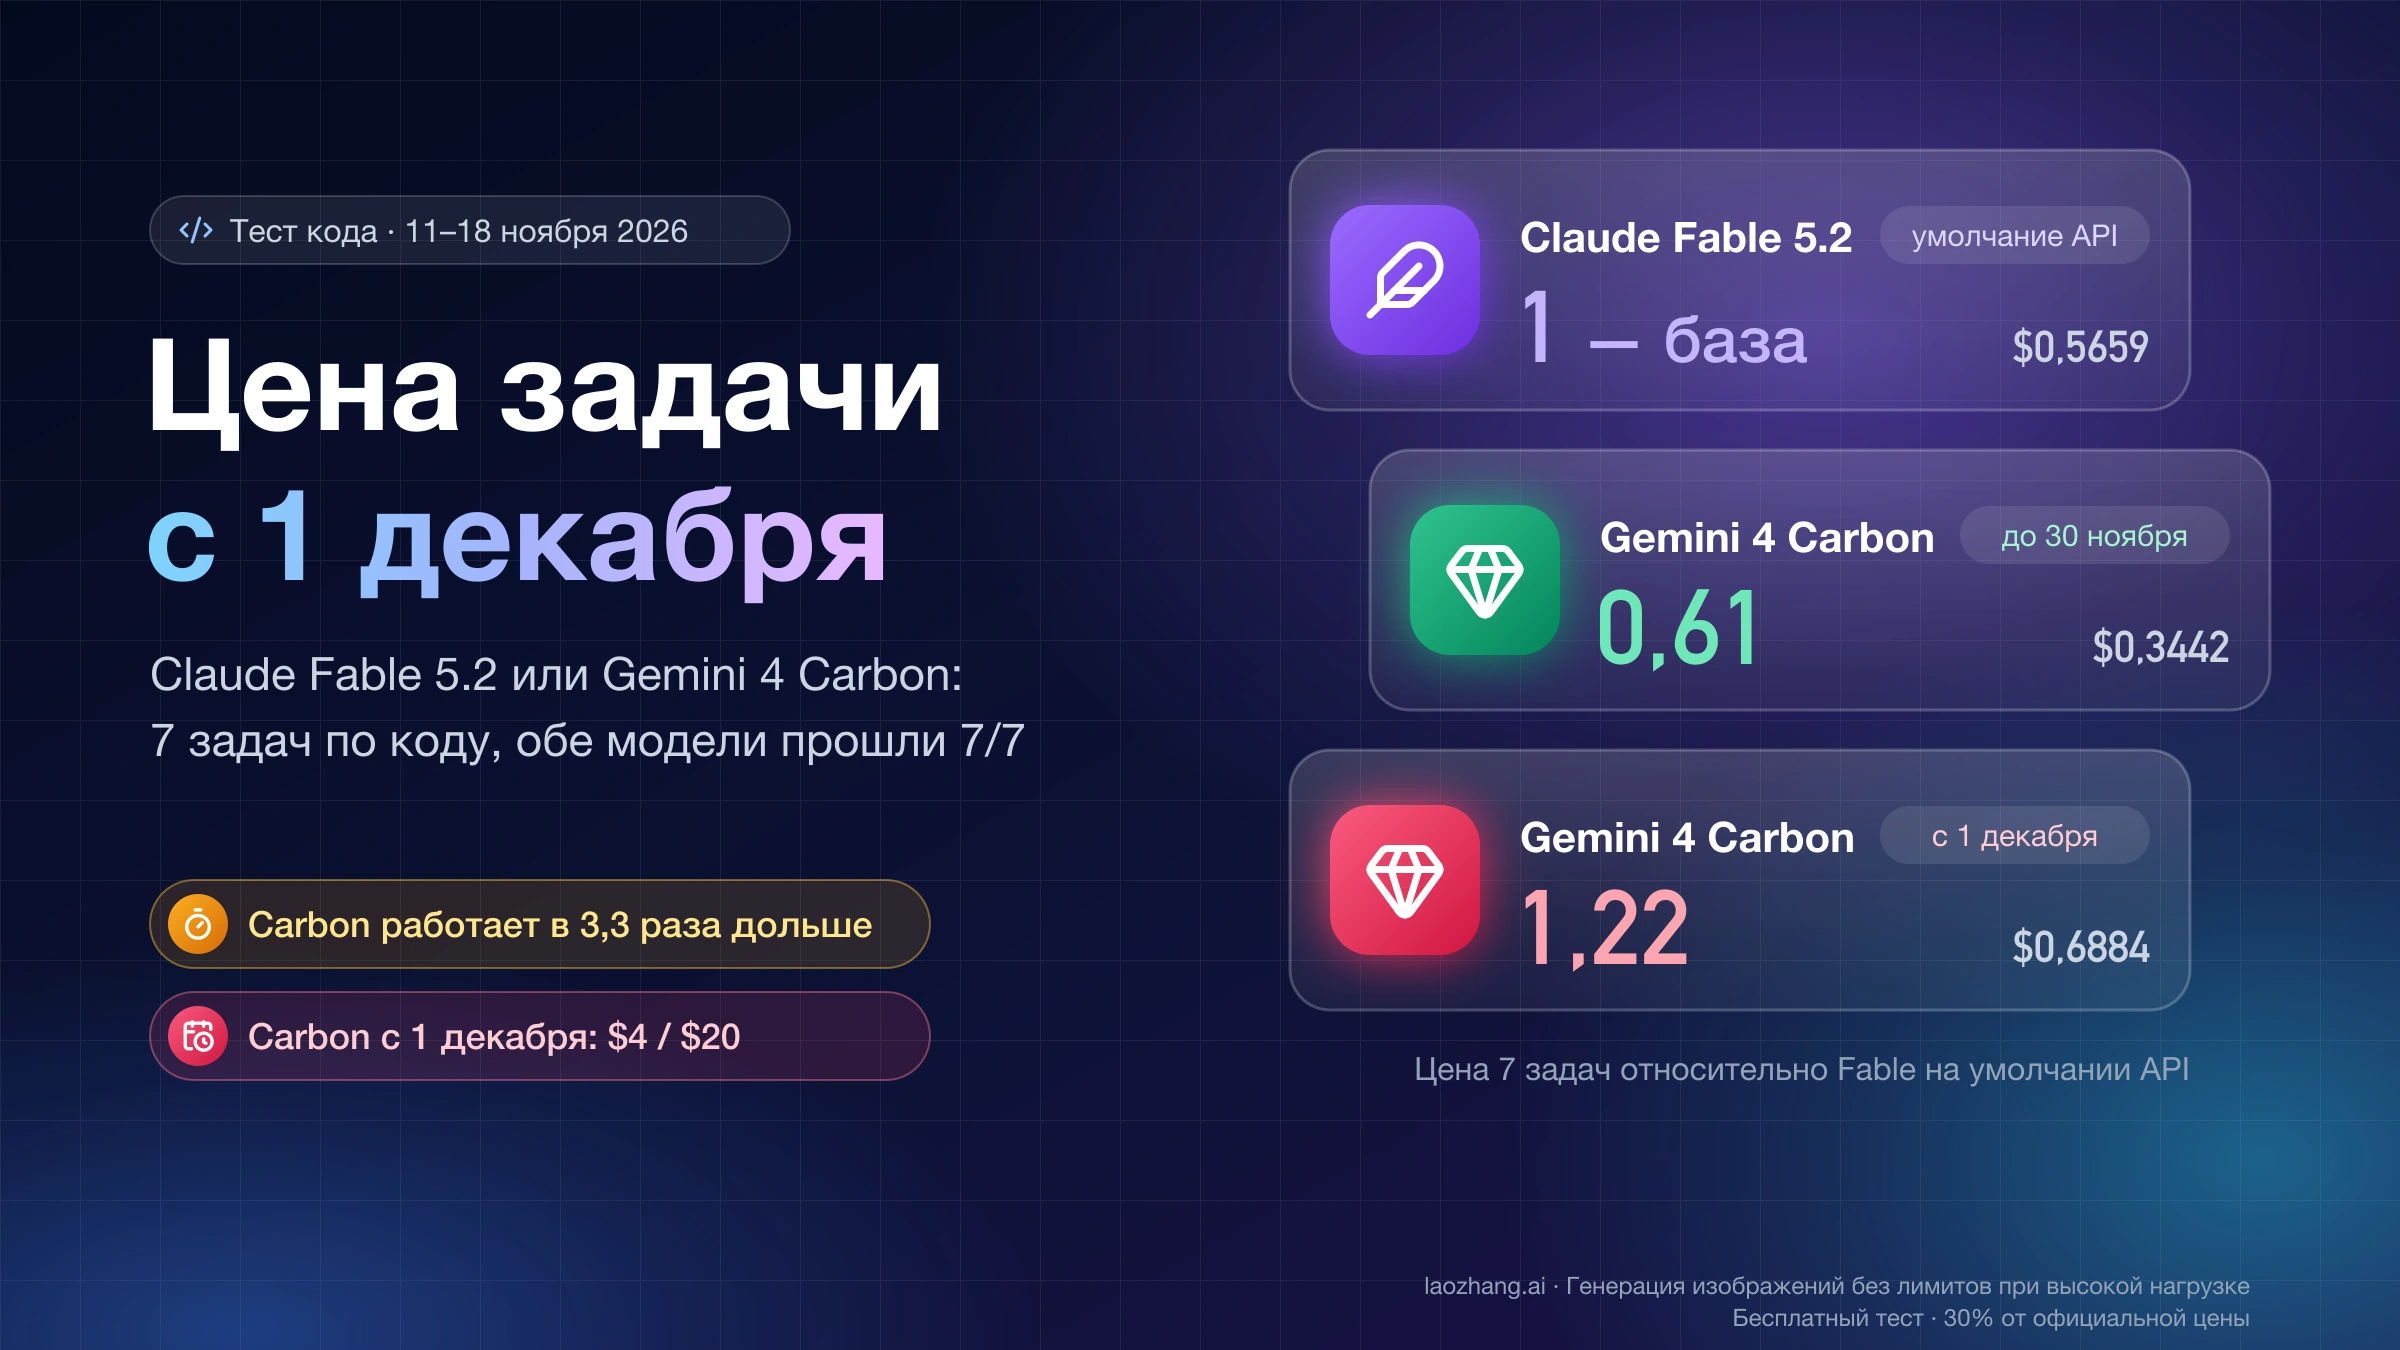
Если вы выбираете между Claude Fable 5.2 и Gemini 4 Carbon для API или кодового агента и будете платить и в декабре, берите по умолчанию claude-fable-5-2 на effort medium, а самые трудные задачи отдавайте ей же на high. Фраза «Carbon в четыре раза дешевле» верна только для цены токена и только до 30 ноября 2026 года: с 1 декабря Google поднимает цену gemini-4-carbon вдвое, до $4 за ввод и $20 за вывод за 1 млн токенов, а размышляет Carbon заметно дольше Fable. В тесте на семи задачах по коду со скрытыми тестами (11–18 ноября 2026 года) обе модели прошли 7 из 7; Carbon на своём уровне по умолчанию стоил 0,61 от Fable на умолчании API сейчас и 1,22 с 1 декабря, а работал в 3,3 раза дольше. Против Fable на medium, которая тоже прошла всё, с декабря он дороже почти вдвое.
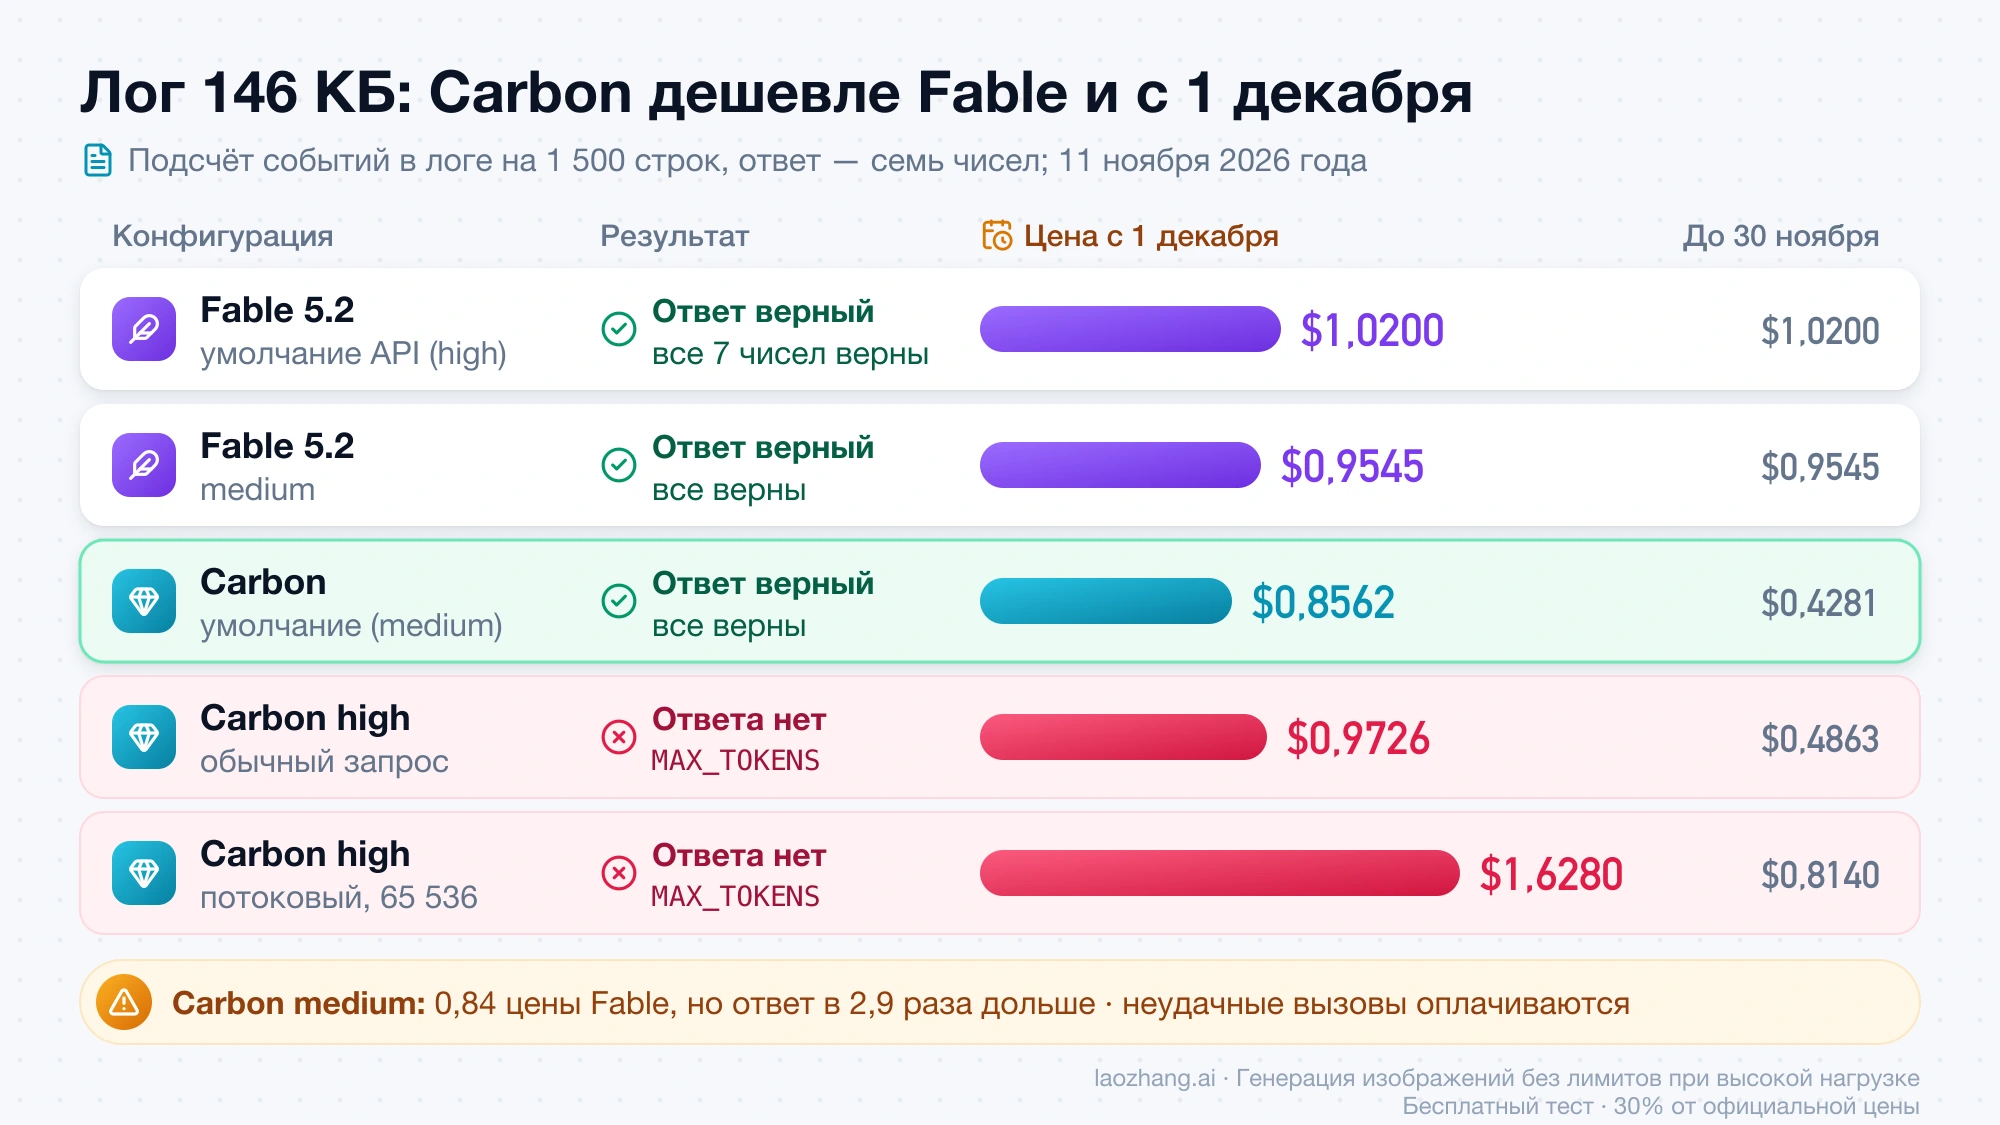
Carbon остаётся выгодным там, где счёт делает вход, а не размышления: длинный лог на 146 КБ он разобрал верно за 0,42 цены Fable сейчас и за 0,84 в декабре. Он же единственный из двух принимает на вход видео и аудио и немного опережает Fable в Terminal-Bench 4.0 и AutomationBench у Artificial Analysis. Fable сильнее в трудном коде, в знаниях и в скорости: по данным Artificial Analysis на 18 ноября 2026 года при одинаковом балле 54 задача индекса на Fable low стоит $3,10 и занимает 5,3 минуты, на Carbon low — $5,22 и 29,6 минуты.
Переход может упереться не в качество. Fable в API требует 30-дневного хранения данных и отказывает в части задач по кибербезопасности, а Carbon доступен только на платном уровне Gemini API, и Россия с Беларусью не входят в список стран, где Gemini API работает.
Цены Fable 5.2 и Gemini 4 Carbon: за токен вчетверо, с 1 декабря вдвое
По странице цен Anthropic на 18 ноября 2026 года Claude Fable 5.2 стоит $8 за 1 млн входных и $40 за 1 млн выходных токенов, вводной цены нет. Запись в кэш на 5 минут стоит $10, на час — $16, чтение из кэша — $0,20, Batch API — $4 и $20, быстрый режим (fast mode) — $16 и $80. Цифра «$8,40 за миллион», которая встречается в обзорах и ИИ-ответах, неверна: ставки две, и вывод в пять раз дороже ввода. Gemini 4 Carbon по странице цен Gemini API до 30 ноября 2026 года стоит $2 за ввод и $10 за вывод, попадание в кэш — $0,10; с 1 декабря — $4, $20 и $0,20. Кэширование у Carbon только неявное, поэтому платы за запись в кэш нет; Batch вдвое дешевле обычного режима, бесплатного уровня нет.
Цена задачи считается так: входные токены × цена ввода + выходные токены × цена вывода, и у обеих моделей размышления оплачиваются как вывод. Carbon в поле usage ответа отдельно показывает токены размышлений, Fable — нет, поэтому сравнивать можно только общий вывод. А его Carbon выдаёт намного больше: на семи задачах по коду из теста ниже — 34 088 выходных токенов против 13 720 у Fable на умолчании API, в 2,48 раза. Умножьте 2,48 на соотношение цен вывода, 1/4 сейчас и 1/2 с декабря, и получите примерно 0,62 и 1,24 — почти ровно то, что показал тест, потому что входных токенов в этих задачах мало. Отсюда правило: преимущество Carbon за токен съедается в той мере, в какой он размышляет дольше, и с 1 декабря для этого хватает вдвое большего объёма вывода.
Тест 11–18 ноября 2026 года: одинаковые задачи, все прошли, Carbon втрое дольше
На одинаковых запросах обе модели прошли всё, а различались ценой и временем. Запросы отправлялись через шлюз laozhang.ai одним ключом, в родном формате API каждого производителя: Anthropic Messages для Fable, generateContent для Carbon; каждый ответ вернул запрошенную модель (claude-fable-5-2 и gemini-4-carbon). Fable работала на умолчании API, то есть на effort high без явного параметра, и на medium, а в смешанном наборе ещё и на low; Carbon — на своём умолчании, уровне мышления medium. Код проверялся скрытыми тестами, остальные ответы — теми же проверками для обеих моделей.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
Семь задач по коду — объединение интервалов, разбор длительностей, частые слова, вычислитель выражений (25 скрытых тестов), разбор строки CSV (16), сравнение версий semver (30) и диапазоны версий в стиле npm (36). Пять задач Carbon решал 11 ноября, две последние — 16 ноября; Fable решала их 11 и 18 ноября. Смешанный набор из 11 ответов прогнан 11 ноября: задача на расчёт цены, три небольшие функции на Python, пересказ статьи на 6 723 слова в пяти пунктах, вычислитель выражений, разбор CSV и задача на подсчёт, причём последние три — дважды.
| Набор и конфигурация | Прошло | Выходных токенов | Время, с | Цена до 30 ноября | Цена с 1 декабря |
|---|---|---|---|---|---|
7 задач по коду · Fable 5.2, умолчание API (high) | 7/7 | 13 720 | 140,1 | $0,5659 | $0,5659 |
7 задач по коду · Fable 5.2 medium | 7/7 | 8 406 | 91,7 | $0,3534 | $0,3534 |
7 задач по коду · Carbon, умолчание (medium) | 7/7 | 34 088 | 459,1 | $0,3442 | $0,6884 |
11 ответов · Fable 5.2, умолчание API (high) | 11/11 | 15 151 | 173,2 | $0,7436 | $0,7436 |
11 ответов · Fable 5.2 medium | 11/11 | 9 317 | 122,3 | $0,5103 | $0,5103 |
11 ответов · Fable 5.2 low | 11/11 | 7 063 | 96,8 | $0,4201 | $0,4201 |
11 ответов · Carbon, умолчание (medium) | 11/11 | 26 826 | 405,4 | $0,2937 | $0,5874 |
На коде Carbon по умолчанию сейчас стоит 0,61 от Fable на умолчании и 0,97 от Fable medium, а с 1 декабря — 1,22 и 1,95; по времени он медленнее в 3,28 и 5,01 раза. В смешанном наборе, где есть длинный пересказ и, значит, больше входных токенов, Carbon дешевле: 0,39, 0,58 и 0,70 от Fable на умолчании, medium и low сейчас, и 0,79, 1,15 и 1,40 с декабря, при времени в 2,34, 3,31 и 4,19 раза больше. Если сравнивать с той настройкой Fable, которая уже проходит ваши проверки, то есть с medium, а не с умолчанием API, в декабре Carbon дороже в обоих наборах.
Стоимость здесь посчитана по прейскуранту из полей usage в ответах, а не по счёту; время включает сеть. На каждую ячейку приходится один прогон, а небольшие задачи с чёткой спецификацией не разделяют модели по способностям: обе с ними справляются, и разница видна только в цене и времени.
Где Carbon теряет деньги: две трудные задачи дали 91 % его расходов
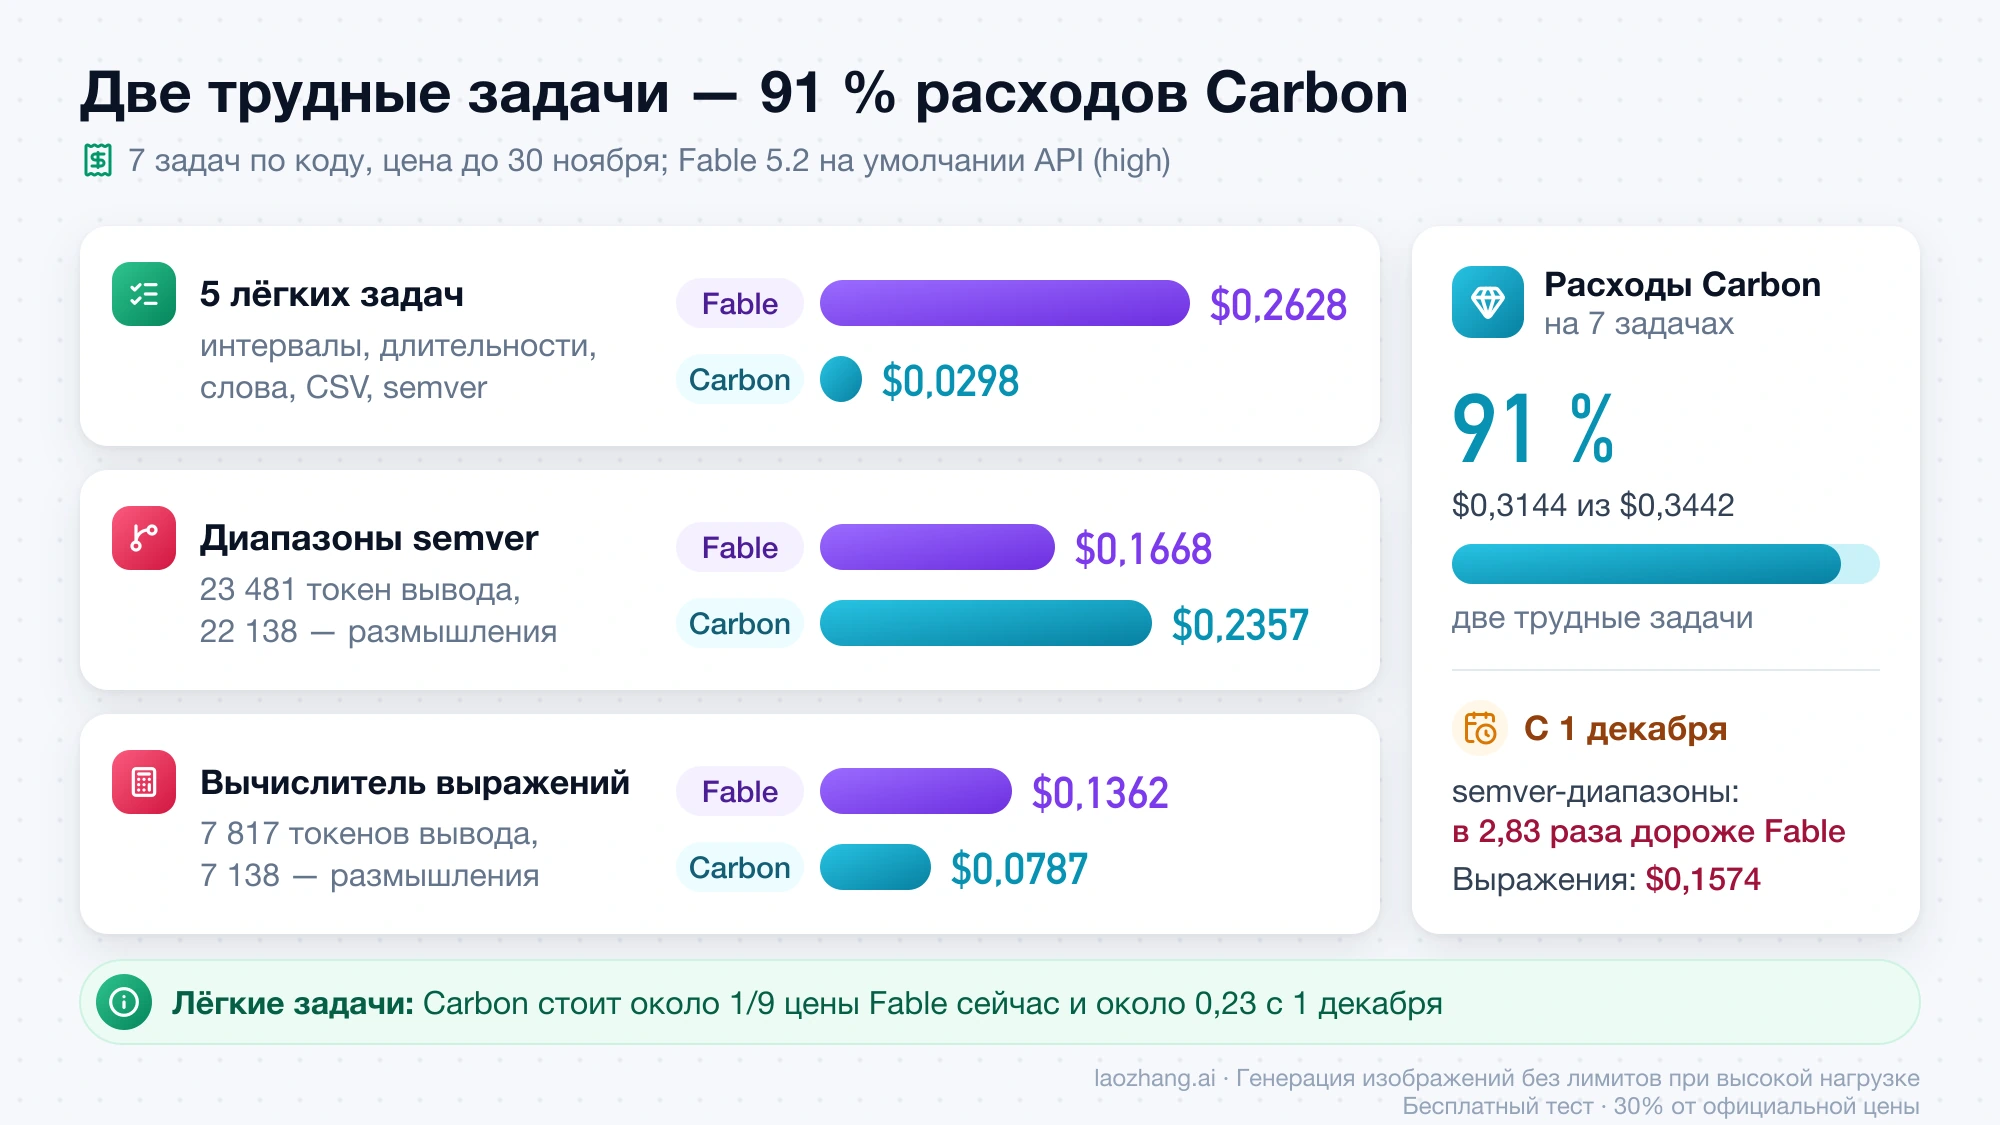
Расходы Carbon сосредоточены на трудных задачах, а на простых он почти ничего не стоит. На пяти лёгких задачах из семи (интервалы, длительности, частые слова, CSV, сравнение semver) в четырёх случаях он не размышлял вовсе, и вместе они обошлись в $0,0298 против $0,2628 у Fable на умолчании API — около 1/9 сейчас и около 0,23 с 1 декабря. На диапазонах версий semver картина обратная: Carbon выдал 23 481 выходной токен, из них 22 138 — размышления, думал 284,0 секунды и стоил $0,2357, а Fable на умолчании решила ту же задачу за 4 036 токенов, 37,0 секунды и $0,1668, на medium — за 2 209 токенов, 20,1 секунды и $0,0938. То есть даже по ноябрьской цене Carbon здесь в 1,41 раза дороже Fable на умолчании, а с декабря будет в 2,83 раза.
Вычислитель выражений устроен так же, только мягче: 7 817 выходных токенов у Carbon (7 138 размышлений) и $0,0787 против $0,1362 у Fable на умолчании и $0,0890 на medium; с декабря Carbon будет стоить $0,1574, дороже обеих. Вместе эти две задачи дали $0,3144 из $0,3442, то есть 91 % расходов Carbon на всём наборе. Google сама описывает Carbon как модель, которая тратит на каждый ход больше токенов размышлений, чтобы всё проверить, и поэтому дороже и медленнее Argon за ход (что нового в Gemini 4 Carbon). Для бюджета это значит: чем больше среди ваших запросов трудных, тем меньше экономии от Carbon.
Объём размышлений у Carbon заметно гуляет от вызова к вызову. Сравнение semver 16 ноября прошло без размышлений за 5,4 секунды и $0,0076, а 18 ноября тот же запрос дал 1 414 токенов размышлений, 38,9 секунды и $0,0216 — в 2,8 раза дороже, хотя оба ответа прошли тесты. На вопрос о двух несуществующих функциях стандартной библиотеки Python Carbon 16 ноября, не размышляя, описал выдуманную statistics.winsorized_mean как настоящую, а 18 ноября ответил, что обеих функций нет; Fable 5.2 18 ноября на умолчании и на medium сразу сказала, что их нет. Два прогона — не доля выдуманных ответов; более крупный замер такого рода — тест AA-Omniscience, где у Fable 67 баллов, у Carbon 54.
Лог на 146 КБ: Carbon дешевле и в декабре, но на high ответа не дал
На длинном входе Carbon выгоднее и после подорожания, потому что там счёт делают входные токены, а ввод у Carbon дешевле в обоих периодах. 11 ноября 2026 года обе модели через тот же шлюз считали события в логе приложения на 146 КБ и 1 500 строк, ответом были семь чисел. Текст лога обе модели разбивают на токены почти одинаково (78 537 и 79 312 входных), а у Fable на ввод пришлось $0,63 из $1,02.
| Конфигурация | Результат | Выходных токенов | Время, с | Цена до 30 ноября | Цена с 1 декабря |
|---|---|---|---|---|---|
Fable 5.2, умолчание API (high) | все 7 чисел верны | 9 792 | 73,7 | $1,0200 | $1,0200 |
Fable 5.2 medium | все верны | 8 156 | 63,5 | $0,9545 | $0,9545 |
Carbon, умолчание (medium) | все верны | 26 952 | 213,9 | $0,4281 | $0,8562 |
Carbon high, обычный запрос | ответа нет, MAX_TOKENS | 32 768 | 276,9 | $0,4863 | $0,9726 |
Carbon high, потоковый, maxOutputTokens 65 536 | ответа нет, MAX_TOKENS | 65 536 | 507,6 | $0,8140 | $1,6280 |
Carbon по умолчанию обошёлся в 0,42 цены Fable на умолчании сейчас и в 0,84 с декабря, против Fable medium — в 0,90 с декабря, но ждать ответа пришлось в 2,9 раза дольше. На уровне high Carbon не ответил ни разу: в обычном запросе он остановился на 32 765 токенах размышлений с причиной MAX_TOKENS, а в потоковом с лимитом 65 536 выходных токенов израсходовал 65 533 на размышления и снова не выдал текста. Оба неудачных вызова оплачиваются полностью, и по декабрьской цене второй стоил бы $1,63 — больше верного ответа любой конфигурации Fable. Это один прогон на конфигурацию и это про бюджет размышлений на таком входе, а не общий предел модели. Практический вывод: на длинных входах держите Carbon на medium, проверяйте причину завершения MAX_TOKENS и помните, что окно 1 048 576 токенов у Carbon общее для входа, размышлений и вывода.
Пары уровней Artificial Analysis: Fable дешевле на low и medium
В индексе Artificial Analysis (Intelligence Index v5.0.1, девять оценок) по состоянию на 18 ноября 2026 года Fable на low и medium дешевле Carbon того же уровня, а Carbon дешевле только на high. Важно, что AA сейчас считает Carbon по цене до 30 ноября, $2 и $10, а Fable — по $8 и $40. Колонка с декабрьской ценой — диапазон, а не замер: нижняя граница — цифра, которую AA показывала 11 ноября 2026 года, когда считала Carbon по ценам $4 и $20, верхняя — сегодняшняя цифра AA, умноженная на два при неизменном расходе токенов.
| Уровень | Fable 5.2: балл / $ за задачу / минут | Carbon: балл / $ за задачу / минут | Carbon с 1 декабря, диапазон |
|---|---|---|---|
low | 54 / $3,10 / 5,3 | 54 / $5,22 / 29,6 | $7,19–$10,44 |
medium | 56 / $3,80 / 6,4 | 58 / $4,68 / 29,3 | $6,59–$9,36 |
high | 62 / $9,08 / 14,8 | 60 / $5,48 / 33,2 | $7,76–$10,96 |
Единственная пара с одинаковым баллом — low: там Fable дешевле в 1,7 раза уже сейчас и быстрее в 5,6 раза. На medium Carbon на 2 балла выше, но дороже и в 4,6 раза медленнее. На high Carbon дешевле ($5,48 против $9,08), хотя на 2 балла ниже и в 2,2 раза медленнее, и это единственная пара, где исход в декабре не очевиден. 11 ноября AA считала Carbon по цене $4 и $20 и показывала на high $7,76 за задачу, а к 18 ноября перешла на текущую цену и показывает $5,48; удвоение даёт $10,96, а не $7,76, то есть между этими чтениями AA изменила и замер расхода токенов. Поэтому декабрьская цена Carbon high лежит где-то между $7,76 и $10,96 — около Fable high с её $9,08. На low и medium Fable дешевле при любой из двух оценок: даже нижние границы, $7,19 и $6,59, выше её $3,10 и $3,80. Выше по уровням у Fable есть xhigh (62 балла, $14,83, 23,8 минуты) и max (65 баллов, $26,54, 40,7 минуты); 65 — лучший результат обеих моделей в индексе, но стоит он почти впятеро дороже Carbon high.
Какая модель лучше для кода: Fable 5.2, если задачи трудные
Для трудного кода и длинных агентских цепочек сильнее Fable 5.2, а на простых задачах с чёткой спецификацией модели равны и решает цена. В оценках Artificial Analysis на 18 ноября 2026 года Fable впереди в FrontierCode-AA 2.0 (49,1 % против 40,6 % на лучших уровнях обеих) и в инженерном разделе индекса (73 против 65). В таблице Anthropic к выходу Fable 5.2 разрыв похожий: FrontierSWE v2 — 69,9 % против 61,2 %, FrontierCode 2.0 — 49,1 % против 41,1 %, но там Fable стоит на xhigh, а Carbon на medium, и это замеры самого производителя. В тесте на семи задачах выше обе модели прошли всё, так что разница проявилась только в том, что трудные задачи Carbon решал дороже и дольше.
Сторонний замер уровнем выше — King Bench 4 от MindStudio (12 ноября 2026 года), шесть сборок целых приложений в агентской среде. Там Fable набрала 70 % против 53,3 % у Carbon, а каждая итоговая сводка Carbon утверждала, что работает хотя бы одна функция, которая на деле не работала. Зато пять из шести сборок у Carbon заняли 34–44 минуты против 60–95 у Fable, а шесть сборок по прейскуранту стоили около $203 против около $222 по подсчёту MindStudio; учтите, что цену Fable там записали неверно, как единые $8,40, так что денежное сравнение приблизительное. Для агентов, которые сами отчитываются о результате, это важнее разницы в цене: сводку Carbon придётся проверять тестами. Как Carbon выглядит против других моделей на коде, разобрано в статьях «Gemini 4 Carbon vs GPT-6.1 Sol для кода: тест и цена с 1 декабря» и «Gemini 4 Carbon vs Opus 5.5: Carbon выше в индексе, Opus — в коде».
Где Gemini 4 Carbon сильнее: терминал, автоматизация, видео и аудио
Carbon опережает Fable в работе в терминале, в автоматизации и в разборе документов, но с небольшим отрывом. У Artificial Analysis на 18 ноября 2026 года Carbon high набирает в Terminal-Bench 4.0 65,2 % против 61,6 % у Fable xhigh, в AutomationBench-AA — 77,8 % против 76,4 %, а в GDP.pdf Carbon medium — 29,6 % против 24,2 %. Даже в таблице Anthropic Carbon впереди в AutomationBench: 53,9 % против 51,4 %. Отрыв от 1,4 до 5,4 процентного пункта в одной тестовой среде — повод проверить Carbon на своих сценариях автоматизации, а не основание переводить на него всё.
Второе преимущество — что модель принимает на вход. Carbon работает с текстом, изображениями, видео, аудио и PDF, а Fable 5.2 — с текстом, изображениями и PDF-документами, но без аудио и видео, так что для видео и аудио выбора нет. Контекст у обеих около миллиона токенов, но у Carbon окно в 1 048 576 токенов общее для входа, размышлений и вывода. В одном синхронном ответе Fable выдаёт до 128 000 токенов, Carbon — до 65 536, зато в фоновом режиме длинного вывода (long decode) Carbon может выдать до 1 048 576. Знания у Fable доходят до июня 2026 года, у Carbon — до марта 2026 года.
В остальных оценках Artificial Analysis впереди Fable: AA-Briefcase (Elo 1785 против 1611), AA-Omniscience (67 против 54), HLE-Diamond (80,2 % против 69,1 %), CritPt v2 hard (76,5 % против 69,0 %) и Terminal-Bench-Science (73,3 % против 64,8 %). Сама Google советует брать Carbon для поиска первопричин сложных ошибок, проектирования архитектуры, плотного разбора мультимодальных материалов, научных доказательств и аудита безопасности, а для большинства задач разработки оставляет Argon. Стоит ли менять Argon на Carbon, разобрано в статье «Gemini 4 Carbon vs Argon: где Carbon сильнее и цена задачи».
Насколько Carbon медленнее: в 2,2–5,6 раза по времени задачи
Carbon медленнее Fable на всех уровнях, потому что дольше размышляет и медленнее выдаёт токены. По Artificial Analysis на 18 ноября 2026 года задача индекса на medium занимает у Fable 6,4 минуты, у Carbon 29,3, на high — 14,8 и 33,2; Fable выдаёт 110–113 токенов в секунду, Carbon 49–62, а первый токен ответа на medium приходит через 9,87 и 27,41 секунды. В тесте через шлюз Carbon по умолчанию был медленнее в 2,3–5 раз в зависимости от набора и настройки Fable, причём сильнее всего отставал от Fable medium на коде. Обратный результат есть только у MindStudio: в агентской сборке целого приложения Carbon обычно укладывался в 34–44 минуты (пять сборок из шести) против 60–95 у Fable. Если пользователь ждёт ответа в интерфейсе, это может решить выбор раньше цены.
Русский текст: у Fable 5.2 на 51 % больше входных токенов
Один и тот же русский абзац с однострочной инструкцией Fable 5.2 посчитала как 336 входных токенов, Carbon — как 223, в 1,51 раза меньше (Fable замерена 18 ноября, Carbon 11 ноября 2026 года, через тот же шлюз). Для сравнения: на английском отношение 1,27, на японском 1,60, на испанском 1,68, на корейском 1,94; на английской статье в 6 723 слова — 1,38, а на логе приложения разницы почти нет, 0,99. Поэтому ввод русского текста на Fable дороже, чем следует из цен: 336 × $8 против 223 × $2 даёт примерно в 6,0 раза сейчас, а против 223 × $4 — в 3,0 раза с декабря, а не в 4 и 2. Если ваш вход — русские документы, переписка или длинные инструкции, это дополнительный довод за Carbon на задачах с тяжёлым входом; для выходных токенов по языкам такой замер не делался, там расход зависит прежде всего от задачи.
Какую модель и какой уровень выбрать под тип работы
С декабря стартовая точка для кода и агентов — Fable 5.2 на medium, а Carbon стоит оставить для задач с тяжёлым входом и для видео и аудио. Учтите, что «по умолчанию» у Fable означает разное: запрос в Claude API без параметра effort идёт на high, а Claude Code и приложения Claude используют medium; в API уровень задаётся параметром output_config.effort. У Carbon уровень мышления по умолчанию — medium, доступны low, medium и high.
| Тип работы | С чего начать | Почему | Когда менять |
|---|---|---|---|
| Много лёгких запросов, время ответа не критично | Carbon, medium | На пяти простых задачах теста он стоил около 1/9 цены Fable сейчас и около 0,23 с декабря | Если важна задержка или предсказуемый счёт — Fable low или medium |
| Трудный код, долгие агентские цепочки | Fable 5.2, medium | В тесте прошла всё, на трудной задаче Carbon дороже уже в ноябре; Fable выше в FrontierCode и King Bench 4 | Не проходят проверки — high; xhigh и max только когда high не справляется |
| Длинный вход: логи, документы, русские тексты | Carbon, medium | Ввод дешевле в обоих периодах, и на логе 146 КБ Carbon остался дешевле Fable после подорожания | Не ставьте high; если ответ нужен быстрее чем за 3–4 минуты — Fable |
| Терминал и автоматизация | Обе на своих сценариях | Carbon впереди на 1,4–3,6 пункта в Terminal-Bench 4.0 и AutomationBench | Решите по стоимости принятого результата на своих задачах |
| Видео и аудио на входе | Carbon | Fable принимает текст, изображения и PDF, но не аудио и видео | Для PDF подходят обе модели |
Перед переходом прогоните обе модели на десятке своих задач с автоматической проверкой и сравните стоимость принятого результата, а не счёт за токены: в тесте выше одна трудная задача из семи решила, кто дешевле.
Что помешает перейти: хранение данных, тариф, страна и фильтры
У каждой модели есть условия, которые блокируют переход независимо от качества. Fable 5.2 в Claude API работает только с 30-дневным хранением данных, и организации с нулевым хранением (zero data retention) получают ошибку 400, если доступ им отдельно не открыт. Защитные классификаторы отказывают в задачах по кибербезопасности высокого риска — тестировании на проникновение, создании эксплойтов, работе с уязвимостями в бинарных файлах — и в большинстве исследовательских задач по биологии; на такие запросы отвечают Opus 4.8 или Opus 5. Принудительный выбор инструмента (tool_choice со значением any или tool) возвращает 400, а лимиты запросов у Fable свои и ниже, чем у Opus 5.5. В подписках Claude модель есть на всех платных тарифах, кроме Free: на Max и Ultra и премиальных местах она входит в подписку в пределах 50 % недельного лимита, а на Pro и стандартных местах Team оплачивается кредитами использования с первого запроса (неделя запуска, когда Fable входила в лимит Pro и Team, закончилась 16 ноября 2026 года).
Gemini 4 Carbon (идентификатор gemini-4-carbon, общий доступ с 10 ноября 2026 года) доступен только на платном уровне Gemini API, бесплатного уровня у него нет, а в Google AI Studio он требует тарифа AI Ultra. В приложение Gemini и Google Antigravity модель постепенно приходит для подписчиков Google AI Ultra; сколько запросов к Carbon входит в Ultra, Google не публикует. Россия и Беларусь не входят в список стран Gemini API, и это ограничение всего API, а не только Carbon. Для защитников есть отдельная версия Gemini 4 Carbon for cyber по списку допуска. Где и кому Carbon доступен, подробнее в статье «Gemini 4 Carbon когда выйдет: уже вышла 10 ноября, кому доступна».
Частые вопросы о Claude Fable 5.2 и Gemini 4 Carbon
Насколько хорош Gemini 4 Carbon?
Google называет Carbon своей самой способной моделью рассуждений, но в паре с Fable он не первый: в индексе Artificial Analysis Carbon high набирает 60 баллов против 65 у Fable 5.2 на max, а сама Google для большинства задач разработки рекомендует Argon. Где Carbon оправдывает свою цену, разобрано в статье «Gemini 4 Carbon vs Argon: где Carbon сильнее и цена задачи».
Какая модель лучше Fable 5.2?
Ни один уровень Gemini 4 Carbon в индексе Artificial Analysis на 18 ноября 2026 года не набирает больше Fable 5.2 на max, хотя в Terminal-Bench 4.0 и AutomationBench Carbon немного впереди. Чаще вопрос стоит иначе: какая модель не хуже, но дешевле или быстрее для вашей работы. Сравнения с другими моделями — в статьях «Claude Fable 5.2 или Opus 5.5: что выбрать и на каком effort» и «Fable 5.2 или GPT-6 Astra и GPT-6.2 Astra: что дешевле за задачу».
Можно ли выключить размышления у Fable 5.2, как уровни у Carbon?
Нет. У Fable 5.2 адаптивное мышление включено всегда, и effort (low, medium, high, xhigh, max) меняет только его глубину; самый экономный вариант — low. У Carbon три уровня мышления, low, medium и high, по умолчанию medium, и даже на medium он на простых задачах иногда не размышляет совсем, а на трудных уходит в десятки тысяч токенов.
Как получить доступ к API Fable 5.2?
Модель вызывается по идентификатору claude-fable-5-2 в Claude API, вышла 9 ноября 2026 года и стоит $8 за ввод и $40 за вывод за 1 млн токенов. Как получить ключ и отправить первый запрос, описано в статье «Claude Fable 5.2 API: как получить доступ, ключ и первый запрос».
Источники4
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 18 нояб. 2026 г..
Источники4
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 18 нояб. 2026 г..