Gemini 4 Carbon vs GPT-6.1 Sol для кода: тест и цена с 1 декабря
До 30 ноября токены у обеих стоят одинаково, но на семи задачах с кодом Carbon при том же результате обошлась в 7 раз дороже Sol, а с 1 декабря — в 14 раз.
Содержание
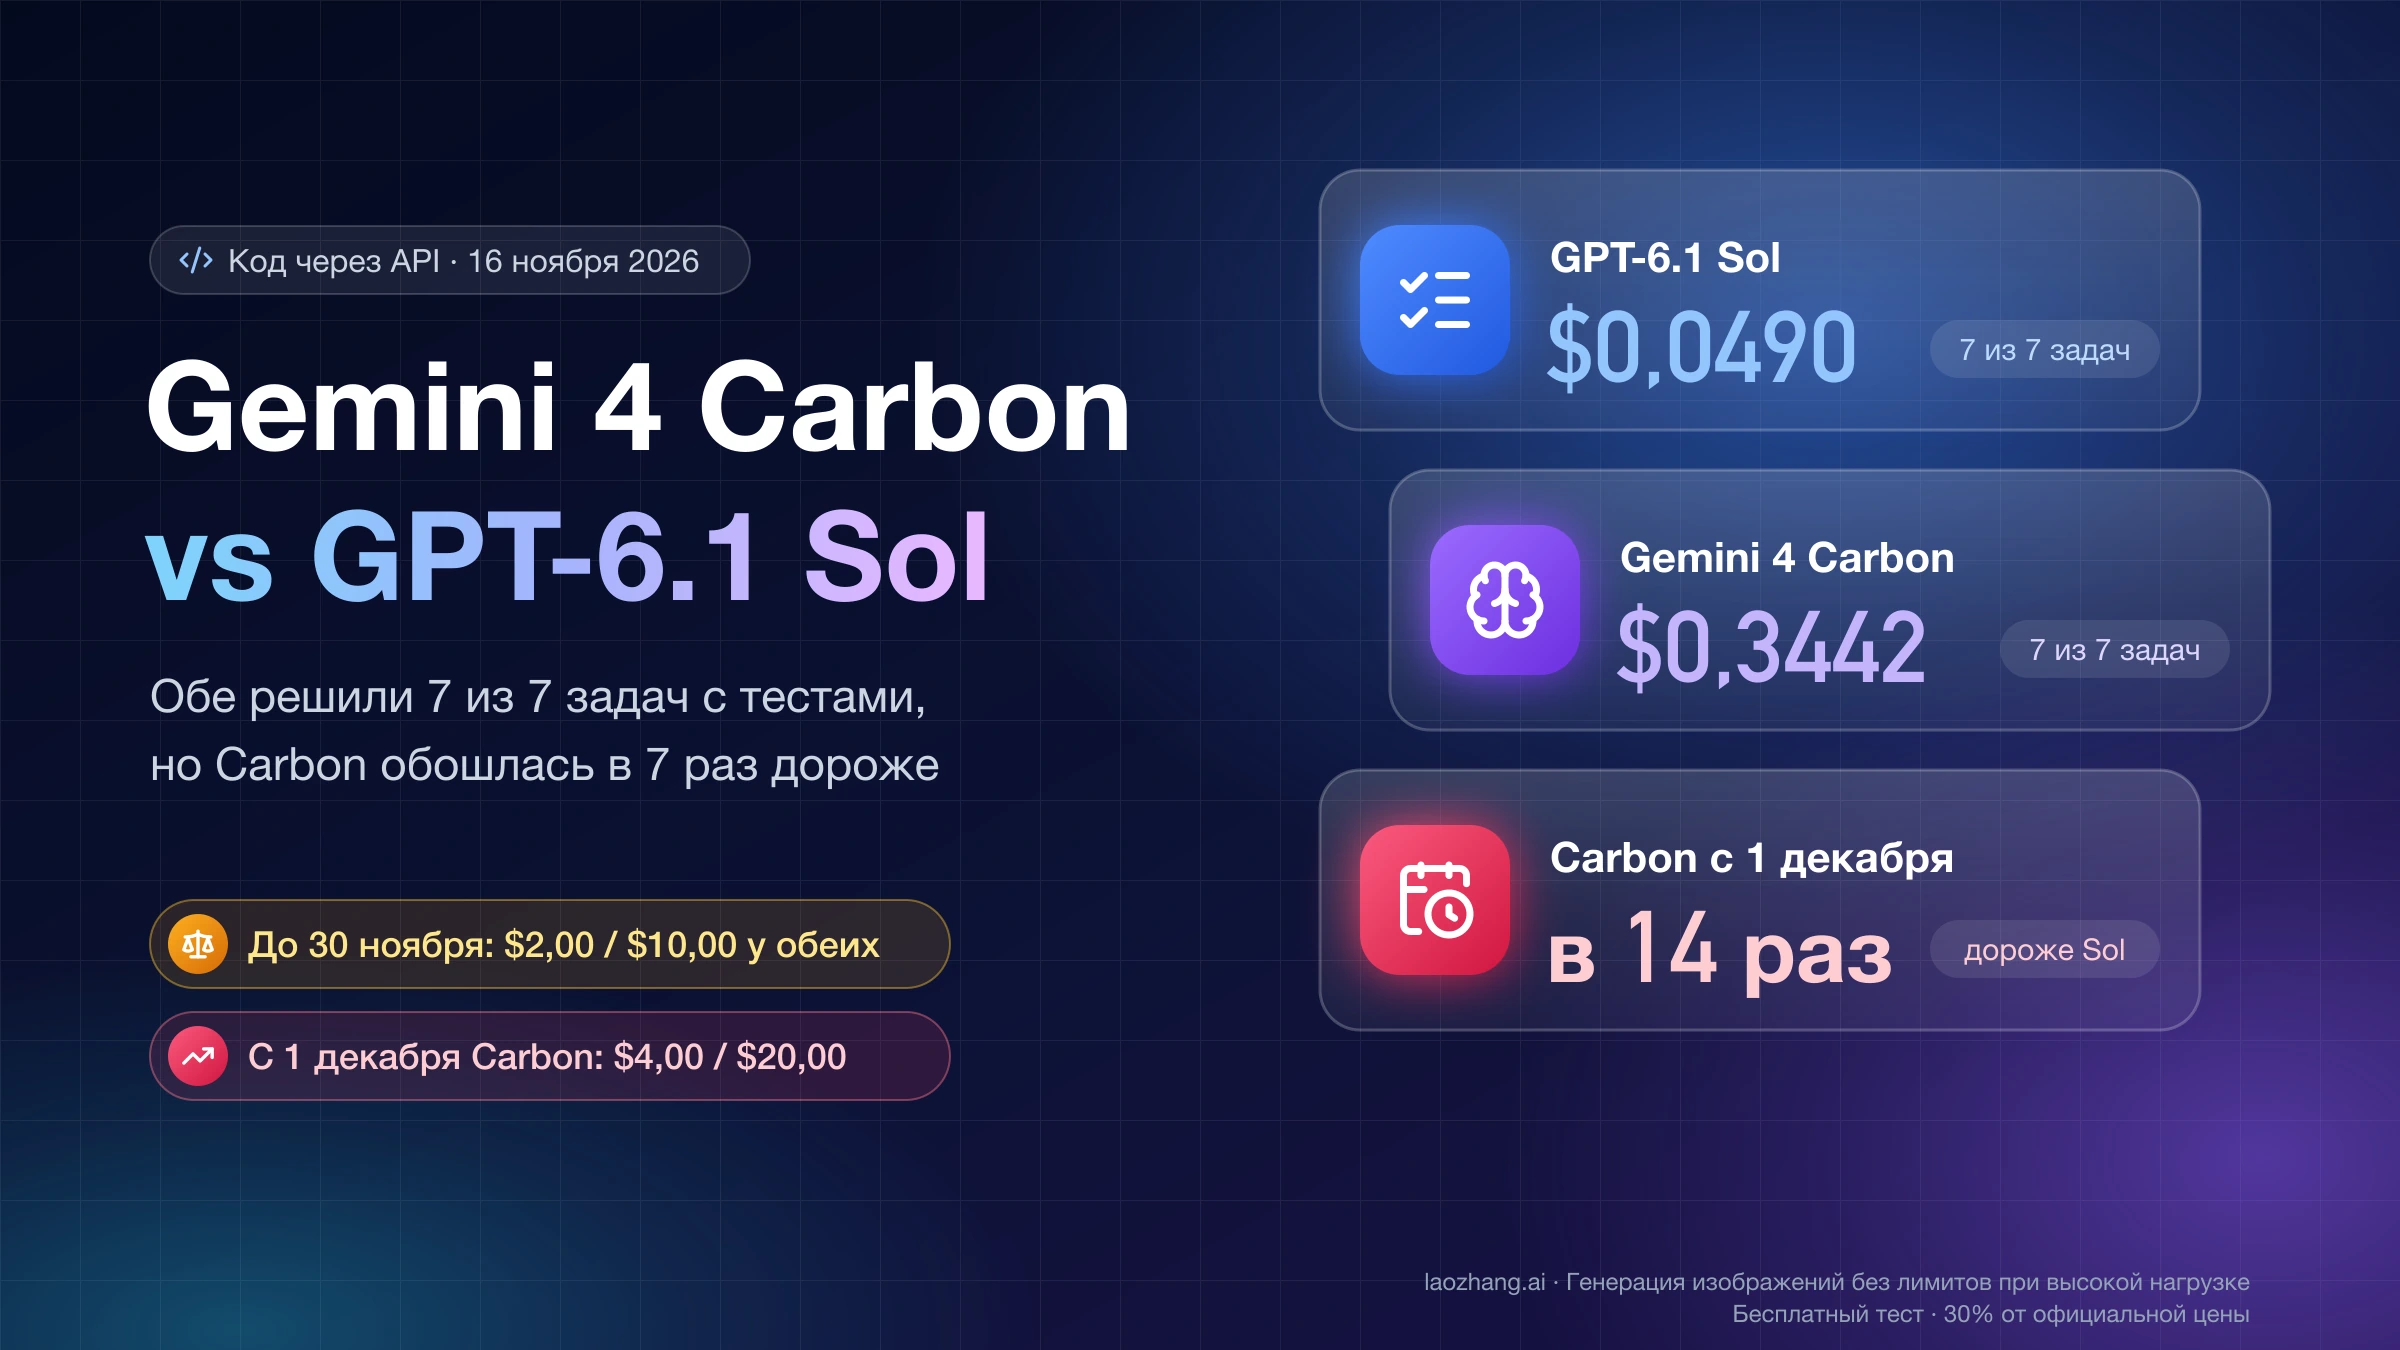
Если вы пишете код через API и решаете, переносить ли задачи с GPT-6.1 Sol на Gemini 4 Carbon, начните с gpt-6.1-sol на уровне рассуждений по умолчанию (medium), а gemini-4-carbon ставьте первой там, где её лидерство в рейтингах действительно проявляется, — в долгих агентских задачах в терминале. На небольших чётко заданных задачах разницы в результате нет. В тесте через шлюз LaoZhang (Sol — 28 октября, Carbon — 11 и 16 ноября 2026 года) обе модели на уровне по умолчанию прошли все скрытые тесты в семи задачах, но Carbon потратила на них $0,3442 против $0,0490 у Sol, то есть в 7 раз больше, и работала в 3,4 раза дольше, потому что тратила гораздо больше токенов на рассуждения.
Цена за токен сейчас у обеих одна — $2,00 за 1 млн входных и $10,00 за 1 млн выходных токенов, — но только до 30 ноября 2026 года. С 1 декабря Google поднимает цену Carbon вдвое, до $4,00 / $20,00, и те же семь задач на ней станут в 14 раз дороже, чем на Sol. Преимущество Carbon в рейтингах Artificial Analysis настоящее, но узкое: на 16 ноября 2026 года она заметно впереди в Terminal-Bench 4.0, а в FrontierCode-AA 2.0, где модели пишут трудный код, верхние уровни обеих набирают одинаковые 40,6 %, и задача индекса у Sol на max стоит $1,27 против $5,48 у Carbon на high.
Ответ меняют три условия. Если вход больше 272 000 токенов, Sol считает весь запрос по повышенному тарифу, а у Carbon такой надбавки нет, поэтому до 30 ноября на таких запросах дешевле Carbon. Если вы работаете не через API, а в агенте, сравниваются уже связки «модель + свой агент»: Carbon в Antigravity, Sol в Codex. И уровень high у Carbon не стоит включать по привычке: в тесте он сделал задачи в 6 раз дороже, а на длинном логе дважды упёрся в лимит вывода и не дал ответа.
Кто лучше в программировании: Sol для задач, Carbon для терминала
Для большинства кодовых задач через API первой стоит пробовать GPT-6.1 Sol на medium, а Gemini 4 Carbon — для агентской работы в командной строке, где она выигрывает в бенчмарках на любом своём уровне. На трудном алгоритмическом коде лидерства у Carbon нет, а на одном длинном логе (около 56 тыс. токенов по счёту Sol) в тесте быстрее и дешевле оказалась Sol. Таблица ниже — стартовая точка на 16 ноября 2026 года; данные для каждой строки разобраны в следующих разделах.
| Задача | С чего начать | На чём основано |
|---|---|---|
| Функции и исправления по ясной спецификации, задачи с тестами | gpt-6.1-sol, medium | В тесте обе модели решили всё, Sol дешевле и быстрее |
| Трудный алгоритмический код | Sol xhigh или max; Carbon high — как второй кандидат | В FrontierCode-AA 2.0 верхние уровни равны, задача у Sol в 4,3 раза дешевле |
| Долгие агентские задачи в терминале: окружение, сборка, скрипты | gemini-4-carbon, medium или high | В Terminal-Bench 4.0 любой уровень Carbon выше Sol на max |
| Разбор лога на десятки тысяч токенов | Sol medium | На одном логе в 146 КБ обе ответили верно, Sol быстрее и дешевле; это один прогон |
| Вход больше 272 000 токенов | До 30 ноября — Carbon; после — сравнить на своей нагрузке | Sol доплачивает за весь запрос, с декабря у Carbon дороже вывод |
| Работа в IDE, где важен быстрый первый ответ | Sol medium или low | Первый токен у Sol medium через 4,8 с, у Carbon medium — через 20,9 с |
Если работа смешанная, не обязательно выбирать одну модель на всё. Разумная схема — Sol по умолчанию и Carbon для отобранных агентских задач в терминале, где её больший расход окупается результатом.
Тест на одних задачах: обе решили 7 из 7, Carbon в 7 раз дороже
Обе модели получили одинаковые по тексту задачи с одними и теми же скрытыми тестами, и на семи задачах с кодом обе на уровне по умолчанию прошли всё; различались только расход токенов, деньги и время. Задачи маленькие и чётко заданные, поэтому тест показывает не «кто умнее», а сколько стоит и сколько ждать одинаковый правильный результат.
Условия такие. Все вызовы шли через шлюз LaoZhang: GPT-6.1 Sol 28 октября 2026 года через POST /v1/chat/completions, Gemini 4 Carbon 11 ноября 2026 года через нативный generateContent Gemini, а три задачи для Carbon (два задания на semver и вопрос по стандартной библиотеке) добавлены 16 ноября 2026 года. Без системного промпта, без инструментов, один ход, по одному прогону на каждую ячейку. «По умолчанию» значит, что уровень не передавался: у Sol это medium, у Carbon тоже medium. Ответы вернули модели gpt-6.1-sol-2026-09-29 и gemini-4-carbon. Стоимость посчитана по возвращённым счётчикам токенов и ценам до 30 ноября, это оценка, а не счёт.
| Задача | Sol: стоимость, время | Carbon: стоимость, время | Рассуждения Carbon, токенов |
|---|---|---|---|
| Слияние интервалов | $0,0062, 17,2 с | $0,0055, 8,6 с | 0 |
| Разбор строки длительности | $0,0033, 10,5 с | $0,0111, 50,7 с | 771 |
| Топ-k частых слов | $0,0017, 6,7 с | $0,0017, 23,7 с | 0 |
| Вычисление выражения | $0,0102, 26,2 с | $0,0787, 78,0 с | 7 138 |
| Разбор строки CSV | $0,0039, 11,5 с | $0,0039, 8,7 с | 0 |
| Сравнение версий semver (30 тестов) | $0,0074, 16,8 с | $0,0076, 5,4 с | 0 |
| Диапазоны semver в стиле npm (36 тестов) | $0,0163, 45,0 с | $0,2357, 284,0 с | 22 138 |
| Всего, 7 из 7 у обеих | $0,0490, 133,9 с | $0,3442, 459,1 с | 30 047 |
Почти вся разница набирается на двух задачах. На диапазонах semver Carbon рассуждала 22 138 токенов и думала 284 с против 45 с у Sol, а на вычислении выражения потратила $0,0787 против $0,0102. На четырёх из пяти остальных задач стоимость отличается не больше чем на 15 %, а на трёх из четырёх задач, где Carbon вовсе не рассуждала, она ответила даже быстрее Sol. Отсюда главный вывод для бюджета: Carbon по умолчанию тратит на рассуждения от 0 до 22 138 токенов на задачу, поэтому итоговая кратность зависит от того, сколько в вашем наборе задач, где она «задумывается». Без двух задач на semver, на пяти остальных, кратность была 4,00 вместо 7,02.
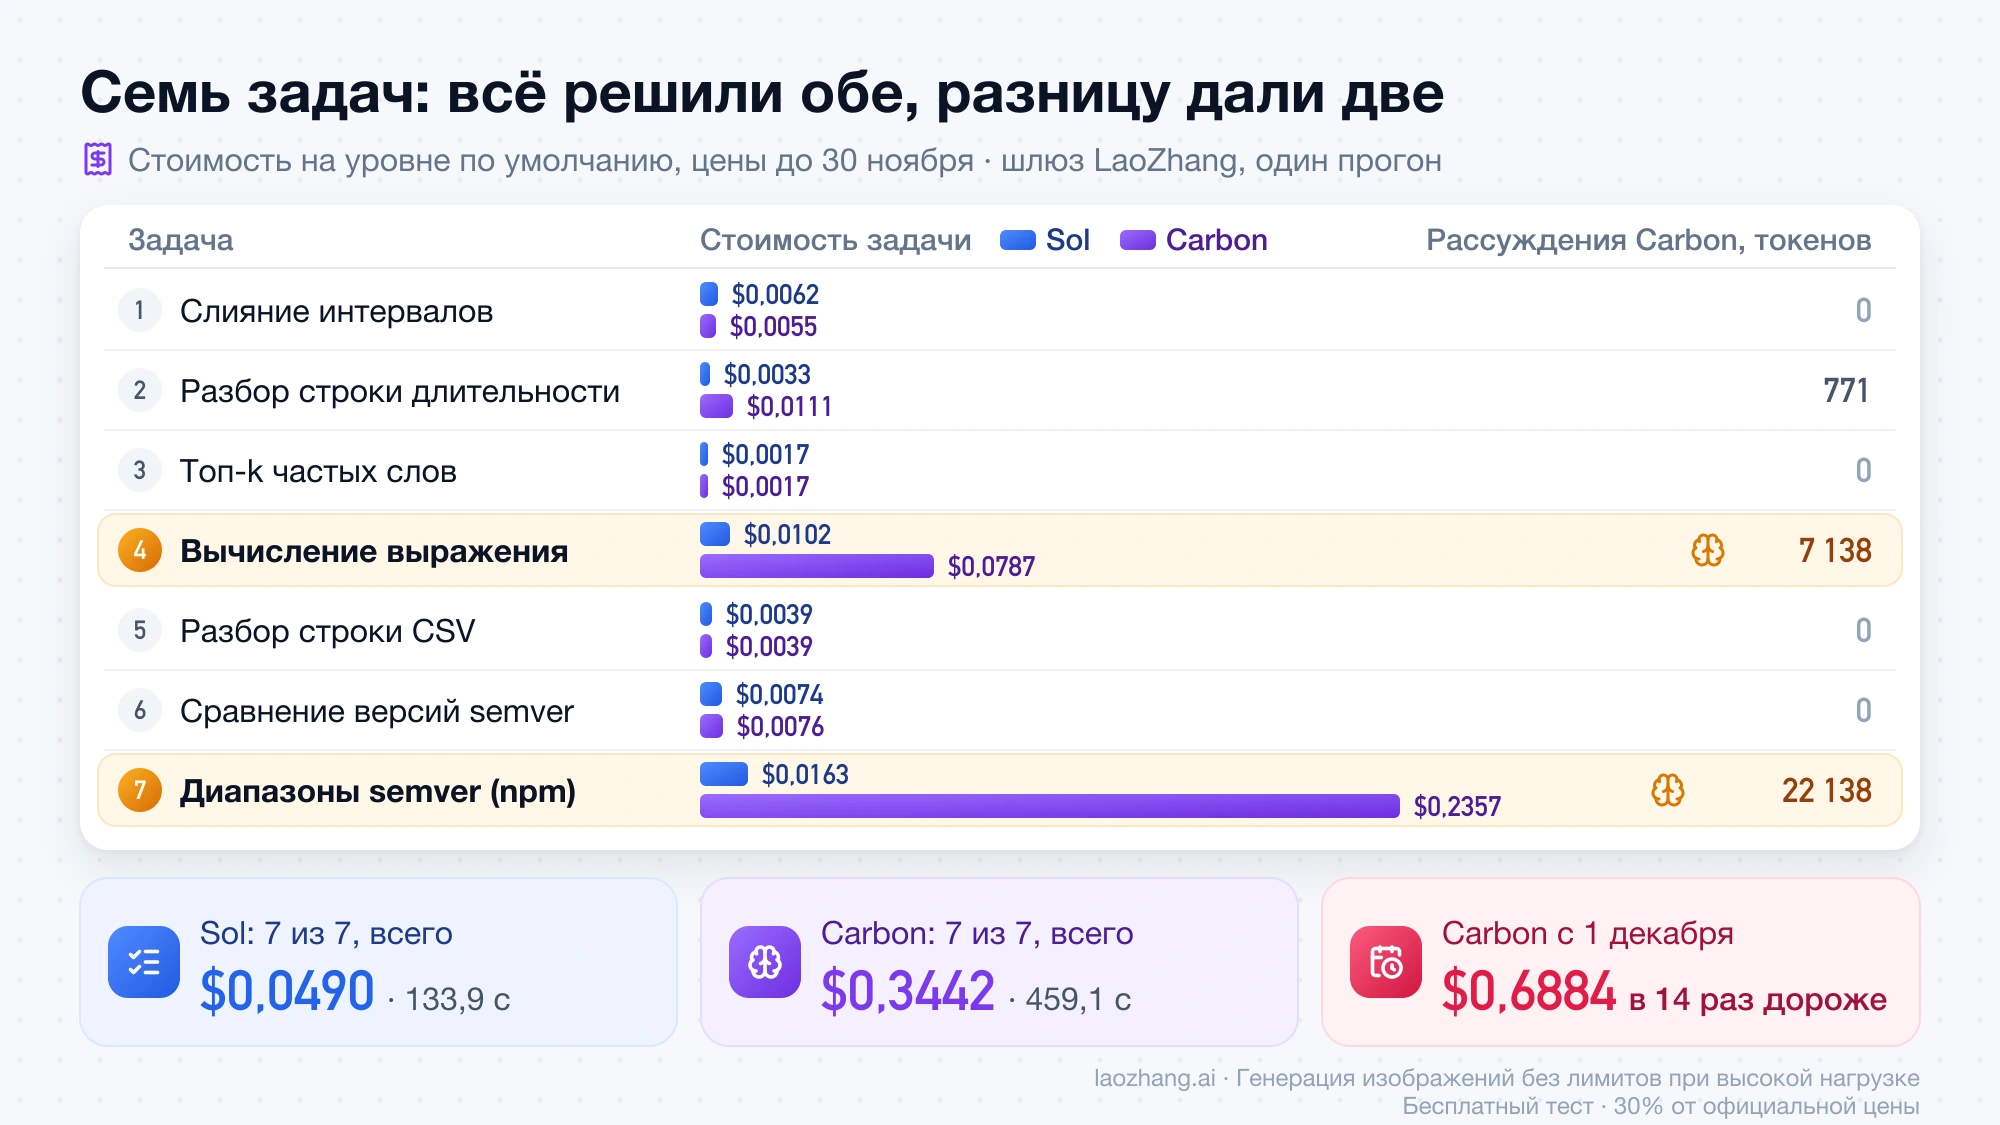
Пересчитать любую строку просто: стоимость = входные токены × цена ввода + выходные токены (включая рассуждения) × цена вывода. На диапазонах semver Carbon вывела 23 481 токен, и 23 481 × $10,00 / 1 млн ≈ $0,2348 — почти вся сумма $0,2357 приходится на вывод.
Повышение уровня этой картины не меняет. Sol на high решила те же семь задач за $0,0859 и 237,9 с — всё равно в 4 раза дешевле и почти вдвое быстрее, чем Carbon по умолчанию. Carbon на high прогоняли на пяти задачах (без двух на semver): $0,6121 и 614,5 с против $0,0387 и 109,5 с у Sol на high, то есть в 15,8 раза дороже и в 5,6 раза дольше, а выходных токенов — в 16,4 раза больше.
В тот же набор входили ещё четыре задачи: текстовая задача на арифметику, подсчёт по сумме цифр, пересказ текста на 6 723 слова в пять пунктов и вопрос о четырёх функциях стандартной библиотеки CPython 3.13, две из которых выдуманы. Первые три обе модели решили на обоих уровнях. В вопросе с выдуманными функциями Sol 28 октября на обоих уровнях ответила, что их не существует. Carbon по умолчанию 16 ноября правильно отвергла functools.memoize_method, но для несуществующей statistics.winsorized_mean выдала описание («It returns the arithmetic mean of a data set after replacing…»), причём в этом ответе не было ни одного токена рассуждений, и он занял 5,2 с. Это один прогон, а не свойство модели: в тесте фактических знаний AA-Omniscience v1.1 у Artificial Analysis Carbon на high набирает 54 и на medium 47 против 38–42 у Sol на разных уровнях. Практический вывод скромнее: имена функций, которые модель предлагает без поиска, проверяйте по документации или тестами. Всего по 11 задачам Sol решила 11 из 11 за $0,0897 и 182,1 с, Carbon по умолчанию — 10 из 11 за $0,4421 и 574,8 с, в 4,93 раза дороже.
Пользователи X, запускавшие одну и ту же задачу на обеих моделях, описывают то же направление, хотя это одиночные прогоны на генерации 3D-сцен без автоматической проверки. По сообщению notjazii, на максимальном уровне рассуждений у Sol задача заняла 30 минут и 5,3 млн токенов (около $1,4), у Carbon — 40 минут и 6,2 млн токенов (около $2,9). У EnvolDev на задаче «Cathedral of Ice» Carbon потратила $8,83 и 2 ч 39 мин 10 с, Sol — $3,11 и 54 мин 19 с.
Чтобы проверить выбор на своей работе, возьмите 5–10 реальных задач с автоматической проверкой, прогоните каждую на обеих моделях с уровнем по умолчанию, запишите, прошли ли тесты, сколько выходных токенов (вместе с рассуждениями) и секунд ушло, и посчитайте стоимость по формуле выше, умножив цены Carbon на два для периода с 1 декабря. Запускать можно напрямую, через платный уровень Gemini API и OpenAI API, или через шлюз: на 16 ноября 2026 года список моделей LaoZhang (GET https://api.laozhang.ai/v1/models) содержит и gemini-4-carbon, и gpt-6.1-sol, так что обе вызываются одним ключом, как в этом тесте.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
Где Carbon впереди в бенчмарках Artificial Analysis, а где нет
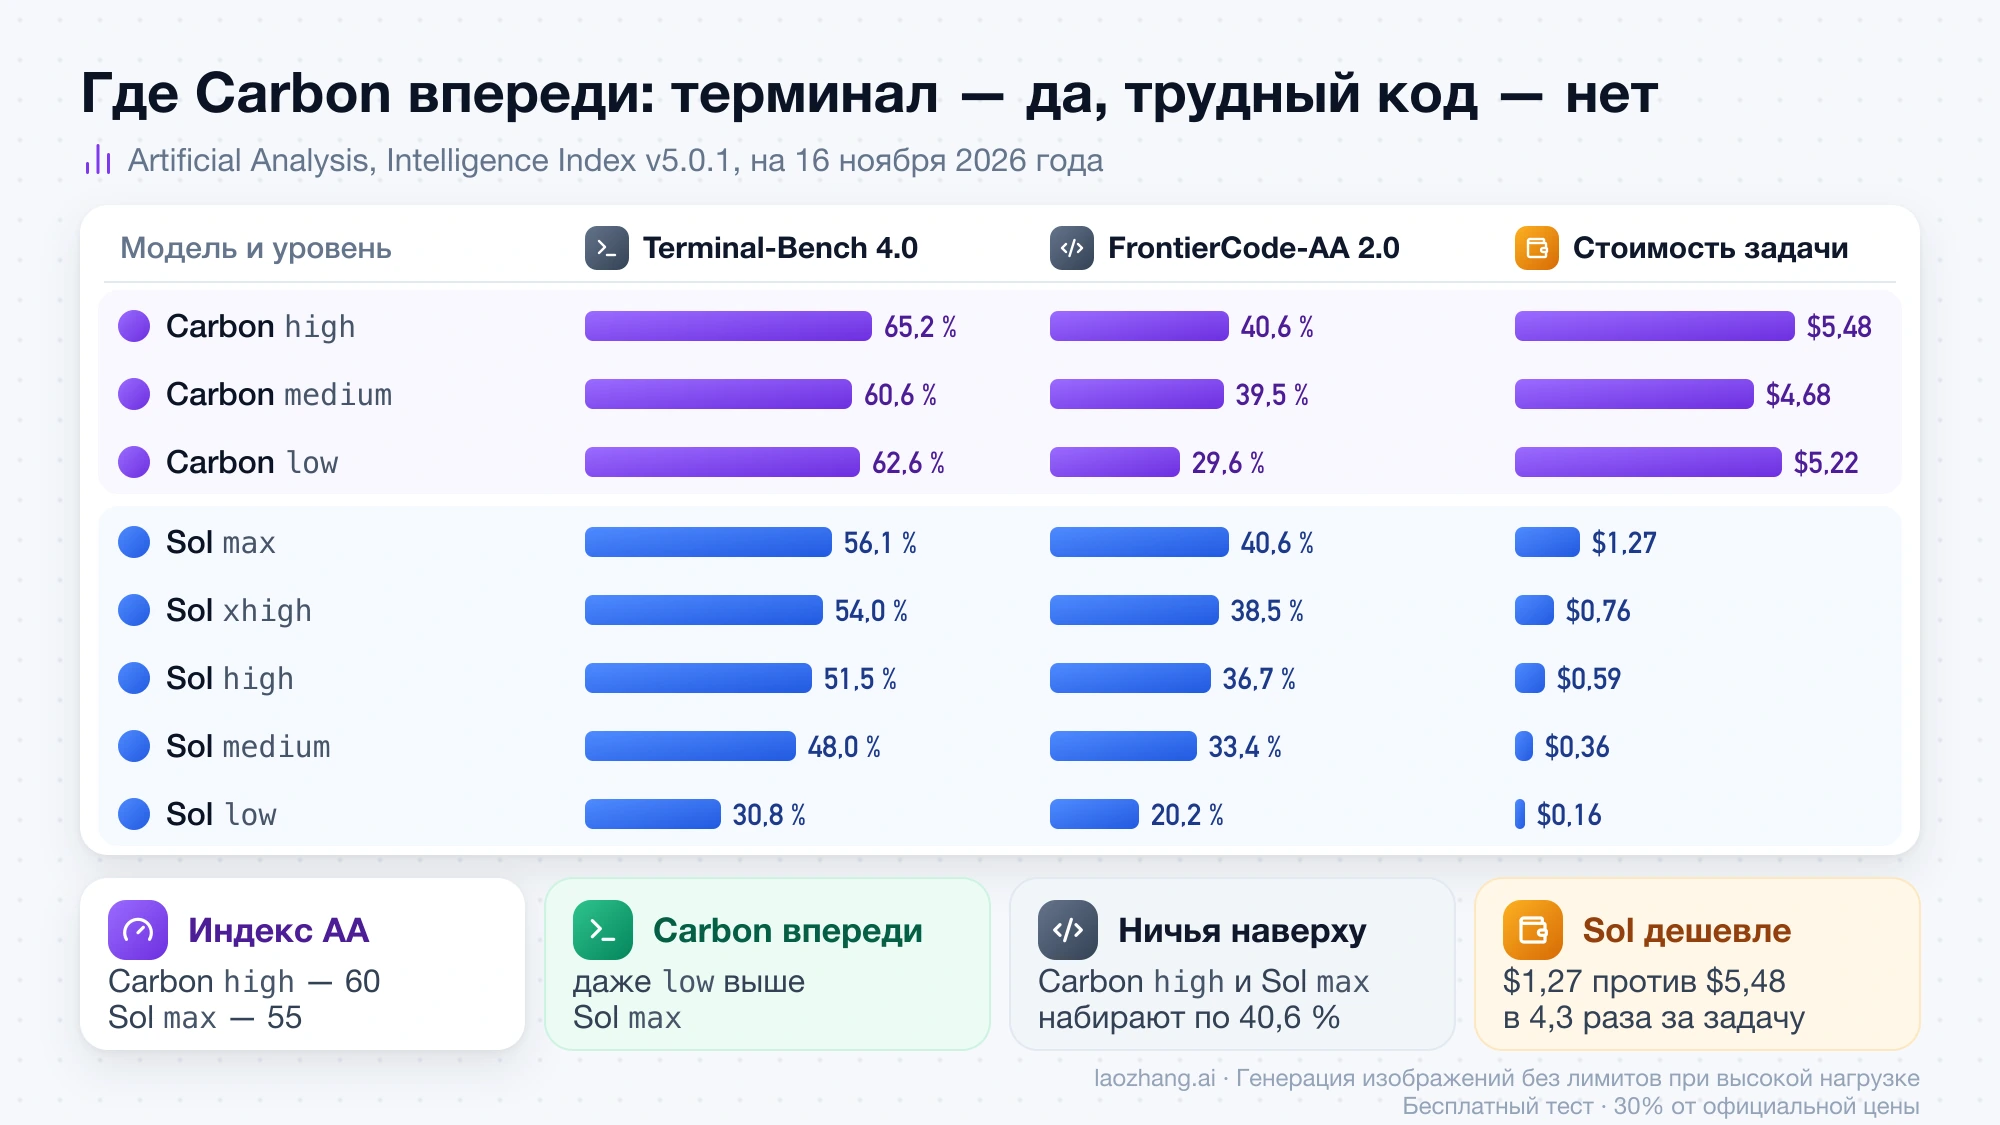
Carbon лидирует в индексе Artificial Analysis и в терминальных бенчмарках, но не в написании трудного кода, и за каждую задачу индекса платит в несколько раз больше Sol. Так выглядит сравнение Gemini 4 Carbon и GPT-6.1 Sol по всем уровням у Artificial Analysis по Intelligence Index v5.0.1 на 16 ноября 2026 года; обе модели AA считает по $2 за ввод и $10 за вывод.
| Модель и уровень | Intelligence Index | Terminal-Bench 4.0 | FrontierCode-AA 2.0 | Engineering | Стоимость задачи | Время задачи |
|---|---|---|---|---|---|---|
Carbon high | 60 | 65,2 % | 40,6 % | 65 | $5,48 | 32,1 мин |
Carbon medium | 58 | 60,6 % | 39,5 % | 64 | $4,68 | 28,0 мин |
Carbon low | 54 | 62,6 % | 29,6 % | 60 | $5,22 | 25,9 мин |
Sol max | 55 | 56,1 % | 40,6 % | 59 | $1,27 | 22,7 мин |
Sol xhigh | 52 | 54,0 % | 38,5 % | 57 | $0,76 | 9,8 мин |
Sol high | 50 | 51,5 % | 36,7 % | 55 | $0,59 | 7,6 мин |
Sol medium | 46 | 48,0 % | 33,4 % | 52 | $0,36 | 4,4 мин |
Sol low | 35 | 30,8 % | 20,2 % | 43 | $0,16 | 1,9 мин |
Явное преимущество Carbon — задачи агента в терминале. В Terminal-Bench 4.0 даже Carbon на low (62,6 %) выше Sol на max (56,1 %), и так же устроен научный Terminal-Bench-Science 0.1: 64,8 / 62,4 / 61,9 % у Carbon против 58,1 / 50,5 / 46,2 / 37,1 / 11,0 % у Sol от max до low. Если ваши задачи — это настройка окружения, сборка, отладка через команды и скрипты, Carbon стоит проверить первой.
В FrontierCode-AA 2.0, где модель пишет трудный код, преимущества нет: Carbon на high и Sol на max набирают одинаковые 40,6 %, а Carbon на low с 29,6 % отстаёт даже от Sol на medium (33,4 %). По баллу индекса ближайшая к Sol max (55) конфигурация — Carbon low (54), и её задача стоит $5,22 против $1,27, в 4,1 раза дороже, и идёт дольше: 25,9 против 22,7 минуты. Поэтому фраза «Carbon в коде сильнее и точнее» верна для общего балла и для терминальных задач, но не для всякого кода.
Время у Carbon уходит ещё до ответа. Первый токен ответа Carbon выдаёт через 10,90 с на low, 20,89 с на medium и 73,49 с на high; у Sol это 3,01 с на low, 4,81 с на medium, 32,56 с на high, 68,00 с на xhigh и 166,70 с на max.
Если вы видели у Carbon другие цены задач, это не ошибка: 11 ноября 2026 года AA показывала $7,76 / $6,59 / $7,19 для high / medium / low, а к 16 ноября пересчитала их до значений в таблице. Все цифры AA посчитаны по ноябрьской цене Carbon.
Одинаковая ли цена: только за токен и только до 30 ноября
Утверждение, что по стоимости Gemini 4 Carbon и GPT-6.1 Sol практически одинаковы, верно ровно для цены за токен и только до 30 ноября 2026 года. Расход на одну и ту же задачу у моделей разный уже сейчас, а с 1 декабря разной станет и цена токена. Ставки за 1 млн токенов в стандартном режиме — по странице цен Gemini API для Gemini 4 Carbon (платный уровень) и странице модели GPT-6.1 Sol в документации OpenAI API на 16 ноября 2026 года.
| Период и размер входа | Carbon: ввод / вывод / кэш | Sol: ввод / вывод / кэш |
|---|---|---|
| До 30 ноября, вход до 272 000 токенов | $2,00 / $10,00 / $0,10 | $2,00 / $10,00 / $0,10 |
| До 30 ноября, вход больше 272 000 токенов | $2,00 / $10,00 / $0,10 | $4,00 / $15,00 / $0,20 |
| С 1 декабря, вход до 272 000 токенов | $4,00 / $20,00 / $0,20 | $2,00 / $10,00 / $0,10 |
| С 1 декабря, вход больше 272 000 токенов | $4,00 / $20,00 / $0,20 | $4,00 / $15,00 / $0,20 |
Токены рассуждений у обеих моделей оплачиваются как вывод, поэтому одинаковая ставка не означает одинаковый счёт: в тесте выше Carbon на семи задачах вывела в 7,4 раза больше токенов, чем Sol. С 1 декабря тот же набор стоит на Carbon $0,6884 против прежних $0,0490 у Sol — в 14 раз больше, а все 11 задач — $0,8842 против $0,0897, в 9,9 раза. По индексу Artificial Analysis удвоение цены при той же доле кэша даёт около $10,96 / $9,36 / $10,44 за задачу Carbon на high / medium / low (расчёт: текущая цифра AA × 2), тогда как у Sol на max остаётся $1,27.
Прочие строки прайса соотношение почти не меняют. Batch у обеих моделей вдвое дешевле стандартного режима, у Sol есть ещё Flex за полцены, Fast вдвое дороже и Ultrafast вшестеро дороже. У Sol отдельно оплачивается запись в кэш ($2,50 за 1 млн), у Carbon кэширование только неявное. Бесплатного уровня у Carbon в Gemini API нет.
Внутри Codex и Antigravity: что сравнивает Coding Agent Index
Если вы пишете код не через API, а в агенте, рейтинг сравнивает не две модели, а два продукта: Carbon в Antigravity CLI и Sol в Codex. В Coding Agent Index v2.1 у Artificial Analysis на 16 ноября 2026 года связка Antigravity CLI + Gemini 4 Carbon (high) набирает 55,5 балла при $7,13 и 33,6 минуты на задачу, а Codex + GPT-6.1 Sol (max) — 52,2 балла при $1,51 и 21,9 минуты. Строки, где Carbon работает в Codex или Sol в Antigravity, нет, поэтому отделить вклад модели от вклада агента по этому рейтингу нельзя, а Sol в нём представлена только на max.
Индекс складывается из трёх наборов с равным весом: 132 задачи FrontierCode-AA 2.0, 66 задач Terminal-Bench 4.1 и 124 задачи SWE-Atlas-QnA-AA, каждая по три попытки. Разбивка повторяет картину из бенчмарков модели: в Terminal-Bench связка с Carbon прошла 129 попыток из 198 против 107 у Sol, а в FrontierCode — 166 из 396 против 183. При этом связка с Carbon делает в среднем 186 шагов на задачу против 43 у Sol, а задача у неё в 4,7 раза дороже и в 1,5 раза дольше. Строка Sol есть в данных страницы, но не среди восьми столбцов, которые показываются по умолчанию.
Для работы в агенте отсюда следует то же правило, что и для API: на терминальных задачах Carbon в Antigravity даёт больше решённого, но за заметно большие деньги и время, а на написании кода Sol в Codex не уступает. Учтите и условия доступа. В приложении Gemini и в Antigravity Carbon доступна только с подпиской Google AI Ultra, а её лимиты не опубликованы; подробности о тарифах — в материале «Gemini 4 Carbon когда выйдет: уже вышла 10 ноября, кому доступна». У Sol в Codex и ChatGPT Work контекст по умолчанию 500 000 токенов, и в пределах подписки надбавки за длинный контекст нет. Если вы собираете собственного агента через API, у Sol вызов инструментов работает только через Responses API, а Carbon поддерживает вызов функций, выполнение кода, управление компьютером и обоснование ответов поиском Google (Google Search grounding).
Большой лог или весь репозиторий: тест на 146 КБ и порог 272K
На одном длинном логе в тесте обе модели ответили верно, но Sol справилась в 4,7 раза быстрее и в 2,6 раза дешевле. Обеим дали один и тот же лог приложения на 1 500 строк (146 КБ) и один вопрос из семи чисел: сколько раз встретился каждый из пяти кодов ошибок, сколько разных пользователей получили E503 и у какого запроса больше всего повторов. Carbon прогоняли через шлюз LaoZhang 11 ноября 2026 года, Sol — 16 ноября 2026 года, по одному прогону на ячейку.
| Конфигурация | Ответ | Время | Вывод (из них рассуждения) | Стоимость |
|---|---|---|---|---|
| Sol по умолчанию | Все 7 чисел верны | 45,7 с | 2 576 (2 527) | $0,1654 |
Sol high | Все 7 чисел верны | 87,7 с | 5 866 (5 817) | $0,1983 |
| Carbon по умолчанию | Все 7 чисел верны | 213,9 с | 26 952 (26 867) | $0,4281 |
Carbon high, лимит вывода не задан | Нет ответа | 276,9 с | 32 768 (32 765) | $0,4863 |
Carbon high, потоковый вызов, maxOutputTokens 65 536 | Нет ответа | 507,6 с | 65 536 (65 533) | $0,8140 |
На уровне high Carbon оба раза израсходовала весь лимит вывода на рассуждения и остановилась с причиной MAX_TOKENS, так и не начав ответ, хотя деньги за эти токены списываются. Если вы даёте Carbon длинные входы, держите её на уровне по умолчанию: даже лимит синхронного вывода в 65 536 токенов на high целиком ушёл на рассуждения. С 1 декабря тот же прогон Carbon по умолчанию стоил бы $0,8563, в 5,2 раза дороже Sol. Стоимость Sol посчитана по ставке записи в кэш ($2,50 за 1 млн), потому что в ответе 55 840 входных токенов учтены как запись в кэш; по обычной ставке ввода было бы $0,1375.
Один и тот же лог Carbon посчитала как 79 312 входных токенов, а Sol — как 55 843, в 1,42 раза меньше, потому что у моделей разные токенизаторы. На этом тексте один и тот же файл у Carbon занимает больше окна и больше стоит на вводе; для кода соотношение может быть другим.
Порог 272 000 токенов тест не проверял, а именно он меняет цену у Sol. Если вы отправляете в модель весь репозиторий целиком и вход больше этого порога, Sol считает весь запрос по $4,00 за ввод и $15,00 за вывод, а Carbon до 30 ноября остаётся на $2,00 / $10,00. Поэтому совет брать для огромных репозиториев именно Sol ценой не подтверждается: до 30 ноября на таких запросах дешевле Carbon, а с 1 декабря ввод у обеих стоит $4,00, но вывод у Carbon дороже — $20,00 против $15,00. Контекст у обеих около миллиона токенов: у Carbon 1 048 576 на ввод и вывод вместе, у Sol 1 050 000. Максимальный вывод за один вызов у Carbon 65 536 токенов, у Sol — 128 000.
Какой уровень рассуждений ставить: Carbon medium, Sol medium или high
Начинайте обе модели с уровня по умолчанию, medium, а повышайте его только у Sol и только на трудных задачах: у Carbon повышение дорого стоит, а понижение почти ничего не экономит. Шкалы у моделей разные: у Carbon три уровня (low, medium, high), у Sol пять (low, medium, high, xhigh, max), и одинаковое название не означает одинаковой глубины рассуждений, поэтому сравнивать Carbon high и Sol high как «равный уровень» нельзя.
У Carbon уровень по умолчанию оказался и самым выгодным. У Artificial Analysis задача на medium стоит меньше, чем на low, а low к тому же теряет в FrontierCode-AA 2.0 десять пунктов, так что понижать его имеет смысл разве что ради более раннего первого токена. Повышение до high добавляет 2 балла индекса, но в тесте на пяти задачах сделало их в 6 раз дороже и в 3,6 раза дольше, чем на уровне по умолчанию, а на длинном логе оставило без ответа. Поэтому high у Carbon стоит включать только для трудных терминальных задач, где medium не проходит проверку.
У Sol шаг вверх обходится дешевле. В тесте high решил те же семь задач, что и medium, но на 75 % дороже и в 1,8 раза дольше, поэтому начинать стоит с medium и поднимать уровень, только если ваши проверки не проходят. Уровни xhigh и max нужны для самых трудных задач: именно на max Sol догоняет Carbon high в FrontierCode-AA 2.0, оставаясь в несколько раз дешевле за задачу индекса.
Главная особенность Carbon — непредсказуемый расход на уровне по умолчанию: в тесте она тратила на одну задачу от 0 до 22 138 токенов рассуждений, тогда как у Sol на medium все семь задач вместе заняли 1 655 токенов рассуждений. Если для вас важна предсказуемость счёта, это аргумент в пользу Sol даже при одинаковой цене токена.
Если Sol на нужном уровне работает слишком медленно, замеры по уровням и способы ускорить её собраны в материале «GPT-6.1 Sol медленно работает: замеры по effort и как ускорить».
Gemini 4 Carbon и GPT-6.1 Sol: другие вопросы о выборе для кода
Можно ли попробовать Gemini 4 Carbon бесплатно через API?
Нет. На 16 ноября 2026 года у gemini-4-carbon в Gemini API нет бесплатного уровня, модель доступна только на платном уровне, а Batch-режим стоит вдвое дешевле стандартного. Где ещё доступна Carbon и с какой даты, разобрано в материале «Gemini 4 Carbon когда выйдет: уже вышла 10 ноября, кому доступна».
Меняет ли Batch-режим соотношение цен Carbon и Sol?
Нет. В Batch обе модели стоят вдвое дешевле своих стандартных ставок, поэтому кратность на одной и той же задаче остаётся той же, что и в стандартном режиме: до 30 ноября её определяет только расход токенов, а с 1 декабря 2026 года у Carbon добавляется удвоение цены.
Если GPT-6.1 Sol слишком дорога, что взять вместо неё?
У OpenAI есть более дешёвая GPT-6.1 Terra; когда её хватает вместо Sol и на каком уровне, показано в материале «GPT-6.1 Terra vs Sol: в чем разница, цена задачи и тест в Codex». Сравнение Sol с Gemini 4 Argon и Claude Opus 5.5 — в статье «Gemini 4 Argon, Claude Opus 5.5 или GPT-6.1 Sol: что выбрать», а цены, доступ и переход на саму Sol — в материале «GPT-6.1 Sol: цена, доступ и что менять при переходе с GPT-6 Sol».
Источники4
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 16 нояб. 2026 г..
Источники4
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 16 нояб. 2026 г..
- 1.сравнение Gemini 4 Carbon и GPT-6.1 Sol по всем уровням у Artificial Analysisartificialanalysis.ai/models/releases/comparisons/gemini-4-carbon-vs-gpt-6-1-sol
- 2.странице цен Gemini API для Gemini 4 Carbonaistudio.google.com/docs/pricing
- 3.странице модели GPT-6.1 Sol в документации OpenAI APIdevelopers.openai.com/api/docs/models/gpt-6.1-sol
- 4.Coding Agent Index v2.1 у Artificial Analysisartificialanalysis.ai/agents/coding-agents