Gemini context caching: кэширование контекста, цены и тест
У Gemini 4 Argon только неявный кэш, у 3.8 Flash есть и явный: кэш на час выгоден от двух запросов. В тесте 30 октября 2026 года попадал каждый третий запрос.
Содержание
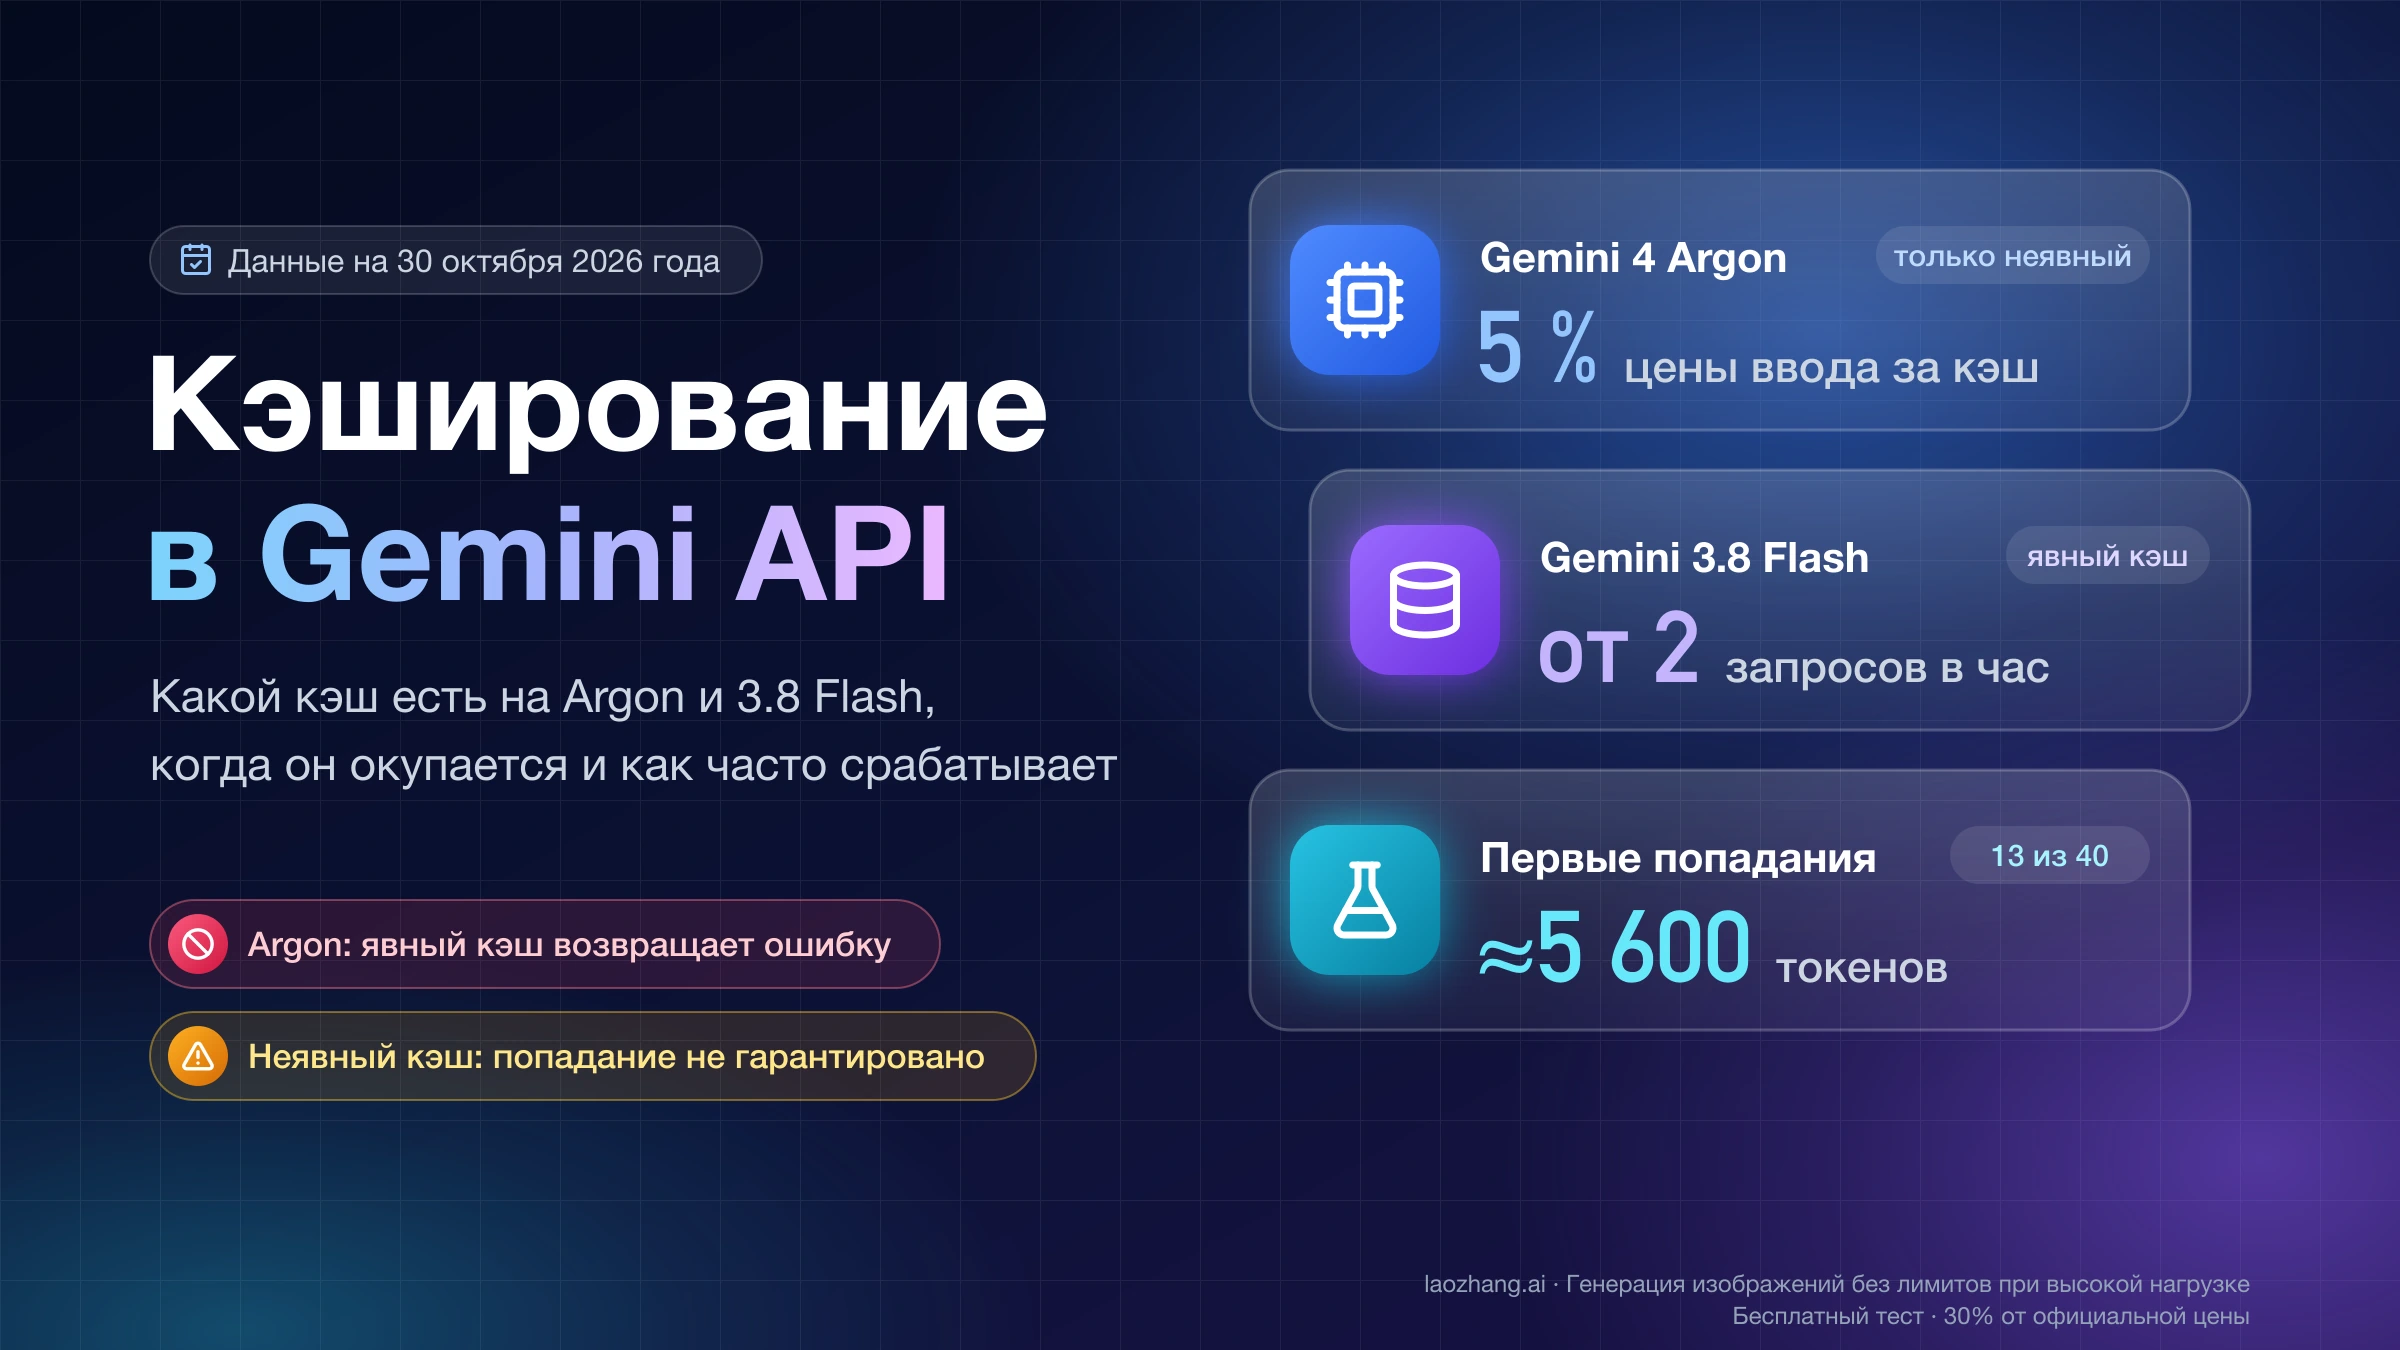
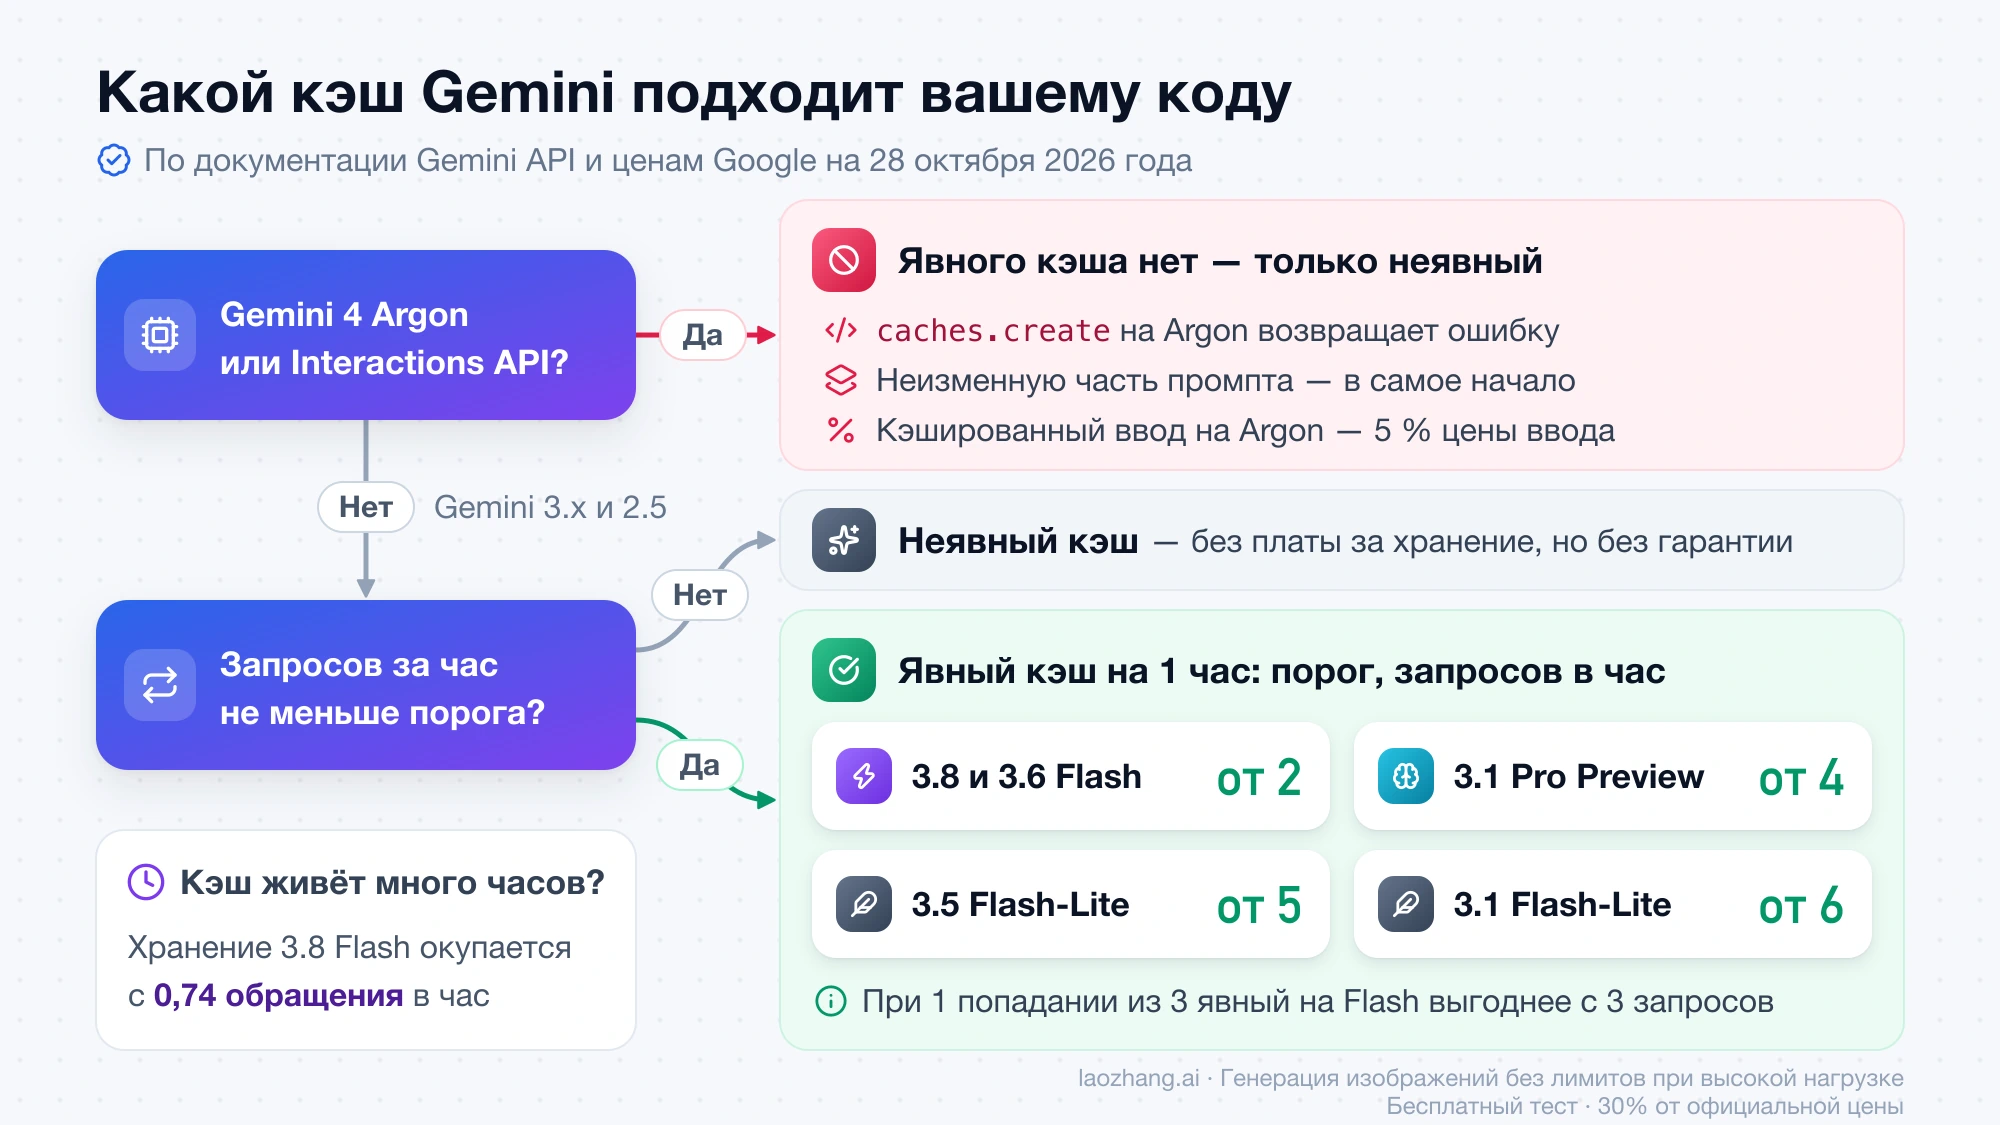
Gemini context caching (кэширование контекста) — это повторное использование уже обработанного начала запроса: если длинный системный промпт, документ или код совпадает с тем, что уже приходило, Google берёт эти токены из кэша и считает их по сниженной цене. По состоянию на 30 октября 2026 года механизмов два. Неявный кэш включён по умолчанию на всех моделях начиная с Gemini 2.5, за хранение не платят, но попадание не гарантировано. Явный кэш вы создаёте сами через caches.create и платите за его хранение по часам, зато скидка гарантирована. Явный кэш есть только на Gemini 3.x и 2.5 (3.8 Flash, 3.6 Flash, 3.1 Pro Preview, 3.5 Flash-Lite) и только в generateContent API: в Interactions API и на Gemini 4 Argon его нет.
Отсюда порядок действий. На Gemini 4 Argon уберите вызовы явного кэша, потому что они возвращают ошибку, и перенесите неизменную часть промпта в самое начало: кэшированный ввод там стоит 5 % от цены обычного. На 3.8 Flash явный кэш, созданный на час, дешевле работы без кэша начиная с двух запросов за этот час, а кэш, который держат много часов, окупает хранение уже при 0,74 обращения в час. Сработал ли кэш, видно по полю cachedContentTokenCount в usageMetadata ответа: при промахе этого поля нет совсем.
Обещанных 90–95 % экономии от неявного кэша на практике ждать не стоит. В тесте 30 октября 2026 года через шлюз LaoZhang запросы к gemini-3.8-flash с промптом от 5 605 токенов попали в кэш 13 раз из 40 (34 из них были одинаковыми до байта повторами, в 6 менялся только вопрос в конце). При попадании из кэша приходило 49–70 % промпта, и запрос дешевел по входу на 44–63 %; у gemini-4-argon из кэша пришло до 82 % промпта и экономия дошла до 78 %. Промпты короче примерно 5 600 токенов не попали ни разу, хотя ai.google.dev называет минимум 4 096.
Неявный и явный кэш Gemini: что доступно на вашей модели
Неявный кэш работает везде, начиная с Gemini 2.5, а явный зависит от модели и от API. По документации Gemini API от 23 октября 2026 года явный кэш (explicit caching) поддерживают модели Gemini 3 и 2.5, и только через generateContent; Interactions API, который Google сейчас рекомендует как основной, умеет только неявный кэш (implicit caching), как и Gemini 4 Argon «и более поздние версии». Явный кэш при этом всё ещё в статусе Beta: его методы находятся в v1beta.
| Модель | Неявный кэш, минимум по ai.google.dev | Минимум в документации Google Cloud | Явный кэш |
|---|---|---|---|
| Gemini 4 Argon | 4 096 токенов | 6 144 в гайде по Argon, 4 096 на странице модели | Нет, вызов возвращает ошибку |
| Gemini 3.8 Flash | 4 096 токенов | 6 144 для неявного кэша | Да, через generateContent |
| Gemini 3.6 Flash | 4 096 токенов | 4 096 | Да, через generateContent |
| Gemini 3.1 Pro Preview | 4 096 токенов | 6 144 для неявного кэша | Да, через generateContent |
| Gemini 3.5 Flash-Lite | Не указан | 4 096 | Да, через generateContent |
| Gemini 2.5 Flash и 2.5 Pro | 2 048 токенов | 2 048 | Да, через generateContent |
Минимумы в двух документациях не совпадают, и это не опечатка в таблице: подробнее о том, где на деле начинались попадания, — в разделе про 4 096 и 6 144 токенов ниже. Списки моделей для явного кэша взяты из обзора кэширования в Google Cloud и страницы цен Gemini API, где у этих моделей указана цена хранения кэша.
Если вы переносите код с 3.x на Argon, уберите client.caches.create и параметр cached_content из запросов: в руководстве по переходу на Gemini 4 Argon Google прямо пишет, что явный кэш там не поддерживается и возвращает ошибку. Вместо него неявный кэш включается сам для промптов от 4 096 токенов и даёт скидку 95 % на кэшированные токены. Ещё одна поломка, которая встречается при таком переходе, разобрана в статье Ошибка Gemini «Requests ending with a model turn»: как исправить.
Сколько стоит кэш Gemini и когда явный кэш окупается
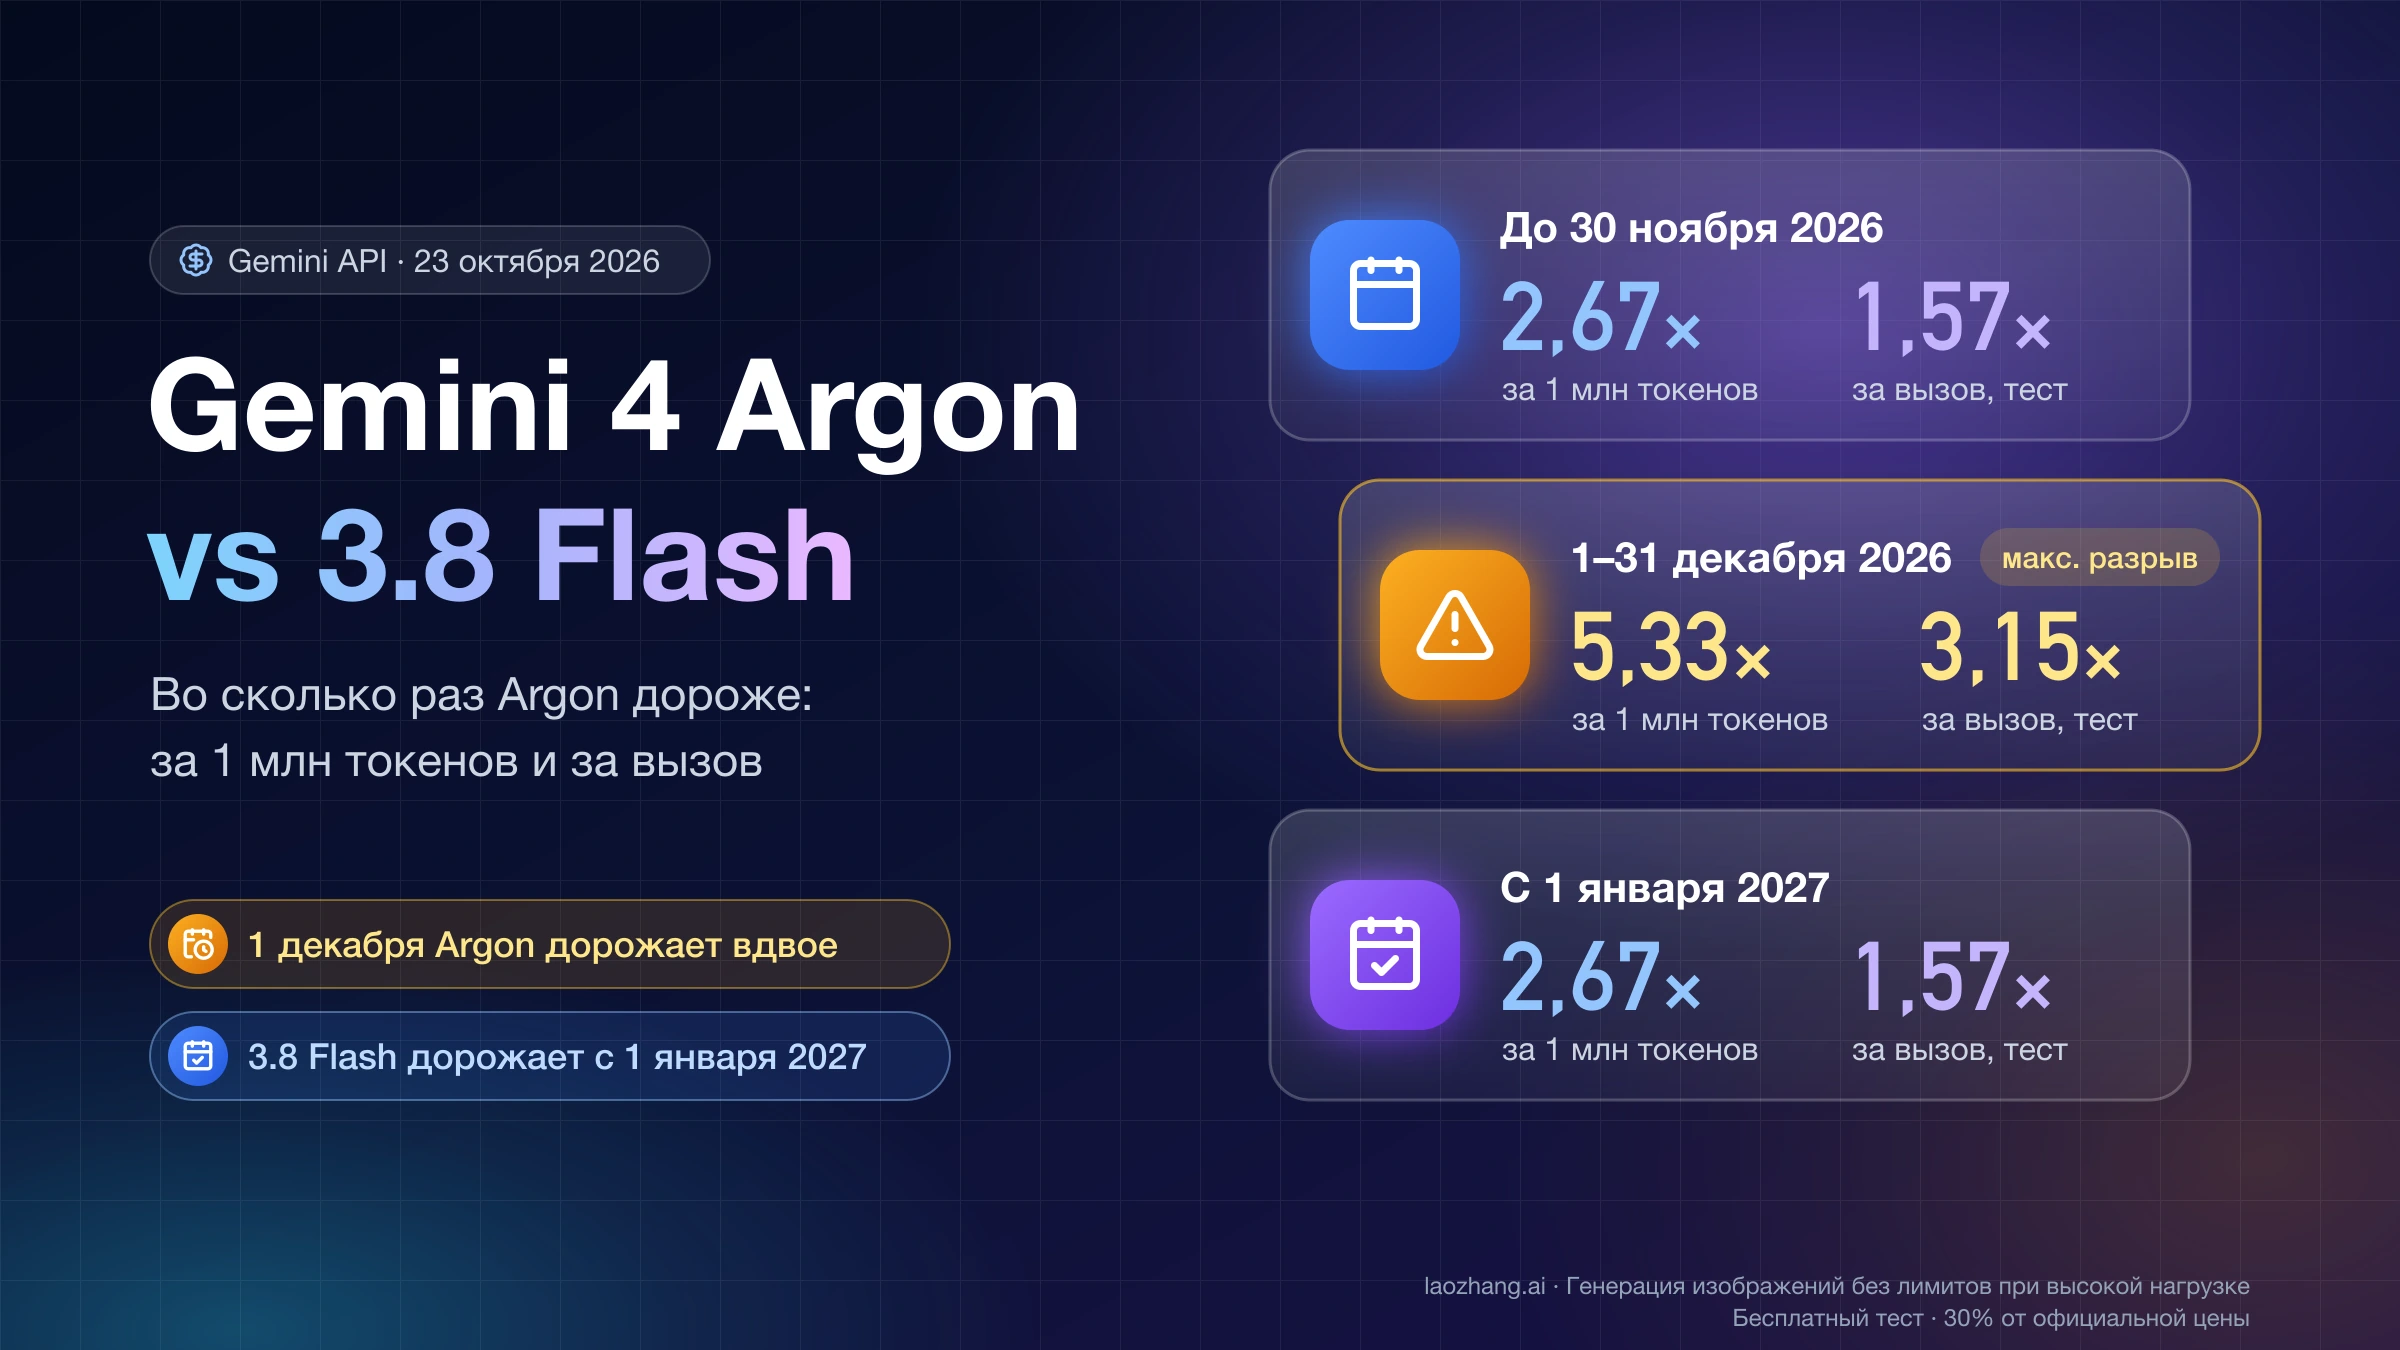
Кэшированный ввод стоит 10 % обычной цены ввода на 3.x-моделях и 5 % на Gemini 4 Argon, а явный кэш добавляет плату за хранение за каждый час. Ниже цены платного уровня Gemini Developer API (Standard) в долларах за 1 млн токенов по странице цен Google от 28 октября 2026 года; у двух моделей цены меняются в ближайшие месяцы.
| Модель | Ввод | Кэшированный ввод | Хранение явного кэша, за 1 млн токенов в час |
|---|---|---|---|
| Gemini 4 Argon до 30 ноября 2026 года | $2,00 | $0,10 | Явного кэша нет |
| Gemini 4 Argon с 1 декабря 2026 года | $4,00 | $0,20 | Явного кэша нет |
| Gemini 3.8 Flash и 3.6 Flash до 31 декабря 2026 года | $0,75 | $0,075 | $0,50 |
| Gemini 3.8 Flash и 3.6 Flash с 1 января 2027 года | $1,50 | $0,15 | $1,00 |
| Gemini 3.1 Pro Preview (промпт до 200 тыс. токенов) | $2,00 | $0,20 | $4,50 |
| Gemini 3.5 Flash-Lite | $0,30 | $0,03 | $1,00 |
| Gemini 3.1 Flash-Lite (текст) | $0,25 | $0,025 | $1,00 |
Окупаемость явного кэша считают двумя способами, и для кэша на один час подходит второй. Если кэш держат много часов, разовая плата за создание распределяется по ним, и важно только, чтобы экономия на чтениях покрывала хранение: цена хранения за час, делённая на разницу между обычным и кэшированным вводом. Для 3.8 Flash и 3.6 Flash это $0,50 / ($0,75 − $0,075) = 0,74 обращения в час, у 3.1 Pro Preview — $4,50 / $1,80 = 2,5, у 3.5 Flash-Lite — $1,00 / $0,27 = 3,7, у 3.1 Flash-Lite — 4,4.
Если же кэш создают под одну задачу и он живёт час, к хранению добавляется создание: оно оплачивается один раз по обычной цене ввода, так это описано в документации Google Cloud. Тогда запросов за этот час должно быть больше, чем (ввод + хранение) / (ввод − кэшированный ввод). На 3.8 и 3.6 Flash это ($0,75 + $0,50) / $0,675 ≈ 1,85, то есть явный кэш дешевле работы без кэша от 2 запросов в час; на 3.1 Pro Preview — от 4 (3,61), на 3.5 Flash-Lite — от 5 (4,81), на 3.1 Flash-Lite — от 6 (5,56). С 1 января 2027 года пороги для Flash не изменятся, потому что все три цены удваиваются одновременно.
На примере документа в 100 000 токенов на 3.8 Flash по ценам 2026 года (считается только ввод, без вопроса и ответа) разница выглядит так:
| Запросов за час | Без кэша | Явный кэш на 1 час | Неявный, если попадают все запросы после первого | Неявный, если попадает 1 запрос из 4 |
|---|---|---|---|---|
| 1 | $0,075 | $0,1325 | $0,075 | $0,075 |
| 2 | $0,15 | $0,14 | $0,0825 | $0,15 |
| 10 | $0,75 | $0,20 | $0,1425 | $0,615 |
| 60 | $4,50 | $0,575 | $0,5175 | $3,555 |
Для явного кэша при 10 запросах это $0,075 за создание, плюс 10 чтений по $0,0075 и $0,05 за час хранения. Неявный кэш в лучшем случае дешевле явного, потому что за хранение не берут, но «все попадания после первого» — это потолок: в тесте ниже на 3.8 Flash попадал примерно каждый третий запрос, а при таком проценте явный кэш выигрывает начиная с трёх запросов в час. При двух запросах неявный в среднем обходится примерно в $0,1275 против $0,14 у явного, при трёх — около $0,18 против $0,1475. Здесь первый запрос считается промахом за $0,075, а каждый следующий в среднем стоит $0,075 − $0,0675 / 3 ≈ $0,0525.
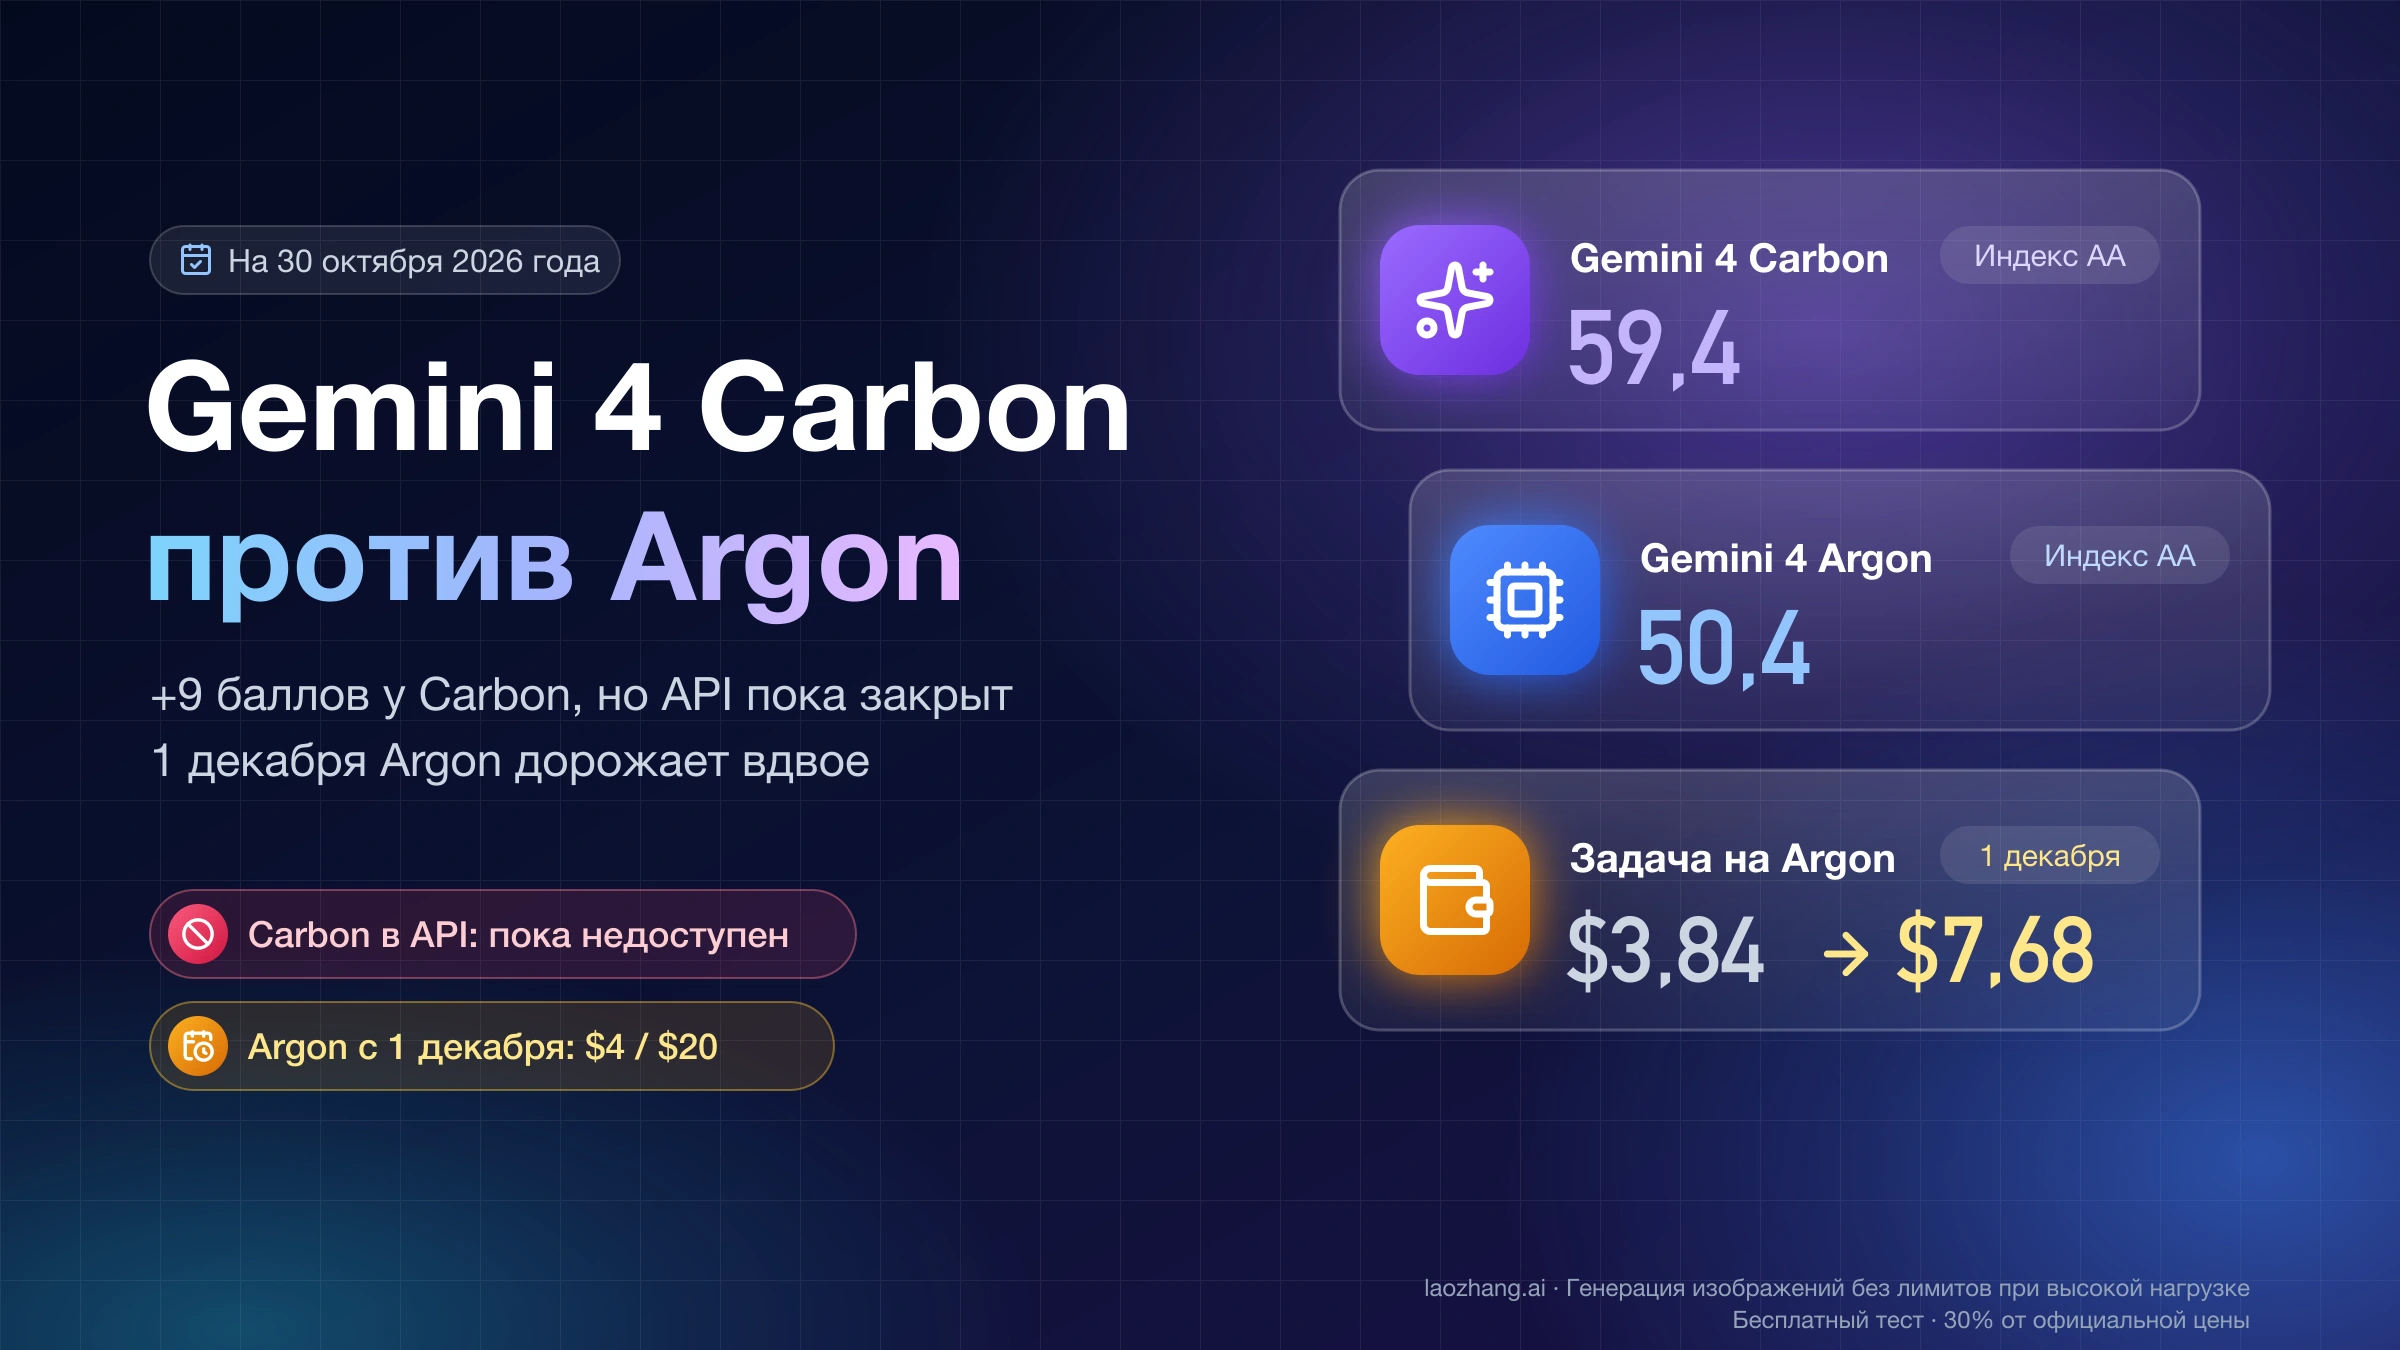
На Gemini 4 Argon считать окупаемость не нужно: хранения нет, а каждое попадание экономит $1,90 на 1 млн кэшированных токенов до 30 ноября 2026 года и $3,80 после повышения цен. Доля попаданий сильно зависит от модели и нагрузки. В сторонних замерах Artificial Analysis (индекс Intelligence Index v5.0, конец октября 2026 года) из кэша пришли 92 % входных токенов Gemini 4 Argon и только 34 % у 3.8 Flash, поэтому стоимость задачи у Argon там оказалась ниже; это один набор тестов, а не общая доля попаданий. Как выбрать между этими моделями, разобрано в статье Gemini 4 Argon vs 3.8 Flash: сравнение, тест цены и что выбрать.
На бесплатном уровне кэширование для 3.8 Flash указано как бесплатное, для 3.5 Flash-Lite — как недоступное, а у Argon бесплатного уровня нет вовсе; подробности — в статье Gemini API Free Tier 2026: ключ бесплатно, какие модели и лимиты. Цены на выход и остальные модели, а также вопрос доступа из России собраны в материале Как купить доступ к Gemini API в России: ключ $0, цены 2026–2027.
Как создать явный кэш на 3.8 Flash: create, TTL и delete
Явный кэш создают один раз, передают его имя в каждый запрос и удаляют, когда он больше не нужен. Пример ниже собран по документации generateContent API (обновлена 23 октября 2026 года) для Python SDK google-genai; ключ берётся из переменной окружения GEMINI_API_KEY. Через шлюз LaoZhang этот код не выполнить: эндпоинты явного кэша там отвечают 404 (подробнее в разделе про шлюз), поэтому нужен собственный ключ Google AI Studio или проект в Google Cloud.
import os

from google import genai
from google.genai import types

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])
model = "gemini-3.8-flash"

with open("manual.txt", encoding="utf-8") as f:
    document = f.read()

# 1. Создать кэш на 1 час (без ttl он тоже живёт 1 час)
cache = client.caches.create(
    model=model,
    config=types.CreateCachedContentConfig(
        display_name="product-manual",
        system_instruction="Отвечай на вопросы по документу.",
        contents=[document],
        ttl="3600s",
    ),
)

# 2. Использовать кэш в обычном запросе
response = client.models.generate_content(
    model=model,
    contents="Какие ограничения перечислены в разделе 4?",
    config=types.GenerateContentConfig(cached_content=cache.name),
)
print(response.usage_metadata)
print(response.text)

# 3. Продлить: менять можно только ttl или expire_time
client.caches.update(
    name=cache.name,
    config=types.UpdateCachedContentConfig(ttl="7200s"),
)

# 4. Удалить, чтобы не платить за лишние часы хранения
client.caches.delete(name=cache.name)
Несколько ограничений, которые влияют на код. Документ в кэше должен быть длиннее минимума модели: по таблице Google Cloud для явного кэша на моделях Gemini 3 это 4 096 токенов. Срок жизни по умолчанию — 1 час, а ограничений сверху и снизу ai.google.dev не задаёт. Время для expire_time должно быть с часовым поясом, например datetime.now(timezone.utc), а не datetime.utcnow(). Содержимое кэша прочитать обратно нельзя: client.caches.list() и client.caches.get(name=...) возвращают только метаданные — имя, модель, display_name, usage_metadata и время создания, изменения и истечения.
Модель не отличает кэшированные токены от обычных: кэш просто подставляется как начало промпта, а ваш запрос идёт следом. Если вы работаете через библиотеку OpenAI, Google предлагает передавать имя кэша в свойстве cached_content внутри extra_body. Отдельных лимитов у кэша нет, действуют обычные лимиты generateContent, и кэшированные токены входят в лимит токенов; как устроены сами лимиты, объясняет статья Лимиты Gemini API: где смотреть, уровни Tier 1–3 и ошибки 429.
Как проверить попадание в кэш: cachedContentTokenCount и cached_tokens
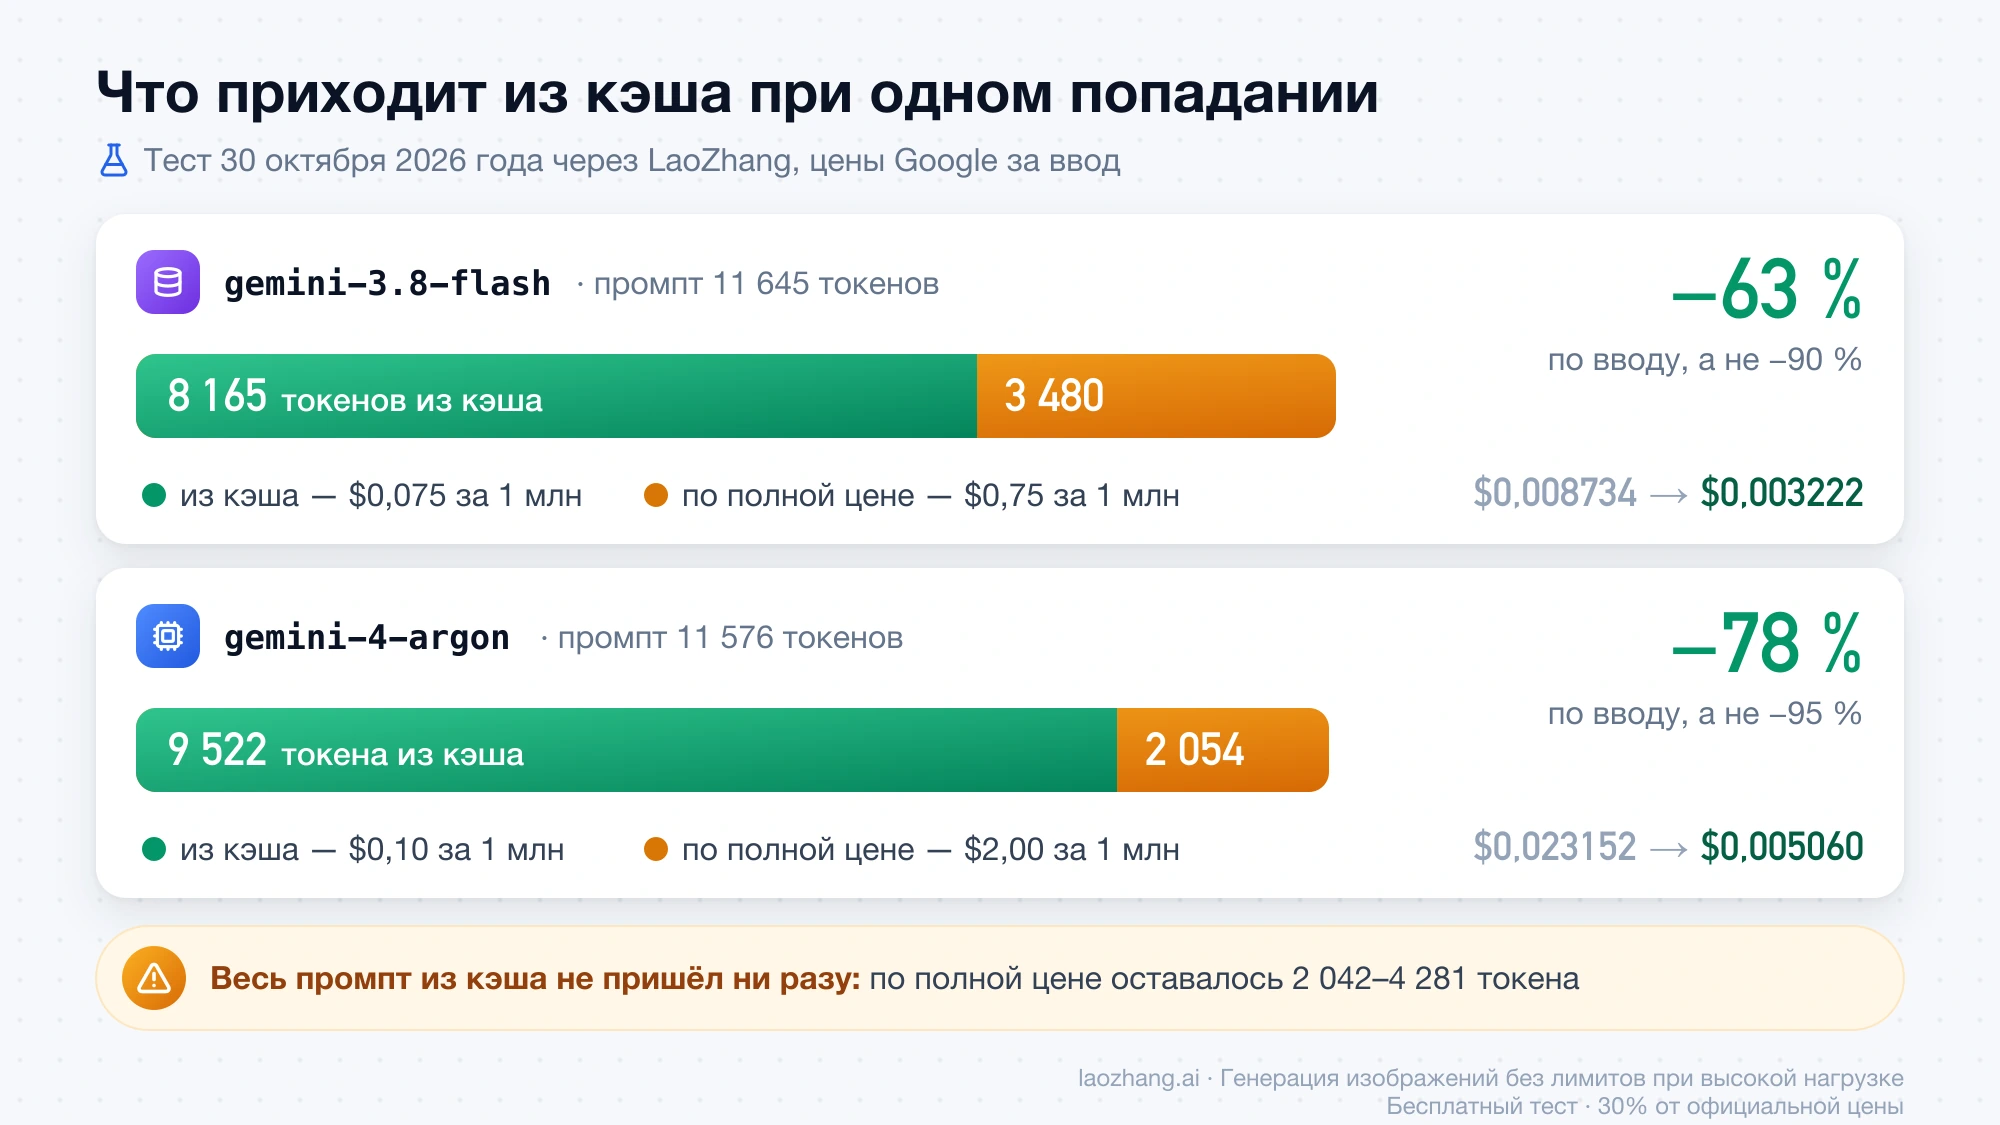
Попадание видно только в счётчиках токенов ответа: если в usageMetadata есть cachedContentTokenCount, часть промпта пришла из кэша. 30 октября 2026 года запрос к gemini-3.8-flash с промптом на 11 645 токенов вернул при попадании такие значения:
{
  "usageMetadata": {
    "promptTokenCount": 11645,
    "cachedContentTokenCount": 8165
  }
}
promptTokenCount включает кэшированную часть, то есть по полной цене оплачены 11 645 − 8 165 = 3 480 токенов. При промахе поле cachedContentTokenCount в ответе отсутствует, а не равно нулю, поэтому проверка в коде должна это учитывать. В Python SDK то же поле называется cached_content_token_count и при промахе равно None:
usage = response.usage_metadata
cached = usage.cached_content_token_count or 0
print(f"из кэша {cached} из {usage.prompt_token_count} токенов")
В Interactions API счётчик называется иначе — usage.total_cached_tokens (Python и JavaScript). Через OpenAI-совместимый эндпоинт /v1/chat/completions в том же тесте попадание выглядело как "prompt_tokens_details": {"cached_tokens": 8161} при prompt_tokens: 11644, а промах — как пустой объект "prompt_tokens_details": {}.
По этим полям легко пересчитать реальную экономию. Тот же запрос на 11 645 токенов стоил бы по вводу $0,008734, а с 8 165 токенами из кэша — $0,003222, то есть на 63 % меньше. У gemini-4-argon промпт на 11 576 токенов с 9 522 кэшированными подешевел с $0,023152 до $0,005060, на 78 %. Расчёт по ценам Google: (некэшированные токены × цена ввода + кэшированные × цена кэша) / 1 000 000.
Минимум 4 096 или 6 144 токенов: где на деле начинались попадания
На Gemini 3.8 Flash попадания начались примерно с 5 600 токенов, то есть ни 4 096, ни 6 144 токенов из документации Google не совпали с тем, что удалось измерить. ai.google.dev указывает для неявного кэша 4 096 токенов на Argon, 3.8 Flash, 3.6 Flash и 3.1 Pro Preview. Обзор кэширования в Google Cloud для 3.8 Flash и 3.1 Pro Preview ставит 6 144 токена (только для неявного кэша), а две страницы Cloud про Argon противоречат друг другу: гайд разработчика называет 6 144, страница модели — 4 096.
Тест прошёл 30 октября 2026 года через шлюз LaoZhang, в нативном формате generateContent. Одинаковые до байта запросы отправлялись с интервалом 15–20 секунд; начало промпта — длинный справочный текст в systemInstruction, в конце — короткий вопрос. Случайный идентификатор в начале текста менялся при каждом запуске скрипта, а не для каждой серии, поэтому серии внутри одного запуска делили общее начало. Чистыми, без более ранней серии с тем же началом, были серии на 4 971, 5 605, 6 143 и около 11 645 токенов у 3.8 Flash и на 11 576 у Argon; попадания в серии на 8 358 токенов у Flash и на 6 122 у Argon могли прийти из кэша, который записала предыдущая серия. Поле modelVersion во всех успешных ответах совпало с запрошенной моделью.
| Модель | Длина промпта, токенов | Попаданий | Токенов из кэша при попадании |
|---|---|---|---|
| gemini-3.8-flash | 4 380 | 0 из 6 | — |
| gemini-3.8-flash | 4 971 | 0 из 8 | — |
| gemini-3.8-flash | 5 605 | 4 из 8 | 3 563 |
| gemini-3.8-flash | 6 143 | 4 из 8 | 4 070 |
| gemini-3.8-flash | 8 358 | 1 из 6 | 4 077 |
| gemini-3.8-flash | около 11 645 | 3 из 15 | 8 165–8 168 |
| gemini-4-argon | 6 122 | 2 из 5 | 4 068 |
| gemini-4-argon | 11 576 | 1 из 5 | 9 522 |
Граница у 3.8 Flash от этого не меняется: в чистых сериях на 4 971 токен попаданий не было, а на 5 605 и 6 143 они были. Минимум Argon эти данные не устанавливают. Запрос на 6 122 токена частично пришёл из кэша, но его начало совпадало с серией на 11 576 токенов, кэш которой дошёл до 9 522, поэтому записать кэш мог и более длинный запрос, а чистая серия Argon на 11 576 токенов попала 1 раз из 5. Значит, на практике закладывайте неизменную часть промпта хотя бы на 6 000 токенов и проверяйте поле cachedContentTokenCount, а не полагайтесь на одно число из документации. У замеров есть пределы: один аккаунт, один шлюз, один день, один текст в начале промпта и небольшие серии, поэтому это не прямое измерение у Google, а о задержке по ним выводов сделать нельзя. Все около 60 вызовов по ценам Google обошлись бы примерно в $0,44.
Почему неявный кэш Gemini не срабатывает: что проверить
Неявный кэш не гарантирует попадания даже при идентичных запросах, поэтому сначала оценивайте его на серии из 10–20 запросов, а не по одному ответу. В серии на 6 143 токена ответы шли так: промах, промах, попадание, промах, промах, попадание, попадание, попадание. Перенос длинного текста из systemInstruction в сообщение пользователя на 11,6 тыс. токенов заметной разницы не дал (2 попадания из 6 против 1 из 6). Если попаданий нет совсем (в англоязычных обсуждениях это ищут как «Gemini implicit caching not working»), пройдитесь по списку:
- Проверьте длину неизменного начала промпта. На 3.8 Flash ниже примерно 5 600 токенов попаданий не было ни разу, хотя формально минимум 4 096.
- Уберите из начала промпта всё, что меняется: дату и время, идентификатор запроса, имя пользователя, порядок инструментов. Кэшируется только совпадающее начало, поэтому изменчивые данные ставьте в конец. На Reddit в r/n8n пользователь, не видевший ни одного попадания, подозревал именно узел AI Agent, который вставляет динамические инструкции в начало промпта.
- Сократите паузы между запросами. Google советует отправлять запросы с одинаковым началом за короткое время; в гайде Cloud по Argon окно кэша названо 15–20 минут.
- Не ждите, что из кэша придёт весь промпт. Ни одно попадание в тесте не покрыло его целиком: по полной цене всегда оставалось 2 042–4 281 токена, больше, чем занимал сам вопрос в конце. Поэтому запрос с попаданием дешевел по входу на 44–63 % у 3.8 Flash и на 63–78 % у Argon, а не на 90–95 %.
- В многоходовых диалогах и агентах на Gemini 4 Argon следите за приростом. По документации Google полный предыдущий запрос кэшируется, только если новый добавляет не меньше 2 050 токенов (ответ модели, рассуждения и результаты функций тоже считаются), иначе последние 2 050 токенов обрабатываются заново по обычной цене. В тесте это правило не проверялось.
- Учитывайте маршрут. По документации Google Cloud кэш привязан к проекту, а шлюз может отправлять ваши запросы через разные проекты; снаружи это не проверить, но доля попаданий через посредника может быть ниже, чем с собственным ключом.
Если после этих изменений попаданий всё равно мало, а модель поддерживает явный кэш, переходите на него: при попадании примерно в каждом третьем запросе явный кэш на 3.8 Flash дешевле начиная с трёх запросов в час. На Argon такого выхода нет, и остаётся только порядок промпта и частота запросов.
Сколько живёт кэш Gemini: TTL явного и неявного кэша
У явного кэша срок жизни (TTL) задаёте вы: по умолчанию 1 час, и ai.google.dev не ставит ни минимума, ни максимума, а в Google Cloud минимум — 1 минута при отсутствии максимума. Платите вы за всё время хранения, поэтому длинный TTL без запросов съедает экономию, а удалённый вручную кэш перестаёт тарифицироваться.
Срок жизни неявного кэша Google не гарантирует. Обзор кэширования в Google Cloud пишет, что кэшированное начало промпта хранится не дольше 24 часов после создания, а большинство записей вытесняется раньше. В гайде Cloud по Gemini 4 Argon скидка 95 % обещана для запросов, идущих друг за другом в пределах 15–20 минут, и на этот интервал разумнее ориентироваться при планировании нагрузки.
Durable caching в Gemini Enterprise Agent Platform (бывший Vertex AI)
Durable caching — второй уровень неявного кэша, описанный только в документации Google Cloud: когда начало промпта вытесняется из оперативной памяти, оно переезжает в долговременное хранилище, а не удаляется, и более поздний запрос может попасть в кэш даже после долгой паузы. Платформа, которую раньше называли Vertex AI, в документации Google теперь называется Gemini Enterprise Agent Platform. По состоянию на 28 октября 2026 года durable caching поддерживают Gemini 4 Argon, 4 Argon Cyber Permissive, 3.8 Flash и 3.8 Flash Cyber; оба уровня включены по умолчанию, а за хранение неявного кэша плата не взимается. В документации Gemini API на ai.google.dev этого механизма нет, поэтому с ключом AI Studio на него рассчитывать не стоит.
Для тех, кто следит за хранением данных, важны детали со страницы Cloud о нулевом хранении данных. В durable-хранилище лежат производные данные кэша (представления «ключ — значение»), они привязаны к проекту, удаляются не позже чем через 24 часа, не используются для обучения и при региональном эндпоинте остаются в выбранном регионе. Ключи шифрования клиента (CMEK) для durable caching не поддерживаются. Его можно отключить на уровне проекта через cacheConfig, а включённый режим виден в ответе как "retentionType": "DURABLE"; отключение кэша целиком выключает оба уровня. Кроме того, явный кэш может запускать дополнительное неявное кэширование сверх указанного содержимого, так что для полного отказа от хранения нужно и отключить неявный кэш, и не создавать явные. Чем ещё маршрут через Google Cloud отличается от ключа AI Studio, разобрано в статье Gemini API или Vertex AI API: какой маршрут Google Gemini выбрать.
Кэш Gemini через шлюз и OpenAI-совместимый эндпоинт
Через шлюз неявный кэш работает, а явный может быть недоступен. Официально Gemini API в России недоступен, поэтому многие подключаются через зарубежный аккаунт или посредника, и 30 октября 2026 года все описанные выше тесты шли через LaoZhang. В нативном формате generateContent попадания приходили на обеих моделях, а через OpenAI-совместимый /v1/chat/completions на gemini-3.8-flash с промптом около 11 644 токенов из трёх запросов с разными вопросами попал один, с 8 161 токеном в кэше; начало этих запросов совпадало с серией на 6 143 токена, так что попадание могло прийти из её кэша.
Явный кэш через этот шлюз создать нельзя: POST /v1beta/cachedContents для gemini-3.8-flash и gemini-4-argon, как и GET /v1beta/cachedContents, вернули HTTP 404 с ошибкой самого шлюза {"error":{"message":"Invalid URL (POST /v1beta/cachedContents)","type":"invalid_request_error"}}, то есть запрос до Google не дошёл. Для явного кэша нужен прямой ключ Google или проект в Google Cloud. В прайсе LaoZhang на 30 октября 2026 года для gemini-3.8-flash указана цена чтения кэша $0,075 за 1 млн токенов, а для gemini-4-argon такой цены нет, поэтому по документации платформы нельзя понять, удешевляет ли попадание запрос к Argon на этом маршруте. Всё, что сказано выше о попаданиях, — наблюдение через один шлюз, а не поведение Google при прямом подключении.
Кэширование контекста Gemini: другие вопросы
Чем кэш Gemini отличается от кэша Claude и OpenAI? У Gemini неявный кэш срабатывает сам и ничего не стоит за хранение, а явный требует отдельного объекта с почасовой оплатой; у Claude кэш включают меткой cache_control и платят за запись. Как это устроено у Claude, разобрано в статье Claude prompt caching: кэширование промптов, TTL, цены и тест.
Работает ли кэш в Batch API? Да, по странице цен Gemini API от 28 октября 2026 года у Gemini 4 Argon в пакетном режиме кэшированный ввод стоит $0,05 за 1 млн токенов до 30 ноября 2026 года и $0,10 с 1 декабря.
Удешевляет ли кэш вывод или рассуждения модели? Нет. Скидка относится только к входным токенам, которые пришли из кэша; ответ, рассуждения и некэшированная часть промпта оплачиваются по обычным ценам выбранной модели.