Claude prompt caching: кэширование промптов, TTL, цены и тест
Кэш Claude включает одно поле cache_control. На Opus и Sonnet 5.5 чтение стоит 0,05× входа, минимум — 512 токенов, срок жизни — 5 минут или час.
Содержание
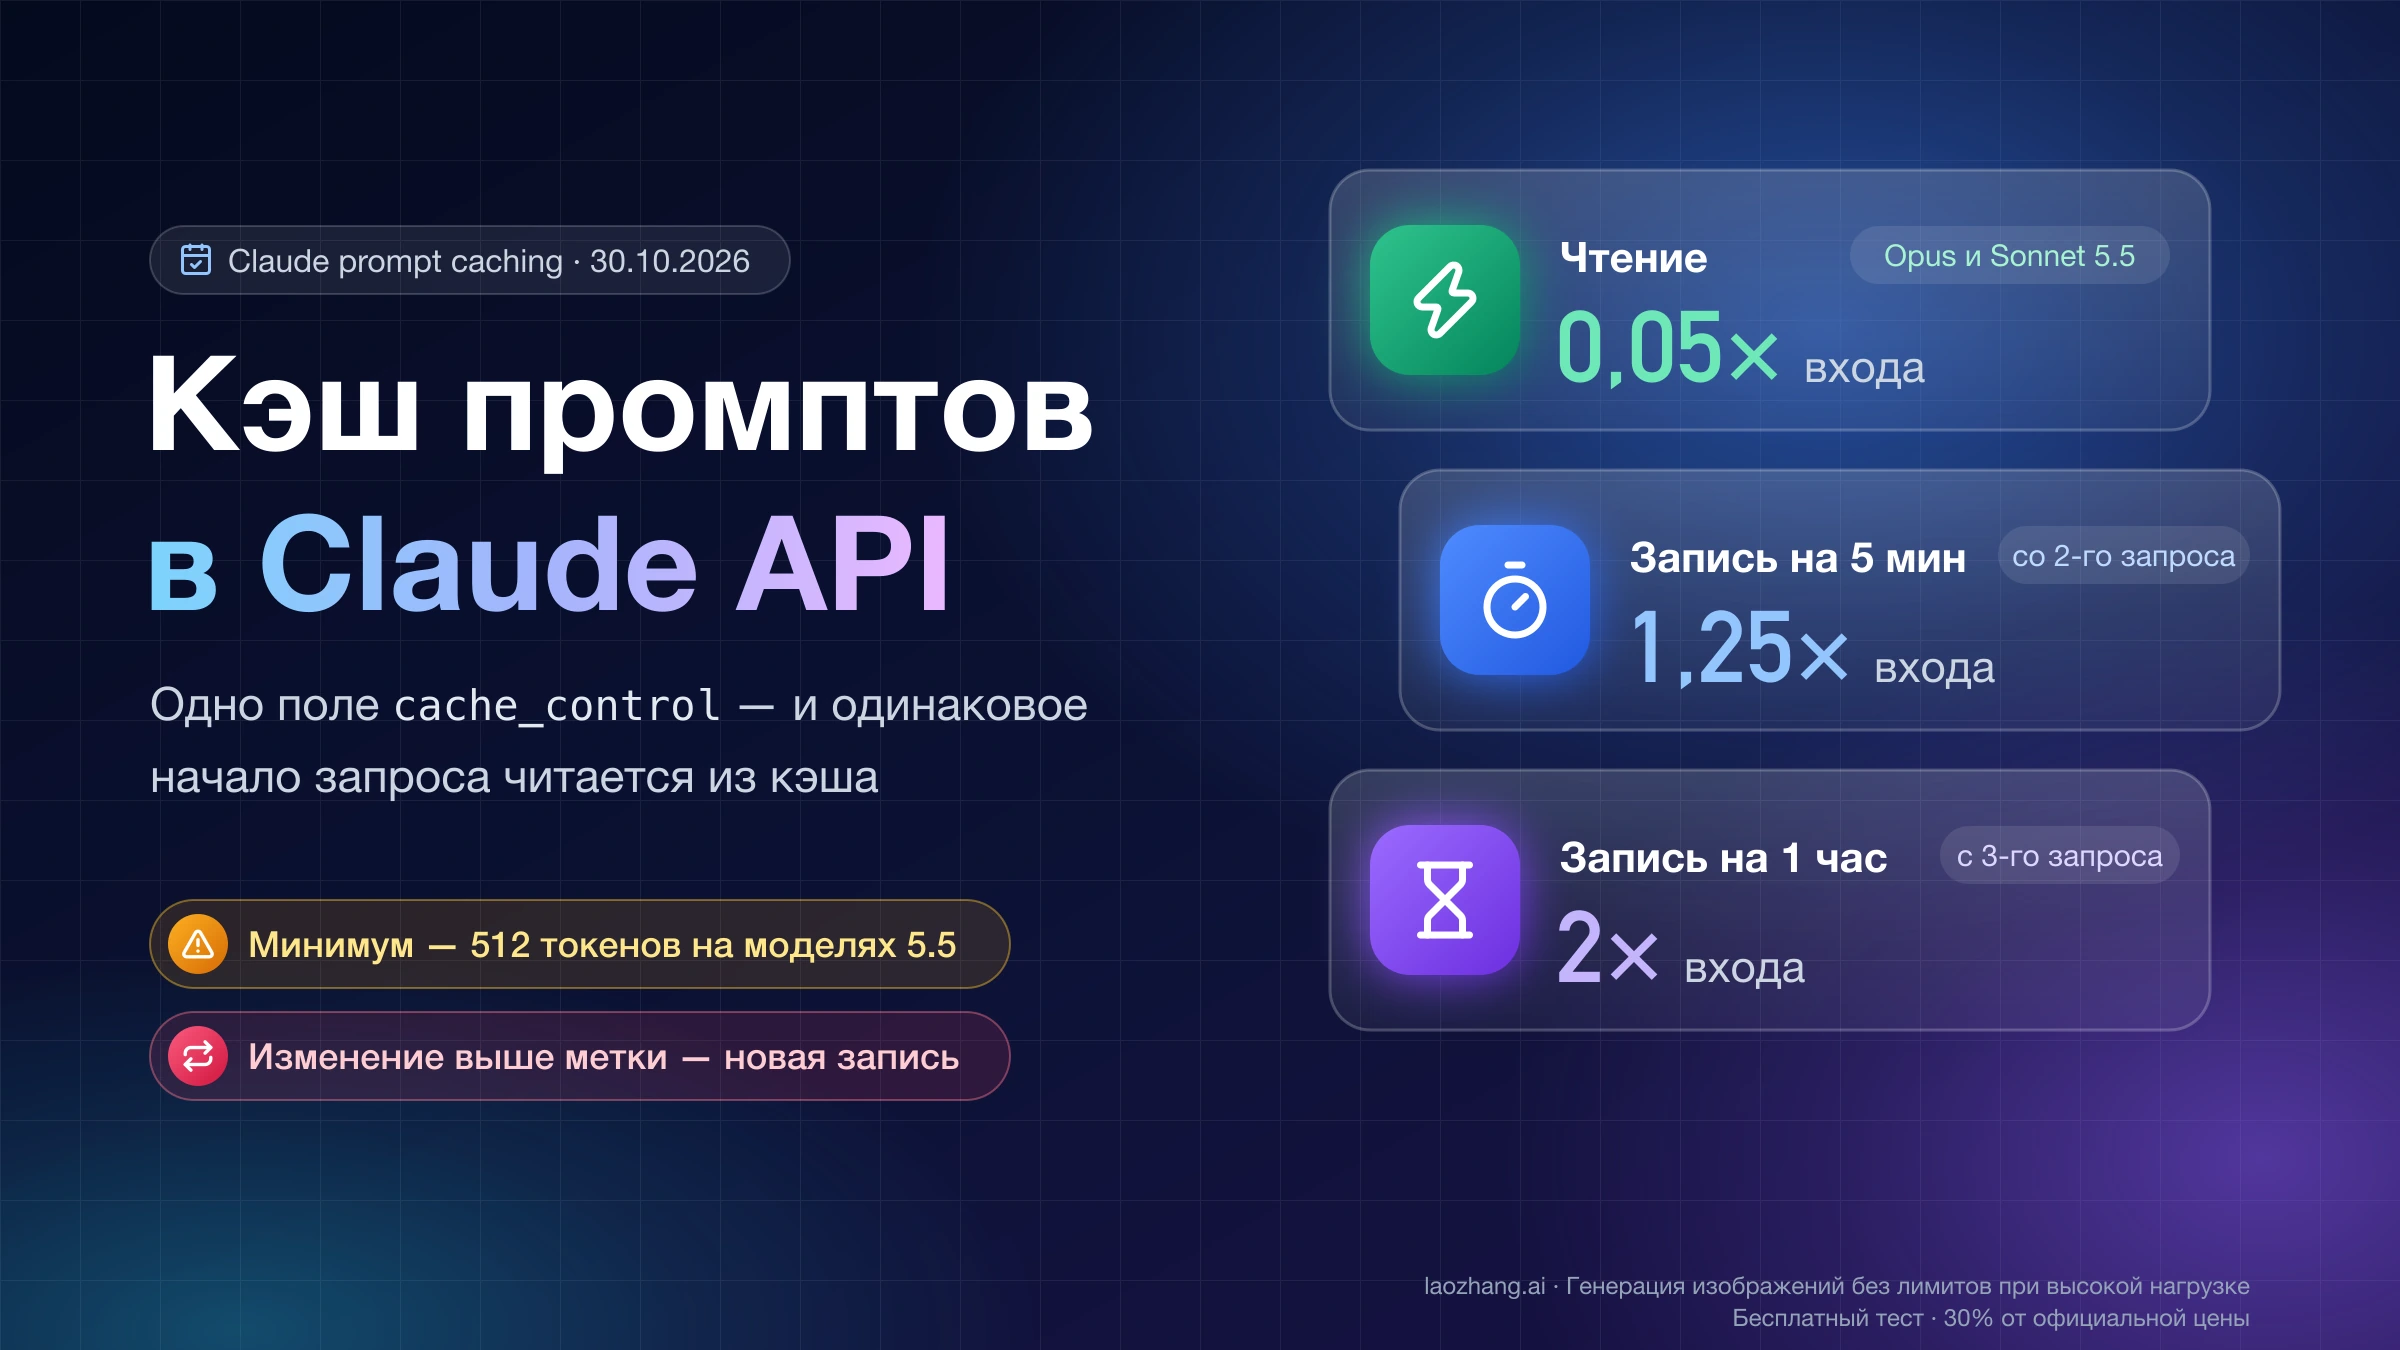
Claude prompt caching (кэширование промптов) удешевляет повторяющееся начало запроса. Claude сохраняет префикс в порядке tools → system → messages до блока с меткой cache_control, и следующий запрос с точно таким же началом читает его из кэша вместо полной обработки. По состоянию на 30 октября 2026 года чтение стоит 0,05× входной цены на Opus 5.5 и Sonnet 5.5, 0,025× на Fable 5.1 и 0,1× на Haiku 5.5, а запись обходится в 1,25× при сроке жизни (TTL) 5 минут или в 2× при TTL 1 час. Каждое чтение бесплатно продлевает срок жизни записи.
Чтобы включить кэш, добавьте в тело запроса к Messages API поле "cache_control": {"type": "ephemeral"} на верхнем уровне (автоматическое кэширование, удобно для диалогов) или поставьте ту же метку на последний блок, который не меняется между запросами, обычно на системный промпт. Затем отправьте похожий запрос второй раз и посмотрите на usage.cache_read_input_tokens в ответе: если там не ноль, кэш сработал. В тесте 30 октября 2026 года через API LaoZhang системный промпт на 7 882 токена у claude-sonnet-5-5 записался первым запросом и прочитался двумя следующими.
Экономии не будет в трёх случаях. Префикс короче 512 токенов на моделях 5.5, Opus 5 и Fable 5.1 (у Sonnet 5 и моделей 4.x — 1 024–4 096) не кэшируется вовсе, и ошибки при этом нет. Любое изменение выше метки, будь то дата в системном промпте или другой порядок инструментов, превращает чтение в новую запись. А если один и тот же префикс приходит реже, чем раз в 5 минут, каждая запись стоит на 25 % дороже обычного входа, и тогда выгоднее TTL 1 час или работа без кэша.
Что кэширует Claude: префикс до метки cache_control
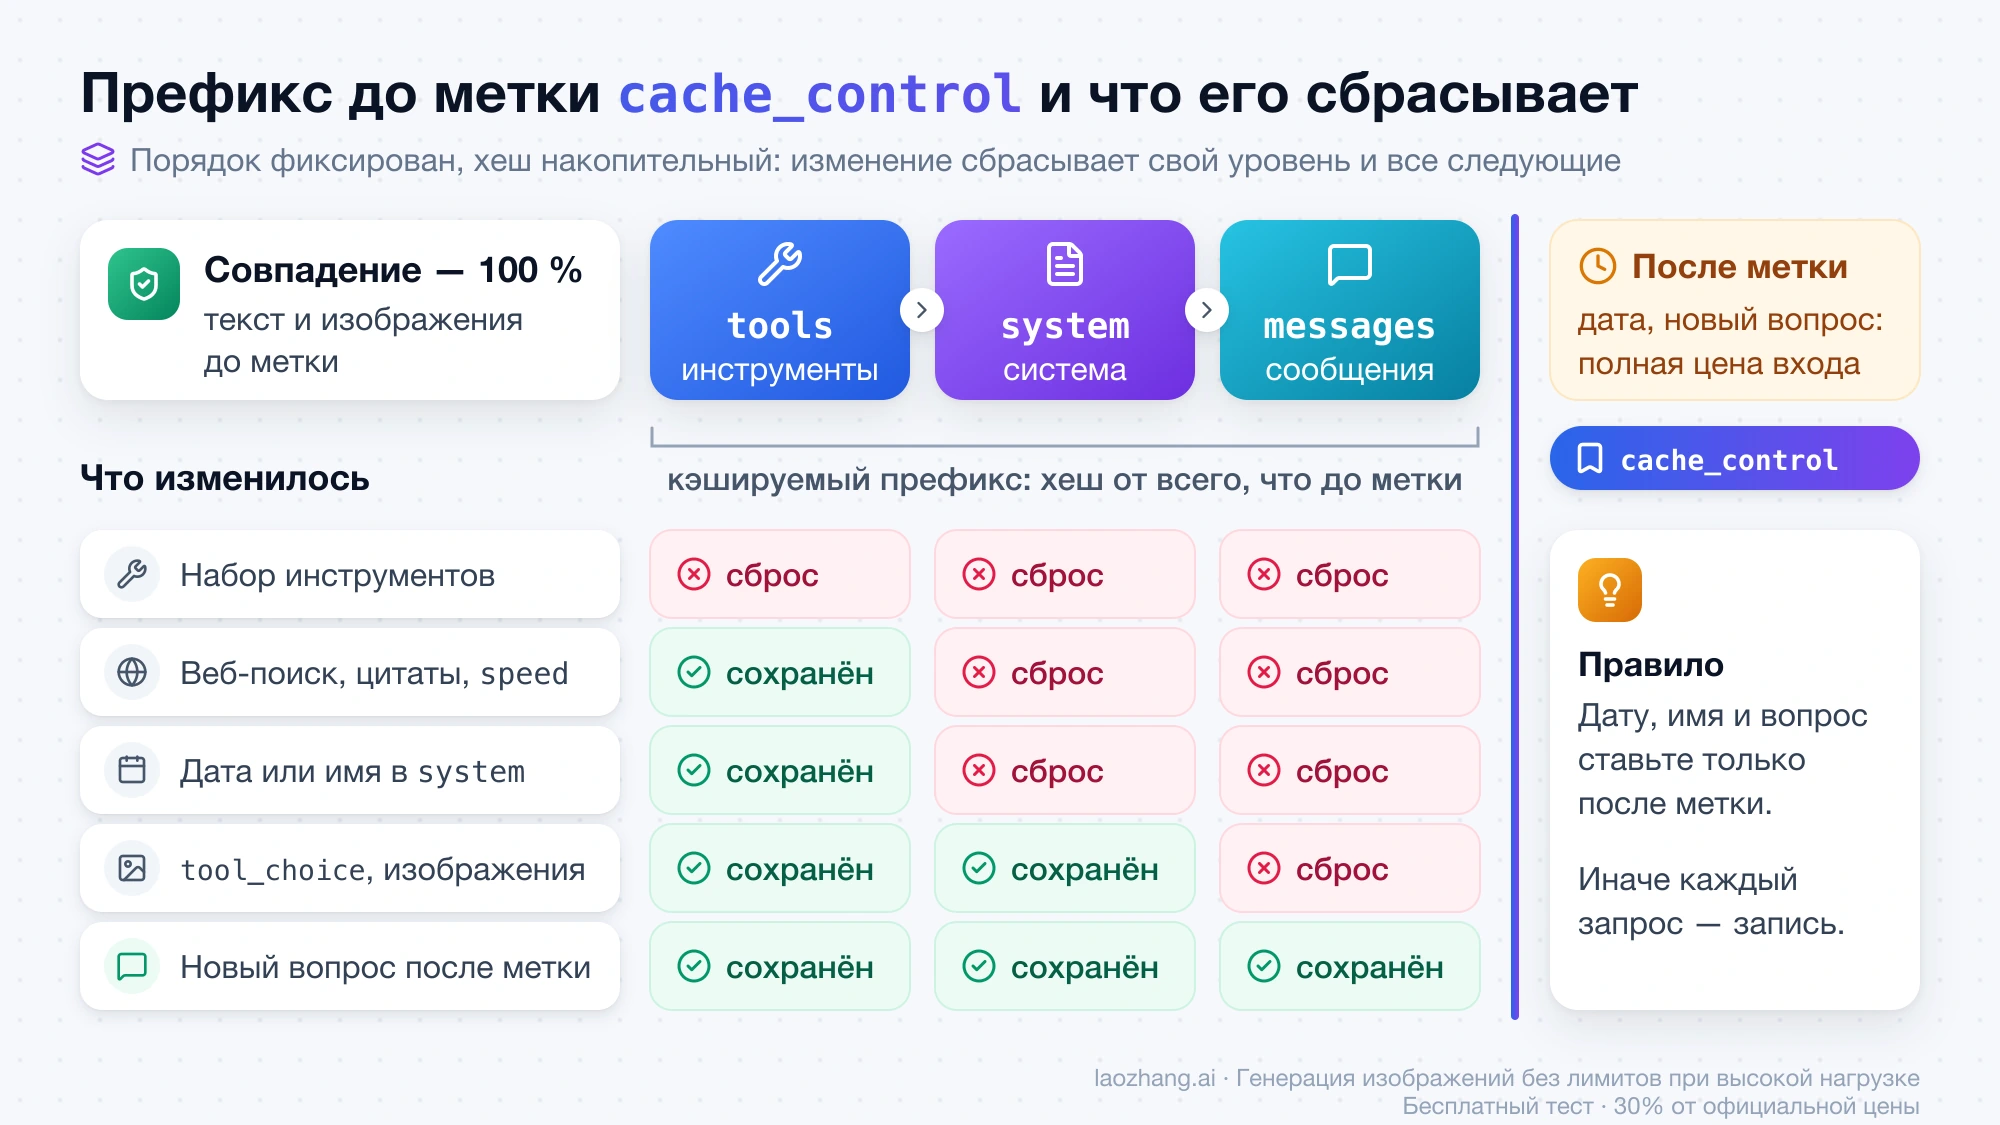
Claude кэширует не готовые ответы, а обработанное начало запроса. Префикс собирается в фиксированном порядке: определения инструментов tools, затем system, затем messages, и заканчивается блоком, на котором стоит cache_control. От этого префикса считается хеш. Если в течение срока жизни приходит запрос с тем же хешем, модель берёт префикс из кэша и заново обрабатывает только то, что идёт после метки (документация Anthropic по prompt caching).
Отсюда главное правило: совпадение должно быть стопроцентным, включая текст и изображения до метки. Хеш накопительный, поэтому изменение в tools сбрасывает кэш инструментов, системы и сообщений, а изменение в system сбрасывает систему и сообщения. Сегодняшняя дата в начале системного промпта, подставленное имя пользователя или перемешанный порядок инструментов делают каждый запрос новой записью. Всё, что меняется от запроса к запросу, должно стоять после метки.
Закэшировать можно определения инструментов, системные блоки, текст в репликах пользователя и ассистента, изображения и документы в репликах пользователя, а также блоки tool_use и tool_result. Блоки рассуждений (thinking) пометить напрямую нельзя: они попадают в кэш вместе с предыдущими ходами ассистента и при чтении считаются входными токенами. Пустые текстовые блоки не кэшируются. Кэш изолирован: разные организации его никогда не делят, а в Claude API, Claude Platform on AWS и Microsoft Foundry он ещё и разделён по рабочим пространствам (workspace), тогда как в Amazon Bedrock и Google Cloud — только по организации.
Как включить кэширование: одно поле или явная точка
Оба способа используют одно и то же значение {"type": "ephemeral"}, разница в том, где оно стоит. Автоматическое кэширование ставит метку на последний кэшируемый блок само и сдвигает её вперёд по мере роста диалога; Anthropic советует начинать с него для многоходовых разговоров. Явная точка кэширования (breakpoint) ставится вручную на конкретный блок и нужна, когда в конце запроса есть что-то, что меняется каждый раз. Сами точки ничего не стоят, в одном запросе их может быть до четырёх, и автоматическая метка занимает одну из этих четырёх позиций.
Автоматическое кэширование: поле на верхнем уровне запроса
Это та самая «одна строка»: cache_control кладётся в корень тела запроса, рядом с model и max_tokens.
curl https://api.anthropic.com/v1/messages \
  -H "content-type: application/json" \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -d '{
    "model": "claude-sonnet-5-5",
    "max_tokens": 1024,
    "cache_control": {"type": "ephemeral"},
    "system": "Ты помощник службы поддержки. Отвечай строго по регламенту ниже. ...",
    "messages": [
      {"role": "user", "content": "Как оформить возврат заказа?"}
    ]
  }'
Через LaoZhang тело запроса не меняется: адрес становится https://api.laozhang.ai/v1/messages, а вместо x-api-key передаётся заголовок Authorization: Bearer $LAOZHANG_API_KEY. Для часового кэша значение заменяется на {"type": "ephemeral", "ttl": "1h"}.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
В тесте 30 октября 2026 года трёхходовой диалог на claude-sonnet-5-5 через LaoZhang вёл себя так, как описано в документации. Первый ход записал 7 906 токенов, второй прочитал эти 7 906 и дописал 65 новых, третий прочитал 7 971 и дописал 74. Переставлять метку между ходами не пришлось.
У автоматического режима есть пограничные случаи. Если последний блок уже помечен явно с тем же TTL, автоматическая метка ничего не добавляет, а с другим TTL запрос получает ошибку 400. Ошибку 400 вернёт и запрос, в котором уже стоят четыре явные точки. В старой интеграции Amazon Bedrock (Opus 4.6 и более ранние модели) поле верхнего уровня не поддерживается, там работают только явные точки.
Явная точка cache_control на последнем неизменном блоке
Если в конце запроса стоит метка времени, контекст конкретного запроса или просто новое сообщение пользователя, автоматическая метка окажется на меняющемся блоке. Тогда каждый запрос записывает новый префикс и ни разу его не читает. В такой структуре ставьте cache_control вручную на последний блок, который одинаков во всех запросах:
import os
from datetime import datetime, timezone
from anthropic import Anthropic

client = Anthropic(api_key=os.environ["ANTHROPIC_API_KEY"])
# Через LaoZhang:
# client = Anthropic(api_key=os.environ["LAOZHANG_API_KEY"], base_url="https://api.laozhang.ai")

with open("reglament.md", encoding="utf-8") as f:
    reglament = f.read()  # большой неизменный текст: регламент, база знаний, примеры

now = datetime.now(timezone.utc).isoformat()

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    system=[
        {"type": "text", "text": "Отвечай только по регламенту ниже."},
        {
            "type": "text",
            "text": reglament,
            "cache_control": {"type": "ephemeral"},  # метка на последнем неизменном блоке
        },
    ],
    messages=[
        {"role": "user", "content": f"Сейчас {now}. Как оформить возврат заказа?"}
    ],
)
print(response.usage)
Запись происходит только в точке с меткой. При следующем запросе система ищет назад совпадения с тем, что прошлые запросы уже записали в своих точках, а просто неизменный текст перед меткой она не находит. Поэтому, по документации Anthropic, метка на блоке со временем now даёт запись при каждом запросе и ни одного чтения. С явной точкой на системном блоке в тесте 30 октября 2026 года первый вызов записал 7 882 токена, а два следующих с другими вопросами прочитали те же 7 882 и оплатили по полной цене только 16 и 17 токенов вопроса.
Несколько точек нужны, когда части промпта меняются с разной частотой: инструменты стоят неделями, база знаний обновляется раз в день, а диалог растёт каждый ход. Вторая точка нужна и в длинном диалоге: поиск прошлых записей проверяет не больше 20 блоков назад от метки, поэтому если с последней записи добавилось 20 блоков и больше, без промежуточной точки чтения не будет.
Цены кэша Claude по моделям: запись 1,25× и 2×, чтение от 0,025×
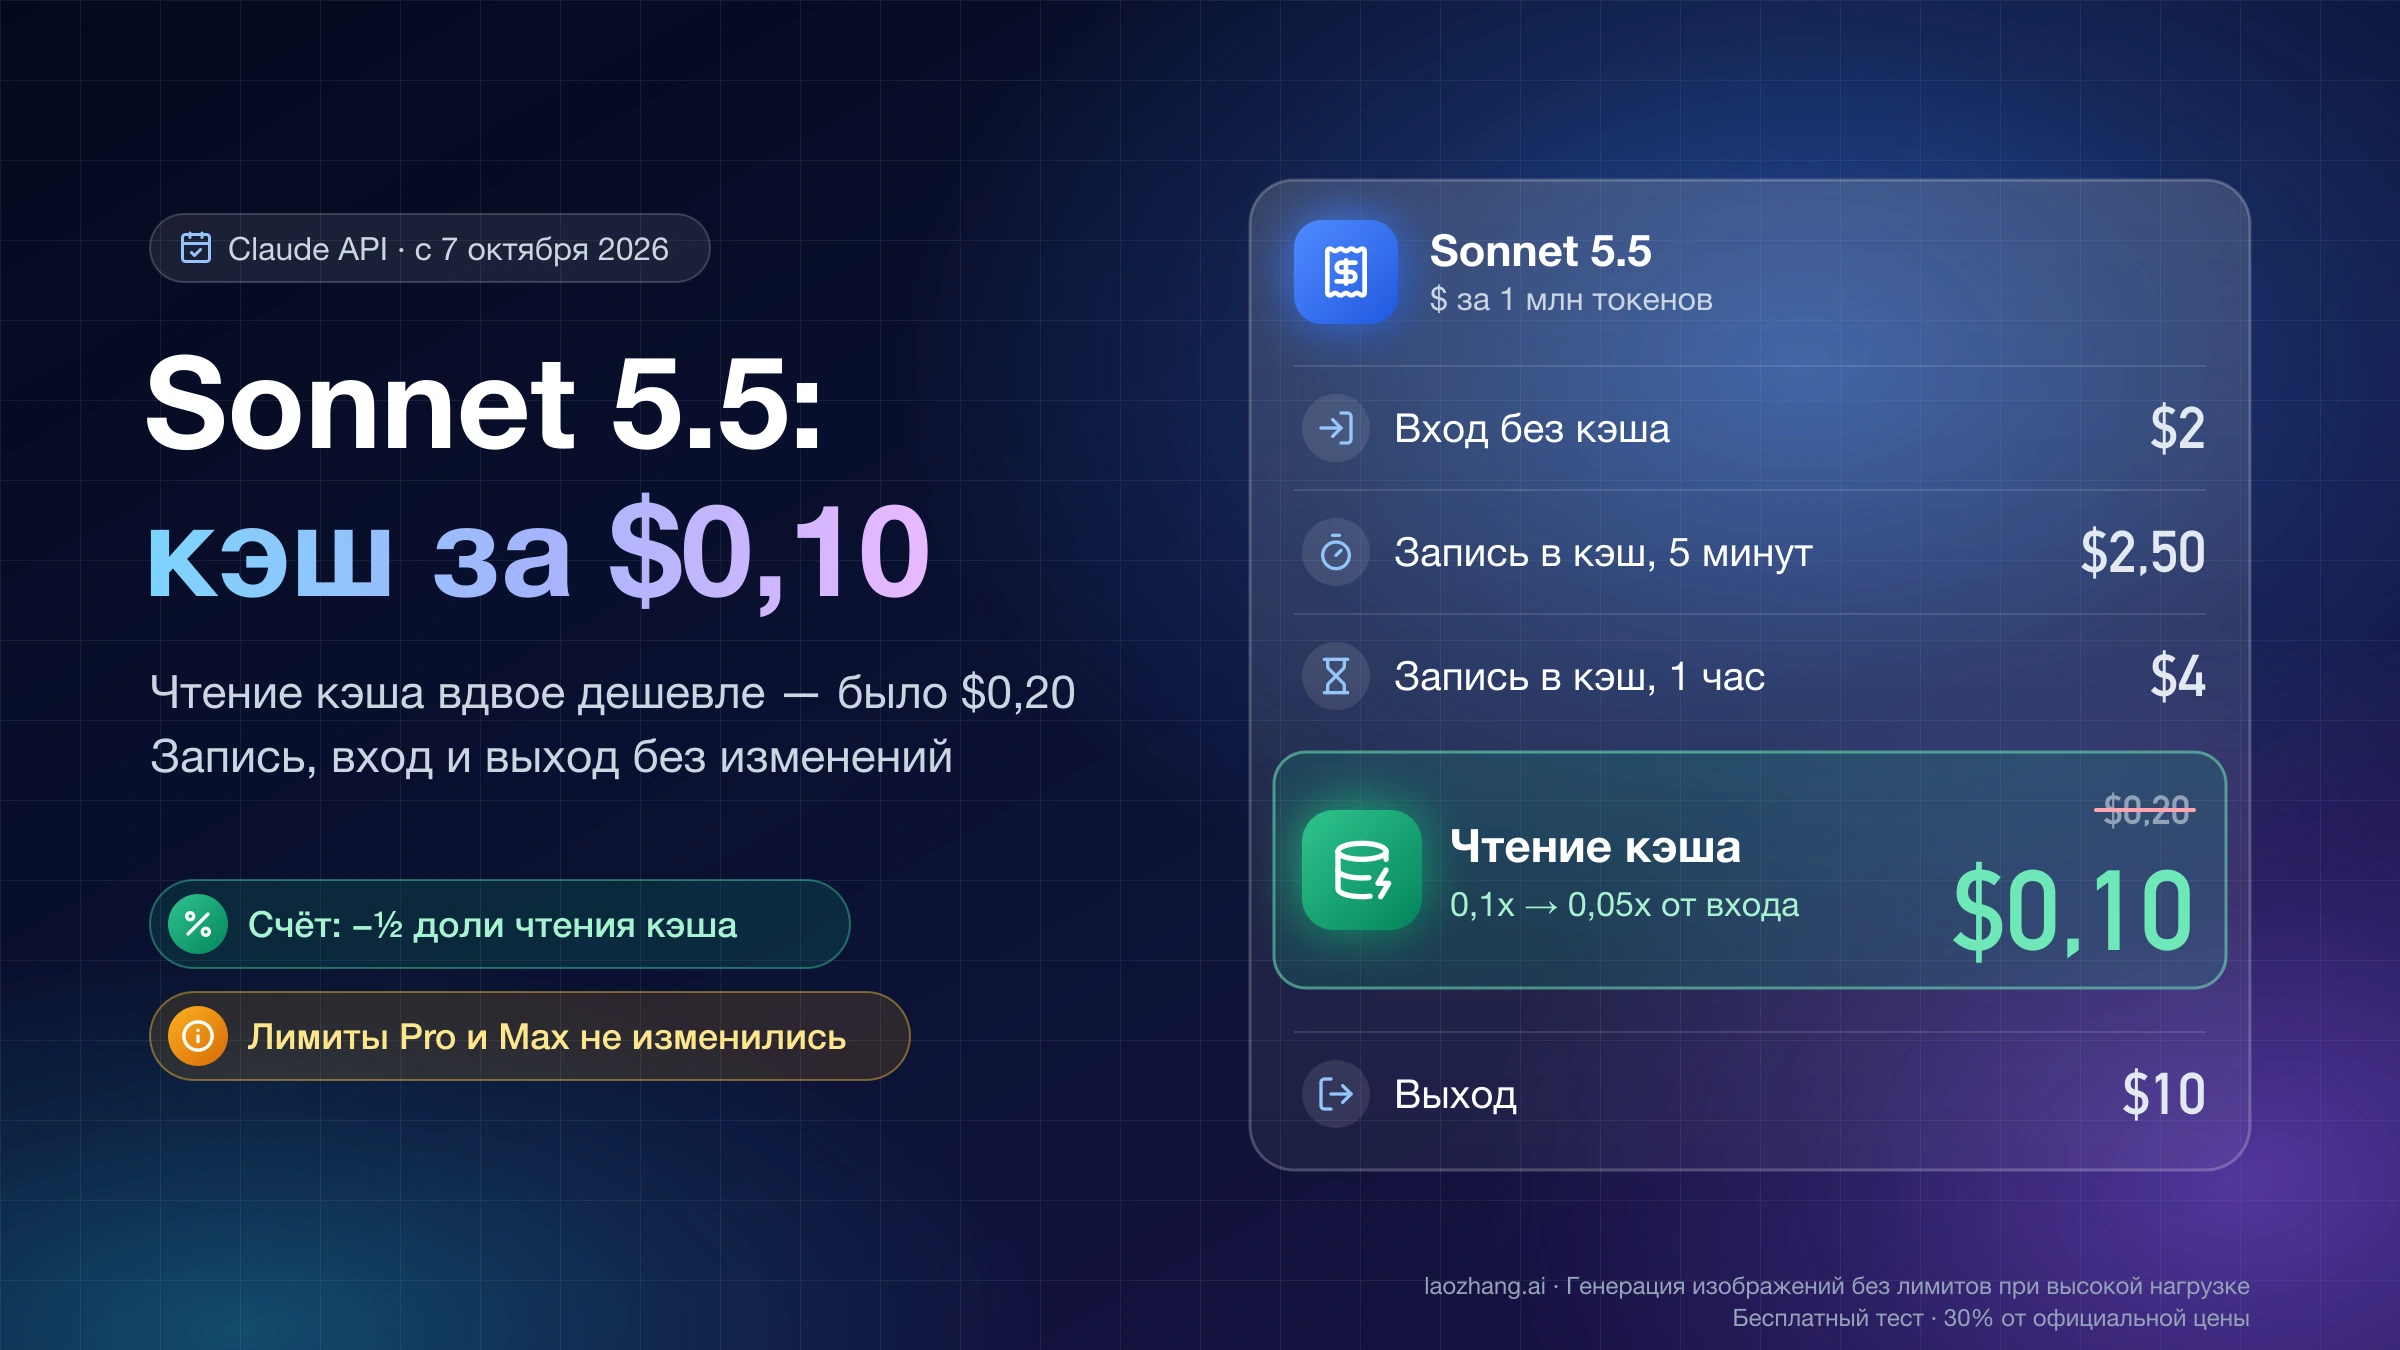
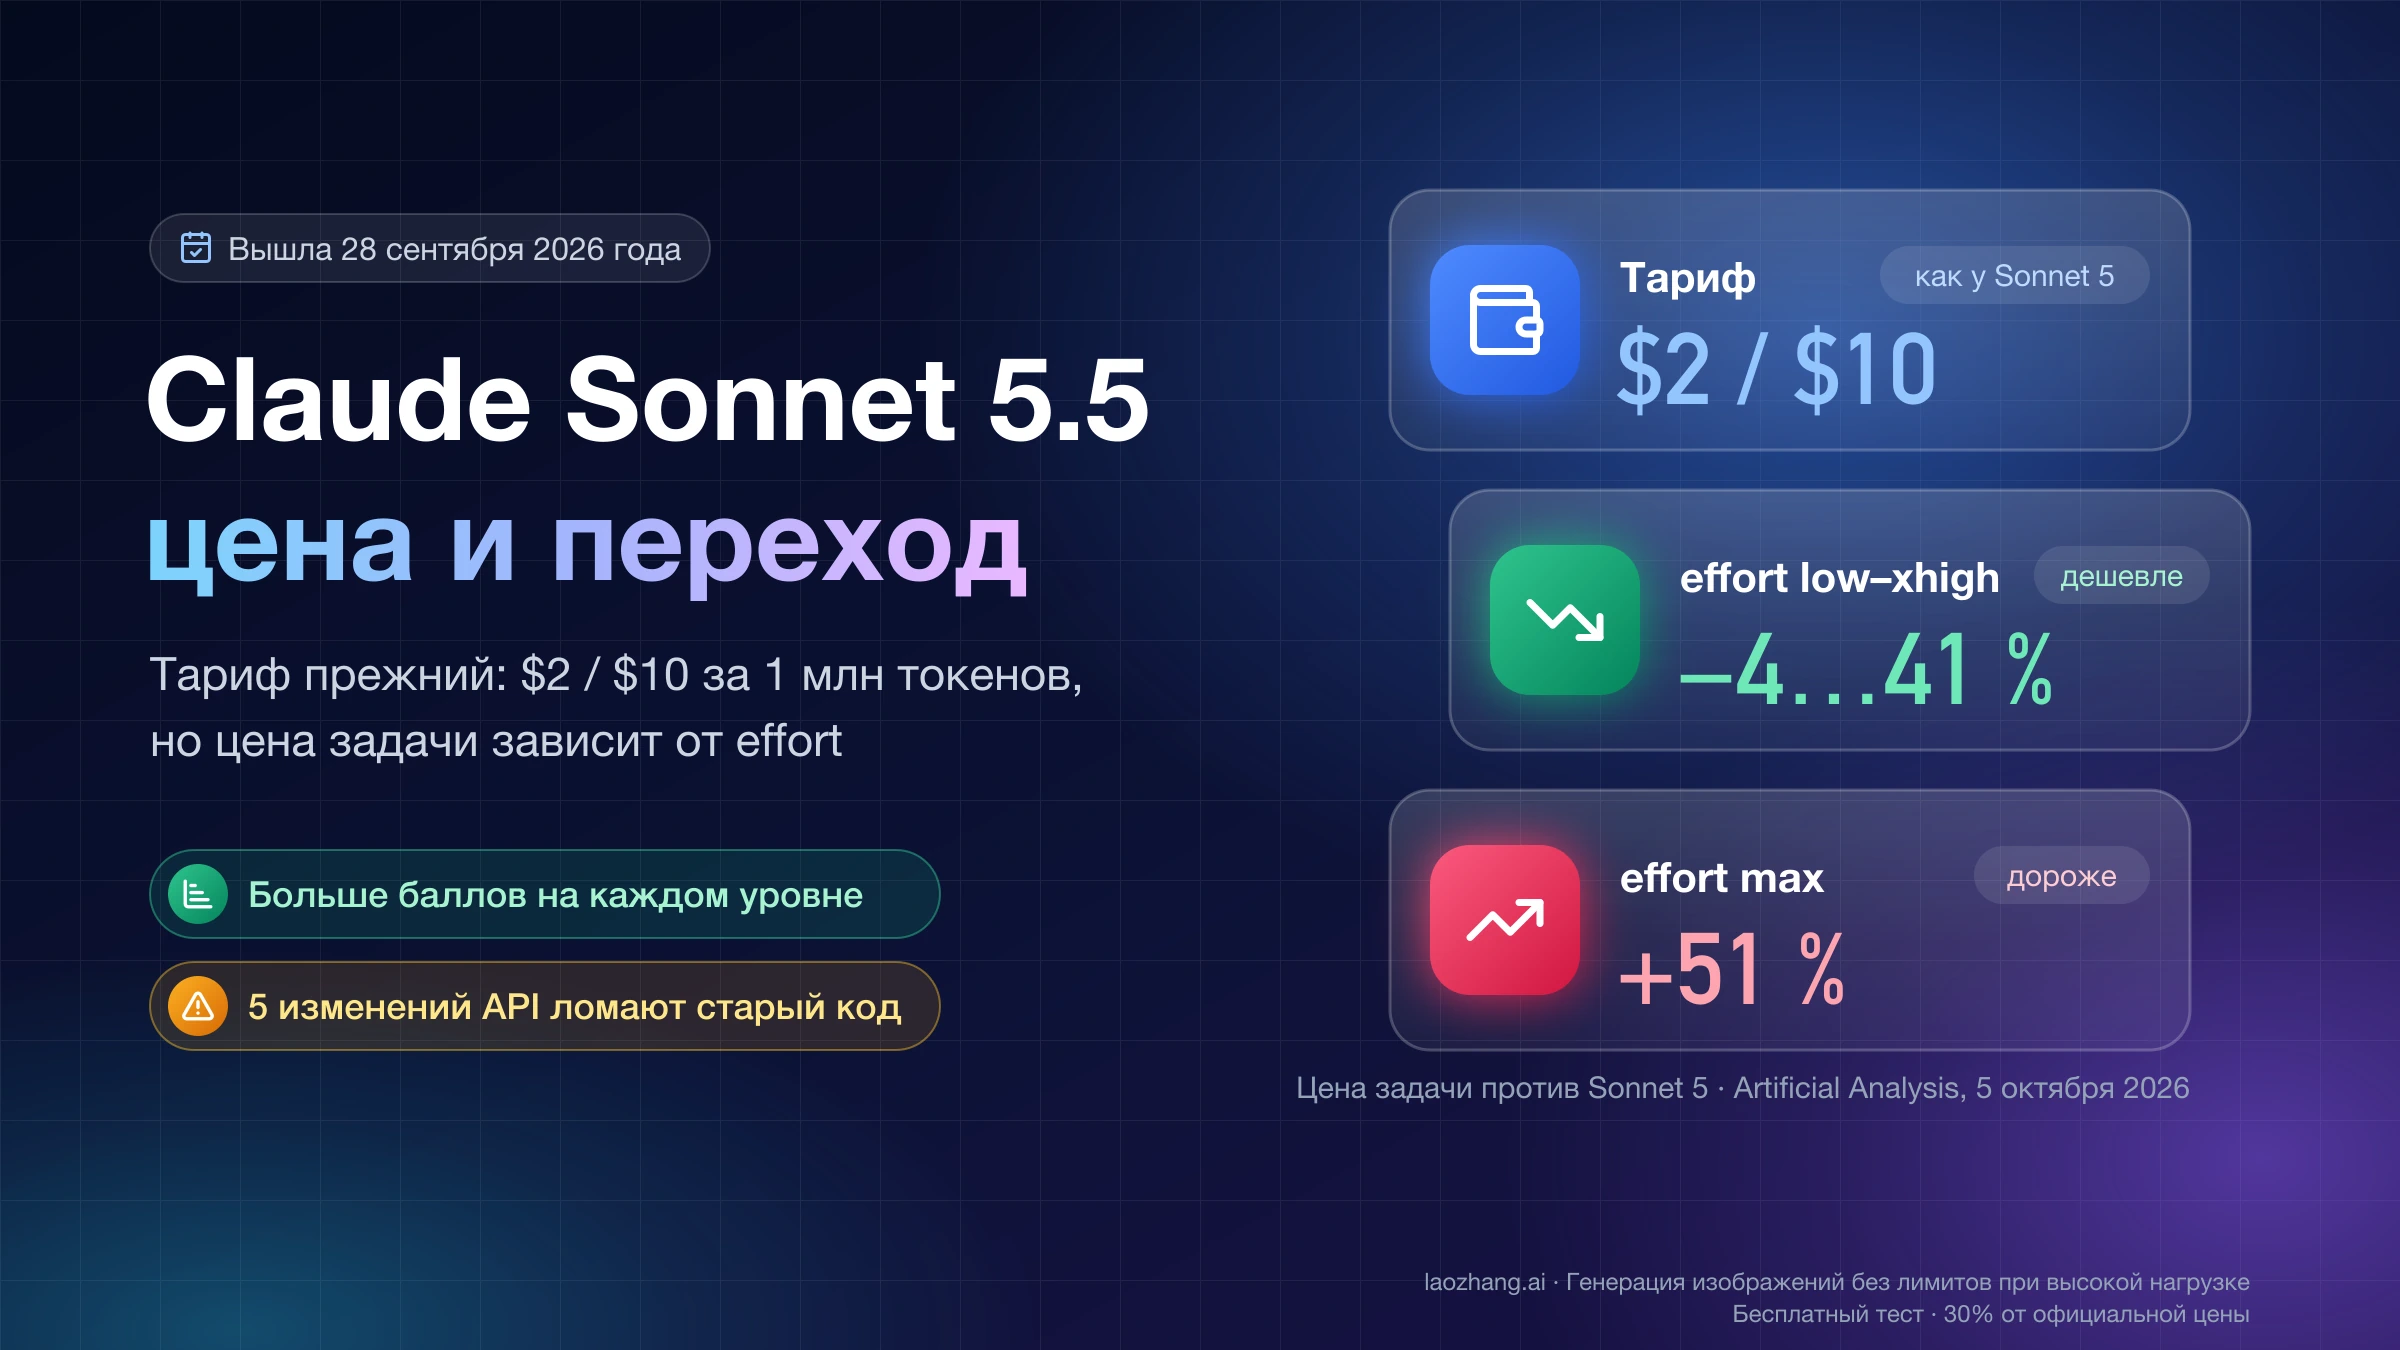
Цена кэша считается от входной цены модели: запись на 5 минут стоит 1,25× входа, запись на час — 2×, чтение — 0,1×, но у новых моделей чтение дешевле. По состоянию на 30 октября 2026 года множитель чтения у Opus 5.5 и Sonnet 5.5 равен 0,05×, у Fable 5.1 — 0,025×, а Haiku 5.5 и более ранние модели остались на 0,1× (таблица цен в документации Anthropic по prompt caching). Цены в долларах США за 1 млн токенов:
| Модель | Вход | Запись, 5 мин | Запись, 1 ч | Чтение кэша | Чтение от входа | Выход |
|---|---|---|---|---|---|---|
| Claude Fable 5.1 | $10 | $12,50 | $20 | $0,25 | 0,025× | $50 |
| Claude Opus 5.5 | $4 | $5 | $8 | $0,20 | 0,05× | $20 |
| Claude Sonnet 5.5 | $2 | $2,50 | $4 | $0,10 | 0,05× | $10 |
| Claude Haiku 5.5, запрос до 100 000 токенов | $0,10 | $0,125 | $0,20 | $0,01 | 0,1× | $0,50 |
| Claude Haiku 5.5, запрос свыше 100 000 токенов | $0,50 | $0,625 | $1 | $0,05 | 0,1× | $2,50 |
| Claude Opus 5 | $5 | $6,25 | $10 | $0,50 | 0,1× | $25 |
| Claude Sonnet 5 | $2 | $2,50 | $4 | $0,20 | 0,1× | $10 |
| Claude Sonnet 4.6 | $3 | $3,75 | $6 | $0,30 | 0,1× | $15 |
| Claude Haiku 4.5 | $1 | $1,25 | $2 | $0,10 | 0,1× | $5 |
Из-за этих исключений привычная «скидка 90 % на чтение» верна только для Haiku и старых моделей. На Opus 5.5 и Sonnet 5.5 чтение в 20 раз дешевле входа, а запись на 5 минут дороже чтения в 25 раз (1,25 / 0,05), а не в 12,5 раза, как при множителе 0,1×. На Fable 5.1 этот разрыв уже 50-кратный. Чем дешевле чтение, тем дороже обходится каждый промах, когда вместо чтения снова идёт запись.
Множители складываются с другими скидками и надбавками: пакетной обработкой (Batch API), тарифом длинного контекста и надбавкой за хранение данных в выбранном регионе (data residency). У Haiku 5.5 закэшированные токены входят в длину запроса, поэтому если чтение, запись и новый текст вместе превышают 100 000 токенов, весь запрос считается по второй строке Haiku в таблице, включая чтение по $0,05.
Чтение у Sonnet 5.5 подешевело вдвое 7 октября 2026 года; что это меняет в конкретном счёте, разобрано в статье «Claude Sonnet 5.5: цена чтения кэша $0,10 — расчёт экономии». Остальные тарифы флагманов, включая выход и пакетные цены, собраны в статьях «Цена Claude Fable 5.1 API: тарифы, кэш и расчёт счёта» и «Claude Opus 5.5: цена API и как сбросить лимит подписки».
Сколько экономит кэш: расчёт для 7 882 и 80 000 токенов
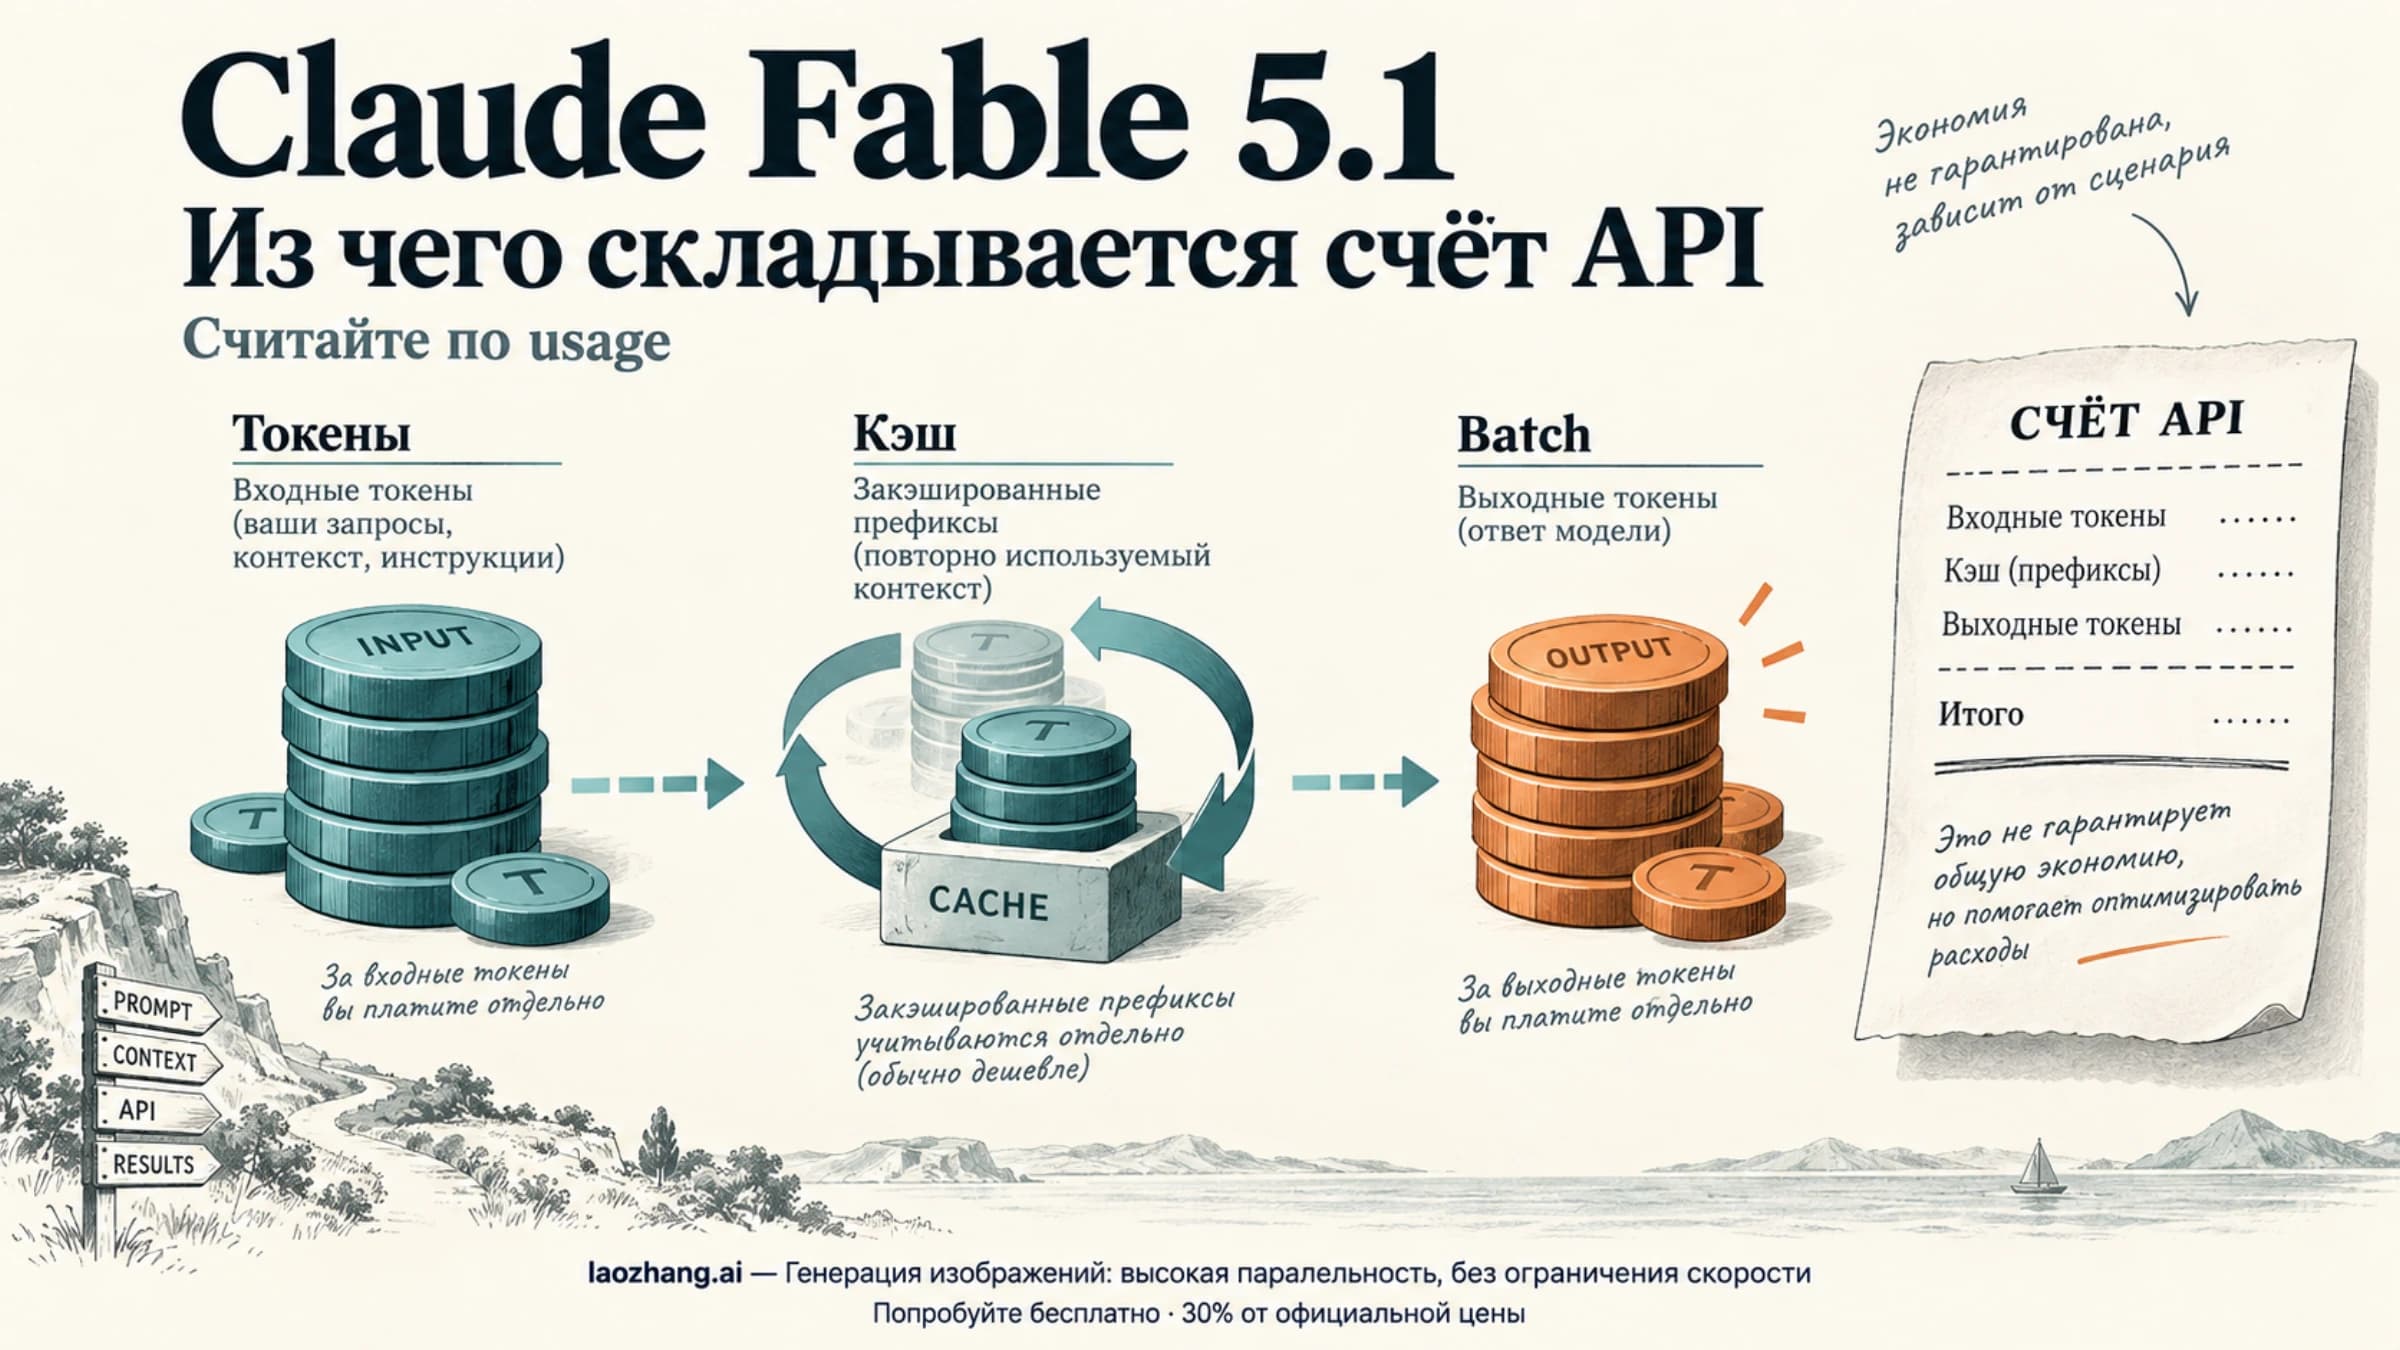
Экономию считают только по входу: число и цену выходных токенов кэш не меняет. Для N запросов с одинаковым префиксом в P токенов, которые укладываются в срок жизни кэша, формула такая: без кэша платится P × N × цена входа, с кэшем — P × цена записи + P × (N − 1) × цена чтения.
На префиксе из теста, 7 882 токена на Sonnet 5.5, десять запросов подряд без кэша стоят $0,1576 (7 882 × 10 × $2 за 1 млн). С 5-минутным кэшем выходит $0,0268: одна запись за $0,0197 и девять чтений за $0,0071, то есть на 83 % меньше. С часовым кэшем запись стоит $0,0315, итог $0,0386, экономия 75,5 %.
Чем длиннее префикс и чем больше запросов, тем ближе экономия к пределу, который задаёт множитель чтения. Для префикса 80 000 токенов и 20 запросов в пределах TTL входная часть стоит так:
| Модель | Без кэша | Кэш 5 мин | Экономия | Кэш 1 ч | Экономия |
|---|---|---|---|---|---|
| Fable 5.1 | $16,00 | $1,38 | 91,4 % | $1,98 | 87,6 % |
| Opus 5.5 | $6,40 | $0,704 | 89,0 % | $0,944 | 85,2 % |
| Sonnet 5.5 | $3,20 | $0,352 | 89,0 % | $0,472 | 85,2 % |
| Haiku 5.5 | $0,16 | $0,025 | 84,2 % | $0,031 | 80,5 % |
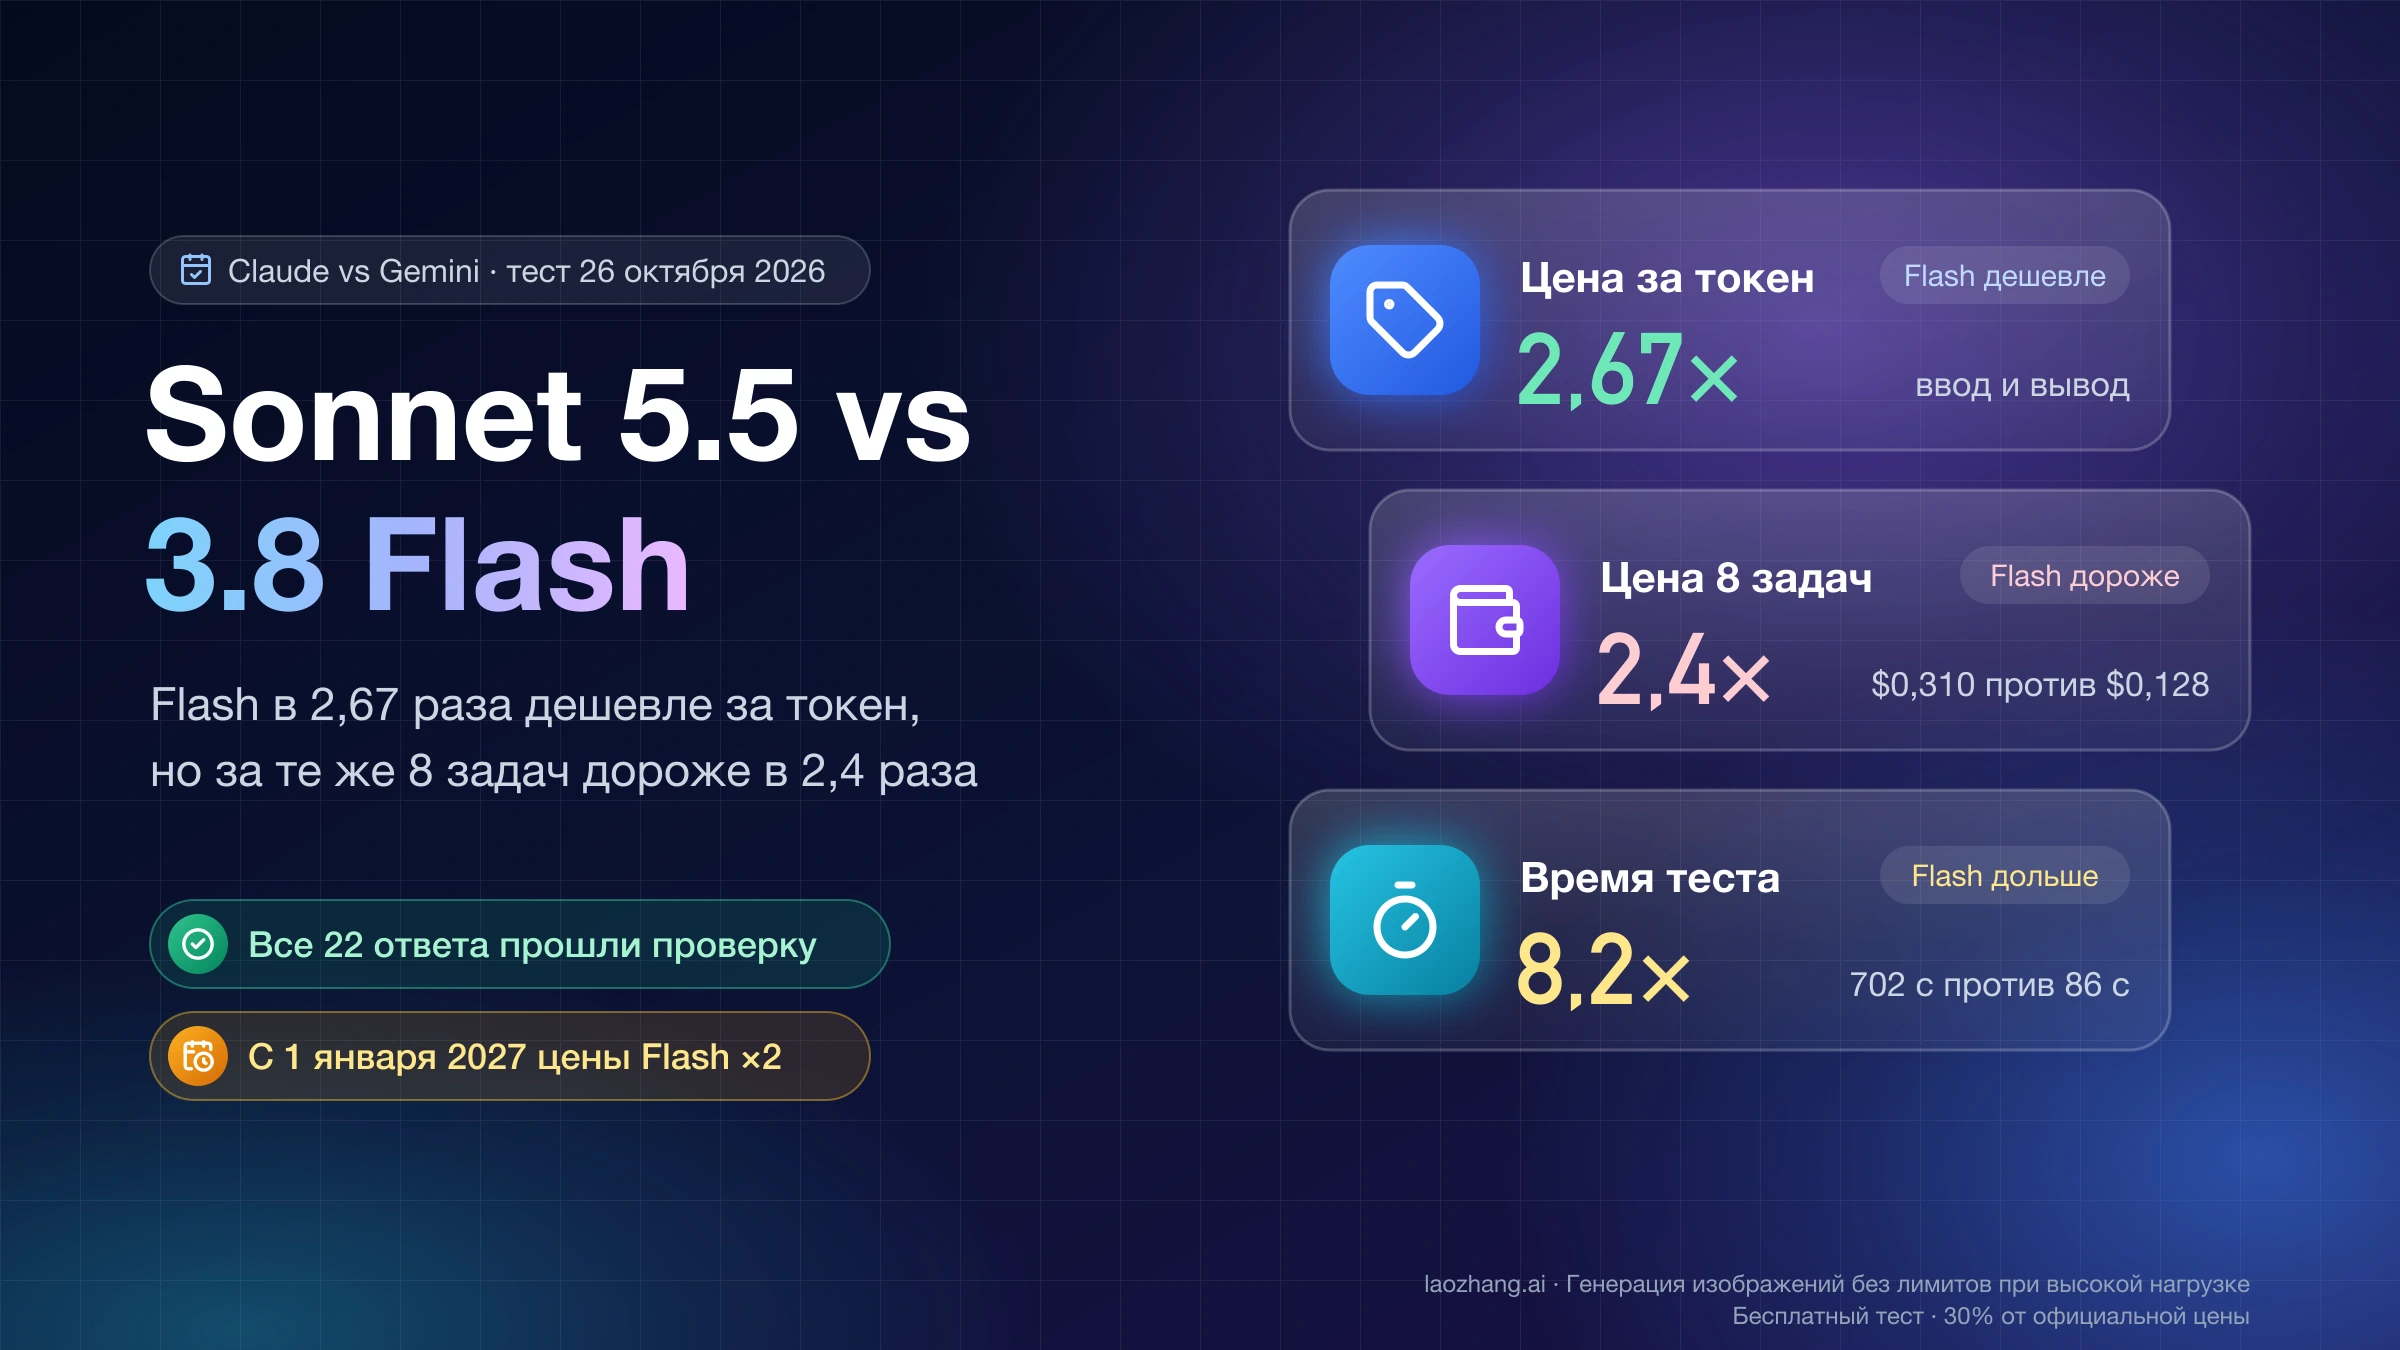
Haiku 5.5 экономит в процентах меньше остальных, потому что его чтение стоит 0,1× входа, а не 0,05×. Пример для Haiku остаётся в первой ценовой ступени: 80 000 токенов префикса плюс короткий вопрос не дотягивают до 100 000. Если же вы выбираете между Haiku и Sonnet по стоимости задачи целиком, а не только по кэшу, полезнее сравнение «Claude Haiku 5.5 или Sonnet 5.5: что выбрать по цене задачи».
TTL 5 минут или 1 час: когда кэш дороже, чем без него
Выбор TTL зависит от того, как часто приходит запрос с тем же префиксом. Если чаще, чем раз в 5 минут, оставайтесь на 5-минутном кэше: он окупается уже со второго запроса (запись 1,25 плюс чтение 0,05 дают 1,30 входной цены против 2,00 без кэша на Opus и Sonnet 5.5; на Haiku 5.5 — 1,35 против 2,00), а продление при каждом чтении ничего не стоит. Если паузы длиннее 5 минут, но короче часа, как в чате с живым пользователем или у агента, который долго работает в стороне, ставьте "ttl": "1h". Запись на час стоит 2×, поэтому такой кэш окупается только с третьего запроса (2 + 2 × 0,05 = 2,10 против 3,00), а при двух запросах он чуть дороже работы без кэша (2,05 против 2,00).
Срок жизни отсчитывается от начала запроса, который записал или прочитал кэш, а не от конца ответа. Если ответ стримится 4 минуты, на следующий запрос с тем же префиксом при TTL 5 минут остаётся около минуты. В одном запросе можно смешивать оба TTL, но точки с часовым сроком должны стоять раньше 5-минутных.
Кэш стоит дороже, чем без него, в трёх ситуациях. Разовый запрос платит 1,25× или 2× за кэшируемую часть и ничего не читает. Запросы с интервалом больше TTL каждый раз переписывают префикс заново: для 100 000 токенов на Sonnet 5.5 и одного запроса раз в 10 минут час работы стоит $1,20 без кэша, $1,50 с 5-минутным кэшем (+25 %) и $0,45 с часовым (одна запись за $0,40 и пять чтений по $0,01). Параллельный холодный старт тоже платит несколько записей, потому что запись становится доступной только после того, как начался первый ответ.
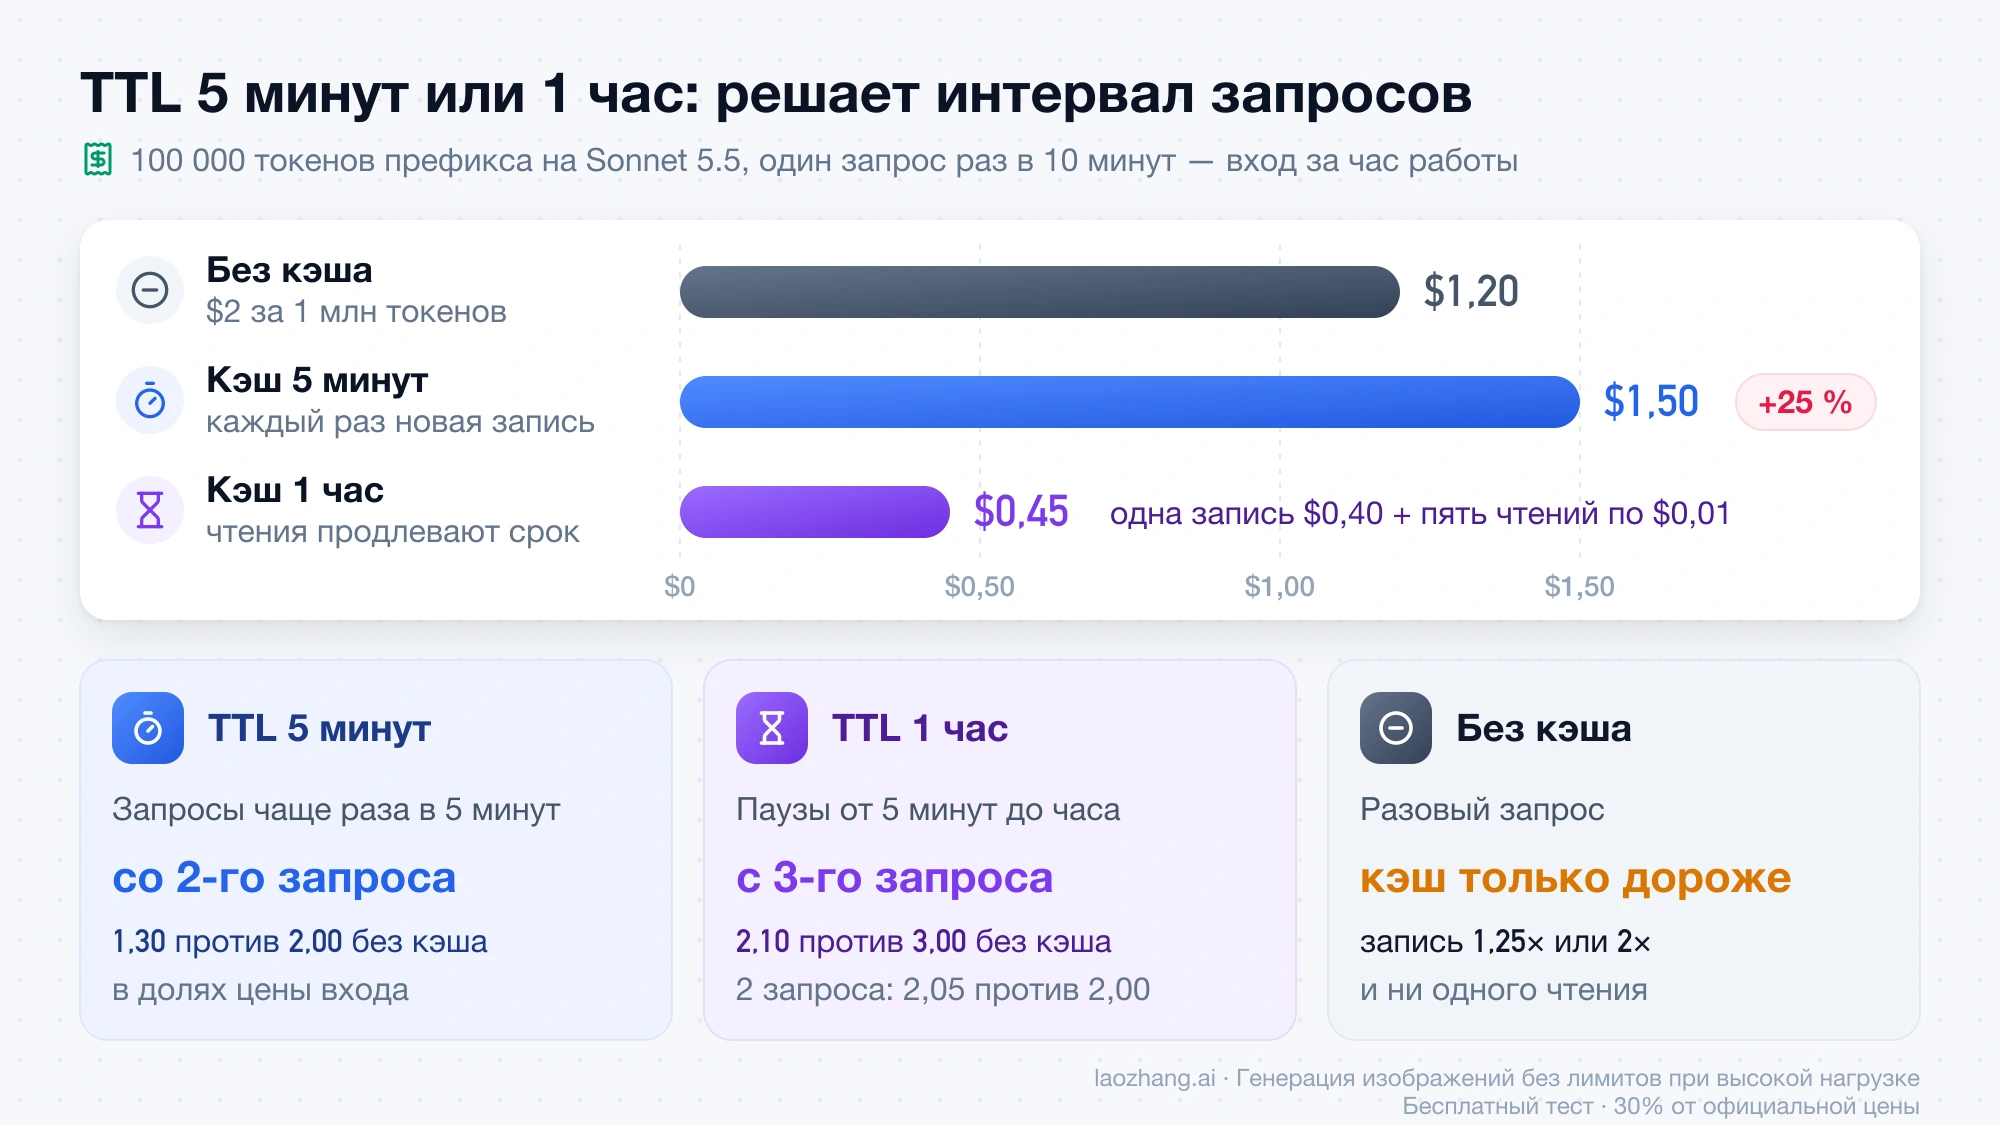
Тест 30 октября 2026 года через LaoZhang показал эти границы на практике. Запись с TTL 5 минут, прочитанная через 6 секунд, после 6 минут 20 секунд простоя уже не нашлась, и тот же префикс на 7 882 токена записался заново. Запись с "ttl": "1h" прочиталась и через 7 минут простоя. Три одинаковых запроса, отправленные одновременно, записали префикс трижды, что стоит $0,0591 вместо $0,0213 при схеме «одна запись, потом два чтения». Поэтому параллельные запросы с общим префиксом отправляйте после того, как первый начал отвечать.
Как понять по полям usage: запись, чтение или промах
Кэш виден только в объекте usage ответа (при стриминге — в событии message_start): при промахе ошибки нет, запрос просто стоит дороже. Полный вход складывается из трёх полей: cache_read_input_tokens + cache_creation_input_tokens + input_tokens, причём input_tokens — это только токены после последней точки кэширования, а не весь вход.
Поле usage | Что означает | Значение в тесте 30.10.2026, Sonnet 5.5 |
|---|---|---|
cache_creation_input_tokens | Токены, записанные в кэш этим запросом, оплачиваются по цене записи | 7 882 на первом запросе, 0 на повторах |
cache_read_input_tokens | Токены, прочитанные из кэша, оплачиваются по цене чтения | 0 на первом запросе, 7 882 на втором и третьем |
input_tokens | Токены после последней метки по полной цене входа | 28, затем 16 и 17 (только вопрос) |
cache_creation.ephemeral_5m_input_tokens и ephemeral_1h_input_tokens | Разбивка записи по TTL, сумма равна cache_creation_input_tokens | В ответе /v1/messages через LaoZhang с TTL 1 час этого объекта не было |
По этим полям запрос раскладывается на четыре случая. Запись (cache_creation_input_tokens больше нуля, чтение равно нулю) нормальна для первого запроса и для новой части диалога. Чтение (cache_read_input_tokens больше нуля) означает попадание. Повторная запись того же объёма там, где ожидалось чтение, — промах, и причину нужно искать по списку ниже. Если оба поля равны нулю, кэширования не было вовсе: в тесте 30 октября системные префиксы на 180 и 377 токенов с меткой cache_control дали 0 и 0 при HTTP 200 без всякой ошибки, а префиксы на 567 и 1 094 токена записались и прочитались, как положено при минимуме 512 токенов у Sonnet 5.5.
Почему нет попаданий в кэш: проверка по порядку
Если cache_read_input_tokens остаётся нулём, проверяйте причины в таком порядке, от самых частых к редким:
- Оба поля кэша равны нулю — префикс короче минимума модели. Для Fable 5.1, Opus 5.5, Opus 5, Sonnet 5.5 и Haiku 5.5 это 512 токенов, для Opus 4.8, Sonnet 5 и Sonnet 4.6 — 1 024, для Opus 4.7 — 2 048, для Opus 4.6, Opus 4.5 и Haiku 4.5 — 4 096. Если не хватает немного, выгодно дополнить кэшируемую часть до порога.
- Каждый запрос записывает один и тот же объём заново — что-то выше метки меняется. Ищите дату, идентификатор запроса или имя пользователя в
system, другой порядок инструментов, а в Swift и Go ещё и случайный порядок ключей JSON в блокахtool_use. Самый быстрый способ — сравнить тела двух запросов побайтно. - Метка стоит на блоке, который меняется. С автоматическим кэшированием так бывает, когда последний блок содержит время или контекст запроса; перенесите явную точку на последний неизменный блок.
- Между запросами прошло больше TTL. Сверьте время запросов и учтите, что долгий стриминг съедает срок жизни.
- Запросы ушли параллельно до первого ответа. Отправляйте остальные после того, как первый начал отвечать.
- Сменилась модель. У каждой модели свой кэш: в тесте 30 октября
claude-opus-5-5записал те же 7 882 токена заново, хотя Sonnet 5.5 их уже закэшировал, и прочитал только со второго вызова. - Изменились параметры запроса. Смена определений инструментов сбрасывает весь кэш; переключение веб-поиска, цитат или быстрого режима (
speed) сбрасываетsystemиmessages; сменаtool_choiceи добавление или удаление изображений сбрасываютmessages. Смена параметров thinking иoutput_config.effortвсегда сбрасываетmessages, аtoolsиsystem— в зависимости от модели. На Sonnet 5.5 в тесте 30 октября переход effort с low на medium и обратно сохранил кэш системного промпта. - Запросы идут из разных рабочих пространств. В Claude API кэш одного workspace не виден другому, даже внутри одной организации.
- Диалог вырос больше чем на 20 блоков с последней записи. Добавьте вторую точку ближе к началу, чтобы запись накопилась там заранее.
В Claude API часть этой проверки делает за вас cache diagnostics. Добавьте в первый запрос "diagnostics": {"previous_message_id": null}, а в следующие — id предыдущего ответа, и ответ покажет, где разошёлся префикс: в модели, system, tools или messages; значение diagnostics: null означает, что расхождения нет (документация Anthropic по cache diagnostics). Функция заявлена только для Claude API: через LaoZhang 30 октября 2026 года запрос с этим полем проходил с HTTP 200, но поле diagnostics в ответ не возвращалось, и промах после смены системного промпта остался без объяснения.
Кэш через шлюз и OpenAI-совместимый API: результаты LaoZhang
Через шлюз кэш работает, если тот передаёт cache_control в Anthropic без изменений, но шлюз может вести себя иначе, чем описано в документации Anthropic, и увидеть это можно только по usage и списаниям. LaoZhang в своей документации по Claude-протоколу заявляет поддержку кэша на 5 минут и 1 час для моделей Claude, и в тесте 30 октября 2026 года оба срока работали. Цены входа, выхода и чтения кэша для claude-opus-5-5, claude-sonnet-5-5, claude-haiku-5-5 и claude-fable-5-1 в прайсе LaoZhang совпадают с ценами Anthropic. Все 51 тестовый запрос списали $0,471, а пересчёт каждого usage по официальным ставкам записи и чтения дал $0,469.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
От документации Anthropic поведение через этот шлюз отличалось в двух местах. Системный промпт кэшировался даже без cache_control: первый запрос записал 7 882 токена, второй их прочитал. На счёте это видно сразу: первый такой запрос на Sonnet 5.5 списал $0,019788 по ставке 5-минутной записи вместо $0,015846 без кэша (+25 %), а повтор — $0,000872. Кроме того, метка на блоке с меткой времени, которая по документации никогда не даёт чтения, через шлюз всё равно читала системную часть (7 882 токена) и дописывала 31–48 токенов хвоста. Похоже, шлюз или его вышестоящий маршрут сам помечает системный промпт; напрямую через API Anthropic это не проверялось, поэтому в коде на такое поведение не полагайтесь и ставьте метки явно. Для разовых запросов с длинным системным промптом это означает доплату 25 % за запись, которую вы не заказывали.
Через OpenAI-совместимый эндпоинт /v1/chat/completions LaoZhang тоже кэшировал системное сообщение на 7 882 токена, хотя полей кэша в запросе не было. Запись в ответе видна как prompt_tokens_details.cached_creation_tokens: 7882, чтение — как prompt_tokens_details.cached_tokens: 7882, а рядом приходят и привычные поля Anthropic (cache_creation_input_tokens, cache_read_input_tokens). prompt_tokens в этом формате (7 893) уже включает закэшированные токены, поэтому при подсчёте стоимости вычитайте их, иначе весь вход окажется посчитан по полной цене.
Ещё три отличия касаются вспомогательных функций. В ответе с TTL 1 час нет объекта cache_creation с разбивкой по срокам, cache diagnostics не возвращается, а эндпоинта /v1/messages/count_tokens у LaoZhang нет, так что длину префикса до минимума модели (512 токенов у моделей 5.5) проверяйте по usage первого ответа. Все эти наблюдения сделаны на одном аккаунте, одном префиксе в 7 882 токена и в один день; задержку тест не сравнивал: при такой длине ответ приходил примерно за 3 секунды и с кэшем, и без него.
Прогрев кэша Claude: max_tokens 0 и max_tokens 1
Прогрев нужен, чтобы первый пользователь не ждал полной обработки длинного префикса. В Claude API для этого отправляют запрос с "max_tokens": 0: API записывает кэш в точке с меткой и сразу возвращает пустой content, stop_reason: "max_tokens" и заполненный usage, выходные токены не оплачиваются, а запись оплачивается как обычно. Метку ставят явно на последний блок, общий с будущими запросами (системный промпт или инструменты), а не на сообщение-заглушку, и с теми же настройками thinking и effort, иначе прогретая запись не совпадёт с реальным трафиком. С stream: true, thinking.type: "enabled", структурированным выводом, tool_choice типа tool или any и внутри Message Batches такой запрос отклоняется (раздел о прогреве в документации Anthropic по prompt caching).
Через LaoZhang 30 октября 2026 года "max_tokens": 0 сработал не так: пришёл обычный ответ со stop_reason: end_turn и 46 выходными токенами, хотя запись на 7 882 токена прошла, и следующий запрос её прочитал. Судя по всему, шлюз считает ноль незаданным значением. Старый приём с "max_tokens": 1 там работает предсказуемо: один выходной токен, запись 7 882, затем чтение. Через этот шлюз прогревайте кэш запросом с единицей и не рассчитывайте на нулевую стоимость выхода.
Кэширование промптов Claude: другие вопросы
Кэширует ли Claude Code промпты сам и какой там TTL?
Да, Claude Code управляет кэшем автоматически. По документации Claude Code на 30 октября 2026 года, с подпиской Claude в пределах лимитов плана основной диалог кэшируется на 1 час, а субагенты и сжатие контекста — на 5 минут; с API-ключом, кредитами или облачным провайдером срок жизни — 5 минут, и его можно изменить настройкой promptCacheTtl или переменной CLAUDE_CODE_PROMPT_CACHE_TTL. Почему отдельный ход внезапно оказывается дорогим, разобрано в статье «Claude Code cache miss и стоимость токенов: почему один turn внезапно дорогой».
Учитываются ли попадания в кэш в лимитах скорости Claude API?
По документации Anthropic по prompt caching, попадания в кэш не вычитаются из лимита скорости, поэтому длинный закэшированный префикс помогает и с лимитами, а не только со счётом. Если вы всё равно получаете 429, сначала выясните, какой именно лимит сработал: об этом статья «Claude API Rate Limit Reached: сначала найдите владельца лимита».
Меняет ли кэш ответ модели Claude?
Нет. По документации Anthropic, кэширование не влияет на генерацию: ответ такой же, каким был бы без кэша, меняются только стоимость входа и время обработки префикса.
Источники2
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 30 окт. 2026 г..
Источники2
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 30 окт. 2026 г..