Gemini 4 Argon API: доступ, finish_reason и обрыв ответа
Argon в API — только на платном уровне. CONTINUATION: повторить запрос с continuationToken; пустой MAX_TOKENS: поднять лимит. OpenAI-эндпоинт не продолжает.
Содержание
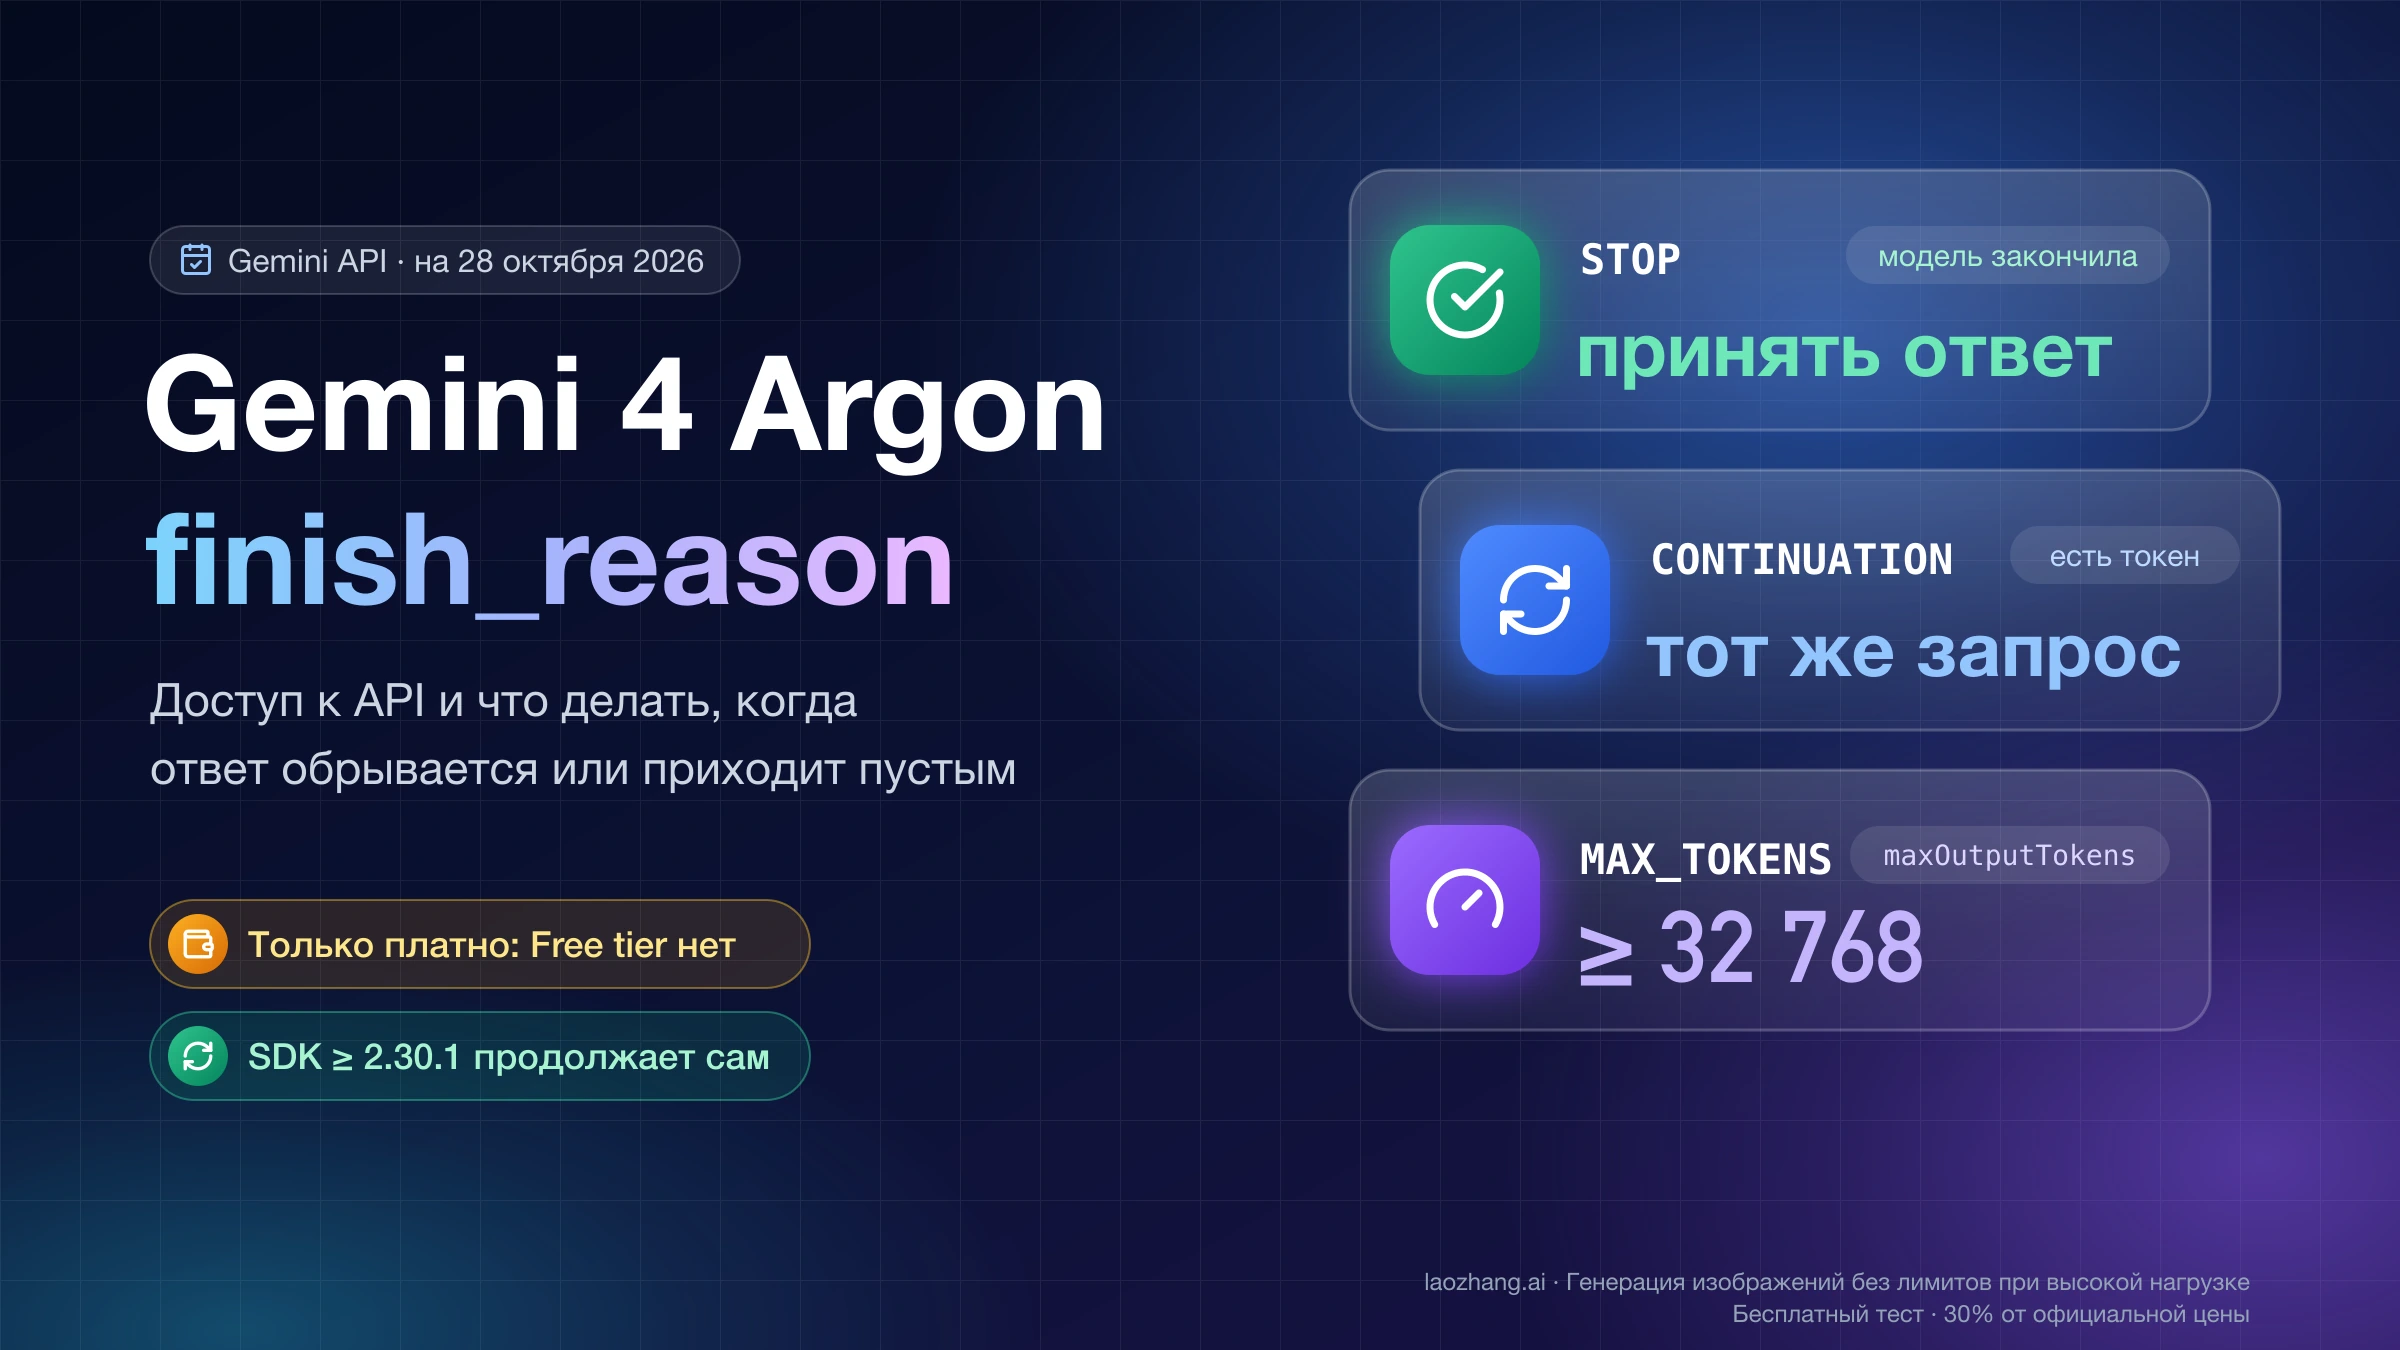
Если ответ gemini-4-argon обрывается или приходит пустым, смотрите на два поля: finishReason (в Python SDK и OpenAI-формате — finish_reason) и continuationToken. CONTINUATION вместе с токеном означает, что модель не закончила и ждёт следующего запроса: отправьте тот же запрос ещё раз и приложите токен. Google GenAI SDK делает это сам, начиная с Python google-genai 2.30.1 и JavaScript @google/genai 2.29.1. MAX_TOKENS, особенно с пустым текстом, означает, что кончился ваш maxOutputTokens: Argon расходует его и на размышления, поэтому Google советует ставить не меньше 32 768, а для длинных ответов — больше 65 536. Без этих настроек вывод останавливается на 64K токенов в потоковом режиме и на 32K в непотоковом REST.
Исключение — маршруты, где продолжать нечем. OpenAI-совместимый эндпоинт Google генерацию не продолжает вовсе: ответ останавливается на лимите одного запроса, и OpenAI-совместимый маршрут проверенного шлюза вёл себя так же. Если ваш API-шлюз не возвращает continuationToken, продолжение тоже невозможно, и ответы длиннее 64K дают только нативный Gemini API (SDK или свой цикл) или Interactions API с background: true. Сам доступ к Argon в Gemini API — только платный: бесплатного уровня у модели нет.
28 октября 2026 года запросы к Argon отправлялись через один API-шлюз, по нативному generateContent и по OpenAI-совместимому /v1/chat/completions, а поведение SDK google-genai 2.33.0 и 2.29.0 проверялось на локальном мок-сервере. Прямого ключа Google в этой проверке не было, и настоящий CONTINUATION на проверенном маршруте не пришёл ни разу, поэтому всё о прямом API ниже описано по документации Google по состоянию на 28 октября 2026 года. Длинную генерацию (long decode) до конца довести не удалось: запросы на 33 000 токенов обрывались примерно на 300-й секунде.
Как получить доступ к API Gemini 4 Argon: оплата, ID модели, SDK
Бесплатного доступа к gemini-4-argon через Gemini API нет: по странице цен Gemini API модель не входит в Free tier, а оплачивается каждый токен, включая токены размышлений. Нужен проект с привязанной оплатой, ключ этого проекта, свежий SDK и правильно выставленный лимит вывода; подписка Google AI Pro или Ultra сама по себе вызовы API не включает. Порядок такой:
- Привяжите платёжный аккаунт к проекту Gemini API и внесите предоплату от $5 — это уровень Tier 1. Ключ бесплатного уровня Argon не вызовет, а при нулевом балансе предоплаты ключи перестают работать с HTTP 402.
- В коде указывайте ID
gemini-4-argon: это стабильная модель, общедоступная (GA) с 13 октября 2026 года. - Обновите SDK:
pip install -U "google-genai>=2.30.1"илиnpm install "@google/genai@>=2.29.1". Для других языков минимум такой: Go 1.74.0, Java 1.77.0, .NET 1.26.0, Kotlin 1.6.0. - Задайте
max_output_tokensне меньше 32 768, а для длинного кода и агентных задач — от 65 536. Это общий лимит на размышления и ответ вместе; контекст в 1 048 576 токенов у Argon тоже общий для ввода и вывода. Уберитеtemperature,top_pиtop_k— Argon их игнорирует. Уровень размышлений ставьтеlow,mediumилиhigh(по умолчаниюmedium); значениеminimalмодель отклоняет. - Поставьте тайм-аут чтения 20 минут: непотоковый запрос сервер закрывает через 10 минут, поток — через 20, а тайм-аут в 3–5 минут обрывает запрос раньше сервера. В Python это
genai.Client(http_options=types.HttpOptions(timeout=1_200_000)). - Выберите эндпоинт: нативный
generateContentилиstreamGenerateContent(через SDK или со своим циклом), Interactions API сbackground: trueили OpenAI-совместимыйhttps://generativelanguage.googleapis.com/v1beta/openai/. У последнего продолжения нет.
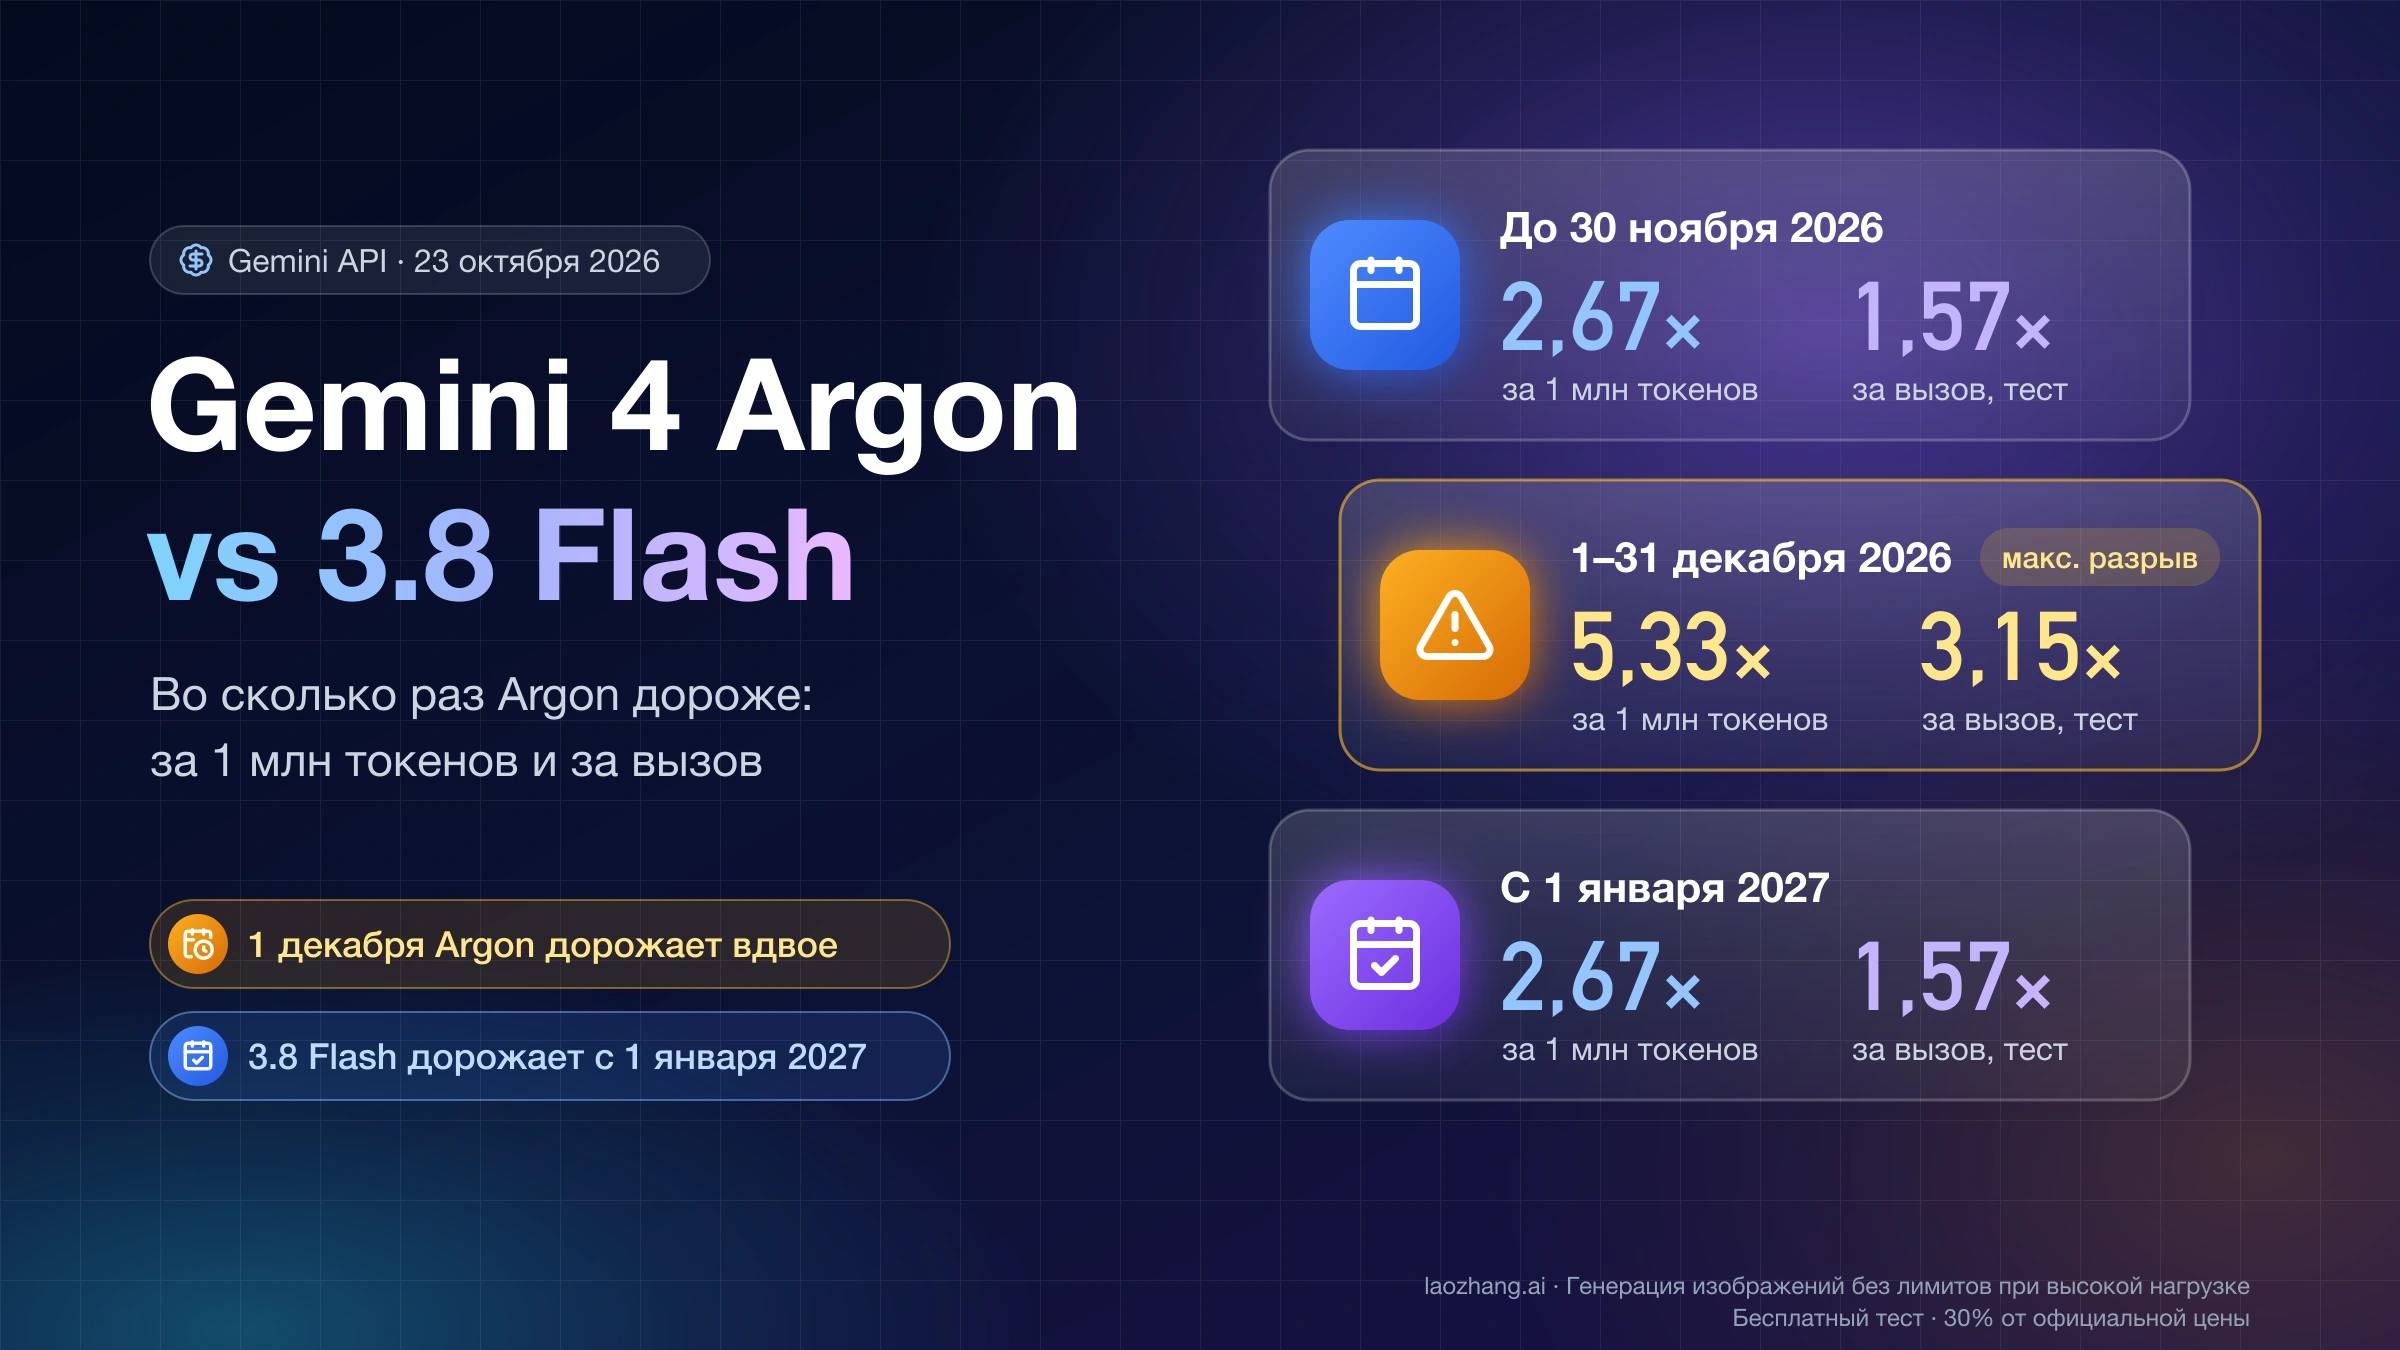
Цена по той же странице Google: $2 за 1 млн входных токенов и $10 за 1 млн выходных (вместе с размышлениями) до 30 ноября 2026 года, с 1 декабря — $4 и $20. Уровни оплаты и ошибки квот разобраны в статье «Лимиты Gemini API: где смотреть, уровни Tier 1–3 и ошибки 429». По состоянию на 28 октября 2026 года России в списке регионов, где доступны Gemini API и AI Studio нет, Беларуси тоже. Если вы обращаетесь к Argon через сторонний API-шлюз, главное для вас — раздел о шлюзах ниже: продолжение там зависит от того, передаёт ли шлюз continuationToken.
Что значит каждый finish_reason у Gemini 4 Argon и что делать
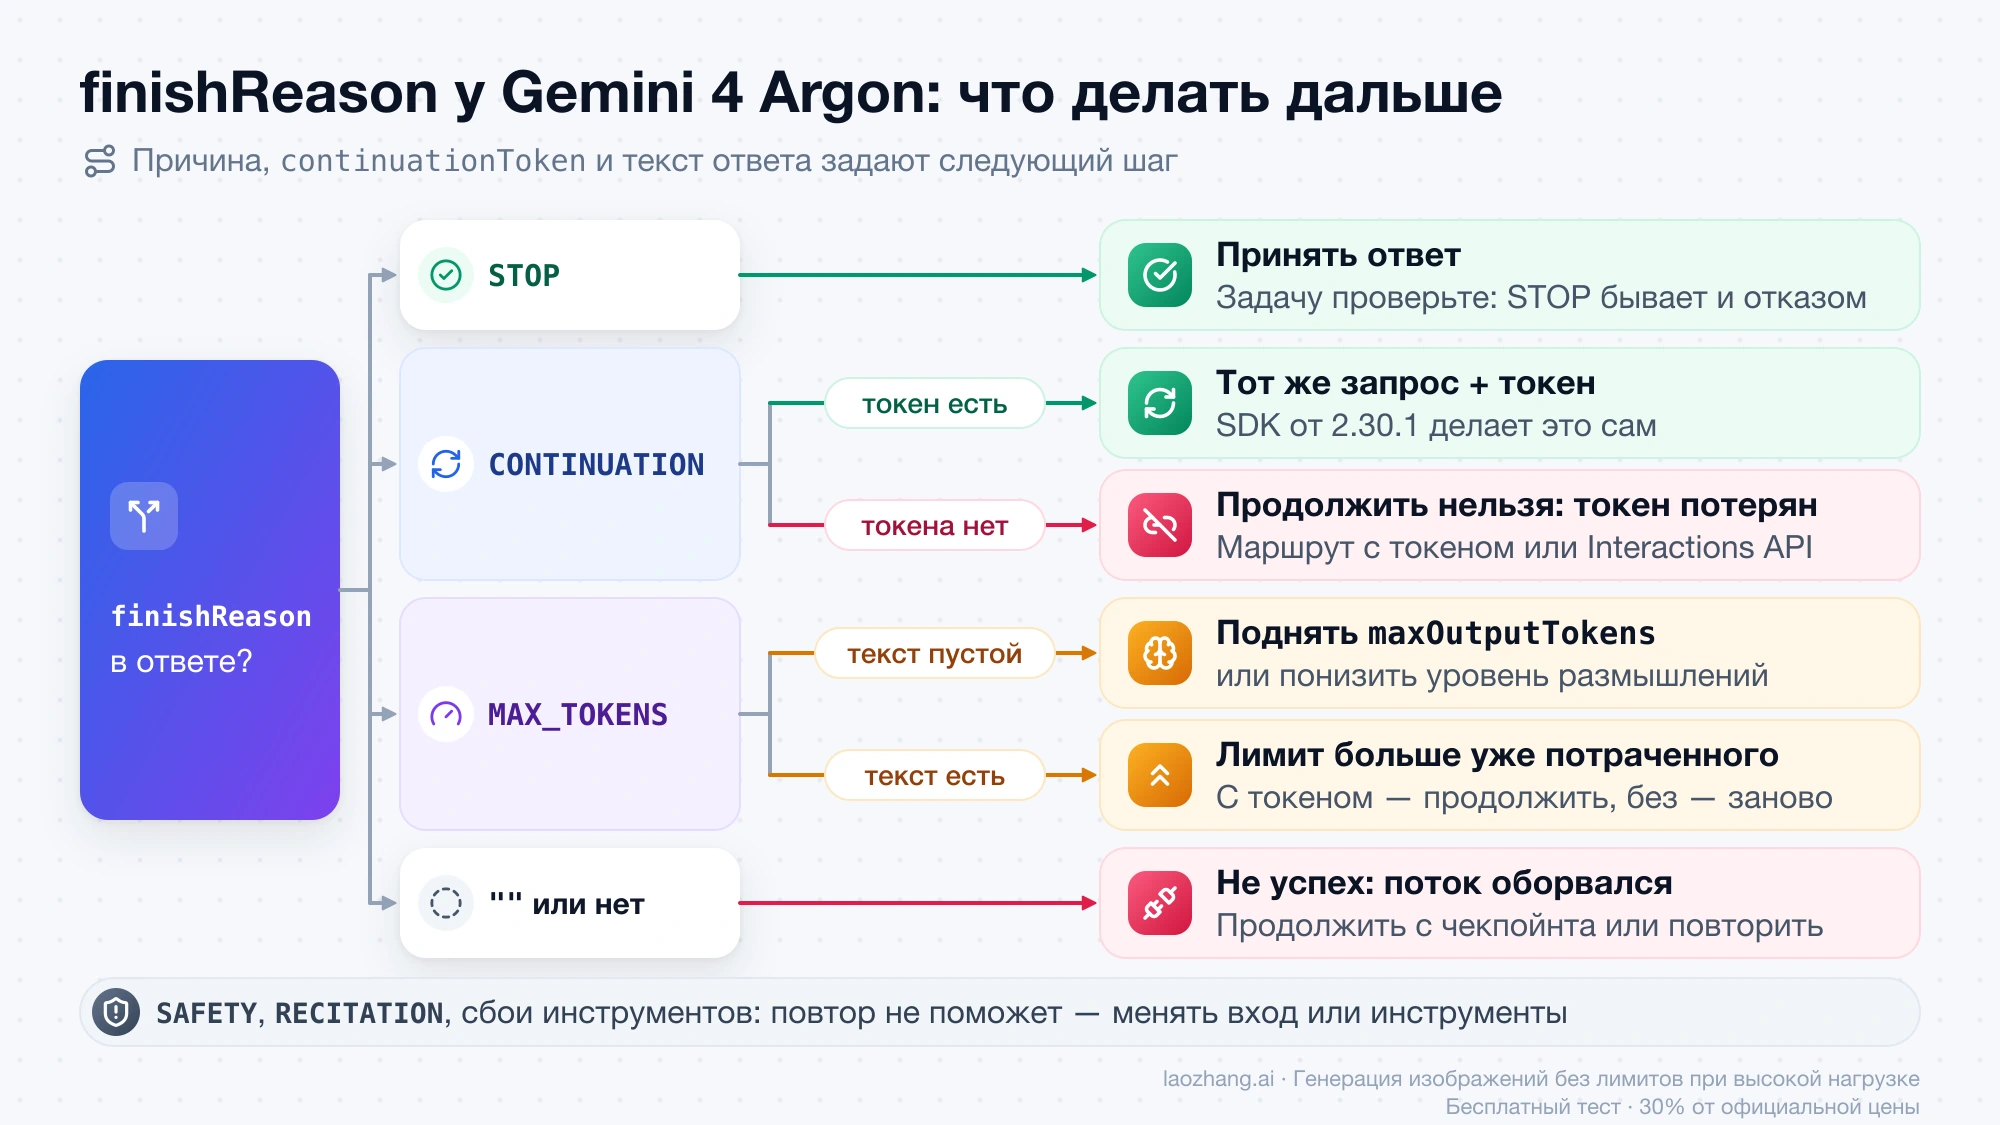
Для кода важны три значения: STOP — принять ответ, CONTINUATION — повторить запрос с токеном, MAX_TOKENS — поднять maxOutputTokens. Остальные причины из справочника generateContent в Gemini API означают, что повтор того же запроса не поможет, пока вы не измените вход, инструменты или аккаунт. Причины, связанные с изображениями (IMAGE_SAFETY, NO_IMAGE и подобные), к Argon не относятся: модель выдаёт только текст.
| finishReason | Что произошло | Что делать коду |
|---|---|---|
STOP | Модель остановилась сама или сработала stop-последовательность | Принять ответ. Выполнена ли задача, проверяйте отдельно: модель может закончить STOP, просто отказавшись |
CONTINUATION и есть токен | Хоп упёрся в лимит одного запроса, а бюджет maxOutputTokens ещё не исчерпан. Текст может быть пустым, если хоп ушёл на размышления — по документации это нормально | Повторить тот же запрос с continuationToken (SDK от 2.30.1 делает это сам) |
CONTINUATION, токена нет | По справочнику токен приходит вместе с CONTINUATION, значит, его потеряли по дороге: старый SDK, прокси или шлюз | Продолжить нельзя. Нужен маршрут, который передаёт токен, или Interactions API |
MAX_TOKENS, текст есть | Израсходован весь maxOutputTokens — это сумма по всем хопам | Если пришёл токен: тот же запрос, токен и maxOutputTokens больше уже потраченного, иначе 400 «Continuation token has already used output tokens…». Без токена — заново с бо́льшим лимитом, оплачиваются оба прогона |
MAX_TOKENS, текст пустой | Весь бюджет ушёл на размышления | Поднять maxOutputTokens или понизить уровень размышлений |
| Поля нет или пустая строка | Оборвались поток или соединение | Не считать успехом, продолжить с последнего чекпойнта или повторить |
SAFETY, PROHIBITED_CONTENT, BLOCKLIST, SPII | Сработал фильтр содержимого | Менять запрос или входные данные; повтор не поможет |
RECITATION, LANGUAGE | Ответ слишком близок к источнику или язык не поддерживается | Переформулировать запрос |
MALFORMED_FUNCTION_CALL, UNEXPECTED_TOOL_CALL, TOO_MANY_TOOL_CALLS | Сбой вызова инструментов; UNEXPECTED_TOOL_CALL — вызов при выключенных инструментах | Исправить объявления инструментов |
MISSING_THOUGHT_SIGNATURE | Не возвращена хотя бы одна подпись размышлений (thought signature) | Отправлять части ответа модели обратно вместе с подписями |
ESCALATION, PUP_LIMITED_DISABLED | Ответ отфильтрован правилом эскалации; аккаунт ограничен за нарушение правил допустимого использования | Записать finishMessage; вопрос не решается повтором |
MALFORMED_RESPONSE, OTHER | Повреждённый ответ или прочая причина | Записать finishMessage и повторить один раз |
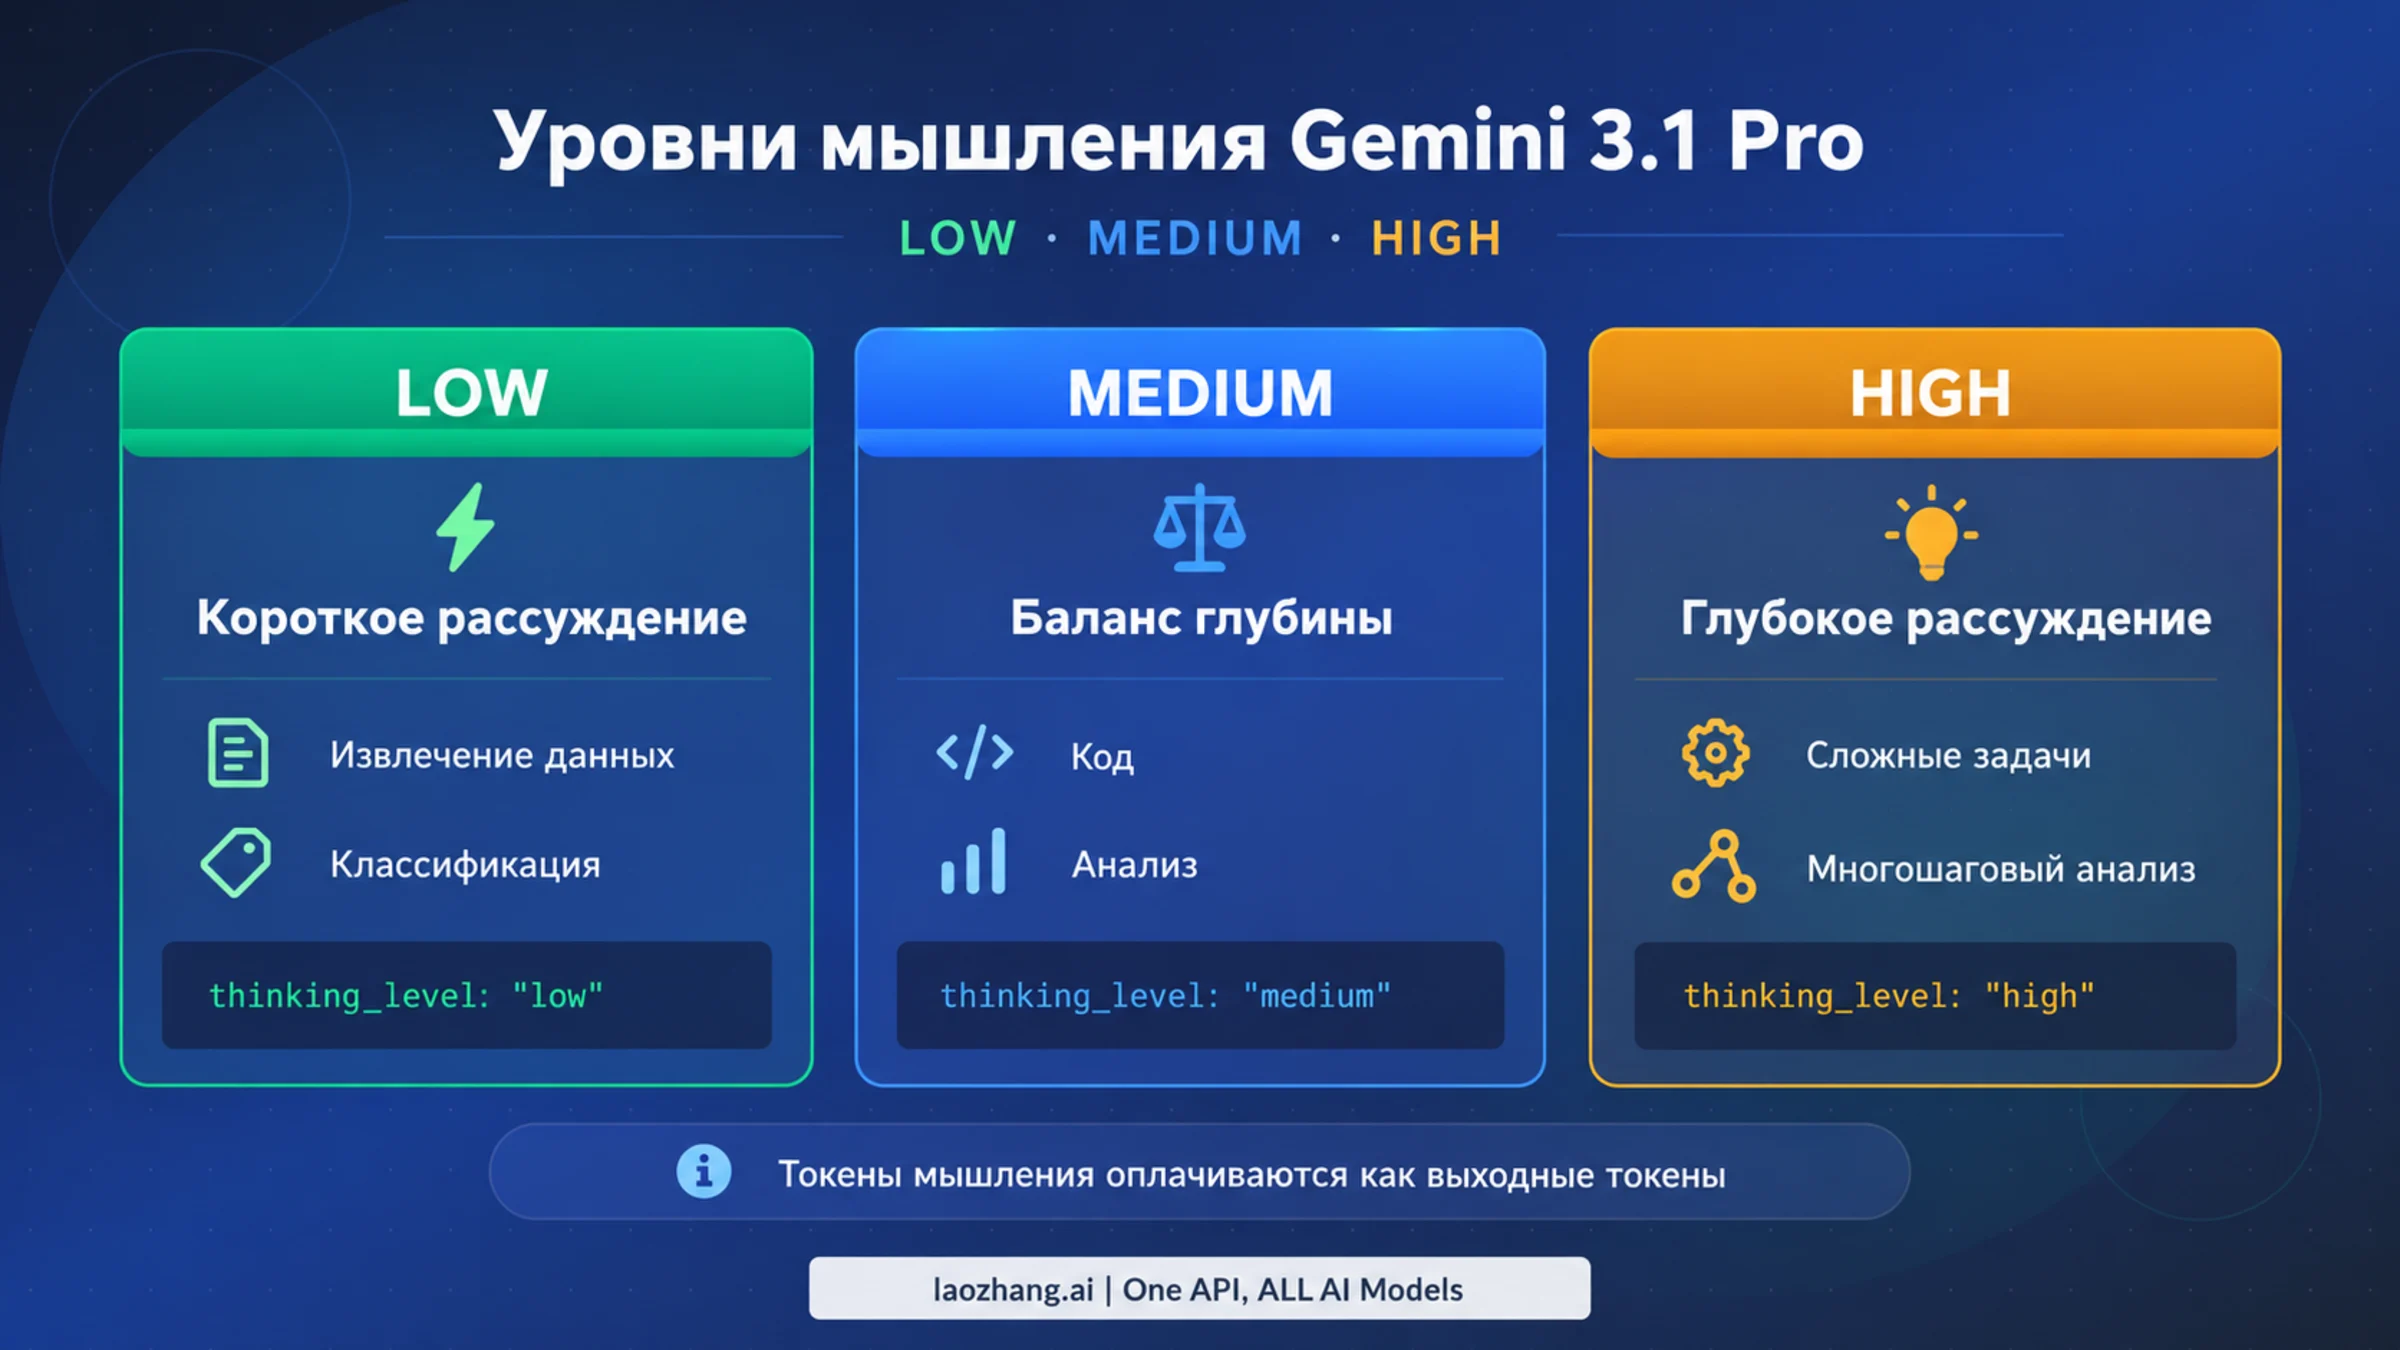
По документации Google, MAX_TOKENS у Argon тоже приходит с continuationToken, но на шлюзе, проверенном 28 октября, токена в таком ответе не было. Поэтому код должен проверять наличие токена, а не предполагать его. При пустом MAX_TOKENS Google предлагает два равноправных пути: поднять maxOutputTokens или понизить уровень размышлений; как устроены уровни, объясняет статья «Как настроить уровни мышления Gemini 3.1 Pro: LOW, MEDIUM, HIGH» — у Argon те же три уровня, только по умолчанию стоит medium, а minimal вызывает ошибку.
То же правило в виде функции. Она не требует зависимостей; 28 октября 2026 года её прогнали на сохранённых ответах шлюза и на четырёх искусственных ответах (CONTINUATION с токеном и без, MAX_TOKENS с токеном, SAFETY), и каждый получил ожидаемое действие.
CONTENT = {"SAFETY", "PROHIBITED_CONTENT", "BLOCKLIST", "SPII", "RECITATION", "LANGUAGE"}
TOOLS = {"MALFORMED_FUNCTION_CALL", "UNEXPECTED_TOOL_CALL", "TOO_MANY_TOOL_CALLS",
         "MISSING_THOUGHT_SIGNATURE", "MALFORMED_RESPONSE"}

def next_action(resp):
    """Ответ generateContent (JSON) -> одно следующее действие."""
    cands = resp.get("candidates") or []
    if not cands:
        return "prompt_blocked" if resp.get("promptFeedback", {}).get("blockReason") else "no_candidate"
    c = cands[0]
    reason = c.get("finishReason") or None   # на шлюзе приходила пустая строка ""
    token = c.get("continuationToken")
    text = "".join(p.get("text", "") for p in (c.get("content") or {}).get("parts") or []
                   if not p.get("thought"))
    if reason is None:
        return "transport_cut"          # поток оборвался: последний чекпойнт или повтор с нуля
    if reason == "STOP":
        return "done"                   # модель остановилась сама; задачу проверяйте отдельно
    if reason == "CONTINUATION":
        return "continue" if token else "token_lost"
    if reason == "MAX_TOKENS":
        empty = "_empty" if not text else ""
        return ("raise_budget_and_continue" if token else "raise_budget_restart") + empty
    if reason in CONTENT:
        return "change_input"
    if reason in TOOLS:
        return "fix_tools"
    return "log_and_retry_once"

def next_action_openai(resp, max_tokens):
    """Chat Completions: обрезку определяем по токенам, а не по finish_reason."""
    used = (resp.get("usage") or {}).get("completion_tokens", 0)
    fr = resp["choices"][0].get("finish_reason")
    if fr == "length" or used >= max_tokens:
        return "truncated"              # продолжения здесь нет: поднять max_tokens или сменить эндпоинт
    return "done" if fr in ("stop", "tool_calls") else "check"
Почему не видно CONTINUATION: SDK с версии 2.30.1 продолжает сам
В google-genai 2.30.1 и новее автоматическое продолжение (automatic_continuation) включено по умолчанию и для потоковых, и для обычных вызовов. SDK сам отправляет следующий хоп — так Google называет один запрос в цепочке продолжения — и возвращает склеенный ответ с итоговой причиной, поэтому промежуточный CONTINUATION ваш код не видит. Версии ниже минимальной не продолжают и не бросают исключение: вы получаете CONTINUATION, часто с пустым текстом.
Это видно на локальном мок-сервере, который 28 октября 2026 года отвечал вместо generateContent в формате из документации Google. Через него прогнали google-genai 2.33.0 (последняя версия на PyPI в тот день) и 2.29.0, которая ниже минимума; в запросе стоял maxOutputTokens 262 144.
| Ответ сервера | google-genai 2.33.0 | google-genai 2.29.0 |
|---|---|---|
Хоп 1: CONTINUATION, токен, пустой текст и 32 768 токенов размышлений; хоп 2: STOP | 2 запроса; второй несёт токен, тот же maxOutputTokens и те же contents. Код видит STOP и итоговый текст | 1 запрос; код получает CONTINUATION, пустой текст и токен, исключения нет |
То же с automatic_continuation=False | 1 запрос; код видит CONTINUATION и токен | Такого параметра в этой версии нет |
CONTINUATION без токена, как после шлюза, который отбрасывает поле | 1 запрос; пустой текст и CONTINUATION, исключения нет | То же самое |
MAX_TOKENS с токеном | 1 запрос; SDK не продолжает, отдаёт частичный текст и токен | То же самое |
Отсюда два практических вывода. Сначала проверьте версию (pip show google-genai): на версиях ниже 2.30.1 (в мок-проверке это была 2.29.0) ответ длиннее 64K не соберётся, сколько бы вы ни поднимали лимит. А затем проверяйте finish_reason и на свежем SDK: потерянный токен не вызывает ошибки, вы просто получаете пустую строку. В исходном коде 2.33.0 (google/genai/_extra_utils.py) продолжение запускается только при причине CONTINUATION или при её отсутствии, а в потоке SDK сдаётся после трёх переподключений подряд без нового чекпойнта. Тайм-ауты и повторы SDK применяет к каждому хопу отдельно. Ответы мок-сервера написаны вручную по документации, так что настоящий сервер может отличаться в деталях.
Свой цикл продолжения: тот же запрос плюс continuationToken
Свой цикл нужен, если вы вызываете REST напрямую, работаете через нативный эндпоинт шлюза, пишете на языке без свежего SDK или выключили automatic_continuation. Принцип простой: каждый следующий запрос — точная копия первого плюс последний continuationToken, и цикл идёт, пока приходит CONTINUATION. В руководстве Google по long decode в generateContent правила такие:
- в каждом хопе отправлять те же
contents,system_instruction,toolsиgenerationConfig,maxOutputTokensне менять; - не добавлять частичный ответ в
contents: состояние модели, включая размышления, несёт токен; - отправлять только последний токен, он содержит весь прежний прогресс;
- продолжать, пока причина
CONTINUATION, и останавливаться на любой другой; - после последнего хопа склеить
partsвсех хопов в один ход модели для истории диалога.
import json, os, urllib.request

URL = "https://generativelanguage.googleapis.com/v1beta/models/gemini-4-argon:generateContent"
KEY = os.environ["GEMINI_API_KEY"]

body = {
    "contents": [{"role": "user", "parts": [{"text": "Докажите теорему о распределении простых чисел."}]}],
    "generationConfig": {"maxOutputTokens": 262144, "thinkingConfig": {"thinkingLevel": "high"}},
}

def call(payload):
    req = urllib.request.Request(URL, data=json.dumps(payload).encode(), method="POST",
                                 headers={"x-goog-api-key": KEY, "Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=1200) as r:  # 20 минут
        return json.load(r)

parts, usage, token = [], {}, None
while True:
    payload = dict(body, continuationToken=token) if token else body  # тот же запрос + последний токен
    data = call(payload)
    cand = data["candidates"][0]
    parts += (cand.get("content") or {}).get("parts", [])
    for k, v in data.get("usageMetadata", {}).items():
        if isinstance(v, int):
            usage[k] = usage.get(k, 0) + v
    usage.setdefault("initialPromptTokenCount", data.get("usageMetadata", {}).get("promptTokenCount"))
    reason, token = cand.get("finishReason"), cand.get("continuationToken")
    if reason != "CONTINUATION":
        break
    if not token:
        raise RuntimeError("CONTINUATION без continuationToken: токен потерян между вами и Google")

text = "".join(p.get("text", "") for p in parts if not p.get("thought"))
print(reason, len(text), usage)
Цикл запускали 28 октября 2026 года только на локальном мок-сервере: три хопа подряд, CONTINUATION без токена и MAX_TOKENS с токеном отработали как задумано, но к серверам Google этот код не обращался. Причину после выхода из цикла удобно передать в next_action из предыдущего раздела. В той же документации Google есть оговорка, что непотоковый REST-запрос с maxOutputTokens больше 32 768 без токена возвращает 400, хотя пример цикла на REST там же отправляет 262 144 в первом же запросе. Если прямой API ответит на первый хоп такой ошибкой, проще перейти на SDK, который Google рекомендует для большинства приложений.
В потоковом цикле (streamGenerateContent) добавляется одно правило. После первых 32 768 токенов поток присылает чекпойнт-токен каждые 5 000 токенов. Новые фрагменты держите в списке ожидающих и переносите в готовый вывод, только когда пришёл фрагмент с токеном. Если поток оборвался, ожидающие фрагменты выбросьте и продолжите с последнего токена; если обрыв случился до первого чекпойнта, отправьте исходный запрос заново.
Через API-шлюз и OpenAI-совместимый эндпоинт: проверка 28 октября
На шлюзе, проверенном 28 октября 2026 года, продолжить ответ было нечем: нативный маршрут вернул MAX_TOKENS без continuationToken, а OpenAI-совместимый ответил finish_reason: "stop" на ответе, обрезанном ровно по max_tokens. Проверка шла через laozhang.ai: этот шлюз принимает и нативный generateContent, и /v1/chat/completions. Результаты относятся только к нему и только к этому дню; передают ли токен продолжения другие шлюзы, продающие доступ к Argon, из их публичных описаний не видно.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
| Запрос | Что вернулось | Что это значит для кода |
|---|---|---|
Нативный, maxOutputTokens 64, уровень low, просьба о длинном ответе | MAX_TOKENS, 291 символ, 64 токена ответа, токена нет | Повтор того же запроса начал ответ с нуля: без токена продолжать нечего |
Нативный, maxOutputTokens 200, уровень high, трудная задача по математике | MAX_TOKENS, 0 символов текста: 197 токенов размышлений и 3 токена ответа | Пустой ответ означает, что бюджет съели размышления |
Нативный непотоковый, maxOutputTokens 40 000, «Reply with exactly: OK» | STOP, «OK», ошибки 400 нет | Шлюз пропустил значение, на которое прямой REST по документации отвечает 400 |
Нативный, thinkingLevel: "minimal" | HTTP 500 с текстом «上游服务异常,请重试,或联系网站客服» («сбой вышестоящего сервиса, повторите») и кодом "402" | Шлюз скрыл исходную ошибку: minimal у Argon просто не поддерживается |
/v1/chat/completions, max_tokens 64, тот же длинный запрос | completion_tokens 64 из 64, finish_reason: "stop" | Обрезку видно только по счётчику токенов |
/v1/chat/completions, max_tokens 40 000, «OK» | stop, 5 токенов | Обычный завершённый ответ |
Нативный, maxOutputTokens 33 000, «выведи все числа от 1 до 7000» | STOP через 142 токена: модель отказалась, сославшись на лимит вывода, и предложила seq 1 7000 | STOP не означает, что задача выполнена |
| Нативный непотоковый, 33 000, таблица CSV на 2 500 строк на трёх языках | Соединение закрылось на 300,9 секунды, тела ответа нет | Ни текста, ни причины |
streamGenerateContent, тот же CSV | 993 события, 74 760 символов (до строки 1 065), конец потока на 302,5 секунды без finishReason, итогового usage и чекпойнта | Разбор — в следующем разделе |
У OpenAI-совместимого маршрута ограничение принципиальное: по документации Google о long decode на этом эндпоинте продолжения нет, и вывод останавливается на лимите одного запроса. Страница Google об OpenAI-совместимости не описывает, какой finish_reason ставится при обрезке; часть поставщиков пишет, что приходит "length", но на проверенном маршруте пришёл "stop". Надёжная проверка одна: сравнить completion_tokens с max_tokens, как делает next_action_openai. reasoning_effort на этом эндпоинте соответствует уровню размышлений Argon (low, medium, high). Как перенаправить OpenAI SDK на другой адрес, описано в статье «OpenAI base_url в SDK и Cursor: приоритет, путь /v1 и проверка».
Пропускает ли ваш шлюз токен, можно проверить одним дешёвым запросом: нативный generateContent с maxOutputTokens 64 и просьбой о длинном ответе. По документации Google ответ MAX_TOKENS у Argon содержит continuationToken; если его нет, длинные ответы через этот маршрут не соберутся. Тогда остаётся держать каждый ответ в пределах лимита одного запроса и делить задачу на части, спросить шлюз о передаче токена или перейти на Interactions API, если он доступен. Вся проверка 28 октября обошлась максимум в $0,59 по ценам Google при выделенном лимите $1; оборванные запросы посчитаны так, будто были оплачены полностью.
Поток закончился без finishReason — ответ не завершён
Если поток закрылся, а в последнем фрагменте нет finishReason (или там пустая строка), ответ не завершён, даже если HTTP-статус был 200 и текст выглядит связным. В потоке на 302,5 секунды из таблицы выше последний фрагмент нёс "finishReason": "", а промежуточные фрагменты показывали candidatesTokenCount 0. Проверка if reason is None такой случай пропустит, поэтому пустую строку приравнивайте к отсутствию причины.
Что делать дальше, зависит от того, успел ли прийти чекпойнт-токен. Есть токен — продолжите с него, как описано в разделе о своём цикле; нет — повторите исходный запрос. Отсекать запрос может и ваша сторона: по документации Google сервер держит поток до 20 минут, так что обрыв на пятой минуте указывает скорее на тайм-аут клиента, прокси или шлюза. В проверке 28 октября между клиентом и шлюзом стоял ещё локальный HTTP-прокси, и какой из них закрывал соединение, установить не удалось. На прямом API оборванный до 32K поток не оплачивается, после этого платите до последнего чекпойнта; непотоковый запрос, оборванный до конца, стоит $0.
Почему prompt_token_count вырос в разы: счёт и оплата по хопам
После long decode prompt_token_count показывает не размер вашего запроса, а сумму входных токенов всех хопов: каждый хоп заново отправляет модели запрос и всё, что уже сгенерировано. Google приводит пример: запрос на 1 000 токенов, на который модель выдаёт 200 000 токенов размышлений и ответа, занимает четыре хопа, и входы складываются как 1 000 + 66 536 + 132 072 + 197 608 = 397 216 токенов, хотя реальный контекст — около 201 000. В непотоковом REST хопы по 32K, их выходит семь, и сумма входа — 695 128 токенов.
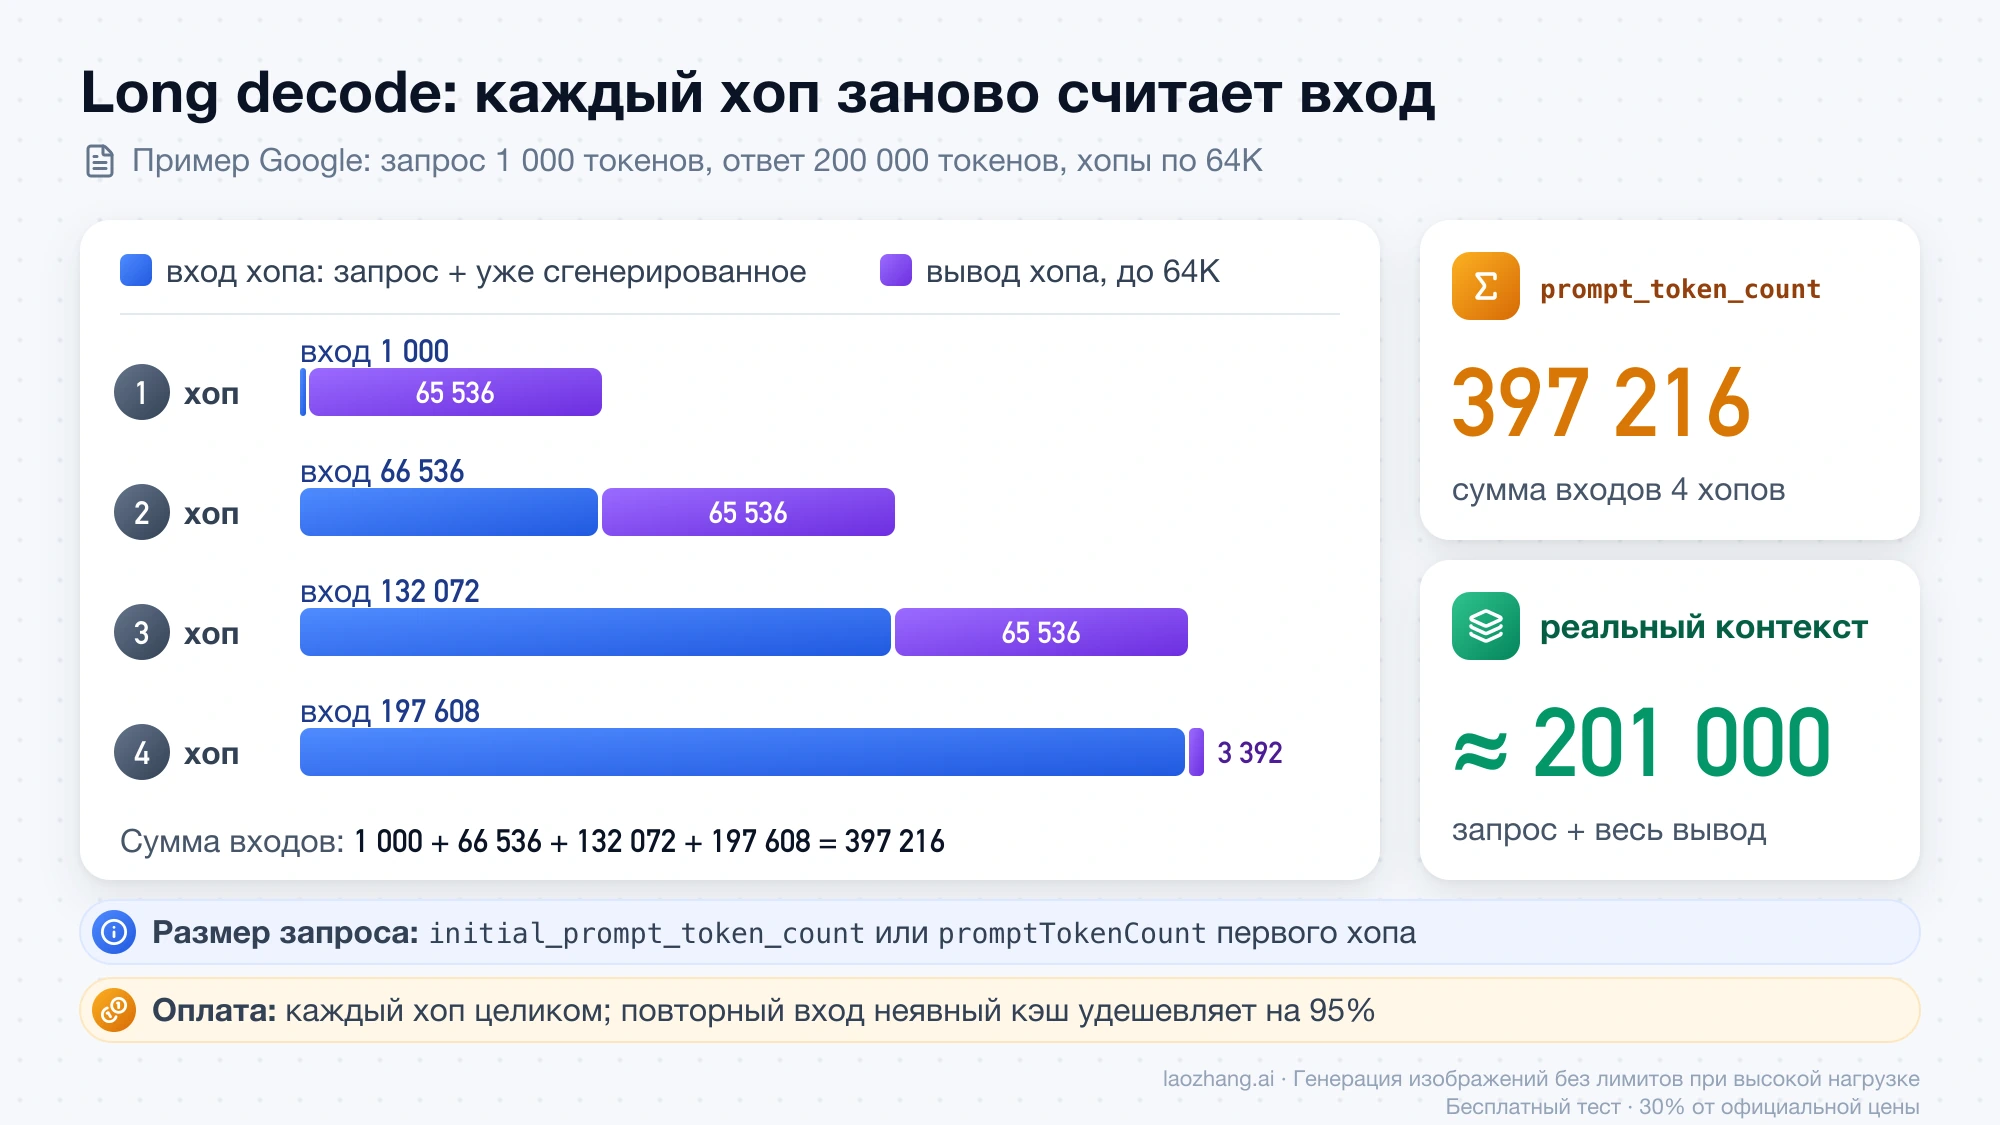
SDK с автоматическим продолжением суммирует все поля usage по хопам. В мок-проверке 28 октября двухшаговый ответ показал prompt_token_count 33 008 = 120 (исходный запрос) + 32 888 (запрос плюс первый хоп), а initial_prompt_token_count — 120. Для размера запроса и решения, когда сжимать историю, читайте initial_prompt_token_count в Python или initialPromptTokenCount в JavaScript. Это поле SDK вычисляет на клиенте: в REST-ответе и в model_dump() его нет, поэтому в собственном цикле сохраняйте promptTokenCount первого хопа, а остальные поля складывайте.
Оплачивается каждый хоп целиком, включая хопы, ушедшие только на размышления. Повторяющийся вход неявный кэш удешевляет на 95%: во вводный период $0,10 вместо $2 за 1 млн токенов. Кэш живёт 15–20 минут без обращений, поэтому длинная пауза между хопами снова тарифицируется по полной цене. Шлюз, который сам ходит в REST, должен складывать поля всех хопов и показывать размер запроса по первому — иначе его цифры разойдутся с цифрами SDK для того же запроса.
Interactions API: статус incomplete вместо finish_reason
В Interactions API нет finishReason: результат описывает поле status, а длинные ответы сервер собирает сам, если запрос создан с background: true. По руководству Google по long decode в Interactions API для этого нужны ещё store: true и max_output_tokens больше 65 536 (до 1 048 576 минус вход); сервер гоняет хопы по 64K и склеивает их, задача может работать до 24 часов. С background: false предел — 65 536, а большее значение даёт 400 «max_output_tokens greater than 65536 is not yet supported with background=false».
Итоговых статусов пять: completed — модель закончила; requires_action — нужен вызов инструмента; incomplete — израсходован весь max_output_tokens, и текст может быть пустым, если модель ещё размышляла, поэтому повторите с бо́льшим лимитом или более низким уровнем размышлений; failed — сервер не справился или задача шла дольше 24 часов; cancelled — вы отменили её сами. Поля total_input_tokens и другие в usage здесь тоже суммируются по хопам. Продолжение на стороне клиента в Interactions API Google пока только обещает.
Источники6
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 28 окт. 2026 г..
Источники6
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 28 окт. 2026 г..
- 1.странице цен Gemini APIai.google.dev/gemini-api/docs/pricing
- 2.списке регионов, где доступны Gemini API и AI Studioai.google.dev/gemini-api/docs/available-regions
- 3.справочника generateContent в Gemini APIai.google.dev/api/generate-content
- 4.руководстве Google по long decode в generateContentai.google.dev/gemini-api/docs/generate-content/long-decode
- 5.Страница Google об OpenAI-совместимостиai.google.dev/gemini-api/docs/openai
- 6.руководству Google по long decode в Interactions APIai.google.dev/gemini-api/docs/long-decode