Gemini 4 HydrogenとGPT-6.2 Sol比較:実測費用はHydrogenが3.6倍
同じ11回のAPI課題を既定設定で比べると両方全問合格、費用はHydrogenがGPT-6.2 Solの3.6倍。無料枠・動画入力・272K超の入力ならHydrogenです。
目次
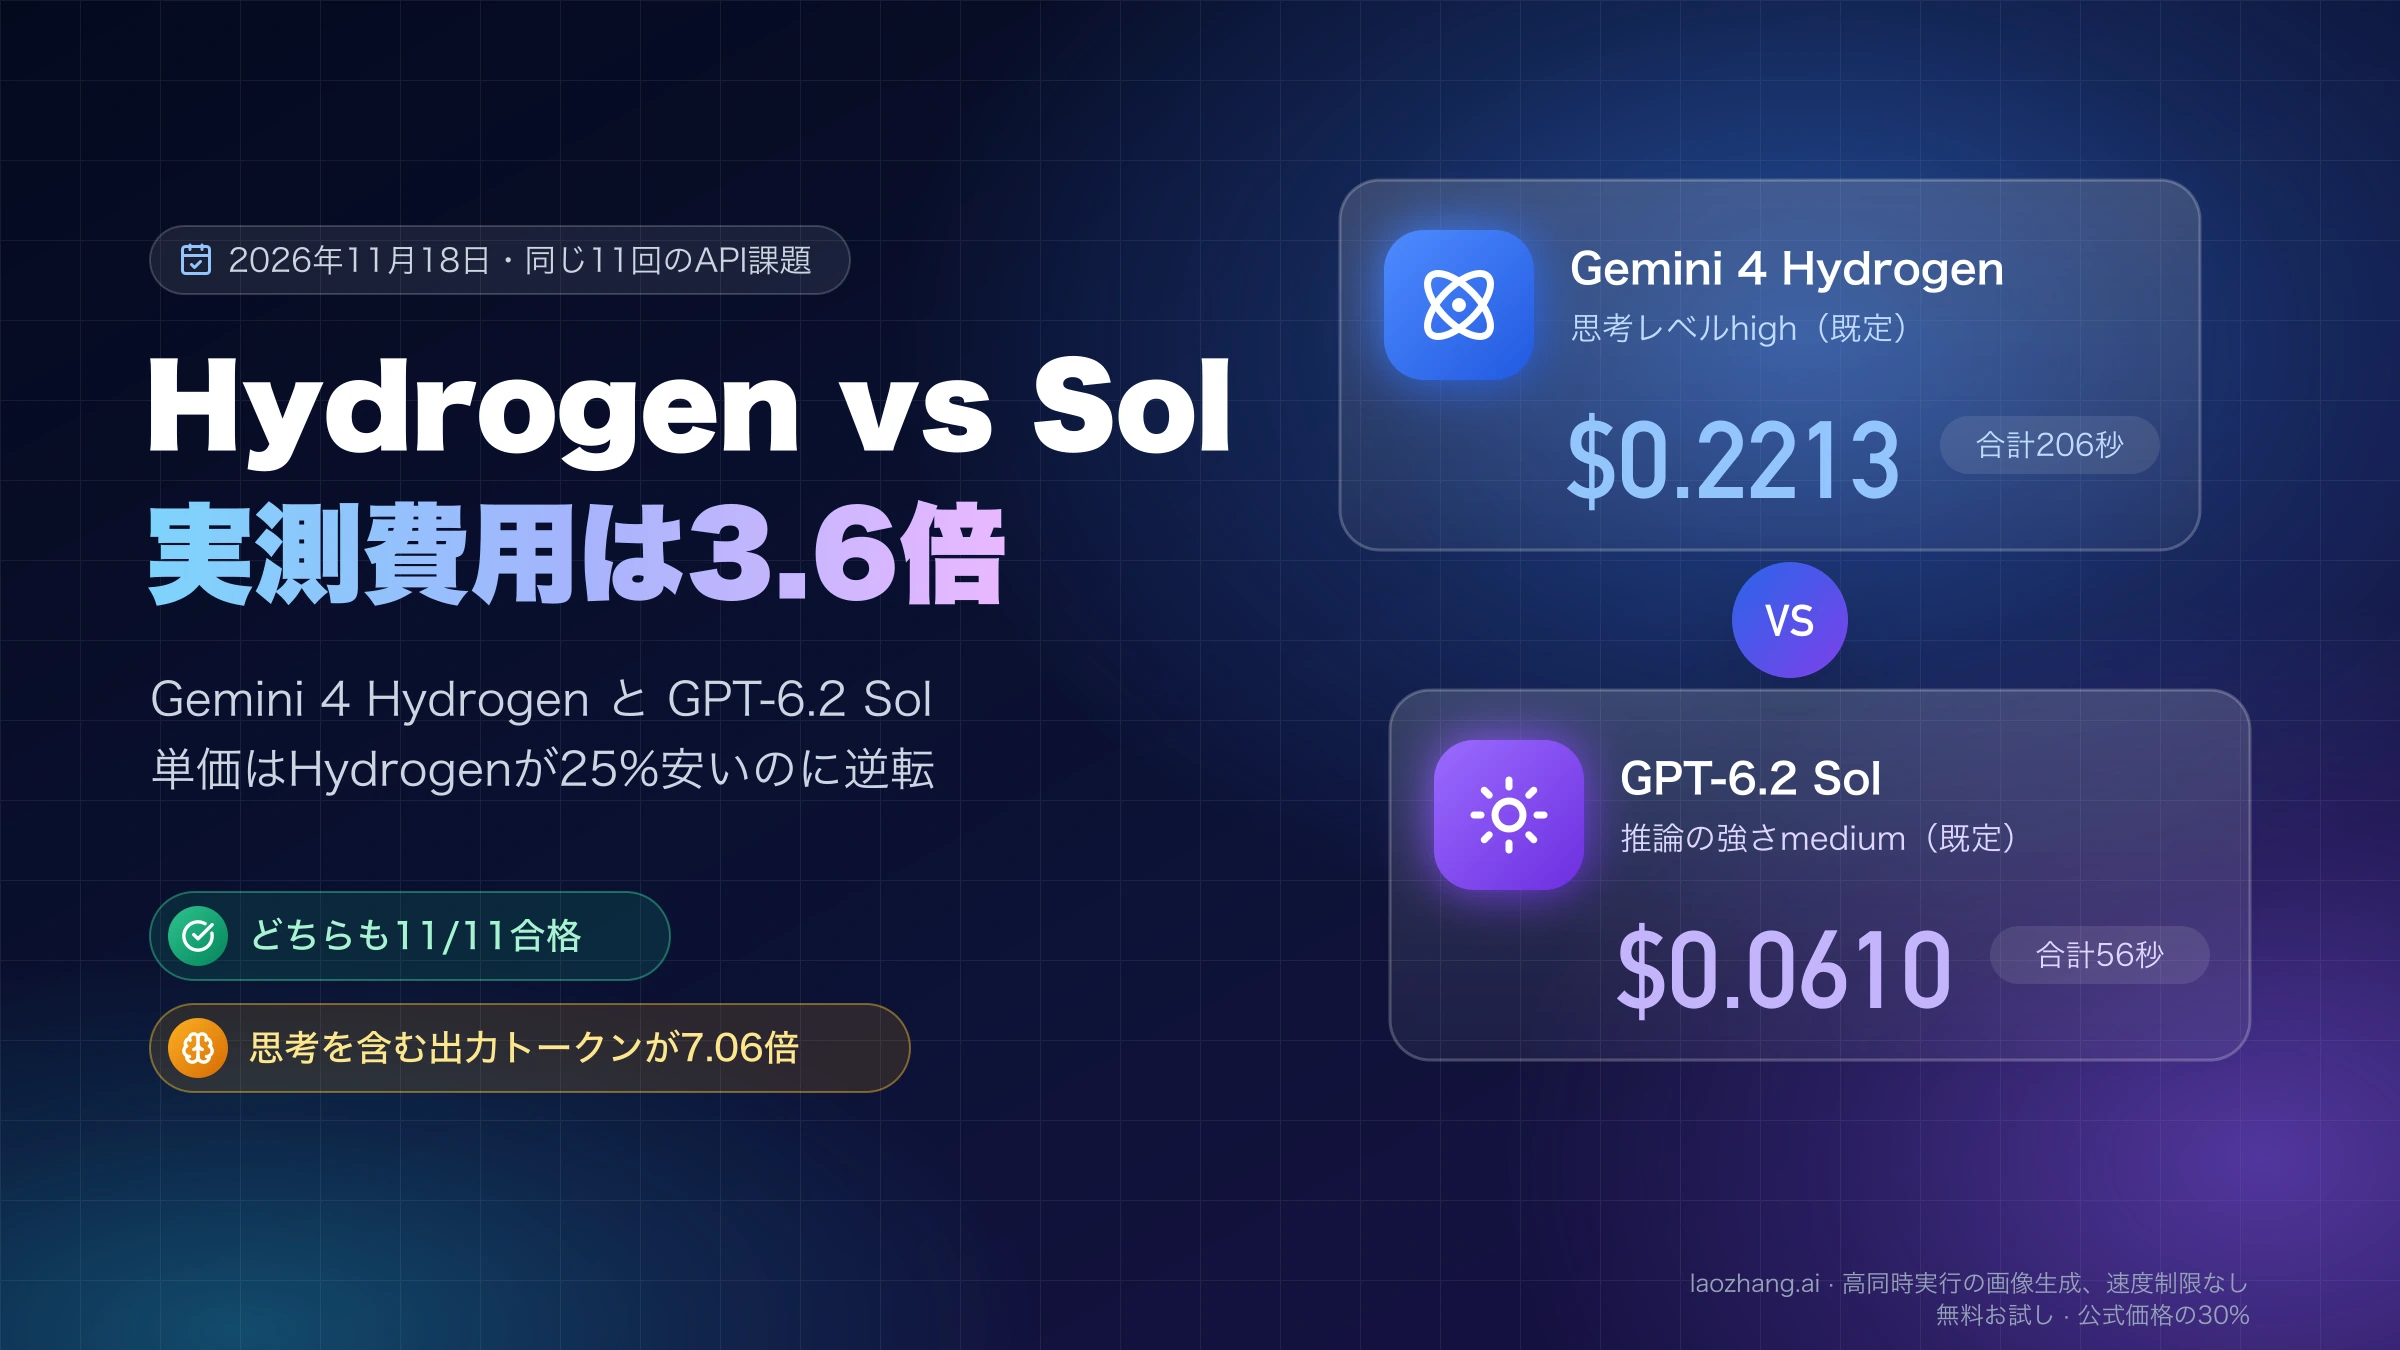
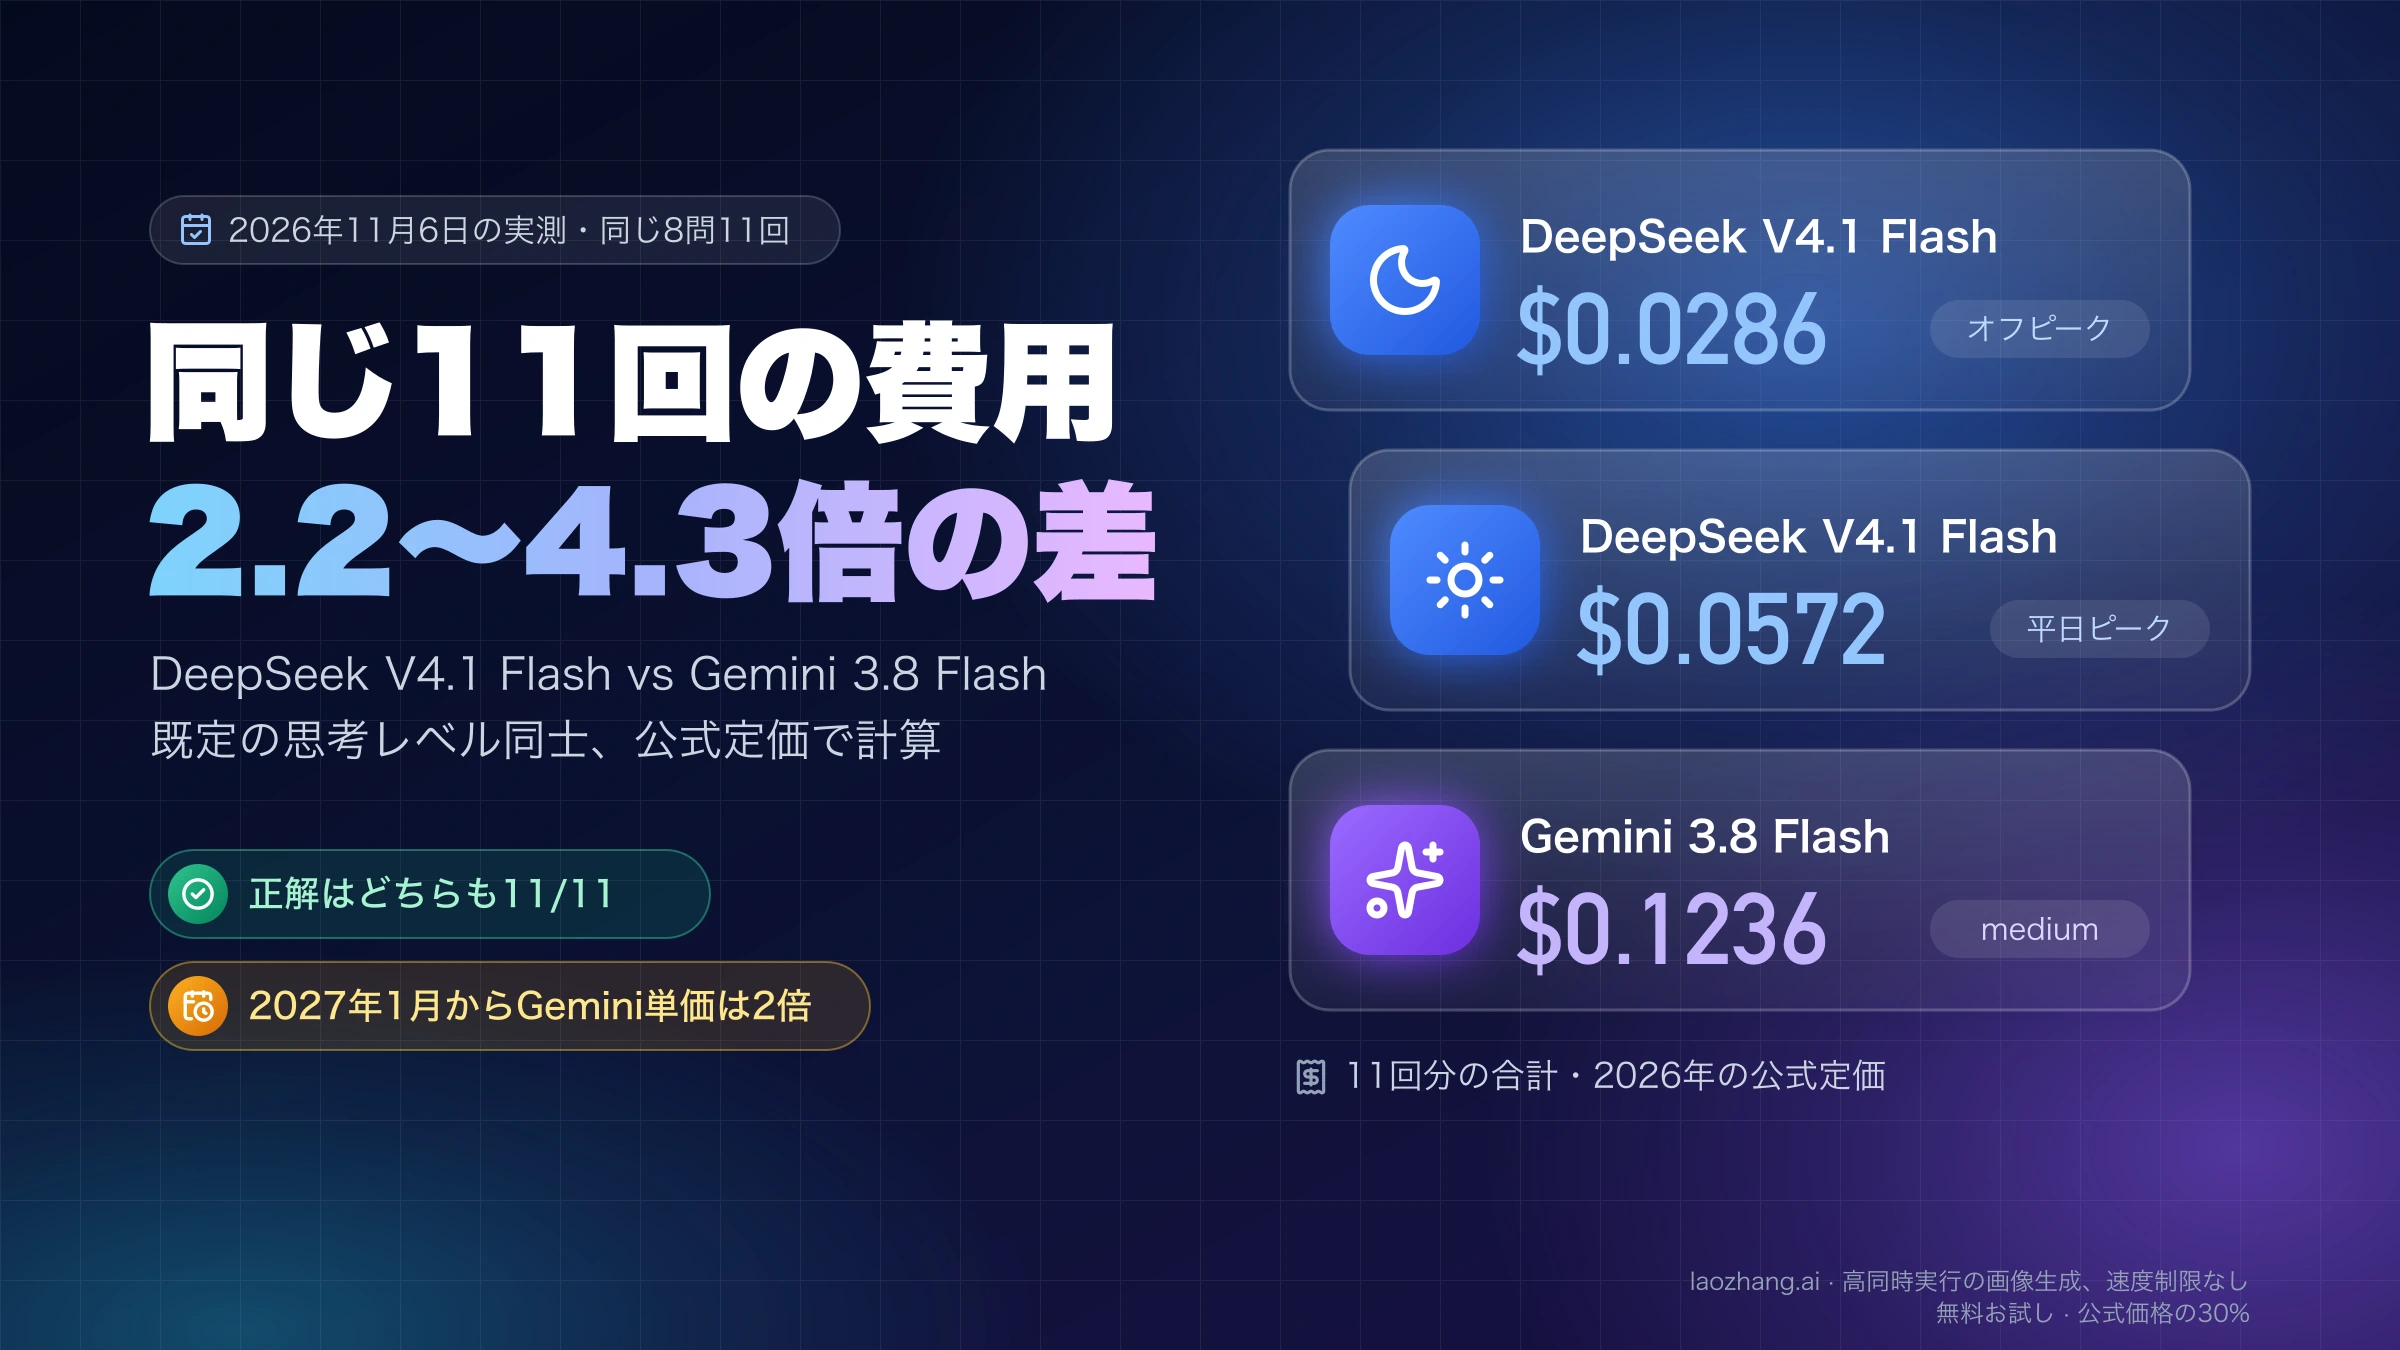
APIで日常のコーディングや単発のリクエストに使う既定モデルを1つ決めるなら、GPT-6.2 Sol(gpt-6.2-sol、推論の強さは既定のmedium)から始めるのが無難です。2026年11月18日にlaozhang.aiゲートウェイ経由で同じ11回の課題を両モデルの既定設定で実行したところ、どちらも11回すべて合格し、公式単価で計算した費用はGemini 4 Hydrogen(思考レベルhigh)が$0.2213、GPT-6.2 Solが$0.0610でした。100万トークンあたりの単価はHydrogenが25%安いのに、思考を含む出力トークンが7.06倍あったため、費用は3.63倍、待ち時間の合計は3.67倍になっています。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
Gemini 4 Hydrogen(gemini-4-hydrogen)を既定にするのは、条件がはっきりしているときです。予算ゼロで試すなら、Gemini APIの無料枠があるのはHydrogenだけです。動画・音声・PDFをそのまま渡せるのもHydrogenで、Solはテキストと画像に限られます。入力が272Kトークンを超えるリクエストでは、Solはリクエスト全体が入力$4/出力$15に上がり、Hydrogenは$1.50/$7.50のままです。
この11回の課題は小さく条件の明確なもので、両モデルとも全問合格だったため、比べているのはトークン数・費用・時間であって賢さではありません。難しい課題の差は第三者の評価機関Artificial Analysis(AA)の数字で見ます。2026年11月18日時点の総合指数では、既定同士でSol 53点、Hydrogen 51点、AA自身の評価セットでの1タスクあたり費用はHydrogenがSolの4.6倍でした。
Gemini 4 HydrogenとGPT-6.2 Solの料金と仕様:単価はHydrogenが25%安い
100万トークンあたりの単価は、入力・出力・キャッシュ入力のすべてでGemini 4 Hydrogen(ハイドロジェン)がGPT-6.2 Sol(ソル)より25%安く、さらにHydrogenには長い入力の割増がありません。Hydrogenは2026年11月12日にGemini APIの無料枠と有料枠の両方で一般提供になり、GPT-6.2 Solは2026年11月17日にGPT-6.2 Astraと同時に公開されました。
| 項目 | Gemini 4 Hydrogen | GPT-6.2 Sol |
|---|---|---|
| モデルID | gemini-4-hydrogen | gpt-6.2-sol |
| 入力(100万トークンあたり) | $1.50 | $2.00(272K以下) |
| 出力(思考・推論トークンを含む) | $7.50 | $10.00(272K以下) |
| キャッシュ入力 | $0.075(暗黙的キャッシュのみ) | $0.10 |
| 入力が272Kトークンを超えたとき | 割増なし | リクエスト全体が入力$4/出力$15 |
| Batch | $0.75/$3.75 | $1/$5 |
| APIの無料枠 | あり | なし |
| コンテキストウィンドウ | 1,048,576トークン | 1,050,000トークン(入力は最大922,000) |
| 最大出力 | 65,536トークン(同期呼び出し) | 128,000トークン |
| 入力の種類 | テキスト、画像、動画、音声、PDF | テキスト、画像 |
| 調整の段階 | 思考レベルlow/medium/high/xhigh、既定high | 推論の強さlow/medium/high/xhigh/max |
出典は2026年11月18日時点のGemini APIの料金ページ、OpenAIのGPT-6.2 Solモデルページ、OpenAI APIの料金表です。GPT-6.2 SolのStandard単価は、GPT-6.1 Solとまったく同じです。Solの128,000トークンは出力の上限で、コンテキストはどちらも約100万トークンあります。「GPTは128K」という説明を見かけたら、出力上限とコンテキストを取り違えていないか確認してください。Hydrogenの無料枠・有料枠・Batchの区分と思考レベルごとの1回の費用は「Gemini 4 Hydrogen API料金・価格:思考レベル別に1回の費用を実測」に詳しくあります。
2つの段階は同じ物差しではありません。Hydrogenの思考レベルとSolの推論の強さはどちらも「high」という値を持ちますが、両者のhighが同じ量の思考を意味するわけではなく、既定値もHydrogenはhigh、Solはmediumと違います。OpenAIのGPT-6移行ガイドは新しい組み込みをmediumから始めるよう勧めており、2026年11月18日にlaozhang.aiゲートウェイ経由で推論の強さを指定せずに送ったときもmediumで動きました。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
同じ11回のAPI呼び出し:両方全問合格、費用はHydrogenが3.63倍
既定設定どうしで同じ11回の課題を投げると、Gemini 4 Hydrogenの費用はGPT-6.2 Solの3.63倍、待ち時間の合計は3.67倍でした。実行は2026年11月18日3時18分〜3時20分(UTC)で、1つのキーでlaozhang.aiゲートウェイを通し、HydrogenはGemini APIのネイティブ形式(generateContent、thinkingLevel: "high")、SolはChat Completions(reasoning_effortを送らない既定と、highを送る設定)で呼びました。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
課題は8種類で、文章題、Pythonの関数作成(区間の結合、時間文字列の解析、頻出単語の集計、数式の評価、CSVの1行の分割)、桁和の推論、約1万1千トークンの文書の5行要約です。難しめの3題(数式の評価、CSV、桁和)だけ2回ずつ実行して計11回、システムプロンプトとツールはなし、1ターン、ストリーミングなし、出力上限32,000トークン、採点は隠しテストで行いました。費用は返ってきたトークン数に各社の公式単価を掛けた計算値で、入力はすべてキャッシュなしの単価で数えています。
| 設定 | 合格 | 入力トークン | 出力トークン(うち思考・推論) | 費用 | 合計秒数 | 1回の中央値 |
|---|---|---|---|---|---|---|
| Gemini 4 Hydrogen high(既定) | 11/11 | 12,712 | 26,966(21,565) | $0.2213 | 206秒 | 15.6秒 |
| GPT-6.2 Sol medium(既定) | 11/11 | 11,407 | 3,820(628) | $0.0610 | 56秒 | 5.0秒 |
| GPT-6.2 Sol high | 11/11 | 11,407 | 5,843(2,610) | $0.0812 | 66秒 | 5.0秒 |
Solを推論の強さhighに上げても、Hydrogenの既定より安く速い結果でした。Hydrogen high÷Sol highは費用2.72倍、出力トークン4.62倍、秒数3.14倍です。Sol自身のmediumからhighへの変化は、費用1.33倍、秒数1.17倍にとどまります。Sol mediumは11回のうち6回で推論トークンを1つも使わずに答えています。
課題別に見ると、8種類すべてでSolの既定のほうが安く、差の大きさは課題の種類で変わりました。差が大きかったのは推論が要る短い課題で、桁和の推論は8.96倍、CSVの分割は5.47倍、時間文字列の解析は4.67倍です。差が小さかったのは区間の結合(1.13倍)と長い文書の要約(1.61倍)でした。難しめの3題の合計は$0.1575対$0.0281(5.60倍)、残る5題の合計は$0.0638対$0.0329(1.94倍)です。
数字は各課題1〜2サンプルで、思考の量は回ごとに揺れます。区間の結合では、Hydrogenの思考トークンが11月18日は110だったのに対し、2026年11月14日の同じ課題では1,763でした。秒数はこのゲートウェイを通した呼び出し全体の時間で、経路が変われば変わります。
単価が安いHydrogenの費用が高くなる理由は思考トークンの量
Gemini 4 Hydrogenの費用がGPT-6.2 Solより高くなったのは、思考に使う出力トークンが多いからです。Googleの思考トークンもOpenAIの推論トークンも、どちらも出力単価で課金されます。11月18日のテストでは、Hydrogenの出力26,966トークンのうち21,565トークン(80%)が思考で、Solの出力3,820トークンのうち推論は628トークンでした。
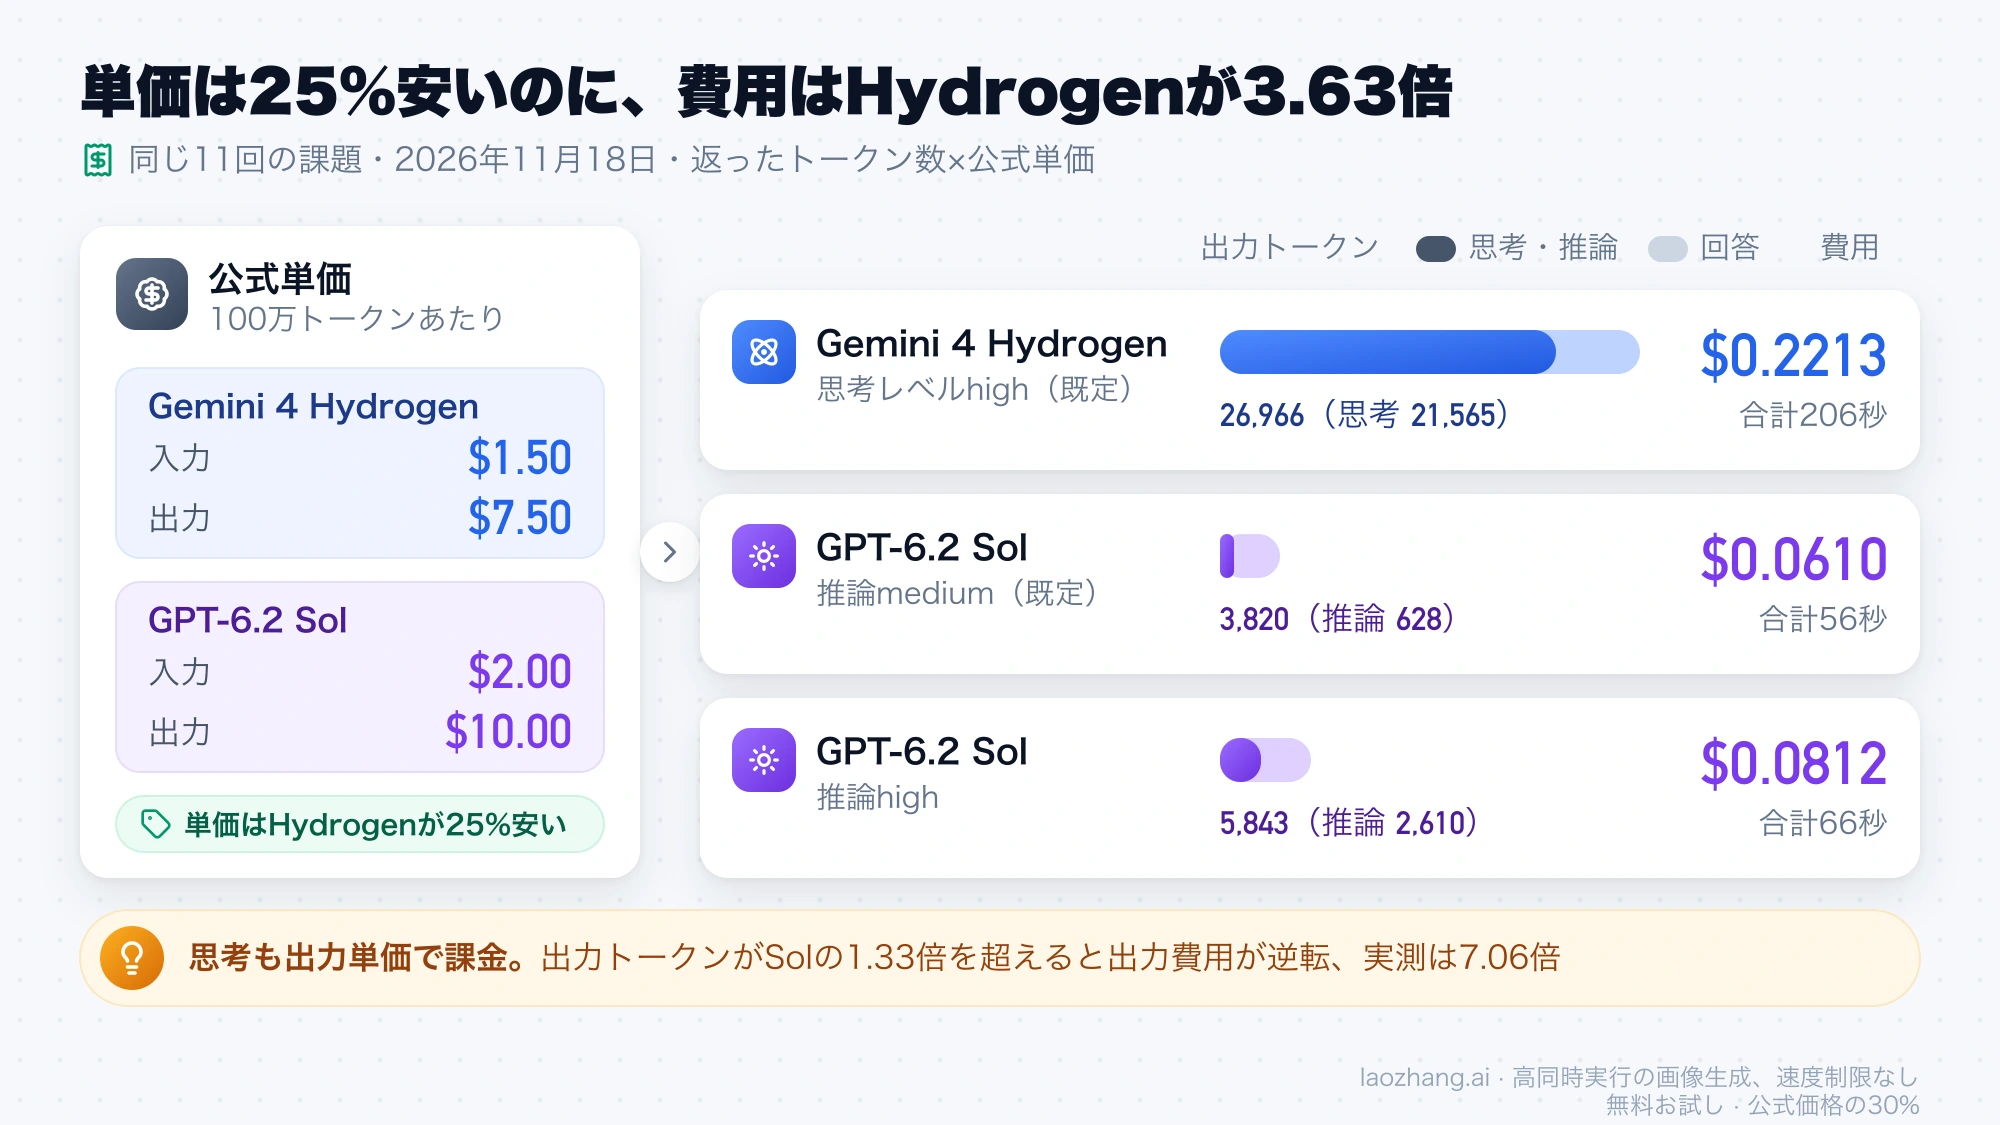
計算式にすると差の出どころがわかります。Hydrogenは入力12,712×$1.50+出力26,966×$7.50を100万で割って$0.0191+$0.2022=$0.2213、Solは入力11,407×$2+出力3,820×$10を100万で割って$0.0228+$0.0382=$0.0610です。入力の費用はほぼ並んでいて、差のほとんどは出力側で生まれています。出力単価の差は$7.50対$10なので、Hydrogenの出力トークンがSolの1.33倍を超えると、出力の費用は逆転します。
入力側にも見落としやすい差があります。同じ文章でも、Hydrogenのほうが入力トークンが多く数えられました。約1万1千トークンの文書はHydrogenで11,110、Solで10,106(約10%多い)、後で触れる146KBのログは79,312対55,843(42%多い)です。ログの入力費用は79,312×$1.50で$0.1190、55,843×$2で$0.1117となり、単価の安さはトークン数の多さでほぼ相殺されています。
一方で、逆の結果を出したテストもあります。Alibaba Cloudの開発者コミュニティに2026年11月13日に掲載された個人の比較記事では、コーディングエージェントでWebページを丸ごと作らせたところ、領収書の写真から割り勘ページを作る課題でHydrogenが56,500トークン、GPT-6.1 Solが113,000トークンでした。この比較は相手がGPT-6.1 Solで、数えているのはエージェントのセッション全体のトークンです。2026年11月18日に同じ12問をGPT-6.2 Solと6.1 Solに投げた別のテストでは、6.2 Solの出力トークンは6.1 Solの0.68倍でした。単発のAPI呼び出しの結果と、エージェントでの長い作業の結果は、どちらも他方の場面にはそのまま当てはまりません。
どちらが速いか:毎秒のトークン数はHydrogen、答えが出るまではSol
「速い」には2つの測り方があり、2モデルの順位が入れ替わります。文字を出す速さ(毎秒の出力トークン数)はGemini 4 Hydrogenが2倍以上速く、答えの最初の文字が出るまでの時間はGPT-6.2 Solが短いです。AAの2026年11月18日時点の計測では、既定同士で出力速度はHydrogen highが毎秒169トークン、Sol mediumが毎秒74トークン、最初の答えのトークンまではHydrogen highが17.39秒、Sol mediumが2.81秒でした。
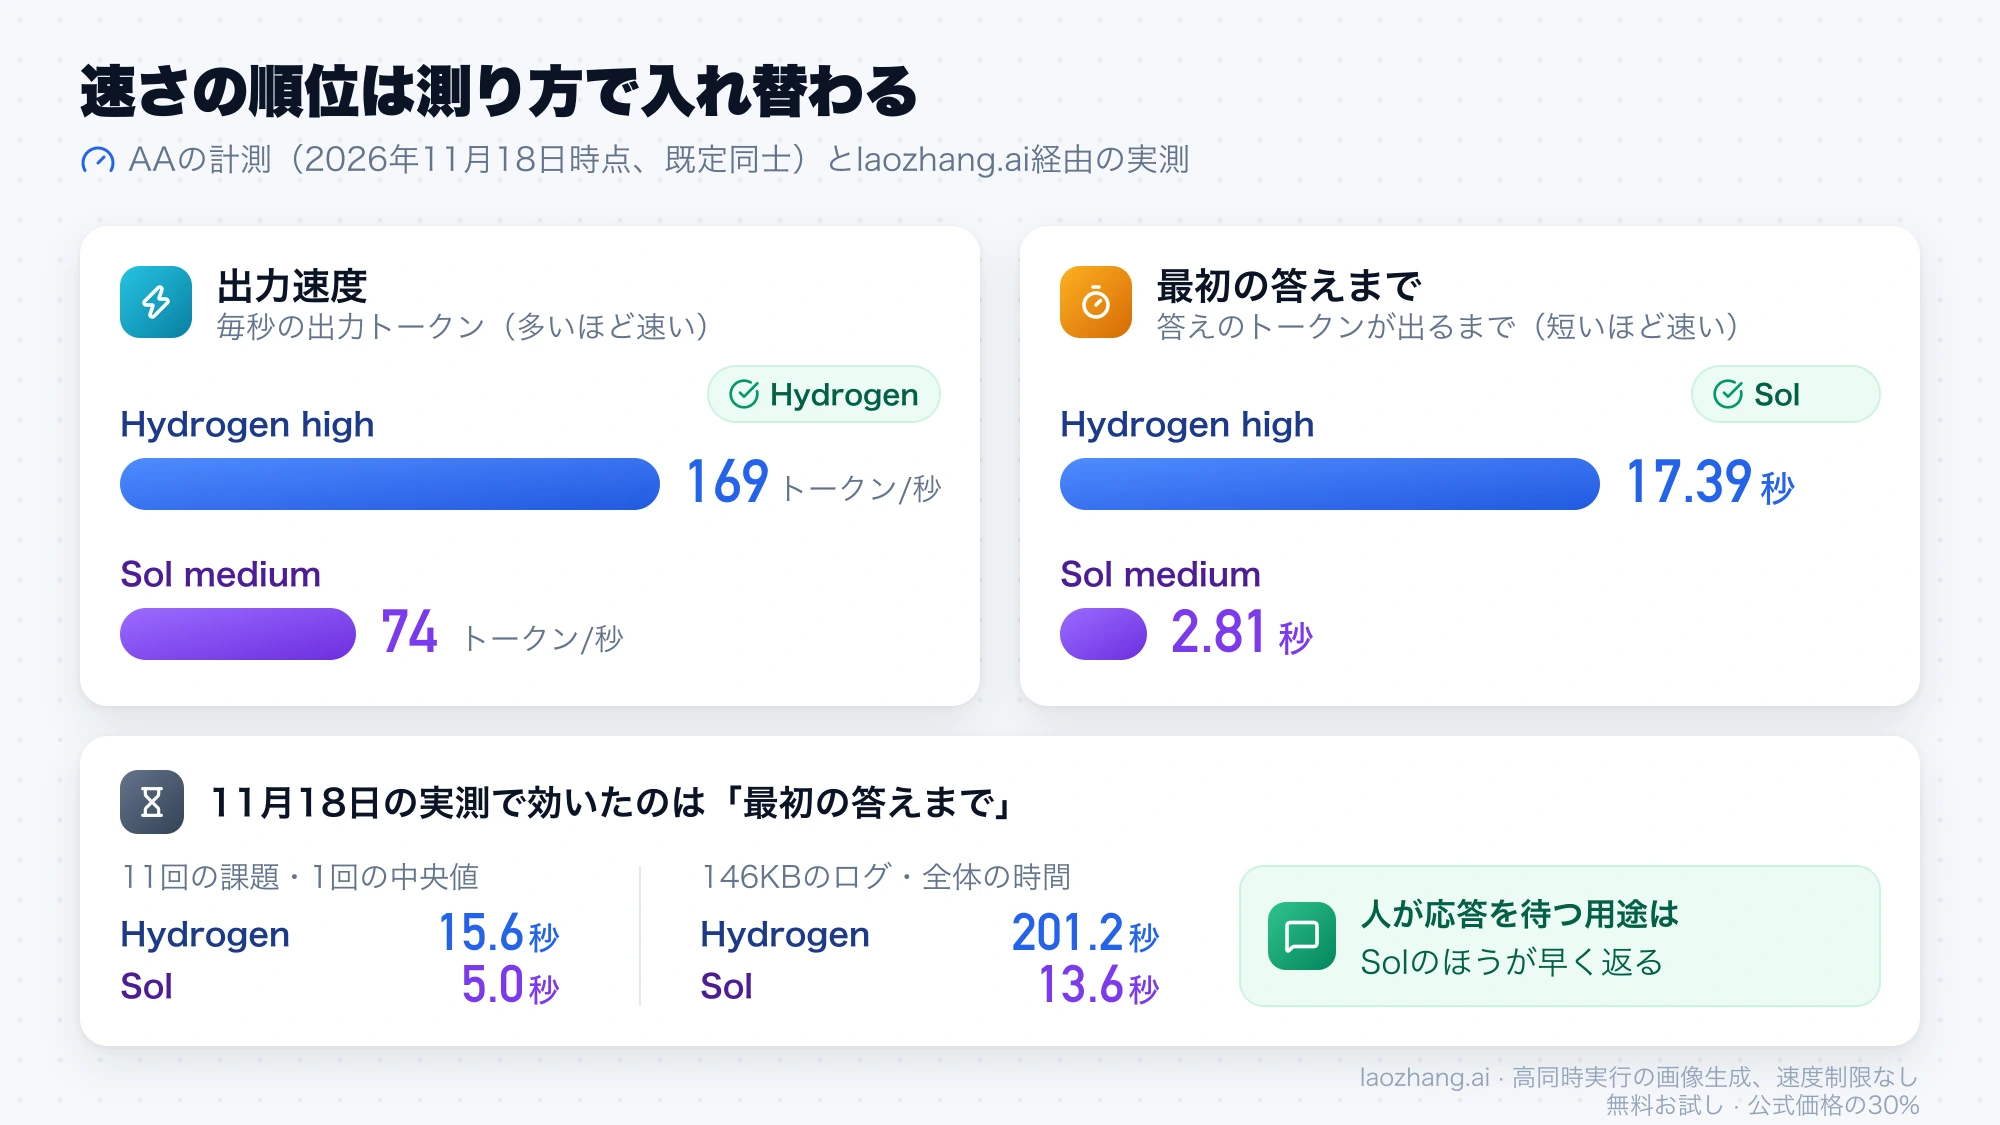
11月18日の11回のテストで効いたのは後者です。Hydrogenは答えを書く前の思考が長く、1回の中央値は15.6秒、Solは5.0秒でした。146KBのログを読ませた単発テストでは差がさらに開き、Hydrogenは答えの最初の文字が出るまでに200.4秒、全体で201.2秒かかり、Solは13.6秒で返しています。チャット画面やAPIの応答を人が待つ用途では、Solのほうが答えが早く返ってきます。
思考が短く、出力が長い作業では事情が変わる可能性があります。X上の個人の単発テストには、PS5コントローラーの3Dモデルを作らせてHydrogen highが3分、公開前のGPT-6.2 Solが11分だったという報告があります。Solの推論の強さや実行環境は示されておらず、1人の1回の結果です。長いコードやページを生成する作業の待ち時間は、11月18日のテストの範囲外です。
ベンチマークの差:ターミナルとコードはSol、事実知識と自動化はHydrogen
総合点ではGPT-6.2 Solが上で、しかも費用が低くなっています。AAの総合指数v5.0.1(2026年11月18日時点、AAのGPT-6.2 SolとGemini 4 Hydrogenの比較ページ)では、Solは推論の強さmediumで53点、Hydrogenは最上位のxhighで54点です。点数がほぼ並ぶこの2つを比べると、AAの1タスクあたり費用は$0.41対$3.16(7.7倍)、1タスクの時間は3.1分対14.8分でした。
| モデルと段階 | 総合指数 | 1タスクの費用 | 1タスクの時間 | Terminal-Bench 4.0 |
|---|---|---|---|---|
| GPT-6.2 Sol max | 57 | $1.01 | 7.9分 | 60.1% |
| GPT-6.2 Sol xhigh | 56 | $0.65 | 5.1分 | 56.1% |
| GPT-6.2 Sol high | 55 | $0.56 | 4.2分 | 58.6% |
| GPT-6.2 Sol medium(既定) | 53 | $0.41 | 3.1分 | 56.1% |
| GPT-6.2 Sol low | 41 | $0.18 | 1.4分 | 37.9% |
| Gemini 4 Hydrogen xhigh | 54 | $3.16 | 14.8分 | 53.5% |
| Gemini 4 Hydrogen high(既定) | 51 | $1.87 | 8.4分 | 54.0% |
| Gemini 4 Hydrogen medium | 41 | $0.80 | 4.0分 | 29.3% |
| Gemini 4 Hydrogen low | 27 | $0.29 | 1.5分 | 6.6% |
「1タスクの費用」と「1タスクの時間」はAA自身の評価セットの平均で、読者のリクエスト1回の費用ではありません。AAはSolを$2/$10、Hydrogenを$1.50/$7.50で計算しています。AAは数値を計算し直すことがあるため、上の表は2026年11月18日時点の値です。
個別の評価項目では、得意分野がはっきり分かれます。既定同士と最上位の段階同士で並べると次のとおりで、ターミナル作業と実際のコードベースでの作業はSol、事実知識と業務の自動化はHydrogenが上です。HLE-Diamondだけは既定同士ではHydrogen、最上位同士ではSolが上で、どちらが得意とは言い切れません。
| AAの評価項目 | Sol medium(既定) | Hydrogen high(既定) | Sol max/Hydrogen xhigh |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 60.5% | 41.4% | 67.6%/49.5% |
| FrontierCode-AA 2.0(実際のコードベースの変更) | 41.4% | 36.3% | 44.4%/39.0% |
| HLE-Diamond | 50.7% | 54.9% | 64.0%/58.8% |
| AA-Omniscience v1.1(事実知識) | 34 | 44 | 40/46 |
| AutomationBench-AA(業務の自動化) | 70.3% | 74.4% | 71.3%/76.1% |
各社の主張は別に読む必要があります。OpenAIはFrontierCode 2.0で「SolはAstraの約5分の1の費用で、マージできる変更をほぼ同水準でこなす」と説明し、GitHubは初期テストでコードレビューで見つけた実際の問題がGPT-6.1 Solの約2倍だったと書いています。弱点もあります。The Decoderの発表記事(2026年11月17日)によると、Codexでのコーディングエージェント指数ではGPT-6.2 Solは6.1 Solより3点下がり、その原因はSWE-Atlas-QnA-AAで回答から重要な事実を落とすことが増えた点(14点の低下)でした。
CodexとAntigravity:Hydrogen xhighが高得点、総費用6.3倍
各社のエージェントの中で動かした場合は、Gemini 4 Hydrogenのほうが点数は高く、費用と時間はGPT-6.2 Solが大幅に少なくなります。AAのコーディングエージェント指数(2026年11月18日時点、AAのCoding Agent Index)は、各モデルを開発元のエージェントで動かし、FrontierCode 2.0、Terminal-Bench、SWE-Atlas-QnA-AAを同じ重みで採点しています。
| 構成 | 指数 | 評価全体の総費用 | 1タスクの平均時間 | 平均ステップ数 |
|---|---|---|---|---|
| Antigravity CLI+Gemini 4 Hydrogen xhigh | 52.3 | $1,482 | 32.1分 | 405 |
| Codex+GPT-6.2 Sol high | 47.5 | $237 | 10.6分 | 42 |
| Codex+GPT-6.2 Sol medium | 45.4 | $176 | 8.4分 | 40 |
総費用の比はHydrogen xhighがSol highの6.3倍、Sol mediumの8.4倍、ステップ数は約10倍です。SolはxhighでもCodexで49.8で、Hydrogenの52.3には届きません。ここで比べているのは「モデル+そのエージェント」の組み合わせで、同じエージェントに2つのモデルを入れたものではありません。AAのページにはHydrogenのxhighの行しかなく、既定のhighでの点数はわかりません。
使い分けとしては、エージェントに長時間任せてでも最高点が要る仕事ならAntigravity CLIのHydrogen xhigh、1件ごとの費用と待ち時間を抑えたい日常の作業ならCodexのSol highかmediumが合います。なお同じ指数ではCodex+GPT-6.1 Sol maxが52.2で、6.2 Solのどの段階より高く出ています。Codexで6.1 Solから移るべきかの判断材料は「GPT-6.2 Sol・6.1 Sol・Opus 5.5の違い:同じ12問の実測と使い分け」にあります。
長い入力:約8万トークンのログはSol、272K超は単価でHydrogen
約8万トークンまでのログ1件では、GPT-6.2 Solのほうが安く速く答えました。8万〜272Kトークンの範囲は実測がありません。272Kを超えるとSolはリクエスト全体の単価が上がるため、単価の面ではGemini 4 Hydrogenが有利になります。2026年11月18日、146KB・1,500行のアプリケーションログを渡し、7つの正確な数値を答えさせる単発テスト(ツールなし、1ターン)を行いました。Solの行は、同じ日に同じログと質問で行った別のテストの結果です。
Hydrogen highは1サンプルで、7問すべて正解、201.2秒、入力79,312トークン、出力33,029トークン(うち思考32,948)、費用$0.3667でした。Sol mediumも全問正解で、13.6秒、入力55,843トークン、出力1,845トークン、費用$0.1581です。このSolの費用は入力がキャッシュ書き込み($2.50)として課金された金額で、入力をすべて通常の$2で数えると$0.1301になります。Hydrogenは費用2.32倍(Solの入力を通常単価で数えると2.82倍)、時間14.8倍でした。Sol highも全問正解で17.3秒、$0.1668です。
このログは5.6万〜7.9万トークンで、Solの割増が始まる272Kよりずっと下です。272Kを超えるリクエストは、単価からの試算になります。Solで30万トークンと数えられる入力に2,000トークンの答えを返す場合、Solは30万×$4+2,000×$15を100万で割って$1.23です。Hydrogenで同じ入力が42%多い426,000トークンと数えられ、ログのテストと同じく33,000トークン出力したと仮定すると、426,000×$1.50+33,000×$7.50を100万で割って$0.89になります。トークン数と思考量はこの仮定どおりにはならないので、自分の入力で一度計測してください。
Solの入力上限は922,000トークン、Hydrogenのコンテキストは1,048,576トークンです。リポジトリ全体を毎回まるごと渡すような使い方では、272Kの線を越えるかどうかが費用を左右します。
思考レベルと推論の強さはどこに置くか:下げると点数が落ちる
Gemini 4 Hydrogenは既定のhighのまま、GPT-6.2 Solは既定のmediumから始め、難しい課題だけhighに上げるのが基本です。Hydrogenをmediumに下げても費用はSolに追いつかず、AAの点数ははっきり下がります。2026年11月16日に同じ11回の課題をHydrogen mediumで実行すると、費用は$0.1927で、11月18日のSol既定の3.16倍でした(実行日が違う比較です)。AAの総合指数は51から41、Terminal-Bench 4.0は54.0%から29.3%に落ちます。
Solはmediumからhighへ上げても負担が小さく、11月18日のテストでは費用1.33倍、秒数1.17倍でした。AAの総合指数は53から55に上がり、1タスクの費用は約1.37倍です。Solのlowは41点で、Hydrogen mediumと同点ですが、AAの1タスクの費用は$0.18対$0.80(4.4倍)です。Hydrogenのlowは27点まで下がるので、点数が要る作業には向きません。
Hydrogenのxhighは54点ですが、AAの1タスク費用$3.16、時間14.8分と、Solのどの段階よりも高く時間もかかります。この11回の課題はどの設定でも全問合格する易しさなので、段階を下げたときの品質低下は表れていません。下げる前に、自分の課題で合格率を確かめてください。
無料で使えるのはどちらか:Gemini APIの無料枠はHydrogenだけ
予算ゼロで試せるのはGemini 4 Hydrogenです。Gemini APIの無料枠では入力も出力も無料ですが、無料枠で送ったデータはGoogleの製品改善に使われ、有料枠のデータは使われません。GPT-6.2 SolにはAPIの無料枠がなく、ChatGPTやCodexで使うにはPlus以上が必要です。
| 入口 | Gemini 4 Hydrogen | GPT-6.2 Sol |
|---|---|---|
| APIの無料枠 | Gemini APIの無料枠、Google AI Studio(全階層) | なし |
| 有料のAPI | Gemini APIの有料枠($1.50/$7.50) | OpenAI API($2/$10) |
| チャットアプリ | Geminiアプリ(プラン未加入の扱いは下記) | ChatGPT Work:Plus、Pro、Enterprise、Edu |
| コーディングエージェント | Antigravity:有料のGoogle AI Pro、Ultra | Codex:Plus、Pro、Enterprise、Edu |
| その他 | Google検索、Gemini for business | GitHub Copilot:Pro+、Max、Business、Enterprise(順次提供) |
Geminiアプリの無料の入口は、出典によって書き方が違います。Googleの発表記事はモデル選択のメニューで全ユーザーが使えるとしていますが、2026年11月16日時点のGeminiアプリのヘルプでは、プラン未加入は「Auto」か「Flash-Lite」で、Autoが一部のプロンプトをHydrogenに回す形です。一方、2026年11月16日には、プラン未加入の個人アカウント1つでWeb版のモデル選択に「4 Hydrogen」が表示されていました(1アカウント・1日の観察)。ChatGPT側は、OpenAIの発表の対象にFreeとGoが入っていません。
HydrogenとSolを切り替えるときに直す設定
モデルIDを書き換えるだけでは動かない設定があります。HydrogenからGPT-6.2 Solへ移る場合、推論の強さにnoneは使えません。2026年11月18日にlaozhang.aiゲートウェイ経由で送ると、HTTP 400でUnsupported value: 'none' is not supported with the 'gpt-6.2-sol' model. Supported values are: 'low', 'medium', 'high', 'xhigh', and 'max'.と返りました。OpenAIのモデルページによると、ツール呼び出しにはResponses APIが必要です。同じゲートウェイでは、Chat Completionsでreasoning_effortに指定できたのはlow〜xhighで、maxはResponses APIでしか使えませんでした。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
同じゲートウェイのChat Completionsでは、応答のmodel欄がgpt-6.2-sol-2026-11-17になり、Responses APIではgpt-6.2-solでした。前者はOpenAIがスナップショットIDとして公開している名前ではないので、この値を前提にしたチェックは書かないほうが安全です。
SolからHydrogenへ移る場合は、思考レベルにminimalがなく、明示的なキャッシュは使えません(暗黙的キャッシュのみ)。同期呼び出しの出力上限は65,536トークンで、Solの128,000トークンを前提にした長い出力はそのままでは収まりません。入力トークンが10〜42%多く数えられたので、トークン数で組んだ予算や上限は計り直してください。
2つのモデルを自分の課題で並べて試すなら、Gemini APIの無料枠でHydrogenを、OpenAI APIでSolを呼ぶのが公式の経路です。1つのキーで両方を呼びたい場合は、laozhang.aiでgemini-4-hydrogenとgpt-6.2-solを各社の定価で呼べます。上のテストもこの経路で呼んだものです。
Gemini 4 HydrogenとGPT-6.2 Solのよくある質問
GPT-6.2 SolはGPT-6.1 Solから何が変わりましたか?
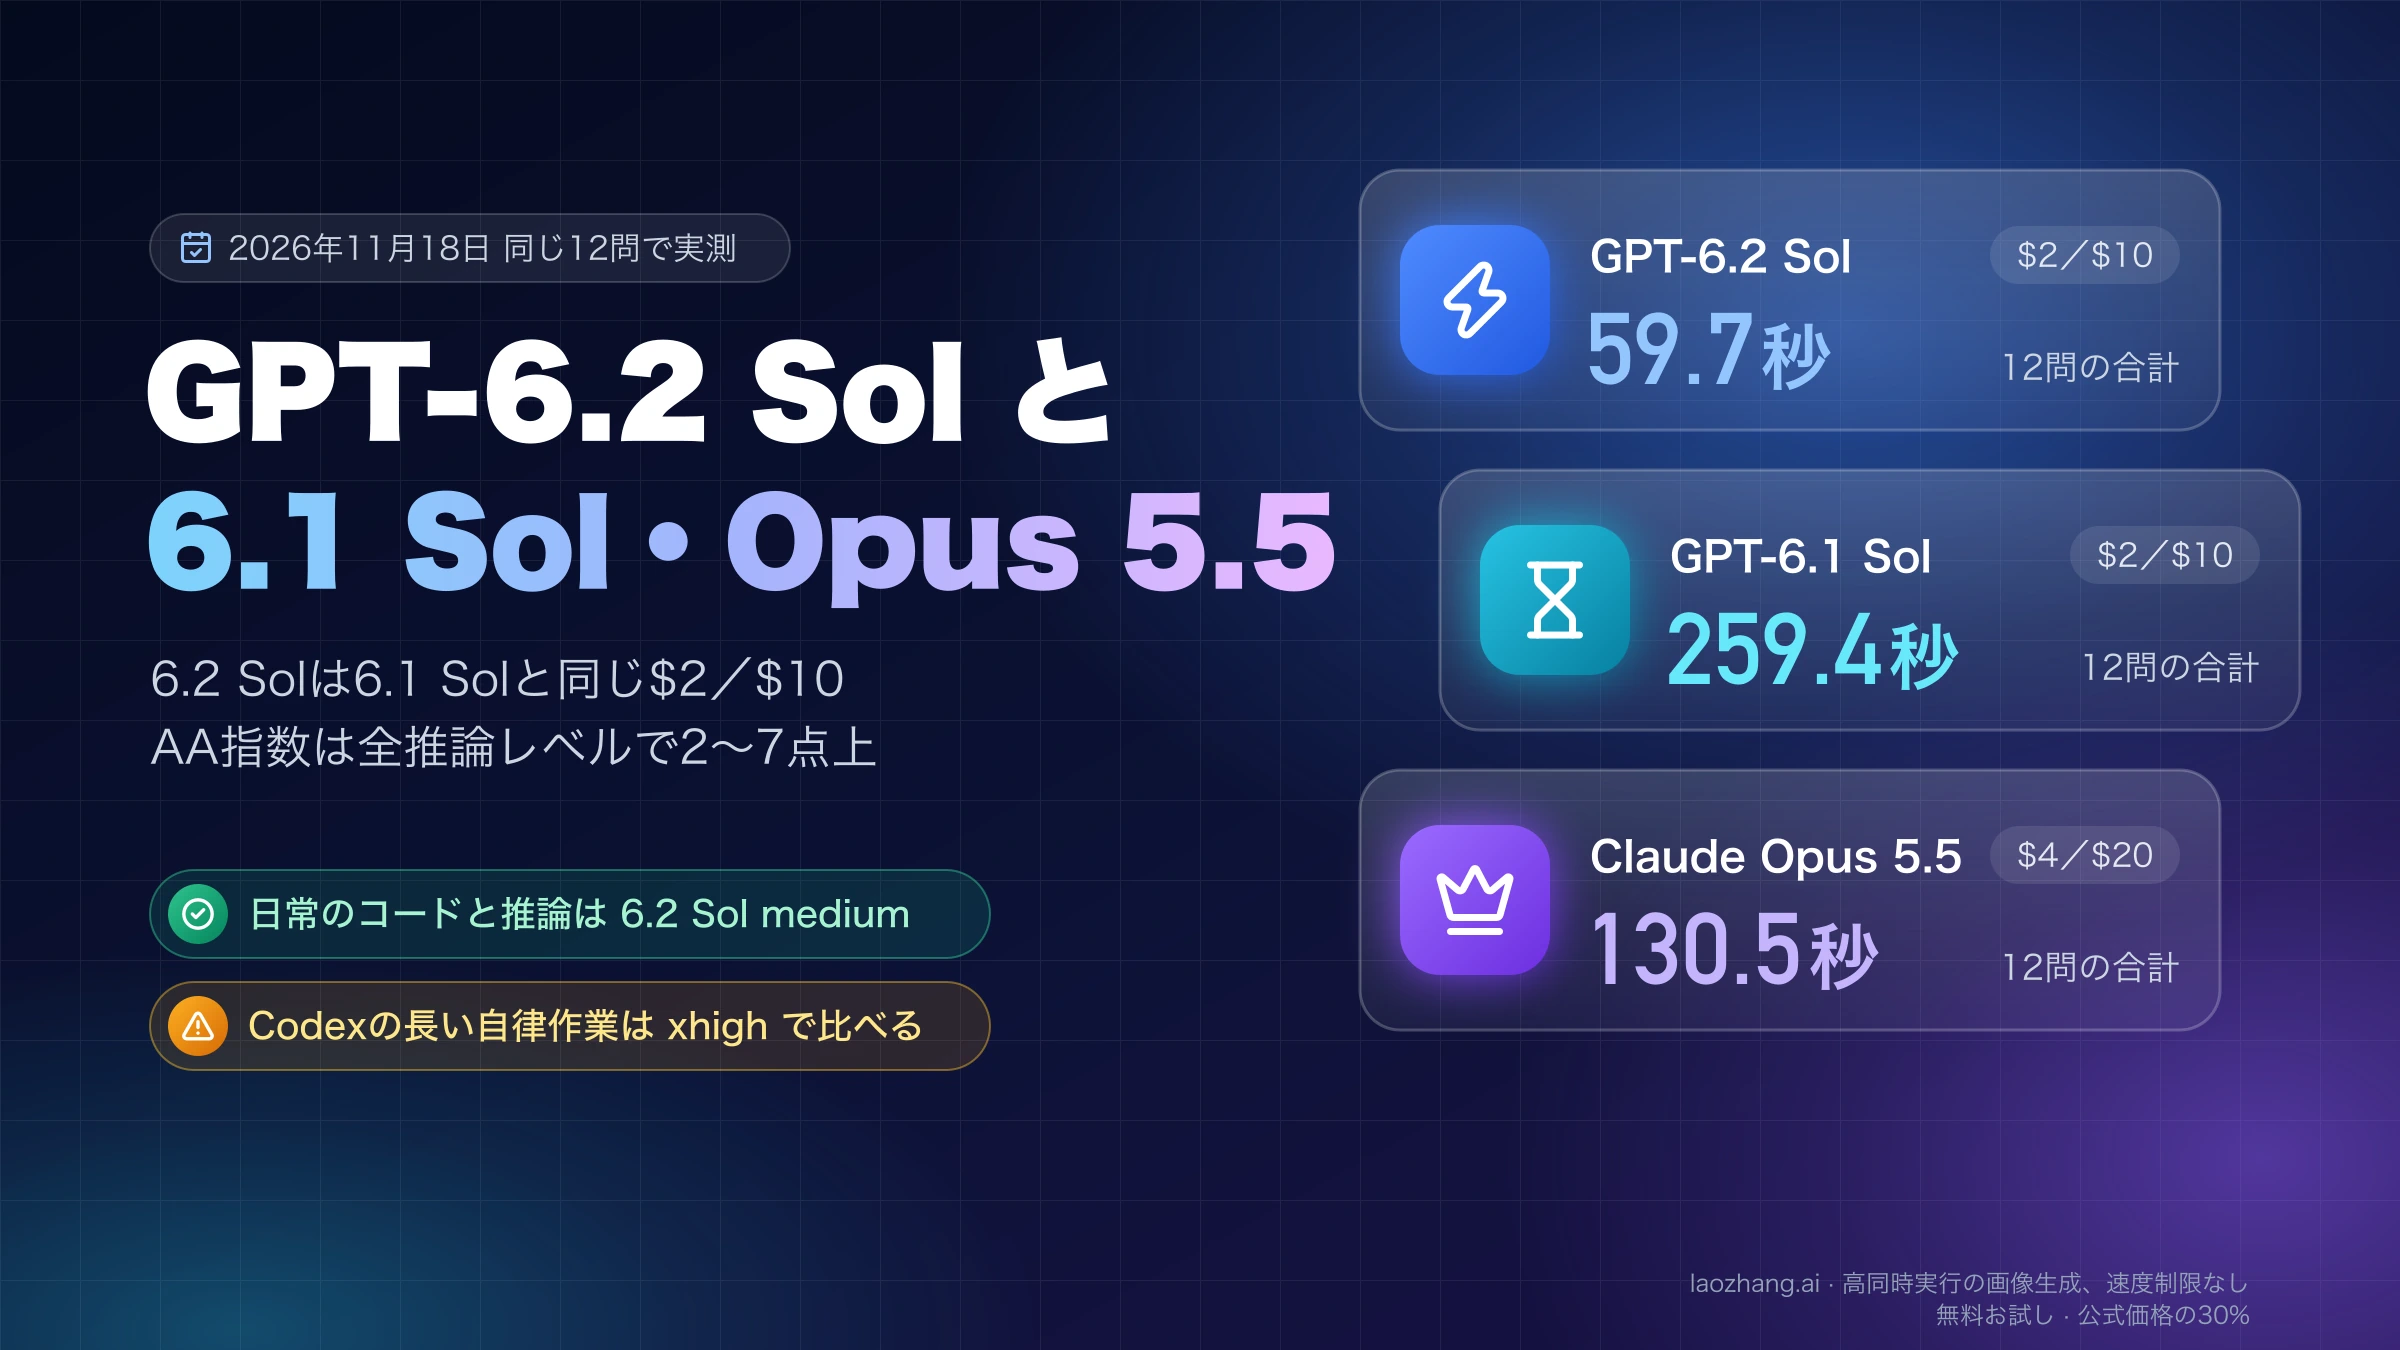
Standard単価は同じで、AAの総合指数はどの段階でも2〜7点上がり、1タスクの時間は短くなっています(6.1 Solは2026年11月16日、6.2 Solは11月18日時点)。同じ12問での実測と移行の判断は「GPT-6.2 Sol・6.1 Sol・Opus 5.5の違い:同じ12問の実測と使い分け」にあります。
「1タスク約$1.27」はGPT-6.2 Solの費用ですか?
違います。$1.27はAAが2026年11月16日時点で示していたGPT-6.1 Sol maxの1タスクあたり費用です。11月18日時点のAAでは、GPT-6.2 Solは最上位のmaxでも$1.01で、6.1 Solの数字を6.2 Solのものとして使うと費用を高く見積もることになります。
Gemini 4 Hydrogenを3.1 ProやSonnet 5.5と比べるとどうですか?
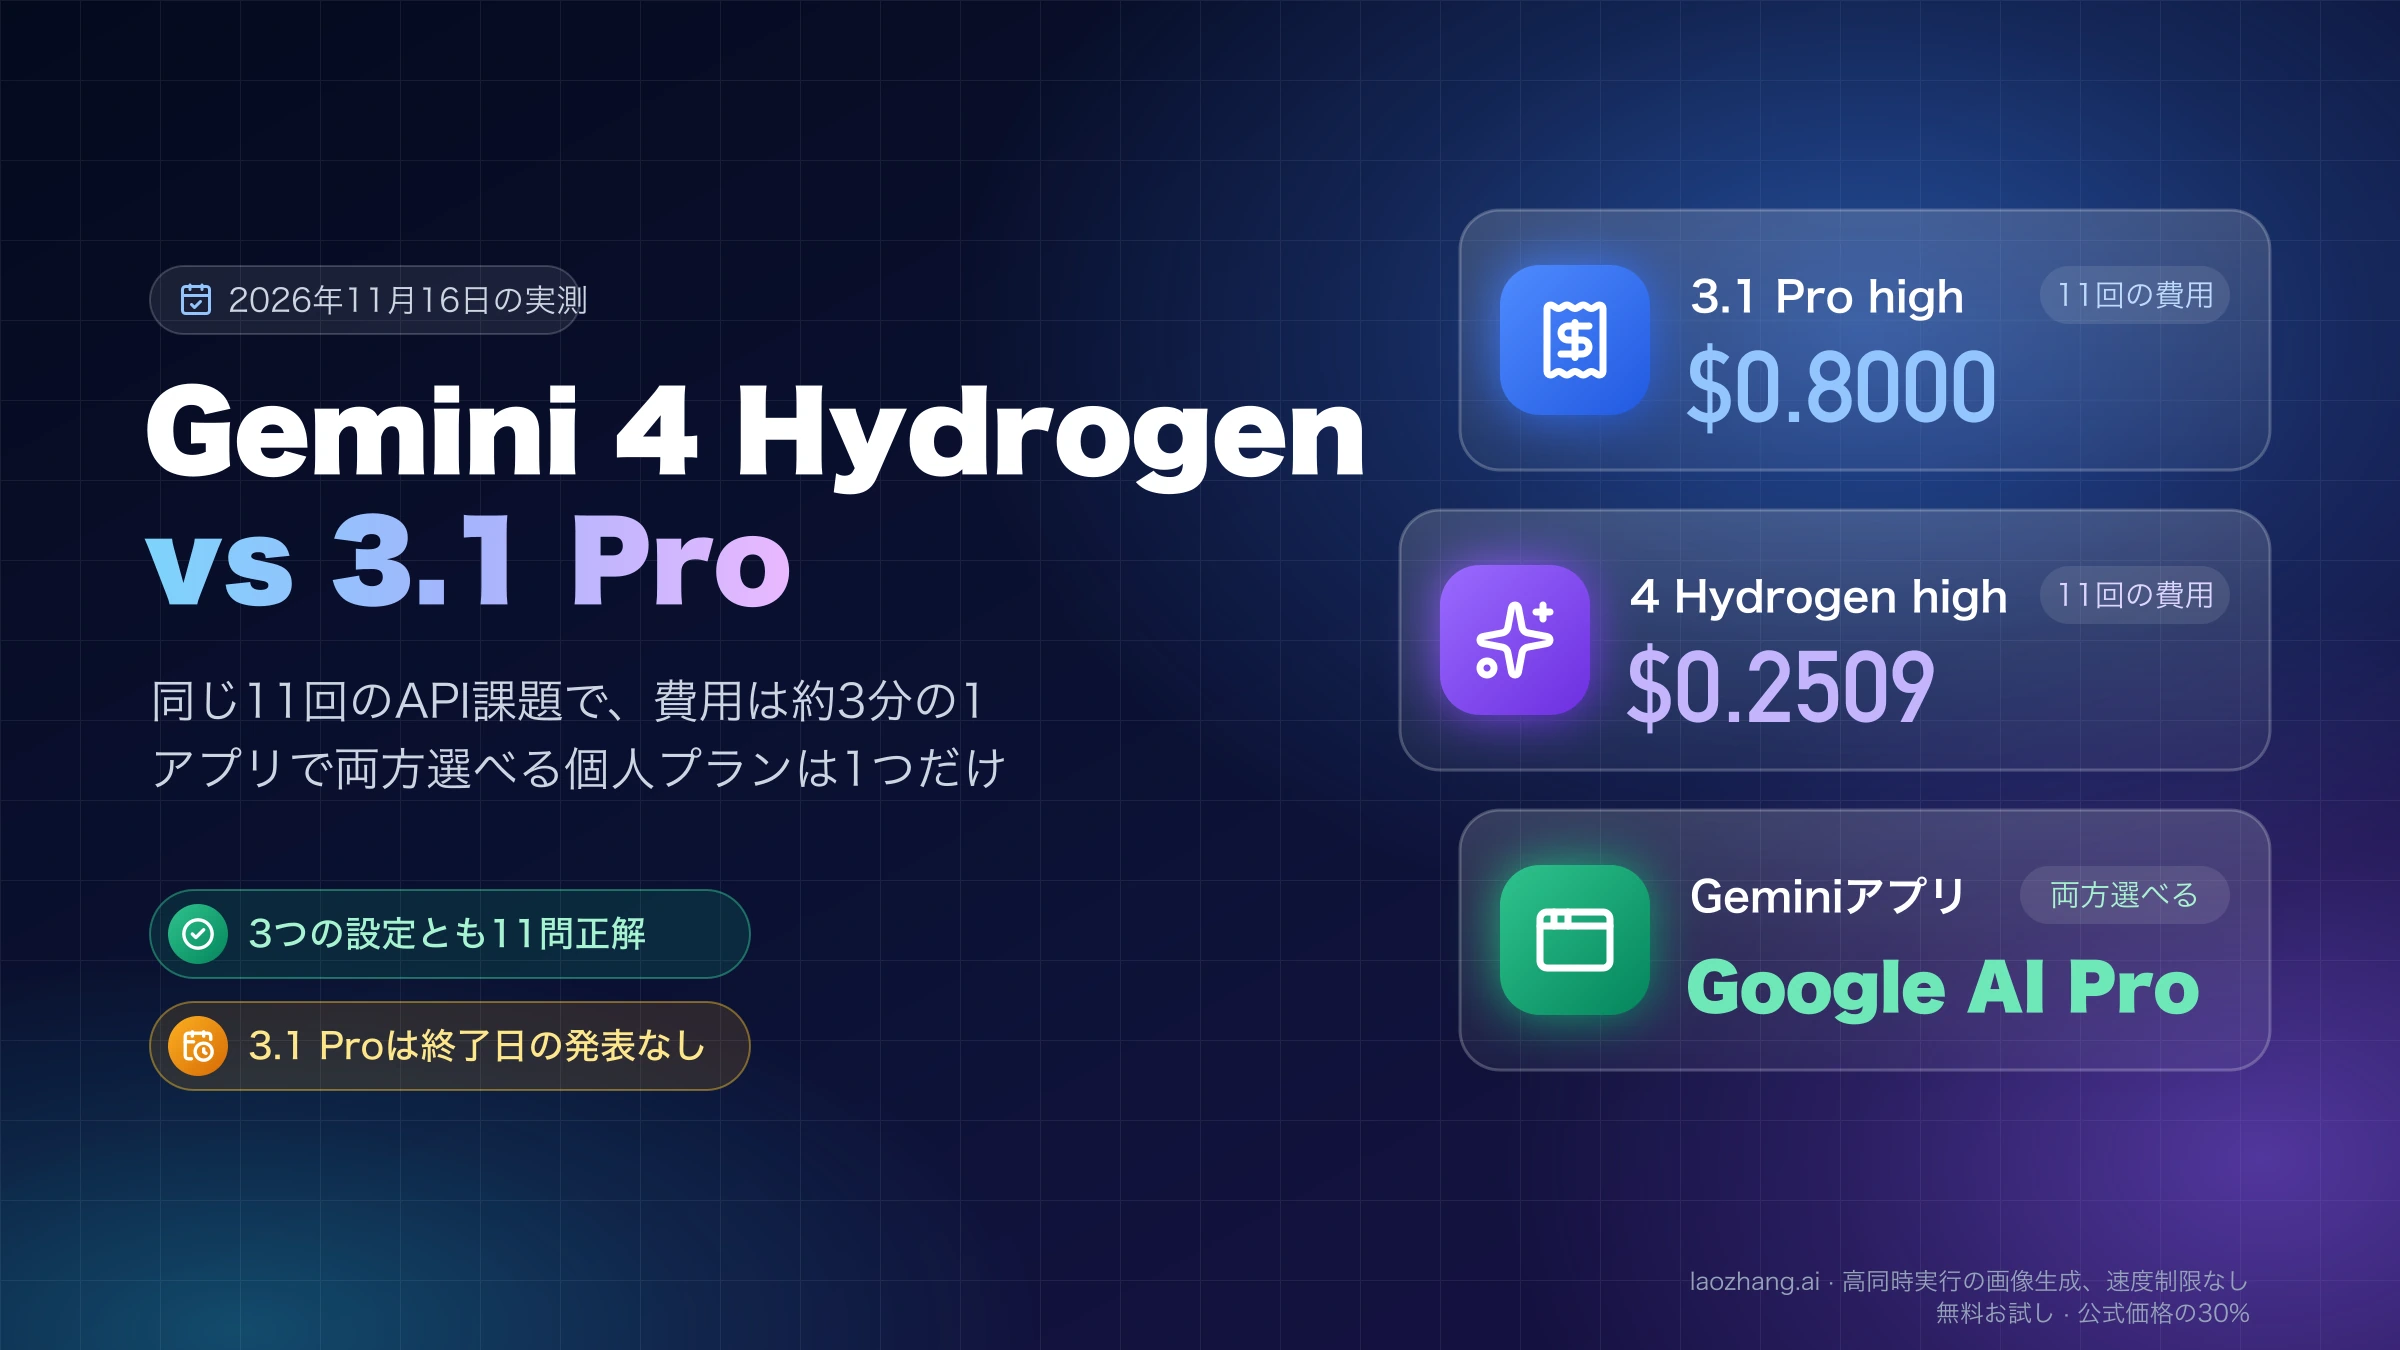
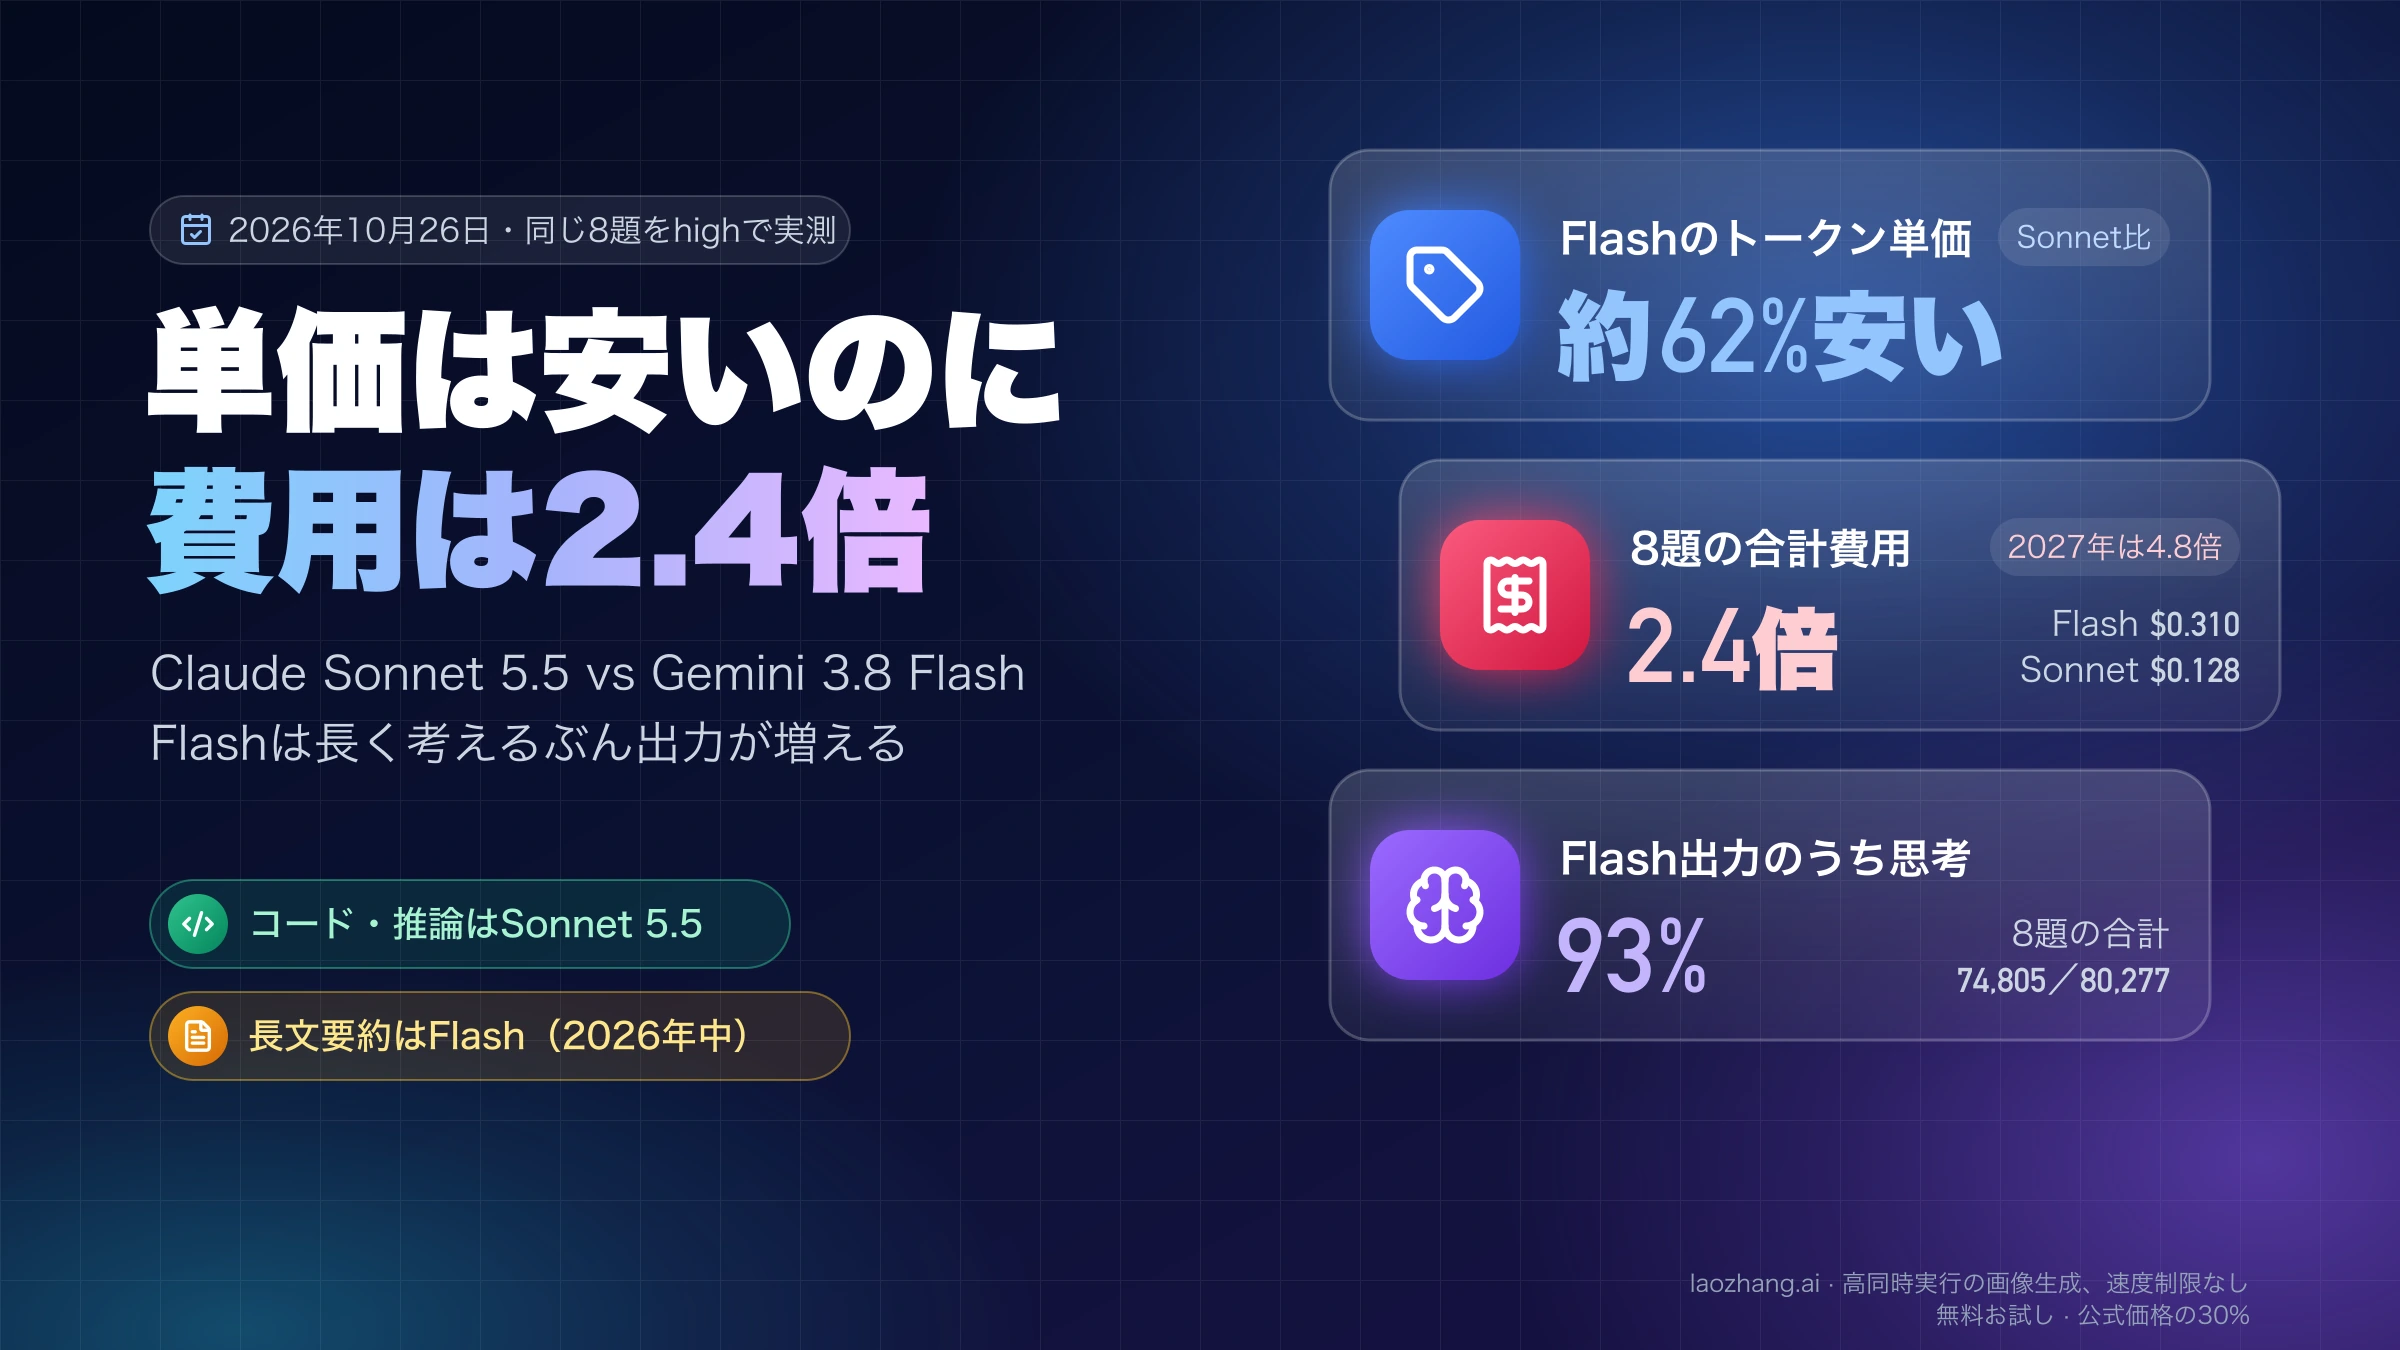
同じ11回の課題セットで比べたページがあります。Gemini 3.1 Proとの比較は「Gemini 4 Hydrogenと3.1 Pro比較:同じ課題の実測で費用約3分の1」、Claude Sonnet 5.5や3.8 Flashとの比較は「Sonnet 5.5とGemini 3.8 Flash比較:Gemini 4 Hydrogenの実測費用」です。これらのページにあるHydrogen highの費用$0.2509は2026年11月14日の実行で、上の表の11月18日の再実行とは日付が違います。
Gemini 4 Carbonに上げたほうがよいですか?
CarbonはGemini 4の最上位モデルで、上と同じ146KBのログでは2026年11月11日に既定設定で213.9秒、$0.4281でした(Hydrogenとは実行日が違います)。前世代のGPT-6.1 Solと比べた結果は「Gemini 4 CarbonとGPT-6.1 Sol比較:コーディング費用はCarbonが7倍」にあります。
参考資料8
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月18日。
参考資料8
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月18日。
- 1.Gemini APIの料金ページai.google.dev/gemini-api/docs/pricing
- 2.OpenAIのGPT-6.2 Solモデルページdevelopers.openai.com/api/docs/models/gpt-6.2-sol
- 3.OpenAI APIの料金表developers.openai.com/api/docs/pricing
- 4.GPT-6移行ガイドdevelopers.openai.com/api/docs/guides/latest-model
- 5.個人の比較記事developer.aliyun.com/article/1782979
- 6.AAのGPT-6.2 SolとGemini 4 Hydrogenの比較ページartificialanalysis.ai/models/comparisons/gpt-6-2-sol-vs-gemini-4-hydrogen
- 7.The Decoderの発表記事the-decoder.com/openai-launches-gpt-6-2-astra-and-sol-with-lower-api-prices-and-some-benchmark-gains
- 8.AAのCoding Agent Indexartificialanalysis.ai/agents/coding