Claude Fable 5.2とGPT-6.2 Sol比較:実測費用はFableが6.5〜12倍
GPT-6.2 Solの単価はFable 5.2の4分の1。同じ問題で両方全問合格し、費用差は6.5〜12倍でした。ただしSolはmaxでもFable highの点に届きません。
目次
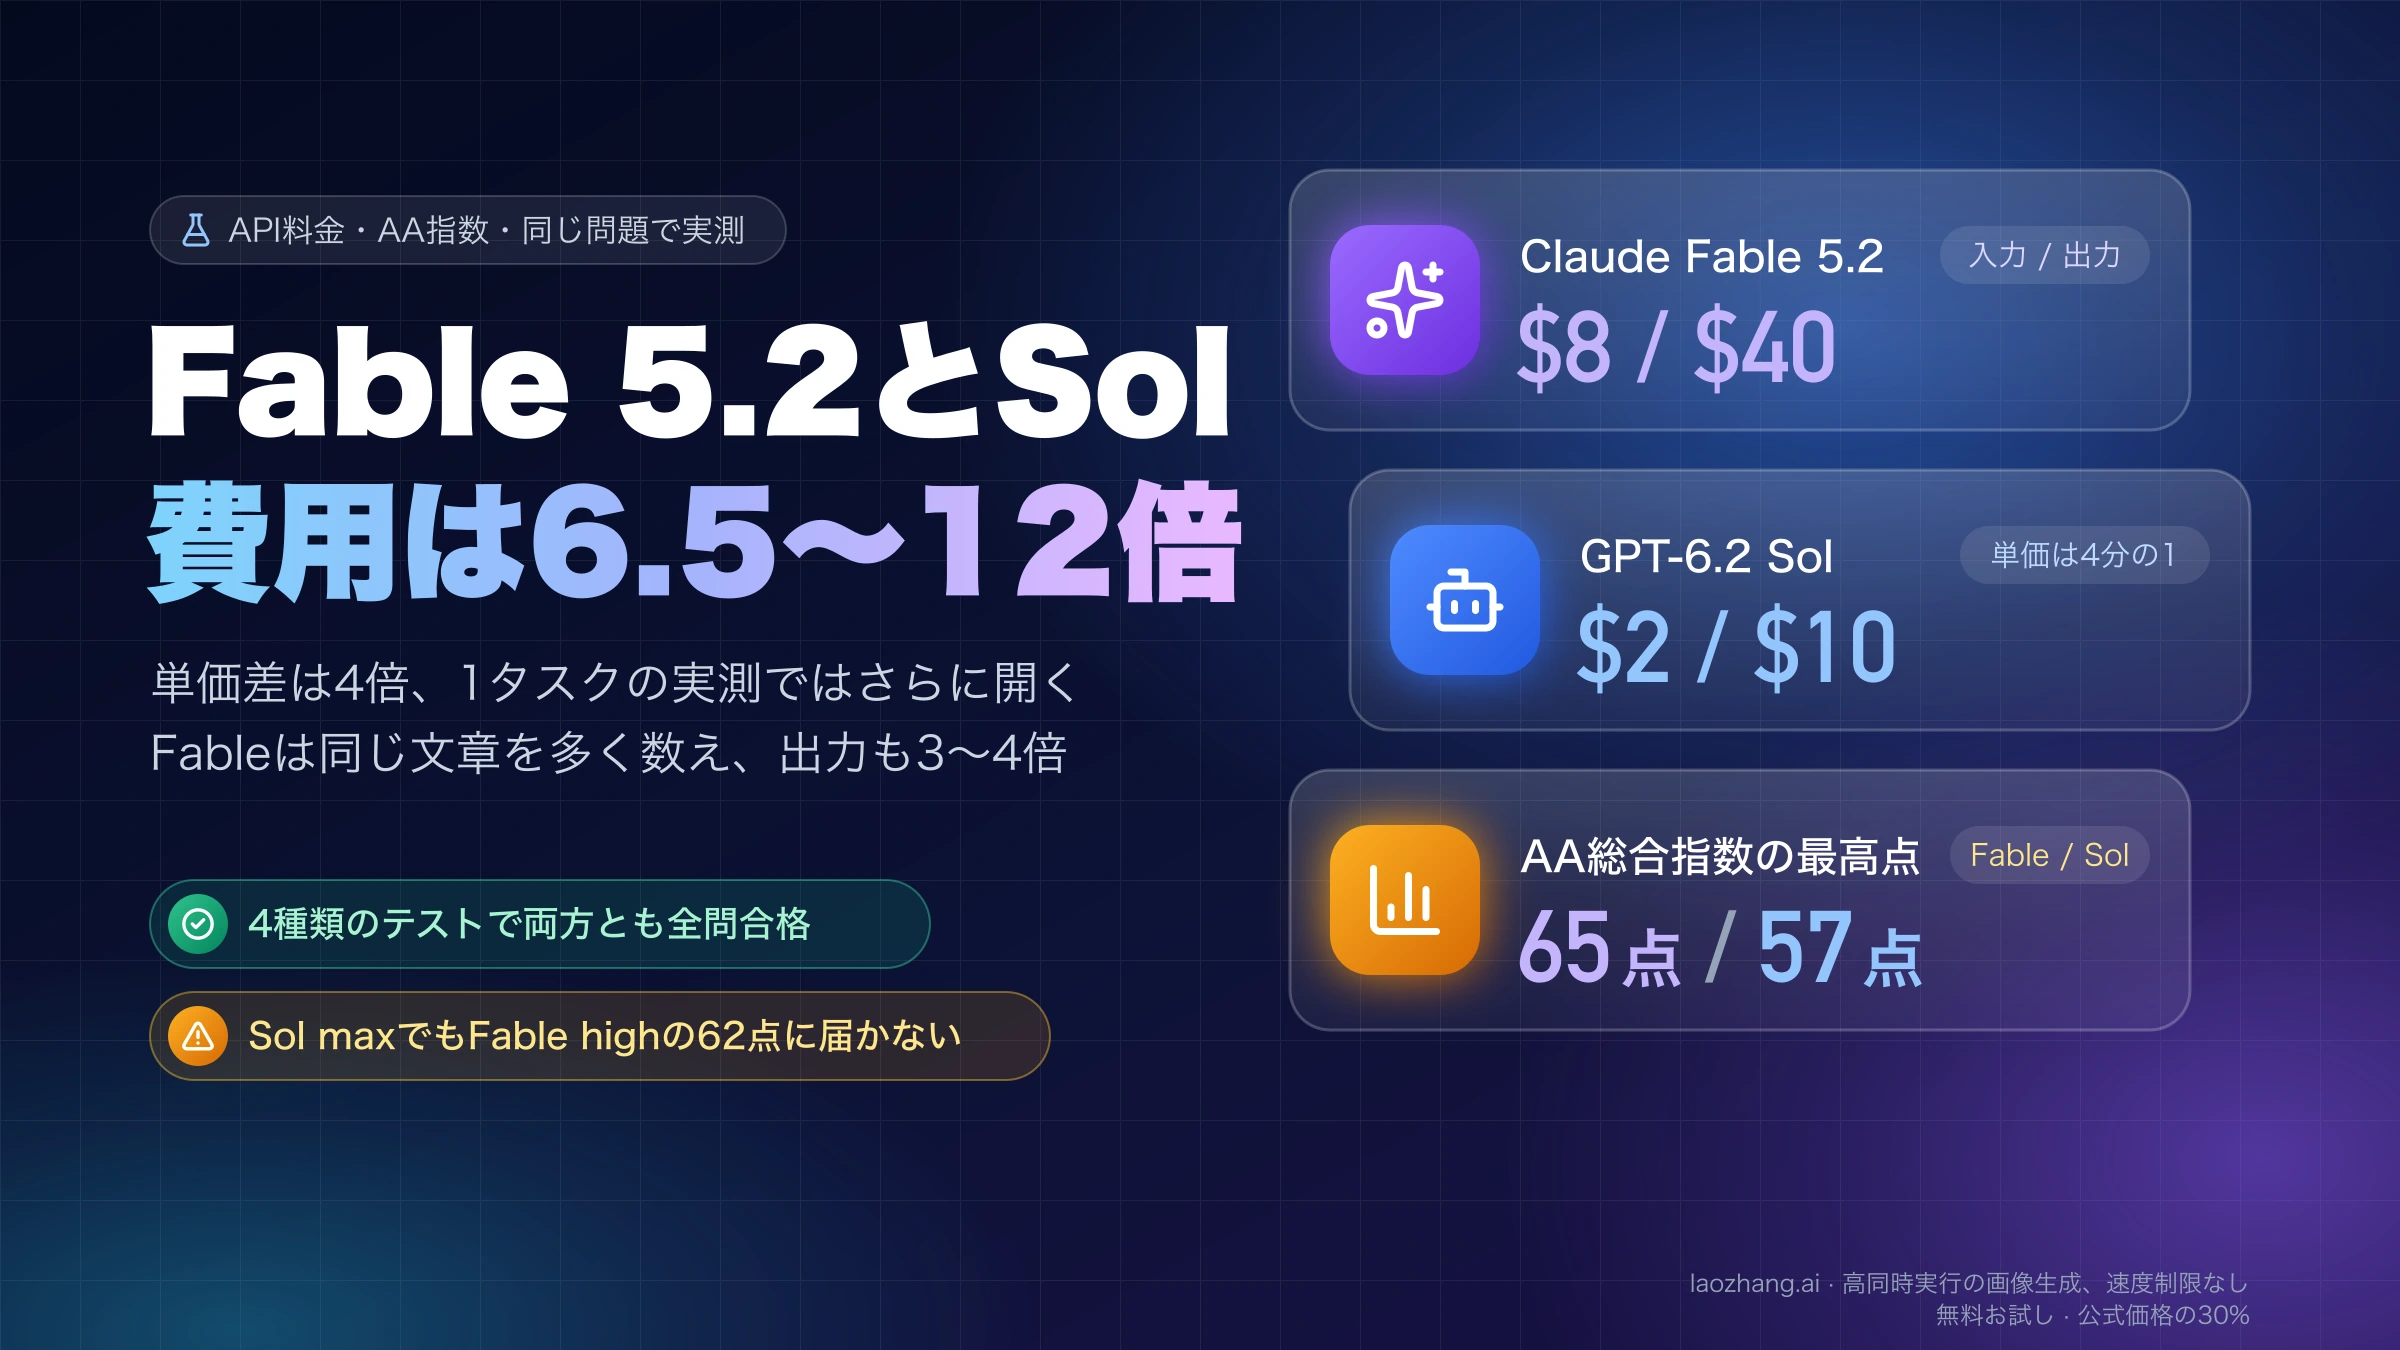
Claude Fable 5.2をlowかmediumで使っている仕事は、GPT-6.2 Solのhighからmaxへ移す候補になります。 第三者機関Artificial Analysis(AA)の総合指数v5.0.1(2026年11月20日時点)では、Sol maxの57点がFable mediumの56点を1点上回り、1タスクの費用は$1.01対$3.80で約27%です。反対に、Solをmaxまで上げてもFable highの62点には届きません。いちばん高い点数が要る仕事は、Fable 5.2に残すのが前提です。
トークン単価の差は4倍(入力$2対$8、出力$10対$40)ですが、1タスクの費用差はそれより大きく開きます。2026年11月10日から20日にかけて同じ問題を両方に解かせた4種類のテストでは、どちらも全問合格し、Fableの費用はSolの6.5〜12.2倍でした。Fableは同じ文章を多めのトークンで数え、出力も3〜4倍書くからです。実測で分かった差は費用・トークン数・時間だけで、品質の差を示す数字はAAの指数とOpenAIの発表グラフにしかありません。
切り替える前に、品質以前にどちらかが外れる条件を確かめてください。ゼロデータ保持で運用している組織ではFable 5.2がエラー400を返し、Solは入力が272Kトークンを超えるとリクエスト全体が入力$4・出力$15の単価になります。そのうえで、自分の仕事から合否を判定できる問題を選び、両方に解かせて合格1件あたりの費用で比べるのが確実です。
料金の差:トークン単価は4倍、AA指数の1タスク費用は9〜26倍
100万トークンあたりの定価では、Claude Fable 5.2は入力・出力ともGPT-6.2 Solの4倍です。キャッシュ読み込みだけは2倍で、Solの入力が272Kトークンを超えるリクエストでは差が縮まります。金額はOpenAIのAPI料金ページとAnthropicのClaude API料金ページにもとづく、2026年11月18日時点の標準単価です。
| 項目(100万トークンあたり) | Claude Fable 5.2 | GPT-6.2 Sol | Fable÷Sol |
|---|---|---|---|
| 入力 | $8.00 | $2.00 | 4倍 |
| キャッシュ読み込み | $0.20 | $0.10 | 2倍 |
| 出力 | $40.00 | $10.00 | 4倍 |
| 入力272Kトークン超のリクエスト | 変わらず入力$8・出力$40 | リクエスト全体が入力$4・出力$15 | 入力2倍、出力2.67倍 |
| Batch(入力・出力) | $4・$20 | $1・$5 | 4倍 |
| 高速モード(入力・出力) | $16・$80 | Fast $4・$20 | 4倍 |
| キャッシュ書き込み | 5分$10、1時間$16 | 30分$2.50、12時間$5.00 | 保持時間が違う |
Solにはさらに速いUltrafastもあり、2027年2月28日までは通常の3倍($6・$30)、その後は6倍になります。Fable 5.2は100万トークンの文脈全体が標準単価のままなので、長い入力ほどSolとの単価差は縮みます。
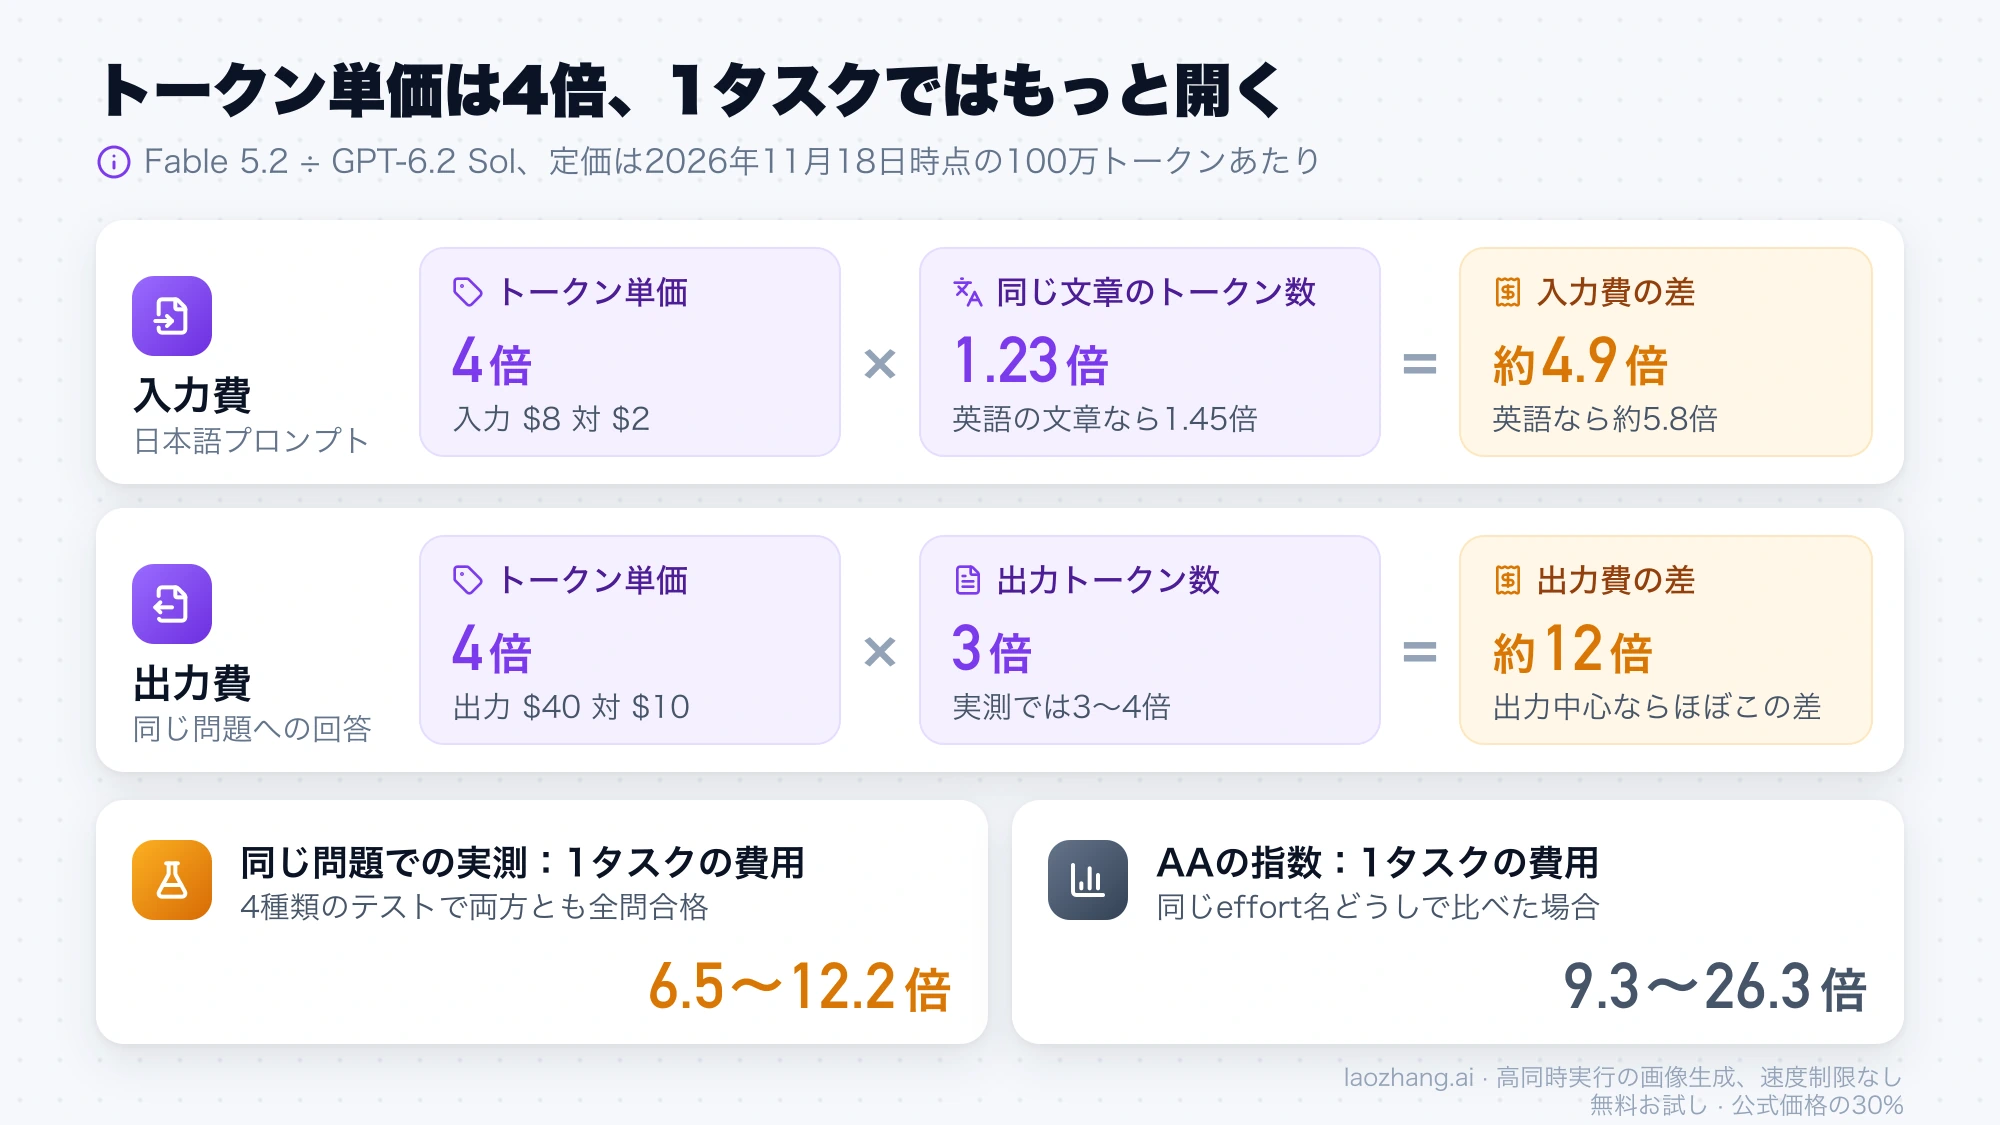
1タスクで差が4倍を超える理由は二つあります。一つはトークンの数え方です。2026年11月18日に同じ日本語の文章を数えさせると、Fable 5.2はGPT-6.2 Astraの1.23倍のトークンとして数えました。Solは同じ11件のプロンプトでAstraとまったく同じ入力トークン数を返したので、同じ数え方とみなすと、同じ日本語プロンプトの入力費はFableが約4.9倍(4×1.23)になります。英語の文章では1.45倍なので約5.8倍です。もう一つは出力の量で、同じ問題に対してFableはSolの3〜4倍の出力トークンを書きました。出力が3倍なら出力費は4×3で約12倍になり、費用の大半を出力が占める問題ではこれがほぼそのまま1タスクの差になります。
AAの指数で同じeffort名どうしを比べても、1タスクの費用はFableがSolの9.3〜26.3倍です。「Fableは4倍高い」という言い方はトークン単価の話で、請求額の見積もりには使えません。
Fableの設定ごとに置き換えられるSol:AA指数の同点ペア
Fable 5.2のlowとmediumは、GPT-6.2 Solの上のほうの設定で同じ点数に届きますが、Fable high以上に届くSolの設定はありません。AAのClaude Fable 5.2とGPT-6.2 Solの比較ページにある総合指数v5.0.1(9種類の評価、2026年11月20日時点)を、点数の近い組み合わせで並べると次のようになります。
| いま使っているFable 5.2 | 点数が並ぶGPT-6.2 Sol | 点数の差 | 1タスクの費用 |
|---|---|---|---|
| max(65点) | なし | Sol最高の57点まで8点 | — |
| xhighまたはhigh(62点) | なし | Sol最高の57点まで5点 | — |
| medium(56点) | xhigh(56点)、max(57点) | 同点、Solが1点上 | $3.80に対し$0.65(17%)、$1.01(27%) |
| low(54点) | high(55点) | Solが1点上 | $3.10に対し$0.56(18%) |
| low(54点)で速さも欲しい | medium(53点) | Solが1点下 | $3.10に対し$0.41(13%) |
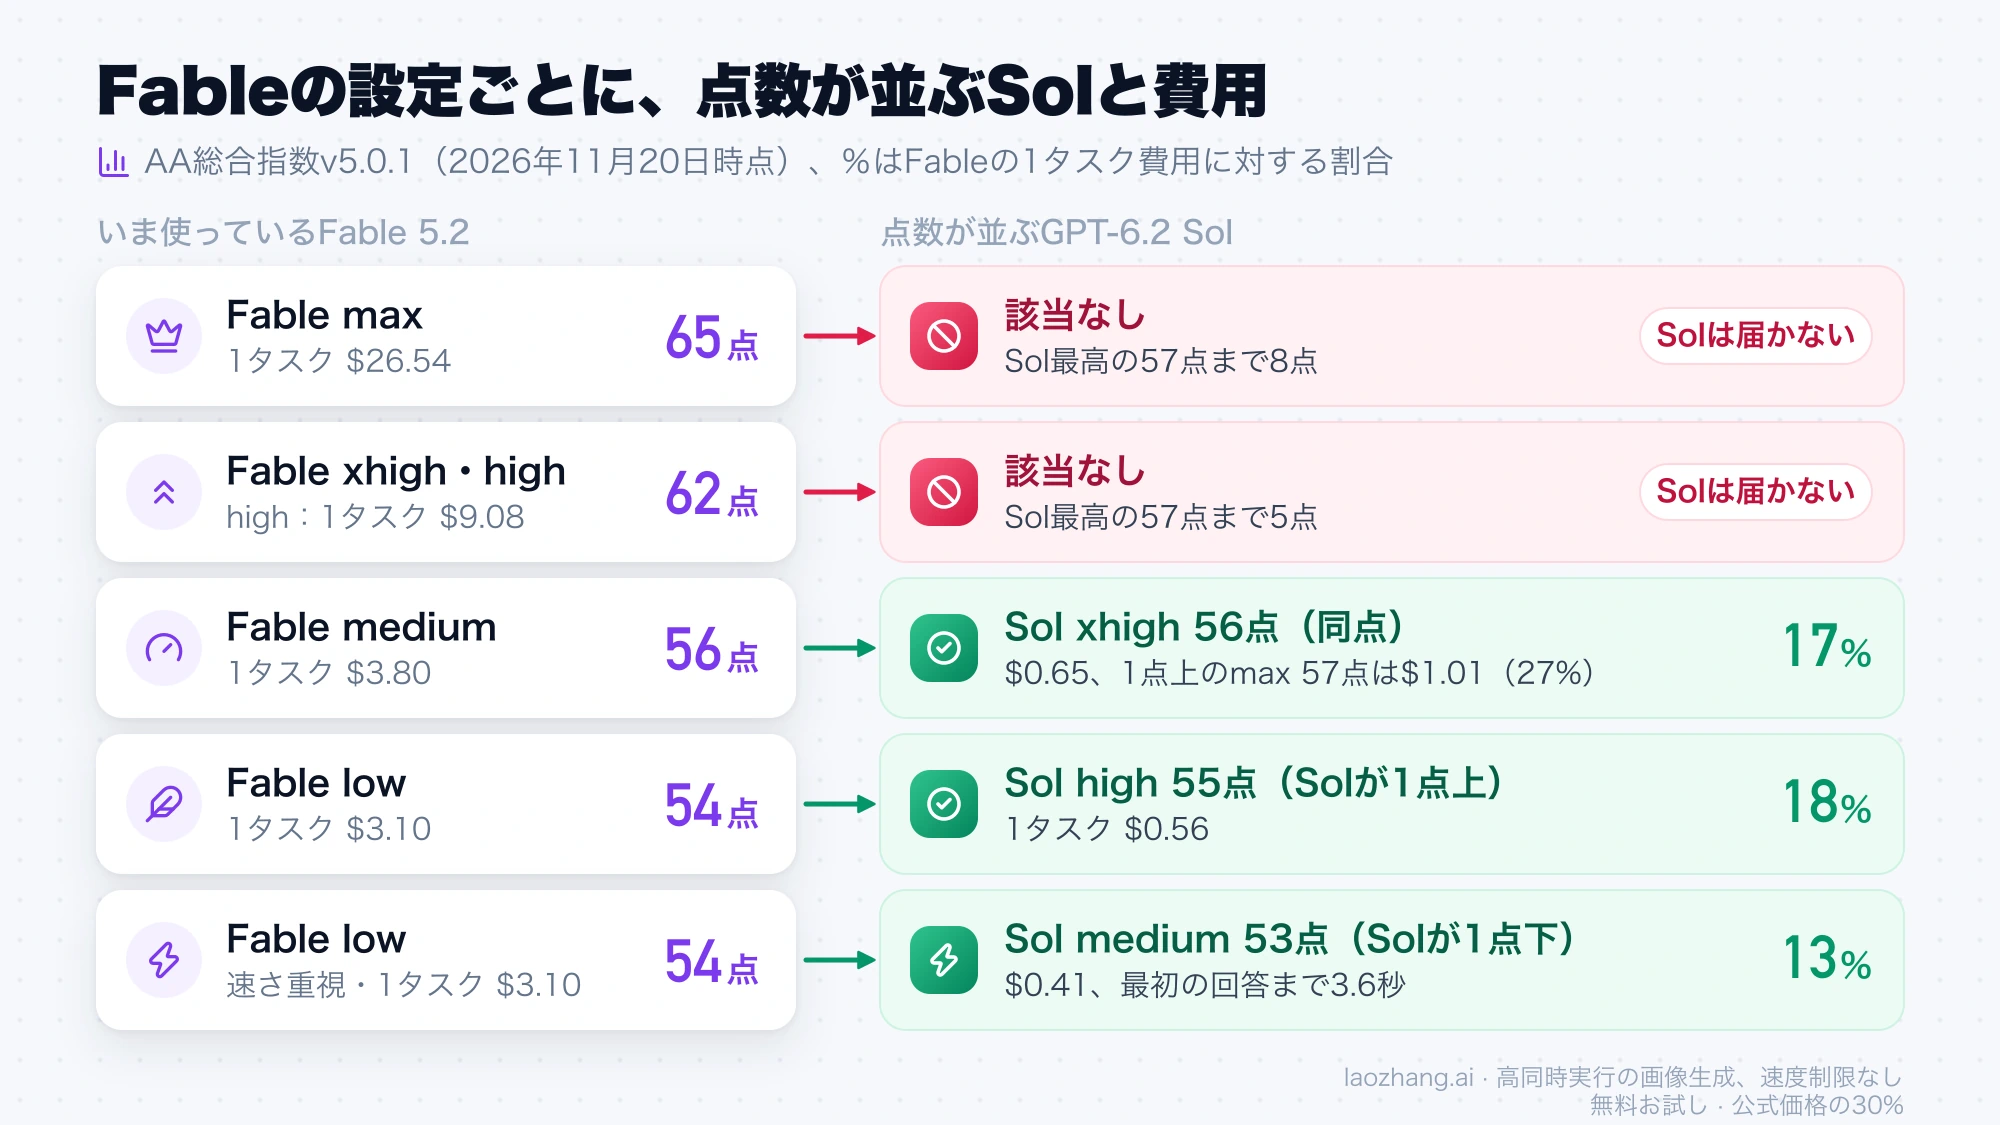
小数点まで見ると、OpenAIが発表グラフに載せた同じ指数の値ではSol xhighが55.7、Fable mediumが56.4、Sol maxが57.3です。Fable mediumを確実に上回りたいならSol max、少しの差を許せるならSol xhighという選び方になります。
同じeffort名どうしで並べると、点数はどの段階でもFableが上で、費用の差は段階によって大きく変わります。
| effort | Fable 5.2:点数・1タスク費用・時間 | GPT-6.2 Sol:点数・1タスク費用・時間 | 費用の倍率 |
|---|---|---|---|
| max | 65点・$26.54・42.0分 | 57点・$1.01・9.6分 | 26.3倍 |
| xhigh | 62点・$14.83・24.5分 | 56点・$0.65・5.9分 | 22.8倍 |
| high | 62点・$9.08・15.2分 | 55点・$0.56・5.0分 | 16.2倍 |
| medium | 56点・$3.80・6.5分 | 53点・$0.41・3.5分 | 9.3倍 |
| low | 54点・$3.10・5.5分 | 41点・$0.18・1.6分 | 17.2倍 |
この指数は設定どうしの順位を示すもので、特定の仕事の結果を予測するものではありません。AAは数値を予告なく更新することがあり、Fableの1タスクの時間もこれまでに変わっているため、時間は2026年11月20日時点の値です。
OpenAIの発表グラフでSolが勝つ所と負ける所
OpenAI自身の比較グラフでも、各ベンチマークの最高点はほとんどFable 5.2が上で、GPT-6.2 Solが上回るのは一部のeffortに限られます。OpenAIのGPT-6.2 AstraとSolの発表ページにある5つのグラフのうち、SolとFableの値(グラフのデータラベル、2026年11月20日時点)は次のとおりです。どのベンチマークを載せるか、どの実行環境で測るかはOpenAIが決めたもので、ベンダーの自己申告です。
| ベンチマーク | Fable 5.2の最高 | GPT-6.2 Solの最高 | 同じeffortどうしの差 |
|---|---|---|---|
| Agents' Last Exam v1.1 | 72.8%(max、$60.05) | 73.0%(max、$1.32) | Fableはmaxの1点だけ |
| Terminal-Bench-Science 0.1 | 73.3%(max、$45.21) | 68.0%(max、$2.21) | mediumはSol、それ以外はFable |
| Vals Science Index v1 | 63.7%($8.79) | 58.5%($0.71) | Fableは1点だけ |
| BenchCAD 2.1 Core | 83.5%(max、$50.77) | 73.1%(max、$1.60) | mediumとhighはSol、それ以外はFable |
| AutomationBench 1.0.6 | 51.4%(max、$4.64) | 41.2%(high、$0.21) | mediumは40.2%で同点、それ以外はFable |
Agents' Last ExamでSolが上というのは0.2ポイントの差で、発表ページの注記によるとFable 5.2の結果は代替モデルが使われた9タスクを除いたものです。品質で勝ったと読める差ではありません。Solがはっきり上回ったのは、BenchCADのmedium(41.2%対32.4%)とhigh(64.0%対61.0%、1タスク$0.75対$9.99)、Terminal-Bench-Scienceのmedium(63.1%対60.5%)です。
一方、最高点どうしではTerminal-Bench-Scienceで5.3ポイント、Vals Science Indexで5.2ポイント、BenchCADで10.4ポイント、AutomationBenchで10.2ポイントFableが上です。Terminal-Bench-ScienceのFableの値はAAがmini-swe-agentという実行環境で測ったもので、AnthropicはClaude Codeのmaxで74.6%と報告しています。
同じ問題での実測:全問合格で、差は費用と時間だけ
2026年11月10日から20日にかけて同じ問題をClaude Fable 5.2とGPT-6.2 Solに解かせた4種類のテストでは、どちらもすべての回答が合格しました。差が出たのは費用、トークン数、時間だけで、Fableの費用はSolの6.5〜12.2倍です。APIのテストはどれもAPIゲートウェイのlaozhang.aiを同じ条件で使い、CLIのテストは各社の定額プランの利用量をAPI定価に換算した値で、請求額ではありません。日付はUTCです。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
表の「既定」は、effortを指定しなかったときの各APIの初期値で、Fable 5.2はhigh、GPT-6.2 Solはmediumです。Claude CodeでのFableの初期値はmediumなので、同じ「既定」でも意味が違います。
| テスト | Claude Fable 5.2 | GPT-6.2 Sol | 費用の倍率 |
|---|---|---|---|
| 8問・11回答(API) | 既定high:11/11合格、$0.7436、合計173.2秒(11月11日) | 既定medium:11/11合格、$0.0610、合計56秒(11月18日) | 12.2倍 |
| 146KBのログから7つの件数を数える(API) | 既定high:全問正解、$1.02、73.7秒(11月11日) | 既定medium:全問正解、$0.1581、13.6秒(11月18日) | 6.5倍 |
| 11問のエージェント課題(CLI、1回あたり) | Claude Codeでhigh:2回とも全問合格、$2.1545、221.8秒(11月10日) | Codex CLIでhigh:3回とも全問合格、$0.184、中央値195秒(11月20日) | 11.7倍 |
| 新しい難問8問×2回(API) | 既定high:16/16合格、$3.6118、1回の中央値25.8秒(11月20日) | 既定medium:16/16合格、$0.2971、1回の中央値7.3秒(11月20日) | 12.2倍 |
最初の3つのテストは、同じ問題と同じ採点でFableを11月10日・11日、Solを11月18日・20日に実行したもので、その間にFableの単価は変わっていません。8問・11回答のテストではFableをlowまで下げても$0.4201で、Sol既定の6.9倍でした。Solをhighに上げても$0.0812で、結果は同じです。
最後の難問セットは、品質の差を見つけるために新しく作ったものです。会議の空き時間探し、優先順位と短絡評価のある整数式の言語、夏時間の切り替え(ロードハウ島の30分ずれ、サモアで2011年に消えた1日)を扱う予約処理、波かっこ展開と**を含むglob照合、83行のキャッシュから二つのバグを見つけて直す問題、8つの規則が絡むJSONの計画、正解6503の数え上げ、正解$130.10の12日間在庫シミュレーションの8問で、問題と隠しテストはモデルを呼ぶ前の2026年11月20日15時48分(UTC)に固定してあります。結果はFable既定、Fable medium($1.7857)、Sol既定、Sol high($0.4574)、Sol xhigh($0.7008)のすべてが16/16でした。
難問セットでも差は費用にしか出ませんでした。問題ごとのFable既定とSol既定の費用比は9.2〜19.7倍で、8問すべてでSolのほうが安く、Fable mediumとSol xhighを比べても2.55倍です。Solをmediumからxhighに上げると推論トークンは14,502から55,000へ約4倍に増えましたが、結果は一つも変わっていません。glob問題の隠しテストのうち1件は問題文に書かれていない規則を確かめていたため、採点から外しています。10件の回答すべてがこの1件だけで不合格になっていたので、外しても比較の結果は変わりません。
CLIのテストはモデルだけでなくClaude CodeとCodex CLIという道具の違いも含み、Fableの列は11月10日の結果を再実行していません。Solの費用は、1回あたり約30万トークンの入力のうち約88%がキャッシュ読み込み($0.10)で、出力トークンはFableがSolの3.10倍でした。どのテストも1回で終わる問題か小さなCLI課題で、何時間も続く複数ファイルのエージェント作業は含んでいません。品質の差があるとすれば、そうした長い作業で出るはずです。
どちらが速いか:Sol mediumは最初の回答まで3.6秒
effort名をそろえて比べるなら、GPT-6.2 Solのほうがはっきり速く返します。AAの計測(2026年11月20日時点)では、最初の回答トークンまでの時間はSol mediumが3.6秒、Fable mediumが11.2秒、highはSolが13.5秒、Fableが25.1秒です。難問セットでも1回の中央値は7.3秒対25.8秒、146KBのログは13.6秒対73.7秒でした。
点数をそろえると話が変わります。Fable mediumの点数を超えるSol maxは1タスク9.6分で、Fable mediumの6.5分より長く、最初の回答まで83.9秒かかります。同点のSol xhighは5.9分で、Fable mediumよりわずかに短い程度です。CLIの11問ではSolの中央値195秒に対しFableは221.8秒で、コマンドの実行時間も含むため差は小さくなりました。安く同じ点数を出すことはできても、速さまで同時に得られるとは限りません。
Fable 5.2が使えない条件、Solの費用が上がる条件
次の条件に当てはまると、品質を比べる前に選択肢が決まるか、見積もりが変わります。互いに独立しているので、一つずつ確認してください。根拠はAnthropicのFable 5.2の概要とFable 5.2への移行ガイド、OpenAIのGPT-6.2 Solのモデルページです。
- ゼロデータ保持(ZDR)の契約で運用している組織では、Fable 5.2はそのままでは使えません。30日間のデータ保持が前提で、承認がなければリクエストは400で拒否されます。
- 特定のツールを強制する
tool_choice(anyやtool)を送るコードは、Fable 5.2では400になります。 - 高リスクのサイバーセキュリティや大半の生物学研究のタスクは、Fable 5.2の安全分類器によって旧モデルに回されます。
- Fable 5.2のレート制限はOpus 5.5より低く設定されています。
- GPT-6.2 Solは入力が272Kトークンを超えると、そのリクエスト全体が入力$4・出力$15で課金されます。長い文書を丸ごと渡す使い方では、単価の差が入力2倍・出力2.67倍まで縮みます。
- GPT-6.2 Solはeffortの
noneを受け付けません。2026年11月18日にAPIゲートウェイ経由で送ると、400で「Unsupported value: 'none' is not supported with the 'gpt-6.2-sol' model…」が返りました。指定しなければmediumで、Chat Completionsでもlowからxhighまでは通り、maxはResponses APIが必要でした。
Fable用のコードをSolへ移すときは、OpenAIのResponses APIに合わせた書き換えも必要です。GPT-6.2 Solでツールを呼び出すにはResponses APIを使い、GPT-6.2以降のモデルは最上位のinstructionsを入力の後ろに付けるため、長いシステムプロンプトをキャッシュの対象にしたいときはdeveloperメッセージとして入力の先頭に置きます。そうしないと、毎回同じinstructionsを送ってもキャッシュ割引の対象になりません。
GPT-6.2 Solに移す仕事とFable 5.2に残す仕事
判断の軸は、いまFable 5.2をどのeffortで使っていて、それで足りているかです。Fable lowやmediumで品質に不満がない仕事は、AAの同点ペアではGPT-6.2 Solのhighからmaxで点数が並び、1タスクの費用はFableの17〜27%まで下がります。同じ問題での実測でも、Solはmedium・high・xhighのどれでも全問合格しました(maxは実測の対象外)。応答の速さが大事な対話的な使い方や大量の定型処理なら、Fable lowに1点届かないだけのSol mediumが最も安く、最初の回答も早く返ります。
Fable highやmaxでないと通らない仕事は残します。AAの指数ではSolの最高57点はFable highに5点、maxに8点届かず、分野別の指数でも金融・会計、戦略・業務、法務、医療の4分野でFableの最高点がSolの最高点を8〜12点上回ります。長時間の作業での手応えとしては、X上でkunchenguid氏が2026年11月19日に、実際のプロジェクトで丸1日使った結果、GPT-6.2 AstraとSolは「Fable 5.2やOpus 5.5のそのままの代わりにはならない」と投稿しています。ユーザーに確認すべきか進めるべきかの判断が少しずれている、という個人の感想です。
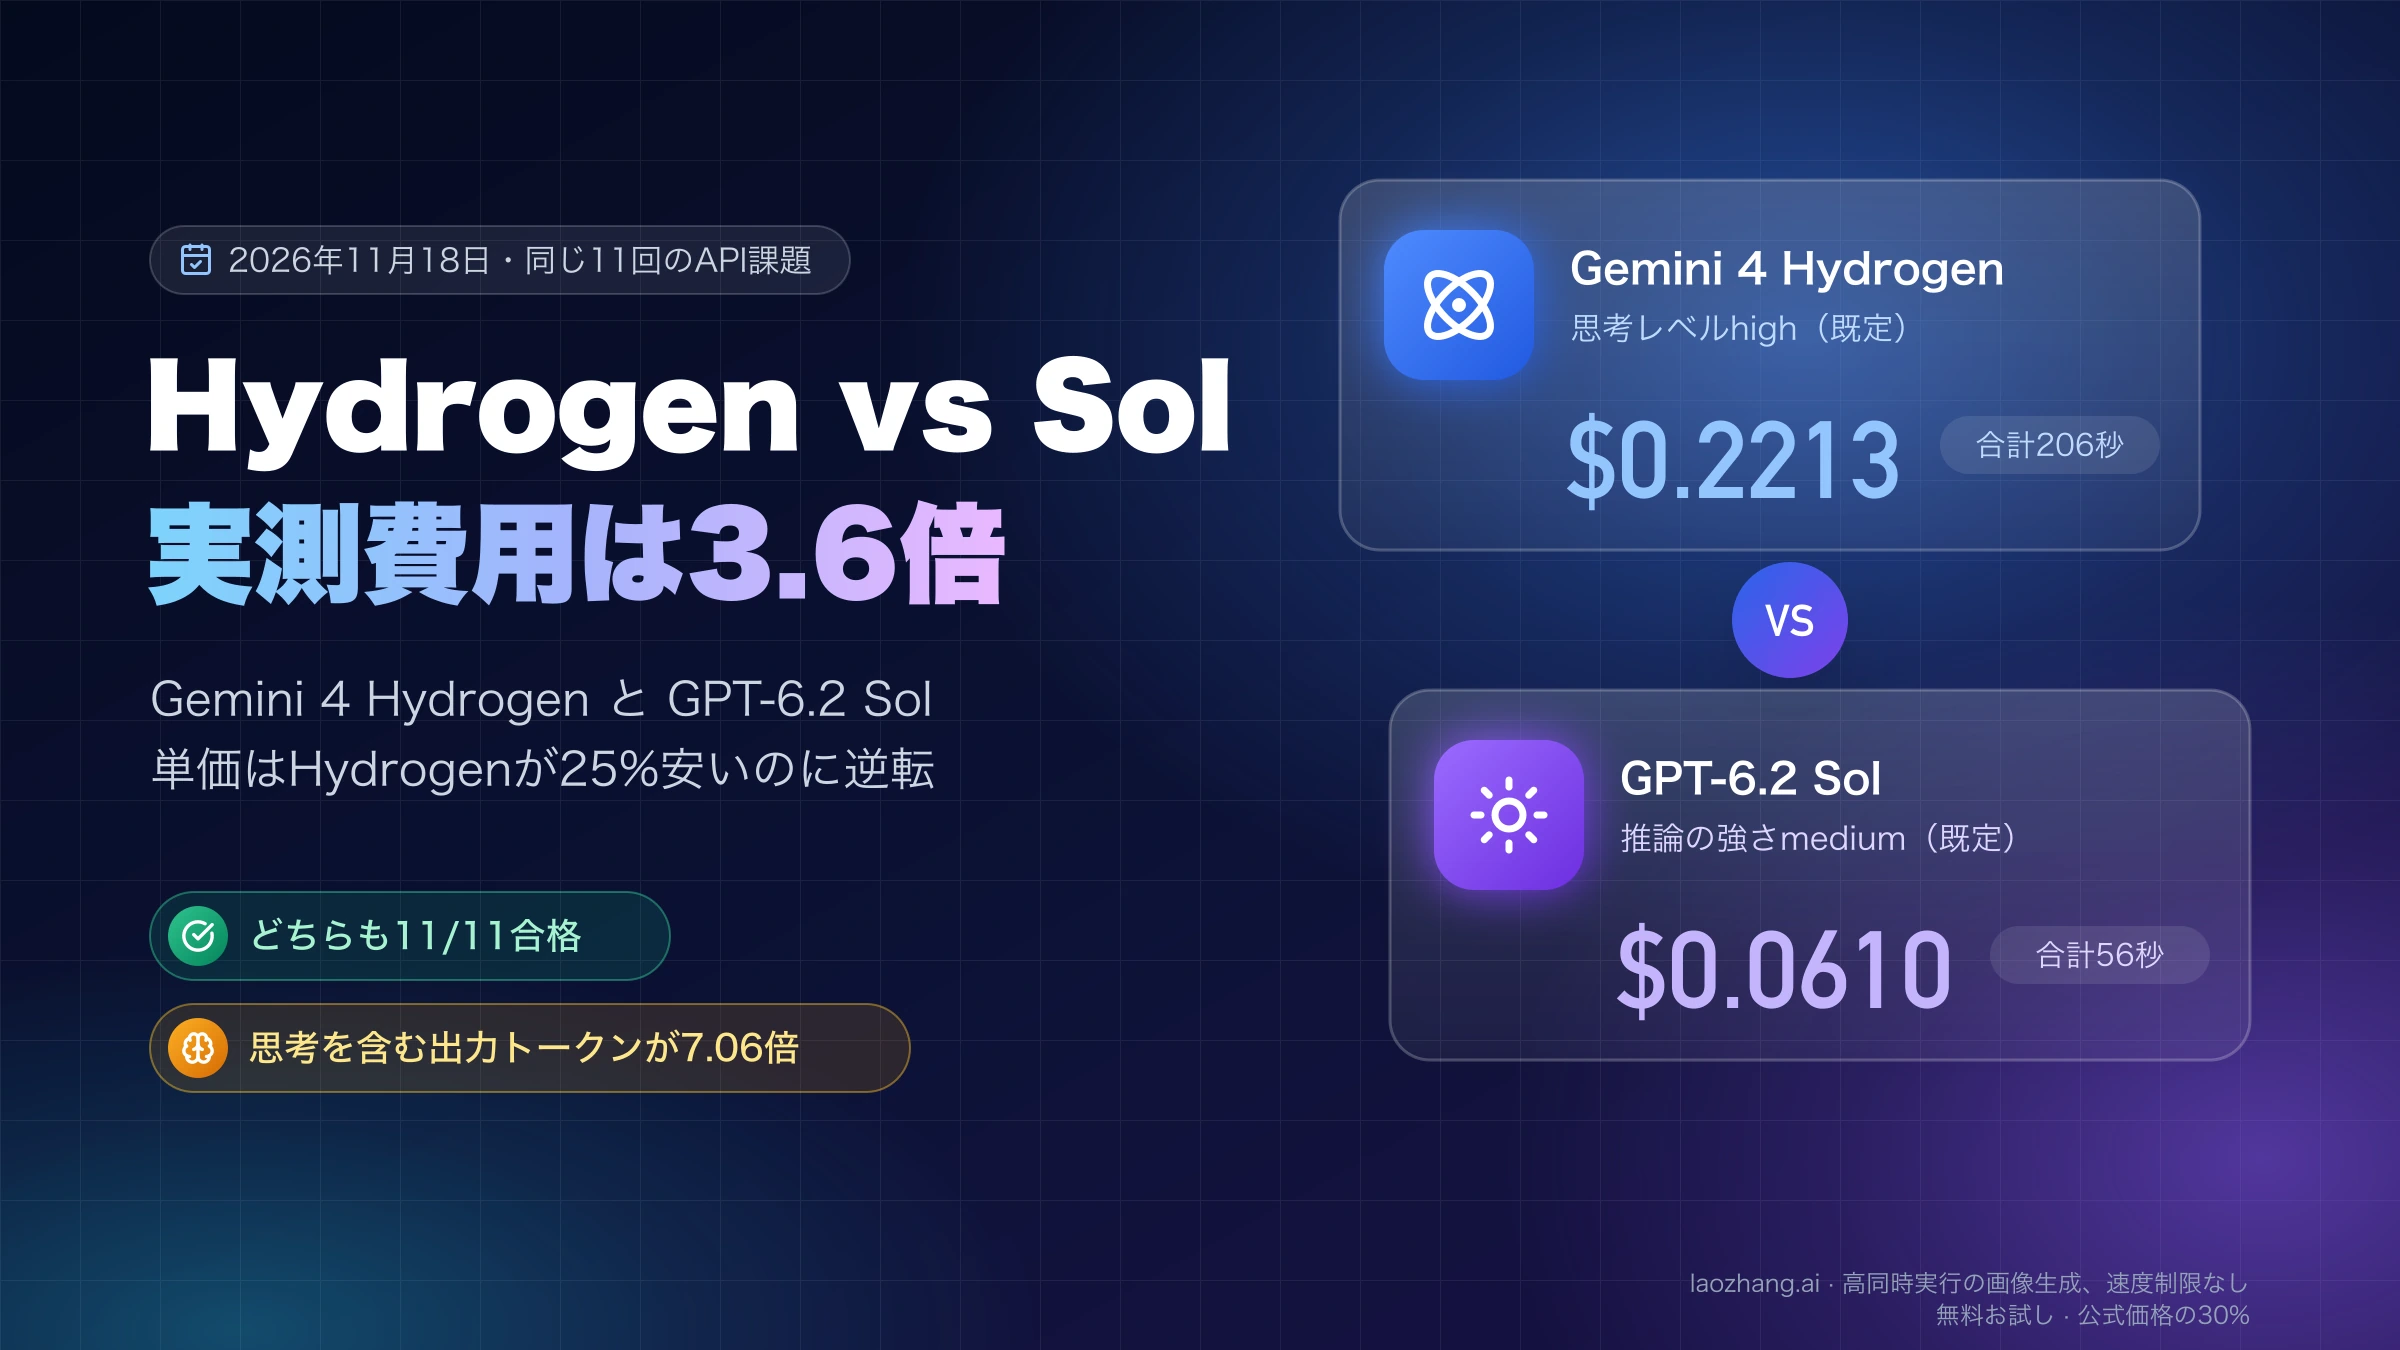
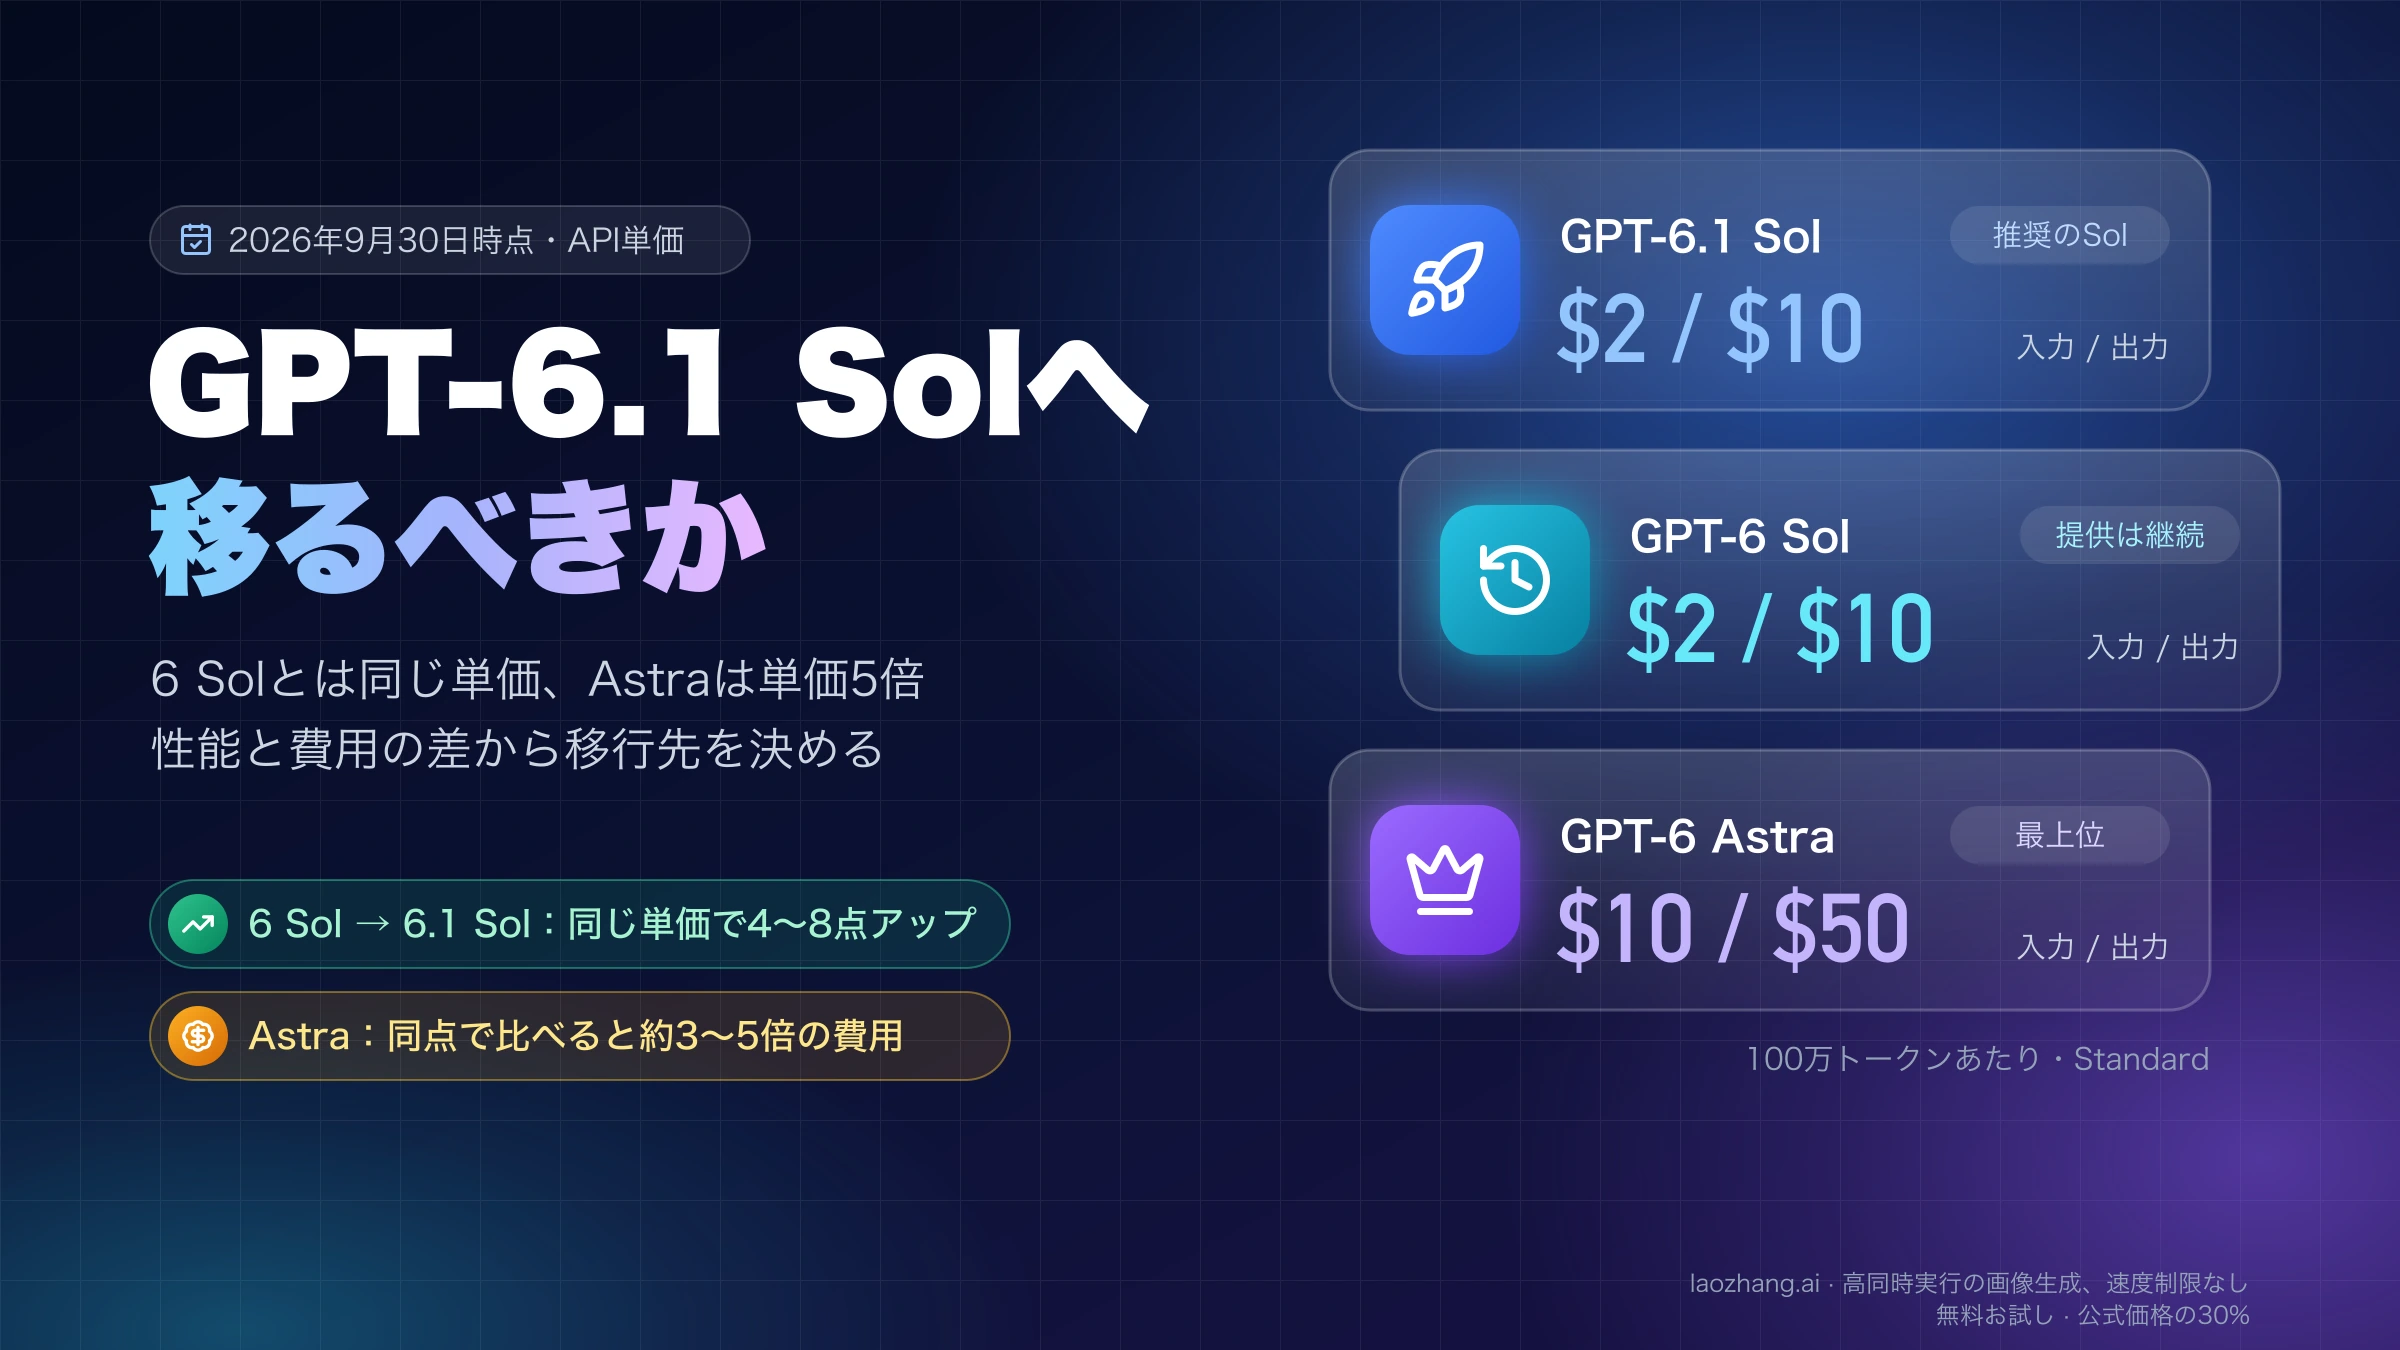
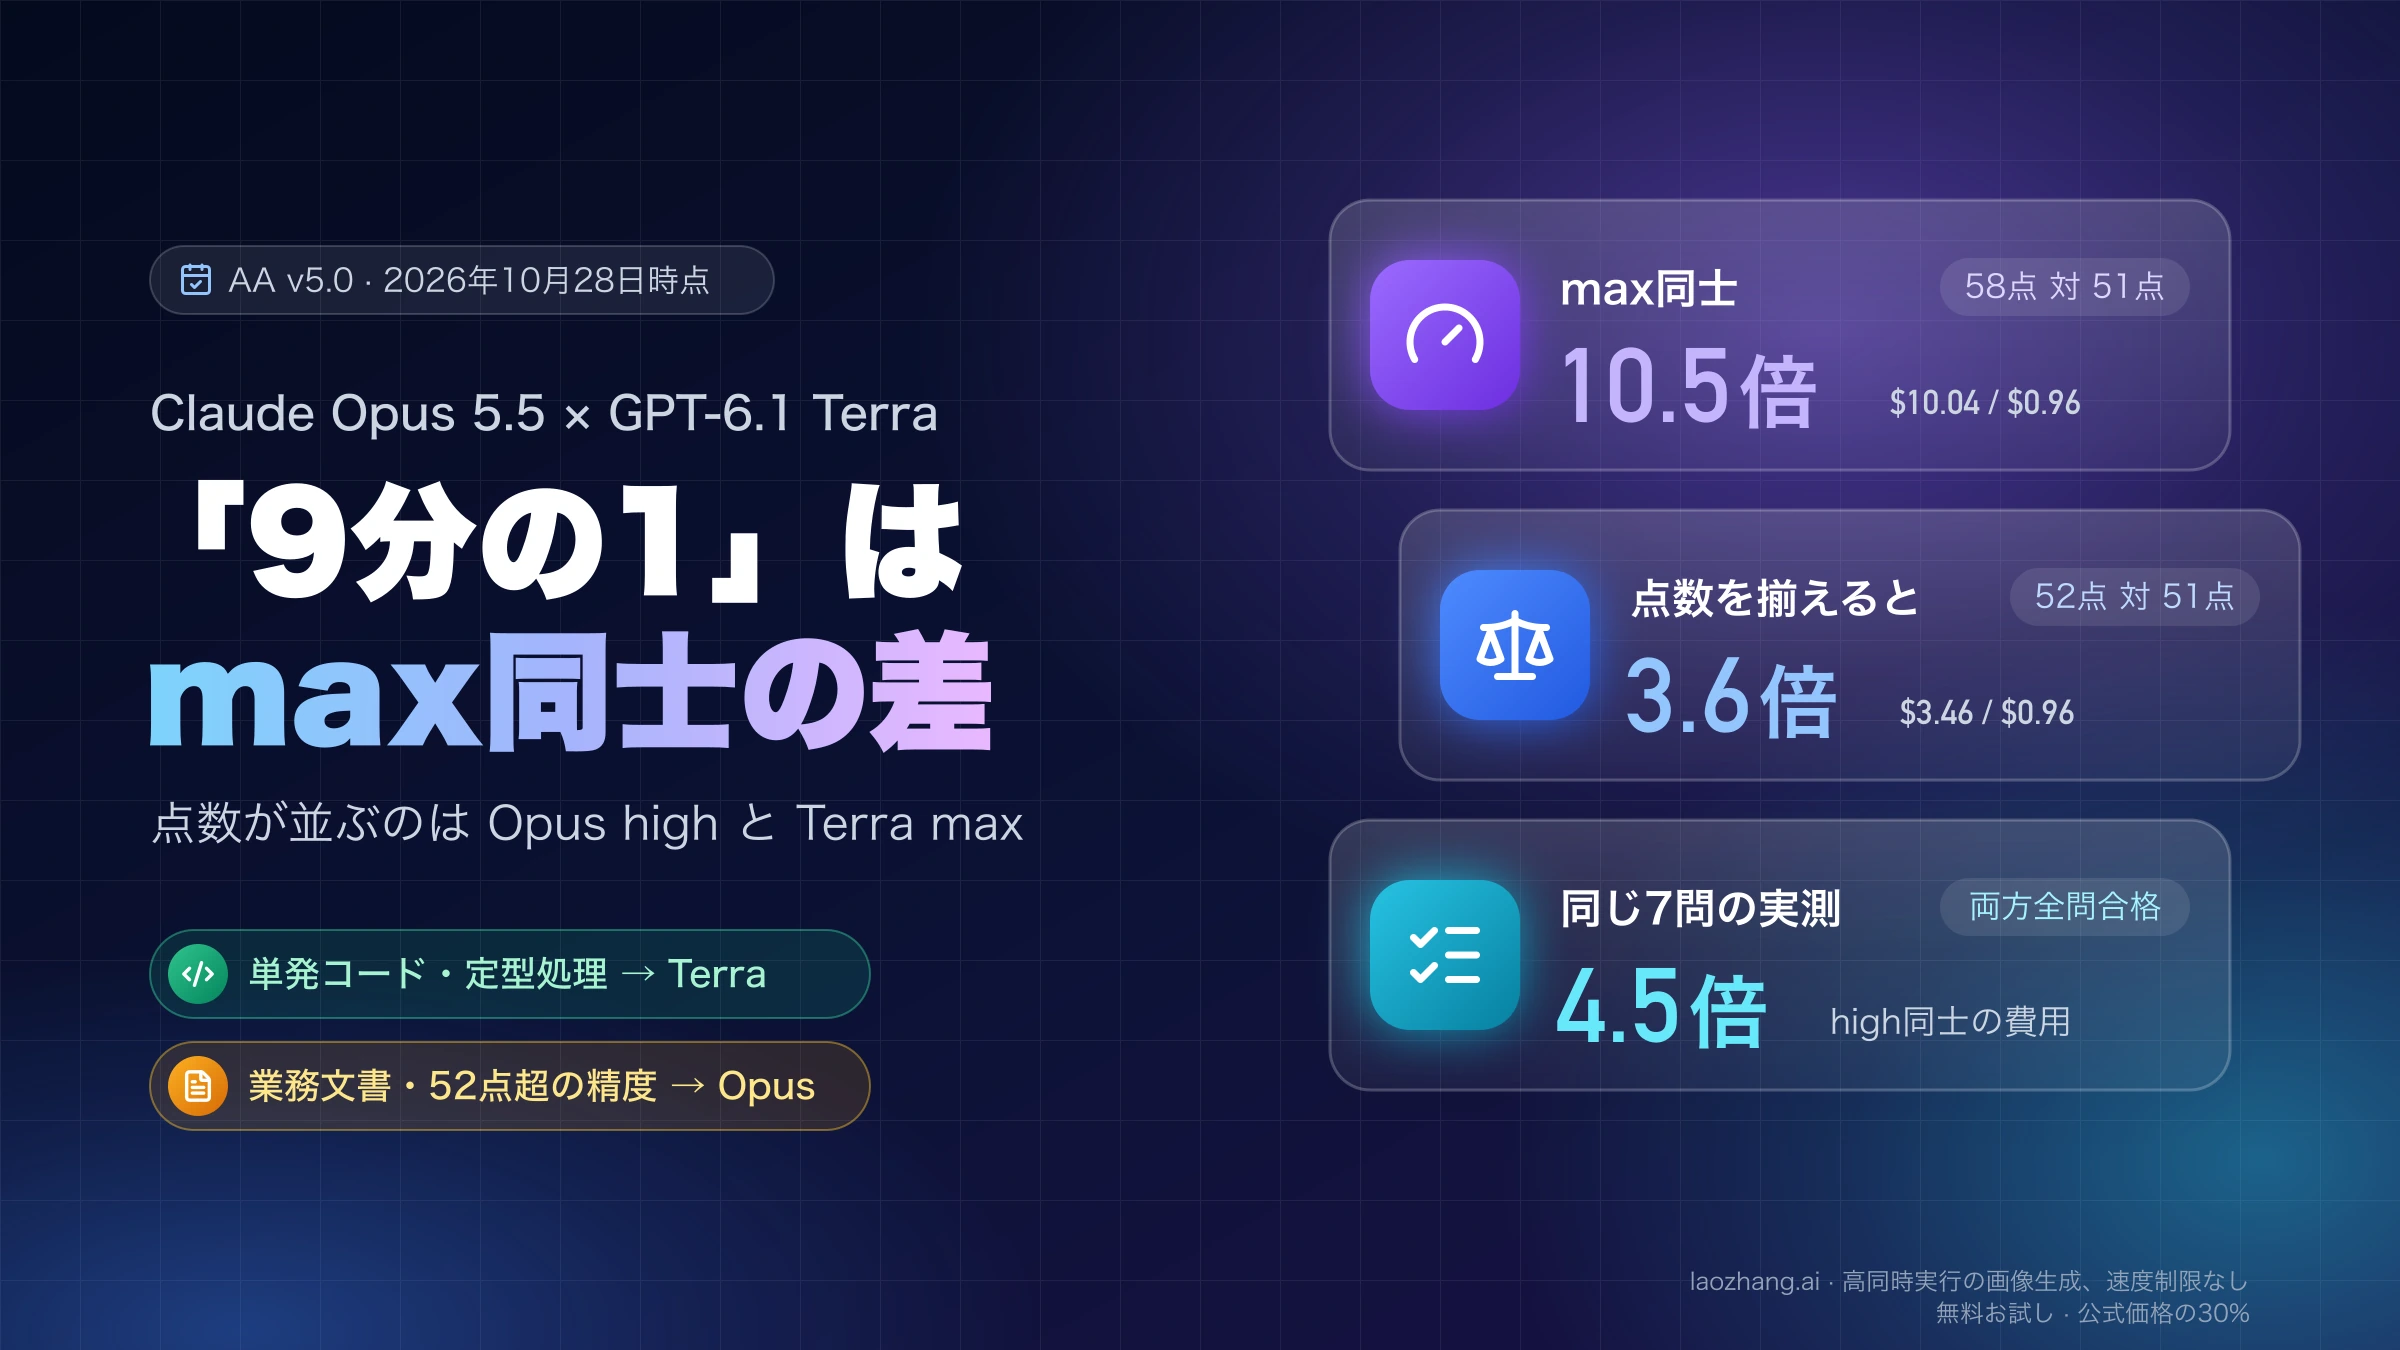
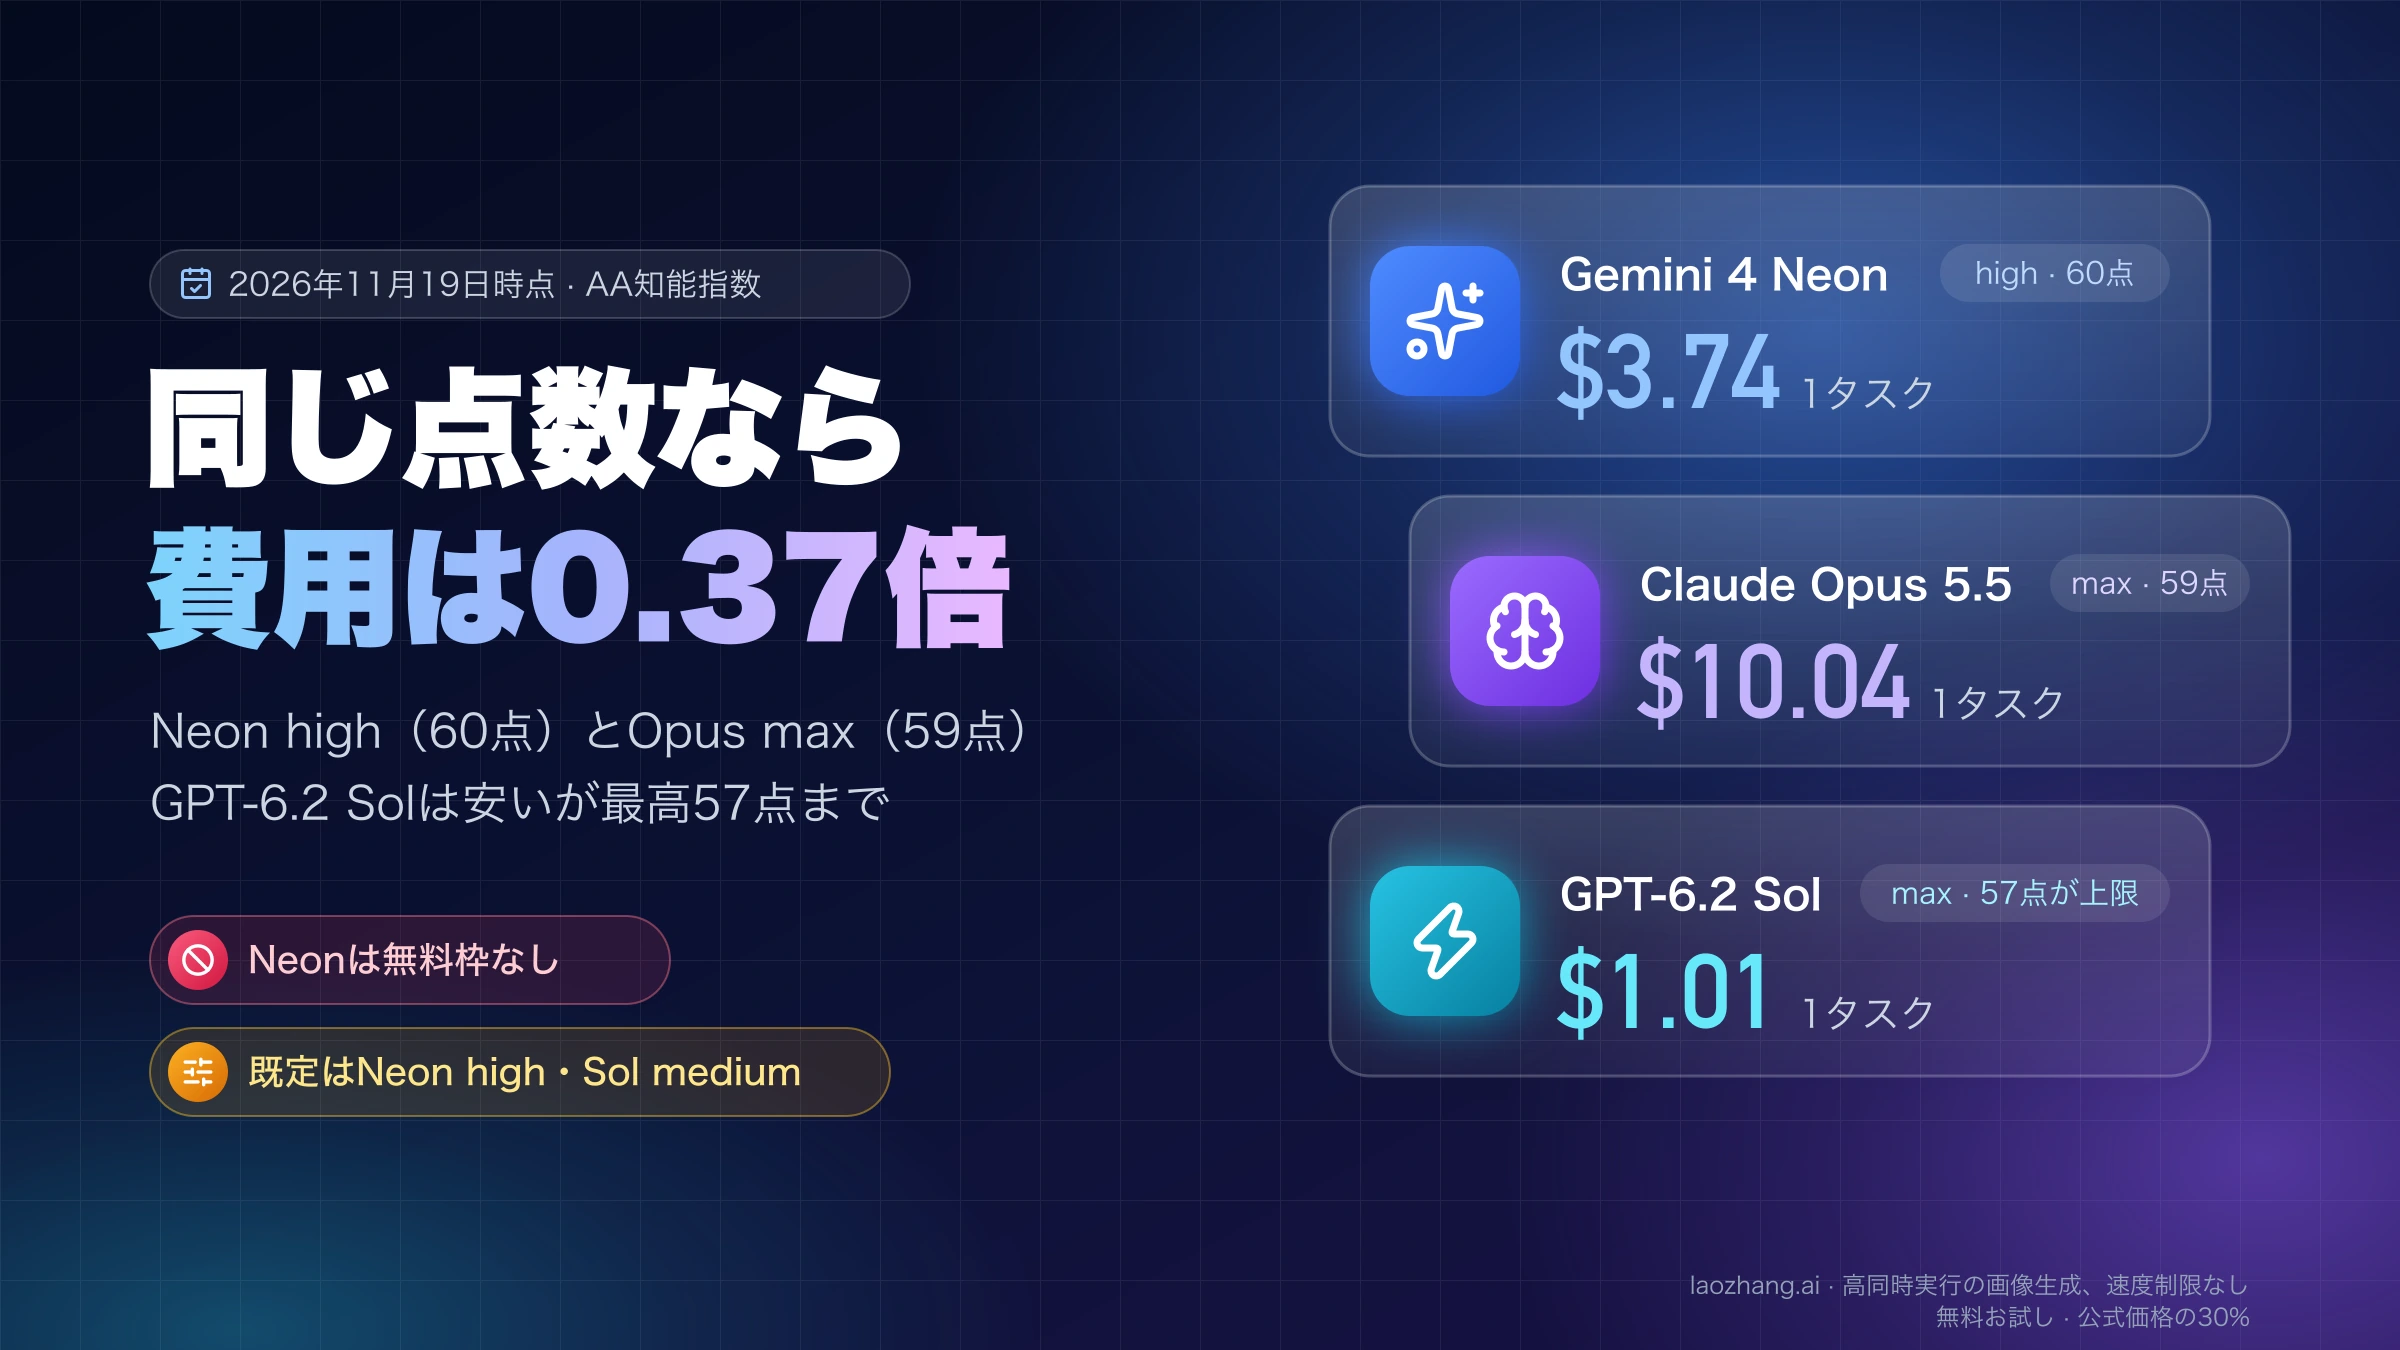
OpenAIがFable 5.2の対抗として置いているのは、同じ入力$8・出力$40のGPT-6.2 Astraです。Astraとの比較は「GPT-6.2 Astra・GPT-6 AstraとClaude Fable 5.2比較:同定価で費用差」で扱っています。Claudeの中で費用を下げたい場合は「Claude Fable 5.2とOpus 5.5の違い:同じ正解数で費用1.86倍」、Solの前の版やOpus 5.5との違いは「GPT-6.2 Sol・6.1 Sol・Opus 5.5の違い:同じ12問の実測と使い分け」、Googleの安価なモデルとの比較は「Gemini 4 HydrogenとGPT-6.2 Sol比較:実測費用はHydrogenが3.6倍」が参考になります。
自分のタスクで確かめる手順:合格1件あたりの費用で比べる
AAの指数も上の実測も、あなたの仕事でどちらが通るかまでは教えてくれません。移す前に、同じ問題をClaude Fable 5.2とGPT-6.2 Solの両方に解かせ、合格1件あたりの費用で比べます。
- 移したい仕事の実例から、合否を機械で判定できる問題を選びます。テストコード、正解の数値、JSONスキーマなど、人の好みに左右されない判定を用意します。
- いまのFable 5.2の設定をそのまま基準にします。APIでeffortを指定していなければhigh、Claude Codeならmediumです。
- Solは上の対応表で点数が並ぶ設定から始め、1段上も一緒に試します。Fable mediumならSol xhighとmax、Fable lowならSol highとxhighです。
- 同じプロンプト、同じツール条件で各問題を2回以上解かせ、レスポンスのusageから入力・出力トークンと所要時間を記録します。
- 設定ごとに総費用を合格数で割ります。難問セットでは、Fable既定が$3.6118÷16で約$0.226、Sol既定が$0.2971÷16で約$0.0186でした。
- 両方とも全問合格して差がつかないなら、問題が易しすぎます。複数ファイルにまたがる長い作業など、実際に失敗が起きている問題を足して測り直します。
Fable 5.2をAPIから呼ぶ準備がまだなら、接続と最初の呼び出しは「Claude Fable 5.2 APIの使い方:専用キー不要、通らない時の原因」にあります。
GPT-6.2 SolとClaude Fable 5.2のよくある質問
「GPT-6.2 Sol Pro」はSolとは別のモデルですか?
別のモデルではありません。OpenAIの推論(reasoning)ガイドによると、GPT-6系はResponses APIでreasoning.modeにstandard(既定)とproを選べ、proは時間とトークンを多く使って難しい課題に取り組むモードで、effortとは独立して指定します。OpenRouterはGPT-6.2 Sol Proのページで、これをGPT-6.2 Solと同じモデルをproモードで提供するものとして同じ入力$2・出力$10で載せ、1リクエストの費用は通常の数倍になると説明しています(2026年11月20日時点)。OpenAIの料金表にSol Pro専用の行はなく、AAの指数にあるSolの値も標準モードのものです。
ChatGPTやClaudeの定額プランでSolとFableは使えますか?
GPT-6.2 Solは、ChatGPTのPlus、Pro、Enterprise、EduでChatGPT WorkとCodexから使えますが、通常のChatには追加されていません(OpenAIヘルプのChatGPTで使えるGPT-6モデルの記事、2026年11月18日時点)。利用回数の上限は公表されておらず、SolのUltrafastはPro $200とPro $500で使えます。Claude Fable 5.2は、Max、Ultra、上位のTeam・Enterpriseシートでは週の利用上限の50%までプランに含まれ、ProとスタンダードのTeamシートでは従量制の利用クレジットで動きます。11月9日から16日の発売週だけProにも含まれていた扱いは終わっています(ClaudeヘルプのプランごとのFableモデルの記事)。
参考資料11
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月21日。
参考資料11
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月21日。
- 1.API料金ページdevelopers.openai.com/api/docs/pricing
- 2.Claude API料金ページplatform.claude.com/docs/en/about-claude/pricing
- 3.Claude Fable 5.2とGPT-6.2 Solの比較ページartificialanalysis.ai/models/comparisons/claude-fable-5-2-vs-gpt-6-2-sol
- 4.OpenAIのGPT-6.2 AstraとSolの発表ページopenai.com/index/introducing-gpt-6-2-astra-sol
- 5.Fable 5.2の概要platform.claude.com/docs/en/models/fable-5-2/overview
- 6.Fable 5.2への移行ガイドplatform.claude.com/docs/en/models/fable-5-2/migration-guide
- 7.GPT-6.2 Solのモデルページdevelopers.openai.com/api/docs/models/gpt-6.2-sol
- 8.推論(reasoning)ガイドdevelopers.openai.com/api/docs/guides/reasoning
- 9.GPT-6.2 Sol Proのページopenrouter.ai/openai/gpt-6.2-sol-pro
- 10.OpenAIヘルプのChatGPTで使えるGPT-6モデルの記事help.openai.com/en/articles/20001354-gpt-6-and-other-models-in-chatgpt
- 11.ClaudeヘルプのプランごとのFableモデルの記事support.claude.com/en/articles/15424964-claude-fable-models-on-your-plan