AI動画で複数キャラに会話させる:同じ画面で1回か、カット割りか
2人・8秒前後・相手の反応が見せ場の会話は同じ画面で1回生成、3人以上、長い台詞、1行ずつ直したい場面はカット割りが向きます。口や声の取り違えにはモデルごとの紐付け方で対処します。
目次
同じ画面かカット割りか:2人・短い台詞・反応が見せ場なら同じ画面
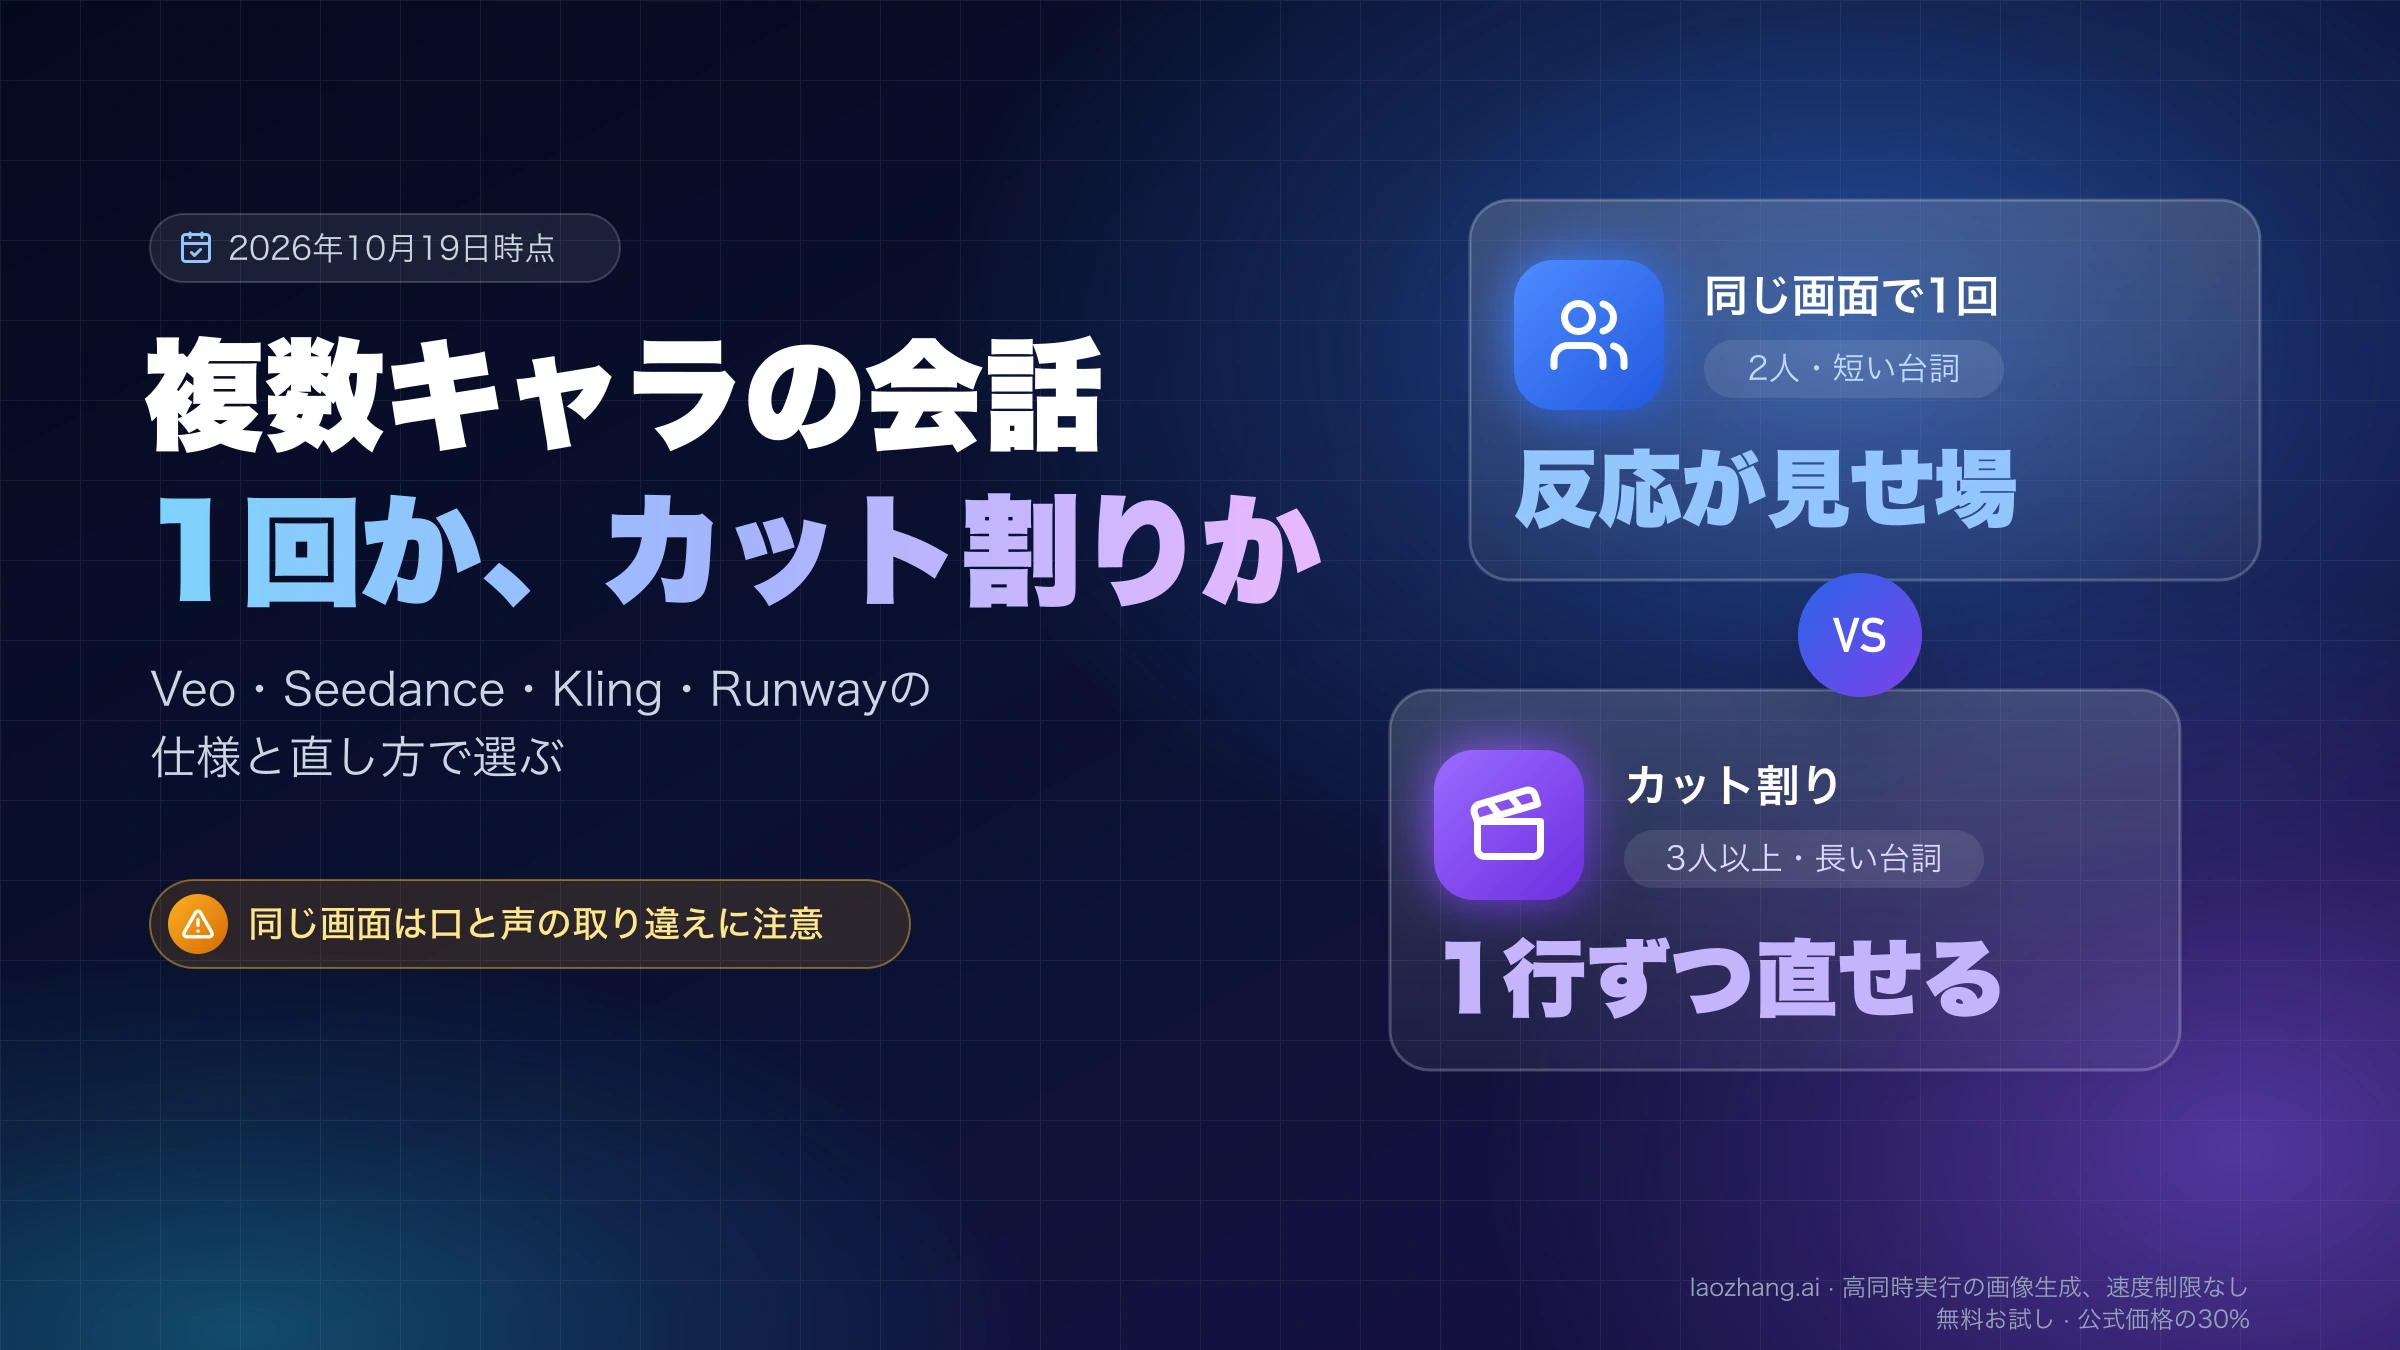
会話シーンの作り方は大きく2つです。2人を同じ画面に映して台詞とリップシンクを1回で生成する方法と、話す人ごとにカットを分けて生成し、切り返しや肩越しショットとして編集でつなぐ方法です。
先に結論を書くと、次の条件がそろうなら同じ画面で1回生成を試す価値があります。
- 話すのは2人まで
- 会話全体が1本の生成で収まる長さ(Veo 3.1なら最長8秒、Seedance 2.5なら最長30秒)
- 相手の表情、うなずき、手渡しや肩に触れるといった接触が見せ場で、別々に撮ると不自然になる
- 台詞はほぼ確定していて、あとから1行だけ差し替える予定がない
逆に、3人以上が話す、台詞が長い、クライアント確認で台詞を何度も直す、日本語の口の動きを1行ずつ詰めたい、という場面はカット割りが向きます。1カットに話す人を1人だけにすれば、口が動く人物を取り違える余地がそもそも小さくなり、失敗したカットだけを作り直せます。
| シーンの条件 | 同じ画面で1回 | カット割り |
|---|---|---|
| 話す人数 | 2人 | 3人以上、または2人でも画面内に人が多い |
| 台詞の長さ | 1本の生成の上限内 | 上限を超える、または延長が必要 |
| 体の接触・反応 | 接触や同時の反応が見せ場 | 交互に話すだけで接触がない |
| 台詞の修正 | ほぼ確定 | 何度も差し替える |
| 失敗したとき | 1本まるごと作り直し | そのカットだけ作り直し |
| 生成回数 | 少ない | カット数だけ増える |
この判断は、各ベンダーの公開文書と、出典を明記した第三者の解説をもとにした整理です。生成の成功率を測ったものではないので、最初の1本で自分の題材に合うかを確かめてから本番の量に進んでください。
中間の選択肢もあります。Runwayのように2人が映る背景動画を作ってから1人ずつ演技を当てて合成する方法や、KlingやGemini Omniのように1回の生成の中でモデルがカットを切り替える方法です。これらは後の節で扱います。
同じ画面で2人に話させると崩れやすいところ:口と声の取り違え
同じ画面で会話させるときに最も起きやすいのは、台詞を話す人物、声、見た目の対応がずれることです。
これを公式に明記しているのはByteDanceのSeedance 2.5です。BytePlusのSeedance 2.5プロンプトガイドのFAQには、複数の人物が出る動画では人物と参照画像、声の音色、登場順がずれることがあり、たとえば最初に登場する人物が別の参照人物に置き換わることがある、と書かれています。対処として示されているのは、人物が最初に登場する順番で参照素材をアップロードし、プロンプト内の画像・音声の番号もその順に合わせることです。
同じガイドは、画像の中にだけ名前を書いて本文で「Johnが学校に…」と書くような指定は、人物の混同や重複を招きやすいとしています。推奨されているのは「画像1〜2がキャラクター1で音声1に対応、画像3〜4がキャラクター2で音声2に対応」のように、プロンプトの文章の中で1つずつ対応を書く方法です。
ほかのモデルの文書は、この取り違えを名指ししていません。ただし、取り違えが起きないと書いてあるわけでもありません。オープンソースのMultiTalkは、論文の要旨で既存手法の課題を「音声と人物の誤った紐付け」と呼び、その解決を研究の目的にしています。複数の声を複数の人物に正しく割り当てることは、それだけで研究テーマになる難しさだということです。
第三者の解説も同じ方向です。Seedance 2.5向けの非公式サイトseedance.tvの複数キャラ会話の解説(2026年8月28日公開)は、片方の人物がもう片方の髪や服の色を借りてしまう崩れと、Aの見た目でBの台詞を話す崩れを挙げ、最も制御しやすいのは2人、3人は見た目がはっきり違えば可能、それ以上は2人ずつのカットや反応ショットに分けて編集する、としています。
つまり同じ画面で作るなら、2人の見た目を髪型や服の色で大きく変え、誰が話して誰が聞いているかを毎行書き、参照素材の順番と番号をそろえることが前提になります。それでも直らない台詞は、その行だけカットを分けるほうが早く済みます。
カット割りでつなぐ場合:1カット1人にして、作り直しを小さくする
カット割りは、話している人の単独ショット、相手の肩越しショット、聞き手の反応ショットを別々に生成して編集でつなぐ方法です。GoogleのVertex AIのVeoプロンプトガイドも、肩越しショットを会話でよく使う構図として紹介しています。
利点は3つあります。
- 1カットに話す人が1人なので、口が動く人物を取り違える余地が小さい
- 失敗したカットだけを作り直せるので、台詞の修正に強い
- 1本の生成の長さの上限に縛られず、長い会話を組める
代わりに必要になるのが、カットをまたいで同じ人物に見せる工夫です。参照画像やキャラクター素材を毎回同じものにし、立ち位置(どちらが画面の左か右か)と照明をカット間で変えないことが基本です。第三者のElser AIの解説も、会話全体を1本で生成しないこと、カットごとに人物の描写を変えないこと、人物の立ち位置をばらばらにしないことを挙げています。
Seedanceを使う場合、BytePlusでは実在人物の顔写真をそのまま参照に使えず、同じアカウントで30日以内に生成した素材、プリセットのデジタルキャラクター、本人確認を済ませた実在人物の素材のいずれかを使います。APIでカットをまとめて生成するなら、laozhang.aiのSeedance 2.5 APIでは公開HTTPS画像1枚から仮想人物のアセットを作り、各カットのreference_imageとして同じアセットを指定できます。複数のカットで同じ人物の顔を使い回したいときの手段の1つです。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
カット割りの費用:生成回数は増え、作り直し1回あたりは安くなる
動画生成APIの多くは秒単位の課金なので、カット割りにすると生成する秒数の合計が増えます。ここではGemini APIのVeo 3.1 Fastの720pを例に、2026年10月1日時点の表示価格(1秒$0.10)で計算します。
- 同じ画面で8秒を1回生成:8秒 × $0.10 = $0.80
- 4秒のカットを4つ生成:4秒 × 4 × $0.10 = $1.60
- 参照画像を使って4カット生成:Veo 3.1は参照画像を使うと長さが8秒に固定されるので、8秒 × 4 × $0.10 = $3.20
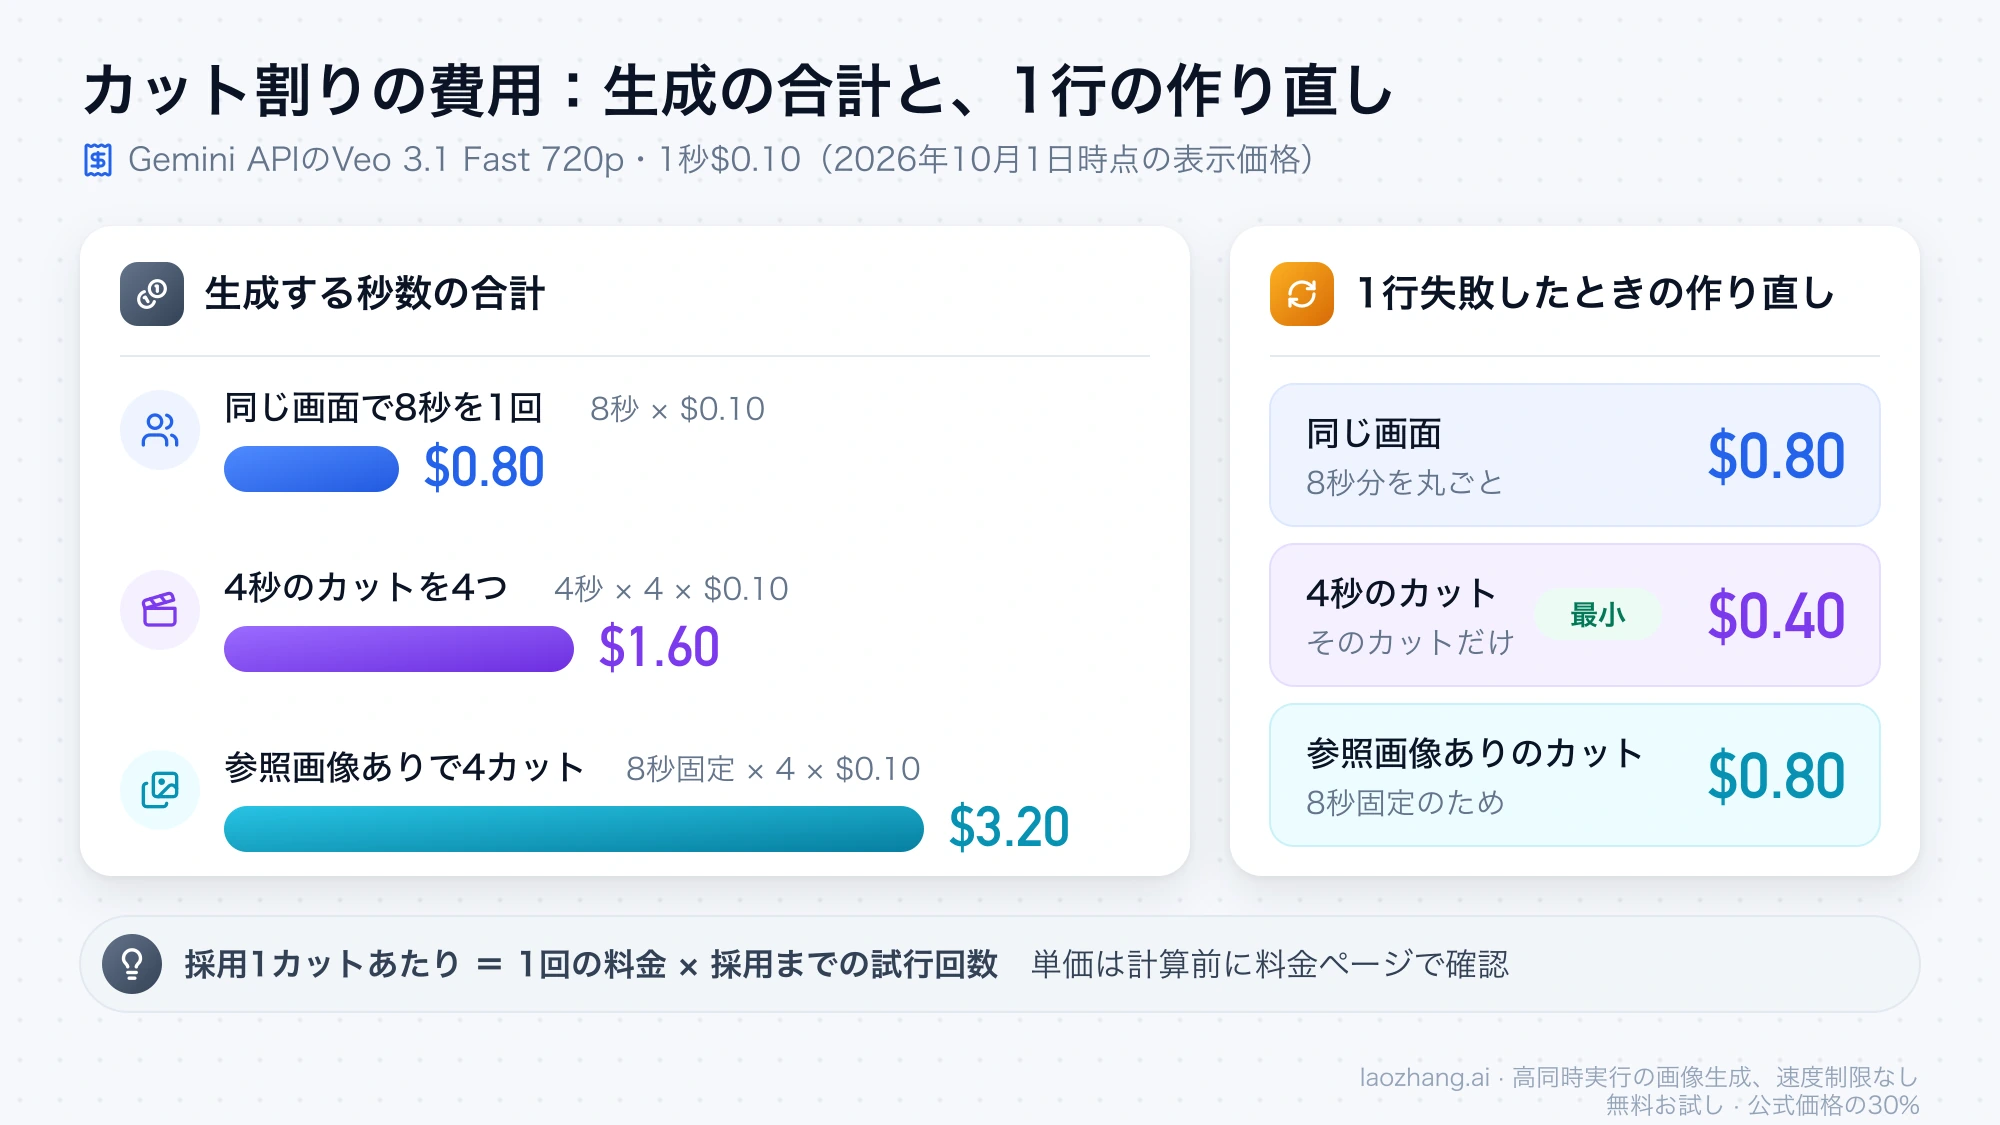
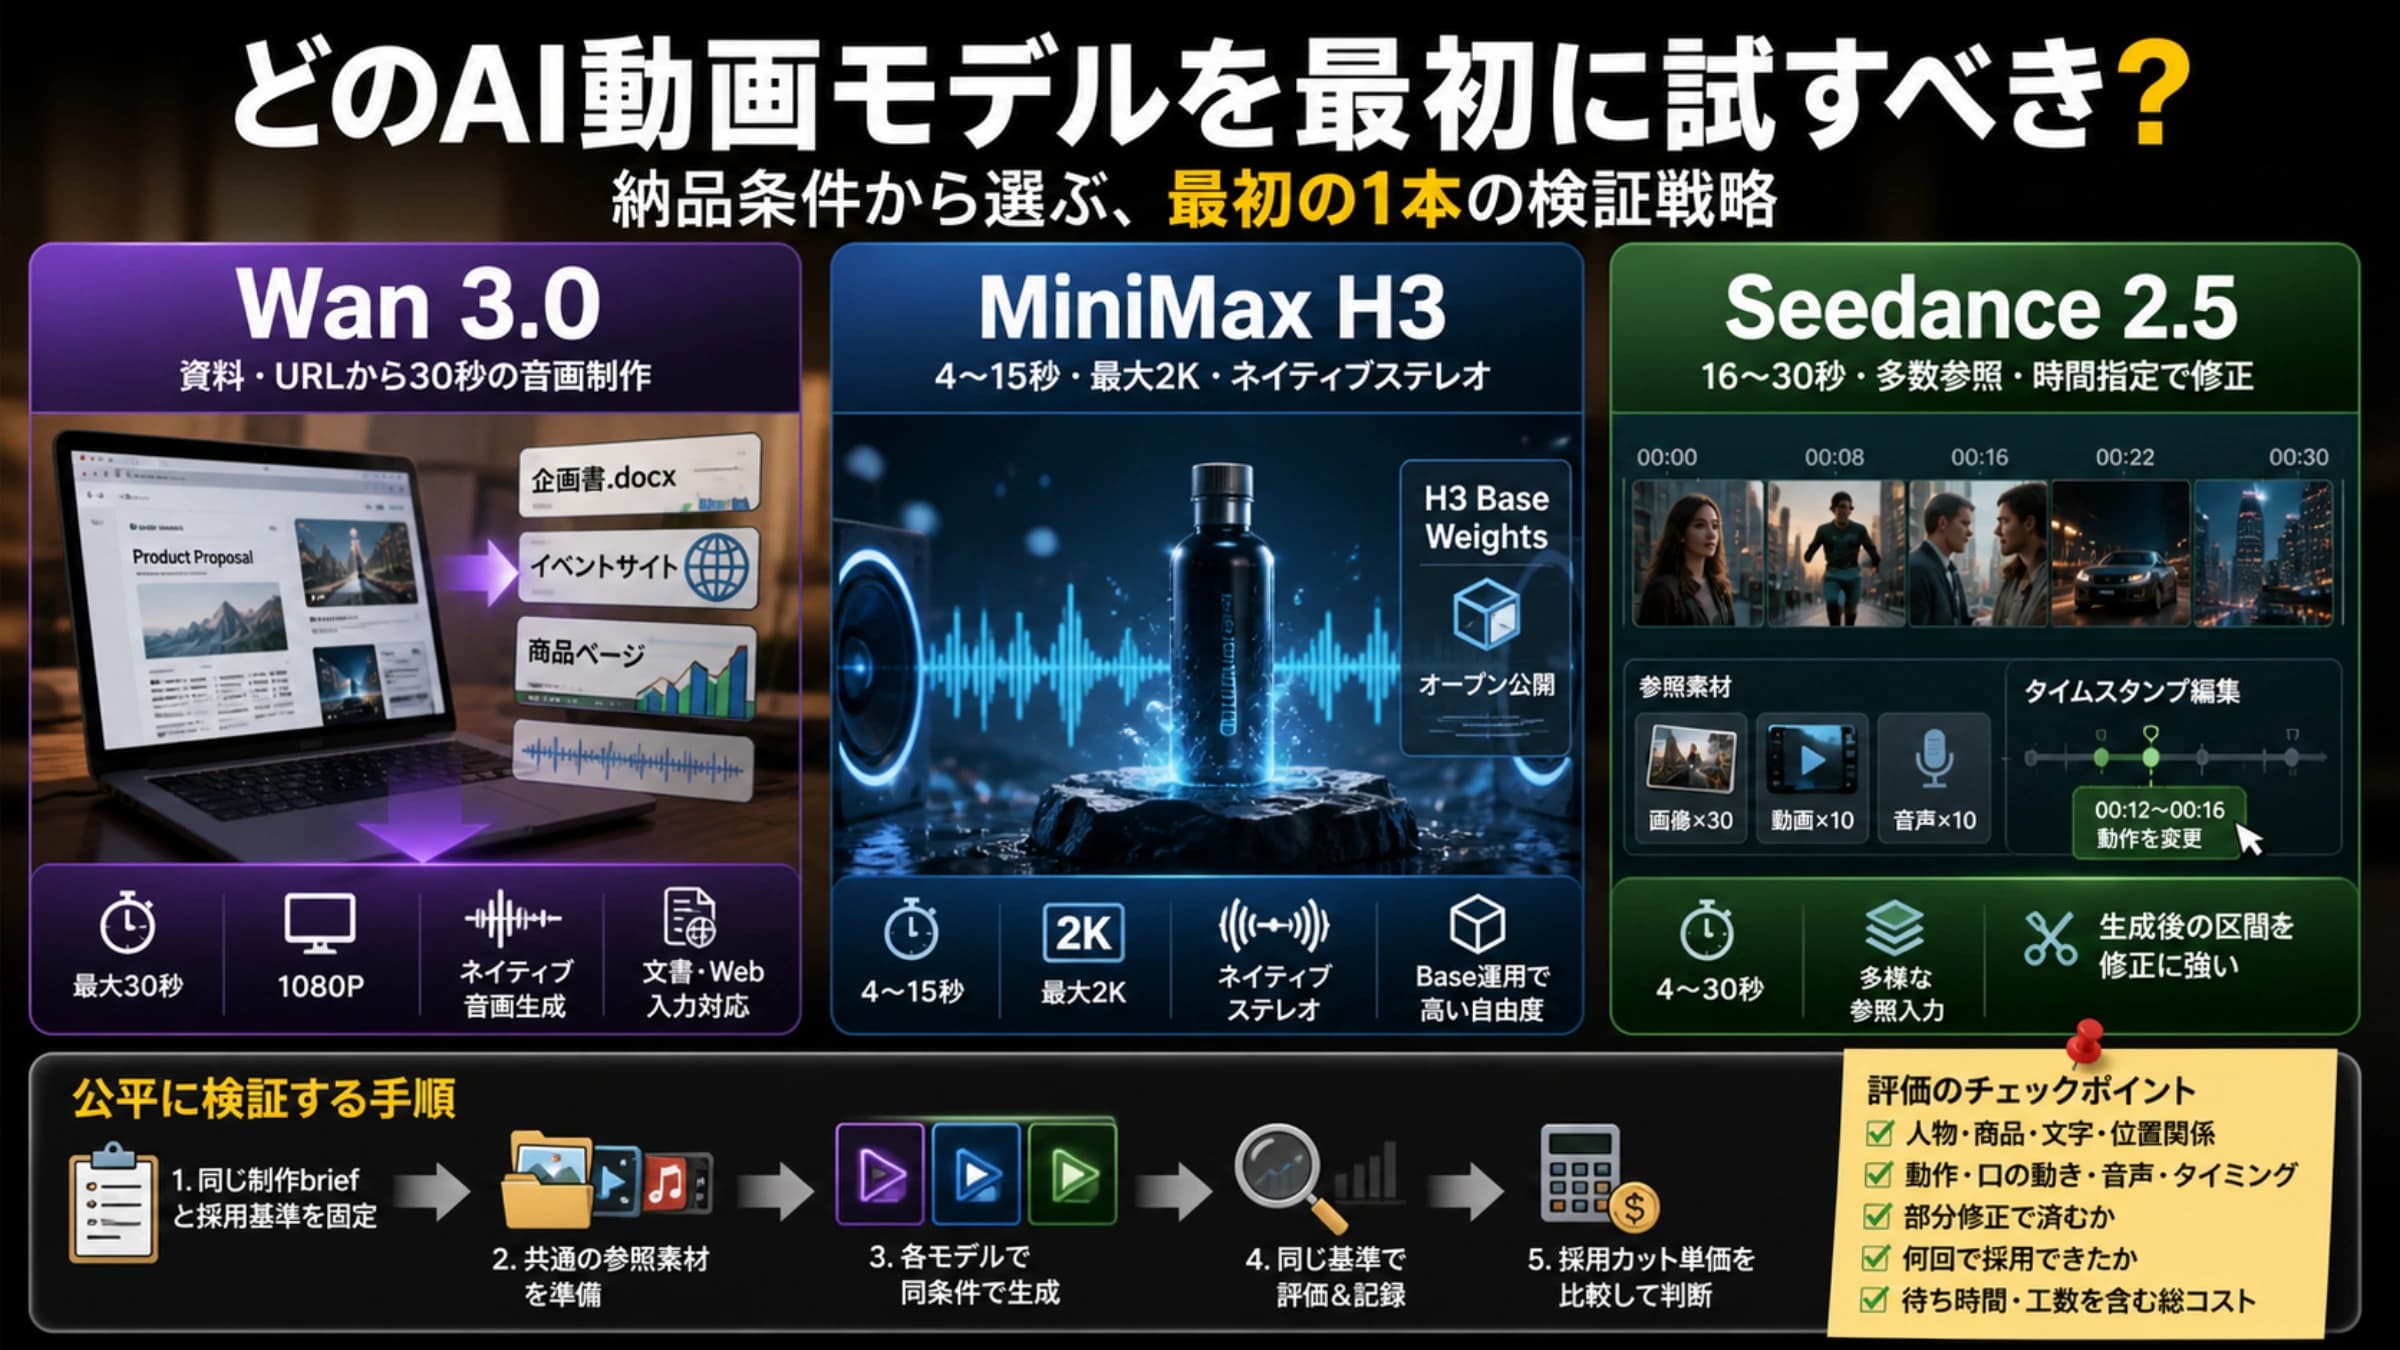
一方で、1行の台詞が失敗したときの作り直しは、同じ画面なら8秒分の$0.80、4秒のカットなら$0.40(参照画像を使う場合は8秒分の$0.80)です。台詞を何度も直す案件ほど、カット割りの「1回あたりの作り直しが小さい」利点が効きます。採用1カットあたりの費用は「1回の料金 × 採用までの試行回数」で決まるので、試行回数の見込みと合わせて比べてください。単価はモデルや解像度で変わり、改定も多いため、計算の前に各社の料金ページで当日の価格を確かめてください。モデルごとの採用1本あたりの費用の考え方は、Wan 3.0・MiniMax H3・Seedance 2.5の選び方:最初の1本で見極めるで扱っています。
中間の方法:Runway Act-Twoの合成とモデル内蔵のマルチショット
同じ画面とカット割りのあいだには、2つの折衷案があります。
Runway Act-Two:2人が映る画面に1人ずつ演技を当てる
Runwayのヘルプ記事「Creating Multi-Character Dialogues with Act-Two」(2025年12月17日更新)は、Act-Twoが1人の入力にしか対応していないことを前提に、2人以上の会話を作る手順を示しています。
- 人物ごとに演技と台詞を録画する(Act-Twoの上限は30秒)
- 2人が映る静止画を作る
- その静止画から10秒の背景動画を生成し、台詞が長ければ最後のフレームから延長する
- 背景動画を1人だけが映るようにトリミングし、その人物の演技をAct-Twoで当てる。もう1人も同様に行う
- 動画編集ソフトで合成する
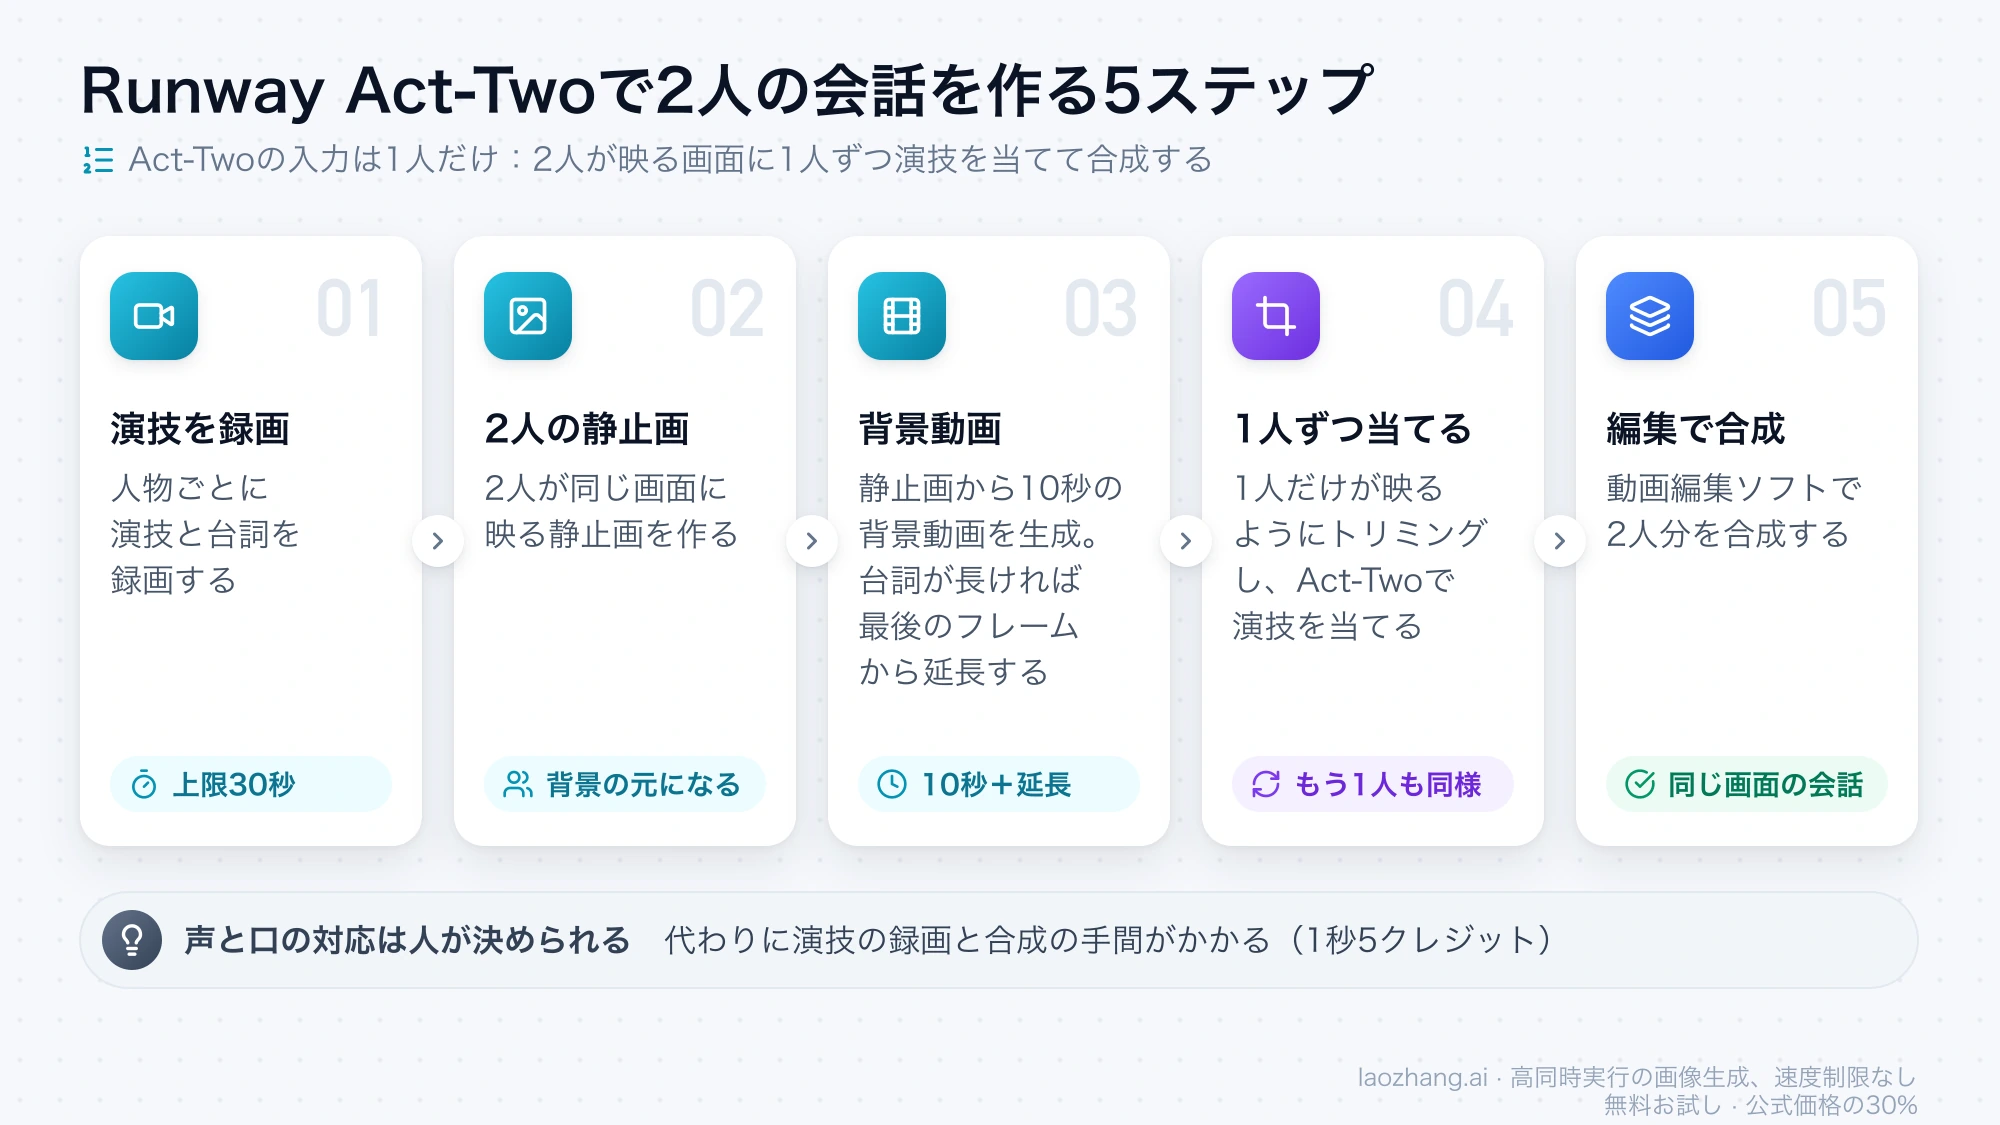
見た目は同じ画面の会話ですが、演技は1人ずつ当てるので、声と口の対応を人が決められます。代わりに自分で演技を録る必要があり、合成の手間がかかります。Act-Twoの料金は1秒あたり5クレジットです。なお、Runwayの単体のLip Syncツールは2026年5月27日に提供を終え、代わりとしてAct-Twoが案内されています。
モデル内蔵のマルチショット:1回の生成の中でカットが切り替わる
1回の生成の中でモデルが切り返しを作る方法もあります。
- Kling 3.0(2026年1月31日公開):リリースノートで、マルチショットが古典的な切り返しの会話を理解してカメラアングルを自動で調整し、ネイティブ音声では複数の人物がいる場面で話している人物を正確に指定できると説明しています。APIでは1〜6ショット、各ショット512文字までです。ただし「曖昧さをなくす」というのはベンダーの説明で、第三者による検証結果ではありません。
- Gemini Omni 1.1 Flash:Gemini APIの文書によると、既定では数ショットに分けた動画を作ろうとします。1カットで続けたいときは「No scene cuts」のように書く必要があります。
- MiniMax H3とWan 2.7:どちらもプロンプトでマルチショットを組めますが、複数の話者と声の紐付けについての記載はありません。
- RunwayのMulti-Shot Videoアプリ:最大5つのつながったショットを作れますが、Kling Pro 3.0で動き、既定では音声が付きません。
カットの切り替えをモデルに任せられるので編集の手間は減りますが、失敗したときは1本まるごと作り直しになる点は同じ画面の方式と変わりません。
会話シーンに関わる公開仕様:モデル別の比較表
各社の一次資料に書かれている、会話シーンの判断に効く仕様だけをまとめました。記載がない項目は「記載なし」とし、できないという意味では使っていません。いずれも2026年10月19日時点です。
| モデル | 1回の長さ | 台詞の書き方 | 声と人物の紐付け | 1回の生成内のカット | 会話で注意する点 |
|---|---|---|---|---|---|
| Veo 3.1 | 4・6・8秒(参照画像使用時は8秒)。延長で最長148秒 | 台詞を引用符で囲む | 記載なし | 記載なし | 参照画像は最大3枚。延長では最後の1秒に声がないと声を引き継げない |
| Gemini Omni 1.1 Flash | 延長は10秒ずつ、合計40秒まで | プロンプトで記述 | 音声参照は非対応、声の編集も非対応 | 既定で数ショットに分ける | 人が話しているアップロード動画に台詞を足す延長は不可。特定の著名人は不可 |
| Seedance 2.5 | 4〜30秒 | 台詞は波括弧で囲む。中国語以外は台詞の前に言語を指定 | 画像と音声を番号で対応づける。音声は合計30秒以内 | Shot N と秒単位の指定 | 複数人物で参照・声・登場順の取り違えを公式FAQが明記。実在人物の顔写真は直接不可 |
| Kling 3.0 | 3〜15秒 | 人物を指定して「says」で台詞 | 話している人物を指定できると説明 | 1〜6ショット | 話者指定の正確さはベンダーの説明 |
| Kling 4.0 | 3〜30秒 | 記載なし | 参照音声は声の参照のみ | 記載なし | 話者指定の記載は4.0のリリースノートにない。APIドキュメントは3.0のまま |
| MiniMax H3 | 4〜15秒 | 11言語の台詞 | 記載なし(音声参照は最大3本) | ネイティブのマルチショット | 音声だけを入力にはできない |
| Wan 2.7 | 2〜15秒 | Shot 1 と秒数でカットを記述 | 記載なし(音声入力は2〜30秒) | プロンプトで指定 | 話者の紐付けの記載なし |
| Runway Act-Two | 演技は30秒まで | 自分で録った演技を当てる | 1回に1人 | なし | 2人以上は合成が必要 |
| MultiTalk・InfiniteTalk | 15秒・既定40秒 | 人物ごとの音声ファイル | person1・person2 に音声を割り当て | なし | 自前のGPU環境が必要 |
出典:Gemini APIのVeo 3.1ドキュメント、Gemini APIのGemini Omniドキュメント、BytePlusのSeedance 2.5モデル説明、Kling 3.0のリリースノート、Kling 4.0のリリースノート、MiniMax H3の公式ブログ、Alibaba CloudのWan 2.7 APIリファレンス、MultiTalkのGitHubリポジトリ、InfiniteTalkのGitHubリポジトリ。
表を読むときの注意点が3つあります。
1つ目はVeo 3.1の参照画像です。文書には「up to three asset images of a single person, character, or product」とあり、1枚ごとに1人という意味にも、全体で1人という意味にも読めます。2人の会話で人物ごとに参照画像を渡せるかは、文書からは確定できません。
2つ目はKlingです。3.0のリリースノートは話者の指定を明記していますが、2026年10月15日に公開された4.0のリリースノートには同じ記載がありません。書かれているのは口の動きの精度向上です。4.0で話者指定がどう扱われるかは公開情報からは読み取れません。
3つ目は延長です。Veo 3.1は延長で長い会話をつなげますが、直前の動画の最後の1秒に声がないと、声をうまく引き継げないと文書にあります。Gemini Omniは、生成済みの動画を続けて延長する場合は台詞を追加できますが、人が話しているアップロード動画には台詞を足せません。
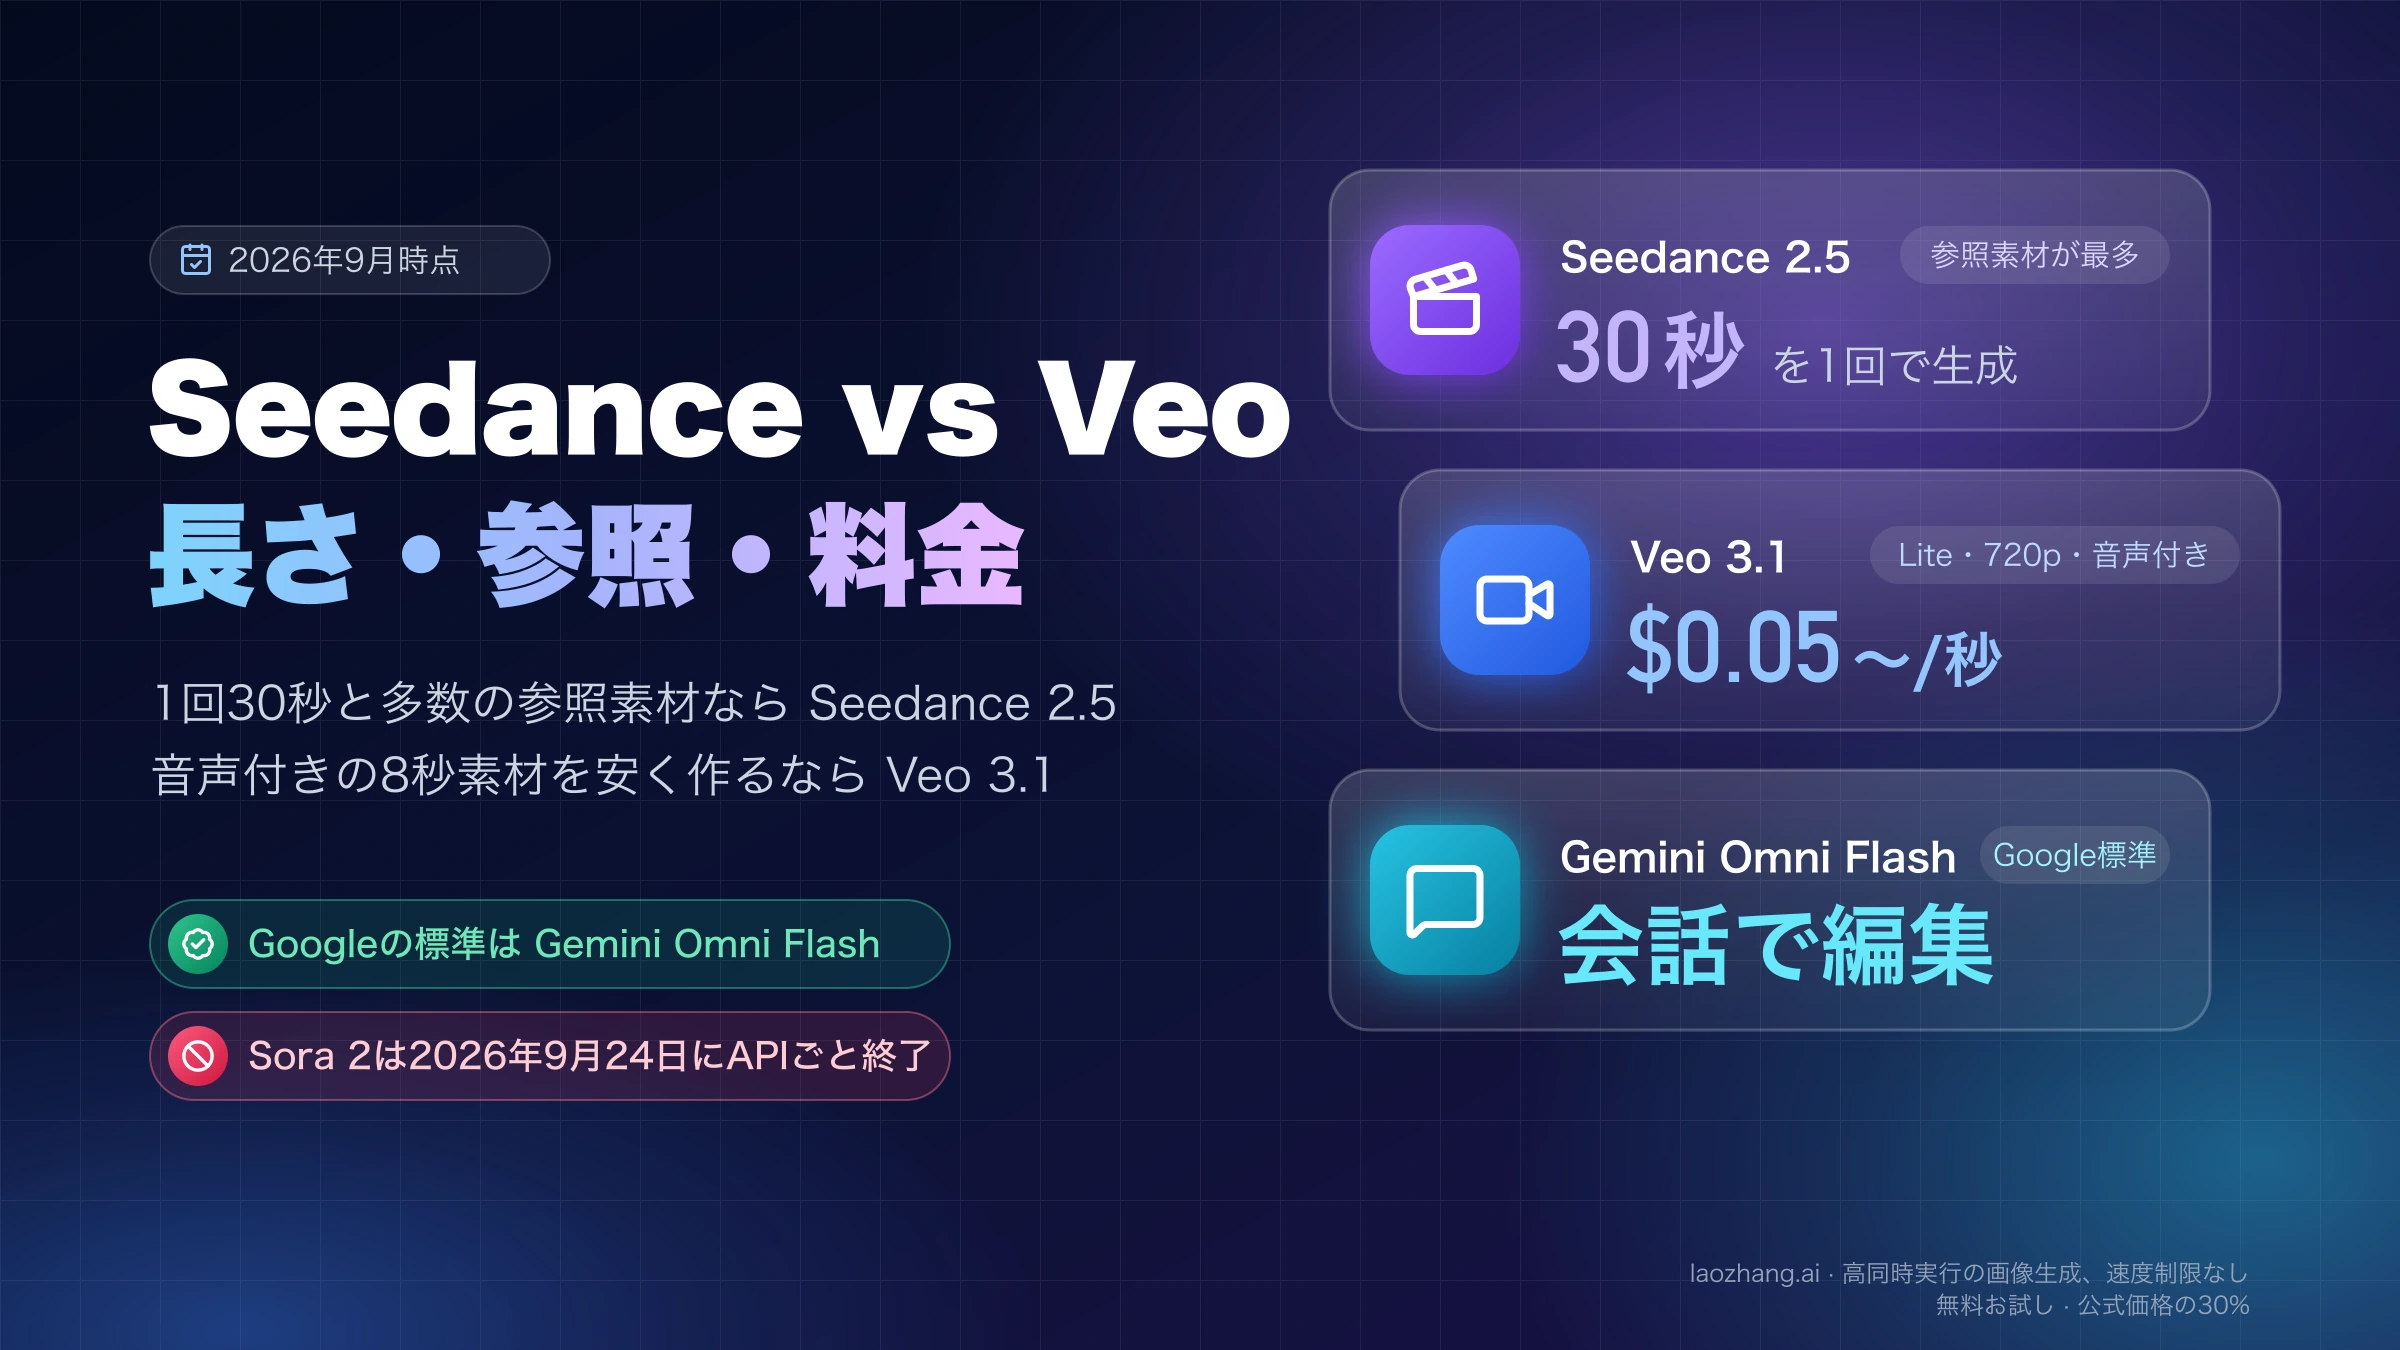
なお、OpenAIのSoraはアプリが2026年4月26日に終了し、Sora 2のモデルとVideos APIも2026年9月24日に終了したため、選択肢から外しています。SeedanceとVeoを長さ・参照・料金で比べたい場合はSeedance vs Veo比較:長さ・参照・料金の違い、Gemini Omniの利用経路とモデルIDはGemini Omni 1.1 Flashは移行すべき?API・料金・利用経路の判断ガイドを参照してください。
台詞の書き方:同じ画面版とカット割り版のプロンプト例
ここでは、Seedance 2.5の文書に書かれている記法で組んだ例を載せます。生成して確かめたものではない未検証のテンプレートなので、人物の描写や台詞は自分の題材に置き換え、最初の1本で崩れ方を見てください。
Seedance 2.5では、台詞を波括弧で囲み、中国語以外の台詞は台詞の前に言語を指定します。日本語の台詞を話させるときは、この言語指定を毎行に付けておくのが文書どおりの書き方です。また、台詞の後に同じ語を繰り返したり、特定の語に表情や動作の指示を付けたりすると字幕が出やすくなる、とガイドにあります。
同じ画面で2人に話させる例
Image 1 is Character A (woman, short black hair, red coat) and corresponds to Audio 1.
Image 2 is Character B (man, gray suit, glasses) and corresponds to Audio 2.
Single continuous medium two-shot at a café table. A sits on the left, B on the right. Static camera.
A speaks in Japanese: {今日の会議、来週に延期になったよ。} B listens and looks at A.
B replies in Japanese: {じゃあ、資料は金曜までに直せばいいね。} A listens and nods.
No subtitles. No BGM.
ポイントは、参照素材を人物が登場する順にアップロードして番号をそろえること、毎行で話す人と聞く人を両方書くこと、立ち位置を最初に固定することです。
カット割りで1人ずつ話させる例
Image 1 is Character A (woman, short black hair, red coat) and corresponds to Audio 1.
Medium close-up of A at a café table, seen over B's right shoulder. A is on the left side of the frame.
A speaks in Japanese: {今日の会議、来週に延期になったよ。}
No subtitles. No BGM.Image 1 is Character B (man, gray suit, glasses) and corresponds to Audio 1.
Medium close-up of B at the same café table, seen over A's left shoulder. B is on the right side of the frame.
B replies in Japanese: {じゃあ、資料は金曜までに直せばいいね。}
No subtitles. No BGM.カット割りでは、1カットに参照する人物を1人に絞り、背景、照明、左右の位置をカット間で同じ言葉で書きます。聞き手の反応ショットは台詞なしで別に作っておくと、編集でつなぎ目を隠しやすくなります。
Veo 3.1の場合、Gemini APIの文書は台詞を引用符で囲む書き方を示し、男性と女性の2人が1本の中で交互に話す例を載せています。Vertex AIのガイドでは「刑事が言う:…」「情報屋が答える:…」とコロンで書く例もあります。参照素材の番号付けや部分修正などSeedanceの書き方を詳しく知りたい場合は、Seedance 2 プロンプトの書き方:2.5の秒指定、参照素材、絵コンテと修正例にまとめています。
よくある失敗と次の一手:症状別の診断表
失敗したとき、プロンプトや参照素材で直すか、方式そのものを変えるかを決める表です。根拠は各行の原因欄に書いた文書や解説です。
| 症状 | 考えられる原因 | まず試す修正 | 直らないときの方式変更 |
|---|---|---|---|
| 台詞を話しているのが別の人物 | 話す人だけを書き、聞き手と位置を書いていない(seedance.tvの解説) | 毎行に話す人と聞く人、左右の位置を書く | その台詞だけ単独ショットに分ける |
| 声が入れ替わる | 声と人物の対応が画像の中だけ、または番号とアップロード順が合っていない(Seedanceガイド) | 登場順にアップロードし、本文で画像と音声の番号を1対1で書く | 1カット1人にする、またはRunway Act-Twoで1人ずつ演技を当てる |
| 最初に出る人物が別の参照人物に置き換わる | 参照素材の順番と登場順のずれ(SeedanceガイドのFAQ) | 人物が最初に登場する順に素材を並べ直し、番号を振り直す | 登場する人物を減らしたカットに分ける |
| 2人の顔や服が混ざる | 2人の見た目が近い、参照が1人1枚になっていない(seedance.tv、Elser AIの解説) | 髪型や服の色を大きく変え、参照を1人1枚にする | カット割りにして1カットに1人だけ参照する |
| 頼んでいないのにカットが切り替わる | Gemini Omniは既定で数ショットに分ける(Gemini APIの文書) | 「No scene cuts」「single continuous shot」と書く | 切り替えを前提にカット割りの構成に寄せる |
| 字幕が出る | 台詞の語の繰り返しや語ごとの指示、参照動画の字幕(Seedanceガイド) | 繰り返しと語ごとの指示を消し、字幕のない参照動画を使う | 編集で字幕部分をトリミングするか作り直す |
| 延長したら声が続かない | 直前の動画の最後の1秒に声がない(Veoの文書) | 最後の1秒に声が入った状態で延長する | 延長をやめ、カットを分けてつなぐ |
| 参照や編集を1回に詰め込んで不安定 | 複数の参照と編集の要求を1つのタスクにまとめている(Seedanceガイド) | 作業を複数の単純なタスクに分ける | カット割りにする |
ByteDanceのガイドは、複数の参照と編集の要求を1つのタスクにまとめると結果が不安定になることがあり、複雑な作業は単純なタスクに分けるよう勧めています。会話シーンに限った説明ではありませんが、同じ画面の会話で直らない崩れが続くときに方式を切り替える目安になります。
3人以上の会話・日本語の台詞・無料ツールについてのFAQ
AI動画で日本語で3人が会話する場面は作れますか?
作れますが、3人を同じ画面に入れて1回で生成するより、カット割りのほうが崩れにくくなります。第三者の解説では、最も制御しやすいのは2人、3人は見た目がはっきり違えば可能とされています。Kling 3.0は3人以上の人物を指し分ける機能を案内していますが、ベンダーの説明です。日本語の台詞は、Seedance 2.5なら台詞の前に言語を指定し、誰がどの順番で話すかを1行ずつ書きます。
複数キャラの会話をAIで無料で作れるツールはありますか?
ソフトウェアとして無料なのは、オープンソースのMultiTalkとInfiniteTalkです。人物ごとに音声ファイルを割り当てる仕組みで、MultiTalkは最長15秒、InfiniteTalkは既定で最長40秒まで生成できます。ただし動かすには自前のGPU環境が必要です。商用サービスの無料枠は頻繁に変わるため、各サービスの料金ページで確認してください。
複数キャラのプロンプトはどう書けば口や声がずれにくくなりますか?
人物と参照素材の対応を本文で1つずつ書き、毎行に話す人と聞く人を書き、立ち位置を固定します。Seedance 2.5のガイドは、参照素材を人物が登場する順にアップロードし、番号をその順に合わせることを勧めています。画像の中に名前を書くだけの指定は、人物の混同を招きやすいとされています。
Soraで複数キャラの会話動画は作れますか?
作れません。Soraのアプリは2026年4月26日に終了し、Sora 2のモデルとVideos APIも2026年9月24日に終了しています。会話シーンには、Veo 3.1、Seedance 2.5、Kling、Runway Act-Twoなどを比較表の条件で選んでください。
長い会話を1本の動画にまとめるにはどうすればいいですか?
1本の生成の上限を超える会話は、延長するかカットに分けます。Veo 3.1は8秒の動画を7秒ずつ延長でき、出力は最長148秒ですが、直前の動画の最後の1秒に声がないと声を引き継げません。Seedance 2.5は1回で最長30秒まで生成できます。台詞の修正が多い場合は、延長でつなぐより、カット割りで作って編集でつなぐほうが作り直しを小さくできます。
参考資料14
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月19日。
参考資料14
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月19日。
- 1.BytePlusのSeedance 2.5プロンプトガイドdocs.byteplus.com/en/docs/modelark/seedance-2-5-prompt-guide
- 2.seedance.tvの複数キャラ会話の解説seedance.tv/blog/seedance-2-5-multi-character-dialogue
- 3.Vertex AIのVeoプロンプトガイドcloud.google.com/vertex-ai/generative-ai/docs/video/video-gen-prompt-guide
- 4.Elser AIの解説elser.ai/blog/how-to-create-multi-character-dialogue-videos-with-ai-without-losing-character-consistency
- 5.Runwayのヘルプ記事「Creating Multi-Character Dialogues with Act-Two」help.runwayml.com/hc/en-us/articles/41748090660499-Creating-Multi-Character-Dialogues-with-Act-Two
- 6.Gemini APIのVeo 3.1ドキュメントai.google.dev/gemini-api/docs/veo
- 7.Gemini APIのGemini Omniドキュメントai.google.dev/gemini-api/docs/omni
- 8.BytePlusのSeedance 2.5モデル説明docs.byteplus.com/en/docs/modelark/seedance-2-5
- 9.Kling 3.0のリリースノートkling.ai/release-note/release-notes/whbvu8hsip
- 10.Kling 4.0のリリースノートkling.ai/release-note/release-notes/Kling_4
- 11.MiniMax H3の公式ブログminimax.io/blog/minimax-h3
- 12.Alibaba CloudのWan 2.7 APIリファレンスalibabacloud.com/help/en/model-studio/text-to-video-api-reference
- 13.MultiTalkのGitHubリポジトリgithub.com/MeiGen-AI/MultiTalk
- 14.InfiniteTalkのGitHubリポジトリgithub.com/MeiGen-AI/InfiniteTalk