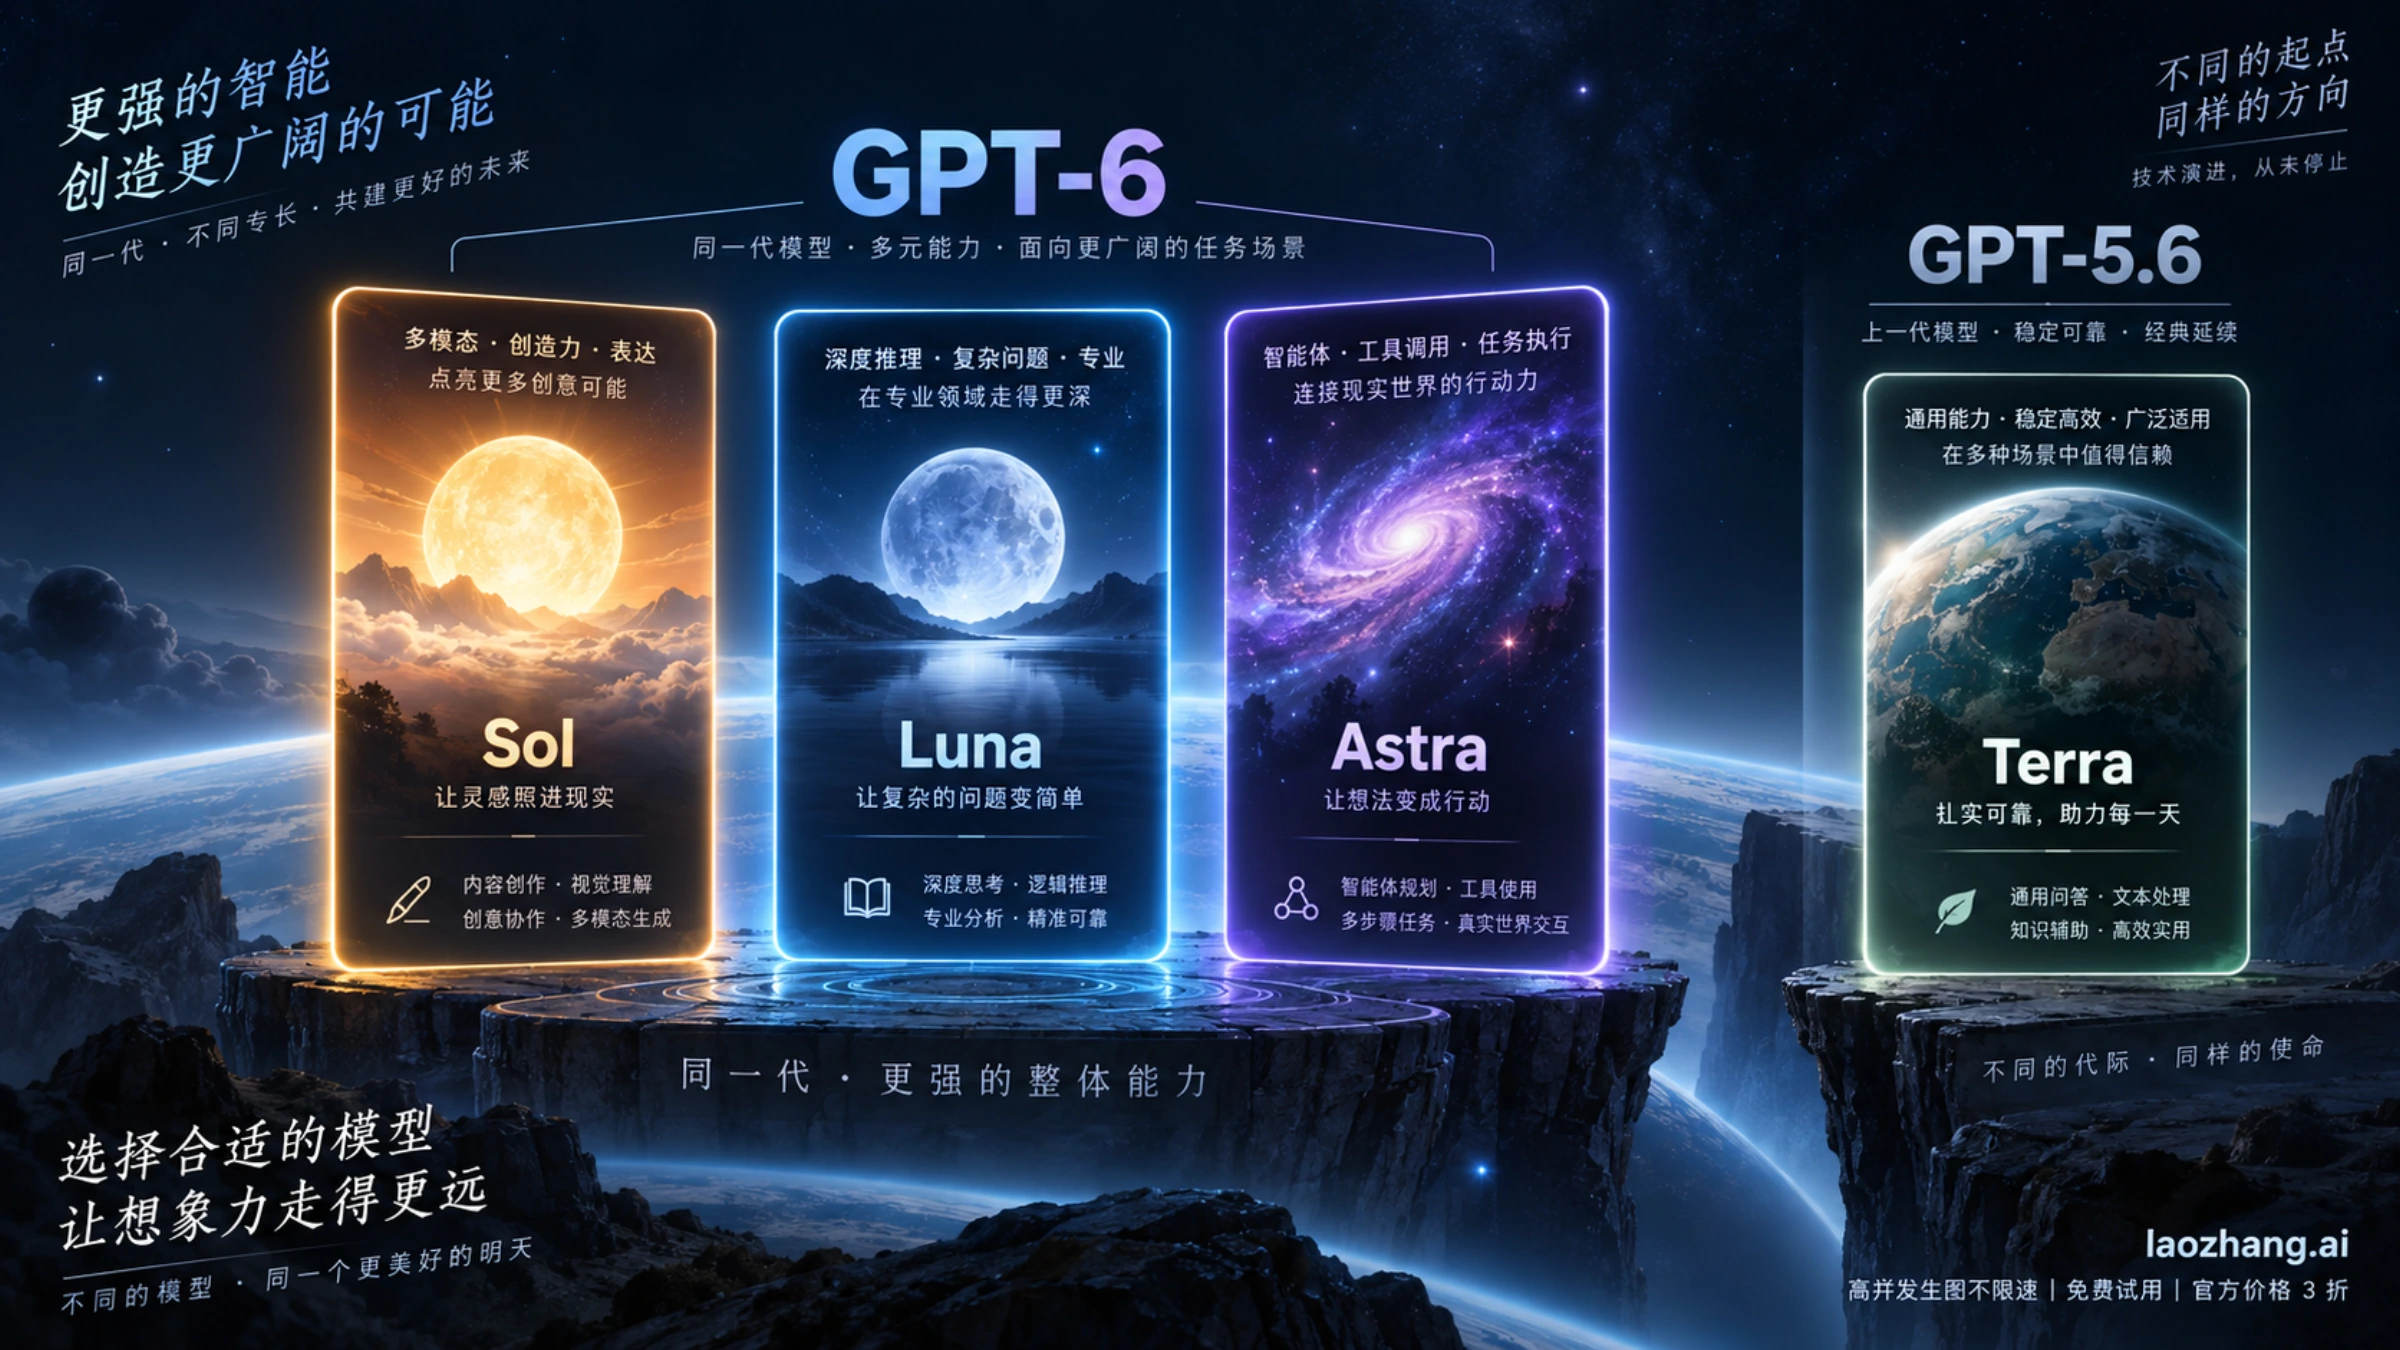
先认型号:GPT-6 有 Astra、Sol、Luna,没有 GPT-6 Terra。 Terra 在官方模型目录中的 ID 是 gpt-5.6-terra。如果你要做复杂编码或代理任务,先试 gpt-6-sol;范围明确、数量大的提取与摘要,先试 gpt-6-luna;跨代码、浏览器与专业软件的高难度长流程,再评估 gpt-6-astra。已经用 Terra 跑得稳的工作,不必只因“6”这个版本号立刻迁移。GPT-6 官方指南和 Terra 型号页给出了这两个代际边界。
以下是选型起点,不是本站跑出的速度或成功率排名。真正要换默认模型,拿同一批任务比较合格率、耗时、实际 token 用量和重试次数。
四个名字其实分属两代
| 名称与 API ID | 官方定位 | 适合先拿来试的工作 |
|---|---|---|
GPT-6 Luna:gpt-6-luna | GPT-6 中面向聚焦、大批量任务的高效率型号 | 字段提取、固定格式摘要、有明确验收规则的轻量编码 |
GPT-6 Sol:gpt-6-sol | 面向复杂编码和代理式工作流 | 跨文件修改、需要工具配合的开发任务、日常复杂判断 |
GPT-6 Astra:gpt-6-astra | 面向最难的端到端工作 | 需要持续协调代码、浏览器、研究或专业软件的多步任务 |
GPT-5.6 Terra:gpt-5.6-terra | GPT-5.6 中平衡能力与成本的型号 | 已有稳定流程、暂不想迁移,或需要与新型号做基线对照 |
前三项的型号与定位来自 OpenAI 的 GPT-6 指南及 Sol、Luna、Astra 型号页;Terra 的身份见 GPT-5.6 Terra 型号页。表里的“适合先试”是据官方定位做的工作分流,不是已验证的胜率。若你比较的是上一代内部三款,应看 GPT-5.6 Sol、Terra、Luna 怎么选。
先选谁:用任务的失败代价划线
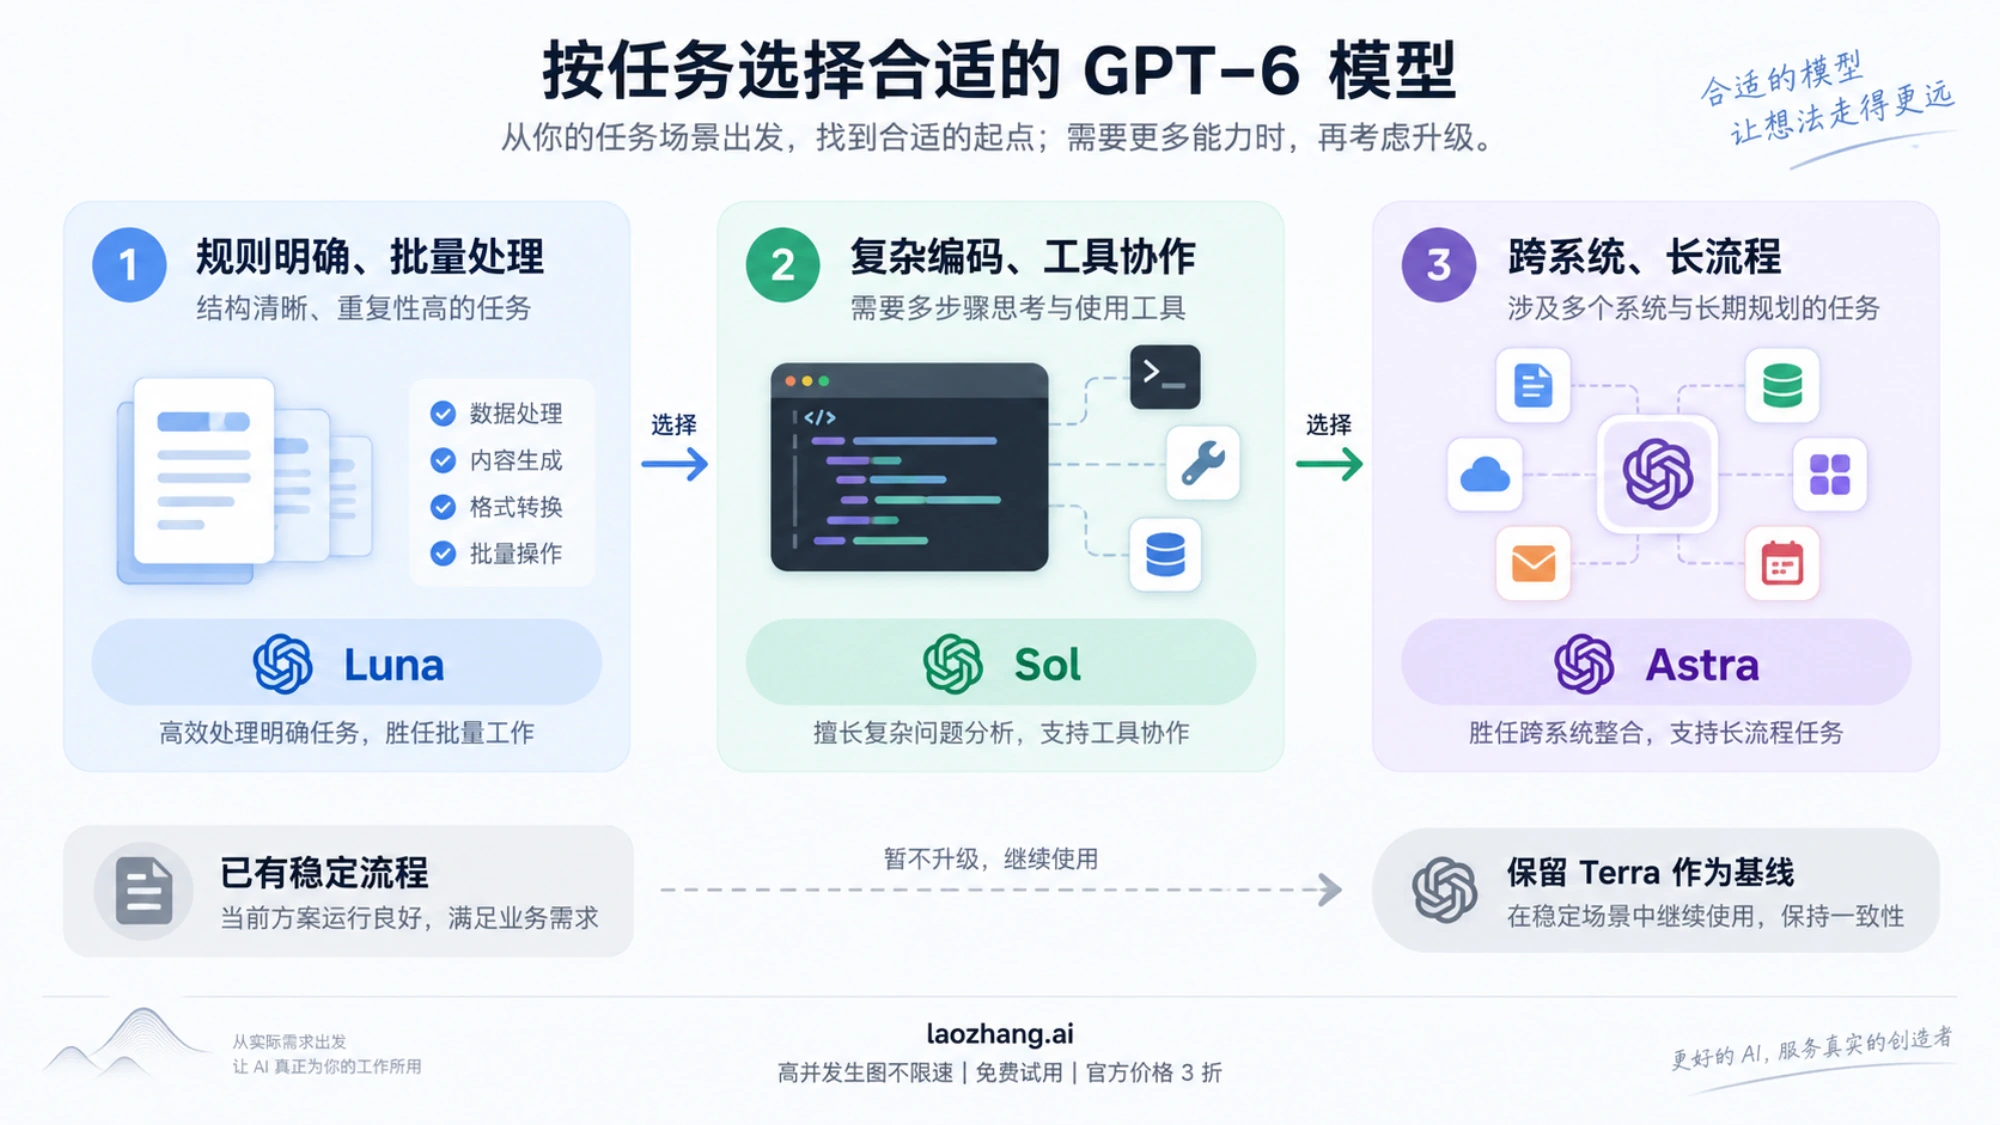
任务短、输入输出格式固定,而且错一条能由规则或人工快速识别,可以从 Luna 开始。它的每 token 单价低,但低价不自动等于更便宜的合格结果;若它使重试或人工修正明显增加,就把这类任务升到 Sol。
代码改动跨多个文件、工具调用多、约束会在过程中变化时,Sol 是更稳妥的首次对照点。先用相同任务和验收标准试 Sol 与当前模型,避免把官方“面向复杂编码”的定位读成对你仓库的实测保证。如果 Sol 已能稳定完成,Astra 的高单价需要由更难的任务来证明价值。
当任务跨系统、步骤长,失败后返工昂贵,且 Sol 的主要问题是中途丢约束、决策质量或需要太多人工接管,再用 Astra 跑同一组任务。官方把它放在最难的端到端工作上;这仍不能替代你的验收数据。Astra 的独立价格与接入说明适合进一步核对高价任务的预算。
Terra 留作现有基线也有合理性:若它的提示词、工具链和人工审核已经成熟,迁移成本本身要进账。尤其是 Sol 与 Terra 的输入单价相同,不能凭“新一代”就断言所有任务的总成本更低;先看下面可复算的价格差,再测实际用量。
API 每百万 token 多少钱?先限定计费条件
下表是 2026 年 9 月 23 日查询的 OpenAI 直连 API、Standard 处理、输入不超过 272K token 的短上下文文本单价,单位均为美元/百万 token。缓存读取、缓存写入和输出分别计价;不能把这张表当作 Codex 或 ChatGPT Work 的订阅额度。官方价格页列出 GPT-6 三款;Terra 型号页列出上一代 Terra 的价格与长上下文规则。
| 模型 | 普通输入 | 已缓存输入 | 缓存写入 | 输出 |
|---|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.50 |
| GPT-6 Sol | $2.00 | $0.20 | $2.50 | $10.00 |
| GPT-5.6 Terra | $2.00 | $0.20 | $2.50 | $12.00 |
| GPT-6 Astra | $10.00 | $1.00 | $12.50 | $50.00 |
Sol 与 Terra 的差价在输出侧。 按这张表,相同处理模式、相同普通输入与输出 token 数量时,两者输入价格一致,Sol 每百万输出 token 少 $2。举个纯演算例子:一次请求使用 10 万普通输入 token、2 万输出 token,没有缓存、工具费、区域加价或重试。Sol 是 0.1 × $2 + 0.02 × $10 = $0.40;Terra 是 0.1 × $2 + 0.02 × $12 = $0.44。同样用量下,Sol 少 $0.04;这不是实际账单,也不能推出 Sol 对同一任务必然少花钱,因为推理输出、重试和合格率可能不同。
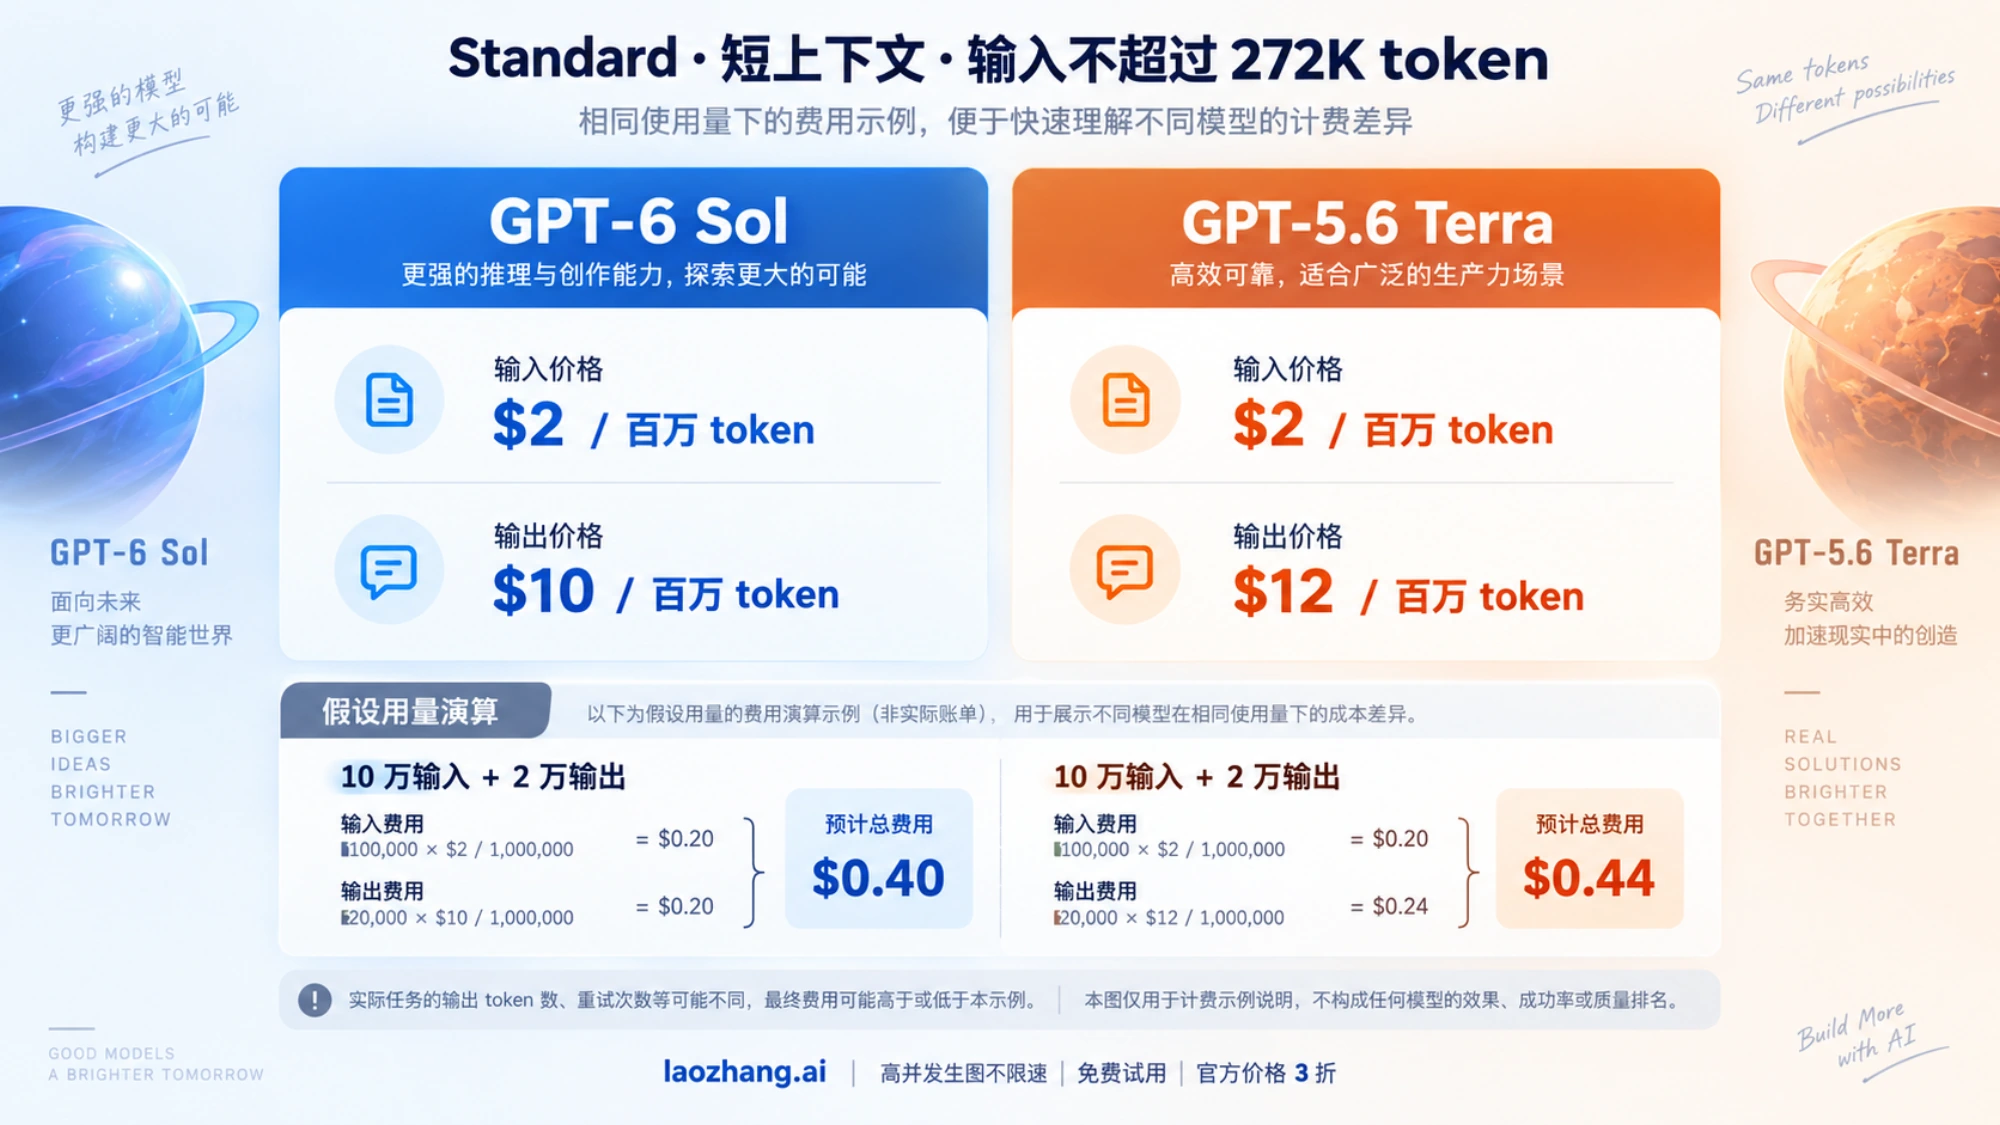
超过 272K 输入 token 时,官方规定整次请求按长上下文价格计,而不是只给超出部分加价。Standard 下每百万 token 的普通输入/输出变为:Luna $0.20/$0.75、Sol $4/$15、Terra $4/$18、Astra $20/$75。Batch、Flex、Fast、区域处理、缓存写入及工具调用会改变账单,核算时应按实际服务模式和 usage 明细重新代入。GPT-6 价格表与 Terra 长上下文规则给出对应口径。
怎样用小样本决定升级或保留 Terra
从自己的真实工作中各挑几件简单、复杂和容易失败的任务,固定输入资料、提示词的关键约束、工具权限与验收标准。让当前型号和候选型号完成同一任务,记录每次是否通过验收、人工修正时间、端到端耗时、普通及缓存输入 token、输出 token、工具费和重试次数。对会影响业务的任务,先写明哪些错误必须人工拦截。
升级条件是结果改善足以抵过总成本。 Luna 若便宜且通过率满足要求,就保留;它若在关键字段上反复返工,试 Sol。Sol 若在多步任务中仍要频繁人工接管,再试 Astra。Terra 若在现有任务上质量稳定、迁移后没有可量化改善,就继续用 Terra。模型选择也受 reasoning.effort 影响:Sol 与 Luna 可用 none 到 max,Astra 从 low 起,不支持 none;比较时应记录实际设置。GPT-6 指南列出此边界。
不要只比标价。一个便宜型号若输出更长、需要重试或人工复核,合格任务的平均成本可能反而高;一个昂贵型号也可能因减少失败而划算。本文没有进行 API 实测,因此没有任何型号在中文开发任务上的普遍胜率或响应速度结论。
API 能用,Work 或 Codex 就一定能选到吗?
不能这样推。 API 文档中的 model ID 和按 token 计费是一种入口;ChatGPT Work、Codex 的模型选择受客户端、套餐、登录方式、工作区设置及逐步开放影响。OpenAI 的 产品模型说明写明 GPT-6 Sol/Luna 可在 Work 和 Codex 使用,但在 ChatGPT 的普通 Chat 中不可选;GPT-5.6 Sol/Terra/Luna 在开放期间仍保留。它也明确说,选择新型号不会改变你的工作区权限或自动授予访问权。
因此,API 开发者先查自己项目的可用型号和实际账单;Work/Codex 用户先看当前客户端模型选择器及账户权限,再按工作任务试用。中文界面或中文文章不代表某个地区、账户一定符合服务资格。若你在 API 里要让 GPT-6 调工具,优先按 官方模型指南走 Responses API:Sol/Luna 的 Chat Completions 函数调用仅支持 reasoning_effort: "none",Astra 的工具调用也要求 Responses。不能把界面里的推理档位直接换算为这张 API 单价表上的固定费用。