Sonnet 5.5 对比 GPT-6 Astra:值不值得换
按 AA v5.0,GPT-6 Astra 每个推理档都比 Sonnet 5.5 分高,xhigh 以上还更便宜;Sonnet 的长处是 high 及以下更省、输出更快。
文章目录
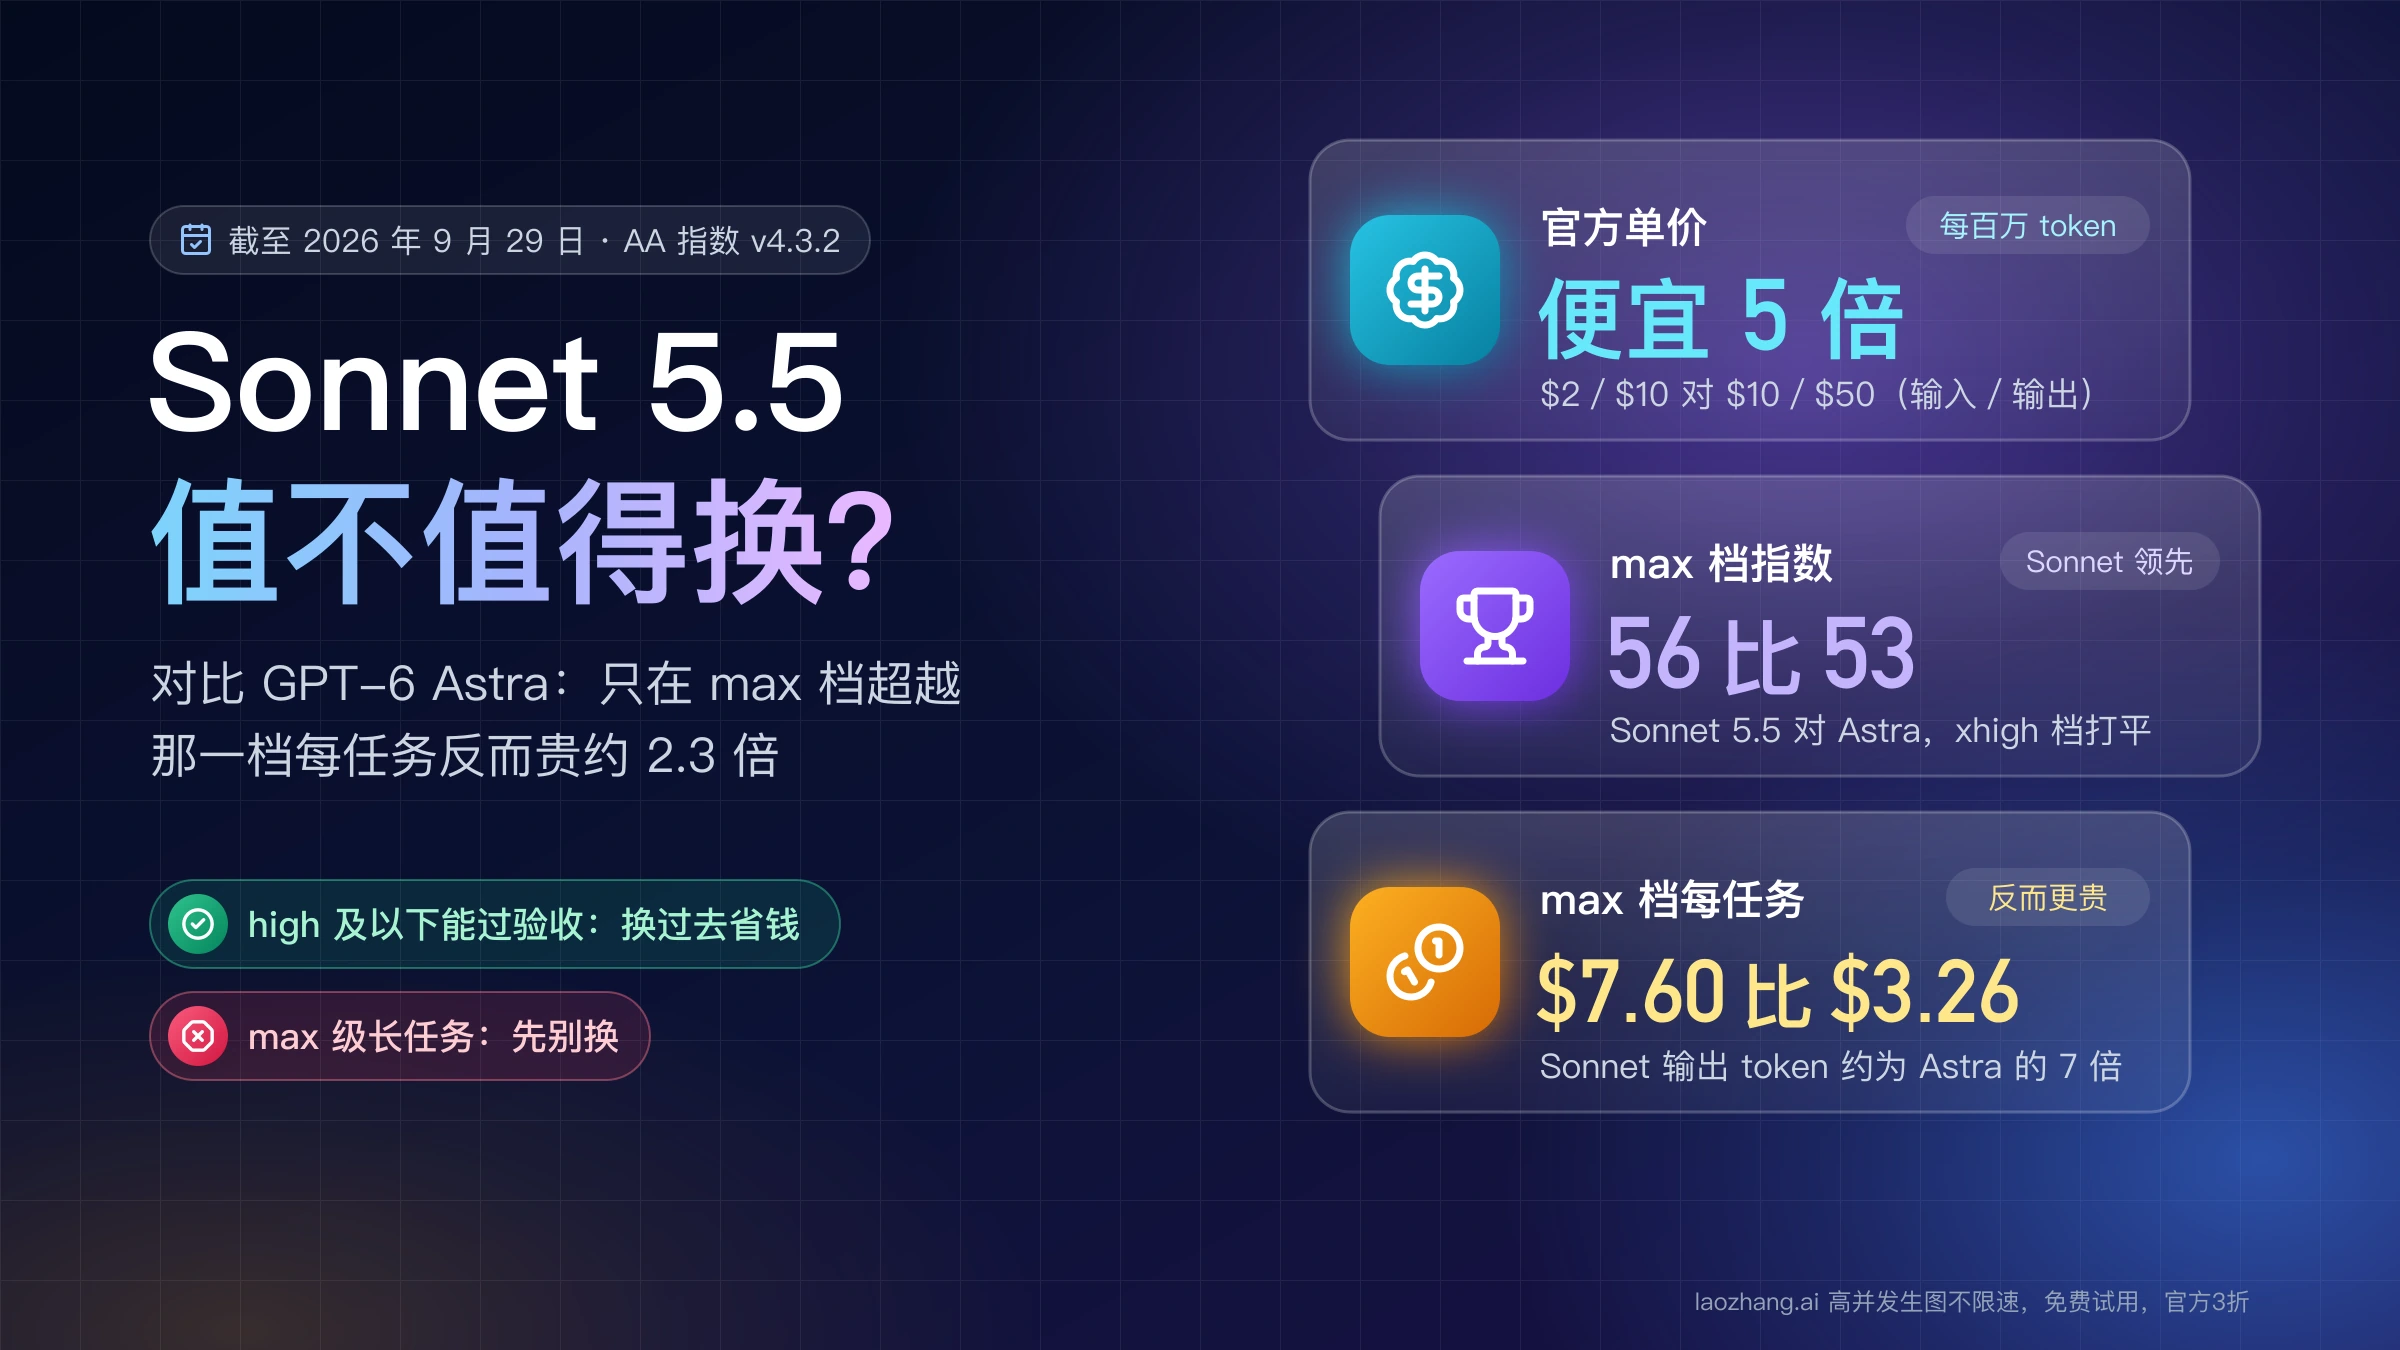
“Sonnet 5.5 超越 GPT-6 Astra”在 Artificial Analysis 智能指数(以下简称 AA)的现行版本里不成立。AA 在 2026 年 10 月 27~28 日把指数从 v4.3.2 换成 v5.0(9 项评测)之后,逐档比较页上 Astra 在每个推理强度(effort)都比 Sonnet 5.5 分高:max 57 比 54,xhigh 55 比 50,high 及以下差 14~21 分。旧版里 Sonnet 只在两边都开 max 时领先 3 分(56 比 53),这个结论随新版作废。Sonnet 5.5 仍占优的是两件事:high 及以下每道指数题更便宜,同名档位的 Astra 要花它的 2.0~3.5 倍;输出也更快,每秒约 109~140 个 token,Astra 约 48~71 个。到了 xhigh 和 max,Astra 分更高,每任务还更便宜。
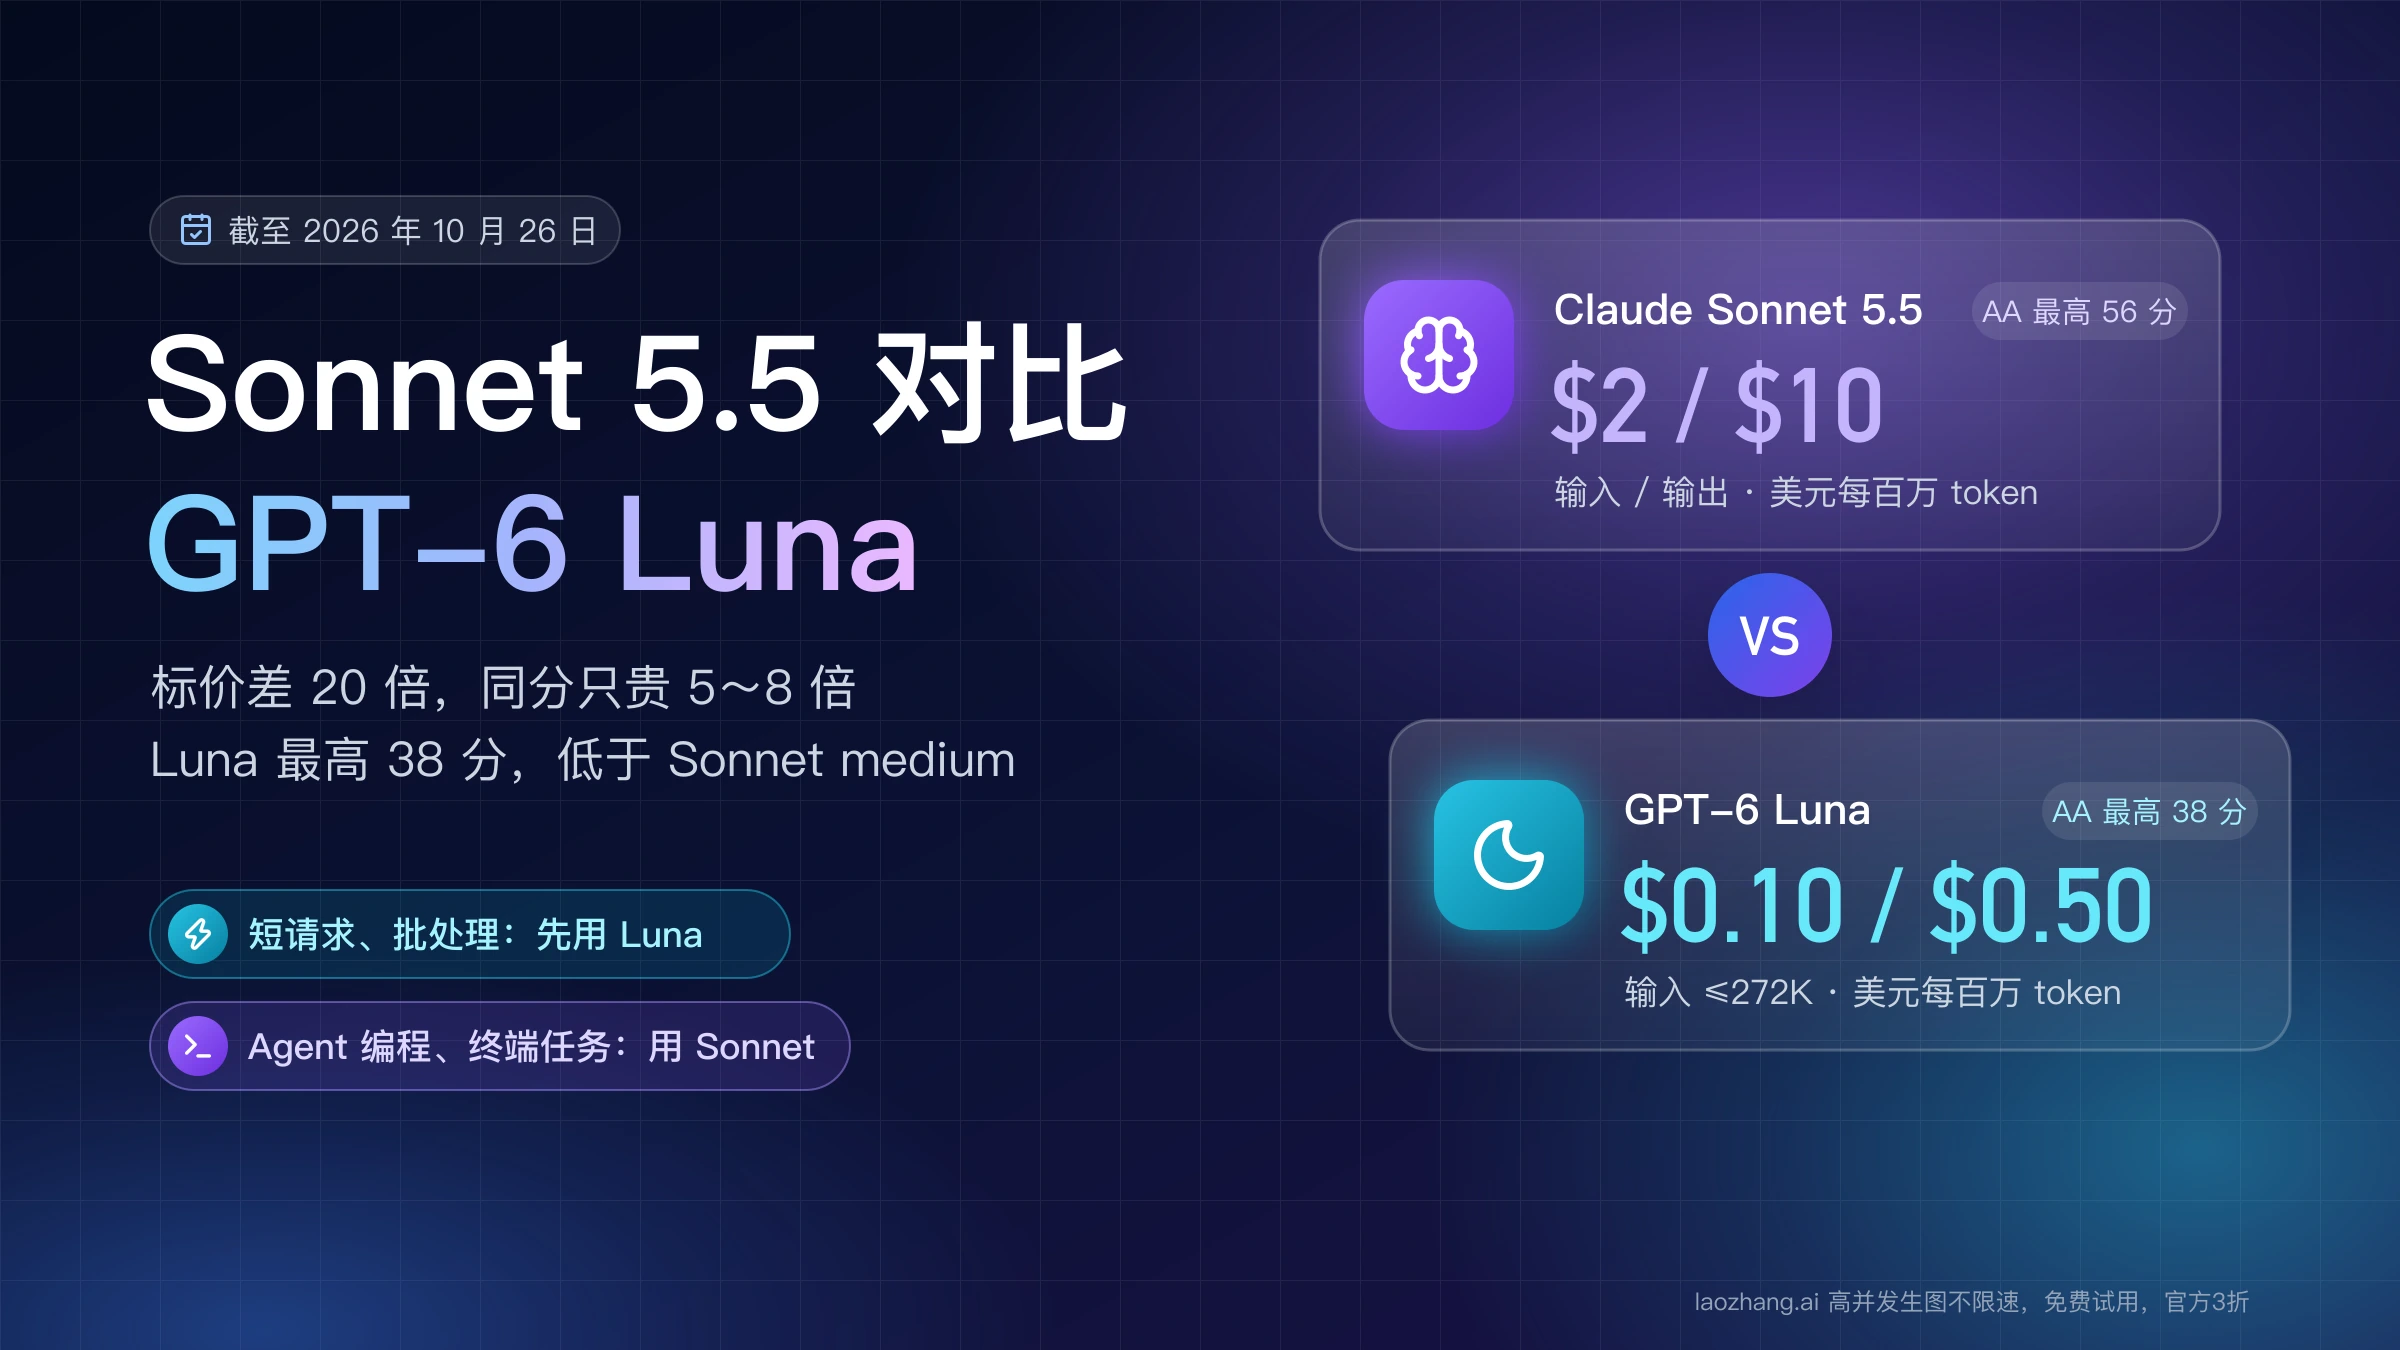
所以别把 Sonnet 5.5 当成“更强、还便宜 5 倍”的 Astra 平替。实际可行的分法是:Sonnet 在 medium 或更低档就能通过你验收的任务,换过去,官方单价差 5 倍会实打实体现在账单上;要开到 high 的,先和 Astra low 比一比(下文有数字);要开到 xhigh 或 max 才够用的长智能体任务,以及终端运维、科研工作流这类第三方测试里 Astra 大幅领先的工作,继续用 Astra,或者两者分流。如果你真正想比的是同价位谁更好,OpenAI 那边和 Sonnet 5.5 同价的是 GPT-6 Sol,不是 Astra。
“超越”是在哪一档比出来的
AA v5.0 对两个模型的五个推理档位都跑了完整指数。v5.0 去掉了旧版的 GDPval-AA、SciCode、Humanity's Last Exam 和 AA-LCR,加入 FrontierCode 2.0 等新评测,分数不能和 v4.3.2 逐分对比。下表的“每任务成本”是 AA 完成一道指数题的平均花费,反映的是它那套测试的工作量,不是你的请求会花多少钱。
| 推理强度 | Sonnet 5.5 指数 | Sonnet 5.5 每任务成本 | GPT-6 Astra 指数 | GPT-6 Astra 每任务成本 |
|---|---|---|---|---|
low | 25 | $0.51 | 43 | $1.42 |
medium | 30 | $0.78 | 51 | $2.73 |
high | 41 | $1.64 | 55 | $3.24 |
xhigh | 50 | $4.09 | 55 | $3.66 |
max | 54 | $10.02 | 57 | $6.24 |
数据来自 AA 的 Sonnet 5.5 与 GPT-6 Astra 逐档比较页,截至 2026 年 10 月 28 日。
按同名档位对照,Astra 从 low 到 max 分别领先 18、21、14、5、3 分,没有一档打平或落后。每任务成本上,Sonnet 在 low 到 high 都比同名档位的 Astra 便宜,Astra 分别是它的 2.78、3.50、1.98 倍,但 Sonnet 的分数低一大截;到了 xhigh 和 max,Astra 分更高,成本反而只有 Sonnet 的 0.89 倍和 0.62 倍。按分数对齐更能说明问题:Astra low 拿 43 分花 $1.42,Sonnet 开到 high 只有 41 分,却要花 $1.64;Sonnet 开满 max 的 54 分($10.02)也够不到 Astra high 的 55 分($3.24)。AA 在 2026 年 9 月 29 日(旧版 v4.3.2)的发布文章里也说过,Sonnet 5.5 不在“智能—每任务成本”的最优曲线上,较低档位时 Astra 或 GPT-6 Sol 的某些配置能用更低成本达到同等表现。
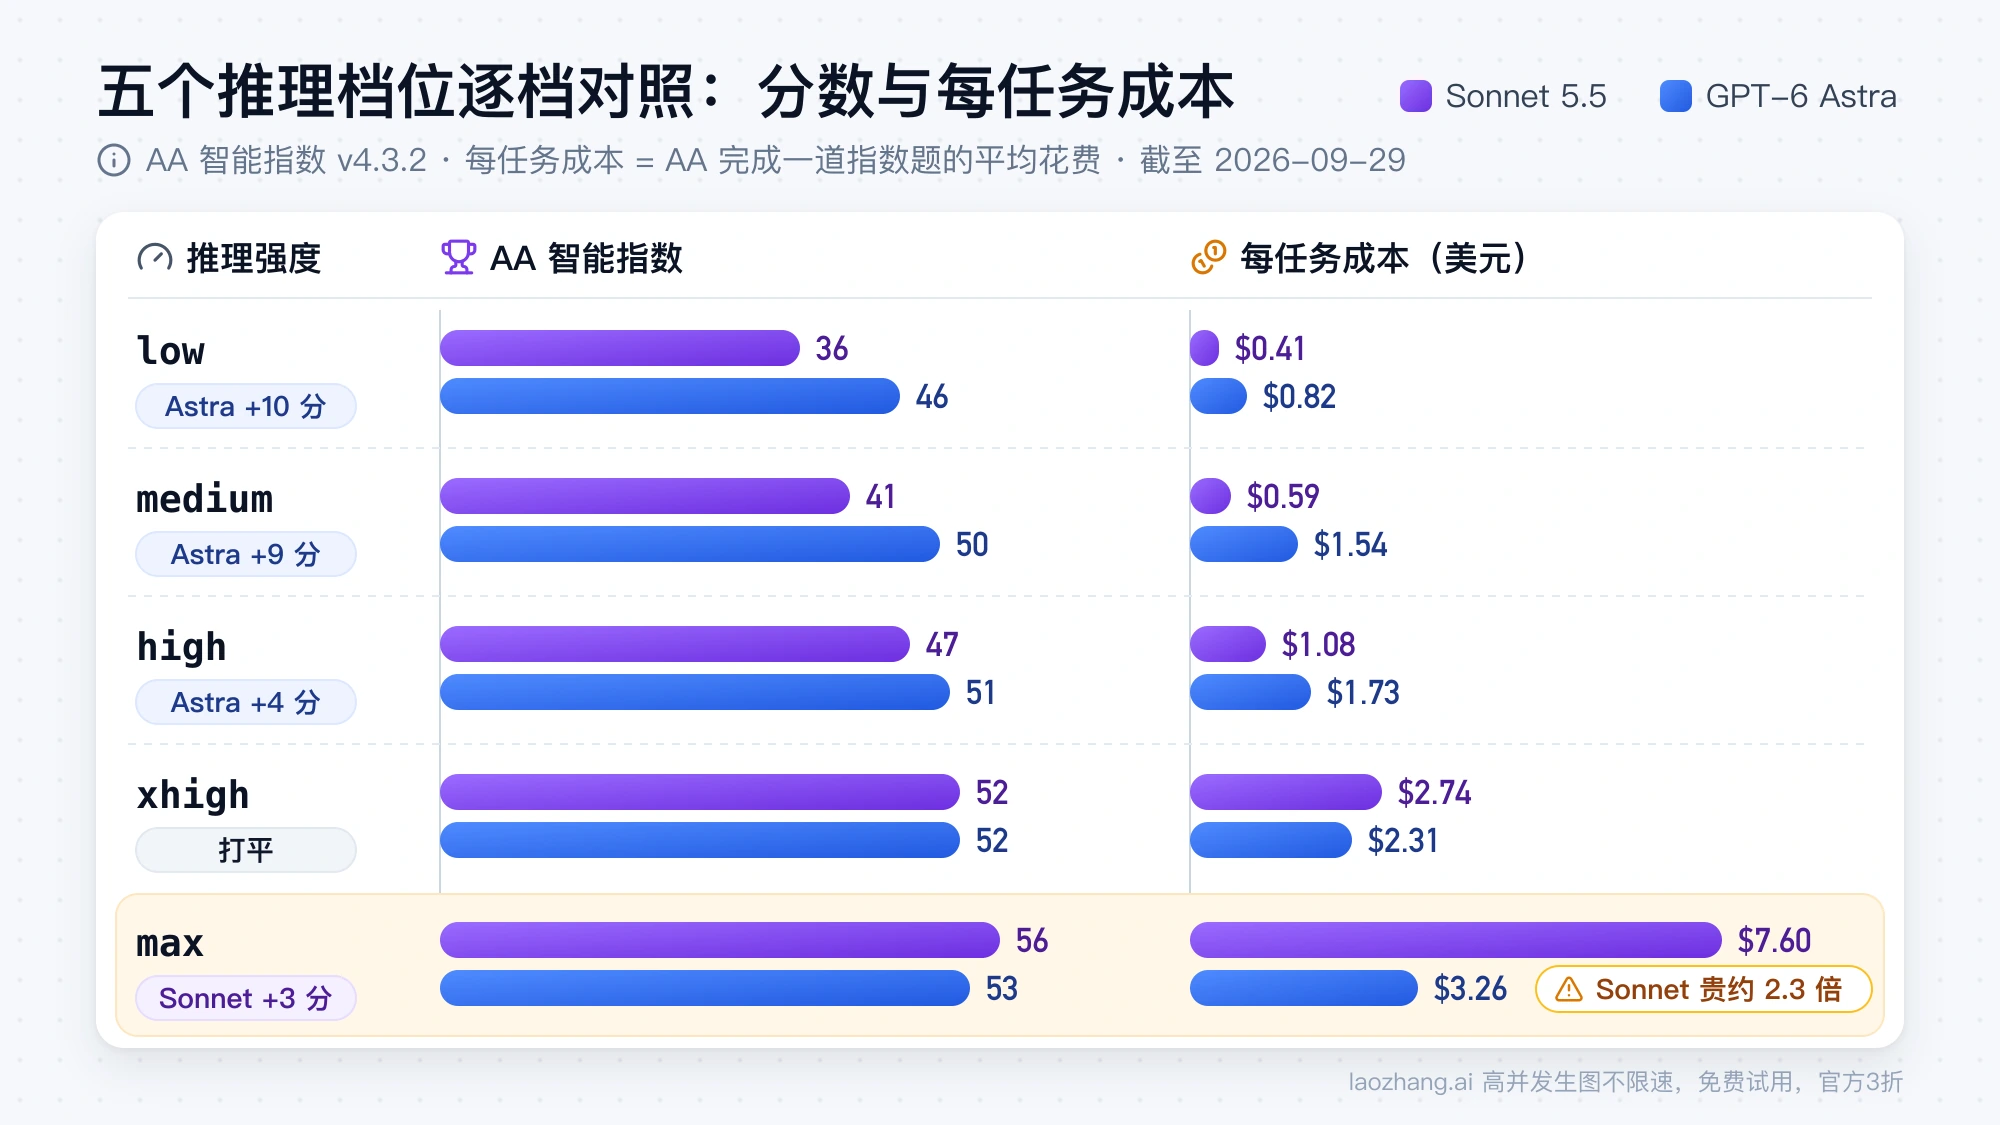
图中是 Artificial Analysis v4.3.2 的分数和成本;截至 2026 年 10 月 28 日的 v5.0 数字以上表为准,Astra 在五个档位都更高。
有一点要记住:两家的档位名称一样,但各自定义,没有互相校准。Sonnet 的 high 和 Astra 的 high 不代表同样的思考量,所以真正该对齐的是“你的任务需要多少分”,而不是档位名。
默认档也会影响你实际拿到的是哪一行。Sonnet 5.5 在 API 上默认 high(AA v5.0 41 分),在 Claude 应用和 Claude Code 里默认 medium(30 分),见 Anthropic 发布页。Astra 的默认档位在 OpenAI 推理文档里没有写明,而且它不接受 none,传了会返回 400。做对比或上线时,两边都显式写上 effort。
账单为什么会涨
原因是输出 token。AA 在 2026 年 9 月 29 日的发布报告(旧版 v4.3.2)里测到,Sonnet 5.5 在 max 档每道指数题平均输出约 19.3 万 token,是它当时测过的最高值,约为 Astra max 的 7 倍,也比 Opus 5.5 max 和 Sonnet 5 max 高约 60%;同一篇报告还测到 Sonnet 5.5 max 的每任务成本比 Sonnet 5 max 高约 50%。这组倍数来自旧版,Sonnet 5 在 v5.0 里也不再打分,但新版的成本结果方向一致:单价便宜 5 倍,输出量却多得多,max 档每任务 $10.02 对 Astra 的 $6.24,Sonnet 贵约 1.6 倍。
Anthropic 说 Sonnet 5.5“快 30% 以上,多数工作最多便宜 30%”,对比对象是 Sonnet 5,不是 Astra,而且写的是“最多”。开到 max 跑长任务时,这句话不一定适用。
AA 9 月 29 日的旧版数字还有一个前提:测的是预发布版本,Anthropic 发现其中有个会影响结构化输出的 bug,正式版已修复,预计变化很小或原分数略偏低,AA 表示会重跑相关测试。另外约 0.1% 的任务回退到了 Sonnet 5。这张表之后还会变,引用时带上日期。
两家的官方跑分表为什么不能拼在一起
Anthropic 的 Sonnet 5.5 发布页对比的是 Sonnet 5、Opus 5.5 和 GPT-6 Sol,整页没有出现 Astra;OpenAI 的 Astra 发布页也没有 Sonnet 5.5 或 Opus 5.5 这一列。两张表各用各的测试环境和提示设置。
最容易被拿来对比的是 Terminal-Bench 4.0:Anthropic 公布 Sonnet 5.5 为 70.6%,OpenAI 公布 Astra(max)为 57.9%。把这两个数放在一起,比的其实是两家各自的跑法。第三方用同一套环境测出来是另一回事,而且彼此方向相反:
| Terminal-Bench 4.0 | Sonnet 5.5 | GPT-6 Astra | 谁高 |
|---|---|---|---|
AA(Sonnet max,Astra xhigh) | 63.6% | 59.6% | Sonnet |
Vals AI(两边 max) | 53.03% | 57.07% | Astra,误差范围重叠 |
结论只能是这项测试没有定论。OSWorld 也一样:Anthropic 用的是 2.1 版,OpenAI 用的是 2.0 离线版,版本都不同。OpenAI 页面上引用的 AA 指数也是旧版(v4.1.1 的 61.2 分),不能和现在的 v5.0 分数混用。
第三方测试:差距集中在哪类任务
Vals AI 的对比页让两个模型都开 max,在 19 项共同测试里 Sonnet 5.5 有 13 项分数更高,Astra 6 项;其中 9 项双方 ±1 标准误差范围重叠,Vals 也注明这不是两两显著性检验。真正拉开差距的是下面几项(截至 2026 年 9 月 29 日):
| 测试 | Sonnet 5.5 | GPT-6 Astra | 差距 |
|---|---|---|---|
| Terminal-Bench Science | 38.57% | 65.71% | Astra 高 27.14 分 |
| SRE Bench | 30.15% | 56.87% | Astra 高 26.72 分 |
| IOI(信息学竞赛题) | 83.06% | 100.00% | Astra 高 16.94 分 |
| CyberBench v1.1 | 59.58% | 41.07% | Sonnet 高 18.51 分,但近半数题靠回退到 Sonnet 5 完成,见下文 |
| Tax Agent Bench | 73.39% | 63.34% | Sonnet 高 10.06 分 |
| Legal Research Bench | 48.08% | 39.42% | Sonnet 高 8.65 分 |
| Vals Index(综合) | 69.22% | 66.61% | Sonnet 高 2.61 分 |
规律比较清楚:终端里的科研流程、线上运维排障、竞赛编程,Astra 明显更强;财税代理、法律检索,Sonnet 更好。安全类测试 CyberBench 表面上 Sonnet 领先,但这个领先要打折扣,原因在下一段。
成本和耗时同样值得看。跑完 Vals Index,Sonnet 5.5 花了 $20.80、用时 1 小时 10 分,Astra 花 $19.09、用时 25 分 11 秒;Terminal-Bench 4.0 一项,Sonnet $19.33,Astra $8.21。在 max 档,Sonnet 的低单价没有换来更低的总花费,耗时还长得多。
另外,Vals 测 Sonnet 5.5 时开着服务端回退:Sonnet 5.5 拒答的题交给 Sonnet 5 作答。Vals 的 Sonnet 5.5 模型页给出了把回退完成的题算作失败后的分数:Vals Index 从 69.22% 降到 68.89%,Terminal-Bench 4.0 从 53.03% 降到 50.51%,影响不大;安全类任务就不同了,CyberBench 的 116 道题里有 54 道用了回退,分数从 59.58% 降到 41.97%,和 Astra 的 41.07% 基本持平;SRE Bench 从 30.15% 降到 19.08%,与 Astra 的差距进一步拉大。所以 Sonnet 5.5 在安全类测试上的领先,很大程度上是 Sonnet 5 替它答出来的。
按任务怎么选
| 你的情况 | 建议 | 依据 |
|---|---|---|
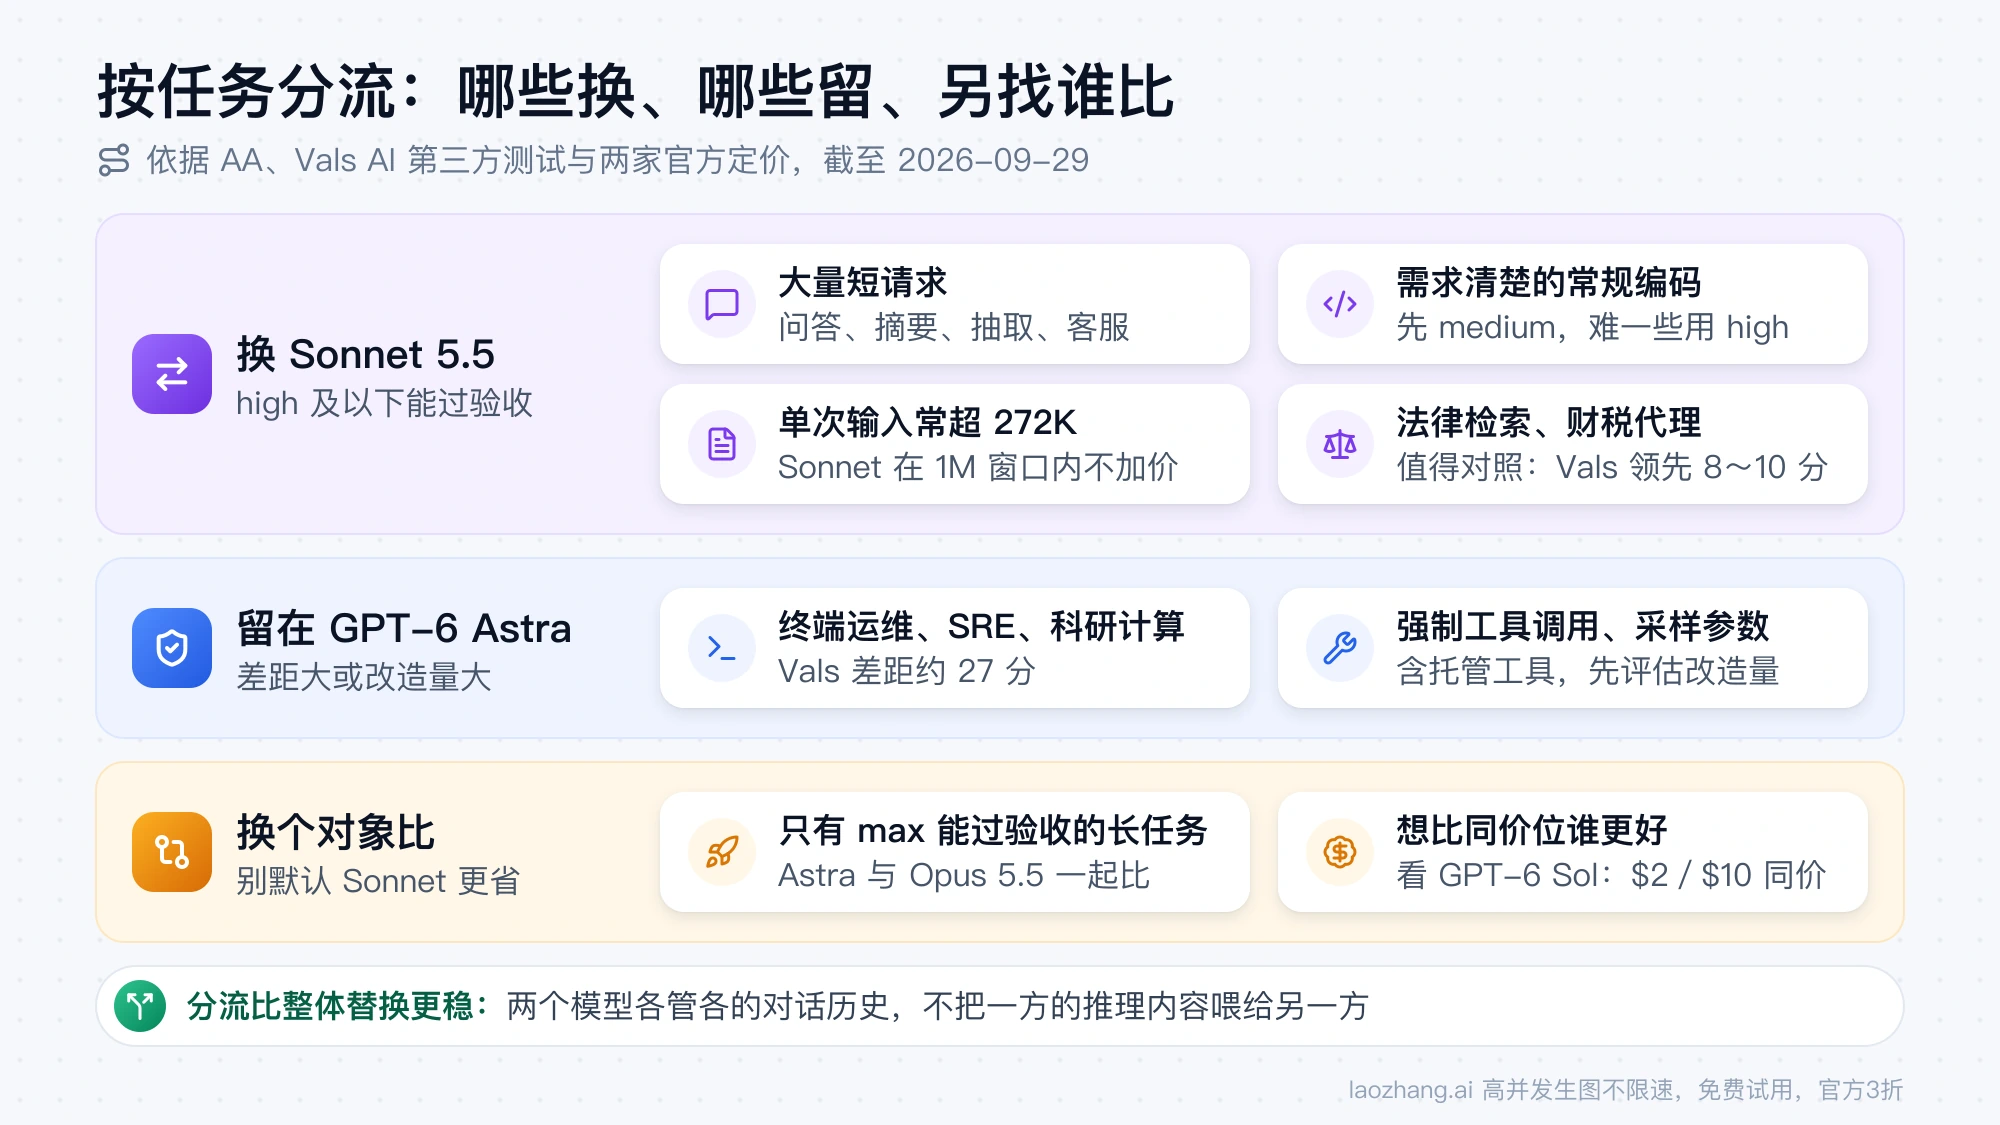
大量短请求:问答、摘要、信息抽取、客服,medium 或 high 就能达标 | 换 Sonnet 5.5 试 | 同样 token 下单价是 Astra 的五分之一;截至 2026 年 10 月 28 日,AA 测到 low 档首个答案 token 延迟 1.29 秒,Astra 为 2.71 秒 |
| 需求写得清楚的常规编码 | 先试 Sonnet 5.5 medium;难一些要开 high 时,同时比 Astra low | Anthropic 对智能体编码的建议档位;AA v5.0 里 Sonnet 这两档每任务 $0.78/$1.64,而 Astra low 为 43 分、$1.42,分数和成本都优于 Sonnet high 的 41 分 |
要开到 xhigh 或 max 才能过验收的长智能体任务 | 留在 Astra,或与 Opus 5.5 一起比 | AA v5.0 中 xhigh 55 对 50 分、$3.66 对 $4.09,max 57 对 54 分、$6.24 对 $10.02;同一指数里 Opus 5.5 max 为 58 分 |
| 终端运维、SRE 排障、科研计算流程 | 留在 Astra | Vals 里 Terminal-Bench Science、SRE Bench 差距都在 27 分左右 |
| 法律检索、财税代理类文档工作 | 值得拿 Sonnet 5.5 做对照 | Vals(max)Sonnet 领先 8~10 分 |
| 单次输入经常超过 272K token | Sonnet 的价格优势放大 | Astra 超过 272K 后整次请求按更高单价计费,Sonnet 在 1M 窗口内不加价 |
| 依赖强制工具调用、采样参数,或 Astra 的托管工具(hosted shell、图片生成等) | 先评估改造量,暂留 Astra | Sonnet 5.5 不支持强制工具调用和非默认采样参数,详见下文清单 |
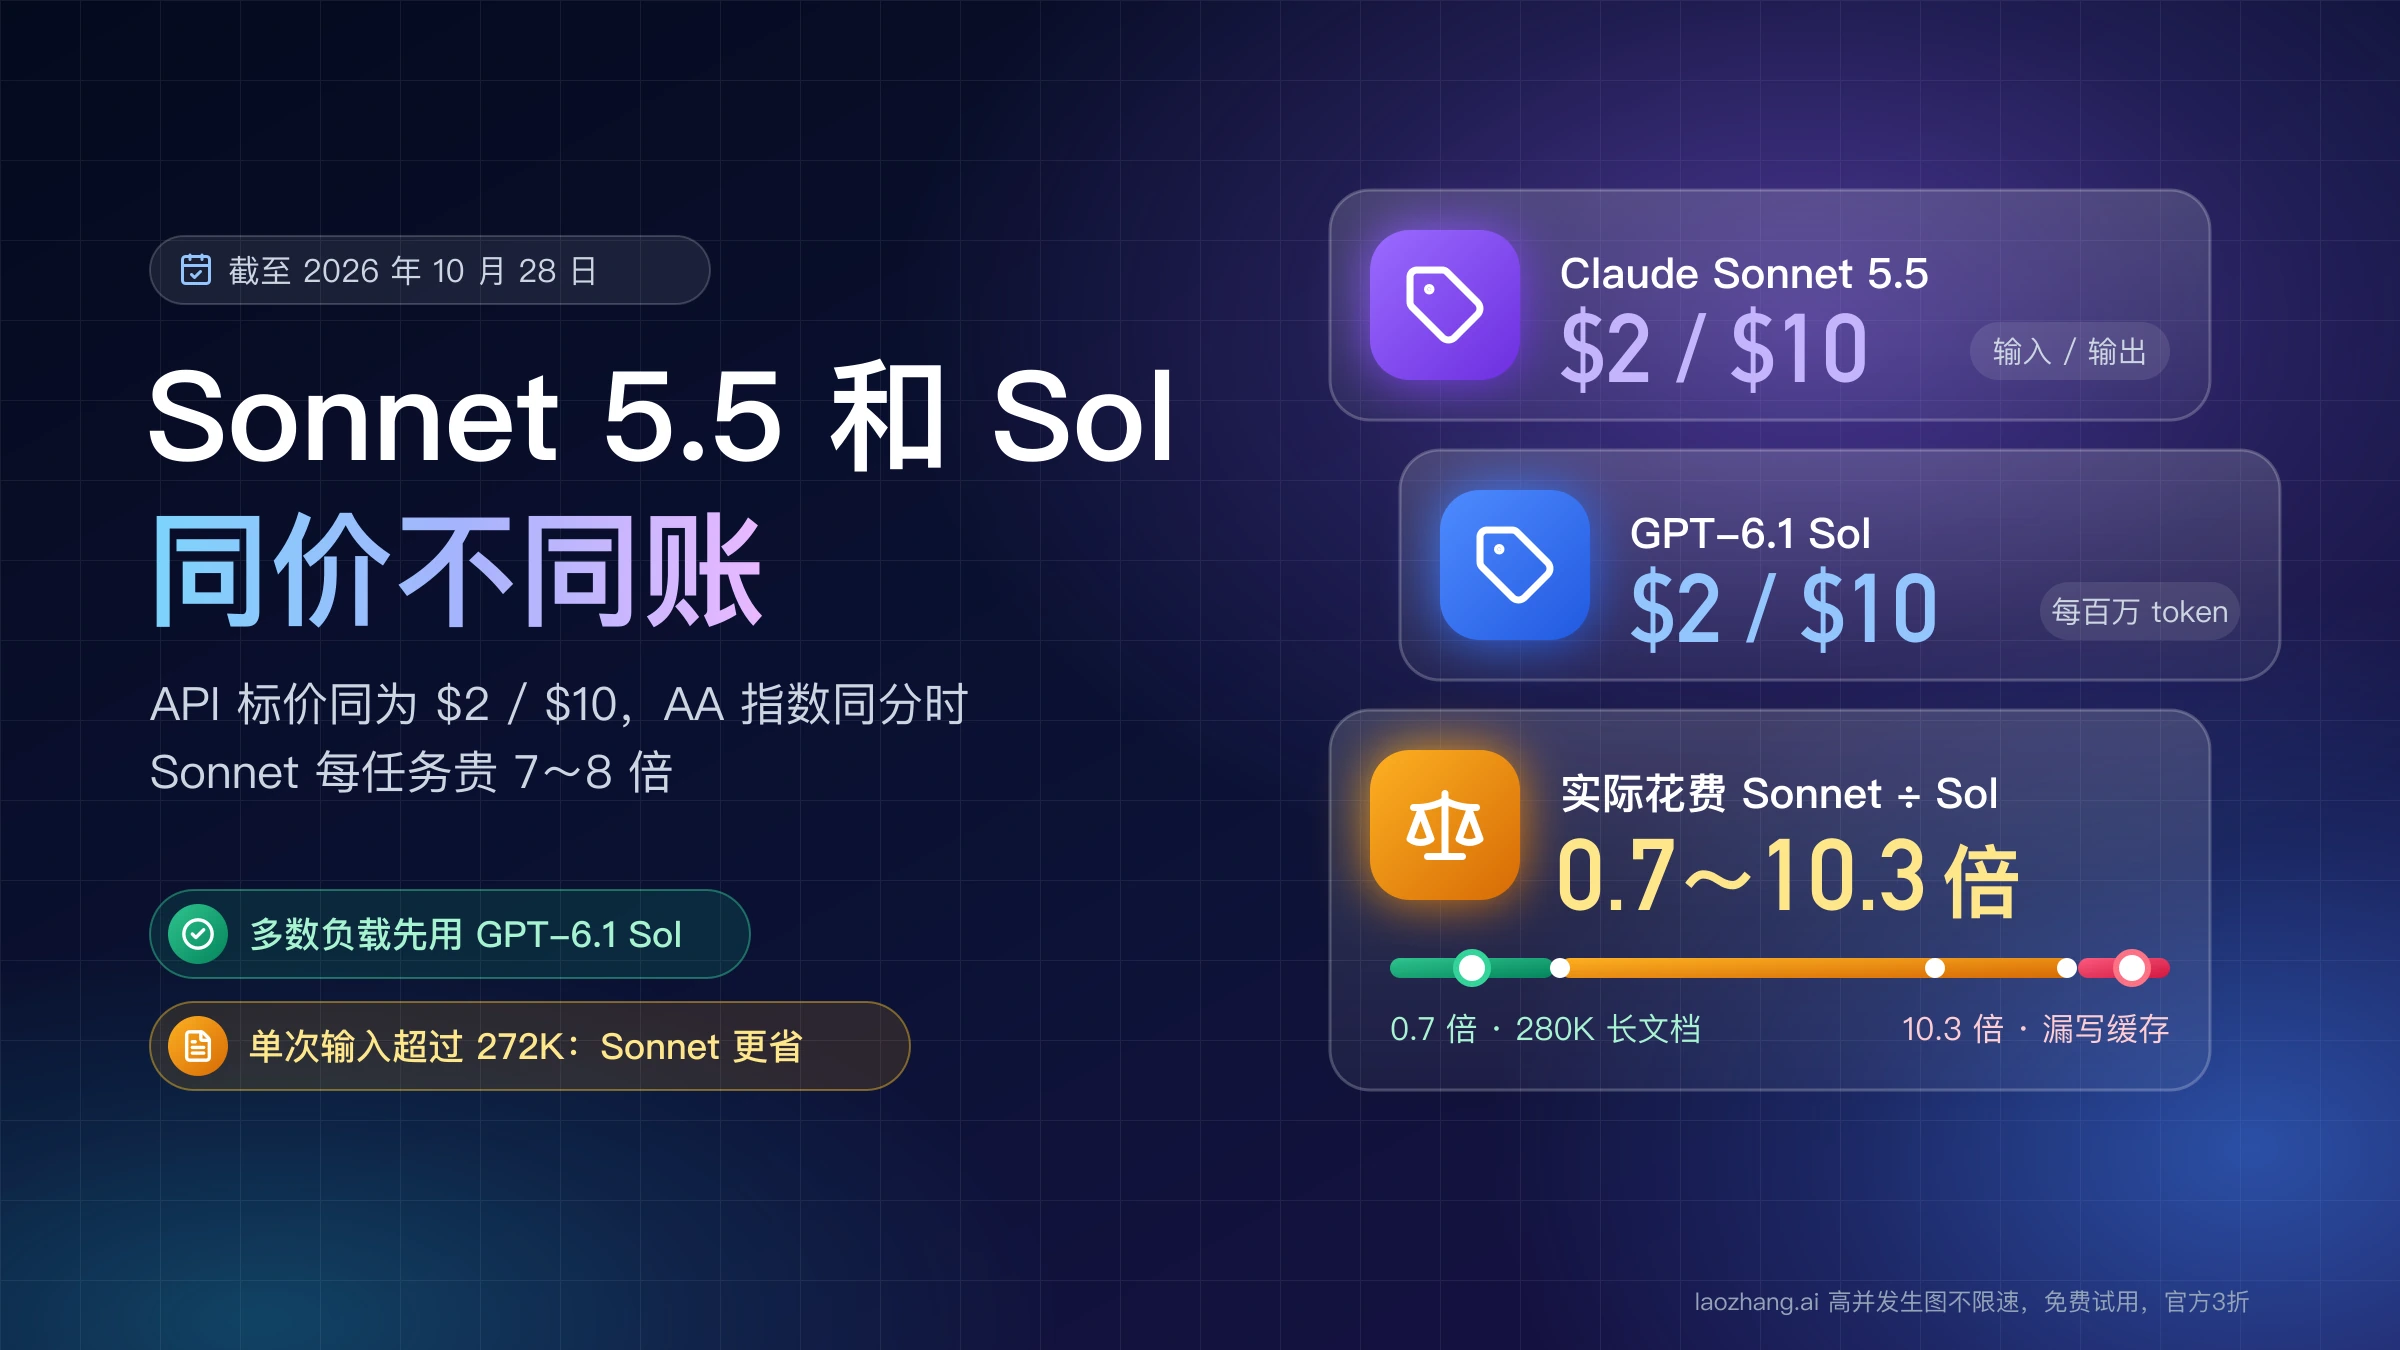
| 真正的问题是同价位谁更好 | 拿 GPT-6 Sol 比 | GPT-6 Sol 短上下文单价 $2/$10,与 Sonnet 5.5 相同;AA 9 月 29 日(旧版 v4.3.2)认为 Sonnet high 在几乎相同的每任务成本下智能指数略低于 GPT-6 Sol;v5.0 不再给 GPT-6 Sol 打分 |
按 AA v5.0,Opus 5.5 max 为 58 分、每任务 $10.04,与 Sonnet 5.5 max 成本几乎相同、高 4 分;Opus 5.5 xhigh(57 分,$6.05)则分数和成本都优于 Sonnet 5.5 max。如果你需要的正是 max 级表现,又想留在 Claude 这边,往上看 Opus 比把 Sonnet 开满更合算;Claude 内部怎么往上选(2026 年 11 月 9 日起当前的 Fable 是 Fable 5.2),可以看 Fable 5.2 和 Opus 5.5 怎么选:哪档对哪档,同题实测贵 1.86 倍。OpenAI 系列内部 Astra 和 Sol 的分工,见 GPT-6 Sol、Luna、Astra 与 Terra 怎么选?认清 6.1 Terra,再算成本;相邻的跨厂商组合,见 Claude Opus 5.5 对比 GPT-6 Sol:先看任务,再算每次合格交付的成本。
分流通常比整体替换更稳:按任务类型把短请求和 Sonnet 擅长的文档类任务路由给 Sonnet 5.5,把需要 max 或终端类的任务留给 Astra。每个模型各自维护对话历史,不要把一方的推理内容喂给另一方,原因见后面的切换清单。
价差怎么算:短请求 5 倍,超过 272K 差距更大
两家直连 API 标准价(美元/百万 token,截至 2026 年 9 月 29 日,Sonnet 5.5 缓存读取为 2026 年 10 月 7 日起的现价,见 Claude Sonnet 5.5 缓存读取价格降到 $0.10:省多少看缓存占比;来源:Anthropic 定价、OpenAI 定价):
| 计费项 | Sonnet 5.5 | GPT-6 Astra(输入 ≤272K) | GPT-6 Astra(输入 >272K) |
|---|---|---|---|
| 输入 | $2 | $10 | $20 |
| 缓存读取 | $0.10(此前 $0.20) | $1 | $2 |
| 缓存写入 | $2.50(5 分钟)/$4(1 小时) | $12.50(30 分钟)/$25(12 小时) | $25(30 分钟)/$50(12 小时) |
| 输出(含推理 token) | $10 | $50 | $75 |
其他会改变账单的规则:
- Sonnet 5.5 在整个 1M 上下文窗口内按同一单价计费,官方原话是 90 万 token 的请求和 9 千 token 的请求单价相同。Astra 输入一旦超过 272K,整次请求的输入和缓存按 2 倍、输出按 1.5 倍计费。
- 批量处理:Sonnet 5.5 Batch 为 $1/$5;Astra 的 Batch 和 Flex 都是标准价的一半。
- Astra 的 Fast 模式(原 Priority)是标准价的 2 倍,不含延迟 SLA;Sonnet 5.5 没有快速模式。
- Sonnet 5.5 指定仅在美国推理是 1.1 倍;Astra 的数据驻留或区域处理加价 10%。
单次请求费用 = 输入 token ÷ 1,000,000 × 输入单价 + 输出 token ÷ 1,000,000 × 输出单价(有缓存时,缓存读取和写入各按自己的单价另算)。假设两边 token 数完全相同、不走缓存、不用工具:
- 10 万输入 + 2 万输出:Sonnet 5.5 = 0.1 × $2 + 0.02 × $10 = $0.40;Astra = 0.1 × $10 + 0.02 × $50 = $2.00,5 倍。
- 30 万输入 + 2 万输出:Sonnet 5.5 = 0.3 × $2 + 0.02 × $10 = $0.80;Astra 超过 272K,按长上下文价 = 0.3 × $20 + 0.02 × $75 = $7.50,约 9.4 倍。这个倍数落在输入 10 倍、输出 7.5 倍之间,具体是多少取决于输入和输出的比例。
想用自己的请求形态算,可以直接改下面的数:
# 美元 / 百万 token,两家直连 API 标准价,截至 2026-10-28(Sonnet 缓存读取 10 月 7 日起为 0.10)
def sonnet_55(inp, out, cached=0, write_5m=0):
    return (inp * 2 + cached * 0.10 + write_5m * 2.50 + out * 10) / 1e6

def gpt_6_astra(inp, out, cached=0, write=0):
    # 按本次请求的全部输入 token 判断是否超过 272K,超过则整次请求用长上下文单价
    long_ctx = inp + cached + write > 272_000
    p_in, p_cached, p_write, p_out = (20, 2, 25, 75) if long_ctx else (10, 1, 12.50, 50)
    return (inp * p_in + cached * p_cached + write * p_write + out * p_out) / 1e6

print(sonnet_55(100_000, 20_000), gpt_6_astra(100_000, 20_000))  # 0.4 2.0
print(sonnet_55(300_000, 20_000), gpt_6_astra(300_000, 20_000))  # 0.8 7.5
这只是 token 数相同时的算术,不是真实账单。实际任务里两家分词器不同,同一段文字计出的 token 数不一样;推理 token 的多少随档位变化很大(前面旧版数据里 max 档的 7 倍就是例子);失败重试也要花钱。Astra 更完整的计费细节见 GPT-6 Astra API 定价与成本计算:价格表、272K 与两档缓存写入;Sonnet 档的预算对账可以参考(Sonnet 5.5 的输入、输出与 Sonnet 5 同价,缓存读取自 10 月 7 日起是 $0.10,比 Sonnet 5 的 $0.20 低一半) Claude Sonnet 5 取消涨价:现行 API 价格与预算重算。
用小测试算每个合格结果的成本
单价和第三方指数都替代不了你自己的任务。更贴近真实花费的口径是“每个合格结果的成本”:一批任务的总计费,除以其中通过你验收标准的任务数。它把失败、重试和额外 token 都算进去,比每百万 token 单价更接近你真正付出的钱。
- 挑 20~50 个真实任务,每个写好验收标准,比如测试通过、字段全对、审阅人签字。
- 两边用同样的输入、同样的工具,固定一组推理强度。可以先比 Sonnet
high对 Astramedium和high,再各升一档比一次。 - 每次请求记下响应里的计费用量:输入、缓存读取、缓存写入、输出(含推理 token),再加上重试次数、耗时和人工修补时间。
- 每个合格结果的成本 = 总计费 ÷ 通过验收的任务数。人工修补时间单独记,必要时按你的人力成本折算进去。
- 只有 Sonnet 5.5 在同样的验收标准下过线,而且每个合格结果的成本更低,才切流量。合格率低的话,便宜的单价很快会被重试和返工吃掉。
如果你的请求大量复用长系统提示或文档,测试时按线上真实的缓存命中情况跑,缓存读取 Sonnet 5.5 只收输入价的 5%($0.10),Astra 收十分之一,对结果影响很大。
从 Astra 切到 Sonnet 5.5,哪些地方会坏
这是一次跨厂商迁移,不是改个型号 ID。下面这些要在切流量之前处理:
- 接口不同:Astra 走 OpenAI 的 Responses 或 Chat Completions(工具调用必须用 Responses),Sonnet 5.5 走 Anthropic Messages。工具定义、流式事件、用量字段都要改。两个模型都能在 Amazon Bedrock 上用,可以少管一个厂商账号,但接口差异还在。
- 采样参数:Sonnet 5.5 上把
temperature、top_p、top_k设成非默认值会返回 400。Astra 本来就要求去掉temperature和top_p,所以在 Astra 上跑通的请求这一点通常不用再改。 - 强制工具调用:
tool_choice设为any或tool会返回 400。改用auto并给工具加strict: true,同时在提示里写清什么情况下调用哪个工具。 - 预填充:在 assistant 消息里预先写开头的做法会返回 400。
- 关闭思考:
thinking: {"type": "disabled"}和手动budget_tokens都返回 400。最低一档是thinking: {"type": "between_tools"},只能配low、medium、high,在xhigh、max下会报 400。 - 工具调用之间的文字:较长的进度说明现在以
thinking块返回,默认display: "omitted"时内容为空。请求不会失败,但把这段文字流给用户看的界面会突然没有输出。需要显示就改display,或用between_tools。 - 推理块绑定模型和对话:Sonnet 5.5 产生的 thinking 块别的模型读不了;改过前面的历史再回放,2026 年 8 月 31 日及之后创建的账号默认返回 400。分流时每个模型各管各的历史。
- 缓存机制:Anthropic 需要显式写缓存(5 分钟或 1 小时两种价格),最小可缓存提示为 512 token;Astra 有
"30m"(默认)和"12h"两种缓存保留选项,后者是 2026 年 10 月 20 日加入的,只在 Responses API 可用,写入价是输入价的 2.5 倍。命中率假设要按新机制重算。 - 电脑操作工具:在 Claude API 和 Google Cloud 上必须用
computer_toolset_20260801,旧的computer_20251124会被拒绝。 - 内容回退:Sonnet 5.5 判定涉及网络安全或前沿大模型相关内容时,Claude 应用可能把对话切到 Sonnet 5,生物类和模型蒸馏类请求直接拒绝;API 侧新增的拒绝类别通过
stop_details返回。做安全研究的团队要把这点算进验收:前面 Vals 的 CyberBench 里,近半数题就是由 Sonnet 5 回退作答的。
如果你手里已有为 Sonnet 5 写的代码,想顺手升到 5.5,Anthropic 迁移指南列出的五项破坏性变更就是上面的关闭思考、强制工具调用、推理块绑定、电脑操作工具四项,外加一项:advisor 工具不再接受 Opus 4.8、Opus 4.7 和 Sonnet 5 作为顾问模型。
两家官方接口在国内直连都有门槛。接入路线可以参考 Claude 稳定接入怎么选:Anthropic 直连、云平台,还是 laozhang.ai 网关?,Astra 的开通条件和首次调用见 GPT-6 Astra API 怎么开通?访问条件、首次调用与报错排查。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
用订阅而不是 API 的话
API 单价换算不出订阅额度,两件事分开看。
ChatGPT 里,由 Astra 驱动的 GPT-6 Pro 只在 Pro($100 和 $200 两档)、Business 和 Enterprise 的对话中提供;Plus 可以在 ChatGPT Work 和 Codex 里用 Astra,但对话里没有 GPT-6 Pro;Free 和 Go 用不到 Astra。Codex 里 Astra 的用量按每 5 小时估算的本地消息数公布,Plus 约 5~45 条,OpenAI 说明这不是固定上限(OpenAI 帮助中心)。
Claude 这边,Sonnet 5.5 已出现在网页端、移动端、桌面端、Cowork 和 Claude Code 中,应用里默认推理强度是 medium。哪些套餐包含 Sonnet 5.5,Anthropic 的公开页面没有写明,以你账户里模型菜单的实际显示为准。
常见问题
Sonnet 5.5 真的比 GPT-6 Astra 强吗?
在 AA 现行的 v5.0 智能指数里不强:截至 2026 年 10 月 28 日,五个推理档都是 Astra 更高,max 57 比 54,xhigh 55 比 50;旧版 v4.3.2 里 Sonnet 在 max 高 3 分的结论已不成立。Sonnet 的长处是 high 及以下每任务更便宜、输出更快。Vals 的 19 项测试里 Sonnet 13 项更高,但终端科研和 SRE 类任务 Astra 领先 27 分左右。按任务类型判断比看总分可靠。
GPT-6 Astra 真的比 Sonnet 5.5 贵 5 倍吗?
按每百万 token 标价,短请求各项都是 5 倍;输入超过 272K 后,输入单价变成 10 倍、输出单价变成 7.5 倍,整次请求的实际倍数落在两者之间,比如 30 万输入加 2 万输出的算例约为 9.4 倍。但按完成一个任务算,结果取决于档位:AA v5.0 的 max 档里 Sonnet 每任务 $10.02,Astra $6.24,贵的反而是 Sonnet,xhigh 也是 Sonnet 稍贵($4.09 对 $3.66)。
和 Sonnet 5.5 同价的 OpenAI 模型是哪个?
GPT-6 Sol。它的短上下文标准价是输入 $2、输出 $10,与 Sonnet 5.5 相同,Anthropic 发布页的对比表比的也是 GPT-6 Sol。注意别和上一代 GPT-5.6 Sol 混淆。
参考来源10
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月10日。
参考来源10
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月10日。
- 1.逐档比较页artificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-gpt-6-astra
- 2.Anthropic 发布页anthropic.com/claude-sonnet-5-5
- 3.OpenAI 推理文档developers.openai.com/api/docs/guides/reasoning
- 4.OpenAI 的 Astra 发布页openai.com/index/gpt-6-astra
- 5.Vals AI 的对比页vals.ai/comparisons/anthropic_claude-sonnet-5-5-vs-openai_gpt-6-astra
- 6.Vals 的 Sonnet 5.5 模型页vals.ai/models/anthropic_claude-sonnet-5-5
- 7.Anthropic 定价platform.claude.com/docs/en/about-claude/pricing
- 8.OpenAI 定价developers.openai.com/api/docs/pricing
- 9.Anthropic 迁移指南platform.claude.com/docs/en/models/sonnet-5-5/migration-guide
- 10.OpenAI 帮助中心help.openai.com/en/articles/20001516-managing-usage-with-gpt-6-astra-in-work-and-codex