GPT-6 Astra API 定价与成本计算:价格表、272K 长上下文、缓存与服务档位
一份可以直接代入 token 用量的 GPT-6 Astra 成本账:先验证项目访问,再计算短上下文、缓存、长上下文和不同处理档位,最后换算每个完成任务的真实成本。
文章目录
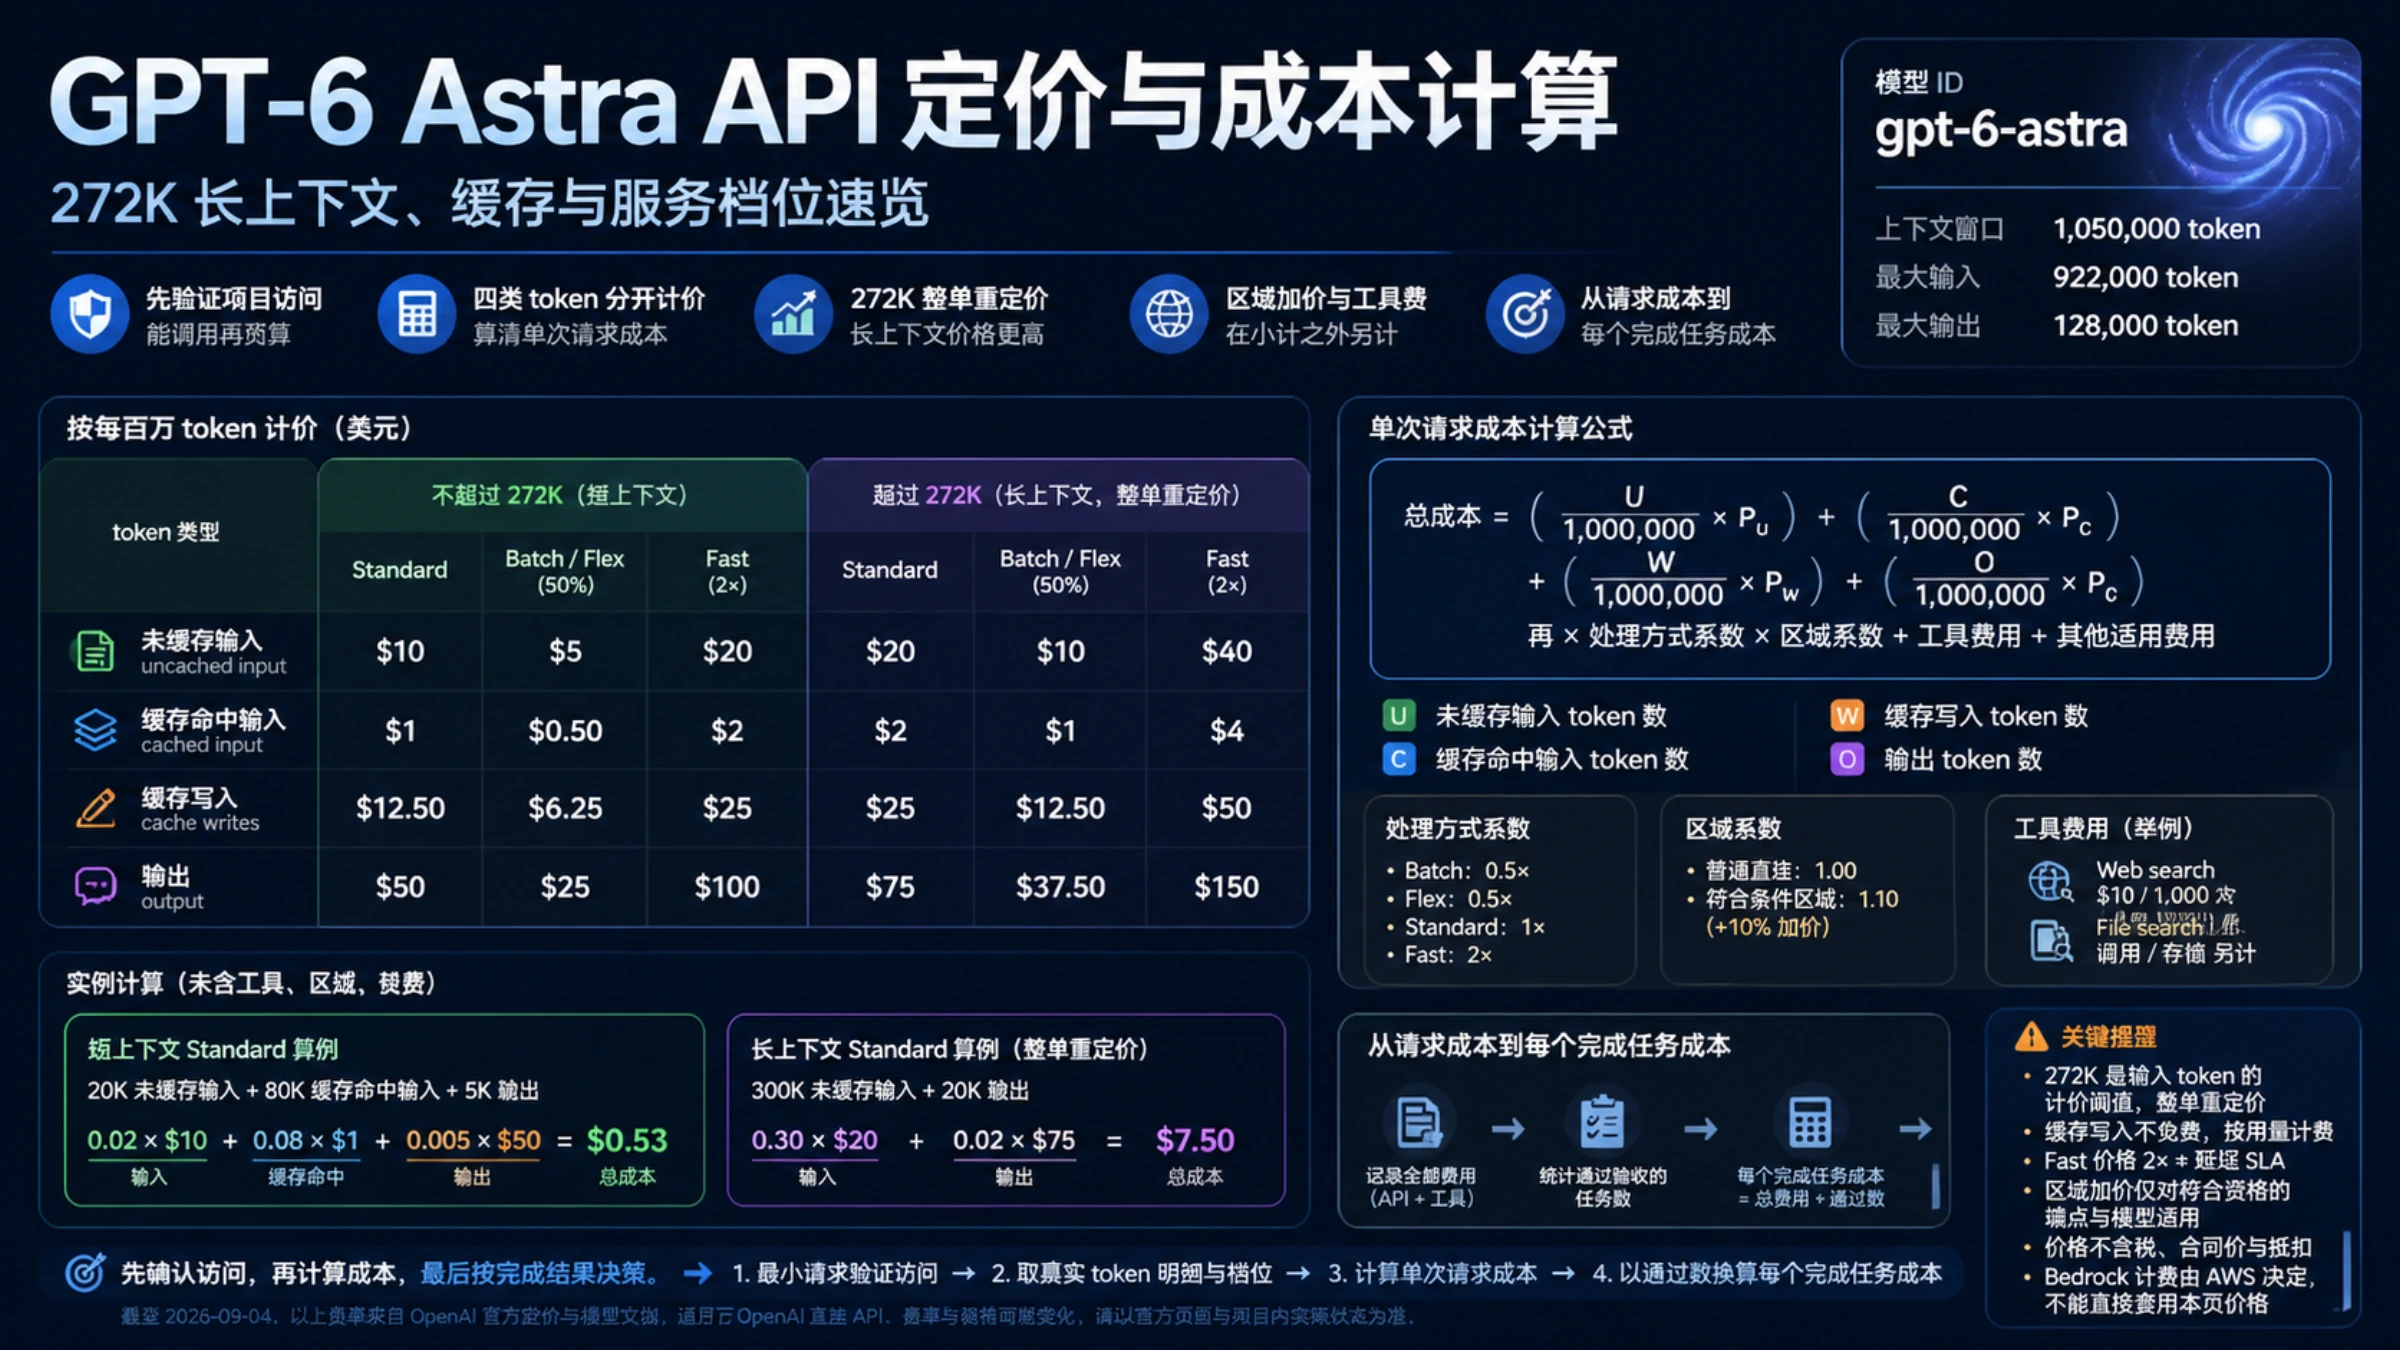
截至 2026 年 9 月 4 日(10 月 15 日复核,费率未变),OpenAI 直连 API 对 gpt-6-astra 给出的 Standard 短上下文单价是:每百万 token 输入 $10、缓存命中输入 $1、缓存写入 $12.50、输出 $50。但这四个数字只适用于单次请求输入不超过 272K token 的情况;一旦超过阈值,整笔请求都会切换到长上下文费率,而不是只给超出的部分加价。OpenAI 模型页与官方定价页列出了当前费率和适用条件。
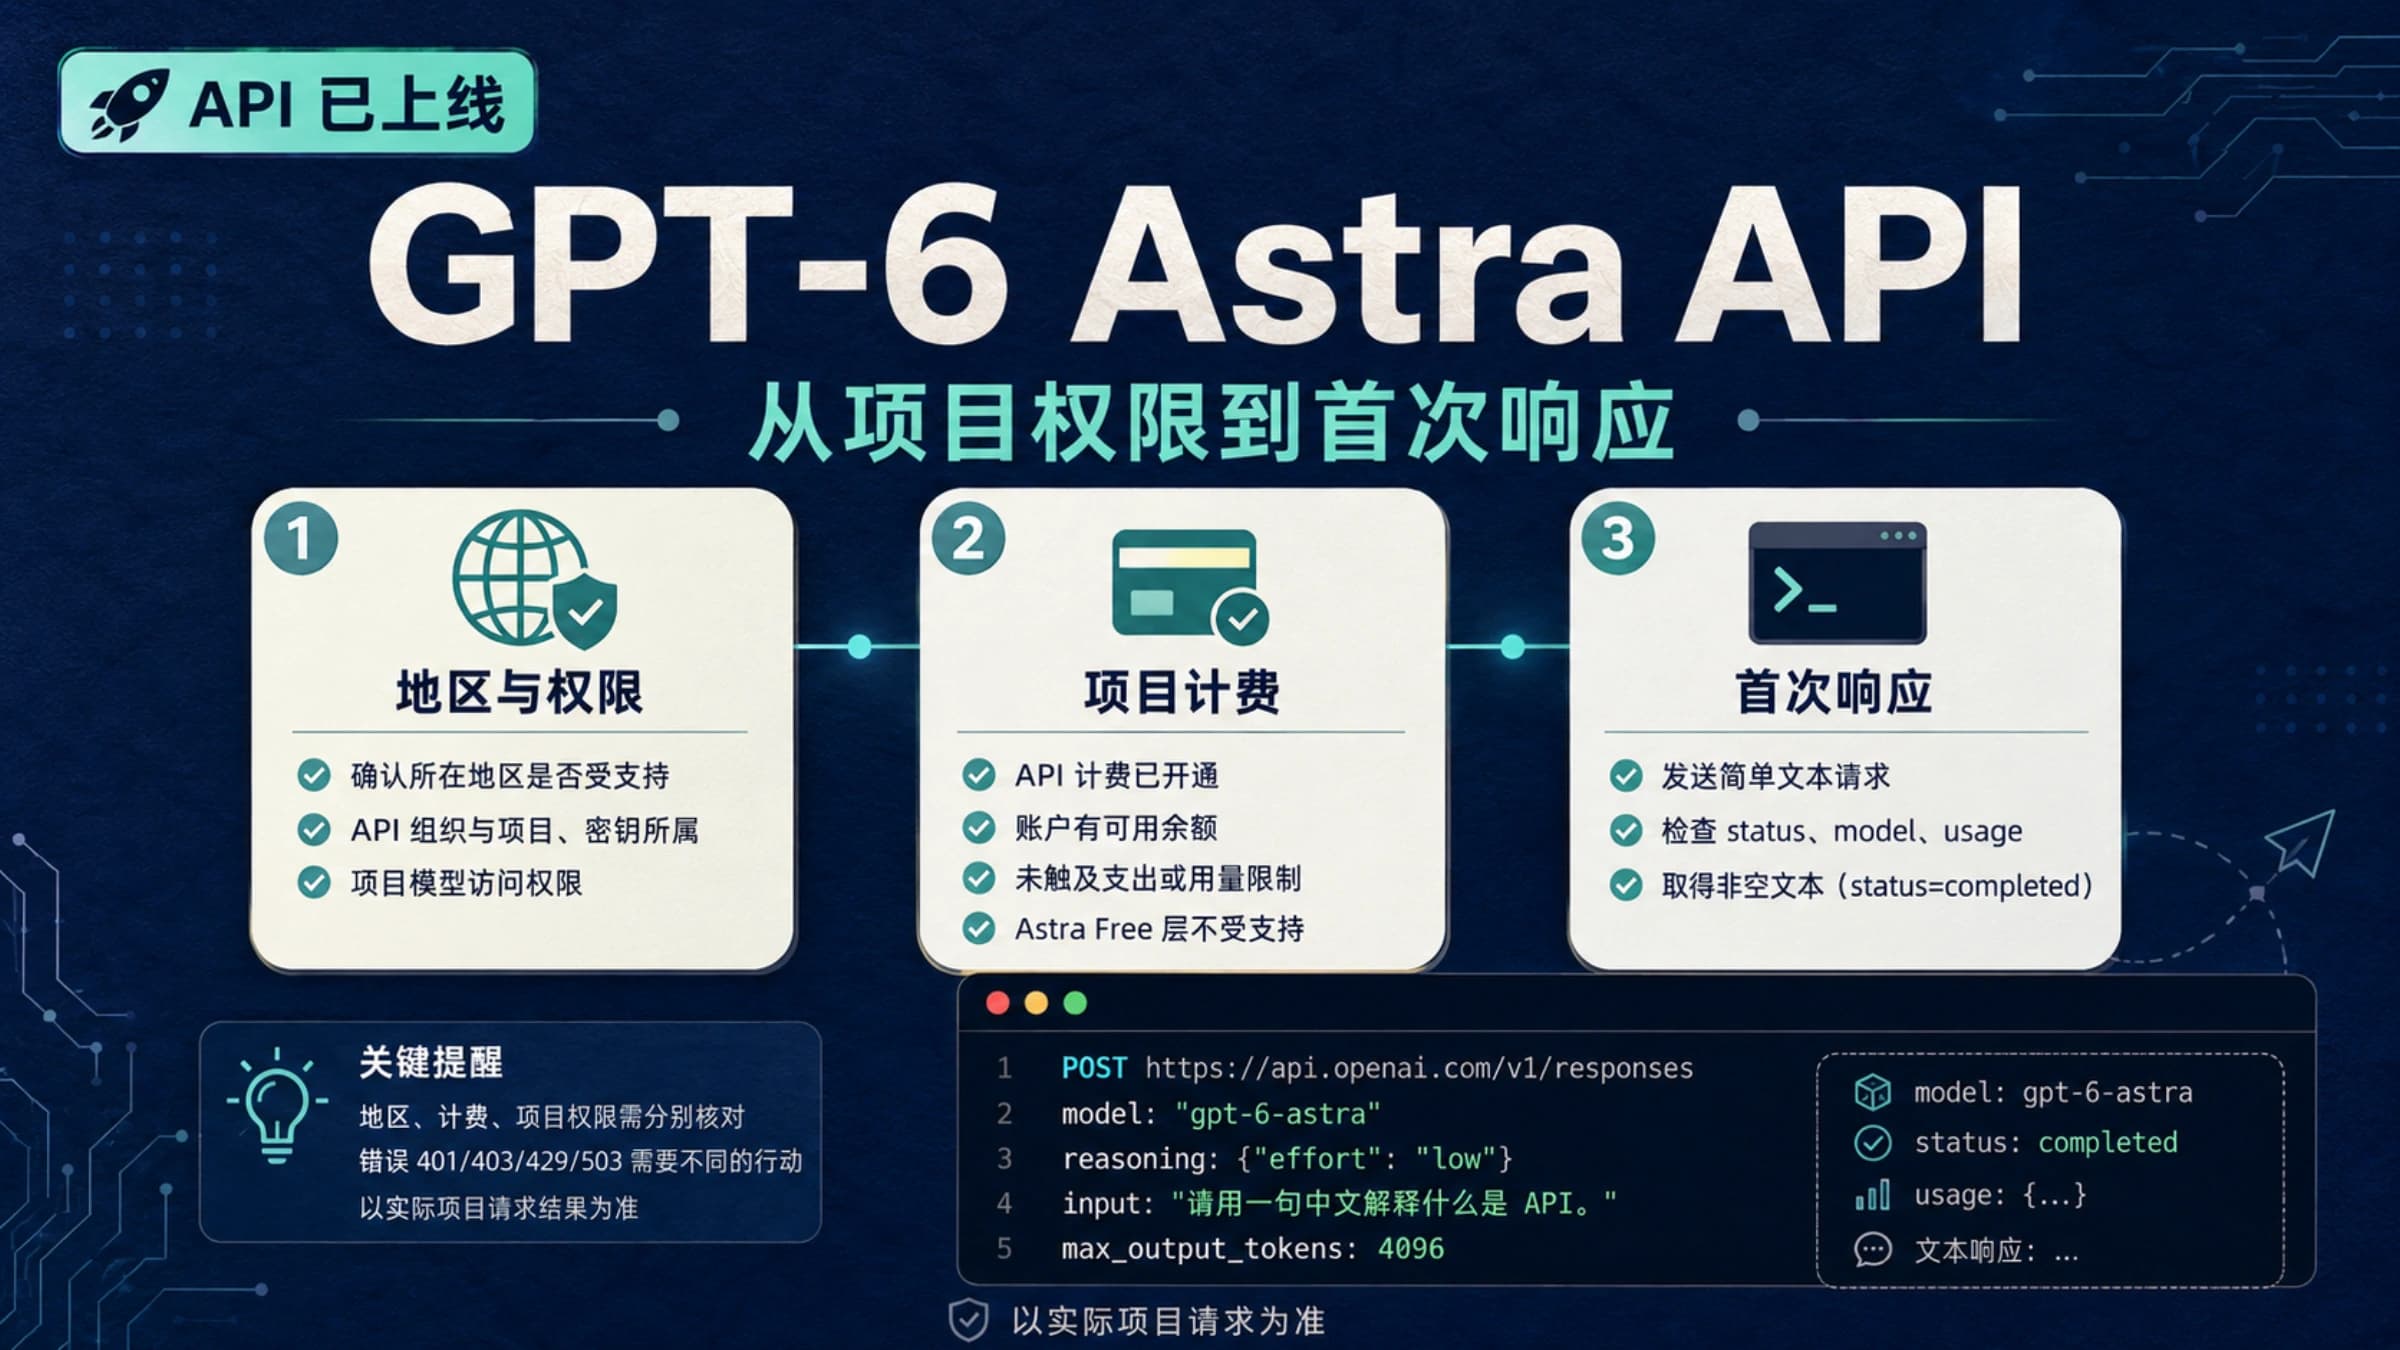
价格表存在也不等于你的项目已经获得访问。OpenAI 对 Astra 采用分阶段开放,发布公告提到先向有限组织开放,再逐步扩大范围。因此,预算之前需要做两件独立的事:用自己的项目发起最小调用确认访问,再根据真实用量计算费用。
先用自己的项目确认 API 访问
官方模型 ID 是 gpt-6-astra。下面的最小 Responses API 请求不加入工具,也不设置服务档位,目的是把“项目能否调用”与“复杂工作流是否正确”分开:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-astra",
    "input": "只回复 OK",
    "reasoning": {"effort": "low"}
}'请求成功,只能证明这个项目在这个时间点可以使用该模型;请求失败也不能据此推断所有账户的状态。当前最新模型指南要求迁移时注意以下兼容性边界:
- 工具调用应使用 Responses API;
reasoning.effort可用范围是 low 到 max,不支持 none;- 不要沿用不受支持的
temperature、top_p或logprob参数; - 从 GPT-5.5 或更早模型迁移缓存时,按指南处理
prompt_cache_options.ttl: "30m"。
模型页目前还把 Free 标为不支持,并说明速率限制取决于账户层级。这里不展开 RPM 或 TPM,因为项目能调用、请求能否通过以及并发上限是不同问题,应以你的项目实际返回和控制台为准。
四类 token 要分开计价
直连 API 的美元费率按每百万 token 计算:
| 单次请求的输入规模 | 未缓存输入 | 缓存命中输入 | 缓存写入 | 输出 |
|---|---|---|---|---|
| 不超过 272K | $10 | $1 | $12.50 | $50 |
| 超过 272K | $20 | $2 | $25 | $75 |
把一笔请求的计费量记为:未缓存输入 U、缓存命中输入 C、缓存写入 W、输出 O。先选中正确的短/长上下文费率,再计算:
token 小计 = U / 1,000,000 × 输入费率
           + C / 1,000,000 × 缓存命中费率
           + W / 1,000,000 × 缓存写入费率
           + O / 1,000,000 × 输出费率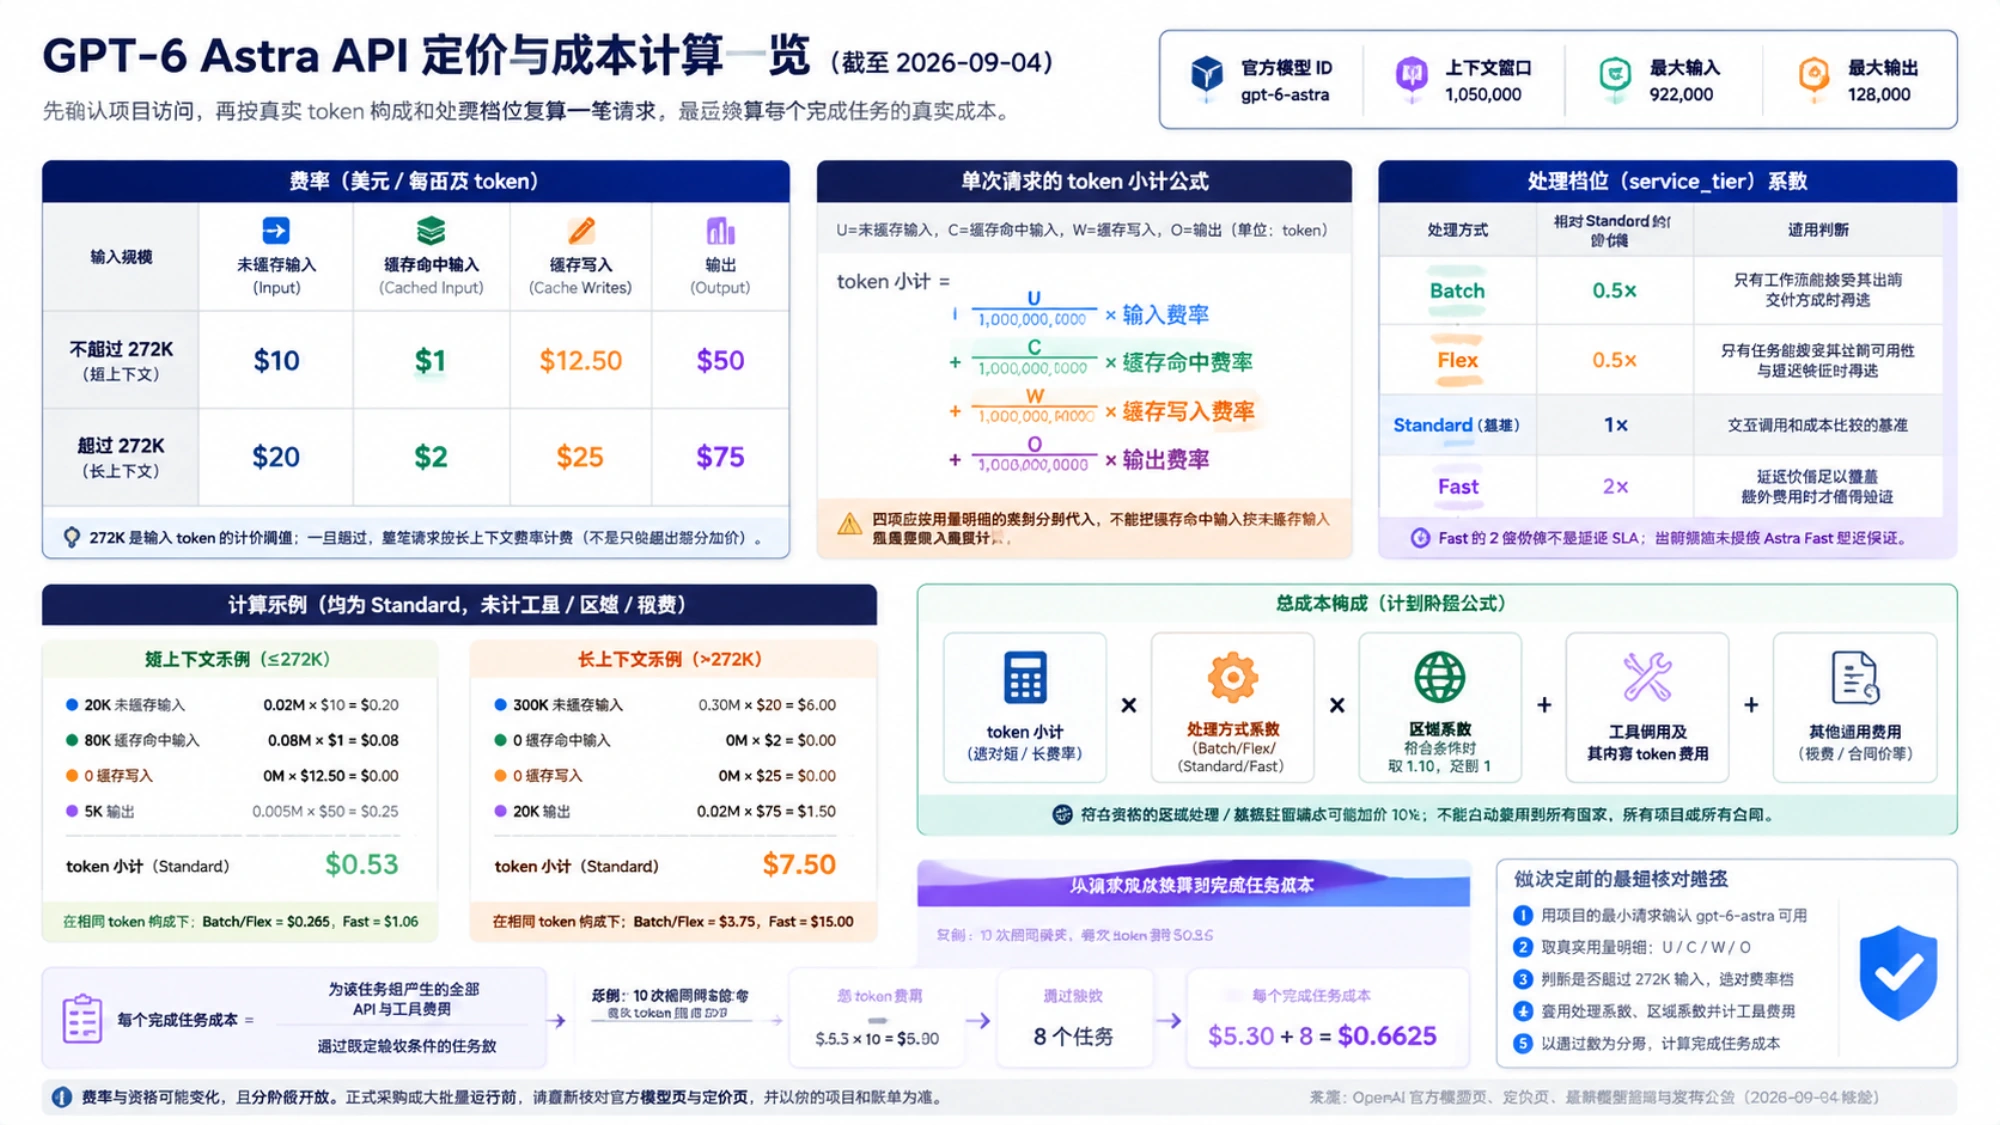
这四项应按用量明细的类别分别代入,不能把缓存命中输入仍按未缓存输入重复计算。缓存写入也不是免费动作:例如短上下文 Standard 中若账单记录 40K 缓存写入,仅这一项就是 40,000 / 1,000,000 × $12.50 = $0.50;若该请求进入长上下文档,则同样的 40K 写入为 $1.00。判断缓存是否省钱,应看后续真实命中量和写入量,而不是只看 $1 的缓存命中单价。
短上下文算例:$0.53 是怎样得到的
假设一笔 Standard 请求包含:
- 20K 未缓存输入;
- 80K 缓存命中输入;
- 0 缓存写入;
- 5K 输出。
计算结果为:
输入       0.02 × $10 = $0.20
缓存命中   0.08 ×  $1 = $0.08
输出      0.005 × $50 = $0.25
合计                     $0.53
这个结果还没有加入工具调用、区域加价、税费或合同价格。若你的系统只记录“总输入”,却没有区分未缓存、命中和写入,就无法可靠复算缓存收益。
超过 272K,涨价作用于整笔请求
272K 是价格阈值,不是上下文容量上限。官方模型页列出的上下文窗口是 1,050,000 token,最大输入为 922,000,最大输出为 128,000;但单次请求的输入只要超过 272K,输入和缓存相关费率变为 2 倍,输出费率变为 1.5 倍。
例如,300K 未缓存输入加 20K 输出的 Standard 请求已经进入长上下文档:
输入    0.30 × $20 = $6.00
输出    0.02 × $75 = $1.50
合计                   $7.50
不能先按短上下文计算前 272K,再只给余下 28K 加价。若误用短上下文单价,这个例子会算成 $4.00,与当前官方整单重定价规则相差 $3.50。做预算时应以单次请求的实际输入 token 判断档位,而不是用文档字符数或整个批次的总 token 代替。
Batch、Flex、Standard 与 Fast 怎么放进公式
在确定短/长上下文费率并算出 token 小计后,再应用当前处理方式的系数:
| 处理方式 | 相对 Standard 的价格 | 更适合怎样判断 |
|---|---|---|
| Batch | 0.5× | 只有工作流能接受其当前交付方式时再选 |
| Flex | 0.5× | 只有任务能接受其当前可用性与延迟特征时再选 |
| Standard | 1× | 作为交互调用和成本比较的基准 |
| Fast | 2× | 延迟价值足以覆盖额外费用时才值得验证 |
| Ultrafast | 6× | 只有延迟收益足以覆盖六倍费用、且项目确实开放该档位时才验证 |
因此,前面的 $0.53 短上下文请求,在 token 构成不变时,Batch 或 Flex 的 token 费用为 $0.265,Fast 为 $1.06。$7.50 的长上下文请求则分别是 $3.75 和 $15.00。
Ultrafast 是 10 月 15 日复核时定价页单独列出的档位:Astra 短上下文为每百万 token 输入 $60、缓存命中 $6、缓存写入 $75、输出 $300,长上下文为 $120、$12、$150、$450,正好是 Standard 的 6 倍。同样两笔请求按 Ultrafast 计算,分别是 $3.18 和 $45.00。
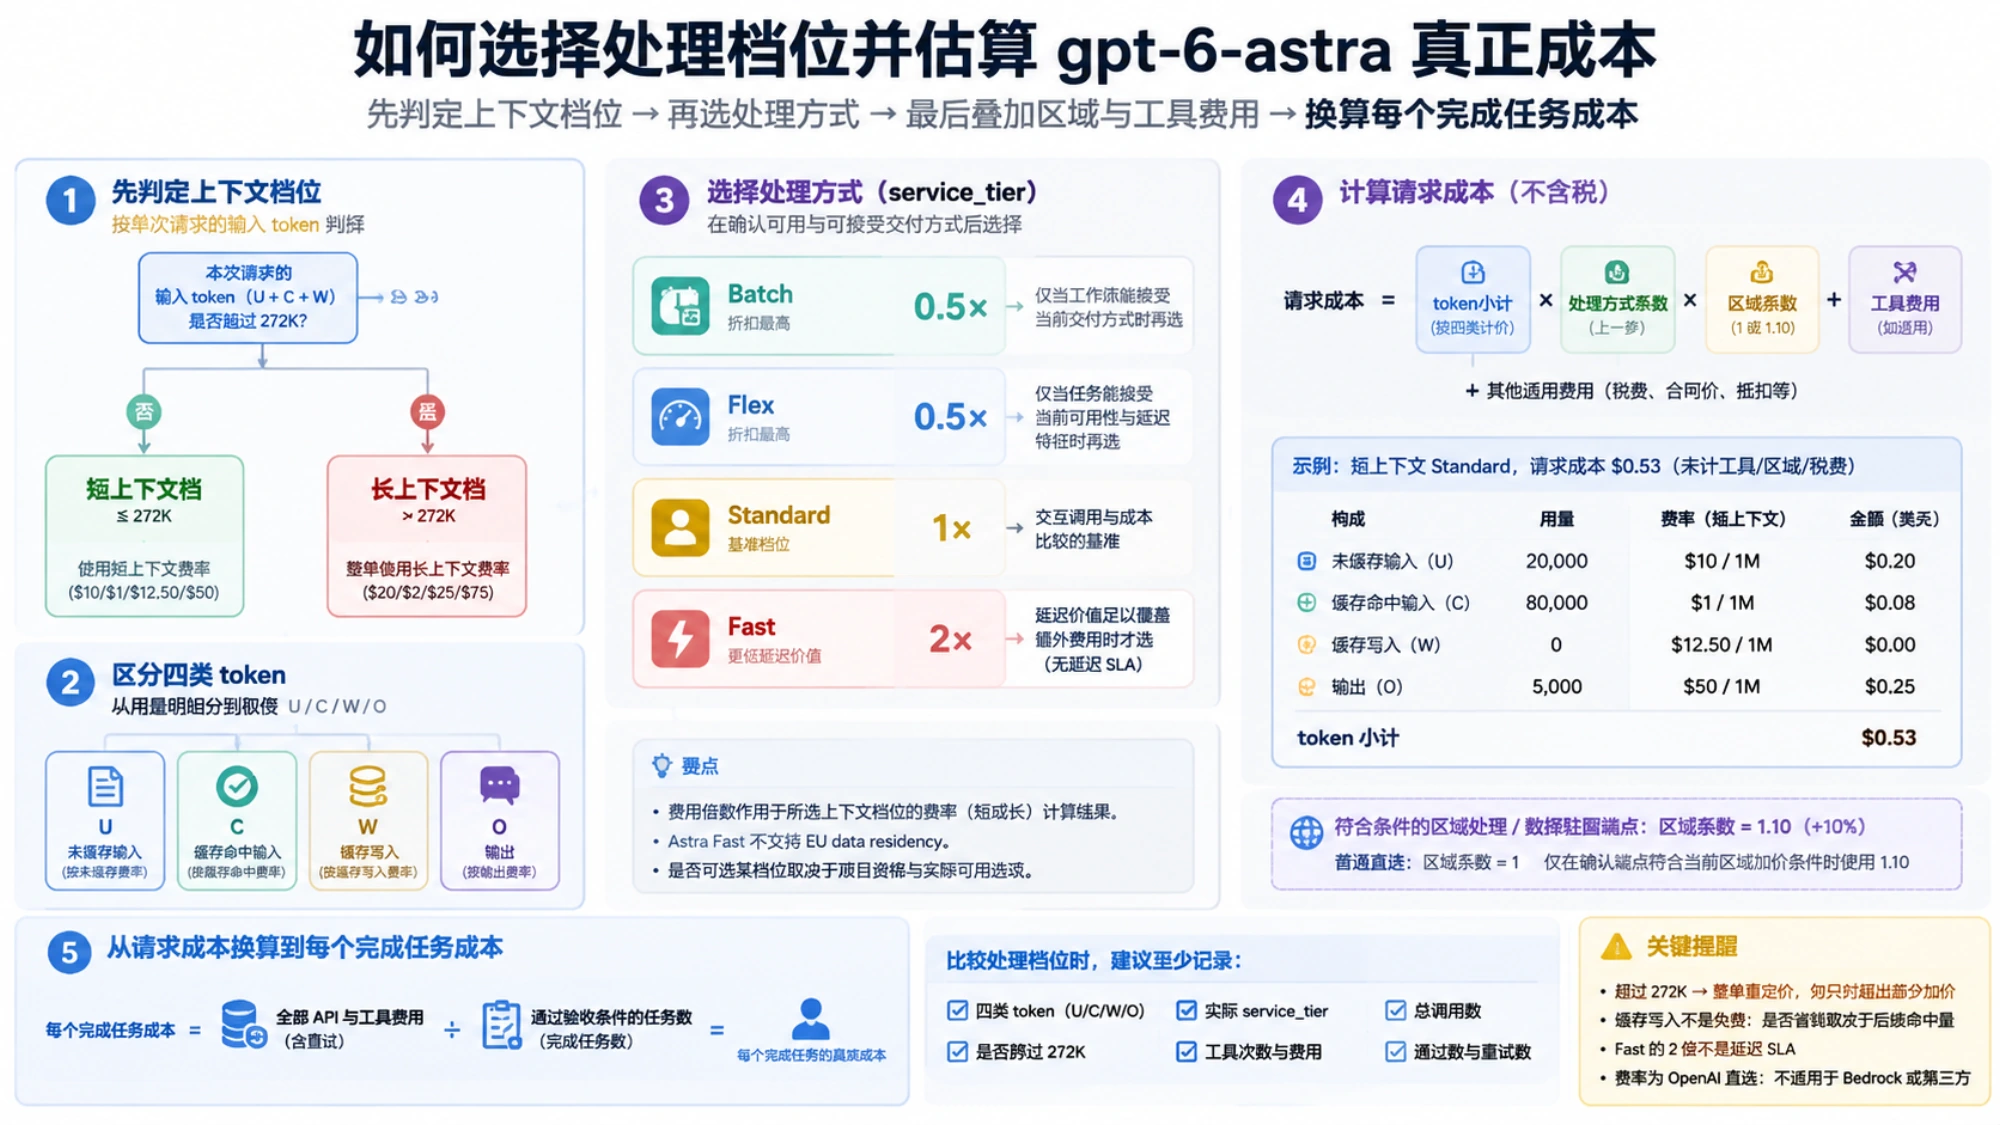
Fast 收取 2 倍费用,并不代表提供响应时间保证。官方最新模型指南目前没有给 Astra Fast 提供延迟保证,而且 Astra Fast 不支持欧盟数据驻留。是否可选某一处理方式仍取决于项目资格;实现时应核对调用配置中的 service_tier 与实际可用选项,不要仅凭价格表假设已经开通。
区域、工具和税费要在 token 小计之外处理
如果项目使用符合条件的区域处理或数据驻留端点,当前官方规则对符合资格且在 2026 年 3 月 5 日之后发布的模型加价 10%。计划阶段可以把直连 API 成本写成:
预计请求成本 = token 小计 × 处理方式系数 × 区域系数
             + 工具调用及尚未计入 token 小计的工具内容费用
             + 其他适用费用
普通直连场景的区域系数为 1;只有确认端点符合当前区域加价条件时才使用 1.10。以 $0.53 的 Standard 请求为例,符合条件的区域处理估算为 $0.583,仍未计税。不要把 10% 自动套到所有国家、所有项目或所有合同上。
API 端点本身没有独立“接口调用费”,但请求使用的托管工具可能另行计价。OpenAI 定价页当前列出的 web search 费用是每 1,000 次 $10,另收搜索内容 token 的模型费用;file search 的调用与存储、托管容器也有各自费用。只有请求实际用了某项工具才把它加入账单,不能给所有 Astra 调用统一附加工具费。
本文费率只对应 OpenAI 直连 API。Amazon Bedrock 的计费由 AWS 决定,第三方转发也可能有不同的单价、充值、汇率或失败结算规则,不能把这里的数字直接套用。税费、优惠额度和企业合同价同样需要从实际账单或合同补入。
从请求成本换算到完成任务成本
单次请求便宜,不代表一个可交付结果便宜。生产预算更有用的口径是:
每个完成任务成本 = 为该任务组产生的全部 API 与工具费用
                   / 通过既定验收条件的任务数
例如,10 次相同 token 构成的 Standard 短请求,每次 $0.53,总 token 费用是 $5.30。如果只有 8 个结果通过你的格式、事实或质量验收,那么每个完成任务的 token 成本是 $5.30 / 8 = $0.6625,而不是 $0.53。若其余两次还要重试,应继续把重试请求及工具费用加到分子里。
比较处理档位时,使用同一批任务、同一验收标准,至少记录以下数据:每次调用的四类 token、是否跨过 272K、实际 service_tier、工具次数与费用、总调用数、通过数和重试数。这样才能判断 Batch/Flex 的折扣是否值得等待,或 Fast 的额外成本是否真的降低了每个完成任务的总成本。公开价格本身不能证明某个档位会提高质量、减少重试或一定更快。
搜“GPT-6 价格”时,先分清订阅、Sol 和 Luna
本文的价格表只对应 API。搜索“GPT-6 价格”时常把下面三件事混在一起:
- ChatGPT 订阅不包含 API 额度。OpenAI 说明 ChatGPT 与 API 使用不同的账单系统,Plus 或 Pro 的月费不会抵扣 API 用量,API 充值也不会带来订阅权益。
- 在 ChatGPT 里用 Astra,消耗的是套餐额度,不按每百万 token 计价。截至 10 月 15 日,OpenAI 帮助中心写明:Pro $100、Pro $200、Business 和 Enterprise 可以在 Chat 中使用由 GPT-6 Astra 驱动的 GPT-6 Pro;Plus 只能在 ChatGPT Work 和 Codex 中使用 Astra。订阅和 API 怎么选,可以看 ChatGPT Plus 和 API 哪个划算。
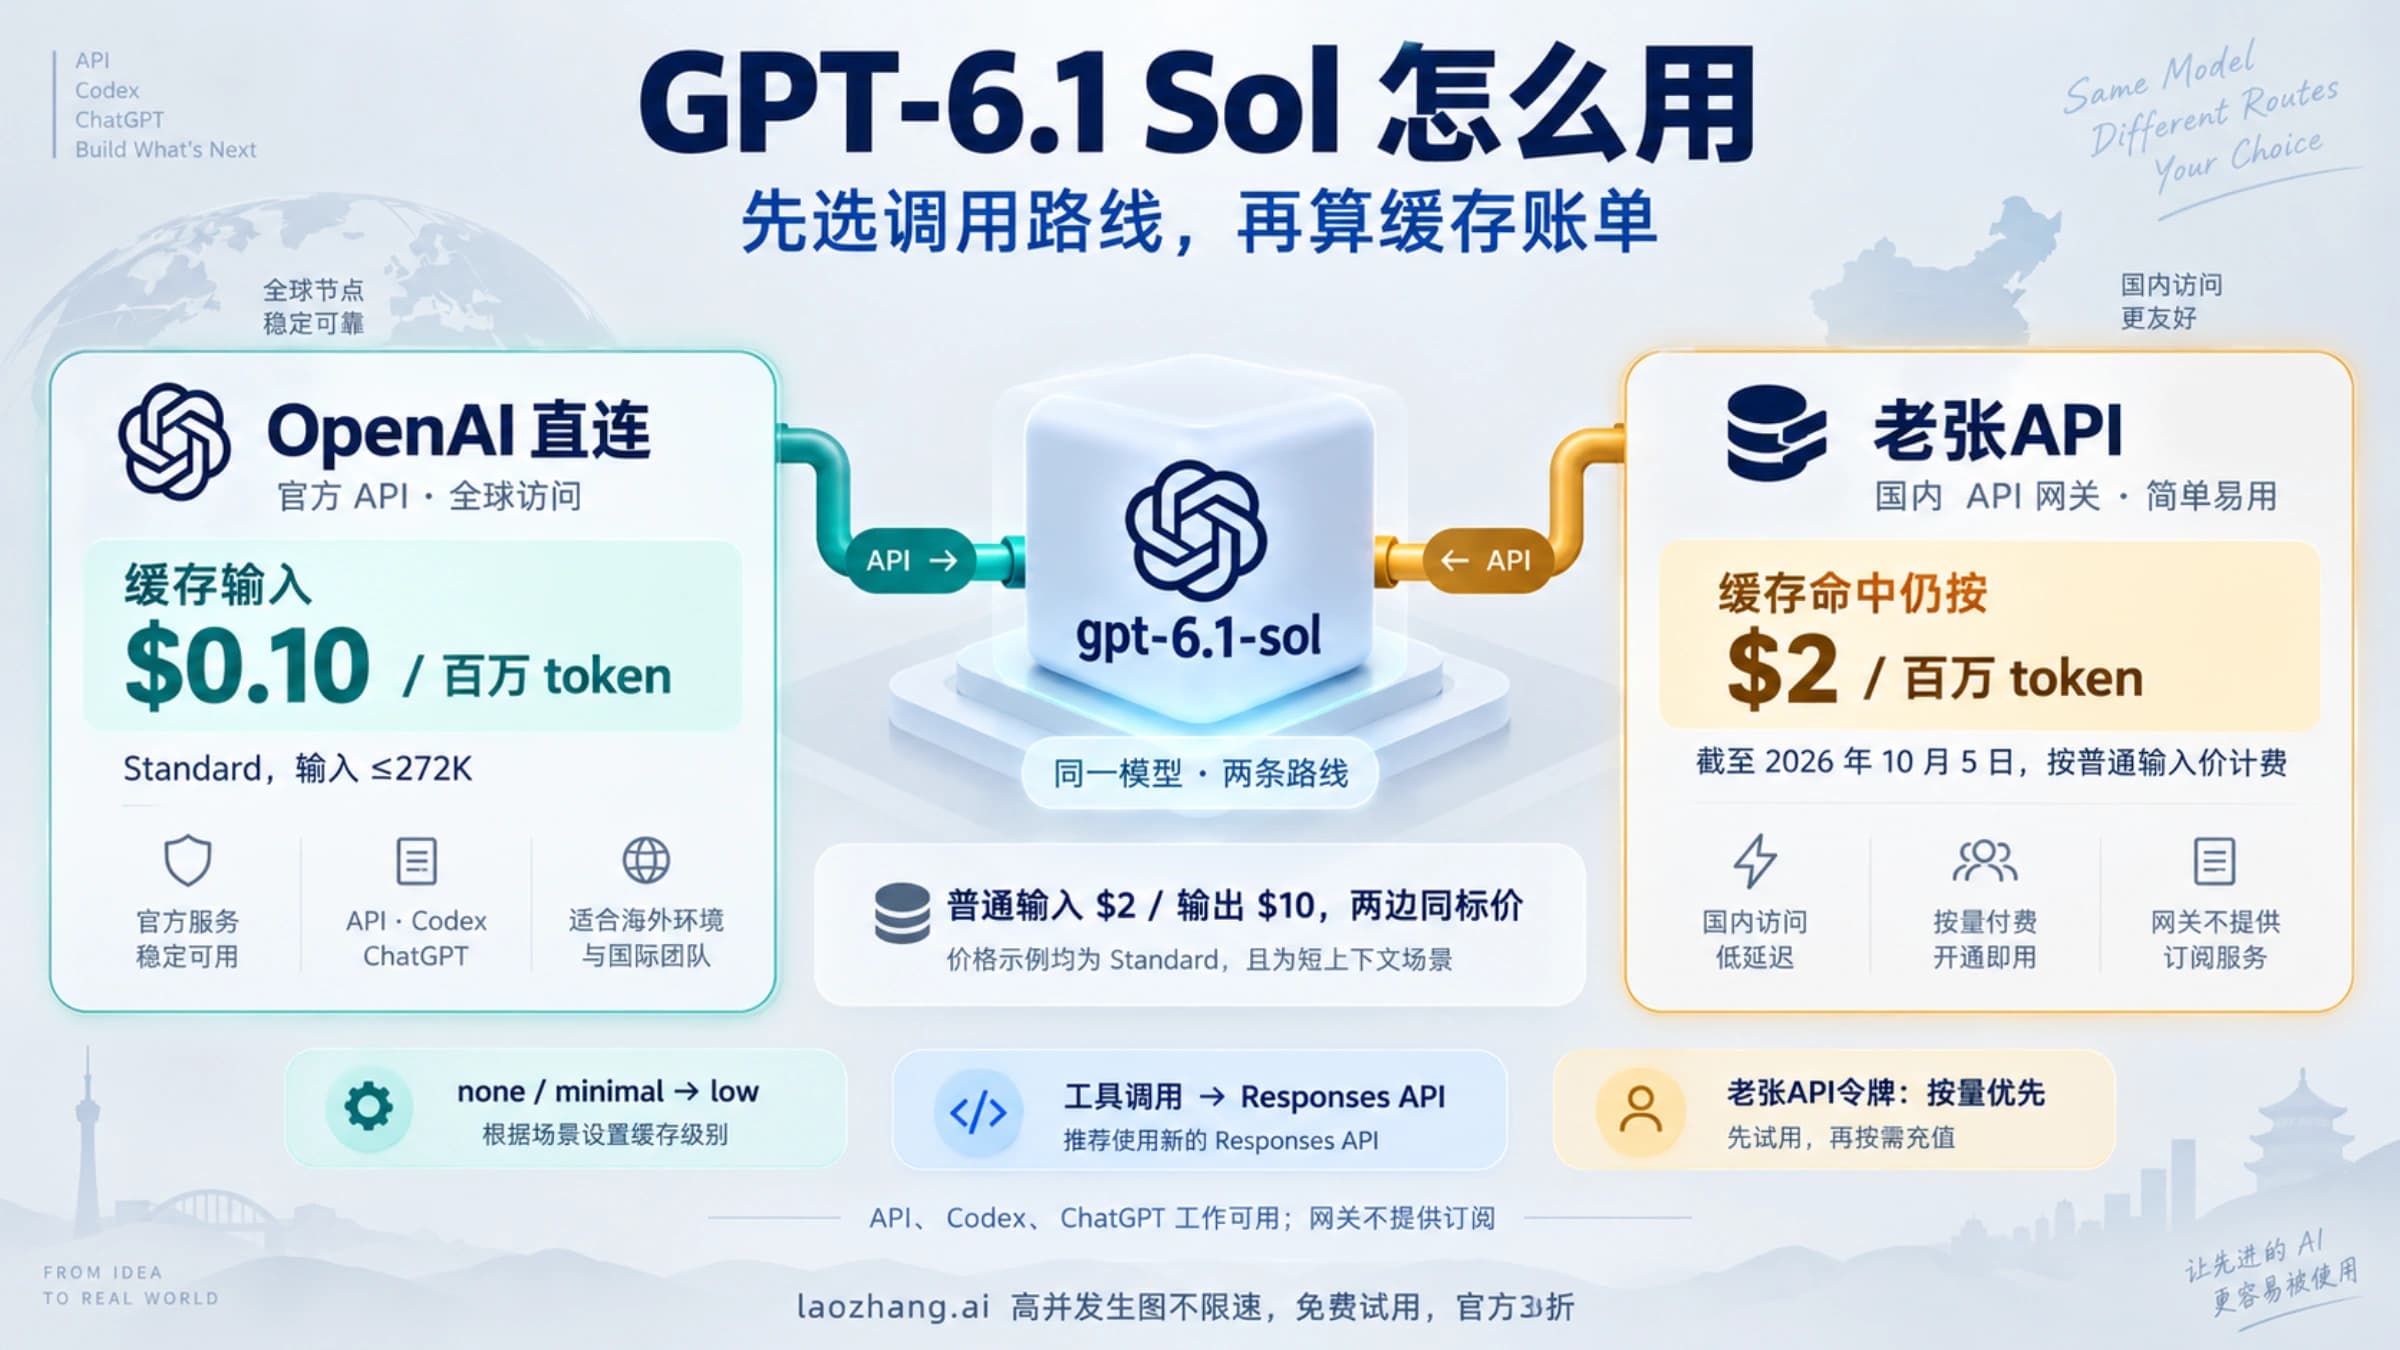
- GPT-6 家族的 API 里,Astra 是最贵的一档。同样按 Standard 短上下文、每百万 token 计:
| 模型 | 输入 | 缓存命中输入 | 缓存写入 | 输出 |
|---|---|---|---|---|
gpt-6-astra | $10 | $1 | $12.50 | $50 |
gpt-6.1-sol | $2 | $0.10 | $2.50 | $10 |
gpt-6-luna | $0.10 | $0.01 | $0.125 | $0.50 |
OpenAI 的模型说明把 GPT-6.1 Sol 定位为成本更低、表现接近 Astra 的选择,Luna 则用于目标明确、可大量重复的任务。如果你的任务不一定需要 Astra,先读 GPT-6.1 Sol、GPT-6 Sol、Astra 怎么选,再决定要不要为 Astra 的 5 倍单价付费。
做决定前的最短核对路径
先在自己的 OpenAI 项目里运行不含工具的最小 Responses API 请求。确认 gpt-6-astra 可用后,用一条接近生产规模的请求,从用量与账单记录取得实际 token 分类,并按 272K 阈值选择费率;随后才加入处理方式、区域和工具费用。上线前再以一小批有明确验收条件的真实任务计算每个完成任务成本。
本文的访问开放安排记录于 2026 年 9 月 4 日,费率于 10 月 15 日复核;此后访问范围、费率和项目资格仍可能变化。正式采购或大批量运行前,请重新核对官方模型页、定价页和项目内的实际可用状态。这样得到的是你当前项目可复现的成本,而不是一张脱离访问资格、上下文档位和交付结果的标价。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月15日。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月15日。
- 1.OpenAI 模型页developers.openai.com/api/docs/models/gpt-6-astra
- 2.官方定价页developers.openai.com/api/docs/pricing
- 3.发布公告openai.com/index/gpt-6-astra
- 4.最新模型指南developers.openai.com/api/docs/guides/latest-model
- 5.OpenAI 说明 ChatGPT 与 API 使用不同的账单系统help.openai.com/en/articles/9039756-billing-settings-in-chatgpt-vs-platform
- 6.OpenAI 帮助中心help.openai.com/en/articles/20001354
- 7.OpenAI 的模型说明learn.chatgpt.com/docs/models