Claude Sonnet 5.5 对比 Sonnet 5:分档成本与五项破坏性变更
Claude Sonnet 5.5 与 Sonnet 5 单价相同。按第三方分档测试,low 到 xhigh 每任务更省,max 档贵约五成;改模型 ID 前先查五项破坏性变更。
文章目录
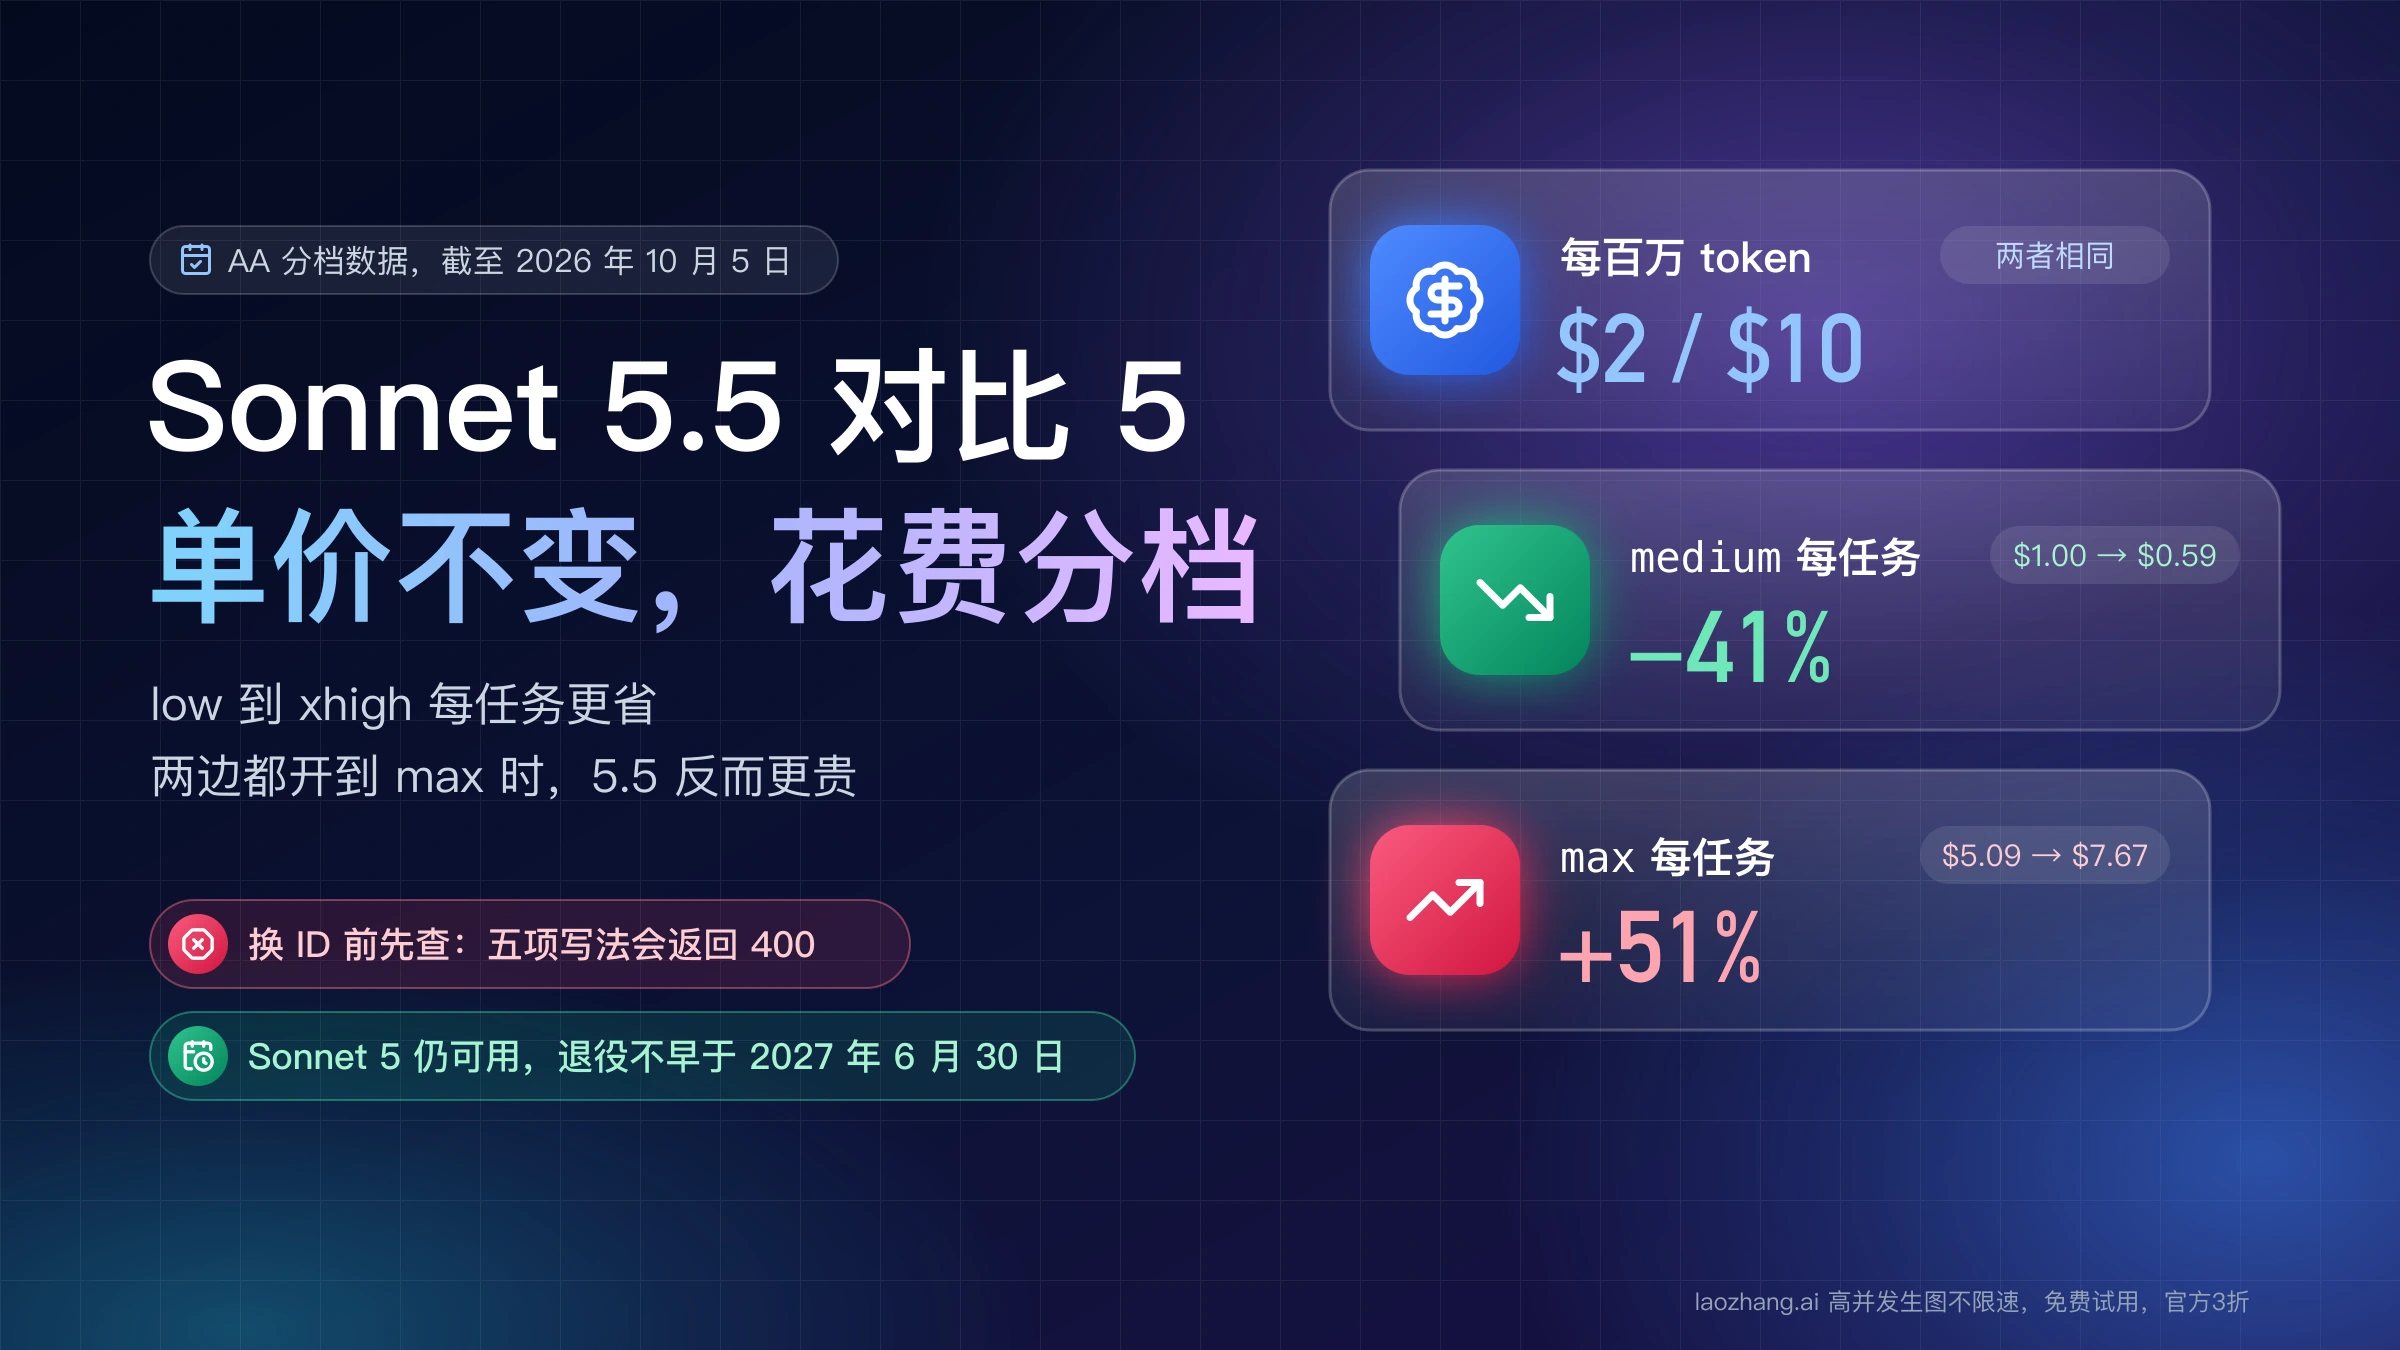
Claude Sonnet 5.5 是 Anthropic 在 2026 年 9 月 28 日发布的新版 Sonnet,API 模型 ID 为 claude-sonnet-5-5。它和 Sonnet 5 的 token 单价完全一样,输入每百万 token $2、输出 $10;分词器也相同,同一段文本计出的 token 数不变。变的是做完同一件事要花多少 token。按 Artificial Analysis 的 Sonnet 5.5 模型页(下称 AA)截至 2026 年 10 月 5 日的分档数据,low 到 xhigh 四档里,Sonnet 5.5 每个任务都比同档的 Sonnet 5 便宜,medium 和 high 省了约四成;只有两边都开到 max 时,Sonnet 5.5 每任务反而贵约 51%。分数则每一档都高出 12 到 18 分。
所以 Anthropic 说的“多数工作每任务最多省 30%”,和 AA 说的“比 Sonnet 5 贵约 50%”并不矛盾:AA 那句比的是 max 对 max。对多数 API 和 Claude Code 用户,换到 Sonnet 5.5 是划算的,但改模型 ID 之前要先排查五项破坏性变更,命中其中任何一项,请求多半会直接返回 400。Sonnet 5 目前是旧版(legacy),仍然可以调用,退役不早于 2027 年 6 月 30 日;真正有期限的是 Sonnet 4.5,它在 Claude API 上 2026 年 11 月 30 日退役。
Claude Sonnet 5.5 和 Sonnet 5 规格对照:价格、分词器不变,知识截止更新
两者的价格、上下文和输出上限都一样,Sonnet 5.5 仍是 Sonnet 级别的模型,不是 Opus。下表来自 Anthropic 的 Sonnet 5.5 模型页、Sonnet 5 模型页和 Sonnet 5.5 新变化文档,截至 2026 年 10 月 5 日。
| 项目 | Claude Sonnet 5.5 | Claude Sonnet 5 |
|---|---|---|
| Claude API 模型 ID | claude-sonnet-5-5(无日期后缀) | claude-sonnet-5 |
| Amazon Bedrock 模型 ID | anthropic.claude-sonnet-5-5 | anthropic.claude-sonnet-5 |
| 发布日期 | 2026 年 9 月 28 日 | 2026 年 6 月 30 日 |
| 状态 | 现行(Active) | 旧版(Legacy),仍可用 |
| 退役时间 | 不早于 2027 年 9 月 28 日 | 不早于 2027 年 6 月 30 日 |
| 上下文窗口 / 最大输出(同步 Messages API) | 1M / 128K | 1M / 128K |
| 知识截止 | 2026 年 6 月 | 2026 年 1 月 |
| 输入 / 输出价格(每百万 token) | $2 / $10 | $2 / $10 |
| Claude API 默认 effort | high | high |
| 关掉回答前思考的写法 | thinking: {"type": "between_tools"} | thinking: {"type": "disabled"} |
| 最小可缓存提示长度 | 512 token | 1,024 token |
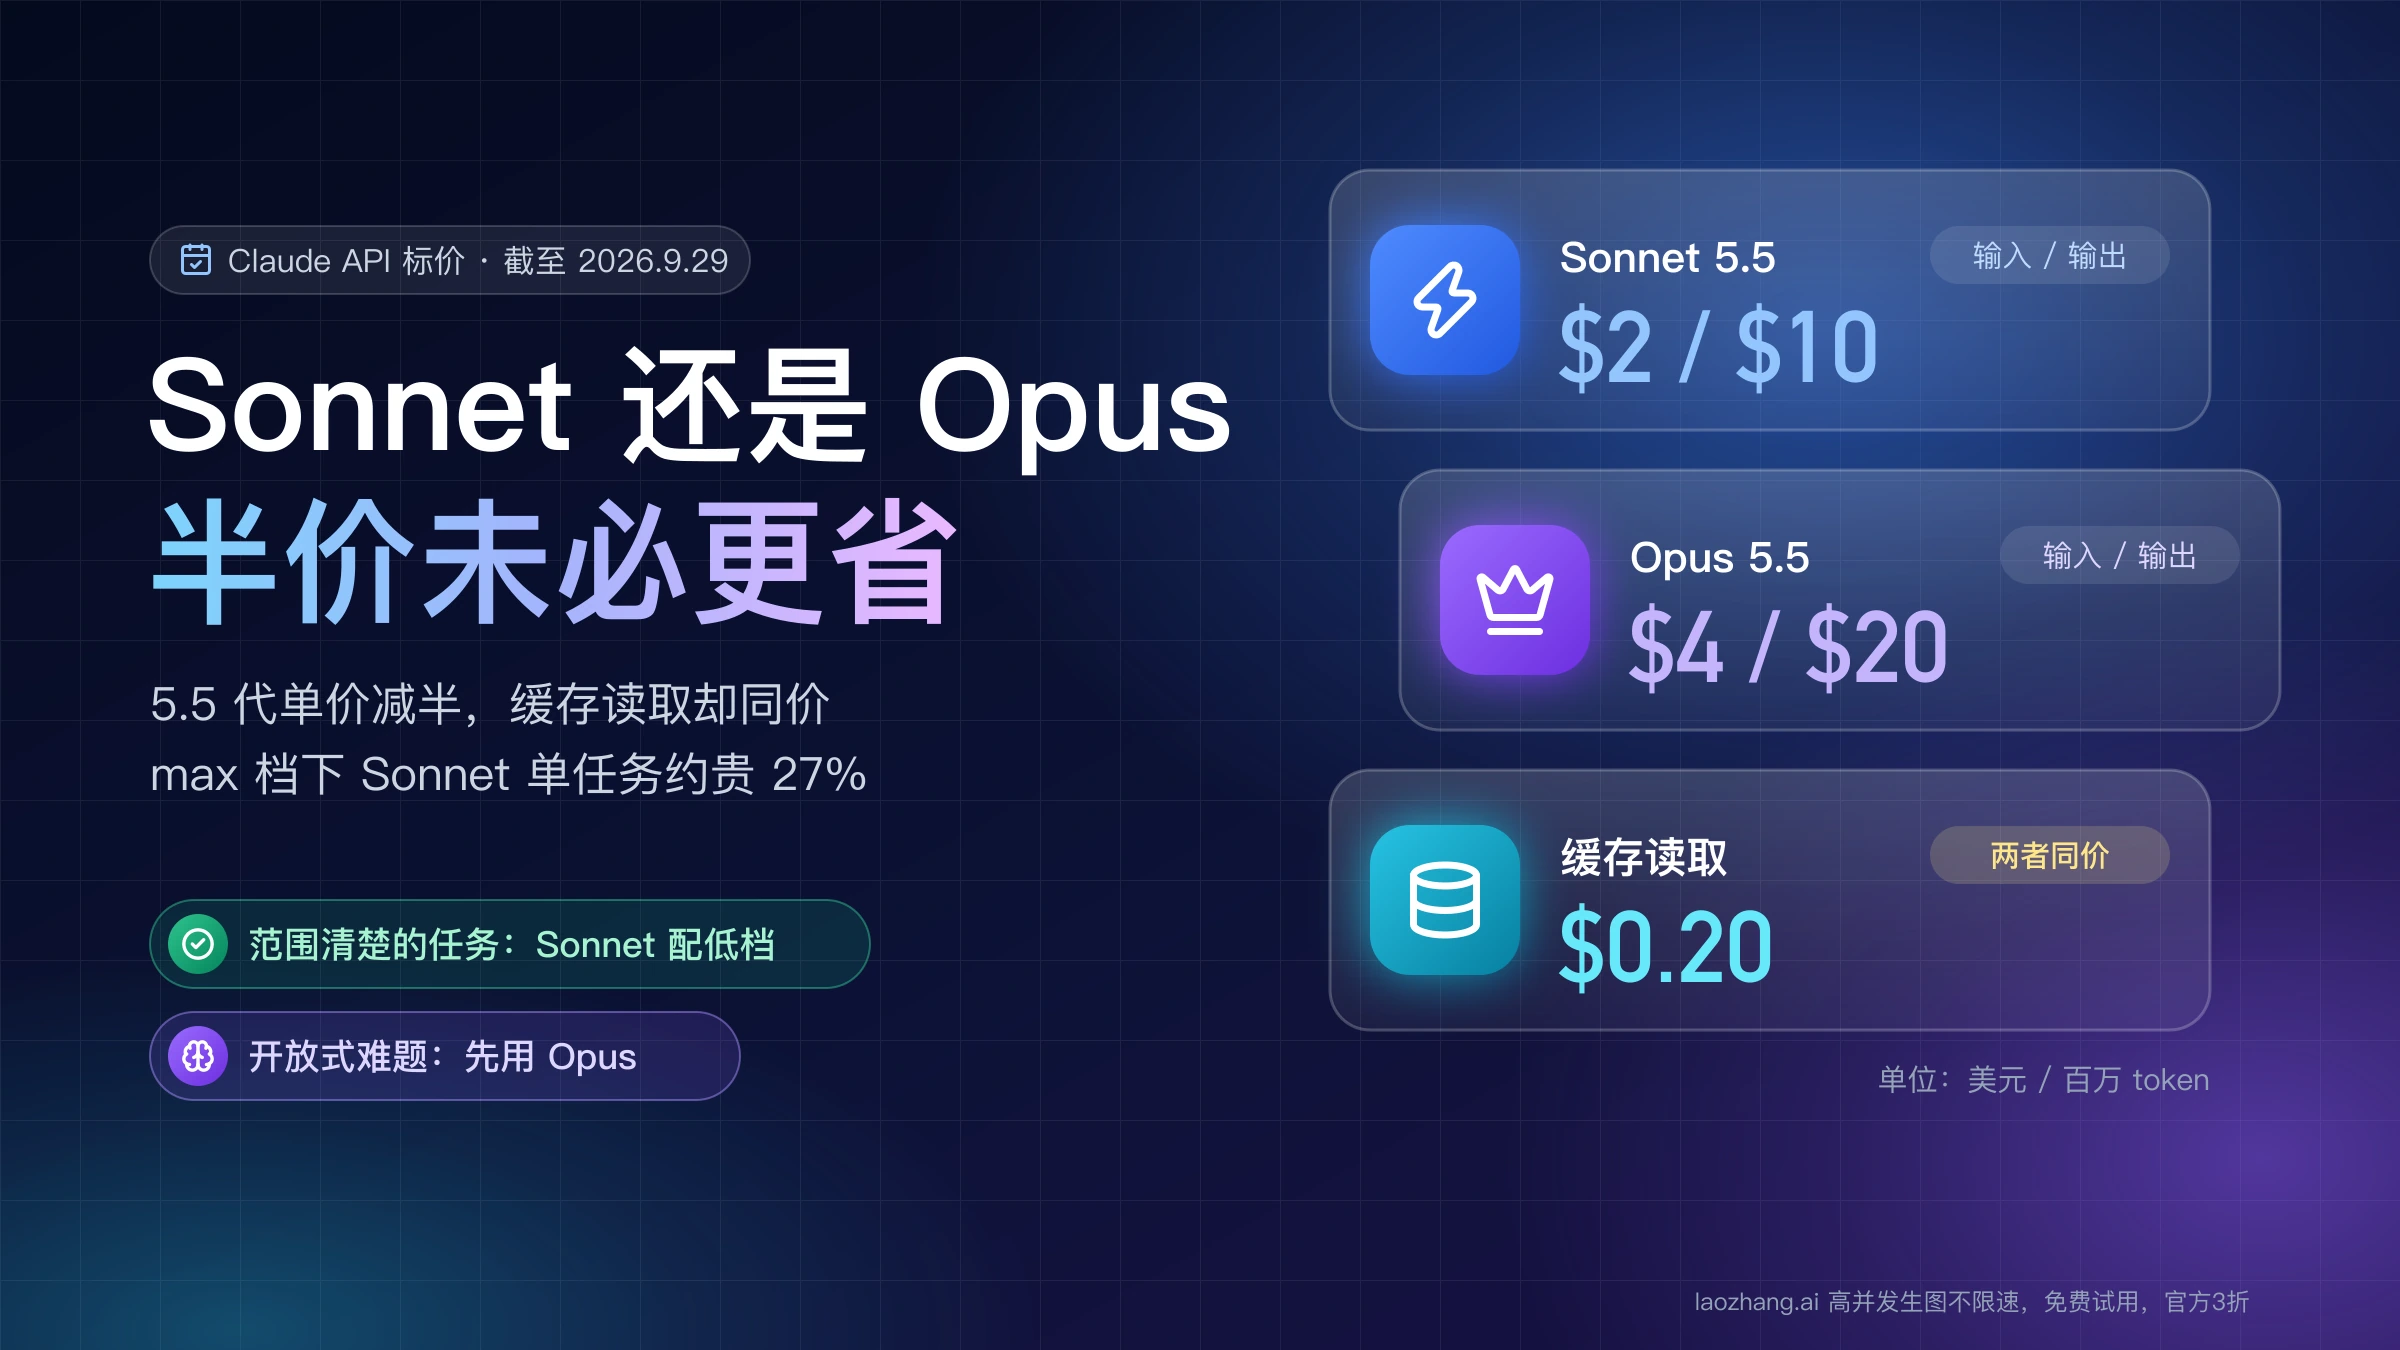
缓存和批处理价格也一致:5 分钟缓存写入 $2.50、1 小时缓存写入 $4,缓存读取 $0.20,Batch 半价,见 Anthropic 定价页面。作为参照,Opus 5.5 是输入 $4、输出 $20,正好两倍。Sonnet 5 原定涨价又取消的经过、缓存费用怎么对账,见 Claude Sonnet 5 取消涨价:现行 API 价格与预算重算。
除 Bedrock 外,Claude Platform on AWS、Google Cloud 和 Microsoft Foundry 上的模型 ID 都是 claude-sonnet-5-5。Sonnet 5.5 还多了几项 Sonnet 5 没有的功能:按消息调整 effort(beta)、对话中途插入 system 消息、对话中途增改工具(beta)。
Sonnet 5.5 比 Sonnet 5 便宜吗:low 到 xhigh 更省,max 贵约五成
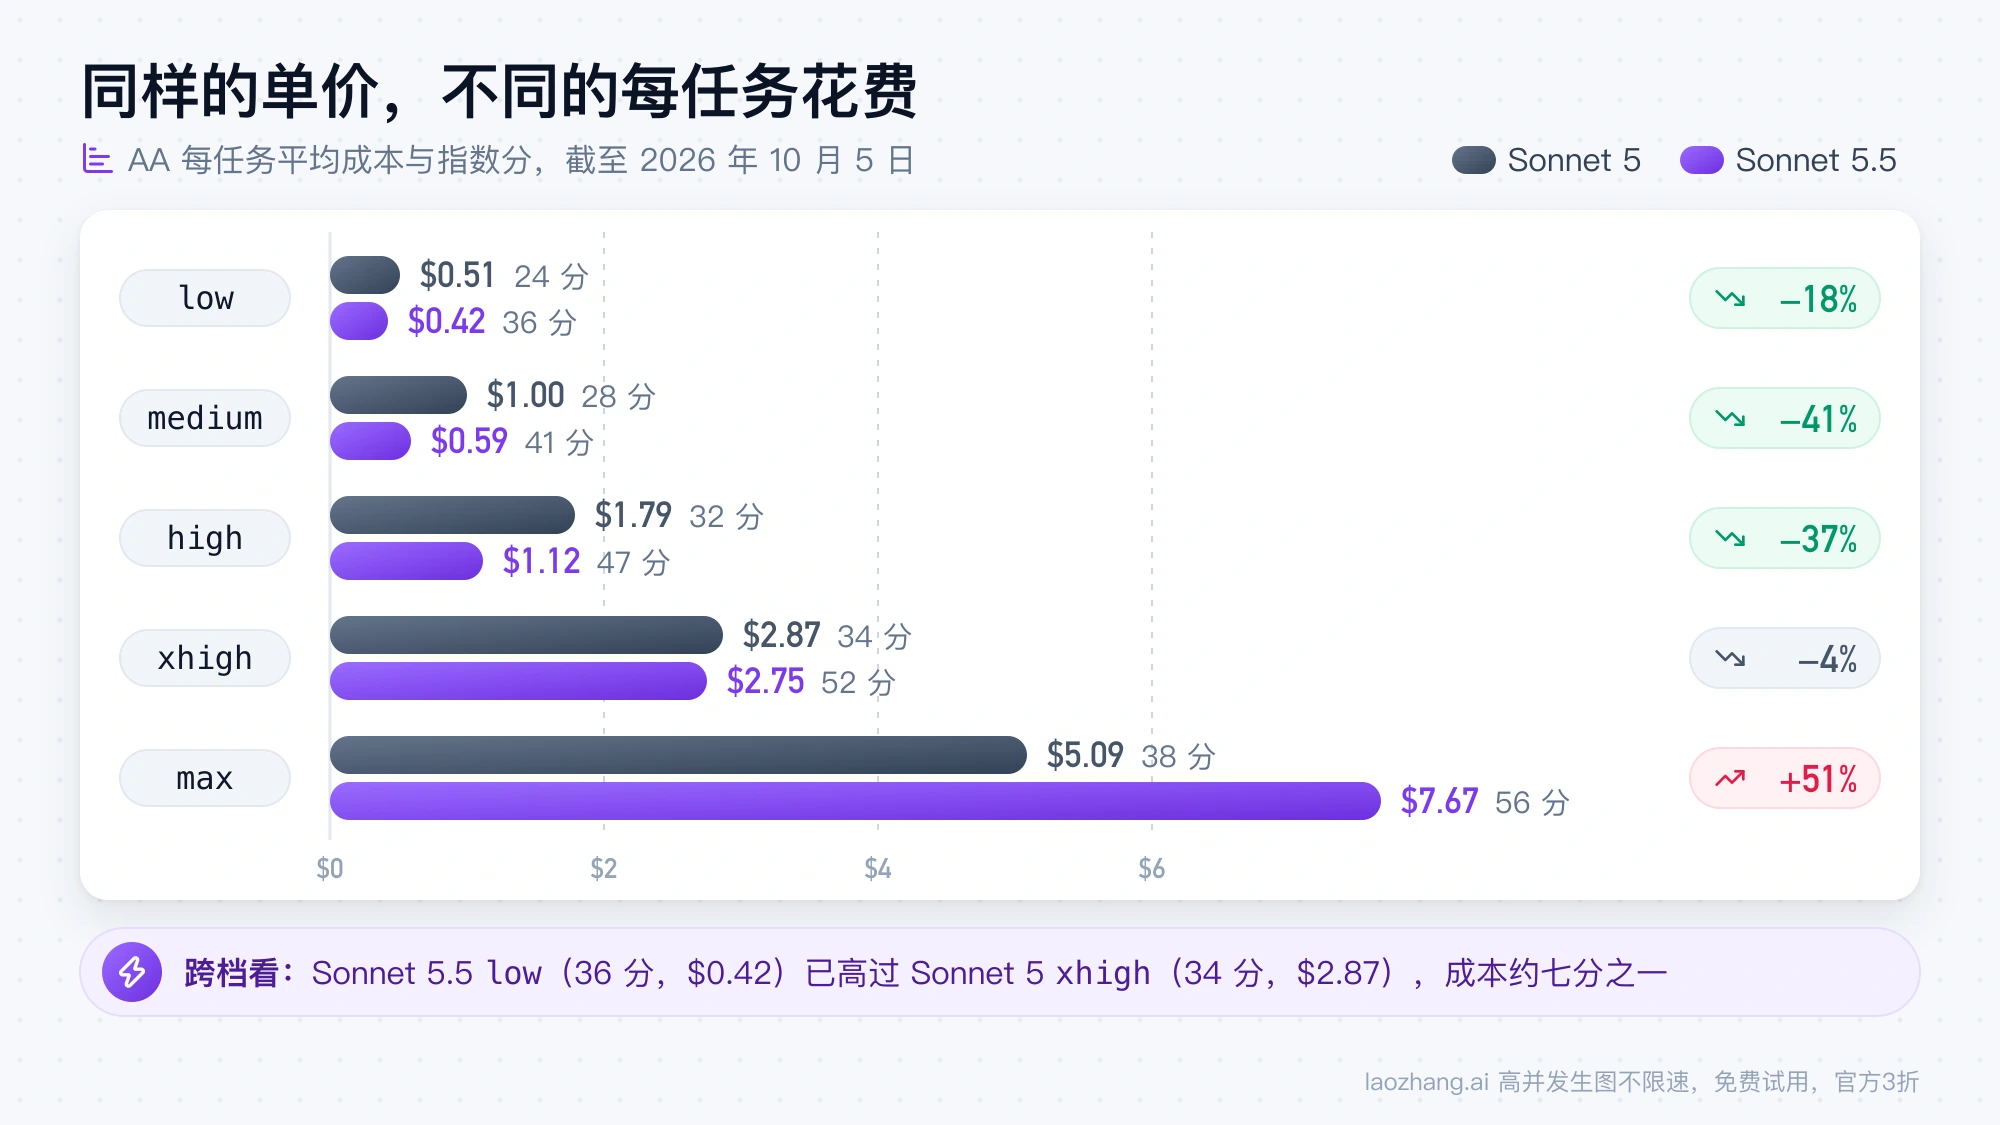
单价没变,所以“便宜”只能指每个任务的花费,而且要看 effort(思考力度)开在哪一档。AA 用同一套题目,把两个模型的五个 effort 档位都跑了一遍:
| effort | Sonnet 5 指数分 | Sonnet 5 每任务成本 | Sonnet 5.5 指数分 | Sonnet 5.5 每任务成本 | 每任务成本变化 |
|---|---|---|---|---|---|
low | 24 | $0.51 | 36 | $0.42 | −18% |
medium | 28 | $1.00 | 41 | $0.59 | −41% |
high | 32 | $1.79 | 47 | $1.12 | −37% |
xhigh | 34 | $2.87 | 52 | $2.75 | −4% |
max | 38 | $5.09 | 56 | $7.67 | +51% |
指数分是 AA 智能指数 v4.3.2(10 项评测)的得分,取整;每任务成本是跑一道指数任务的平均花费,按 AA 自己的题目组合、对话轮数和缓存情况计算,数据截至 2026 年 10 月 5 日。AA 在发布后重跑过,早先公布的数字和这里略有出入。最后一列按“Sonnet 5.5 每任务成本 ÷ Sonnet 5 每任务成本 − 1”算出,例如 max:$7.67 ÷ $5.09 − 1 ≈ +51%。AA 测 Sonnet 5.5 时开着 Anthropic 默认的服务端回退,约 0.1% 的任务回退到了 Sonnet 5。
max 档变贵,原因在输出 token:
| effort | 每任务输出 token(Sonnet 5 → 5.5) | 每任务用时(Sonnet 5 → 5.5) |
|---|---|---|
low | 1.52 万 → 1.43 万 | 138 秒 → 95 秒 |
medium | 2.73 万 → 2.09 万 | 245 秒 → 138 秒 |
high | 4.43 万 → 3.73 万 | 375 秒 → 238 秒 |
xhigh | 6.54 万 → 7.48 万 | 525 秒 → 461 秒 |
max | 11.78 万 → 19.74 万 | 852 秒 → 968 秒 |
开到 max,Sonnet 5.5 每个任务要输出约 19.7 万 token,比 Sonnet 5 多约 68%(19.74 ÷ 11.78 ≈ 1.68),AA 在发布当天的评测文章里称这是它测到过的最高 token 用量。单价不变而输出多了近七成,成本自然上去。反过来,low 档两者的输出 token 只差约 6%,成本却低了 18%,说明差别不只在输出量上:每任务成本还包括输入和多轮调用。Anthropic 在发布公告里提到,早期测试者看到 Sonnet 5.5 比 Sonnet 5 更常把多个工具调用合并,步骤更少,成本也更低。
再看两个口径为什么能同时成立。Anthropic 的“最多省 30%”来自它自己的测试,“最多”是上限,不是平均值;AA 的“贵约 50%”是 max 对 max 的标题结论。按 AA 同一份数据,medium 和 high 的降幅(41%、37%)还超过了 30%,xhigh 基本持平,只有 max 变贵。哪个数字跟你有关,取决于你实际跑在哪一档。
跨档比较,差距更明显:
- Sonnet 5.5
low(36 分,$0.42)已经高过 Sonnet 5xhigh(34 分,$2.87),成本约为后者的七分之一。 - Sonnet 5.5
medium(41 分,$0.59)高过 Sonnet 5max(38 分,$5.09),成本约为九分之一。
这与 Anthropic 公告里“在多项基准上,Sonnet 5.5 用 Low 或 Medium 就能超过 Sonnet 5 的最好成绩,每任务成本约为十分之一”的说法方向一致。不过这些仍是基准任务的花费,不是你的账单:提示长度、缓存命中率和对话轮数都会让结果偏离。估自己的成本,用同一批真实任务分别跑两个模型,把花费代入上面的公式。
Sonnet 5.5 比 Sonnet 5 强多少:每档高 12 到 18 分,厂商表差距更大
在 AA 的指数里,Sonnet 5.5 每一档都比同档 Sonnet 5 高,low 高 12 分,max 高 18 分。Anthropic 自己公布的评测表差距更大,但要带着几条限定看:
| 评测(Anthropic 公布) | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0(终端智能体编码) | 70.6% | 10.3% | 66.4%(xhigh) |
| FrontierCode 1.1 主集 | 52.1%(xhigh) | 42.4% | 54.4% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% |
| GDPval-AA v2.1 | 1844 | 1449 | 1846 |
| AA-Briefcase v1.1 | 1811 | 1359 | 1822 |
| Humanity's Last Exam(带工具) | 64.5% | 54.9% | 67.7% |
| OSWorld 2.1(partial) | 80.1% | 57.0% | 81.8% |
| Chartography(不带工具) | 61.6% | 15.6% | 64.4% |
- 这是厂商自报的数字,多数为
maxeffort 下的成绩。 - Sonnet 5 在 Terminal-Bench 4.0 上的 10.3% 偏低。AA 自己跑的同一评测里,Sonnet 5
max是 14.1%,Sonnet 5.5max是 63.6%,差距依然很大,但没有厂商表那么悬殊。 - GDPval-AA 和 AA-Briefcase 是 AA 在 Sonnet 5.5 预发布部署上跑的,那时有一个会影响结构化输出的 bug,现已修复。
- FrontierCode 上 Sonnet 5.5 开
max只有 46.2%,低于xhigh。Anthropic 的解释是:max下模型更常调用 Claude Code 的代码审查技能,把审查拆给多个子代理,结果出现超时或超出任务范围的改动。
第三方的一个具体例子是 CodeRabbit 的 Sonnet 5.5 代码审查测试:在 13 个已知 bug 的难例上,Sonnet 5.5 通过可执行的评论抓到 6 个,Sonnet 5 抓到 4 个,可执行评论的精确率分别为 41.2% 和 40.0%;用时约为一半,按标价算,每次审查的 Claude 调用费用约低 60%($0.46 至 $0.47 对 $1.16)。但其中有 2 个 bug 是 Sonnet 5 抓到、Sonnet 5.5 漏掉的。CodeRabbit 自己也说 13 个样本只能看方向;它在 44 个开源 PR 上的第二轮测试印证了“评论更少、速度快一倍”这一面。
和 Opus 5.5 比,上表的百分比项目多数只差约 2 到 3 个百分点,Terminal-Bench 上 Sonnet 5.5 还领先,但 Anthropic 也承认 Opus 5.5 在需要持续判断的复杂开放式工作上明显更强,而 Opus 的单价是 Sonnet 的两倍。
Sonnet 5.5 的 effort 从哪档起步:别照搬 Sonnet 5 的设置
Anthropic 说 Sonnet 5.5 的 effort 档位“重新校准过”,同名档位的思考量和 Sonnet 5 不一样,要求重新扫一遍档位,而不是沿用旧设置。官方给的起点按负载类型分:
- 一般任务:从
high起步。 - 需求明确的智能体编码和多步工具调用:从
medium起步,更难、更长的任务再升到high。 - 聊天等对延迟敏感的工作:从
medium或low起步。 xhigh和max:只在你的评测显示确有质量提升时使用。
这些建议见 Anthropic 的 effort 文档。如果你的目标是“效果不比 Sonnet 5 差、花得更少”,可以按你在 Sonnet 5 上的档位,参照 AA 的分数往下找起点:
| 你在 Sonnet 5 上用 | Sonnet 5.5 先试 | AA 指数里的依据(截至 2026 年 10 月 5 日) |
|---|---|---|
low 或 medium | low | 5.5 low 36 分、$0.42,高过 Sonnet 5 这两档(24、28 分),成本也更低 |
high | low,不够再 medium | 5.5 low 的 36 分已高过 5 high 的 32 分,成本约四分之一;medium 为 41 分、$0.59 |
xhigh | medium,不够再 high | 5.5 medium(41 分、$0.59)高过 5 xhigh(34 分、$2.87);high 为 47 分、$1.12 |
max | high,不够再 xhigh | 5.5 high(47 分、$1.12)高过 5 max(38 分、$5.09);xhigh 为 52 分、$2.75,仍比 5 max 便宜 |
disabled(关掉思考) | between_tools,effort 不高于 high | between_tools 在 xhigh、max 下会返回 400 |
两条路怎么选:手上有验收集,就从这张表的档位跑起,过不了再升一档;没有验收集,按官方建议的起点走更稳,因为 AA 指数是 10 项评测的平均,你的任务可能更依赖其中某一项。无论走哪条,max 都应当是最后的选项:Sonnet 5.5 在这一档每任务 $7.67,比 Sonnet 5 max 还贵。AA 的评价是 high 档在分数和每任务成本之间最有竞争力。
还要注意默认值:Claude API 不设 effort 时按 high 跑,Claude Code 和 Claude 应用里 Sonnet 5.5 默认是 medium。API 里用 output_config.effort 设置;做智能体编码时,effort 文档建议把 max_tokens 设为上限 128,000 并使用流式响应,因为思考也计入 max_tokens。
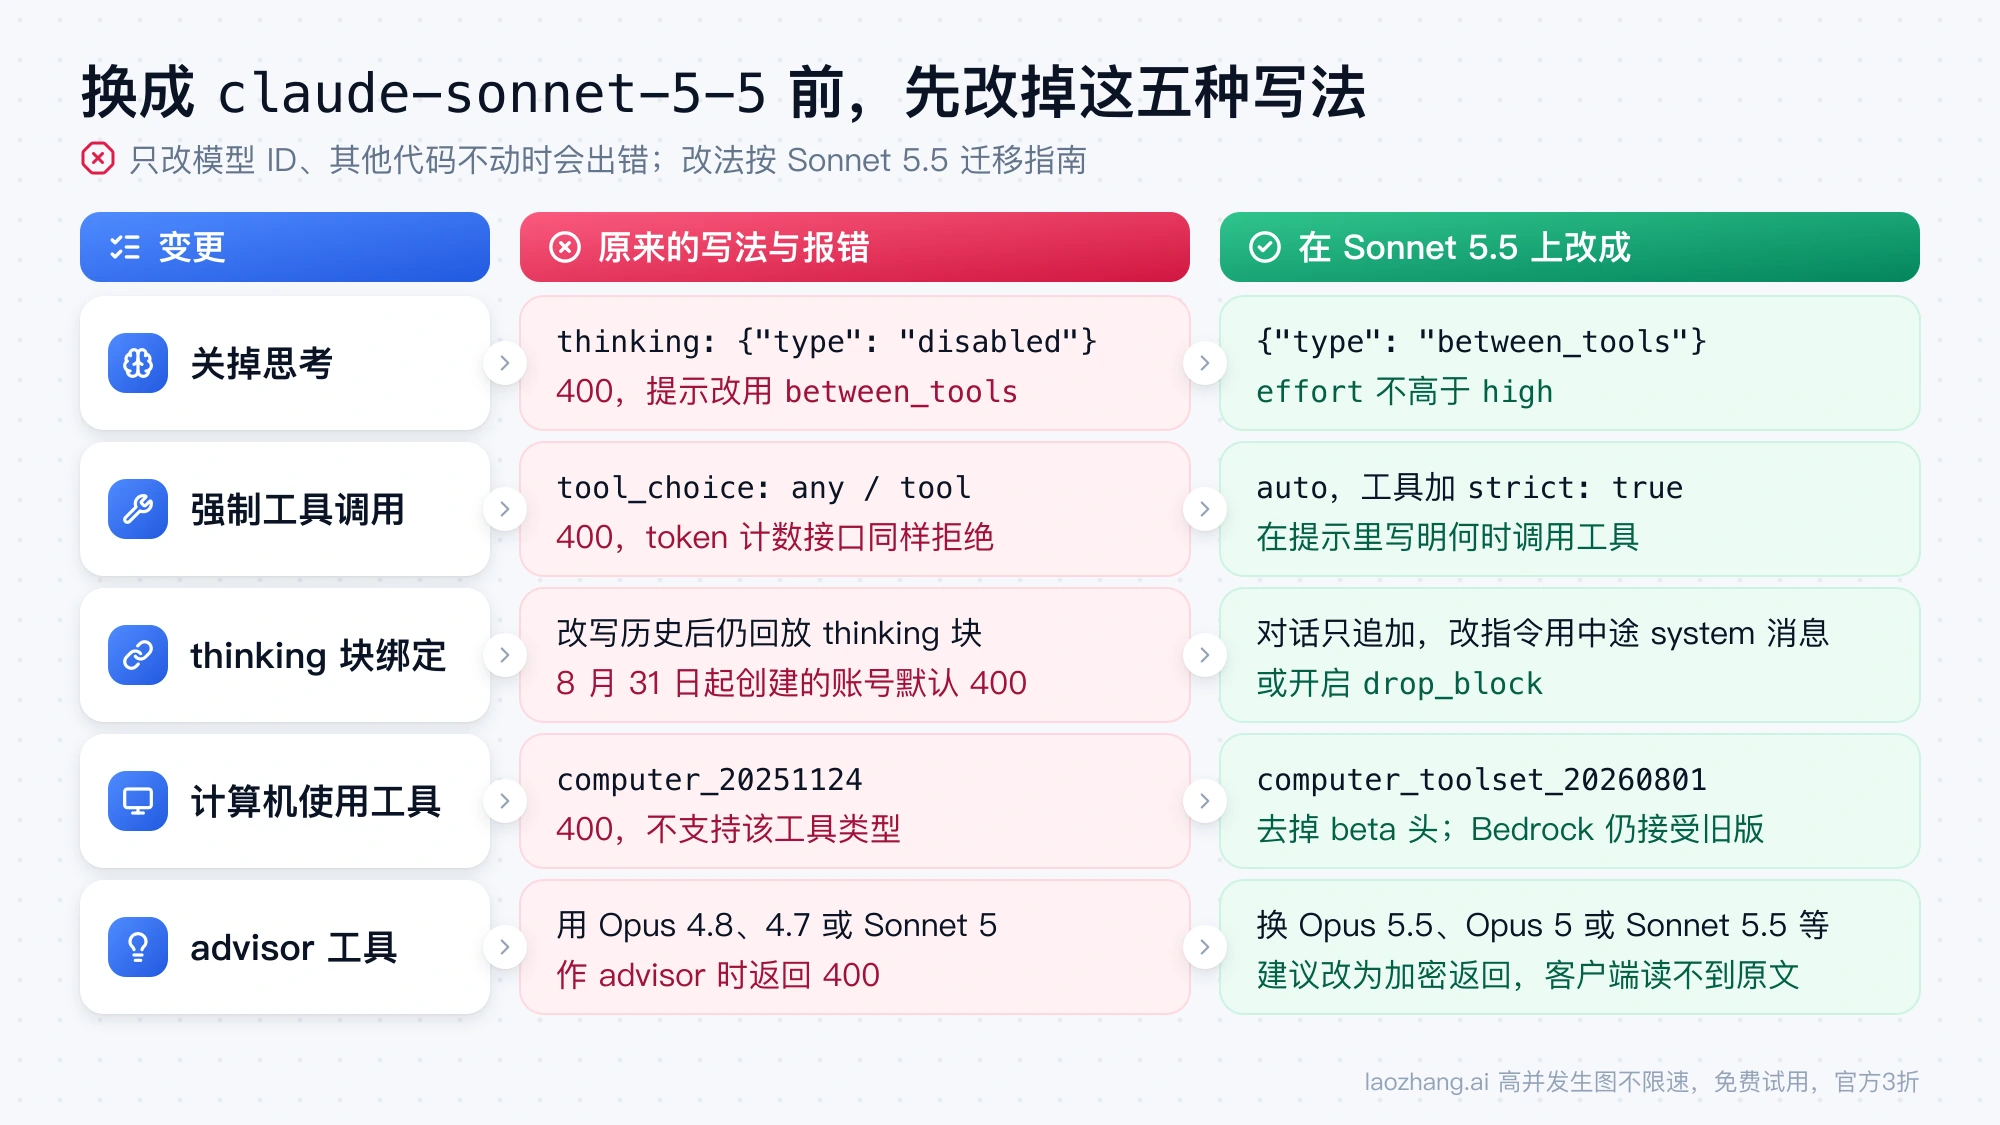
换成 claude-sonnet-5-5 会坏什么:五项破坏性变更
只改模型 ID、其他代码不动的话,下面五种写法会出问题。前两项最常见,后文给出改前改后的代码。
| 变更 | 你的代码如果 | 在 Sonnet 5.5 上的结果 | 怎么改 | 涉及平台 |
|---|---|---|---|---|
| 关掉思考 | 发送 thinking: {"type": "disabled"} | 400 invalid_request_error,提示改用 between_tools | 改成 {"type": "between_tools"},effort 限 low、medium、high | 所有平台 |
| 强制工具调用 | tool_choice 为 {"type": "any"} 或 {"type": "tool", "name": ...} | 400,token 计数接口同样拒绝 | 用 auto,工具加 strict: true,或把 schema 移到结构化输出;在提示里写明何时调用工具 | 所有平台;Bedrock 上见下文 |
| thinking 块与对话绑定 | 改动过 system、tools 或更早的消息后,仍回放 Sonnet 5.5 的 thinking 块 | 2026 年 8 月 31 日 00:00(UTC)及之后创建的账号默认返回 400 | 对话只追加、不改写,改指令用对话中途的 system 消息;或开启 drop_block | Claude API、Bedrock、Google Cloud |
| 计算机使用工具 | 声明 computer_20251124 | 400,报错开头为 'claude-sonnet-5-5' does not support tool types: computer_20251124. | 去掉 beta 头,工具改为 {"type": "computer_toolset_20260801"},代理循环改为处理成员 tool_use 块、批量动作和 toolset_name | Claude API、Google Cloud;Bedrock 仍接受旧版 |
| advisor 工具(beta) | 用 Opus 4.8、Opus 4.7 或 Sonnet 5 当 advisor | 400 invalid_request_error | 换成 Opus 5.5、Opus 5、Fable 5 或 5.1、Mythos 5 或 5.1,或 Sonnet 5.5 本身 | 使用 advisor 的集成 |
第三项的 drop_block 写法是:带上 beta 头 thinking-binding-controls-2026-08-01,并设置 thinking.block_binding.prefix_mismatch_behavior: "drop_block",只能配合 adaptive 思考使用。跨模型切换也受这条规则影响:对话从 Sonnet 5 切到 Sonnet 5.5,推理内容能接上;在 Claude API 和 Google Cloud 上从 Sonnet 5.5 切到 Opus 5.5 也能接上;从 Sonnet 5.5 切到其他任何模型,之前的 thinking 块会在模型看到之前被丢弃,请求照常成功,被丢弃的部分不计费。Sonnet 5.5 的 thinking 块还绑定产生它的账号(或关联账号),换账号发送同样会被丢弃。
advisor 一项还有个变化:Sonnet 5.5 接受的所有 advisor 都以加密的 advisor_redacted_result 块返回建议,你的客户端读不到建议原文。
关掉思考:把 disabled 改成 between_tools
between_tools 是 Sonnet 5.5 最低的思考设置,准确含义是:模型不在回答前思考,但它在工具调用之间写的简短进度说明,仍以 thinking 块返回,要随助手消息原样传回。请求里不带工具时,响应只有文本,和 Sonnet 5 上的 disabled 一样。它不需要 beta 头,所有提供 Sonnet 5.5 的平台都支持。
在 Sonnet 5.5 上发送 disabled,截至 2026 年 10 月 5 日返回的报错原文是:
To turn thinking off on this model, send "thinking": {"type": "between_tools"} instead of {"type": "disabled"}. The model does not think before responding. The short updates it writes between tool calls come back as thinking blocks.Sonnet 5.5 迁移指南里的例子是一个在 Sonnet 5 上关掉思考、同时开 xhigh 的请求。改前:
client.messages.create(
    model="claude-sonnet-5",
    max_tokens=16000,
    thinking={"type": "disabled"},
    output_config={"effort": "xhigh"},
    messages=[{"role": "user", "content": "..."}],
)
改后,effort 必须降到 high 或以下:
client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=16000,
    thinking={"type": "between_tools"},
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "..."}],
)
如果你确实需要 xhigh 或 max,就去掉 thinking 字段或发送 {"type": "adaptive"},改用自适应思考。另外几条限制:between_tools 不能再带 display、budget_tokens 或 block_binding,否则返回 400;用它时不能在对话中途改 effort;手动设置思考预算 {"type": "enabled", "budget_tokens": N} 也会返回 400。
强制工具调用:改成 auto 加 strict: true
tool_choice 用 any 或 tool 时,报错原文是 tool_choice: type "tool" and "any" are not supported for this model.。迁移指南给的改法如下。改前:
client.messages.create(
    model="claude-sonnet-5",
    max_tokens=1024,
    tools=tools,
    tool_choice={"type": "tool", "name": "get_weather"},
    messages=[{"role": "user", "content": "What's the weather in Paris?"}],
)
改后:
client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    # strict tool use: every call matches the tool's input_schema
    tools=[{**tool, "strict": True} for tool in tools],
    tool_choice={"type": "auto"},
    messages=[
        {
            "role": "user",
            "content": "What's the weather in Paris? Use the get_weather tool.",
        }
    ],
)
auto 意味着模型也可以不调用工具直接回答,所以提示里要写明什么时候用这个工具。strict 只支持 JSON Schema 的一个子集,每个 object 都要有 additionalProperties: false;一个请求最多 20 个 strict 工具,MCP、计算机使用和浏览器使用的工具集条目不接受 strict。Amazon Bedrock 上的 Sonnet 5.5 不提供结构化输出(含 strict 工具),只能发 auto 不带 strict,在提示里说明调用时机,再在自己的代码里校验工具输入。
不报错但界面变安静:工具调用之间的文字进了 thinking 块
这一项不算破坏性变更,因为没有请求会失败,但做流式界面的人最容易踩到。在 Sonnet 5 上,工具调用之间的文字都以 text 块返回;在 Sonnet 5.5 上,超过一两句的说明会变成“进度更新”类的 thinking 块,而默认的 display: "omitted" 下这些块是空的。结果是界面在工具调用之间一片安静,没有任何报错。
改法:用自适应思考时,把 thinking.display 设为 "updates"(beta,需要 thinking-display-updates-2026-08-18 头)只拿进度更新,或设为 "summarized",拿到混在推理摘要里的版本;然后在每个 tool_use 块之前渲染非空的 thinking 块。用 between_tools 的话,这些文字不需要设置 display 就会返回。
拒答类别更多:refusal 与回退到 Sonnet 5
Sonnet 5.5 拒答的类别比 Sonnet 5 多。拒答时返回 HTTP 200、stop_reason: "refusal",stop_details 会给出类别:cyber(网络安全危害)、bio(生物危害)、frontier_llm(协助开发竞争性 AI 模型)、reasoning_extraction(要求在回答里复述内部推理)、general_harms(其他使用政策领域,正常请求也可能触发)。Claude API 上的服务端回退(fallbacks: "default",beta)会把 cyber 和 frontier_llm 两类拒答交给 Sonnet 5 重试,另外三类不重试。拒答是否计费取决于类别,但都会占用速率限制。Anthropic 表示日常软件开发不受影响,高风险的网络安全任务会明显地回退到 Sonnet 5。
在 Claude Code 里用 Sonnet 5.5:先确认 sonnet 别名指向谁
Claude Code 里的 sonnet 别名只在 Anthropic API 上指向 Sonnet 5.5,在云平台上指向更旧的版本。按 Claude Code 模型配置文档,截至 2026 年 10 月 5 日:
| 接入方式 | sonnet 别名指向 |
|---|---|
| Anthropic API | Sonnet 5.5 |
| Claude Platform on AWS | Sonnet 4.6 |
| Amazon Bedrock、Google Cloud Agent Platform | Sonnet 4.5 |
| Microsoft Foundry | Sonnet 4.5 |
切换步骤:
- 运行
claude update,Sonnet 5.5 要求 Claude Code v2.1.284 或更高版本。 - 在会话里输入
/model claude-sonnet-5-5,或启动时用claude --model claude-sonnet-5-5,也可以设置环境变量ANTHROPIC_MODEL。只有 Anthropic API 上可以直接用/model sonnet。 - 在云平台上,用完整模型名,或把
ANTHROPIC_DEFAULT_SONNET_MODEL设为该平台的 Sonnet 5.5 模型 ID,否则sonnet和用到它的opusplan拿到的都是旧版。 - 用
/status确认当前模型;会话标题里模型名旁边会显示当前 effort。 - Claude Code 里 Sonnet 5.5 默认 effort 是
medium,需要时用/effort high、启动参数--effort或环境变量CLAUDE_CODE_EFFORT_LEVEL调整。
几个容易误会的地方:
- 没有手动选过模型时,
default设置在 Pro、Max、Team、Enterprise 和 Anthropic API 上解析为 Opus 5.5(从 v2.1.280 起),并不是 Sonnet。 - 每个模型有自己的提示词缓存,会话中途用
/model从 Sonnet 5 切到 5.5,下一次请求要在没有缓存的情况下重读整段对话。长会话最好在新会话开头切换。反过来,在 Sonnet 5.5 上改 effort 不会丢缓存(Bedrock、Google Cloud 除外)。 - 被判为网络安全类的请求会自动换到 Sonnet 5 重跑,并在记录里提示;生物类请求没有回退模型,直接拒答。在 Bedrock、Google Cloud 和 Foundry 上,自动回退要求部署里能解析到一个 Opus 模型(设置
ANTHROPIC_DEFAULT_OPUS_MODEL,或在平台模型列表里保留 Opus 4.8),同时能解析到 Sonnet 5(设置ANTHROPIC_DEFAULT_SONNET_MODEL,或保留 Sonnet 5 条目),否则被标记的请求直接以拒答结束。 - 如果仓库里有安全相关材料,第一次请求就可能触发回退。可以用
claude --safe-mode关掉 CLAUDE.md、技能、MCP 等自定义内容,看是不是它们触发的。
先留在 Sonnet 5 的情况:退役不早于 2027 年 6 月 30 日
Sonnet 5 没有收到弃用通知,Anthropic 只是建议考虑迁移。下面几种情况,晚一点换更合理:
- 你的任务只有在
max下才能过验收,且对成本敏感。同档对比,Sonnet 5.5 每任务贵约 51%;先拿high、xhigh试,过得了再换。 - Claude API 或 Google Cloud 上有基于
computer_20251124的计算机使用集成,短期内改不完。 - 你的流程需要读取 advisor 的建议原文:Sonnet 5.5 下所有 advisor 都加密返回。
- 产品会改写对话历史后再发送,而账号是 2026 年 8 月 31 日之后创建的,暂时还没改成只追加。
- 工作负载以渗透测试、CTF 或生物相关内容为主,在 Sonnet 5.5 上会频繁拒答或回退。Anthropic 表示,做网络安全防御的团队很快可以申请扩展后的 Cyber Verification Program,获得 Sonnet 5.5 更高级别的能力。
这几项都处理好之后,换模型就只是改一个 ID 的事。
Sonnet 4.5 用户:Claude API 上 2026 年 11 月 30 日退役
claude-sonnet-4-5-20250929 已于 2026 年 9 月 30 日被标为弃用,在 Claude API 上 2026 年 11 月 30 日退役,Anthropic 推荐的替代就是 claude-sonnet-5-5。见 Anthropic 模型弃用页面。Sonnet 4.6 仍是现行模型,退役不早于 2027 年 2 月 17 日。Bedrock、Google Cloud 和 Foundry 上的退役日期由各平台自己定。
从 Sonnet 4.5 直接跳到 5.5,除了上面的五项,还要补上 Sonnet 4.5 和 Sonnet 5 之间积累的改动。迁移指南里这部分的要点:
- 思考默认开启(Sonnet 4.5 默认关闭):按
type读取内容块,原样传回 thinking 块,重新估算max_tokens。 - 删掉非默认的
temperature、top_p、top_k。 - 分词器变了,同样的文本比 Sonnet 4.5 多出约 30% 的 token,预算要重算;高分辨率图片最长边可到 2576 像素、最多 4,784 token。
- 助手消息预填(prefill)会返回 400:
This model does not support assistant message prefill. The conversation must end with a user message. - 用标准 JSON 解析器解析工具输入;显式设置
output_config.effort。 - 删除上下文窗口相关的 beta 头和
interleaved-thinking-2025-05-14,把fine-grained-tool-streaming-2025-05-14换成eager_input_streaming,把output_format移到output_config.format。 - Bedrock 上的计算机使用从
computer_20250124换成computer_20251124。
离退役不到两个月,这份清单比“要不要换”更紧迫。
切换后的核对清单:模型 ID、effort 和每任务成本
- 请求日志里发出的模型 ID 是
claude-sonnet-5-5(Bedrock 上是anthropic.claude-sonnet-5-5);Claude Code 里用/status看。 - 显式写
output_config.effort,不依赖默认值,档位按上面的方法重新选。 - 在代码里搜
"disabled"、tool_choice、computer_20251124和 advisor 的模型名,确认五项破坏性变更都已处理。 - 流式界面在工具调用之间有没有变安静,
display是否已按需设置。 - 记录
stop_reason: "refusal"及其stop_details类别,决定是否开启fallbacks: "default"。 - 用同一批真实任务对比两个模型的输出 token 和花费,按“5.5 每任务成本 ÷ 5 每任务成本 − 1”算出你自己的变化幅度。
- 最小可缓存长度从 1,024 降到 512 token,之前因为太短没缓存的提示,现在可以考虑加上缓存。
关于 Claude Sonnet 5.5 的其他问题
Claude 免费版能用 Sonnet 5.5 吗?
Claude 定价页的“模型与用量”表(截至 2026 年 9 月 29 日)写着免费版可用 Sonnet、不能用 Opus,Pro 和 Max 两者都能用,但表里没写具体版本号,所以免费版是否已经是 Sonnet 5.5,官方没有明文说明。Anthropic 的公告提到,在 Claude 应用和 Claude Code 里,Sonnet 5.5 默认 effort 是 Medium,Claude Platform 上默认是 High。
Sonnet 5.5 和 Opus 5.5 怎么选?
需求清楚的日常编码、修 bug、做文档和表格,先用 Sonnet 5.5,单价是 Opus 5.5 的一半,Anthropic 公布的多数基准只落后约 2 到 3 个百分点。需要长时间独立判断的复杂开放式任务,Anthropic 自己的结论是 Opus 5.5 明显更强;AA 的知识准确性测试里,Sonnet 5.5 准确率 54%、Opus 5.5 为 66%,但 Sonnet 5.5 的幻觉率更低(47% 对 59%)。
Sonnet 5.5 和 GPT-6 Astra 哪个更值得用?
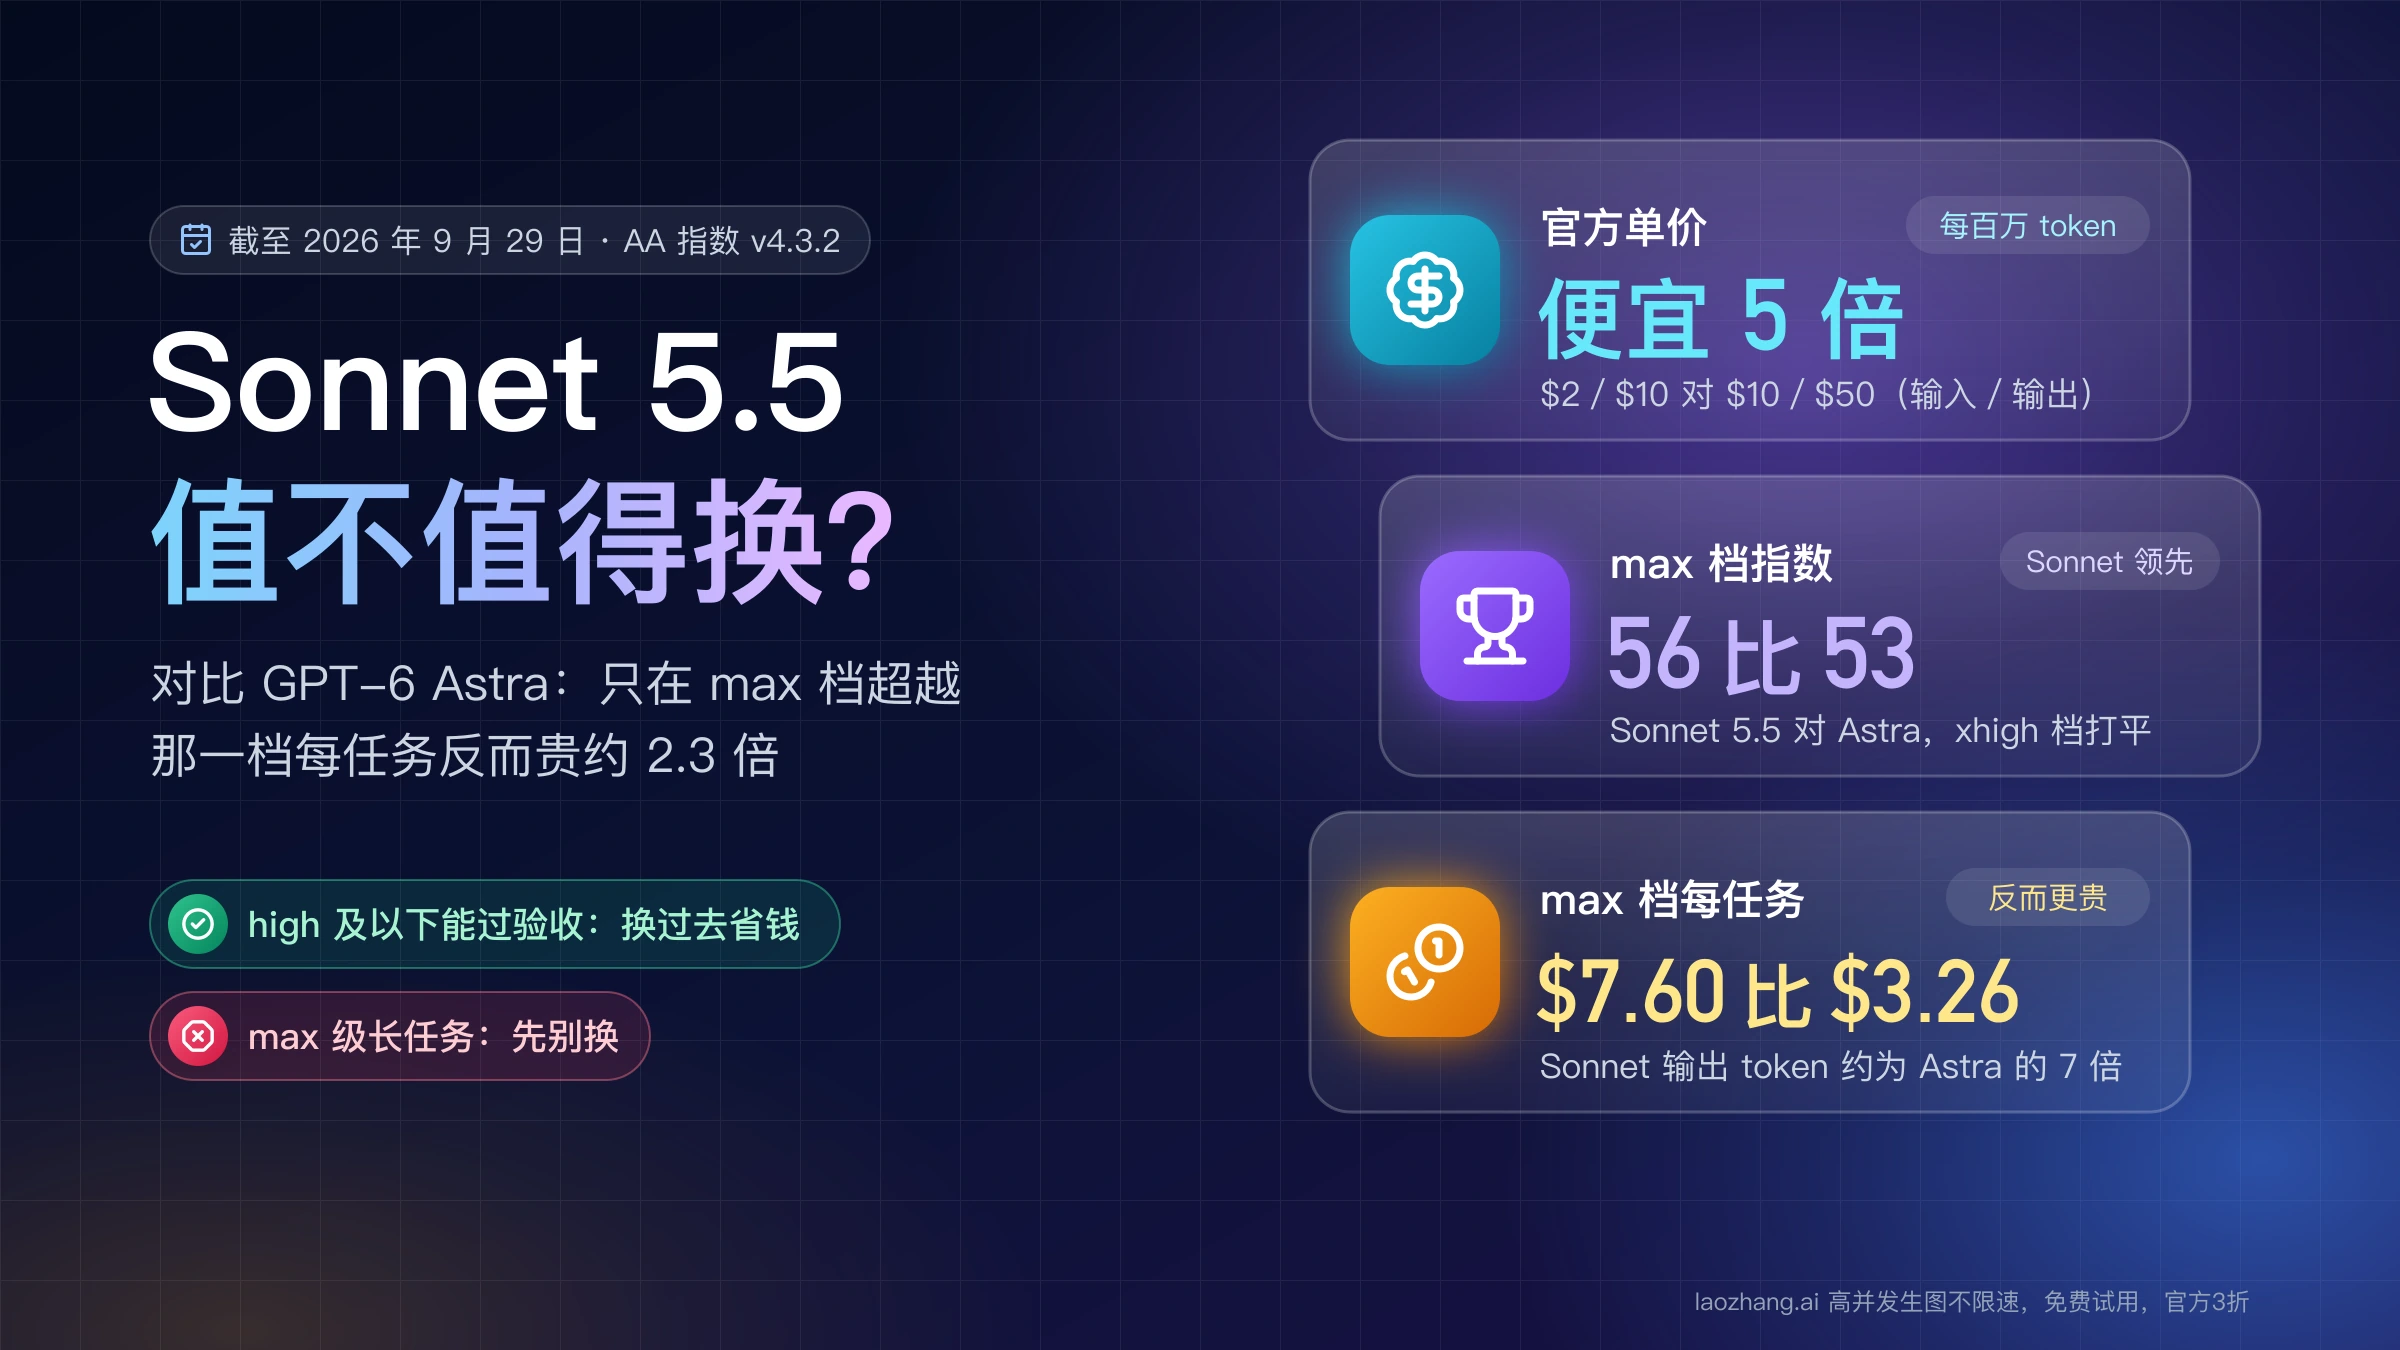
两者在不同 effort 档位上的分数和每任务成本差别很大,结论取决于你跑在哪一档,具体对比见 Sonnet 5.5 对比 GPT-6 Astra:值不值得换。
在中国大陆能直接使用 Claude Sonnet 5.5 吗?
不能。Anthropic 支持的国家和地区列表(截至 2026 年 9 月 29 日)不包含中国大陆和香港,Claude 应用和 Claude API 都按这份列表提供服务。Amazon Bedrock、Google Cloud 和 Microsoft Foundry 上的 Sonnet 5.5 按各云平台自己的区域和账号条款提供。
参考来源13
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月6日。
参考来源13
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月6日。
- 1.Artificial Analysis 的 Sonnet 5.5 模型页artificialanalysis.ai/models/claude-sonnet-5-5
- 2.Anthropic 的 Sonnet 5.5 模型页platform.claude.com/docs/en/models/sonnet-5-5/overview
- 3.Sonnet 5 模型页platform.claude.com/docs/en/models/sonnet-5/overview
- 4.Sonnet 5.5 新变化文档platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
- 5.Anthropic 定价页面platform.claude.com/docs/en/about-claude/pricing
- 6.发布当天的评测文章artificialanalysis.ai/articles/claude-sonnet-5-5
- 7.发布公告anthropic.com/claude-sonnet-5-5
- 8.CodeRabbit 的 Sonnet 5.5 代码审查测试coderabbit.ai/blog/sonnet-5-5-model-review
- 9.Anthropic 的 effort 文档platform.claude.com/docs/en/build-with-claude/effort
- 10.Sonnet 5.5 迁移指南platform.claude.com/docs/en/models/sonnet-5-5/migration-guide
- 11.Claude Code 模型配置文档code.claude.com/docs/en/model-config
- 12.Anthropic 模型弃用页面platform.claude.com/docs/en/about-claude/model-deprecations
- 13.Anthropic 支持的国家和地区列表anthropic.com/supported-countries