Claude 最新模型对比:Haiku、Sonnet、Opus 5.5 与 Fable 5.1 怎么选
Claude 最新四档:Haiku、Sonnet、Opus 5.5、Fable 5.1。官方建议 App 先用 Sonnet,API 先用 Opus 5.5,不够再上 Fable。
文章目录
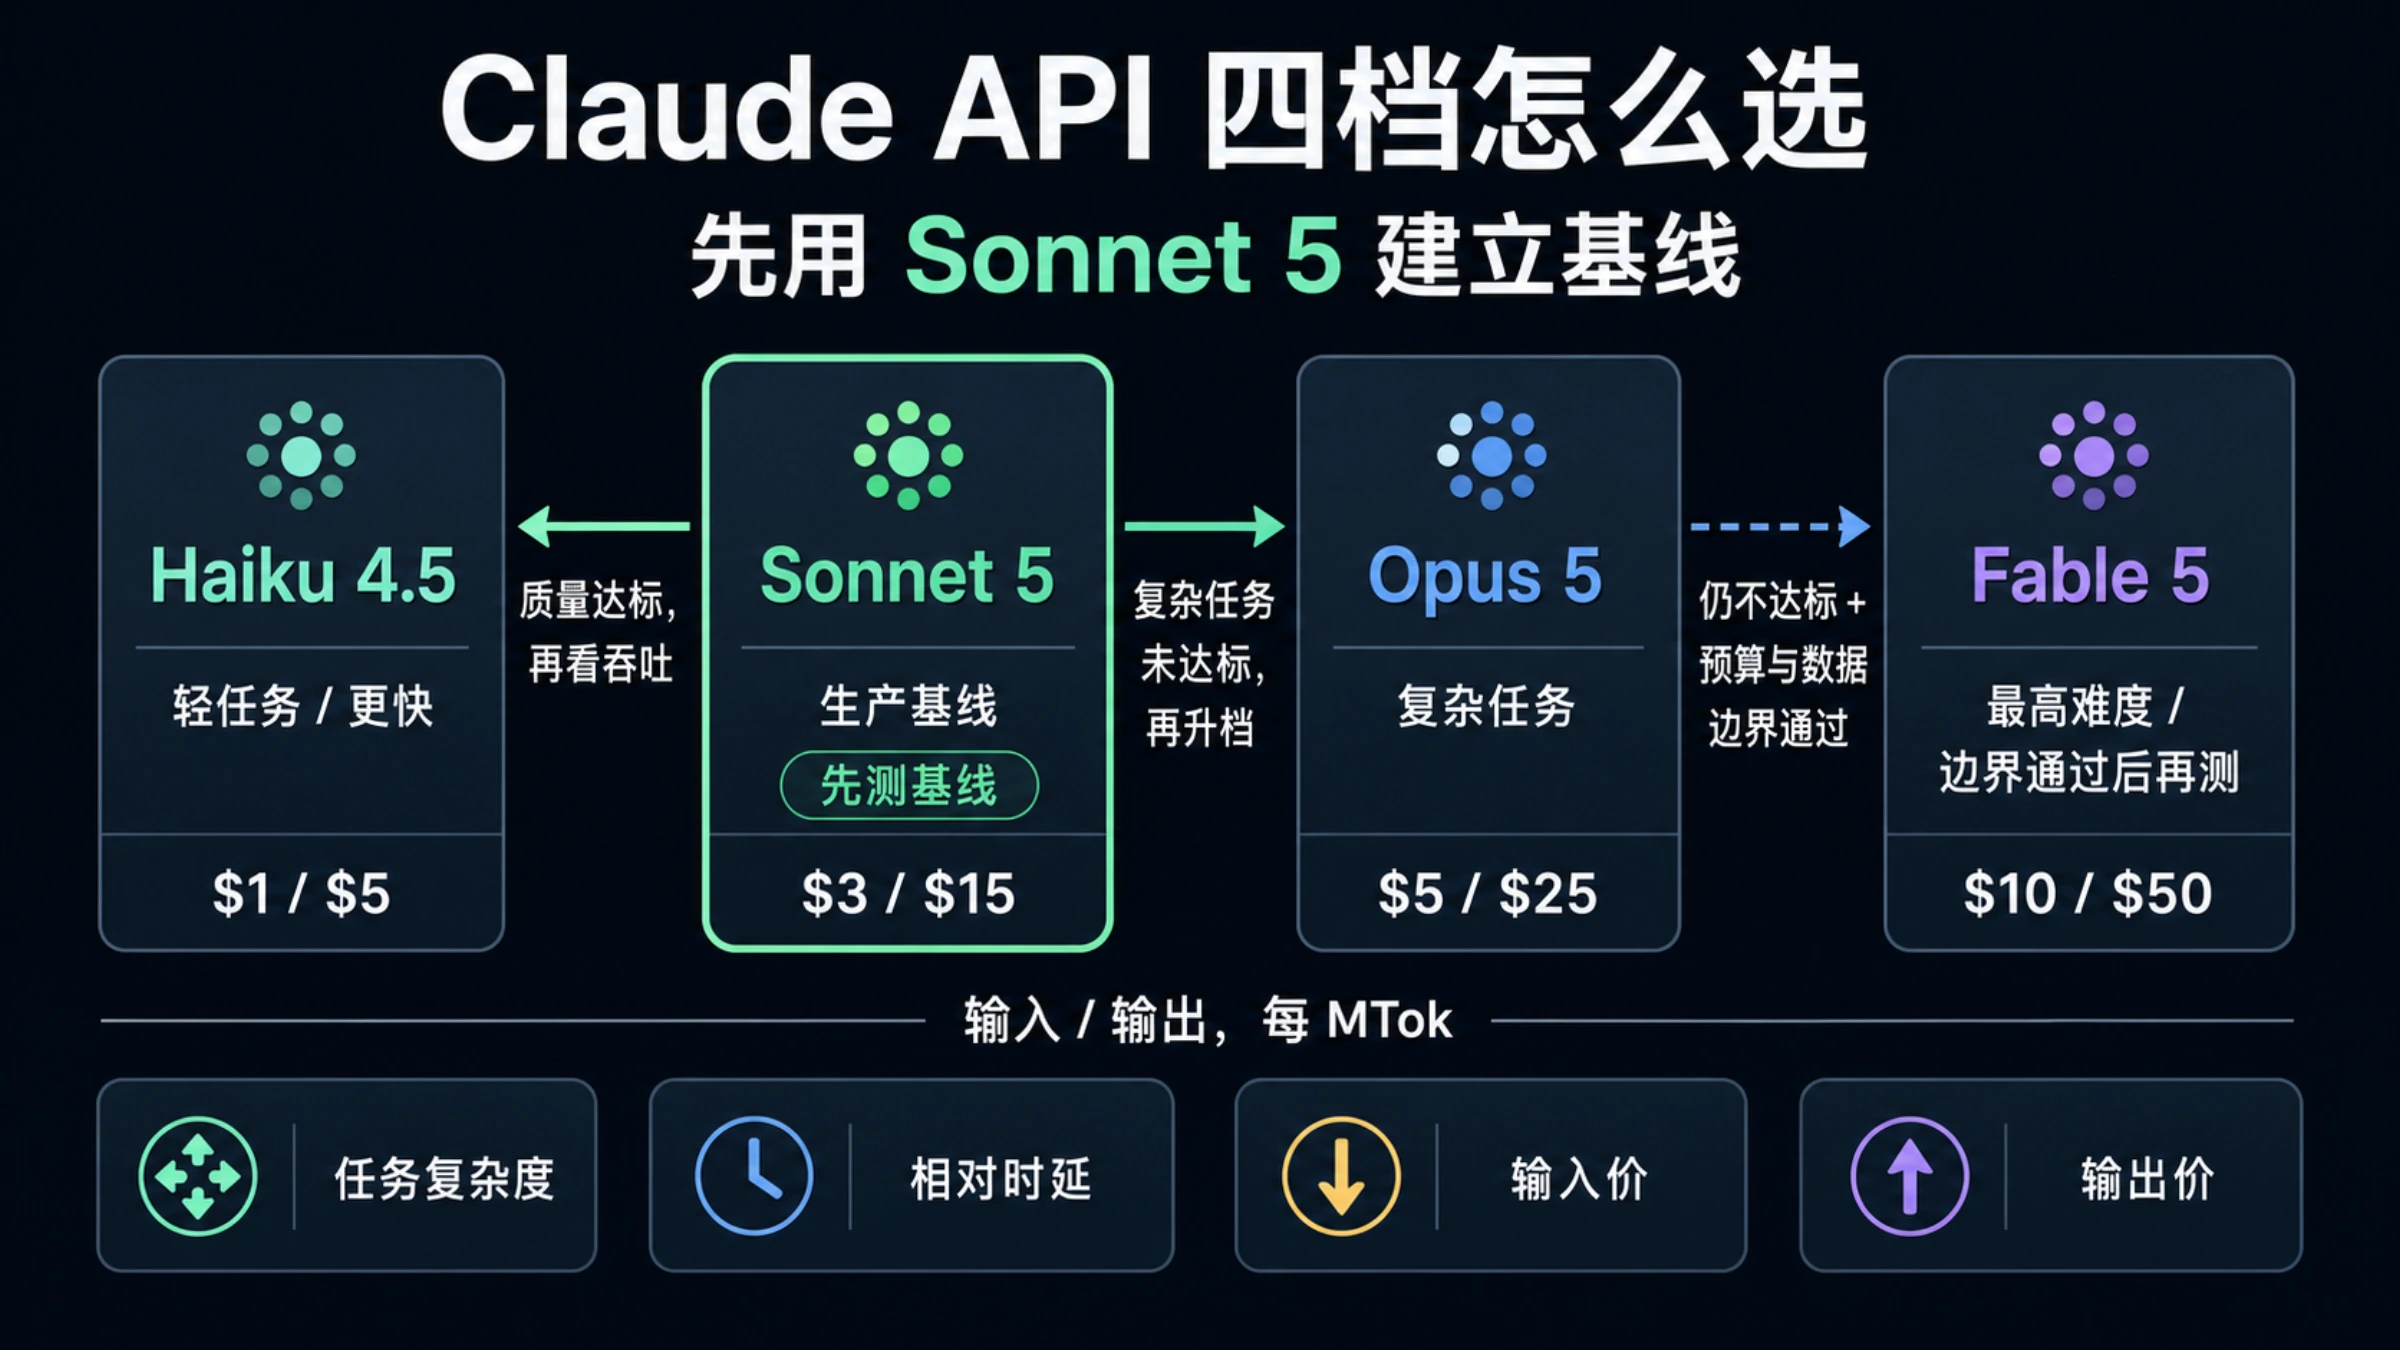
截至 2026 年 10 月 26 日,Claude 的最新模型是四档:Claude Haiku 5.5、Claude Sonnet 5.5、Claude Opus 5.5 和 Claude Fable 5.1。最新的 Opus 是 Opus 5.5,能力最强、付费用户和 API 都能用的是 Fable 5.1。2026 年 8 月的阵容 Haiku 4.5、Sonnet 5、Opus 5、Fable 5 已经归入旧版,仍能调用,但不再是 Anthropic 推荐的起点。
选哪一档,先看你在哪里用。在 Claude App(网页、桌面和手机)里,Anthropic 的建议是拿不准就先用 Sonnet 5.5,Sonnet 做不好再换 Opus,Opus 也做不好再换 Fable,Free 套餐只有 Haiku 和 Sonnet。调用 API 时,官方模型总览建议多数工作先用 Opus 5.5,把分类、抽取、路由、子代理这类窄而量大的任务交给 Haiku 5.5,只有 Opus 5.5 调高推理强度(effort)后仍达不到要求才上 Fable 5.1。两条建议并不矛盾:App 按用量额度计,越强的模型额度消耗越快;API 按 token 计费,Opus 5.5 的默认设置本来就面向长时间运行的代理和知识工作。
换档前别只看每百万 token 的标价。Opus 5.5 的标价是 Haiku 5.5 的 40 倍,但按 Artificial Analysis(下称 AA)在各自 API 默认推理强度下的数据,每道评测任务的成本是 Haiku $0.05、Sonnet $0.88、Opus $1.34、Fable $3.91,对应 34、47、51、51 分,Fable 5.1 在任何分数档上都不是最省钱的选择。想要更好的结果,先把当前模型的推理强度调高一档,往往比直接换模型便宜。
Claude 最新模型有哪四档:Haiku、Sonnet、Opus、Fable 的区别
四档的基础规格相同:都支持 100 万 token 上下文、单次同步输出最多 12.8 万 token、文本和图片输入、工具调用,可靠知识截止都是 2026 年 6 月。真正的区别在定位、价格、默认推理强度和 App 套餐。下表截至 2026 年 10 月 26 日,来自 Anthropic 模型总览、Claude API 定价页和 Claude Academy 的模型选择教程,价格单位是美元 / 每百万 token。
| 模型 | Claude API ID | Anthropic 的定位 | 相对速度标签 | API 默认推理强度 | 标价(输入 / 输出) | 缓存读取 | Claude App 套餐 |
|---|---|---|---|---|---|---|---|
| Haiku 5.5 | claude-haiku-5-5 | 大量、对延迟敏感的任务,如分类、抽取、路由 | Fastest | medium | $0.10 / $0.50(输入不超过 10 万 token) | $0.01 | Free 起可用,额度消耗最轻 |
| Sonnet 5.5 | claude-sonnet-5-5 | 速度与智能的最佳组合 | Fast | high | $2 / $10 | $0.10 | Free 起可用,消耗中等 |
| Opus 5.5 | claude-opus-5-5 | 长时间运行的代理编程和知识工作 | Moderate | medium | $4 / $20 | $0.20 | Pro 及以上,消耗较重 |
| Fable 5.1 | claude-fable-5-1 | 高难度推理和长周期代理工作 | Slower | high | $10 / $50 | $0.25 | 付费套餐,消耗最重 |
Haiku 5.5 的价格分两档:一次请求的输入超过 10 万 token 时,整次请求按 $0.50 / $2.50 计,缓存读取和缓存写入也算在这 10 万里面。四档的 Batch API 都是五折。速度标签是 Anthropic 在当前阵容里的相对排序,官方注明实际延迟取决于提示长度、输出长度和推理强度;在下文 10 月 26 日的同题测试里,按 API 默认设置,Sonnet 5.5 在 9 道题中有 8 道最先答完,Haiku 只快过一次。
模型 ID 都是固定快照,不会自动漂移到以后的版本。Amazon Bedrock 上的 ID 带 anthropic. 前缀(如 anthropic.claude-opus-5-5),Google Cloud、Microsoft Foundry 和 Claude Platform on AWS 用的是上表同样的 ID。Anthropic 承诺的最早退役时间是 Fable 5.1 2027 年 9 月 1 日、Opus 5.5 9 月 22 日、Sonnet 5.5 9 月 28 日、Haiku 5.5 10 月 7 日,合作云平台各自另定。另有一款 Claude Mythos 5.1,标价与 Fable 5.1 相同,但只对通过验证的机构开放,普通账号选不到。
Haiku 4.5、Sonnet 5、Opus 5、Fable 5 现在对应哪个型号
这四个是 2026 年 8 月的现役阵容,现在都列在 Anthropic 的旧版模型里,仍可以按原 ID 调用、按原价计费。同档的新型号要么更便宜,要么同价但缓存更便宜,所以没有特殊原因不必留在旧版上:
| 旧型号 | 旧型号标价(输入 / 输出) | 对应的现役型号 | 现役标价(输入 / 输出) | 变化 |
|---|---|---|---|---|
| Haiku 4.5 | $1 / $5 | Haiku 5.5 | $0.10 / $0.50(超过 10 万 token 为 $0.50 / $2.50) | 10 万 token 以内便宜 10 倍,超过只便宜 2 倍 |
| Sonnet 5 | $2 / $10,缓存读取 $0.20 | Sonnet 5.5 | $2 / $10,缓存读取 $0.10 | 标价相同,缓存读取减半 |
| Opus 5 | $5 / $25 | Opus 5.5 | $4 / $20 | 输入和输出都低 20% |
| Fable 5 | $10 / $50,缓存读取 $1 | Fable 5.1 | $10 / $50,缓存读取 $0.25 | 标价相同,缓存读取降到四分之一 |
Sonnet 5 原定 2026 年 9 月 1 日从 $2 / $10 恢复到 $3 / $15,Anthropic 已在定价页注明这次涨价不会发生,$2 / $10 成为它的标准价。Opus 5 的 $5 / $25 与 Opus 4.5 到 4.8 相同。更早的 Opus 4 和 Sonnet 4 已经退役,只在部分合作云平台上保留。Sonnet 5.5 的缓存读取在 10 月 7 日从 $0.20 降到 $0.10,缓存占比高的工作负载能省多少,见《Claude Sonnet 5.5 缓存读取价格降到 $0.10:省多少看缓存占比》。
起步选哪档:Claude App 先用 Sonnet,API 先用 Opus 5.5
在 Claude App 里,Sonnet 5.5 是 Anthropic 给的通用默认。Claude Academy 的模型选择教程写明:拿不准用哪个,就从 Sonnet 开始;Free 套餐包含 Haiku 和 Sonnet,Pro 和 Max 增加 Opus、Fable 和更多额度。四档消耗用量额度的程度依次是 Haiku 最轻、Sonnet 中等、Opus 较重、Fable 最重,但 Anthropic 没有公布具体的消耗倍数,所以没法换算成"用 Opus 一次等于用 Sonnet 几次"。
App 里换档的信号也写得很直接:用 Sonnet 试过、它确实吃力的问题交给 Opus,还有需要边看边追问、反复调整方向的深度研究;用 Opus 试过仍吃力的问题,以及步骤很多的长任务、要从大量原始材料里出结果的工作,交给 Fable。涉及部分生物和安全话题时,Claude 可能会换用别的模型回答,并会告诉你。各套餐的额度差别见《Claude Pro vs Max 怎么选(2026):价格、额度与 Claude Code 限制》。另外,Anthropic 公布的支持国家和地区列表不含中国大陆和香港,Claude App 和 Claude API 都是如此。
调用 API 时起点不同。Anthropic 的模型选择指南给了两条路线:效率优先,从 Haiku 5.5 开始,只在遇到具体能力缺口时升档,适合做原型、延迟要求严、对成本敏感、量大而简单的任务;能力优先,先用 Opus 5.5 把流程做通,再通过降低推理强度或换小模型来省钱,如果 xhigh 或 max 下的评测仍不达标,再换 Fable 5.1。Sonnet 5.5 在这份指南里的位置是"日常编程、代理和企业工作负载的速度与能力"。
App 和 API 的起点不一样,是因为两边受限的东西不一样。App 用户付的是固定订阅费,真正有限的是用量额度,Sonnet 在质量和额度之间最均衡;API 每次请求单独计费,而 Opus 5.5 默认推理强度只是 medium,在 AA 数据里比 Sonnet 5.5 默认的 high 高 4 分、每任务成本只多 52%($1.34 对 $0.88)。Haiku 5.5 的发布文章则把它的位置说得很清楚:复杂的代理编程仍是 Sonnet 5.5 和 Opus 5.5 更合适,Haiku 5.5 适合压缩上下文、摘要、子代理这类范围窄的任务;Anthropic 自己公布的 Terminal-Bench 4.0 成绩是 Haiku 5.5 39.2%、Opus 5.5 66.4%(xhigh),两者来自不同的发布文章和设置,只能看方向。
在 Claude Code 里,这个分工可以直接配置。Anthropic API 上的别名 opus 指向 Opus 5.5,haiku 从 v2.1.293 起指向 Haiku 5.5;Claude Code 的成本文档建议简单的子代理任务在子代理配置里写 model: haiku。内置的 Explore 子代理默认跟随主对话的模型,除非你建一个同名的 Explore 子代理并设 model: haiku,或设置 CLAUDE_CODE_SUBAGENT_MODEL 和 CLAUDE_CODE_SUBAGENT_MODEL_FORCE=1。在 Bedrock、Google Cloud 和 Foundry 上,haiku 别名会解析到更早的版本,要写全 claude-haiku-5-5。Claude Code 里 Opus 5.5、Sonnet 5.5 和 Haiku 5.5 的默认推理强度都是 medium,其中只有 Sonnet 5.5 与 API 默认的 high 不同;会话中途用 /model 换模型,会在没有缓存命中的情况下重新读入整段对话。
图中是 2026 年 8 月的型号阵容,正文已按 2026 年 10 月 26 日的现役型号更新。
往上或往下换一档,同等质量下多花多少钱
每百万 token 的标价倍数和每个任务的成本倍数是两个数。按标价,Sonnet 5.5 是 Haiku 5.5 的 20 倍,Opus 5.5 是 40 倍,Fable 5.1 是 100 倍(Haiku 按 10 万 token 以内那一档算);但每个任务的实际花费还取决于模型写了多少输出 token,思考过程也计入输出。AA 公布了四档在五级推理强度下的分数和每任务成本,2026 年 10 月 26 日用这 20 组配置复算,找出每个分数档最便宜的配置:
| AA 智能指数达到 | 最便宜的配置 | 每任务成本 | 每任务用时 |
|---|---|---|---|
| 34 | Haiku 5.5 medium | $0.05 | 119 秒 |
| 41 | Haiku 5.5 xhigh | $0.12 | 291 秒 |
| 47 | Sonnet 5.5 high | $0.88 | 217 秒 |
| 51 | Opus 5.5 medium | $1.34 | 198 秒 |
| 54 | Opus 5.5 high | $1.82 | 282 秒 |
| 56 | Opus 5.5 xhigh | $3.46 | 494 秒 |
| 58 | Opus 5.5 max | $5.98 | 791 秒 |
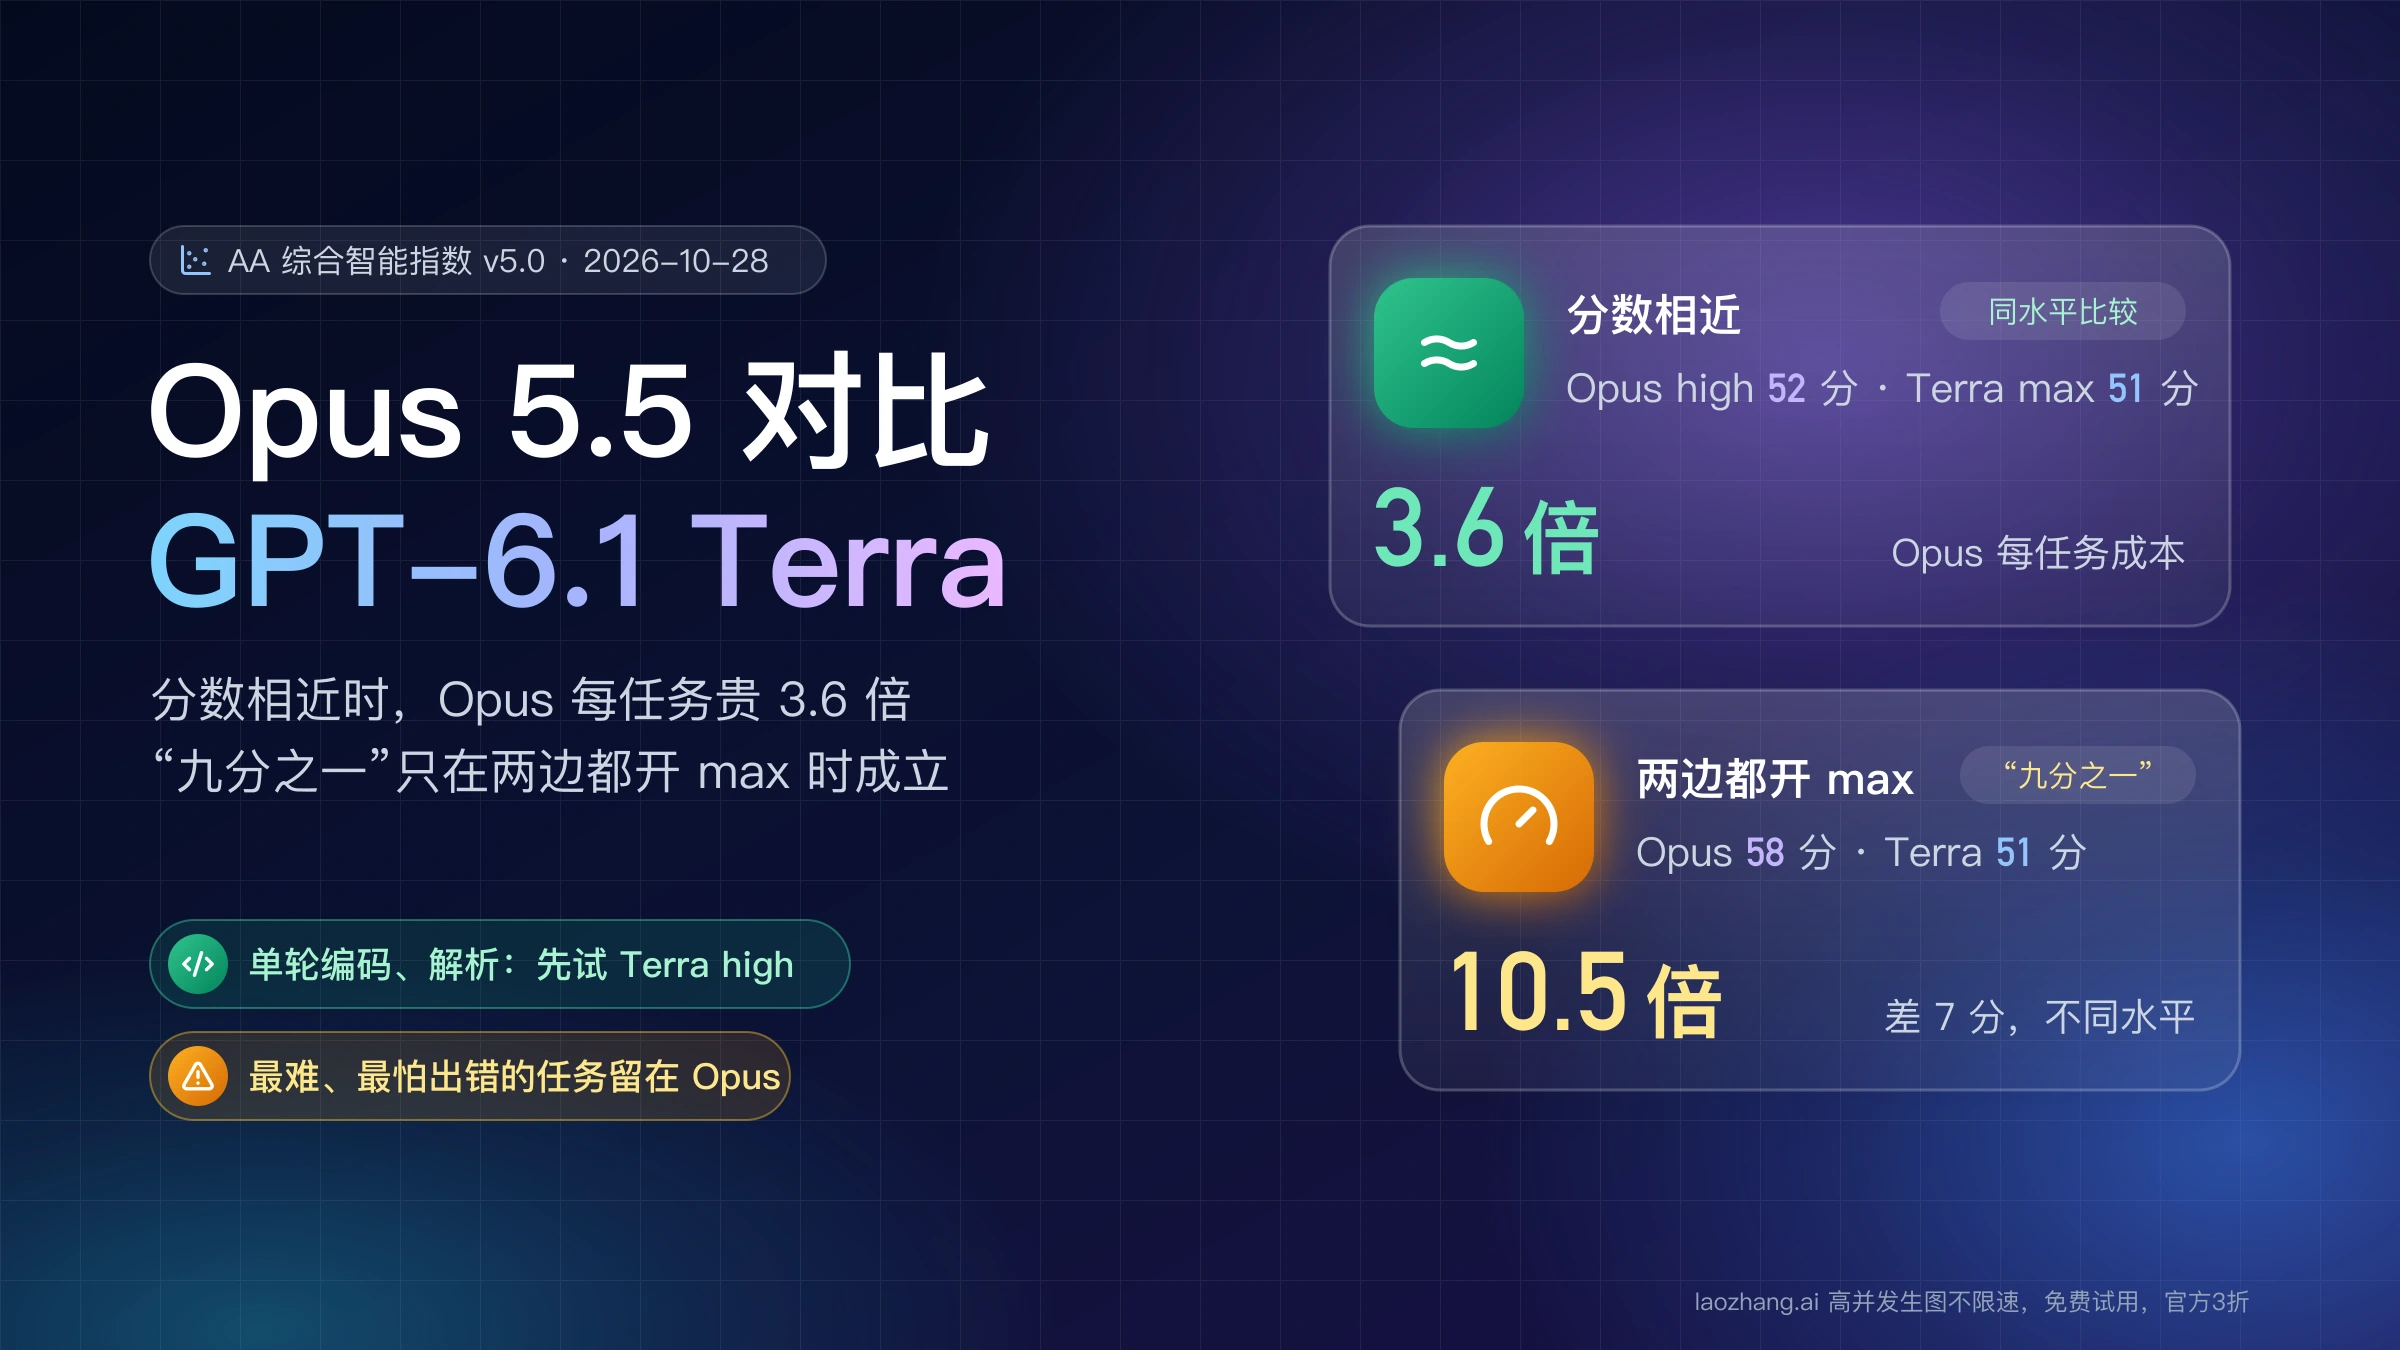
按这张表,从 Haiku 默认设置升到 Sonnet 默认设置,分数高 13 分,每任务成本是 17.6 倍;从 Sonnet 默认升到 Opus 默认,只高 4 分,成本是 1.52 倍。51 分以上的每一档,最便宜的都是 Opus 5.5。各档推理强度开到 max 的上限分别是 Haiku 43、Sonnet 56、Opus 58、Fable 53。Fable 5.1 默认的 high 和 Opus 5.5 默认的 medium 都是 51 分,Fable 的每任务成本是 2.92 倍、用时是 2.09 倍。数据来自 AA 的 Sonnet 5.5 与 Opus 5.5 对比页及同系列的 Haiku、Fable 对比页,AA 指数是 10 项评测的平均,会盖住单项差距,所以它说明的是"平均意义上 Fable 不划算",不排除 Fable 在某类任务上确实更强。Fable 的溢价什么时候值得,见《Claude Fable 5.1 和 Opus 5.5 怎么选?性能、价格与切换建议》。
如果你更关心固定大小的请求,可以直接按标价算:成本 = 各类 token 数 ÷ 1,000,000 × 对应单价,再相加。下面四个算例假设四档用掉的 token 一样多,不含 Batch 折扣和首轮缓存写入:
| 请求 | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| A:输入 1 万 + 输出 1,000,无缓存 | $0.0015 | $0.030 | $0.060 | $0.150 |
| B:代理一轮,缓存读取 9 万 + 新输入 5,000 + 输出 2,000 | $0.0024 | $0.039 | $0.078 | $0.1725 |
| C:同一轮,缓存读取增到 15 万 | $0.015 | $0.045 | $0.090 | $0.1875 |
| D:100 万次分类,每次输入 2,000 + 输出 300 | $350 | $7,000 | $14,000 | $35,000 |
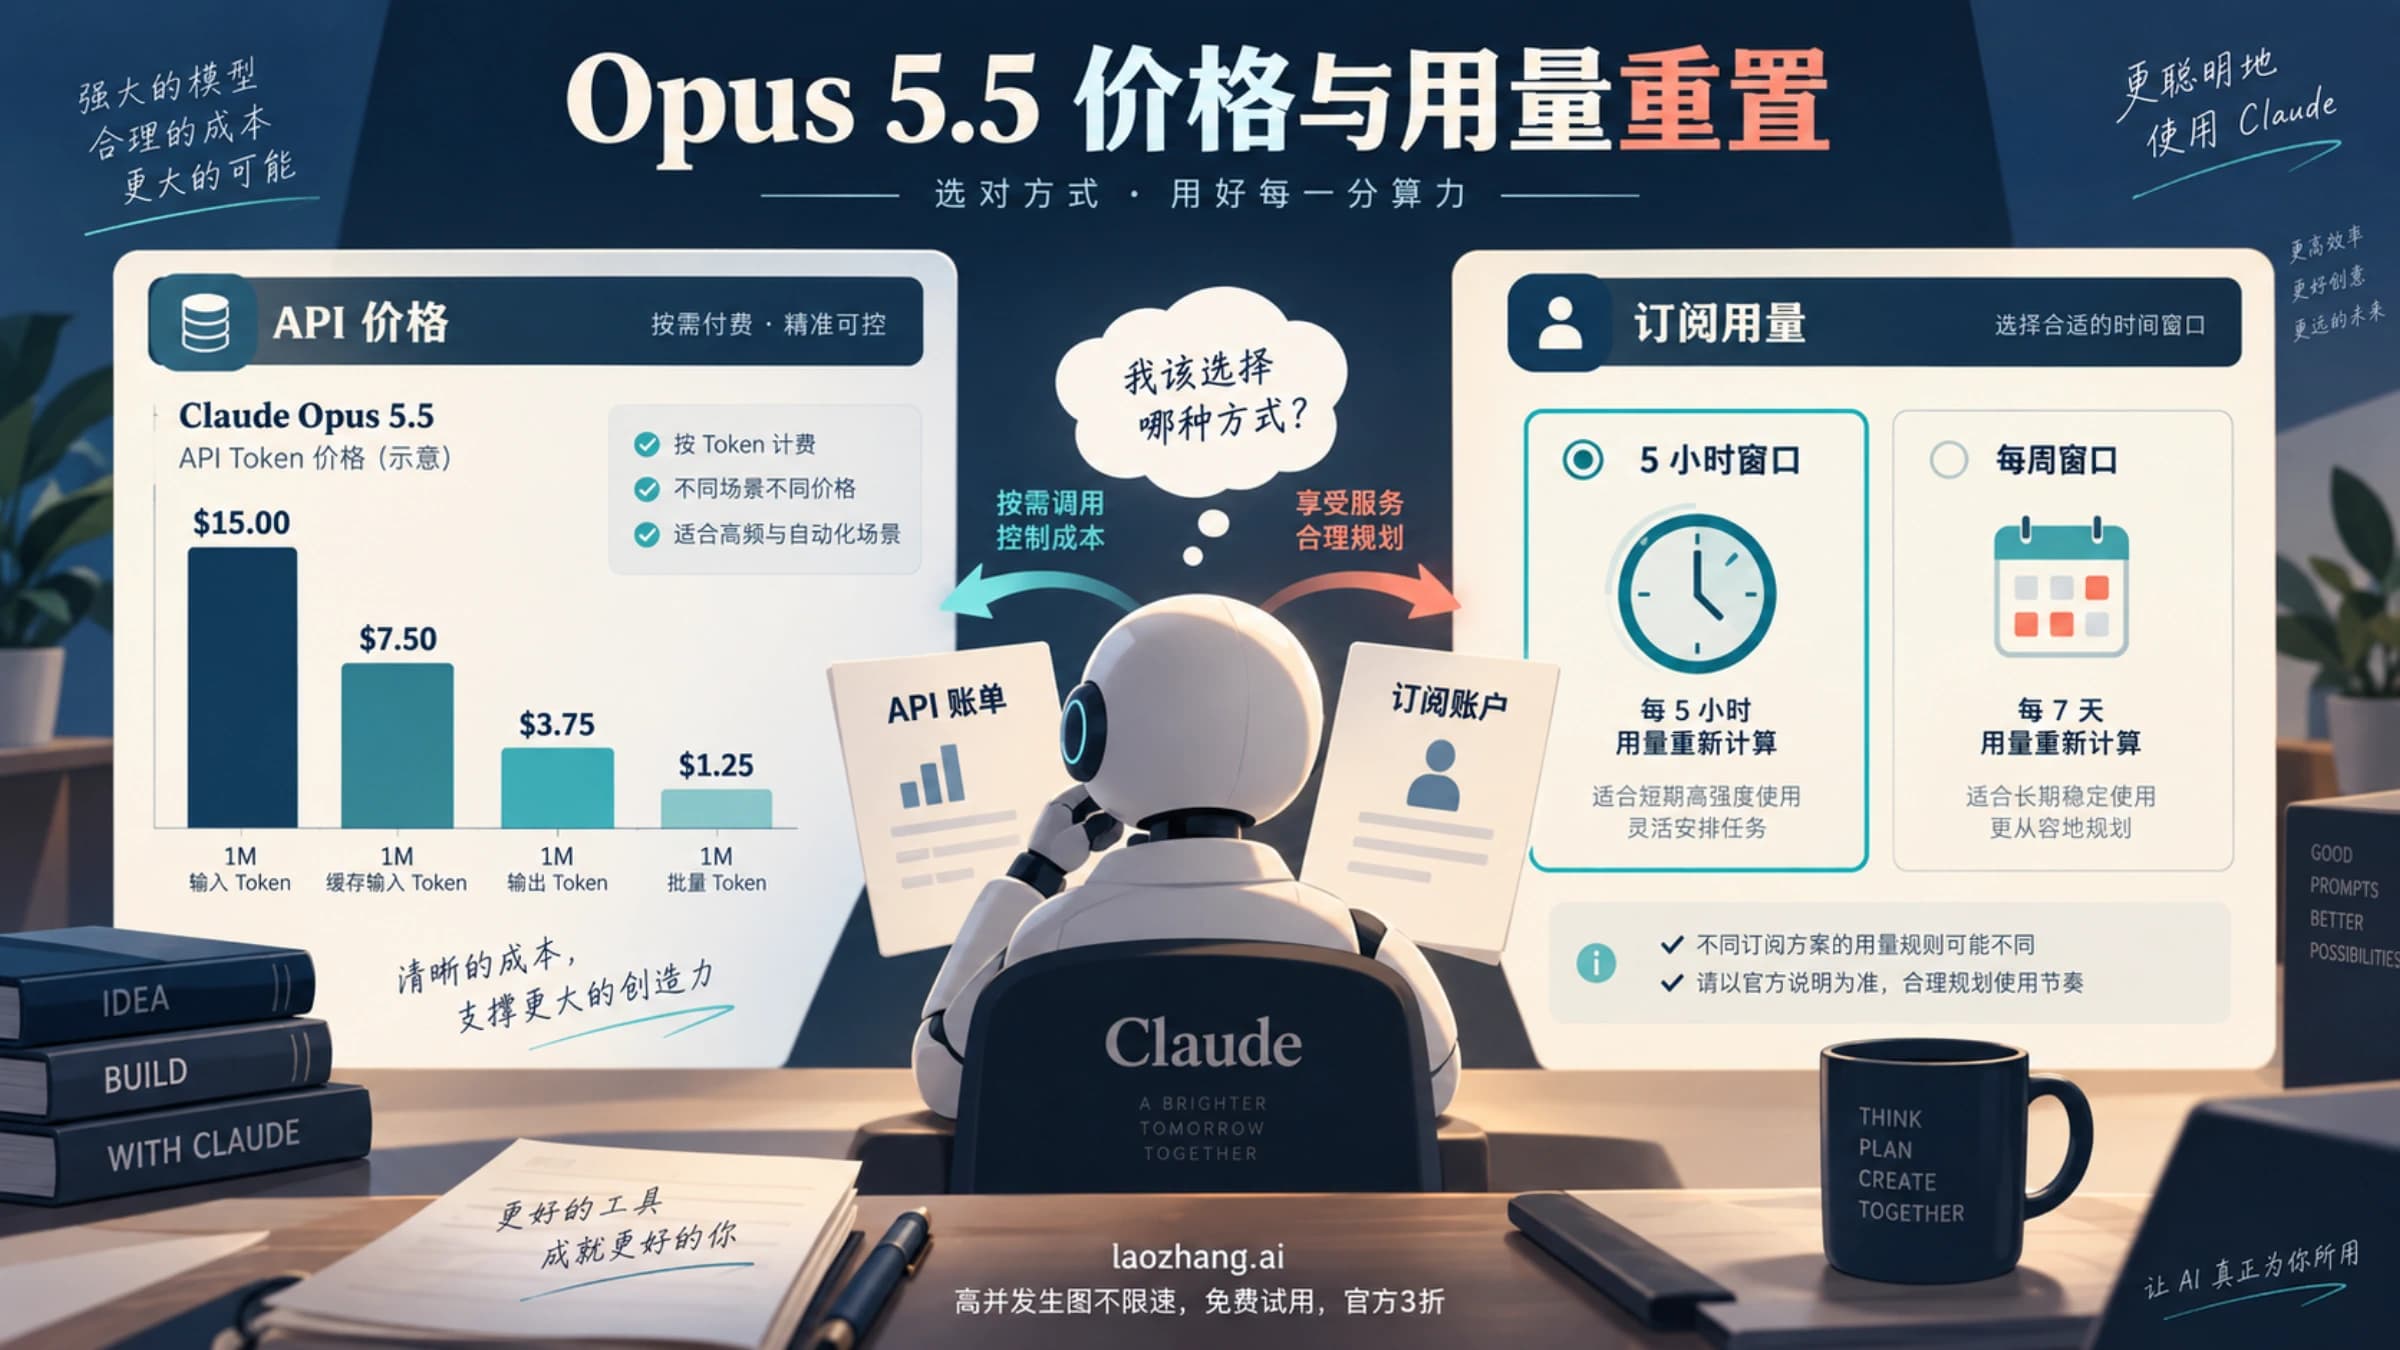
以 B 中的 Opus 为例:0.09 × $0.20 + 0.005 × $4 + 0.002 × $20 = $0.018 + $0.020 + $0.040 = $0.078。C 和 B 只差 6 万 token 的缓存读取,但 Haiku 的输入总量越过了 10 万,整次请求改按高价档计,成本从 $0.0024 跳到 $0.015,是 6.25 倍;Haiku 5.5 会把前几轮的思考块当作输入带下去,长对话的代理循环比你预想的更早碰到这条线。D 这类量大而简单的任务,档位差距直接放大成账单差距,是最值得先试 Haiku 的地方。Opus 5.5 账单的完整算法和用量重置,见《Claude Opus 5.5 价格与用量重置:API 账单怎么算,重置卡怎么用》。
同一组 9 道题实测:三档都通过,Opus 的成本约是 Haiku 的 31 倍
2026 年 10 月 26 日,用 Haiku 5.5、Sonnet 5.5 和 Opus 5.5 各跑了同一组 9 道题。请求通过老张 API(laozhang.ai)的 Anthropic Messages 接口以流式方式发送,该平台对这三个模型的报价与 Anthropic 标价相同,成本按返回的 token 用量乘以标价计算。请求里不设推理强度和思考参数,也不加系统提示,所以三档都按 API 默认值运行:Haiku medium、Sonnet high、Opus medium。题目和判分标准在看答案之前就已固定:一道应用题、五个带隐藏测试的 Python 函数、把一篇 6,723 词的文章压成恰好 5 条每条不超过 25 词的要点、一道组合计数题,以及修复一个埋了 5 个错误、缺 2 个函数的 billing.py(36 个隐藏测试)。每道题只跑一次。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
| 模型(API 默认推理强度) | 9 题通过 | 合计成本 | 合计用时 | 输出 token |
|---|---|---|---|---|
Haiku 5.5(medium) | 9 / 9 | $0.0087 | 74.9 秒 | 13,843 |
Sonnet 5.5(high) | 9 / 9 | $0.0866 | 50.6 秒 | 5,061 |
Opus 5.5(medium) | 9 / 9 | $0.2695 | 103.5 秒 | 9,875 |
三档的输入都是 18,003 token,成本差几乎全来自输出。Sonnet 的输出标价是 Haiku 的 20 倍,实际花费只有约 10 倍,因为 Haiku 写出的输出 token(含思考)是 Sonnet 的 2.74 倍;Opus 的标价是 Sonnet 的 2 倍,实际花费是 3.11 倍,因为它写了 Sonnet 1.95 倍的 token。速度也一样:Haiku 每秒生成的 token 最多(AA 测得 173 到 234 token/秒,Sonnet 为 105 到 134),但写得多,所以 9 道题里 Sonnet 有 8 道最先答完,Opus 9 道都最慢。输入最长的那道摘要题(15,335 个输入 token)三档分别是 $0.0024、$0.0335 和 $0.0916,输入占了大头,倍数就接近输入标价的倍数。
这组测试能说明的范围很窄。题目小而定义明确,三档全部通过,所以它测的是"同样做对时花多少钱、多少时间",测不出谁更聪明,不能读成"Haiku 和 Opus 一样好",质量差距仍以 AA 这类大样本评测为参照。每题只有一个样本,只走了一个接口,只在一天内跑;Fable 5.1 没有测,Anthropic 官方接口、改动推理强度、提示缓存和 Claude App 也都没有测。
Opus 和 Sonnet 的区别:什么时候该从 Sonnet 5.5 换到 Opus 5.5
已经能被 Sonnet 5.5 做好的任务,留在 Sonnet 更省;Sonnet 反复做不好,或者你开始把 Sonnet 的推理强度往 xhigh 调的时候,就该试 Opus 5.5 了。两者的标价差 2 倍($2 / $10 对 $4 / $20,缓存读取 $0.10 对 $0.20),定位上 Sonnet 是速度与智能的组合,Opus 面向长时间运行的代理编程和知识工作。各自默认设置下,AA 指数 Sonnet 47、Opus 51,每任务成本 $0.88 对 $1.34,Opus 每任务用时反而略短(198 秒对 217 秒);上一节的 9 道小题两者都做对了,Opus 花了 3.11 倍的钱,而且每道都更慢。
换档点藏在推理强度里。Sonnet 5.5 调到 xhigh 是 52 分、每任务 $2.01,而 Opus 5.5 的 high 是 54 分、$1.82,分数更高还更便宜;Sonnet 开到 max 是 56 分、$5.46,Opus 的 xhigh 同样 56 分只要 $3.46。也就是说,一旦 Sonnet 的默认 high 不够用,再往上加推理强度不如直接换 Opus。反过来,如果你的任务在 Sonnet medium(41 分、$0.48)下就能通过,把 Sonnet 的推理强度调低比换任何模型都省。
对话进行到一半升档也有讲究。在 Claude API 和 Google Cloud 上,Opus 5.5 能读取 Sonnet 5.5 和 Haiku 5.5 留下的思考块,所以从 Sonnet 升到 Opus 时,前面的推理会被保留;Sonnet 5.5 读不了 Opus 的思考块,往下换时这些内容会被静默丢弃,请求照常成功、也不计费,但模型看不到之前的推理。在 App 里,Opus 需要 Pro 及以上套餐,用量额度消耗也比 Sonnet 重。
先调推理强度(effort)再换模型:思考模式也会改变 token 用量
四档都支持 low、medium、high、xhigh、max 五级推理强度,默认值是 Opus 5.5 和 Haiku 5.5 为 medium,Sonnet 5.5 和 Fable 5.1 为 high,显式设成默认值和不设效果一样。Anthropic 在模型选择指南里写道,调推理强度往往比换模型更有效。四档都使用自适应思考,由模型自己决定想多少,Opus 5.5 和 Fable 5.1 的思考始终开启;思考内容按输出 token 计费,所以调高一级会同时增加输出量、成本和等待时间,参数说明见 Anthropic 的推理强度文档。
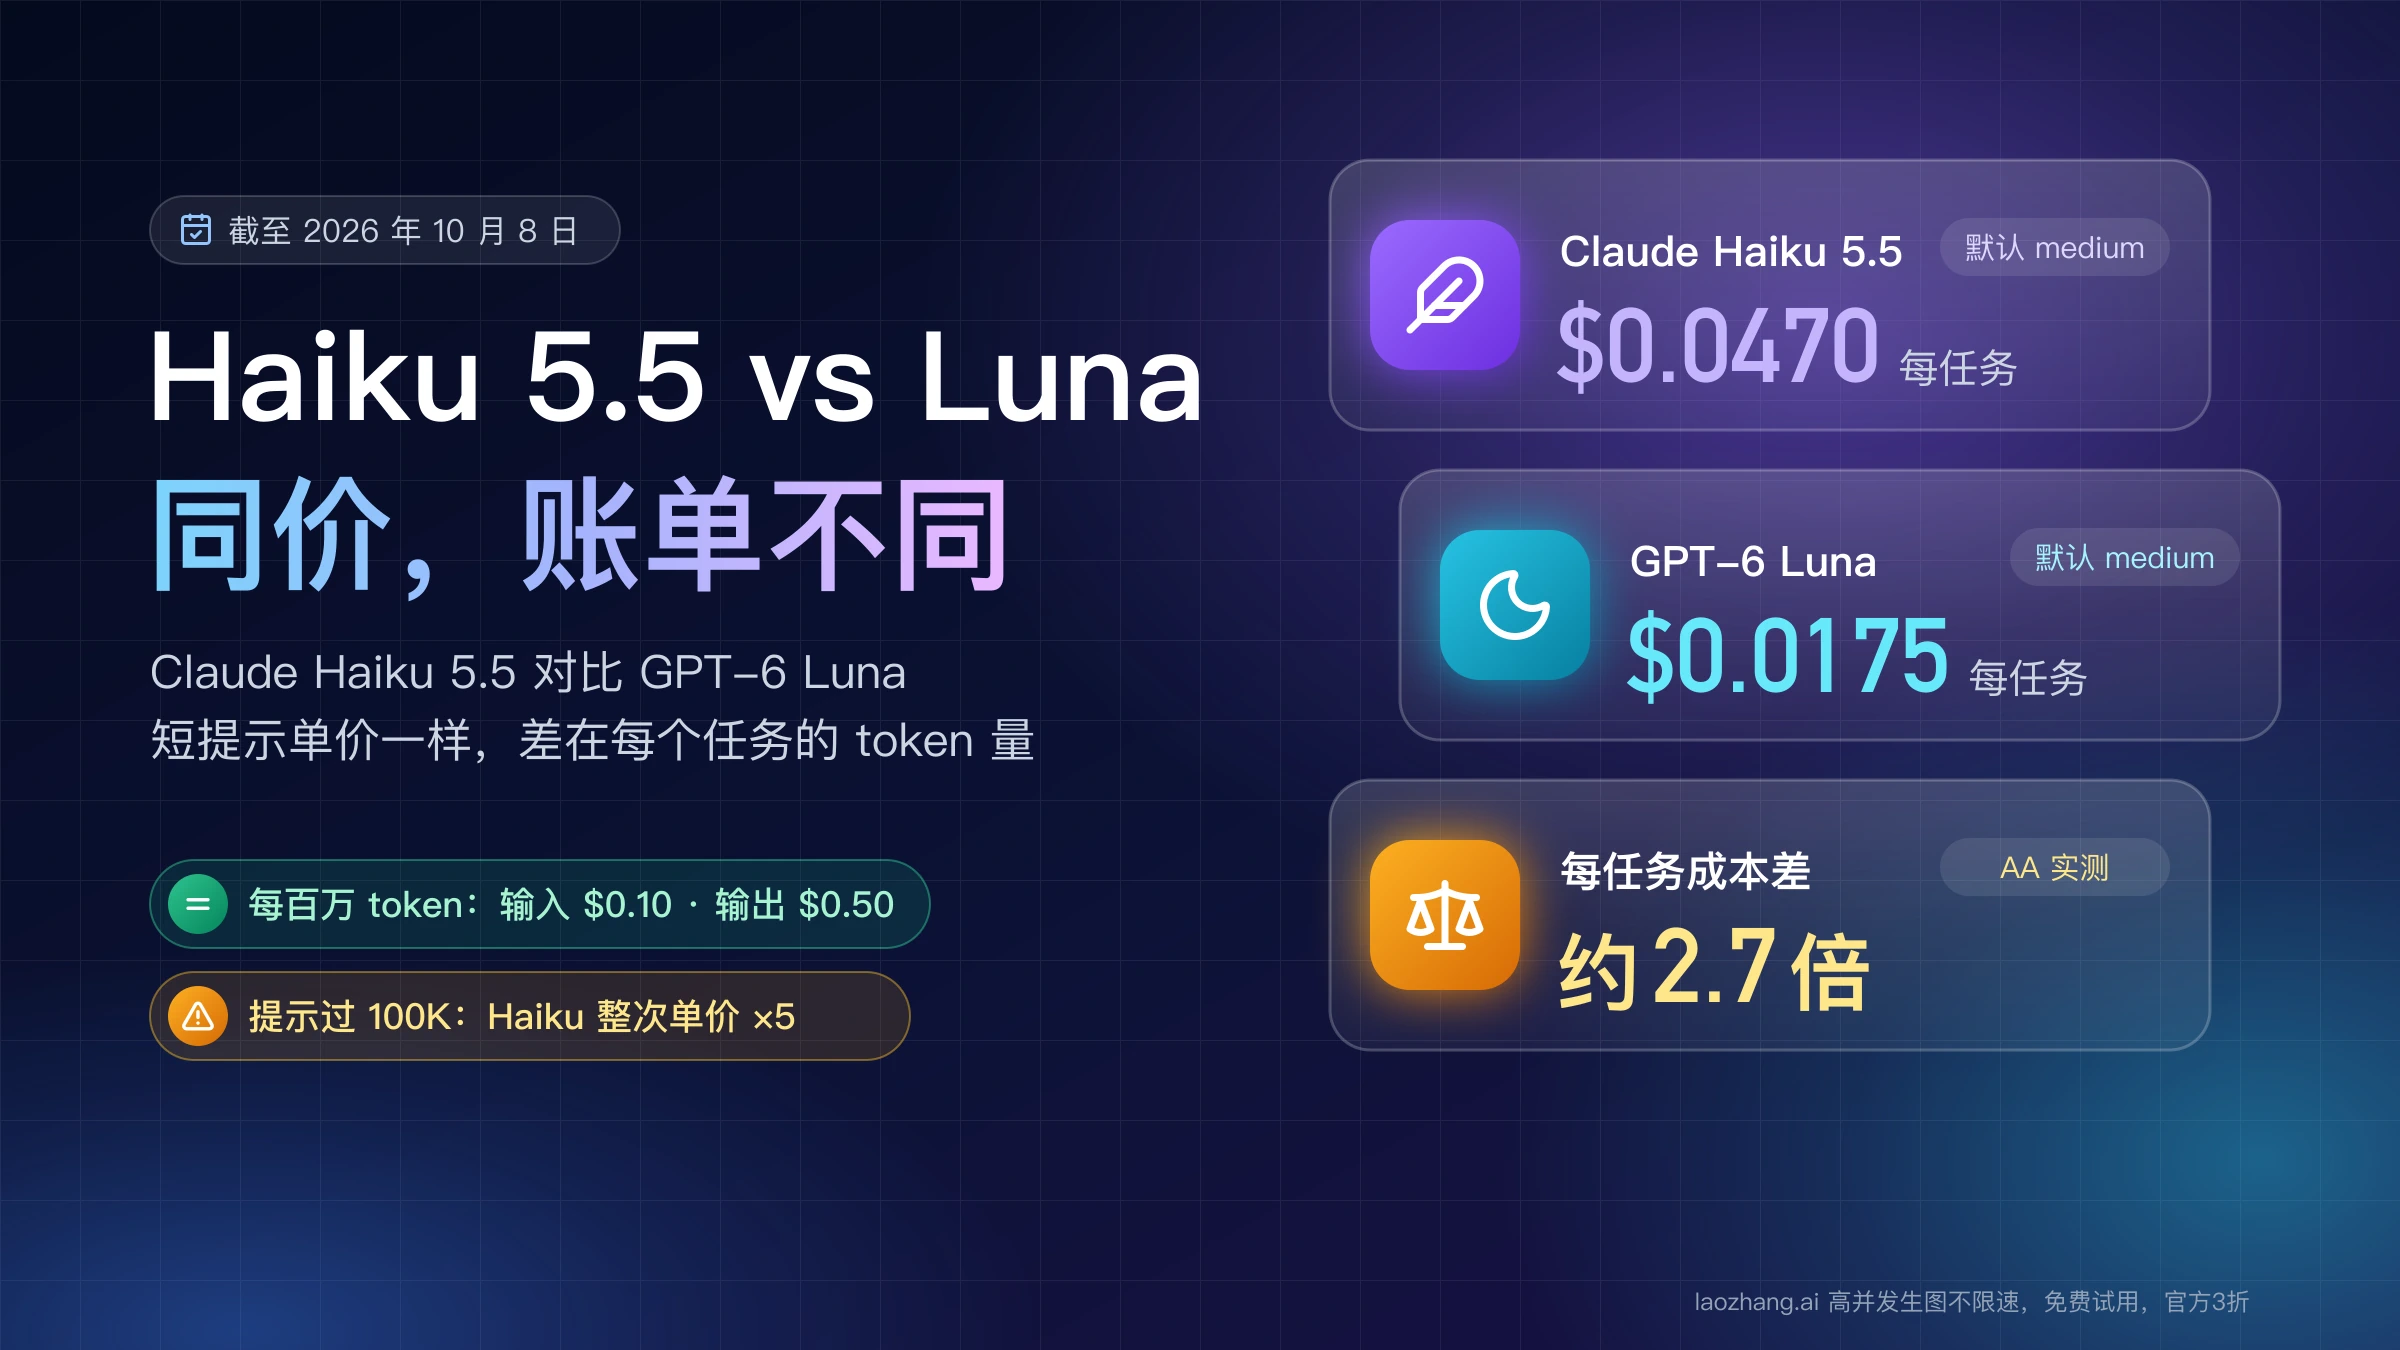
Haiku 是最能体现这一点的例子。Haiku 5.5 调到 xhigh 是 41 分、每任务 $0.12,和 Sonnet 5.5 medium 同分,成本只有它的四分之一($0.48)。Anthropic 对 Haiku 的建议是,只在评测确实显示有提升时才用 xhigh 或 max,并把结果和 Sonnet 5.5 比较性能、成本和速度;Haiku 开到 max 的上限是 43 分,任务需要更高时就该换 Sonnet。哪些 Sonnet 任务可以挪给 Haiku、怎么按任务算成本,见《Claude Haiku 5.5 和 Sonnet 5.5 区别:标价差 20 倍,同分只差 5 倍》。
App 的模型选择器里也有推理强度设置。Claude Academy 的说法是:默认级别适合大多数工作,调低能更快拿到回答、少用额度,最高级别留给最难的问题。所以在 App 里,Sonnet 回答不够好时,先把它的推理强度调高试一次,再决定要不要换到额度消耗更重的 Opus。
判断该换模型而不是继续加推理强度,看两个信号:一是当前模型加一级推理强度的成本,已经超过上一档用某一级推理强度达到同样或更高分数的成本,Sonnet xhigh(52 分、$2.01)对 Opus high(54 分、$1.82)就是这种情况;二是当前模型开到 max 仍不够,Haiku 的上限是 43 分,Fable 5.1 的上限 53 分还低于 Opus 5.5 high 的 54 分。
换模型 ID 前先排除会直接报错或改账单的条件
只把 model 换成新 ID,请求也可能直接失败。下面这些行为来自 Anthropic 各型号的说明文档和模型选择指南,截至 2026 年 10 月,适用于 Claude API:
| 请求里的写法 | 受影响的型号 | 结果 | 改法 |
|---|---|---|---|
tool_choice 设为 any 或 tool(强制调用工具) | Opus 5.5、Sonnet 5.5 | 400:tool_choice: type "tool" and "any" are not supported for this model. | 改用 auto,配合严格工具调用(strict tool use) |
thinking: {"type": "disabled"} | Opus 5.5、Sonnet 5.5 | 400 | Opus 5.5 思考始终开启;Sonnet 5.5 改用 {"type": "between_tools"},只在 low、medium、high 下可用 |
手动设置 budget_tokens | 四档都受影响 | 400 | 删除,改用推理强度控制思考深度 |
非默认的 temperature、top_p、top_k,或在 assistant 消息里预填内容 | 从 Haiku 4.5 换到 Haiku 5.5 | 前者 400,预填报错 | 删除这些参数;Haiku 5.5 在 high 及以下可以关闭思考 |
电脑操作工具 computer_20251124 | Opus 5.5 | 被拒绝 | 发给 Opus 5.5 的请求里不要带这个工具版本 |
不报错、但会改账单的条件也要先查。Haiku 5.5 的 10 万 token 门槛把缓存读写都算进输入,长对话代理循环最容易越线。当前四档都使用 Opus 4.7 引入的 tokenizer,从更早的型号(如 Haiku 4.5)换过来,同样的文本会切出更多 token:按模型总览的换算,100 万 token 在新 tokenizer 下约合 55.5 万英文单词,在旧 tokenizer 下约 75 万。中文、代码和结构化数据要用自己的真实输入重新统计,再调整限额和预算告警。
固定快照、退休日期和云平台也要分开核对。从 4.6 代开始,不带日期的 ID 本身就是固定快照,不会自动指向新版本;上面的退休时间只适用于 Anthropic 自己运营的平台,Amazon Bedrock、Google Cloud 等合作平台有各自的型号命名和生命周期,迁移时要查对应平台的文档。
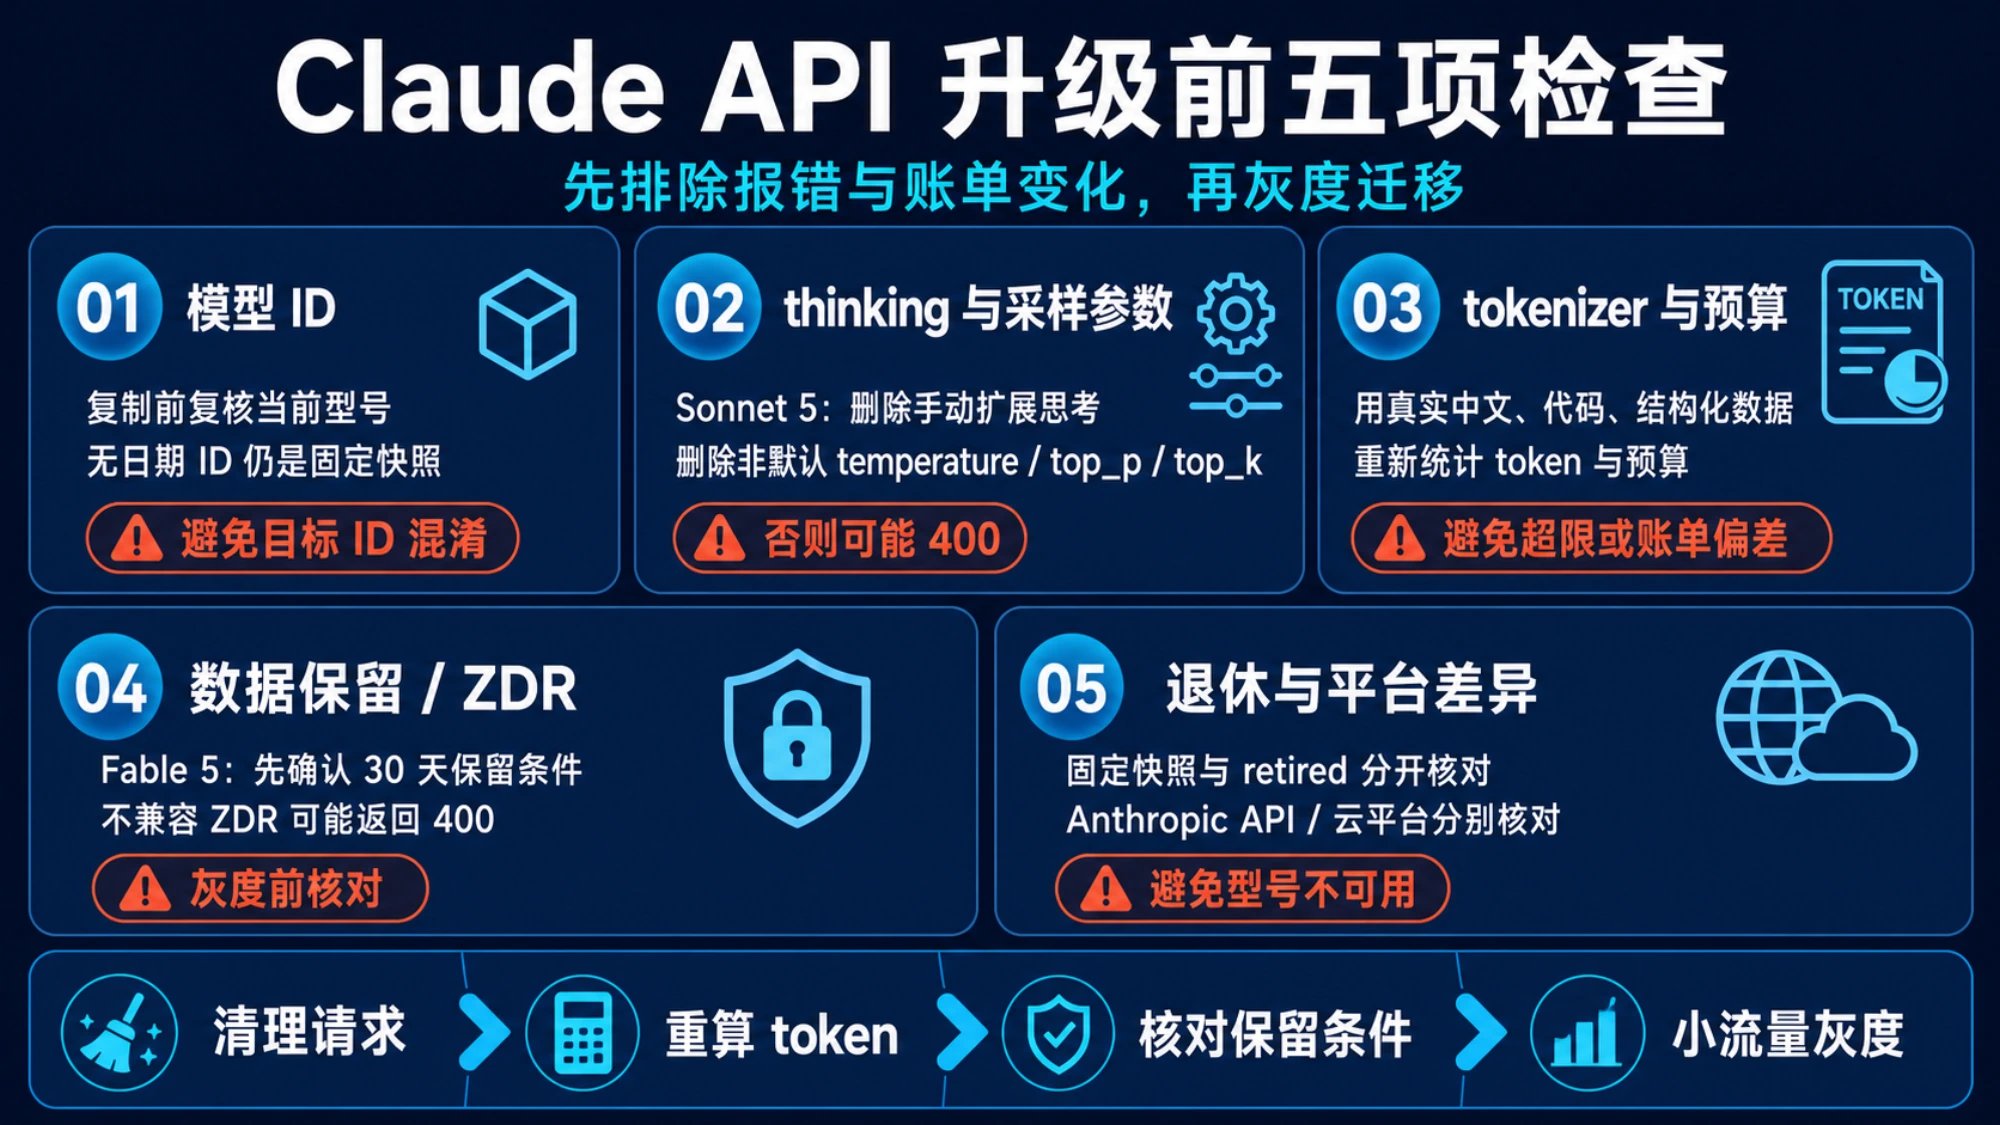
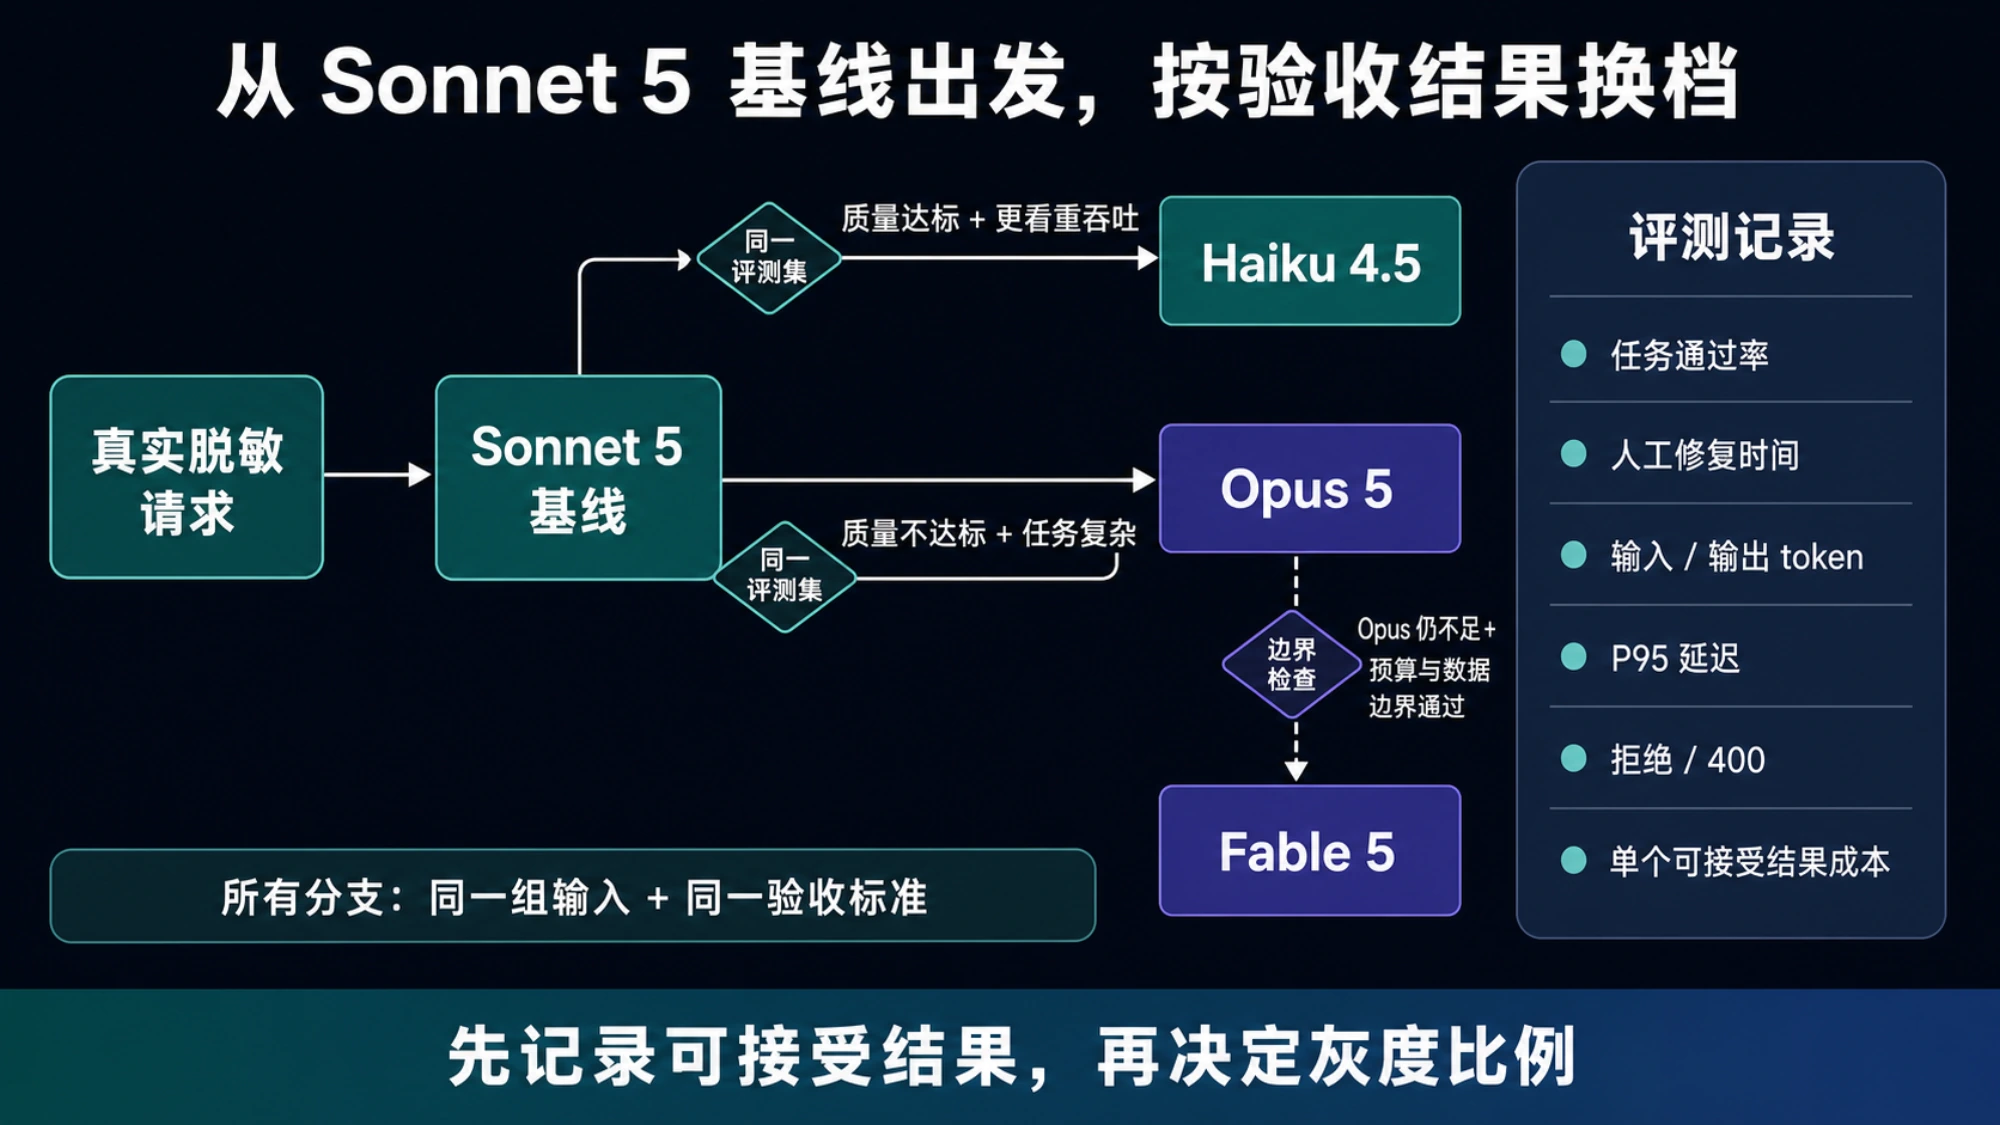
图中是 2026 年 8 月的型号阵容,正文已按 2026 年 10 月 26 日的现役型号更新。
当天用自己的任务做一次最小评测,再决定灰度比例
上面的同题测试只回答了"都做对时花多少钱",真正拉开档位差距的是你自己的难题。Claude App 用户可以照 Claude Academy 的做法:把同一个提示(例如"用五条要点总结附件报告,再指出其中你最想找第二个来源核实的一条说法")先给 Haiku、再给 Sonnet,比较两者答案不同的地方,而不是比谁写得长。调用 API 时,可以按下面的顺序当天跑完一轮:
- 从真实流量里抽一组脱敏请求,在看答案之前先定好判定标准,比如测试用例、字段校验或人工打分规则。
- 用候选档位的默认推理强度各跑一遍,记录是否通过、输入和输出 token、用时,以及 400 报错或拒绝回答。
- 没通过的请求先把推理强度调高一级重跑,仍不通过再换上一档;已经通过的请求,试一次更便宜的下一档。
- 用"总花费 ÷ 通过的请求数"算每个合格结果的成本来比较,而不是比每百万 token 的标价。
- 按结果把流量分开:窄而量大的请求交给 Haiku 5.5,其余留在 Sonnet 5.5 或 Opus 5.5,只有 Opus 在
xhigh或max下仍失败的少数请求再试 Fable 5.1,先小比例灰度。
复制模型 ID 或更新预算之前,再打开 Anthropic 的模型总览和定价页看一眼当天的状态,上面的价格和型号截至 2026 年 10 月 26 日。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月26日。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月26日。
- 1.Anthropic 模型总览platform.claude.com/docs/en/about-claude/models/overview
- 2.Claude API 定价页platform.claude.com/docs/en/about-claude/pricing
- 3.Claude Academy 的模型选择教程academy.claude.com/tutorials/choosing-the-right-claude-model
- 4.Anthropic 的模型选择指南platform.claude.com/docs/en/about-claude/models/choosing-a-model
- 5.AA 的 Sonnet 5.5 与 Opus 5.5 对比页artificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-claude-opus-5-5
- 6.Anthropic 的推理强度文档platform.claude.com/docs/en/build-with-claude/effort