Claude Sonnet 5.5 vs Gemini 3.8 Flash 对比:单价低 63% 未必更省
Gemini 3.8 Flash 单价比 Sonnet 5.5 低约 63%,同题实测都开 high 时总费用却是它的 2.4 倍:长文摘要省一半,难题贵近 4 倍。
文章目录
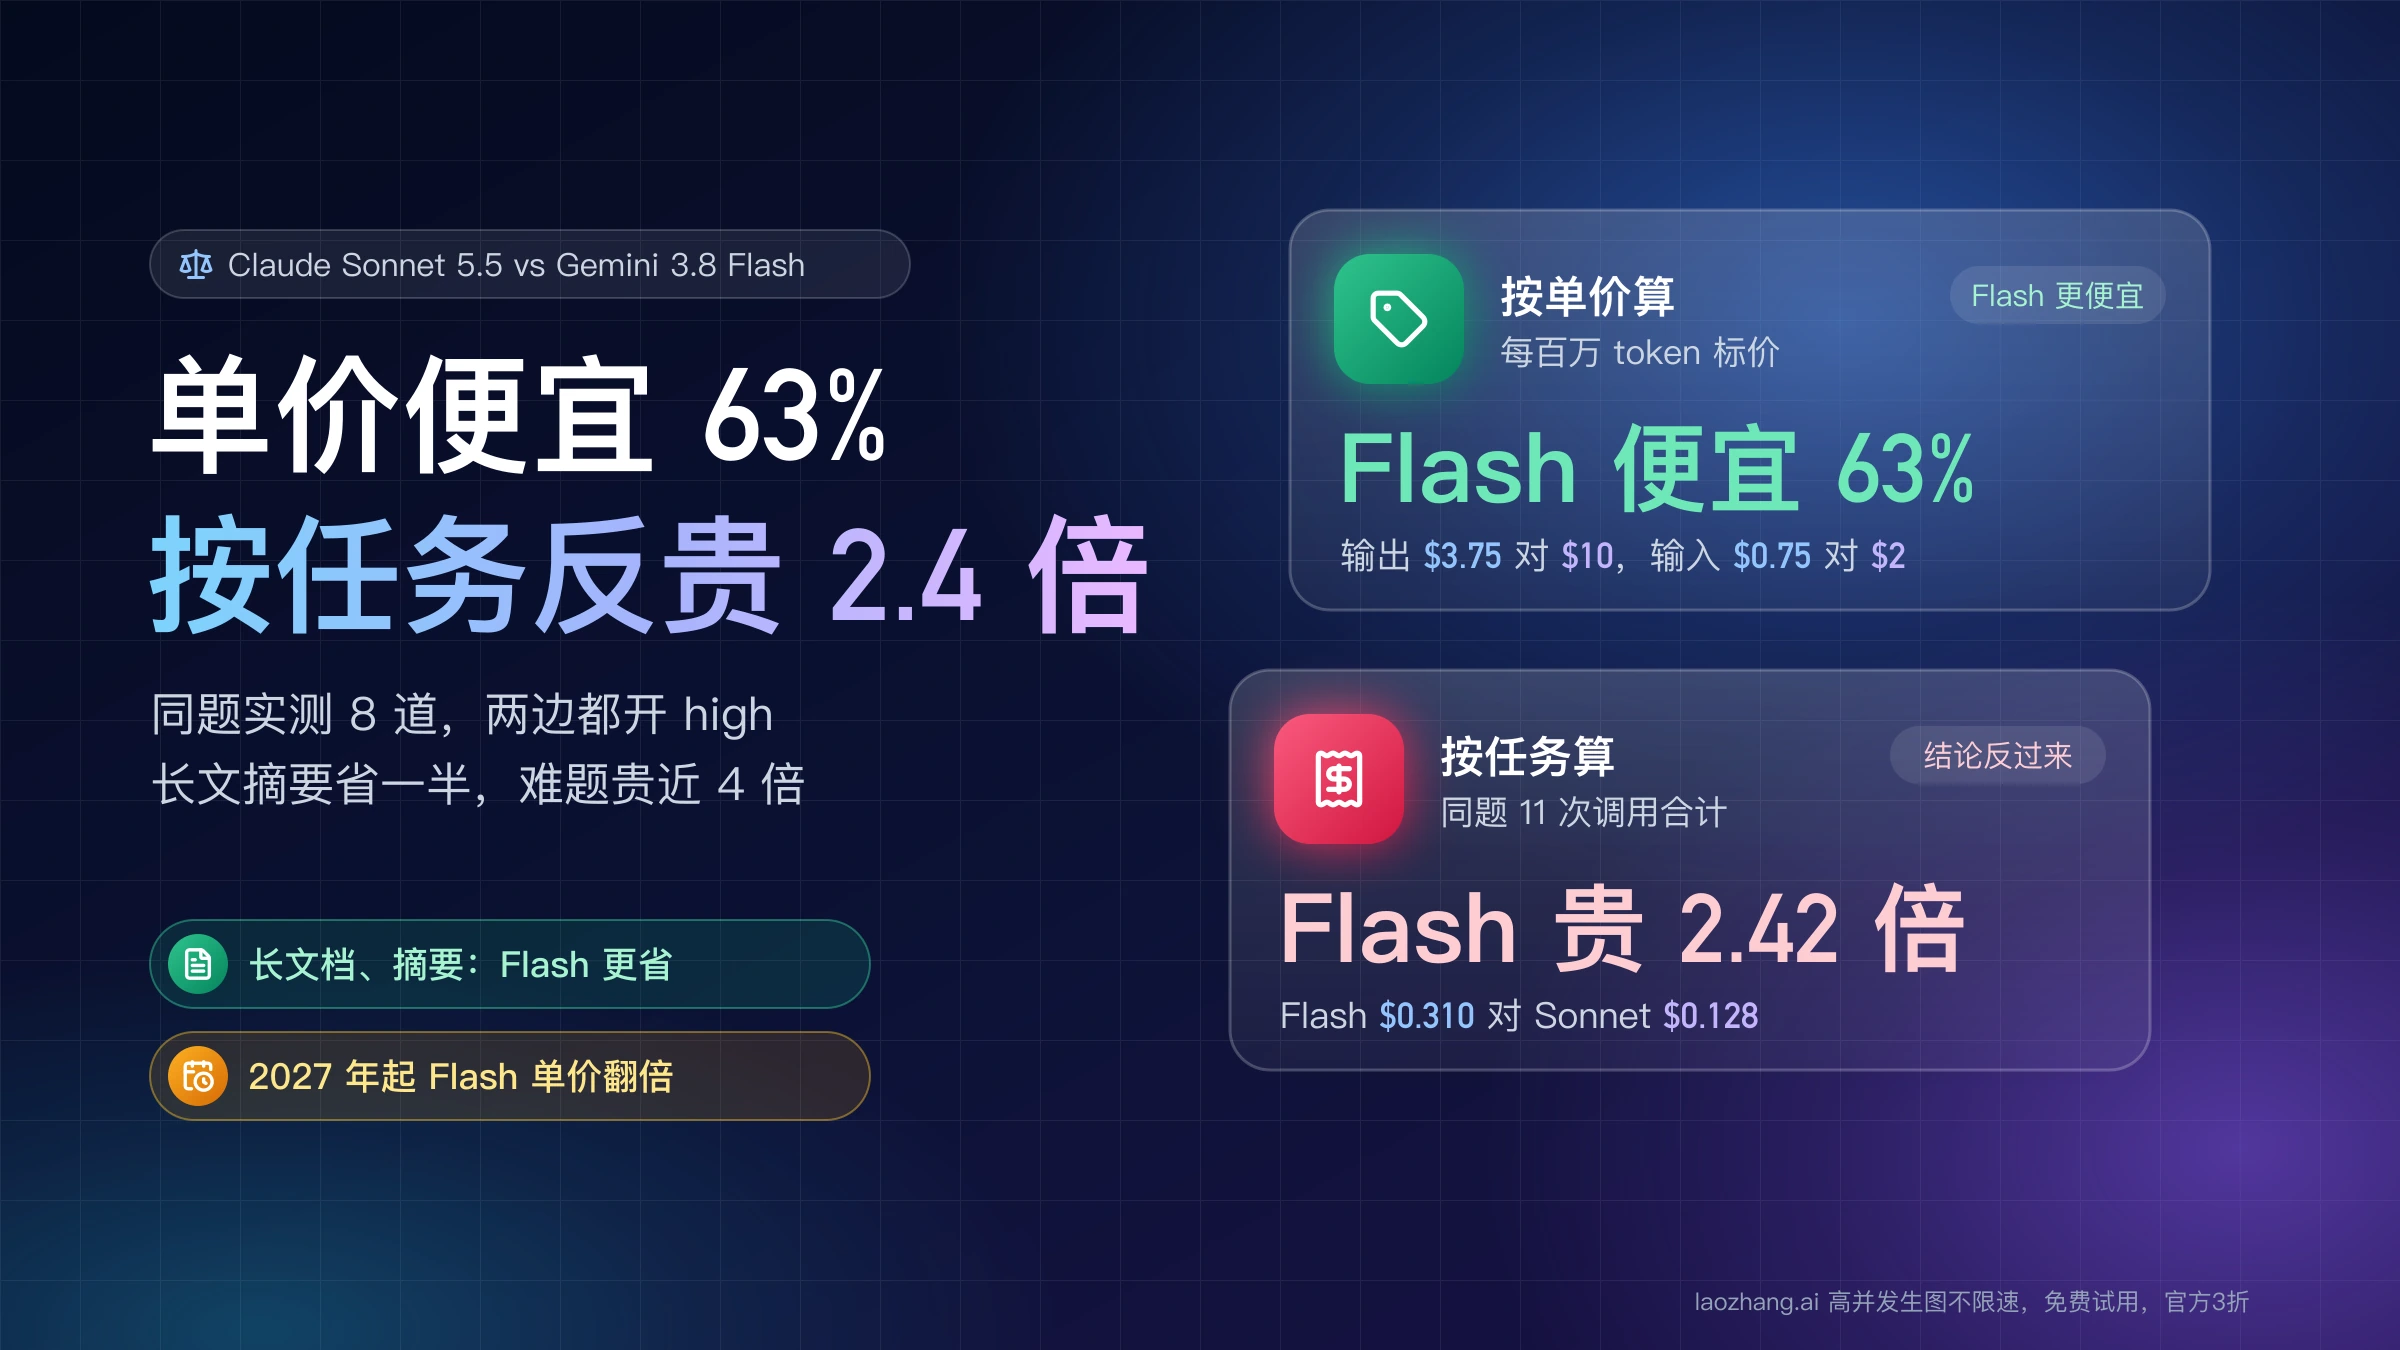
截至 2026 年 10 月 26 日,Gemini 3.8 Flash 的 API 单价比 Claude Sonnet 5.5 低约 63%(每百万 token 输入 $0.75 对 $2,输出 $3.75 对 $10),反过来说 Sonnet 是它的 2.67 倍;但按完成一个任务算,Flash 并不一定更便宜。同一天把 8 道题经同一个网关发给两个模型、两边都设成 high,22 个回答全部通过判分,Sonnet 5.5 一共花了 $0.128、86 秒,Flash 花了 $0.310、702 秒。Flash 只在输入很长、输出很短的长文摘要和一道简单代码题上便宜一半。
所以默认可以这样分:写代码、在终端里跑多步 Agent、需要较长推理的题目,默认用 claude-sonnet-5-5,effort 从 medium 或 high 起步;长文档阅读和摘要、知识类问答、视频和音频输入,交给 gemini-3.8-flash。Flash 的成本主要花在思考 token 上,它在一道表达式求值题上单次想了 30,721 个 token,单价再低也抵不住这个量。
这个分法有两个前提。一是 2027 年 1 月 1 日起 Flash 单价翻倍,同一批调用的费用会变成 Sonnet 的 4.84 倍,长文摘要上的优势也基本消失,Sonnet 的价格不变。二是实测题目都不难,两边全做对了,它只能说明成本和耗时;能力差距看 Artificial Analysis(下称 AA)的分项:Terminal-Bench 4.0 上 Sonnet high 43.9%、Flash high 19.7%,而长文档推理 AA-LCR 上 Flash high 81.3%,略高于 Sonnet high 的 78.0%。
2026 年 10 月 26 日同题实测:8 道题,两边都开 high
实测在 2026 年 10 月 26 日北京时间 11:41 到 11:55 之间完成,两个模型都通过 laozhang.ai 的 API 调用,同一个 key、同一个网关,标价与两家官方一致。Sonnet 5.5 走 Anthropic Messages 接口,设 output_config.effort: "high"(也是 Claude API 的默认值),不传 thinking 字段,由模型自适应决定思考多少;Flash 走 Gemini 原生 generateContent,设 thinkingConfig.thinkingLevel: "high"。两边的输出上限都是 32,000 token,没有系统提示词,没有工具,每次只发一条用户消息,返回的模型名每次都是 claude-sonnet-5-5 和 gemini-3.8-flash,没有报错也没有重试。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
8 道题里 5 道各跑一次,3 道较难的各跑两次,每个模型 11 次调用。代码题用事先写好的隐藏测试判分,应用题、计数题核对唯一答案,摘要题检查是否正好 5 条、每条不超过 25 个英文词。费用按返回的 token 数乘官方标价计算;难题两次的 token 分开列,费用和用时取平均,合计一行按 11 次实际调用相加。
| 题目与判分 | Sonnet 5.5 输入 / 输出 token | Sonnet 费用 | Sonnet 用时 | 3.8 Flash 输入 / 思考 + 回答 token | Flash 费用 | Flash 用时 | Flash 费用是 Sonnet 的 |
|---|---|---|---|---|---|---|---|
| 买笔应用题,答案 $41.50 | 86 / 704 | $0.0072 | 7.1 秒 | 61 / 1,716 + 355 | $0.0078 | 78.5 秒 | 1.08 倍 |
merge_intervals 合并区间,8 个隐藏测试 | 105 / 1,217 | $0.0124 | 9.3 秒 | 61 / 974 + 522 | $0.0057 | 25.6 秒 | 0.46 倍 |
parse_duration 解析时长,18 个 | 248 / 723 | $0.0077 | 7.5 秒 | 207 / 4,463 + 318 | $0.0181 | 30.5 秒 | 2.34 倍 |
top_words 词频统计,10 个 | 174 / 160 | $0.0019 | 3.0 秒 | 115 / 1,115 + 130 | $0.0047 | 27.2 秒 | 2.44 倍 |
| 6,723 词英文长文压成 5 条要点 | 15,335 / 277 | $0.0334 | 5.0 秒 | 11,198 / 1,733 + 154 | $0.0155 | 14.3 秒 | 0.46 倍 |
eval_expr 不用 eval 求值,25 个,两次 | 314 / 1,816、1,849 | $0.0190 | 13.7 秒 | 212 / 14,876 + 730、30,721 + 809 | $0.0885 | 156.9 秒 | 4.67 倍 |
parse_csv_line 不用 csv 库,16 个,两次 | 244 / 880、432 | $0.0070 | 6.1 秒 | 159 / 4,175 + 371、6,167 + 371 | $0.0209 | 34.2 秒 | 2.97 倍 |
| 100 万以内数位和为 27 的数有几个,答案 55,252,两次 | 69 / 678、647 | $0.0068 | 7.0 秒 | 51~52 / 4,831 + 847、4,034 + 865 | $0.0199 | 71.9 秒 | 2.94 倍 |
| 合计,各 11 次调用 | 17,202 / 9,383 | $0.128 | 86 秒 | 12,487 / 74,805 + 5,472 | $0.310 | 702 秒 | 2.42 倍 |
Sonnet 的输出 token 已经包含它没有返回出来的思考部分,所以只有一个数;Flash 的用量会把思考和回答分开报。把题目按难度拆开看,前 5 道较简单的题 Sonnet 合计 $0.0627、Flash $0.0518,Flash 便宜 17%;3 道难题的 6 次调用 Sonnet $0.0655、Flash $0.2586,Flash 是 3.95 倍。Flash 便宜的两道,一道是长文摘要,Sonnet 的输入 token 多;另一道是合并区间,Flash 在这题只想了 974 个 token,思考加回答共 1,496 个,只是 Sonnet 含思考在内 1,217 个的约 1.23 倍,低于 2.67 倍的单价差,所以反而便宜。
这次测试的边界也要说清楚:一个网关、一天、多数题只有一个样本,只测了 high,没有跑 medium、low,也没有跑 Sonnet 的 xhigh、max;没有走 Anthropic 和 Google 的官方直连,没有测缓存、Batch、工具调用、多轮对话和多步 Agent 会话,题目和长文都是英文。用时是经网关的单次调用墙钟时间,不是测速。两边都把题做对了,所以它不说明谁在哪类任务上会失败,能力判断以下文 AA 的分项为准。
单价便宜 2.67 倍,为什么每题没便宜:思考 token 和分词器
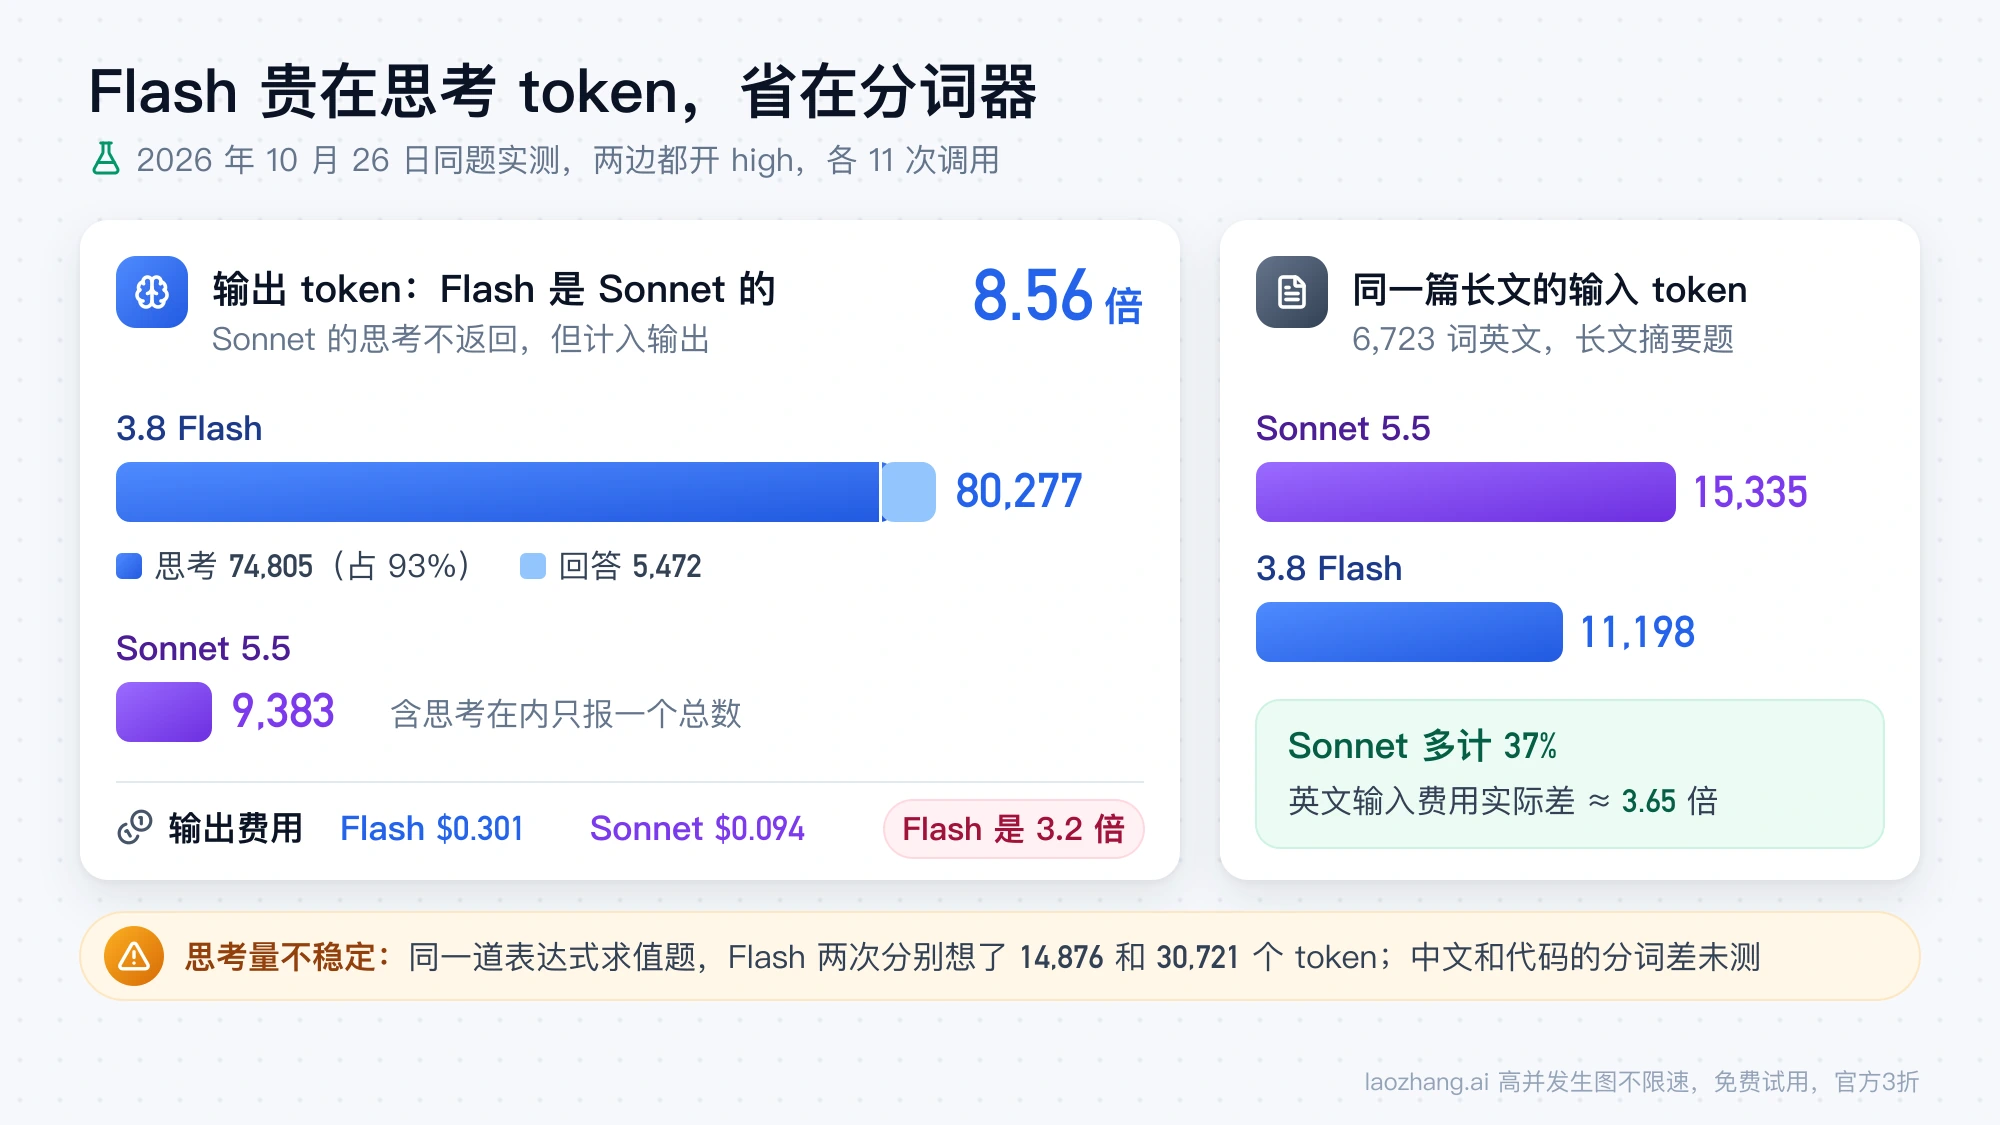
原因有两个,方向相反。主要的一个是 Flash 在 high 下的思考 token 多:11 次调用 Flash 一共输出 80,277 个 token,其中 74,805 个是思考,占 93%,真正的回答只有 5,472 个;Sonnet 包括思考在内一共只输出 9,383 个。Flash 的输出量是 Sonnet 的 8.56 倍,输出单价只低 2.67 倍,结果输出费用 Flash $0.301、Sonnet $0.094,Flash 反而是 3.2 倍。
思考量还很不稳定。表达式求值那道题,Flash 第一次想了 14,876 个 token,第二次想了 30,721 个,加上回答共 31,530 个,离 32,000 的输出上限只差 470 个;同一道题 Sonnet 两次都在 1,850 个以内。所以用 Flash 跑难题时,maxOutputTokens 要留足余量(3.8 Flash 最多可设到 65,536),预算也要按波动的上沿估。
第二个原因让差距朝 Flash 有利的方向偏:同一段文字,Anthropic 的分词器数出来的 token 更多。那篇 6,723 词的英文长文,Sonnet 计 15,335 个输入 token,Flash 计 11,198 个,多了 37%,短题也是同一个方向(买笔题 86 对 61)。所以在英文文本上,两边输入费用的实际差距大约是 2.67 × 1.37 ≈ 3.65 倍,而不是 2.67 倍,长文摘要这类输入长、输出短的任务 Flash 便宜一半,就是这个原因。中文文本和代码的分词差多少没有测过,不能直接套 37%。
想在自己的任务上复算,公式是:费用 = 输入 token × 输入单价 + 输出 token(含思考)× 输出单价,单价按每百万 token。以长文摘要为例,Flash 是 11,198 × $0.75 + 1,887 × $3.75,约 $0.0084 + $0.0071 = $0.0155;Sonnet 是 15,335 × $2 + 277 × $10,约 $0.0307 + $0.0028 = $0.0334。用量字段在两边不一样:Gemini 返回 thoughtsTokenCount 和 candidatesTokenCount,可以直接看思考占比;Sonnet 只返回一个 output_tokens,按 Anthropic 扩展思考文档,不传 thinking 时思考内容默认不返回(display 为 "omitted"),但照样按输出计费、计入 max_tokens,想看思考摘要要传 thinking: {"type": "adaptive", "display": "summarized"}。
Flash high 和 Sonnet 谁更靠谱:差在终端编程和职场任务
两边都开 high 时,Sonnet 5.5 整体更强,但差距集中在少数几类任务上。按 AA 的 Claude Sonnet 5.5 与 Gemini 3.8 Flash 全档位对比页(截至 2026 年 10 月 26 日,智能指数 v4.3.2),Sonnet high 的指数是 47,Flash high 是 41;拉开差距的主要是在终端里完成编程任务的 Terminal-Bench 4.0(43.9% 对 19.7%)、偏职场任务的 AA-Briefcase(1635 对 1202)和 GDPval-AA(1548 对 1436),以及 CritPt(24.6% 对 18.3%)。另一些项目 Flash 持平或略高:自动化流程 AutomationBench-AA 59.9% 对 59.4%,科学编程 SciCode 56.6% 对 53.7%,Humanity's Last Exam 47.8% 对 45.8%,知识问答 AA-Omniscience 30 对 21,长文档推理 AA-LCR 81.3% 对 78.0%,而 Flash 在 medium 下的 AA-LCR 是 84.0%,是两个模型 8 个档位里最高的。
要比"同样水平花多少钱",应该拿 AA 指数同为 41 的那一对:Sonnet 5.5 medium 和 Flash high。在 AA 的测试集上,Sonnet medium 每个任务平均 $0.48、121 秒,Flash high 是 $1.24、498 秒,Flash 花 2.6 倍的钱、4.1 倍的时间拿到同样的总分。分项上这一对也不完全一样:Terminal-Bench Sonnet medium 29.8% 仍高于 Flash high 的 19.7%,AA-LCR 则是 Flash 81.3% 对 76.3%,知识问答 30 对 20。AA 每任务成本是它那套偏长、偏难的测试题的加权平均,反映的是工作量对比,不是你的账单。
也有人直接拿 Flash high 和 Sonnet low 比。2026 年 10 月 11 日的 linux.do 体验帖《Gemini 3.8Flash high vs Sonnet 5.5 low》里,楼主用 Gemini Pro 订阅里的 Flash 做一个生成动态图的小任务,改了三四次只完成六成,最后一次没有输出,换到 Claude 免费版的 Sonnet 5.5(楼主说只有 low)一次做完;同一帖里也有人在 Codex 里用 Flash high 觉得够用,还有人认为论说话自然 Flash 更好。这些都是单人单任务的体验。按 AA 的数字,Sonnet low 的总分 36 低于 Flash high 的 41,但 Terminal-Bench 20.7% 和 Flash high 的 19.7% 基本持平,而每任务只要 $0.35、85 秒,对比 Flash high 的 $1.24、498 秒。
在别处看到 "Sonnet 5.5 Terminal-Bench 4.0 70.6%" 这类数字时,那是 Anthropic 在 Haiku 5.5 发布表里自己公布的结果,测试设置与 AA 不同,不能和上面 AA 的 43.9% 放在同一张表里比较。
哪个更快:每秒 token、首 token 和整题耗时不是一回事
如果"快"指的是拿到完整答案要等多久,Sonnet 5.5 更快:实测 8 道题每一道都是 Sonnet 用时更短,合计 86 秒对 702 秒;AA 的每任务耗时也是 Sonnet high 217 秒、Flash high 498 秒,Sonnet medium 只要 121 秒。原因和费用一样,Flash 在 high 下要先生成大量思考 token。
另外两种"快"的结论会反过来或互相矛盾。一种是生成时每秒吐多少 token:AA 测得 Flash high 137 token/秒、Sonnet high 106 token/秒,Flash 更快;但 OpenRouter 的 Claude Sonnet 5.5 与 Gemini 3.8 Flash 对比页(数据更新于 2026 年 10 月 5 日)按真实路由流量算,中位数是 Sonnet 108、Flash 52 token/秒,正好相反。两者的差别在于 AA 用自己的测试和固定档位,OpenRouter 统计的是各种调用方、各种设置下的混合流量。另一种是首 token 时间:OpenRouter 的中位延迟 Flash 2.14 秒、Sonnet 2.39 秒,相差很小;AA 按档位测的首 token 时间则是 Sonnet high 10.46 秒、medium 1.35 秒,Flash high 27.26 秒,因为思考时间算在首个可见 token 之前。
做聊天界面、要尽快出第一个字时,看首 token 时间,AA 测得 Sonnet 的 low 和 medium 都在 1.4 秒以内;做批处理、只关心总吞吐时,看整题耗时和费用;每秒 token 数单独看意义不大。Flash 在 Antigravity 里慢有另外几种原因,见 Gemini 3.8 Flash 在 Antigravity 中很慢?先分清四种卡顿再处理。
2027 年 1 月 1 日 Flash 涨价后:实测账单变成 Sonnet 的 4.84 倍
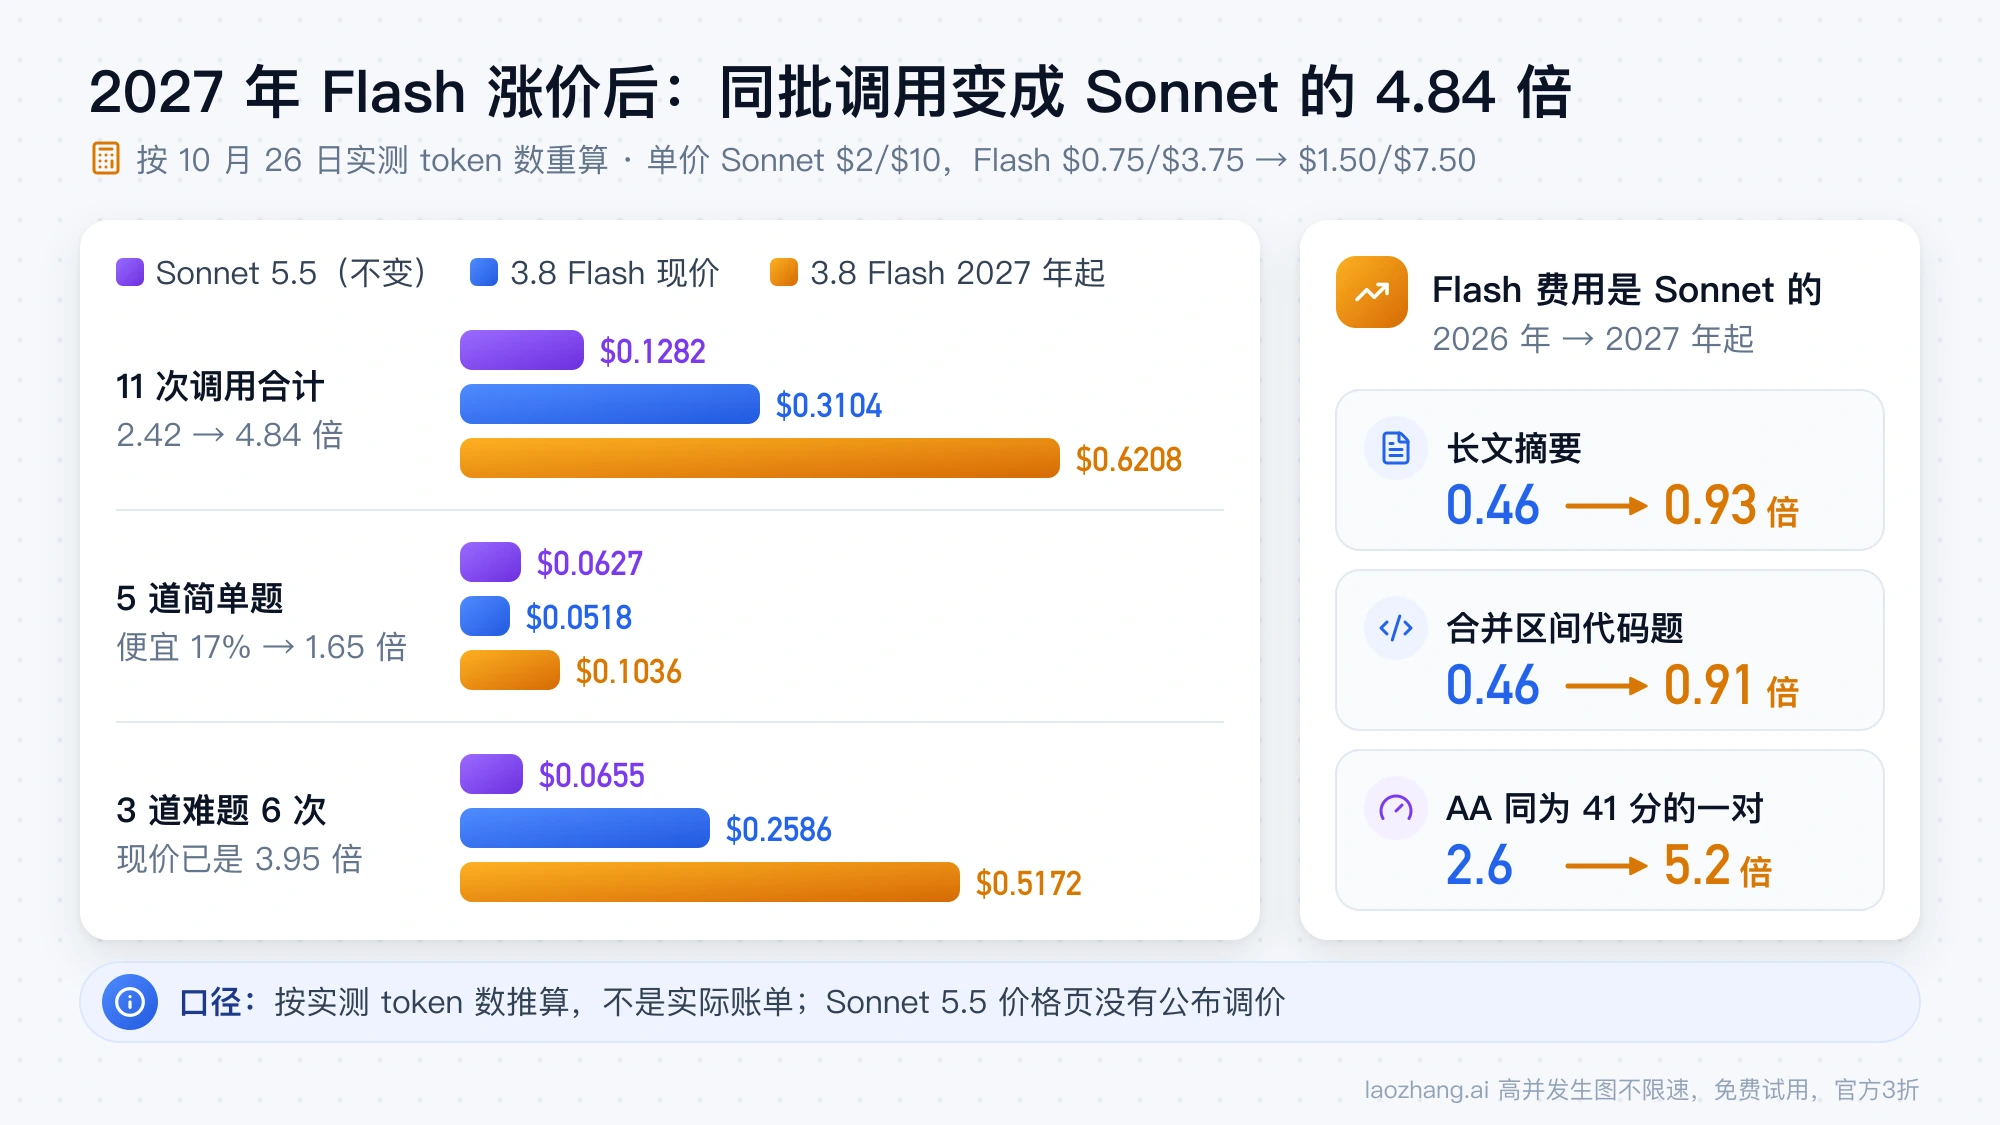
按 Gemini API 价格页,3.8 Flash 的 Standard 价格到 2026 年 12 月 31 日为止是输入 $0.75、输出 $3.75,2027 年 1 月 1 日起变成 $1.50、$7.50,缓存、Batch、Flex 和 Priority 也一起翻倍;Claude API 价格页上 Sonnet 5.5 是 $2、$10,没有公布调价。假设 token 数不变,把上面的实测重算一遍:
| 模型与价格时期 | 输入 / 输出单价(每百万 token) | 11 次调用合计 | 5 道简单题 | 3 道难题 6 次 |
|---|---|---|---|---|
| Sonnet 5.5,2027 年不变 | $2 / $10 | $0.1282 | $0.0627 | $0.0655 |
| 3.8 Flash,2026 年 12 月 31 日前 | $0.75 / $3.75 | $0.3104 | $0.0518 | $0.2586 |
| 3.8 Flash,2027 年 1 月 1 日起 | $1.50 / $7.50 | $0.6208 | $0.1036 | $0.5172 |
涨价后 Flash 在简单题上也变成 Sonnet 的 1.65 倍,原本便宜一半的两道题只剩一点差距:长文摘要 0.93 倍,合并区间 0.91 倍。放大到量上更直观(按实测 token 推算,不是实际账单):一万次长文摘要这样的调用,2026 年 Flash 约 $155、Sonnet 约 $334,2027 年起 Flash 约 $310;一万次表达式求值这样的难题,2026 年 Flash 约 $885、Sonnet 约 $190,2027 年起 Flash 约 $1,770。AA 的数字也一样翻倍,Flash high 每任务从 $1.24 变成约 $2.48,是 Sonnet medium 同分成本的 5.2 倍。
所以现在把长文档任务放在 Flash 上省钱,是一个只到年底的判断;如果你的批量任务以长输入为主,到 2027 年要重新算一遍,或者看缓存能省多少。Gemini 各型号的完整价格、免费额度和涨价细节见 Gemini API Key 购买前先看:价格、免费额度与 2027 年 Flash 涨价。
哪类任务交给哪个模型:编程和 Agent 给 Sonnet,长文档给 Flash
按上面的实测成本和 AA 分项,默认模型可以这样定。表里的"依据"列只放决定这一行的数字,Flash 的倍数都是 2026 年价格,2027 年起翻倍。
| 任务类型 | 默认模型 | 依据 |
|---|---|---|
| 在终端里执行命令、多步 Agent,例如 Claude Code、Cline | Sonnet 5.5 | Terminal-Bench 4.0:Sonnet high 43.9%、medium 29.8%,Flash high 19.7% |
| 写函数、修 bug 这类代码题 | Sonnet 5.5 | 实测 5 道代码题两边都做对,其中 4 道 Flash 费用是 2.3~4.7 倍,只有合并区间是 0.46 倍;每道 Flash 用时都更长 |
| 报告、表格这类职场任务交付 | Sonnet 5.5 | AA-Briefcase 1635 对 1202,GDPval-AA 1548 对 1436 |
| 数学、科学推理题 | 分数接近,按成本默认 Sonnet 5.5 | HLE、SciCode 上 Flash 略高;实测数位和题 Flash 费用 2.94 倍 |
| 长文档阅读、摘要、基于文档问答 | 3.8 Flash | AA-LCR:Flash medium 84.0%、high 81.3%,Sonnet high 78.0%;实测长文摘要 Flash 费用 0.46 倍 |
| 知识类问答、事实查询 | 3.8 Flash | AA-Omniscience 30 对 21 |
| 视频、音频直接输入 | 3.8 Flash | Sonnet 5.5 只接受文本和图片 |
两个模型都做不好的任务,不必在这两者之间反复换。Claude 这边往上一档是 Opus 5.5,见 Sonnet 5.5 和 Opus 5.5 怎么选:半价未必更省;Google 这边往上一档是 Gemini 4 Argon,Flash 自身的强项和短板也在 Gemini 4 Argon 和 3.8 Flash 区别:实测成本差多少,哪些任务该换 里。想把 Sonnet 的任务降到更便宜的 Haiku 5.5,先看 Claude Haiku 5.5 和 Sonnet 5.5 区别:标价差 20 倍,同分只差 4 倍;在 OpenAI 里找同档替代,见 Sonnet 5.5 对比 GPT-6 Astra:值不值得换。
规格对照:上下文、最大输出、输入类型与缓存价
两个模型的上下文都在 100 万 token 左右,真正影响用法的是最大输出、输入类型和思考的调法。下表来自 Claude 模型总览、Gemini 3.8 Flash 模型页 和两家价格页,价格截至 2026 年 10 月 26 日。
| 项目 | Claude Sonnet 5.5 | Gemini 3.8 Flash |
|---|---|---|
| API 模型 ID | claude-sonnet-5-5 | gemini-3.8-flash |
| 发布 | 2026 年 9 月 28 日 | 2026 年 9 月 2 日正式版 |
| 上下文窗口 | 1,000,000 token,整窗按同一单价 | 1,048,576 token,没有长上下文加价档 |
| 最大输出 | 128K token,Batch 加 beta 头可到 300K | 65,536 token |
| 输入类型 | 文本、图片、PDF(Claude API 用 document 块,每次请求最多 600 页、32MB) | 文本、图片、视频、音频、PDF |
| 思考怎么调 | effort:low 到 max 五档,API 默认 high | thinkingLevel:low、medium、high,默认 medium |
| 输入 / 输出单价 | $2 / $10 | $0.75 / $3.75,2027 年起 $1.50 / $7.50 |
| 缓存读取 | $0.10 | $0.075,另收每小时存储费 |
| Batch | $1 / $5 | $0.375 / $1.875,Flex 同价 |
effort 和 thinkingLevel 是两家各自的旋钮,不是同一个参数换了名字。Flash 最高只到 high,Sonnet 在 high 之上还有 xhigh 和 max,所以"两边都开 high"是最接近的设置,并不等于投入同样多的思考。Sonnet 5.5 的思考是自适应的,旧的 "enabled" 加 budget_tokens 写法会返回 400;Flash 不支持 minimal,传了会报错。Claude Code 里 Sonnet 5.5 的默认 effort 是 medium,和 API 的默认 high 不同,比较两边体验时要先确认档位。
Sonnet 5.5 的缓存读取在 2026 年 10 月 7 日从 $0.20 降到了 $0.10,重复发送同一段长上下文的任务能省多少,见 Claude Sonnet 5.5 缓存读取价格降到 $0.10:省多少看缓存占比。
在 Claude.ai、Gemini 应用、Claude Code 和 Antigravity 里怎么用
不走 API 时,两个模型的入口和门槛差别很大。截至 2026 年 10 月 26 日,任何人都可以在 Claude.ai 免费和 Sonnet 5.5 对话,Claude 帮助中心关于 effort 的说明写明 Sonnet 5.5 可以选 Low、Medium、High、Extra high、Max 五档,思考不能关闭,但没有写免费版能用哪一档。Gemini 应用里,按 Gemini 应用的模型说明,没有订阅时只有 Auto 或 Flash-Lite,开了 Auto 时较难的问题才可能交给 Flash 或 Pro;Google AI Plus、Pro、Ultra 都能手动选 Flash,其中 Plus 从 2026 年 11 月 13 日起不再包含 Pro,但保留 Flash。
编程工具里,Claude Code 用 Sonnet 5.5 时默认 effort 是 medium,额度跟着 Claude 订阅走,Pro 和 Max 的区别见 Claude Pro vs Max 怎么选(2026):价格、额度与 Claude Code 限制。Google 的 Antigravity 两个模型都提供,但门槛不同:按 Antigravity 的模型说明页(2026 年 10 月 23 日的版本),3.8 Flash 在免费版、Google AI Plus、Pro、Ultra 和企业版都能用;Claude Sonnet 5.5(thinking)在免费版和 Plus 不能用,Google AI Pro 只限非试用订阅,Ultra 和企业版可以用。
Claude Sonnet 5.5 和 Gemini 3.8 Flash 对比的其他问题
我用的中转或聚合平台价格和官方不一样,这些倍数还成立吗?
token 数不随平台变,变的只是单价。把实测表里的 token 数乘上你所用平台给 claude-sonnet-5-5 和 gemini-3.8-flash 的实际单价,就能得到自己的每题费用;如果平台对两个模型的折扣比例相同,倍数不变,折扣不同就要重新算。上面的数字只用了官方标价,测试所走的 laozhang.ai 截至 2026 年 10 月 26 日的标价与官方相同,其他平台没有比较。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
把 Flash 的思考等级降到 medium 或 low 能省多少?
AA 的数据是:Flash medium 指数 40、每任务 $0.93,high 是 41、$1.24,low 是 33,没有公布成本和速度(截至 2026 年 10 月 26 日)。也就是说降到 medium 分数几乎不掉,成本低四分之一,但仍高于同分的 Sonnet 5.5 medium(41 分、$0.48)。medium 本来就是 Flash 的默认值;上面的实测只跑了 high,降档后每题省多少需要用自己的题目再测。
Gemini 3.8 Flash 的免费层能用来跑正式业务吗?
Gemini API 的免费层对 3.8 Flash 的输入、输出和缓存都不收费,但按 Gemini API 价格页,免费层的数据会被用于改进 Google 的产品,付费层不会;免费层每分钟、每天能调用多少次,Google 没有公开表格。处理客户数据或需要稳定额度的业务应该用付费层,免费层的现状和限额查看方法见 Gemini API Key 免费额度与速率限制 2026:哪些还免费、去哪看限额。
Sonnet 5 和 Sonnet 5.5 是一回事吗?
不是。两者 API 输入、输出单价相同,但 Sonnet 5.5 是 2026 年 9 月 28 日发布的新模型,Sonnet 5 已列为旧型号,缓存读取仍是 $0.20。BenchLM 的 "Claude Sonnet 5 vs Gemini 3.8 Flash" 和 aigrow.gg 的每千条有效回答成本比较,用的都是 Sonnet 5,数字不能直接套到 Sonnet 5.5 上。
参考来源12
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月26日。
参考来源12
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月26日。
- 1.Anthropic 扩展思考文档platform.claude.com/docs/en/build-with-claude/thinking
- 2.AA 的 Claude Sonnet 5.5 与 Gemini 3.8 Flash 全档位对比页artificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-gemini-3-8-flash
- 3.linux.do 体验帖《Gemini 3.8Flash high vs Sonnet 5.5 low》linux.do/t/topic/3010438
- 4.OpenRouter 的 Claude Sonnet 5.5 与 Gemini 3.8 Flash 对比页openrouter.ai/compare/anthropic/claude-sonnet-5.5/google/gemini-3.8-flash
- 5.Gemini API 价格页ai.google.dev/gemini-api/docs/pricing
- 6.Claude API 价格页platform.claude.com/docs/en/about-claude/pricing
- 7.Claude 模型总览platform.claude.com/docs/en/about-claude/models/overview
- 8.Gemini 3.8 Flash 模型页ai.google.dev/gemini-api/docs/models/gemini-3.8-flash
- 9.document 块platform.claude.com/docs/en/build-with-claude/pdf-support
- 10.Claude 帮助中心关于 effort 的说明support.claude.com/en/articles/8664678
- 11.Gemini 应用的模型说明support.google.com/gemini/answer/18648722
- 12.Antigravity 的模型说明页antigravity.google/docs/models