Claude Haiku 5.5 или Sonnet 5.5: что выбрать по цене задачи
Claude Haiku 5.5 дешевле Sonnet 5.5 в 20 раз за токен, но при равном балле в замерах Artificial Analysis — лишь в 4 раза, и задача решается дольше.
Содержание
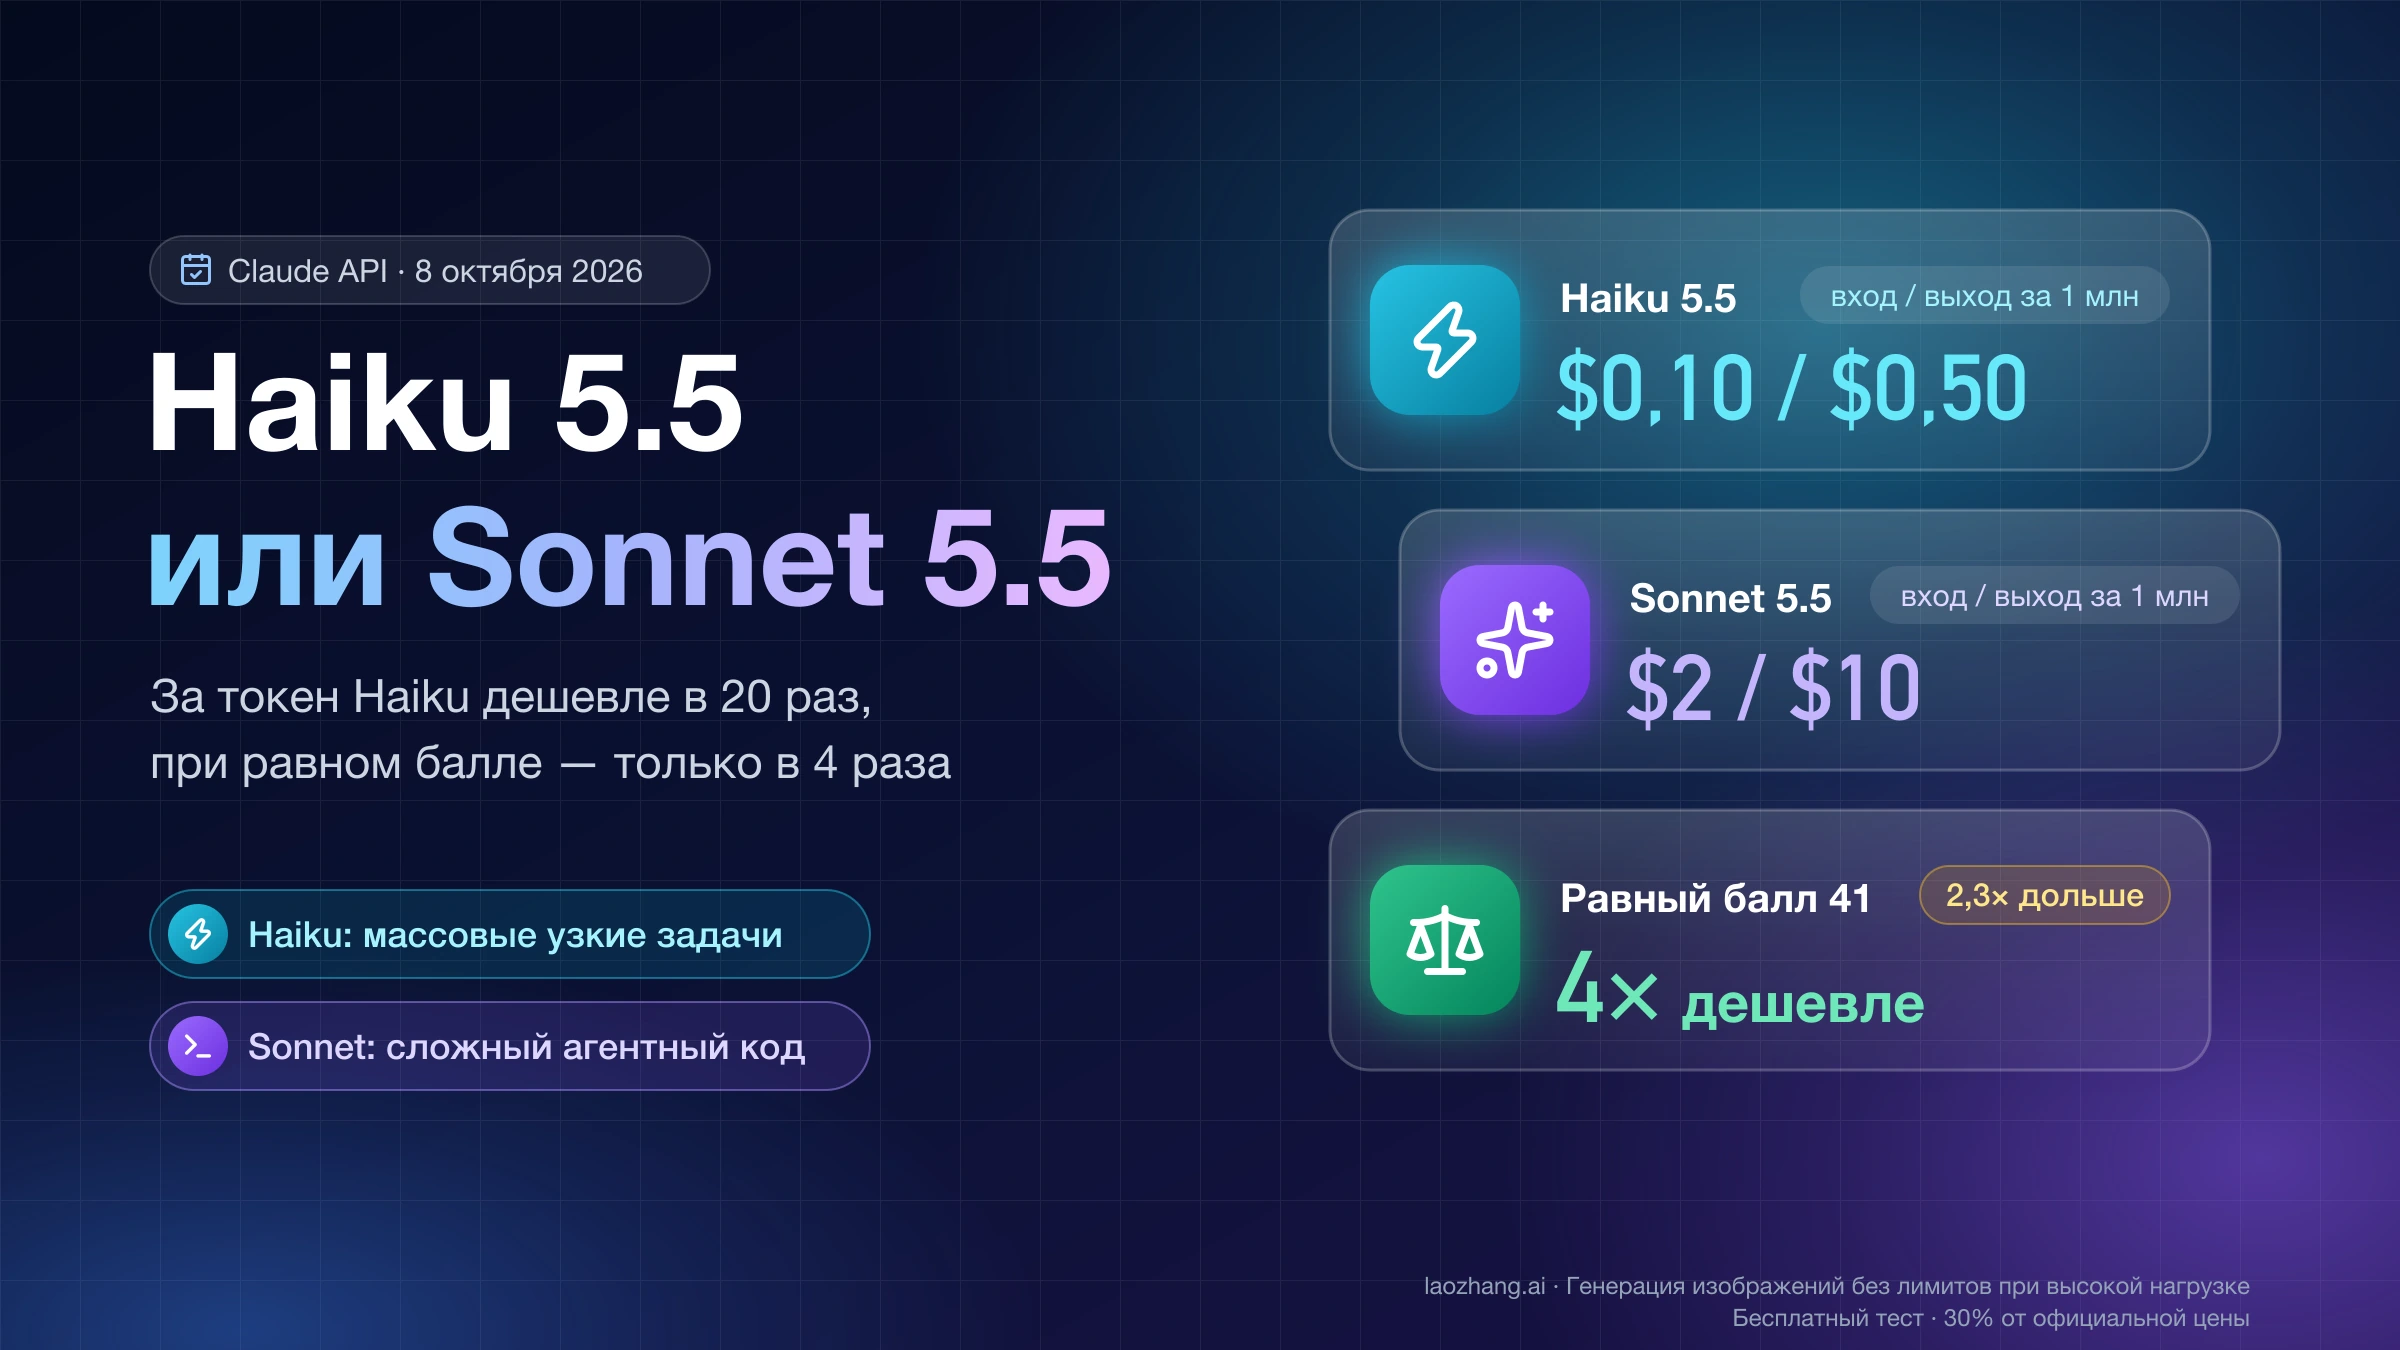
Массовые узкие задачи — классификацию, извлечение полей, маршрутизацию, сжатие контекста, работу субагентов — переводите на Claude Haiku 5.5. Сложное агентное программирование, бизнес-автоматизацию и ответы, где ошибка в фактах дорого стоит, оставляйте на Sonnet 5.5. Если результат Haiku проверяется автоматически — тестами, JSON-схемой, валидатором, — выгоднее третий вариант: сначала Haiku, а то, что он не решил, отправлять на Sonnet.
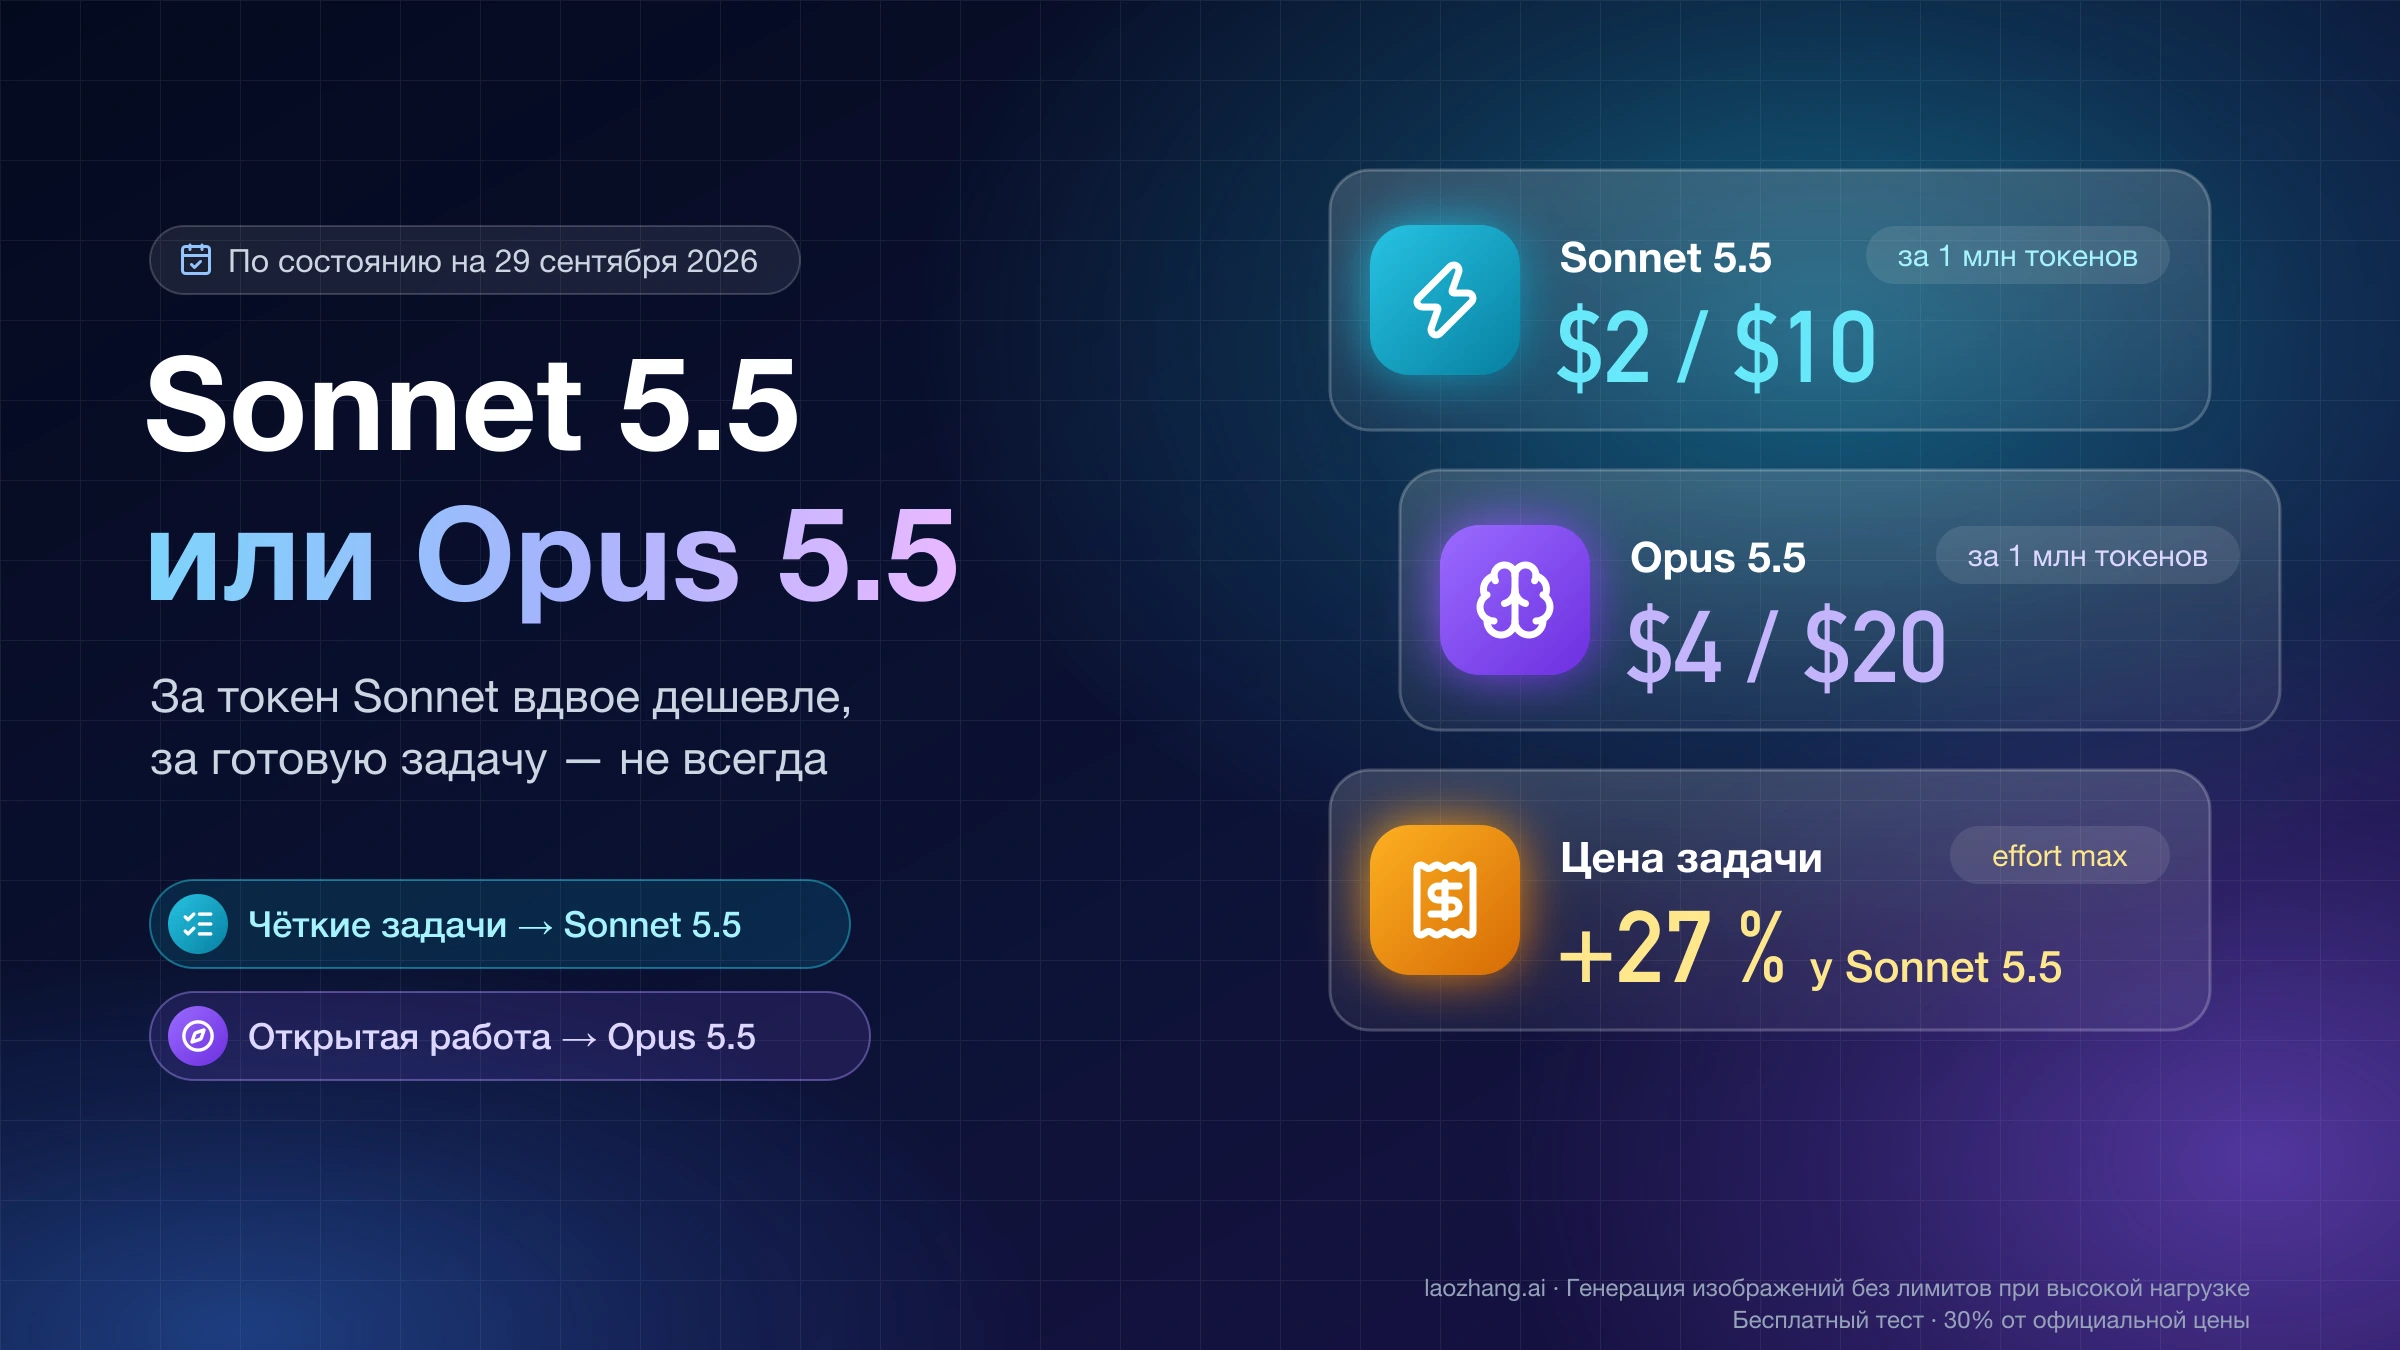
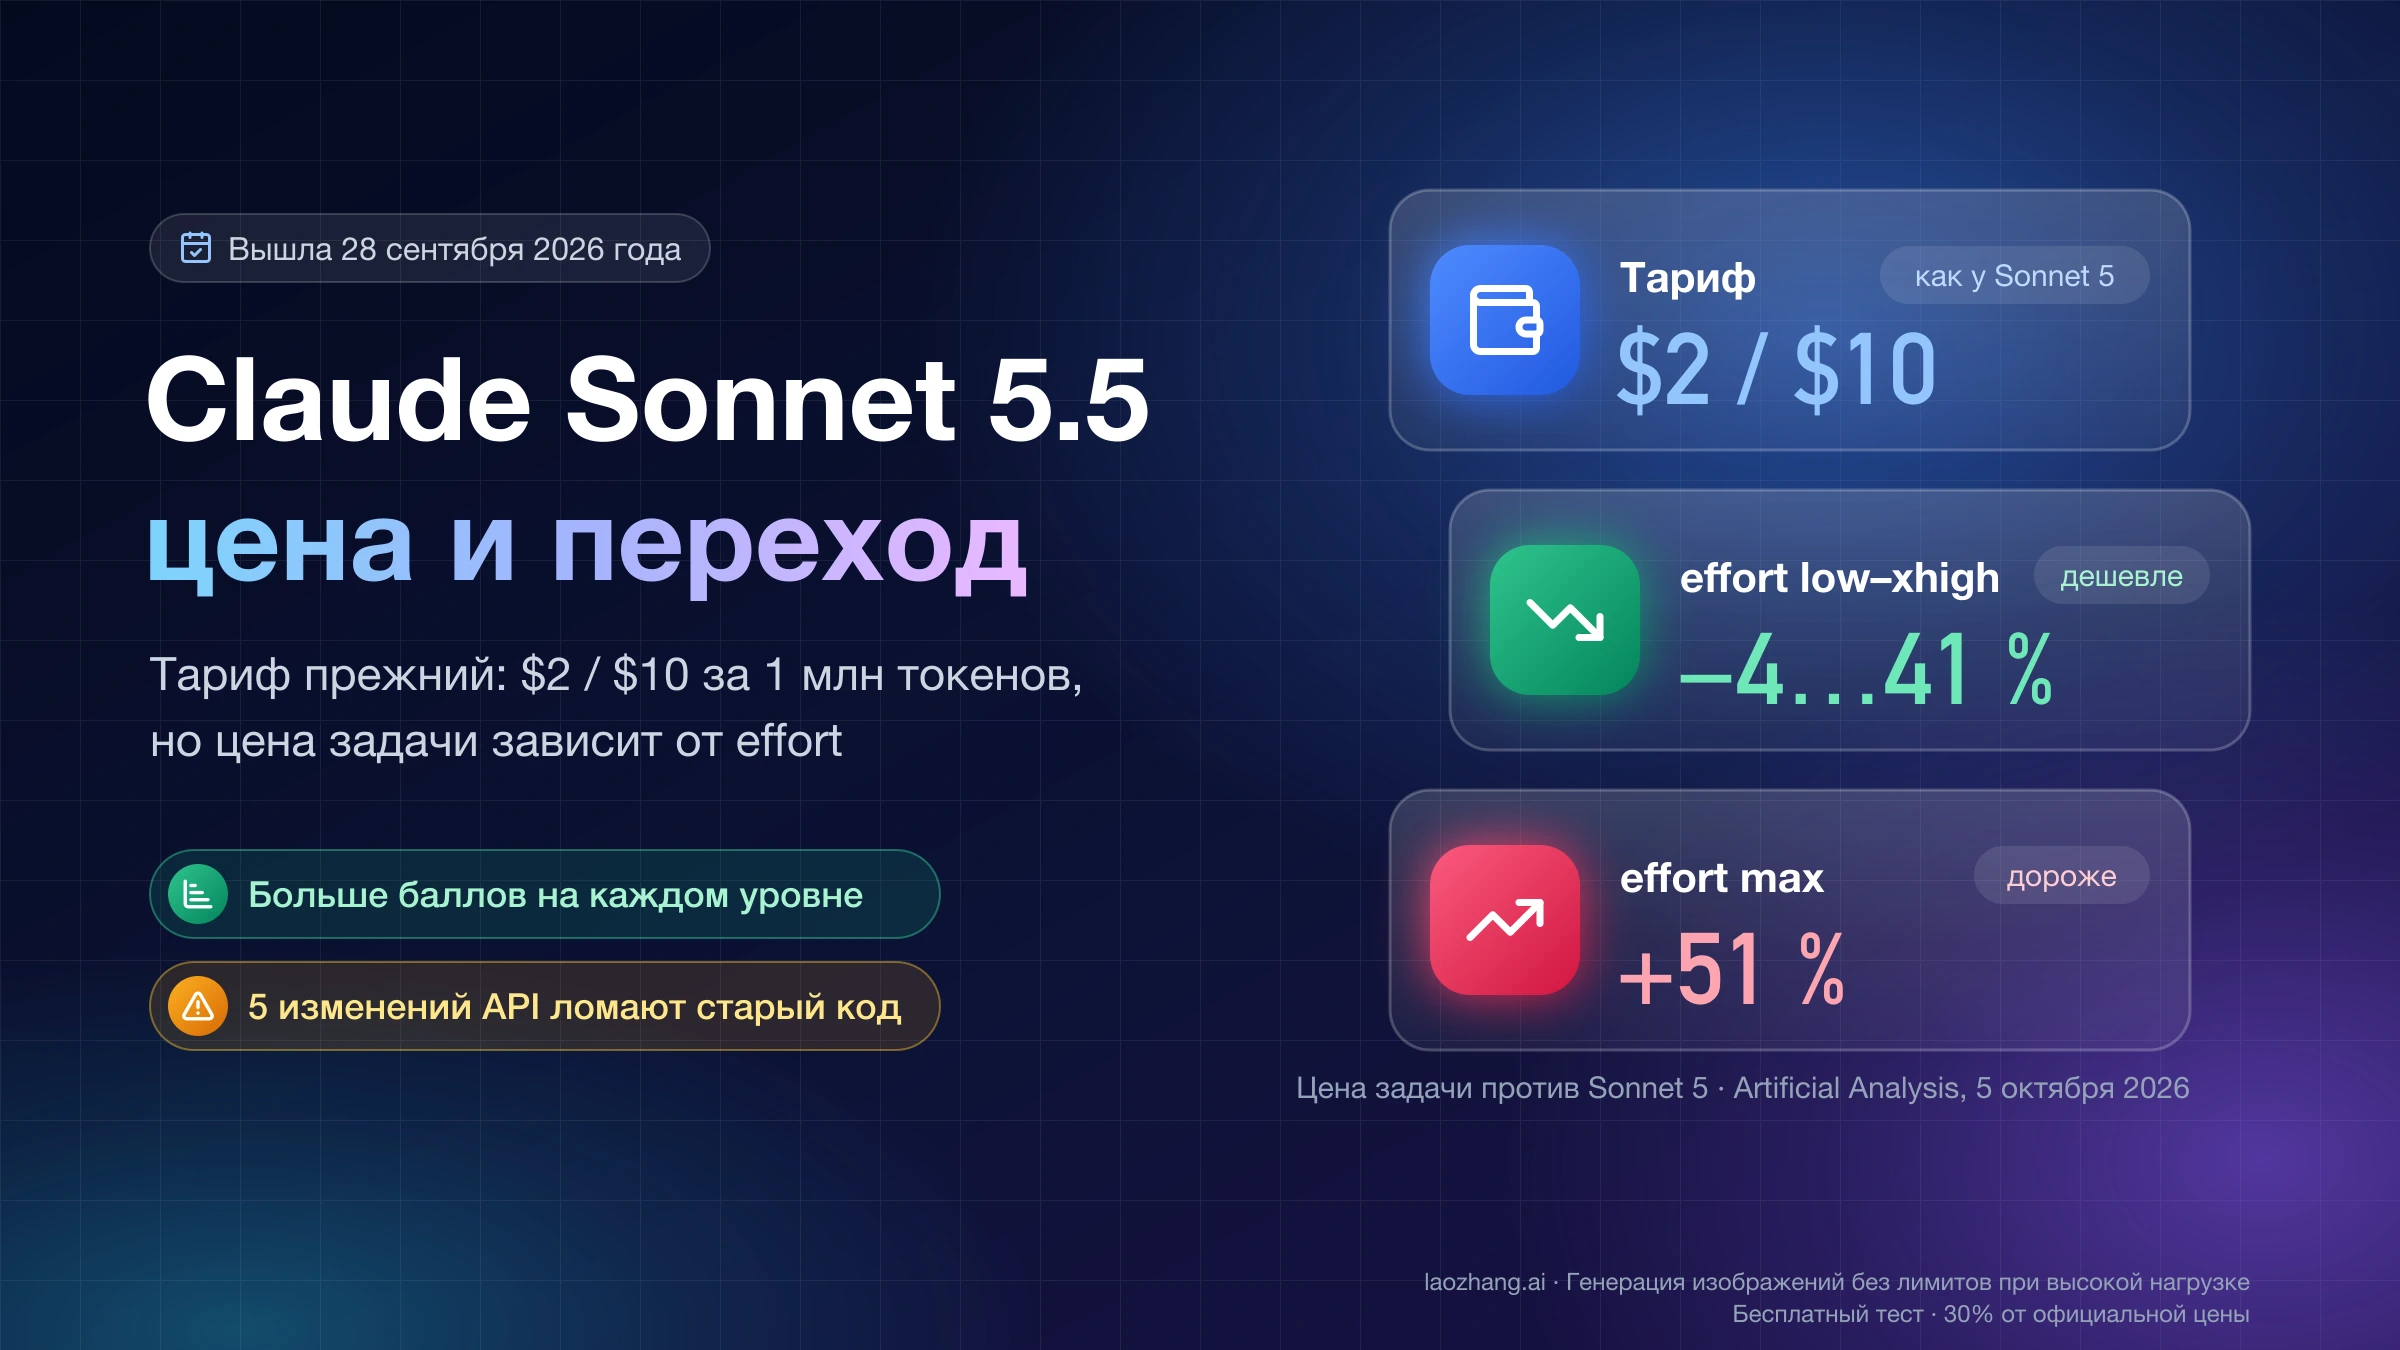
Разрыв в цене меньше, чем кажется по прайсу. За токен Haiku 5.5 дешевле в 20 раз, пока промпт не длиннее 100 000 токенов, и в 4 раза — на более длинных промптах. В сторонних замерах Artificial Analysis задача на одинаковом уровне effort medium обходится на Haiku примерно в 10 раз дешевле (effort задаёт, сколько модель рассуждает перед ответом), а при одинаковом итоговом балле — только в 4 раза, причём решается в 2,3 раза дольше. Все цифры ниже приведены по состоянию на 8 октября 2026 года.
Haiku 5.5 (claude-haiku-5-5) вышел 7 октября 2026 года, Sonnet 5.5 (claude-sonnet-5-5) — 28 сентября. Если и Sonnet 5.5 не справляется, следующий шаг — Opus 5.5 или Fable 5.1, об этом ниже в вопросах.
Чем Haiku 5.5 отличается от Sonnet 5.5: то же окно, другая цена
Технически модели почти одинаковы: контекст 1 млн токенов, до 128 тыс. токенов ответа, на вход текст и изображения, знания до июня 2026 года, адаптивное рассуждение (adaptive thinking) и пять уровней effort. Различаются цена, качество на сложных задачах, настройки по умолчанию и то, насколько хорошо модель доводит до конца длинную работу. Цены — по странице цен Claude API, за 1 млн токенов:
| Haiku 5.5 | Sonnet 5.5 | |
|---|---|---|
| Входные токены, промпт до 100 000 | $0,10 | $2 |
| Выходные токены, промпт до 100 000 | $0,50 | $10 |
| Чтение из кэша, промпт до 100 000 | $0,01 | $0,10 |
| Промпт больше 100 000: вход / выход / кэш | $0,50 / $2,50 / $0,05 | без надбавки: $2 / $10 / $0,10 |
| Пакетная обработка (Batch), вход / выход | $0,05 / $0,25 (до 100 000) | $1 / $5 |
| Effort по умолчанию в API | medium | high |
| Effort по умолчанию в Claude Code | medium | medium |
| Как выключить рассуждение перед ответом | thinking: {"type": "disabled"}, до high | thinking: {"type": "between_tools"}, от low до high |
| Назначение по описанию Anthropic | большие объёмы и низкая задержка: классификация, извлечение, маршрутизация | лучшее сочетание скорости и интеллекта |
Две детали важны для расчётов. Во-первых, 7 октября Anthropic вдвое снизила для Sonnet 5.5 цену чтения из кэша — с $0,20 до $0,10. По этой ставке оплачиваются токены, которые повторно используются через кэширование промптов (prompt caching), поэтому таблицы, составленные раньше, завышают стоимость агентной работы на Sonnet. Во-вторых, Haiku 5.5 использует тот же токенизатор, что и модели Claude 4.7 и новее, к которым относится и Sonnet 5.5. Поэтому один и тот же промпт должен давать на обеих моделях одинаковое число токенов, и цены за токен сравниваются напрямую. А вот по сравнению с Haiku 4.5 тот же текст на Haiku 5.5 занимает примерно на 30 % больше токенов.
Цифры «на 90 % дешевле» и «на 75 % дешевле» из анонса Claude Haiku 5.5 относятся к сравнению с Haiku 4.5, а не с Sonnet.
Что выбрать: задачи для Haiku 5.5 и задачи для Sonnet 5.5
Граница проходит не по сложности темы, а по тому, длинная ли цепочка действий и видна ли ошибка сразу. Результаты отдельных тестов Artificial Analysis в таблице приведены для уровня medium — он стоит по умолчанию в Claude Code и у Haiku в API; в парах чисел первым идёт Haiku 5.5, вторым Sonnet 5.5.
| Задача | Что брать | На чём основано |
|---|---|---|
| Классификация, извлечение полей, маршрутизация запросов | Haiku 5.5, effort low или medium | Прямое назначение модели по описанию Anthropic; миллион коротких запросов стоит $350 вместо $7 000 (расчёт ниже) |
| Сжатие контекста (compaction), суммаризация, субагент для поиска по коду или документам | Haiku 5.5 | В анонсе Anthropic называет эти задачи основными для Haiku 5.5 и советует ставить его субагентом к Sonnet 5.5 или Opus 5.5 |
| Ответы по длинному документу | Обе подходят, выбор по цене | AA-LCR: 77,3 % против 76,3 %; но после 100 000 токенов промпта разрыв в цене сокращается до 4× |
| Научный и вычислительный код | Haiku 5.5, если проходят ваши тесты | SciCode: 49,0 % против 52,9 % |
| Агентное программирование в терминале, многошаговые правки | Sonnet 5.5 | Terminal-Bench 4.0: 15,2 % против 29,8 % у Artificial Analysis, 39,2 % против 70,6 % в таблице Anthropic |
| Бизнес-автоматизация через инструменты | Sonnet 5.5 | AutomationBench-AA: 28,6 % против 54,9 % |
| Ответы по фактам без поиска, где выдумка недопустима | Sonnet 5.5 | AA-Omniscience, где штрафуют за галлюцинации: 4 против 20 |
| Чат, где важно быстро начать отвечать | Sonnet 5.5 на low или Haiku 5.5 без рассуждения | Первый токен на low: 12,0 с у Haiku против 1,05 с у Sonnet; режим disabled в этих замерах не участвовал |
| Оборонительные задачи по кибербезопасности | Haiku 5.5, кроме пентеста | Ограничения Haiku 5.5 пропускают больше оборонительных задач, чем у Sonnet 5.5, но тестирование на проникновение блокируют |
Практическое правило: короткая проверяемая задача, повторяемая тысячи раз, — Haiku. Задача, где ошибку заметит только человек или где модель должна сама провести десятки вызовов инструментов, — Sonnet. Всё, что между, проще решить каскадом и измерить долю успеха Haiku на своих данных. Такой порядок предлагает и руководство Anthropic по выбору модели: начать с Haiku 5.5 и переходить на старшую модель там, где тесты показывают нехватку качества. Там же сказано, что настройка effort часто полезнее смены модели.
Что лучше по бенчмаркам: при равном балле Haiku дешевле в 4 раза
В собственной таблице Anthropic Sonnet 5.5 впереди во всех строках. Уровень effort для каждой колонки в анонсе не указан, кроме FrontierCode, где Sonnet запускался на xhigh.
| Тест (данные Anthropic) | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|
| Terminal-Bench 4.0, агентное программирование | 39,2 % | 70,6 % |
| OSWorld 2.1 (офлайн-подмножество), работа с компьютером | 72,4 % | 83,9 % |
| FrontierCode 1.1 (Main) | 46,4 % | 52,1 % |
| Humanity's Last Exam без инструментов / с инструментами | 45,9 % / 57,4 % | 56,9 % / 64,5 % |
| GDPval-AA v2.1, профессиональные задачи | 1620 | 1840 |
| Chartography без инструментов | 46,4 % | 61,6 % |
Для сравнения: Haiku 4.5 в Terminal-Bench 4.0 набирал 0,0 %. Скачок большой, но до Sonnet в агентном коде Haiku 5.5 всё ещё далеко.
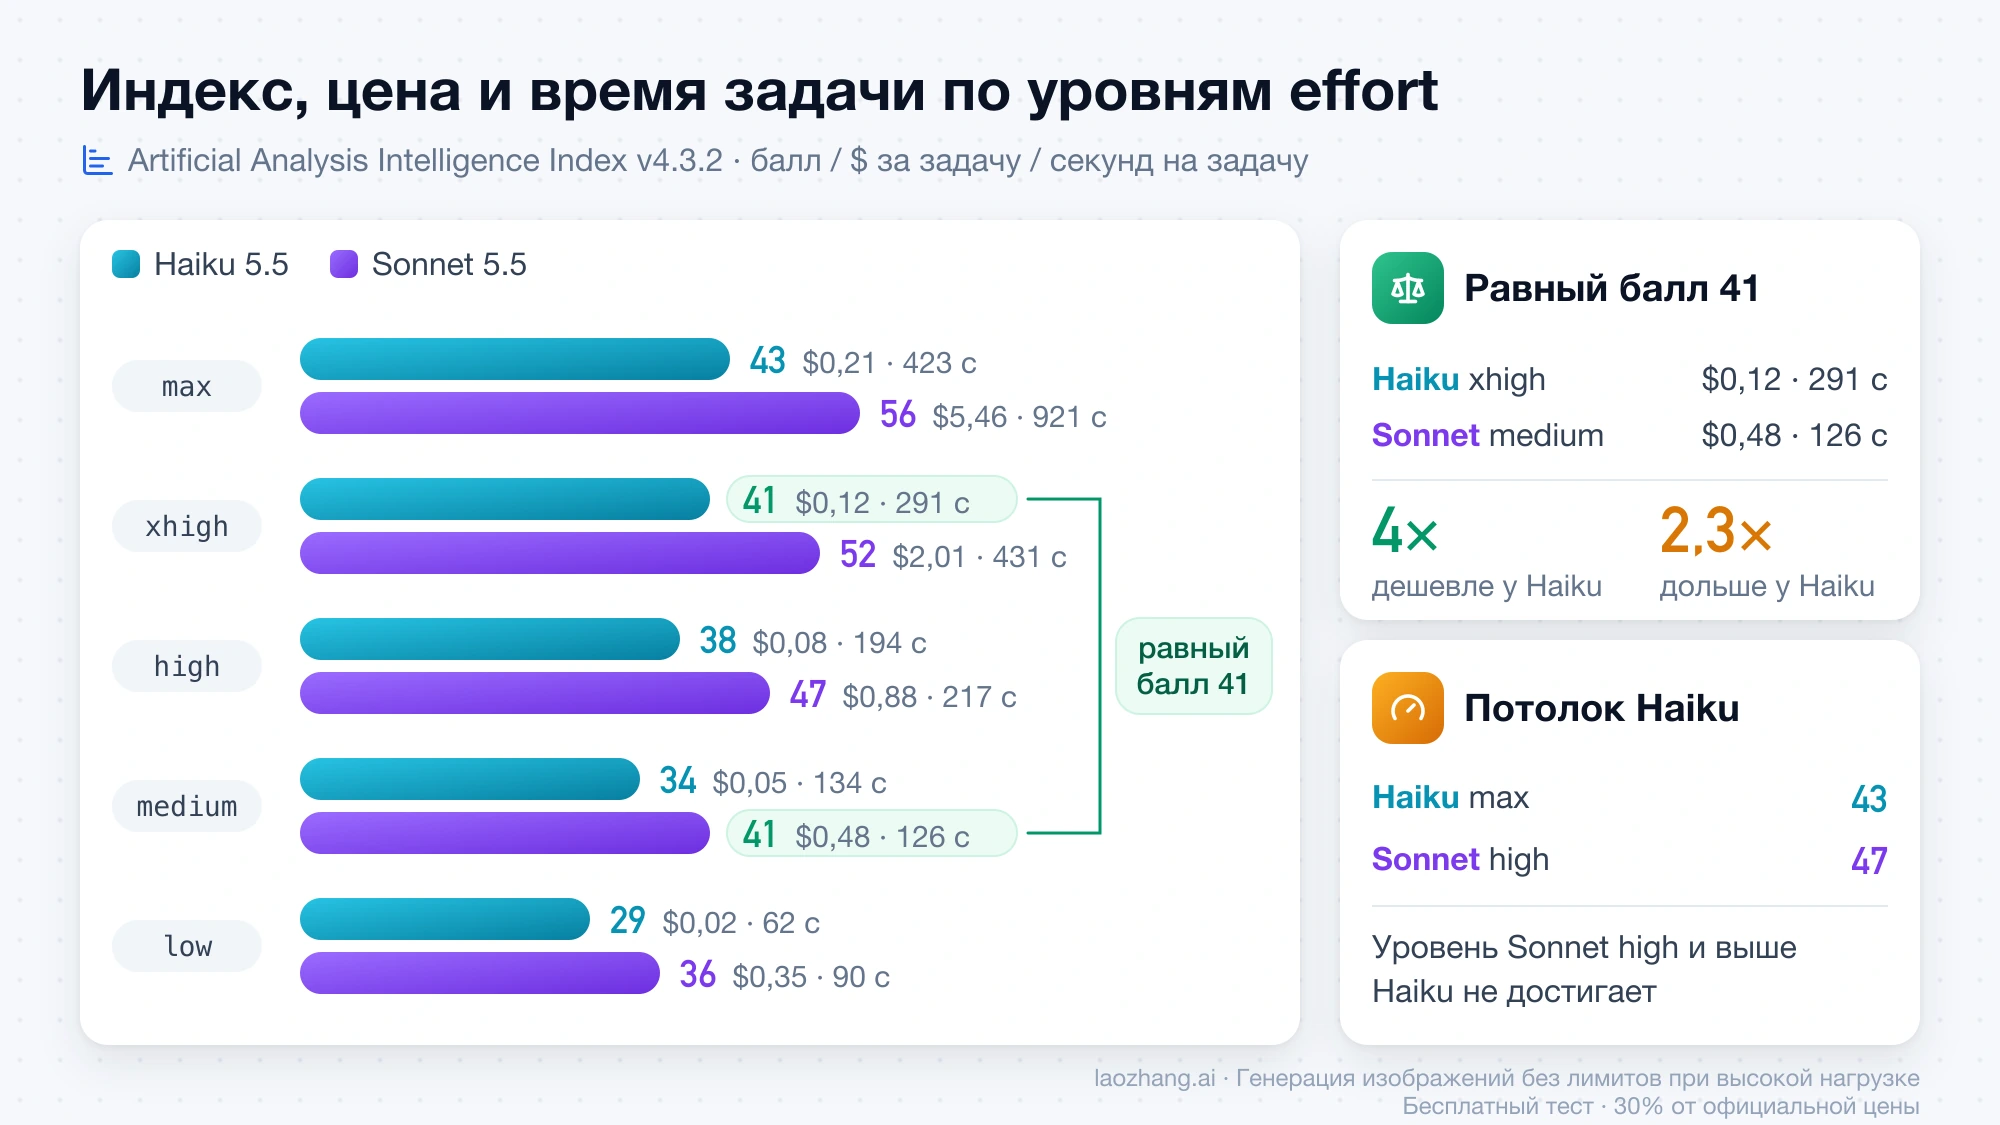
Полезнее другой разрез. Artificial Analysis прогнала обе модели на всех пяти уровнях effort и для каждого записала итоговый индекс (Intelligence Index v4.3.2, среднее по десяти тестам), стоимость одной задачи индекса и время на неё:
| Effort | Sonnet 5.5: индекс / $ за задачу / с на задачу | Haiku 5.5: индекс / $ за задачу / с на задачу |
|---|---|---|
max | 56 / $5,46 / 921 | 43 / $0,21 / 423 |
xhigh | 52 / $2,01 / 431 | 41 / $0,12 / 291 |
high | 47 / $0,88 / 217 | 38 / $0,08 / 194 |
medium | 41 / $0,48 / 126 | 34 / $0,05 / 134 |
low | 36 / $0,35 / 90 | 29 / $0,02 / 62 |
Из этой таблицы следуют три вывода:
- При одинаковом effort задача на Sonnet дороже в 9,6 раза на
medium($0,48 / $0,05) и в 17,5 раза наlow($0,35 / $0,02). - При одинаковом балле разрыв меньше. Haiku на
xhighнабирает те же 41, что Sonnet наmedium, и стоит $0,12 против $0,48 — в 4 раза дешевле, но тратит 291 с против 126 с, то есть в 2,3 раза дольше. Haiku наhigh(38 баллов, $0,08, 194 с) обходит Sonnet наlow(36 баллов, $0,35, 90 с): дешевле в 4,4 раза, медленнее в 2,2 раза. - У Haiku есть потолок. Даже на
maxон набирает 43 — меньше, чем Sonnet наhigh(47). Если вашей задаче нужен уровень Sonnethighи выше, Haiku его не достигает ни при какой настройке.
«Самая быстрая модель» — это про скорость выдачи токенов: 137–243 токена в секунду у Haiku против 101–136 у Sonnet. Но перед ответом Haiku долго рассуждает: первый токен на low появился через 12,0 с, на medium — через 12,6 с, тогда как Sonnet на low начал отвечать через 1,05 с. На max обе модели многословны: на тестах индекса Haiku сгенерировал 440 млн токенов, Sonnet — 420 млн.
Ограничения этих замеров: Haiku в них тарифицирован только по ставке для промптов до 100 000 токенов, поэтому на длинном контексте его стоимость занижена. Прогоны Sonnet подписаны «with fallback», и смысл этой пометки на странице не раскрыт. Индекс — среднее значение, и он скрывает провалы в отдельных тестах из таблицы выбора выше.
Что дешевле за задачу: от 20× на коротком промпте до 4× после 100K
Стоимость запроса считается так: входные токены × цена входа ÷ 1 000 000 плюс выходные токены × цена выхода ÷ 1 000 000. Токены рассуждения входят в выходные. Цены — по прайсу на 8 октября 2026 года, без кэша, если не указано иное:
| Сценарий | Haiku 5.5 | Sonnet 5.5 | Во сколько раз |
|---|---|---|---|
| 10 000 токенов на вход + 1 000 на выход | $0,0015 | $0,030 | 20 |
| 99 000 на вход + 2 000 на выход | $0,0109 | $0,218 | 20 |
| 150 000 на вход + 2 000 на выход | $0,080 | $0,32 | 4 |
| 1 млн запросов классификации по 2 000 на вход + 300 на выход | $350 | $7 000 | 20 |
| Ход агента: 90 000 из кэша + 5 000 новых + 2 000 на выход | $0,0024 | $0,039 | ≈16 |
| Тот же ход, но 120 000 из кэша (если кэш учитывается в границе 100 000) | $0,0135 | $0,042 | ≈3 |
Как получен ход агента на Haiku: 90 000 × $0,01 + 5 000 × $0,10 + 2 000 × $0,50, всё делённое на 1 000 000, — $0,0009 + $0,0005 + $0,0010 = $0,0024. На Sonnet: $0,009 + $0,010 + $0,020 = $0,039. По старой цене кэша $0,20 тот же ход стоил $0,048, то есть снижение цены сделало его на 18,75 % дешевле. Anthropic оценивает экономию на большинстве агентных задач примерно в 20 %. Запись в кэш на первом ходе в расчёт не входит.
Граница в 100 000 токенов — главный подвох Haiku. На странице цен у тарифа для длинных промптов есть свои колонки для входа, выхода и кэша, то есть по старшей ставке оплачивается весь такой запрос, включая ответ. Учитываются ли в границе кэшированные токены и описания инструментов, в документации не уточняется. Поэтому бюджет надёжнее считать по полному входу: кэш плюс запись в кэш плюс новые токены. Агент с длинной историей, которую он каждый ход читает из кэша, легко переходит через 100 000, и тогда преимущество Haiku сжимается с 16 раз примерно до 3.
Цена за токен — ещё не цена задачи. Сколько токенов уйдёт на рассуждение, зависит от effort: на medium у Artificial Analysis задача на Haiku стоит $0,05, на max — $0,21, в четыре раза больше. Подняв Haiku до xhigh, чтобы догнать Sonnet на medium, вы сокращаете выигрыш с 10 до 4 раз и ждёте результат в 2,3 раза дольше.
Каскад «сначала Haiku, потом Sonnet» окупается при успехе от 10 %
Схема простая: каждую задачу сначала решает Haiku, результат проверяется автоматически, всё, что не прошло проверку, повторно отправляется на Sonnet. Ожидаемая стоимость задачи:
C = c(Haiku) + (1 − p) × c(Sonnet), где p — доля задач, которые Haiku решил правильно.
Если взять стоимость задачи из замеров Artificial Analysis на medium (Haiku $0,05, Sonnet $0,48), каскад дешевле одного Sonnet, как только p больше 0,05 / 0,48 ≈ 10,4 %. Время считается так же: T = 134 + (1 − p) × 126 секунд — Haiku тратит свои 134 с на каждую задачу, а Sonnet добавляет 126 с к тем, что ушли дальше.
| Доля успеха Haiku | Стоимость 1 000 задач | Среднее время на задачу |
|---|---|---|
| Только Sonnet 5.5 | $480 | 126 с |
| 50 % | $290 | 197 с |
| 70 % | $194 | 172 с |
| 90 % | $98 | 147 с |
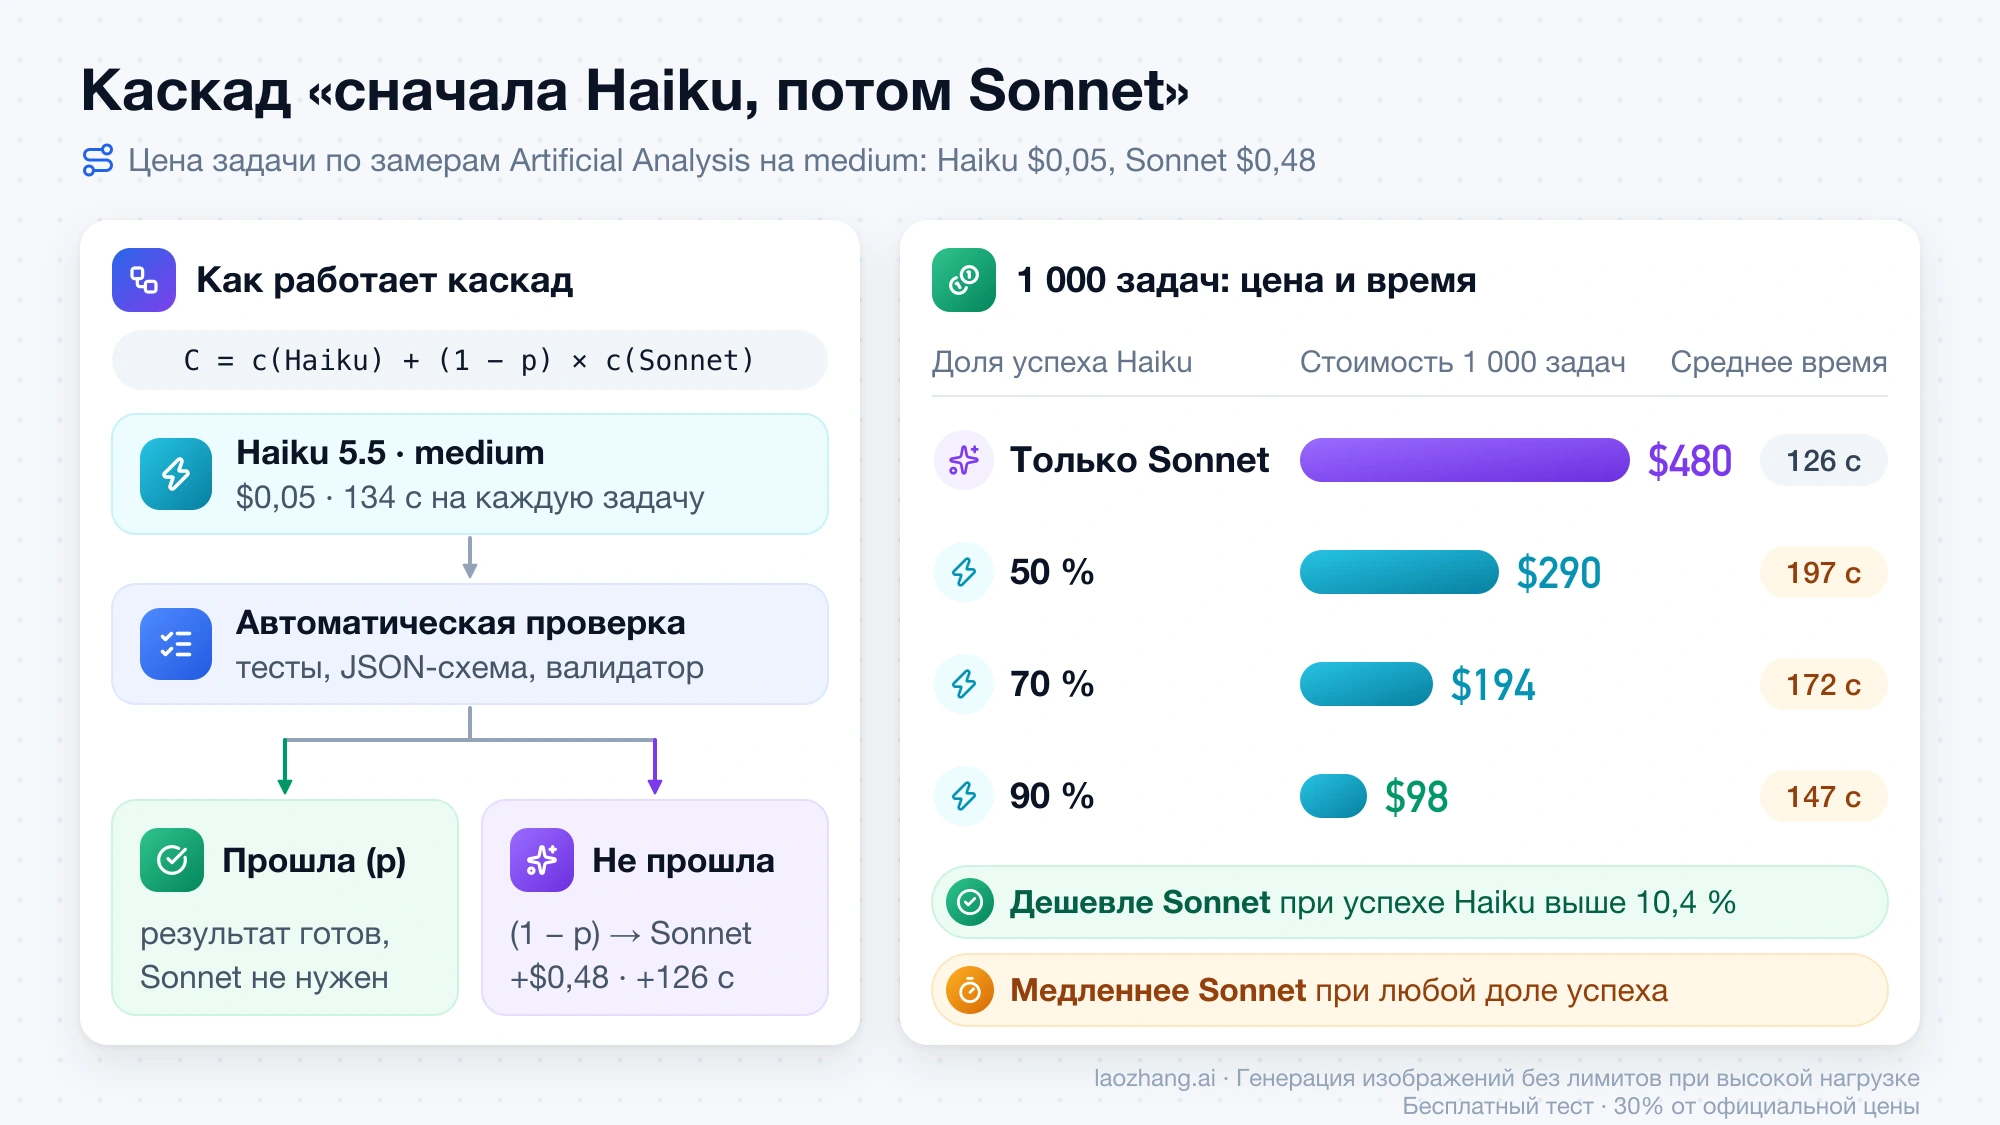
Расчёт верен только при трёх условиях. Ошибку Haiku должна ловить автоматическая и почти бесплатная проверка: прогон тестов, валидация по JSON-схеме, сверка с базой, stop_reason: "refusal". Sonnet должен решать задачу со второй попытки. И неверные ответы, которые проверка пропустила, обходятся вам дороже любой экономии — в таблицу они не входят. При этих цифрах каскад медленнее одного Sonnet при любой доле успеха, потому что Haiku на medium решает задачу не быстрее Sonnet. Для интерактивного чата он поэтому подходит хуже, чем для фоновой обработки.
Подставьте свои цифры: прогоните выборку реальных задач через Haiku на medium, посчитайте долю прошедших проверку и среднюю стоимость по счёту API — и посмотрите, сколько выходит на 1 000 задач.
Переход с Sonnet 5.5 на Haiku 5.5 в API: что сломается при замене ID
Простая замена claude-sonnet-5-5 на claude-haiku-5-5 запустит код, но поменяет поведение. Что проверить:
- Effort. Если вы не задавали
output_config.effort, Sonnet 5.5 работал наhigh, а Haiku 5.5 будет работать наmedium. Задайте уровень явно. По документации Anthropic по параметру effort:medium— для большинства задач, включая агентное программирование;low— для чата, коротких задач с инструментами и простых массовых запросов;high— для работы со знаниями, длинных агентных задач и строгого следования инструкциям;xhighиmax— только если тесты показывают выигрыш, и тогда стоит сравнить с Sonnet 5.5 по качеству, цене и скорости. - Режим без рассуждения. На Sonnet 5.5 минимальная настройка —
thinking: {"type": "between_tools"}. На Haiku 5.5 её аналог —thinking: {"type": "disabled"}, допустимый доhigh. Наxhighиmaxобе настройки возвращают ошибку 400: там оставьте адаптивный режим, просто не передавая полеthinking. - Смена effort посреди диалога. Обе модели на Claude API и Google Cloud принимают
output_configв отдельном сообщении с beta-заголовкомmid-conversation-output-config-2026-07-01, и кэш промпта при этом сохраняется. Сdisabledна Haiku так же, как сbetween_toolsна Sonnet, это не работает — будет 400. - Лимит
max_tokens. Рассуждение входит вmax_tokens. Слишком маленький лимит может закончиться на блокеthinking, до текста ответа. - Ответ начинается с блока рассуждения. Выбирайте блоки по полю
type, а не по позиции. Текст рассуждения по умолчанию не возвращается; чтобы получить краткое изложение, укажитеthinking.display: "summarized".
Если код раньше работал с Haiku 4.5, добавляются несовместимые изменения из списка изменений Haiku 5.5 по сравнению с Haiku 4.5: budget_tokens вызывает ошибку, нестандартные temperature, top_p и top_k возвращают 400, предзаполнение ответа ассистента (prefill) не поддерживается, для работы с компьютером нужен computer_toolset_20260801 вместо computer_20250124, а классификаторы безопасности могут вернуть stop_reason: "refusal" без серверного переключения на другую модель.
Минимальный запрос к Haiku 5.5 с явными настройками выглядит так:
{
  "model": "claude-haiku-5-5",
  "max_tokens": 16000,
  "output_config": { "effort": "medium" },
  "messages": [
    { "role": "user", "content": "Определи категорию обращения: ..." }
  ]
}
Есть и поведенческие отличия, которые Anthropic описывает в руководстве по промптам для Haiku 5.5:
- Останавливается раньше времени на
lowс длинным системным промптом агента и возвращает задачу пользователю. Переход сlowнаmediumпримерно вдвое сократил такие остановки в тестах Anthropic, но более чем вдвое увеличил число выходных токенов. В руководстве есть готовый фрагмент системного промпта против этого. - Сообщает, что правка кода готова, не запустив проверку, на
lowиmedium. Добавьте в системный промпт требование проверять работу или запускайте тесты в своём коде после ответа модели. - Пропускает нужный вызов инструмента, если рассуждение выключено и запрошен структурированный JSON-вывод. Помогает адаптивный режим или принудительный вызов через
tool_choice. - Не ищет свежие данные, если не знает сегодняшнюю дату. Вместе с инструментом поиска передавайте текущую дату в системном промпте.
Haiku 5.5 и Sonnet 5.5 в Claude Code: /model, субагенты, effort
В Claude Code Haiku 5.5 работает с версии v2.1.293 (Sonnet 5.5 — с v2.1.284); обновление — claude update. Переключиться можно командой /model claude-haiku-5-5 в сессии или при запуске: claude --model claude-haiku-5-5. Подробности — в настройках моделей в документации Claude Code.
Что учесть при выборе:
- Алиасы зависят от провайдера.
haikuуказывает на Haiku 5.5 иsonnetна Sonnet 5.5 только при работе через Anthropic API. На Amazon Bedrock и Google Cloudhaikuведёт к Haiku 4.5, аsonnetк Sonnet 4.5, на Claude Platform on AWS — к Haiku 4.5 и Sonnet 4.6. Там указывайте полный ID модели. - Sonnet ведёт, Haiku помогает. Переменная
CLAUDE_CODE_SUBAGENT_MODEL=haikuзадаёт модель для субагентов, у которых модель не указана иначе; полеmodelв определении субагента имеет приоритет. Основная сессия при этом остаётся на Sonnet 5.5. ПеременнаяANTHROPIC_DEFAULT_HAIKU_MODELуправляет тем, куда ведёт алиасhaiku, и заодно фоновыми функциями Claude Code. - Effort по умолчанию одинаковый. В Claude Code и Haiku 5.5, и Sonnet 5.5 по умолчанию работают на
medium— в отличие от API, где у Sonnet по умолчаниюhigh. - Рассуждение не выключается. Для обеих моделей Claude Code показывает «Thinking can't be turned off»; глубину регулирует только effort.
- Длинные сессии дороже на Haiku. Обе модели работают в Claude Code с окном 1 млн токенов на любом плане. Если сессия оплачивается через API, запросы Haiku с промптом больше 100 000 токенов идут по старшему тарифу, а в долгой сессии с большим репозиторием это быстро становится нормой. Тогда разница с Sonnet ближе к 4×, чем к 20×.
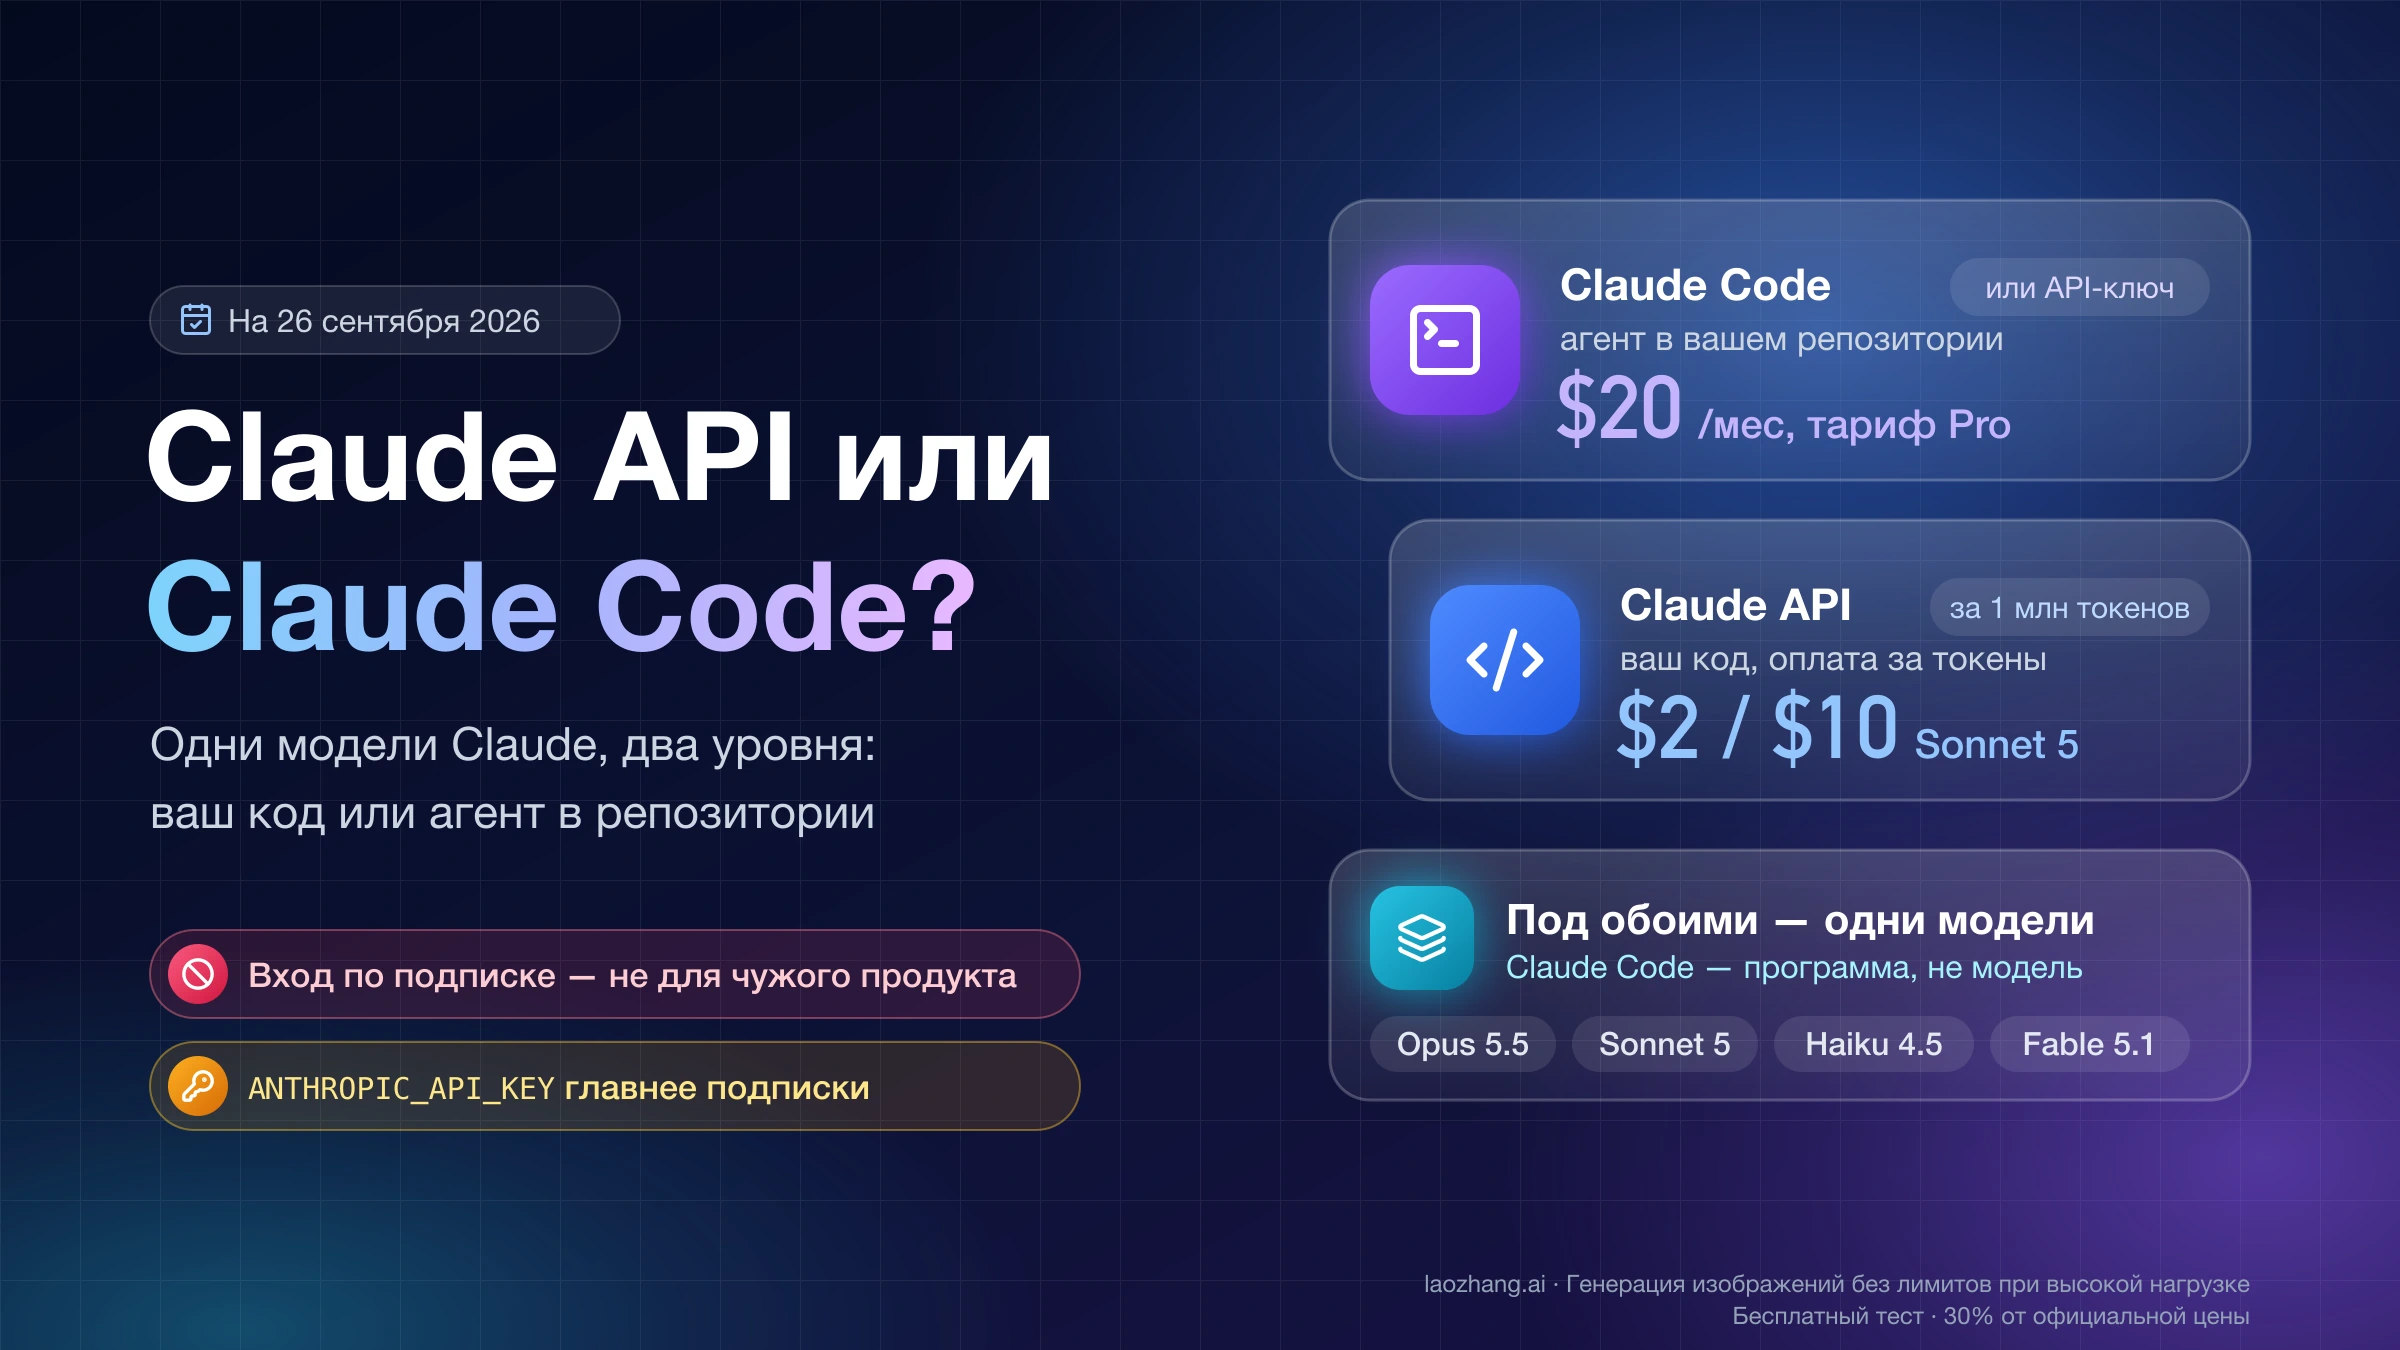
Чем платить за Claude Code — подпиской или токенами API — разобрано в статье «Claude API и Claude Code: в чём разница и что выбрать».
Haiku 5.5 в приложении Claude: доступен на всех планах, включая Free
По странице Claude Haiku на сайте Anthropic, Haiku 5.5 можно выбрать в Claude.ai на планах Free, Pro, Max, Team и Enterprise — в веб-версии и в приложениях для iOS и Android. Sonnet 5.5 доступен в Claude.ai всем пользователям.
Расходует ли Haiku меньше лимита подписки, Anthropic напрямую не говорит. В справке Claude о лимитах использования сказано, что расход зависит от длины и сложности разговора, используемых функций, выбранной модели и уровня effort, но соотношение между моделями не опубликовано. Как устроены пятичасовые и недельные лимиты на разных планах, собрано в статье «Лимиты Claude Pro и Max в неделю и за 5 часов: сводная таблица».
С 7 октября Anthropic постепенно включает подписчикам Max и Team ежемесячный кредит на Claude API: $100 на Max 5x, $200 на Max 20x и до $500 общего пула на Team. Его можно потратить на любую модель в Claude Platform, в том числе на Haiku 5.5.
Россия, по состоянию на 8 октября 2026 года, не входит в список стран, где Anthropic официально предоставляет Claude. На само сравнение моделей это не влияет.
Вопросы о Claude Haiku 5.5 и Sonnet 5.5
Хватает ли Claude Haiku 5.5 для программирования?
Для узких задач — да: поиск по коду, сводка изменений, небольшие правки, которые проверяются тестами. Для многошаговой агентной работы в терминале — нет: в Terminal-Bench 4.0 у Haiku 5.5 39,2 % против 70,6 % у Sonnet 5.5 по данным Anthropic, и сама Anthropic называет Sonnet 5.5 и Opus 5.5 лучшим выбором для сложного агентного программирования. Рабочая связка в Claude Code — Sonnet в основной сессии и Haiku в субагентах.
Когда нужен не Sonnet 5.5, а Opus 5.5 или Fable 5.1?
Когда Sonnet 5.5 не решает задачу даже на xhigh или max. Цены Opus 5.5 и работа его лимитов в подписке описаны в статье «Claude Opus 5.5: цена API и как сбросить лимит подписки», а выбор между двумя старшими моделями — в статье «Claude Fable 5.1 или Opus 5.5: что выбрать и когда стоит доплатить».
Источники11
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 8 окт. 2026 г..
Источники11
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 8 окт. 2026 г..
- 1.Artificial Analysisartificialanalysis.ai/models/releases/comparisons/claude-haiku-5-5-vs-claude-sonnet-5-5
- 2.странице цен Claude APIplatform.claude.com/docs/en/about-claude/pricing
- 3.анонса Claude Haiku 5.5anthropic.com/claude-haiku-5-5
- 4.руководство Anthropic по выбору моделиplatform.claude.com/docs/en/about-claude/models/choosing-a-model
- 5.документации Anthropic по параметру effortplatform.claude.com/docs/en/build-with-claude/effort
- 6.списка изменений Haiku 5.5 по сравнению с Haiku 4.5platform.claude.com/docs/en/models/haiku-5-5/whats-new-haiku-5-5
- 7.руководстве по промптам для Haiku 5.5platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-haiku-5-5
- 8.настройках моделей в документации Claude Codecode.claude.com/docs/en/model-config
- 9.странице Claude Haiku на сайте Anthropicanthropic.com/claude/haiku
- 10.справке Claude о лимитах использованияsupport.claude.com/en/articles/11647753-understanding-usage-and-length-limits
- 11.список стран, где Anthropic официально предоставляет Claudeanthropic.com/supported-countries