Claude Opus 5.5 или GPT-6 Astra: что выбрать по цене задачи
Токен Claude Opus 5.5 на 60 % дешевле, чем у GPT-6 Astra, но задача — не всегда: на коротких задачах Opus дешевле, на длинной агентной работе — уже нет.
Содержание
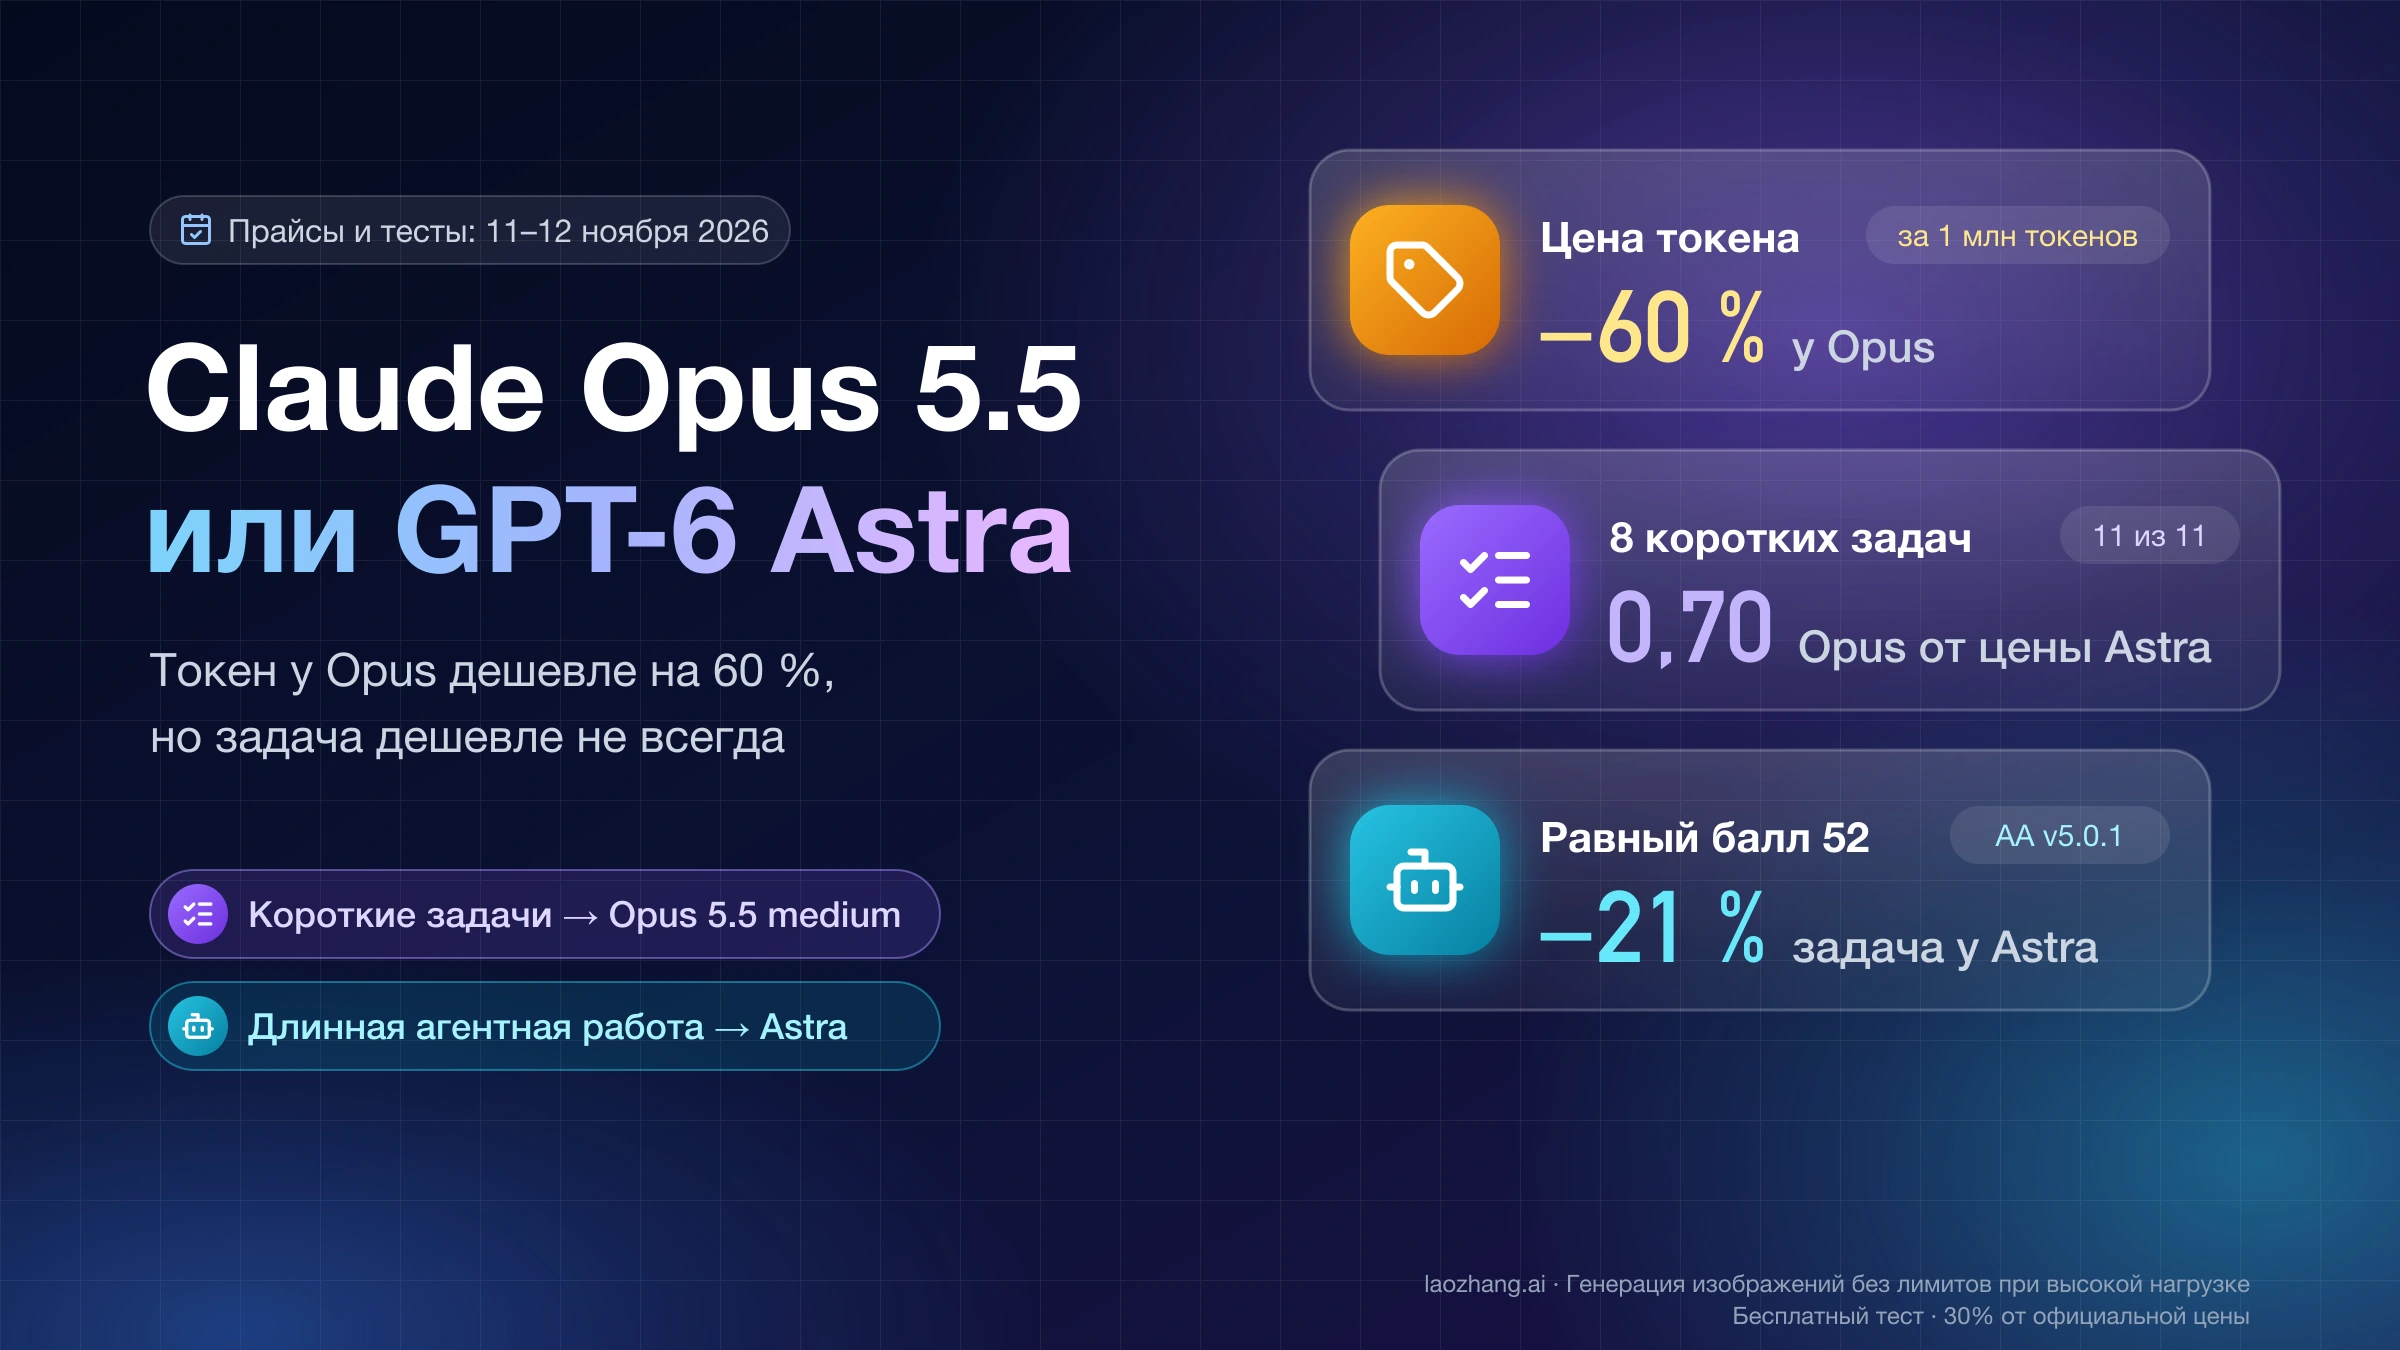
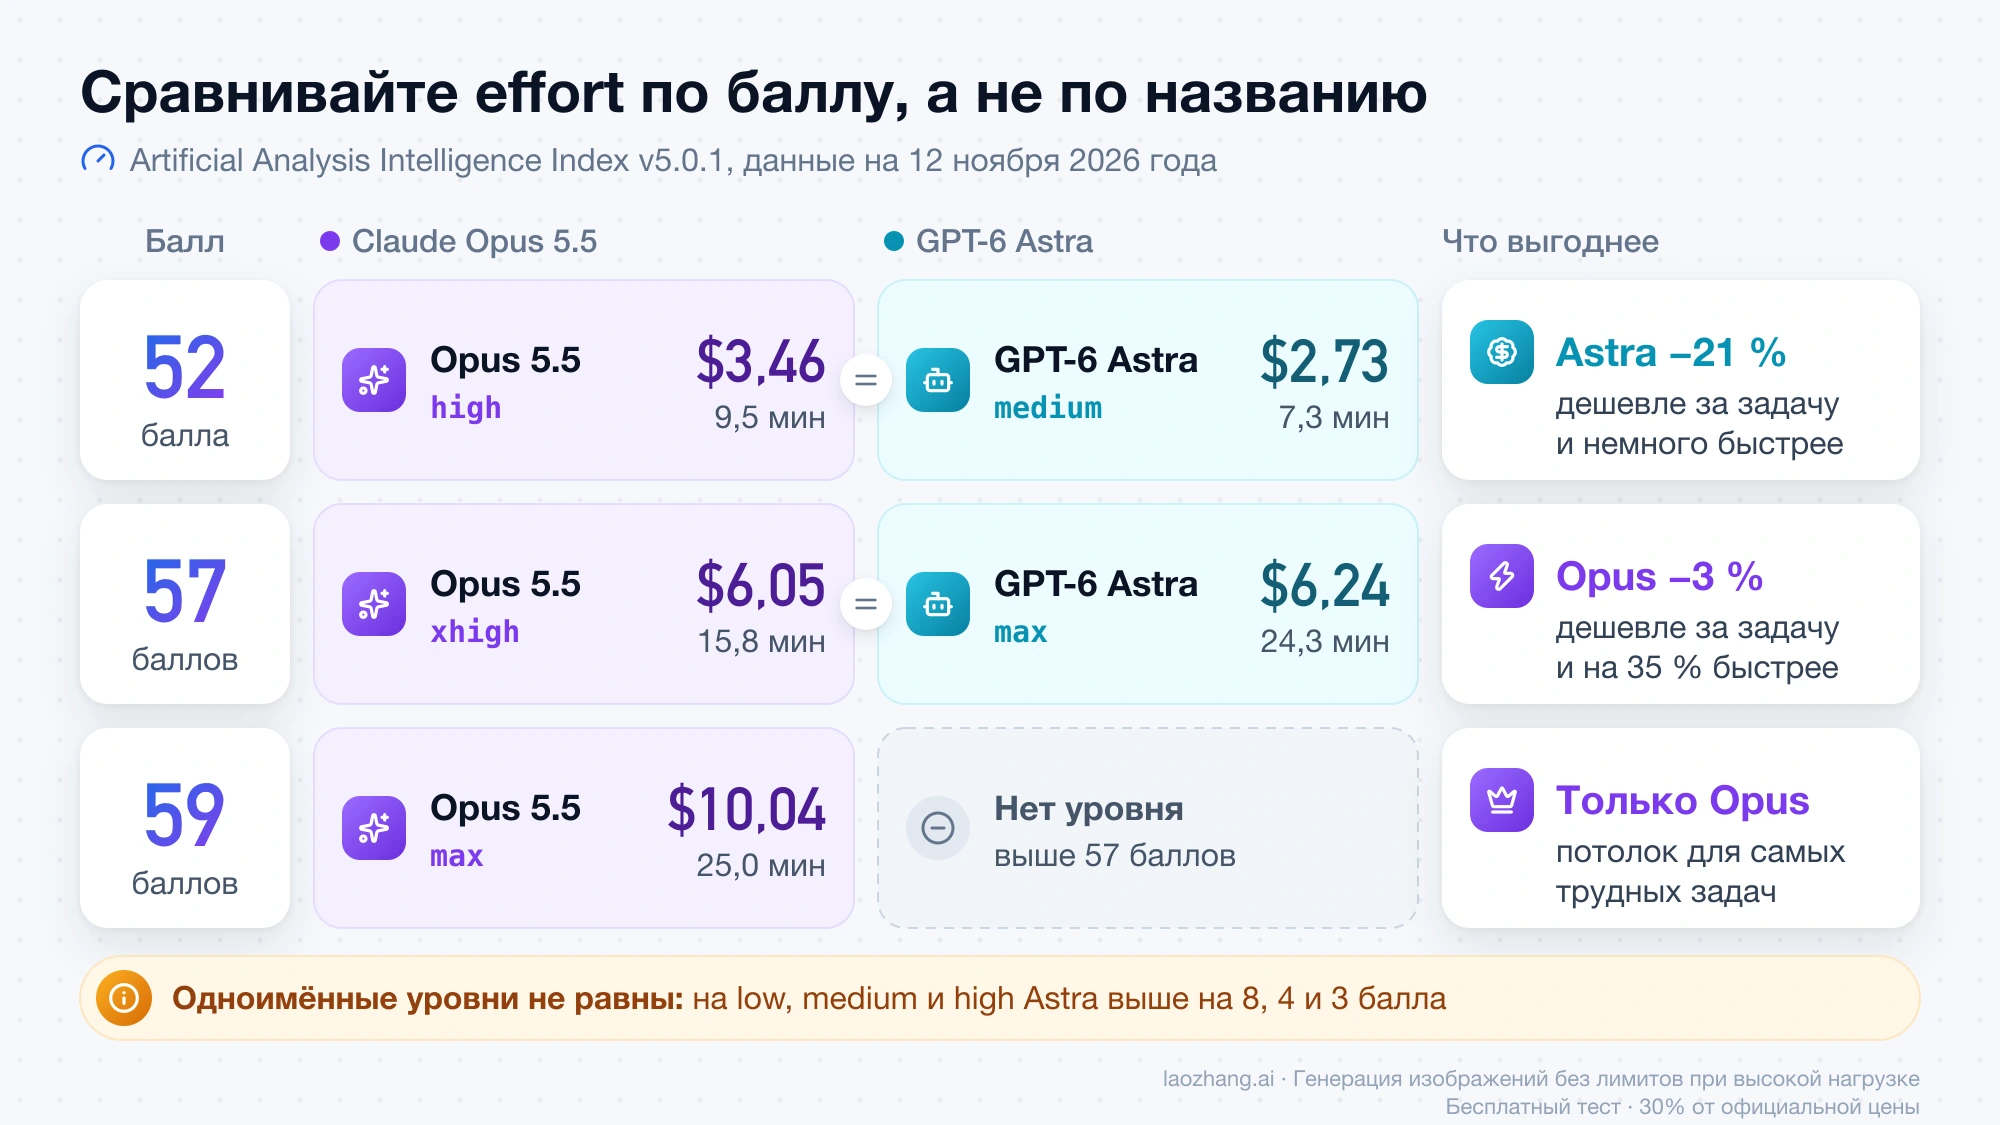
Если ваша работа — много небольших чётко поставленных запросов (написать функцию под тесты, разобрать лог, сжать документ), делайте основной моделью Claude Opus 5.5 на уровне рассуждений (effort) medium. 11 ноября 2026 года на одних и тех же 8 задачах он прошёл все проверки и обошёлся в 0,70 от стоимости GPT-6 Astra, запущенной без указания effort. Если же это длинные автономные прогоны агента в Codex или Claude Code, по умолчанию разумнее GPT-6 Astra на medium или high: в Artificial Analysis Intelligence Index v5.0.1 (данные на 12 ноября 2026 года) Astra medium набирает те же 52 балла, что Opus high, а задача у неё на 21 % дешевле. Opus на xhigh или max оставьте для работы, где нужен потолок: выше 57 баллов поднимается только он.
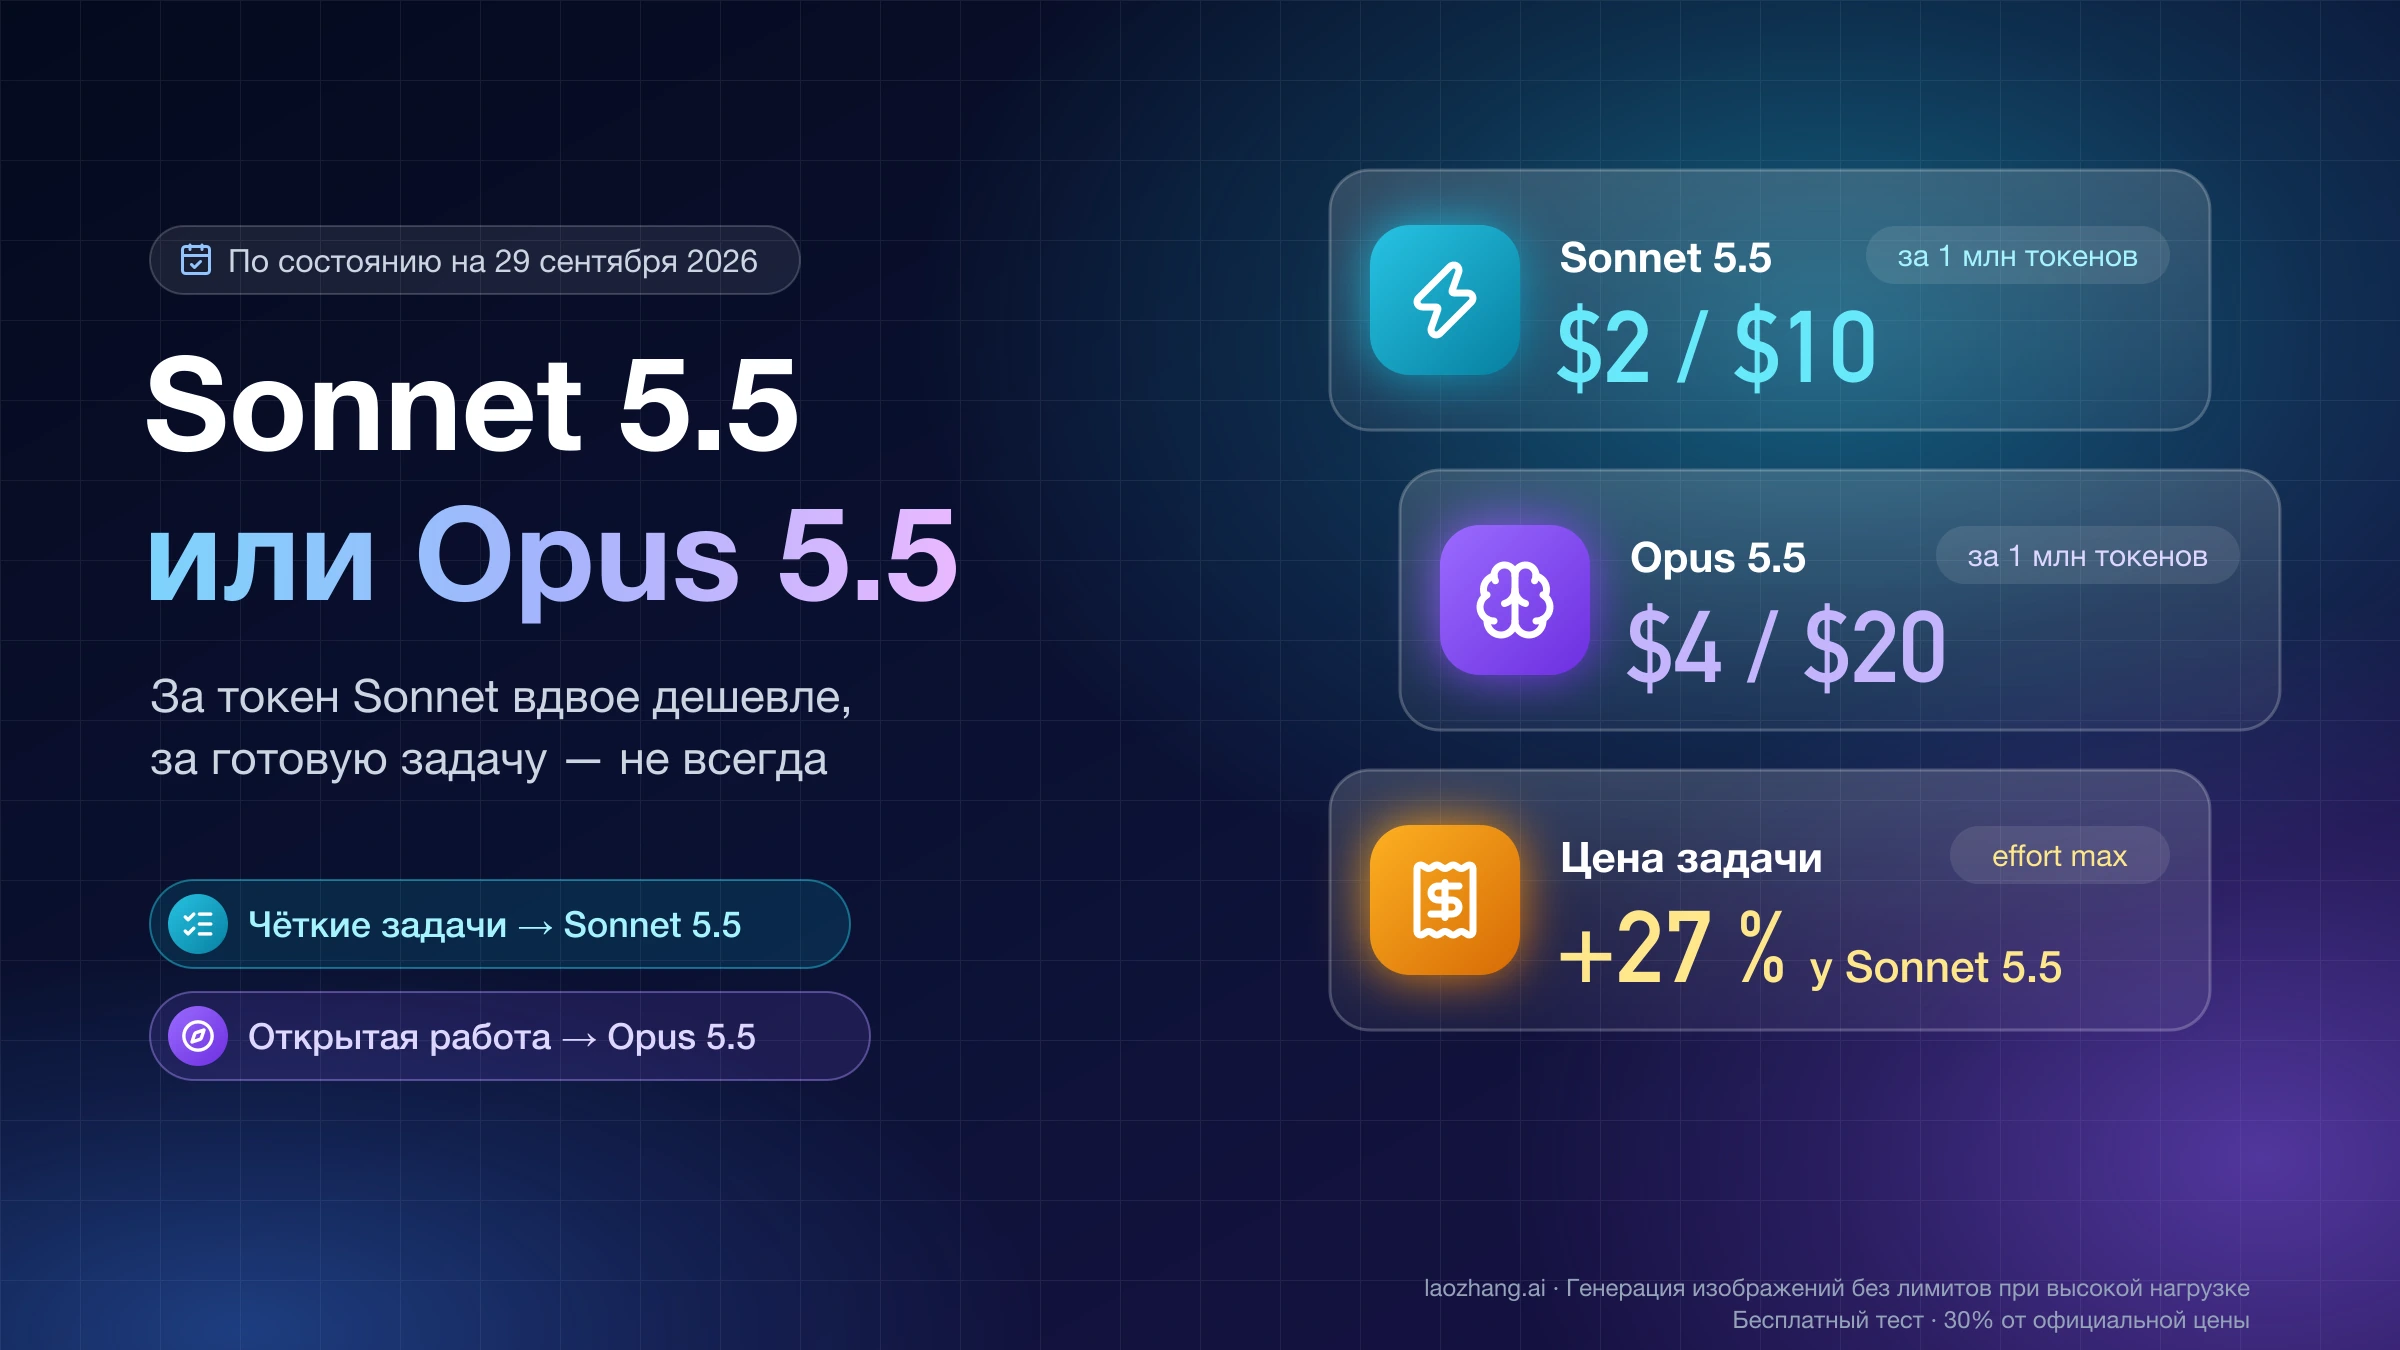
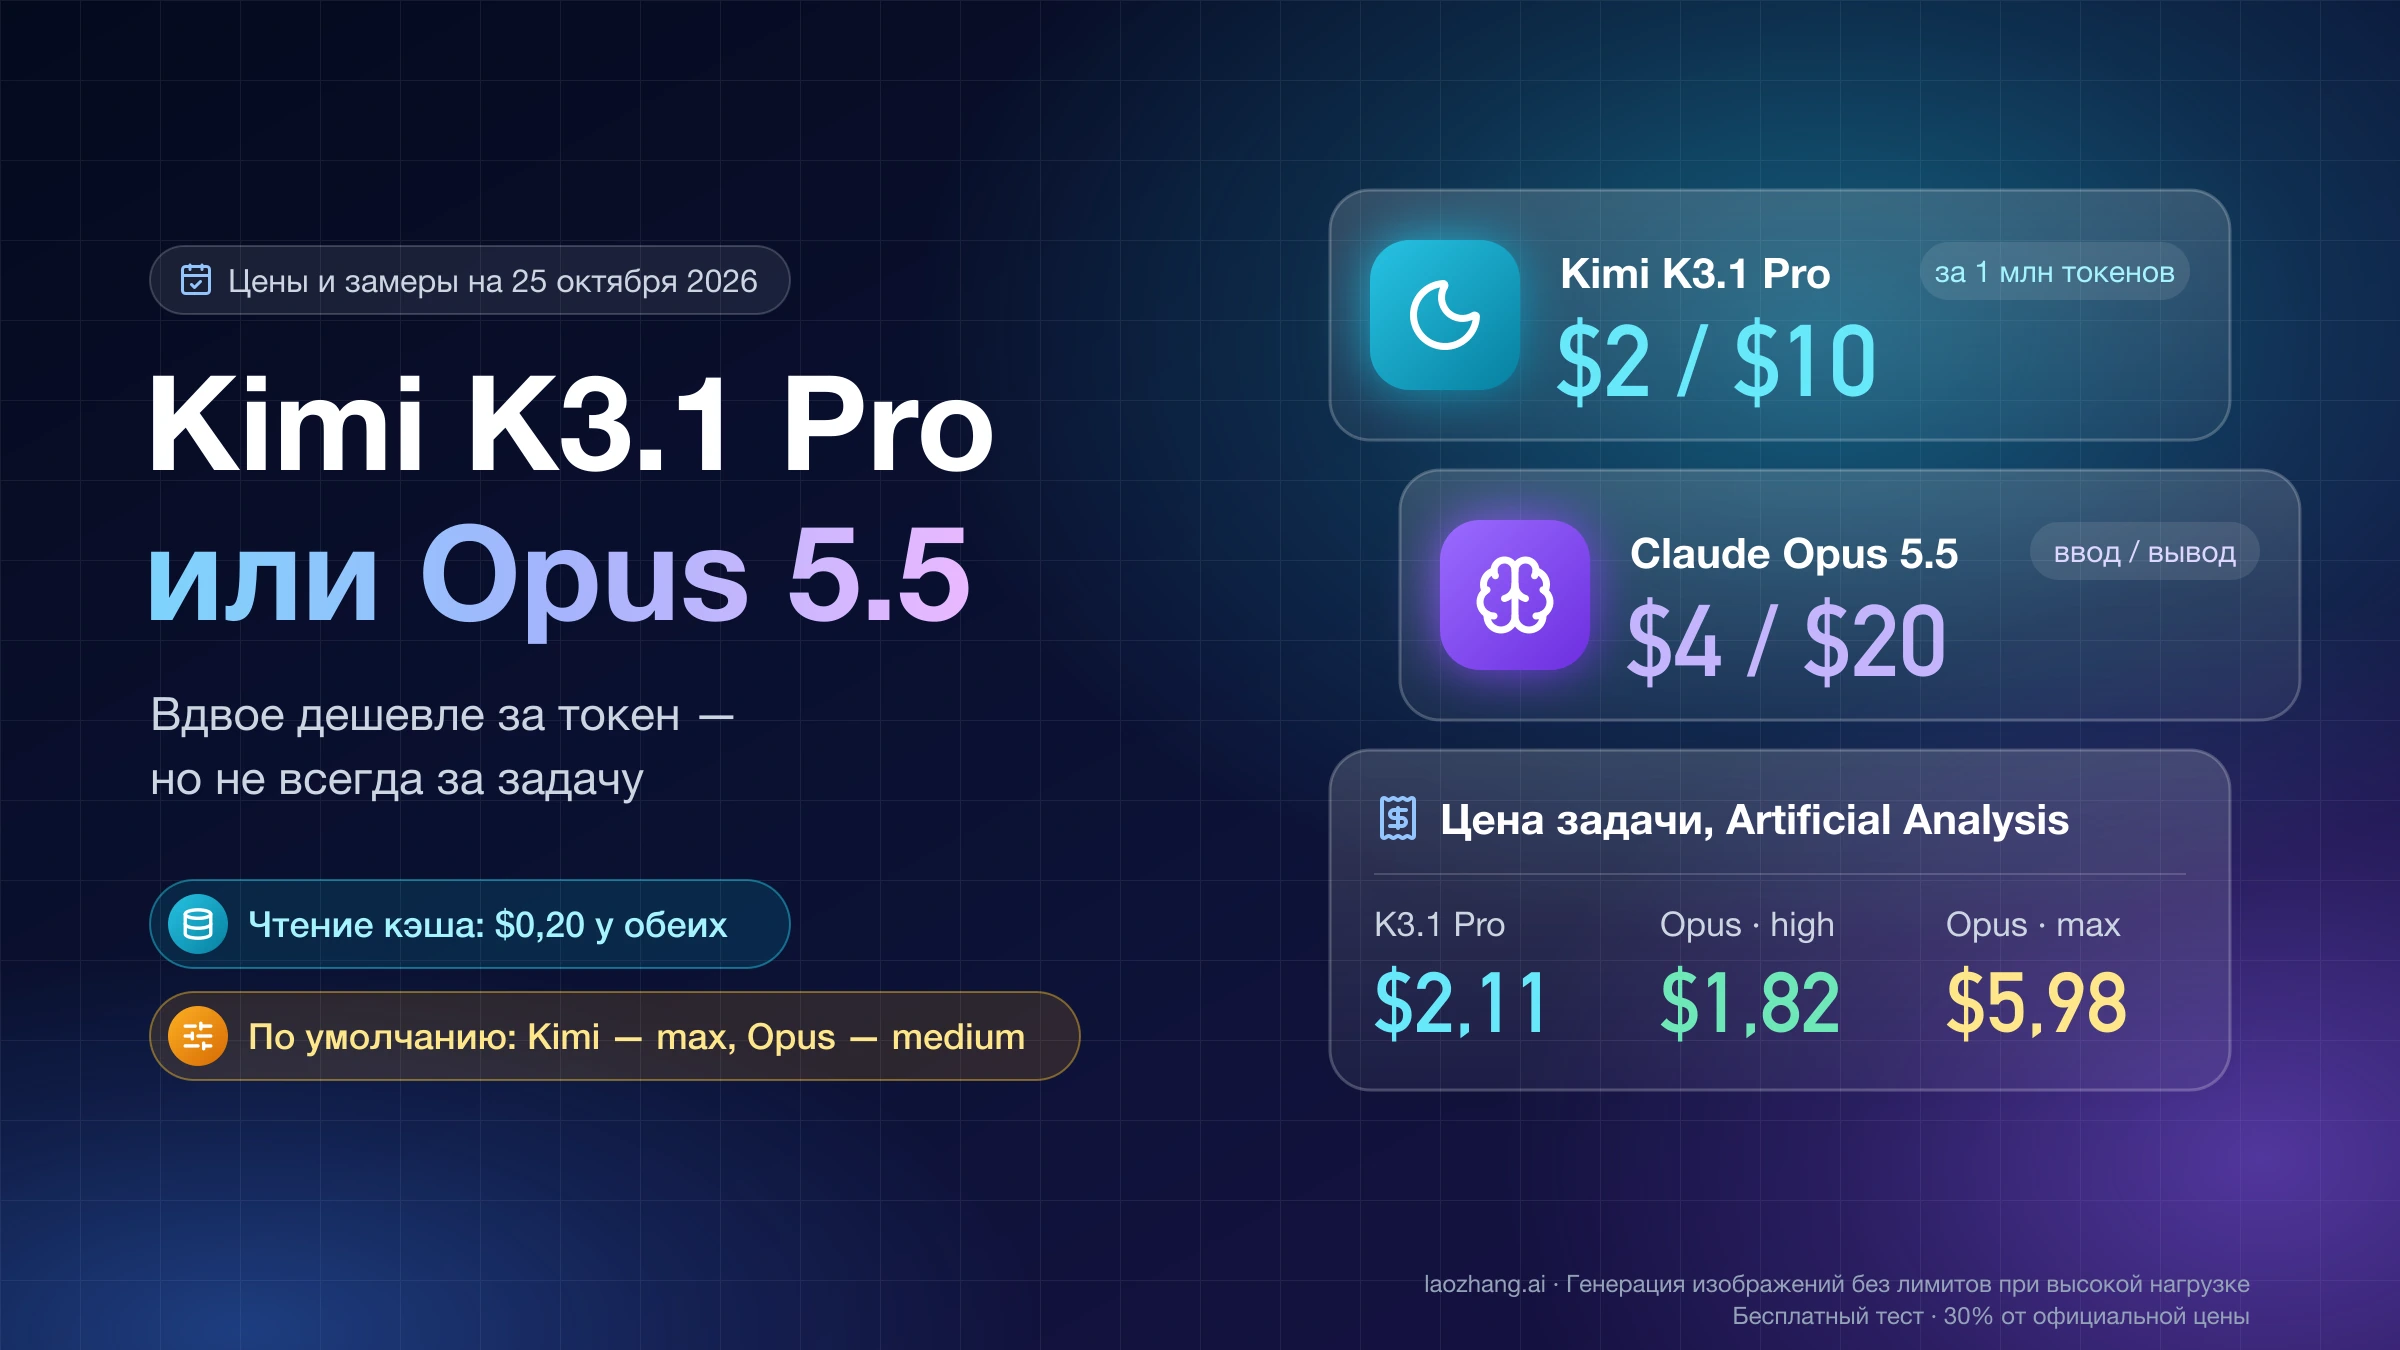
Цена за миллион токенов здесь почти ничего не предсказывает. По прайсам на 12 ноября 2026 года Opus 5.5 стоит $4 за 1 млн входных и $20 за 1 млн выходных токенов, Astra — $10 и $50, то есть токен Opus на 60 % дешевле. Но одинаковый текст Opus считает примерно в полтора раза большим числом токенов, пишет более длинные ответы, и на задачах Artificial Analysis его стоимость на одноимённых уровнях составляет от 0,69 до 1,65 стоимости Astra. Поэтому сравнивать надо не уровни с одинаковым названием, а уровни, которые дают одинаковый результат.
Вторую модель стоит подключать по конкретным условиям. Исследовательские задачи и точные науки отдавайте Astra: в оценках GDP.pdf, CritPt и Terminal-Bench-Science у Artificial Analysis она впереди почти на всех уровнях. Запросы длиннее 272 000 входных токенов оставляйте Opus: у Astra такой запрос целиком тарифицируется по повышенной ставке. Если ваш код вызывает функции через Chat Completions, для Astra его придётся перевести на Responses API: только там у неё работает вызов функций. Чтобы проверить выбор на своей нагрузке, хватит формулы стоимости и пар уровней с равным баллом из последних разделов.
Opus 5.5 или GPT-6 Astra: какую модель и какой effort брать
Выбор определяет тип работы, а не прайс: на коротких задачах с проверяемым ответом дешевле выходит Opus 5.5, на длинной агентной работе среднего уровня — Astra, а на самом верху снова Opus. Условия, при которых решение меняется, собраны в таблице; цифры к каждой строке — в разделах ниже.
| Ваша работа | Модель и уровень по умолчанию | Почему |
|---|---|---|
| Короткие чётко поставленные запросы через API: код под тесты, извлечение данных, пересказ | Opus 5.5, medium | В тесте 11 ноября все ответы верны, а набор стоил заметно дешевле, чем у Astra |
Длинная агентная работа, где хватает уровня Astra medium–high | GPT-6 Astra, medium или high | По Artificial Analysis при равном балле задача у Astra дешевле, а на одноимённых уровнях балл выше |
| Самые трудные многошаговые задачи, нужен максимум | Opus 5.5, xhigh или max | При равном балле 57 Opus xhigh дешевле и быстрее Astra max; балл 59 есть только у Opus |
| Исследования и точные науки | GPT-6 Astra | Впереди в GDP.pdf, CritPt и почти везде в Terminal-Bench-Science |
| Готовые деловые документы и отчёты | Opus 5.5 | Впереди в AA-Briefcase на всех уровнях |
«Astra 6» и «GPT Astra» — это та же GPT-6 Astra (gpt-6-astra), вышедшая 3 сентября 2026 года; модели GPT-6.2 у OpenAI нет, и на 12 ноября Astra остаётся её старшей общей моделью. Opus 5.5 (claude-opus-5-5, вышел 22 сентября) с 9 ноября уже не старшая модель Anthropic: выше стоит Claude Fable 5.2 за $8 / $40, а сама Anthropic советует начинать большую часть работы с кодом и документами с Opus 5.5 и подниматься до Fable, только если его не хватает. Сравнение старшей модели с Astra — в материале «Fable 5.2 или GPT-6 Astra: что выбрать и сколько стоит задача», шаг внутри Claude — в «Claude Fable 5.2 или Opus 5.5: что выбрать и на каком effort». Если обе модели для вашей нагрузки слишком дороги, посмотрите «Claude Sonnet 5.5 или GPT-6 Astra: стоит ли переходить», «GPT-6.1 Sol, GPT-6 Astra и GPT-6 Sol: какую модель выбрать» и «Claude Opus 5.5 или GPT-6.1 Sol (и GPT-6 Sol): выбор для кода».
«На 60 % дешевле» за токен: сколько стоили одни и те же 8 задач
«На 60 % дешевле» относится только к цене токена: $4 / $20 у Opus 5.5 против $10 / $50 у Astra по странице цен Claude API и странице цен OpenAI API на 12 ноября 2026 года. Стоимость задачи зависит ещё и от того, сколько токенов модель насчитает и напишет. 11 ноября 2026 года одни и те же 8 небольших задач на код и рассуждение прогнали на обеих моделях через шлюз laozhang.ai, одним ключом, в родном формате запросов каждого вендора, без системного промпта и инструментов. Opus работал на medium (значение по умолчанию в API, передано явно) и high, Astra — без указания effort и на high.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
Задачи были такие: текстовая задача на рассуждение; функции merge_intervals, parse_duration и top_words со скрытыми тестами (8, 18 и 10 тестов); пересказ статьи на 6 723 слова ровно в 5 пунктов; вычислитель выражений без eval (25 скрытых тестов); разбор строки CSV без модуля csv (16 тестов); подсчёт чисел по сумме цифр. Последние три задали по два раза, так что у каждой конфигурации 11 оценённых ответов. Стоимость пересчитана по прайсу из числа токенов, которое вернул API.
| Конфигурация | Прошли проверку | Токены ввода | Токены вывода | Стоимость набора | Время набора |
|---|---|---|---|---|---|
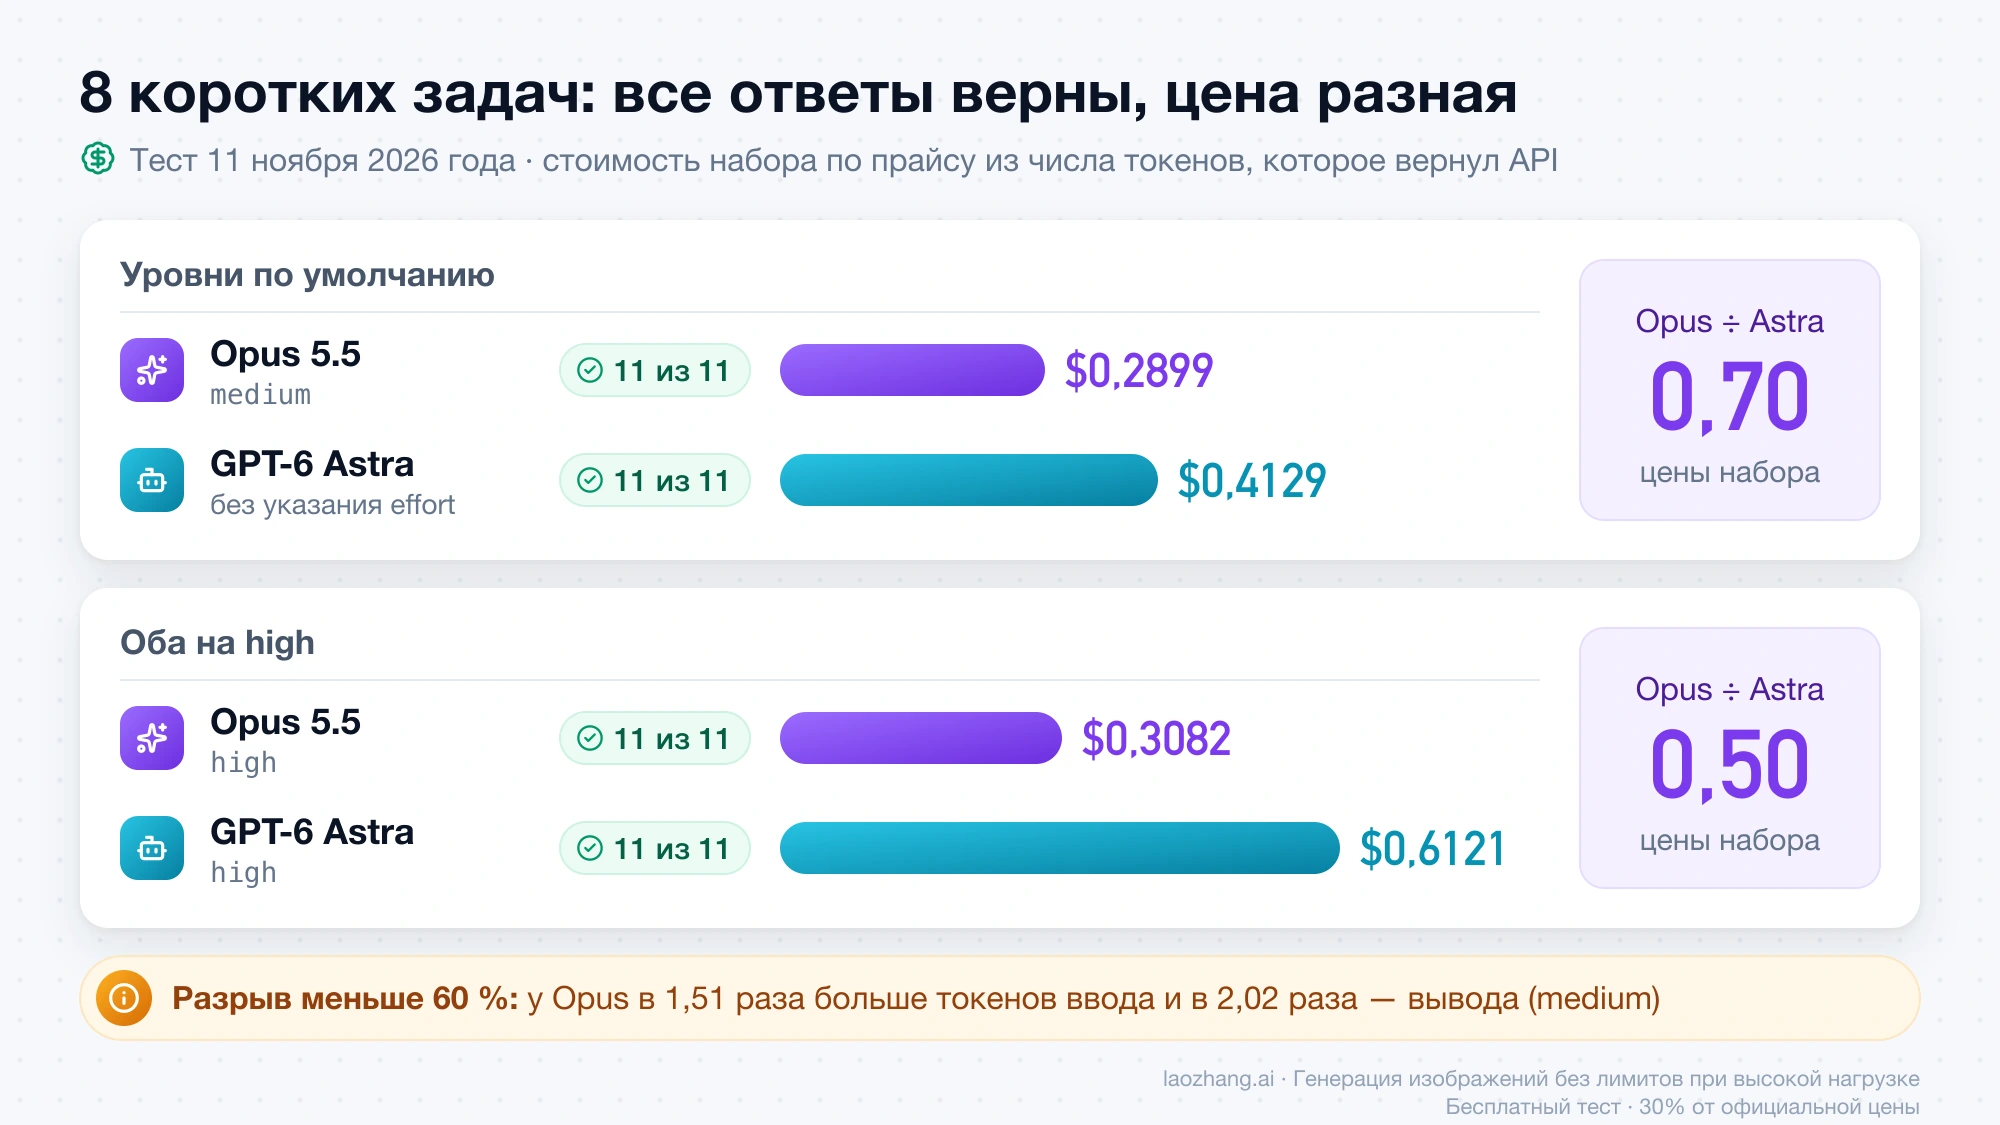
Opus 5.5, medium | 11 из 11 | 17 202 | 11 056 | $0,2899 | 126,1 с |
Opus 5.5, high | 11 из 11 | 17 202 | 11 968 | $0,3082 | 147,2 с |
| GPT-6 Astra без указания effort | 11 из 11 | 11 407 | 5 471, из них 1 964 на рассуждение | $0,4129 | 91,8 с |
GPT-6 Astra, high | 11 из 11 | 11 407 | 9 455, из них 6 042 на рассуждение | $0,6121 | 141,7 с |
Все 44 ответа прошли проверку, и Opus оказался дешевле в обеих парах: medium стоил 0,70 от Astra без указания effort, high — 0,50 от Astra high. Разрыв меньше, чем обещают 60 %, потому что на тех же промптах Opus насчитал в 1,51 раза больше входных токенов и на medium написал в 2,02 раза больше выходных, чем Astra без указания effort (на high против high — в 1,27 раза). Из 11 ответов Astra без указания effort была дешевле Opus medium только в одном: в первом прогоне разбора CSV ($0,0173 против $0,0227). В стоимость Astra входит оплаченная запись в кэш на задаче с длинной статьёй, $0,0253 сверх обычной цены ввода в каждой конфигурации; без неё соотношение было бы 0,75 и 0,53, и Opus всё равно дешевле.
У этого теста есть границы. Один шлюз, один день на каждую модель, по 1–2 прогона на задачу; Opus не показывает токены рассуждения отдельно, а время включает задержку шлюза. Задачи короткие и полностью описаны, агентного цикла нет, поэтому тест показывает токены, деньги и время на работе, которую решают обе модели, а не то, какая из них умнее. По времени Opus medium был медленнее Astra без указания effort в 1,37 раза, на high — почти вровень.
Какой effort Opus 5.5 соответствует какому уровню GPT-6 Astra
Одноимённые уровни effort у двух вендоров — не одинаковый объём работы, и сопоставлять их надо по результату. У Opus 5.5 значения low, medium, high, xhigh и max, по умолчанию в API и в Claude Code — medium. У Astra те же пять значений (none и minimal она не принимает), а какое из них действует по умолчанию, OpenAI в документации не указывает. Независимую раскладку по всем уровням даёт сравнение Claude Opus 5.5 и GPT-6 Astra на Artificial Analysis: Intelligence Index v5.0.1, данные на 12 ноября 2026 года, обе модели посчитаны по прайсу.
| Уровень | Opus 5.5: балл | Opus: $ за задачу | Opus: минут | Astra: балл | Astra: $ за задачу | Astra: минут | Цена Opus ÷ Astra |
|---|---|---|---|---|---|---|---|
low | 35 | $0,98 | 3,0 | 43 | $1,42 | 4,0 | 0,69 |
medium | 48 | $2,45 | 7,1 | 52 | $2,73 | 7,3 | 0,90 |
high | 52 | $3,46 | 9,5 | 55 | $3,24 | 9,5 | 1,07 |
xhigh | 57 | $6,05 | 15,8 | 55 | $3,66 | 11,1 | 1,65 |
max | 59 | $10,04 | 25,0 | 57 | $6,24 | 24,3 | 1,61 |
На low, medium и high Astra выше на 8, 4 и 3 балла, на xhigh и max выше Opus — на 2. Если же ставить рядом уровни с одинаковым баллом, картина такая. При 52 баллах Opus high стоит $3,46, а Astra medium — $2,73, то есть Astra на 21 % дешевле и немного быстрее (7,3 против 9,5 минуты). При 57 баллах Opus xhigh за $6,05 на 3 % дешевле Astra max за $6,24 и на 35 % быстрее (15,8 против 24,3 минуты). Astra high за $3,24 набирает 55 баллов, на 3 больше Opus high, и стоит на 6 % меньше. Только у Opus есть уровень выше 57 (max, 59 баллов за $10,04) и самый дешёвый вариант ниже 43 баллов (low, 35 баллов за $0,98). Строку Opus max Artificial Analysis помечает как «Max, Default Fallback»: часть задач защитные механизмы Anthropic передают другой модели, подробнее — в разделе об ограничениях.
Почему соотношение цен здесь 0,69–1,65, а не 0,40 по прайсу? Если бы обе модели тратили одинаковые токены, Opus стоил бы 0,40 от Astra. Разделив наблюдаемое соотношение на 0,40, получаем оценку: на задачах Artificial Analysis Opus расходует примерно в 1,7 (low) – 4,1 раза (xhigh) больше токенов в денежном выражении. Это расчёт, а не замер, и он предполагает похожую долю ввода, вывода и кэша у обеих моделей.
Длинный лог на 146 КБ: первый вызов и повтор из кэша
На одном длинном вводе первый вызов дешевле у Opus, а повтор того же промпта зависит от того, включён ли кэш. Задача: синтетический лог приложения на 146 КБ (1 500 строк, из них 326 строк ERROR), нужно точно посчитать семь значений — число ошибок по пяти кодам, число разных пользователей с ошибкой E503 и запрос с наибольшим числом повторов; правильные ответы заранее получены скриптом. Opus 5.5 11 ноября 2026 года решил её верно 4 раза из 4 (по два прогона на medium и high) за 55,7–59,0 с, потратив 78 537 входных и 7 699–8 255 выходных токенов, то есть $0,47–0,48 за прогон. Astra без указания effort была верна 3 раза из 3 (два прогона 4 ноября, один 11 ноября) за 26,3–46,4 с на 55 843 входных и 2 423–3 793 выходных токенах; на high — 2 из 2 за 71,7–77,5 с.
С кэшем арифметика меняется. OpenAI по умолчанию кэширует промпты Astra длиннее 1 024 токенов, берёт за запись 1,25 цены ввода и 0,1 цены ввода за чтение; в Claude API кэша нет, пока в запросе не указан cache_control, а чтение из него стоит 0,05 цены ввода. Первый вызов Astra без указания effort стоил $0,75 без записи в кэш и $0,82, когда запись была оплачена, так что Opus на первом вызове обошёлся в 57–64 % от Astra. Повтор того же промпта у Astra в пределах получаса прочитался из кэша и стоил $0,21 (на high — $0,34), дешевле некэшированного вызова Opus. В запросах к Opus cache_control не передавался, поэтому его кэшированный повтор не измерялся; по прайсу чтение 78 537 токенов из кэша стоит около $0,016, а вывод 7 699–8 255 токенов — $0,15–0,17, итого примерно $0,17–0,18. Если длинный промпт повторяется, Opus с явной разметкой кэша по этому расчёту дешевле Astra, а без разметки повтор дешевле у Astra.
Русский промпт: ввод у Opus дешевле на 37 %, а не на 60 %
Один и тот же текст две модели режут на разное число токенов, и для русского языка разница заметная. Короткие одинаковые фрагменты с одной и той же инструкцией отправили обеим моделям (Opus 11 ноября 2026 года, Astra 4 ноября) и вычли токены самой инструкции. Токенизатор от даты не зависит, а цена ввода у Opus составляет 0,4 от Astra, поэтому итоговое соотношение стоимости ввода — это коэффициент по токенам, умноженный на 0,4.
| Текст | Токенов у Opus 5.5 | Токенов у Astra | Opus ÷ Astra | Стоимость ввода Opus ÷ Astra |
|---|---|---|---|---|
| Русский фрагмент | 302 | 193 | 1,56 | 0,63 |
| Английский фрагмент | 199 | 137 | 1,45 | 0,58 |
| Китайский фрагмент | 247 | 165 | 1,50 | 0,60 |
| Японский фрагмент | 312 | 254 | 1,23 | 0,49 |
| Корейский фрагмент | 396 | 208 | 1,90 | 0,76 |
| Испанский фрагмент | 304 | 162 | 1,88 | 0,75 |
| Английская статья на 6 723 слова | 15 335 | 10 106 | 1,52 | 0,61 |
| Лог на 146 КБ | 78 537 | 55 843 | 1,41 | 0,56 |
Для русских промптов и документов ввод у Opus дешевле не на 60 %, а примерно на 37 %. Фрагменты короткие, около 250–800 знаков, и на длинном тексте коэффициент может немного отличаться, но порядок совпадает с длинными примерами из таблицы. Выходные токены этот замер не описывает: их число зависит от задачи и уровня effort.
Что лучше для кода: Terminal-Bench и FrontierCode по уровням
Для кода ответ зависит от уровня effort и от того, чью таблицу смотреть. В независимых замерах Artificial Analysis v5.0.1 (12 ноября 2026 года) на max Opus 5.5 и Astra почти равны в Terminal-Bench 4.0 (59,6 % против 59,1 %), а в FrontierCode-AA 2.0 впереди Opus (46,4 % против 42,4 %). На high расклад другой: в Terminal-Bench 4.0 впереди Opus (56,6 % против 54,0 %), в FrontierCode-AA 2.0 — Astra (40,1 % против 35,9 %); на medium так же — Opus 52,5 % против 49,5 % в Terminal-Bench и Astra 36,6 % против 33,1 % в FrontierCode. В инженерном подындексе Artificial Analysis Opus выше на xhigh и max (63 и 65 против 60 и 62), а на low–high выше Astra.
Практический вывод для агента, который пишет код: на high и ниже модели делят кодовые оценки (Opus впереди в Terminal-Bench, Astra в FrontierCode), а по общему индексу и цене за балл выигрывает Astra; если нужен максимум, впереди Opus на xhigh или max. Таблица Anthropic от 22 сентября 2026 года даёт Opus более уверенное преимущество в коде, и откуда разница, разобрано в следующем разделе.
Бенчмарки Anthropic и Artificial Analysis: чьи цифры и почему расходятся
Цифры, которые пересказывают обзоры, — это таблица самой Anthropic из анонса Claude Opus 5.5 от 22 сентября 2026 года; OpenAI таблицы против Opus 5.5 не публиковала. В ней Opus работает на max, если не указано иное, а в Terminal-Bench 4.0 сравниваются «лучшие результаты каждой модели»: Opus на xhigh и Astra на high, причём цифру Astra Anthropic берёт из отчёта OpenAI. Artificial Analysis прогоняет обе модели сам, на каждом уровне, в своих версиях тестов.
| Оценка | Anthropic, Opus / Astra | Artificial Analysis v5.0.1, max: Opus / Astra | Artificial Analysis, high: Opus / Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 66,4 % / 57,9 % | 59,6 % / 59,1 % | 56,6 % / 54,0 % |
| FrontierCode | v1.1 (Main): 54,4 % / 53,3 % | AA 2.0: 46,4 % / 42,4 % | 35,9 % / 40,1 % |
| AutomationBench | 40,0 % / 41,4 % (прогон Zapier) | 69,5 % / 68,5 % | 63,2 % / 66,6 % |
| Terminal-Bench-Science 0.1 | 58,7 % / 64,6 % | 59,0 % / 63,3 % | 49,0 % / 59,5 % |
| Humanity's Last Exam | с инструментами: 67,7 % / 57,2 % | HLE-Diamond: 67,9 % / 63,8 % | 55,6 % / 59,3 % |
| Деловые документы (рейтинг, не проценты) | GDPval-AA v2.1: 1 846 / 1 542 | AA-Briefcase v1.1: 1 801 / 1 569 | 1 682 / 1 505 |
Главное расхождение — в стоимости. Anthropic пишет, что на уровне по умолчанию Opus обходит Astra в FrontierCode «примерно за 20 % стоимости задачи», а в Terminal-Bench 4.0 сравнивается с ней «примерно за 40 % стоимости»; по её данным, Opus на medium набирает в FrontierCode v1.1 54,6 % против лучших 53,3 % у Astra. У Artificial Analysis Opus medium стоит 0,90 от Astra medium и набирает на 4 балла меньше, а в FrontierCode-AA 2.0 показывает 33,1 % против 42,4 % у Astra на max, то есть обратную картину. Вероятно, часть разницы дают разные версии тестов, разная обвязка и защитные механизмы, но ни один источник её прямо не объясняет, и ни одну из цифр нельзя назвать ошибочной. Сама Anthropic в том же анонсе замечает, что отрывы в бенчмарках стали менее надёжным ориентиром для реальной работы. Если ваша работа похожа на короткие задачи с проверяемым ответом, ориентируйтесь на прямой тест стоимости выше; если на длинные многошаговые задачи — на замеры Artificial Analysis, сделанные на всех уровнях одной обвязкой. Таблица Anthropic — заявление вендора о лучших результатах своей модели.
Остальные строки Artificial Analysis показывают, где каждая модель сильнее вне кода. Astra впереди в GDP.pdf и CritPt на всех уровнях (на high в CritPt — 71,5 % против 59,5 %) и в Terminal-Bench-Science везде, кроме пары xhigh (там Opus 61,9 % против 54,8 %). Opus впереди в AA-Briefcase, оценке готовых деловых документов, на каждом уровне.
Что пишут на Reddit и в X: на длинных задачах Opus выходит дороже
Сторонние отчёты о длинных открытых задачах в агентных инструментах («сделай игру», «построй проект») в основном указывают в обратную сторону от теста на коротких задачах. MindStudio 24 сентября 2026 года написал, что по качеству результата победил Opus 5.5, но Astra оказалась и быстрее, и дешевле: 32 минуты и $11,33. У Moe Lueker (25 сентября) Opus оба раза построил лучшую игру, но прогон обошёлся в $15,25 против $7,09 у Astra. Пользователь X EnvolDev около 9 ноября привёл $60,89 и 2 ч 19 мин у Opus против $16,89 и 34 мин у Astra, добавив, что результат Astra и близко не так хорош. Nate Herk на LinkedIn по 12 сценариям насчитал, что Astra потратила на 45 % меньше времени и вышла примерно на 38 % дешевле по оценочной стоимости API.
Встречается и обратное: в популярном комментарии на r/ClaudeCode автор пишет, что сжёг около $5 000 на задаче, вокруг которой Astra ходила кругами, а Opus решил её меньше чем за $100. Уровни effort, обвязка и промпты в этих отчётах неизвестны, поэтому суммы — это опыт авторов, а не свойства моделей. Общая картина такая: на открытой задаче без чёткого критерия готовности Opus дольше работает и доводит результат, поэтому прогон дороже, а качество авторы чаще оценивают выше. Если ваша задача такая же, задайте бюджет прогона на Opus заранее.
Какая модель быстрее: токены в секунду и время до готового ответа
Opus 5.5 генерирует текст быстрее, но готовый ответ не всегда приходит раньше. По Artificial Analysis v5.0.1 (12 ноября 2026 года) Opus выдаёт 103–116 выходных токенов в секунду против 36–41 у Astra; на странице сравнения OpenRouter около 4 ноября значились 69 и 33. При этом время задачи индекса на одноимённых уровнях почти равное (medium 7,1 против 7,3 минуты, high 9,5 против 9,5), потому что Opus пишет больше токенов, а при равном балле 57 быстрее Opus. Первый токен ответа на medium у Opus приходит через 14,7 с против 7,0 с у Astra, на high — через 21,9 с против 57,8 с.
В тесте 11 ноября Astra без указания effort закончила 8 задач за 91,8 с против 126,1 с у Opus medium, потому что Opus написал вдвое больше токенов; на high модели сравнялись (141,7 и 147,2 с), а медианное время до первого видимого текста составило 6,0–6,5 с у Opus и 5,0 с у Astra (7,4 с на high). На логе в 146 КБ Astra без указания effort отвечала за 26–46 с, Opus — за 56–59 с, Astra high — за 72–78 с. Для интерактивной работы с короткими запросами быстрее ощущается Astra без указания effort или на low–medium, для длинных задач на верхних уровнях — Opus.
Что исключает Opus 5.5 или Astra ещё до сравнения качества
Часть условий решает выбор раньше, чем дело доходит до баллов и цены задачи. Проверьте их по своей нагрузке:
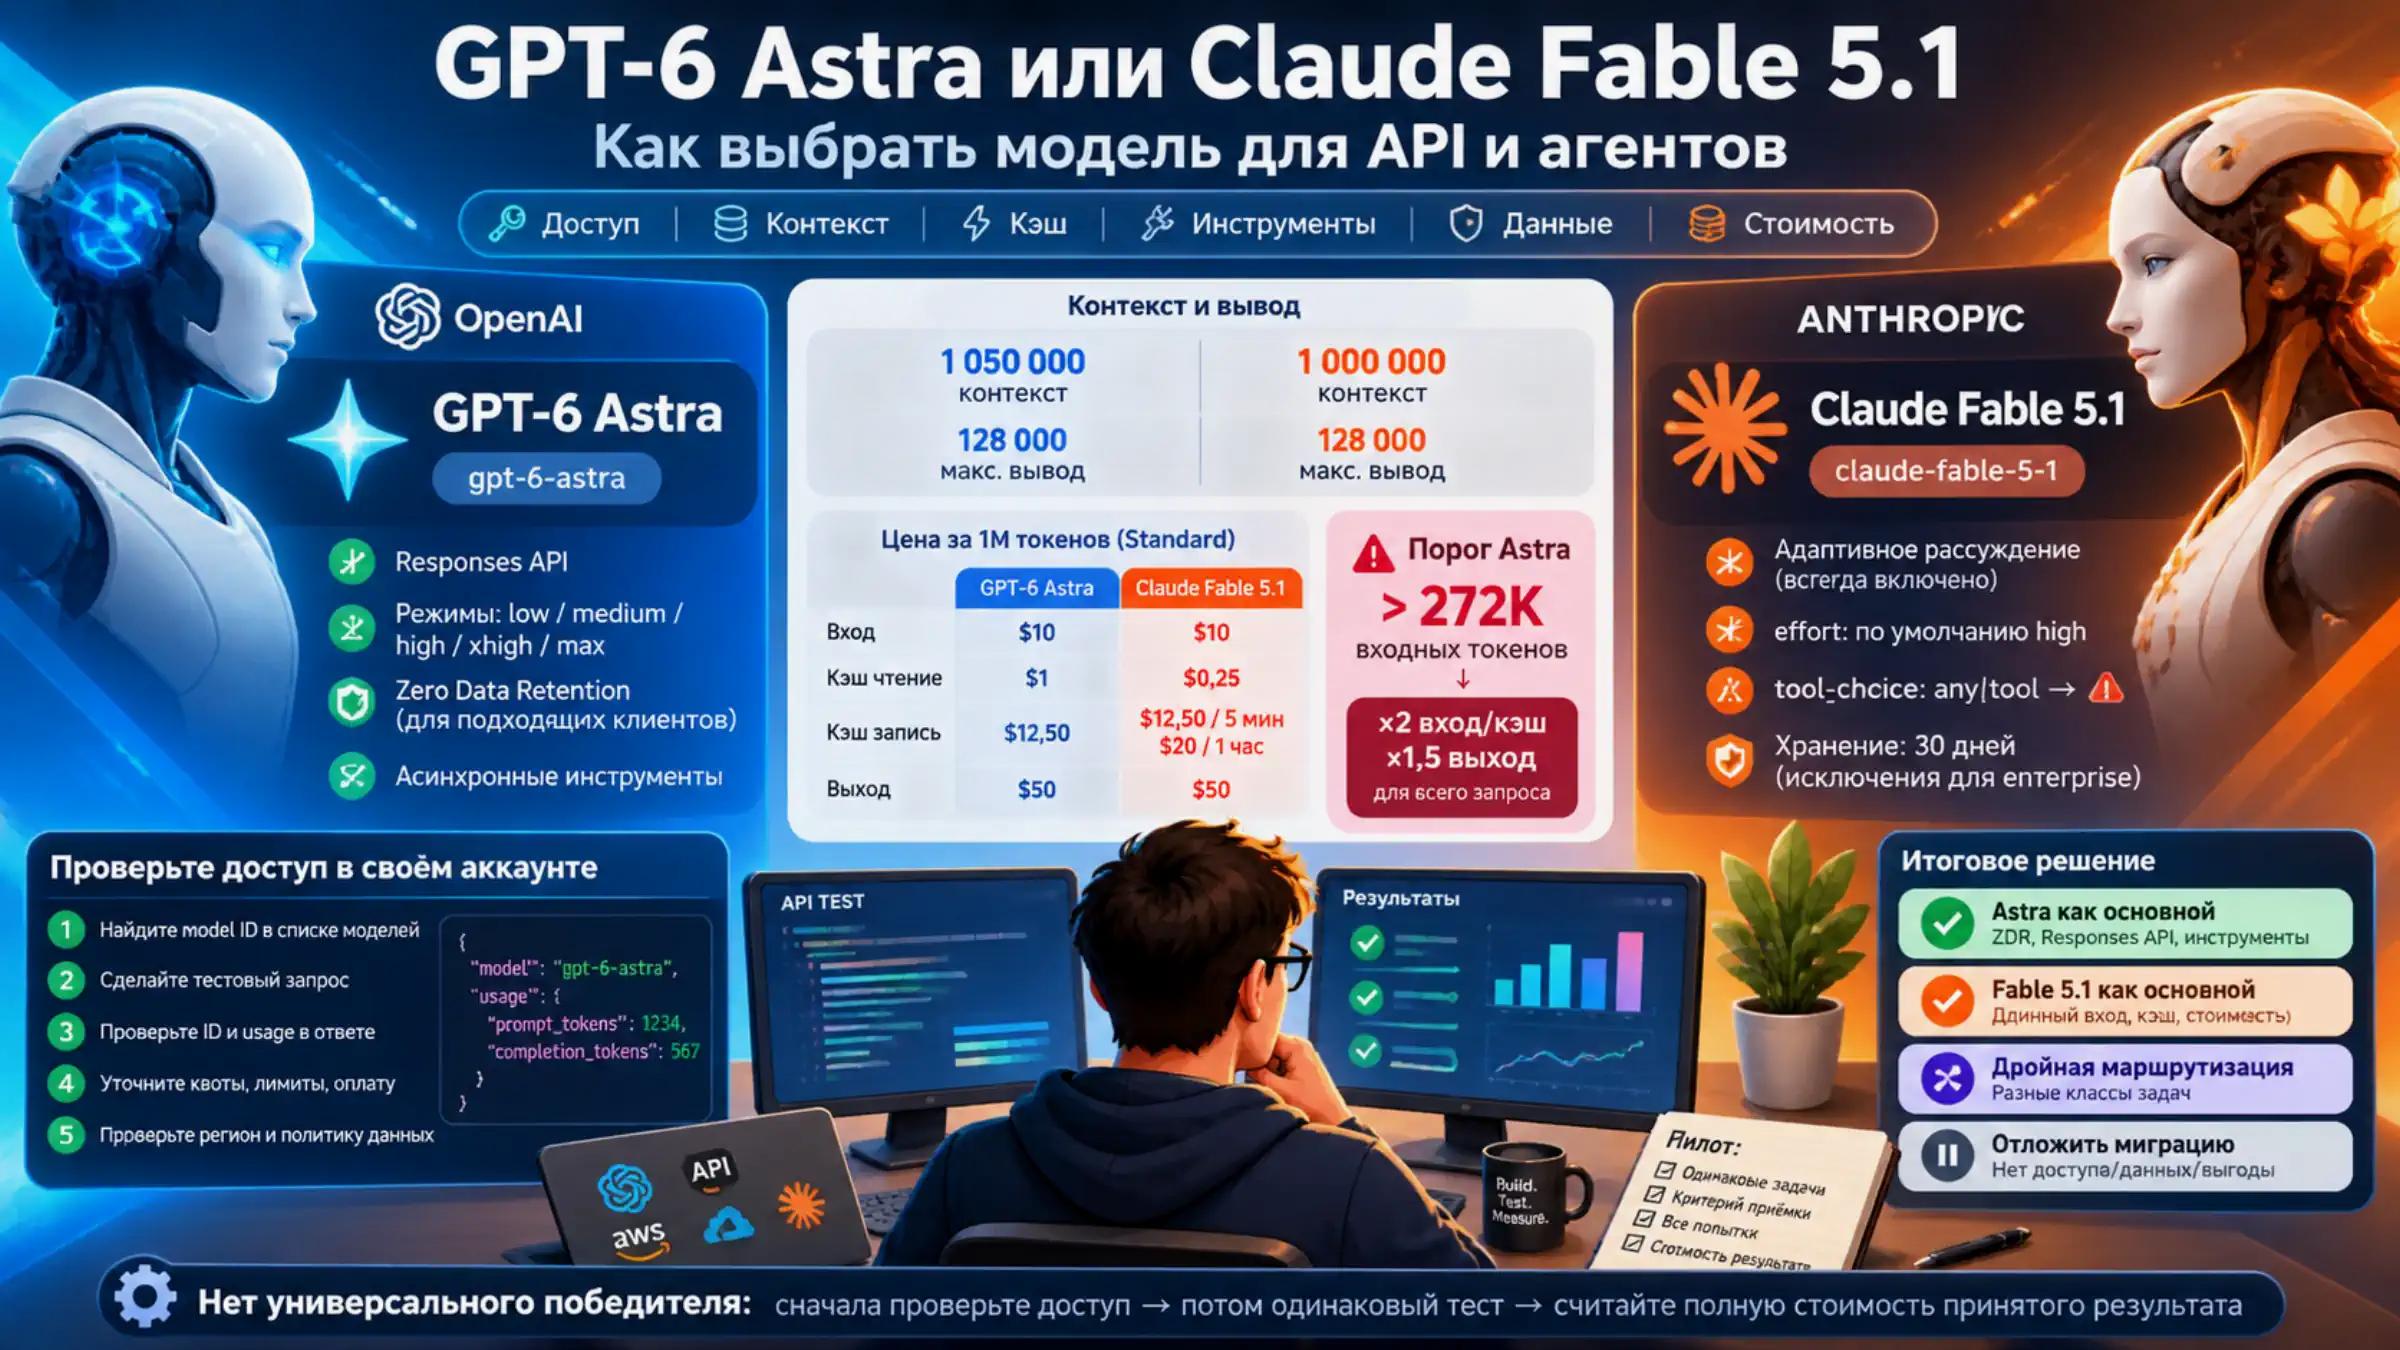
- Если в одном запросе бывает больше 272 000 входных токенов, Astra тарифицирует весь такой запрос по $20 за 1 млн входных и $75 за 1 млн выходных токенов (по прайсу OpenAI на 12 ноября 2026 года). У Opus 5.5 весь контекст в 1 млн токенов оплачивается по $4 / $20.
- Если ваш код вызывает функции через Chat Completions, с Astra он не заработает без переделки: вызов функций у неё есть только в Responses API.
- Если работа связана с кибербезопасностью, такие задачи защитные механизмы Opus 5.5 передают Opus 4.8, а часть задач по биологии и по разработке передовых языковых моделей — Opus 5; именно это Artificial Analysis отмечает пометкой «Default Fallback».
- Если промпты Astra не повторяются, автоматическая запись в кэш (от 1 024 токенов, 1,25 цены ввода) — лишний расход; её отключает параметр
prompt_cache_options.mode: "explicit". - Если нужна обработка данных в определённом регионе, эндпоинты резидентности данных у Astra стоят на 10 % дороже.
- Ни Anthropic, ни OpenAI не включают Россию и Беларусь в списки поддерживаемых стран (по состоянию на 11 и 4 ноября 2026 года соответственно), так что для аккаунтов в России это ограничение одинаково для обеих моделей и выбор между ними не меняет.
Подробнее о ступени 272K и уровнях кэша Astra — в материале «GPT-6 Astra API: тарифы, кэш и стоимость длинного контекста».
Как перепроверить выбор между Opus и Astra на своих задачах
Чужие замеры показывают направление, а окончательное решение даёт прогон вашей собственной нагрузки. Стоимость одного вызова считается одинаково для обеих моделей: входные токены × цена ввода + выходные токены × цена вывода, плюс запись в кэш и чтение из него, если они были. Для теста выше у Opus medium это 17 202 × $4 / 1 млн + 11 056 × $20 / 1 млн = $0,0688 + $0,2211 = $0,2899; у Astra без указания effort 11 407 × $10 / 1 млн + 5 471 × $50 / 1 млн = $0,1141 + $0,2736 = $0,3876, плюс $0,0253 за запись в кэш, итого $0,4129.
- Возьмите 10–20 реальных задач из своей работы, у которых результат можно проверить: тесты, эталонный ответ или чёткий критерий готовности.
- Прогоните их на парах уровней с близким баллом Artificial Analysis: Opus
highи Astramedium, Opusxhighи Astramax; для коротких задач — Opusmediumи Astra без указания effort. - Из ответа API сохраните число входных, выходных и кэшированных токенов. У Astra токены рассуждения входят в выходные; Opus их отдельно не показывает, но тоже берёт за них как за вывод.
- Посчитайте стоимость по формуле выше и сравнивайте только прогоны, прошедшие проверку: переделка неудачного ответа тоже стоит денег.
- Если промпты на русском, считайте входные токены по ответу API, а не по длине текста.
Модель, которая дешевле при одинаковой доле успешных ответов, и становится основной; вторую оставьте для задач из таблицы в начале, где она сильнее.
Opus 5.5 и Astra в подписках Claude и ChatGPT
В подписках выбор устроен иначе, и API ни одна из них не покрывает. По состоянию на 6 ноября 2026 года на бесплатном тарифе Claude нет ни Opus 5.5, ни Claude Code, а в Pro ($20 в месяц или $17 при оплате за год), Max ($100), Ultra ($200), Team и Enterprise Opus 5.5 есть. В ChatGPT, по данным на 26 октября 2026 года, Free и Go получают GPT-6 Luna, а не Astra; на Plus и стандартном Business в режимах Work и Codex даётся примерно 5–45 локальных сообщений Astra за 5 часов, у Pro пятичасового лимита нет, а в Enterprise и Edu модель должен включить владелец рабочего пространства. Какие тарифы ChatGPT позволяют выбрать Astra в обычном чате, OpenAI прямо не указывает. Цена Opus в API и лимиты подписок разобраны в материале «Claude Opus 5.5: цена API и как сбросить лимит подписки», способы доступа — в «Claude Opus 5.5: как пользоваться, можно ли бесплатно и в России».
Источники4
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 12 нояб. 2026 г..
Источники4
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 12 нояб. 2026 г..
- 1.странице цен Claude APIplatform.claude.com/docs/en/about-claude/pricing
- 2.странице цен OpenAI APIdevelopers.openai.com/api/docs/pricing
- 3.сравнение Claude Opus 5.5 и GPT-6 Astra на Artificial Analysisartificialanalysis.ai/models/releases/comparisons/claude-opus-5-5-vs-gpt-6-astra
- 4.анонса Claude Opus 5.5anthropic.com/claude-opus-5-5