Gemini 4 Argon API finish_reason: CONTINUATION·빈 응답 대처
Gemini 4 Argon 답변이 끊기면 CONTINUATION 토큰으로 같은 요청을 다시 보내야 합니다. SDK 2.30.1 이상은 자동으로 잇고, OpenAI 호환 엔드포인트는 잇지 못합니다.
목차
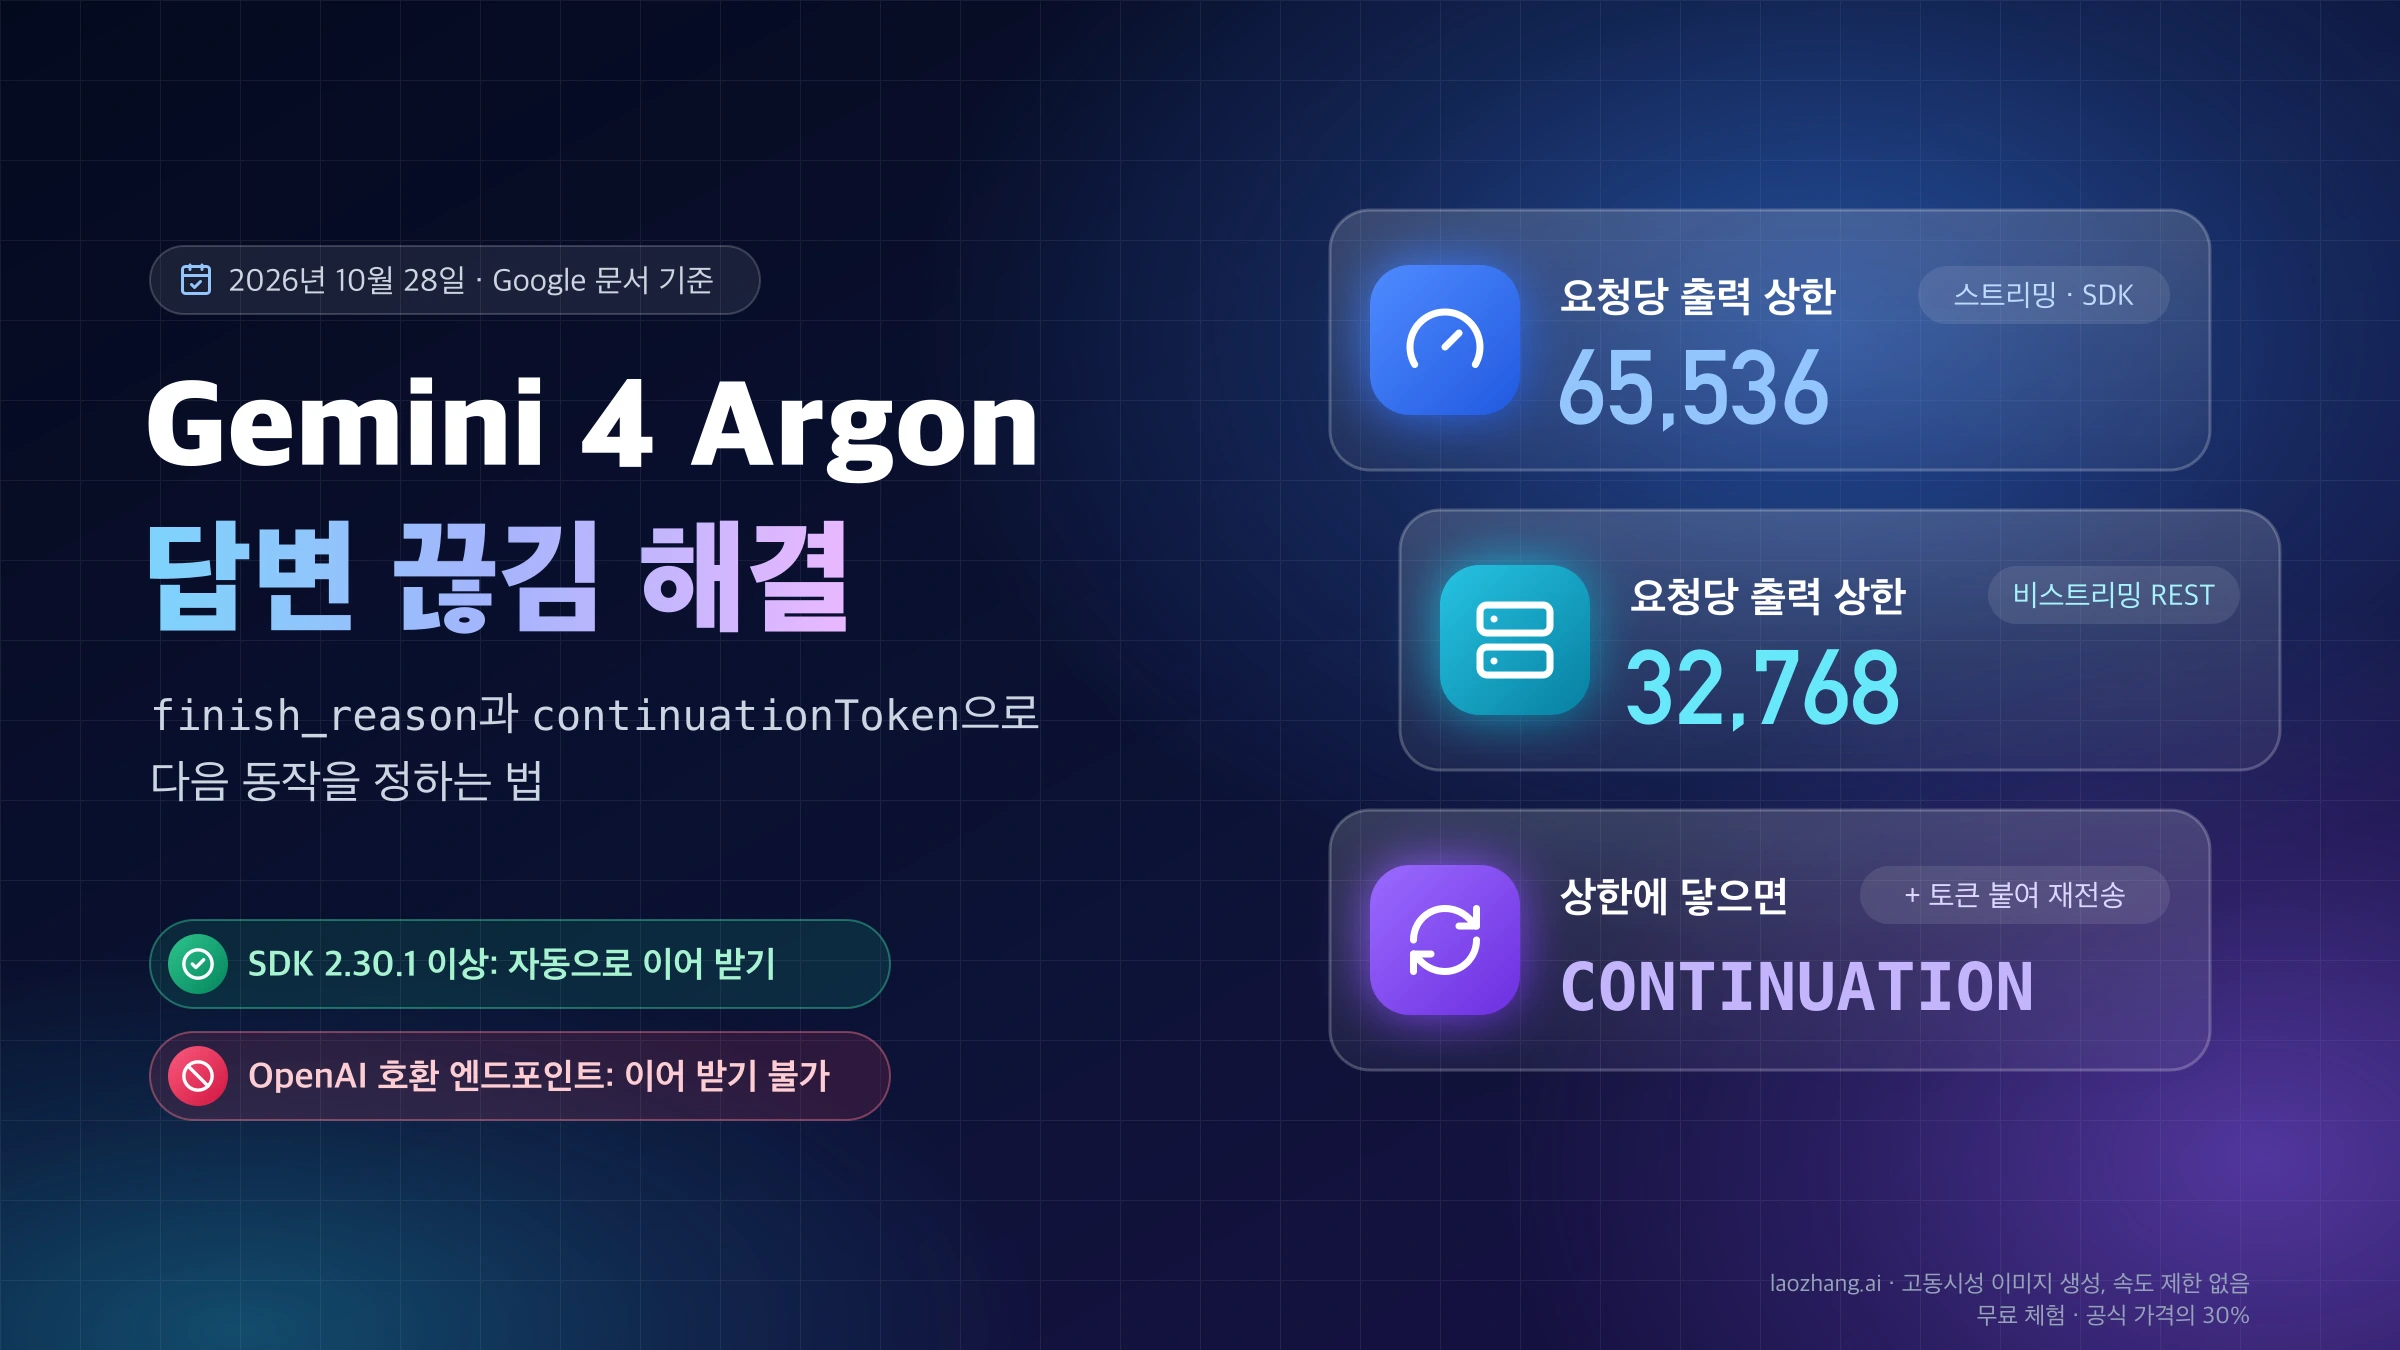
gemini-4-argon으로 바꾼 뒤 답변이 중간에 끊기거나 텍스트가 빈 채로 온다면, 대부분은 Argon의 요청당 출력 상한 때문입니다. 2026년 10월 28일 기준 Google 문서에 따르면 Argon은 요청 한 번에 스트리밍·SDK 호출은 65,536토큰, 비스트리밍 REST는 32,768토큰까지만 생성하고, 더 써야 하면 finishReason: CONTINUATION과 continuationToken을 돌려줍니다. 같은 요청에 이 토큰을 붙여 다시 보내야 나머지가 이어서 나옵니다. 텍스트 없이 MAX_TOKENS가 왔다면 사고(thinking) 토큰이 예산을 다 쓴 것입니다.
지금 할 일은 호출 경로에 따라 갈립니다. Python google-genai 2.30.1 이상이나 JavaScript @google/genai 2.29.1 이상이면 SDK가 알아서 이어 받으므로 max_output_tokens만 32,768 이상(긴 작업은 65,536 이상)으로 올리면 됩니다. 그보다 낮은 SDK나 REST 직접 호출이라면 SDK를 올리거나 이어 받기 루프를 직접 씁니다. OpenAI 호환 엔드포인트나 continuationToken을 돌려주지 않는 API 중계 서비스라면 이어 받기가 원천적으로 안 되므로, 네이티브 generateContent나 Interactions API 백그라운드 실행으로 옮겨야 합니다.
실제로 돌려 본 것은 두 가지입니다. 2026년 10월 28일 한 API 중계 서비스를 거쳐 네이티브 경로와 OpenAI 호환 경로에 11번 요청했고, 같은 날 로컬 모의 서버로 google-genai 2.33.0과 2.29.0의 이어 받기 동작을 확인했습니다. Google 직접 API 키로는 호출하지 않았고, 테스트한 경로에서 진짜 CONTINUATION 응답은 한 번도 나오지 않았습니다. 그래서 Google에 직접 연결했을 때의 동작은 모두 공식 문서를 근거로 씁니다.
Gemini 4 Argon API 연결 조건: 유료 등급, 모델 ID, SDK 버전
Argon을 제미나이 API로 부르려면 결제가 연결된 유료 등급 프로젝트, 모델 ID gemini-4-argon, 그리고 이어 받기를 지원하는 SDK 버전이 필요합니다. Google 제미나이 API 가격 문서는 2026년 10월 28일 기준 Argon이 무료 등급에서 제공되지 않는다고 적고 있으므로, 무료 키로는 처음부터 호출되지 않습니다. 순서대로 따라 하면 됩니다.
- 결제를 연결하고 선불 잔액을 넣습니다. 제미나이 API 결제 문서 기준 Tier 1은 결제 계정 연결과 $5 이상의 선불 충전이 조건이고, 선불 잔액이 0이 되면 키가 HTTP 402로 멈춥니다. Google AI Pro·Ultra 구독 혜택은 제미나이 앱과 AI Studio 웹 화면 안에서만 적용되고, API 키로 부르는 제미나이 API는 구독과 별도로 과금됩니다.
- 모델 ID를
gemini-4-argon으로 바꿉니다. 2026년 10월 13일 GA(정식 출시)된 안정판이고, Gemini 4 Argon 모델 페이지에 따르면 입력과 출력이 1,048,576토큰 창 하나를 함께 씁니다. - SDK를 올립니다.
pip install -U "google-genai>=2.30.1"또는npm install "@google/genai@>=2.29.1"입니다. Go는 1.74.0, Java는 1.77.0, .NET은 1.26.0, Kotlin은 1.6.0이 자동 이어 받기의 최소 버전입니다. max_output_tokens를 다시 정합니다. 이 값은 사고 토큰과 답변 토큰을 합친 상한이라, Google은 기존 앱도 최소 32,768로 올리고 긴 코딩·에이전트 작업은 65,536, 어려운 수학·증명은 262,144부터 시험하라고 권합니다. 값을 낮춘다고 사고가 짧아지지 않고 답이 더 일찍 잘릴 뿐입니다.- 사고 수준과 샘플링 파라미터를 정리합니다.
thinking_level은low·medium(기본값)·high만 받고minimal은 오류입니다.thinking_level과thinking_budget을 함께 보내도 오류이고,temperature·top_p·top_k는 경고와 함께 무시됩니다. - HTTP 읽기 타임아웃을 20분으로 늘립니다. 서버는 비스트리밍 요청을 10분, 스트리밍을 20분 뒤에 닫으므로 3분·5분 타임아웃은 요청을 먼저 끊습니다. Python은
genai.Client(http_options=types.HttpOptions(timeout=1_200_000))입니다.
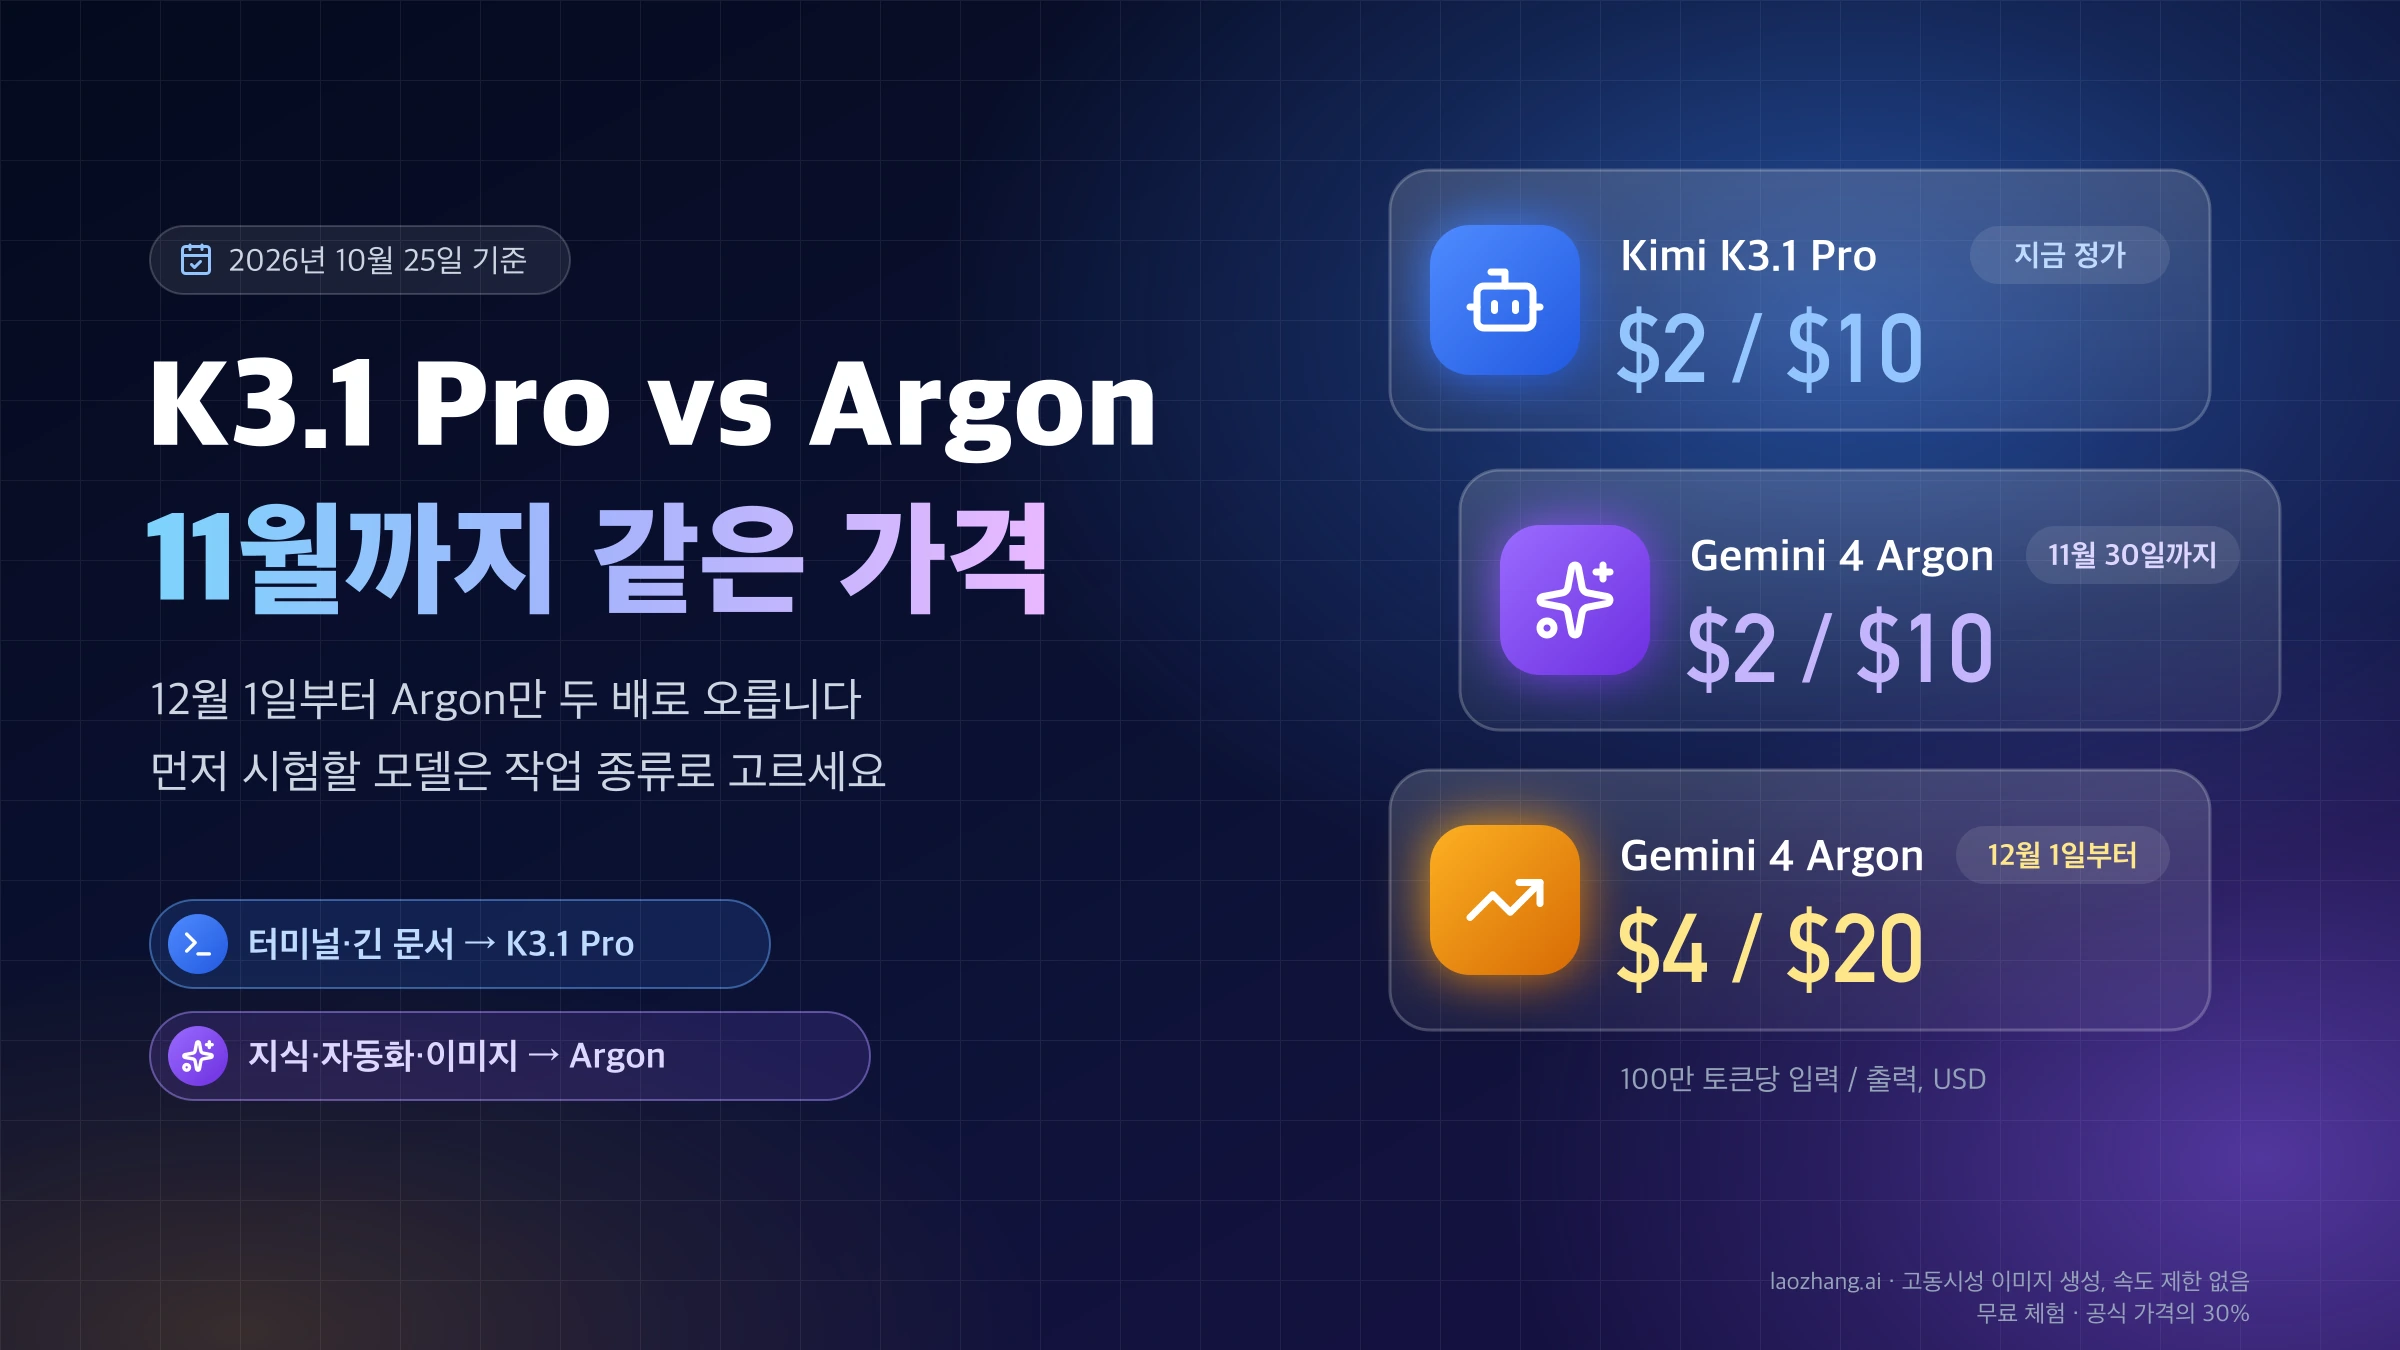
엔드포인트도 이 단계에서 고릅니다. 64K를 넘는 긴 출력(long decode)은 네이티브 generateContent·streamGenerateContent와 Interactions API에서만 되고, Google의 OpenAI 호환 엔드포인트(https://generativelanguage.googleapis.com/v1beta/openai/)에서는 요청당 상한에서 멈춥니다. 가격은 100만 토큰당 입력 $2.00, 사고를 포함한 출력 $10.00이며 2026년 12월 1일부터 각각 $4.00과 $20.00으로 오릅니다. 한국은 제미나이 API 제공 지역에 들어 있고, 429와 등급별 한도는 Gemini API 사용량 한도 2026: 프로젝트 단위 집계와 티어별 상한, 429 대처에서 다룹니다.
Argon finish_reason 값별 의미와 코드가 할 일
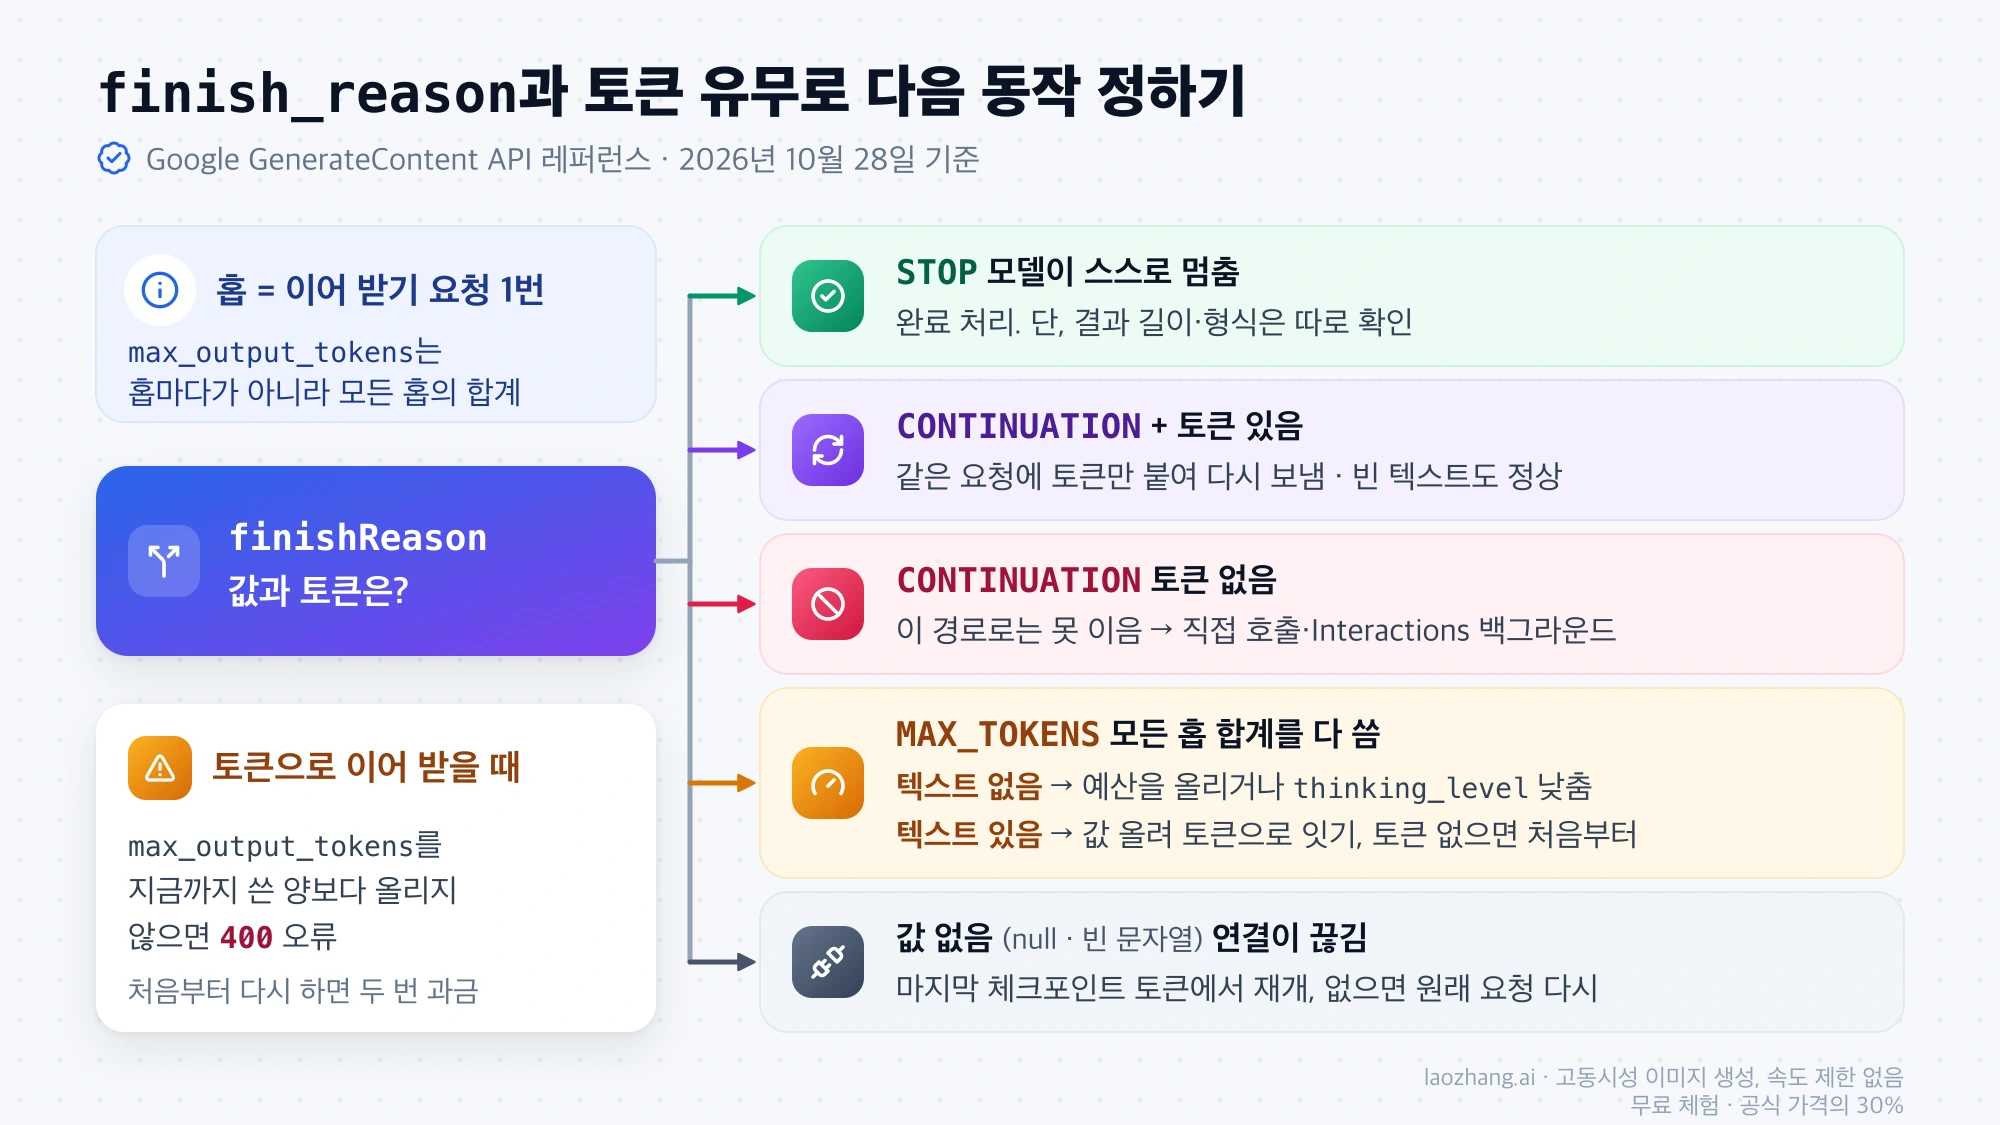
Argon 응답을 받으면 finishReason(REST JSON) 또는 finish_reason(Python SDK·OpenAI 형식)과 continuationToken이 함께 왔는지를 같이 봐야 다음 동작이 정해집니다. 같은 MAX_TOKENS라도 토큰이 있으면 이어 받을 수 있고, 없으면 처음부터 다시 생성해야 하기 때문입니다. 아래 표는 Google GenerateContent API 레퍼런스의 FinishReason 목록 가운데 텍스트만 출력하는 Argon에 해당하는 값을 정리한 것입니다(2026년 10월 28일 기준).
| finish_reason | 뜻 | 코드가 할 일 |
|---|---|---|
STOP | 모델이 스스로 멈췄거나 stop sequence에 닿음 | 완료로 처리하되, 모델이 거절하거나 요약하고 멈춰도 STOP이므로 결과의 길이·형식은 따로 확인 |
CONTINUATION + continuationToken | 요청당 상한에 닿았지만 max_output_tokens가 남음. 텍스트가 비어도 정상 | 같은 요청에 토큰만 붙여 다시 보냄 |
CONTINUATION, 토큰 없음 | 호출 경로 중간에서 토큰이 빠짐 | 이 경로로는 이을 수 없음. 직접 호출이나 Interactions 백그라운드로 옮김 |
MAX_TOKENS, 텍스트 있음 | 모든 홉을 합쳐 max_output_tokens를 다 씀 | 토큰이 있으면 더 높은 max_output_tokens와 토큰으로 이어 받고, 없으면 더 높은 값으로 처음부터 |
MAX_TOKENS, 텍스트 없음 | 사고 토큰이 예산을 전부 씀 | max_output_tokens를 올리거나 thinking_level을 낮춤 |
| 값 없음(null 또는 빈 문자열) | 스트림이나 연결이 끝맺음 없이 끊김 | 마지막 체크포인트 토큰에서 재개하고, 없으면 원래 요청을 다시 보냄 |
SAFETY, PROHIBITED_CONTENT, BLOCKLIST, SPII | 안전 필터, 금지 콘텐츠, 금지어, 민감한 개인정보 | 같은 요청 반복은 소용없음. 입력이나 프롬프트를 수정 |
RECITATION, LANGUAGE | 학습 데이터 재현 의심, 지원하지 않는 언어 | 프롬프트나 출력 언어를 바꿈 |
MALFORMED_FUNCTION_CALL, UNEXPECTED_TOOL_CALL, TOO_MANY_TOOL_CALLS | 잘못된 함수 호출, 도구를 켜지 않았는데 호출, 연속 도구 호출 과다 | 도구 선언과 도구 설정을 고친 뒤 재시도 |
MISSING_THOUGHT_SIGNATURE, MALFORMED_RESPONSE | 이전 턴의 thought signature 누락, 응답 형식 오류 | 받은 parts를 서명째 대화 기록에 돌려보내고 재시도 |
ESCALATION, PUP_LIMITED_DISABLED | 에스컬레이션 규칙에 걸림, 금지 사용 정책 위반으로 계정 제한 | 재시도로 풀리지 않음. 요청 내용과 계정 상태를 확인 |
OTHER | 알 수 없는 이유 | finishMessage를 기록하고 한 번만 재시도 |
여기서 홉(hop)은 이어 받기 과정의 요청 한 번을 뜻합니다. max_output_tokens는 홉마다 새로 주어지는 값이 아니라 모든 홉을 합친 총량이고, 이 총량을 다 쓰면 MAX_TOKENS, 총량은 남았는데 요청당 상한에 닿으면 CONTINUATION이 옵니다. MAX_TOKENS 뒤 토큰으로 이어 받을 때 max_output_tokens를 지금까지 쓴 토큰보다 높게 주지 않으면 400: Continuation token has already used output tokens… 오류가 나므로, 반드시 값을 올려서 보냅니다. 처음부터 다시 생성하는 쪽을 택하면 두 번의 실행 비용을 모두 냅니다.
프롬프트 단계에서 막히면 candidates 자체가 비고 promptFeedback.blockReason이 옵니다. 이때는 생성된 것이 없으므로 이어 받을 대상도 없고, 프롬프트를 고쳐야 합니다.
CONTINUATION이 안 보이는 이유: SDK 2.30.1 이상의 자동 이어 받기
google-genai 2.30.1 이상에서는 자동 이어 받기(automatic_continuation)가 스트리밍·비스트리밍 모두 기본으로 켜져 있어, SDK가 중간 홉의 CONTINUATION을 받아 다음 요청을 직접 보내고 모든 홉을 합친 응답 하나를 호출자에게 돌려줍니다. 그래서 코드에서는 CONTINUATION이 거의 보이지 않고 STOP이나 MAX_TOKENS만 보입니다. 반대로 2.30.1 미만에서는 오류 없이 첫 홉에서 멈추고 빈 텍스트와 CONTINUATION을 그대로 돌려줍니다.
2026년 10월 28일 로컬 모의 서버로 이 차이를 확인했습니다. 모의 서버는 Google 문서에 나온 응답 형태를 손으로 작성해 :generateContent를 흉내 낸 것이라 실제 서버와 세부가 다를 수 있습니다. 시나리오 A의 첫 홉은 32,768개의 사고 토큰만 쓰고 텍스트 없이 CONTINUATION과 토큰을 돌려주며, 두 번째 홉은 STOP으로 끝나게 했습니다. 2.33.0은 그날 PyPI의 최신 버전입니다.
| 시나리오 | google-genai 2.33.0 | google-genai 2.29.0 |
|---|---|---|
A. 첫 홉 CONTINUATION+토큰, 둘째 홉 STOP | 요청 2번. 둘째 요청에 토큰을 붙이고 maxOutputTokens 262,144와 contents를 그대로 보냄. 호출자는 STOP과 "Final answer."를 받음 | 요청 1번. 호출자는 빈 텍스트와 CONTINUATION, 토큰을 받음. 예외 없음 |
B. A와 같고 automatic_continuation=False | 요청 1번. 호출자가 CONTINUATION과 토큰을 받음 | 이 설정 항목이 없음 |
C. CONTINUATION인데 토큰 없음 | 요청 1번. 빈 텍스트와 CONTINUATION, 예외 없음 | 같음 |
D. MAX_TOKENS+토큰 | 요청 1번. SDK는 잇지 않고 일부 텍스트와 토큰을 돌려줌 | 같음 |
시나리오 C가 가장 위험합니다. 중간 경로가 토큰을 버리면 최신 SDK도 이어 받을 방법이 없는데, 예외를 던지지 않고 빈 문자열을 정상 응답처럼 돌려줍니다. 따라서 response.text가 비어 있을 때는 오류가 없더라도 finish_reason을 꼭 확인해야 합니다. 2.33.0 소스(google/genai/_extra_utils.py)를 보면 SDK는 finish reason이 비어 있거나 CONTINUATION일 때만 이어 받습니다. 반면 MAX_TOKENS는 SDK가 다시 보내지 않으므로 이어 받을지 처음부터 다시 할지를 호출자가 정해야 합니다.
REST로 직접 이어 받기: 같은 요청 + continuationToken
SDK를 올릴 수 없거나 REST를 직접 부른다면, 홉마다 첫 요청과 똑같은 본문에 가장 최근의 continuationToken 하나만 붙여 보내는 루프를 씁니다. Google의 GenerateContent long decode 문서가 정한 규칙은 다섯 가지입니다. contents·system_instruction·tools·generation_config를 매 홉 똑같이 보내고 max_output_tokens도 바꾸지 않습니다. 앞 홉의 부분 출력을 contents에 덧붙이지 않습니다(토큰이 사고 상태까지 담고 있습니다). 최신 토큰 하나만 보냅니다. CONTINUATION인 동안만 계속하고 다른 값이 오면 멈춥니다. 마지막 홉 뒤에 모든 parts를 합쳐 대화 기록의 모델 턴 하나로 만듭니다.
import os
import requests

URL = "https://generativelanguage.googleapis.com/v1beta/models/gemini-4-argon:generateContent"
HEADERS = {"x-goog-api-key": os.environ["GEMINI_API_KEY"], "Content-Type": "application/json"}
BASE_BODY = {
    "contents": [{"role": "user", "parts": [{"text": "여기에 긴 작업 프롬프트"}]}],
    "generationConfig": {
        "maxOutputTokens": 262144,               # 모든 홉의 총량. 홉마다 같은 값
        "thinkingConfig": {"thinkingLevel": "high"},
    },
}

parts, token = [], None
first_prompt_tokens, usage_sum = None, {}
while True:
    body = dict(BASE_BODY)                        # 매 홉 같은 본문
    if token:
        body["continuationToken"] = token         # 가장 최근 토큰 하나만
    r = requests.post(URL, headers=HEADERS, json=body, timeout=1200)  # 읽기 타임아웃 20분
    r.raise_for_status()
    data = r.json()
    cand = data["candidates"][0]
    parts += (cand.get("content") or {}).get("parts") or []

    u = data.get("usageMetadata", {})
    if first_prompt_tokens is None:
        first_prompt_tokens = u.get("promptTokenCount")   # 실제 프롬프트 크기
    for k in ("promptTokenCount", "candidatesTokenCount", "thoughtsTokenCount", "totalTokenCount"):
        usage_sum[k] = usage_sum.get(k, 0) + u.get(k, 0)  # 비용은 홉 합계로

    reason, token = cand.get("finishReason") or None, cand.get("continuationToken")
    if reason != "CONTINUATION" or not token:
        break

answer = "".join(p.get("text", "") for p in parts if not p.get("thought"))
print(reason, len(answer), first_prompt_tokens, usage_sum)
이 코드는 Google 문서의 REST 예시와 규칙을 Python으로 옮긴 것이고, Google 직접 키로 실행해 보지는 않았습니다. 한 가지 걸리는 점이 있습니다. 같은 문서가 한 곳에서는 비스트리밍 REST에 토큰 없이 32,768을 넘는 maxOutputTokens를 보내면 400이 난다고 적고, REST 예시는 첫 홉부터 262,144를 보냅니다. 첫 홉에서 400이 나면 총량을 32,768로 줄이기보다 streamGenerateContent나 최신 SDK로 옮기는 편이 낫습니다. 총량은 홉마다 같아야 하므로, 첫 요청만 낮추는 방법은 쓸 수 없습니다. 스트리밍 루프는 체크포인트 처리가 하나 더 필요하며, 아래 스트림 절에서 다룹니다.
중계 서비스·OpenAI 호환 경로 실측: 토큰 없이는 못 잇는다
이어 받기는 응답에 continuationToken이 실제로 실려 와야만 가능합니다. Google은 자사 OpenAI 호환 엔드포인트에서 long decode가 지원되지 않고 출력이 요청당 상한에서 멈춘다고 명시하고 있습니다. 2026년 10월 28일 laozhang.ai의 API 중계 서비스로 확인해 보니, 네이티브 generateContent 경로에서도 MAX_TOKENS 응답에 토큰이 붙지 않았습니다. Google 문서는 Argon의 MAX_TOKENS에도 토큰이 붙는다고 적고 있으므로, 같은 모델이라도 거치는 경로에 따라 받을 수 있는 정보가 다릅니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
이날 같은 중계 서비스에 보낸 요청 11번 가운데 판단을 바꾸는 결과만 모았습니다. 로컬 HTTP 프록시를 거쳐 중계 서비스로 나가는 구성이었고, 정가로 따진 최악의 비용 추정은 $0.59였습니다.
| 요청 | 결과 | 읽는 법 |
|---|---|---|
네이티브, maxOutputTokens 64, thinkingLevel low, 긴 설명 요청 | MAX_TOKENS, 291자, 출력 64토큰, continuationToken 없음 | 이을 수 없음. 같은 요청을 다시 보내자 처음부터 새 답이 나옴 |
네이티브, maxOutputTokens 200, thinkingLevel high, 어려운 수학 문제 | MAX_TOKENS, 텍스트 0자 (사고 197 + 출력 3토큰) | 오류 없이 빈 응답. 예산을 올리거나 사고 수준을 낮춤 |
네이티브 비스트리밍, maxOutputTokens 40,000, "OK"만 답하게 | HTTP 200, STOP, "OK" | Google 문서가 말하는 32,768 초과 400이 이 경로에서는 안 나옴 |
네이티브, thinkingLevel "minimal" | HTTP 500, 메시지 上游服务异常…(상위 서비스 이상), code "402" | Argon의 minimal 거부가 다른 오류로 가려져 옴 |
OpenAI 호환, max_tokens 64 | completion_tokens 64인데 finish_reason "stop" | "length"만 기다리면 잘린 답을 놓침 |
네이티브, maxOutputTokens 33,000, 1부터 7,000까지 출력 | STOP, 142토큰. 출력 한도를 넘는다며 거절하고 seq 1 7000을 제안 | STOP이 작업 완료를 뜻하지 않음 |
| 네이티브 비스트리밍, 33,000, 3개 언어 2,500행 CSV | 300.9초에 연결 끊김, 본문 없음 | 응답이 없으니 판단할 정보도 없음 |
스트리밍(alt=sse), 같은 CSV | 이벤트 993개, 74,760자(1,065행까지), 302.5초에 끝맺음 없이 종료 | 성공이 아님(아래 스트림 절) |
OpenAI 형식의 잘림 표시는 서비스마다 다를 수 있습니다. 일부 제3자 서비스는 Chat Completions에서 잘리면 "length"가 온다고 설명하지만, 이날 테스트한 경로는 상한에 정확히 닿고도 "stop"을 돌려줬고, Google의 OpenAI 호환 문서에는 이 대응이 적혀 있지 않습니다. 그래서 OpenAI 형식에서는 finish_reason보다 completion_tokens가 max_tokens에 닿았는지를 기준으로 잘림을 판단하는 편이 안전합니다. OpenAI SDK의 base_url을 바꿔 쓰는 중이라면 설정 위치는 OpenAI API base_url 변경: 적용 순서와 경로 맞추는 법에서 확인할 수 있지만, 주소를 바꿔도 OpenAI 형식인 한 이어 받기는 되지 않습니다.
자기 경로가 토큰을 전달하는지는 maxOutputTokens를 64 정도로 작게 준 요청 하나로 빠르게 가늠할 수 있습니다. MAX_TOKENS 응답에 continuationToken이 없다면 적어도 그 경로는 MAX_TOKENS 토큰을 넘기지 않는다는 뜻이고, CONTINUATION 토큰까지 넘기는지는 64K를 넘는 실제 긴 응답으로만 확인할 수 있습니다. 토큰이 오지 않는 경로에서 64K를 넘겨야 한다면 옮길 곳은 두 군데입니다. 제미나이 API를 직접 부르는 네이티브 generateContent(SDK 2.30.1 이상), 또는 Interactions API의 long decode입니다. Interactions는 background: true, store: true, max_output_tokens 65,536 초과로 만들면 서버가 홉을 돌려 합쳐 주고 최대 24시간 실행되며, finish_reason 대신 status로 결과를 알려 줍니다. completed면 완료, incomplete면 max_output_tokens를 다 쓴 것(텍스트가 빌 수 있음)이라 값을 올려 다시 보내고, requires_action은 도구 호출, failed·cancelled는 재시도나 취소 확인입니다. background: false로 65,536을 넘기면 400이 납니다.
finish_reason을 다음 동작으로 바꾸는 판정 함수
앞의 표를 코드로 옮기면 응답 하나를 다음 동작 하나로 바꾸는 함수가 됩니다. 아래는 2026년 10월 28일에 저장한 중계 서비스 응답 7개와 모의 응답 4개, 모두 11개에 돌려 본 함수를 반환값만 짧은 라벨로 줄인 것이며 의존성 없이 Python 3.9 이상에서 돌아갑니다.
def next_action(resp: dict) -> str:
    """제미나이 REST 응답(JSON dict) 하나를 다음 동작 하나로 바꿉니다."""
    cands = resp.get("candidates") or []
    if not cands:
        # 프롬프트 단계에서 막히면 candidates가 비고 promptFeedback.blockReason이 옵니다
        return "blocked_prompt" if resp.get("promptFeedback", {}).get("blockReason") else "no_candidate"
    c = cands[0]
    reason = c.get("finishReason") or None      # 중간 청크는 빈 문자열로 올 수 있음
    token = c.get("continuationToken")
    parts = (c.get("content") or {}).get("parts") or []
    text = "".join(p.get("text", "") for p in parts if not p.get("thought"))

    if reason is None:
        return "transport_cut"                  # 마지막 체크포인트에서 재개하거나 다시 보냄
    if reason == "STOP":
        return "done"                           # 모델이 스스로 멈춤. 작업 완료와는 별개
    if reason == "CONTINUATION":
        return "continue" if token else "continuation_without_token"
    if reason == "MAX_TOKENS":
        return ("raise_budget_empty" if not text else "raise_budget") + ("+token" if token else "+restart")
    if reason in ("SAFETY", "PROHIBITED_CONTENT", "BLOCKLIST", "SPII", "RECITATION", "LANGUAGE"):
        return "content_stop"                   # 같은 요청 반복은 소용없음
    if reason in ("MALFORMED_FUNCTION_CALL", "UNEXPECTED_TOOL_CALL", "TOO_MANY_TOOL_CALLS",
                  "MISSING_THOUGHT_SIGNATURE", "MALFORMED_RESPONSE"):
        return "tool_or_format_stop"
    return "other"                              # finishMessage를 기록하고 한 번만 재시도


def next_action_openai(resp: dict, max_tokens: int) -> str:
    """OpenAI 호환 응답: finish_reason만 믿지 않고 completion_tokens를 max_tokens와 비교합니다."""
    ch = (resp.get("choices") or [{}])[0]
    used = (resp.get("usage") or {}).get("completion_tokens", 0)
    if ch.get("finish_reason") == "length" or used >= max_tokens:
        return "truncated"                      # 이 엔드포인트는 잇지 못하므로 max_tokens를 올림
    return "done" if ch.get("finish_reason") in ("stop", "tool_calls") else "check"
11개 모두 예상대로 분류됐습니다. 토큰 없는 MAX_TOKENS 두 건은 raise_budget+restart와 raise_budget_empty+restart, OpenAI 호환 64토큰 응답은 "stop"인데도 truncated, 끝맺음 없이 끝난 스트림의 마지막 청크는 transport_cut이 나왔습니다. 모의 응답 네 건은 continue, continuation_without_token, raise_budget+token, content_stop입니다. 1부터 7,000까지 출력하라는 요청을 모델이 거절한 응답은 done으로 분류되는데, 이 함수가 판단하는 것은 모델이 스스로 멈췄는지까지이고 작업을 끝냈는지는 아니기 때문입니다. 결과물의 줄 수나 스키마 검사는 이 함수 뒤에 따로 붙입니다.
finishReason을 그대로 비교하지 않고 or None으로 받는 데도 이유가 있습니다. 테스트한 스트림의 중간 청크와 마지막 청크는 finishReason이 없는 것이 아니라 빈 문자열("")로 왔기 때문에, is None만 검사하면 끊긴 스트림이 other로 빠집니다.
스트림이 finishReason 없이 끝났다면 성공이 아니다
스트림이 마지막 청크에 finishReason(빈 문자열 포함)도, 최종 usage도 없이 닫혔다면 응답이 완성된 것이 아니라 중간에 끊긴 것으로 봐야 합니다. 정상적으로 끝난 스트림은 마지막 청크에 STOP·MAX_TOKENS·CONTINUATION 같은 값을 남기기 때문입니다. 2026년 10월 28일 테스트한 스트리밍 요청도 약 302초에 이렇게 끝났는데, 그때까지 받은 74,760자는 2,500행 중 1,065행까지였습니다.
다음 동작은 체크포인트 토큰이 있었는지에 따라 갈립니다. Google 문서에 따르면 스트림은 첫 32,768토큰이 지난 뒤부터 약 5,000토큰마다 continuationToken이 붙은 체크포인트 청크를 보냅니다. 직접 쓰는 스트리밍 루프는 새 청크를 대기 목록에 두었다가 토큰이 붙은 청크가 오면 확정 출력으로 옮기고, 끊기면 대기 중인 청크를 버린 뒤 마지막 토큰으로 재개합니다. 첫 체크포인트 전에 끊겼다면 원래 요청을 처음부터 다시 보냅니다. 최신 SDK는 이 과정을 대신하지만, 새 체크포인트 없이 3번 연속 재연결하면 포기하고 그대로 돌려줍니다.
비스트리밍 요청이 300.9초, 스트리밍이 302.5초로 거의 같은 시점에 끊긴 원인은 로컬 HTTP 프록시인지 중계 서비스인지 가려내지 못했습니다. Google 서버는 비스트리밍을 10분, 스트리밍을 20분까지 유지하므로, 5분 근처에서 반복해서 끊긴다면 자기 클라이언트와 그 사이에 있는 프록시·게이트웨이의 타임아웃부터 확인하는 것이 순서입니다.
prompt_token_count가 커지는 이유: 4홉이면 397,216
long decode 뒤 prompt_token_count가 프롬프트보다 훨씬 크게 나오는 것은 오류가 아니라, 홉마다 프롬프트와 그때까지 생성한 내용 전체가 다시 입력으로 들어가고 SDK가 모든 홉의 입력을 더하기 때문입니다. Google 문서의 예시에서는 1,000토큰 프롬프트로 사고와 답변을 합쳐 200,000토큰을 생성하면 SDK 기준 4홉이 걸리고, 홉별 입력이 1,000, 66,536, 132,072, 197,608토큰이라 prompt_token_count는 합계 397,216이 됩니다. total_token_count는 약 597,000이지만 실제 컨텍스트는 약 201,000토큰뿐이고, 32K씩 나누는 비스트리밍 REST 루프라면 7홉에 입력 합계 695,128토큰으로 보고됩니다.
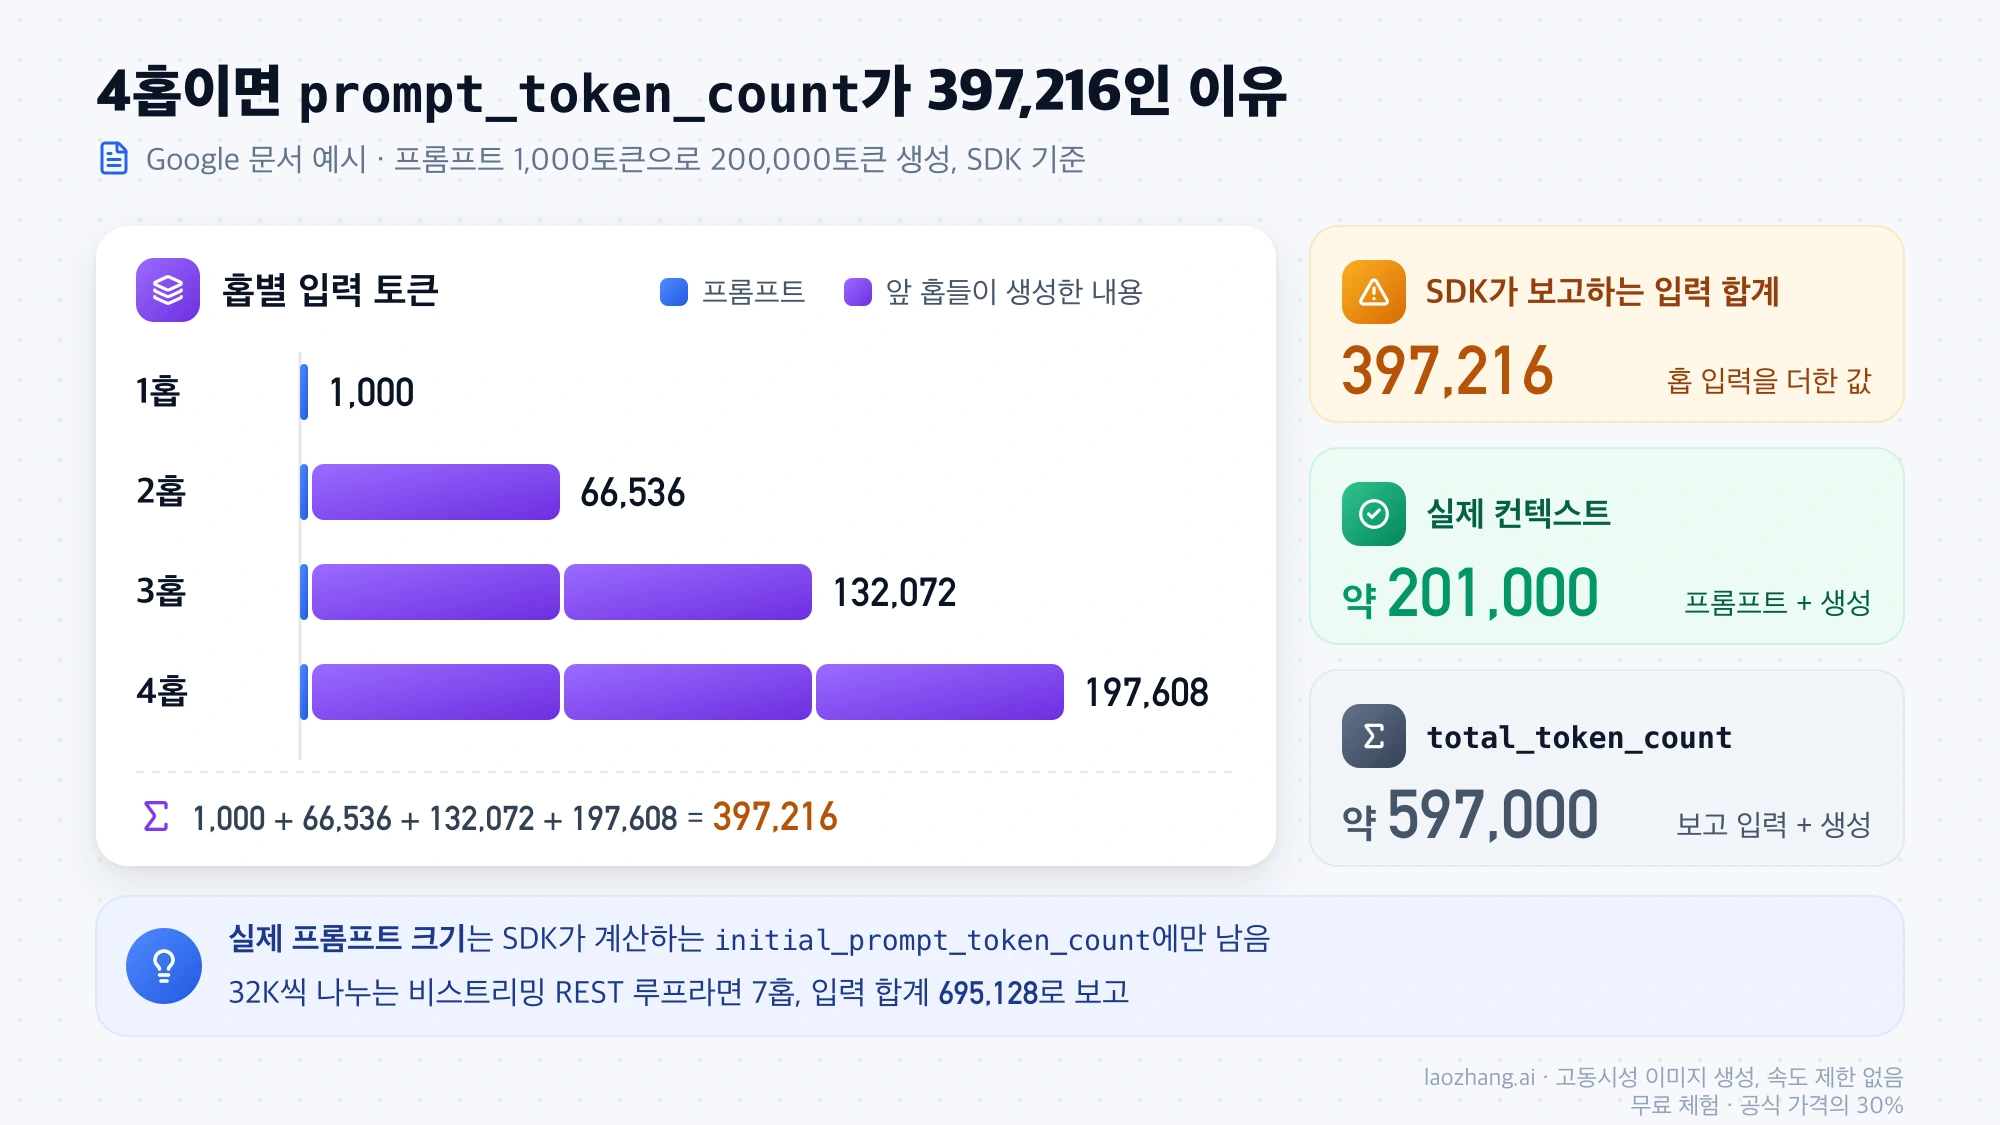
모의 서버 테스트에서도 같은 일이 일어났습니다. 120토큰 프롬프트가 첫 홉에서 사고 토큰 32,768개를 쓰자 둘째 홉 입력은 32,888토큰이 됐고, 2.33.0이 돌려준 prompt_token_count는 120 + 32,888 = 33,008이었습니다. 실제 프롬프트 크기 120은 initial_prompt_token_count(JavaScript는 initialPromptTokenCount)에만 남는데, 이 값은 SDK가 클라이언트에서 계산하므로 REST 응답이나 model_dump()에는 없고, 2.29.0에는 필드 자체가 없습니다. 컨텍스트 압축이나 토큰 한도 판단에는 합산값 대신 이 값을 써야 하고, REST 루프라면 앞의 코드처럼 첫 홉의 promptTokenCount를 따로 보관합니다.
비용은 모든 홉의 모든 토큰, 사고만 한 홉까지 청구됩니다. 대신 반복되는 홉 입력에는 암시적 캐싱이 95% 할인을 적용해 도입 기간 동안 100만 토큰당 $2.00이 아닌 $0.10이 붙고, 홉 사이가 15~20분 넘게 비면 캐시가 만료돼 정가로 돌아갑니다. 실패하거나 끊긴 비스트리밍 홉은 청구되지 않고, 스트림은 32K 전에 끊기면 0원, 그 뒤에 끊기면 마지막 체크포인트까지 청구됩니다. REST 응답은 홉마다 자기 홉의 숫자만 보고하므로, REST로 Google을 부르는 중계 서비스나 게이트웨이가 홉별 값을 더하지 않으면 같은 요청이라도 SDK 사용자와 다른 사용량이 보입니다.
참고 자료6
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 28일.
참고 자료6
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 28일.
- 1.Google 제미나이 API 가격 문서ai.google.dev/gemini-api/docs/pricing
- 2.제미나이 API 결제 문서ai.google.dev/gemini-api/docs/billing
- 3.Gemini 4 Argon 모델 페이지ai.google.dev/gemini-api/docs/models/gemini-4-argon
- 4.Google GenerateContent API 레퍼런스ai.google.dev/api/generate-content
- 5.Google의 GenerateContent long decode 문서ai.google.dev/gemini-api/docs/generate-content/long-decode
- 6.Interactions API의 long decodeai.google.dev/gemini-api/docs/long-decode