Gemini 컨텍스트 캐싱: 암시적·명시적 차이와 비용, 실측 적중은 3번에 1번
Gemini 4 Argon은 암시적 캐싱만, 3.8 Flash는 명시적도 됩니다. 2026년 10월 30일 실측 적중은 약 3번에 1번, 1시간짜리 명시적 캐시는 2회 이상 써야 이득입니다.
목차
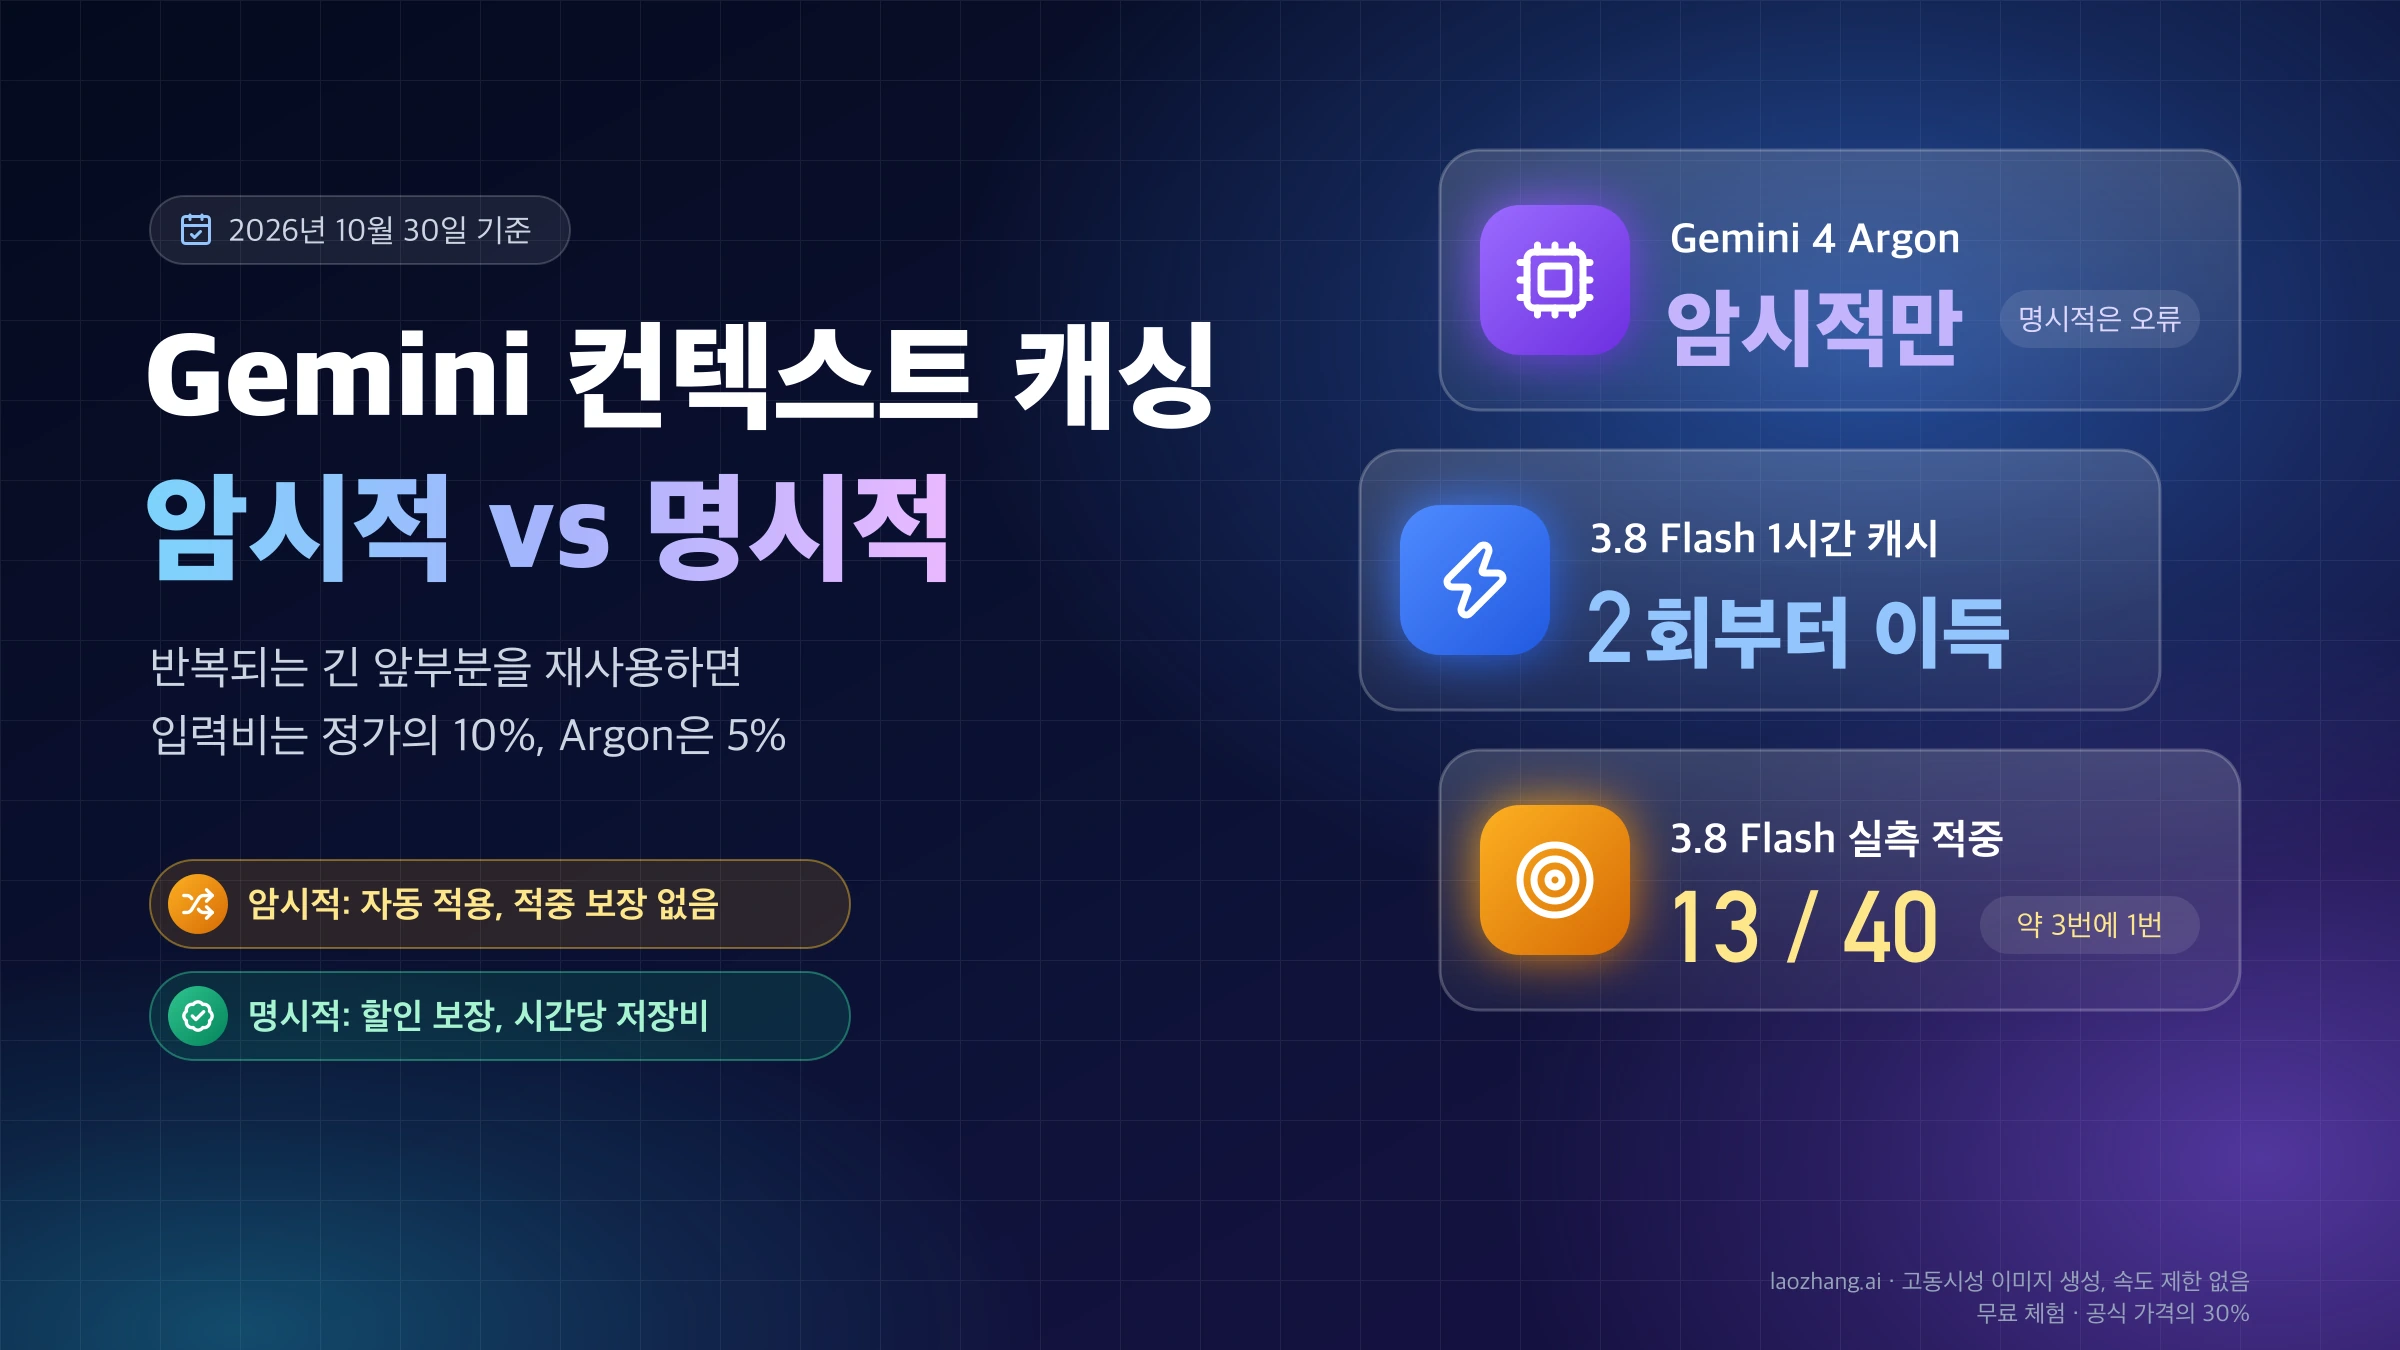
Gemini(제미나이) 컨텍스트 캐싱(context caching)은 요청마다 반복해서 보내는 긴 시스템 지시·문서·코드 같은 앞부분을 재사용해, 그 부분의 입력 토큰을 정가의 10%(Gemini 4 Argon은 5%)로 청구하는 기능입니다. 방식은 두 가지입니다. 암시적 캐싱은 Gemini 2.5 이후 모델에서 자동으로 켜져 있지만 적중이 보장되지 않고, 명시적 캐싱은 caches.create로 캐시를 직접 만들어 할인을 보장받는 대신 시간당 저장비를 냅니다. 2026년 10월 30일 기준 Gemini 4 Argon은 암시적 캐싱만 지원하고, Gemini 3.8 Flash·3.6 Flash·3.1 Pro Preview·3.5 Flash-Lite·2.5 계열은 둘 다 지원합니다.
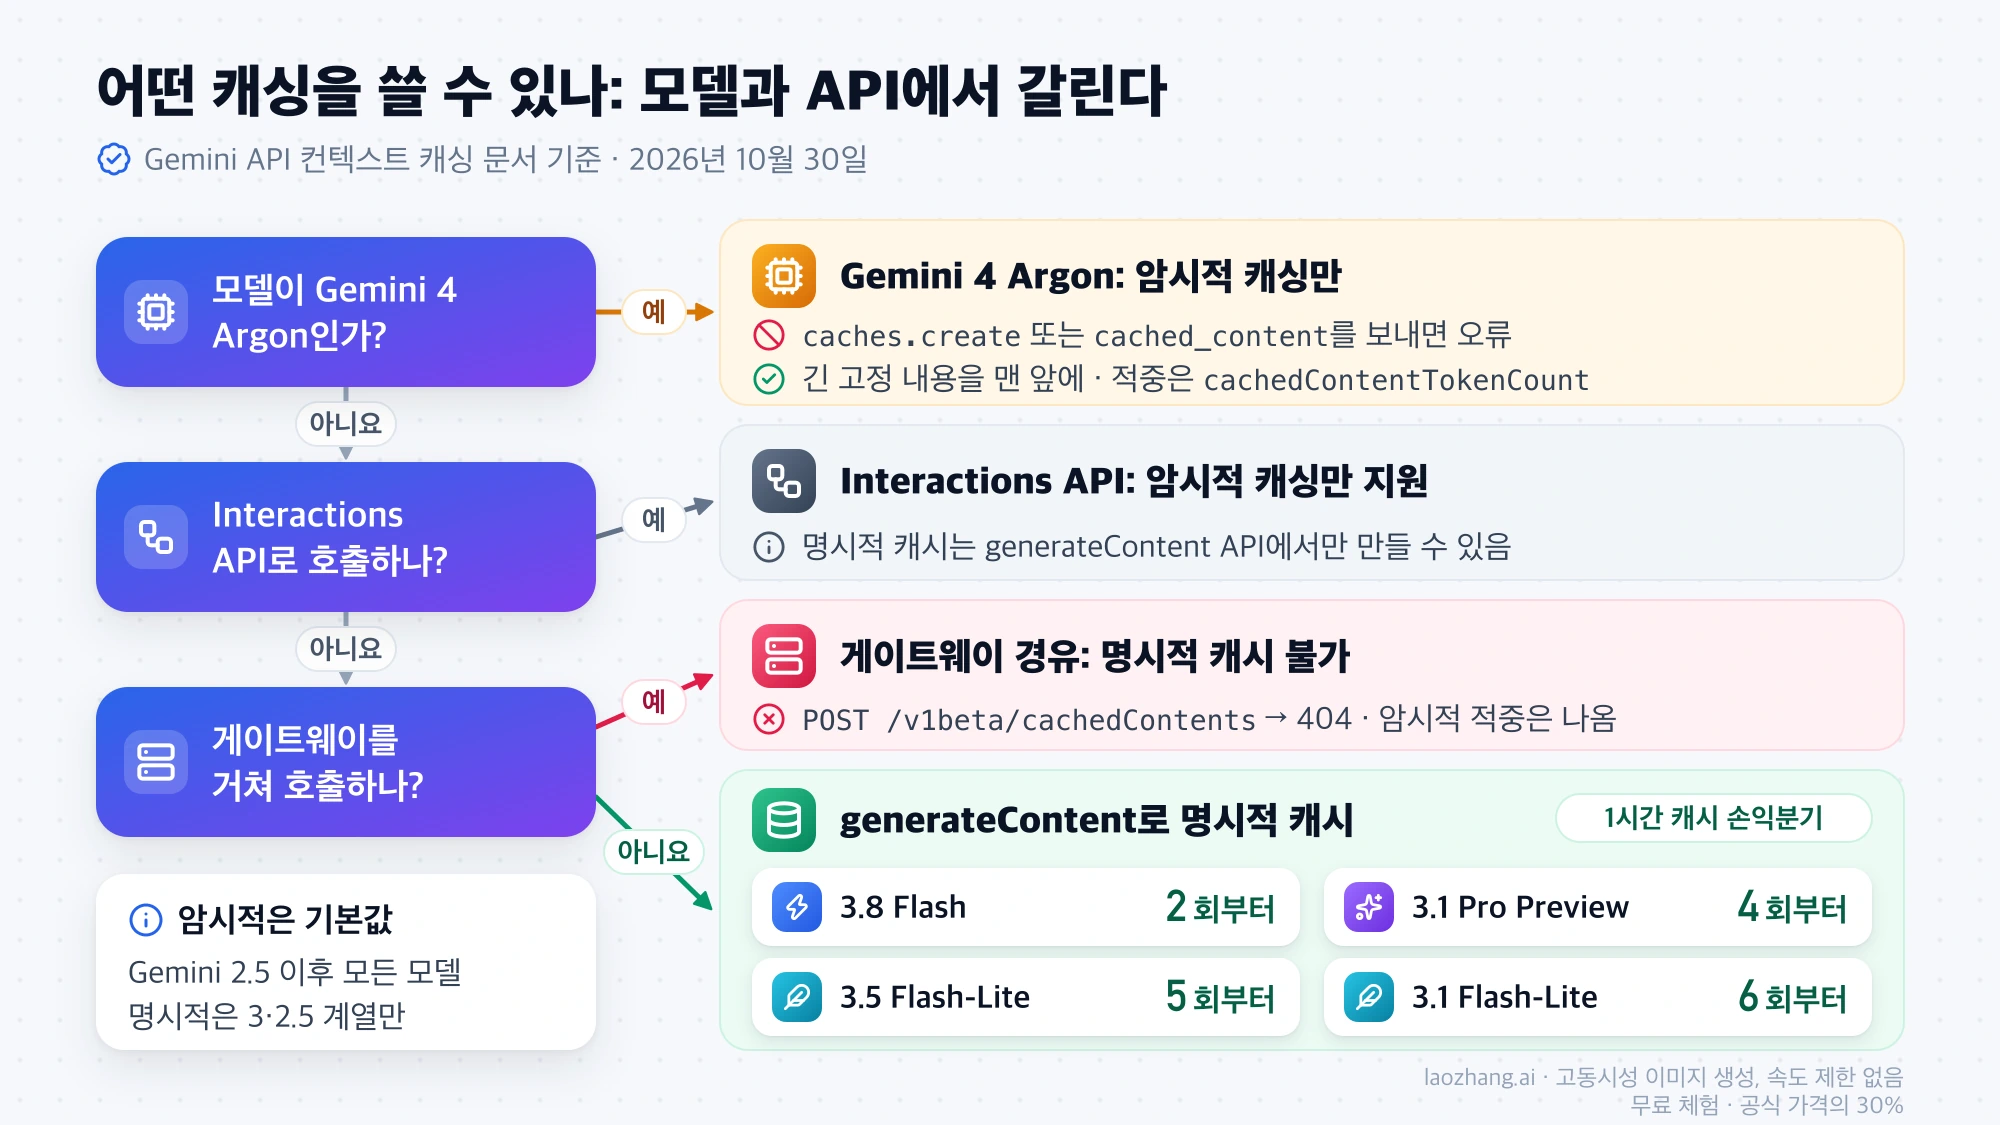
그래서 Argon을 쓴다면 할 일은 바뀌지 않는 긴 내용을 프롬프트 맨 앞에 두고, 응답의 cachedContentTokenCount로 적중 여부를 확인하는 것뿐입니다. 3.8 Flash처럼 명시적 캐싱이 되는 모델에서 같은 긴 컨텍스트를 한 시간에 여러 번 쓴다면 generateContent API로 명시적 캐시를 만드는 편이 확실합니다. 캐시를 만들 때 한 번 내는 정가 입력비까지 넣으면 한 시간만 유지하는 3.8 Flash 캐시는 그 시간 안에 2회 이상 써야 캐싱 없이 보내는 것보다 싸지고, 여러 시간 유지하는 캐시는 저장비만 따져 시간당 0.74회 재사용이 손익분기입니다. 단, 명시적 캐시는 구글이 권장하는 Interactions API에서는 만들 수 없습니다.
암시적 캐싱에만 기대면 생각보다 덜 아낍니다. 2026년 10월 30일 LaoZhang 게이트웨이를 거쳐 같은 긴 앞부분을 붙인 요청을 15~20초 간격으로 반복해 보니, 5,605토큰 이상 프롬프트에서 3.8 Flash는 네이티브·OpenAI 호환 경로를 합쳐 40번 중 13번(34번은 바이트 단위로 똑같은 요청, 6번은 끝 질문만 다른 요청), Argon은 똑같은 요청 10번 중 3번 적중했습니다. 적중해도 캐시된 양은 3.8 Flash가 프롬프트의 49~70%, Argon이 66~82%여서 입력비 절감은 44~78%에 그쳤고, 3.8 Flash는 구글 문서의 최소값 4,096토큰을 넘는 4,971토큰에서도 한 번도 적중하지 않았습니다.
모델별 캐싱 지원과 캐시 단가: Argon은 암시적만
암시적 캐싱은 Gemini 2.5 이후 모든 모델에서 기본으로 켜져 있고, 명시적 캐싱은 Gemini 3 계열과 2.5 계열에서만 됩니다. Gemini API 컨텍스트 캐싱 문서(generateContent 버전)는 Gemini 4 Argon과 그 이후 모델에서 명시적 캐싱을 지원하지 않는다고 적고 있고, Gemini 4 Argon 이전 안내는 Argon에 caches.create나 cached_content를 보내면 오류가 난다고 설명합니다. 아래 단가는 2026년 10월 30일 기준 Gemini API 가격 페이지의 유료 등급 Standard 요금이며, 100만 토큰당 달러입니다.
| 모델 | 암시적 | 명시적 | 입력 | 캐시 입력 | 명시적 캐시 저장(시간당) |
|---|---|---|---|---|---|
| Gemini 4 Argon | 지원 | 미지원(오류) | $2.00, 12월 1일부터 $4.00 | $0.10, 12월 1일부터 $0.20 (95% 할인) | 해당 없음 |
| Gemini 3.8 Flash | 지원 | 지원 | $0.75, 2027년 1월 1일부터 $1.50 | $0.075, 2027년부터 $0.15 (90% 할인) | $0.50, 2027년부터 $1.00 |
| Gemini 3.6 Flash | 지원 | 지원 | 3.8 Flash와 같음 | 3.8 Flash와 같음 | 3.8 Flash와 같음 |
| Gemini 3.1 Pro Preview (20만 토큰 이하) | 지원 | 지원 | $2.00 | $0.20 | $4.50 |
| Gemini 3.5 Flash-Lite | 지원 | 지원 | $0.30 | $0.03 | $1.00 |
| Gemini 3.1 Flash-Lite (텍스트) | 지원 | 지원 | $0.25 | $0.025 | $1.00 |
Gemini 2.5 Flash와 2.5 Pro도 두 방식을 모두 지원합니다. 어느 API로 호출하느냐도 갈림길입니다. Interactions API의 컨텍스트 캐싱 문서는 Interactions API가 암시적 캐싱만 지원하며, previous_interaction_id를 쓰는 상태 유지 대화와 상태 비저장 호출 양쪽에서 동작한다고 설명합니다. 명시적 캐시를 쓰려면 지원 모델로 generateContent API를 호출해야 하고, 명시적 캐싱은 아직 Beta라 엔드포인트가 v1beta 아래에 있습니다. 모델별 전체 요금과 결제 방법은 Gemini API 키 발급과 가격·결제: 키는 무료, 3.8 Flash 단가 2027년 2배에 정리돼 있습니다.
명시적 캐시는 언제 이득인가: 1시간 캐시는 3.8 Flash 2회부터
한 시간만 쓰고 지우는 명시적 캐시라면 3.8 Flash는 그 한 시간 안에 같은 컨텍스트를 2회 이상 써야 캐싱 없이 보내는 것보다 쌉니다. Gemini Enterprise Agent Platform의 컨텍스트 캐싱 개요에 따르면 캐시를 만들 때 들어가는 입력 토큰은 정가로 한 번 청구되므로, 필요한 요청 수는 "(입력 단가 + 시간당 저장비) ÷ (입력 단가 − 캐시 입력 단가)"입니다. 3.8 Flash는 ($0.75 + $0.50) ÷ ($0.75 − $0.075) = 1.85회라 2회부터, 3.1 Pro Preview는 ($2.00 + $4.50) ÷ $1.80 = 3.61회라 4회부터, 3.5 Flash-Lite는 ($0.30 + $1.00) ÷ $0.27 = 4.81회라 5회부터, 3.1 Flash-Lite는 ($0.25 + $1.00) ÷ $0.225 = 5.56회라 6회부터 이득입니다.
캐시를 여러 시간 계속 유지한다면 생성비는 처음 한 번뿐이라 저장비만 따지면 됩니다. 이때 손익분기는 "시간당 저장비 ÷ 재사용 1회당 절약액"이어서 3.8 Flash는 $0.50 ÷ $0.675 = 시간당 0.74회, 3.1 Pro Preview는 2.5회, 3.5 Flash-Lite는 3.7회, 3.1 Flash-Lite는 4.44회입니다. 2027년 1월 1일에는 3.8 Flash의 입력·캐시 입력·저장비가 모두 두 배가 되므로 두 기준 모두 그대로입니다. 어느 쪽이든 저장비가 단가에 비해 큰 모델일수록 캐시를 자주 꺼내 써야 남습니다. 100,000토큰 문서를 3.8 Flash(2026년 단가)로 한 시간 동안 쓰는 경우를 입력 비용만 따져 보면 다음과 같습니다.
| 시간당 요청 수 | 캐싱 없음 | 명시적 캐시 | 암시적, 첫 요청 뒤 모두 적중 | 암시적, 첫 요청 뒤 4번에 1번 적중 |
|---|---|---|---|---|
| 1 | $0.0750 | $0.1325 | $0.0750 | $0.0750 |
| 2 | $0.1500 | $0.1400 | $0.0825 | $0.1500 |
| 10 | $0.7500 | $0.2000 | $0.1425 | $0.6150 |
| 60 | $4.5000 | $0.5750 | $0.5175 | $3.5550 |
명시적 캐시 열은 생성 $0.075 + 요청마다 캐시 읽기 $0.0075 + 1시간 저장 $0.05로 계산했습니다. 암시적 캐싱이 매번 적중하고 문서 전체가 캐시된다면 저장비가 없는 만큼 가장 싸지만, 실측 적중은 약 3번에 1번이었고 적중할 때도 프롬프트 일부만 캐시됐습니다. 적중률을 3번에 1번으로 놓고 문서 전체가 캐시된다고 쳐도, 시간당 2회에서는 암시적 쪽이 약 $0.1275로 명시적 캐시 $0.14보다 싸고 3회부터 명시적 캐시($0.1475 대 약 $0.18)가 앞섭니다. 그래서 같은 문서를 한 시간에 3회 이상 쓰고 구글 API 키나 Google Cloud 프로젝트로 직접 호출할 수 있다면 명시적 캐시가 싸고 비용도 예측하기 쉽습니다.
Argon에는 이 계산이 해당하지 않습니다. 저장비도 손익분기도 없고, 적중한 캐시 토큰 100만 개마다 2026년 11월 30일까지 $1.90, 12월 1일부터 $3.80을 아낄 뿐입니다. Batch 요청의 Argon 캐시 입력 단가도 12월 1일에 $0.05에서 $0.10으로 오릅니다. Argon과 3.8 Flash 중 어느 모델이 실제 작업 비용에서 유리한지는 Gemini 4 Argon vs 3.8 Flash 차이: 같은 프롬프트 실측 비용과 갈아탈 작업에서 따로 비교합니다.
명시적 캐시 만들기: caches.create부터 삭제까지
명시적 캐시는 만들고, 요청에서 이름으로 참조하고, 필요하면 TTL을 바꾸고, 다 쓰면 지우는 네 단계입니다. 아래 코드는 Gemini API 컨텍스트 캐싱 문서의 Python(google-genai) 예제를 텍스트 문서용으로 줄인 것이고, API 키는 환경 변수 GEMINI_API_KEY에서 읽습니다. 2026년 10월 30일 LaoZhang 게이트웨이에서는 캐시 생성 엔드포인트가 404를 반환했기 때문에, 이 흐름은 구글 API 키나 Google Cloud 프로젝트로 직접 호출할 때 씁니다.
import os
from google import genai
from google.genai import types

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])
MODEL = "gemini-3.8-flash"  # Argon은 명시적 캐싱 미지원

with open("manual.md", encoding="utf-8") as f:
    manual = f.read()

# 1) 캐시 생성: 여기서 들어간 입력 토큰은 정가로 한 번 청구
cache = client.caches.create(
    model=MODEL,
    config=types.CreateCachedContentConfig(
        display_name="product-manual",
        system_instruction="첨부한 제품 매뉴얼을 근거로만 답하세요.",
        contents=[manual],
        ttl="3600s",  # 생략하면 기본 1시간
    ),
)

# 2) 사용: cached_content에 캐시 이름을 넘김
resp = client.models.generate_content(
    model=MODEL,
    contents="환불 규정을 세 줄로 요약해 주세요.",
    config=types.GenerateContentConfig(cached_content=cache.name),
)
print(resp.usage_metadata.cached_content_token_count)

# 3) TTL 변경: 바꿀 수 있는 것은 ttl 또는 expire_time뿐
client.caches.update(
    name=cache.name,
    config=types.UpdateCachedContentConfig(ttl="7200s"),
)

# 4) 삭제: 저장비는 TTL 동안 계속 붙으므로 다 쓰면 지움
client.caches.delete(name=cache.name)expire_time으로 만료 시각을 지정할 때는 시간대가 붙은 값을 넘겨야 합니다. 공식 문서의 예시대로 datetime.now(datetime.timezone.utc)를 기준으로 계산하면 됩니다. caches.list()와 caches.get()은 이름, 모델, 생성·만료 시각 같은 메타데이터만 돌려주고 캐시에 넣은 내용은 다시 꺼낼 수 없습니다. OpenAI 라이브러리로 Gemini API를 호출한다면 extra_body에 cached_content를 넣어 같은 캐시를 지정합니다. 모델은 캐시된 토큰을 프롬프트 앞부분으로 취급하므로, 캐시 뒤에 붙는 질문이 짧을수록 할인되는 비중이 커집니다.
캐시 적중 확인: cachedContentTokenCount 필드 읽기
적중했는지는 응답의 사용량 필드에 캐시 토큰 수가 있는지로 판단합니다. generateContent의 REST 응답에서는 usageMetadata.cachedContentTokenCount, Python SDK에서는 usage_metadata.cached_content_token_count이고, Interactions API는 usage.total_cached_tokens에 적중한 토큰 수를 넣습니다. 2026년 10월 30일 LaoZhang 경유 3.8 Flash 호출에서 적중한 응답은 다음과 같았습니다.
"usageMetadata": {
  "promptTokenCount": 11645,
  "cachedContentTokenCount": 8165,
  "candidatesTokenCount": 56,
  "totalTokenCount": 11701,
  "cacheTokensDetails": [{ "modality": "TEXT", "tokenCount": 8165 }]
}
promptTokenCount 11,645에는 캐시된 8,165토큰이 포함돼 있으므로, 이 요청은 8,165토큰을 캐시 단가로, 나머지 3,480토큰을 정가로 냈습니다. 미적중이면 cachedContentTokenCount가 0으로 오는 것이 아니라 키 자체가 없어서, Python에서는 cached_content_token_count or 0처럼 None을 0으로 바꿔 읽어야 집계가 깨지지 않습니다. OpenAI 호환 /v1/chat/completions 경로에서는 적중하면 "prompt_tokens_details": {"cached_tokens": 8161}, 미적중이면 "prompt_tokens_details": {}로 왔고, prompt_tokens는 여기서도 캐시분을 포함한 전체 값이었습니다.
최소 토큰은 4,096인가 6,144인가: 실측은 5,605토큰부터 적중
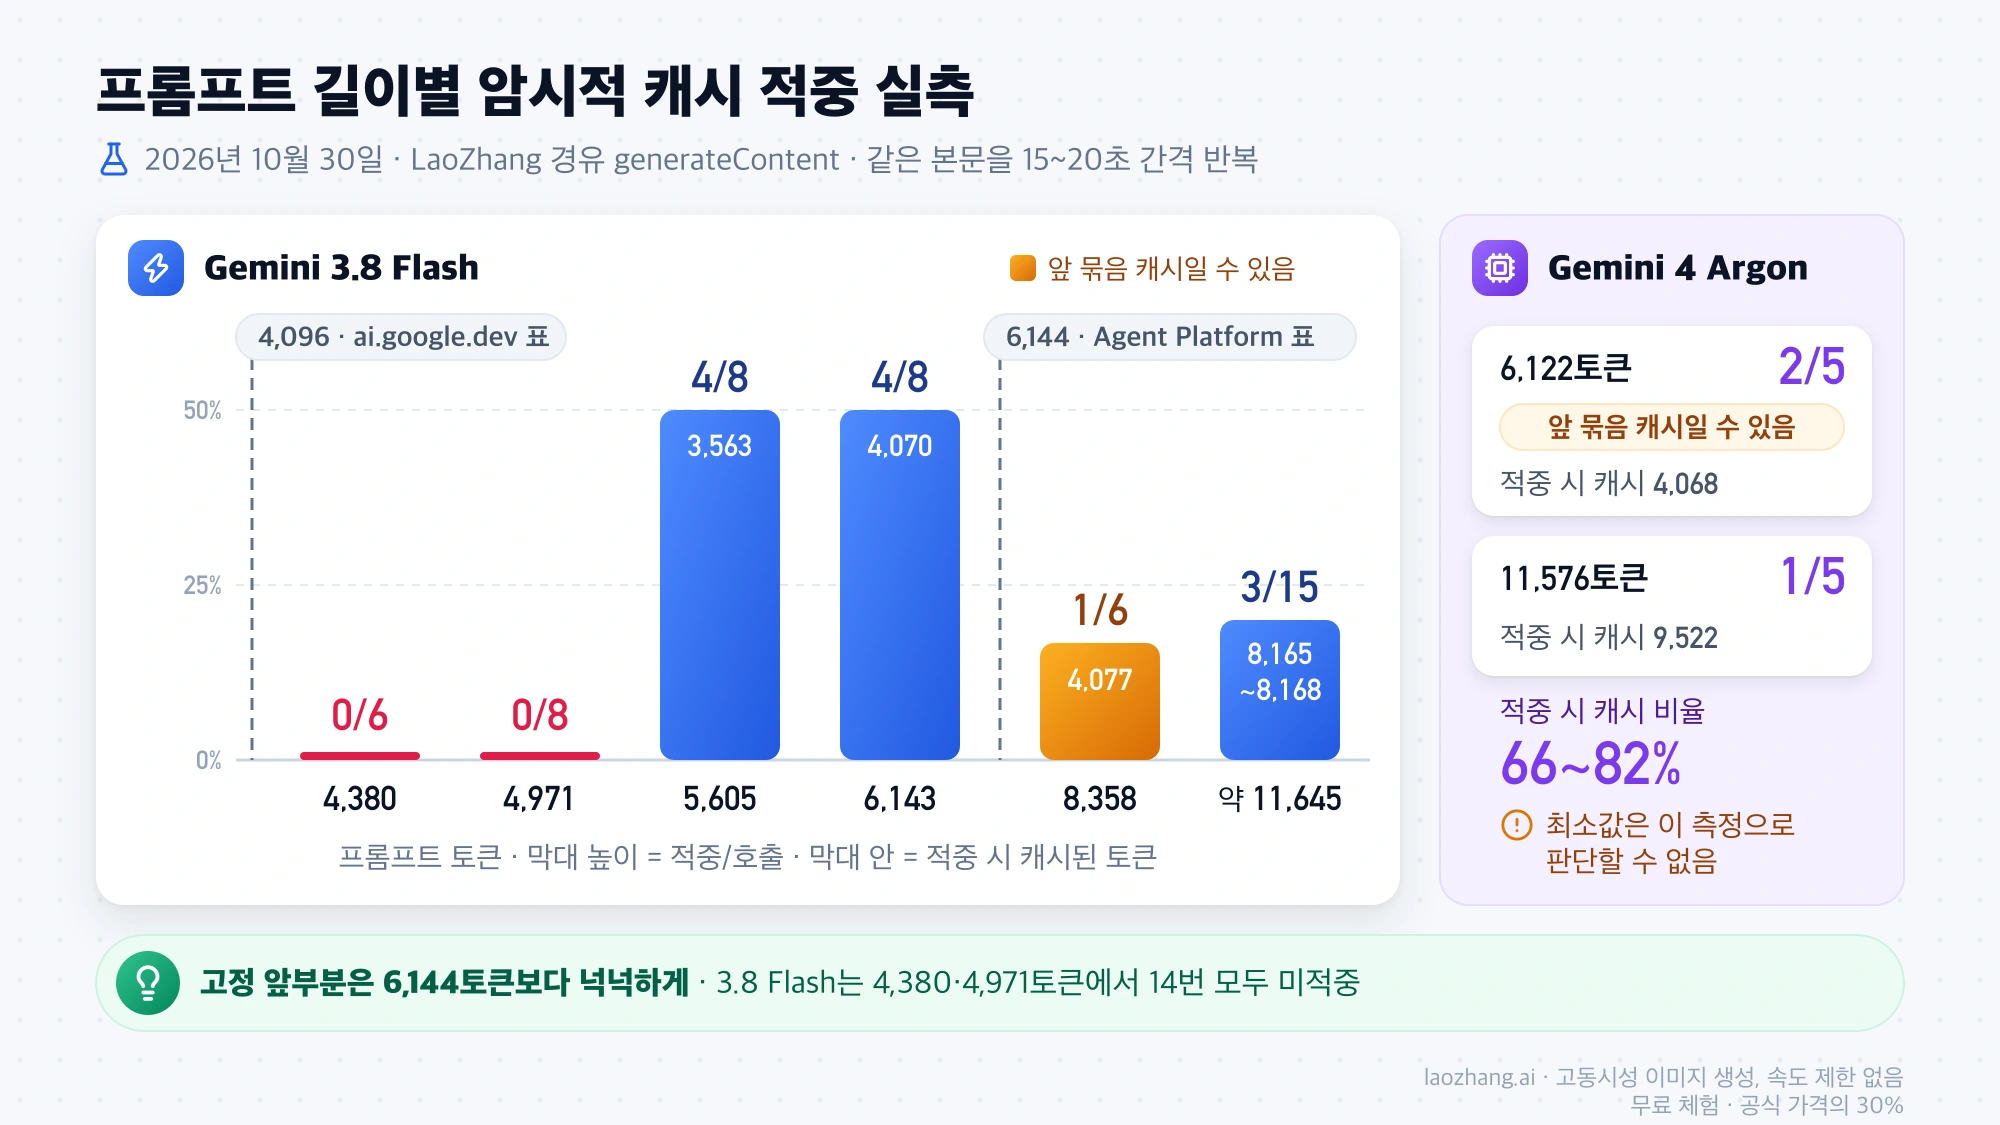
암시적 캐싱이 시작되는 최소 프롬프트 길이는 구글 문서끼리 서로 다릅니다. ai.google.dev의 표는 Argon, 3.8 Flash, 3.6 Flash, 3.1 Pro Preview를 모두 4,096토큰(2.5 Flash·Pro는 2,048토큰)으로 적고 있습니다. 반면 Gemini Enterprise Agent Platform의 한도 표는 3.8 Flash와 3.1 Pro Preview의 암시적 캐싱 최소값을 6,144토큰으로 따로 적고, Cloud의 Argon 개발자 가이드는 6,144토큰, 같은 Cloud의 Argon 모델 페이지는 4,096토큰이라고 씁니다. 어느 숫자가 맞는지는 공개 문서만으로 가릴 수 없으므로, 아래는 프롬프트 길이를 바꿔 가며 실제 적중 경계를 잰 결과입니다.
측정은 2026년 10월 30일 15시 15분~51분(UTC)에 LaoZhang 게이트웨이의 Gemini 네이티브 generateContent 경로로 했습니다. 영문 기사 두 편을 이어 붙인 텍스트를 시스템 지시에 넣고 길이를 바꿔 가며, 길이마다 같은 본문을 15~20초 간격으로 반복해 보냈습니다. 약 11,645토큰 묶음의 처음 3번만 끝 질문을 서로 다르게 했고 나머지는 바이트 단위로 똑같은 요청이었으며, 모든 200 응답의 modelVersion은 요청한 모델과 같았습니다. 다만 한 번의 스크립트 실행 안에서는 묶음끼리 앞부분 텍스트가 같았기 때문에, 3.8 Flash 8,358토큰 묶음과 Argon 6,122토큰 묶음은 앞서 보낸 다른 묶음이 남긴 캐시를 읽었을 수 있습니다. 앞에 재사용할 묶음이 없었던 것은 3.8 Flash의 4,971·5,605·6,143·약 11,645토큰 묶음과 Argon 11,576토큰 묶음입니다. 계정 1개, 게이트웨이 1곳, 하루, 접두 텍스트 1종으로 잰 결과이고 구글 키로 직접 보낸 측정은 아닙니다. 호출 약 60회의 비용은 구글 정가로 다시 계산하면 약 $0.44였습니다.
| 모델 | 프롬프트 토큰 | 호출 | 적중 | 적중 시 캐시 토큰 |
|---|---|---|---|---|
| 3.8 Flash | 4,380 | 6 | 0 | — |
| 3.8 Flash | 4,971 | 8 | 0 | — |
| 3.8 Flash | 5,605 | 8 | 4 | 3,563 |
| 3.8 Flash | 6,143 | 8 | 4 | 4,070 |
| 3.8 Flash | 8,358 (앞 묶음 캐시일 수 있음) | 6 | 1 | 4,077 |
| 3.8 Flash | 약 11,645 | 15 | 3 | 8,165~8,168 |
| Gemini 4 Argon | 6,122 (앞 묶음 캐시일 수 있음) | 5 | 2 | 4,068 |
| Gemini 4 Argon | 11,576 | 5 | 1 | 9,522 |
3.8 Flash는 4,096토큰을 넘는 4,380·4,971토큰에서 14번 모두 빗나갔고, 6,144토큰보다 짧은 5,605토큰부터 적중이 나왔습니다. 3.8 Flash의 이 경계는 앞 묶음의 캐시가 섞이지 않은 묶음에서 나온 결과입니다. Argon의 6,122토큰 적중은 먼저 보낸 11,576토큰 요청이 만든 캐시를 읽었을 수 있어서, 6,122토큰 프롬프트가 스스로 캐시를 만든다는 근거가 되지 못하고 Argon의 최소값은 이 측정으로 판단할 수 없습니다. 이 결과만으로 어느 문서가 정답이라고 할 수는 없지만, 고정된 앞부분이 4,096토큰을 겨우 넘는 정도라면 3.8 Flash에서는 캐시를 기대하지 않는 편이 안전합니다. 적중률을 올리려면 고정 부분을 6,144토큰보다 넉넉하게 잡는 쪽이 문서 세 곳의 기준을 모두 만족합니다.
암시적 캐싱이 안 맞을 때: 똑같은 요청도 맞았다 안 맞았다
암시적 캐싱은 "처음 한 번만 빗나가고 그 뒤로는 계속 맞는" 방식이 아니었습니다. 2026년 10월 30일 LaoZhang 경유로 6,143토큰짜리 똑같은 요청을 15~20초 간격으로 8번 보냈을 때 결과는 미적중, 미적중, 적중, 미적중, 미적중, 적중, 적중, 적중이었습니다. 구글 문서도 암시적 캐싱에 대해 "비용 절감 보장 없음"이라고 적고 있으므로, 같은 요청이 맞았다 안 맞았다 하는 것만으로는 설정이 틀렸다고 볼 수 없습니다. 11,645토큰에서 긴 텍스트를 시스템 지시에 넣었을 때(6번 중 2번)와 사용자 턴에 넣었을 때(6번 중 1번)도 뚜렷한 차이는 없었습니다.
적중해도 할인이 90%에 못 미치는 이유는 프롬프트 전체가 캐시되지 않기 때문입니다. 실측에서 적중 한 번에 캐시된 양은 3.8 Flash가 프롬프트의 49~70%, Argon이 66~82%였고, 나머지 2,042~4,281토큰은 정가로 청구됐습니다. 이 토큰 수는 끝에 붙인 짧은 질문보다 항상 길었습니다. 구글 정가로 환산하면 3.8 Flash 11,645토큰 프롬프트의 입력비는 $0.008734에서 $0.003222로 63% 줄었지만, 8,358토큰 프롬프트에서 4,077토큰만 캐시된 적중은 $0.006269에서 $0.003517로 44%밖에 줄지 않았습니다. Argon 11,576토큰은 $0.023152에서 $0.005060으로 78% 줄었고, 측정한 모든 적중의 절감 폭은 3.8 Flash 44~63%, Argon 63~78%였습니다. 비용 예측에는 할인율 90%나 95%를 그대로 쓰지 말고, 실제 cachedContentTokenCount ÷ promptTokenCount 비율을 넣어야 합니다.
적중이 아예 나오지 않거나 너무 드물다면 다음 항목을 차례로 확인합니다.
| 원인 | 확인 방법 | 고칠 점 |
|---|---|---|
| 고정된 앞부분이 짧음 | promptTokenCount에서 바뀌는 부분을 뺀 길이가 6,144토큰에 못 미치는지 | 고정 지시·문서를 앞으로 모아 6,144토큰보다 넉넉하게 만듦 |
| 앞부분에 매번 바뀌는 값이 있음 | 시스템 지시에 날짜, 사용자 이름, 요청 ID, 검색 결과가 들어가는지 | 바뀌는 값은 모두 프롬프트 끝(사용자 질문 쪽)으로 옮김 |
| 같은 앞부분의 요청 간격이 김 | 같은 앞부분을 가진 요청이 드문드문 오는지 | 구글 권고대로 비슷한 앞부분 요청을 짧은 시간에 몰아 보내거나, 지원 모델이면 명시적 캐시로 전환 |
| 도구가 앞부분을 바꿈 | 프레임워크가 실제로 보내는 요청 본문을 기록해 비교 | 동적 지시를 끝으로 보내도록 설정을 바꾸거나 직접 호출 |
| 게이트웨이·여러 프로젝트 경유 | 요청이 늘 같은 구글 프로젝트로 가는지 | 캐시는 프로젝트 단위이므로 직접 키로 같은 조건을 비교 |
| Argon 멀티턴에서 추가분이 적음 | 턴마다 새로 붙는 출력·생각·함수 결과가 2,050토큰 미만인지 | 짧은 턴이 많으면 직전 요청의 마지막 2,050토큰이 정가로 다시 처리됨을 비용에 반영 |
네 번째 항목은 Reddit r/n8n의 "Google Gemini's Implicit Context Caching" 스레드에서 사용자가 n8n의 AI 에이전트 노드가 프롬프트 앞부분에 동적 지시를 끼워 넣어 적중하지 않는다고 의심한 사례에서 나온 것으로, 구글이 확인한 동작은 아닙니다. 다섯 번째 항목의 게이트웨이 영향도 추정입니다. 게이트웨이가 요청을 여러 상위 프로젝트에 나눠 보내면 적중률이 낮아질 수 있지만, 위 측정에서는 그 영향과 구글 쪽의 "보장 없음"을 구분할 수 없었습니다. 마지막 항목의 2,050토큰 규칙은 Gemini API 컨텍스트 캐싱 문서가 Gemini 4 이후 멀티턴·에이전트 루프에 대해 적은 내용이며, 단일 요청만 보낸 위 측정으로는 검증되지 않았습니다.
캐시 유지 시간(TTL): 명시적은 기본 1시간, 암시적은 최대 24시간
명시적 캐시의 TTL은 지정하지 않으면 1시간이고, ai.google.dev 문서는 TTL에 최솟값도 최댓값도 없다고 적고 있습니다. Gemini Enterprise Agent Platform 쪽 한도 표는 명시적 캐시의 최소 TTL을 1분, 최대는 없음으로 적습니다. 저장비는 캐시된 토큰 수와 TTL 길이에 비례해 붙으므로, 길게 잡기보다 필요한 만큼 잡고 caches.update로 연장하는 편이 낫습니다.
암시적 캐시는 유지 시간을 정할 수 없습니다. Google Cloud 문서는 캐시된 앞부분이 생성 후 최대 24시간 안에 만료되고 대부분은 그보다 일찍 밀려난다고 설명하며, Cloud의 Argon 가이드는 연속 요청이 15~20분 캐시 유지 시간 안에 들어올 때 95% 할인을 받는다고 적고 있습니다. ai.google.dev는 구체적인 시간 없이 "비슷한 앞부분의 요청을 짧은 시간 안에 보내라"고만 권합니다. 15~20초 간격으로 보낸 실측에서도 적중이 들쭉날쭉했으므로, 암시적 캐시가 몇 분 동안 살아 있다고 가정해 비용을 짜는 것은 위험합니다.
durable caching은 Gemini Enterprise Agent Platform 전용
durable caching(내구성 캐시 계층)은 Google Cloud의 Gemini Enterprise Agent Platform(이전 이름 Vertex AI)에만 있는 암시적 캐싱의 두 번째 저장 계층입니다. 컨텍스트 캐싱 개요에 따르면 메모리 캐시에서 밀려난 앞부분을 버리지 않고 durable 저장소로 옮겨, 재사용 간격이 길어도 적중률을 높입니다. 두 계층 모두 기본으로 켜져 있고 저장비는 없으며, 지원 모델은 Gemini 4 Argon, 4 Argon Cyber Permissive, 3.8 Flash, 3.8 Flash Cyber입니다. ai.google.dev의 Gemini API 문서에는 이 계층이 나오지 않으므로, AI Studio 키로 호출할 때도 같은 효과가 있다고 기대하면 안 됩니다.
데이터 보존 쪽도 함께 봐야 합니다. Gemini Enterprise Agent Platform의 데이터 보존 문서는 durable 캐시가 입력에서 만든 키-값 표현을 구글 기본 암호화로 저장하고, 프로젝트 범위로 묶어 늦어도 24시간 안에 지우며, 학습에는 쓰지 않는다고 설명합니다. 고객 관리 암호화 키(CMEK)는 durable 캐시에 적용되지 않습니다. 프로젝트의 cacheConfig로 durable 계층만 끄거나 암시적 캐싱 전체를 끌 수 있고, 켜져 있으면 응답에 "retentionType": "DURABLE", durable만 끄면 "EPHEMERAL"이 보입니다. 명시적 캐시를 만들면 지정한 내용 밖에서 암시적 캐싱이 추가로 일어날 수 있으므로, 보존 자체를 피해야 하는 프로젝트라면 암시적 캐싱을 끄고 명시적 캐시도 쓰지 않아야 합니다. AI Studio API와 Cloud 중 어느 쪽으로 갈지는 Gemini API와 Vertex AI API 선택 기준: 빠른 개발인지, 클라우드 거버넌스인지를 참고하면 됩니다.
LaoZhang 같은 게이트웨이와 OpenAI 호환 경로의 캐싱
게이트웨이를 거쳐도 암시적 캐싱은 동작했고, 명시적 캐싱은 쓸 수 없었습니다. 2026년 10월 30일 LaoZhang의 Gemini 네이티브 경로에서는 앞의 표처럼 3.8 Flash와 Argon 모두 적중이 나왔고, OpenAI 호환 /v1/chat/completions 경로로 3.8 Flash에 약 11,645토큰 프롬프트를 끝 질문만 바꿔 3번 보냈을 때는 1번 적중해 8,161토큰이 캐시됐습니다. 이 요청은 앞서 보낸 6,143토큰 묶음과 앞부분이 같아서, 그 캐시를 읽었을 가능성도 있습니다. 반면 POST /v1beta/cachedContents와 GET /v1beta/cachedContents는 {"error":{"message":"Invalid URL (POST /v1beta/cachedContents)","type":"invalid_request_error"}}와 함께 HTTP 404를 돌려줬습니다. 이 오류 형식은 게이트웨이의 것이라 요청이 구글까지 가지 않은 것으로 보이며, 명시적 캐시가 필요하면 구글 API 키나 Google Cloud 프로젝트로 직접 호출해야 합니다.
청구도 게이트웨이의 가격표를 따릅니다. 2026년 10월 30일 기준 LaoZhang 가격표에는 gemini-3.8-flash의 캐시 읽기 단가가 100만 토큰당 $0.075로 적혀 있지만 gemini-4-argon에는 캐시 읽기 단가가 없어서, Argon의 적중분이 그 청구서에서 할인되는지는 공개 문서로 알 수 없습니다. 게이트웨이로 측정한 적중률은 구글 직접 호출의 적중률과 다를 수 있으므로, 비용이 큰 작업이라면 실제로 쓰는 경로에서 cachedContentTokenCount 비율을 하루치 이상 모아 보고 판단하는 것이 정확합니다.
Gemini 컨텍스트 캐싱 자주 묻는 질문
Claude 프롬프트 캐싱과 무엇이 다른가요?
Claude는 요청에 cache_control을 넣어 캐시할 위치를 직접 지정하고 앞부분이 512토큰 이상이어야 캐시되지만, Gemini 암시적 캐싱은 아무 표시 없이 일정 길이를 넘는 공통 앞부분에 자동으로 적용되고 적중이 보장되지 않습니다. Claude 쪽 설정과 단가는 Claude(클로드) 프롬프트 캐싱 적용법: 캐시 읽기 0.05배, 최소 512토큰에 있습니다.
무료 등급에서도 컨텍스트 캐싱을 쓸 수 있나요?
2026년 10월 30일 기준 Gemini API 가격 페이지에서 3.8 Flash의 무료 등급 컨텍스트 캐싱은 "Free of charge", 3.5 Flash-Lite는 "Not available"로 표시되고, Gemini 4 Argon은 무료 등급 자체가 없습니다. 무료 등급에서 쓸 수 있는 모델과 한도는 Gemini API 무료 사용 한도(Free Tier) 2026: 무료 모델과 실시간 한도 확인에서 확인할 수 있습니다.
캐싱을 쓰면 요청 한도에 여유가 생기나요?
생기지 않습니다. Gemini API 문서에 따르면 컨텍스트 캐싱에 별도 한도는 없고 generateContent의 일반 한도가 그대로 적용되며, 토큰 한도에는 캐시된 토큰도 포함됩니다. 한도가 집계되는 단위와 429 대처는 Gemini API 사용량 한도 2026: 프로젝트 단위 집계와 티어별 상한, 429 대처를 보면 됩니다.
3.8 Flash에서 Argon으로 옮길 때 명시적 캐시 코드는 어떻게 하나요?
caches.create로 캐시를 만들거나 cached_content를 넘기는 코드를 지워야 합니다. Gemini 4 Argon 이전 안내는 Argon에서 이 호출이 오류를 낸다고 적고 있으며, 대신 암시적 캐싱이 기본으로 적용됩니다. 대화 기록이 모델 턴으로 끝나는 요청도 Argon에서 400 오류가 나는 지점이니 제미나이 "Requests ending with a model turn" 400 오류 원인과 해결도 함께 확인하세요.
참고 자료6
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 30일.
참고 자료6
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 30일.
- 1.Gemini API 컨텍스트 캐싱 문서(generateContent 버전)ai.google.dev/gemini-api/docs/generate-content/caching
- 2.Gemini 4 Argon 이전 안내ai.google.dev/gemini-api/docs/generate-content/latest-model
- 3.Gemini API 가격 페이지ai.google.dev/gemini-api/docs/pricing
- 4.Interactions API의 컨텍스트 캐싱 문서ai.google.dev/gemini-api/docs/caching
- 5.Gemini Enterprise Agent Platform의 컨텍스트 캐싱 개요docs.cloud.google.com/gemini-enterprise-agent-platform/models/context-cache/context-cache-overview
- 6.Gemini Enterprise Agent Platform의 데이터 보존 문서docs.cloud.google.com/gemini-enterprise-agent-platform/resources/zero-data-retention