Claude(클로드) 프롬프트 캐싱 적용법: 캐시 읽기 0.05배, 최소 512토큰
Claude 프롬프트 캐싱은 cache_control 한 줄로 켭니다. Opus·Sonnet 5.5는 캐시 읽기가 입력가의 0.05배이고, 앞부분이 512토큰 미만이면 캐시되지 않습니다.
목차
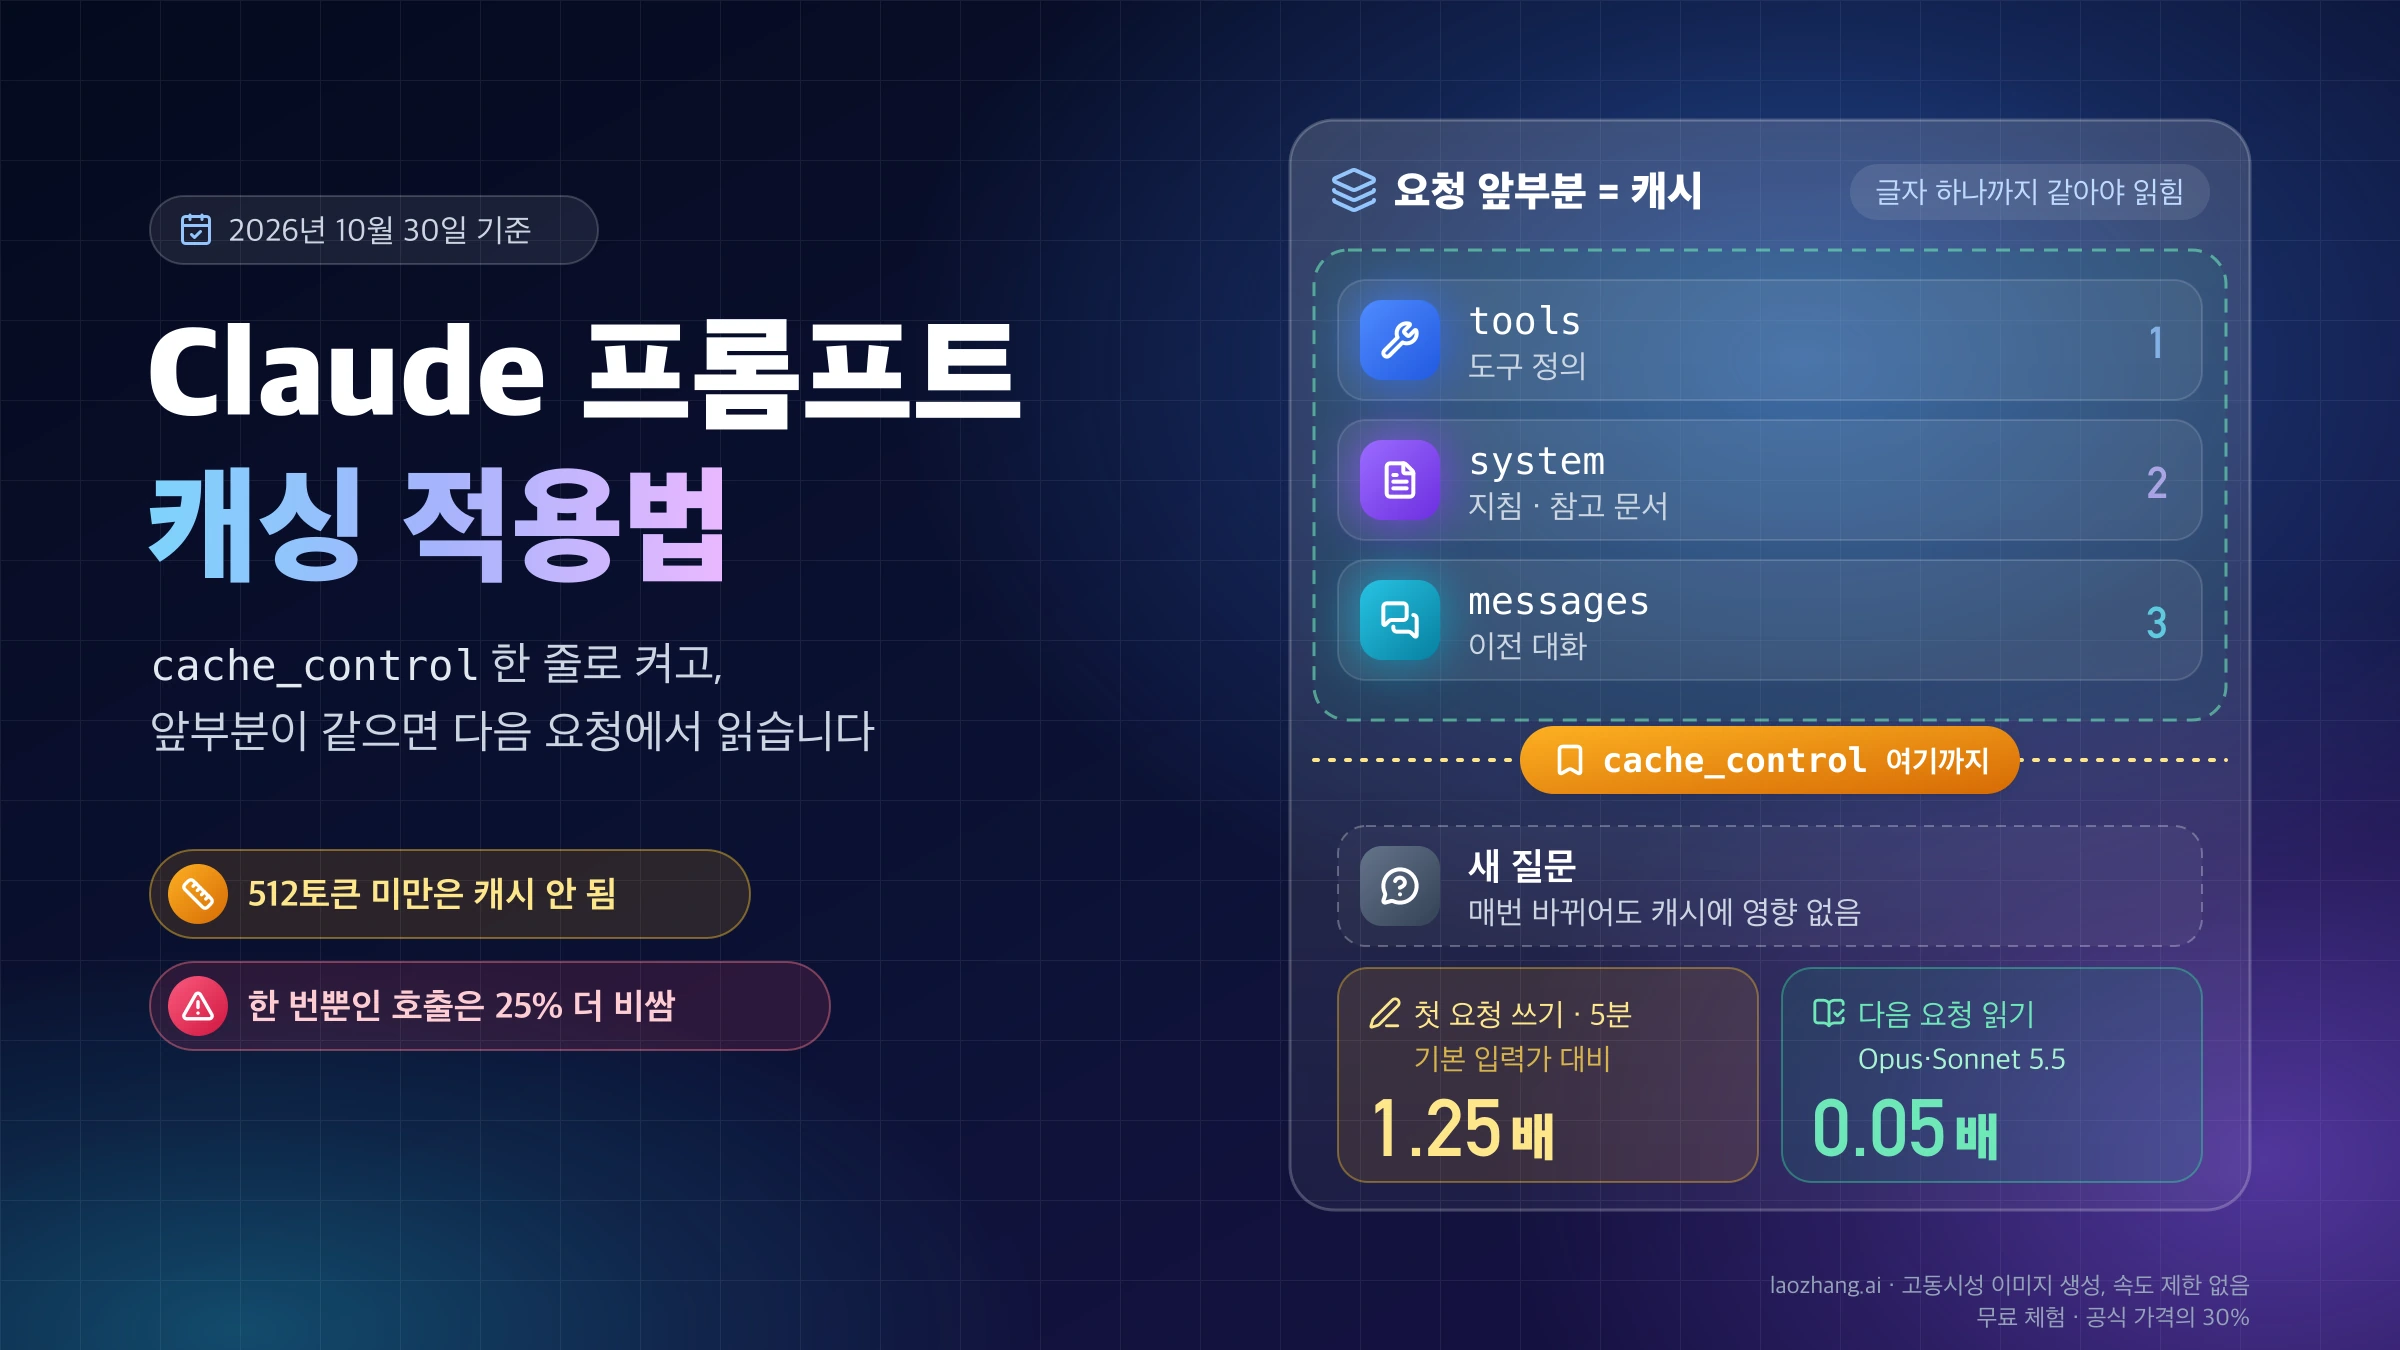
Claude 프롬프트 캐싱은 요청의 앞부분, 즉 tools → system → messages 순서로 맨 앞부터 cache_control을 붙인 블록까지를 저장해 두었다가, 다음 요청의 앞부분이 글자 하나까지 같으면 그대로 읽어 쓰는 기능입니다. 처음 저장(캐시 쓰기)할 때는 기본 입력 단가의 1.25배(5분 캐시) 또는 2배(1시간 캐시)를 내고, 다시 읽을 때는 2026년 10월 30일 기준 Opus 5.5와 Sonnet 5.5가 0.05배, Fable 5.1이 0.025배, Haiku 5.5가 0.1배를 냅니다. "캐시 읽기는 10%"라는 숫자는 이제 Haiku와 구형 모델에만 맞습니다(Anthropic 프롬프트 캐싱 문서).
오늘 적용한다면 멀티턴 대화는 요청 본문 최상위에 "cache_control": {"type": "ephemeral"} 한 줄을 넣는 자동 캐싱으로 시작하고, 마지막 블록에 타임스탬프나 요청마다 바뀌는 내용이 들어간다면 바뀌지 않는 마지막 블록에 직접 cache_control을 붙이세요. 그런 다음 응답 usage의 cache_read_input_tokens가 두 번째 호출부터 0보다 큰지 확인하면 됩니다. 2026년 10월 30일 LaoZhang API를 거쳐 Sonnet 5.5에 같은 system 프롬프트를 세 번 보낸 시험에서도 첫 호출은 쓰기, 두 번째와 세 번째는 읽기로 기록됐습니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
예외도 분명합니다. Opus 5.5, Sonnet 5.5, Haiku 5.5, Fable 5.1은 캐시할 앞부분이 512토큰보다 짧으면 오류 없이 캐싱을 건너뜁니다. 1,024·4,096토큰 기준은 Sonnet 5와 4.x 이하 모델의 값입니다. 또 같은 앞부분을 한 번만 보내거나 5분보다 긴 간격으로 보내면, 5분 캐시는 쓰기 할증만 내고 읽기는 한 번도 못 해서 캐싱하지 않을 때보다 25% 비싸집니다.
Claude 프롬프트 캐싱이란: 앞부분이 같아야 읽히는 프리픽스 캐시
Claude는 문서나 질문 단위로 캐시하지 않고, 요청 앞부분(프리픽스) 전체를 하나의 덩어리로 캐시합니다. 요청을 tools, system, messages 순서로 이어 붙인 뒤 맨 앞부터 cache_control이 붙은 블록까지를 해시로 저장하기 때문에, 그 구간 안에서 도구 설명 한 줄이나 날짜 하나만 달라져도 다른 프리픽스가 되고 처음부터 다시 쓰기가 일어납니다. 반대로 표시한 블록 뒤에 붙는 새 질문은 아무리 바뀌어도 캐시에 영향을 주지 않습니다. 그래서 오래 변하지 않는 도구 정의, 지침, 참고 문서를 앞에 두고 매번 바뀌는 질문을 뒤에 두는 것이 캐싱 구조의 기본입니다.
캐시 시간(TTL)은 기본 5분이고, 캐시를 읽을 때마다 추가 비용 없이 다시 5분으로 늘어납니다. 이 5분은 응답이 끝난 때가 아니라 그 캐시를 쓰거나 읽은 요청이 시작된 때부터 셉니다. 응답을 4분 동안 스트리밍했다면 다음 요청은 응답이 끝나고 약 1분 안에 보내야 히트한다는 뜻입니다. 5분이 짧으면 쓰기 단가 2배를 내고 1시간 캐시를 쓸 수 있으며, 두 TTL 중 무엇이 이득인지는 아래 호출 간격 계산에서 정리합니다.
자동 캐싱으로 켜기: 요청 최상위에 cache_control 한 줄
여러 턴이 이어지는 대화라면 자동 캐싱이 가장 간단합니다. 블록마다 표시하는 대신 요청 본문 최상위에 cache_control을 하나 넣으면, API가 마지막 캐시 가능 블록에 브레이크포인트를 걸고 대화가 길어질 때마다 그 위치를 뒤로 옮깁니다. Anthropic도 멀티턴 대화는 자동 캐싱부터 시작하라고 권합니다.
curl https://api.anthropic.com/v1/messages \
  -H "content-type: application/json" \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -d '{
    "model": "claude-sonnet-5-5",
    "max_tokens": 1024,
    "cache_control": {"type": "ephemeral"},
    "system": "제품 매뉴얼을 근거로 짧게 답하세요. (이어서 매뉴얼 전문)",
    "messages": [
      {"role": "user", "content": "환불 기간은 며칠인가요?"},
      {"role": "assistant", "content": "구매 후 14일입니다."},
      {"role": "user", "content": "부분 환불도 되나요?"}
    ]
  }'
이렇게 보내면 각 요청은 이전 턴까지를 캐시에서 읽고, 새로 붙은 꼬리 부분만 새로 씁니다. 2026년 10월 30일 LaoZhang API를 거쳐 같은 방식으로 Sonnet 5.5에 3턴 대화를 보냈을 때 1턴은 7,906토큰을 썼고, 2턴은 7,906토큰을 읽으면서 새로 붙은 65토큰만 썼으며, 3턴은 7,971토큰을 읽고 74토큰을 썼습니다. 문서에 적힌 대로 캐시 지점이 대화를 따라 앞으로 이동한 것입니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
1시간 캐시를 원하면 같은 자리에 {"type": "ephemeral", "ttl": "1h"}를 넣습니다. 자동 캐싱도 브레이크포인트 4개 중 하나를 차지하므로, 이미 블록에 cache_control을 4개 붙인 요청이나 마지막 블록에 다른 TTL의 cache_control이 붙은 요청은 400 오류를 받습니다. 그리고 마지막 블록이 매 요청 달라지는 구조, 예를 들어 사용자 메시지 앞에 현재 시각을 붙이는 경우에는 자동 캐싱도 매번 쓰기만 하고 읽지 못하므로 다음 절의 명시적 브레이크포인트를 써야 합니다. 구형 Amazon Bedrock 통합(Opus 4.6 이하)은 최상위 cache_control을 400으로 거절하므로 그곳에서도 명시적 방식을 씁니다.
명시적 브레이크포인트: 바뀌지 않는 마지막 블록에 cache_control 붙이기
질문마다 앞에 붙는 긴 지침이나 문서가 있고 끝부분만 요청마다 바뀐다면, 바뀌지 않는 마지막 블록에 직접 cache_control을 붙입니다. 캐시 쓰기는 브레이크포인트 위치에서만 일어나므로, 이 위치가 곧 캐시되는 범위의 끝입니다. 브레이크포인트 자체에는 비용이 없고 한 요청에 4개까지 둘 수 있습니다.
import os
import anthropic

client = anthropic.Anthropic(api_key=os.environ["ANTHROPIC_API_KEY"])
manual = open("manual.md", encoding="utf-8").read()  # 512토큰 이상이어야 캐시됨

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    system=[
        {"type": "text", "text": "제품 매뉴얼을 근거로 짧게 답하세요."},
        {
            "type": "text",
            "text": manual,
            "cache_control": {"type": "ephemeral"},  # 바뀌지 않는 마지막 블록
        },
    ],
    messages=[{"role": "user", "content": "환불 기간은 며칠인가요?"}],
)
print(response.usage)
2026년 10월 30일 LaoZhang API를 거쳐 이 구조로 Sonnet 5.5에 7,882토큰짜리 system 블록(블로그 글 한 편)을 붙이고 질문만 바꿔 세 번 보냈습니다. 첫 호출은 cache_creation_input_tokens: 7882, cache_read_input_tokens: 0이었고, 두 번째와 세 번째 호출은 cache_creation_input_tokens: 0, cache_read_input_tokens: 7882였습니다. 질문이 달라도 표시한 블록까지의 앞부분이 같았기 때문에 그대로 읽힌 것입니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
가장 흔한 실수는 매번 바뀌는 블록에 브레이크포인트를 다는 것입니다. 타임스탬프와 사용자 질문이 든 마지막 블록에 cache_control을 붙이면 해시가 매번 달라지고, API는 그보다 앞선 위치에 이전 요청이 써 둔 항목만 찾기 때문에 매 요청이 새 쓰기로 끝납니다. 앞쪽의 변하지 않는 내용을 알아서 찾아 캐시해 주지는 않으므로, 브레이크포인트를 변하지 않는 마지막 블록으로 옮기는 것이 해결책입니다. 이 되짚어 찾기는 브레이크포인트에서 최대 20블록까지만 거슬러 올라가므로, 한 턴에 블록이 20개 넘게 늘어나는 에이전트 대화라면 중간에 두 번째 브레이크포인트를 미리 두세요. 도구 정의는 거의 안 바뀌고 참고 자료는 하루에 한 번 바뀌는 식으로 변경 주기가 다른 구간이 있을 때도 구간마다 브레이크포인트를 나눠 두면 됩니다.
모델별 Claude 캐시 가격: 읽기 배수가 0.05·0.025·0.1로 갈립니다
캐시 쓰기는 모든 모델에서 기본 입력 단가의 1.25배(5분) 또는 2배(1시간)로 같고, 모델마다 달라지는 것은 읽기 배수입니다. 2026년 10월 30일 기준 Anthropic 가격표를 100만 토큰당 달러로 옮기면 다음과 같습니다(Anthropic 프롬프트 캐싱 문서의 가격 표).
| 모델 | 기본 입력 | 5분 쓰기 | 1시간 쓰기 | 캐시 읽기 | 읽기 배수 | 최소 캐시 길이 |
|---|---|---|---|---|---|---|
| Fable 5.1 | $10 | $12.50 | $20 | $0.25 | 0.025배 | 512토큰 |
| Opus 5.5 | $4 | $5 | $8 | $0.20 | 0.05배 | 512토큰 |
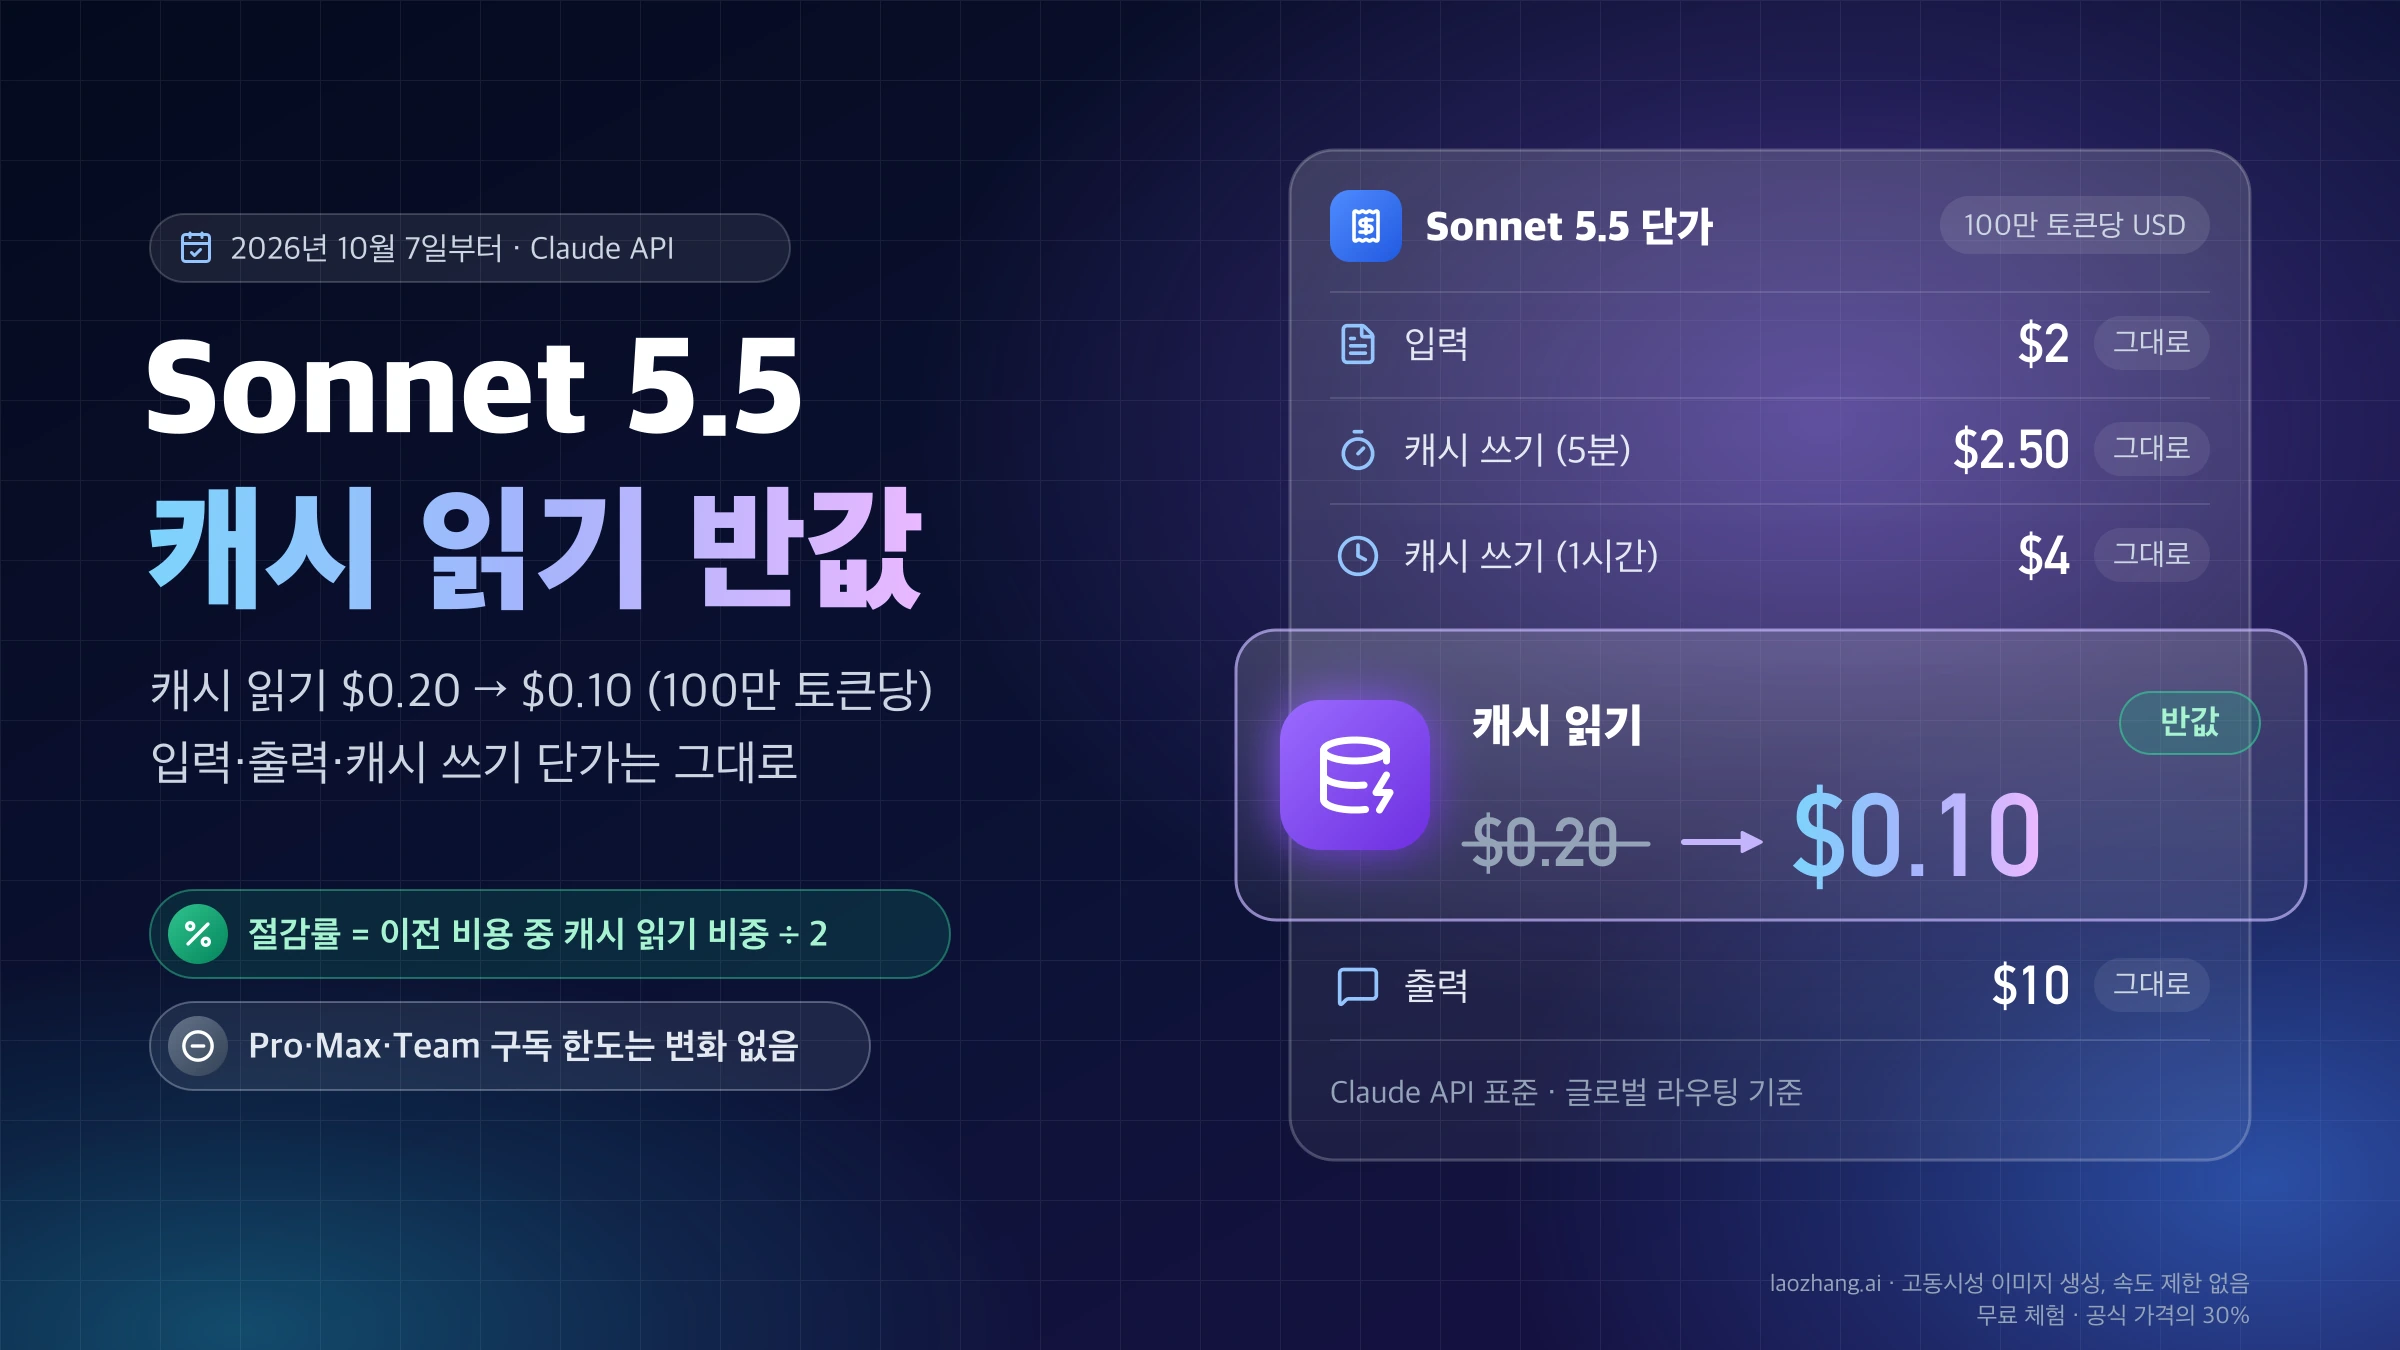
| Sonnet 5.5 | $2 | $2.50 | $4 | $0.10 | 0.05배 | 512토큰 |
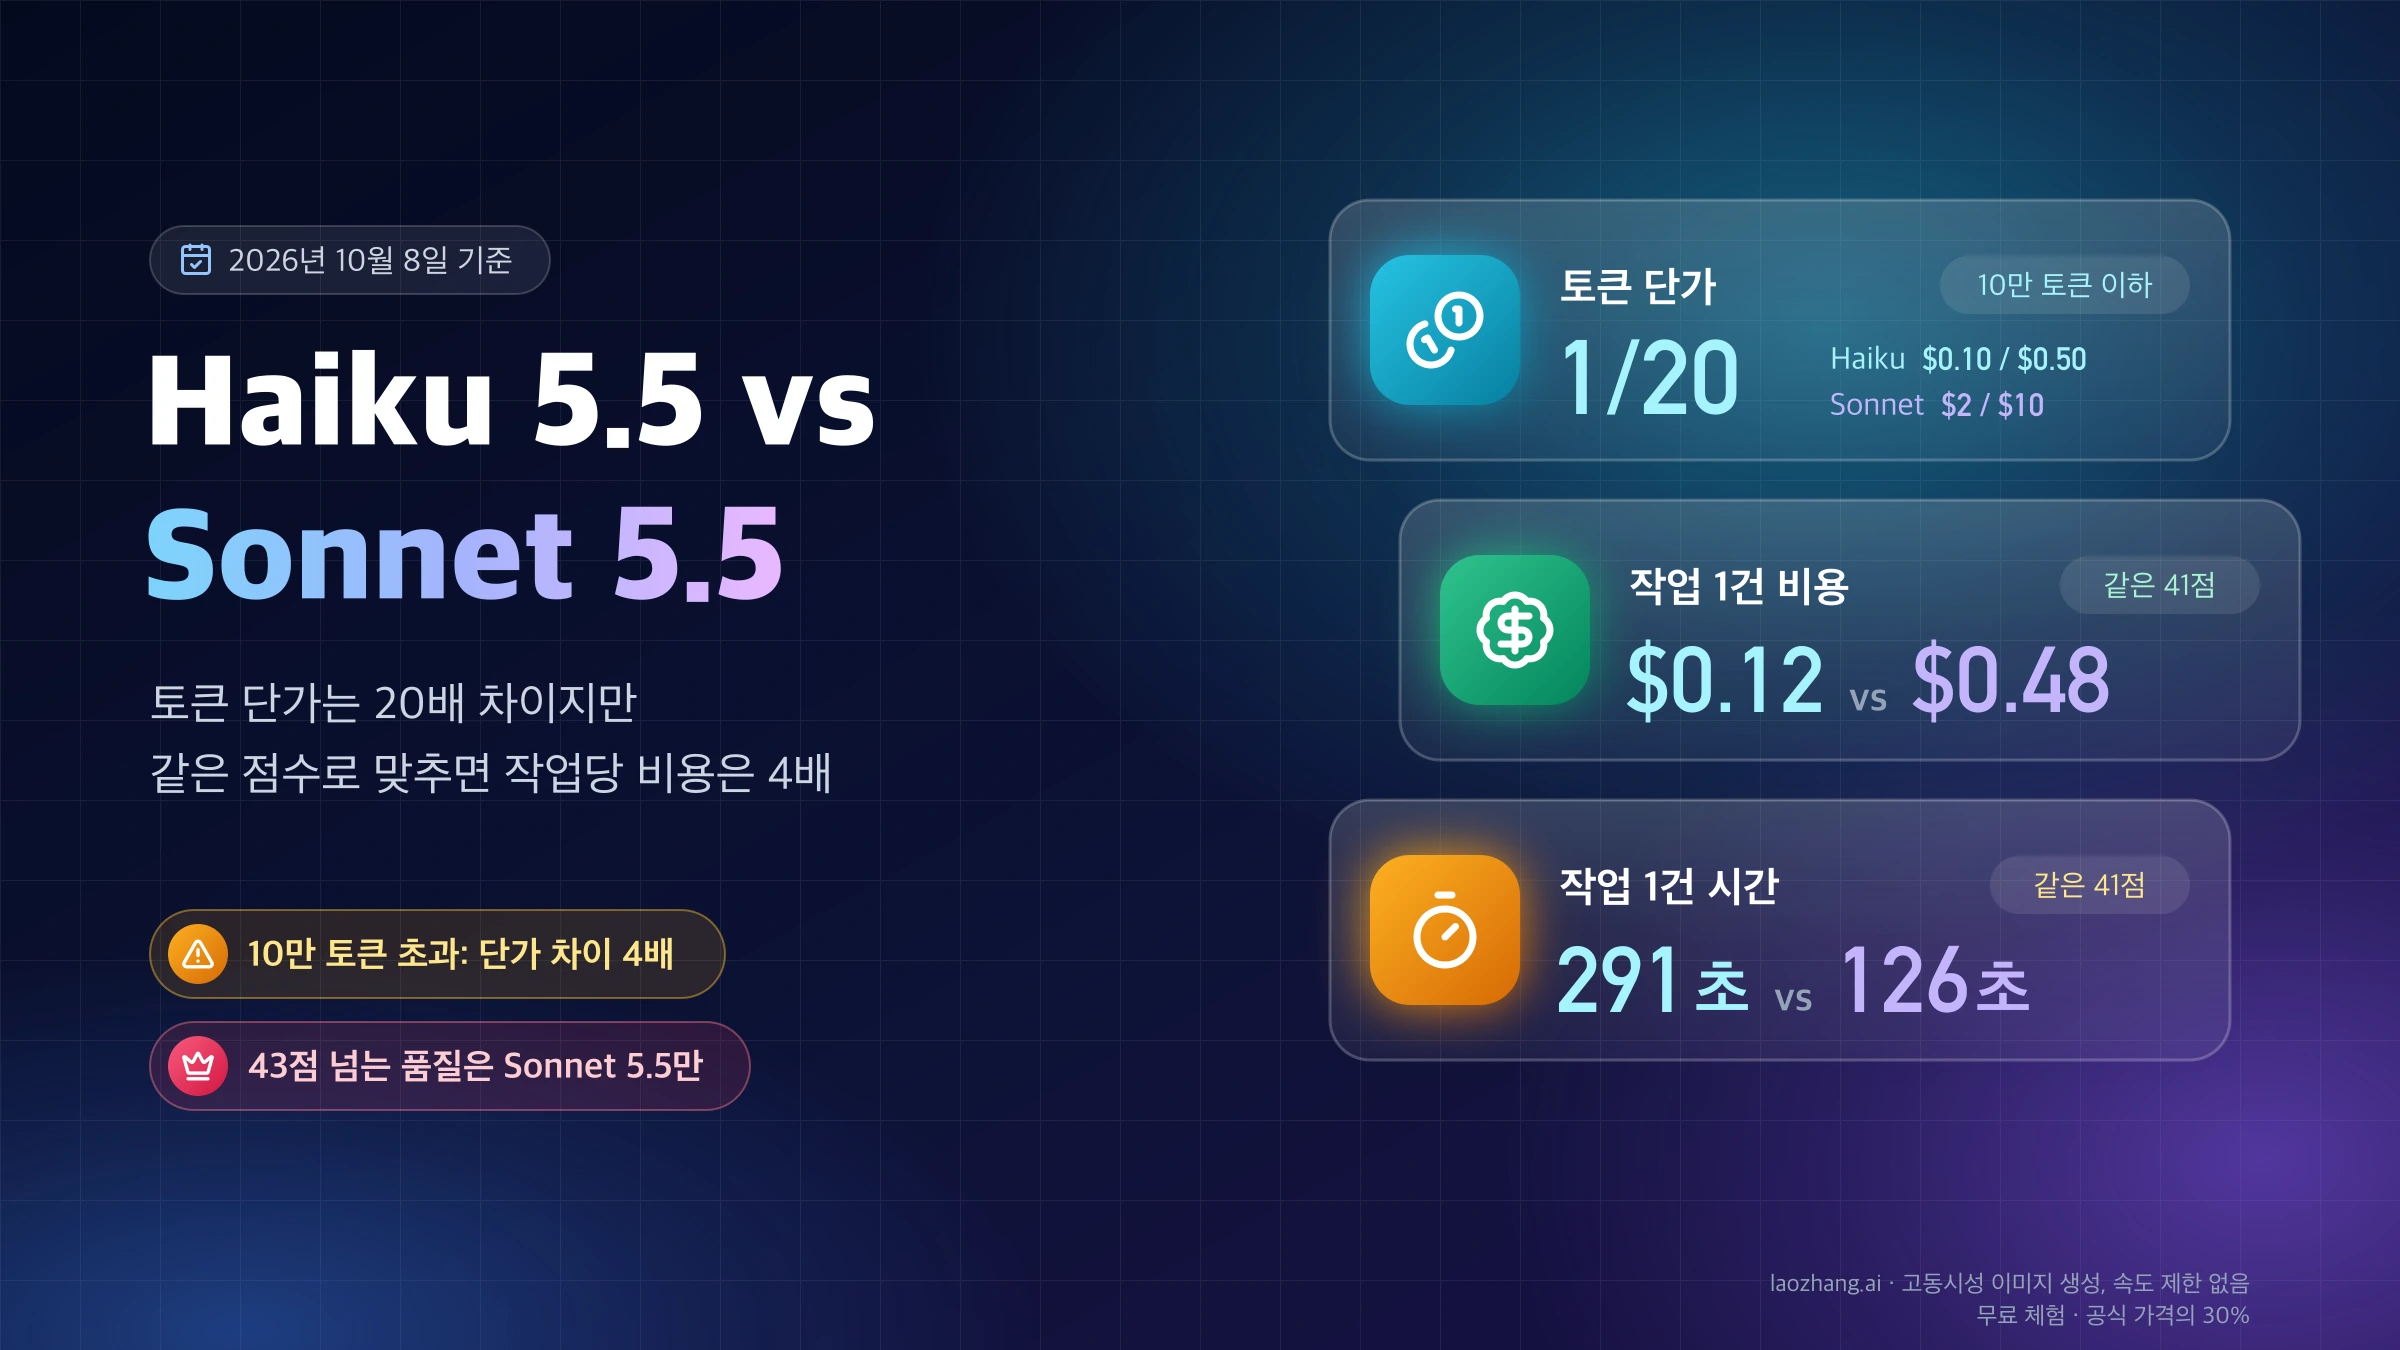
| Haiku 5.5 (10만 토큰 이하) | $0.10 | $0.125 | $0.20 | $0.01 | 0.1배 | 512토큰 |
| Haiku 5.5 (10만 토큰 초과) | $0.50 | $0.625 | $1 | $0.05 | 0.1배 | 512토큰 |
| Opus 5 | $5 | $6.25 | $10 | $0.50 | 0.1배 | 512토큰 |
| Sonnet 5 | $2 | $2.50 | $4 | $0.20 | 0.1배 | 1,024토큰 |
| Sonnet 4.6 | $3 | $3.75 | $6 | $0.30 | 0.1배 | 1,024토큰 |
| Haiku 4.5 | $1 | $1.25 | $2 | $0.10 | 0.1배 | 4,096토큰 |
그래서 Opus 5.5와 Sonnet 5.5에서는 5분 쓰기(1.25배)와 읽기(0.05배)의 차이가 흔히 알려진 12.5배가 아니라 25배입니다. Haiku 5.5는 캐시 읽기와 쓰기 토큰도 프롬프트 길이에 들어가므로, 캐시한 문서 때문에 한 요청이 10만 토큰을 넘으면 그 요청 전체가 장문 컨텍스트 단가로 계산됩니다. 배수는 Batch 할인이나 데이터 레지던시 할증과 곱해서 적용됩니다.
절감액은 캐시 비용 = 프리픽스 토큰 × (쓰기 단가 + (호출 수 − 1) × 읽기 단가)로 계산합니다. 80,000토큰 프리픽스를 TTL 안에서 20번 호출한다고 하면 입력 쪽 비용은 아래와 같고, 출력 토큰 비용은 캐싱과 관계없이 그대로입니다.
| 모델 | 캐시 없음 | 5분 캐시 | 절감률 | 1시간 캐시 | 절감률 |
|---|---|---|---|---|---|
| Fable 5.1 | $16.00 | $1.38 | 91.4% | $1.98 | 87.6% |
| Opus 5.5 | $6.40 | $0.704 | 89.0% | $0.944 | 85.2% |
| Sonnet 5.5 | $3.20 | $0.352 | 89.0% | $0.472 | 85.2% |
| Haiku 5.5 | $0.16 | $0.025 | 84.2% | $0.031 | 80.5% |
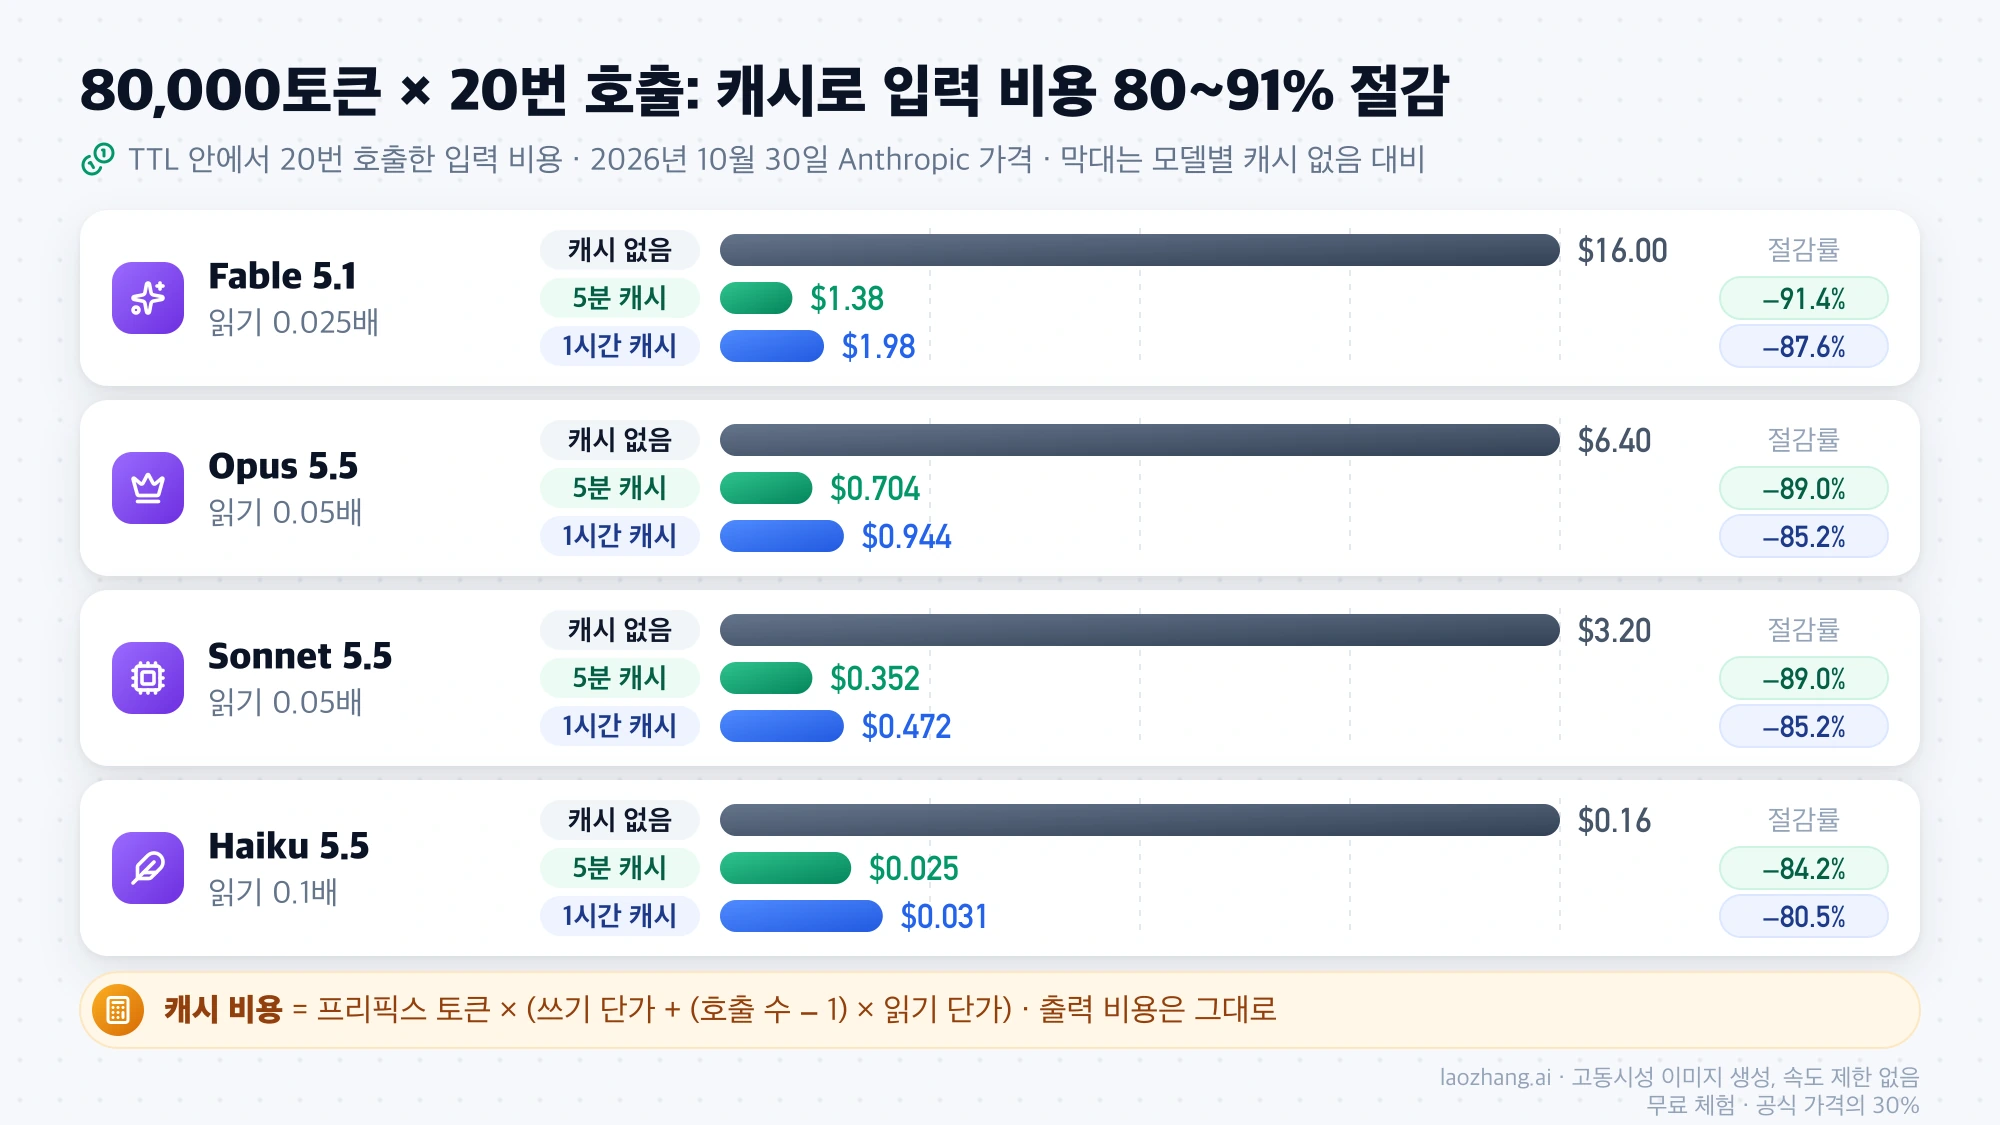
Opus 5.5를 예로 들면 캐시 없이 80,000 × 20 × $4/100만 = $6.40이고, 5분 캐시는 80,000 × ($5 + 19 × $0.20)/100만 = $0.704입니다. 시험에 쓴 7,882토큰 프리픽스를 Sonnet 5.5로 10번 부르는 작은 경우에도 $0.1576이 $0.0268로 83.0% 줄어듭니다. "90% 절감"은 호출 수가 충분하고 읽기 배수가 낮은 모델일 때의 숫자이고, 호출이 적거나 Haiku처럼 배수가 0.1배인 모델에서는 그보다 덜 줄어듭니다. 모델별 기본 단가와 청구액 계산은 Claude Opus 5.5 가격과 사용량 초기화권: 토큰 비용 계산부터 사용 시점까지와 Claude Fable 5.1 API 가격: 내 청구액은 얼마나 줄까에, 캐시를 포함한 작업 단가로 모델을 고르는 문제는 Claude Haiku 5.5 vs Sonnet 5.5 차이: 단가는 20배, 어떤 작업을 옮길까에 정리돼 있습니다.
5분 캐시와 1시간 캐시: 호출 간격 5분이 갈림길입니다
같은 프리픽스를 5분 안에 다시 부른다면 5분 캐시가, 5분보다 길고 1시간보다 짧은 간격으로 부른다면 1시간 캐시가 쌉니다. 5분 캐시는 읽을 때마다 공짜로 연장되므로 자주 부르는 동안에는 1시간 캐시의 2배 쓰기 단가를 낼 이유가 없습니다. 손익분기도 단순합니다. Opus 5.5·Sonnet 5.5 기준으로 5분 캐시는 두 번째 호출부터 이득이고(1.25 + 0.05 = 1.30배 < 캐시 없이 2배), 1시간 캐시는 세 번째 호출부터 이득입니다(두 번이면 2 + 0.05 = 2.05배로 2배보다 비싸고, 세 번이면 2.10배 < 3배). Fable 5.1과 Haiku 5.5도 손익분기 호출 수는 같습니다.
간격이 5분을 넘는데 5분 캐시를 쓰면 손해가 됩니다. 100,000토큰 프리픽스를 Sonnet 5.5로 10분마다 한 번씩, 1시간에 6번 부른다고 하면 캐시 없이 $1.20인데, 5분 캐시는 매번 만료되어 6번 다시 쓰므로 $1.50으로 25% 더 비싸고, 1시간 캐시는 한 번 쓰고 다섯 번 읽어 $0.45로 62.5% 줄어듭니다. 사용자가 몇 분씩 생각하다 답하는 채팅이나 5분 넘게 걸리는 보조 에이전트 작업이 이 경우에 해당합니다.
2026년 10월 30일 LaoZhang API를 거친 Sonnet 5.5 시험에서도 두 TTL은 이렇게 움직였습니다. 5분 캐시는 04:45:11(UTC)에 쓰고 6초 뒤 읽은 다음 6분 20초를 비워 두자 다시 7,882토큰 전체를 새로 썼고, 1시간 캐시는 7분을 비운 뒤에도 쓰기 없이 7,882토큰을 읽었습니다. 1시간 캐시의 상한 시점까지는 시험하지 않았습니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
한 요청에 두 TTL을 섞을 수도 있습니다. 이때는 1시간 캐시 블록이 5분 캐시 블록보다 앞에 와야 하므로, 거의 안 바뀌는 도구와 지침을 1시간으로, 그 뒤의 대화 부분을 5분으로 나누는 식으로 구성합니다. Anthropic 문서는 응답 속도 면에서 두 TTL에 차이가 없다고 설명합니다.
Claude 캐싱이 오히려 비싸지는 경우: 한 번뿐인 호출과 동시 요청
같은 프리픽스를 딱 한 번만 보내는 호출에는 캐시를 걸지 않는 편이 쌉니다. 읽을 일이 없는데 캐시 부분에 1.25배(5분) 또는 2배(1시간)를 내기 때문입니다. 문서 한 편씩 요약하는 일괄 작업처럼 매 요청의 앞부분이 다르다면, 공통 지침이 512토큰을 넘을 때 그 지침까지만 표시하고 문서 본문은 표시하지 마세요.
동시에 보내는 요청도 주의해야 합니다. 캐시 항목은 첫 요청의 응답이 시작된 뒤에야 쓸 수 있으므로, 캐시가 비어 있는 상태에서 같은 요청을 여러 개 한꺼번에 보내면 모두가 각자 쓰기를 합니다. 2026년 10월 30일 LaoZhang API를 거쳐 Sonnet 5.5에 같은 콜드 요청 3개를 병렬로 보냈더니 3개 모두 cache_creation_input_tokens: 7882였고 읽기는 하나도 없었습니다. 7,882토큰 기준으로 쓰기 3번은 $0.0591, 한 번 쓰고 두 번 읽었다면 $0.0213이니 약 2.8배 차이입니다. 요청을 한꺼번에 보내야 한다면 하나를 먼저 보내 응답이 시작되는 것을 확인한 뒤 나머지를 보내거나, 아래의 예열 요청을 먼저 보내세요.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
캐시 히트 확인: usage의 cache_read_input_tokens 읽는 법
캐시가 히트했는지는 응답 usage의 세 필드로 판별합니다. cache_read_input_tokens가 0보다 크면 그만큼 캐시에서 읽은 것(히트)이고, cache_creation_input_tokens가 0보다 크면 이번 요청이 캐시를 새로 쓴 것이며, 둘 다 0이면 캐싱이 전혀 일어나지 않은 것입니다. 스트리밍 응답에서는 message_start 이벤트에 같은 필드가 들어 있습니다. 아래 실측값은 2026년 10월 30일 LaoZhang API를 거쳐 Sonnet 5.5에 7,882토큰 system 블록을 표시해 보낸 첫 호출과 두 번째 호출입니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
| 필드 | 뜻 | 과금 | 첫 호출 → 두 번째 호출 |
|---|---|---|---|
cache_creation_input_tokens | 이번 요청에서 캐시에 새로 쓴 토큰 | 쓰기 단가(1.25배 또는 2배) | 7,882 → 0 |
cache_read_input_tokens | 캐시에서 읽은 토큰 | 읽기 단가 | 0 → 7,882 |
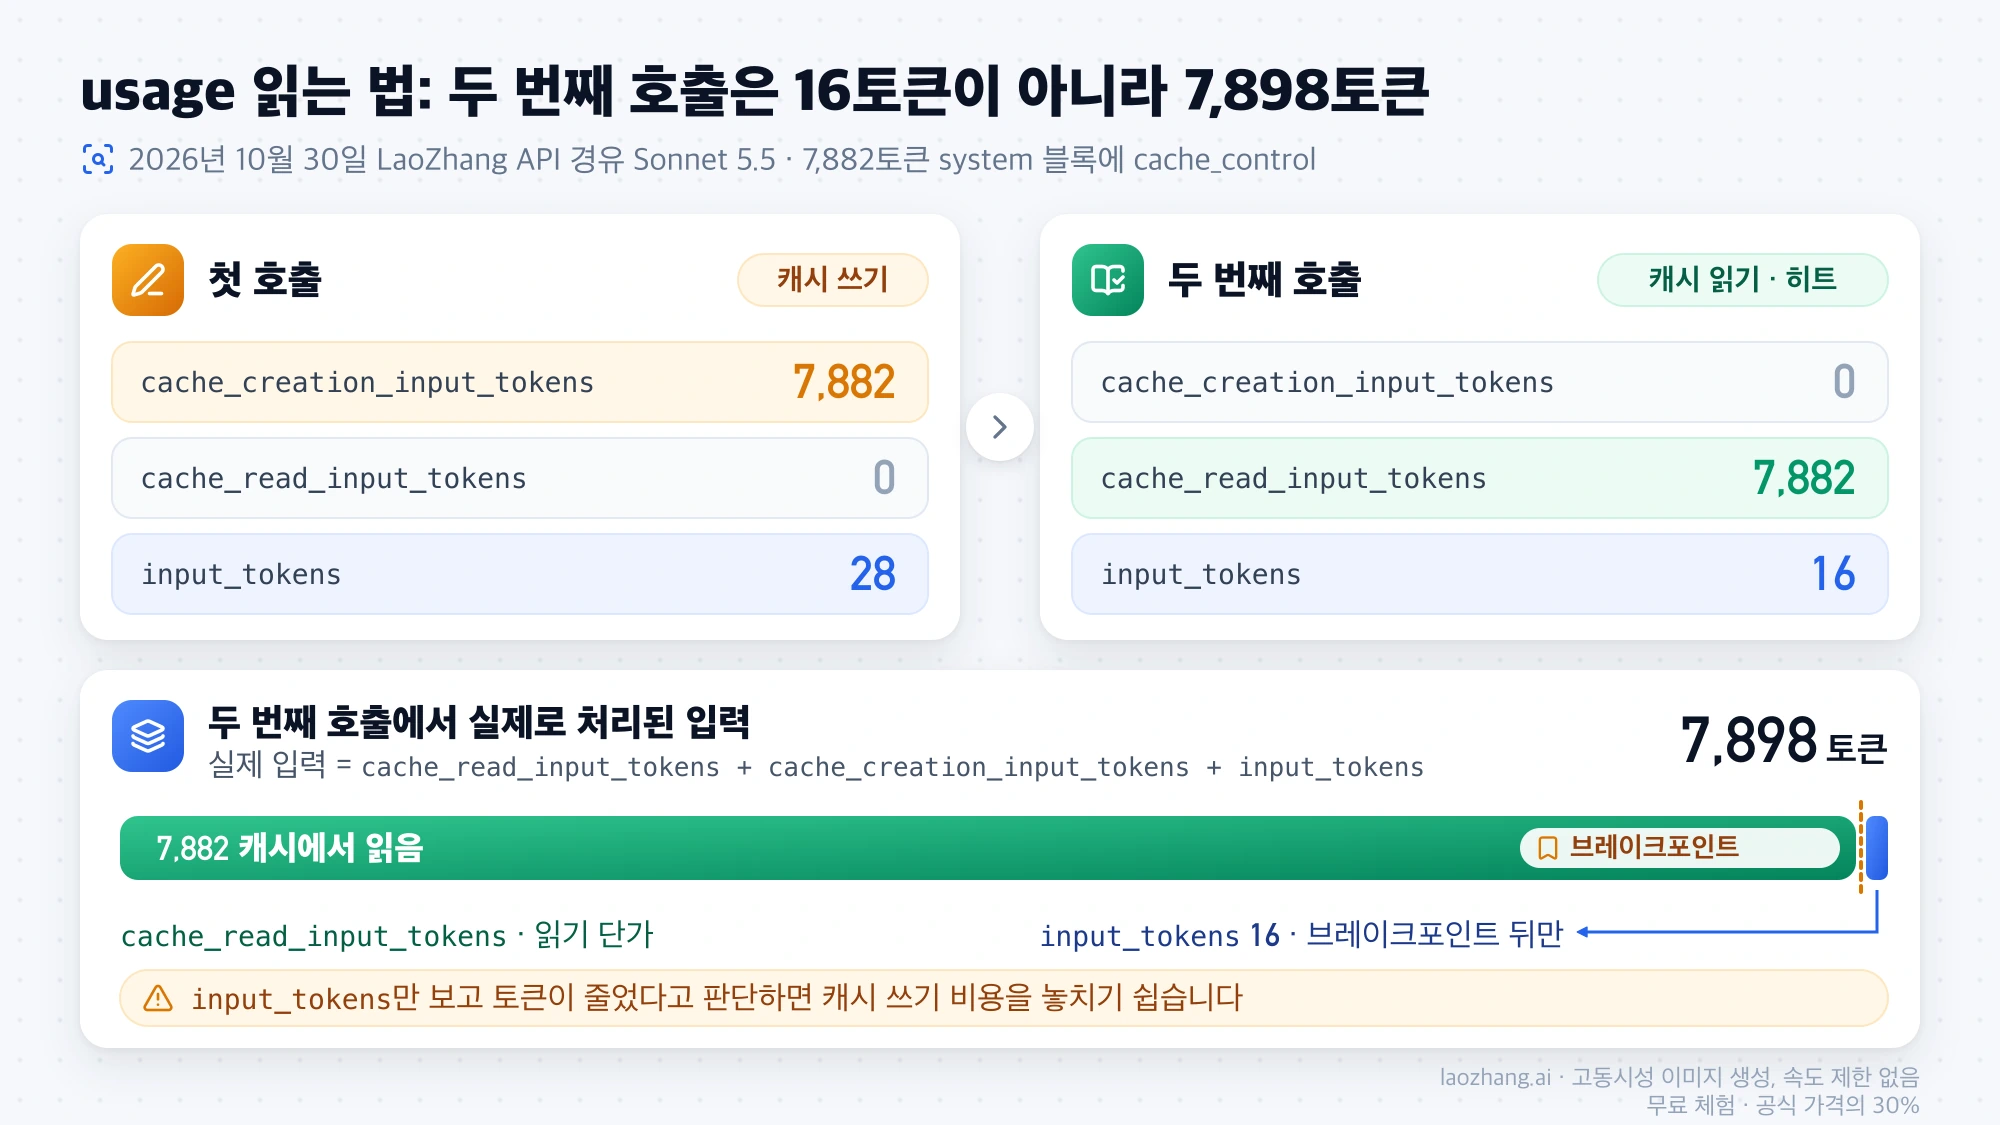
input_tokens | 마지막 브레이크포인트 뒤의 토큰 | 기본 입력 단가 | 28 → 16 |
cache_creation.ephemeral_5m_input_tokens, ephemeral_1h_input_tokens | 1시간 TTL을 쓸 때 쓰기를 TTL별로 나눈 값 | 합계가 cache_creation_input_tokens | LaoZhang 경유 1시간 캐시 응답에는 없었음 |
input_tokens는 전체 입력이 아니라 마지막 브레이크포인트 뒤의 토큰만 뜻합니다. 실제로 처리된 입력은 cache_read_input_tokens + cache_creation_input_tokens + input_tokens이므로, 위 두 번째 호출은 16토큰짜리 요청이 아니라 7,898토큰 요청이고 그중 7,882토큰을 읽기 단가로 낸 것입니다. 로그나 대시보드에서 input_tokens만 보고 "토큰이 줄었다"고 판단하면 캐시 쓰기 비용을 놓치기 쉽습니다.
Claude 캐시 히트가 안 될 때 하나씩 확인할 것
먼저 증상을 둘로 나눕니다. 두 캐시 필드가 계속 0이면 캐싱 자체가 일어나지 않은 것이고, 두 번째 호출에서도 cache_creation_input_tokens만 크다면 캐시는 쓰지만 앞부분이 매번 달라져 읽지 못하는 것입니다. 아래 항목을 위에서부터 확인하면 대부분의 원인이 걸립니다.
- 두 필드가 모두 0이면 프리픽스 길이부터 봅니다. Opus 5.5·Sonnet 5.5·Haiku 5.5·Fable 5.1·Opus 5는 512토큰, Sonnet 5와 Sonnet 4.6은 1,024토큰, Opus 4.7은 2,048토큰, Haiku 4.5는 4,096토큰보다 짧으면 HTTP 200으로 정상 응답하면서 캐싱만 건너뜁니다. 2026년 10월 30일 LaoZhang API를 거친 Sonnet 5.5에서 180토큰과 377토큰 프리픽스는 두 번 보내도 둘 다 0이었고, 567토큰과 1,094토큰은 쓰기 뒤 읽기로 바뀌었습니다.
- 매번 쓰기만 일어나면
cache_control이 붙은 블록에 타임스탬프, 요청 ID, 사용자 질문처럼 매번 바뀌는 값이 들어 있지 않은지 확인하고, 있다면 브레이크포인트를 그 앞의 변하지 않는 블록으로 옮깁니다. - 앞부분이 바이트 단위로 같은지 비교합니다. 도구 이름·설명·파라미터를 하나라도 고치면
tools,system,messages캐시가 모두 무효가 되고, Swift나 Go처럼 JSON 변환 때 키 순서를 섞는 언어는tool_use블록의 키 순서 때문에 캐시가 깨질 수 있습니다. - 호출 간격이 TTL을 넘지 않았는지 봅니다. 5분은 직전 요청이 시작된 시점부터 세므로 긴 스트리밍 응답 뒤에는 남은 시간이 짧습니다.
- 모델을 바꾸지 않았는지 확인합니다. 캐시는 모델마다 따로이므로 2026년 10월 30일 LaoZhang API를 거쳐 Sonnet 5.5가 이미 캐시한 같은 프리픽스를 Opus 5.5로 보내자 7,882토큰을 다시 썼고, 그다음 Opus 호출부터 읽었습니다.
- 요청 옵션이 그대로인지 봅니다. 웹 검색·인용(citations)·fast 모드를 켜고 끄면
system과messages캐시가,tool_choice나 이미지 유무를 바꾸면messages캐시가 무효가 됩니다. thinking 설정과output_config.effort를 바꾸면messages캐시는 항상 무효이고tools·system캐시는 모델에 따라 다릅니다. 같은 날 같은 경로로 Sonnet 5.5의 effort를 low에서 medium으로 바꿨을 때는 system 캐시가 그대로 읽혔습니다. - 대화 도중 지침을 바꾸느라 최상위
system을 고치고 있다면, Opus 5.5·Sonnet 5.5·Haiku 5.5·Fable 5.1에서는messages에{"role": "system"}메시지를 덧붙이는 방식으로 바꾸면 앞부분 캐시가 유지됩니다. - 첫 요청과 동시에 같은 요청을 여러 개 보내고 있지 않은지 봅니다. 앞 절에서 본 것처럼 모두 쓰기가 됩니다.
- 요청을 보내는 API 키가 같은 워크스페이스에 속하는지 확인합니다. Claude API에서 캐시는 워크스페이스별로 분리되고 조직 사이에는 절대 공유되지 않습니다.
- 대화가 길어졌는데 브레이크포인트가 하나뿐이라면, 마지막으로 쓴 위치가 20블록 되짚기 범위 밖으로 밀려나지 않았는지 봅니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
Claude API에 직접 요청한다면 원인 찾기를 API에 맡길 수도 있습니다. 첫 요청에 "diagnostics": {"previous_message_id": null}을 넣고 다음 요청부터 직전 응답의 id를 넣으면, 응답의 diagnostics가 모델·system·tools·messages 중 어디서 앞부분이 갈라졌는지 알려 주고, 갈라진 곳이 없으면 null이 됩니다(Anthropic 캐시 진단 문서). 이 기능은 Claude API 전용이어서, 2026년 10월 30일 LaoZhang API를 거쳐 같은 요청을 보냈을 때는 HTTP 200이었지만 diagnostics 필드가 돌아오지 않았습니다.
게이트웨이와 OpenAI 호환 엔드포인트에서의 Claude 캐싱
게이트웨이를 거쳐도 캐싱은 동작할 수 있지만, 동작 방식이 Anthropic 문서와 같다고 가정하면 안 됩니다. LaoZhang API 문서는 Claude 모델이 5분·1시간 프롬프트 캐싱을 지원한다고 적고 있고, Anthropic SDK에서 base_url만 바꾸면 위의 cache_control 요청을 그대로 보낼 수 있습니다(LaoZhang API의 Claude 프로토콜 문서). 이곳의 Claude 입력·출력·캐시 읽기 단가는 2026년 10월 30일 기준 Anthropic 정가와 같습니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["LAOZHANG_API_KEY"],
    base_url="https://api.laozhang.ai",  # /v1을 붙이지 않음
)
2026년 10월 30일 이 경로로 계정 하나, 7,882토큰 프리픽스 하나를 써서 51번 호출하며 확인한 차이는 이렇습니다. 요청 어디에도 cache_control이 없었는데 system 프롬프트가 첫 호출에 쓰이고 두 번째 호출에 읽혔고, 타임스탬프가 든 사용자 블록에 브레이크포인트를 둔 요청도 system 부분 7,882토큰은 읽고 뒤쪽 31~48토큰만 새로 썼습니다. 두 동작 모두 Anthropic 문서에는 없으며, 게이트웨이나 그 앞단 경로가 system 프롬프트에 스스로 캐시 표시를 하는 것으로 추정됩니다. Anthropic API 직결로는 같은 시험을 하지 않았습니다.
이 차이는 비용에도 드러납니다. cache_control 없이 보낸 첫 요청이 5분 캐시 쓰기 단가로 1.9788센트가 과금됐는데, 캐시 없이 계산하면 1.5846센트였으니 25% 더 낸 셈이고, 같은 요청을 다시 보내자 0.0872센트로 내려갔습니다. 반복 호출에는 이득이지만 한 번뿐인 호출은 표시를 하지 않아도 할증이 붙을 수 있다는 뜻입니다. 51번 호출의 총 과금액은 $0.471이었고, 기록된 usage를 정가로 다시 계산한 $0.469와 맞았습니다. 그 밖에 1시간 캐시 응답에 cache_creation 세부 객체가 없었고, 캐시 진단도 돌아오지 않았습니다.
OpenAI 호환 경로(POST /v1/chat/completions)로 Claude 모델을 부르면 필드 이름이 달라집니다. 같은 날 캐시 관련 필드를 하나도 보내지 않고 7,882토큰 system 메시지를 두 번 보냈더니 첫 응답은 prompt_tokens: 7893, prompt_tokens_details.cached_creation_tokens: 7882, 두 번째 응답은 prompt_tokens: 7893, prompt_tokens_details.cached_tokens: 7882였습니다. 이 형식에서는 prompt_tokens가 캐시된 토큰을 포함한 전체 입력이므로, 비용은 cached_tokens를 빼고 계산해야 합니다. 이 관찰은 모두 하루, 한 계정의 결과이고 응답 속도에 대한 결론은 내리지 않았습니다.
Claude 캐시 예열: max_tokens 0 요청으로 미리 써 두기
사용자의 첫 질문이 오기 전에 캐시를 미리 써 둘 수 있습니다. Anthropic 문서에 따르면 max_tokens: 0으로 요청을 보내면 API가 브레이크포인트까지를 캐시에 쓰고, 빈 content와 stop_reason: "max_tokens"를 돌려주며 출력 토큰은 과금하지 않습니다. 브레이크포인트는 자리채움용 메시지가 아니라 실제 요청과 공유할 블록에 두고, thinking·effort 설정도 실제 요청과 같게 맞춰야 합니다. stream: true, thinking.type: "enabled", 구조화 출력, tool_choice의 tool·any 지정, Message Batches 안에서는 이 예열 요청이 거절됩니다.
게이트웨이에서는 결과가 달랐습니다. 2026년 10월 30일 LaoZhang API로 max_tokens: 0을 보내자 빈 응답 대신 46토큰짜리 일반 답변(stop_reason: end_turn)과 함께 7,882토큰 쓰기가 일어났습니다. 0을 지정하지 않은 값처럼 처리한 것으로 보입니다. 예전 방식인 max_tokens: 1은 출력 1토큰과 쓰기 7,882토큰으로 예열 역할을 했고 다음 요청이 그대로 읽었으므로, 이 경로에서는 max_tokens: 1을 쓰는 편이 비용을 예측하기 쉽습니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
Claude 프롬프트 캐싱 자주 묻는 질문
Claude Code도 프롬프트 캐싱을 자동으로 하나요? 캐시 시간은 얼마인가요?
Claude Code는 별도 설정 없이 캐싱을 자동으로 관리하고, 2026년 10월 30일 기준 Claude 구독 사용량 안에서는 메인 대화가 1시간, API 키·사용량 크레딧·클라우드 제공자로 쓰면 5분 캐시를 씁니다(Claude Code 프롬프트 캐싱 문서). 한 턴이 갑자기 비싸지는 원인과 TTL 설정은 Claude Code 캐시 미스 토큰 비용: 한 turn 이 갑자기 비싸지는 이유에서 다룹니다.
Sonnet 5.5 캐시 읽기 인하로 청구액이 얼마나 줄어드나요?
Sonnet 5.5의 캐시 읽기는 2026년 10월 7일부터 100만 토큰당 $0.10(0.05배)이고, 실제 청구액이 얼마나 줄어드는지는 캐시 읽기 비중에 따라 달라 Claude Sonnet 5.5 캐시 가격: 캐시 읽기 $0.10로 반값, 청구액 계산법에서 계산법을 정리했습니다.
캐시 히트도 속도 제한(rate limit)에 잡히나요?
Anthropic 문서는 Claude API에서 캐시 히트 토큰이 속도 제한에서 차감되지 않는다고 설명합니다. 그래도 429가 난다면 어느 제한에 걸렸는지부터 Claude API Rate Limit Reached: 재시도 전에 제한 소유자를 확인하세요에서 확인하세요.
프롬프트 캐싱을 쓰면 Claude의 답변이 달라지나요?
달라지지 않습니다. Anthropic 문서에 따르면 캐싱은 앞부분을 다시 처리하는 비용과 시간만 줄이고 출력 내용에는 영향을 주지 않습니다.
thinking 블록도 캐시되나요?
thinking 블록은 직접 cache_control을 붙일 수 없고, 이전 assistant 턴 안에서 다른 내용과 함께 캐시됩니다. 캐시에서 읽힌 thinking 블록은 입력 토큰으로 계산되며, 인용(citations) 하위 블록과 빈 텍스트 블록도 직접 캐시할 수 없어 인용은 원본 문서 쪽을 캐시해야 합니다.
참고 자료3
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 30일.
참고 자료3
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 30일.