Claude Sonnet 5.5 가격과 성능: Sonnet 5 대비 effort별 비용, 전환 방법
Claude Sonnet 5.5는 Sonnet 5와 단가가 같고 AA 기준 작업당 비용은 effort max에서만 51% 높습니다. thinking 끄기·강제 도구 호출은 400 오류를 냅니다.
목차
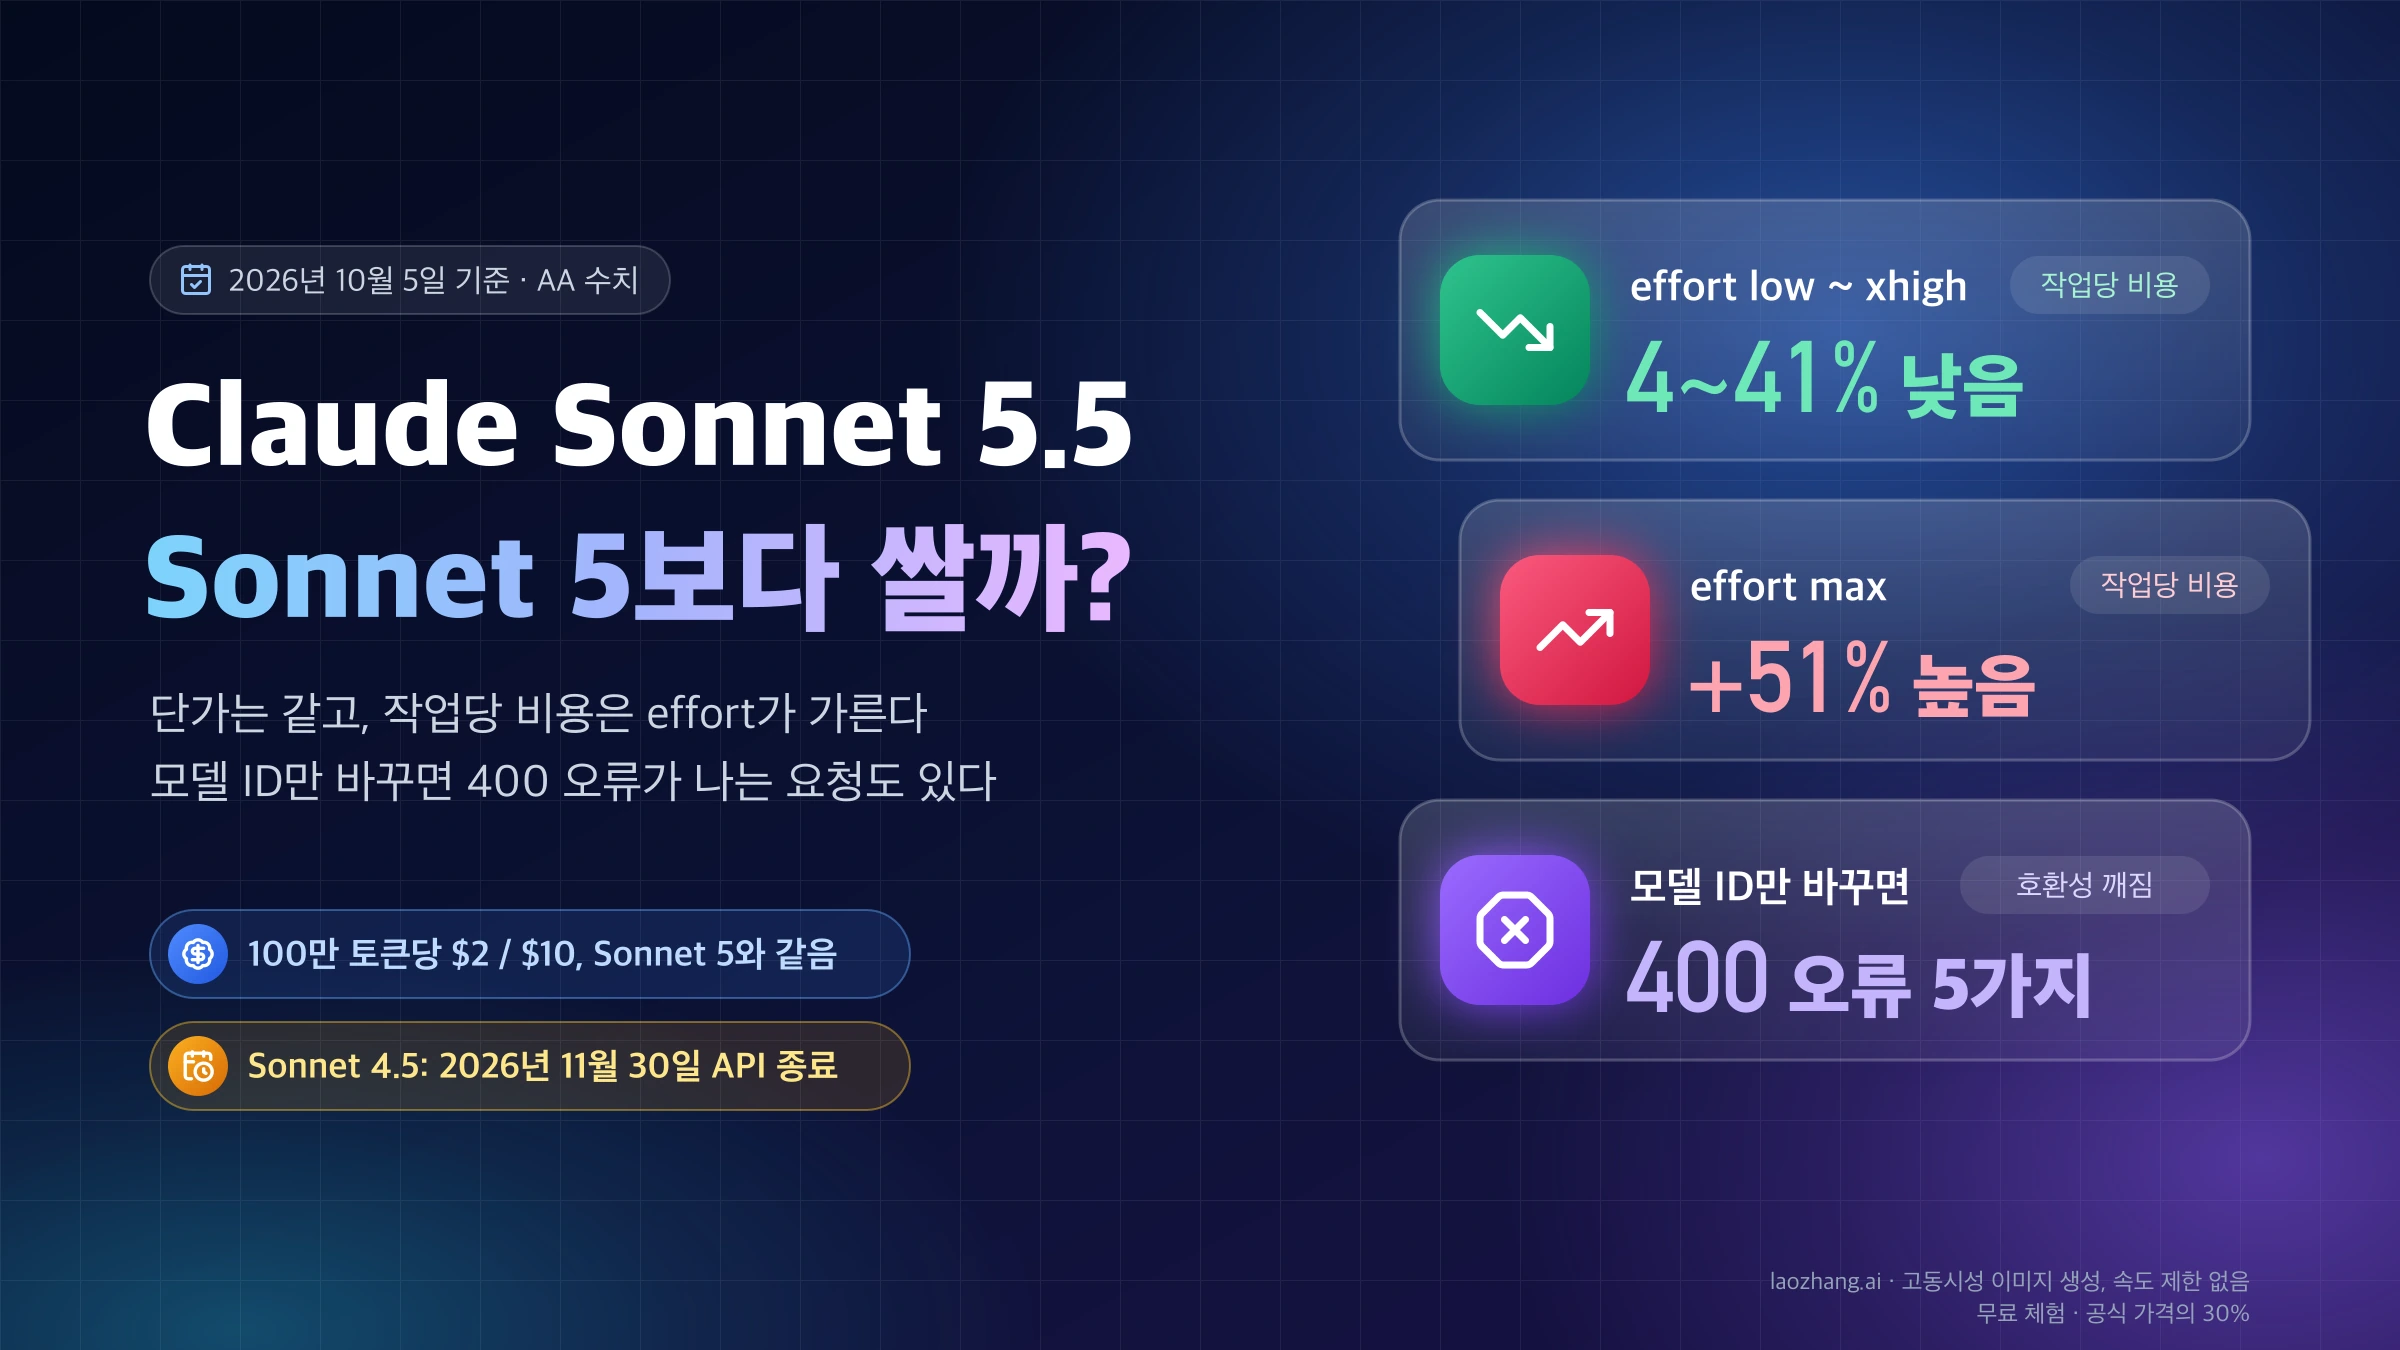
Claude Sonnet 5.5(소넷 5.5)는 Anthropic이 2026년 9월 28일 출시한 Sonnet급 모델이고, API ID는 날짜 접미사 없는 claude-sonnet-5-5입니다. 100만 토큰당 입력 $2, 출력 $10으로 Sonnet 5와 단가가 같고, 토크나이저도 같아서 같은 텍스트는 같은 토큰 수로 계산됩니다. 그래서 "Sonnet 5보다 싸졌나"는 단가의 문제가 아니라, 작업 하나를 끝내는 데 토큰을 얼마나 쓰느냐의 문제입니다.
답은 effort(추론 강도) 단계에 따라 갈립니다. Artificial Analysis(AA)가 2026년 10월 5일 기준 공개한 단계별 수치로 계산하면, 같은 effort끼리 비교할 때 Sonnet 5.5는 low부터 xhigh까지 작업당 비용이 4~41% 낮고 점수는 12~18점 높습니다. max에서만 비용이 51% 높습니다. Anthropic의 "작업당 최대 30% 저렴"과 AA의 "약 50% 비쌈"은 서로 다른 설정을 잰 숫자라서 둘 다 맞습니다.
손이 가는 쪽은 코드입니다. 모델 ID만 바꾸면 thinking: {"type": "disabled"}와 tool_choice의 any·tool이 400 오류를 냅니다. Sonnet 5는 레거시 상태로 계속 쓸 수 있고 종료일은 2027년 6월 30일 이전이 아니므로 서두를 이유는 없습니다. 기한이 정해진 쪽은 Claude API에서 2026년 11월 30일 종료되는 Sonnet 4.5 사용자입니다.
Sonnet 5.5 사양: 단가는 Sonnet 5와 같고 지식은 2026년 6월까지
Sonnet 5와 Sonnet 5.5의 차이는 가격표가 아니라 지식 컷오프, thinking을 끄는 방식, 몇 가지 API 동작에 있습니다. 2026년 10월 5일 기준 Anthropic의 Claude Sonnet 5.5 모델 개요와 Anthropic API 요금 문서를 정리하면 다음과 같습니다.
| 항목 | Claude Sonnet 5 | Claude Sonnet 5.5 |
|---|---|---|
| Claude API ID | claude-sonnet-5 | claude-sonnet-5-5 |
| Amazon Bedrock ID | anthropic.claude-sonnet-5 | anthropic.claude-sonnet-5-5 |
| 출시일 | 2026-06-30 | 2026-09-28 |
| 상태 | 레거시(계속 사용 가능) | 활성 |
| 종료 시점 | 2027-06-30 이후 | 2027-09-28 이후 |
| 입력 / 출력 (100만 토큰당) | $2 / $10 | 같음 |
| 캐시 읽기 (100만 토큰당) | $0.20 | 같음 |
| 배치 처리 | 50% 할인 | 같음 |
| 컨텍스트 / 최대 출력 | 1M / 128K | 같음 |
| 지식 컷오프 | 2026년 1월 | 2026년 6월 |
| thinking 기본값 | adaptive, disabled로 끔 | adaptive, between_tools로 끔 |
| Claude API 기본 effort | high | high |
| 최소 캐시 가능 프롬프트 | 1,024토큰 | 512토큰 |
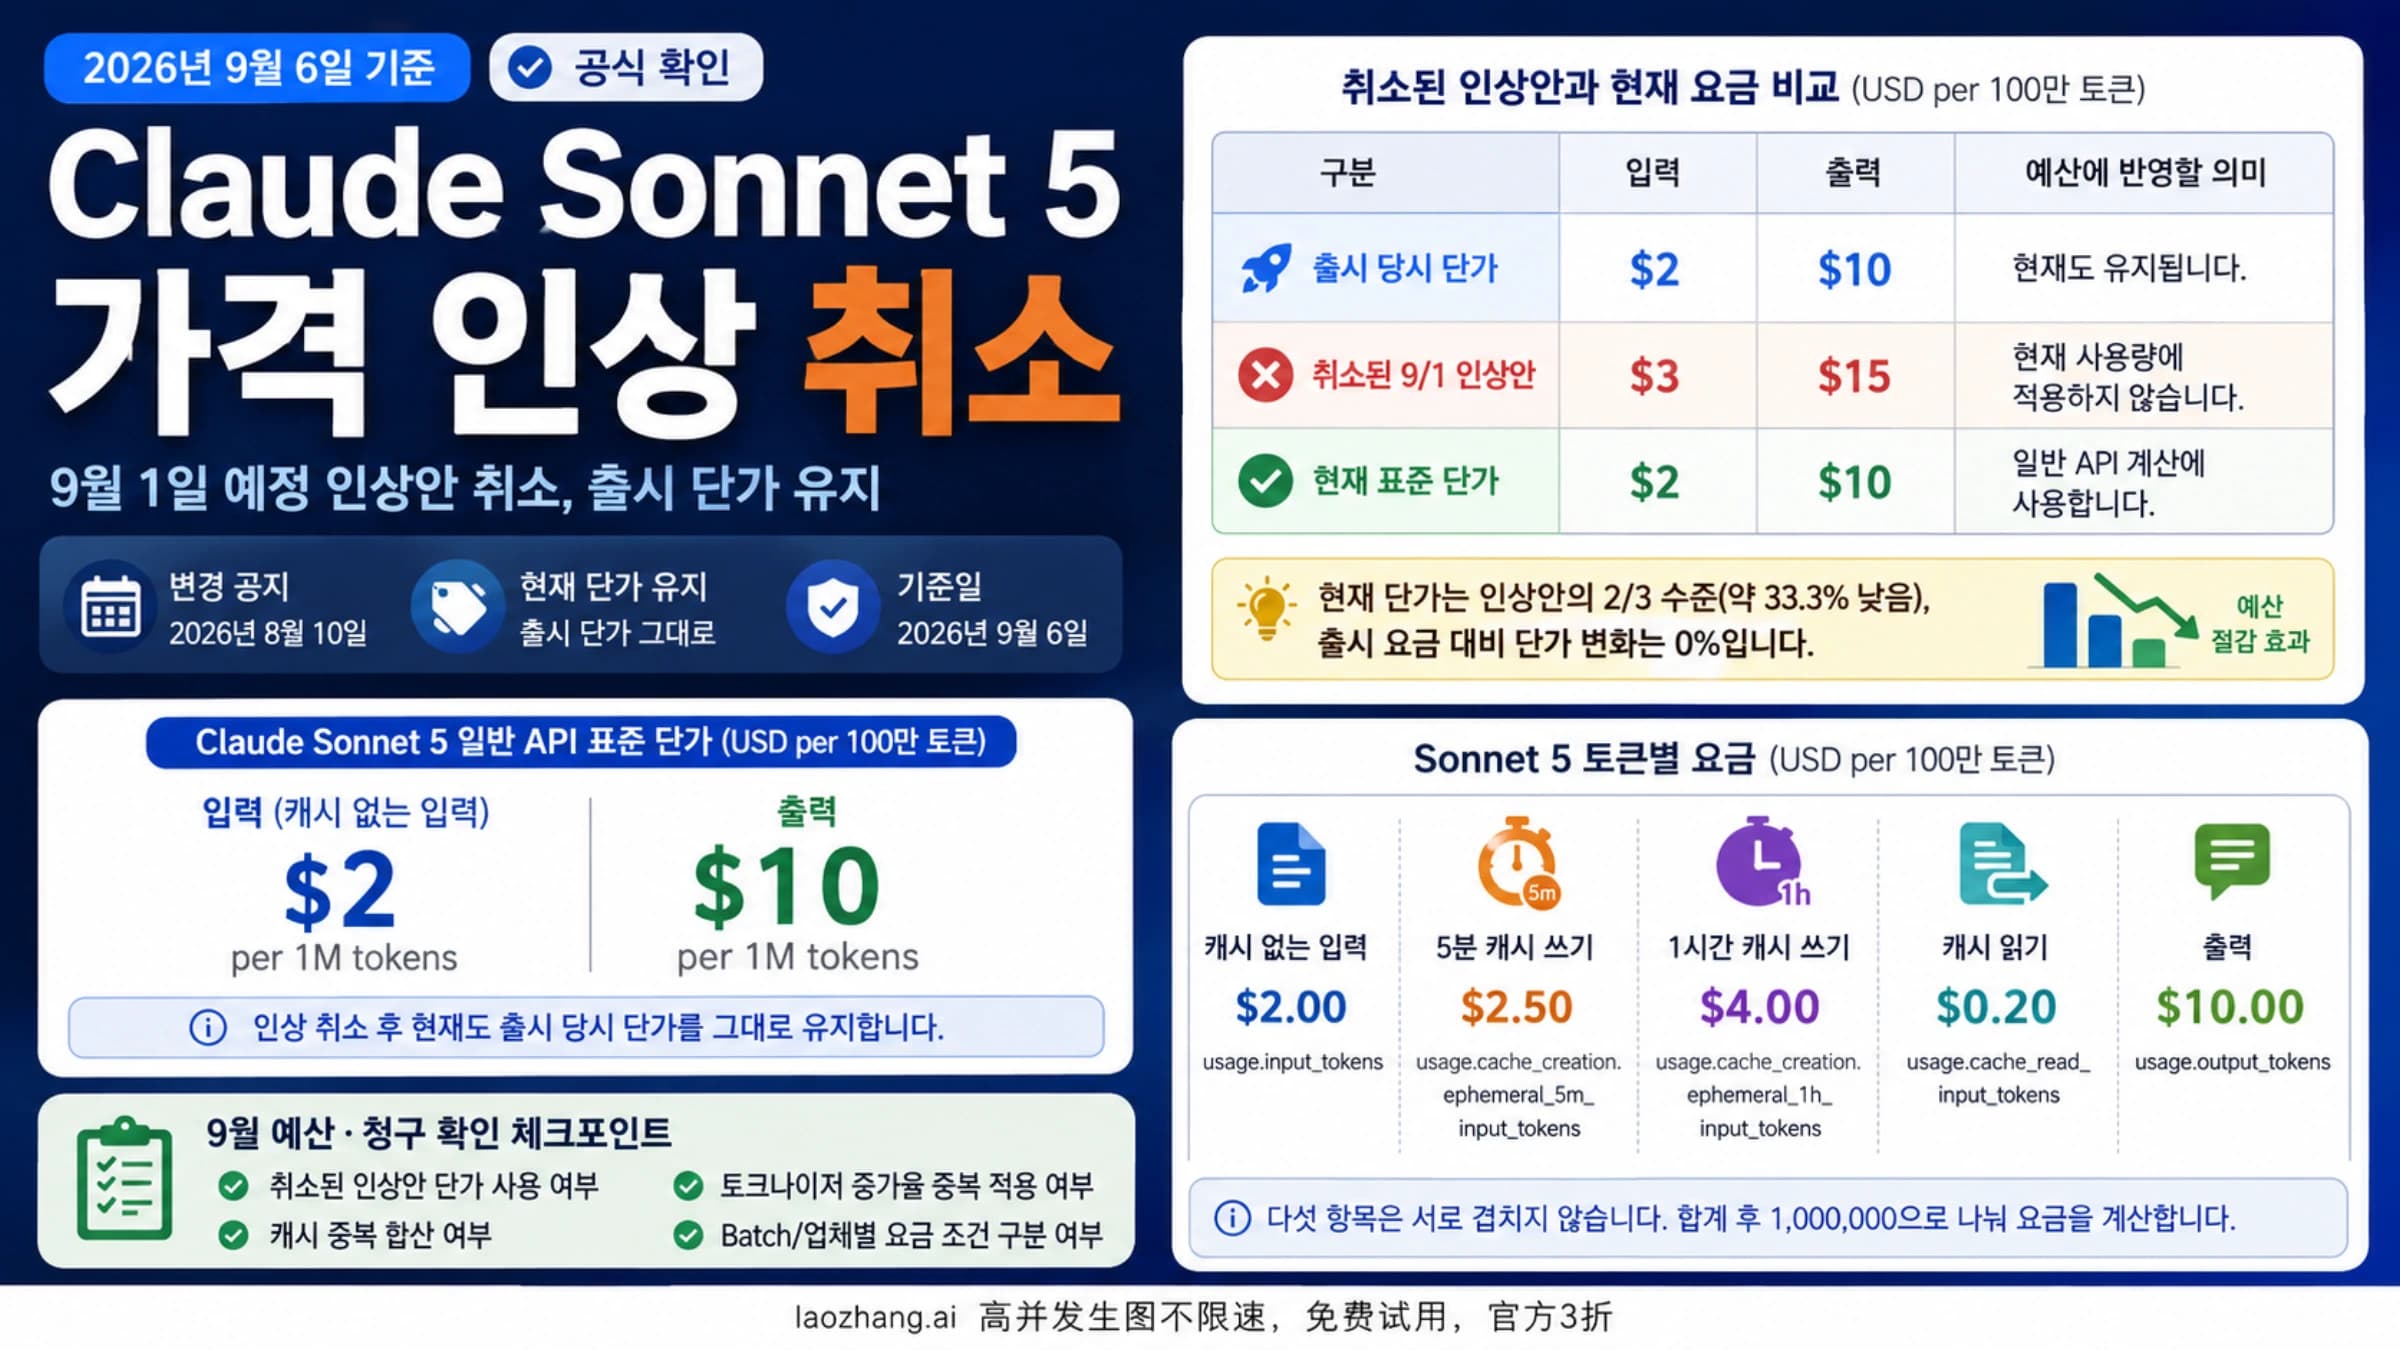
캐시 쓰기 요금(5분 $2.50, 1시간 $4)도 두 모델이 같습니다. Claude API, Claude Platform on AWS, Google Cloud, Microsoft Foundry에서는 claude-sonnet-5-5, Bedrock에서는 anthropic.claude-sonnet-5-5로 부르며, 클라우드 공급자는 자체 종료 일정을 따로 둡니다. 한국은 Anthropic의 지원 국가 목록에 들어 있습니다(2026년 9월 29일 기준).
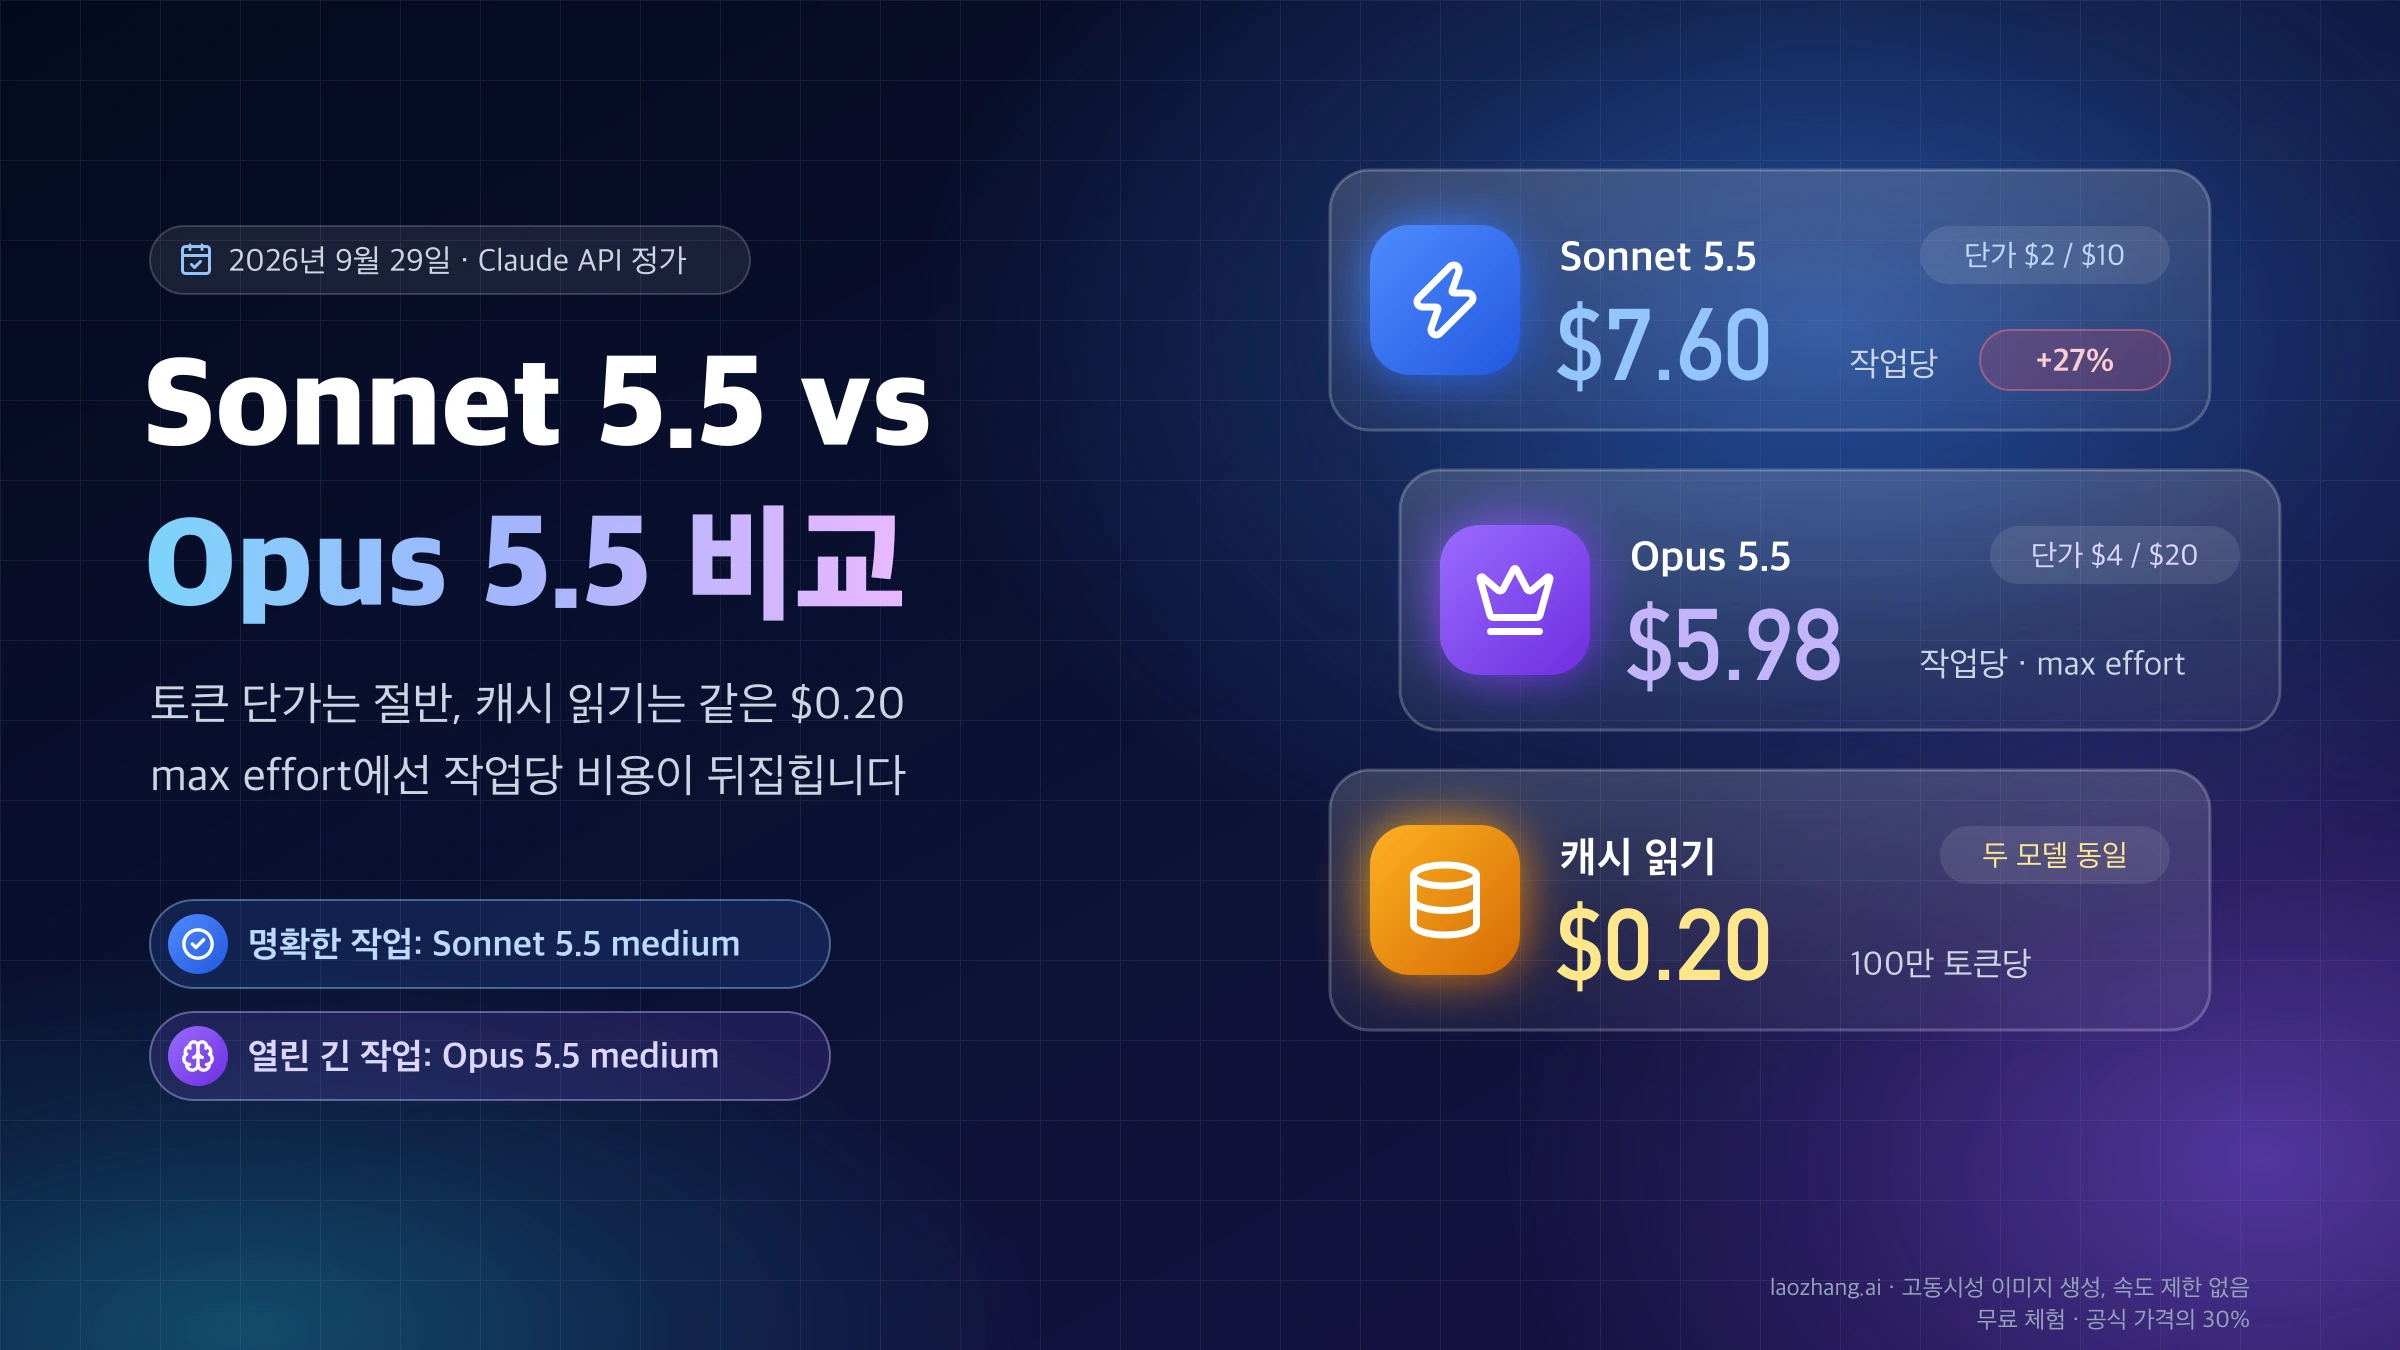
이름이 비슷해도 Sonnet 5.5는 Opus급이 아닙니다. Opus 5.5는 100만 토큰당 $4/$20으로 단가가 두 배이고, Anthropic도 오래 판단을 이어 가야 하는 복잡한 작업에서는 Opus 5.5가 여전히 확실히 강하다고 밝혔습니다. AA 지수에서 Sonnet 5.5 max는 56점으로 Opus 5.5 max보다 2점 낮지만, 사실 지식 정확도(AA-Omniscience)는 54% 대 66%로 차이가 더 큽니다.
Sonnet 5.5는 Sonnet 5보다 싼가: max만 51% 비싸고 나머지는 저렴
같은 effort 단계끼리 놓으면 low, medium, high, xhigh에서는 Sonnet 5.5가 더 싸고 점수도 높습니다. max에서만 비용이 51% 올라갑니다. 아래 표는 Artificial Analysis의 Claude Sonnet 5.5 모델 페이지에 실린 단계별 데이터입니다.
| effort | Sonnet 5 점수 | Sonnet 5 작업당 비용 | Sonnet 5.5 점수 | Sonnet 5.5 작업당 비용 | 비용 차이 | 작업당 시간 (5 → 5.5) |
|---|---|---|---|---|---|---|
low | 24 | $0.51 | 36 | $0.42 | −18% | 138초 → 95초 |
medium | 28 | $1.00 | 41 | $0.59 | −41% | 245초 → 138초 |
high | 32 | $1.79 | 47 | $1.12 | −37% | 375초 → 238초 |
xhigh | 34 | $2.87 | 52 | $2.75 | −4% | 525초 → 461초 |
max | 38 | $5.09 | 56 | $7.67 | +51% | 852초 → 968초 |
점수는 AA Intelligence Index v4.3.2(평가 10종)이며 정수로 반올림했습니다. 작업당 비용은 AA가 지수 과제 하나를 푸는 데 쓴 금액이고, 2026년 10월 5일 기준 수치입니다. 비용 차이는 AA가 공개한 비용으로 계산한 값으로, 공식은 (Sonnet 5.5 비용 ÷ Sonnet 5 비용) − 1입니다. 예를 들어 max는 7.67 ÷ 5.09 − 1 ≈ 0.51, high는 1.12 ÷ 1.79 − 1 ≈ −0.37입니다.
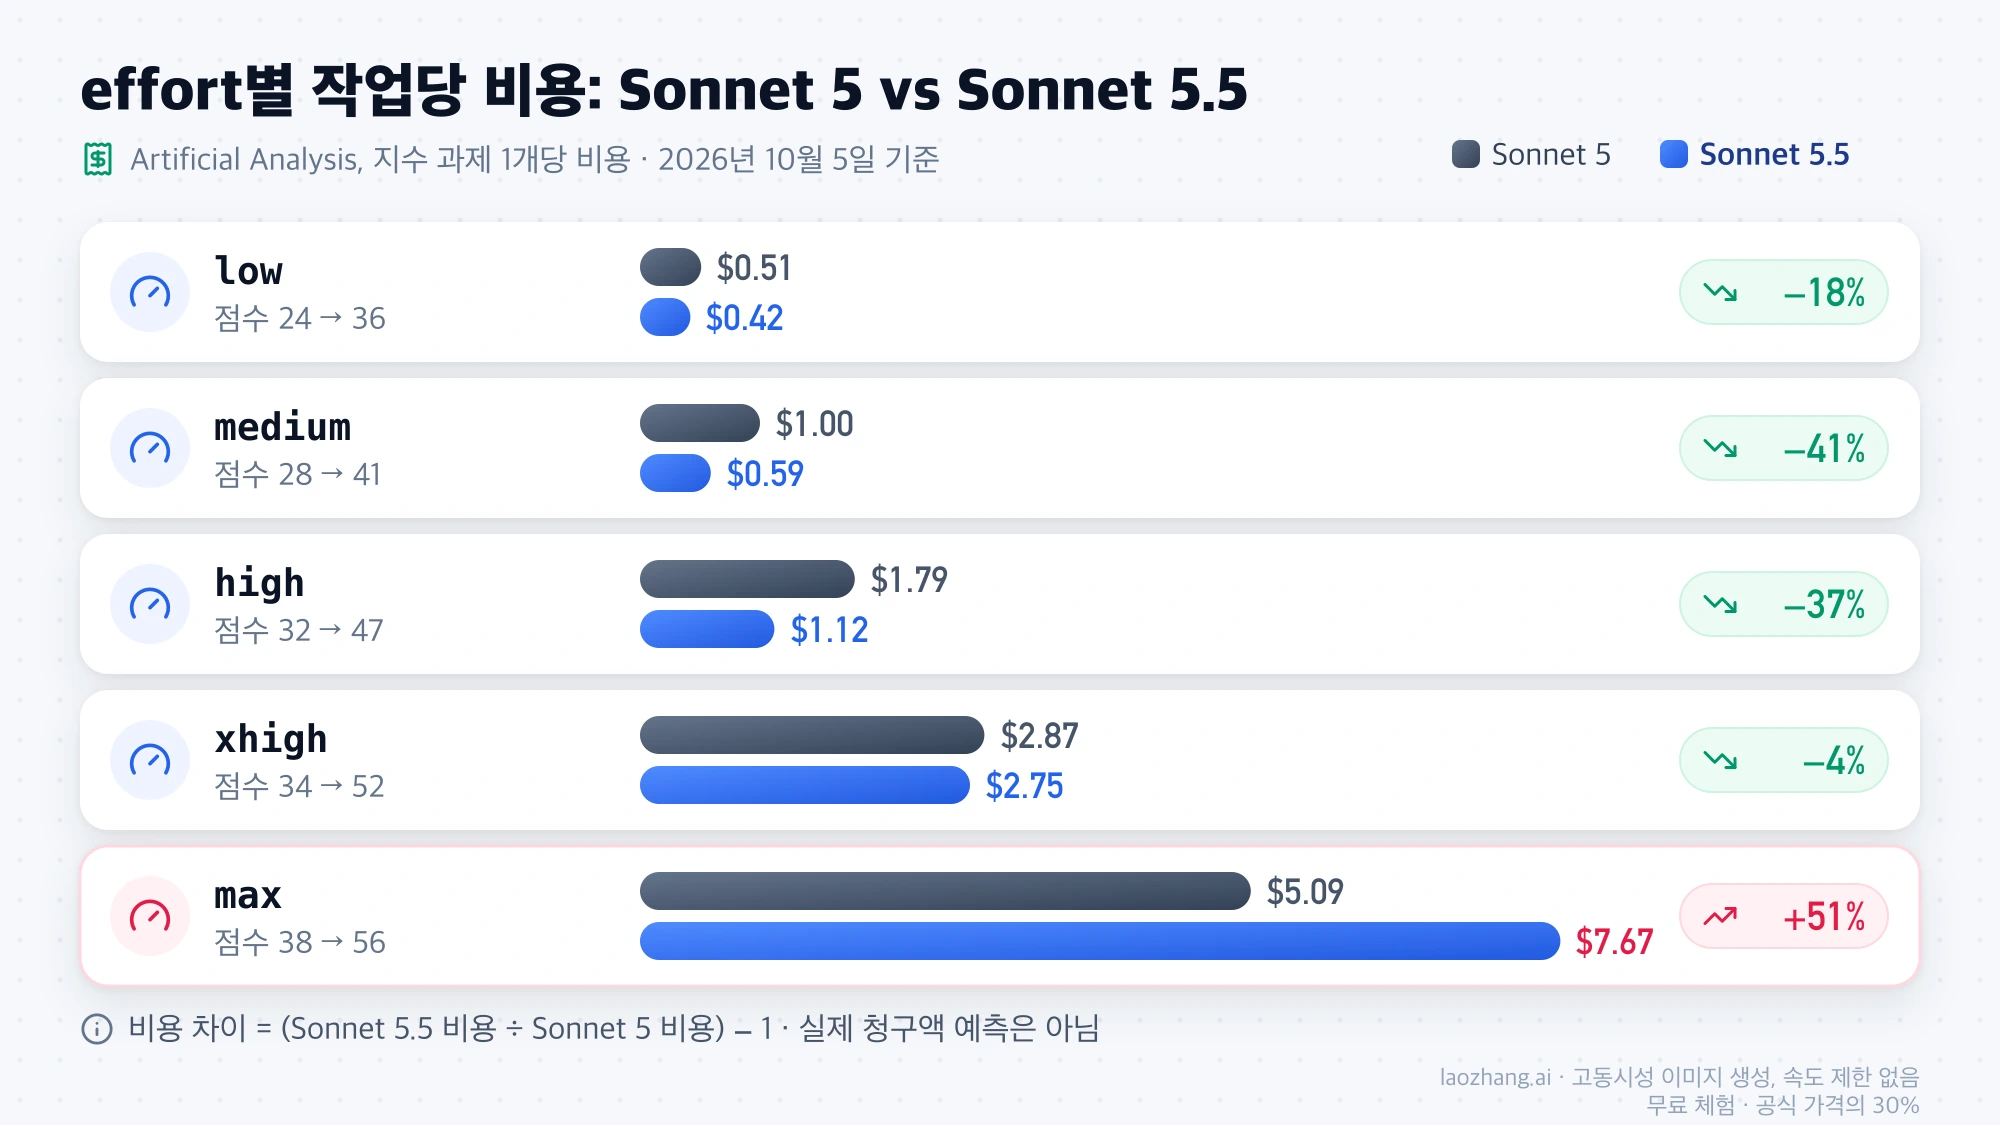
max에서 비싸지는 이유는 토큰입니다. 단가가 같으니 작업당 비용은 쓰는 토큰 양을 따라가는데, AA 측정에서 Sonnet 5.5 max는 과제 하나에 출력 토큰을 약 19.7만 개 썼습니다. Sonnet 5 max의 약 11.8만 개보다 약 68% 많은 양입니다(197.4K ÷ 117.8K ≈ 1.68). AA는 출시 분석에서 이를 자신들이 측정한 가장 많은 출력 토큰 사용량이라고 적었습니다.
이렇게 보면 두 회사의 말이 함께 성립합니다. Anthropic의 Claude Sonnet 5.5 발표는 "자체 테스트에서 작업당 최대 30% 저렴"하다고 했는데, '최대'가 붙은 값이고 평균이 아닙니다. Artificial Analysis의 Sonnet 5.5 출시 분석 기사가 "Sonnet 5보다 작업당 비용이 약 50% 높다"고 한 것은 두 모델을 모두 max로 돌린 결과입니다. 같은 기사에서 AA는 다른 모델과 견준 비용 대비 성능에서 Sonnet 5.5는 high 설정이 가장 경쟁력 있다고 평가했습니다.
단계를 엇갈려 비교하면 차이가 더 벌어집니다. Sonnet 5.5 low(36점, $0.42)는 Sonnet 5 xhigh(34점, $2.87)보다 점수가 높고 비용은 약 7분의 1입니다(2.87 ÷ 0.42 ≈ 6.8). Sonnet 5.5 medium(41점, $0.59)은 Sonnet 5 max(38점, $5.09)를 넘고 비용은 약 9분의 1입니다(5.09 ÷ 0.59 ≈ 8.6). Anthropic이 "여러 벤치마크에서 Low나 Medium의 Sonnet 5.5가 Sonnet 5 최고 점수를 약 10분의 1 비용으로 넘는다"고 한 것과 같은 방향입니다.
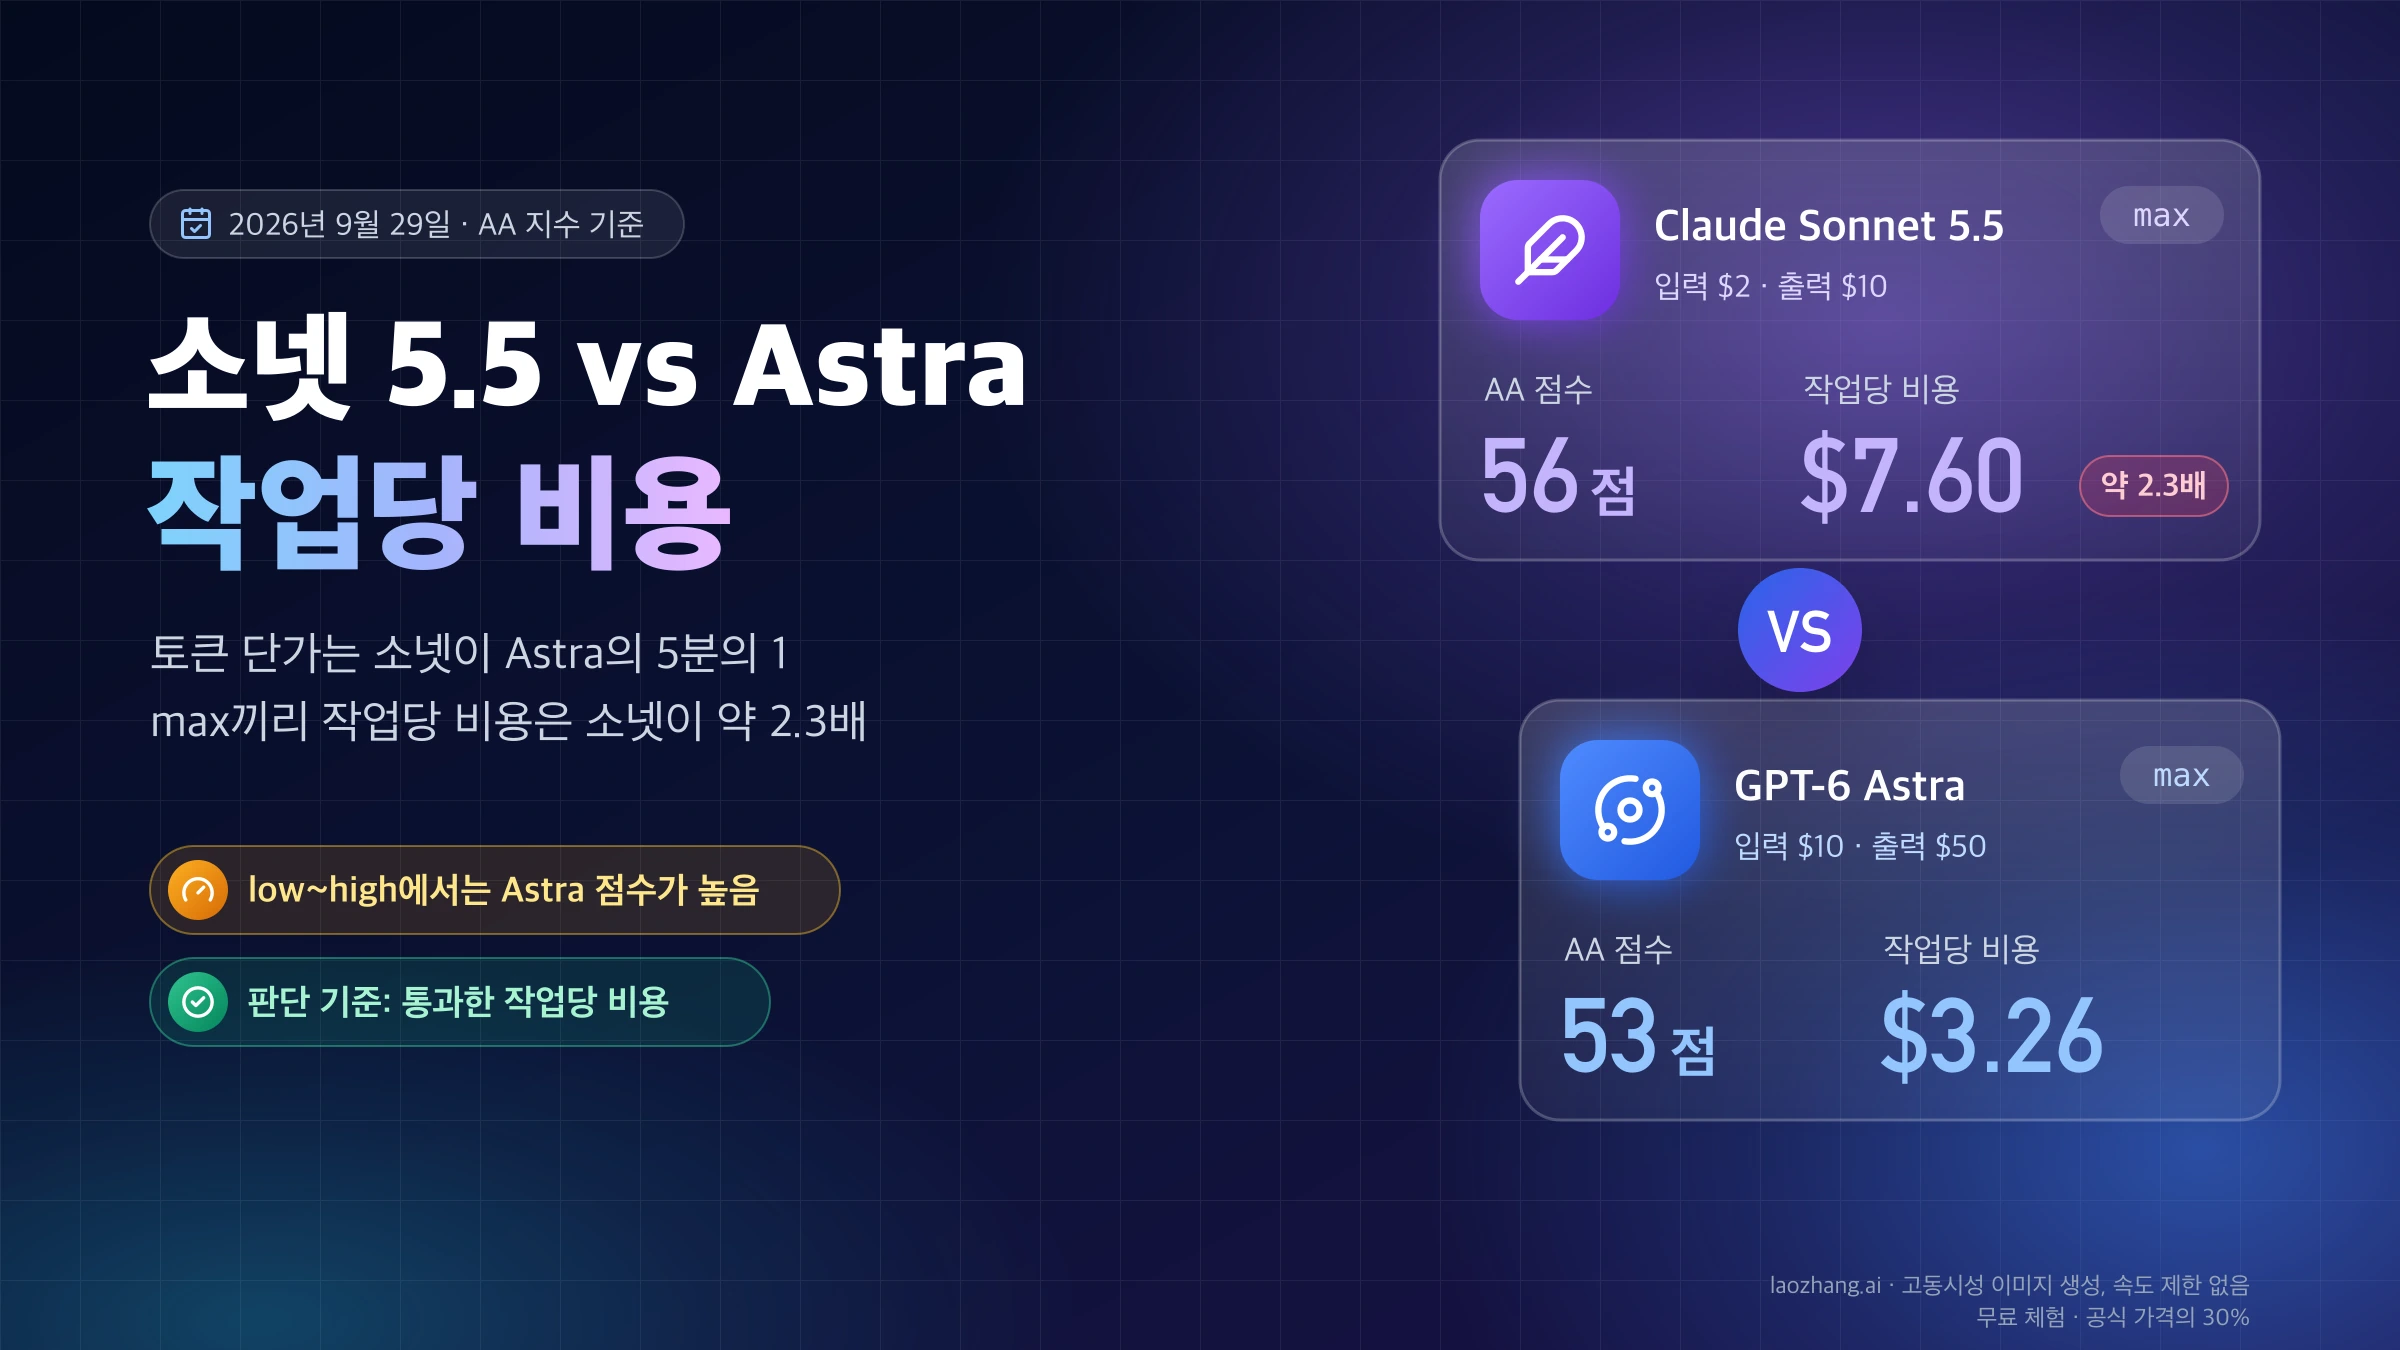
이 수치는 AA가 고른 평가 10종과 AA의 대화 턴·캐시 조건에서 나온 것이라 실제 청구액을 예측하지는 않습니다. Sonnet 5.5는 Anthropic 기본 서버 측 폴백을 켠 채 측정됐고, AA에 따르면 과제의 약 0.1%가 Sonnet 5로 넘어갔습니다. AA는 출시 이후 일부 평가를 다시 돌렸기 때문에 출시일 기사의 max 수치와 위 표는 조금 다릅니다. Anthropic이 공개한 단계별 비용 차트는 이미지뿐이라, 표로 비교할 수 있는 공식 수치는 없습니다. 다른 회사 모델과 단계별로 견준 비용은 소넷 5.5 vs GPT-6 Astra: 추론 강도별 성능과 작업당 비용에서 다루며, 그 비교의 Sonnet 5.5 수치는 2026년 9월 29일 기준이라 위 표와 조금 다를 수 있습니다.
Sonnet 5.5 성능은 얼마나 올랐나: Anthropic 발표와 제3자 측정
Anthropic 발표 기준으로 코딩·에이전트 벤치마크에서 Sonnet 5보다 크게 올랐고, AA와 CodeRabbit의 제3자 측정도 개선 방향은 같습니다. 아래는 Anthropic이 직접 돌린 결과입니다(대부분 max effort).
| 벤치마크 (Anthropic 발표) | Sonnet 5 | Sonnet 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | 10.3% | 70.6% |
| CursorBench 4.0 | 34.1% | 55.5% |
| FrontierCode 1.1 Main | 42.4% | 52.1% (xhigh), 46.2% (max) |
| OSWorld 2.1 (부분) | 57.0% | 80.1% |
| Humanity's Last Exam (도구 사용) | 54.9% | 64.5% |
| GDPval-AA v2.1 | 1449 | 1844 |
두 가지를 함께 읽어야 합니다. Terminal-Bench 4.0에서 Sonnet 5의 10.3%는 이례적으로 낮은 기준치입니다. AA가 직접 돌린 같은 벤치마크에서는 max 기준 Sonnet 5가 14.1%, Sonnet 5.5가 63.6%였습니다. 또 GDPval-AA는 AA가 출시 전 배포판에서 측정했는데, 그 배포판에는 구조화된 출력을 쓰는 요청의 응답 품질을 떨어뜨릴 수 있는 버그가 있었고 이후 고쳐졌습니다.
FrontierCode에서 max가 xhigh보다 낮은 점도 눈여겨볼 만합니다. Anthropic 각주에 따르면 max의 Sonnet 5.5는 Claude Code의 코드 리뷰 스킬을 더 자주 실행해 여러 하위 에이전트로 일을 나눴고, 일부 과제에서 시간 초과나 범위 밖 수정으로 점수를 잃었습니다. effort를 끝까지 올린다고 결과가 늘 좋아지지는 않는다는 뜻입니다.
속도는 Anthropic이 "출력 생성이 Sonnet 5보다 30% 이상 빠르다"고 밝혔고, 초기 테스터들은 Sonnet 5.5가 도구 호출을 한꺼번에 묶어 단계 수가 줄었다고 전했습니다. 위 AA 표에서도 low~xhigh의 작업당 시간은 Sonnet 5.5가 짧고, max에서는 968초로 더 깁니다.
제3자 테스트로는 CodeRabbit의 Sonnet 5.5 코드 리뷰 테스트 글이 있습니다. 이미 알려진 어려운 버그 13건에서 Sonnet 5.5는 6건, Sonnet 5는 4건을 잡았고, 정가 기준 리뷰 한 건의 Claude 호출 비용은 약 60% 낮았으며($0.46~0.47 대 $1.16) 걸린 시간은 약 절반이었습니다. Sonnet 5가 잡은 버그 2건은 놓쳤고, CodeRabbit 스스로 13건은 방향을 보여 줄 뿐 증명은 아니라고 적었습니다.
Sonnet 5에서 쓰던 effort, Sonnet 5.5에서는 어디서 시작하나
Sonnet 5의 effort 설정을 그대로 옮기지 말고, 대부분 한두 단계 낮은 곳에서 시작해 자기 작업으로 다시 재는 것이 맞습니다. Anthropic은 Sonnet 5.5 변경 사항 문서에서 effort가 재보정되어 같은 단계라도 Sonnet 5와 같은 양을 생각하지 않는다며, effort 비교를 다시 돌리라고 권합니다.
AA 수치를 시작점 고르는 기준으로 쓰면 다음과 같습니다.
| Sonnet 5에서 쓰던 effort | Sonnet 5.5 시작점 | AA 수치 (2026년 10월 5일 기준) |
|---|---|---|
max | high, 어려운 작업이면 xhigh | 5.5 high 47점·$1.12 vs 5 max 38점·$5.09 |
xhigh | medium, 부족하면 high | 5.5 medium 41점·$0.59 vs 5 xhigh 34점·$2.87 |
high | medium, 부족하면 high | 5.5 medium 41점·$0.59 vs 5 high 32점·$1.79 |
medium·low | 같은 단계 | 같은 단계에서 점수 12~13점 높고 비용 18~41% 낮음 |
작업 성격에 따른 Anthropic의 권장 시작점도 같이 봅니다.
- 일반 API 작업은
high에서 시작합니다. 에이전트형이거나 지연에 민감한 작업이 아닐 때의 기본값입니다. - 에이전트 코딩과 여러 단계의 도구 호출은 범위가 명확한 작업이면
medium, 더 어렵거나 긴 작업이면high에서 시작합니다. - 채팅처럼 응답 속도가 중요한 작업은
medium이나low에서 시작합니다.
Sonnet 5.5 max는 자기 평가에서 점수 상승이 51% 높은 비용과 더 긴 처리 시간을 감수할 만하다고 확인된 경우에만 고르는 편이 안전합니다. 응답 전 사고를 끈 between_tools를 써야 한다면 선택지는 처음부터 high까지입니다. 확인 방법은 단순합니다. 실제 업무에서 뽑은 대표 과제를 두세 개 effort 단계로 돌려, 응답의 토큰 사용량과 결과 품질을 단계별로 나란히 놓고 가장 낮은 합격 단계를 고릅니다.
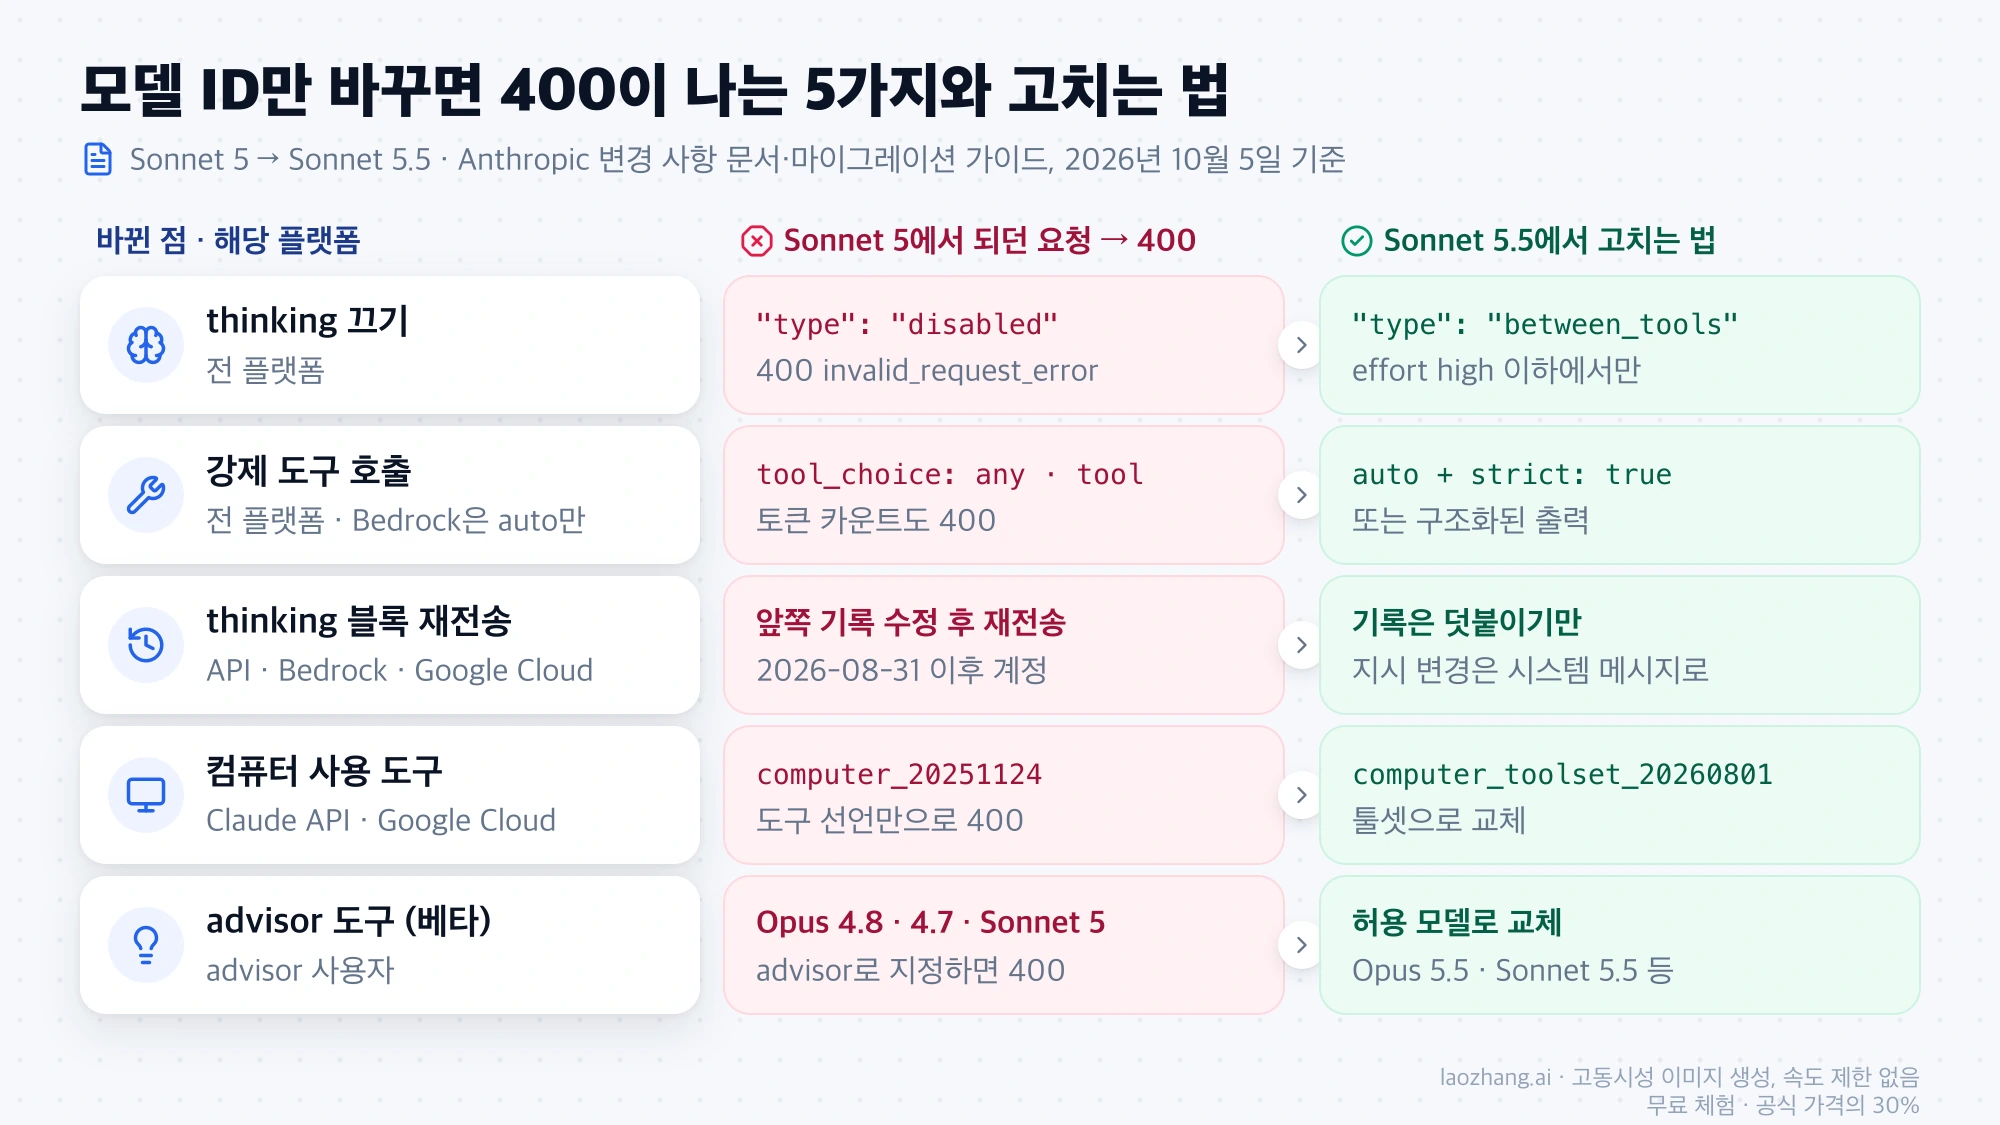
모델 ID만 바꾸면 400 오류가 나는 5가지: Sonnet 5 → 5.5 호환성 깨짐
Sonnet 5에서 잘 돌던 코드라도 아래 다섯 가지 중 하나를 쓰고 있으면 Sonnet 5.5에서 요청이 실패합니다. 근거는 Anthropic의 Sonnet 5.5 변경 사항 문서와 Sonnet 5.5 마이그레이션 가이드이며, 2026년 10월 5일 기준 내용입니다.
| 바뀐 점 | Sonnet 5에서 되던 요청 | Sonnet 5.5 결과 | 고치는 법 | 해당 플랫폼 |
|---|---|---|---|---|
| thinking 끄기 | thinking: {"type": "disabled"} | 400 invalid_request_error | {"type": "between_tools"}, effort high 이하 | 전 플랫폼 |
| 강제 도구 호출 | tool_choice 타입 any·tool | 400, 토큰 카운트 엔드포인트도 동일 | auto + strict: true 또는 구조화된 출력 | 전 플랫폼 (Bedrock은 auto만) |
| thinking 블록 재전송 | 앞쪽 기록을 고친 뒤 블록 재전송 | 2026년 8월 31일 이후 만든 계정은 400 | 기록은 덧붙이기만, 지시 변경은 대화 중 시스템 메시지로 | Claude API, Bedrock, Google Cloud |
| 컴퓨터 사용 | computer_20251124 | 400 | computer_toolset_20260801로 교체 | Claude API, Google Cloud |
| advisor 도구 (베타) | Opus 4.8·Opus 4.7·Sonnet 5 advisor | 400 | Opus 5.5, Opus 5, Sonnet 5.5 등 허용 모델로 교체 | advisor 사용자 |
thinking 끄기: disabled 대신 between_tools
Sonnet 5.5에서 disabled를 보내면 400 invalid_request_error가 돌아오고, 메시지가 바꿀 값을 알려 줍니다.
To turn thinking off on this model, send "thinking": {"type": "between_tools"} instead of {"type": "disabled"}. The model does not think before responding. The short updates it writes between tool calls come back as thinking blocks.between_tools는 응답하기 전에 하는 사고(up-front thinking)를 끄는 설정입니다. 다만 도구 호출 사이에 모델이 남기는 짧은 진행 메모는 계속 thinking 블록으로 돌아오므로, 다른 블록과 함께 그대로 다시 보내야 합니다. 도구를 쓰지 않는 요청이라면 응답은 Sonnet 5의 disabled처럼 텍스트만 옵니다.
조건이 몇 가지 붙습니다. between_tools는 effort low·medium·high에서만 받고, xhigh나 max와 함께 보내면 400입니다. display, budget_tokens, block_binding 같은 다른 필드를 같이 보내도 400이고, 대화 도중 메시지별로 effort를 바꿀 수도 없습니다. 수동 사고 예산({"type": "enabled", "budget_tokens": N})도 400입니다.
변경 전(Sonnet 5):
{
  "model": "claude-sonnet-5",
  "max_tokens": 16000,
  "thinking": {"type": "disabled"},
  "output_config": {"effort": "xhigh"},
  "messages": [{"role": "user", "content": "..."}]
}
변경 후(Sonnet 5.5):
{
  "model": "claude-sonnet-5-5",
  "max_tokens": 16000,
  "thinking": {"type": "between_tools"},
  "output_config": {"effort": "high"},
  "messages": [{"role": "user", "content": "..."}]
}xhigh를 꼭 유지해야 한다면 반대로 사고를 켜야 합니다. thinking 필드를 빼거나 {"type": "adaptive"}를 보내면 됩니다. 서버 측 폴백을 켠 상태에서 between_tools 요청이 Sonnet 5로 넘어가면, 그쪽에서는 disabled로 실행됩니다.
강제 도구 호출: tool_choice를 auto와 strict로
tool_choice에 {"type": "any"}나 {"type": "tool", "name": "..."}를 보내면 다음 오류가 납니다.
tool_choice: type "tool" and "any" are not supported for this model.auto(기본값)와 none은 그대로 쓸 수 있습니다. 입력이 스키마를 지키게 하려면 auto를 유지한 채 도구에 strict: true를 붙이거나, 스키마를 구조화된 출력(structured outputs)으로 옮깁니다. auto에서는 모델이 도구를 부르지 않고 답할 수도 있으므로, 언제 그 도구를 써야 하는지 프롬프트에 적어 둡니다. strict 도구는 JSON Schema 일부만 지원하고 모든 객체에 additionalProperties: false가 필요합니다.
변경 전(Sonnet 5):
{
  "model": "claude-sonnet-5",
  "tools": [{"name": "get_weather", "input_schema": {"...": "..."}}],
  "tool_choice": {"type": "tool", "name": "get_weather"}
}
변경 후(Sonnet 5.5):
{
  "model": "claude-sonnet-5-5",
  "tools": [{"name": "get_weather", "input_schema": {"...": "..."}, "strict": true}],
  "tool_choice": {"type": "auto"},
  "messages": [{"role": "user", "content": "What's the weather in Paris? Use the get_weather tool."}]
}
Amazon Bedrock에서는 Sonnet 5.5에 strict 도구를 포함한 구조화된 출력을 쓸 수 없습니다. Bedrock에서는 strict 없이 auto만 보내고, 프롬프트로 도구 사용 시점을 알려 준 뒤 도구 입력을 코드에서 검증합니다.
thinking 블록: 모델 전환과 앞쪽 기록 수정
thinking 블록에는 그것을 만든 모델이 기록되고, 다른 모델이 읽을 수 있는 범위가 정해져 있습니다. Sonnet 5.5는 Sonnet 5, Opus 4.8, Haiku 4.5와 그 이전 모델의 블록을 읽지만 Opus 5, Opus 5.5, Fable·Mythos 계열의 블록은 읽지 못합니다. Sonnet 5.5가 만든 블록을 읽는 다른 모델은 Claude API와 Google Cloud의 Opus 5.5뿐입니다.
그래서 대화 도중 Sonnet 5에서 Sonnet 5.5로 넘어가면 앞선 추론이 이어지고, Claude API·Google Cloud에서 Sonnet 5.5에서 Opus 5.5로 올라가도 이어집니다. 그 밖의 전환에서는 읽을 수 없는 블록을 API가 버리고 요청은 성공하며, 버려진 블록은 과금되지 않습니다.
실제로 오류가 나는 경우는 기록을 고칠 때입니다. API는 Sonnet 5.5 thinking 블록 앞의 system 프롬프트, tools, 이전 메시지가 블록 생성 이후 바뀌었는지 확인합니다. 2026년 8월 31일 00:00 UTC 이후 만든 계정은 Claude API, Bedrock, Google Cloud에서 이 확인이 기본으로 켜져 있어, 바뀐 기록 뒤에 블록을 다시 보내면 400이 납니다. 오류 대신 블록을 버리게 하려면 thinking-binding-controls-2026-08-01 베타 헤더를 보내고 thinking.block_binding.prefix_mismatch_behavior를 "drop_block"으로 설정합니다. 이 설정은 adaptive thinking에서만 됩니다.
가장 깔끔한 방법은 대화 기록을 덧붙이기만 하는 것입니다. 지시나 도구를 바꿔야 하면 앞 메시지를 고치지 말고 대화 중 시스템 메시지(mid-conversation system messages)로 추가합니다. 또 Sonnet 5.5의 thinking 블록은 만든 계정(또는 연결된 계정)에서만 쓰이고, 다른 계정이 보내면 버려집니다.
컴퓨터 사용 도구와 advisor 도구
Claude API와 Google Cloud에서 Sonnet 5.5는 컴퓨터 사용을 computer_toolset_20260801 툴셋으로만 받습니다. computer_20251124를 선언하면 400이 나고, Claude API에서는 메시지가 'claude-sonnet-5-5' does not support tool types: computer_20251124.로 시작합니다. 베타 헤더를 빼고 tools 항목을 {"type": "computer_toolset_20260801"}로 바꾼 뒤, 에이전트 루프가 멤버 tool_use 블록, 묶음 동작, 결과의 toolset_name을 처리하도록 고칩니다. Bedrock은 기존 computer_20251124를 계속 받고, 이미 툴셋을 쓰는 코드와 브라우저 사용 도구는 바꿀 것이 없습니다.
advisor 도구(베타)에서 Sonnet 5.5를 실행 모델로 쓰면, advisor로 Opus 4.8, Opus 4.7, Sonnet 5를 지정할 때 400이 납니다. 허용되는 advisor는 Mythos 5.1, Fable 5.1, Mythos 5, Fable 5, Opus 5.5, Opus 5, 그리고 Sonnet 5.5 자신입니다. 이들은 모두 조언을 advisor_redacted_result 블록으로 암호화해 돌려주므로 클라이언트에서 조언 내용을 읽을 수 없습니다.
오류 없이 달라지는 것: 도구 호출 사이 메시지, refusal, 캐시
요청은 성공하는데 화면이나 결과가 달라지는 변화도 세 가지 있습니다.
첫째, 도구 호출 사이의 텍스트입니다. Sonnet 5에서는 도구 호출 사이 텍스트가 모두 text 블록이었지만, Sonnet 5.5에서는 한두 문장보다 긴 메모가 진행 상황 thinking 블록으로 옵니다. 기본값 display: "omitted"에서는 이 블록의 텍스트가 비어 있어서, 그 메모를 사용자에게 스트리밍하던 앱은 오류 없이 도구 호출 사이에 조용해집니다. adaptive thinking에서는 display를 "updates"(베타 헤더 thinking-display-updates-2026-08-18 필요)나 "summarized"로 바꾸고, 비어 있지 않은 thinking 블록을 뒤따르는 tool_use 블록 앞에 표시합니다. between_tools를 쓰면 display 없이도 텍스트가 돌아옵니다.
둘째, 거절(refusal) 범주가 늘었습니다. 거절된 요청은 HTTP 200에 stop_reason: "refusal"로 오고, stop_details에 cyber, bio, frontier_llm, reasoning_extraction, general_harms 중 하나가 적힙니다. general_harms는 무해한 작업에서도 걸릴 수 있습니다. Claude API의 서버 측 폴백(fallbacks: "default", 베타)은 cyber와 frontier_llm 거절만 Sonnet 5로 다시 시도하고 나머지 셋은 다시 시도하지 않습니다. 거절이 과금되는지는 범주에 따라 다르고, 어느 경우든 속도 제한에는 잡힙니다. Anthropic은 Sonnet 5.5가 사이버 보안 보호 장치를 단 첫 Sonnet이며, 일반 소프트웨어 개발은 영향이 없고 위험도가 높은 보안 작업은 눈에 보이게 Sonnet 5로 넘어간다고 설명합니다.
셋째, 캐시할 수 있는 최소 프롬프트가 1,024토큰에서 512토큰으로 줄었습니다. Sonnet 5에서 짧아서 캐시되지 않던 프롬프트가 캐시될 수 있습니다. 그 밖에 메시지별 effort(베타), 대화 중 시스템 메시지, 대화 중 도구 변경(베타)은 Sonnet 5.5에만 있는 기능입니다.
Claude Code에서 Sonnet 5.5 쓰기: v2.1.284 이상과 sonnet 별칭
Claude Code에서 Sonnet 5.5를 쓰려면 v2.1.284 이상이 필요하고, sonnet 별칭이 Sonnet 5.5를 가리키는 것은 Anthropic API로 연결했을 때뿐입니다. Claude Code 모델 설정 문서의 공급자별 별칭은 2026년 10월 5일 기준 다음과 같습니다.
| 공급자 | sonnet이 가리키는 모델 |
|---|---|
| Anthropic API | Sonnet 5.5 |
| Claude Platform on AWS | Sonnet 4.6 |
| Amazon Bedrock, Google Cloud Agent Platform | Sonnet 4.5 |
| Microsoft Foundry | Sonnet 4.5 |
Bedrock이나 Google Cloud에서 /model sonnet을 고르면 Sonnet 4.5가 잡히는 이유가 이것입니다. 클라우드 공급자 쪽에서 Sonnet 5.5를 쓰려면 전체 모델 이름을 지정하거나 ANTHROPIC_DEFAULT_SONNET_MODEL로 고정합니다.
전환과 확인은 이 순서로 합니다.
claude update로 v2.1.284 이상으로 올립니다. 그 전 버전에서는 Sonnet 5.5 요청이 실패할 수 있습니다.- 세션 안에서
/model claude-sonnet-5-5(Anthropic API라면/model sonnet도 가능)를 실행하거나,claude --model claude-sonnet-5-5로 시작하거나, 환경 변수ANTHROPIC_MODEL을 설정합니다. /status로 현재 모델을 확인합니다. 세션 헤더에는 모델 이름 옆에 적용 중인 effort가 표시됩니다.- effort를 확인합니다. Claude Code에서 Sonnet 5.5의 기본 effort는
medium이고, Claude API 기본값high와 다릅니다. 기존 코드베이스의 버그 수정처럼 검증이 중요한 작업이면/effort high,--effort,CLAUDE_CODE_EFFORT_LEVEL중 하나로 올립니다.
default 모델 설정은 v2.1.280부터 Pro, Max, Team, Enterprise, Anthropic API에서 Opus 5.5로 해석됩니다. 따로 고르지 않으면 Sonnet 5.5가 아니라 Opus 5.5로 돌아갈 수 있다는 뜻입니다. 또 세션 중간에 /model로 모델을 바꾸면 프롬프트 캐시가 무효화되어 지금까지의 대화를 캐시 없이 다시 읽습니다. 긴 세션이라면 새 세션을 열 때 바꾸는 편이 비용이 덜 듭니다.
보안 관련 저장소에서는 폴백도 확인해 둡니다. Sonnet 5.5에서 사이버 보안으로 분류된 요청은 Sonnet 5로 다시 실행되고 기록에 알림이 뜨며, 생물학으로 분류된 요청은 폴백 없이 거절로 끝납니다. Bedrock, Google Cloud Agent Platform, Foundry에서는 Opus 모델 고정과 함께 Sonnet 5 항목이나 ANTHROPIC_DEFAULT_SONNET_MODEL이 있어야 이 폴백이 동작합니다. 자동 전환 대신 매번 묻게 하려면 /config에서 Switch models when a message is flagged를 끕니다.
Claude 앱에서도 Sonnet 5.5의 기본 effort는 Medium이라고 Anthropic은 밝혔습니다. API에서 high로 쓰던 감각과 앱·Claude Code의 결과가 다르게 느껴진다면 effort 기본값 차이부터 의심해 볼 만합니다.
Sonnet 5에 남을지, Sonnet 4.5에서는 언제까지 옮길지
Sonnet 5는 당분간 써도 되고, Sonnet 4.5는 기한 안에 옮겨야 합니다. 일정은 Anthropic 모델 지원 종료 일정 문서 기준입니다.
Sonnet 5에 당분간 남아도 되는 경우
Sonnet 5는 레거시 상태이고, Anthropic은 Sonnet 5.5로 옮기는 것을 검토하라고 권하지만 종료 공지는 없습니다. 종료는 2027년 6월 30일 이전이 아닙니다. 다음에 해당하면 준비가 끝날 때까지 Sonnet 5에 머무는 것이 합리적입니다.
disabled와xhigh·max를 함께 쓰는 등, 위의 400 오류를 고칠 시간이 아직 없는 경우- Bedrock에서 강제 도구 호출에 의존하고 있어
auto와 코드 검증으로 바꿔야 하는 경우 - 도구 호출 사이 메모를 사용자에게 스트리밍하는 화면을 아직 고치지 못한 경우
max를 고정해 쓰는 파이프라인이라 effort를 다시 재기 전에는 비용이 오를 수 있는 경우- 보안 연구처럼 사이버 보안 분류에 자주 걸려 Sonnet 5로 폴백되는 일이 잦은 작업
Sonnet 4.5 사용자: 2026년 11월 30일 Claude API 종료
Anthropic은 2026년 9월 30일 claude-sonnet-4-5-20250929의 지원 종료를 알렸고, Claude API에서 2026년 11월 30일 종료됩니다. 권장 대체 모델은 claude-sonnet-5-5입니다. Sonnet 4.6은 아직 활성이지만 종료 시점이 2027년 2월 17일 이후로만 정해져 있어, Sonnet 5.5(2027년 9월 28일 이후)보다 보장된 기간이 짧습니다. Bedrock, Google Cloud, Foundry의 Sonnet 4.5 종료일은 각 공급자 일정을 따로 확인해야 합니다.
Sonnet 4.5에서 바로 Sonnet 5.5로 가면 위 다섯 가지 호환성 깨짐에 더해 다음도 처리해야 합니다.
thinking필드가 없어도 사고가 켜집니다. 응답 블록을type으로 읽고, thinking 블록을 다시 보내며,max_tokens를 다시 잡습니다.- 기본값이 아닌
temperature,top_p,top_k를 뺍니다. - 같은 텍스트가 Sonnet 4.5보다 약 30% 많은 토큰으로 계산되므로 비용을 다시 계산합니다.
- assistant 프리필은 400입니다(
This model does not support assistant message prefill. The conversation must end with a user message.). - 도구 입력은 표준 JSON 파서로 읽고,
output_config.effort를 명시합니다. - 컨텍스트 윈도 베타 헤더와
interleaved-thinking-2025-05-14를 빼고,fine-grained-tool-streaming-2025-05-14는eager_input_streaming으로 바꾸며,output_format은output_config.format으로 옮깁니다.
전환 전 API 코드 점검 순서
API 코드를 옮길 때는 아래 순서로 확인하면 빠뜨리는 곳이 줄어듭니다.
model을claude-sonnet-5-5로 바꿉니다. Bedrock은anthropic.claude-sonnet-5-5입니다.- 코드에서
"disabled",tool_choice,computer_20251124, advisor 모델 지정을 검색해 위 표대로 고칩니다. - 대화 기록을 수정하거나 앞 메시지를 다시 쓰는 로직이 있으면 덧붙이기 방식으로 바꿉니다.
output_config.effort를 명시합니다. 생략하면high로 실행됩니다.- 도구 호출 사이 메모를 보여 주는 화면이 있으면
display설정을 넣고 실제 스트리밍을 확인합니다. stop_reason: "refusal"처리와 폴백 설정을 확인합니다.- 대표 과제를 두세 effort 단계로 돌려 토큰 사용량과 품질을 Sonnet 5 결과와 비교합니다.
Claude Sonnet 5.5 무료 사용, Opus 5.5 선택, 가격 관련 질문
Claude Sonnet 5.5는 무료로 쓸 수 있나요?
Claude 요금제 표(2026년 9월 29일 기준)에는 Free 플랜에서 Sonnet을 쓸 수 있고 Opus는 쓸 수 없다고 나옵니다. 다만 표에 버전이 적혀 있지 않아, Free 플랜에서 쓰는 Sonnet이 5.5라고 단정할 근거는 없습니다. API는 사용한 토큰만큼 100만 토큰당 입력 $2, 출력 $10을 냅니다.
Sonnet 5.5와 Opus 5.5 중 무엇을 써야 하나요?
Anthropic은 Sonnet 5.5가 범위가 분명한 일상 작업, 버그 수정, 문서·슬라이드·스프레드시트 작성에 가장 강하다고 설명하며, 단가는 Opus 5.5의 절반입니다. 반대로 오래 판단을 이어 가야 하는 복잡하고 열린 작업에서는 Opus 5.5가 확실히 강하다고 밝혔고, AA 측정에서도 사실 지식 정확도는 Opus 5.5가 높습니다.
Sonnet 5 가격이 오른다는 이야기는 어떻게 됐나요?
Sonnet 5는 100만 토큰당 입력 $2, 출력 $10을 그대로 유지하고 있고, Sonnet 5.5도 같은 단가입니다. 인상안이 나왔다가 취소된 경위와 캐시 요금 대조 방법은 Claude Sonnet 5 가격 인상 취소: 현재 API 요금과 청구 금액 확인법에 정리되어 있습니다.
참고 자료10
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 6일.
참고 자료10
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 6일.
- 1.Anthropic의 Claude Sonnet 5.5 모델 개요platform.claude.com/docs/en/models/sonnet-5-5/overview
- 2.Anthropic API 요금 문서platform.claude.com/docs/en/about-claude/pricing
- 3.Artificial Analysis의 Claude Sonnet 5.5 모델 페이지artificialanalysis.ai/models/claude-sonnet-5-5
- 4.Anthropic의 Claude Sonnet 5.5 발표anthropic.com/claude-sonnet-5-5
- 5.Artificial Analysis의 Sonnet 5.5 출시 분석 기사artificialanalysis.ai/articles/claude-sonnet-5-5
- 6.CodeRabbit의 Sonnet 5.5 코드 리뷰 테스트 글coderabbit.ai/blog/sonnet-5-5-model-review
- 7.Sonnet 5.5 변경 사항 문서platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
- 8.Sonnet 5.5 마이그레이션 가이드platform.claude.com/docs/en/models/sonnet-5-5/migration-guide
- 9.Claude Code 모델 설정 문서code.claude.com/docs/en/model-config
- 10.Anthropic 모델 지원 종료 일정 문서platform.claude.com/docs/en/about-claude/model-deprecations