Nano Banana 2.1・Pro・GPT Image 2.5の違い:GPT Image 2.6も実測
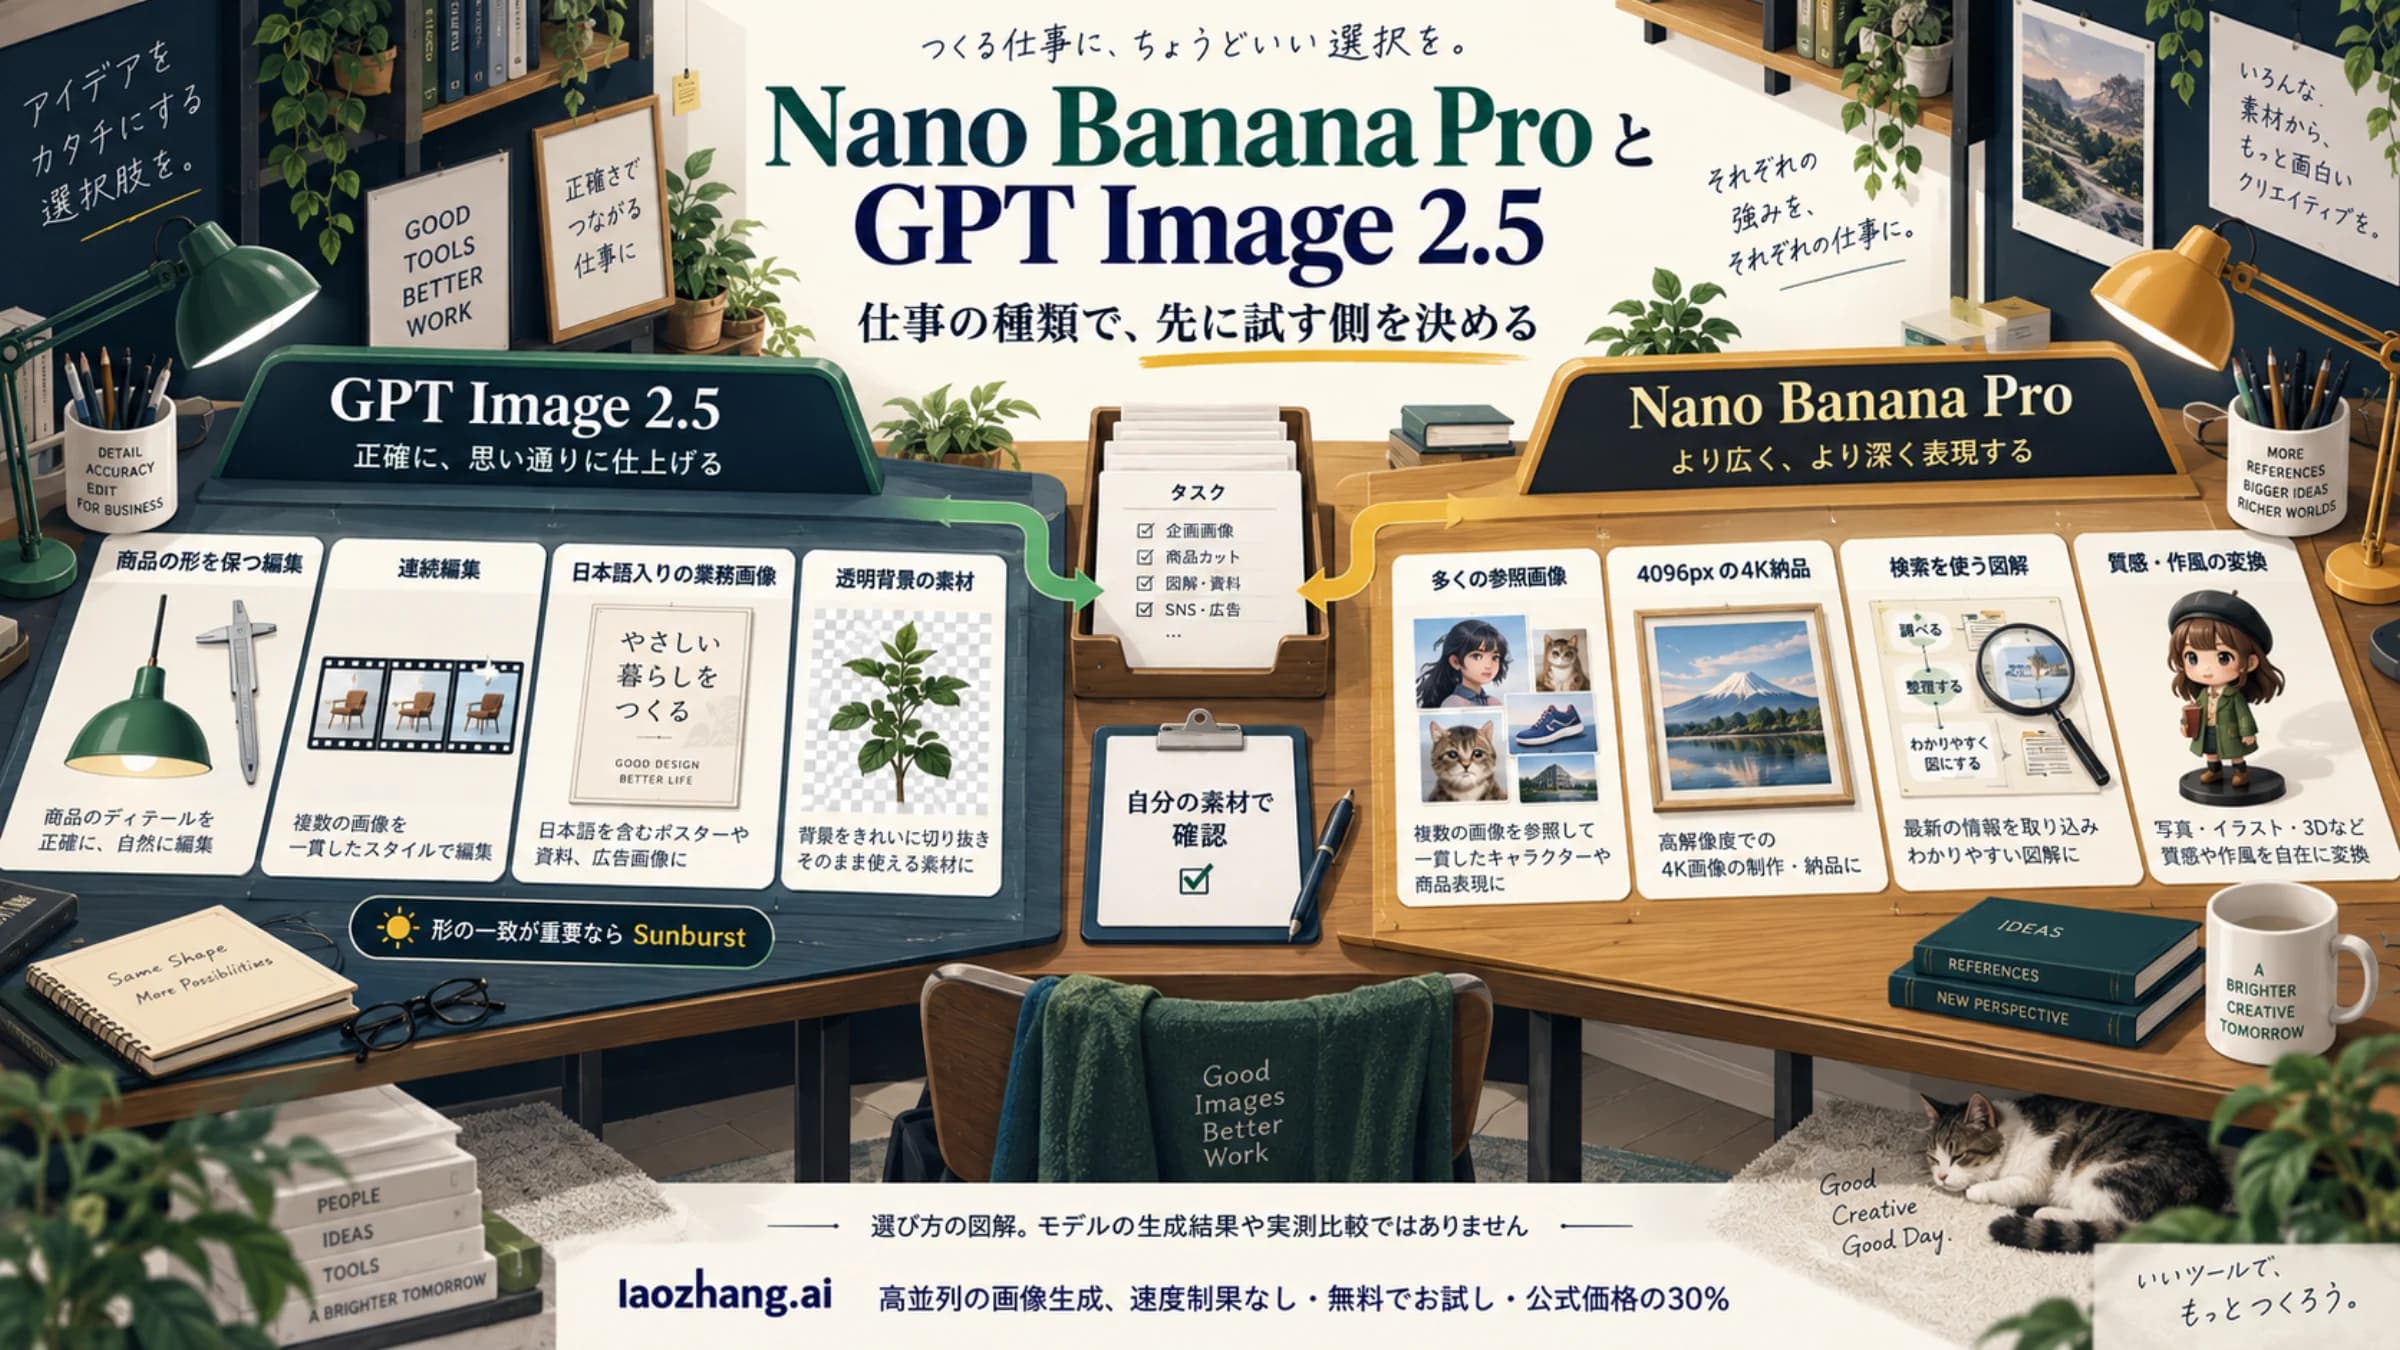
文字を正確に入れるならProかGPT Image 2.6、量と公式価格なら2.1。11月20日の追試で2.6は看板・ポスター・価格を指定どおりに描き、highは2.5と同額でした。
目次
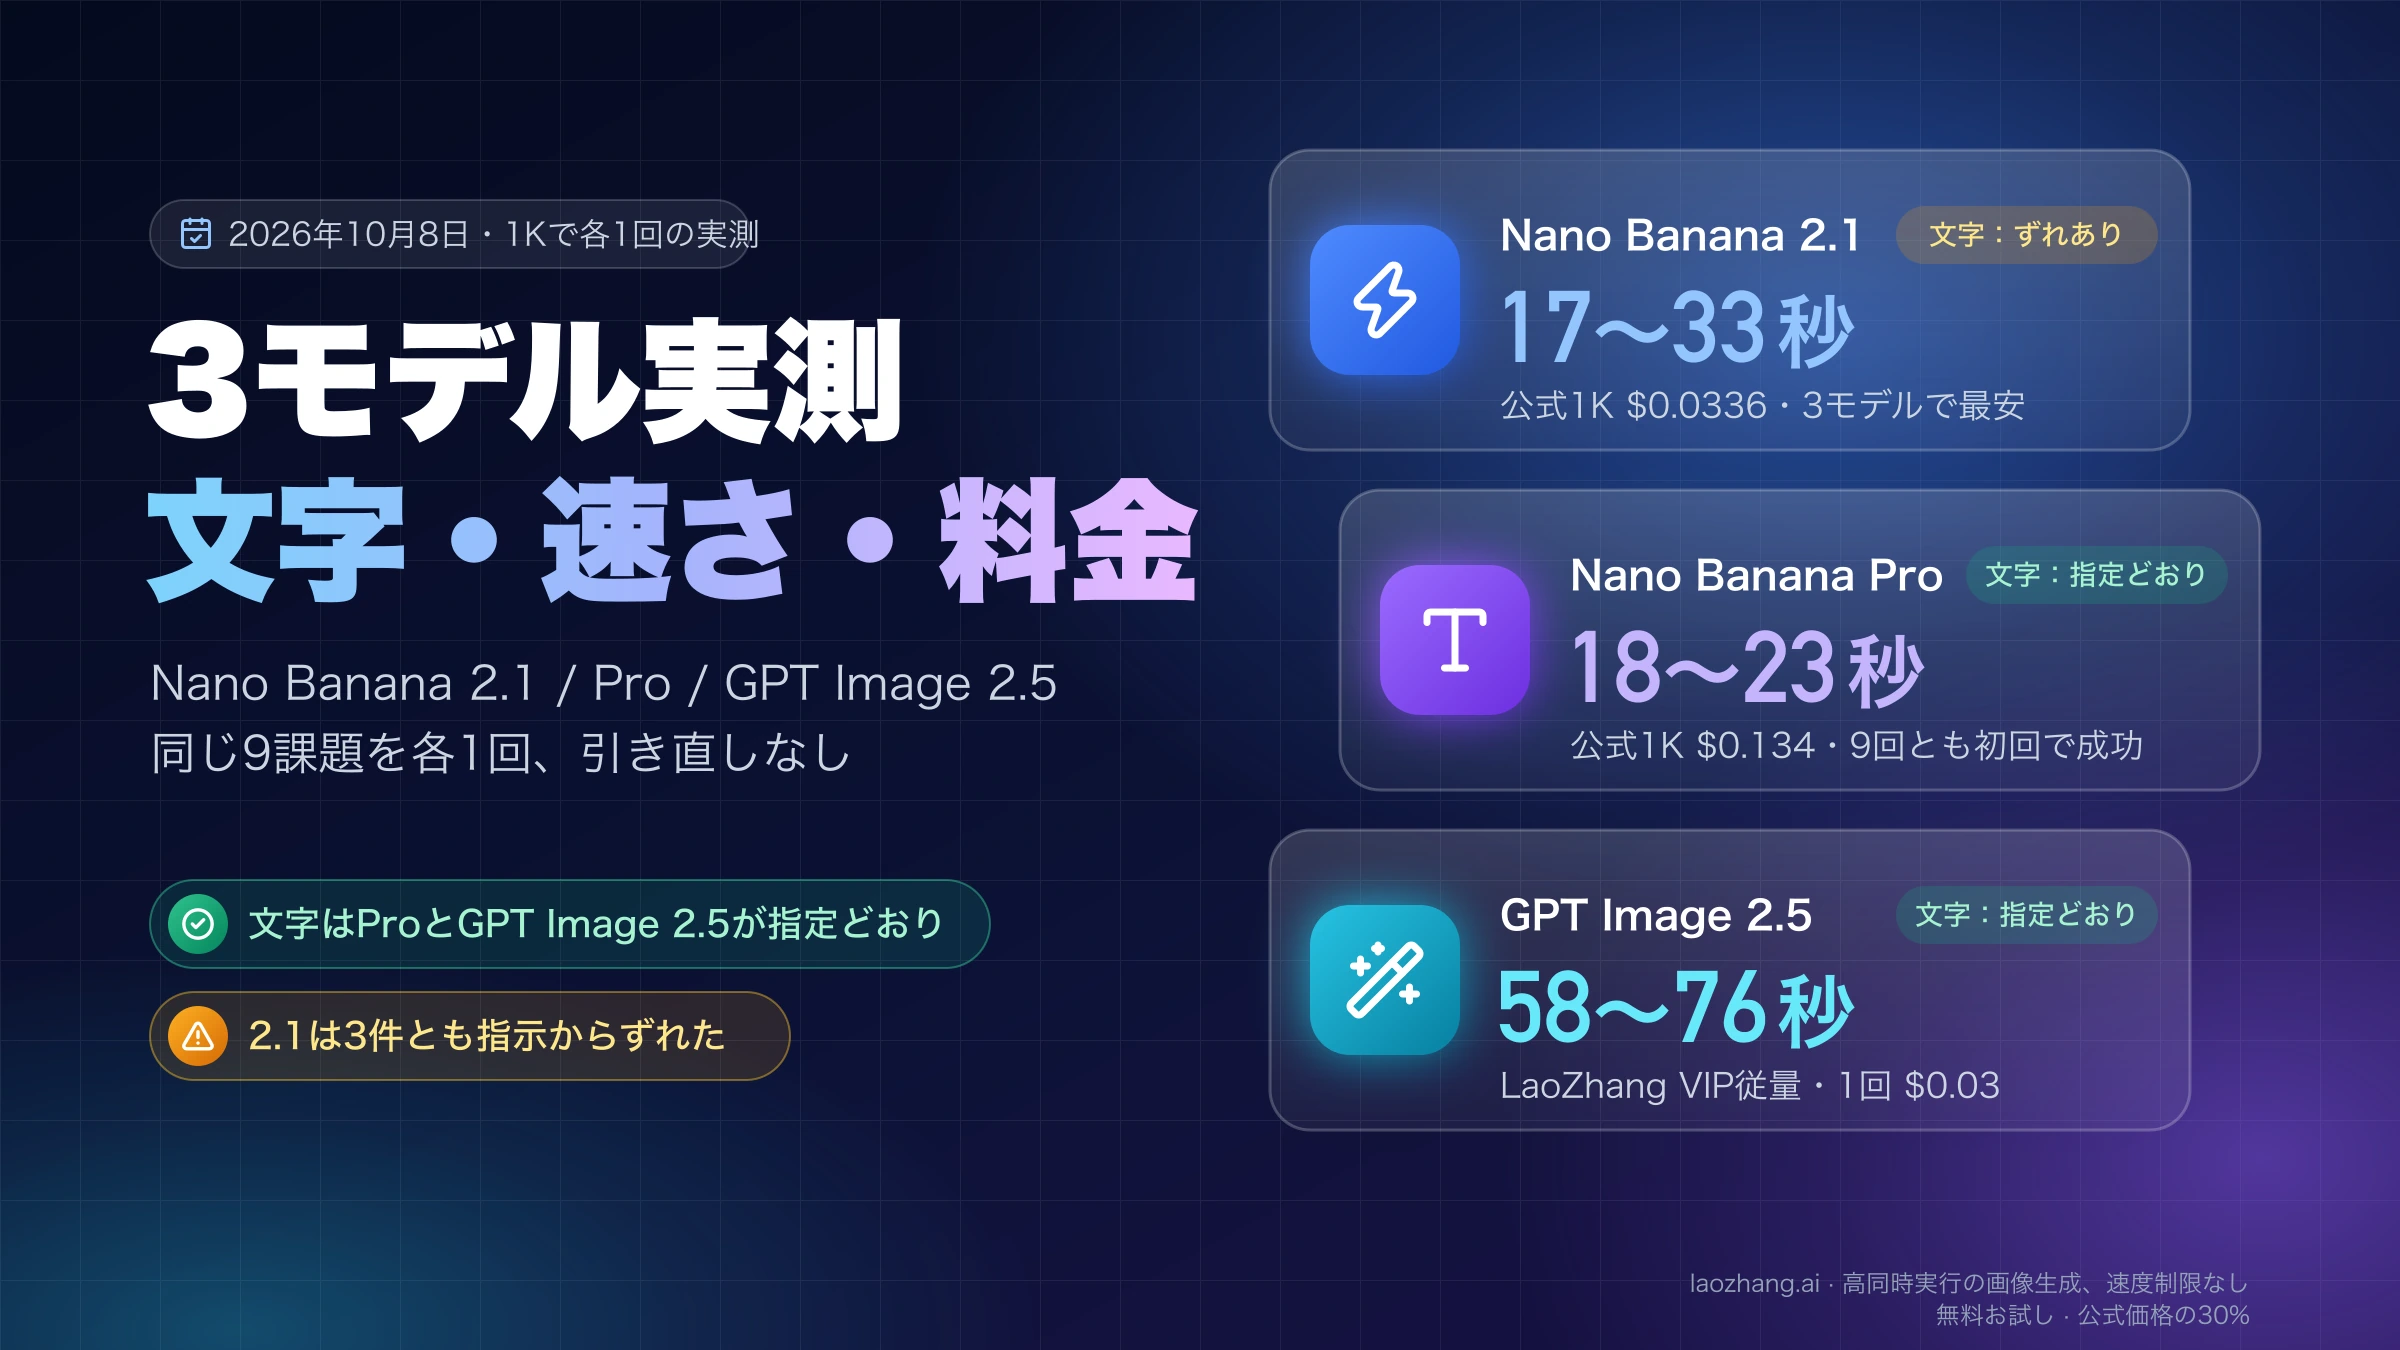
Nano Banana 2.1、Nano Banana Pro、GPT Image 2.5、そして2026年11月4日に出たGPT Image 2.6のどれを使うかは、画像に入れる文字をどこまで正確にしたいかでほぼ決まります。2026年10月8日に同じ8つのプロンプトと同じ編集1件を最初の3モデルに1回ずつ出したところ、看板・ポスター・価格表の文字を指定どおりに描いたのはNano Banana ProとGPT Image 2.5で、Nano Banana 2.1は3件とも指示から少しずれました。日本語の看板では、2.1だけが頼んでいない語を書き足しています。
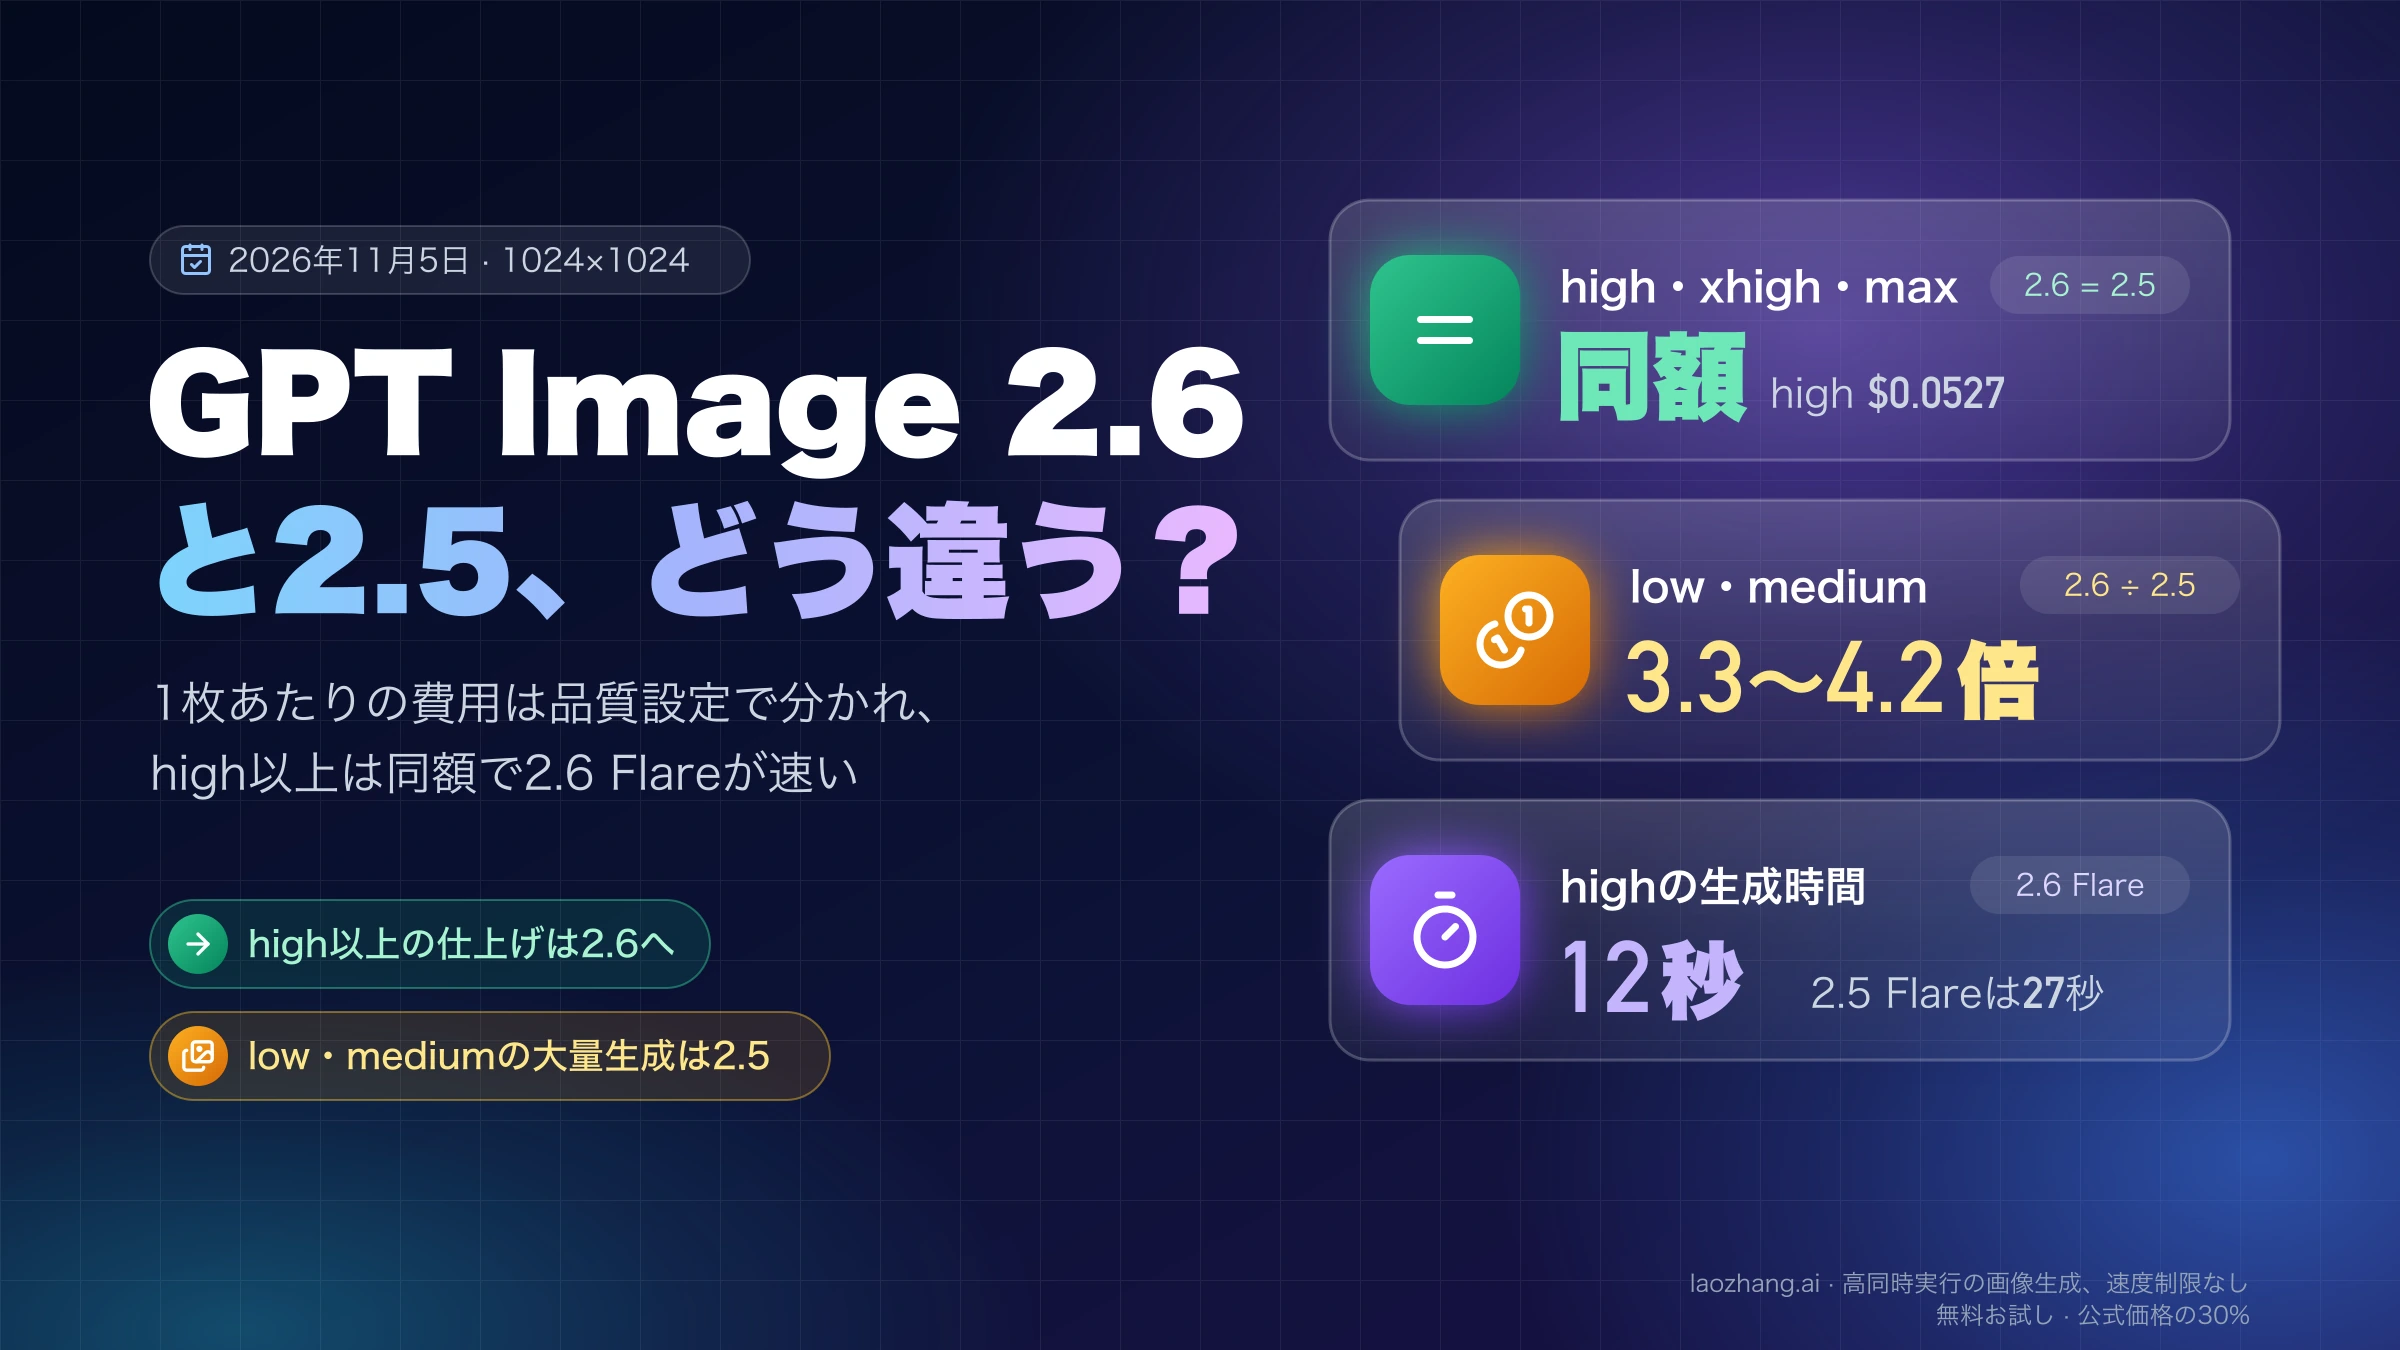
2026年11月20日に同じ9課題をGPT Image 2.6 Sunburstでも1回ずつ出すと、ポスター・看板・メニューの価格・天気画面の文字は指定どおりで、正確さはProや2.5と並びました(メニューのタイトルの簡体字「单」は、4モデルとも日本の字形「単」で描いています)。頼んでいない要素も2.5より少なく、2.5が図解に足したような標語は入れていません。OpenAIの公式料金では、2.6はquality highなら1枚約$0.054で2.5と同じですが、lowとmediumは2.5の3〜4倍になります。
生成時間は2.1とProが約20秒、GPT Image 2.5は約1分で、Googleの公式料金では2.1が1K画像1枚$0.0336とProの約4分の1です。文字を一字一句合わせたいならProかGPT Image 2.6、下書きを大量に作るなら2.1、演出の強い1枚ならGPT Image 2.5から試すのが目安です。どれも1Kで各1回だけ出した画像の比較でベンチマークではなく、GPTの2モデルはOpenAIのAPIに直接つながず、LaoZhang APIのVIP従量(1回ごとの課金)経由で呼んでいます。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
どれを選ぶか:文字はPro、量は2.1、演出はGPT Image 2.5
実測の結果と料金を合わせると、最初に試すモデルは次のようになります。GPT Image 2.6の欄は2026年11月20日、ほかの3モデルは10月8日の結果です。右端の列は、その判断がどの程度の根拠に支えられているかです。
| 用途 | 最初に試すモデル | 実測で見えたこと | 根拠の強さ |
|---|---|---|---|
| 看板・ポスター・価格表など、文字を一字一句合わせる | Nano Banana Pro。費用を抑えるならGPT Image 2.6 | 3件ともPro・GPT Image 2.5・2.6は指定どおり。2.1は3件とも表記や語が変わった | 各1回・3件のみ |
| アプリ画面のモックなど、書いた項目だけを載せる | GPT Image 2.6か2.5 | 天気画面で2.1とProは空気の質などの項目を自分で追加。GPTの2モデルはデータの項目を足さなかった | 1件のみ |
| 下書きやバリエーションを大量に作る | Nano Banana 2.1 | 9回すべて初回で成功、17〜33秒。Googleの1K単価はProの約4分の1 | 料金は公式価格。速度と成功率は1回ずつ |
| 手順図・インフォグラフィック | Nano Banana 2.1、Pro、GPT Image 2.6 | 4モデルとも5つの手順は正確。GPT Image 2.5だけが指示にない標語を追加 | 1件+Googleの自社評価 |
| 広告ビジュアル・商品のメイン画像 | GPT Image 2.5 | 4モデルとも写実的で破綻なし。演出が最も強いのは2.5で、2.6はカタログ写真に近い仕上がり | 見た目の評価は主観。Artificial Analysisの11月20日の順位では2.6 Sunburstが1位、2.5 Sunburstが2位 |
| 既存画像の色替えなど部分編集 | どれでも可。変える範囲を具体的に書く | 4モデルとも構図を保った。ふたの内側の扱いだけが分かれた | 1件のみ |
| 簡体字の中国語を入れる | どれを使っても目視確認が必要 | 4モデルとも「单」を日本の字形「単」で描いた | 1件のみ |
Nano Banana Proを文字の第一候補にしたのは、GPTの2モデルと同じく指定どおりに描けたうえで、10月8日のテストでは生成時間がGPT Image 2.5の3分の1ほどで、一度も失敗しなかったためです。費用で見ると順番が変わり、GPT Image 2.6はOpenAIの公式料金(quality high)でProの1Kの4割ほど、LaoZhang APIのVIP従量では1回あたりProの3分の1です。文字の正確さはProと並び、2.5のように指示外の標語も足さなかったので、待ち時間が気にならない用途では2.6を先に試す価値があります。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
GPT Image 2.6とNano Banana 2.1の違い:文字を守るのは2.6
GPT Image 2.6とNano Banana 2.1で迷っているなら、画像内の文字を指定どおりに入れたい仕事はGPT Image 2.6、Googleの料金体系で下書きを大量に回す仕事は2.1を先に試してください。2026年11月20日にGPT Image 2.6 Sunburstで10月8日と同じ9課題を1回ずつ出したところ、英語ポスター・日本語看板・中国語メニューの価格・天気アプリの文字はすべて指定どおりでした。同じ課題で2.1は、ポスターの大文字化、看板への語の追加、価格の漢数字化と、3件で指示からずれています。
料金の差は、2.6のqualityをどこに設定するかで変わります。OpenAIの公式料金で1024×1024のhighは1枚約$0.054で、文字の多いプロンプトで思考トークンまで含めた2.1の1K(約$0.043〜0.046)より少し高くなります。mediumの約$0.044なら2.1とほぼ同じ、lowの約$0.026なら2.1より安くなりますが、今回の実測はhighだけで、lowとmediumで文字が同じように正確かは確かめていません。LaoZhang APIの1回課金では、2.6のVIP従量が$0.03、2.1が$0.045です。計算の内訳は料金の節にまとめています。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
文字以外の差は小さく出ました。図解は両方とも5つの手順が正確で、色替え編集も両方成功しています(ふたの内側を2.1は白に、2.6は黒のまま残しました)。第三者の評価では、Artificial Analysisの画像生成ランキング(2026年11月20日時点、利用者の好みの比較)で2.6 Sunburstが1位の1261点、2.1が8位の1177点です(GPTはquality maxでの計測)。2.1には、参照画像を最大14枚まで渡せることや、Google検索によるグラウンディングに対応していることといった仕様上の特徴もあり、こうした機能が必要なら2.1が候補に残ります。2.6を前の版と比べたい場合はGPT Image 2.6と2.5の違い:high以上は同額、low/mediumは3〜4倍を参照してください。
実測の条件:1Kで各1回、GPT Image 2.5はLaoZhangのVIP従量経由
テストは2026年10月8日に、LaoZhang AI編集部がLaoZhang API経由で行いました。GPT Image 2.6は2026年11月20日に、同じプロンプト・同じ設定・同じ編集元画像で追加しています。条件は次のとおりです。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
| モデル | 呼び出したモデルID | 呼び出し方 | 設定 |
|---|---|---|---|
| Nano Banana 2.1 | gemini-nano-banana-2.1 | Gemini形式のgenerateContent | 1:1、imageSize 1K、思考は既定のまま |
| Nano Banana Pro | gemini-3-pro-image | Gemini形式のgenerateContent | 1:1、imageSize 1K |
| GPT Image 2.5 | gpt-image-2.5-sunburst-vip | /v1/images/generationsと/v1/images/edits | 1024×1024、quality high |
| GPT Image 2.6(11月20日) | gpt-image-2.6-sunburst-vip | /v1/images/generationsと/v1/images/edits | 1024×1024、quality high、3件ずつ並列 |
課題は次の9つです。8つは画像生成で、最後の1つは2.1が描いた黒いイヤホンケースの写真を各モデルに同じ指示で編集させたものです。
- 英語のコンサートポスター:「MIDNIGHT TRAIN」と「Live at Hall 7 - Nov 14, 2026 - Doors 19:30」
- 「How a bill becomes law in the U.S.」(米国で法案が法律になるまで)の5段階の図解
- 石の上に置いた黒いイヤホンケースの商品写真(文字・ロゴなし)
- 夕暮れの東京の路地。ラーメン店の看板に「本日のおすすめ ラーメン 980円」、入口の横に「OPEN」
- 中国茶館の筆書きメニュー:「今日茶单」「龙井 38元」「普洱 42元」「茉莉花茶 28元」
- 机の左半分に赤いカップ3個、右半分に青いカップ2個を真上から
- 港で網を繕う年配の漁師のポートレート
- 天気アプリの画面:「Lisbon 23°C Sunny」と、Mon〜Friの5日分に23・21・19・22・24
- 編集:ケースの色を光沢のある白に変え、イヤホン・角度・石・光と影はそのまま
各モデル1回ずつで、引き直しや選別はしていません。文字の課題(1、4、5、8)は1字ずつ確認しました。10月8日の27回の成功分をLaoZhangの定価で数えると、9課題 ×($0.045 + $0.09 + $0.03)=$1.485です。11月20日のGPT Image 2.6は9回すべて初回で成功し、9 × $0.03=$0.27でした。
GPT Image 2.5の接続方式には注意が必要です。2026年10月8日時点では、LaoZhangでOpenAIへそのまま転送するgpt-image-2.5-sunburstはSora2Officialグループのキーでしか使えず、通常グループのキーでは503「no available channels」が返りました(この失敗は課金されていません)。そのため1回$0.03のVIP従量版gpt-image-2.5-sunburst-vipを使っています。現在はこのグループが「OpenAI Official」という名前になり、2026年11月6日からは通常グループのキーでも公式名のFlareとSunburstがVIPの経路で1回$0.03で課金されます。LaoZhangのGPT Image 2.5ドキュメントにあるとおりこれはLaoZhang独自の従量課金の経路で、OpenAIのAPIを直接呼んだ場合と出力が同じとは限りません。GPT Image 2.6も同じ1回$0.03のVIP従量版gpt-image-2.6-sunburst-vipで、この経路はqualityをhighまでしか選べません。2.6にはもう1つの階層Flareがありますが、今回試したのはSunburstだけです。
このテストで分からないことも挙げておきます。2Kと4Kの画質、GoogleやOpenAIに直接つないだときの速度、Batch処理、複数の参照画像を使った人物や商品の一貫性、Google検索によるグラウンディング、GPT Image 2.6のFlareとlow・mediumでの画質、そして同じプロンプトを何度も出したときのばらつきです。GPT Image 2.6だけは別の日に3件ずつ並列で実行したため、所要時間は10月8日の3モデルと横並びでは比べられません。1回だけの結果なので、どの項目も「このモデルは常にこうなる」とは言えません。
画像内の文字の違い:指示からずれたのは3件とも2.1
文字を指定した3つの課題では、Nano Banana ProとGPT Image 2.5が指定どおりの文字を描き、Nano Banana 2.1はどれも語の追加や表記の書き換えをしました。11月20日に同じ課題を出したGPT Image 2.6 Sunburstも、看板・ポスター・メニューの価格はProや2.5と同じく指定どおりでした。メニューのタイトルだけは、4モデルとも簡体字の「单」を日本の字形「単」で描いています。読めない文字や崩れた文字はどのモデルにもなく、差が出たのは「指示どおりか」という点です。
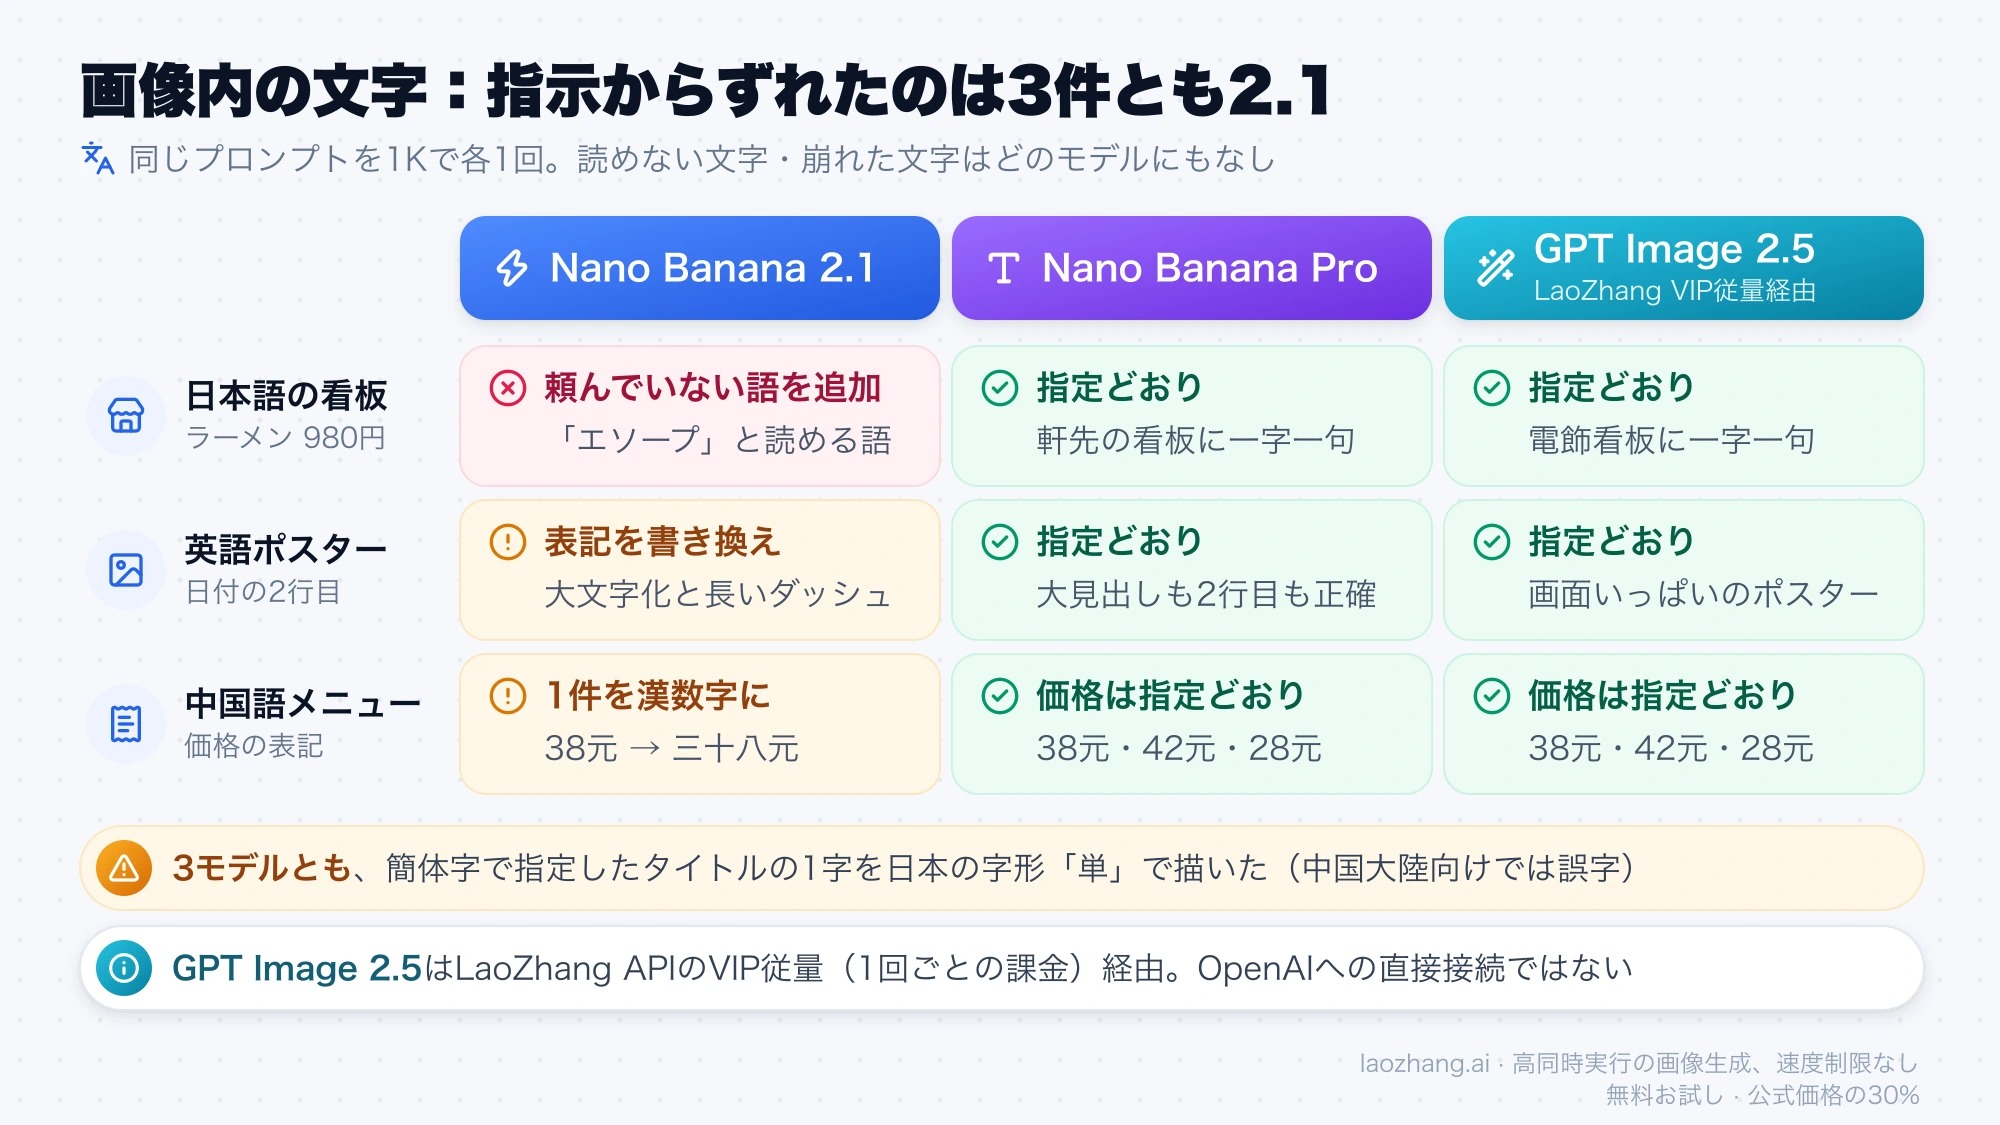
上の図は10月8日の3モデルの結果です。GPT Image 2.6を加え、文字の入る天気アプリの画面も含めて4モデルを並べると次のようになります。
| 課題(指定した文字) | Nano Banana 2.1 | Nano Banana Pro | GPT Image 2.5 | GPT Image 2.6 |
|---|---|---|---|---|
| 日本語の看板「本日のおすすめ ラーメン 980円」 | 指示にない文字列を追加 | 一致 | 一致 | 一致 |
| 英語ポスターの日付の行 | 全部大文字、ハイフンを長いダッシュに | 一致 | 一致 | 一致 |
| 中国語メニューの価格 | 「38元」を「三十八元」に | 一致 | 一致 | 一致 |
| 中国語メニューのタイトル「今日茶单」 | 「単」で描画 | 「単」で描画 | 「単」で描画 | 「単」で描画 |
| 天気アプリの都市名・気温・5日分 | 一致。空気の質などの行を追加 | 一致。体感温度などの行を追加 | 一致 | 一致。°Cの単位を付けた |
GPT Image 2.6は、指定した文字を守るという点ではProや2.5と同じ結果でした。違いが出たのは文字の外側で、2.6も看板の周りにのれんを足すなど、指定していない装飾は加えています。
日本語の看板:2.1だけが頼んでいない語を追加
「本日のおすすめ ラーメン 980円」はProとGPT Image 2.5が一字も違えずに描きました。Proは店の軒先の看板に、GPT Image 2.5は店先の電飾看板に入れ、どちらも入口の横に「OPEN」の札を描いています(GPT Image 2.5は縦書き)。GPT Image 2.5は背景に「麺」「やきとり」といった看板も足していますが、指定した看板の文字には影響していません。
11月20日のGPT Image 2.6も、店先のA型看板に「本日のおすすめ ラーメン 980円」を一字も違えずに描き、扉に「OPEN」の札を掛けました。そのうえで、店の入口に「ラーメン」と書いたのれんを、手前の路面には一部が見える「止まれ」の標示を加えています。どちらも街の風景として自然で、看板の文字そのものには手を加えていません。
Nano Banana 2.1は店先のA型看板に「本日のおすすめ」「ラーメン」「980円」を正しく書いたうえで、その間に「エソープ」のように読める、指示にない文字列を入れました。日本語の文字そのものは整っているため、遠目には気づきにくい種類の誤りです。そのまま広告や店頭用の素材に使うと、意味の通らない語が載ることになります。
英語ポスター:2.1は日付の行を大文字とダッシュに変更
「MIDNIGHT TRAIN」の大見出しは3モデルとも正確でした。違いは2行目で、ProとGPT Image 2.5は「Live at Hall 7 - Nov 14, 2026 - Doors 19:30」を指定どおりに描き、2.1は「LIVE AT HALL 7 — NOV 14, 2026 — DOORS 19:30」と全部大文字にしてハイフンを長いダッシュに変えました。デザインとしては自然ですが、表記を変えてほしくない場面では修正が必要です。
構図にも差がありました。2.1とProはポスターを背景の上に置いた「紙」として描き、GPT Image 2.5は画面いっぱいをポスターにして、線路が奥へ伸びるモチーフまで加えています。3枚の中で最も完成品に近く見えたのはGPT Image 2.5でした。GPT Image 2.6は2行目もハイフンのまま指定どおりに描き、大きな見出しと赤い円の一部だけを置いた平面的なスイス風のレイアウトで、指定外の要素は足していません。
中国語メニュー:3モデルとも「单」を日本の字形「単」で描いた
価格はProとGPT Image 2.5が「38元」「42元」「28元」と指定どおりで、2.1は龍井茶の価格だけを「三十八元」と漢数字に書き換えました。
見落としやすいのはタイトルです。プロンプトでは簡体字の「今日茶单」と指定しましたが、3モデルとも「単」(日本の字形)で描きました。11月20日のGPT Image 2.6も価格は3つとも指定どおりで、タイトルはやはり「単」でした。4モデルそろって、中国語の簡体字の「单」を日本の字形に置き換えたことになります。日本向けの素材なら問題になりませんが、中国大陸向けのメニューや広告では誤字になります。簡体字・繁体字・日本の字形で形が違う漢字を使うときは、どのモデルでも出力を目で確かめる必要があります。
文字の多い課題では、2.1の思考トークンも増えました。ポスターで1,552、日本語看板で1,209、中国語メニューで1,352と、文字のない商品写真(336)の数倍です。Proは同じ課題でも122〜252にとどまりました。2.1は文字の多い画像ほど内部で多く考えていて、それでも指示からのずれが残ったことになります。
図解と天気アプリ画面:内容は正確、差は指示外の追加
図解と画面モックでは、指定した内容は11月20日のGPT Image 2.6を含む4モデルとも正確でした。差が出たのは、頼んでいない要素をどれだけ足すかです。
米国で法案が法律になるまでの5段階の図解は、3モデルとも事実として正しい順序でした。2.1は「提出→委員会→本会議で審議・採決→もう一方の院へ→大統領」と素直な流れで、Proは上下両院の採決を1段階にまとめ、両院協議会の段階を入れています。GPT Image 2.5は各段階に説明文を付けた最も情報量の多い図でしたが、下部に「A LAW FOR A STRONGER TOMORROW」という、指示にない標語を入れました。社内資料ならそのままでも使えますが、公開する図では余計な文言を消す手間が出ます。GPT Image 2.6は各段階に説明文を付けた2.5に近い図で、Proと同じく上下両院の採決を1段階にまとめ、大統領の拒否権を議会が覆す流れまで入れました。2.5のような標語は入っていません。
天気アプリの画面では、「Lisbon 23°C Sunny」とMon〜Friの5日分の気温を3モデルとも正しく描きました。そのうえで2.1は空気の質・湿度・風速の行を、Proは体感温度・UV指数・最高最低気温・時間ごとの予報・空気の質などを小さな文字で書き足しています。GPT Image 2.5は指定した要素だけを大きく配置し、追加は最も少なく済みました。GPT Image 2.6は気温に「°C」を付け、画面上部のステータスバーとリスボンの街並みの写真を加えましたが、空気の質や湿度のような架空のデータ項目は足していません。アプリのモックアップのように「書いたものだけを載せたい」場面では、GPT Image 2.5と2.6が後処理の手間が少なかったことになります。
Googleは2.1の既知の弱点として「1Kでは小さな文字がぼやけることがある」と公表しています。今回の天気画面では2.1の小さな文字も読める状態でしたが、文字の小さい画像を本番に使うなら2Kで出して比べるほうが確実です。
商品写真と人物写真:破綻なし、演出はGPT Image 2.5が強め
文字を含まない3つの課題では、11月20日のGPT Image 2.6を含めて4モデルとも使える画像を返しました。
- 商品写真:4枚とも写実的で、ケースの質感や影も自然です。2.1とProは落ち着いた撮影風、GPT Image 2.5は光の当て方が強く、ケースの形も高級感のある別の形状になりました。GPT Image 2.6は真上から撮ったようなすっきりしたカタログ写真で、文字やロゴも入れていません。
- 漁師のポートレート:4枚とも肌や網の質感が自然です。GPT Image 2.5は夕日を画面に入れた色の濃い仕上がりで、2.1とProはより素直な写真に近い色でした。GPT Image 2.6は港の船を背景に置き、夕方の柔らかい光で暖かい色に寄せています。
- カップの配置:赤3個を左、青2個を右という指定を4モデルとも守りました。Googleは2.1の既知の弱点に左右の取り違えを挙げていますが、今回の1回では起きていません。
広告のメイン画像のように「目を引く1枚」が欲しいならGPT Image 2.5、カタログ写真のように素直な見た目が欲しいなら2.1、Pro、GPT Image 2.6という分け方になります。ただし見た目の好みは主観で、1回ずつの比較では傾向以上のことは言えません。
同じ画像の色替え編集:3モデルとも成功、ふたの内側で差
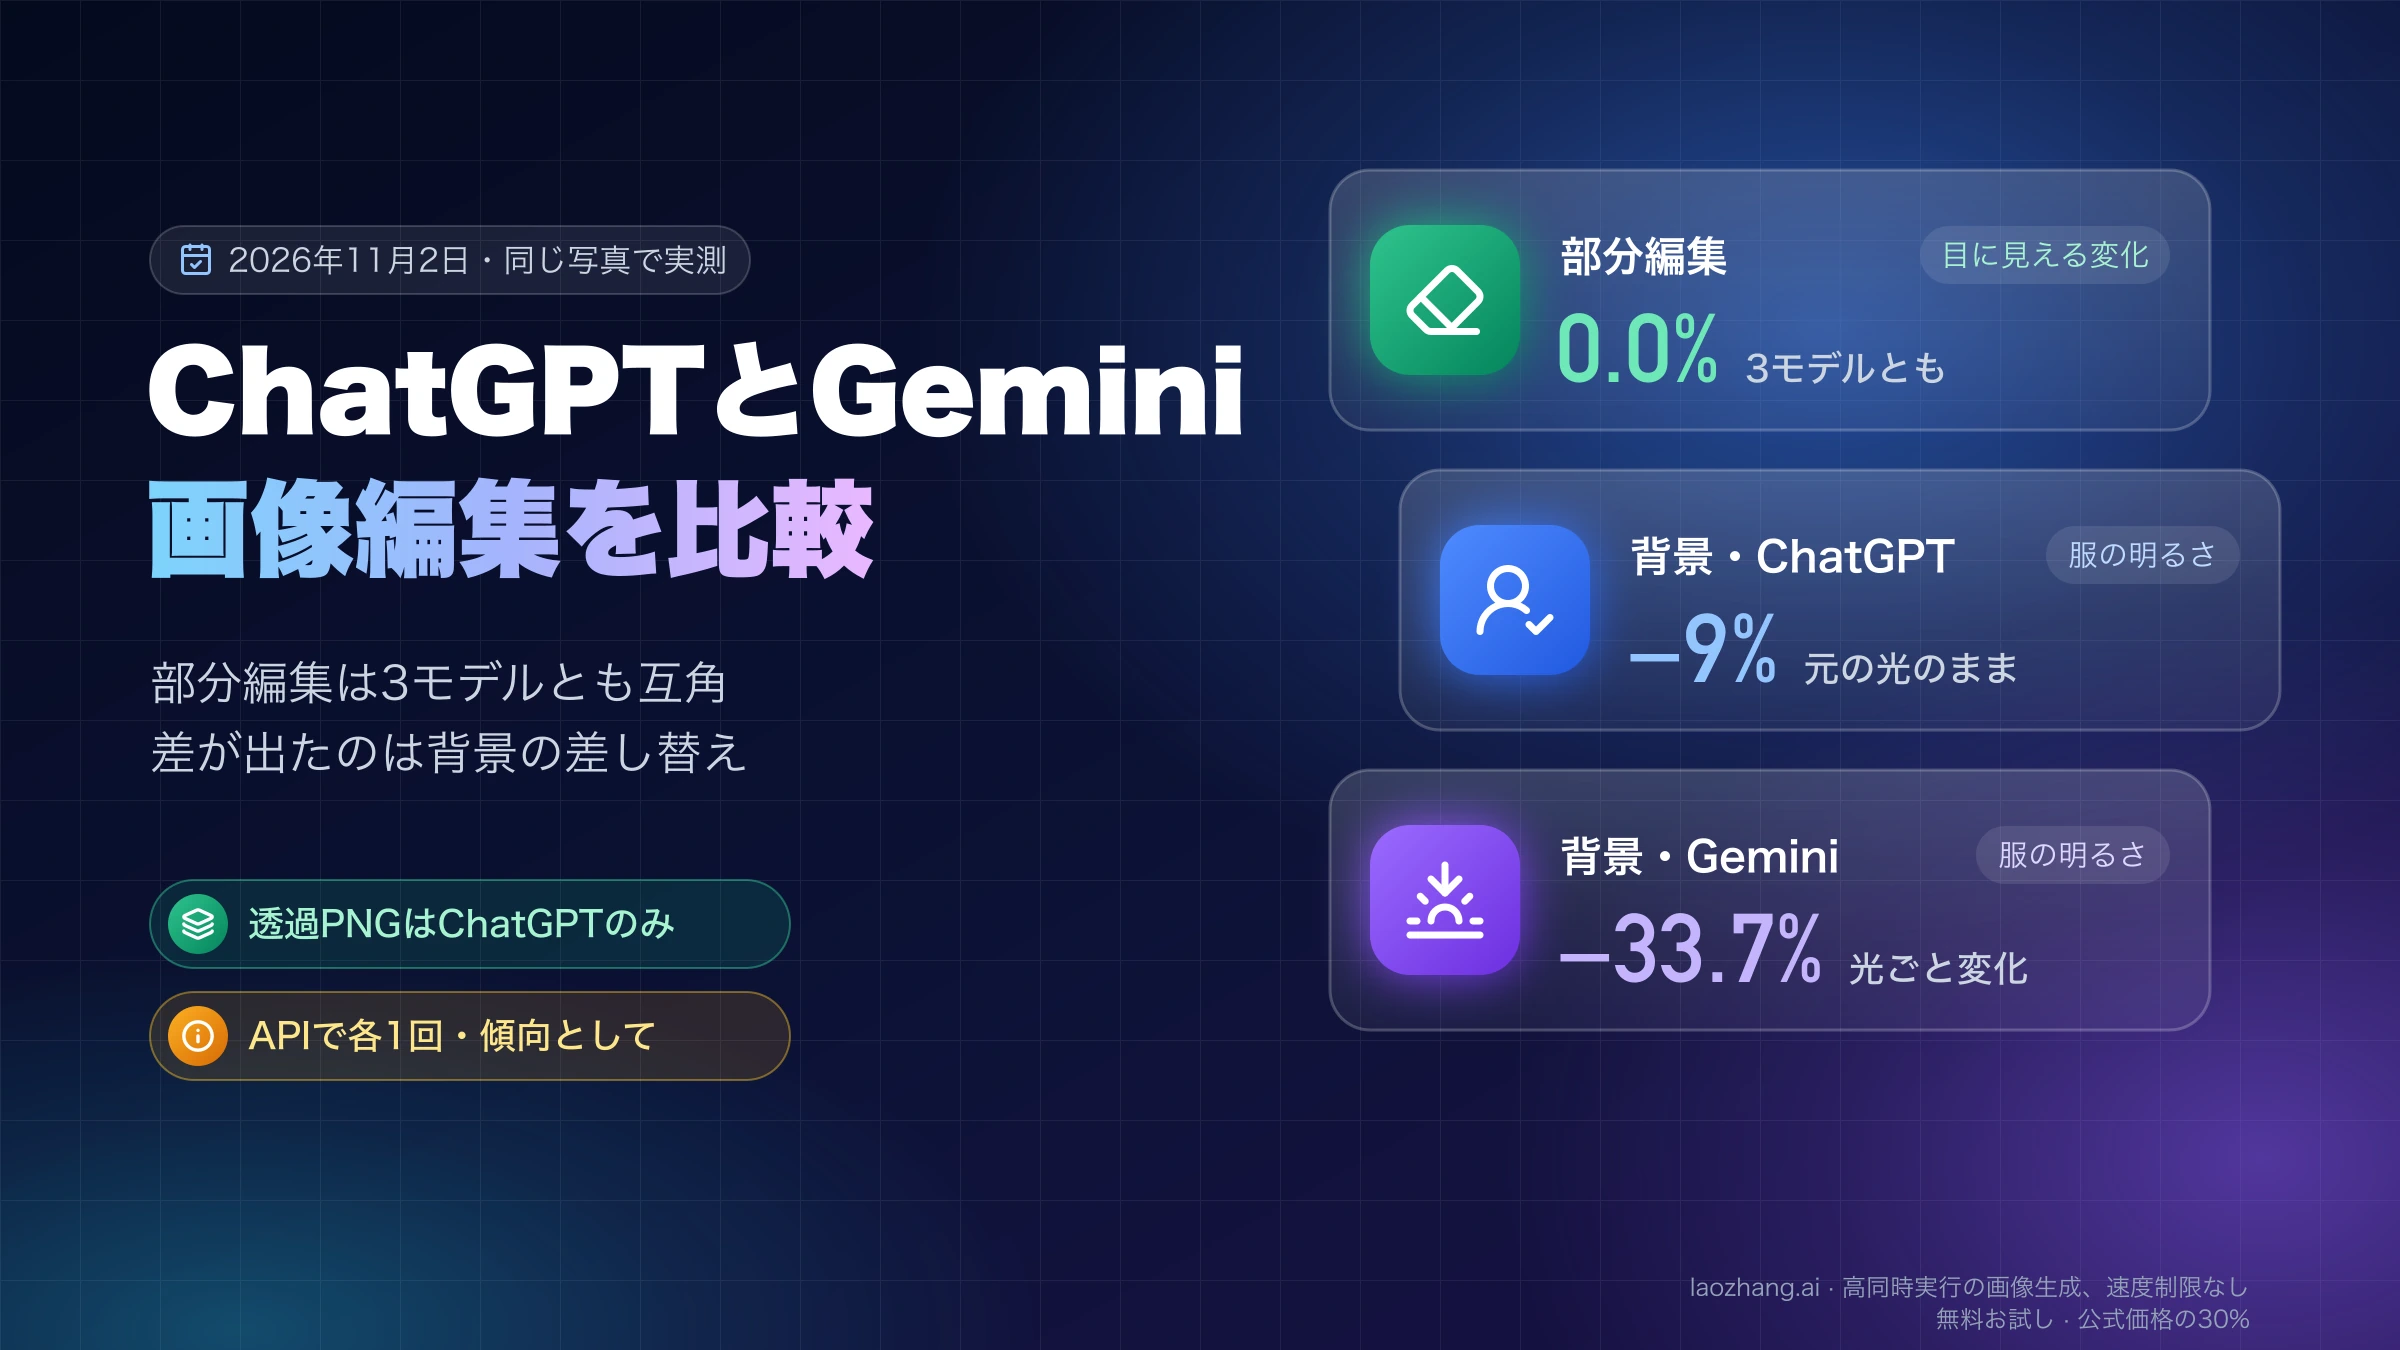
2.1が描いた黒いイヤホンケースの写真を3モデルに渡し、「ケースを光沢のある白に。それ以外はそのまま」と指示しました。3モデルともケースを白くし、イヤホン、カメラの角度、石の表面、光と影を保っています。11月20日に同じ元画像と同じ指示を渡したGPT Image 2.6も、ケースを白くして場面を保ちました。
違いはふたの内側です。2.1とProはふたの内側まで白くし、GPT Image 2.5と2.6はふたの内側を黒いまま残しました。どちらも「ケースの色」の解釈としてあり得るため、正誤ではなく解釈の差です。実際の商品画像を編集するときは、「ふたの内側も白に」「内側は黒のまま」のように、変える範囲を部品単位で書くと結果がそろいやすくなります。
Googleの自社評価でも、一般的な編集では2.1がProを上回っています(スコア1026対939)。今回の1件ではその差は見えず、4モデルとも実用上の問題はありませんでした。
変えてはいけない部分がどれだけ動いたかも数値で確かめました。ケースを囲む中央の620×620ピクセルの外側を白黒にして元画像と比べると、1ピクセルあたりの平均の差(255段階)は2.1が1.7、Proが1.6、GPT Image 2.5が2.5、GPT Image 2.6が3.5でした。40段階を超えて変わった画素は4モデルとも0.02%以下で、目で見て分かる差ではありません。ただ2.6は全体の明るさが平均1.4段階下がっていました。2026年11月5日に同じ画像へ編集を何度も重ねた別のテストでも、2.6は指示していない部分を1回あたり約1.5段階ずつ暗くしており、その傾向と合っています。同じ画像を何度も編集し直す使い方なら、元画像からやり直すほうが安全です。
速度と失敗率:2.1とProは約20秒、GPT Image 2.5は約1分
1枚あたりの所要時間(手元の端末からの実測、各1回)は次のとおりです。
| モデル | 所要時間 | 1回目で成功した割合 |
|---|---|---|
| Nano Banana 2.1 | 17〜33秒 | 9回中9回 |
| Nano Banana Pro | 18〜23秒 | 9回中9回 |
| GPT Image 2.5(VIP従量) | 58〜76秒 | 11回中9回。2回は503「Upstream model service error」で、再試行して成功 |
| GPT Image 2.6 Sunburst(VIP従量、11月20日・3件並列) | 34〜45秒 | 9回中9回 |
上の3行は2026年10月8日に1件ずつ順に、GPT Image 2.6は11月20日に3件ずつ並列で測ったもので、日も条件も違うため2.6と他の3モデルの速さは比べられません。分かるのは、11月20日のLaoZhangのVIP従量では2.6が9回とも初回で成功し、1枚40秒前後で返ってきたということです。この時間にはLaoZhangのゲートウェイと通信の時間が含まれ、GoogleやOpenAIに直接つないだときの速度ではありません。それでもGPT Image 2.5は2.1やProのおよそ2〜4倍待つ計算になり、1枚ずつ確認しながら作る作業では差を体感します。大量に並列で回す用途や、ユーザーが画面の前で待つサービスに組み込むなら、2.1かProのほうが扱いやすい結果でした。
2.1で最も時間がかかったのは中国語メニューの33秒でした。思考トークンの量と時間はきれいには比例せず、思考トークンが最も多かった図解(1,704)は22秒で終わっています。
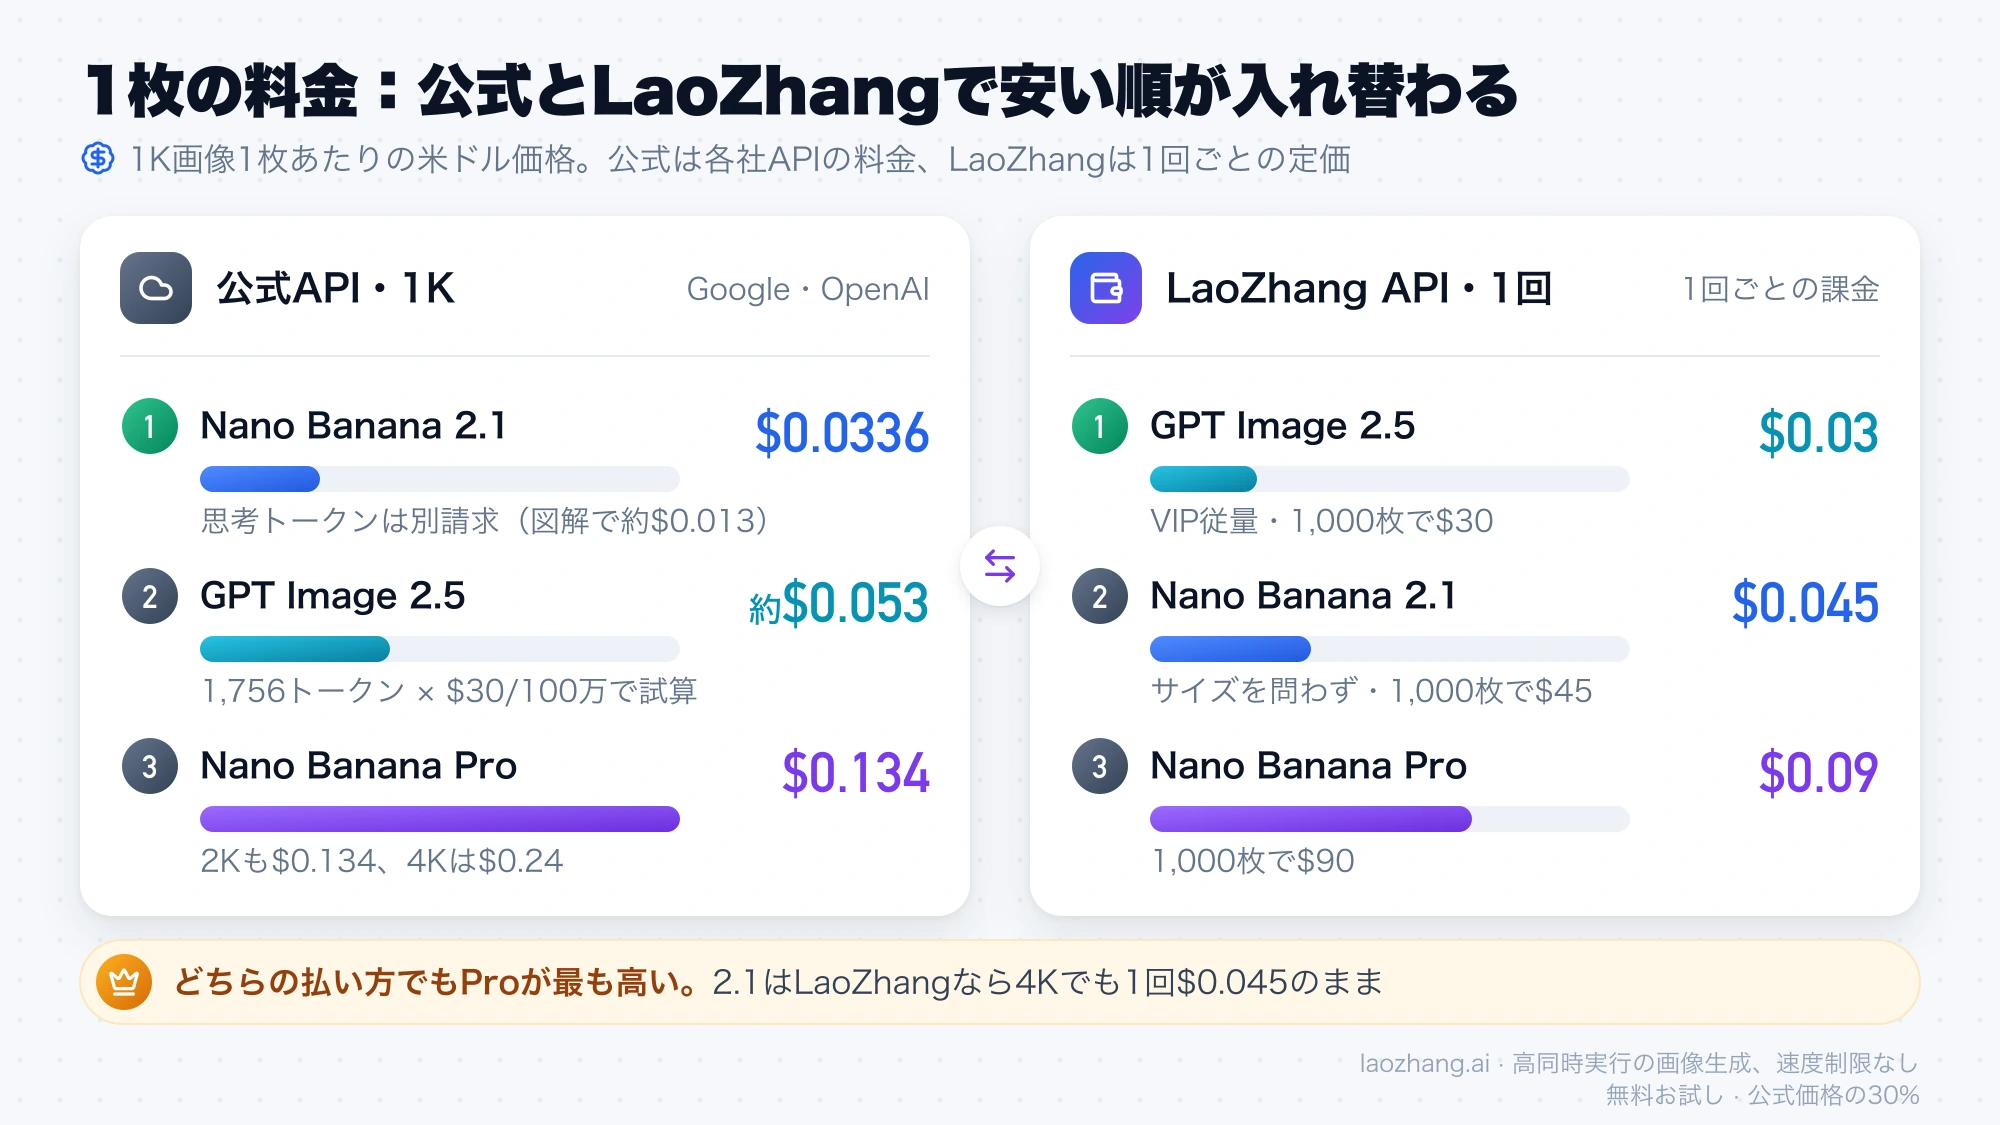
1枚あたりの料金:公式APIとLaoZhang経由で安い順が入れ替わる
料金は、GoogleやOpenAIの公式APIを直接使う場合と、LaoZhang APIで1回ごとに払う場合とで順番が変わります。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
| 項目 | Nano Banana 2.1 | Nano Banana Pro | GPT Image 2.5 | GPT Image 2.6 |
|---|---|---|---|---|
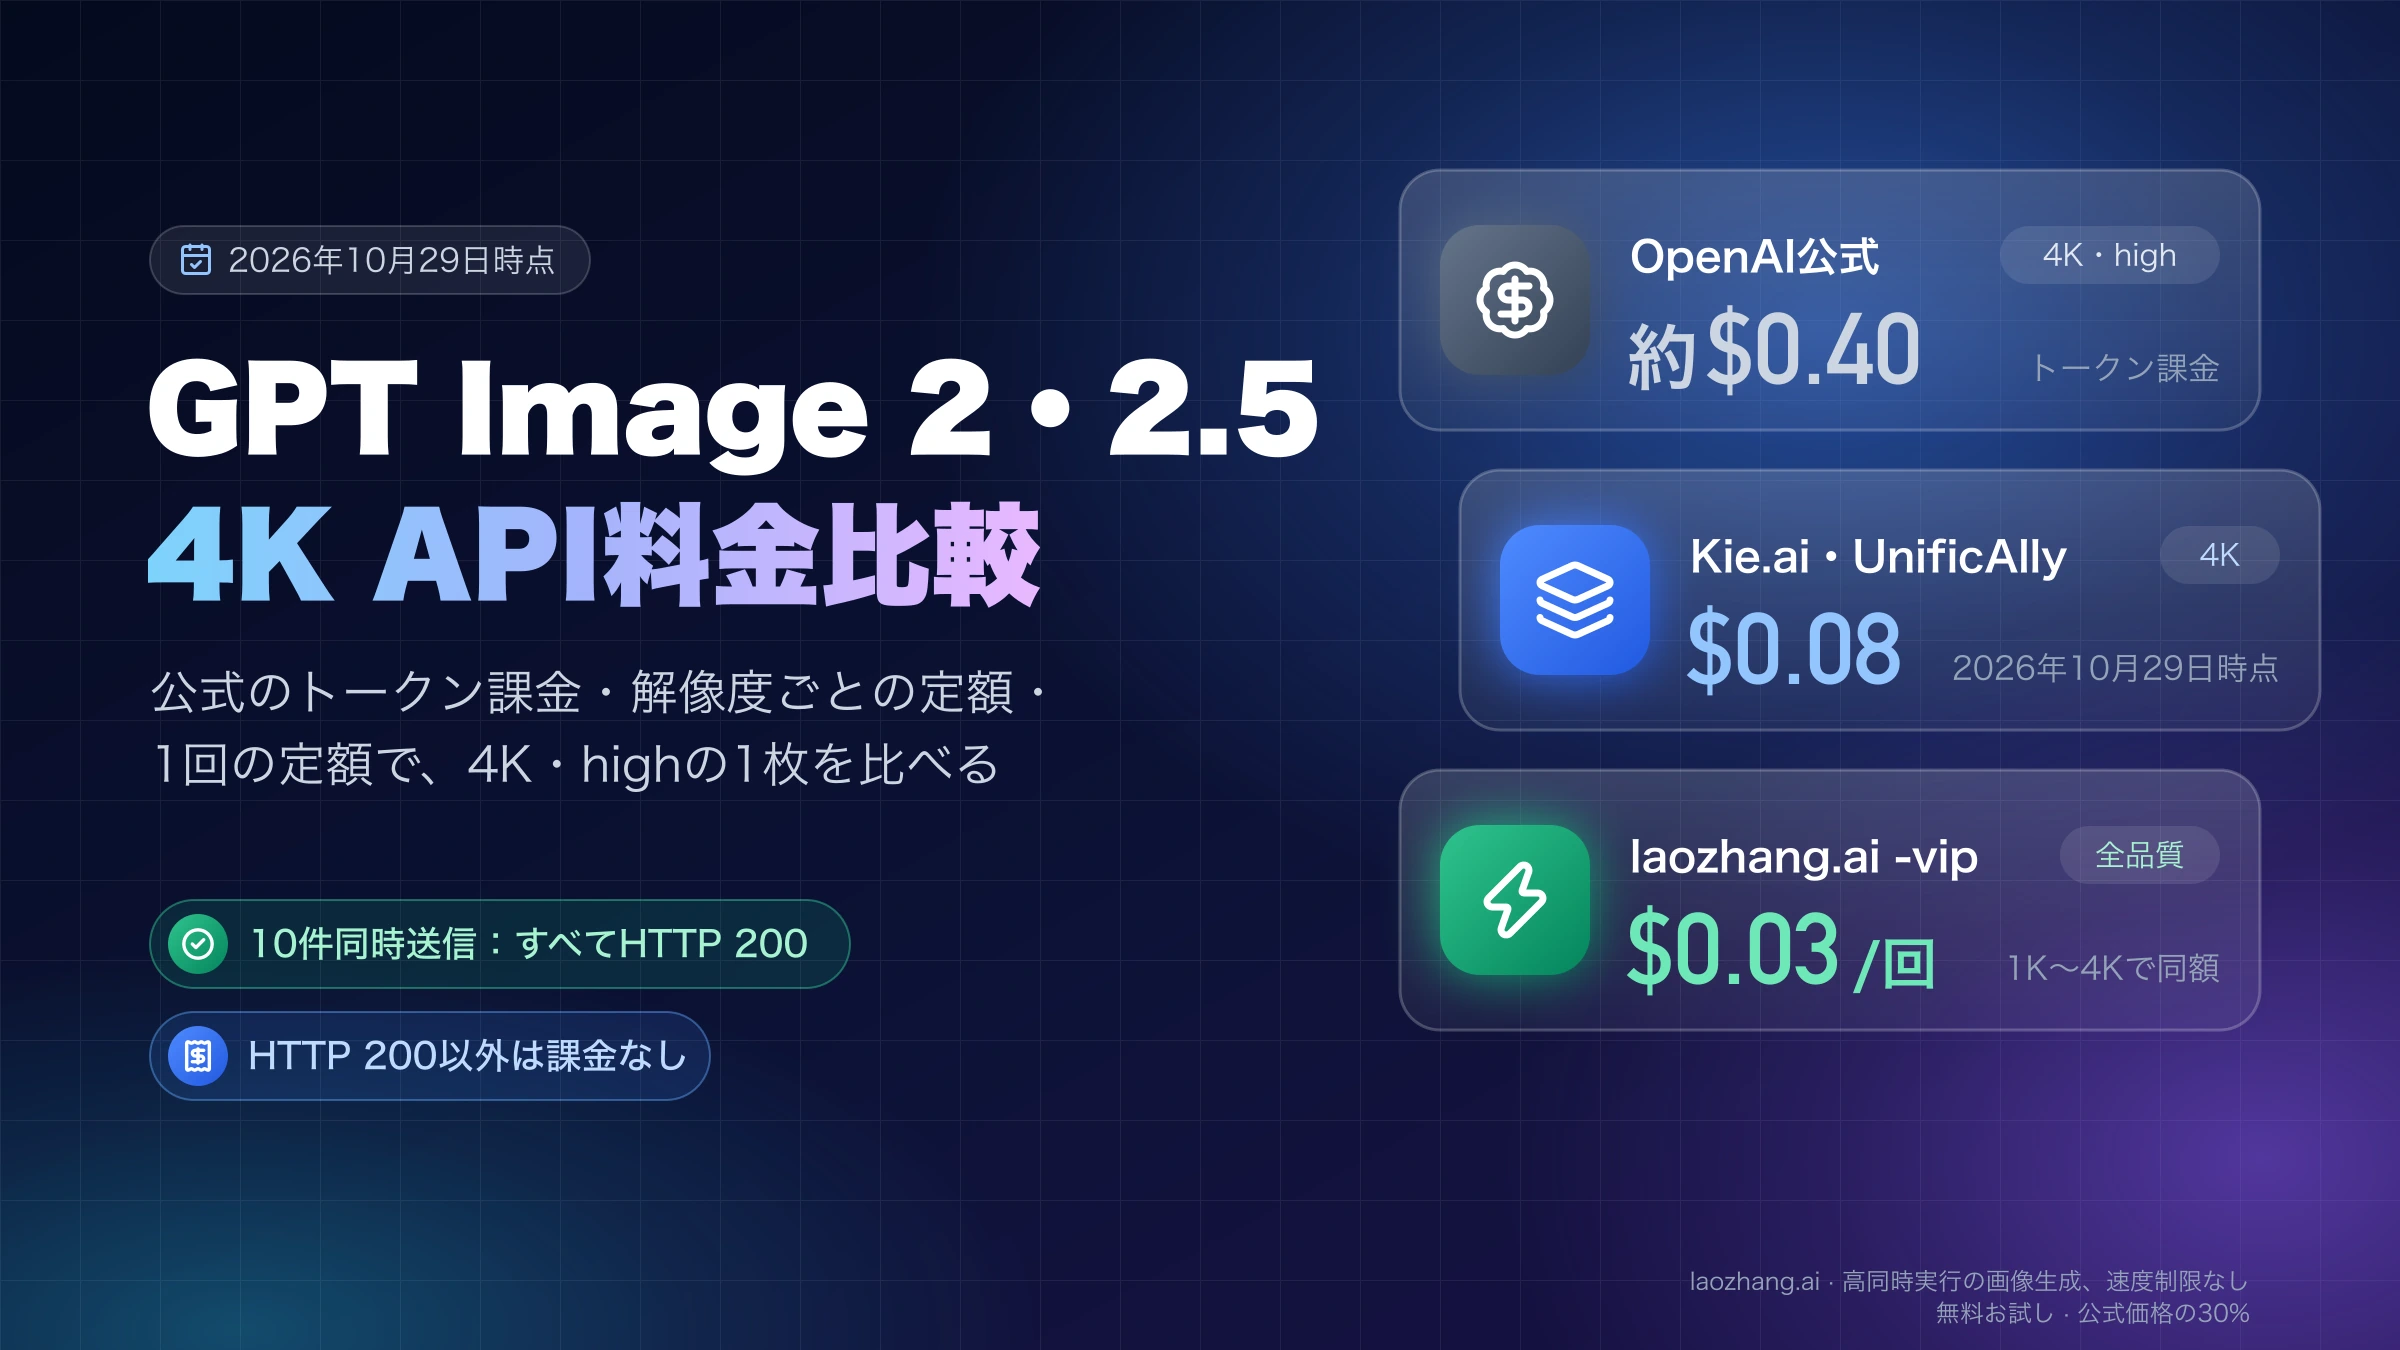
| 公式API・1K | $0.0336(思考トークンは別) | $0.134 | 約$0.054(1024×1024、high、下の計算) | 約$0.054(1024×1024、high、2.5と同額) |
| 公式API・2K | $0.0504 | $0.134 | サイズとトークン数で変動 | サイズとトークン数で変動 |
| 公式API・4K | $0.113 | $0.24 | サイズとトークン数で変動 | サイズとトークン数で変動 |
| LaoZhang API・1回 | $0.045(サイズを問わず) | $0.09 | $0.03(VIP従量) | $0.03(VIP従量、qualityはhighまで) |
| LaoZhang APIで1,000枚 | $45 | $90 | $30 | $30 |
Googleの価格はGemini APIの料金ページのStandardの画像出力分です。2.1はBatchを使うと画像出力が100万トークンあたり$15と半額になりますが、2026年11月20日時点でProの欄にはBatchの料金が表示されていません。2.1は思考トークンが既定でオンになり、テキストと思考の出力は100万トークンあたり$7.50で別に請求されます。今回いちばん思考トークンが多かった図解(1,704)で計算すると、1,704 × $7.50 ÷ 1,000,000 ≒$0.013で、1K画像と合わせても約$0.046です。文字の多い課題(思考1,209〜1,704)では約$0.043〜0.046で、Proの1K(思考トークンを含めて約$0.136〜0.137)の3分の1ほどに収まります。
GPT Image 2.5はOpenAIのAPI料金ページで画像出力100万トークンあたり$30です。今回のVIP従量の応答は、1024×1024・highで毎回1,756の出力画像トークンを報告していました。これをOpenAIの単価に当てはめると、1,756 × $30 ÷ 1,000,000 ≒$0.053で、約200トークンのプロンプト入力(100万トークンあたり$5)の約$0.001を足すと約$0.054です。OpenAIの料金計算ツールでは、1024×1024の1枚は画質lowの$0.0059から最高設定の$0.2107まで幅があります。いずれもOpenAIの見積もりで、請求書の金額ではありません。
GPT Image 2.6のトークン単価は2.5と同じで、11月20日の実測でも1024×1024・highで毎回1,756の出力画像トークンを報告しました。highの1枚が約$0.054で2.5と同額になるのはこのためです。注意したいのはlowとmediumで、OpenAIの公表値では2.6の出力トークンがlowで824、mediumで1,449と、2.5の196と439より大幅に多くなっています。入力分を含めると2.6のlowは約$0.026(2.5は約$0.007)、mediumは約$0.044(2.5は約$0.014)で、2.5で画質を下げて費用を抑えていた使い方は、2.6では3〜4倍になります。品質別の全体の料金はGPT Image 2.6の料金:Sunburst・Flareは1枚$0.025〜$0.21にまとめています。
まとめると、公式APIで1K画像をhighで出すなら2.1が最も安く、GPT Image 2.5と2.6が同額で続きます。2.6をlowにすれば2.1より安くなりますが、その画質で文字が正確に出るかは今回試していません。LaoZhang APIの1回払いではGPT Image 2.5と2.6($0.03)、2.1($0.045)、Pro($0.09)の順になり、2.1は4Kでも$0.045のままです。どちらの場合もProは最も高く、文字の正確さや一貫性にその差額を払う価値があるかが判断の分かれ目になります。
LaoZhang APIでは、今回のテストのとおり同じキーで4モデルを呼べるため、自分のプロンプトで同じ比較を再現できます。Proの費用をサブスクリプションや他のサービスと比べたい場合はNano Banana Proの料金をAPI・月額プラン・外部サービス別に計算した記事、2.1と前の世代のサイズ別料金はNano Banana 2 API料金の解説にまとめています。
ArenaのランキングとGoogleの自社評価:総合では2.1がProより上
今回の実測とは別に、公開されている評価があります。どれも誰が何を測ったかによって意味が変わるので、分けて読む必要があります。
Artificial Analysisの画像生成ランキング(AA-Image-T2I v2.1)は、利用者に2枚の画像を見比べてもらい、好みを点数にしたものです。2026年11月20日時点で、GPT Image 2.6 Sunburstが1261点(±14)で1位、GPT Image 2.5 Sunburstが1230点で2位、GPT Image 2.6 Flareが1227点で3位、Nano Banana 2.1が1177点で8位、Nano Banana Proが1119点で18位です。GPTのモデルは最高設定のquality maxで測られていて、今回の実測のhighとは条件が違います。文字の正確さ・料金・編集も評価に含まれていません(Artificial Analysisのテキストから画像生成のランキング)。
Arenaの画像生成ランキングは、利用者が2枚の画像を見比べて投票する盲評価です。2026年10月6日更新の時点では、GPT Image 2.5 Sunburstが1425点(±7)で1位、同Flareが1398点で2位、Nano Banana 2.1が1328点(5,312票)で5位、Nano Banana Pro(2K)が1248点で16位でした。当時はGPT Image 2.5の2種とNano Banana 2.1の点数がまだ暫定で、GPT Image 2.6が出る前の順位です。どちらのランキングでもGPTのモデルが見た目の好みで上位に来ていて、その傾向は今回のポートレートやポスターの印象とも合っています。
Googleの自社評価(Nano Banana 2.1のモデルカード)では、思考ありの2.1がProを多くの項目で上回っています。総合的な好みで1050対935、インフォグラフィックの事実の正確さで0.521対0.265、一般的な編集で1026対939、複数キャラクターの一貫性で1106対1011、マスク指定の編集で1049対927です。ただしGoogle自身による評価で、独立した検証ではありません。同じモデルカードは、1Kでの小さな文字のぼやけ、マスク編集での指示の一部無視、左右の取り違えを2.1の既知の弱点として挙げています。
「2.1はProを超えた」という評価は、総合点ではこれらの数字が裏づけています。一方、今回の1Kの実測では、指定した文字を一字一句守る点ではProが上でした。総合力で選ぶなら2.1、文字の正確さを外せないならProという使い分けになります。2.1の公開時期や料金、移行方法はNano Banana 2.1の解説記事で詳しく扱っています。
3モデルの仕様:解像度・アスペクト比・参照画像の上限
画質以外で選択が変わるのは、出力サイズと参照画像の数です。
| 項目 | Nano Banana 2.1 | Nano Banana Pro | GPT Image 2.5 |
|---|---|---|---|
| 出力サイズ | 1K・2K・4K(0.5Kなし) | 1K・2K・4K | 最大3840×2160または2880×2880、任意のサイズを指定可 |
| 形の指定 | 1:8や8:1を含む14種類のアスペクト比 | アスペクト比を選ぶ | 幅と高さを直接指定 |
| 画質の指定 | 解像度で選ぶ | 解像度で選ぶ | qualityをlowからmaxまで選ぶ |
Googleの2モデルは参照画像の上限も違います。2.1は最大14枚(物体10枚・人物4人)、Proは物体6枚・人物5人までです。Google検索によるグラウンディングは、2.1がウェブ検索と画像検索、Proがウェブ検索に対応しています。
GPT Image 2.6は2.5と同じくqualityをlowからmaxまで選べ、2026年11月4日の公開でGIFとSVGの出力と、complexityというパラメーターが加わりました。ただしLaoZhang APIのVIP従量ではqualityはhighまでで(xhighとmaxは400エラーになり課金されません)、SVGは出せず、GIFは出せます。コードからの呼び出し方はGPT Image 2.6 APIの使い方:モデル名はFlareとSunburstの2つを参照してください。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
人物を5人まで固定したいならPro、物体の参照を多く渡したいなら2.1、横長のバナーや縦長のスクロール画像のような極端な比率なら2.1かGPT Image 2.5が候補です。GPT Image 2.5のSunburstとFlareの選び方はGPT Image 2.5 FlareとSunburstの違い、GPT Image 2から移るかどうかはGPT Image 2.5とGPT Image 2の比較を参照してください。
Nano Banana 2.1・Pro・GPT Image 2.5についての質問
Nano Banana 2.1とNano Banana Proの違いは何ですか?
2.1は速くて安い汎用モデルで、Proは本番素材向けの上位モデルです。Googleの1K画像の単価は2.1が$0.0336、Proが$0.134です。Googleの自社評価では総合的な好みや編集で2.1がProを上回りますが、1Kで各1回出した実測では、看板やポスターの文字を指定どおりに描いたのはProで、2.1は語の追加や表記の書き換えをしました。人物の参照はProが5人まで、2.1が4人までです。
Nano Banana 2.1はProより上ですか?
総合的な評価では上です。Googleの自社評価で2.1がProを上回り、2026年11月20日時点のArtificial Analysisのランキングでも2.1(8位)がPro(18位)より上にいます(10月6日時点のArenaでも2.1が5位、Proの2K版が16位でした)。ただし画像内の文字を一字一句守る点では、2026年10月8日の実測でProのほうが正確でした。文字が主役の画像ではProを先に試すほうが安全です。
日本語の文字を画像に入れるならどのモデルですか?
Nano Banana Pro、GPT Image 2.5、GPT Image 2.6のいずれかです。「本日のおすすめ ラーメン 980円」の看板を1回ずつ描かせたところ、2026年10月8日のProと2.5、11月20日の2.6は指定どおりで、2.1は指示にない語を書き足しました。待ち時間を短くしたいならPro(約20秒)、1回の費用を下げたいならLaoZhang APIのVIP従量のGPT Image 2.6か2.5(どちらも$0.03)です。どのモデルでも、公開前に1字ずつ確認するのが前提です。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
GeminiアプリではNano Banana 2.1とProのどちらが使えますか?
2026年11月20日時点のGoogleの製品ページでは、無料で使えるのはNano Banana 2で、Nano Banana 2.1はGoogle AIプランに加入すると使えるようになると案内されています。Proで作り直す「Redo with Pro」は、Geminiのモデルを「Pro」に設定しているときに使える機能です(Geminiアプリのヘルプ)。Google AI Plusは11月13日からProモデルを選べなくなったため、Plusでは「Redo with Pro」も使えないと考えられます。これはヘルプの説明とプラン変更から推測したもので、Googleが明言しているわけではありません。APIと違い、モデルを細かく選んだり枚数あたりの費用を計算したりする使い方には向きません。
GPT Image 2.5はNano Banana 2.1より文字に強いですか?
今回の3つの文字課題(英語ポスター、日本語看板、中国語メニュー)では、GPT Image 2.5はすべて指定どおりで、2.1はすべてどこかが変わりました。その範囲ではGPT Image 2.5のほうが正確です。ただしGPT Image 2.5は図解に指示外の標語を足すことがあり、生成に約1分かかりました。今回のGPT Image 2.5はLaoZhangのVIP従量経由で、OpenAIのAPIに直接つないだ結果ではありません。後継のGPT Image 2.6も2026年11月20日の同じ課題でポスター・看板・価格の文字は指定どおりで、図解に標語を足すこともありませんでした(メニューのタイトルの「単」は2.5や2.1と同じです)。
GPT Image 2.5を使っているなら2.6に替えるべきですか?
quality highで使っているなら、OpenAIの公式料金は2.5と同じなので替えやすい条件です。lowやmediumで費用を抑えている場合は、2.6に替えると1枚あたりの料金が3〜4倍になります(OpenAIが公表している出力トークン数による計算)。2つの版の違いはGPT Image 2.6と2.5の違い:high以上は同額、low/mediumは3〜4倍で詳しく比べています。
GPT Image 2.6はChatGPTでも使えますか?
使えます。OpenAIは2026年11月4日の発表で、GPT Image 2.6(Images 2.6)をChatGPT、Codex、APIに提供し、ChatGPTではすべてのプランで使えるとしています。ただし、ChatGPTで1日に何枚作れるかといったプランごとの上限は公表されていません。FlareとSunburstを選び分けたり、1枚あたりの費用を計算したりできるのはAPIで呼ぶ場合です。