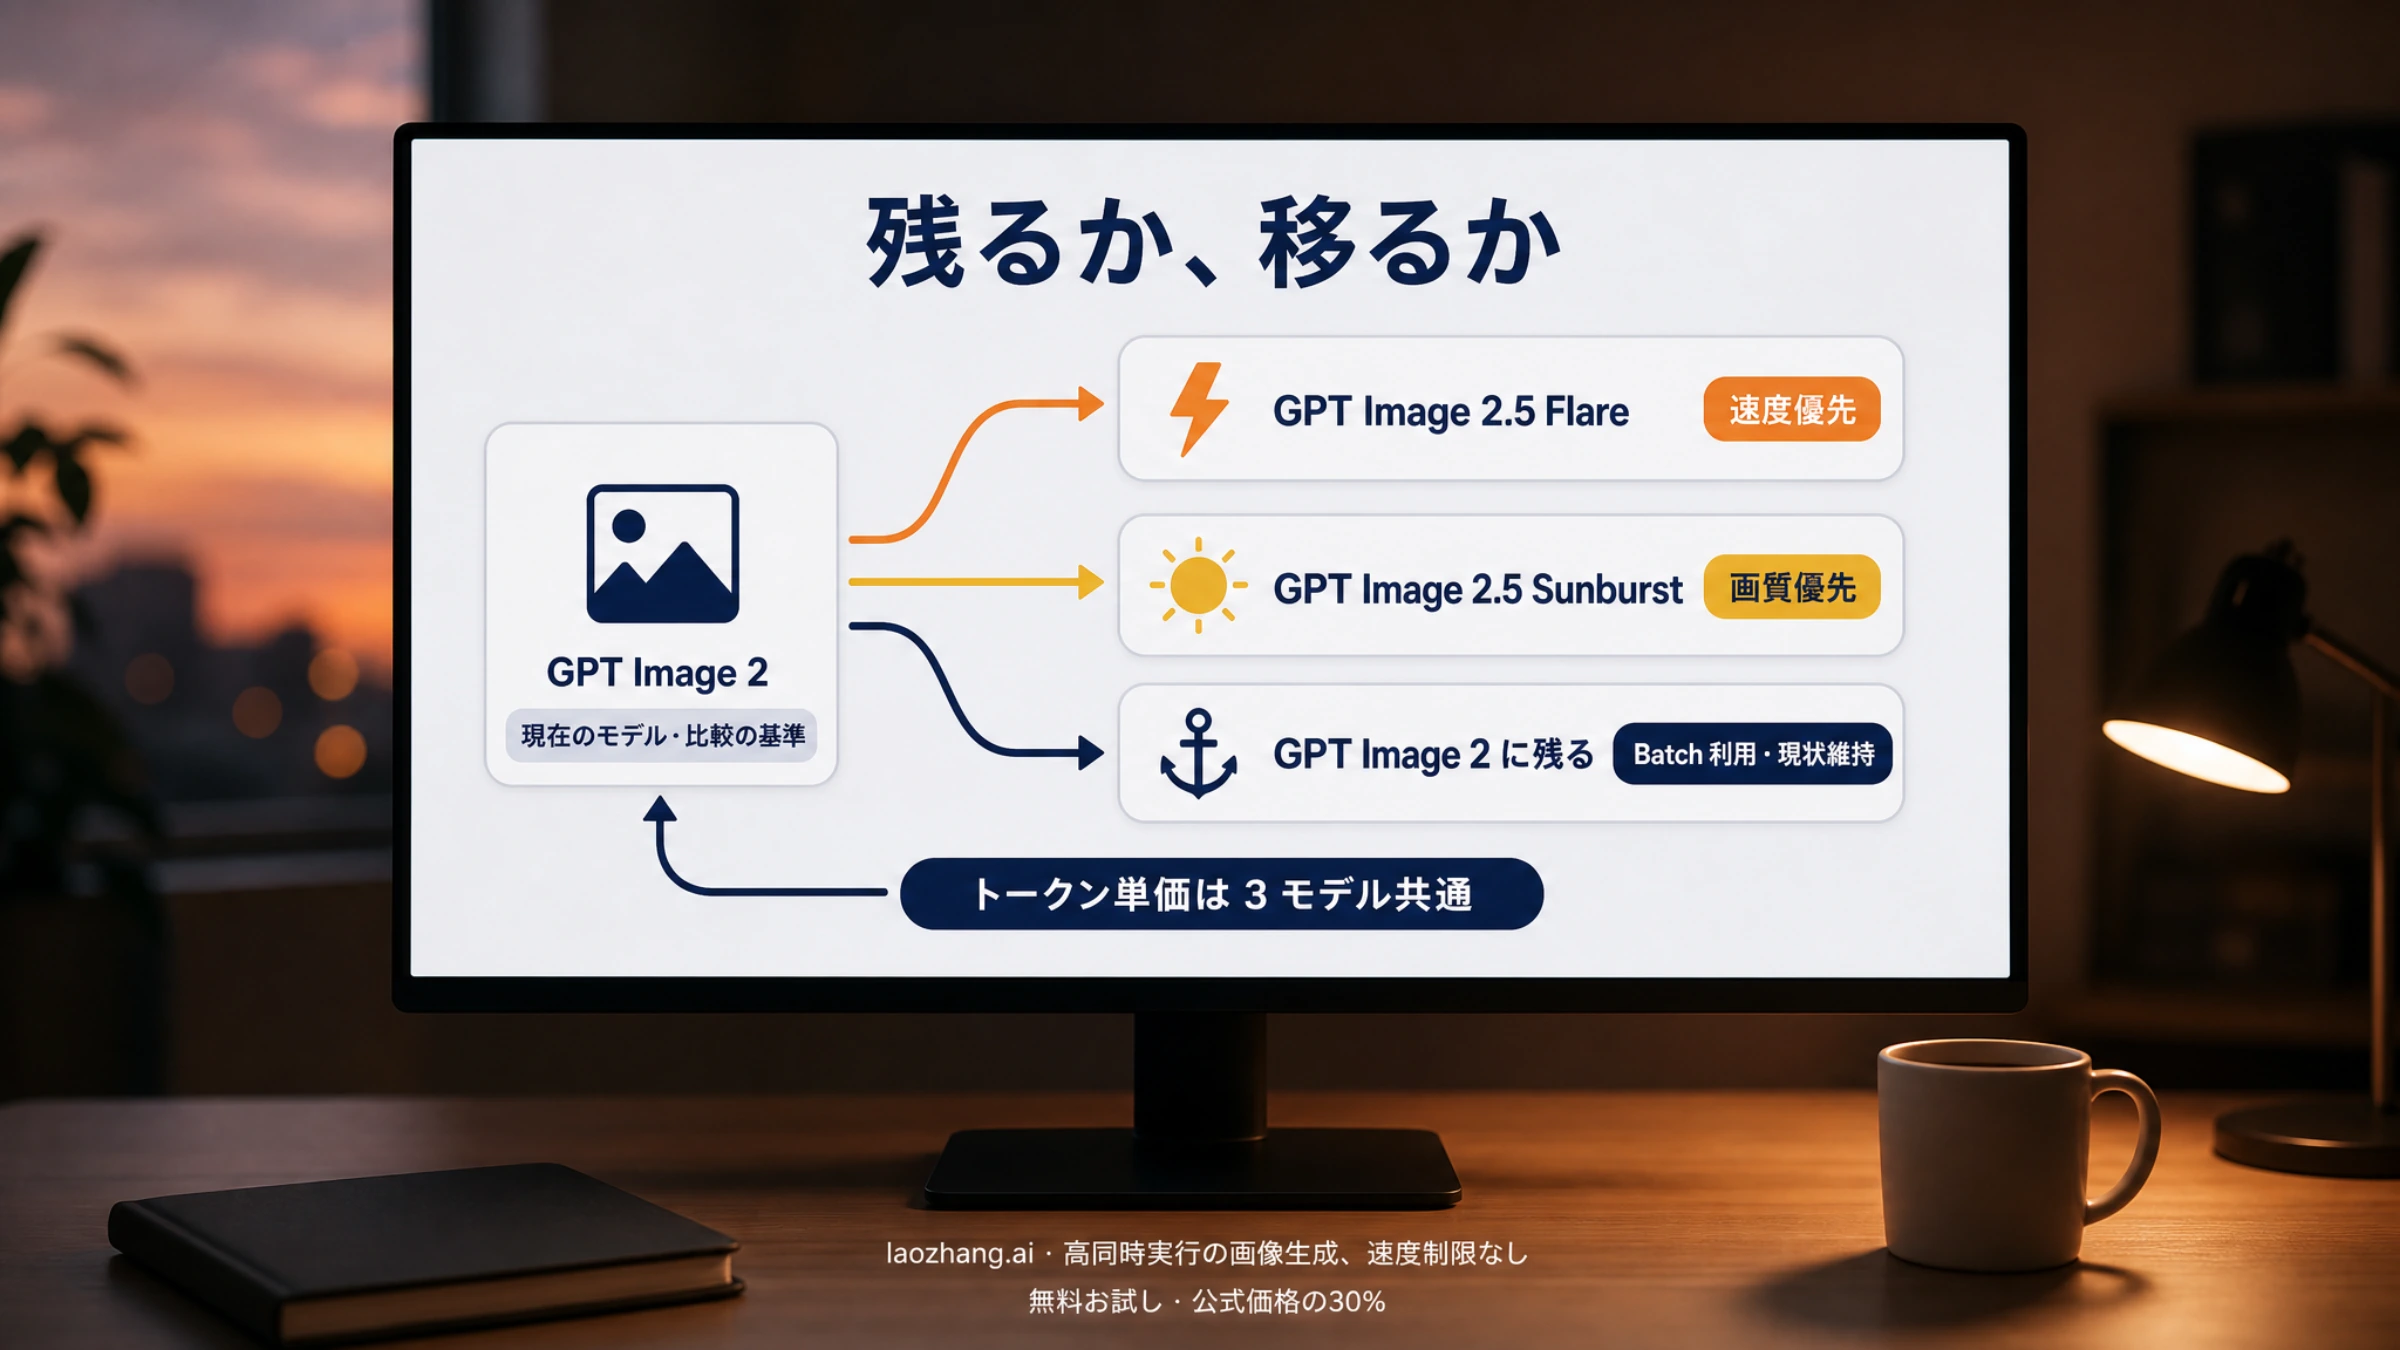
すでに gpt-image-2 で品質が合格している制作フローなら、まず gpt-image-2.5-flare を同じプロンプト・参照画像・サイズで試し、品質を保ったまま待ち時間が縮むかを確認します。GPT Image 2 では品質が足りない複雑な用途なら、先に gpt-image-2.5-sunburst で必要な品質に届くかを確かめ、届いたら同じ入力で Flare も試します。これはOpenAI のプロンプトガイドが示す順序で、Flare と Sunburst の 2 択ではなく「GPT Image 2 に残るか」を含めた 3 択として組まれています。GPT Image 2 に残る理由もはっきりしていて、Batch API の半額レートを使っている場合と、今の結果に不満がなく検証に工数を割けない場合です。
移行で最もつまずきやすいのは、料金ではなく品質設定の対応です。3 モデルのトークン単価は同じですが、quality: "medium" のままモデル ID だけを差し替えると、2048×1152 では出力トークンが 1,413 から 367 に減り、請求額も画の密度も変わります。公式計算機を 2026年9月22日に読んだ限りでは、2.5 の high が GPT Image 2 の medium、2.5 の max が GPT Image 2 の high と同じ出力予算です。本記事では、この対応表を含めて「何が変わり、何が変わらないか」を公式ページの記述と、投票数つきの独立ランキング、条件つきの第三者実測に分けて整理します。本サイト自身は有料 API のベンチマークを行っていません。
3つのモデルの位置づけ:公式の説明はどこまで一致しているか
OpenAI のモデル一覧にある現行の画像モデルは次の 3 つです。いずれもテキストと画像を入力に取り、生成・編集・インペインティングに対応します。gpt-image-2.5 という接尾辞なしの ID は存在せず、必ず -flare か -sunburst を付けて指定します。
| モデル ID | スナップショット | 公式の位置づけ | 品質設定 | Batch API |
|---|---|---|---|---|
gpt-image-2 | gpt-image-2-2026-04-21 | 性能「Higher」、速度「Medium」。比較の基準 | low / medium / high / auto | 対応 |
gpt-image-2.5-flare | gpt-image-2.5-flare-2026-09-08 | 速度「Very fast」。「高品質な日常的な画像生成向けの最速モデル」 | 上記に xhigh / max を追加 | 現時点で未掲載 |
gpt-image-2.5-sunburst | gpt-image-2.5-sunburst-2026-09-08 | 性能「Highest」、速度「Medium」。「画像生成と編集で最も高性能なモデル」 | 上記に xhigh / max を追加 | 現時点で未掲載 |
画質について、OpenAI 自身の表現は 2 通りあります。プロンプトガイドは Flare を「速度に最適化した小型モデルで、画質は GPT Image 2 と同程度」、Sunburst を「品質に最適化した基本モデルで、GPT Image 2 より高い画質」と説明し、両方とも「精密な編集と被写体の保持が改善」としています。一方、2026年9月8日の発表記事は Flare を「GPT-Image-2 より高品質な画像を 50% 低いレイテンシで生成する、ほとんどのアプリケーションの標準的な選択肢」と書き、Sunburst は「生成時間は長いが、細部の作り込みが必要な創作向けにもう一段の精度」としています。
「同程度」と「より高品質」のどちらが正しいかは、公式文書だけでは決められません。実務上の読み方としては、ガイドの控えめな表現を前提にするのが安全です。つまり Flare へ移る主目的は速度で、画質の向上は自分の素材で確認できたときだけ加点する、という扱いにします。「50% 低いレイテンシ」も OpenAI の主張であり、ガイドは「あるワークロードでの速度改善は、別のワークロードでの固定的な改善を保証しない」と明記しています。
GPT Image 2 はいつまで使えるか
移行を急ぐ必要があるかどうかは、非推奨ページを見れば分かります。2026年9月22日時点で、gpt-image-2 にも 2 つの 2.5 モデルにも非推奨の記載はありません。それどころか GPT Image 2 は、古いモデルの推奨移行先として指定されています。
gpt-image-1:2026年10月23日に API から削除。推奨移行先はgpt-image-2gpt-image-1.5、gpt-image-1-mini、chatgpt-image-latest:2026年6月2日に通知、2026年12月1日に削除。推奨移行先はgpt-image-2- DALL·E 2 / 3:2026年5月12日に停止済み
したがって、GPT Image 2 のワークフローを「終了前に逃がす」必要は今のところありません。移る動機は速度と編集精度の改善であって、期限ではないということです。ただし今日記載がないことは将来の保証ではないので、プロンプトガイドが言うように「サポートされている間は前のモデルをロールバック先として残す」運用にし、スナップショット ID gpt-image-2-2026-04-21 を明示して固定しておくと、意図しない切り替わりを防げます。
単価が同じでも費用は違う:品質ラダーのずれ
料金ページの Standard タブでは、3 モデルのトークン単価は完全に同じです。2.5 のモデルページにも「Token rates match GPT Image 2」と書かれています。
| 項目(Standard、100万トークンあたり) | gpt-image-2 | gpt-image-2.5-flare | gpt-image-2.5-sunburst |
|---|---|---|---|
| テキスト入力 | $5.00 | $5.00 | $5.00 |
| テキスト入力(キャッシュ) | $1.25 | $1.25 | $1.25 |
| 画像入力 | $8.00 | $8.00 | $8.00 |
| 画像入力(キャッシュ) | $2.00 | $2.00 | $2.00 |
| 画像出力 | $30.00 | $30.00 | $30.00 |
テキスト出力は課金されません。それでも 1 枚あたりの費用は同じにならない、というのが本題です。理由は、同じ品質ラベルでも消費する出力トークン数がモデルによって違うからです。公式ガイドは「同じ品質ラベルは、モデル間で同じ画質や応答時間を意味しない」と明言しています。公式計算機で 2026年9月22日に読み取った値は次のとおりです(出力トークンのみ。入力トークンとストリーミングの部分画像は含みません)。
| 品質設定 | GPT Image 2(1024×1024) | GPT Image 2.5(1024×1024) | GPT Image 2(2048×1152) | GPT Image 2.5(2048×1152) |
|---|---|---|---|---|
low | 196($0.00588) | 196($0.00588) | 157($0.00471) | 157($0.00471) |
medium | 1,756($0.05268) | 439($0.01317) | 1,413($0.04239) | 367($0.01101) |
high | 7,024($0.21072) | 1,756($0.05268) | 5,650($0.16950) | 1,413($0.04239) |
xhigh | 提供なし | 3,122($0.09366) | 提供なし | 2,511($0.07533) |
max | 提供なし | 7,024($0.21072) | 提供なし | 5,650($0.16950) |
読み方は単純で、2.5 のラダーは GPT Image 2 の low と medium の間に 2 段を挿入した形になっています。low は同じ予算、2.5 の high は GPT Image 2 の medium と同じ予算、2.5 の max は GPT Image 2 の high と同じ予算です。計算機は Sunburst と Flare を 1 つの選択肢にまとめているため、両者の出力トークンはこの見積もり上は区別されません。
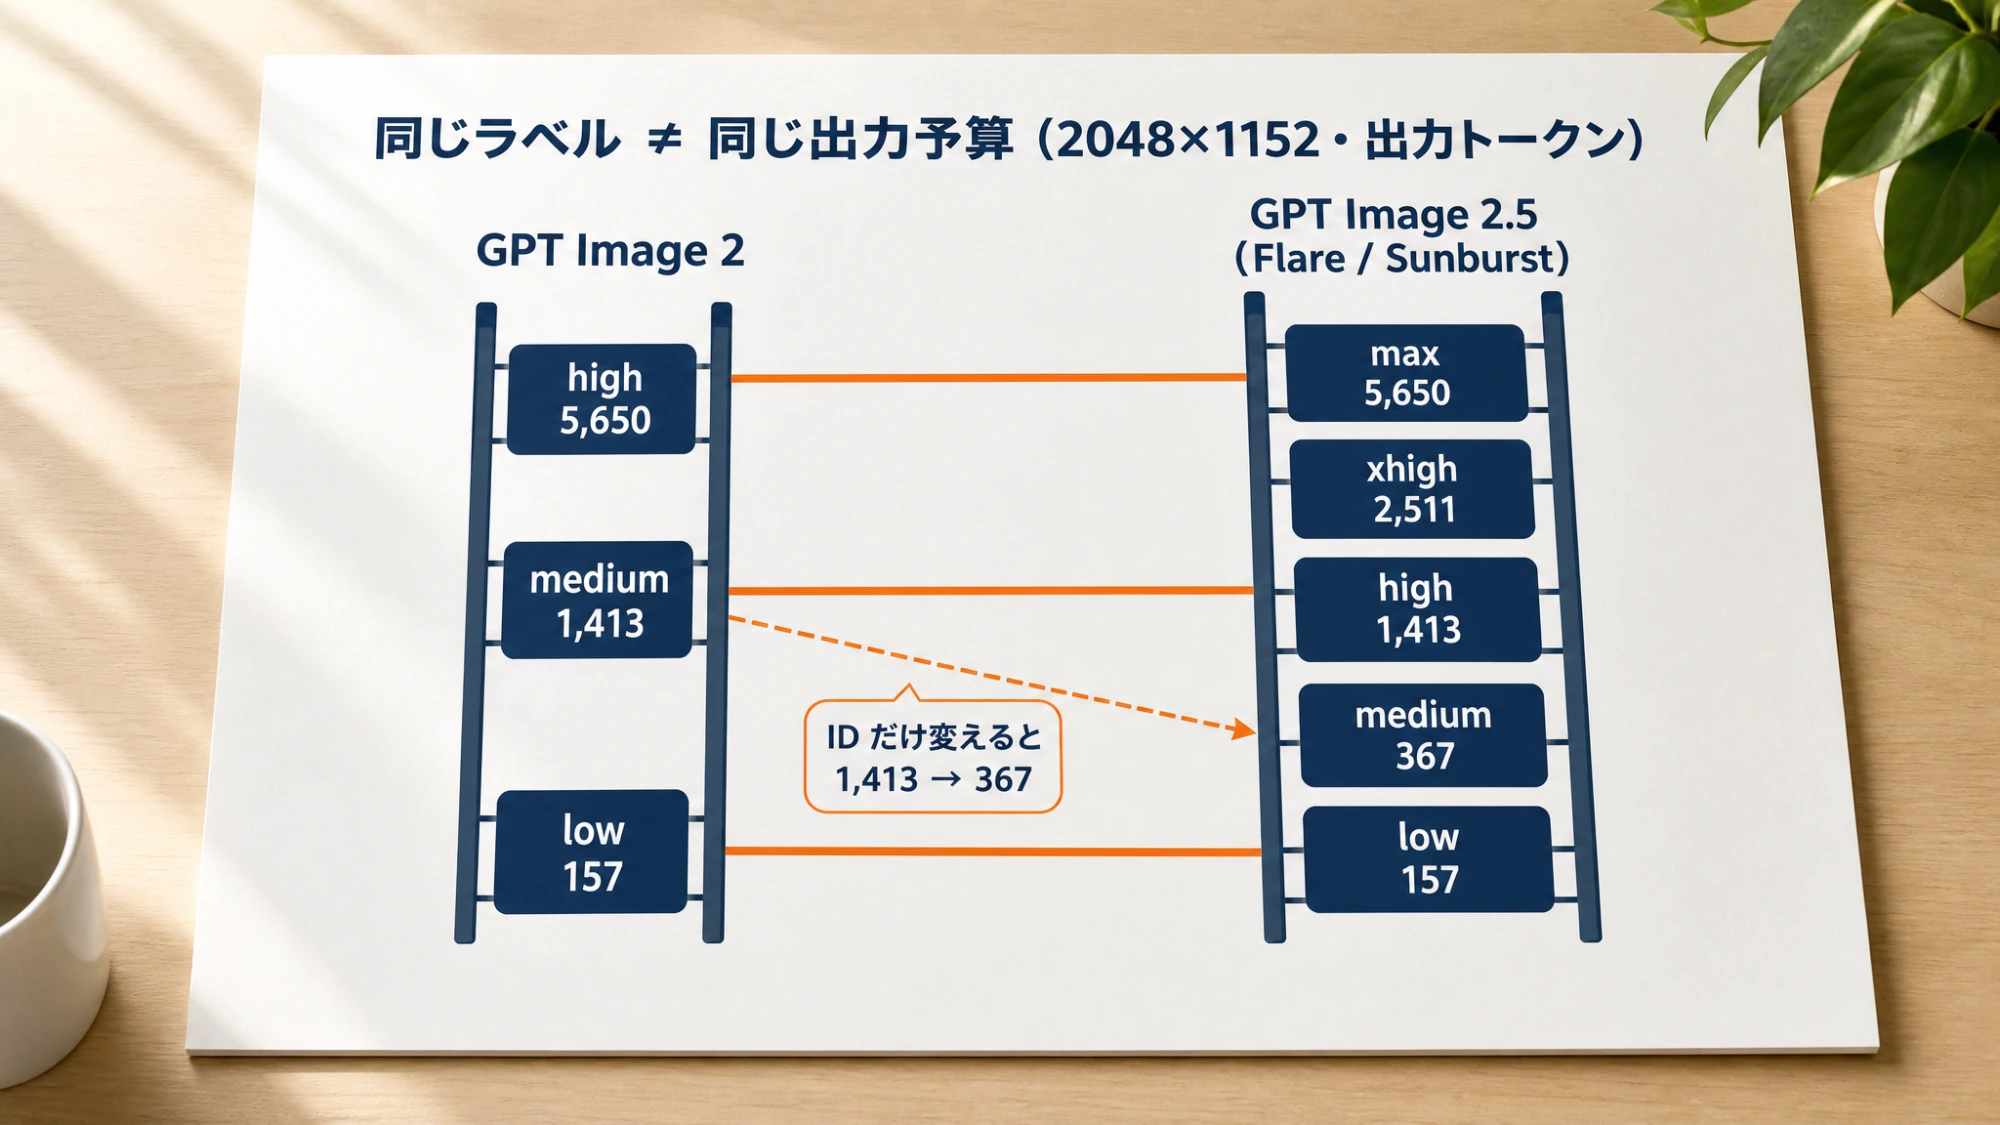
ここから 2 つの実務的な帰結が出ます。1 つ目は、モデル ID だけを変えて quality を据え置くと、実際には出力予算を約 4 分の 1(2048×1152 なら 1,413 → 367 トークン)に落として描かせていることになり、「2.5 にしたら画が簡素になった」「請求が急に減った」という現象はモデルの性質ではなく設定のずれで説明できることです。2 つ目は、公平に比べたいなら品質ラベルではなく出力トークン数を揃える必要があることです。GPT Image 2 の medium に対しては 2.5 の high、GPT Image 2 の high に対しては 2.5 の max を当てます。auto は計算機で見積もれないため、比較のときは明示的な品質を指定します。
「GPT Image 2.5 は GPT Image 2 の倍額」という比較記事も見かけますが、2026年9月22日に公式料金ページを読む限り、これは GPT Image 2 の Batch レートを Standard レートと取り違えたものです。Batch タブには画像モデルとして gpt-image-2 だけが載っていて、テキスト入力 $2.50、画像入力 $4.00、画像出力 $15.00(100万トークンあたり)と Standard の半額です。gpt-image-2 のモデルページは v1/batch を対応エンドポイントに含めていますが、2 つの 2.5 モデルページでは非対応の表示になっています。Batch で GPT Image 2 を安く回している場合、2.5 へ移ると単価は据え置きでも Batch 割引がなくなるので、移行判断はこの点を先に確認してください。「現時点で未掲載」であって、今後も対応しないという意味ではありません。GPT Image 2 の Batch 運用の詳細はGPT Image 2 API の料金比較にまとめています。
速度と画質の根拠:誰が、どの条件で測ったか
本サイトは今回モデル出力の比較を行っていないため、根拠は出所ごとに分けて示します。
OpenAI の主張。前述のとおり、発表記事は Flare について「50% 低いレイテンシ」、ChatGPT 側については「Images 2.0 と比べて画像生成のレイテンシを最大 50% 削減」としています。ガイドは自分のワークロードで測ることを求めています。
Arena(旧 LMArena)の人間投票。Text-to-Image リーダーボードでは、表示上の更新日 2026年9月7日の時点で、1 位 gpt-image-2.5-sunburst 1421 ±13(3,149 票、Preliminary)、2 位 gpt-image-2.5-flare 1399 ±13(2,856 票、Preliminary)、3 位 gpt-image-2(medium)1381 ±4(78,731 票)。Image Editでは 1 位 Sunburst 1520 ±9(6,704 票)、2 位 Flare 1491 ±9(5,676 票)、3 位 GPT Image 2(medium)1461 ±3(235,928 票)です。2.5 の 2 件は Preliminary 表示で票数が 1 桁少なく、GPT Image 2 の項目は medium 品質での登録です。ここには速度も費用も含まれません。
Artificial Analysis の人間投票。Text to Image リーダーボードでは、1 位 GPT Image 2.5 Sunburst(max)Elo 1197 ±9(13,401 比較)、2 位 Flare(max)1190 ±9(12,778 比較)、3 位 GPT Image 2(high)1171 ±9(15,176 比較)。同サイトの 1,000 枚あたり価格は $210.7 / $210.7 / $211.0 でほぼ同額です。これは 2.5 の max と GPT Image 2 の high を並べた比較で、上の計算機で見た 7,024 トークンの等予算と整合しています。
Tosea.ai の実測(2026年9月9日公開)。同社の完全ガイドは、公式 API の images/edits を 41 回呼び、構成案のプロンプトにブランドテンプレートの参照画像 1〜3 枚を添えてビジネススライドを生成する条件で、2048×1152 と 3840×2160 の 2 サイズ、単発・再試行なし、5 ページ平均で測っています。要点は次のとおりです。
- 2048×1152 の出力トークンは公式計算機と完全に一致(GPT Image 2 の low/medium/high が 157 / 1,413 / 5,650、2.5 が 157 / 367 / 1,413 / 2,511 / 5,650)
- 1,413 トークンで揃えた比較:GPT Image 2
medium37.3 秒、Sunbursthigh27.7 秒、Flarehigh19.7 秒。Flare が 47%、Sunburst が 26% 短縮で、1 ページあたり約 $0.059 は 3 者同じ - 5,650 トークンで揃えた比較:82.9 秒 / 59.8 秒 / 33.7 秒
- 4K(3840×2160):GPT Image 2
highは 13,342 トークンで 92.4 秒、約 $0.42。2.5 のhighは 3,336 トークンで 27.8〜33.8 秒、約 $0.12。2.5 のmaxは 13,342 トークン - 連続編集 1 回 / 2 回 / 3 回後の変化画素率:GPT Image 2 5.6 / 8.1 / 11.4%、Sunburst 4.1 / 6.8 / 9.9%、Flare 3.8 / 6.7 / 9.2%。9 回の編集は 3 モデルとも全て成功
- 15 枚のスライドの文字と数値は 3 モデルとも全て正しく、2.5 だけが成功して GPT Image 2 が失敗したケースはなし
- 2.5 の
autoは 5 回中 4 回が 1,413 トークンの段に着地し、1 回だけ 628
この結果は、密度の高いビジネススライドという 1 つの領域に限られ、人物写真の同一性保持、透過背景、マスク指定のインペインティングは含まれていません。p95 のような遅い側の分布も出ていません。それでも「等予算なら 2.5 は速く、連続編集の崩れが少ない」という OpenAI の主張の方向と一致する、条件が明示された数少ない公開データです。自分の用途が違うなら、この数字をそのまま当てはめず、次節の手順で自分の素材を測ってください。
どれを選ぶか:判断を変える条件
3 択の判断は、次の条件で分岐します。
| 状況 | まず試すモデル | 理由 |
|---|---|---|
| GPT Image 2 で品質が合格し、待ち時間を減らしたい | gpt-image-2.5-flare | 公式ガイドの移行表の第 1 行。等予算で速度改善が得られるかを確認する |
| GPT Image 2 では品質が届かない複雑な編集・細部の作り込み | gpt-image-2.5-sunburst | 公式ガイドの第 2 行。まず品質に届くかを確定し、届いたら同じ入力で Flare も試す |
| 連続編集で被写体や商品の形が崩れるのが課題 | Sunburst または Flare | 両モデルとも「精密な編集と被写体の保持が改善」(公式)。Tosea の実測ではどちらも GPT Image 2 より変化画素率が低い |
| Batch API の半額レートで大量生成している | gpt-image-2 に残る | Batch は現時点で gpt-image-2 のみ。2.5 では Standard 単価になる |
| 現状に不満がなく、検証に割く時間がない | gpt-image-2 に残る | 非推奨の記載はなく、古いモデルの推奨移行先。急ぐ理由がない |
xhigh / max が必要になる用途 | 2.5 のどちらか | GPT Image 2 は high まで。max は GPT Image 2 の high と同じ予算で、上位の画質段を試したいときだけ使う |
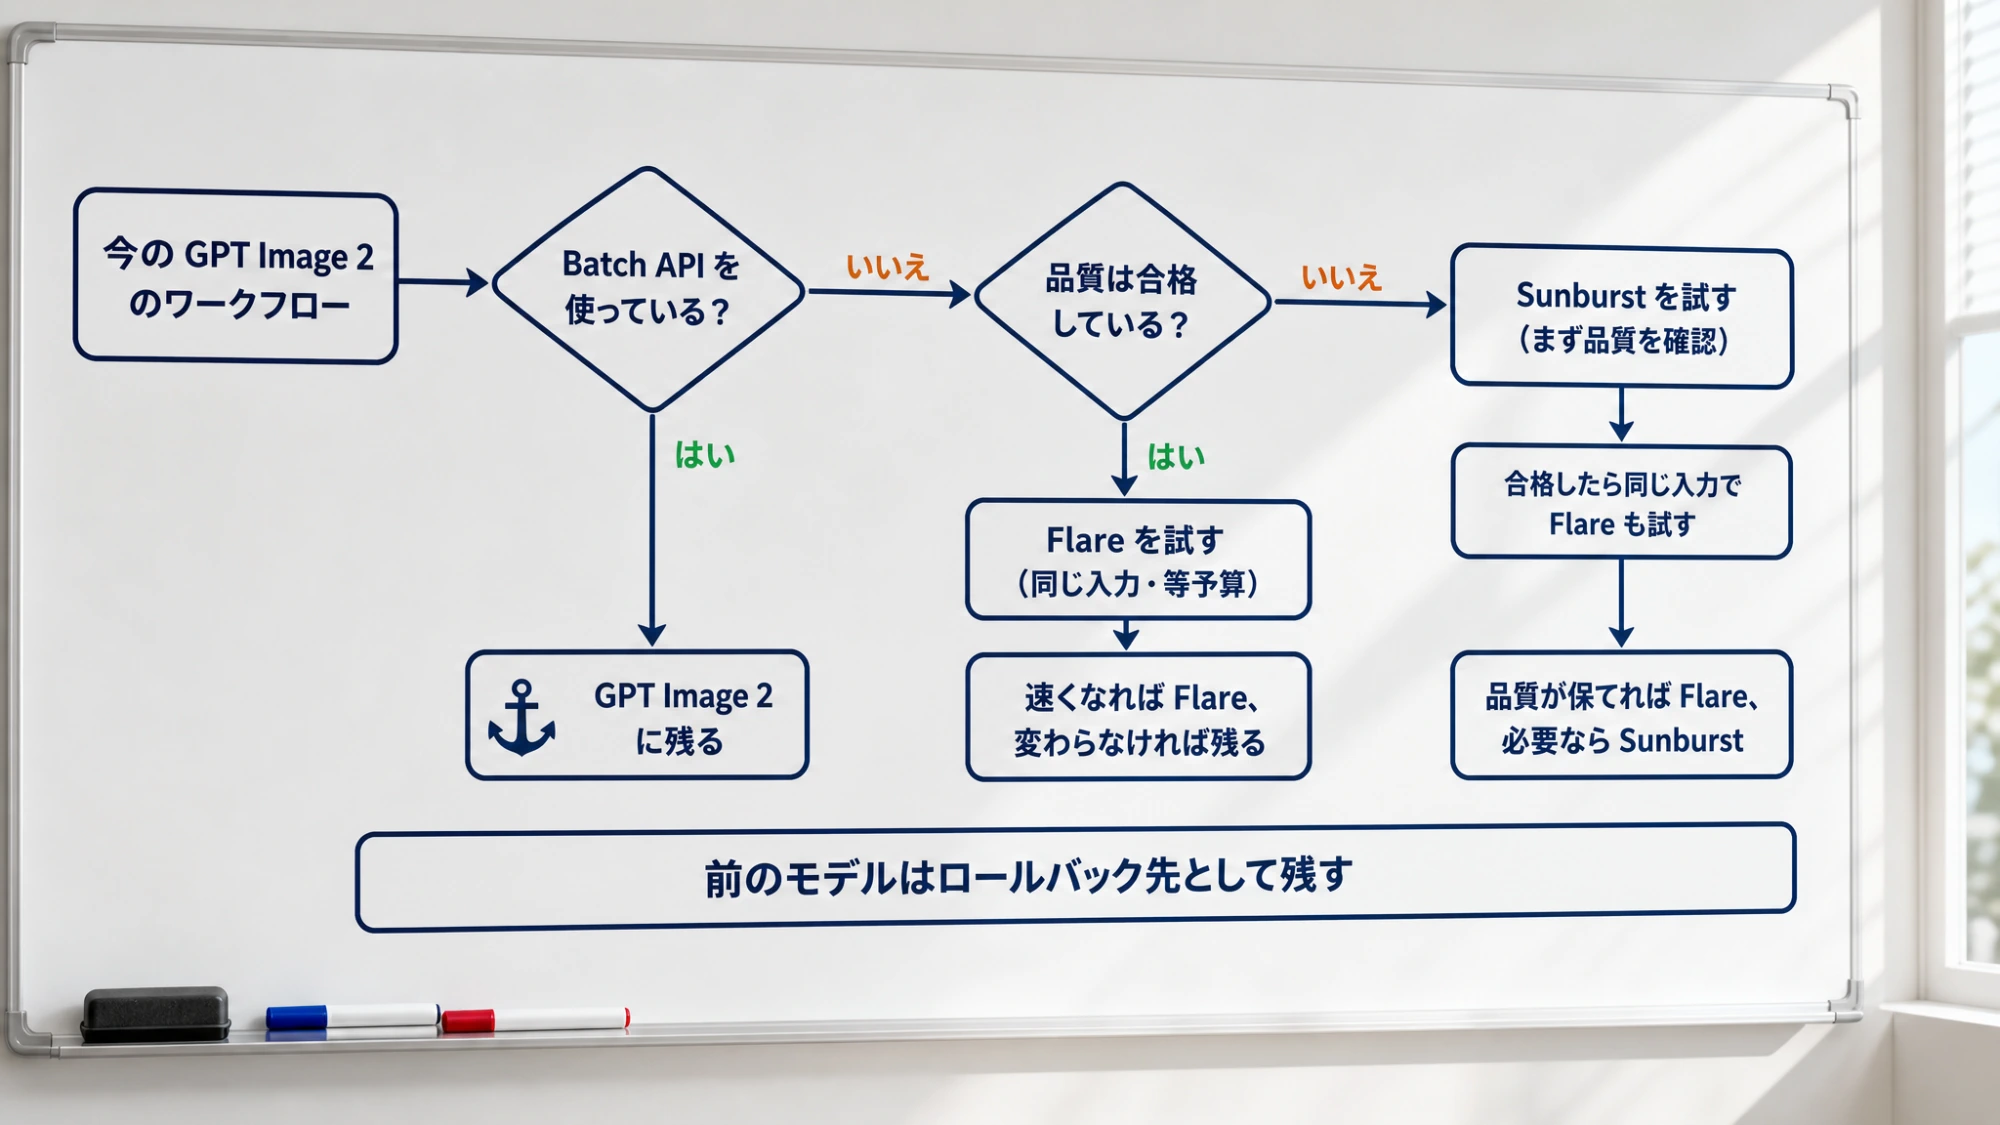
Flare と Sunburst のどちらにするかは、Sunburst で合格したうえで Flare が「品質を保ったまま速くなる」かどうかで決まります。ガイドはこの順序を「品質が通った後に速度の改善を試す」と表現しており、Sunburst の品質優位が必要なら Sunburst を残すとしています。2.5 内での選び方と商品画像の編集精度の見方は、Flare と Sunburst の比較記事にまとめています。
移行手順:出力予算を変えずに比べる
以下は公式の「既存ワークフローの移行」手順を、品質ラダーの対応を組み込んだ形にしたものです。
- 基準を保存する。本番で使っている代表的なプロンプトと参照画像を集めます。難しい編集、正確な文字、顔、商品の形状、透過アセットを必ず含め、現在のモデル・リクエスト設定・結果を記録します。
- 最初の候補を決める。前節の表に従い、Flare か Sunburst を選びます。
- 等予算に置き換える。最初の比較では、プロンプト・参照画像・サイズ・出力形式を変えず、品質だけを対応表で読み替えます。GPT Image 2 の
mediumを測っていたなら 2.5 はhigh、highならmax、lowはlowのまま。autoで運用していた場合は、比較の間だけ明示的な値に固定します。 - 結果を全体で確認する。指示の追従、人物や商品の同一性、文字の正確さ、意図しない変更、透過の有無を見ます。同じリクエストを繰り返して安定性を測り、編集ワークフローなら連続する編集の全体も試します。
- 品質が通ってから速度を試す。Sunburst から始めた場合は、同じ要件で Flare を評価し、品質が許容範囲かつ待ち時間が改善するときだけ切り替えます。
- 設定は 1 つずつ動かす。プロンプトを書き換える前に品質段を比べ、典型的な応答時間と遅い応答、失敗、再試行、採用画像 1 枚あたりの費用を測ります。速いモデルが安いとは決めつけず、現在の料金を確認します。
- ワークフロー単位で段階的に切り替える。受け入れ基準を通ったら少量のトラフィックから移し、同じ指標を監視しながら広げます。前のモデルはロールバック先として残します。
リクエストで変えるのは model と quality の 2 箇所です。Images API での最小の例を示します。
bash# 比較前(GPT Image 2、2048×1152 の medium = 出力 1,413 トークンの見積もり)
curl https://api.openai.com/v1/images/generations \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2-2026-04-21",
    "prompt": "…同じプロンプト…",
    "size": "2048x1152",
    "quality": "medium"
  }'

# 比較後(Flare、同じ出力予算にするには high を指定)
curl https://api.openai.com/v1/images/generations \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2.5-flare-2026-09-08",
    "prompt": "…同じプロンプト…",
    "size": "2048x1152",
    "quality": "high"
  }'
実際の請求は計算機の見積もりではなく、レスポンスの usage で確認します。入力トークン(プロンプトと参照画像)が加わり、ストリーミングで部分画像を受け取る場合は 1 枚ごとに出力 100 トークンが追加されます。
採用画像 1 枚あたりの費用は「課金された試行の合計(入力+出力+部分画像+再試行)÷ 採用した枚数」で出します。仮の例として、2048×1152 の 2.5 high で出力が 1 回 $0.0424、プロンプトと参照画像 1 枚の入力が 1 回 $0.01 かかると仮定し、10 回生成して 8 枚を採用すれば、(0.0424 + 0.01) × 10 ÷ 8 ≈ $0.066 です。採用率が 5 枚に落ちれば同じ生成費用で約 $0.105 になります。単価が同じ 3 モデルの間で差が出るのは、まさにこの採用率と再試行の回数です。採用が 0 枚なら費用は定義できないので、その設定は不合格として扱います。生成した枚数と採用した枚数を分けて数えるのは、この計算のためです。
透過アセットを扱っているなら、比較でも background: "transparent" と PNG または WebP の出力を明示し、デコード後のアルファチャンネルを髪・ガラス・影・輪郭で確認します。GPT Image 2 のリファレンスでは透過背景は「プレビュー提供」の扱いなので、既存の透過ワークフローは移行で挙動が変わりやすい部分です。設定と検証手順はGPT Image 2.5 での背景透過を参照してください。
よくある質問
GPT Image 2 から 2.5 へ移ると料金は上がりますか
トークン単価は上がりません。Standard レートは 3 モデルとも同じです。変わるのは同じ品質ラベルで消費される出力トークン数で、quality を据え置けば 2.5 の方が少なく(安く)なり、等予算に読み替えれば同じ金額になります。上がるケースは 1 つで、GPT Image 2 を Batch API の半額レートで使っていた場合です。2.5 は現時点で Batch に掲載されていないため、Standard 単価での請求になります。
gpt-image-2.5 というモデル ID は使えますか
使えません。公式のモデル一覧にあるのは gpt-image-2.5-flare と gpt-image-2.5-sunburst の 2 つで、日付つきのスナップショットはそれぞれ gpt-image-2.5-flare-2026-09-08、gpt-image-2.5-sunburst-2026-09-08 です。本番では日付つきの ID を固定しておくと、ロールバックのときに何と比べたかが明確になります。
Responses API の image_generation ツールでも 2.5 を指定できますか
できます。公式の画像生成ガイドには tools: [{ type: "image_generation", model: "gpt-image-2.5-sunburst" }] の例があり、モデルページも「Image API で直接、または Responses API の画像生成ツールのモデルとして選択」と書いています。Responses 経由では、画像モデルのトークンに加えてメインラインモデルのトークンも課金される点に注意してください。発売直後の第三者記事に「Responses ツールでは未対応」とあるのは、その時点の情報です。
移行したら画像が簡素になった、または粒状感が出たときは
まず quality を確認します。モデル ID だけを変えて medium のままなら、出力予算が 1,413 から 367 トークン(2048×1152)に落ちているので、high に上げると GPT Image 2 の medium と同じ予算に戻ります。それでも粒状ノイズや色むらが残るときは、ダウンロードした元画像と編集後を見比べ、圧縮や繰り返し編集の影響を切り分けます。手順はGPT Image 2.5 の画像がざらつくときの対処にあります。
移行の効果は何で判断すればよいですか
公式ガイドが挙げる指標は、典型的な応答時間と遅い応答、失敗、再試行、採用画像 1 枚あたりの費用です。等予算で比べたうえで、この 4 つが同等か改善していれば移行の根拠になります。速度だけ改善して採用率が落ちた場合、採用画像 1 枚あたりの費用は上がることがあるので、単一の指標で決めないでください。