Claude 構造化出力の使い方:400になる指定と強制されない制約
Claude の構造化出力は output_config.format で指定します。minimum は 400、minLength は守られない例があり、自前の検証が必要です。
目次
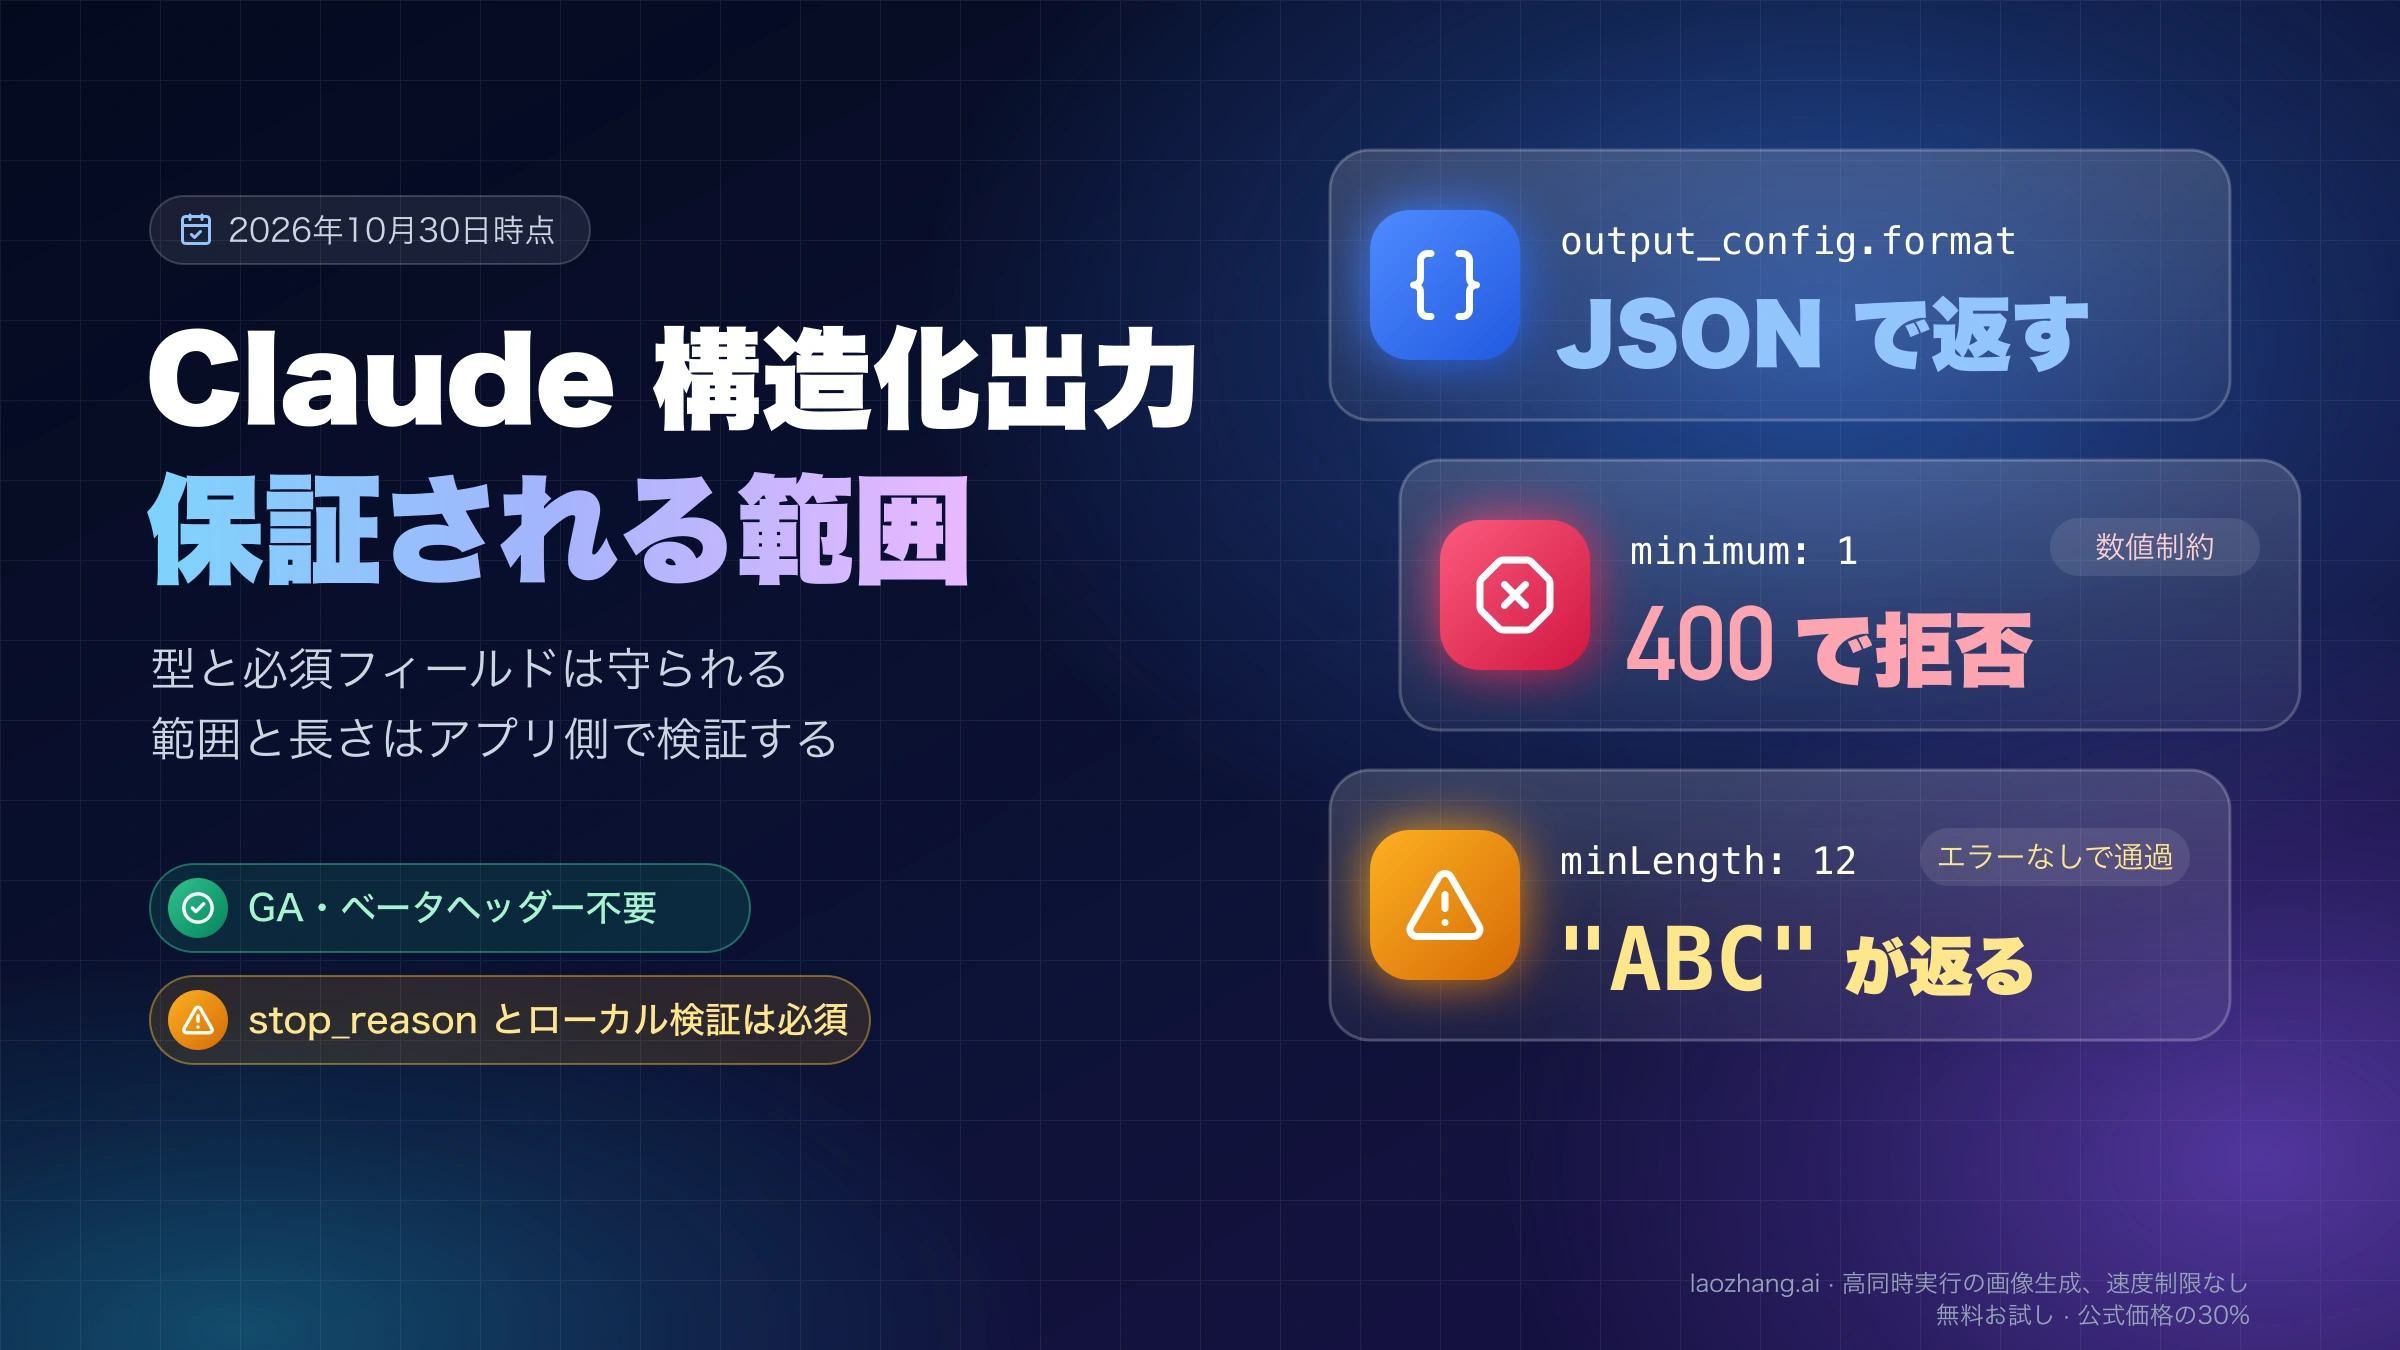
Claude に JSON だけを確実に返させるには、Messages API のリクエストに output_config.format を追加し、type: "json_schema" と JSON Schema を渡します。2026年10月30日時点でこの構造化出力(Structured outputs)は一般提供(GA)で、ベータヘッダーは不要です。JSON は content の text ブロックに文字列で入り、Python の client.messages.parse()(Pydantic)や TypeScript の zodOutputFormat()(Zod)を使えば、パースと検証まで SDK が行います。独立した「JSON モード」はなく、ツールの引数を型どおりにしたいときはツール定義の strict: true を使います。
ただし「常に有効な JSON」が保証するのは、型と必須フィールドまでです。minimum や自己参照する $ref を含むスキーマは 400 で拒否され、拒否応答(stop_reason: "refusal")や max_tokens での打ち切りでは JSON そのものが壊れます。2026年10月30日に LaoZhang API 経由で試したところ、minLength: 12 を指定したスキーマがエラーなく通り、そのまま 3 文字の "ABC" が返ってきました。stop_reason の確認と、Pydantic や Zod によるローカル検証は省けません。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
古い記事にある最上位フィールド output_format は非推奨で、Anthropic の API ではベータヘッダー structured-outputs-2025-11-13 を付ければまだ動き、付けなければ 400 になります。一方、同じ日に試したプロキシでは、ヘッダーの有無にかかわらず 400 にならず、スキーマが黙って捨てられて普通の文章が返りました。JSON のつもりで文章が返ってきたら、まず usage.input_tokens がスキーマなしのときより増えているかを見てください。
output_config.format の最小リクエストと JSON の取り出し方
cURL で試す場合は、通常の Messages API リクエストに output_config.format を足すだけです。返ってきた JSON は content[0].text に文字列として入っているので、JSON.parse() や json.loads() で読み込みます。次のリクエストは Anthropic の構造化出力ドキュメントの例を、安価な Haiku 5.5 に置き換えたものです。
curl https://api.anthropic.com/v1/messages \
  -H "content-type: application/json" \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -d '{
    "model": "claude-haiku-5-5",
    "max_tokens": 1024,
    "messages": [
      {
        "role": "user",
        "content": "Extract the key information from this email: John Smith (john@example.com) is interested in our Enterprise plan and wants to schedule a demo for next Tuesday at 2pm."
      }
    ],
    "output_config": {
      "format": {
        "type": "json_schema",
        "schema": {
          "type": "object",
          "properties": {
            "name": {"type": "string"},
            "email": {"type": "string"},
            "plan_interest": {"type": "string"},
            "demo_requested": {"type": "boolean"}
          },
          "required": ["name", "email", "plan_interest", "demo_requested"],
          "additionalProperties": false
        }
      }
    }
  }'
2026年10月30日に、同じリクエストを LaoZhang API の Anthropic 互換エンドポイント(https://api.laozhang.ai/v1/messages、ヘッダーは上と同じ x-api-key 方式)へ送ると、3.61 秒で HTTP 200 が返りました。レスポンスの要点は次のとおりです。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
{
  "content": [
    {
      "type": "text",
      "text": "{\"demo_requested\": true, \"email\": \"john@example.com\", \"name\": \"John Smith\", \"plan_interest\": \"Enterprise\"}"
    }
  ],
  "stop_reason": "end_turn",
  "usage": { "input_tokens": 333, "output_tokens": 46 }
}
text の中身はオブジェクトではなく JSON 文字列なので、取り出したあとに一度パースする必要があります。キーの並びがスキーマと違うのは、この経路で毎回見られた挙動で、後述のとおり順序には頼らない作りにします。Anthropic 直結の API で同じ順序になるかは、この結果からは言えません。
Python と TypeScript:messages.parse() で検証まで任せる
SDK を使うなら、スキーマを手書きせず、Python は Pydantic、TypeScript は Zod で型を定義して client.messages.parse() に渡すのが Anthropic の推奨です。SDK は API が受け付けない制約をスキーマから外して送り、返ってきた JSON を元の型で検証して parsed_output に入れます。ここで使う Python の引数名 output_format は parse() ヘルパーの引数で、非推奨になったリクエスト本体の最上位フィールドとは別物です。
次の Python コードは、2026年10月30日に anthropic Python SDK 2.3.0 で実行したものです。範囲や長さの制約をわざと入れています。
from typing import Literal, Optional

import anthropic
from pydantic import BaseModel, Field, ValidationError


class Lead(BaseModel):
    name: str = Field(min_length=2)
    email: str
    plan: Literal["Starter", "Team", "Enterprise"]
    seats: int = Field(ge=1, le=500)
    phone: Optional[str] = None


client = anthropic.Anthropic()  # 環境変数 ANTHROPIC_API_KEY を使用

try:
    resp = client.messages.parse(
        model="claude-haiku-5-5",
        max_tokens=512,
        messages=[{
            "role": "user",
            "content": "John Smith (john@example.com) wants the Enterprise plan for 40 seats.",
        }],
        output_format=Lead,
    )
    print(resp.parsed_output)
except ValidationError as e:
    # 制約違反はここで捕まえる(再試行するか、人の確認に回す)
    print(e)
同じ日に LaoZhang API 経由(anthropic.Anthropic(base_url="https://api.laozhang.ai"))で実行すると、parsed_output に name='John Smith'、plan='Enterprise'、seats=40、phone=None が入り、入力は 489 トークンでした。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
送信前に SDK が何をしているかは、from anthropic import transform_schema の transform_schema(Lead) で確認できます。同じ日の出力では、name の min_length=2 が説明文 "{minLength: 2}" に、seats の ge=1, le=500 が "{maximum: 500, minimum: 1}" に移され、制約そのものはスキーマから消えていました。phone は anyOf で文字列か null を許す任意フィールドになり、オブジェクトには additionalProperties: false が追加されています。つまり Claude には制約が「お願い」として伝わるだけで、守らせているのは SDK の検証です。
実際に、「0 seats」と書いた依頼文で同じ Lead を使うと、API は seats: 0 を返し、SDK が pydantic の ValidationError(Input should be greater than or equal to 1)を送出しました。API の応答自体は正常に終わっているので、この例外を捕まえなければ処理が止まります。
TypeScript では、Zod スキーマを zodOutputFormat() で包んで output_config.format に渡します。次は Anthropic のドキュメントにある書き方で、上の Python のような実測はしていません。
import Anthropic from "@anthropic-ai/sdk";
import { z } from "zod";
import { zodOutputFormat } from "@anthropic-ai/sdk/helpers/zod";

const ContactInfo = z.object({
  name: z.string(),
  email: z.string(),
  plan_interest: z.string(),
  demo_requested: z.boolean(),
});

const client = new Anthropic();

const response = await client.messages.parse({
  model: "claude-haiku-5-5",
  max_tokens: 1024,
  messages: [{ role: "user", content: "Extract the key information from this email: ..." }],
  output_config: { format: zodOutputFormat(ContactInfo) },
});

console.log(response.parsed_output);
生の JSON Schema を変換する jsonSchemaOutputFormat() もありますが、ドキュメントによればこちらはスキーマを変換するだけで、レスポンスの検証はしません。Java SDK は変換せず、非対応の制約をローカルで拒否します。
JSON 出力か strict ツールか:保証される場所で選ぶ
最終的な回答そのものを JSON にしたいなら output_config.format(JSON 出力)、Claude にツールを呼ばせてその引数を型どおりにしたいならツールの strict: true(厳密なツール使用)を選びます。両方を同じリクエストで併用でき、ツールを呼びながら作業し、最後の報告だけを決まった JSON で返すエージェントではこの組み合わせになります。
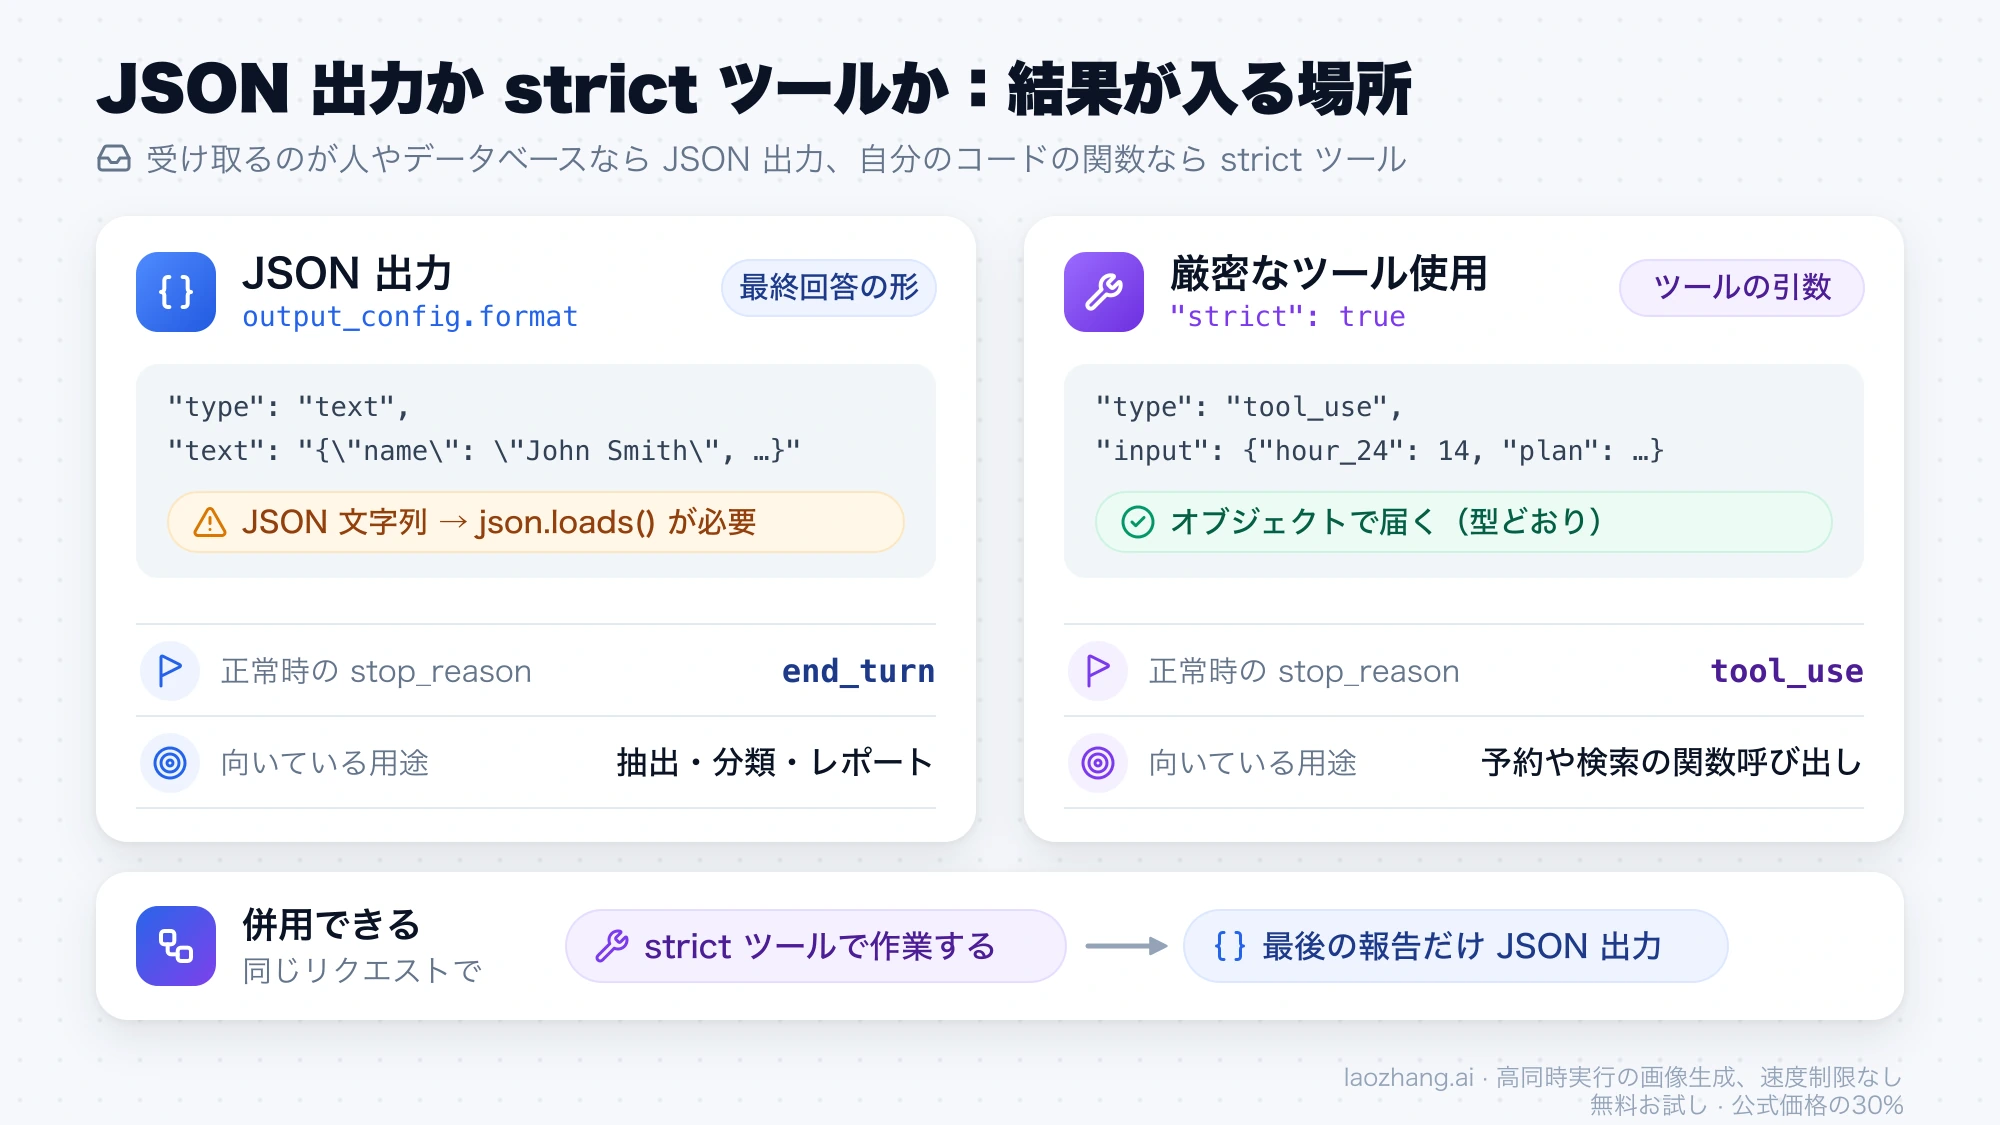
| 観点 | JSON 出力 | 厳密なツール使用 |
|---|---|---|
| 指定する場所 | リクエストの output_config.format | tools 内の各ツール定義に strict: true |
| 形が保証されるもの | Claude の最終回答 | ツール名とツールの input |
| 結果が入る場所 | text ブロック(JSON 文字列) | tool_use ブロックの input(オブジェクト) |
正常時の stop_reason | end_turn | tool_use |
| 向いている用途 | 抽出、分類、レポート、エージェントの最終出力 | 予約や検索などの関数呼び出し、エージェントのループ |
| 使えるスキーマ | 共通(次の節の表を参照) | 共通(1 リクエストで strict ツールは 20 個まで) |
Anthropic の厳密なツール使用ドキュメントは、passengers を整数で受け取りたいときに strict なしでは "two" や "2" が来ることがあり、strict ありなら常に 2 になる、という例で違いを説明しています。2026年10月30日に LaoZhang API 経由で、plan と weekday を enum、hour_24 を整数、email を format: "email" にした strict ツール create_demo_booking を tool_choice で強制したところ、stop_reason: "tool_use" で {"email": "john@example.com", "hour_24": 14, "plan": "Enterprise", "weekday": "Tue"} が返りました。「next Tuesday at 2pm」が "Tue" と 14 に正しく変換されています。入力はツール定義の分だけ増えて 682 トークンでした。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
判断に迷う場合は、その JSON を受け取るのが「人やデータベース」なら JSON 出力、「自分のコードの関数」なら strict ツールと考えると整理できます。OpenAI の API で同じ使い分けを考える場合は、「Structured OutputsとFunction Callingの違い:最終JSONとツール実行の使い分け」で扱っています。
400 になるスキーマ指定と、通っても守られない指定
公式ドキュメントでは、minimum などの数値制約、minLength などの文字列制約、再帰スキーマ、false 以外の additionalProperties は非対応で、使うと 400 エラーになると説明されています。ところが 2026年10月30日に LaoZhang API 経由で試すと、数値制約と再帰は説明どおり 400 になった一方、文字列長の制約は 400 にならずに通り、しかも守られませんでした。経路によって「拒否される」と「黙って無視される」が分かれるので、制約はどちらの場合もコードで検証する前提にします。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
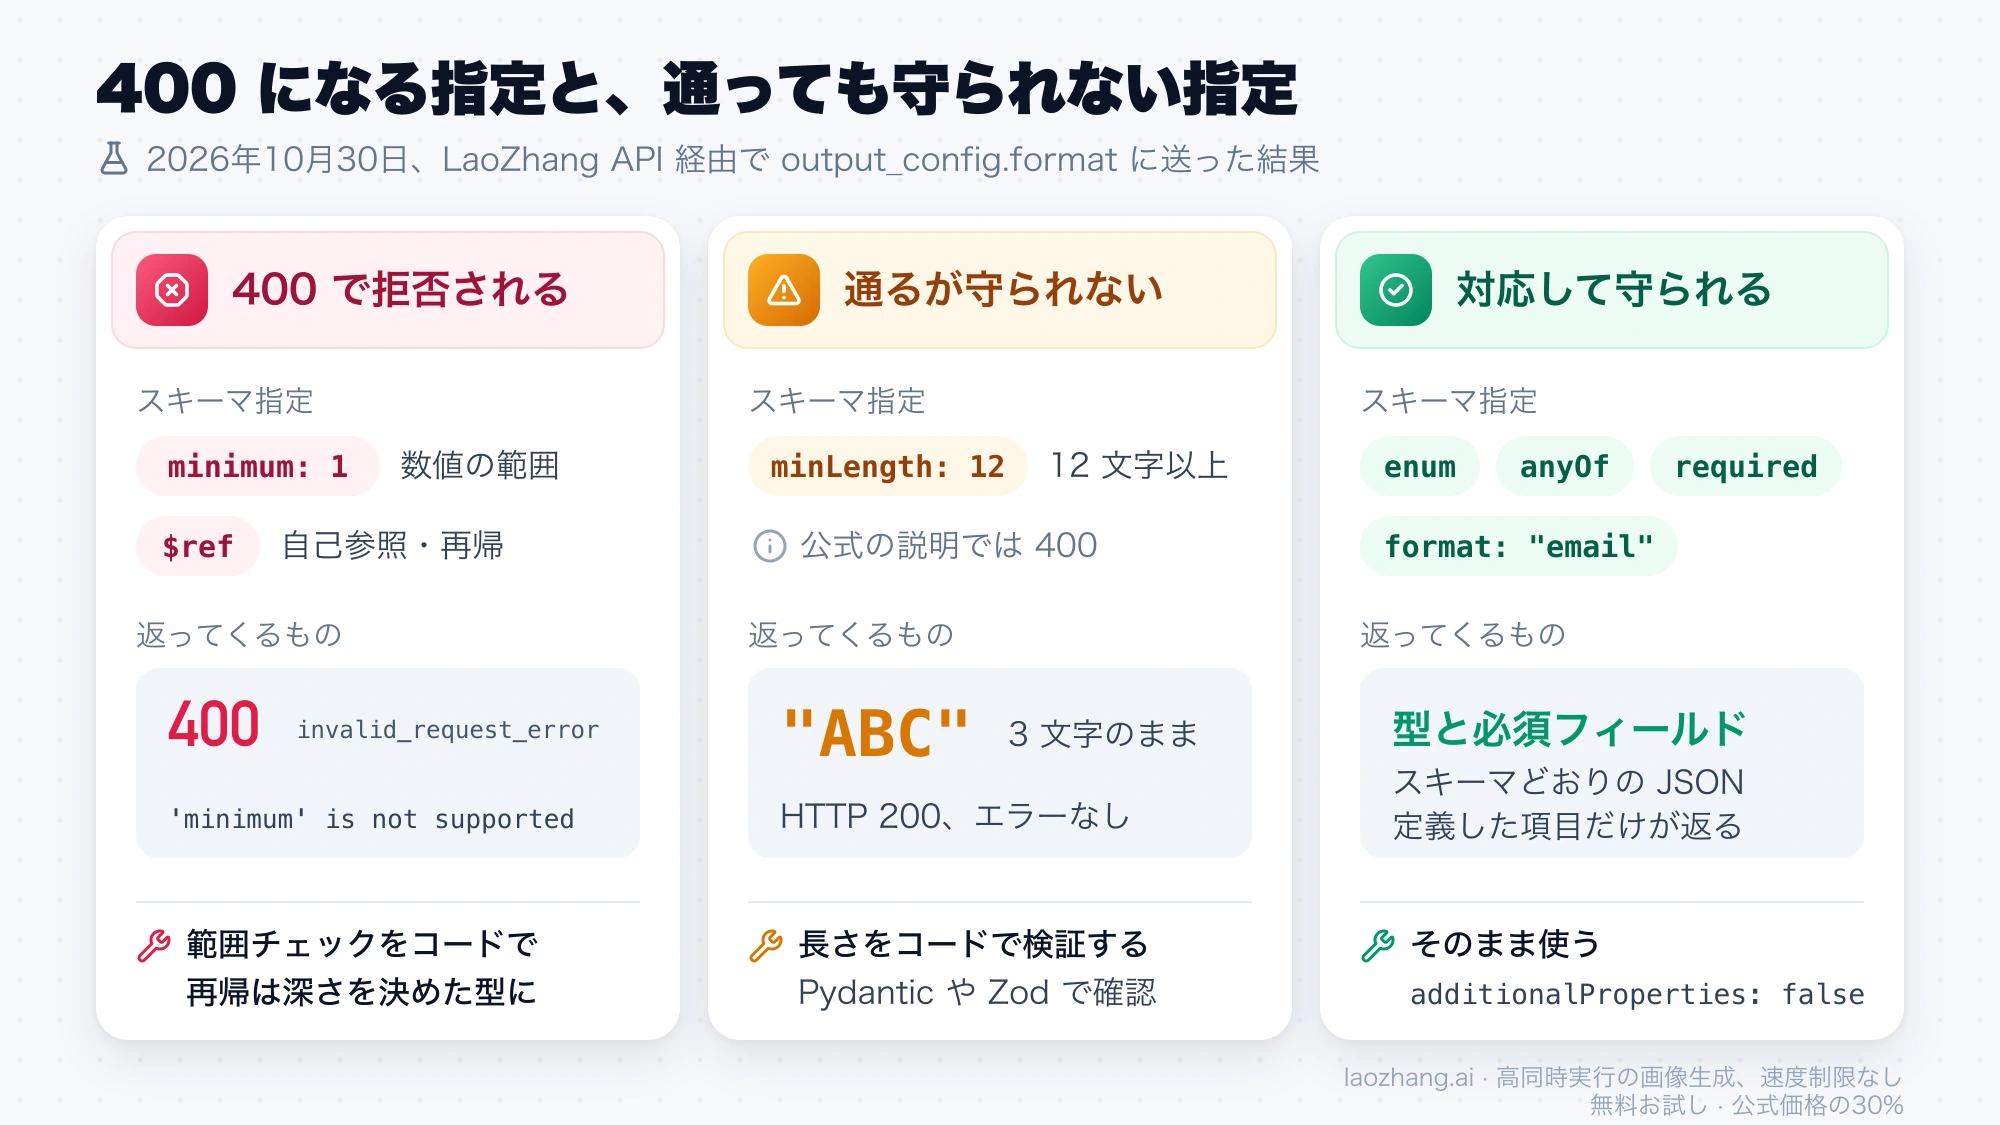
| スキーマ指定 | 公式ドキュメント | 2026年10月30日、LaoZhang API 経由 | 自分のコードですること |
|---|---|---|---|
type、enum、const、anyOf、required、外部を指さない $ref | 対応 | enum、anyOf、required で正常 | そのまま使う |
format(email、date、date-time、uuid など 10 種) | 対応 | format: "email" を strict ツールで使用し正常 | 一覧外の format は SDK が除去する |
minimum、maximum、multipleOf | 非対応、400 | minimum: 1 で 400 | 範囲チェックをコードで行う |
自己参照・相互参照する $ref | 非対応、400 | 自己参照で 400 | 深さを決めた型に書き直す |
minLength、maxLength | 非対応、400 | 200 で受け付け、12 文字指定に "ABC" | 長さをコードで検証する |
additionalProperties を省略 | false が必須 | 200、出力は定義した 4 項目のみ | 常に false を明記する |
配列の minItems が 2 以上、maxItems | 非対応 | 公式の記述のみ | 件数をコードで検証する |
後方参照、先読み・後読み、\b を含む pattern | 非対応 | 公式の記述のみ | 単純な正規表現に書き換える |
400 になったときのメッセージは次のとおりで、どのキーワードが原因かがそのまま書かれています。
output_config.format.schema: For 'integer' type, property 'minimum' is not supported

output_config.format.schema: Invalid schema: Circular reference detected in schema definitions: node -> node. Self-referencing or mutually-referencing definitions are not supported.
どちらも invalid_request_error です。minimum のような制約は SDK の parse() を使えば変換で外れますが、生のスキーマを送る場合は自分で説明文(description)に移し、値の確認をコードに書きます。再帰は変換では消えないので、ツリー構造なら 3 階層までのように深さを決めた型に書き直します。
スキーマが大きすぎる場合にも 400 になります。ドキュメントによれば、1 リクエスト内のすべての strict スキーマを合計して、strict ツールは 20 個、任意パラメータ(required に入っていないもの)は 24 個、anyOf や ["string", "null"] のような型の組み合わせを使うパラメータは 16 個が上限です。これを満たしていても、内部の文法サイズの上限を超えると Schema is too complex for compilation が返り、コンパイルには 180 秒のタイムアウトもあります。任意パラメータを減らして required にする、入れ子を浅くする、という順で見直すのが公式の勧める対処です。
JSON ではなく文章が返る、extra inputs are not permitted が出る
output_config を書いたのに JSON ではなく普通の文章が返る、あるいは Extra inputs are not permitted の 400 が出る場合、原因はスキーマではなく、リクエストを受け取る側がそのフィールドを解釈していないことです。前者は古い書き方が黙って捨てられたとき、後者は経路側が知らないフィールドを厳しく拒否したときに起きます。
ベータ期の記事やサンプルには、リクエスト最上位の output_format と anthropic-beta: structured-outputs-2025-11-13 ヘッダーを使うコードがまだ残っています。Anthropic のドキュメントでは、output_format は非推奨で、ベータヘッダーなしで送ると 400 になり、Python SDK v1.0 以降は client.beta.messages.create() に output_format={...} を渡すと TypeError になります。ところが 2026年10月30日に LaoZhang API 経由で送ると、ヘッダーの有無にかかわらず HTTP 200 で箇条書きの文章が返り、input_tokens はスキーマなしと同じ 64 でした。エラーが出ないので、パース処理まで進んでから初めて気づく失敗です。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
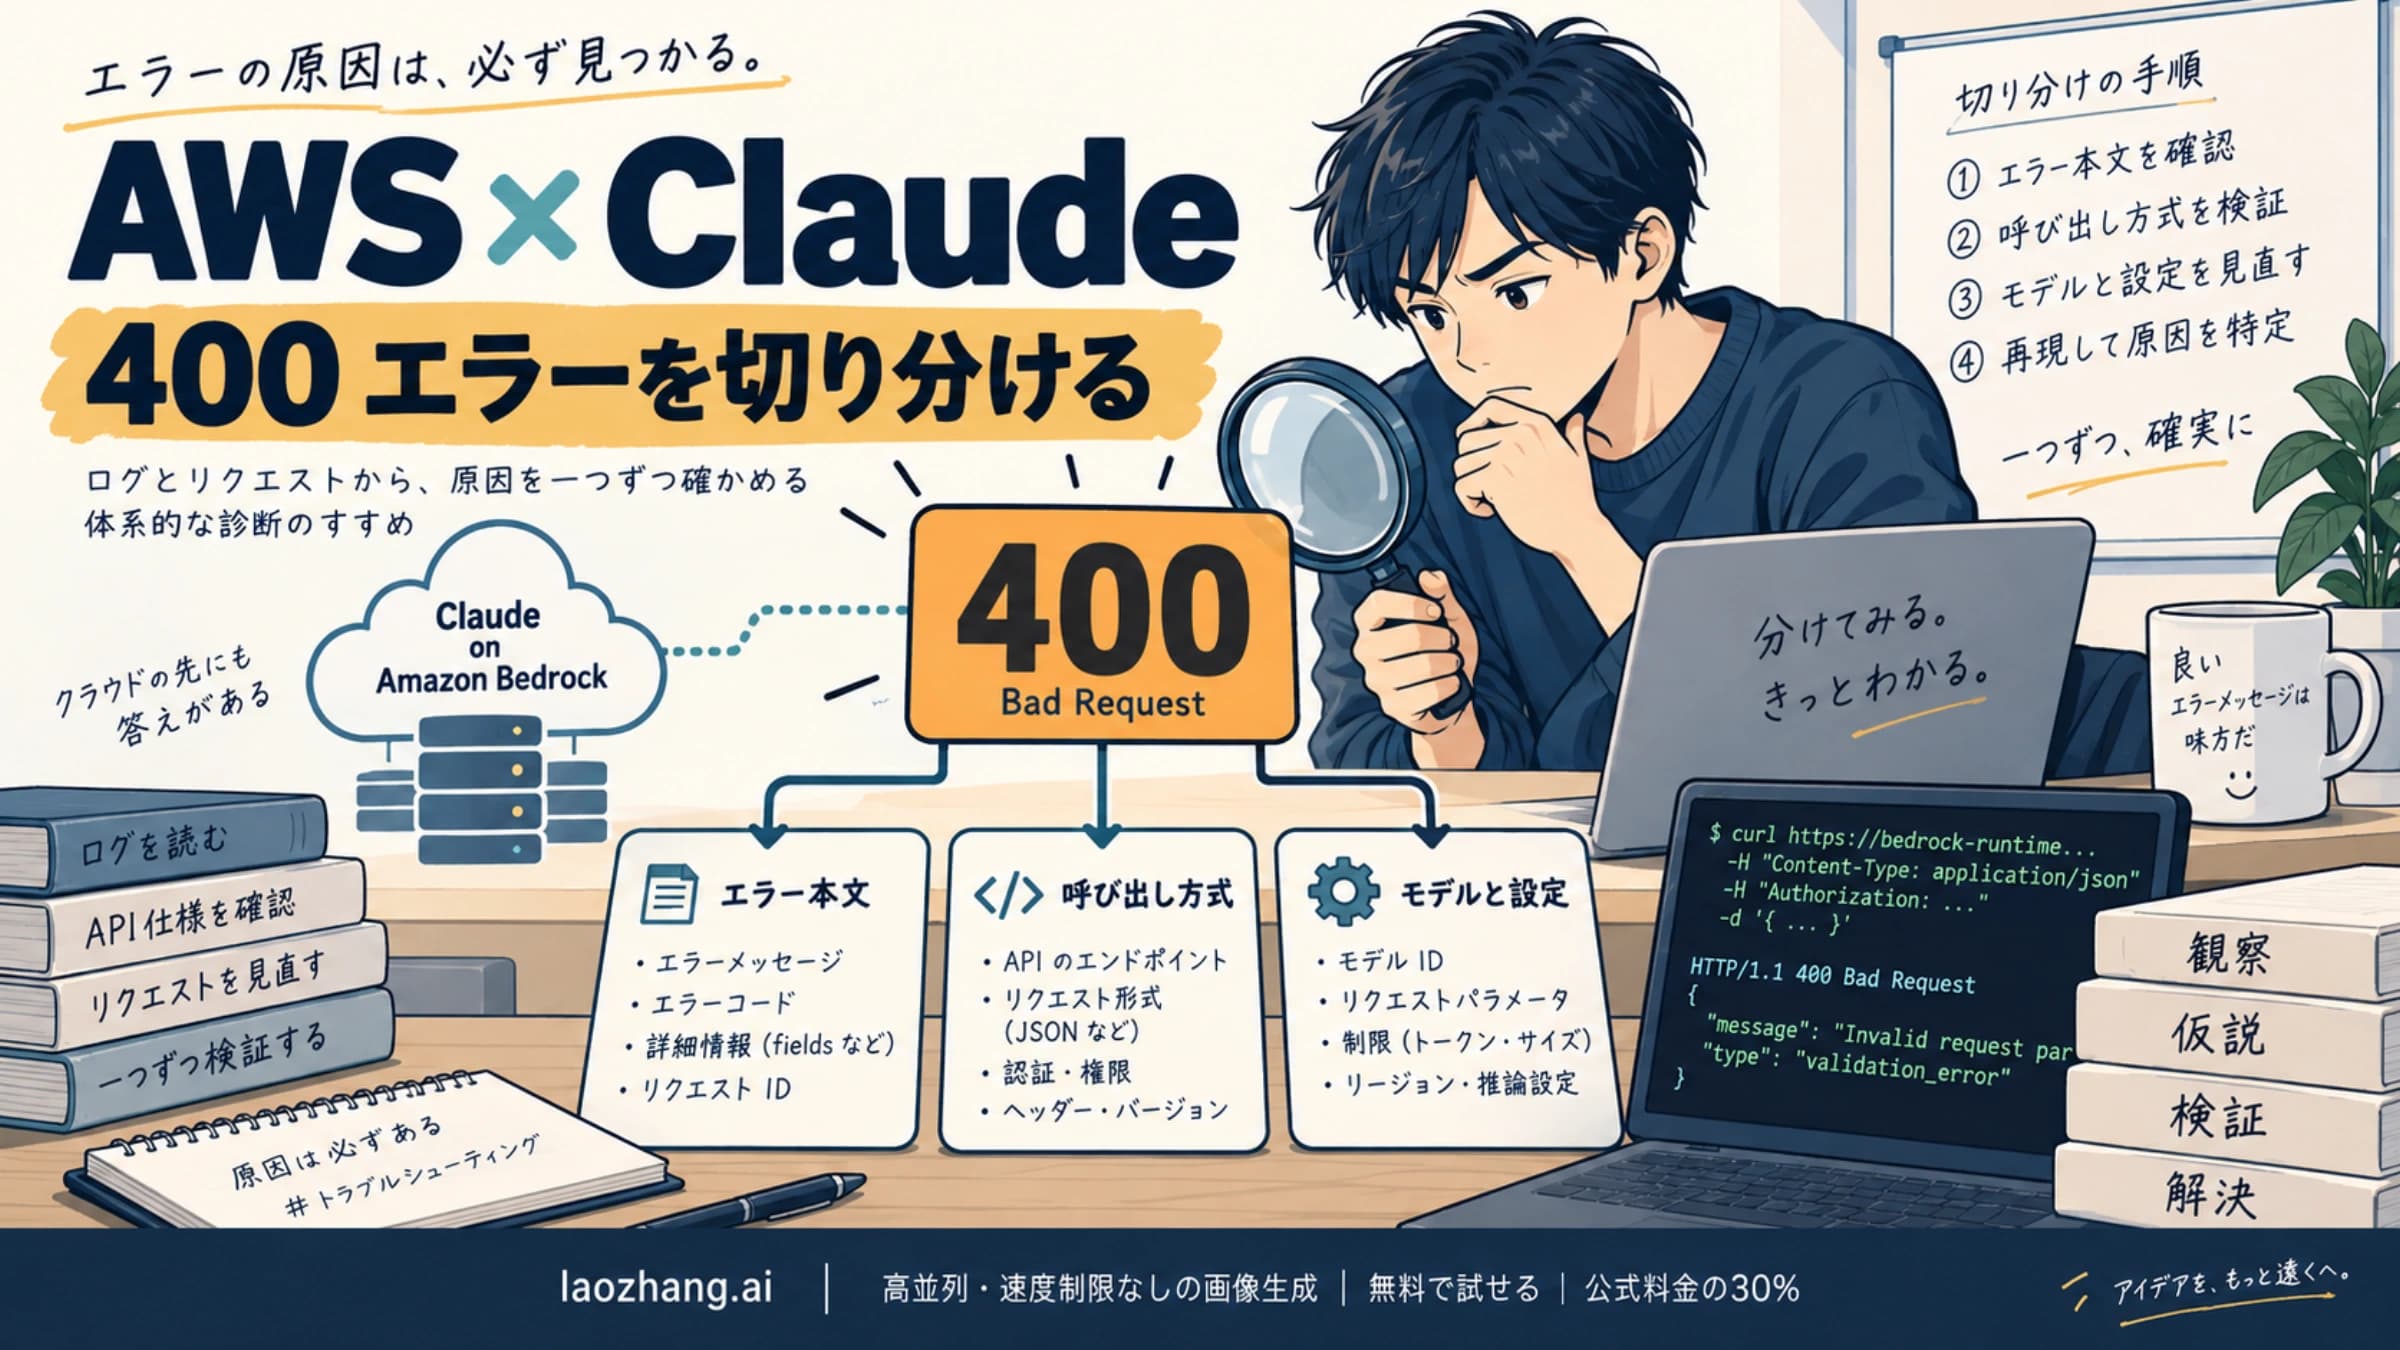
Extra inputs are not permitted は、リクエスト本体を厳密に検証する経路が、受け付けないフィールドを 400 ValidationException として返すときのメッセージです。LaoZhang のドキュメントは、AWS や Bedrock 系の経路で Claude を提供するときにこの 400 が出ることがあると説明しています。output_config.effort のように output_config の下の別フィールドで出ることもあるので、エラー文に書かれたフィールド名を確認し、その経路が対応しているかを調べます。Bedrock で出るほかの 400 メッセージは「AWS の Claude 400 エラー、メッセージ別の対処法」にまとめています。
直結でもプロキシ経由でも、次の項目を確認すれば原因を絞れます。
- リクエスト本体に
output_config.formatがあり、最上位にoutput_formatが残っていない anthropic-beta: structured-outputs-2025-11-13ヘッダーを外しているusage.input_tokensがスキーマなしのときより増えている(上の 4 項目スキーマでは 64 から 333)contentの text が{で始まり、JSON としてパースできる- モデル ID が公式の対応一覧にある(Claude 3 系は載っていない)
- 同じリクエストで Citations を有効にしていない(併用すると 400)
拒否・打ち切り・キー順・null:受け取り側で書くチェック
HTTP 200 で返ってきても、スキーマどおりの JSON とは限りません。Anthropic のドキュメントは、安全上の理由による拒否と max_tokens での打ち切りを例外として挙げており、実際の挙動を見るとキーの順序や任意フィールドの扱いにも注意が要ります。それぞれ受け取り側で次のように扱います。
stop_reasonが"refusal"なら、HTTP 200 でも出力がスキーマに合わないことがあり、生成されたトークンは課金されます。手順を追った推論を書かせるプロパティはreasoning_extractionによる拒否を招くことがあるため、短い説明を求める形にします。stop_reasonが"max_tokens"なら、JSON は途中で切れています。2026年10月30日に LaoZhang API 経由でmax_tokens: 30のまま 15 件のアイデアを頼むと、text は{"ideas": ["REST vs GraphQL vs gRPC: How to Choose theで終わり、パースできませんでした。max_tokensを増やして再試行します。- キーの順序には依存しません。ドキュメントは「スキーマの順序、ただし必須プロパティが先」と説明していますが、同じ日に LaoZhang API 経由で得た JSON は、すべてキーがアルファベット順でした。
- 任意フィールドは「ない」場合と「null」の場合の両方を想定します。
requiredに入れず型をstringだけにしたphoneが、省略されずに"phone": nullで返りました。null に揃えたいなら、anyOf: [{"type": "string"}, {"type": "null"}]にしてrequiredに入れ、指示文で「記載がなければ null」と書くと、{"company": null, "name": "John Smith", "phone": null}のように返りました。 enumの値は大文字小文字を区別せずに比較します。ドキュメントには、"Conversation topic 3"が"Conversation Topic 3"で返ることがあると書かれています。2026年10月30日に LaoZhang API 経由で同じ enum を 5 回試した範囲では 5 回とも完全一致でしたが、大文字小文字だけが違う値を enum に並べないのが安全です。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
これらをまとめると、messages.parse() を使わずに messages.create() で生のスキーマを送る場合の受け取り処理は次の形になります。
import json

from pydantic import BaseModel, ValidationError


def read_structured(resp, model_cls: type[BaseModel]) -> BaseModel:
    if resp.stop_reason == "refusal":
        raise RuntimeError("Claude が拒否しました。入力内容を確認してください")
    if resp.stop_reason == "max_tokens":
        raise RuntimeError("途中で切れました。max_tokens を増やして再試行してください")

    text = next(block.text for block in resp.content if block.type == "text")
    data = json.loads(text)  # キーの順序には依存しない

    try:
        # 範囲・長さ・件数などの制約はここで初めて検証される
        return model_cls.model_validate(data)
    except ValidationError:
        raise  # 再試行するか、人の確認に回す
フォーマット用プロンプトの追加トークンとコスト
構造化出力を使うと、Claude には出力形式を説明するシステムプロンプトが自動で追加され、その分の入力トークンが課金されます。2026年10月30日に LaoZhang API 経由で、同じ依頼文を Haiku 5.5 に送った結果、4 項目のスキーマありでは入力 333 トークン、なしでは 64 トークンで、差は 269 トークンでした。スキーマが大きくなれば差も広がります。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
269 トークンが毎回加わるとして、Anthropic の料金ページの入力単価で 100万リクエスト分を計算すると次のとおりです。計算式は「269 トークン × 100万回 = 2億6,900万トークン(269 MTok)× 入力単価」です。
| モデル | 入力単価(100万トークンあたり) | 100万リクエストでの追加コスト |
|---|---|---|
| Haiku 5.5(プロンプト 10万トークン以下) | $0.10 | $26.90 |
| Sonnet 5.5 | $2 | $538 |
| Opus 5.5 | $4 | $1,076 |
一方で、同じ例では出力が文章の 91 トークンから JSON の 46 トークンに減りました。Sonnet 5.5(出力単価は100万トークンあたり $10)なら、1 リクエストあたり入力が $0.000538 増え、出力が $0.00045 減る計算で、差し引きの増加は $0.000088 にとどまります。どちらに傾くかは依頼文と出力の長さ次第なので、自分のプロンプトで usage を比べるのが確実です。
コストに関係する注意点がもう二つあります。output_config.format を変えると、その会話のプロンプトキャッシュは無効になります。大量の抽出処理なら、Anthropic の Message Batches API で構造化出力を使うと 50% 割引になります。
速度については、ドキュメントによれば初めて使うスキーマは文法のコンパイルで最初のリクエストが遅くなり、コンパイル結果は最後の利用から 24 時間キャッシュされます。プロパティの名前や説明だけを変えてもキャッシュは無効になりません。同じ日に LaoZhang API 経由で、初めてのスキーマを 1 回、続けて同じスキーマを 2 回送った応答時間は 4.23 秒、3.33 秒、4.28 秒で、ネットワークのばらつきと区別できる差は見えませんでした。
Claude 構造化出力のよくある質問
Amazon Bedrock や Google Cloud の Claude でも構造化出力は使えますか
使えます。2026年10月30日時点の Anthropic のドキュメントでは、Claude API に加えて Claude Platform on AWS、Amazon Bedrock(InvokeModel を含む)、Google Cloud の Claude(Anthropic 管理と Google 管理の両方)、Microsoft Foundry で一般提供となっています。Managed Agents では使えません。Bedrock 側で 400 が出る場合は、エラー文のフィールド名からその経路の対応状況を確認します。
どの Claude モデルが構造化出力に対応していますか
2026年10月30日時点のドキュメントでは、Opus 5.5、Sonnet 5.5、Haiku 5.5、Fable 5.1、Mythos 5.1 などの現行モデルから、claude-sonnet-4-5-20250929、claude-opus-4-5-20251101、claude-haiku-4-5-20251001 までが対応一覧に載っています。Claude 3 系や Opus 4.1 は載っていないため、対応していないものとして扱ってください。
thinking(拡張思考)と構造化出力は一緒に使えますか
使えます。ドキュメントによれば、スキーマによる制約がかかるのは Claude の最終的な出力だけで、thinking ブロックやツール呼び出しには適用されません。2026年10月30日に LaoZhang API 経由で Sonnet 5.5 に thinking: {"type": "adaptive"} と output_config の effort: "low" と format を同時に指定したところ、thinking ブロックは出ず、text ブロックに有効な JSON だけが返りました。
ストリーミングやバッチ処理でも構造化出力は使えますか
どちらも使えます。Anthropic のドキュメントでは、ストリーミングは通常の応答と同じように扱え、Message Batches API でも使え、トークン数のカウントにも対応しています。併用できないのは Citations(引用)とアシスタントのプレフィルです。ゲートウェイ経由の場合はエンドポイント自体があるかを先に確認してください。LaoZhang API は、2026年10月30日時点で Message Batches と /v1/messages/count_tokens を提供していません。
JSON を { から始めさせる prefill の代わりになりますか
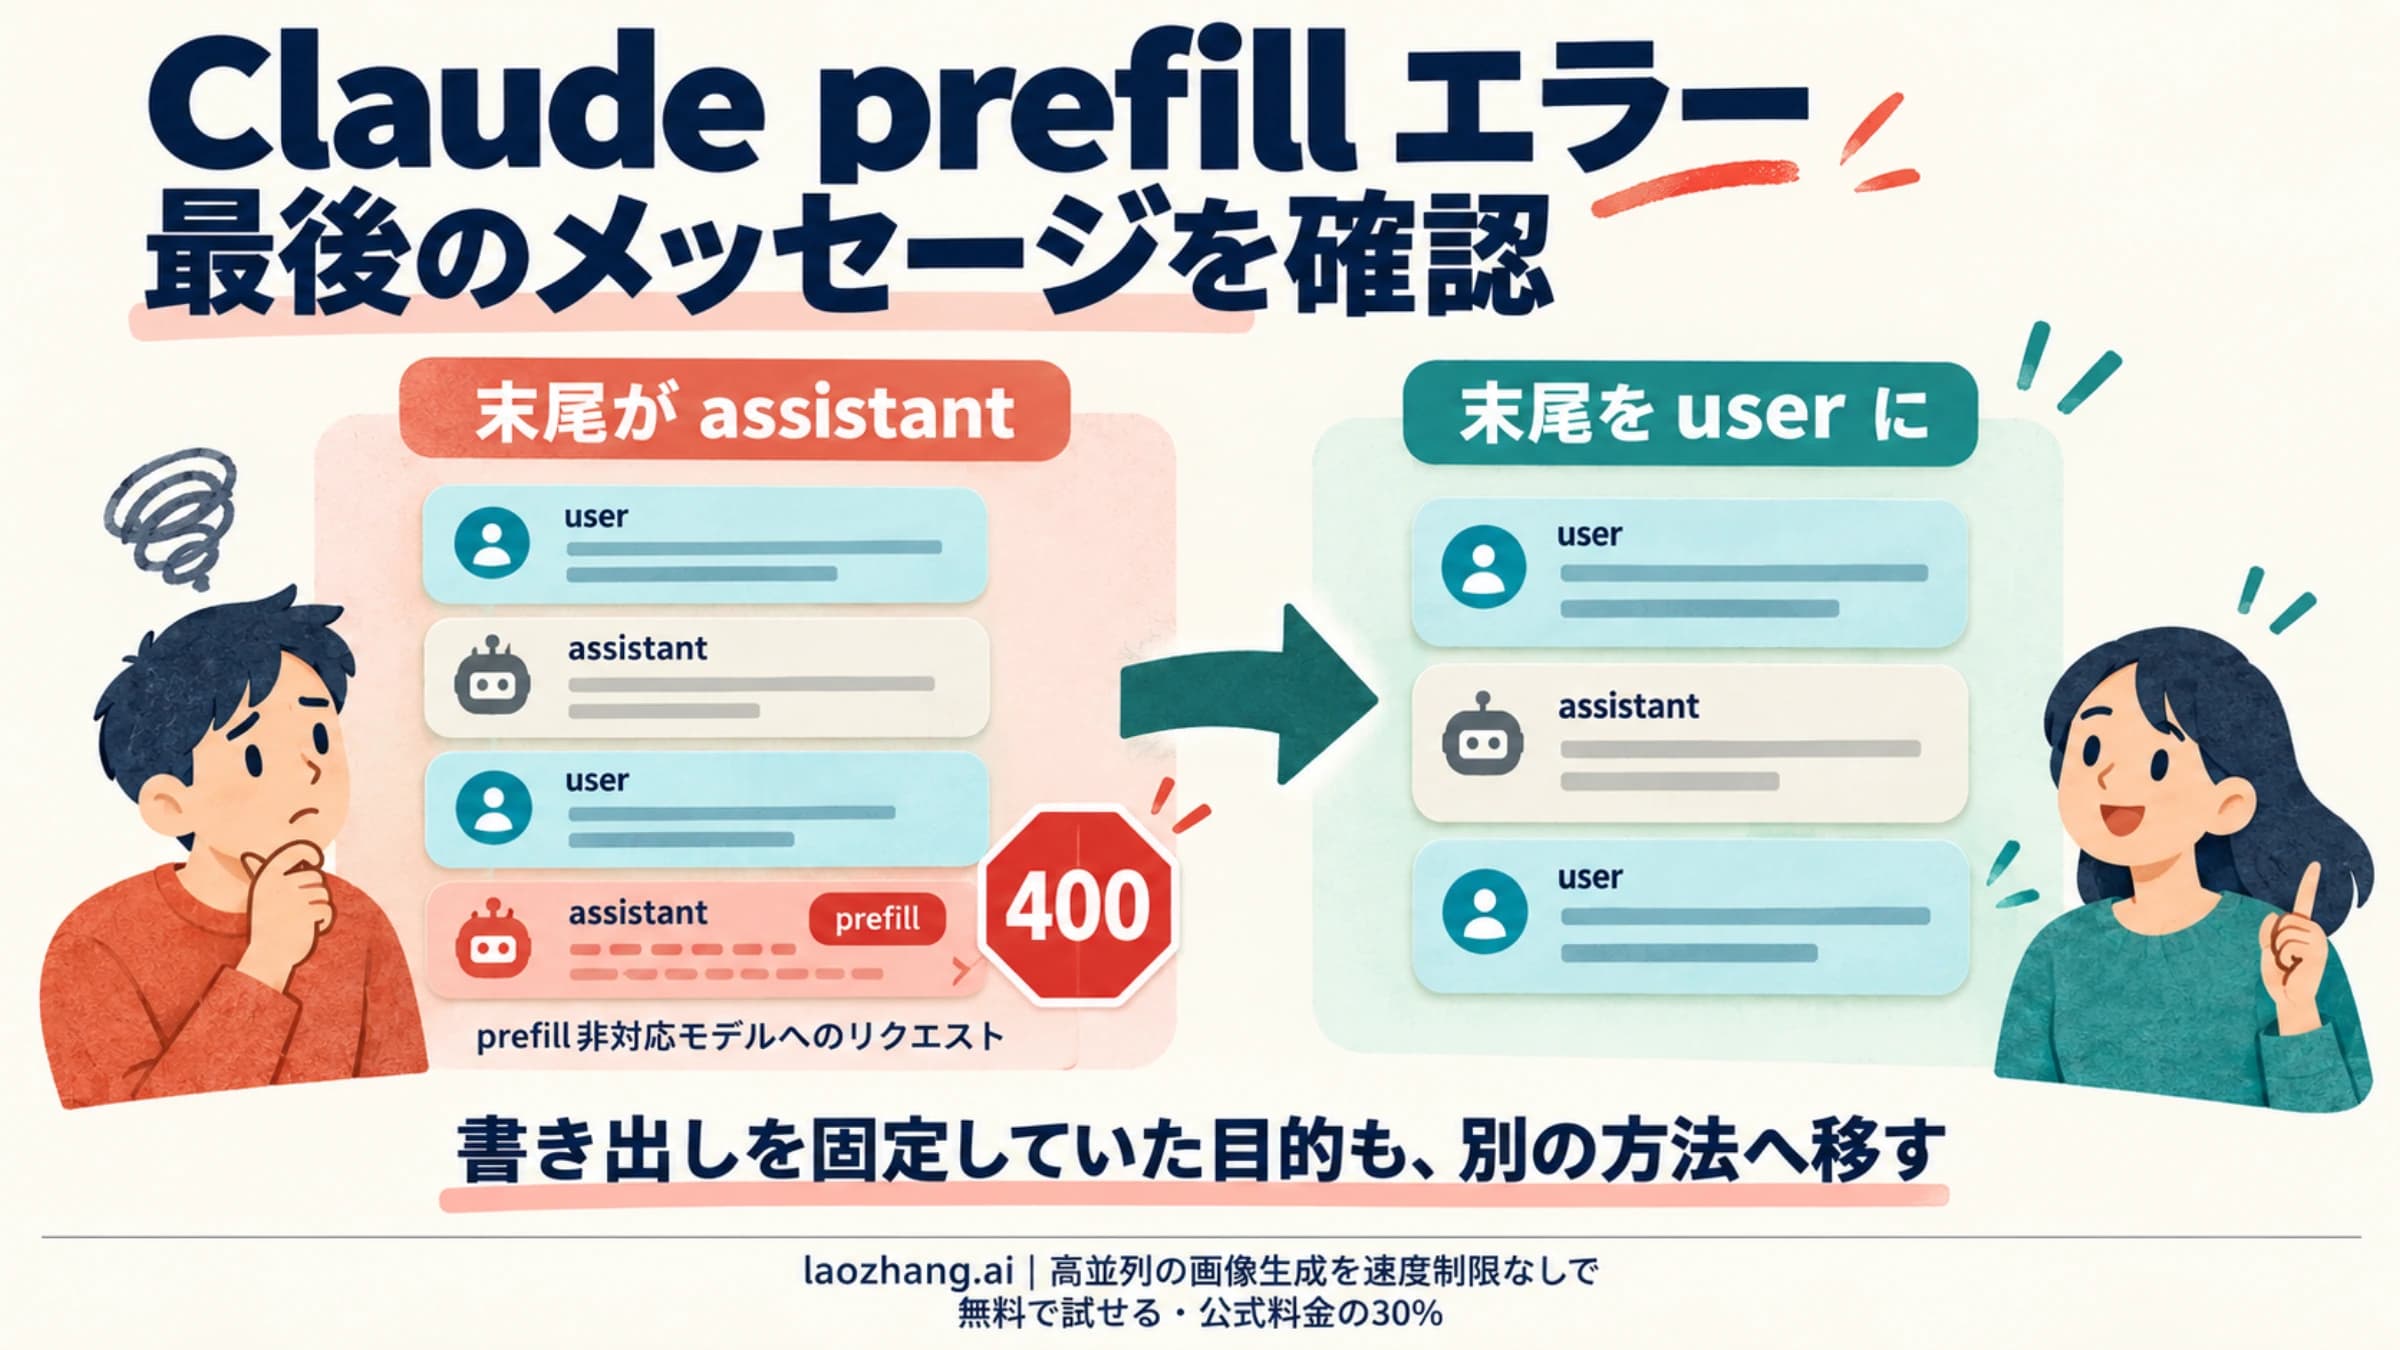
なります。2026年10月30日に LaoZhang API 経由で試した Haiku 5.5 は、末尾が assistant のリクエスト自体を This model does not support assistant message prefill. The conversation must end with a user message. という 400 で拒否するため、JSON を返させる目的なら output_config.format に置き換えます。非対応モデルの一覧とほかの用途の代替は「Claude assistant prefill 400 エラー:非対応モデルと代替手段」にあります。
Claude Code や Agent SDK の構造化出力は同じ仕組みですか
別の仕組みです。Agent SDK では query() に outputFormat(Python は output_format)で JSON Schema を渡し、SDK が結果を検証して合わなければ再度依頼し、上限回数を超えると error_max_structured_output_retries で失敗します。詳しくは Claude Agent SDK の構造化出力ドキュメントを参照してください。
ゼロデータ保持(ZDR)や HIPAA の環境でも使えますか
使えます。ドキュメントによれば、プロンプトと出力は保存されず、キャッシュされるのは JSON スキーマだけで、期間は最後の利用から最大 24 時間です。HIPAA の対象にもなりますが、スキーマはメッセージ本文と別に保存されるため、プロパティ名、enum や const の値、pattern の正規表現に個人の医療情報(PHI)を入れてはいけません。
参考資料4
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月30日。
参考資料4
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月30日。
- 1.Anthropic の構造化出力ドキュメントplatform.claude.com/docs/ja/build-with-claude/structured-outputs
- 2.Anthropic の厳密なツール使用ドキュメントplatform.claude.com/docs/ja/agents-and-tools/tool-use/strict-tool-use
- 3.Anthropic の料金ページplatform.claude.com/docs/ja/about-claude/pricing
- 4.Claude Agent SDK の構造化出力ドキュメントcode.claude.com/docs/ja/agent-sdk/structured-outputs