Gemini 400「Requests ending with a model turn」の原因と直し方
Gemini 3.6 Flash 以降と Argon は、model ターンで終わるリクエストを 400 で拒否します。user ターンで終えれば通り、再試行では直りません。
目次
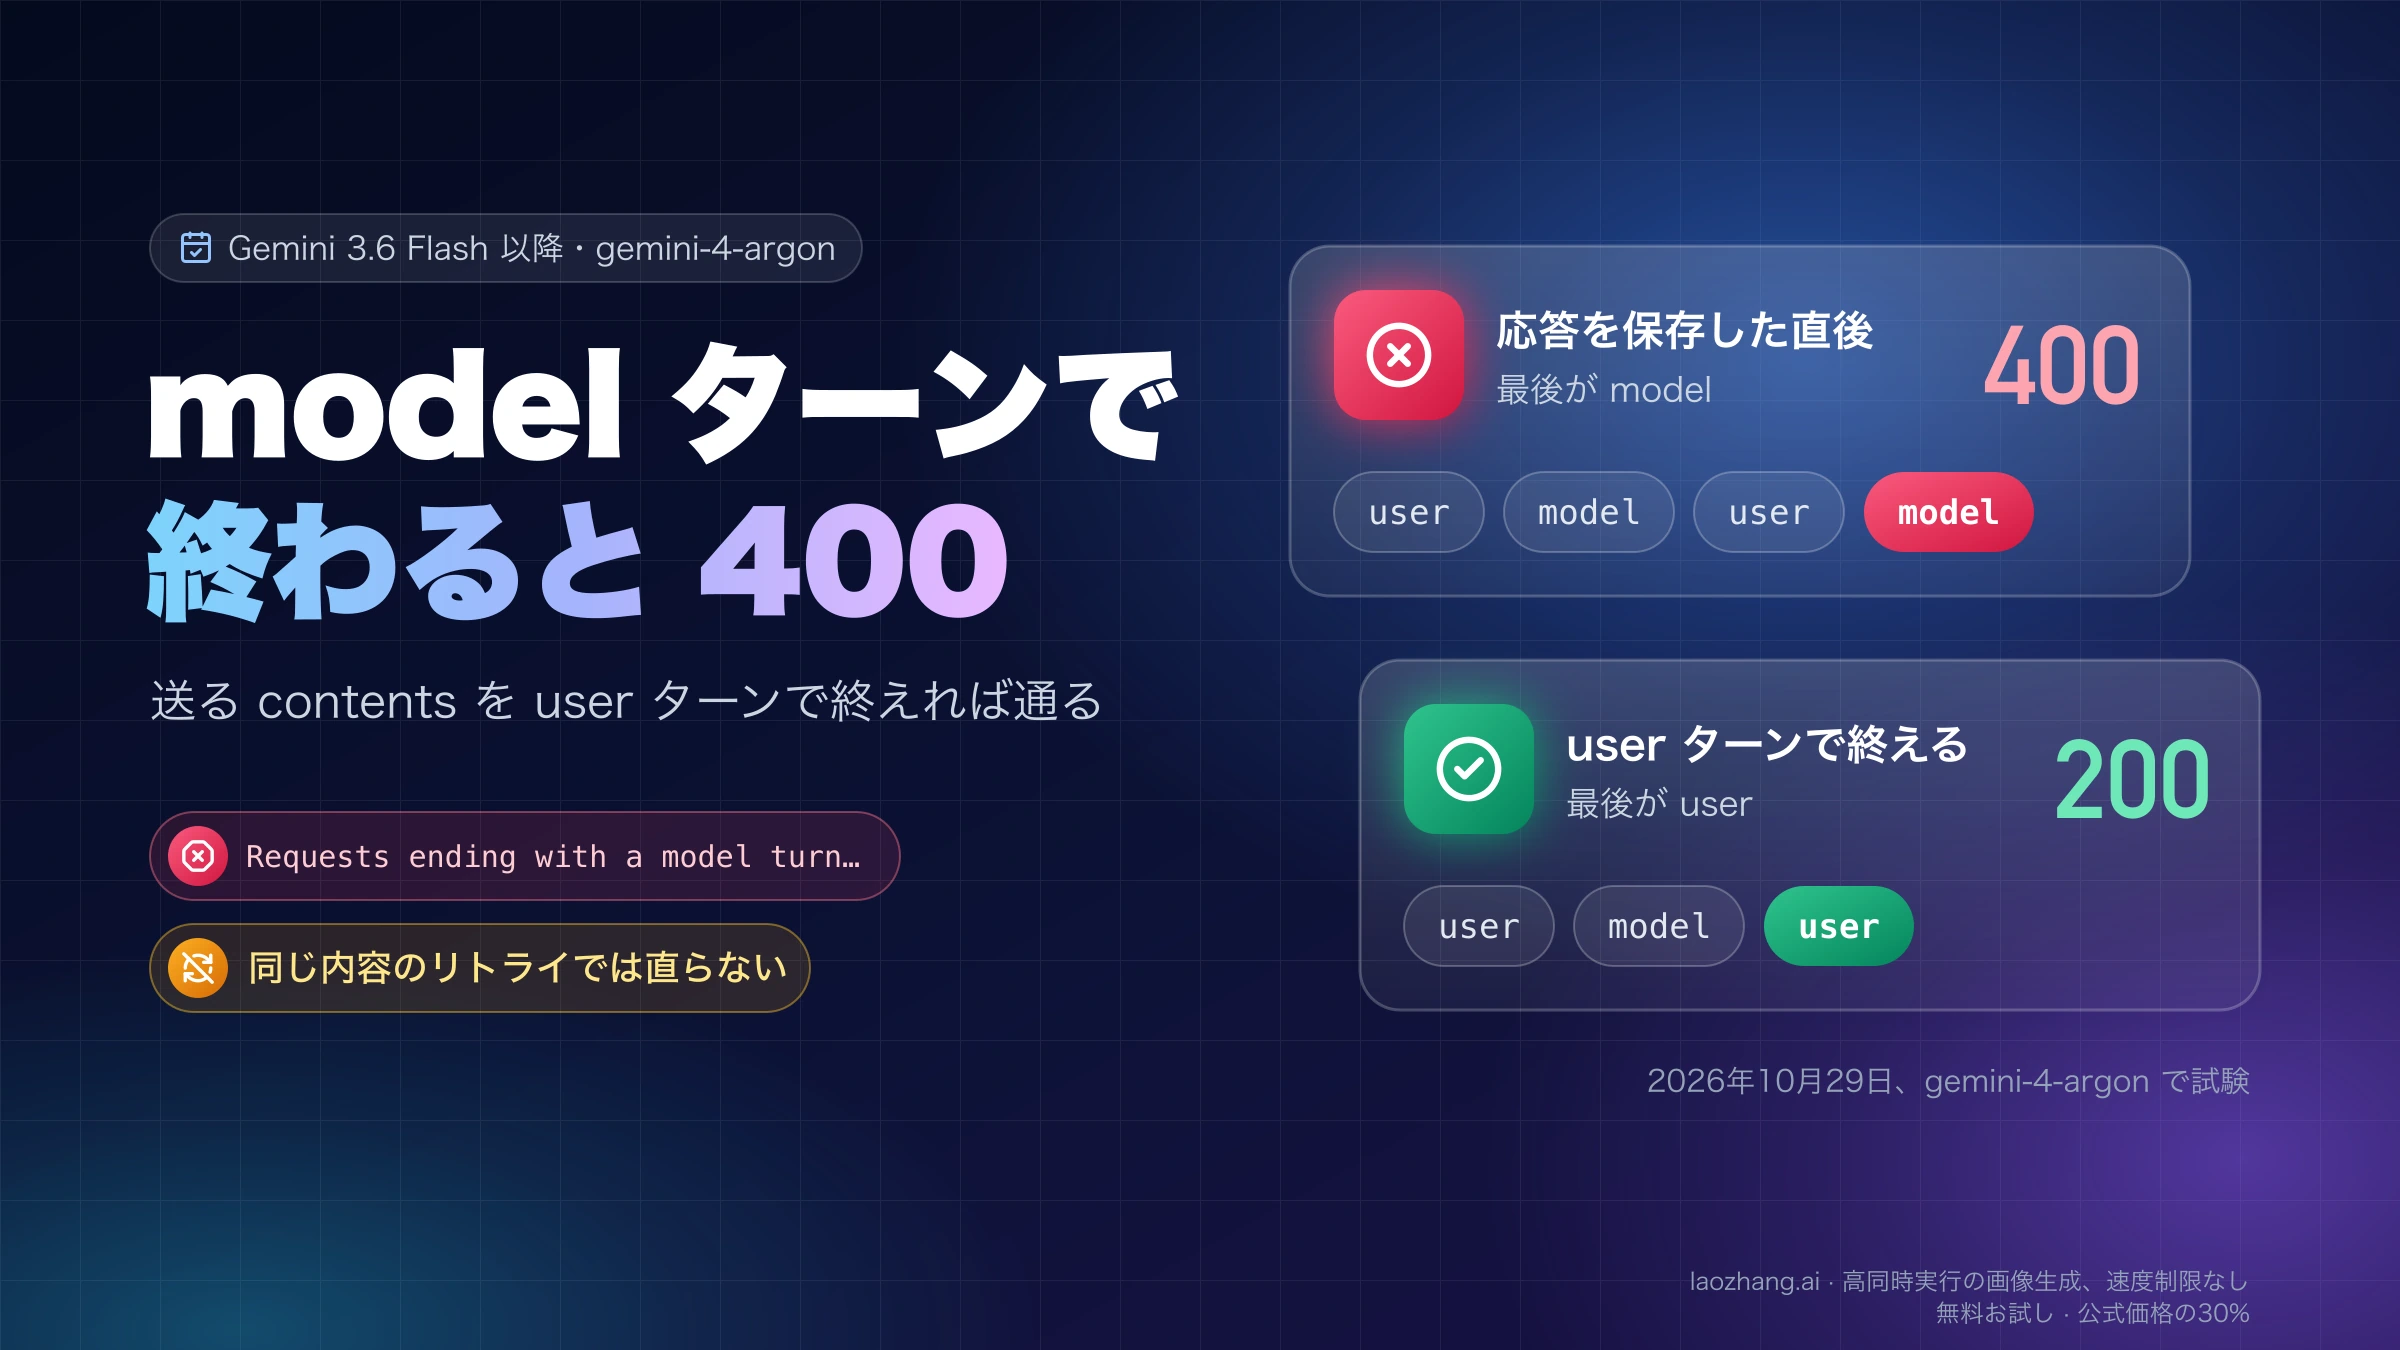
400 INVALID_ARGUMENT: Requests ending with a model turn are not supported. は、Gemini API に送ったリクエストの contents が、role が model のターン(OpenAI 形式でいう assistant のメッセージ)で終わっていることを示すエラーです。Google は Gemini 3.6 Flash と Gemini 3.5 Flash-Lite からこの形を 400 で拒否するようにし、それ以降のすべてのモデルにも適用するとしています。2026年10月29日時点では gemini-4-argon も対象で、以前のモデルで通っていたプリフィル(assistant prefill)や続き生成のリクエストがそのまま 400 になります。
直すのは、実際に送信している contents の最後の要素です。末尾の model ターンを外すか、次の user メッセージを足して、user ターンで終わらせます。プリフィルで書き出しや JSON 形式を固定していた場合は、Google が勧める systemInstruction か構造化出力(JSON スキーマ)に置き換えます。ツール呼び出しの途中なら、モデルが返した functionCall のターンをそのまま返し、その後に functionResponse を入れた user ターンを置きます。リクエストの形の問題なので、同じ内容をリトライしても結果は変わりません。
画面上の最後のメッセージが自分の発言でも、送信されたリクエストが user で終わっているとは限りません。Gemini CLI、opencode、SillyTavern などのツールは、中断や巻き戻し、プリフィル系の設定、画像を返すツール結果の扱いによって、末尾に model ターンを残すことがあります。その場合は、ツールの更新か設定の見直しが先です。
エラー文の意味:最後の空でないターンが model
Google の Gemini API「What's new in Gemini 3.6」ページ(2026年10月13日更新)は、Gemini 3.6 Flash と Gemini 3.5 Flash-Lite から model ターンのプリフィルをサポートしないとし、リクエストの最後の空でないターンが model ターンなら API が 400 を返すと明記しています。対象は「この 2 モデルと今後のすべての Gemini モデル」です。Gemini API の role は user と model の 2 種類で、OpenAI 互換形式の assistant は model に変換されて届きます。
Gemini 4 Argon だけの問題ではありません。Google の Gemini 4 Argon 移行ページ(2026年10月27日更新)はこのルールに触れていませんが、Argon は「今後のすべてのモデル」に含まれます。一方、3.5 Flash 以前のモデルはルールの対象外で、LINUX DO の 2026年7月22日の投稿は、3.5 Flash ではプリフィルがまだ通り、3.6 Flash では通らなくなったと報告しています。
エラー文は経路によって少し違います。AI Studio 系のプロキシや Google Issue Tracker の 2026年7月の報告では「Requests ending with a model turn are not supported unless the last part is a function response.」という形で出ており、ツール結果(function response)で終わる場合は例外という意味で、ルールは同じです。プロキシは PROXY ERROR 400: {...} のように包み、OpenRouter は「Provider returned error」と表示して Google の原文を error.metadata.raw に入れます。Argon では明示的キャッシュ(cachedContents)を使ってもエラーになると Google の移行ページに書かれていますが、これは別の原因で、文言も違います。
どのケースか:プリフィル・履歴・ツール・画像・countTokens
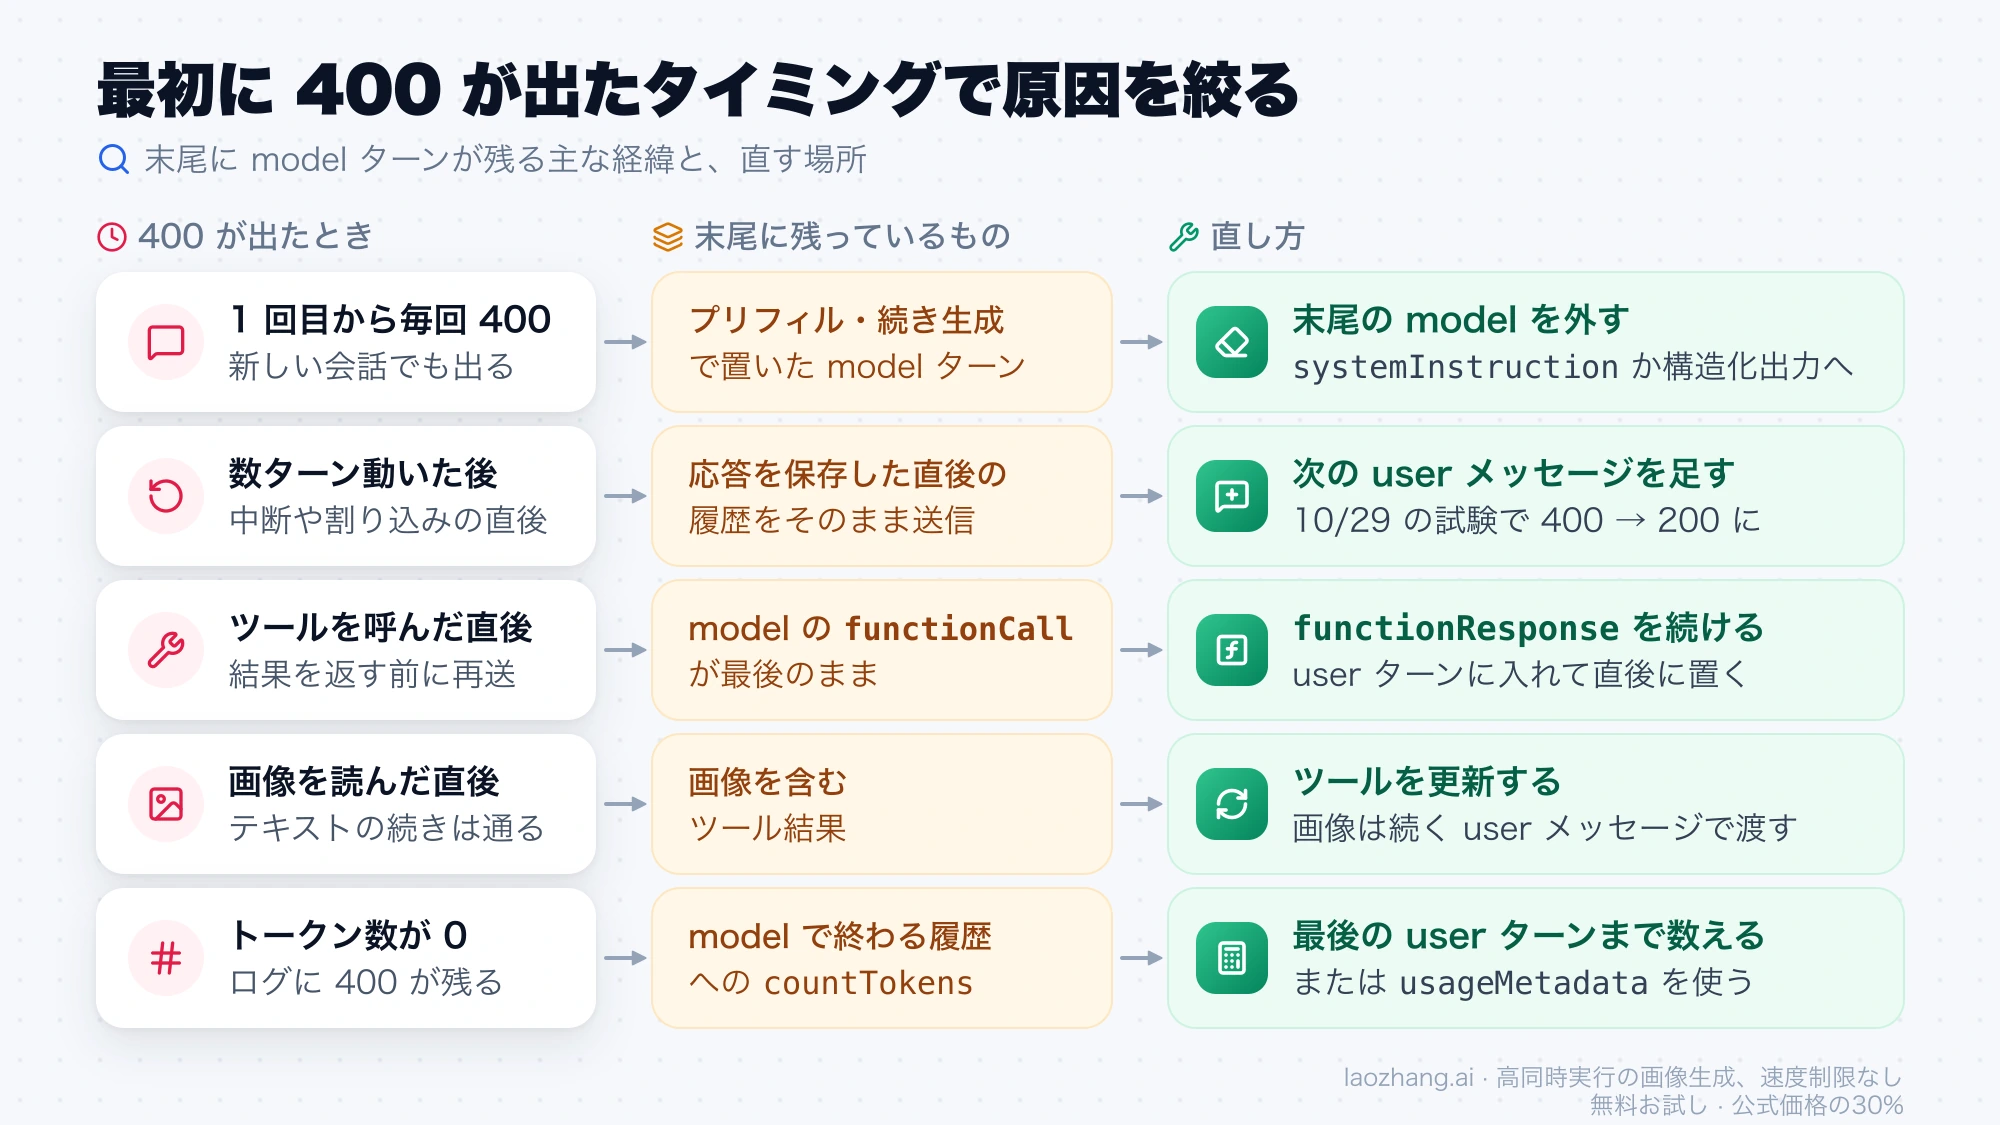
末尾に model ターンが残る経緯は、GitHub の issue や利用者の報告を見ると次の 7 通りに分かれます。どれに当たるかで、直す場所が自分のコードか、使っているツールかが決まります。
| きっかけ | よく出る症状 | 直し方 |
|---|---|---|
| プリフィルや続き生成のために、model ターンを末尾に置いて送る | 1 回目のリクエストから毎回 400。3.5 Flash に戻すと通る | 末尾の model ターンを外し、systemInstruction か JSON スキーマで代える |
| 応答を保存した直後の履歴をそのまま送る(巻き戻し、生成の中断、音声エージェントでの割り込みの後) | 数ターン動いた後や中断の直後から 400 が続き、新しいメッセージを送ると再開できる | 次の user メッセージを足してから送る |
| ツールが assistant メッセージを末尾に差し込む(opencode のステップ上限の通知など) | 一定のステップ数で止まり、入力内容と関係なく起きる | ツールの更新。差し込みを system 側に移す修正が必要 |
| model の functionCall が最後のまま送る | ツールを実行する前に再送したときや、結果を返さずに次の生成を求めたとき | functionResponse を入れた user ターンを続ける |
| ツール結果と追加のテキストを 1 つの user ターンに入れる(Vertex AI で報告) | ツール結果の直後に指示やリマインダーを差し込むエージェントで出る | functionResponse をそのターンの最後に置くか、追加テキストを別の user ターンにする |
| ツール結果に画像が入る(.png の読み込みなど) | 画像を読んだ直後のステップだけ失敗し、テキストだけの続きは通る | ツールを更新する。画像は続く user メッセージで渡す |
| model で終わる履歴に対して countTokens を呼ぶ | 会話は動くが、トークン数の表示が 0 になりログに 400 が残る | 最後の user ターンまでを数えるか、usageMetadata を使う |
見分けるには、最初に 400 が出たタイミングを思い出すのが早道です。新しい会話の 1 回目から必ず出るならプリフィル、何ターンか動いた後や Ctrl-C、/rewind、割り込みの直後から出るなら止まった履歴、ツールを呼んだ直後や画像を読んだ直後だけならツールの流れを疑います。自分でリクエストを組み立てていない場合は、下のツール別の表から先に見てください。
直し方:送信する contents を user ターンで終える
修正は、実際に送ったリクエスト本文を確かめ、末尾の model ターンの由来に応じて外すか user ターンを足し、ツールの流れならターンの並びを直す、という順番で進めます。どの場合も、最後の空でないターンの role が user になれば、このエラーは出なくなります。
まず、送信直前の contents(OpenAI 互換形式なら messages)をログに出し、最後の要素の role を見ます。SDK やフレームワークは履歴を変換して送るため、コード上の配列と実際の本文が一致しないことがあります。OpenRouter 経由なら error.metadata.raw に Google の本文が入っています。送信前に末尾をそろえる処理を入れておくと、プリフィルの消し忘れや保存済み応答の送り直しをまとめて防げます。
def ensure_user_last(contents, next_user_text=None):
    """送信前に contents の末尾を user ターンにそろえる"""
    if not contents or contents[-1]["role"] == "user":
        return contents
    last = contents[-1]
    if any("functionCall" in part for part in last["parts"]):
        # functionCall は消さず、functionResponse を入れた user ターンを続ける
        raise ValueError("functionCall の後には functionResponse の user ターンが必要です")
    if next_user_text:
        return contents + [{"role": "user", "parts": [{"text": next_user_text}]}]
    return contents[:-1]  # プリフィルや保存済みの応答を外す
プリフィルで書き出しや形式を固定していた場合は、末尾の model ターンを外し、その役目を systemInstruction に移します。Google の 3.6 の変更点ページは、前置きを抑えたり JSON 形式を強制したりする目的のプリフィルは system_instruction か Structured outputs(構造化出力)に置き換えるよう勧めています。generateContent の REST なら次のような形です。JSON を返させたいだけなら、指示文ではなく Gemini API の generateContent 版構造化出力ガイドにあるとおり、generationConfig の responseMimeType: "application/json" と responseJsonSchema でスキーマを渡すほうが確実です(Interactions API では response_format)。
{
  "systemInstruction": {
    "parts": [{ "text": "前置きを書かず、回答は「結論:」から始めてください。" }]
  },
  "contents": [
    { "role": "user", "parts": [{ "text": "次の文を 1 文で要約してください。…" }] }
  ]
}
履歴が応答の直後で止まっている場合は、次の user メッセージを足してから送ります。2026年10月29日の試験では、[user, model, user, model] で終わる履歴が 400 になり、最後の model ターンを外して新しい user ターンで終えた同じ履歴は 200 になりました。巻き戻しや生成の中断の後に、途中までの応答が履歴の最後に残っていないかも確かめます。
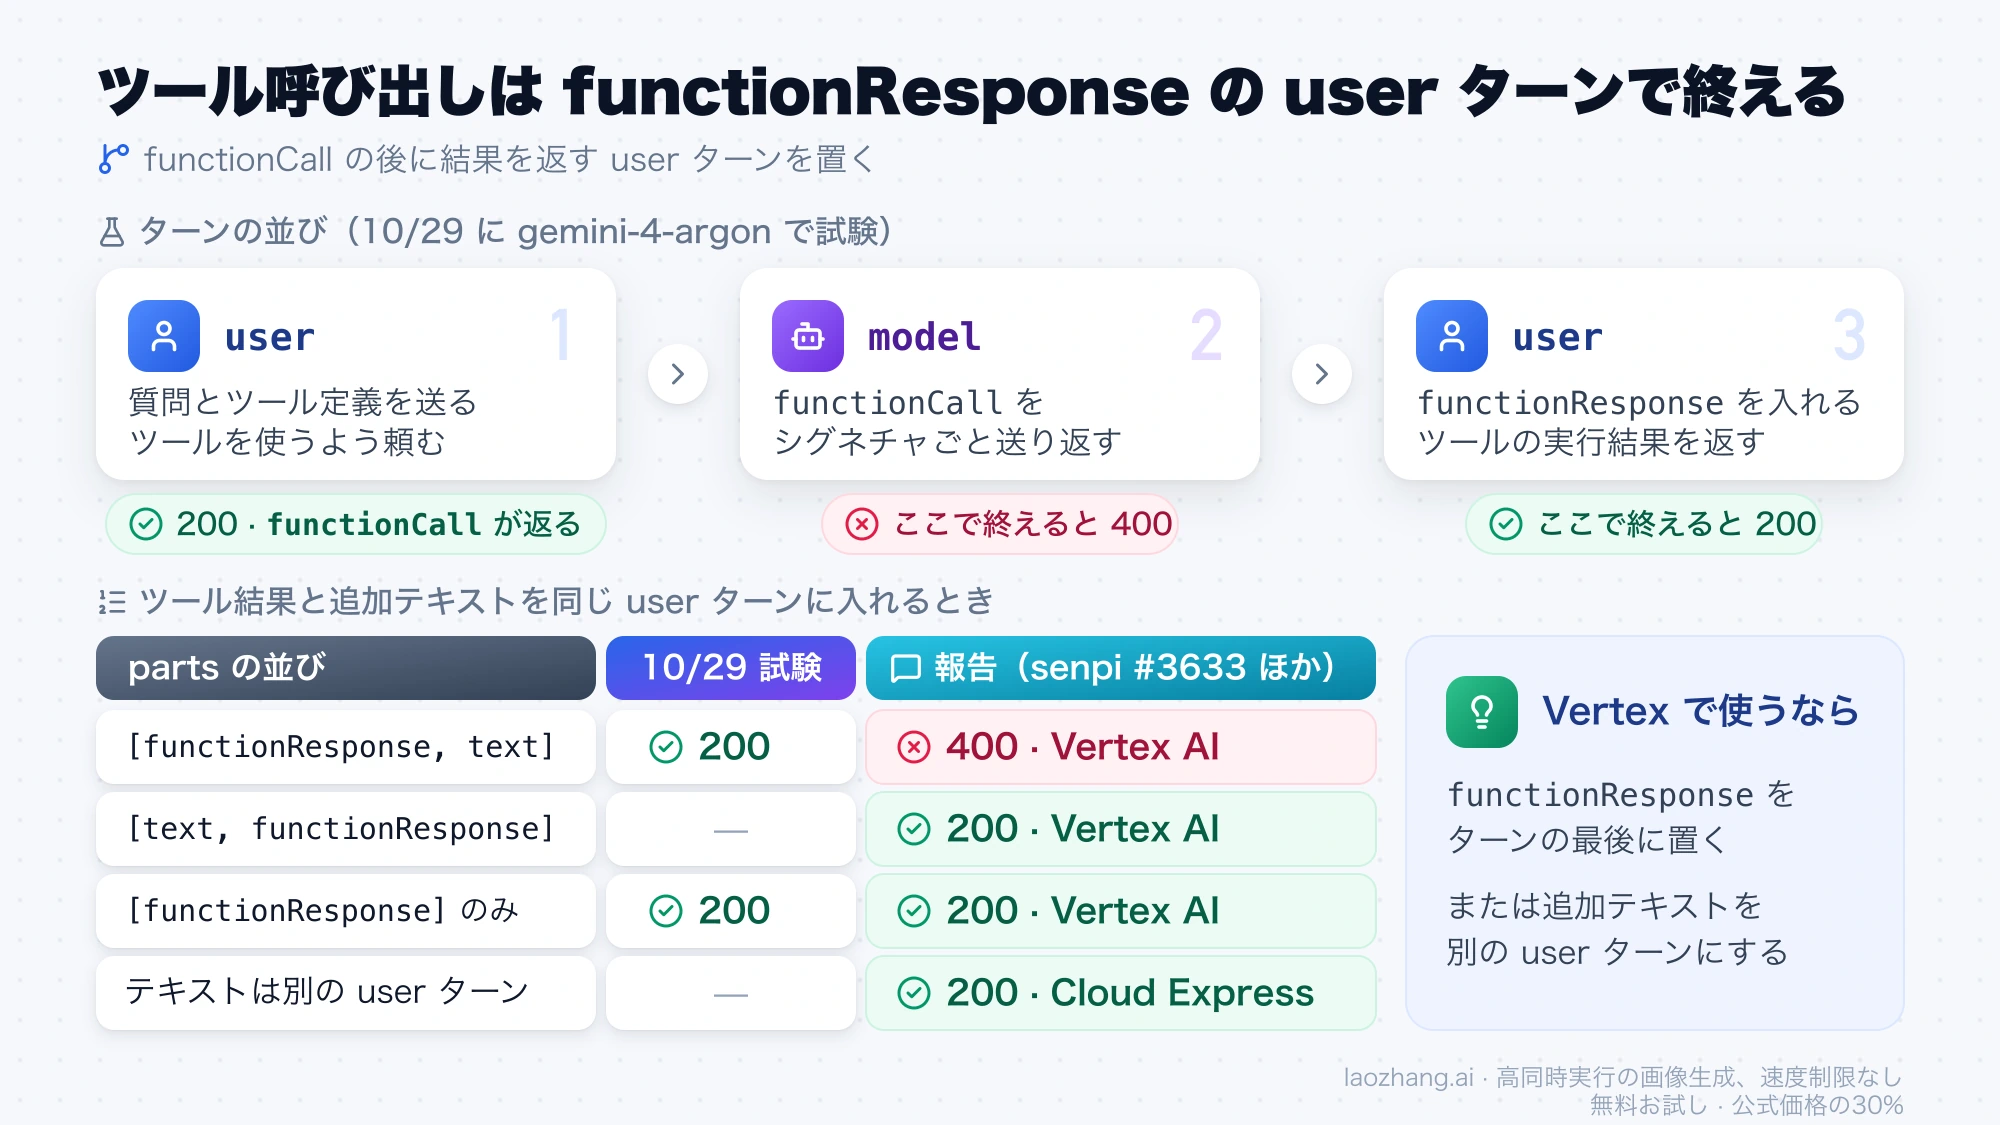
ツール呼び出しでは、モデルが返した functionCall のターンを thoughtSignature も含めて手を加えずに送り返し、その後に functionResponse を入れた user ターンを置きます。Google の Argon 移行ページも、マルチターンと関数呼び出しでは思考シグネチャ(thought signature)を含む履歴全体を渡すよう求めています。senpi の GitHub issue #3633(2026年10月18日)では、Argon が失敗した後のフォールバック先 gemini-3.1-pro-preview で、シグネチャのない functionCall を最後の model ターンに置くと「Function call is missing a thought_signature」という別の 400 になり、それより前の model ターンにある場合は受け付けられたと報告されています。
"contents": [
  { "role": "user", "parts": [{ "text": "パリの今の気温は?ツールを使って調べて" }] },
  { "role": "model", "parts": [{
      "functionCall": { "name": "get_weather", "args": { "city": "Paris" } },
      "thoughtSignature": "返ってきた値をそのまま入れる"
  }] },
  { "role": "user", "parts": [{
      "functionResponse": { "name": "get_weather", "response": { "temperature_c": 14 } }
  }] }
]
Vertex AI では、ツール結果と追加のテキストを同じ user ターンに [functionResponse, text] の順で入れると 400 になるという報告が複数あります。上の senpi #3633 は Vertex の Gemini 4 Argon での報告で、[functionResponse] だけ、または [text, functionResponse] の順なら 200 でした。同じ issue への 2026年10月28日のコメントでは、LiteLLM 1.101.0 から Google Cloud Express の gemini-4-argon に送り、ツール結果とテキストを 2 つの Content に分けると 200 になっています。Vertex を使うなら、functionResponse をそのターンの最後に置くか、追加テキストを別の user ターンに分けます。
この 400 はリトライしないでください。Google の Gemini API トラブルシューティングガイドは、429、408、5xx のような一時的なエラーだけを再試行し、400 などのクライアントエラーは再試行しないよう求めています。senpi のメンテナーも 2026年10月20日、この 400 を過負荷のクールダウンとして扱うと正常なモデルまで外してしまうので、リクエストのエラーとして分類すべきだと書いています。
gemini-4-argon で試した結果:最後の 1 ターンで 200 と 400 が入れ替わる
2026年10月29日 03:00〜03:05 UTC に、gemini-4-argon へ 1 か所ずつ形を変えたリクエストを送ったところ、同じ会話でも最後のターンが model なら 400、user なら 200 になりました。経路は laozhang.ai の Gemini ネイティブ形式の generateContent エンドポイントで、SDK を使わない REST、thinkingLevel: "low" です。200 の応答はすべて modelVersion: gemini-4-argon でした。400 の本文には modelVersion がないため、Argon の判定とみなす根拠は、指定したモデル ID と Google が公開しているルールです。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
| 送った contents(右端が最後) | 結果 |
|---|---|
[user] | 200 |
[user, model "Rain"](プリフィル) | 400(03:13 UTC の再送でも同じ) |
[user, model, user, model](応答を保存した直後の履歴) | 400 |
| 上の履歴から最後の model を外し、user で終える | 200 |
[user] とツール定義 | 200(functionCall が返る) |
[user, model(functionCall)](ツール結果を返す前) | 400 |
[user, model(functionCall), user(functionResponse)] | 200 |
[user, model(functionCall), user(functionResponse, text)] | 200 |
400 のメッセージはどれも Requests ending with a model turn are not supported. で、この経路では {"error":{"message":"…","type":"upstream_error","code":400}} という形で返りました。Google の API から直接受け取った場合は "status":"INVALID_ARGUMENT" を含む本文になるため、包み方は経路で変わっても、見るべきはメッセージの文言です。
最後の行の [functionResponse, text] は、この経路では 200 でしたが、前の節で触れた Vertex の報告では 400 です。同じ形でも経路によって結果が違うので、どちらか一方に一般化はできません。試験は 1 経路、1 日、各形 1 回(プリフィルのみ 2 回)の小さなサンプルです。[text, functionResponse] の順、ツール結果とテキストを 2 つの user ターンに分けた形、プリフィルを systemInstruction や JSON スキーマに置き換えた形は有効な結果が得られず、表に入れていません。前の節のこれらの直し方は、Google の推奨と Vertex 利用者の報告に基づいています。中身が空の model ターンで終える形は、ゲートウェイ側の 500 が続いたため結論が出ていません。
ツール別の状況:Gemini CLI・opencode・SillyTavern ほか
ツール経由で出ている場合、原因はツールがリクエストを組み立てる処理にあり、利用者に直せる範囲は限られます。2026年10月29日時点で、下の表のうち修正版が出ているのは Gemini CLI だけで、ほかは issue が開いたままか、修正版が出ていません。
| ツール | 出るきっかけ | 2026年10月29日時点の状況と対処 |
|---|---|---|
| Gemini CLI | /rewind や中断した生成の後、Ctrl-C の連打、ReadFile で .png を読んだ後(#29530、#29574、#29588) | 修正 PR #29612(10月7日マージ)と #29728(10月13日マージ)が v0.65.0(10月20日公開)に含まれる。v0.65.0 以降に更新する |
| opencode | ステップ上限の通知が assistant メッセージとして末尾に入る(steps を設定したサブエージェント、#45359)。OpenRouter 経由の Argon で read が画像を返した直後(#55694) | 未解決。#45359 は閉じられたが 1.18.31 でも再発の報告がある。新しいメッセージを送ると続行できる |
| Zoo Code、Kilo Code | Zoo Code は Vertex AI で、ツール利用のプリフィルとして model ターンを末尾に入れる(#1052)。Kilo Code は手順の保存順が前後して model ターンが最後に残る(#15073) | 未解決。Zoo Code の報告者は 3.5 Flash に戻して回避している |
| LangChain(langchain-google の Vertex AI) | ToolMessage と直後の HumanMessage が 1 つの user ターンにまとめられる(#1995) | 未解決。ツール結果の直後に HumanMessage を足さない |
| LiteLLM | Vertex の 3.7 Flash で、テキストだけの assistant メッセージで終わる履歴を送る(#38537) | 未解決。最後を user にし、ツール結果とテキストは別の Content に分ける |
| instructor | 構造化出力の再質問(reask)が model ターンで終わるリクエストになる(#2631) | 未解決 |
| OpenRouter 経由のエージェント(Hermes Agent など) | 画像を含むツール結果が最後のメッセージになる(hermes-agent #139313) | 未解決。ツール結果はテキストだけにし、画像は続く user メッセージで渡すと 200 になったと報告されている |
| LiveKit Agents(JS) | 割り込み(barge-in)で途中までの assistant メッセージが履歴の最後に入る(#2108) | 未解決。400 をリトライし続けてエージェントが無言になると報告されている |
| SillyTavern などのロールプレイ用フロントエンド | AI Studio のキーやプロキシ経由で、プリフィル、続き生成、返答の書き出し指定といった設定や拡張機能が末尾に model ターンを作る | 新しいチャットを実際の user メッセージで終わる状態にして試し、プリフィル系の設定を外してから 1 つずつ戻す |
Gemini CLI は npm で入れ直せば最新の安定版になります。手順は Gemini CLI インストール方法:npm手順と個人ログイン終了後の認証 にあります。v0.64 系に修正が個別に取り込まれているかは公開情報に記載がないため、v0.65.0 以降を目安にしてください。
SillyTavern 系では、入力欄に自分のメッセージがあっても、プリフィルや続き生成、履歴の変換、拡張機能によって最後に送られるメッセージが変わることがあります。EvoLink の SillyTavern と Gemini の設定トラブルシューティング記事(2026年10月16日)は、まず新しいチャットで実際の user メッセージを最後にして試し、その後で設定を 1 つずつ戻す手順を勧めています。Reddit の r/SillyTavernAI でも、プロンプトの末尾にある model ターンを取り除いたら 3.6 Flash でエラーが消えたという書き込みがあります。設定項目の名前はバージョンやプリセットで違うため、assistant prefill、続き生成、返答の書き出し指定に当たる設定を探してください。
Gemini 4 Argon の countTokens が 400 を返すという報告
Gemini 4 Argon で countTokens が同じ 400 を返したという報告は、2026年10月29日時点で 1 件です。Obsidian 用プラグイン Gemini Scribe のメンテナー allenhutchison 氏が 2026年10月27日に立てた obsidian-gemini の GitHub issue #1708 によると、チャットモデルを gemini-4-argon にすると、新しいセッションの最初のターンで models.countTokens が {"error":{"code":400,"message":"Requests ending wi…are not supported.","status":"INVALID_ARGUMENT"}} を返しました。ログでメッセージの途中が切れているため全文は分かっておらず、同じ流れを gemini-flash-latest で行うと失敗しなかったとしています。
報告者の仮説は、応答を保存した直後のセッション履歴は model ターンで終わっており、Argon は contents が model で終わる countTokens も拒否する、というものです。2026年10月29日の generateContent の試験で、応答直後の履歴が 400 になり user ターンを足すと 200 になったことは、この仮説と整合しますが、証明にはなりません。プラグイン側ではエラーを処理しており会話は続きますが、新しいセッションではトークン数が 0 と表示され、履歴を圧縮するしきい値の計算にも数が入りません。
対処の方針は、数える対象を最後の user ターンまでに切り詰めるか、次に送る user メッセージを足してから数えることです。issue でもこの 2 つが修正案として挙がっています。Firebase AI Logic のトークン数のドキュメント(2026年10月27日更新)によると、countTokens は対応モデルに gemini-4-argon を含み、呼び出しは無料、上限は毎分 3,000 リクエストで、入力の数にはシステム指示とツールも含まれます。実際に送る内容と同じ数を出すには、systemInstruction とツール定義も一緒に渡します。
from google import genai

client = genai.Client()

def count_until_last_user(model, history):
    # 最後の user ターンまでに切り詰めてから数える
    last_user = max(i for i, c in enumerate(history) if c["role"] == "user")
return client.models.count_tokens(model=model, contents=history[: last_user + 1])直前に送ったリクエストの入力トークン数でよければ、generateContent の応答に必ず付く usageMetadata.promptTokenCount を読む方法もあります。同じドキュメントは、usageMetadata が追加のトークンや料金なしで返ると説明しています。
中継サービスを挟んでいる場合は、その 400 が Google から来たものかを先に確かめます。上の試験と同じゲートウェイ経路では、gemini-4-argon の :countTokens は最後が user でも model でも {"error":{"message":"unsupported action: countTokens","type":"invalid_request_error"}} の 400 を返しました(2026年10月29日)。これは Google ではなくゲートウェイが返す別の 400 で、countTokens 自体に対応していないという意味です。
Requests ending with a model turn のよくある質問
「role system is not supported」と同じエラーですか?
別のエラーです。「role system is not supported」は system ロールを受け付けないモデルに system メッセージを送ったときの 400 で、直し方は API 400 の role 未対応エラーを、システム指示を壊さず直す を参照してください。
Claude でも同じエラーになりますか?
Claude にも、assistant で終わるリクエスト(assistant prefill)を 400 で拒否するモデルがあります。対象モデルと代わりの方法は Claude assistant prefill 400 エラー:非対応モデルと代替手段 を参照してください。
Gemini 3.5 Flash に戻せば通りますか?
2026年10月29日時点で、Google のルールの対象は Gemini 3.6 Flash と 3.5 Flash-Lite 以降です。LINUX DO の 2026年7月22日の投稿と Zoo Code の GitHub issue #1052 の報告者は、3.5 Flash ではプリフィルがまだ通ると書いています。ただし以降のモデルはすべて拒否するので、モデルを戻すのは一時しのぎで、リクエストの形を直すほうが長く使えます。
途中で切れた回答の続きを書かせるにはどうすればいいですか?
途中までの回答を model ターンとして末尾に置き、続きを書かせる方法は、Gemini 3.6 Flash 以降と Gemini 4 Argon では使えません。Argon で長い回答が切れたときの続け方は Gemini 4 Argon APIのfinish_reason:途中で切れる回答の続け方 を参照してください。
参考資料8
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月29日。
参考資料8
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月29日。
- 1.Gemini API「What's new in Gemini 3.6」ページai.google.dev/gemini-api/docs/whats-new-gemini-3.6
- 2.Gemini API の generateContent 版構造化出力ガイドai.google.dev/gemini-api/docs/generate-content/structured-output
- 3.GitHub issue #3633github.com/code-yeongyu/senpi/issues/3633
- 4.Gemini API トラブルシューティングガイドai.google.dev/gemini-api/docs/troubleshooting
- 5.SillyTavern と Gemini の設定トラブルシューティング記事evolink.ai/blog/sillytavern-gemini-setup-troubleshooting
- 6.obsidian-gemini の GitHub issue #1708github.com/allenhutchison/obsidian-gemini/issues/1708
- 7.Firebase AI Logic のトークン数のドキュメントfirebase.google.com/docs/ai-logic/count-tokens
- 8.GitHub issue #1052github.com/Zoo-Code-Org/Zoo-Code/issues/1052