Claude Opus 4.6 vs GPT-5.3-Codex: costes y pruebas para elegir
GPT-5.3-Codex cuesta menos por token; Opus 4.6 admite más contexto. Compara las tarifas API, la caché y el coste por entrega con una prueba reproducible.
En esta página
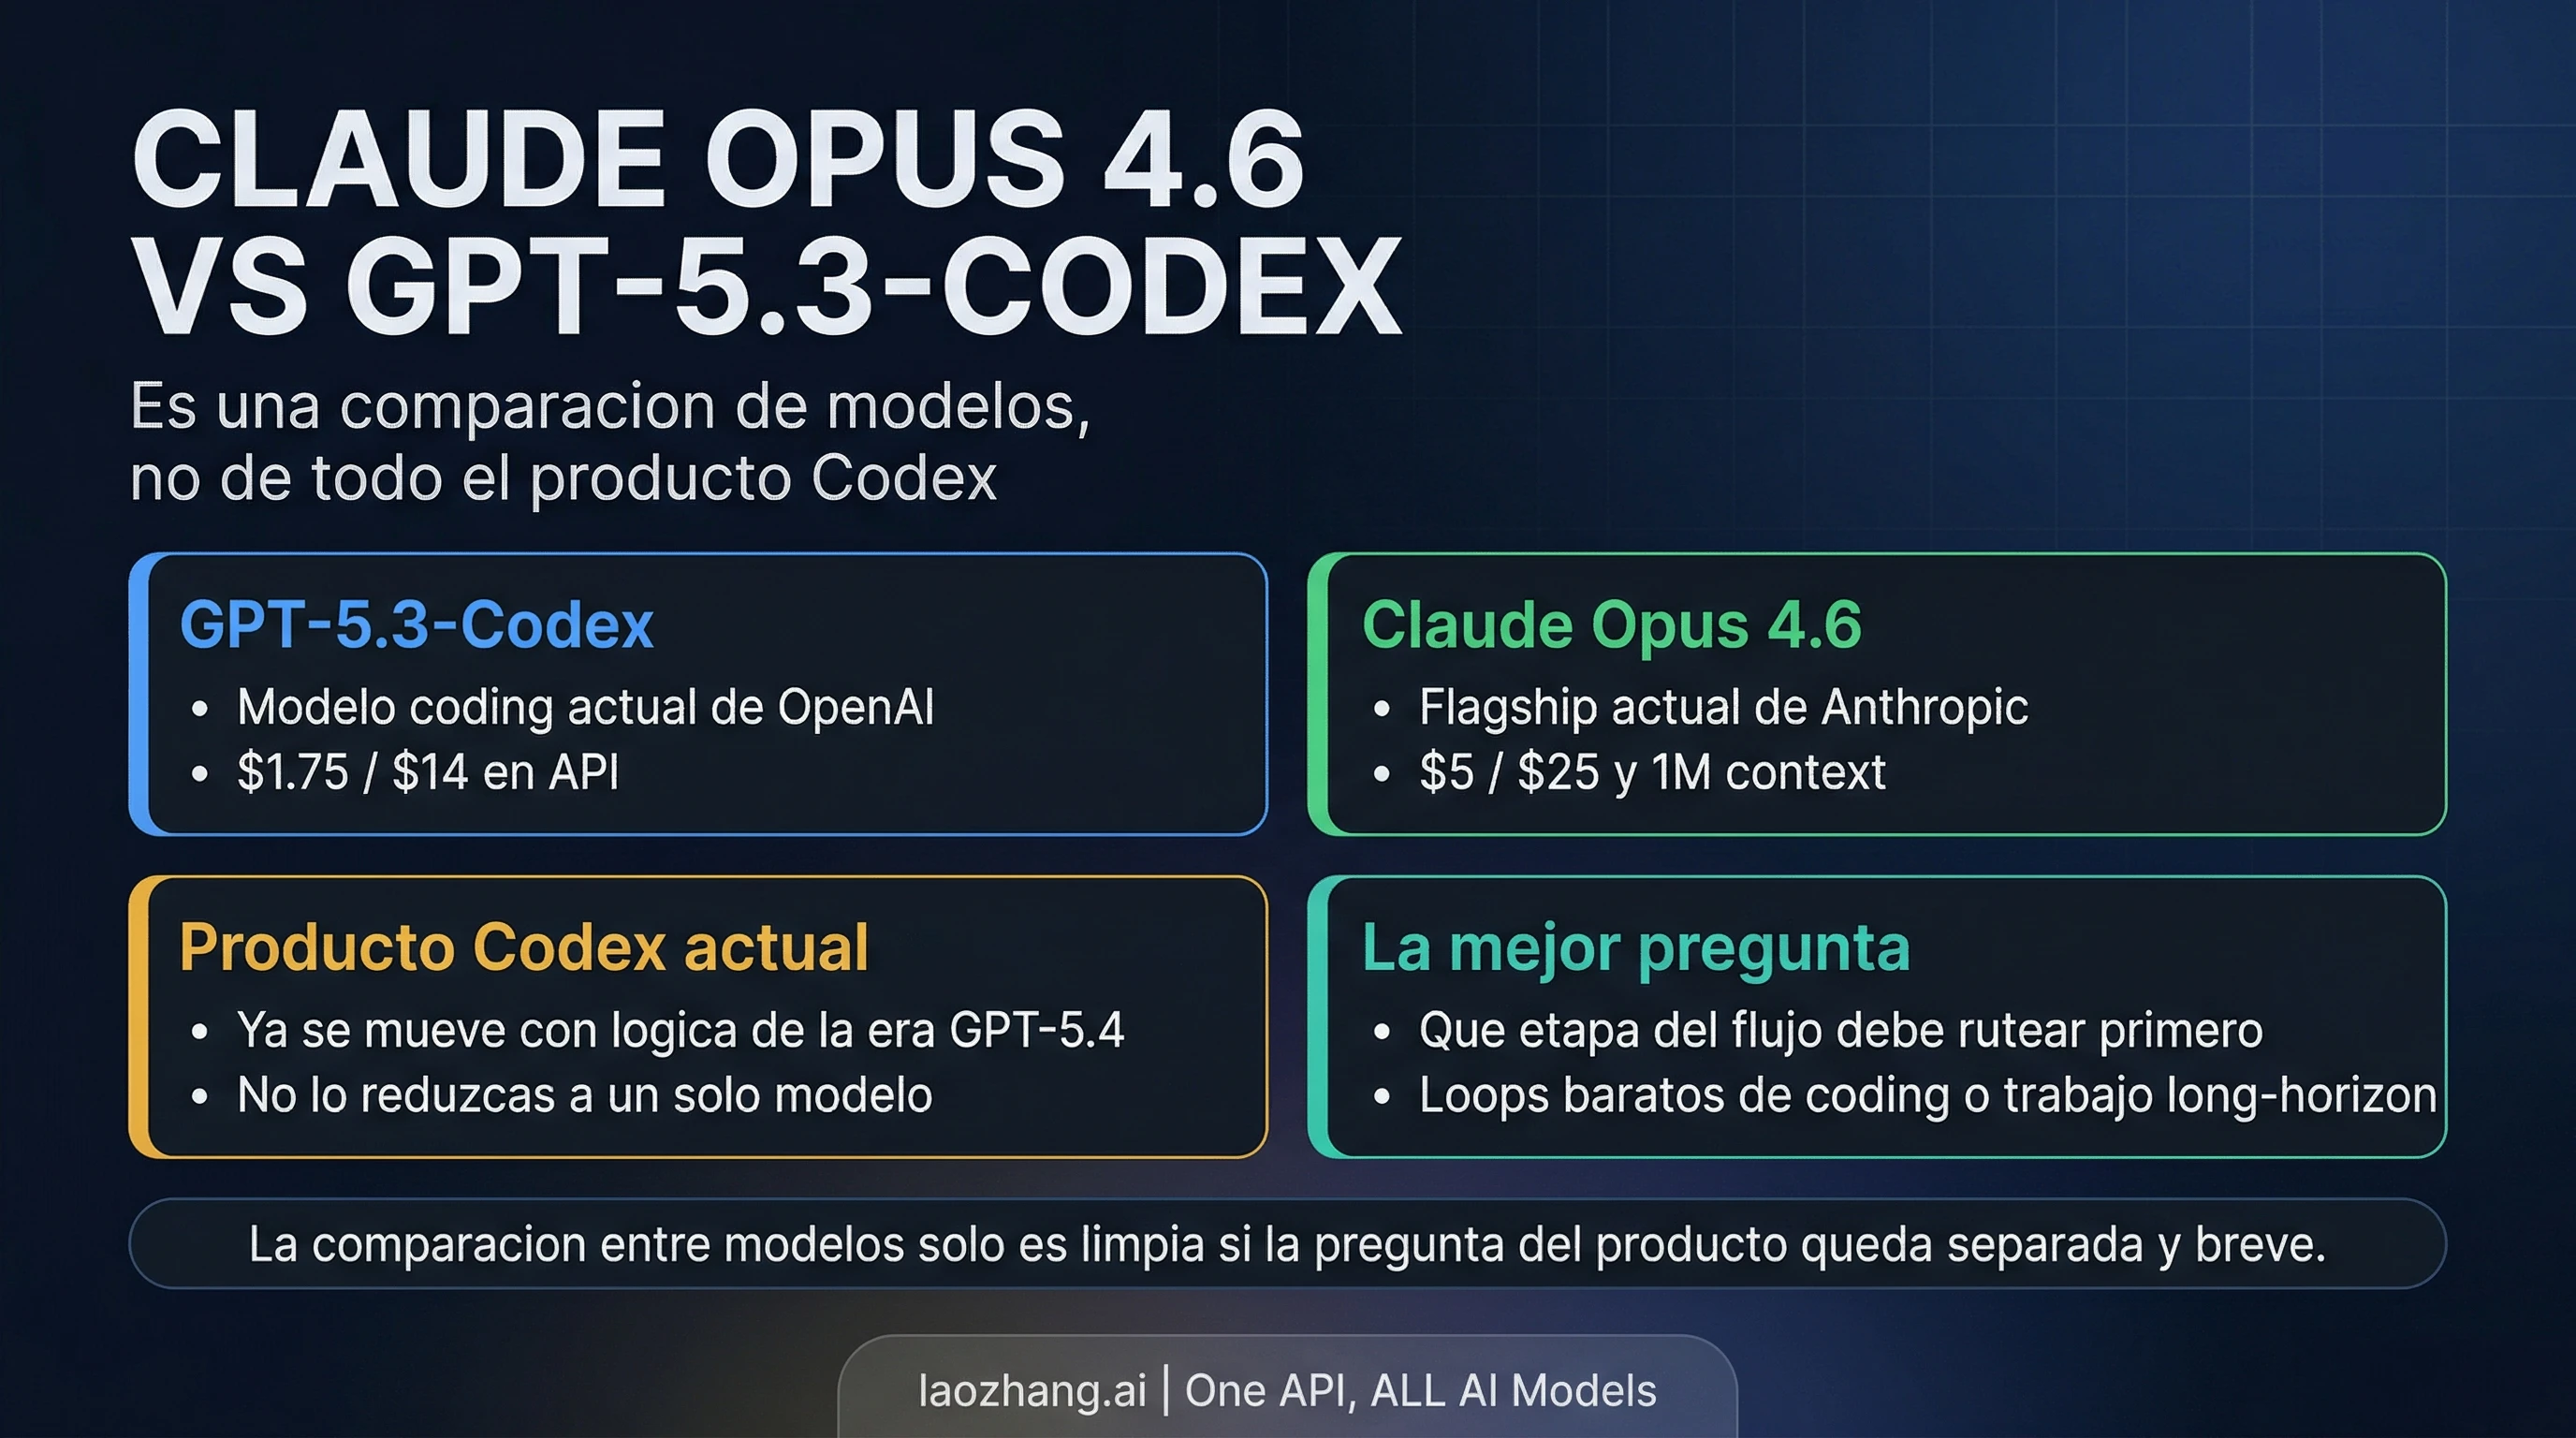
GPT-5.3-Codex tiene una tarifa API inferior en entrada, lectura de caché y salida. Claude Opus 4.6 ofrece una ventana de contexto mayor: un millón de tokens frente a 400.000. Estas diferencias permiten elegir qué probar primero, pero no demuestran qué modelo resolverá mejor los errores de tu repositorio. Para decidirlo, mide las entregas que pasan tus pruebas, los reintentos y el tiempo de revisión.
Esta comparación, revisada el 7 de septiembre de 2026, está dirigida a quienes evalúan o mantienen flujos de programación con estos dos modelos concretos. Utiliza documentación oficial y cálculos ilustrativos; no hemos ejecutado una prueba comparativa de pago. Las tarifas proceden de la ficha de GPT-5.3-Codex y de la documentación de Claude Opus 4.6.
Qué cambia al sustituir un modelo por el otro
El nombre del modelo determina capacidades y facturación de la API. El programa que lo utiliza determina también qué archivos puede leer, qué comandos ejecuta y cómo conserva el historial. Si cambias ambos a la vez, estarás comparando dos sistemas completos. Para elegir una herramienta de desarrollo, consulta Claude Code vs Codex.
| Característica | GPT-5.3-Codex | Claude Opus 4.6 |
|---|---|---|
| Identificador de API | gpt-5.3-codex | claude-opus-4-6 |
| Ventana de contexto | 400.000 tokens | 1.000.000 de tokens |
| Salida máxima ordinaria | 128.000 tokens | 128.000 tokens |
| Ajuste del razonamiento | low, medium, high, xhigh | Razonamiento adaptativo; esfuerzo high por defecto |
| Entrada sin caché, por millón de tokens | 1,75 USD | 5 USD |
| Salida, por millón de tokens | 14 USD | 25 USD |
Fuentes: especificaciones de OpenAI y especificaciones de Anthropic. Los niveles de esfuerzo no constituyen una escala común: seleccionar high en ambos no garantiza el mismo consumo ni un razonamiento equivalente.
Una ventana de contexto es el espacio disponible para trabajar con instrucciones, historial y contenido de la petición; no es una promesa de que todo un repositorio quepa ni de que el modelo encuentre cada dependencia relevante. Tampoco debes sumar la salida máxima al contexto como si fueran dos capacidades independientes. En GPT-5.3-Codex, la documentación técnica especifica un máximo de entrada de 272.000 tokens junto a la ventana total de 400.000.
Opus 4.6 resulta pertinente para una evaluación cuando necesitas conservar más material en una misma petición y dividirlo alteraría la tarea. Ese margen no permite deducir que produzca menos regresiones. Si el material útil cabe en ambos, la diferencia de contexto por sí sola no resuelve la elección. Anthropic documenta además una excepción de hasta 300.000 tokens de salida para Opus 4.6 en una modalidad beta de Batch; no es el límite de las peticiones ordinarias. Detalles de límites y modalidades.
La caché debe entrar en las dos cuentas
En un agente de programación, las instrucciones del proyecto y parte del código pueden repetirse durante varios turnos. Si el proveedor reconoce esos tokens como una lectura de caché, cambia su precio. Conviene separar una petición inicial, una escritura de caché y una lectura posterior: no cuestan lo mismo.
| Concepto, por millón de tokens | GPT-5.3-Codex | Claude Opus 4.6 |
|---|---|---|
| Entrada ordinaria | 1,75 USD | 5 USD |
| Entrada leída de caché | 0,175 USD | 0,50 USD |
| Escritura de caché de 5 minutos | Sin tarifa de escritura separada en la ficha del modelo | 6,25 USD |
| Escritura de caché de 1 hora | Sin tarifa de escritura separada en la ficha del modelo | 10 USD |
| Salida | 14 USD | 25 USD |
Son tarifas estándar de API en USD. Las referencias son la ficha de precios de GPT-5.3-Codex y la tabla de precios y caché de Anthropic. En Opus 4.6, el millón de tokens de contexto admite la tarifa estándar; determinadas opciones regionales o de procesamiento pueden modificar el precio. Una suscripción a una aplicación y su cuota de uso no equivalen a estas tarifas de API.
Ejemplo: una petición con 10.000 tokens de entrada y 2.000 de salida
Fijamos las mismas cantidades para aislar la diferencia de tarifa. Es un cálculo hipotético: el mismo código puede producir cantidades de tokens distintas en cada proveedor y una tarea real suele consumir varias peticiones.
Sin caché, GPT-5.3-Codex costaría:
10.000 × 1,75 / 1.000.000 + 2.000 × 14 / 1.000.000 = 0,0455 USD
Claude Opus 4.6 costaría:
10.000 × 5 / 1.000.000 + 2.000 × 25 / 1.000.000 = 0,10 USD
Ahora supongamos que una petición posterior tiene 2.000 tokens nuevos y 8.000 tokens efectivamente leídos de caché, con los mismos 2.000 tokens de salida:
| Petición ilustrativa | GPT-5.3-Codex | Claude Opus 4.6 |
|---|---|---|
| 10.000 de entrada sin caché + 2.000 de salida | 0,0455 USD | 0,10 USD |
| 2.000 nuevos + 8.000 de caché + 2.000 de salida | 0,0329 USD | 0,064 USD |
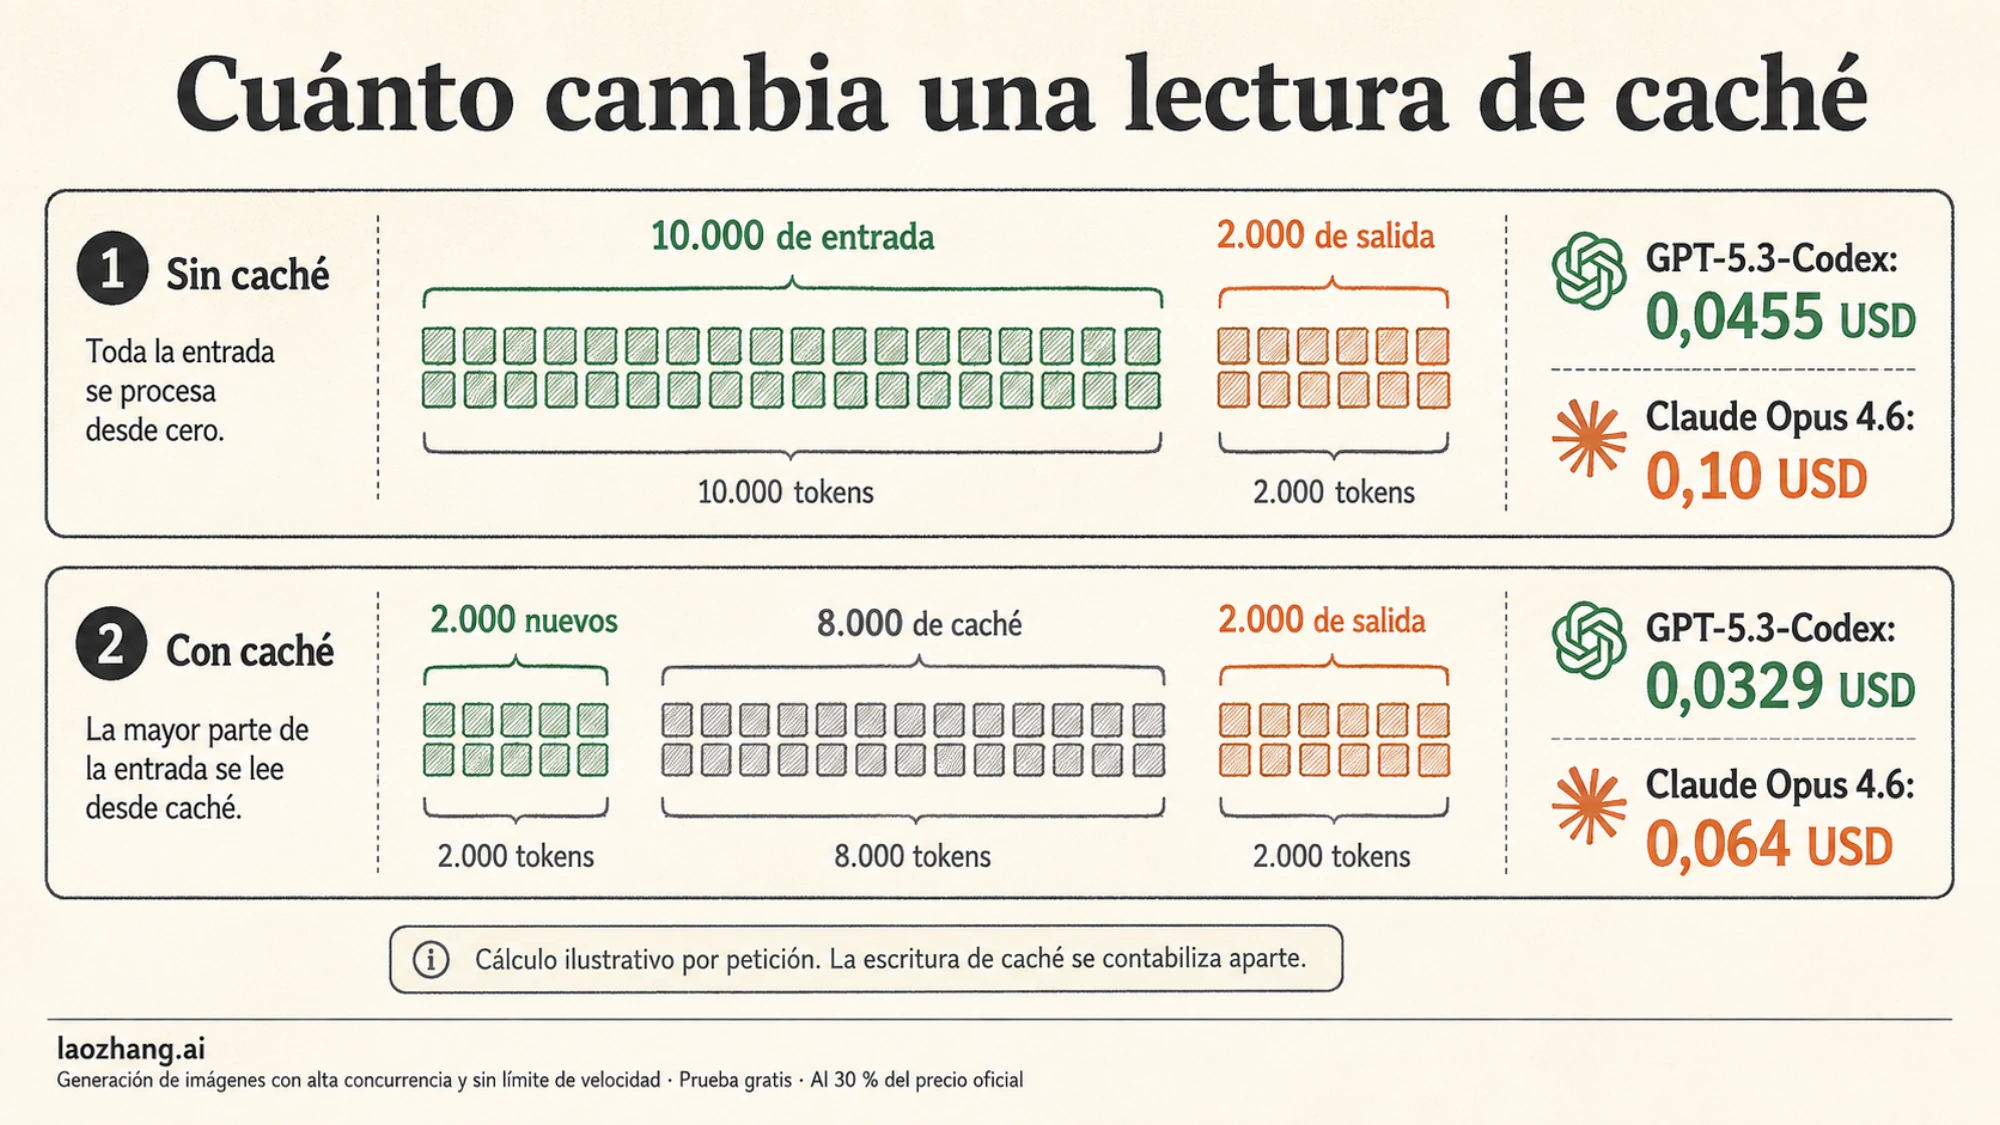
En Opus, preparar esos 8.000 tokens mediante una escritura de cinco minutos, con 2.000 tokens nuevos y 2.000 de salida, costaría 0,11 USD; con escritura de una hora, 0,14 USD. La escritura sustituye la tarifa ordinaria para esos 8.000 tokens: no hay que cobrarlos también como entrada nueva. Por eso el ahorro de una lectura posterior no representa, por sí solo, el coste de toda la conversación.
Usa el desglose de consumo devuelto por la API para saber qué se leyó o escribió realmente. Repetir texto no basta para dar por hecho un acierto de caché. Estos ejemplos tampoco incluyen herramientas de pago, servicios adicionales ni nuevas peticiones generadas por reintentos.
Por qué una puntuación pública no predice tu entrega
Las pruebas publicadas sirven para conocer los escenarios evaluados y sus condiciones. El anexo de lanzamiento de GPT-5.3-Codex presenta resultados con esfuerzo xhigh; el anuncio de Opus 4.6 recoge evaluaciones de programación, contexto largo y uso del ordenador. Son resultados publicados por los respectivos fabricantes.
Antes de comparar una cifra, comprueba la versión de la prueba, el programa que controla el agente, las herramientas y el presupuesto de ejecución. Terminal-Bench estudia tareas de terminal; OSWorld estudia el uso de interfaces gráficas. Una puntuación de OSWorld no mide directamente cuántas regresiones introducirá un cambio en tu API.
También hay que separar la fecha de un anuncio de la documentación vigente. Una restricción de acceso descrita en un lanzamiento puede haber cambiado. Para integrar estos modelos, utiliza su ficha actual y registra el identificador que realmente ejecutaste; no deduzcas la disponibilidad de una API a partir de una noticia antigua.
Una comparación que puedes repetir en tu repositorio
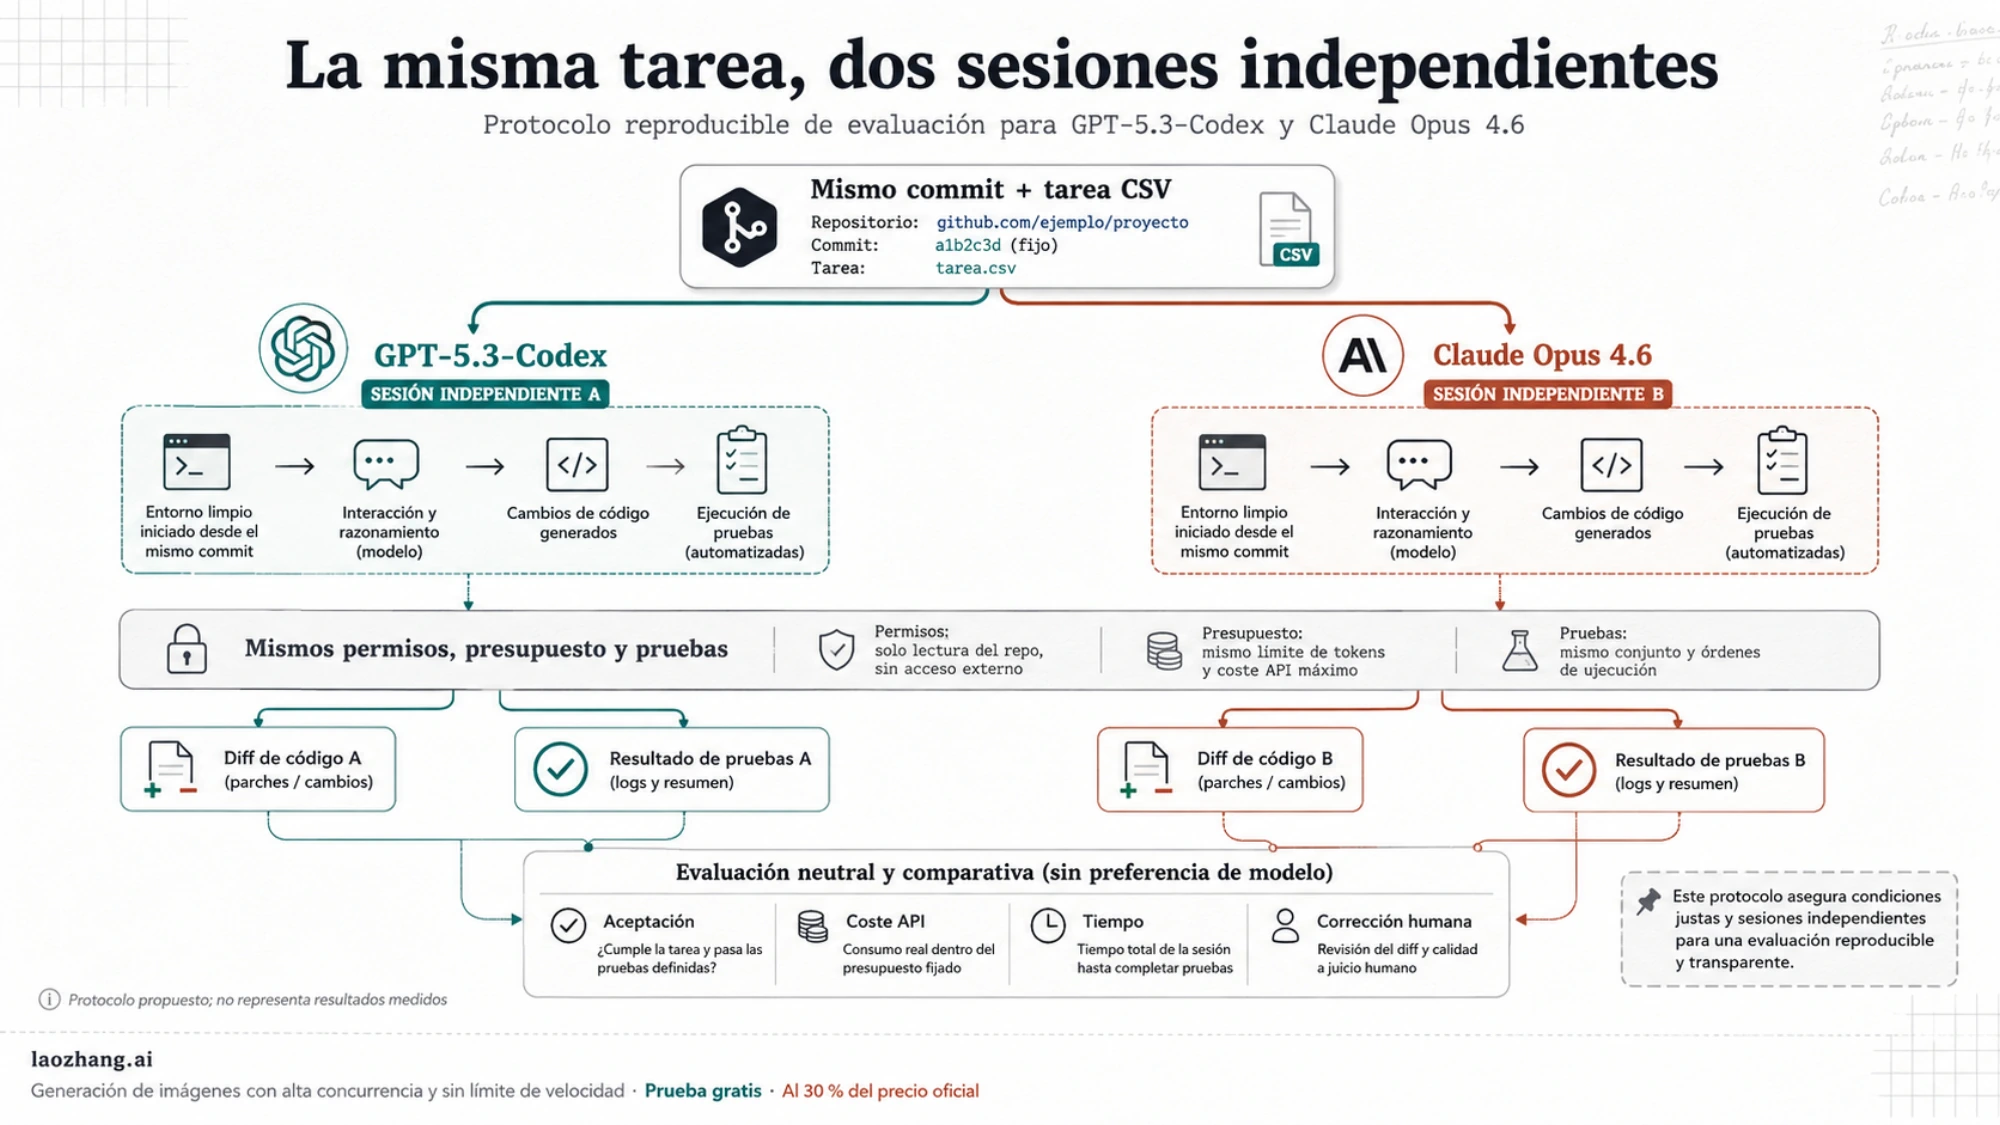
La siguiente propuesta permite evaluar una reparación concreta sin convertir impresiones de conversación en resultados técnicos. Es un protocolo sugerido, no una prueba que hayamos realizado.
- Congela el punto de partida. Anota el commit con
git rev-parse HEAD. Prepara una copia limpia para cada modelo, con las mismas dependencias y las mismas variables de configuración. Comprueba primero qué pruebas ya fallan sin modificaciones. - Escribe la tarea y la aceptación antes de empezar. Especifica el comportamiento esperado, los archivos que pueden cambiar y las restricciones. Entrega el mismo texto y los mismos archivos iniciales a ambos modelos.
- Iguala los permisos y el presupuesto. Define acceso a terminal, red, instalación de dependencias y ejecución de pruebas. Fija un límite de tiempo, un presupuesto monetario y un máximo de intentos. Registra el esfuerzo de razonamiento de cada modelo, aunque sus opciones no sean equivalentes.
- Ejecuta sesiones nuevas. No pases al segundo modelo el diagnóstico ni el parche del primero. Conserva los comandos, el cambio final, el consumo facturado y los errores. Si una ejecución se interrumpe por un problema del entorno, identifícalo por separado.
- Valida fuera de la conversación. Aplica las mismas pruebas de aceptación al cambio final y revisa el diff. Un mensaje del agente que diga «resuelto» no sustituye una prueba ejecutada. Cuenta cualquier corrección manual necesaria para aceptar el resultado.
Por ejemplo, toma un lector CSV de tu proyecto que separa incorrectamente los campos entrecomillados. El encargo puede exigir conservar su interfaz y añadir una prueba de regresión con este contenido:
id,descripcion
1,"cable, adaptador"
2,"monitor ""Pro"""
La aceptación se puede definir sin ambigüedad: dos registros; la descripción del primero debe ser cable, adaptador, y la del segundo, monitor "Pro". Repite el caso con y sin salto de línea al final, y exige que sigan pasando las pruebas existentes. Decide de antemano si se permiten nuevas dependencias. Así, ambos modelos reciben un problema con una salida comprobable y el mismo margen de implementación.
Esta reparación pequeña permite observar instrucciones, cambios y pruebas, pero no representa una migración de cien archivos. Añade tareas reales de distinta naturaleza —una regresión, un cambio que afecte a varios módulos y una investigación con abundante documentación— si esas son las cargas que necesitas cubrir. Mantén las condiciones de cada tarea y repite las ejecuciones para identificar resultados inestables.
Decide por coste de entrega, no por coste de una respuesta
Registra por ejecución el modelo y su configuración, tarea, resultado de las pruebas, archivos modificados, coste total de API, duración y minutos de corrección humana. Distingue «aceptada sin ayuda», «aceptada tras corrección» y «rechazada»: agruparlas como respuestas útiles oculta trabajo pendiente.
Una medida operativa sencilla es:
Coste de API por entrega aceptada = gasto de todos los intentos / número de entregas aceptadas
Incluye en el numerador los intentos fallidos y las escrituras de caché. Si no se acepta ninguna entrega, informa de ese resultado y del gasto; no inventes un coste unitario. Mantén el tiempo humano como una columna separada o conviértelo a dinero con una tarifa explícita del equipo.
Si tu contexto cabe en ambos y aún no tienes mediciones, la tarifa inferior de GPT-5.3-Codex permite empezar por una evaluación de menor coste por token. Si el contexto necesario supera lo que admite ese modelo y debe permanecer junto, Opus 4.6 ofrece una capacidad que merece probarse. Después, conserva el que cumpla tu umbral de aceptación con el coste y tiempo tolerables. Pagar más solo queda justificado por una necesidad concreta o por resultados comprobados en tu trabajo; mantener dos modelos tampoco es un requisito para obtener una buena solución.