Claude Structured Outputs: JSON válido con output_config.format
Pon tu JSON Schema en output_config.format y Claude responde con JSON parseable en el bloque text. Lo que el esquema no garantiza se valida en tu código.
En esta página
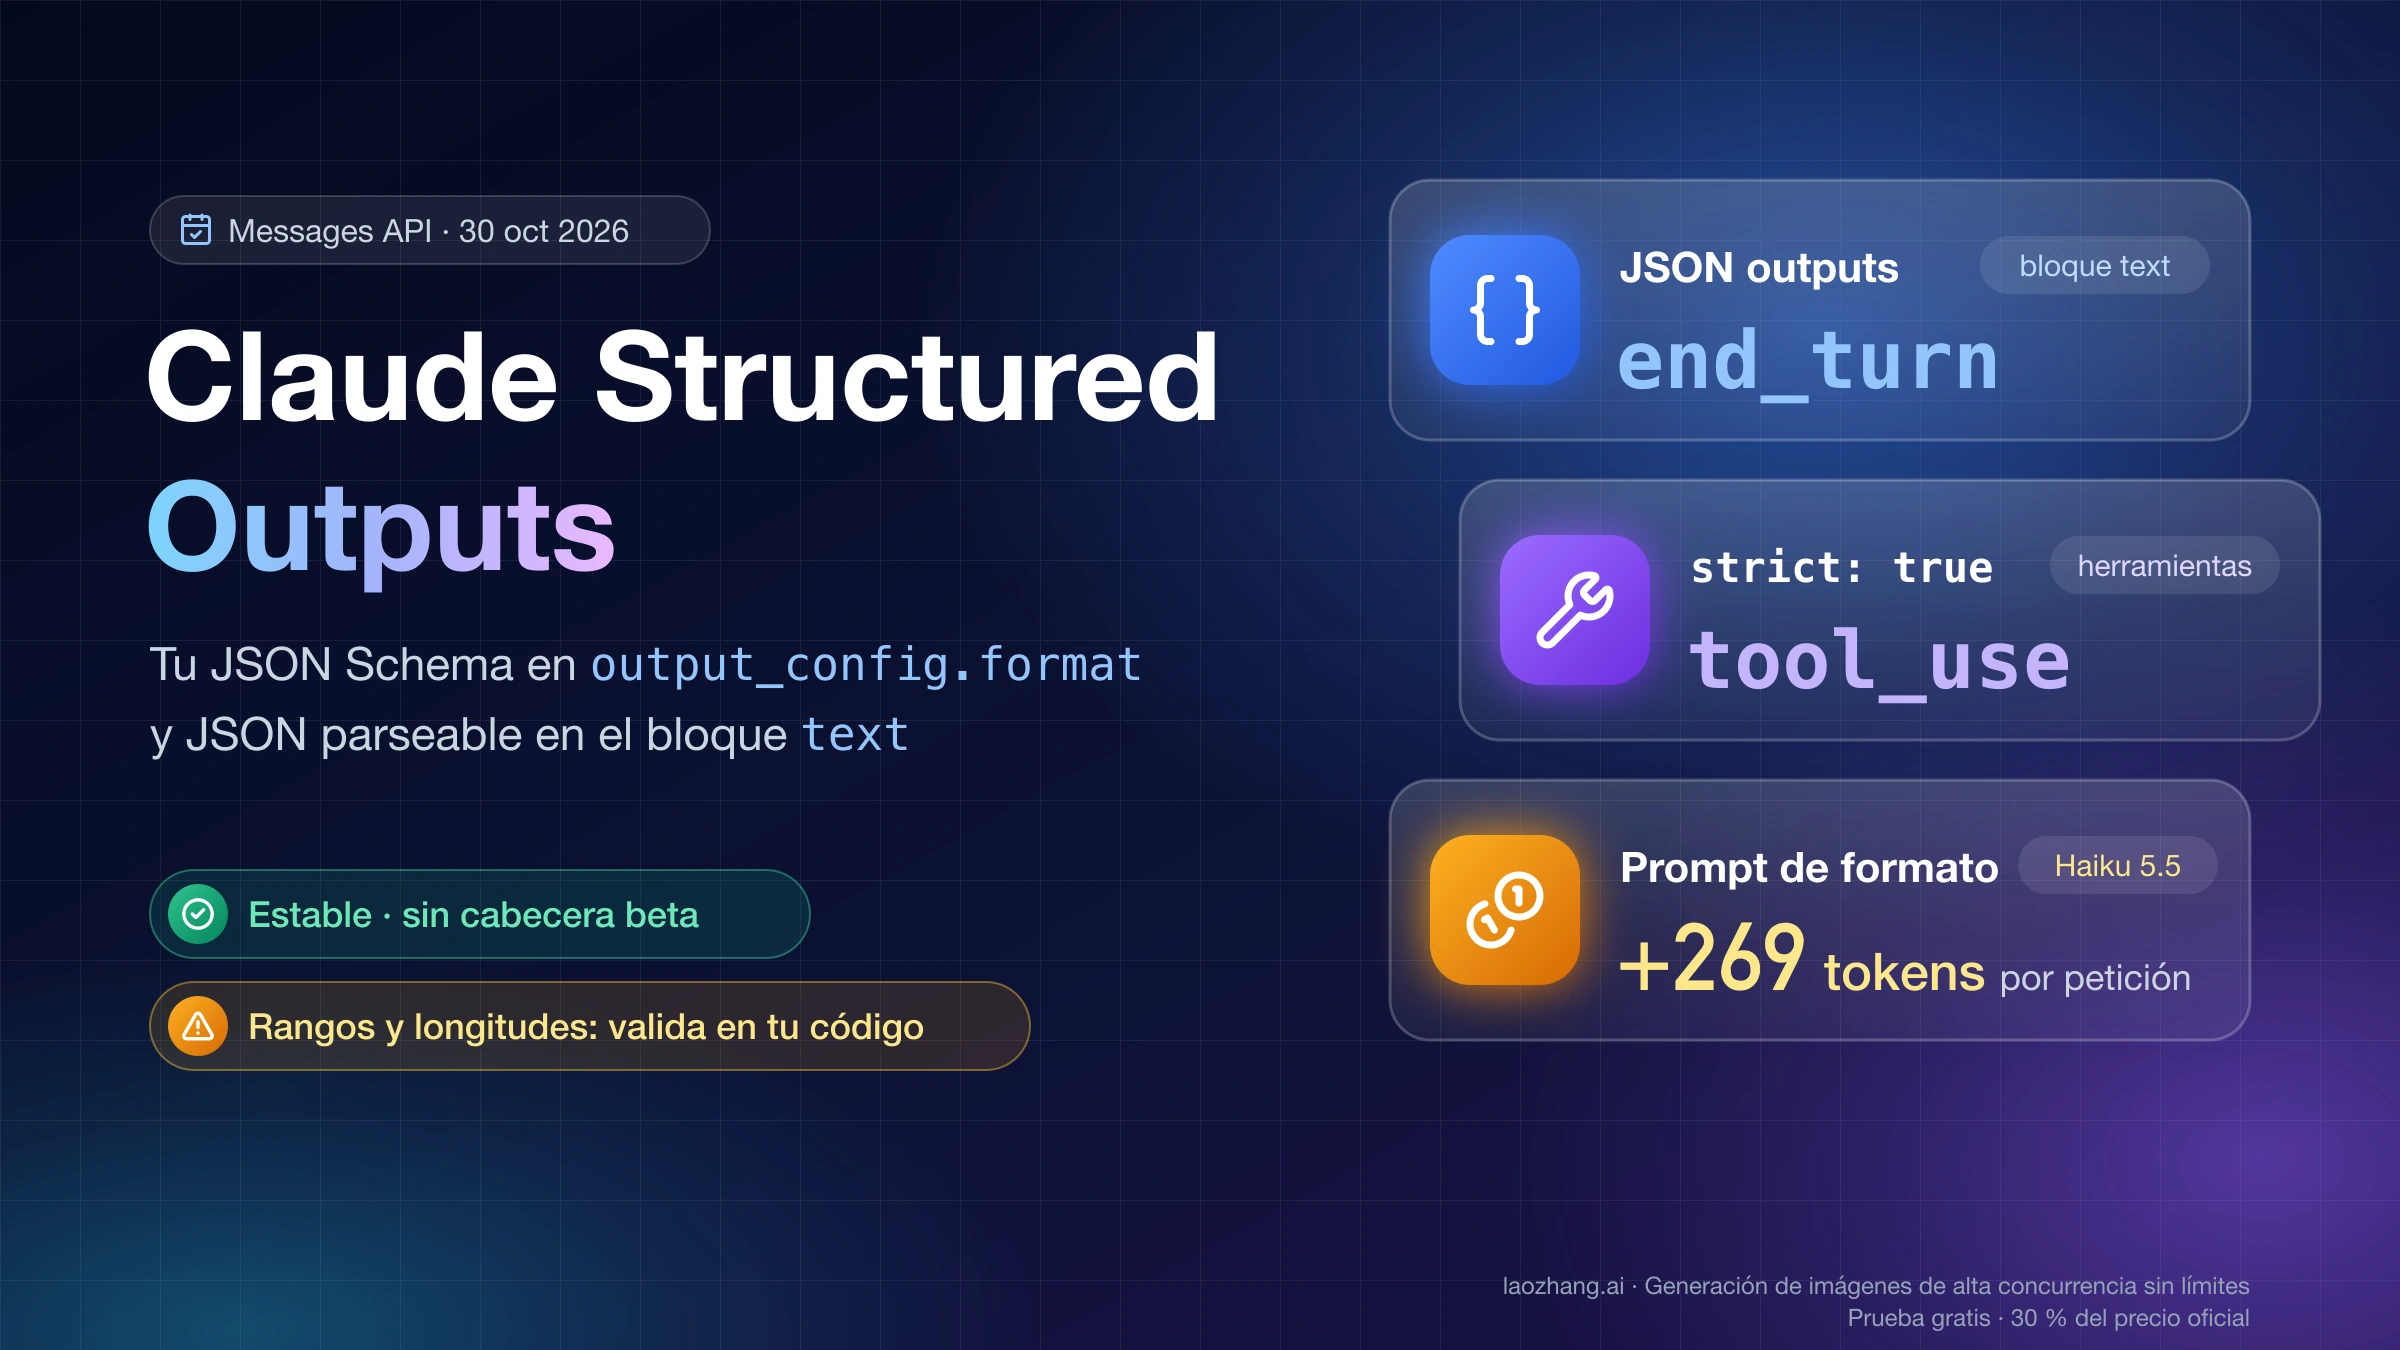
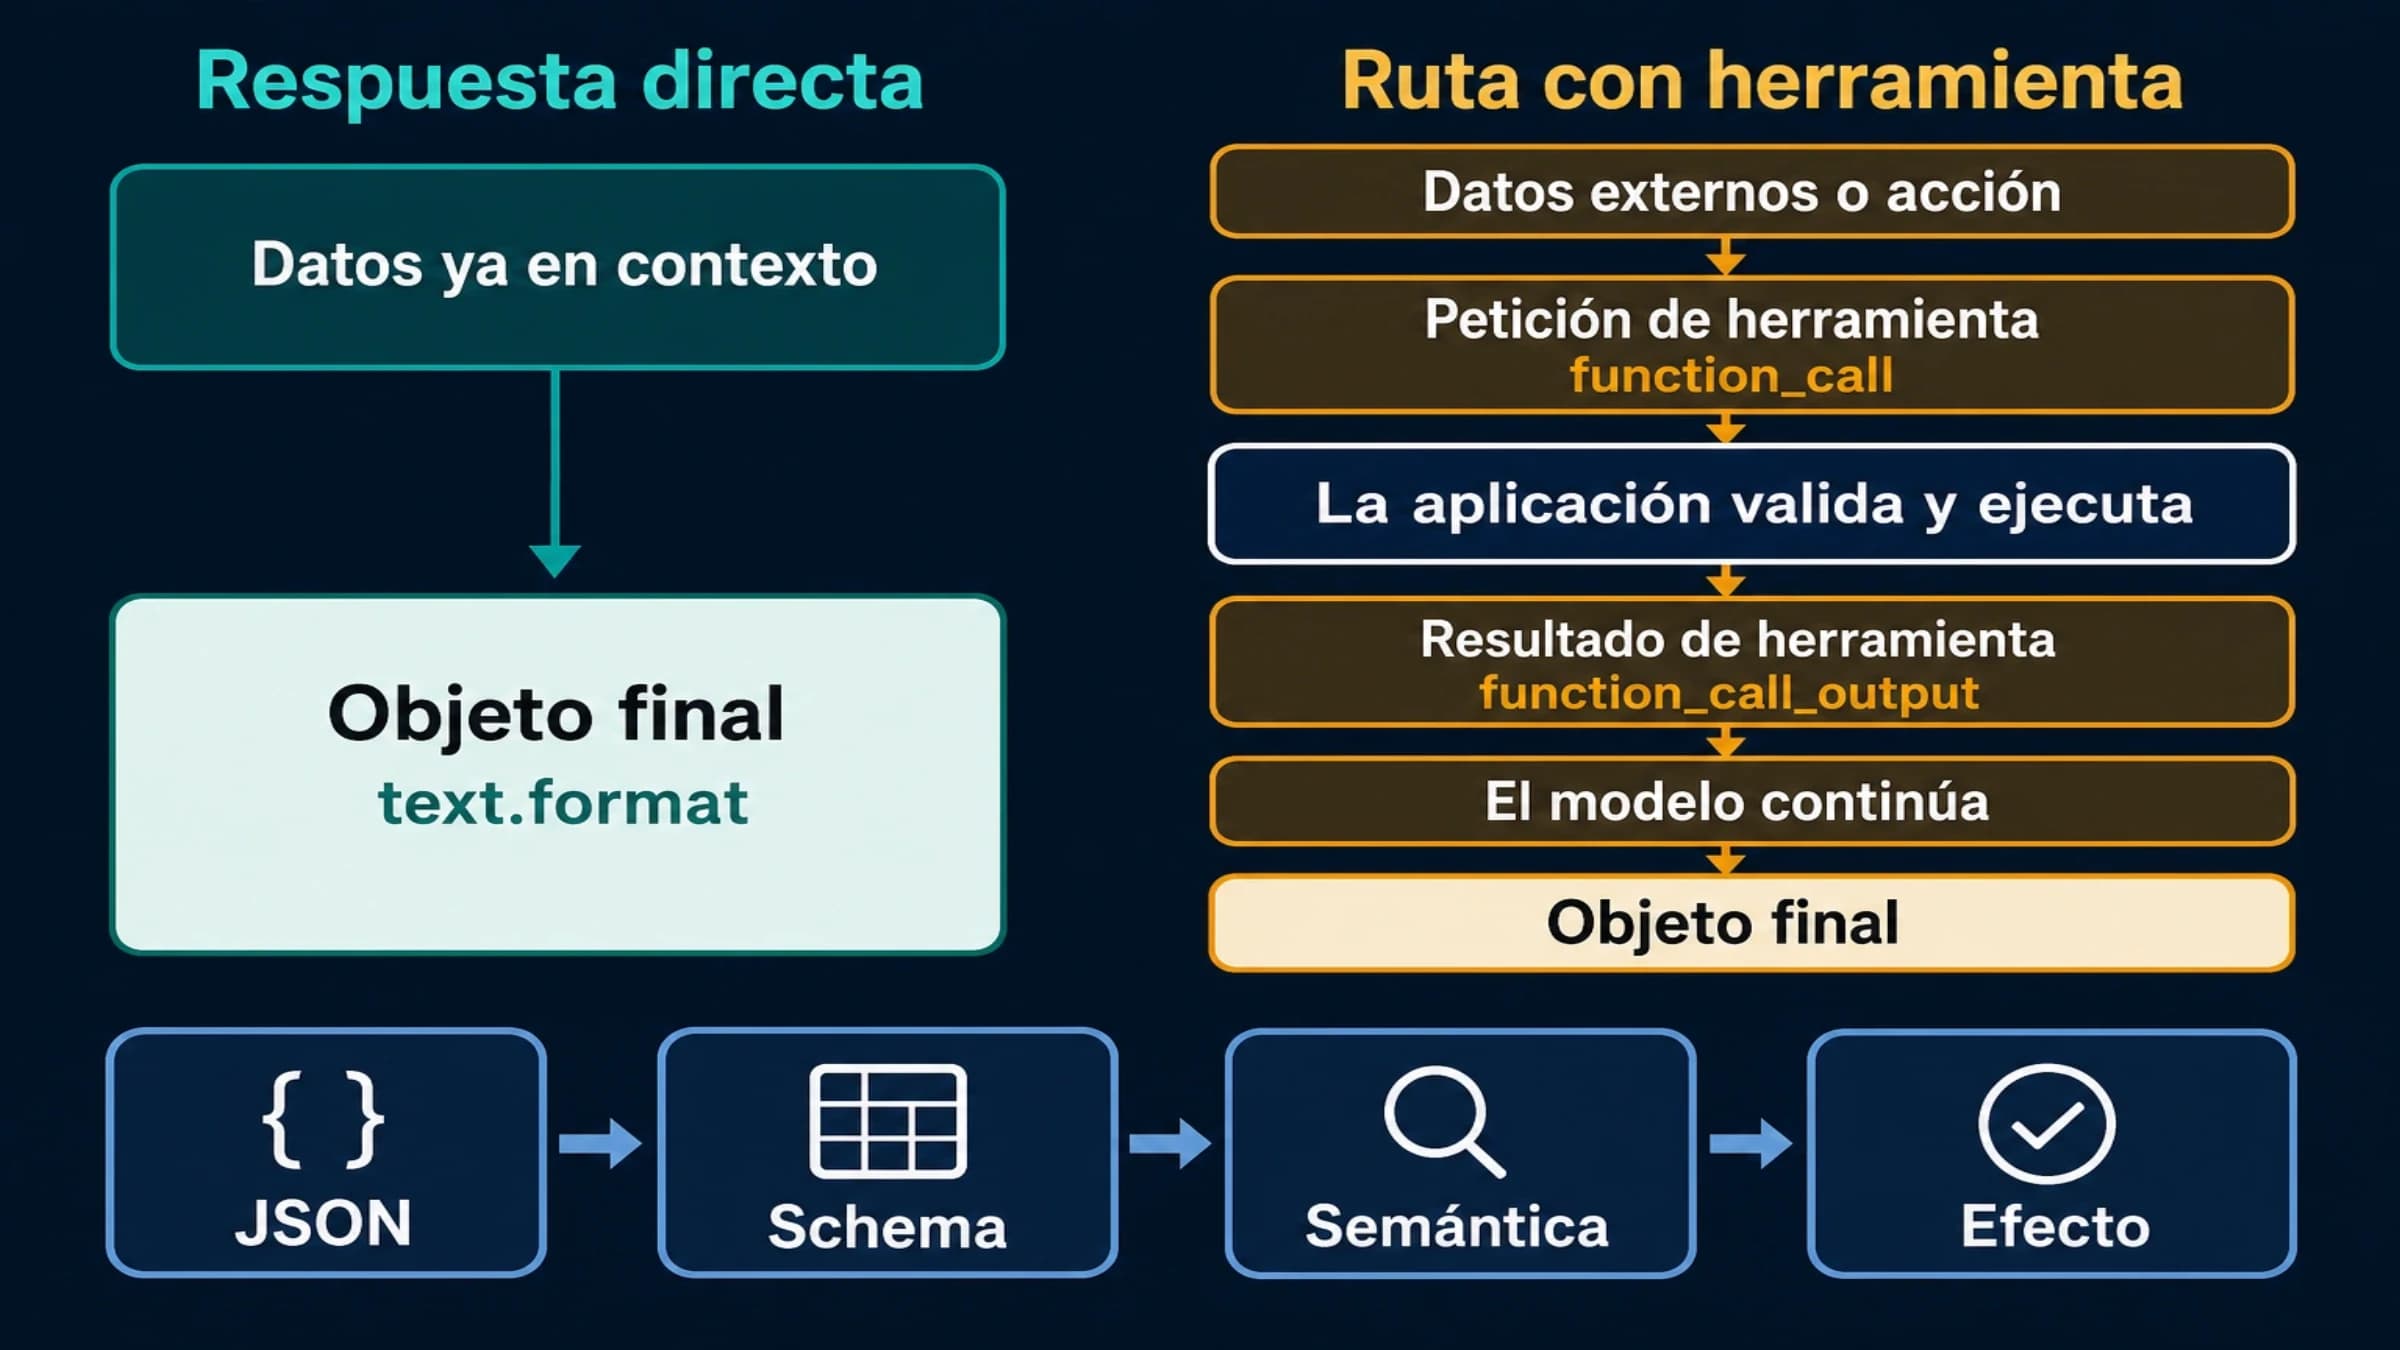
Sí: Claude tiene structured outputs (salidas estructuradas) y, a 30 de octubre de 2026, son una función estable de la Messages API. Para recibir JSON que tu código pueda parsear sin retoques, envía tu JSON Schema en output_config.format con "type": "json_schema": Claude escribe el JSON en el bloque text de la respuesta, y en Python client.messages.parse() lo devuelve ya validado en parsed_output. No hace falta cabecera beta y no existe un «modo JSON» aparte. Si lo que necesitas es que Claude llame a una función con argumentos del tipo correcto, la pieza es otra: "strict": true en la definición de la herramienta.
Los ejemplos antiguos usan un campo output_format en la raíz de la petición y la cabecera anthropic-beta: structured-outputs-2025-11-13. Ese campo está obsoleto: según la documentación de Anthropic, sin la cabecera la API devuelve un 400, pero en una prueba del 30 de octubre de 2026 a través de LaoZhang API devolvió 200 con un texto normal, como si el esquema no existiera. Por eso, cuando llames a Claude a través de un proxy, comprueba dos cosas en la primera respuesta: que el texto empiece por { y que input_tokens haya subido respecto a la misma petición sin esquema.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
«Siempre válido» tiene límites. Palabras clave como minimum devuelven un 400, minLength se aceptó en esa misma pasarela sin aplicarse, y un rechazo o un corte por max_tokens llegan con código 200 y JSON incompleto. Los rangos, longitudes y reglas de negocio se validan en tu código después de la llamada.
Petición mínima en cURL: output_config.format y dónde llega el JSON
La petición es un POST /v1/messages normal con un objeto output_config.format que contiene tu esquema. La respuesta no trae un campo especial: el JSON llega como cadena dentro de content[0].text, con stop_reason: "end_turn", y tu código lo parsea con json.loads o JSON.parse.
Esta es la llamada directa a la API de Anthropic, con el esquema de contacto de cuatro campos que usa la documentación de structured outputs de Claude:
curl https://api.anthropic.com/v1/messages \
  -H "content-type: application/json" \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -d '{
    "model": "claude-haiku-5-5",
    "max_tokens": 1024,
    "messages": [{
      "role": "user",
      "content": "Extract the key information from this email: John Smith (john@example.com) is interested in our Enterprise plan and wants to schedule a demo for next Tuesday at 2pm."
    }],
    "output_config": {
      "format": {
        "type": "json_schema",
        "schema": {
          "type": "object",
          "properties": {
            "name": {"type": "string"},
            "email": {"type": "string"},
            "plan_interest": {"type": "string"},
            "demo_requested": {"type": "boolean"}
          },
          "required": ["name", "email", "plan_interest", "demo_requested"],
          "additionalProperties": false
        }
      }
    }
  }'
Las pruebas citadas a partir de aquí se hicieron el 30 de octubre de 2026 a través de LaoZhang API, en su endpoint compatible con Anthropic https://api.laozhang.ai/v1/messages, con el mismo cuerpo y una clave de esa plataforma en lugar de la de Anthropic. Con claude-haiku-5-5, la petición anterior devolvió 200 en 3,61 segundos y esta respuesta (recortada):
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
{
  "content": [{
    "type": "text",
    "text": "{\"demo_requested\": true, \"email\": \"john@example.com\", \"name\": \"John Smith\", \"plan_interest\": \"Enterprise\"}"
  }],
  "model": "claude-haiku-5-5",
  "stop_reason": "end_turn",
  "usage": {"input_tokens": 333, "output_tokens": 46}
}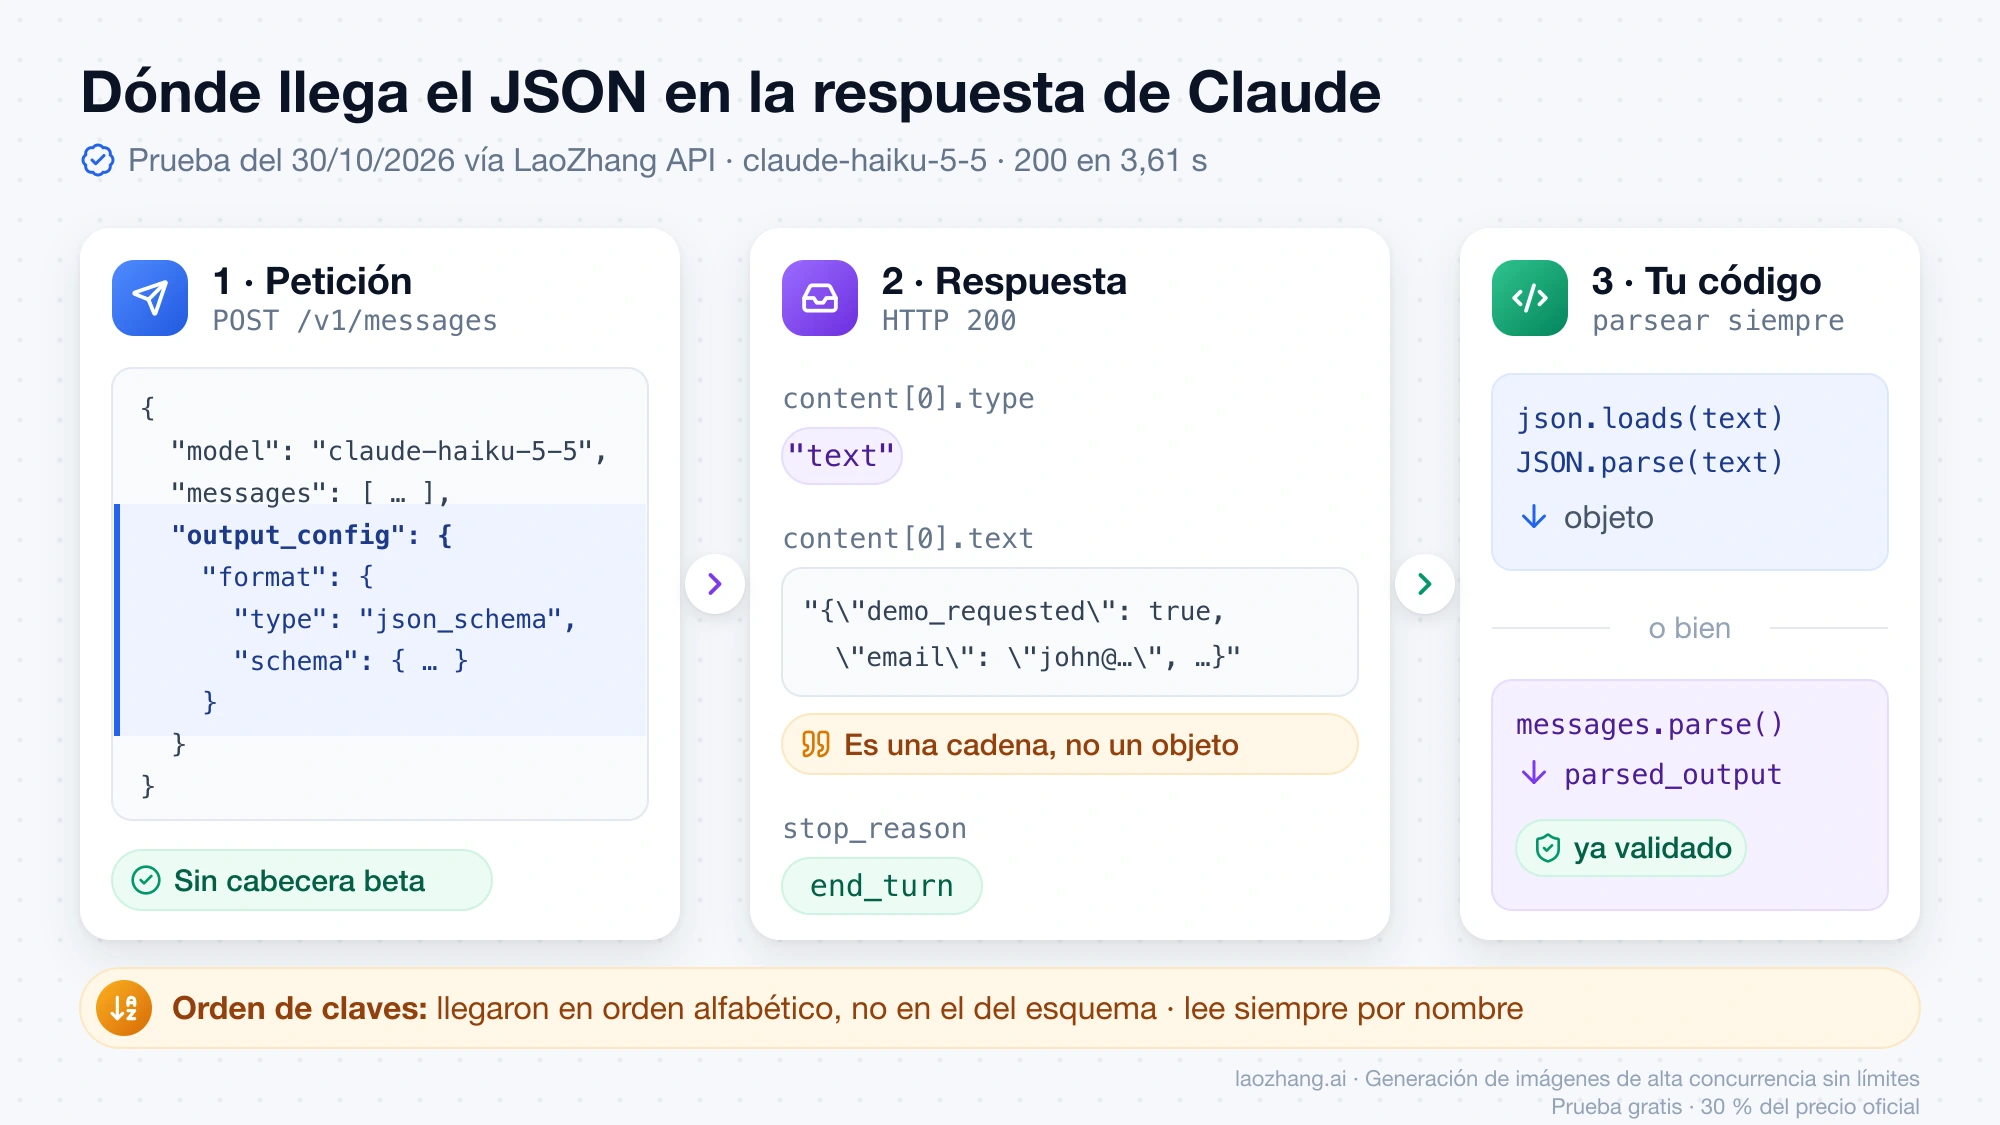
Fíjate en dos detalles. El JSON es una cadena escapada dentro de text, no un objeto anidado, así que siempre hay un paso de parseo. Y las claves salieron en orden alfabético, no en el orden del esquema; más abajo se explica por qué no debes depender del orden. Los resultados de la pasarela pueden no coincidir con los de api.anthropic.com: la documentación de LaoZhang indica que parte de su tráfico de Claude pasa por un canal oficial de AWS que valida los campos de la petición con más rigor. Cuando la documentación de Anthropic describe otro comportamiento, se dan las dos versiones.
messages.parse() en Python y TypeScript: el JSON ya validado
Los SDK oficiales hacen tres cosas por ti: convierten tu modelo de Pydantic o de zod en un esquema que Claude acepta, lo envían en output_config.format y validan la respuesta contra el modelo original. El resultado tipado está en parsed_output.
Python: Pydantic, transform_schema y ValidationError
En Python, pasa la clase de Pydantic al argumento output_format de client.messages.parse(). Ese nombre es el del helper del SDK y es el actual; lo obsoleto es el campo output_format en la raíz del cuerpo JSON de la petición. Este ejemplo se ejecutó el 30 de octubre de 2026 con anthropic 2.3.0 y Pydantic 2.14:
from typing import Literal, Optional

import anthropic
from pydantic import BaseModel, Field


class Lead(BaseModel):
    name: str = Field(min_length=2)
    email: str
    plan: Literal["Starter", "Team", "Enterprise"]
    seats: int = Field(ge=1, le=500)
    phone: Optional[str] = None


client = anthropic.Anthropic()  # lee ANTHROPIC_API_KEY

resp = client.messages.parse(
    model="claude-haiku-5-5",
    max_tokens=512,
    messages=[{"role": "user", "content": "John Smith (john@example.com) wants the Enterprise plan for 40 seats."}],
    output_format=Lead,
)
print(resp.parsed_output.model_dump())
# {'name': 'John Smith', 'email': 'john@example.com', 'plan': 'Enterprise', 'seats': 40, 'phone': None}
Para la prueba se creó el cliente con anthropic.Anthropic(api_key=..., base_url="https://api.laozhang.ai"); la llamada consumió 489 tokens de entrada. Lo interesante es lo que el SDK envió. transform_schema(Lead), que devuelve el esquema transformado sin hacer ninguna llamada, muestra que min_length, ge y le no viajan como restricciones: el SDK los quita y los copia en la descripción del campo, y añade additionalProperties: false al objeto.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
"name":  {"type": "string",  "title": "Name",  "description": "{minLength: 2}"},
"seats": {"type": "integer", "title": "Seats", "description": "{maximum: 500, minimum: 1}"}
Claude ve esos límites como una pista de texto, no como una regla del muestreo. La prueba lo deja claro: con el mensaje «Jane Roe (jane@example.com) is on the Team plan but currently has 0 seats. Report seats exactly as stated.», la API devolvió seats: 0 y fue el SDK, ya en tu proceso, quien lanzó un pydantic.ValidationError con el texto Input should be greater than or equal to 1. Si llamas a messages.parse(), captura esa excepción: es la forma en que una regla de negocio incumplida llega a tu código.
TypeScript: zodOutputFormat()
En TypeScript el equivalente es envolver un esquema de zod con zodOutputFormat() y pasarlo en output_config.format a client.messages.parse(). Este fragmento es el de la documentación de Anthropic:
import Anthropic from "@anthropic-ai/sdk";
import { z } from "zod";
import { zodOutputFormat } from "@anthropic-ai/sdk/helpers/zod";

const ContactInfo = z.object({
  name: z.string(),
  email: z.string(),
  plan_interest: z.string(),
  demo_requested: z.boolean(),
});

const client = new Anthropic();

const response = await client.messages.parse({
  model: "claude-haiku-5-5",
  max_tokens: 1024,
  messages: [{ role: "user", content: "Extract the key information from this email: ..." }],
  output_config: { format: zodOutputFormat(ContactInfo) },
});

console.log(response.parsed_output);
Si en lugar de zod tienes un JSON Schema suelto, jsonSchemaOutputFormat() lo transforma igual pero no valida la respuesta, así que la validación vuelve a ser cosa tuya. El SDK de Java se comporta al revés que los de Python y TypeScript: rechaza en local las restricciones no admitidas en vez de moverlas a la descripción.
¿JSON outputs o herramienta con strict: true? Cuándo usar cada uno
Usa JSON outputs cuando el JSON es la respuesta final (extraer datos, clasificar, devolver un informe), y una herramienta con "strict": true cuando tu código va a ejecutar una acción con los argumentos que elige Claude. Un agente que llama a herramientas y luego entrega un resultado estructurado usa las dos en la misma petición.
| Criterio | JSON outputs | Herramienta con strict: true |
|---|---|---|
| Qué restringe | El texto de la respuesta de Claude | El nombre de la herramienta y su input |
| Cómo se activa | output_config.format en la petición | "strict": true en cada definición de herramienta |
| Dónde llega el JSON | Bloque text, con stop_reason: "end_turn" | Bloque tool_use, campo input, con stop_reason: "tool_use" |
| Caso típico | Extracción, clasificación, informe final | Reservar, escribir en una base de datos, llamar a otra API |
| Límites propios | Comparte el subconjunto de JSON Schema | Máximo 20 herramientas strict por petición |
La diferencia práctica está en qué pasa sin strict. Según la guía de strict tool use de Anthropic, una herramienta normal que espera passengers como entero puede recibir "two" o "2"; con strict: true siempre recibe 2. En la prueba del 30 de octubre de 2026 a través de LaoZhang API, una herramienta create_demo_booking con strict: true, enums para el plan y el día, un entero hour_24 y "format": "email", forzada con tool_choice, devolvió stop_reason: "tool_use" y este input a partir del mismo correo de ejemplo:
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
{"email": "john@example.com", "hour_24": 14, "plan": "Enterprise", "weekday": "Tue"}«2pm» se convirtió en el entero 14 y «next Tuesday» en el valor de enum Tue, que es justo el tipo de normalización que te ahorra código. Cuando combines las dos funciones, recuerda que los límites de complejidad se suman entre todos los esquemas strict de la petición: 24 parámetros opcionales y 16 parámetros con uniones (anyOf o "type": ["string", "null"]) en total. Por eso Anthropic recomienda marcar como strict solo las herramientas en las que un argumento mal tipado rompe algo.
Qué palabras del esquema dan 400 y cuáles se aceptan sin aplicarse
Claude solo admite un subconjunto de JSON Schema, y lo que queda fuera se comporta de tres maneras: la API lo rechaza con un 400 y un mensaje concreto, el SDK lo saca del esquema y lo comprueba en local, o (según la prueba en la pasarela) se acepta sin aplicarse. En los tres casos, la regla acaba en tu código.
Lo admitido, según la documentación a 30 de octubre de 2026: los tipos básicos, enum con valores primitivos, const, anyOf, allOf (sin $ref dentro), $ref y $defs internos, default, required, additionalProperties: false, pattern con expresiones sencillas y los formatos date-time, time, date, duration, email, hostname, uri, ipv4, ipv6 y uuid. Lo que no está en esa lista es lo que recoge la tabla.
| Palabra clave | Documentación de Anthropic | LaoZhang API, 30/10/2026 | Qué hacer |
|---|---|---|---|
minimum, maximum, multipleOf | No admitidas, 400 | minimum: 1 → 400 output_config.format.schema: For 'integer' type, property 'minimum' is not supported | Quitarlas y validar el rango en código |
$ref recursivo | No admitido | 400 Invalid schema: Circular reference detected in schema definitions: node -> node. Self-referencing or mutually-referencing definitions are not supported. | Aplanar a una profundidad fija |
minLength, maxLength | No admitidas, 400 | Aceptadas con 200; con mínimo y máximo de 12 devolvió {"code": "ABC"} | No confiar en ellas: validar la longitud |
Objeto sin additionalProperties | Debe ser false | Aceptado, salida correcta | Escribir false siempre |
enum con objetos o arrays | No admitido | — | Usar anyOf o valores primitivos |
minItems mayor que 1, maxItems | Solo minItems 0 o 1 | — | Contar los elementos en código |
pattern con \b, lookahead o \1 | No admitidos; patrones complejos pueden dar 400 | — | Simplificar la regex y revalidar |
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Las dos filas con resultado distinto según la ruta son las peligrosas. Que minLength pase en una plataforma y dé 400 en otra significa que el mismo esquema puede funcionar en desarrollo y romperse al cambiar de proveedor, y que donde pasa no protege nada. Si usas los helpers de Python o TypeScript, este problema desaparece porque el SDK quita esas restricciones antes de enviar y las comprueba después; si envías el esquema a mano, quítalas tú.
Además de las palabras clave, hay límites de tamaño por petición: 20 herramientas strict, 24 parámetros opcionales y 16 parámetros con uniones, sumando todos los esquemas. Por encima de eso, o si la gramática compilada resulta demasiado grande, la API responde con un 400 Schema is too complex for compilation, y la compilación tiene un tiempo máximo de 180 segundos. Si llegas a ese error, Anthropic propone probar en este orden: marcar como strict solo las herramientas críticas, convertir parámetros opcionales en required (cada parámetro opcional duplica aproximadamente una parte de la gramática), aplanar los objetos anidados y repartir las herramientas entre varias peticiones.
¿Por qué Claude devuelve texto en vez de JSON?
Si la respuesta llega con 200 pero en prosa, casi siempre el esquema no ha llegado al modelo: el campo tiene el nombre antiguo, la plataforma lo ha descartado o la petición mezcla algo incompatible. La causa depende de por dónde pasa la llamada, así que la comprobación empieza por los tokens de entrada.
El caso más traicionero es el retroceso silencioso. El 30 de octubre de 2026, a través de LaoZhang API, la misma petición con el campo antiguo output_format en la raíz devolvió 200 y una lista en Markdown, tanto sin la cabecera anthropic-beta: structured-outputs-2025-11-13 como con ella. Los tokens de entrada fueron 64, exactamente los de la petición sin esquema, frente a los 333 de la versión con output_config.format: el esquema se había descartado antes de llegar al modelo. En la API directa, la documentación de Anthropic dice que ese campo sin la cabecera beta devuelve un 400, y el SDK de Python 1.0 o posterior lanza un TypeError si pasas output_format={...} a client.beta.messages.create().
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
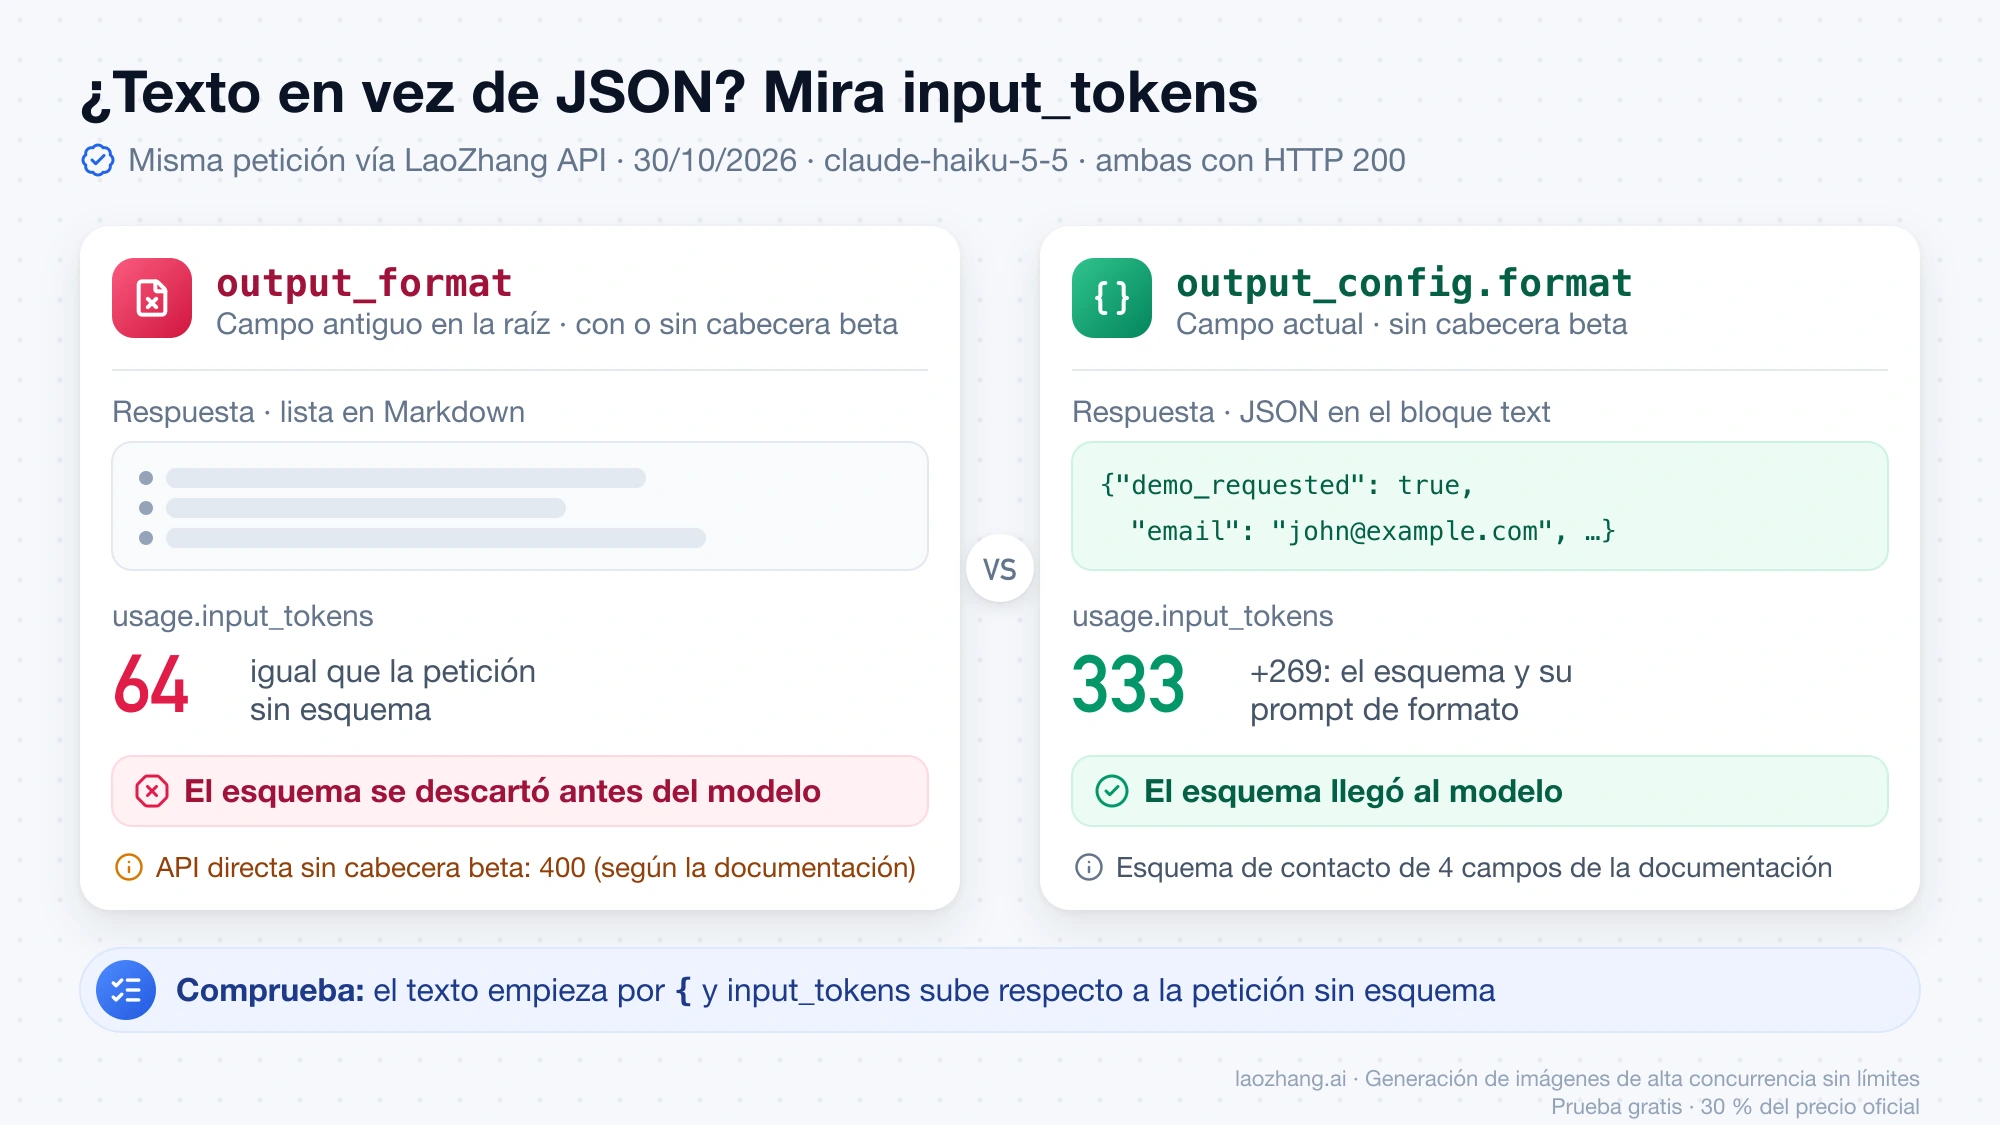
Antes de tocar el prompt, revisa esta lista en orden:
- El esquema va en
output_config.format, no enoutput_format, y sin cabeceras beta copiadas de tutoriales de 2025. usage.input_tokenssube cuando añades el esquema. Si da lo mismo con y sin esquema, el campo no está llegando.- Si recibes un 400 con
Extra inputs are not permitted(por ejemplo, mencionandooutput_configooutput_config.effort), la plataforma valida el cuerpo y rechaza ese campo. Pasa en Bedrock y en pasarelas que reenvían a canales de AWS; los mensajes típicos están en Error 400 de Claude en AWS Bedrock: qué significa cada mensaje. - El modelo está en la lista compatible. Claude 3.x y las versiones de la época de Opus 4.1 no aparecen en ella.
- La conversación termina en un mensaje de usuario. El prefill (empezar la respuesta del asistente con
{) es incompatible con JSON outputs, y en Haiku 5.5 la petición devolvió un 400:This model does not support assistant message prefill. The conversation must end with a user message. - Citations no está activado: junto con
output_config.formatdevuelve un 400.
Rechazos, cortes por max_tokens y nulls: qué validar en tu código
Un JSON que cumple el esquema no es lo mismo que un JSON que tu aplicación puede usar. Hay casos en los que la respuesta llega con 200 y no encaja, y otros en los que encaja con el esquema pero no con lo que tu código espera; cada uno necesita una línea de defensa propia.
| Caso | Cómo se ve | Qué hace tu código |
|---|---|---|
| Rechazo | stop_reason: "refusal", código 200, tokens facturados, salida que puede no cumplir el esquema | No parsear; registrar y no reintentar igual |
Corte por max_tokens | stop_reason: "max_tokens" y JSON a medias | Reintentar con más max_tokens |
| Regla de negocio incumplida | JSON válido con un valor fuera de rango, como seats: 0 | Validar con Pydantic, zod o tu propio código |
| Orden de claves | Documentación: requeridas primero, en el orden del esquema; pasarela: orden alfabético | Leer por nombre, nunca por posición |
| Campo opcional | En la pasarela, "phone": null aunque el esquema decía "type": "string" | Tratar opcional como «ausente o null» |
Mayúsculas en enum | Documentación: puede llegar Conversation Topic 3 con el enum Conversation topic 3 | Comparar sin distinguir mayúsculas |
El corte es fácil de provocar. Con max_tokens: 30 y la petición de 15 ideas para artículos, la respuesta del 30 de octubre de 2026 a través de LaoZhang API terminó con stop_reason: "max_tokens" y este texto, que ningún parser acepta: {"ideas": ["REST vs GraphQL vs gRPC: How to Choose the. El rechazo tiene un disparador menos obvio: según la documentación, una propiedad que pide el razonamiento paso a paso puede provocar un rechazo de tipo reasoning_extraction, así que si quieres una justificación, pide un campo de explicación breve.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Las tres últimas filas son de forma, no de contenido. En la misma pasarela, todas las salidas JSON llegaron con las claves en orden alfabético, y en un esquema con name y email obligatorios y notes y phone opcionales, la respuesta incluyó "phone": null en lugar de omitir el campo. Las mayúsculas del enum, en cambio, no fallaron: en cinco llamadas pidiendo el tercer valor llegó siempre Conversation topic 3 exacto, pero cinco intentos no prueban nada frente a lo que advierte Anthropic, y la comparación sin mayúsculas cuesta una línea.
Este patrón cubre los dos primeros casos con un reintento y deja la validación de contenido a Pydantic:
import json

import anthropic
from pydantic import BaseModel, ValidationError


class Contact(BaseModel):
    name: str
    email: str
    plan_interest: str
    demo_requested: bool


SCHEMA = {
    "type": "object",
    "properties": {
        "name": {"type": "string"},
        "email": {"type": "string"},
        "plan_interest": {"type": "string"},
        "demo_requested": {"type": "boolean"},
    },
    "required": ["name", "email", "plan_interest", "demo_requested"],
    "additionalProperties": False,
}

client = anthropic.Anthropic()


def extract(text: str, max_tokens: int = 1024) -> Contact:
    for _ in range(2):
        resp = client.messages.create(
            model="claude-haiku-5-5",
            max_tokens=max_tokens,
            messages=[{"role": "user", "content": text}],
            output_config={"format": {"type": "json_schema", "schema": SCHEMA}},
        )
        if resp.stop_reason == "max_tokens":
            max_tokens *= 2  # JSON cortado: otro intento con más margen
            continue
        if resp.stop_reason == "refusal":
            raise RuntimeError("Claude rechazó la petición")
        raw = next(b.text for b in resp.content if b.type == "text")
        try:
            return Contact.model_validate(json.loads(raw))
        except (json.JSONDecodeError, ValidationError) as err:
            # aquí cae también el texto en prosa de un retroceso silencioso
            raise ValueError(f"Respuesta fuera de contrato: {raw[:200]}") from err
    raise RuntimeError("La respuesta sigue cortada por max_tokens")
Coste del prompt de formato: 269 tokens más por petición
Activar output_config.format añade un prompt de sistema que explica el formato, y esos tokens se facturan como entrada. Con un esquema de 4 campos en Haiku 5.5, la diferencia medida el 30 de octubre de 2026 a través de LaoZhang API fue de 269 tokens por petición.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
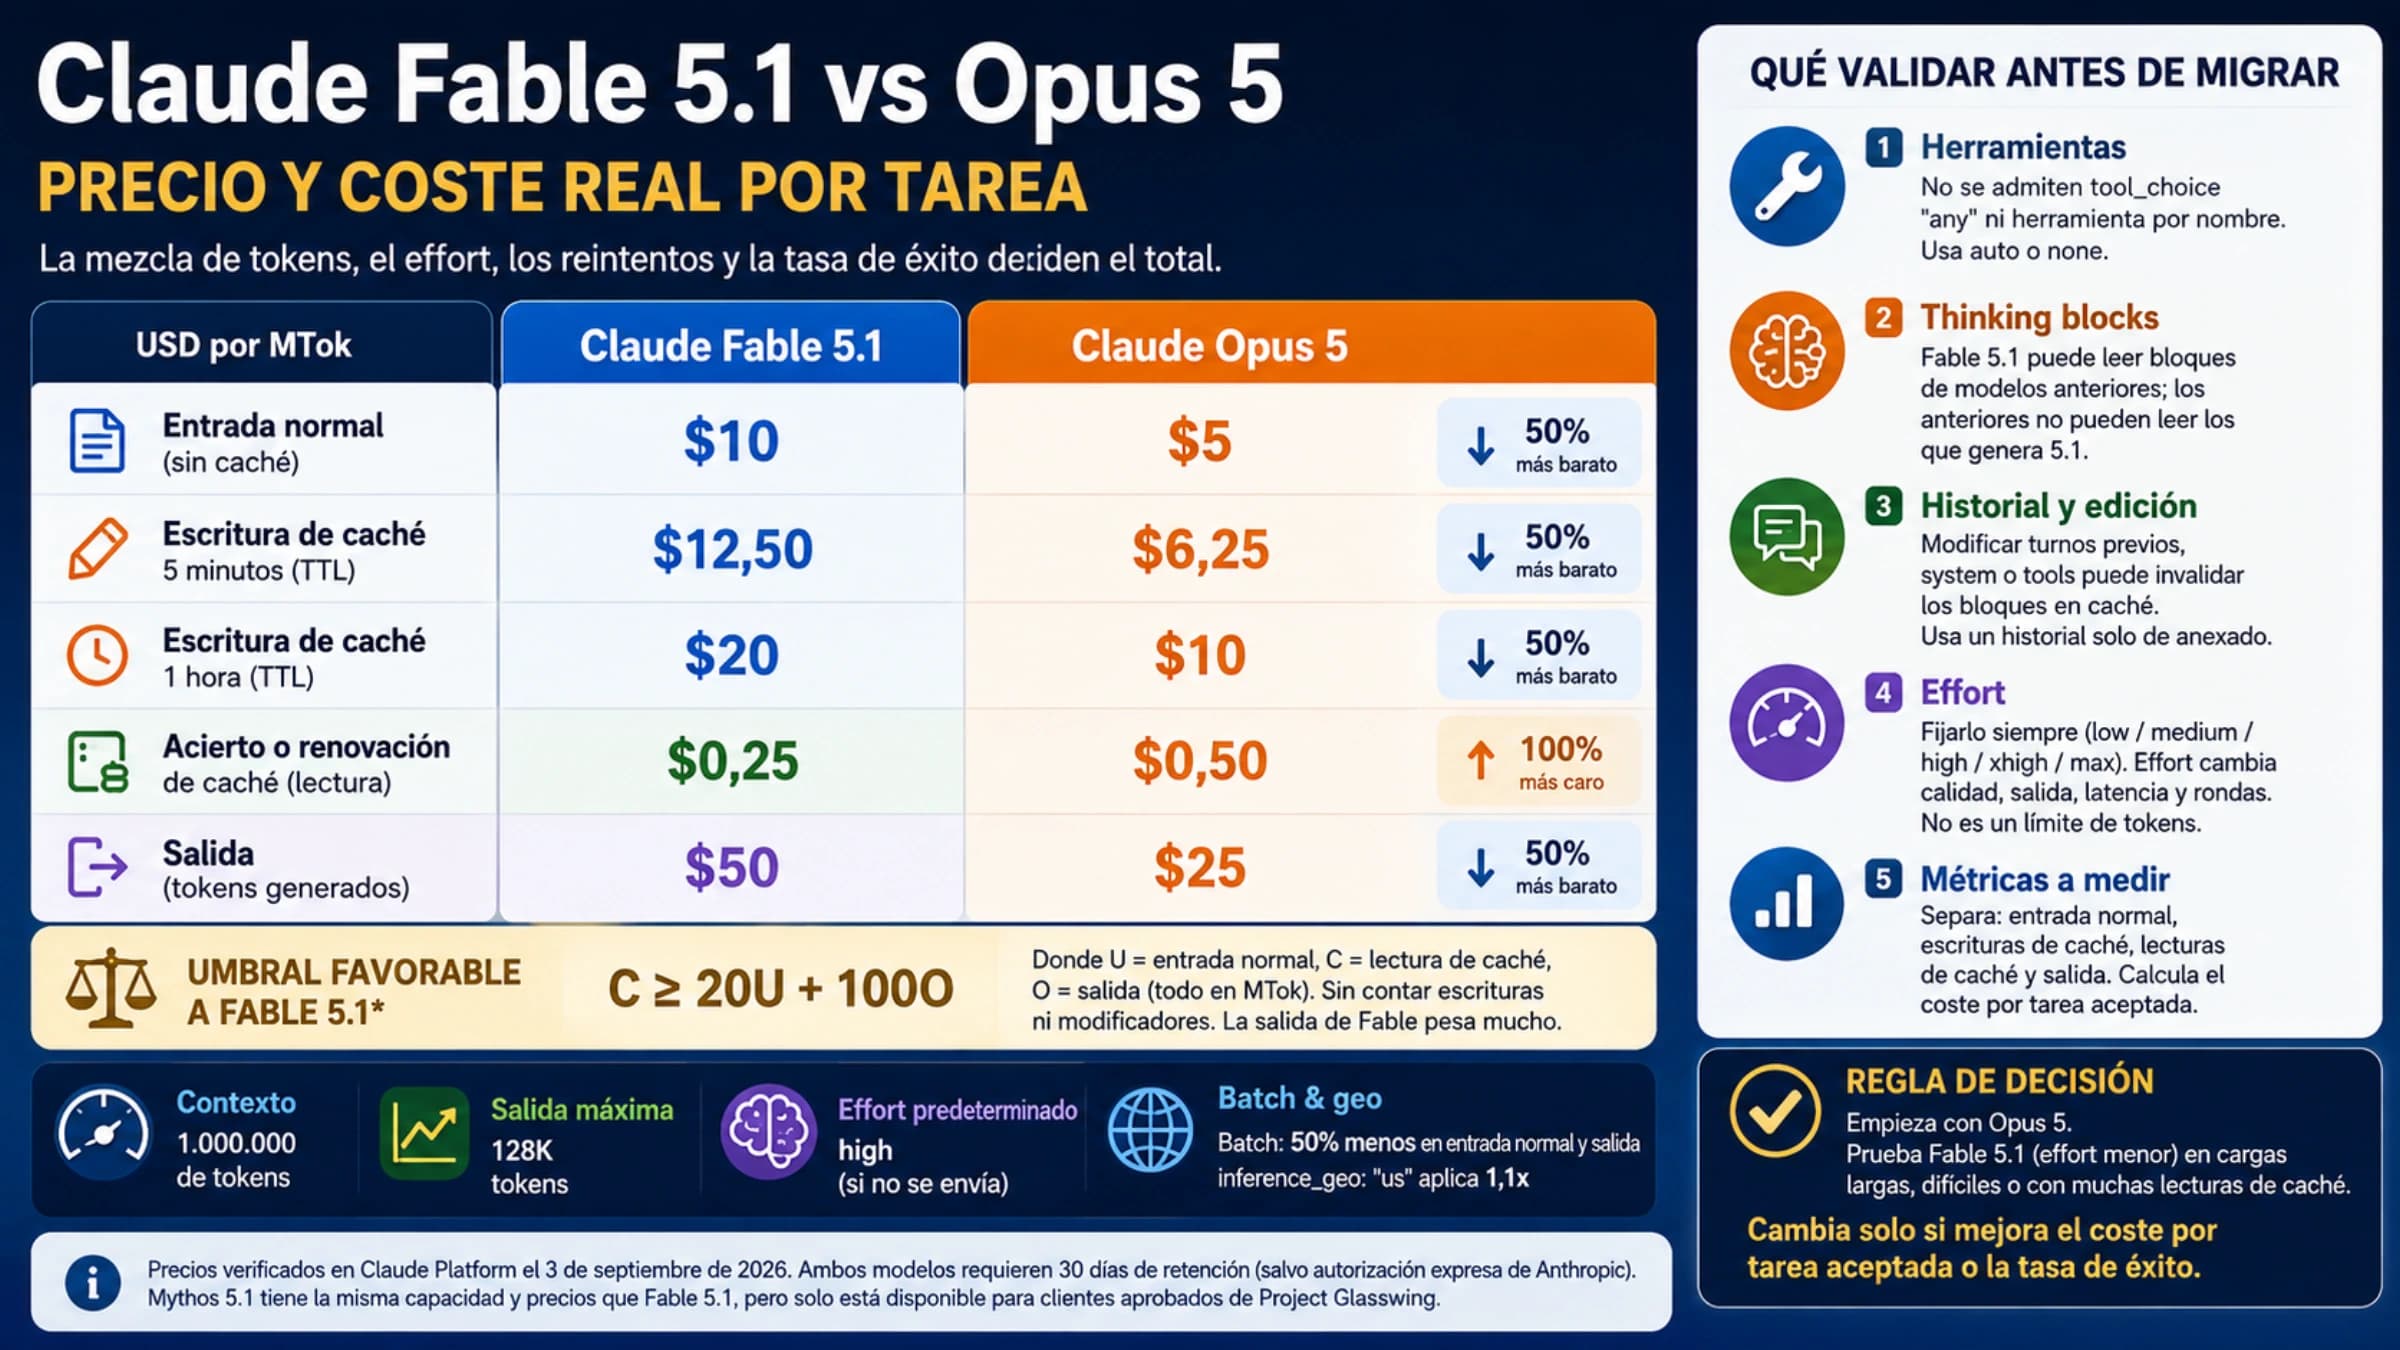
La cifra sale de comparar la misma petición con y sin esquema: 333 tokens de entrada con output_config.format y 64 sin él, así que 333 − 64 = 269 tokens de prompt de formato más esquema. Un millón de peticiones suma 269 millones de tokens extra, que se multiplican por el precio de entrada de cada modelo según la tabla de precios de Anthropic; el precio de Haiku 5.5 vale para prompts de hasta 100.000 tokens y por encima sube a 0,50 $:
| Modelo | Entrada por millón de tokens | Coste extra por millón de peticiones |
|---|---|---|
| Haiku 5.5 | 0,10 $ | 26,90 $ |
| Sonnet 5.5 | 2 $ | 538 $ |
| Opus 5.5 | 4 $ | 1.076 $ |
Es una muestra con un esquema pequeño: cuantos más campos y descripciones tenga, más crece la diferencia. En esa misma muestra la salida bajó de 91 tokens en prosa a 46 en JSON; en Sonnet 5.5, a 10 $ por millón de tokens de salida, esos 45 tokens ahorrados valen 0,00045 $ por llamada frente a 0,000538 $ de entrada extra, así que el balance final depende de cuánto hablaría Claude sin formato. Para comparar el precio por modelo con OpenAI, mira Precio de la API de Claude vs OpenAI: qué nivel sale más barato.
Hay dos costes más que no son de tokens. Cambiar output_config.format invalida la caché de prompts de esa conversación, así que mantén el esquema estable entre llamadas que comparten prefijo. Y la primera vez que usas un esquema, la API compila la gramática, lo que añade latencia; la gramática se guarda 24 horas desde el último uso y solo se recompila si cambia la estructura, no si cambias nombres o descripciones. A través de la pasarela esa penalización no se distinguió del ruido de red: un esquema nuevo y dos repeticiones idénticas tardaron 4,23, 3,33 y 4,28 segundos.
Preguntas frecuentes sobre Claude Structured Outputs
¿Claude Structured Outputs funciona con streaming y Batch?
Sí. Según la documentación de Anthropic a 30 de octubre de 2026, funciona con streaming (el JSON llega por fragmentos como cualquier texto, así que lo parseas al terminar), con el conteo de tokens y con la Message Batches API, que aplica su descuento del 50 %.
¿Se puede usar con extended thinking?
Sí. La gramática solo restringe la respuesta final, no los bloques de thinking ni las llamadas a herramientas, así que Claude puede razonar libremente y después escribir el JSON. En una prueba del 30 de octubre de 2026 a través de LaoZhang API, Sonnet 5.5 con thinking: {"type": "adaptive"} y effort: "low" devolvió solo el bloque de texto, con JSON válido; con esfuerzo bajo no generó bloque de thinking.
¿Está disponible en Amazon Bedrock y Google Cloud Vertex AI?
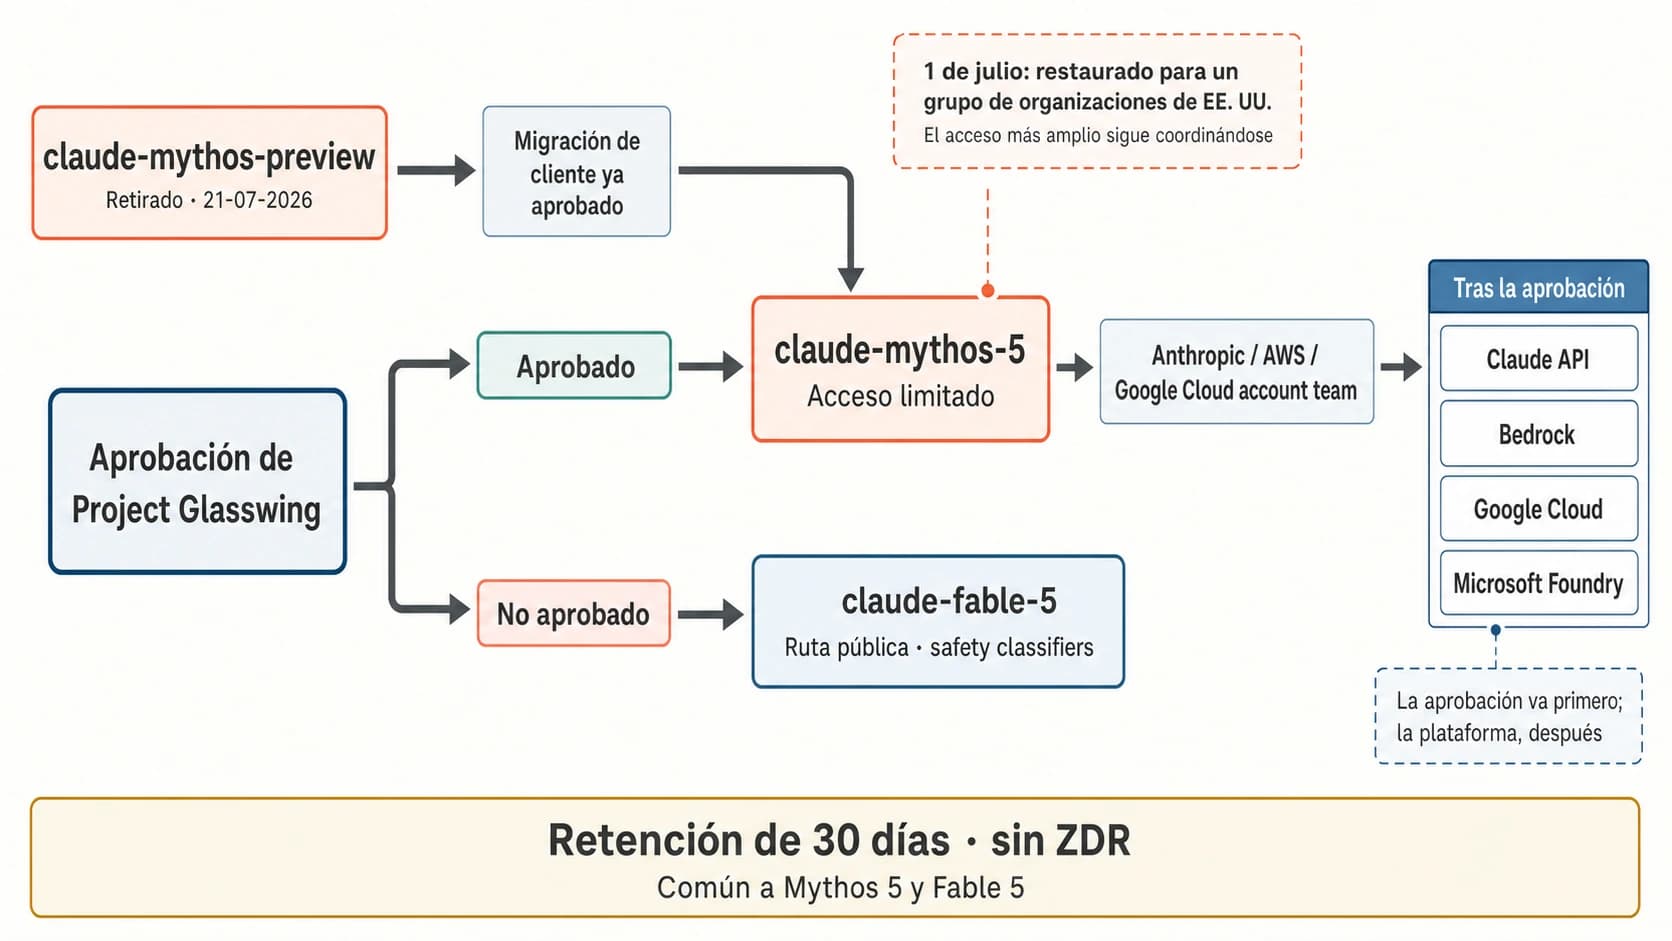
Sí. La documentación la marca como disponible de forma general en la Claude API, Claude Platform on AWS, Amazon Bedrock (incluido InvokeModel), Claude en Google Cloud (gestionado por Anthropic o por Google) y Microsoft Foundry. No está disponible en Managed Agents.
¿Qué modelos de Claude admiten structured outputs?
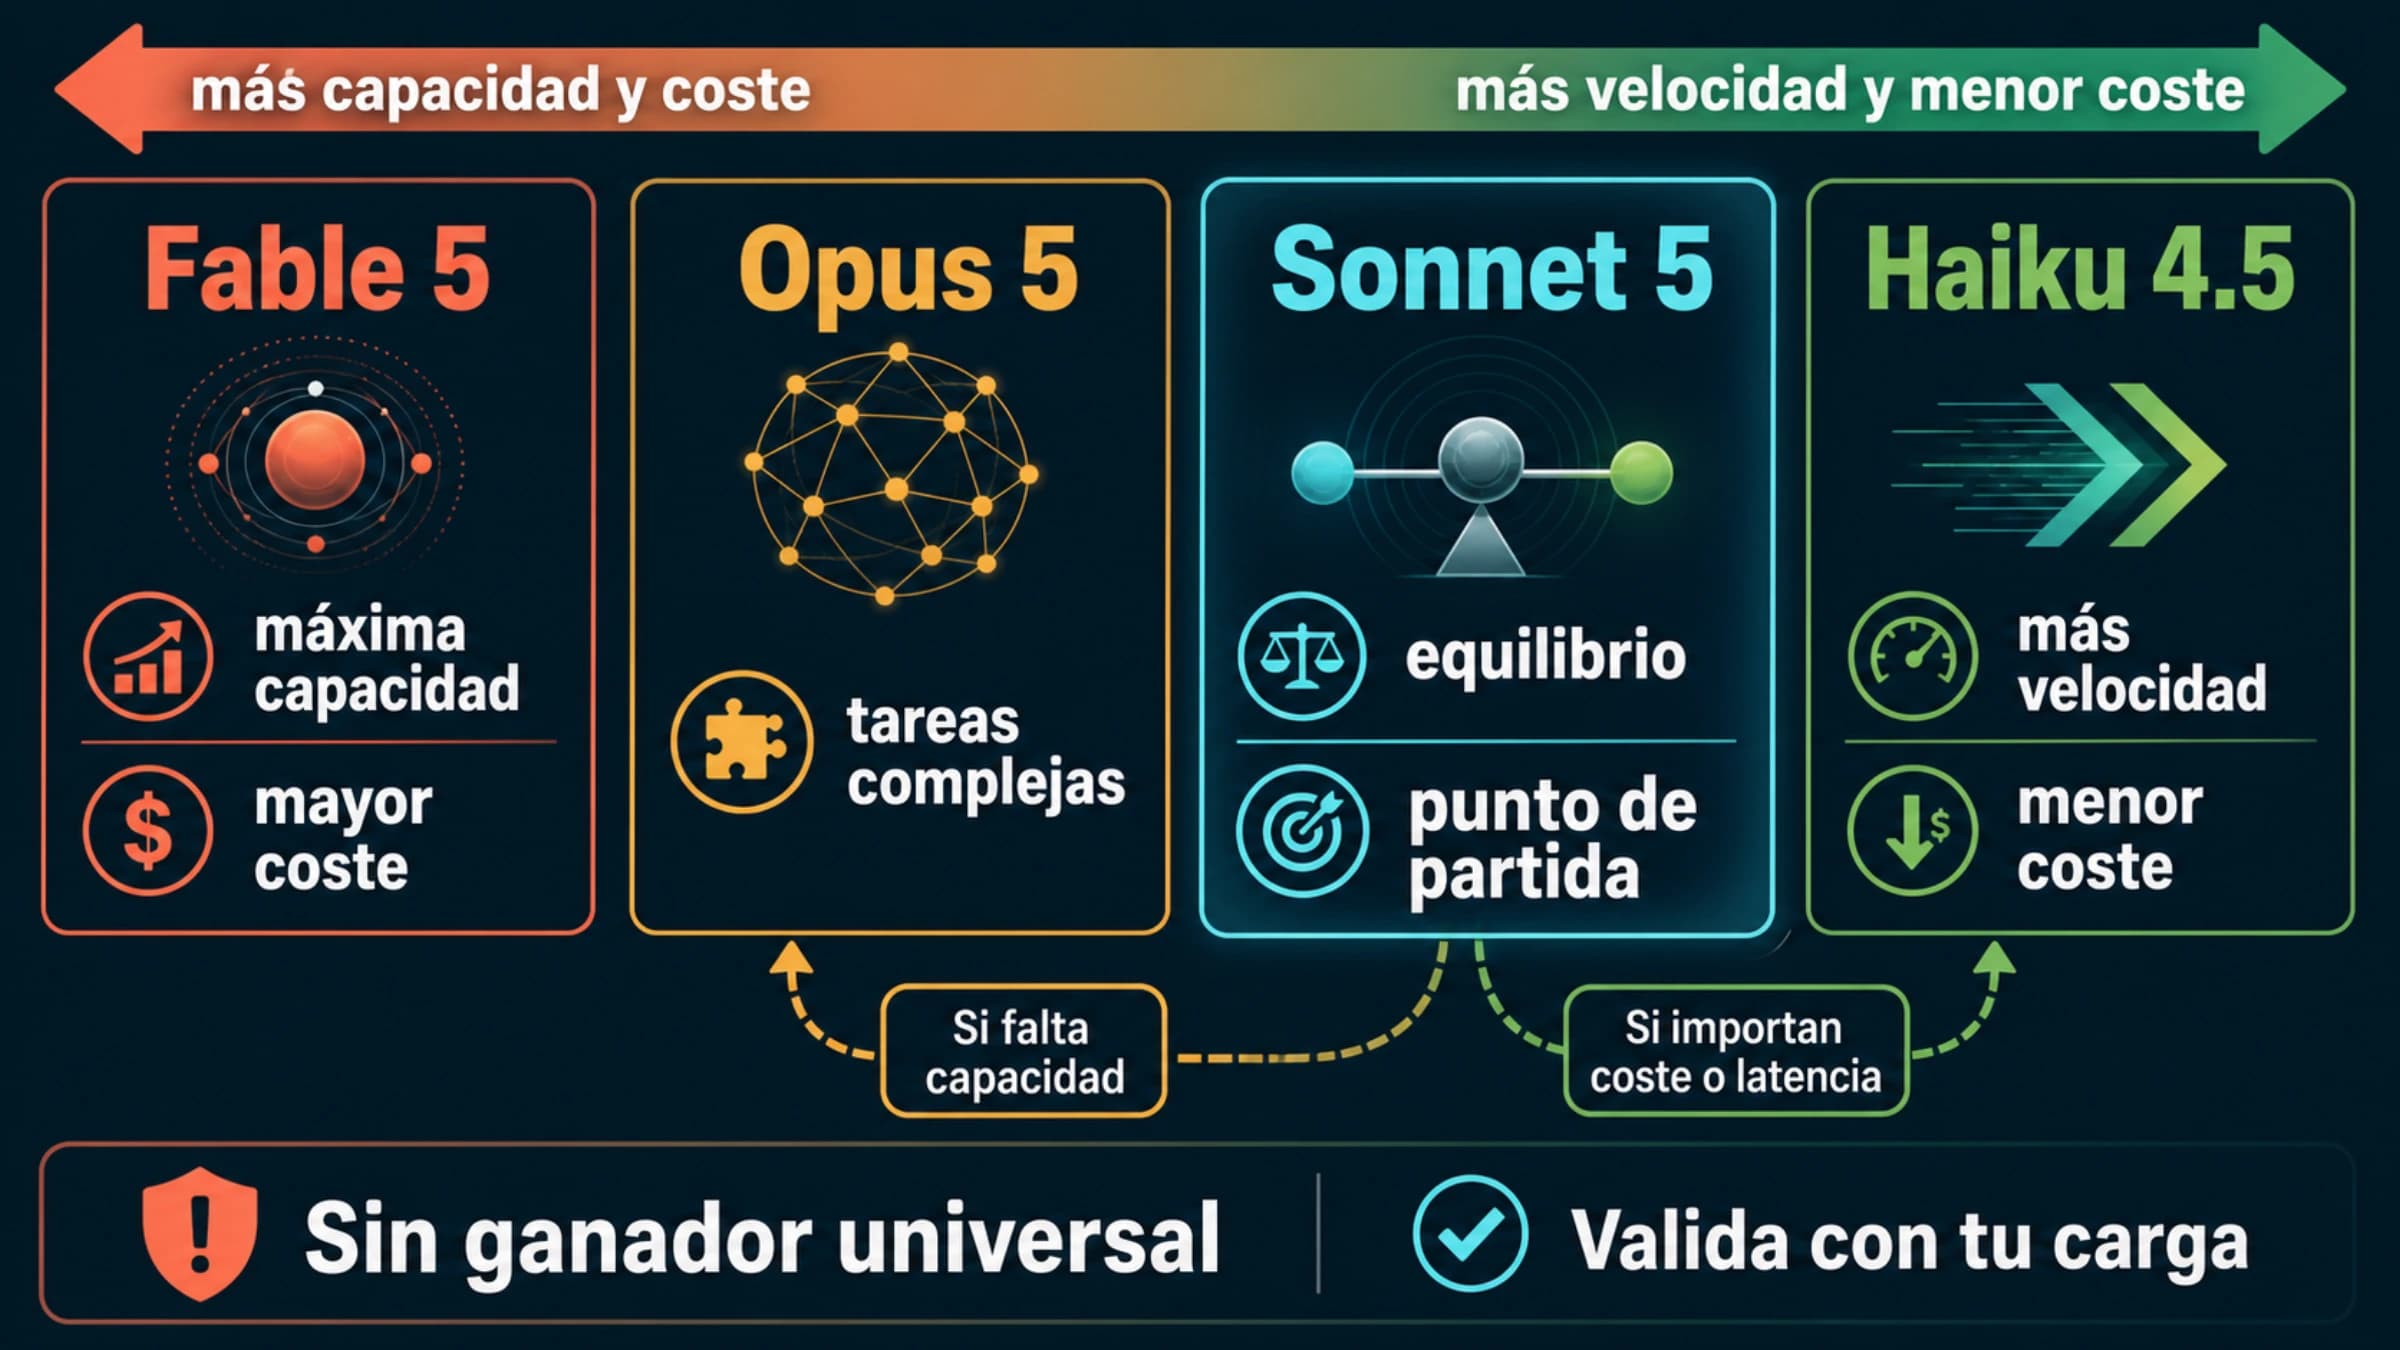
A 30 de octubre de 2026, la lista oficial incluye Fable 5.1 y 5, Mythos 5.1, 5 y preview, Opus 5.5, 5, 4.8, 4.7, 4.6 y 4.5, Sonnet 5.5, 5, 4.6 y 4.5, y Haiku 5.5 y 4.5. Los modelos Claude 3.x no figuran.
¿Qué pasa con los datos si uso ZDR o HIPAA?
Con retención cero (ZDR), los prompts y las respuestas no se guardan; solo el esquema JSON se almacena en caché hasta 24 horas desde su último uso. La función es apta para HIPAA, pero los datos de salud protegidos no pueden aparecer en el esquema: ni en nombres de propiedades, ni en valores de enum o const, ni en pattern.
¿Es lo mismo que los structured outputs de Claude Code o del Agent SDK?
No. En el Agent SDK pasas un JSON Schema a query() con outputFormat (TypeScript) u output_format (Python), y el propio SDK valida el resultado y vuelve a preguntar si no encaja; está explicado en la guía de structured outputs del Claude Agent SDK.
¿En qué se diferencia de Structured Outputs de OpenAI?
La idea es la misma, pero los campos y la forma de elegir entre formato de respuesta y funciones son distintos; para el lado de OpenAI, consulta Structured Outputs vs. function calling: qué usar en OpenAI.
Fuentes3
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 30 oct 2026.
Fuentes3
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 30 oct 2026.
- 1.documentación de structured outputs de Claudeplatform.claude.com/docs/en/build-with-claude/structured-outputs
- 2.guía de strict tool use de Anthropicplatform.claude.com/docs/en/agents-and-tools/tool-use/strict-tool-use
- 3.guía de structured outputs del Claude Agent SDKcode.claude.com/docs/en/agent-sdk/structured-outputs