Gemini «Requests ending with a model turn»: error 400 y solución
Desde Gemini 3.6 Flash, y también en Gemini 4 Argon, una petición cuyo último turno es model da 400. Termina en un turno user o usa systemInstruction.
En esta página
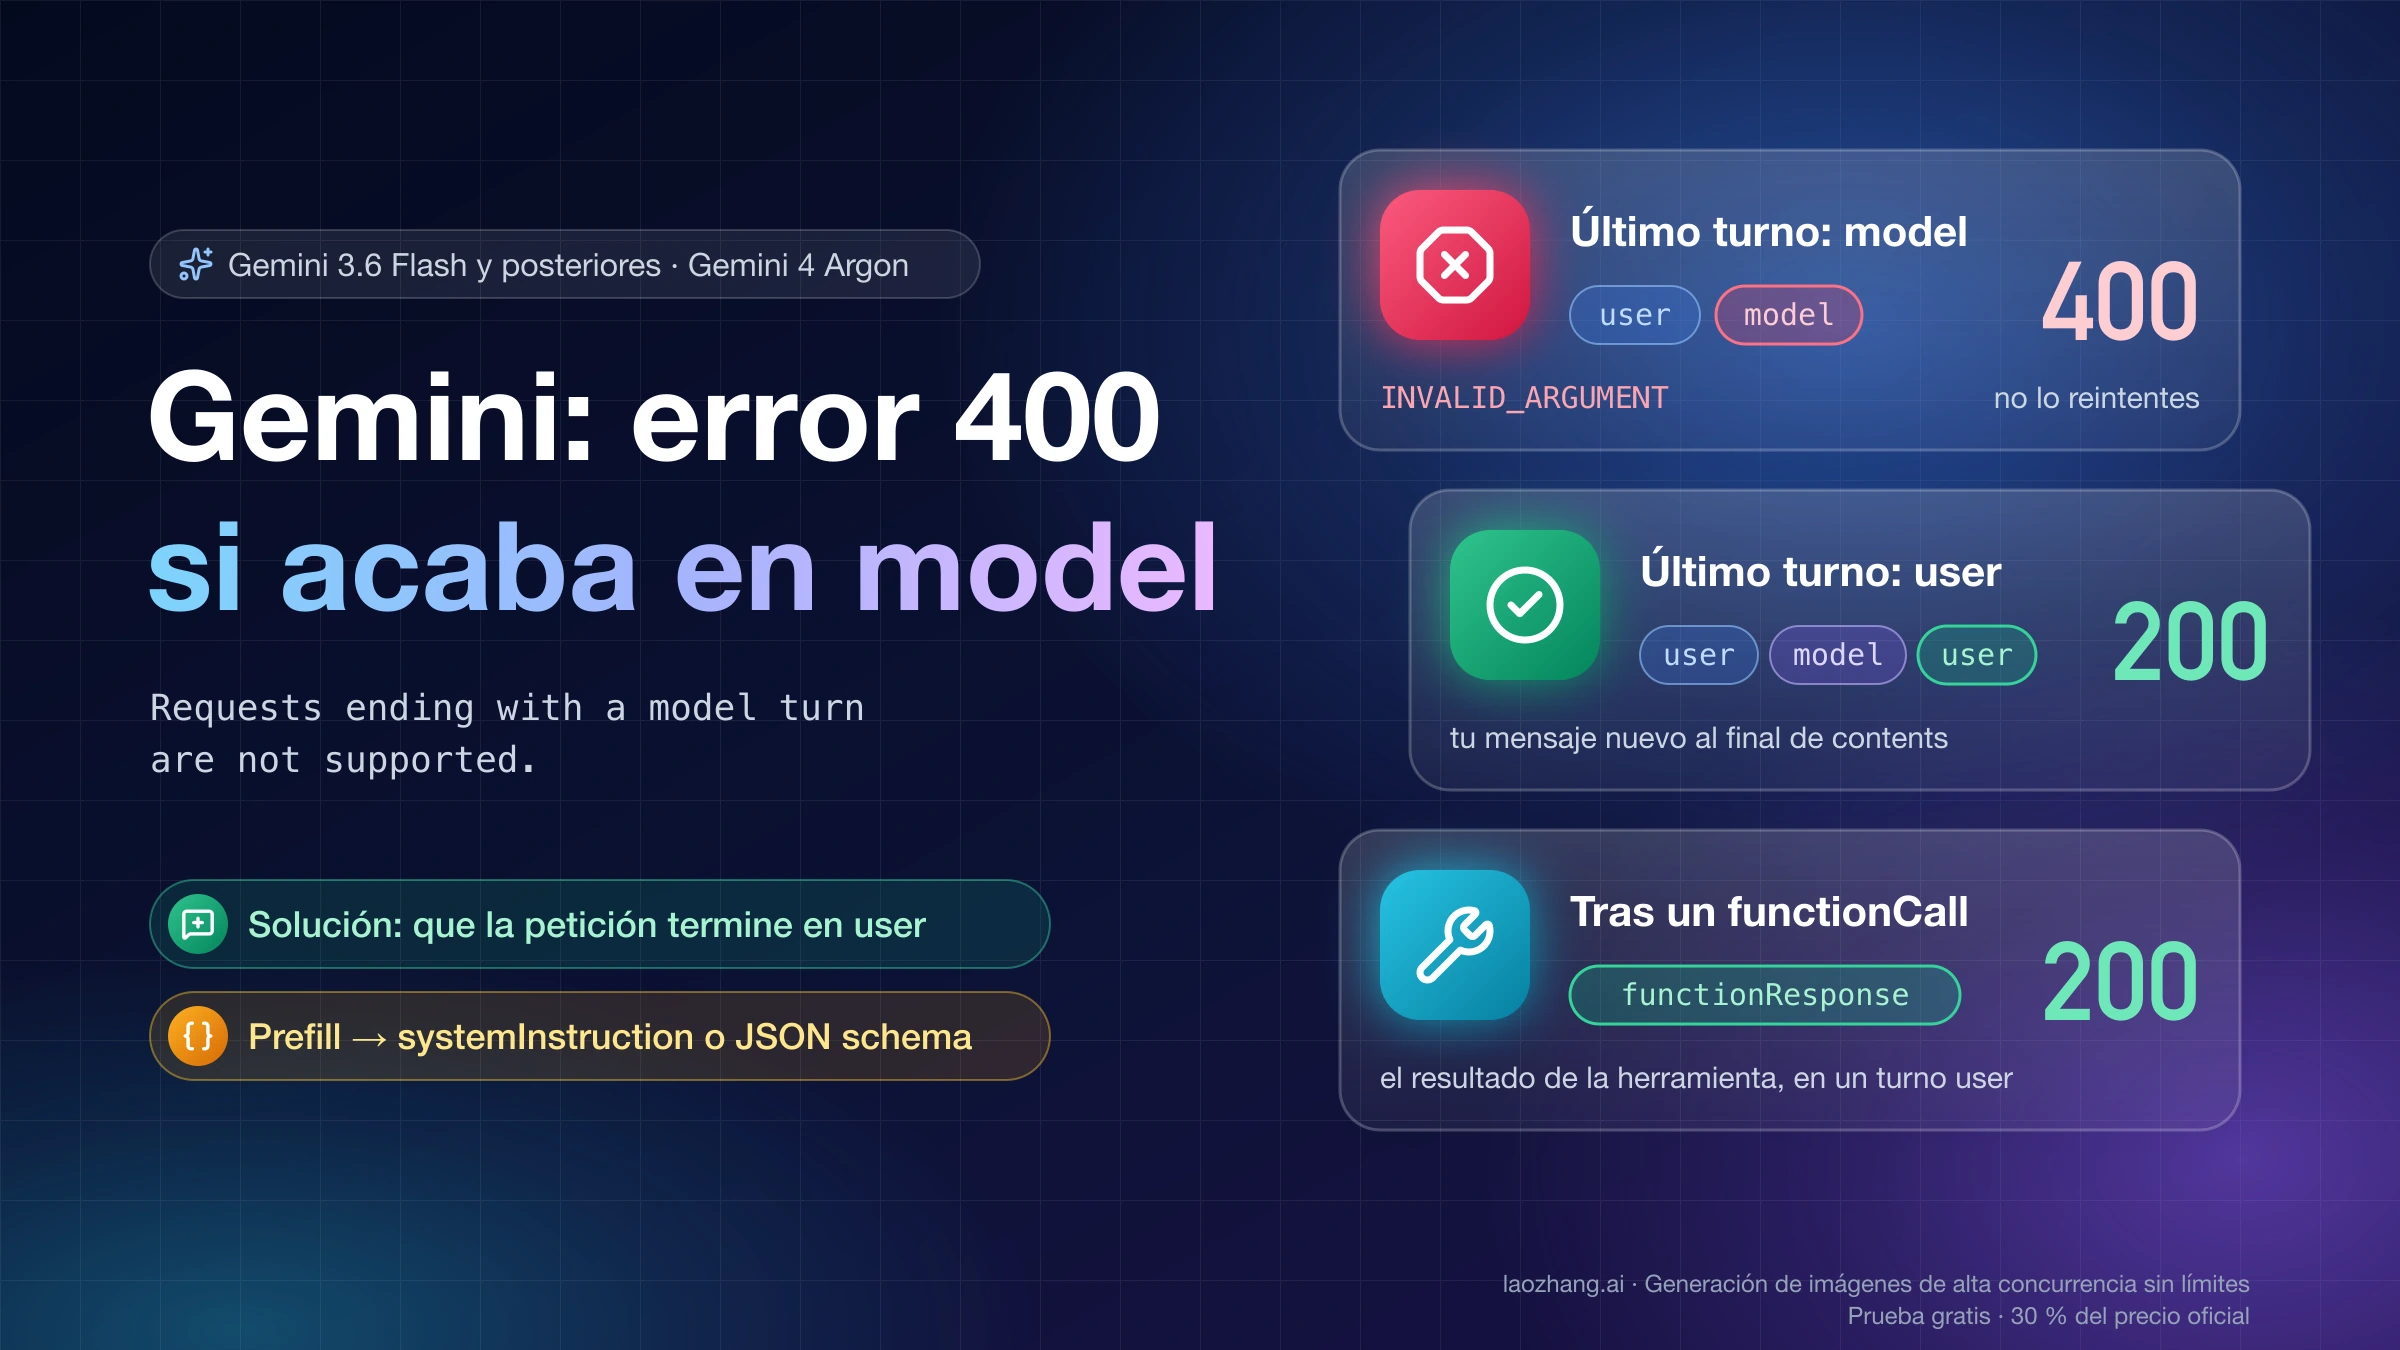
Requests ending with a model turn are not supported. es un error 400 INVALID_ARGUMENT que Gemini devuelve cuando el último turno no vacío de contents tiene role model, es decir, cuando la petición acaba en un mensaje del modelo (en formato OpenAI, el de role assistant). Google aplica esta regla desde Gemini 3.6 Flash y Gemini 3.5 Flash-Lite a todos los modelos posteriores, Gemini 4 Argon incluido, y con ella dejó de admitir el prefill, la respuesta pre-rellenada que antes servía para arrancar la salida del modelo (novedades de Gemini 3.6 en la documentación de Gemini API). La solución es que la petición termine en un turno user: tu mensaje nuevo o el functionResponse con el resultado de la herramienta. Si usabas el prefill para quitar preámbulos o forzar JSON, Google recomienda pasarlo a systemInstruction o a una salida estructurada con JSON schema.
Que en pantalla el último mensaje sea tuyo no demuestra que la petición enviada acabe en user. Un historial guardado justo después de una respuesta, un rewind, una interrupción, un resultado de herramienta con imagen o los ajustes de continuación de un frontend de rol pueden dejar un turno del modelo al final. Si el error sale dentro de una herramienta, en Gemini CLI se corrige actualizando a v0.65.0 o posterior; en opencode, LangChain, LiteLLM e instructor el arreglo sigue sin versión confirmada a 29 de octubre de 2026, y en opencode basta con escribir un mensaje nuevo para seguir la sesión.
No reintentes este error como si fuera saturación: Google pide reintentar solo errores transitorios (429, 408, 5xx) y no los 400, que indican un problema en la propia petición (solución de problemas de Gemini API). En una prueba del 29 de octubre de 2026 con gemini-4-argon, la misma conversación pasó de 400 a 200 solo con quitar el turno del modelo final. La regla no alcanza a los modelos anteriores: según un usuario de un hilo de LINUX DO sobre el error en Gemini 3.6 Flash, el prefill seguía funcionando en Gemini 3.5 Flash el 22 de julio de 2026.
Qué rechaza Gemini: un turno model al final de contents
Gemini mira el último turno no vacío de contents, no el último mensaje que ves en la interfaz. Si ese turno tiene role model, la API responde 400 aunque el resto de la conversación sea correcto. El ejemplo que Google marca como prohibido en la documentación de Gemini 3.6 es exactamente un prefill:
{
  "contents": [
    { "role": "user", "parts": [{ "text": "Translate 'Hello world' to Spanish." }] },
    { "role": "model", "parts": [{ "text": "Translation:" }] }
  ]
}
No es un error exclusivo de Gemini 4 Argon. La página de novedades de Gemini 3.6 no nombra Argon, pero dice que el cambio se aplica a «todos los futuros modelos de Gemini», lo que incluye Gemini 3.7 Flash, 3.8 Flash y Argon; la guía de migración a Gemini 4 Argon no menciona esta regla.
El texto cambia según por dónde pase la petición. En la mayoría de los issues de GitHub aparece tal cual, con "status":"INVALID_ARGUMENT". Desde AI Studio y en el Issue Tracker de Google se ve una versión más larga, Requests ending with a model turn are not supported unless the last part is a function response., que adelanta la excepción: un turno con el resultado de una herramienta sí puede cerrar la petición. Los proxies de frontends de rol lo envuelven como PROXY ERROR 400: {...}, y OpenRouter lo muestra como Provider returned error con el texto de Google dentro de error.metadata.raw, así que si solo ves ese mensaje genérico, abre metadata.raw antes de buscar otra causa (issue #55694 de opencode).
Cuál es tu caso: seis formas de acabar en un turno del modelo
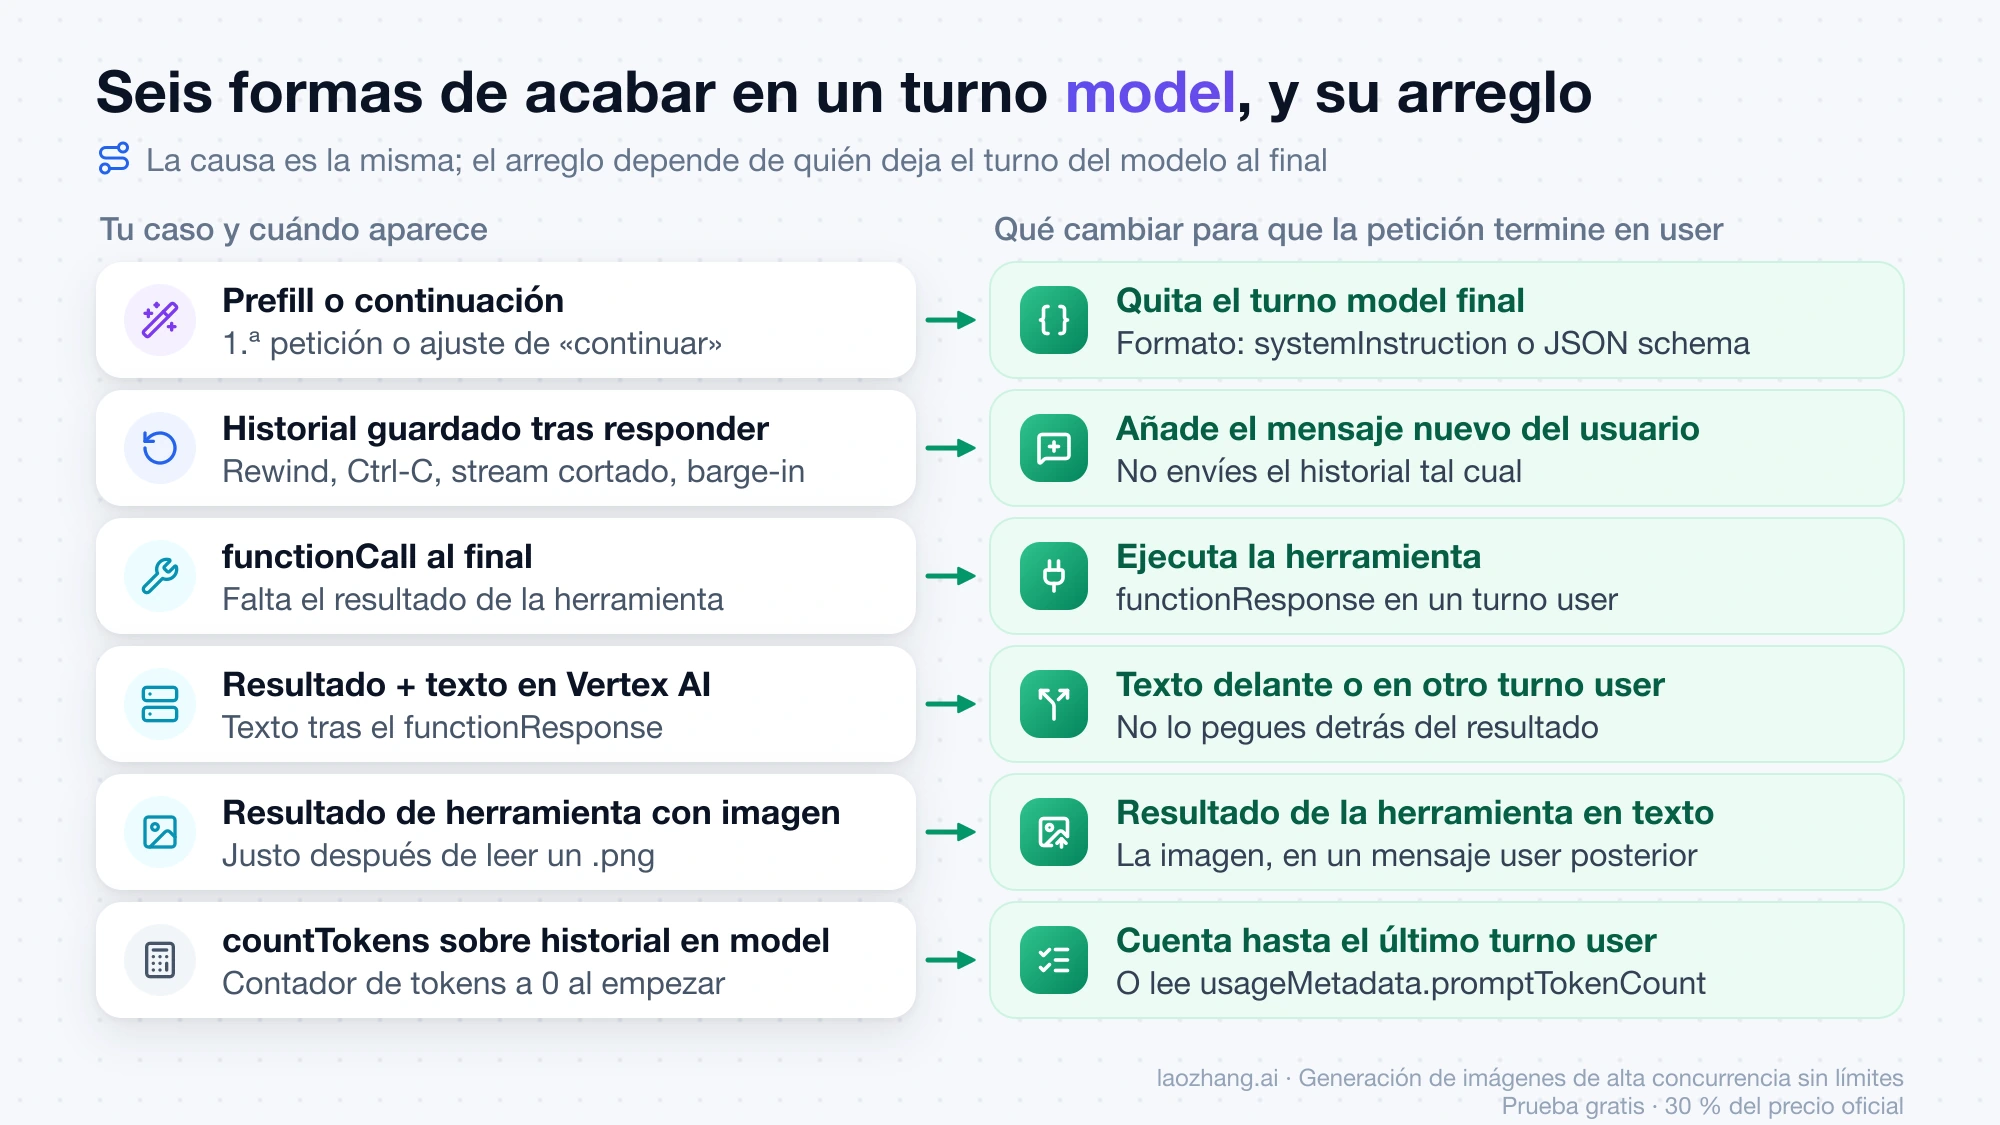
La causa es siempre la misma, pero lo que hay que cambiar depende de quién dejó el turno del modelo al final. Compara el momento en que aparece el error con esta tabla:
| Caso | Cuándo aparece | Qué cambiar |
|---|---|---|
| Prefill o continuación | En la primera petición, o al activar en un frontend ajustes de prefill del asistente o de «continuar» | Quitar el turno model final; el formato pasa a systemInstruction o a JSON schema |
| Historial guardado justo después de una respuesta | Tras un rewind, un Ctrl-C, un stream interrumpido, un barge-in en un agente de voz o un paso guardado fuera de orden | Añadir el mensaje nuevo del usuario antes de enviar, sin mandar el historial tal cual |
functionCall del modelo al final | El modelo pidió una herramienta y la siguiente petición sale sin su resultado | Ejecutar la herramienta y enviar el functionResponse en un turno user |
| Resultado de herramienta seguido de texto en Vertex | Un turno user con [functionResponse, text] en Vertex AI | Poner el texto antes del functionResponse o en un turno user aparte |
| Resultado de herramienta con imagen | Justo después de que el agente lea un .png | Resultado de la herramienta en texto y la imagen en un mensaje user posterior |
countTokens sobre un historial que acaba en model | Al empezar una sesión, con el contador de tokens a 0 | Contar hasta el último turno user o leer usageMetadata.promptTokenCount |
El caso de las imágenes parece el más raro, pero tiene la misma raíz. En Gemini CLI, al leer un .png con ReadFile la parte de imagen se perdía, el turno del usuario quedaba vacío y el último turno no vacío pasaba a ser el del modelo (issue #29574 de Gemini CLI). En OpenRouter con google/gemini-4-argon el patrón observado es parecido: un resultado de herramienta [text, image_url] como último mensaje da 400, mientras que el mismo resultado solo en texto, seguido de un mensaje del usuario con la imagen, da 200 (issue #139313 de Hermes Agent); por qué OpenRouter acaba dejando un turno del modelo al final no está confirmado.
Prueba del 29 de octubre de 2026 con gemini-4-argon: 200 frente a 400
El 29 de octubre de 2026, entre las 03:00 y las 03:05 UTC, se enviaron a gemini-4-argon ocho formas de petición por la ruta nativa de Gemini generateContent de laozhang.ai, en REST sin SDK y con thinkingLevel: low, cambiando una sola variable cada vez. Todas las respuestas 200 venían con modelVersion: gemini-4-argon. El resultado coincide con la regla de Google: lo que decide es el rol del último turno, no el contenido de la conversación.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Forma de contents (el último elemento es el final de la petición) | Resultado |
|---|---|
[user] | 200 |
[user, model "Rain"], un prefill | 400, repetido a las 03:13 UTC con el mismo resultado |
[user, model, user, model], historial guardado justo después de una respuesta | 400 |
La misma conversación sin el último model, terminada en el nuevo user | 200 |
[user] con la herramienta get_weather declarada | 200, el modelo devuelve un functionCall con thoughtSignature |
[user, model(functionCall)], todavía sin resultado de la herramienta | 400 |
[user, model(functionCall), user[functionResponse]] | 200 |
[user, model(functionCall), user[functionResponse, text]] | 200 |
El par de la tercera y la cuarta fila es el arreglo en su forma más simple: el mismo historial da 400 si termina en la respuesta guardada del modelo y 200 en cuanto el último turno es el mensaje nuevo del usuario. La última fila, en cambio, choca con lo que se ha informado en Vertex AI: en un issue de senpi (#3633, 18 de octubre de 2026) con Gemini 4 Argon en Vertex, [functionResponse, text] en un mismo turno dio 400, y un comentario del 28 de octubre de 2026 repitió el 400 con LiteLLM 1.101.0 hacia Google Cloud Express. La misma forma de petición puede pasar o fallar según cómo la serialice cada ruta, así que si trabajas con Vertex no te fíes de ese 200.
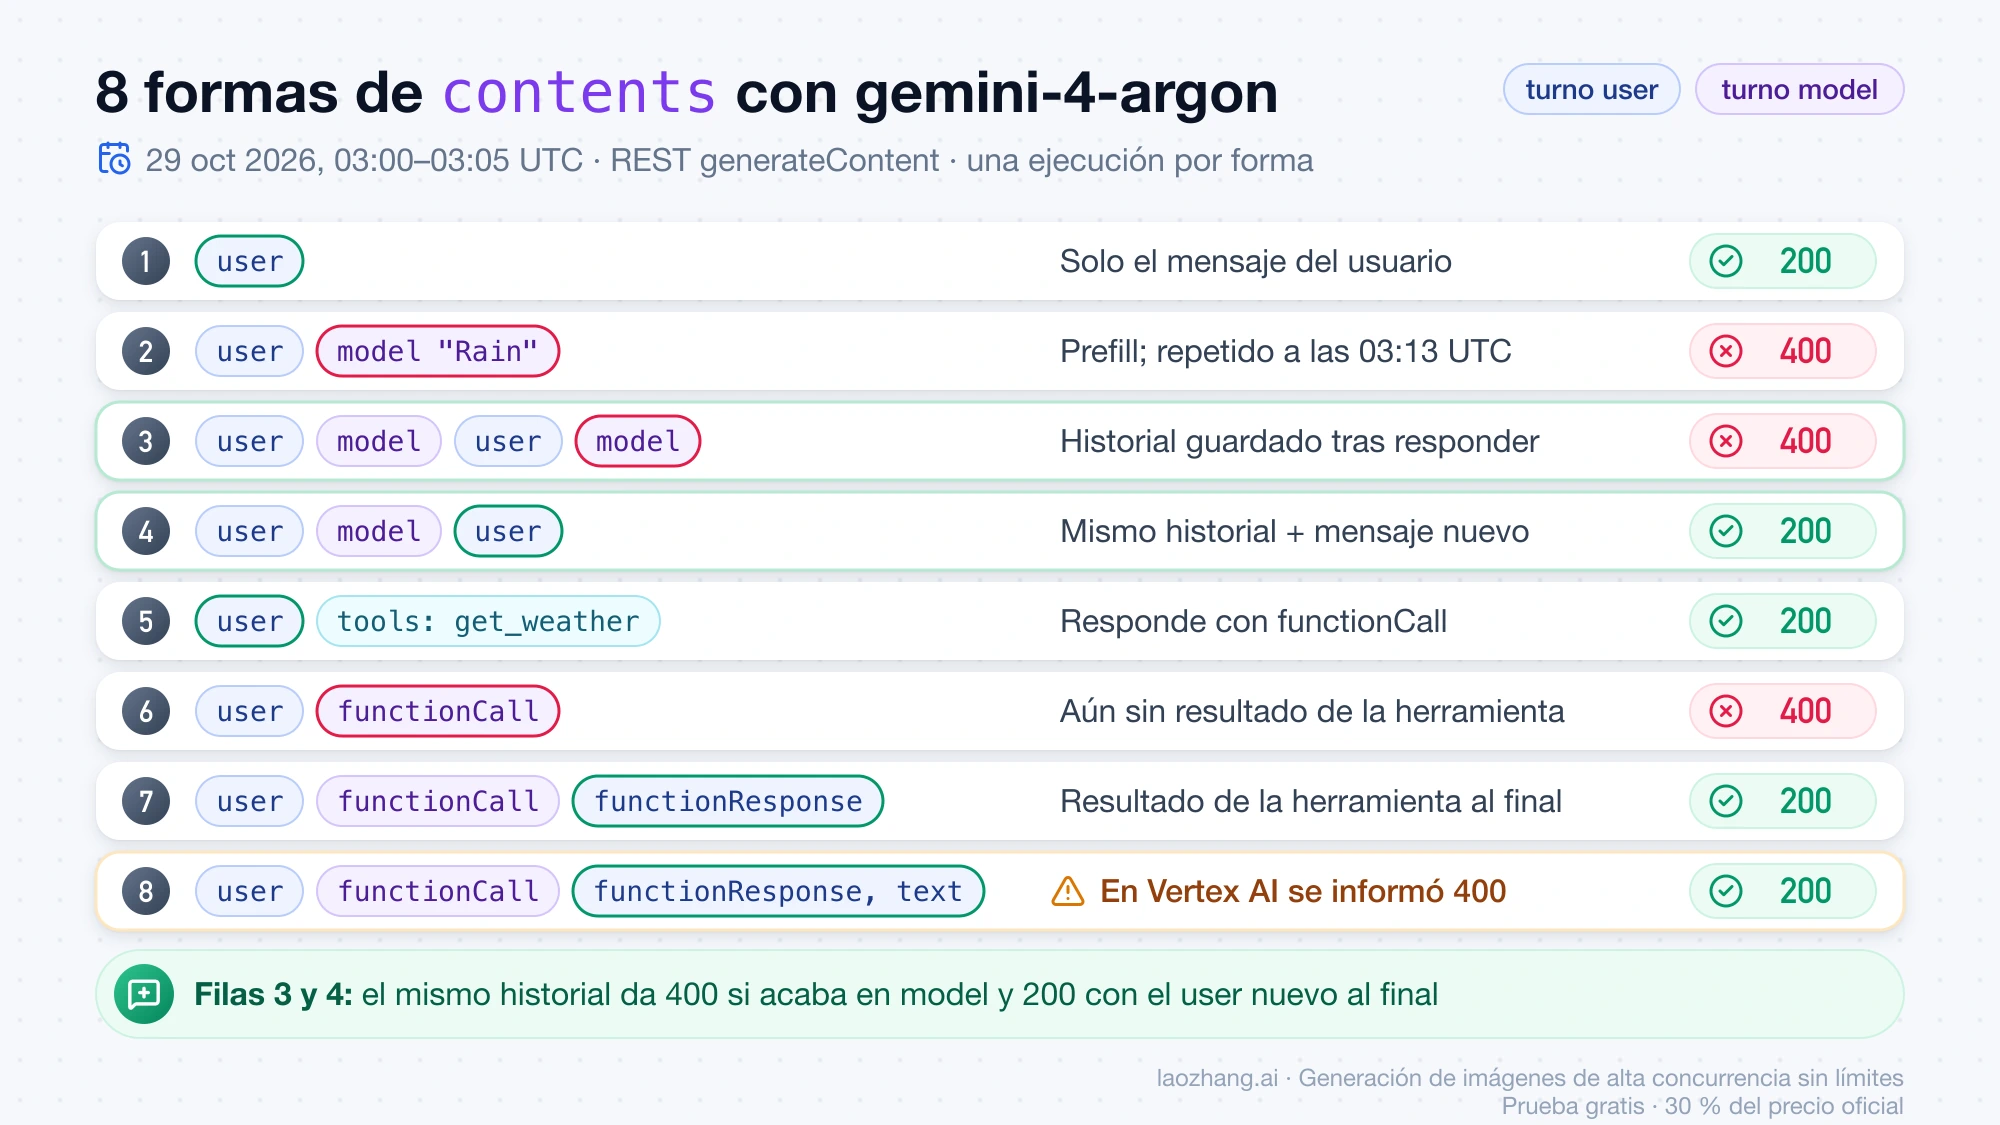
La muestra es pequeña: una ruta, un día y una sola ejecución por forma, salvo el prefill, que se repitió. Las respuestas 400 no traen modelVersion, así que atribuirlas a Argon se apoya en el ID de modelo de la petición y en la regla documentada por Google. El envoltorio del error también cambia con la ruta: la pasarela devolvió {"error":{"message":"Requests ending with a model turn are not supported.","type":"upstream_error","code":400}}, mientras que la API de Google usa "status":"INVALID_ARGUMENT", así que compara el texto del mensaje y no la estructura. Un turno del modelo con texto vacío obtuvo un 500 de la pasarela tras seis intentos, y de ahí no se puede sacar ninguna conclusión. Los sustitutos del prefill de la sección siguiente vienen de la documentación de Google.
Cómo arreglarlo en tu código: que la petición termine en user
Antes de cambiar nada, mira el cuerpo real que sale hacia la API, porque las librerías y los frontends convierten el historial y el último turno no siempre es el que crees. Después aplica el arreglo de tu caso:
-
Registra la petición y comprueba el rol del último turno no vacío. Esta función se puede dejar como protección antes de cada llamada:
def rol_del_ultimo_turno(contents): for turno in reversed(contents): partes = [p for p in turno.get("parts", []) if p.get("text") != ""] if partes: return turno["role"] return None if rol_del_ultimo_turno(payload["contents"]) == "model": raise ValueError("La petición termina en un turno model: añade el turno user") -
Si era un prefill, borra el turno
modeldel final y pasa la instrucción asystemInstruction. Es la sustitución que Google propone para quien prefijaba la salida para quitar preámbulos:{ "systemInstruction": { "parts": [{ "text": "Devuelve solo la traducción, sin introducción." }] }, "contents": [ { "role": "user", "parts": [{ "text": "Traduce 'Hello world' al español." }] } ] }Si el prefill servía para forzar JSON (por ejemplo, empezar la respuesta con
{), usa la salida estructurada engenerationConfigen lugar del turno del modelo:"generationConfig": { "responseMimeType": "application/json", "responseJsonSchema": { "type": "object", "properties": { "traduccion": { "type": "string" } }, "required": ["traduccion"] } } -
Si el historial se guarda justo después de cada respuesta, no lo envíes tal cual: añade al final el mensaje nuevo del usuario y solo entonces llama a la API. Es lo que corrige el par de filas 400 → 200 de la prueba anterior y lo que hace falta tras un rewind, una cancelación o una interrupción del usuario.
-
En un flujo con herramientas, devuelve el turno del modelo con el
functionCallexactamente como llegó, con suthoughtSignature, y cierra con un turnouserque lleve elfunctionResponse. Google pide reenviar el historial completo con las firmas de pensamiento (guía de Gemini 4 Argon), así que no las borres ni las inventes. En Vertex, si tienes que añadir texto, ponlo en un turnouseraparte, como en este ejemplo, o delante delfunctionResponse:"contents": [ { "role": "user", "parts": [{ "text": "¿Qué temperatura hace en París? Usa la herramienta." }] }, { "role": "model", "parts": [{ "functionCall": { "name": "get_weather", "args": { "city": "Paris" } }, "thoughtSignature": "FIRMA_DEVUELTA_SIN_CAMBIOS" }] }, { "role": "user", "parts": [{ "functionResponse": { "name": "get_weather", "response": { "temperature_c": 14 } } }] }, { "role": "user", "parts": [{ "text": "Responde en una frase." }] } ] -
Si el resultado de la herramienta incluye una imagen, devuélvelo como texto y manda la imagen en un mensaje
userposterior, que es la forma que dio 200 en OpenRouter.
En un agente o una pasarela con lógica de reintento o de cambio de modelo, clasifica este 400 como error de la petición: un mantenedor de senpi pidió el 20 de octubre de 2026 que no dispare enfriamientos ni cambios a otro modelo, y en LiveKit Agents el reintento en bucle tras un barge-in dejaba al agente en silencio (issue #2108 de LiveKit Agents JS).
countTokens da 400 con Gemini 4 Argon: cuenta hasta el último turno user
El fallo de countTokens con Argon está descrito en el issue #1708 de obsidian-gemini, abierto el 27 de octubre de 2026 por su mantenedor, allenhutchison. Con gemini-4-argon como modelo del chat, la llamada models.countTokens del plugin en el primer turno de una sesión nueva devolvió 400 INVALID_ARGUMENT con el mensaje truncado en el registro, Requests ending wi…are not supported., y el mismo flujo con gemini-flash-latest no falló. La causa que propone el autor, marcada por él mismo como hipótesis, es que justo después de guardar una respuesta el historial de la sesión termina en el turno del modelo y Argon rechaza un countTokens cuyo contents acaba en model. Los resultados de generateContent de la prueba del 29 de octubre son coherentes con esa hipótesis, pero no la demuestran.
El fallo no rompía el plugin, pero lo dejaba ciego: el código caía en promptTokenCount ?? 0, así que el contador de tokens y el umbral de compactación leían 0 en cada sesión nueva. El arreglo que propone el issue es contar solo hasta el último turno user o añadir un turno user al final antes de contar:
from google import genai

client = genai.Client()

def hasta_el_ultimo_user(contents):
    corte = max(i for i, t in enumerate(contents) if t["role"] == "user")
    return contents[: corte + 1]

recuento = client.models.count_tokens(
    model="gemini-4-argon",
    contents=hasta_el_ultimo_user(historial),
)
print(recuento.total_tokens)
Si te basta con saber cuánto ocupó la última petición, no necesitas countTokens: usageMetadata.promptTokenCount llega en cada respuesta de generateContent sin coste adicional. countTokens tampoco cuesta nada, admite hasta 3.000 peticiones por minuto, incluye gemini-4-argon en su lista de modelos y cuenta también las instrucciones de sistema y las herramientas, así que pásale las mismas que a la petición real si quieres que el número coincida (recuento de tokens en Firebase AI Logic, actualizado el 27 de octubre de 2026).
Si llamas a Gemini a través de una pasarela, comprueba antes que acepte :countTokens. El 29 de octubre de 2026, la pasarela de la prueba respondió 400 unsupported action: countTokens (invalid_request_error) tanto con contents terminado en user como en model: es otro 400, de otra capa, que no tiene nada que ver con la regla del turno del modelo.
Gemini CLI, opencode, SillyTavern y otras herramientas: estado y arreglo
Cuando el error aparece dentro de una herramienta, la petición la construye la herramienta y tú solo puedes actualizarla, cambiar un ajuste o desbloquear la sesión. Este es el estado de los casos documentados en GitHub y en foros a 29 de octubre de 2026:
| Herramienta | Qué deja el turno del modelo al final | Estado y qué hacer |
|---|---|---|
| Gemini CLI | /rewind, un stream interrumpido, Ctrl-C rápido o leer un .png (#29530, #29574, #29588) | Corregido por los PR #29612 (7 de octubre) y #29728 (13 de octubre), incluidos en v0.65.0 del 20 de octubre: actualiza a v0.65.0 o posterior |
| opencode | El aviso de límite de pasos (MAX_STEPS_PROMPT) añadido como mensaje del asistente (#45359); el paso tras leer un .png vía OpenRouter (#55694) | #45359 cerrado, pero aún reproducido en 1.18.31 el 15 de septiembre y sin versión corregida confirmada; #55694 abierto. Escribe un mensaje nuevo para seguir |
| Kilo Code | Un paso guardado fuera de orden cuando el reloj del sistema retrocede (#15073) | Abierto desde el 14 de octubre |
LangChain (langchain-google, Vertex) | Une ToolMessage y HumanMessage en un solo turno user (#1995) | Abierto; no envíes texto del usuario pegado al resultado de la herramienta |
| LiteLLM (Vertex) | Historial que termina en un mensaje del asistente solo de texto (#38537) | Abierto; termina la lista de mensajes con uno del usuario |
| instructor | El «reask» de la salida estructurada termina en el turno del modelo (#2631) | Abierto |
| LiveKit Agents (JS) | Tras un barge-in, la respuesta truncada queda al final del historial (#2108) | Abierto; la protección injectDummyUserMessage no salta en este caso |
| Hermes Agent con OpenRouter | Resultado de herramienta con imagen como último mensaje (#139313) | Abierto; resultado en texto e imagen en un mensaje user aparte |
| SillyTavern, JanitorAI con proxy y otros frontends de rol | Presets de Chat Completion con prefill del asistente, continuación o «empezar la respuesta con», sobre clave de AI Studio y Gemini 3.6 Flash o posterior | Chat nuevo que termine en un mensaje real tuyo, sin esos ajustes; reactívalos de uno en uno |
En los frontends de rol, el nombre exacto de cada ajuste cambia según la versión y las extensiones instaladas. La guía de EvoLink para Gemini en SillyTavern (16 de octubre de 2026) lo resume bien: que veas la caja de texto no prueba que el último mensaje enviado sea del usuario, porque el prefill, la continuación, la conversión del historial o una extensión pueden cambiarlo. Por eso el método fiable es empezar con un chat limpio y volver a activar los ajustes uno a uno hasta que reaparezca el 400.
Otras preguntas sobre el error «Requests ending with a model turn»
¿Es lo mismo que el error «role system is not supported»?
No. Ese 400 se refiere a un rol que el modelo no acepta, no a la posición del último turno, y se corrige de otra forma: lo tienes en Corrige API 400 por rol no admitido sin romper las instrucciones del sistema.
¿Cómo hago que Gemini 4 Argon continúe una respuesta cortada sin prefill?
Envía la respuesta parcial como turno del modelo y, detrás, un turno user que pida seguir, de modo que la petición termine en user. Antes de continuar conviene saber por qué se cortó, y eso depende del finish_reason: lo explica Gemini 4 Argon API: acceso, finish_reason y respuestas cortadas.
Mi 400 con Gemini 4 Argon dice otra cosa, ¿tiene la misma causa?
No necesariamente. Según la guía de migración de Google, el caché explícito (cachedContents) no está disponible en Gemini 4 Argon y devuelve un error, y «Function call is missing a thought_signature» es otro 400 distinto, relacionado con las firmas de pensamiento que faltan al reenviar un functionCall.
Fuentes11
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 29 oct 2026.
Fuentes11
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 29 oct 2026.
- 1.novedades de Gemini 3.6 en la documentación de Gemini APIai.google.dev/gemini-api/docs/whats-new-gemini-3.6
- 2.solución de problemas de Gemini APIai.google.dev/gemini-api/docs/troubleshooting
- 3.hilo de LINUX DO sobre el error en Gemini 3.6 Flashlinux.do/t/topic/2631609
- 4.guía de migración a Gemini 4 Argonai.google.dev/gemini-api/docs/generate-content/latest-model
- 5.issue #55694 de opencodegithub.com/anomalyco/opencode/issues/55694
- 6.issue #29574 de Gemini CLIgithub.com/google-gemini/gemini-cli/issues/29574
- 7.issue #139313 de Hermes Agentgithub.com/NousResearch/hermes-agent/issues/139313
- 8.issue #2108 de LiveKit Agents JSgithub.com/livekit/agents-js/issues/2108
- 9.issue #1708 de obsidian-geminigithub.com/allenhutchison/obsidian-gemini/issues/1708
- 10.recuento de tokens en Firebase AI Logicfirebase.google.com/docs/ai-logic/count-tokens
- 11.guía de EvoLink para Gemini en SillyTavernevolink.ai/blog/sillytavern-gemini-setup-troubleshooting