Límites de la API de Gemini: niveles, topes de gasto y error 429
RPM, TPM y RPD se cuentan por proyecto y se ven en AI Studio; tu nivel fija además un tope de gasto de 10 $ a 200 $ cada 10 minutos y un tope mensual.
En esta página
La API de Gemini (la Gemini Developer API que usas con una clave de AI Studio) limita tu uso de dos formas a la vez. La primera son los límites de frecuencia: solicitudes por minuto (RPM), tokens de entrada por minuto (TPM) y solicitudes por día (RPD), que se cuentan por proyecto, no por clave. La segunda son los límites de dinero, que dependen del nivel de tu cuenta de facturación: un tope de gasto en una ventana móvil de 10 minutos (10 $ en Tier 1, 50 $ en Tier 2, 200 $ en Tier 3) y un tope mensual (250 $, 2.000 $ y de 20.000 a más de 100.000 $).
Google no publica una tabla de RPM por modelo y nivel. Las cifras que se aplican a tu proyecto solo aparecen en la página de límites de AI Studio, y la propia documentación advierte que no están garantizadas. Todo lo que sigue procede de las páginas oficiales de límites de frecuencia y de facturación de Google, a 5 de octubre de 2026.
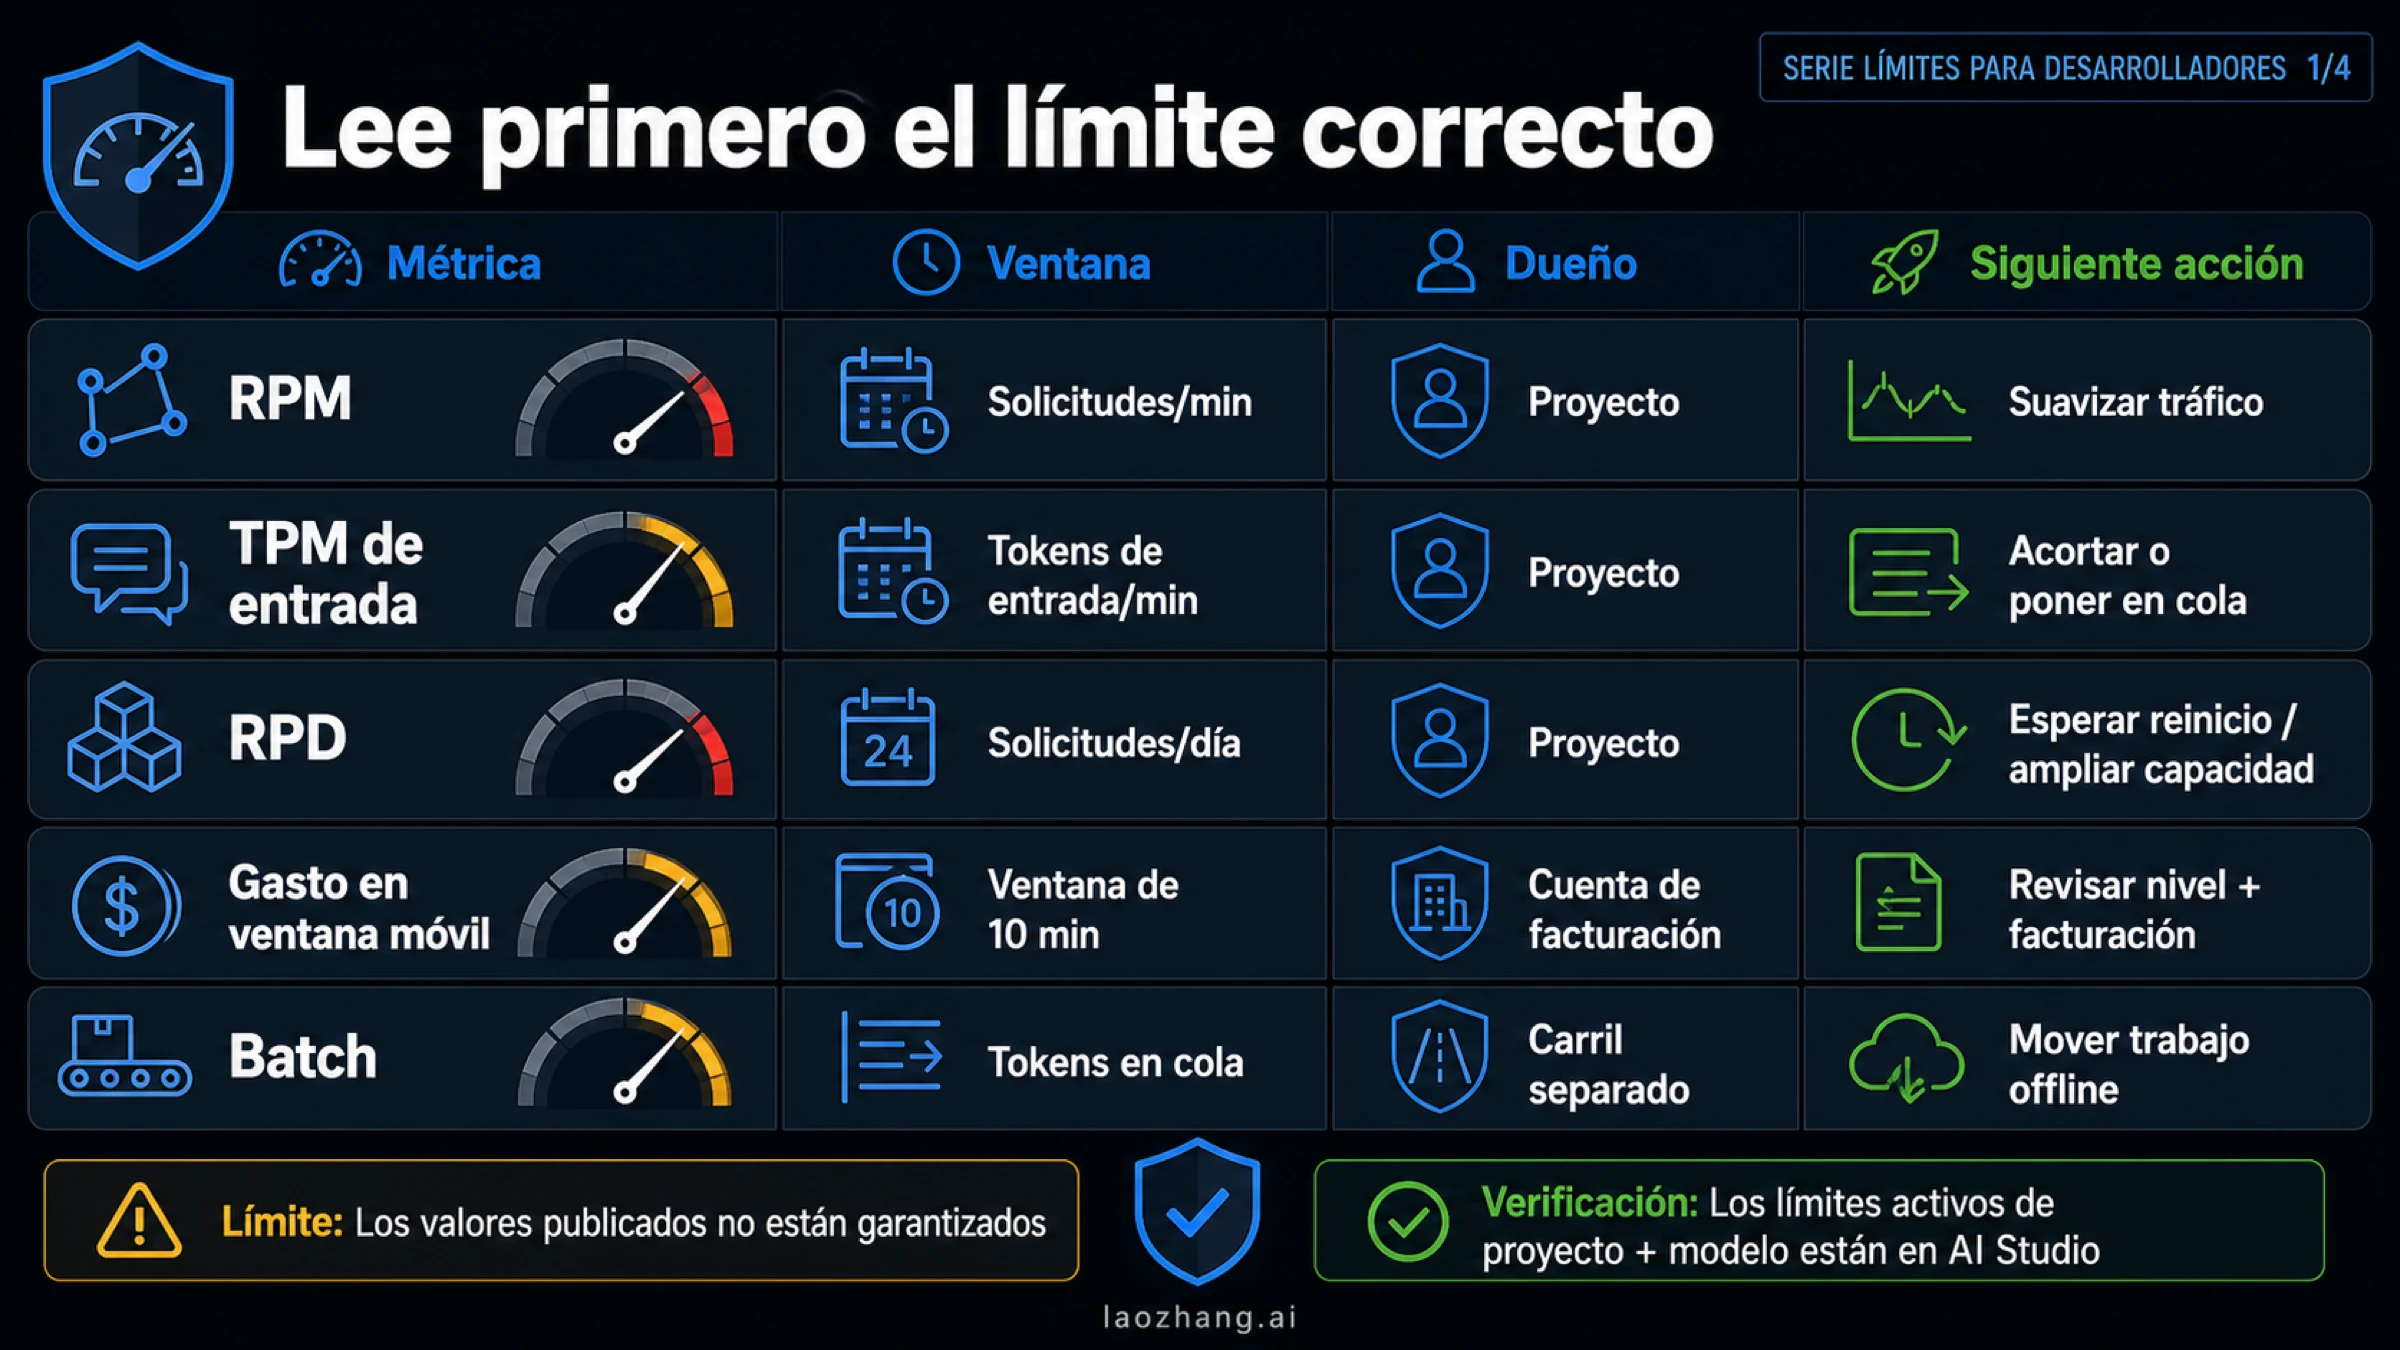
Qué mide cada límite de la API de Gemini: RPM, TPM, RPD, IPM y TPD
Tu uso se compara con cada dimensión por separado, y basta con superar una para recibir un error de límite. Si tu RPM es 20, la petición 21 dentro del mismo minuto falla aunque estés lejos de tu TPM.
| Dimensión | Qué cuenta | Ventana | Dónde se suma |
|---|---|---|---|
| RPM | Solicitudes | 1 minuto | Proyecto |
| TPM | Tokens de entrada | 1 minuto | Proyecto |
| RPD | Solicitudes | Día; se reinicia a medianoche del Pacífico | Proyecto |
| IPM | Imágenes generadas | 1 minuto; solo modelos que generan imágenes (Nano Banana) | Proyecto |
| TPD | Tokens | Día; solo en algunos modelos | Proyecto |
Tres consecuencias prácticas:
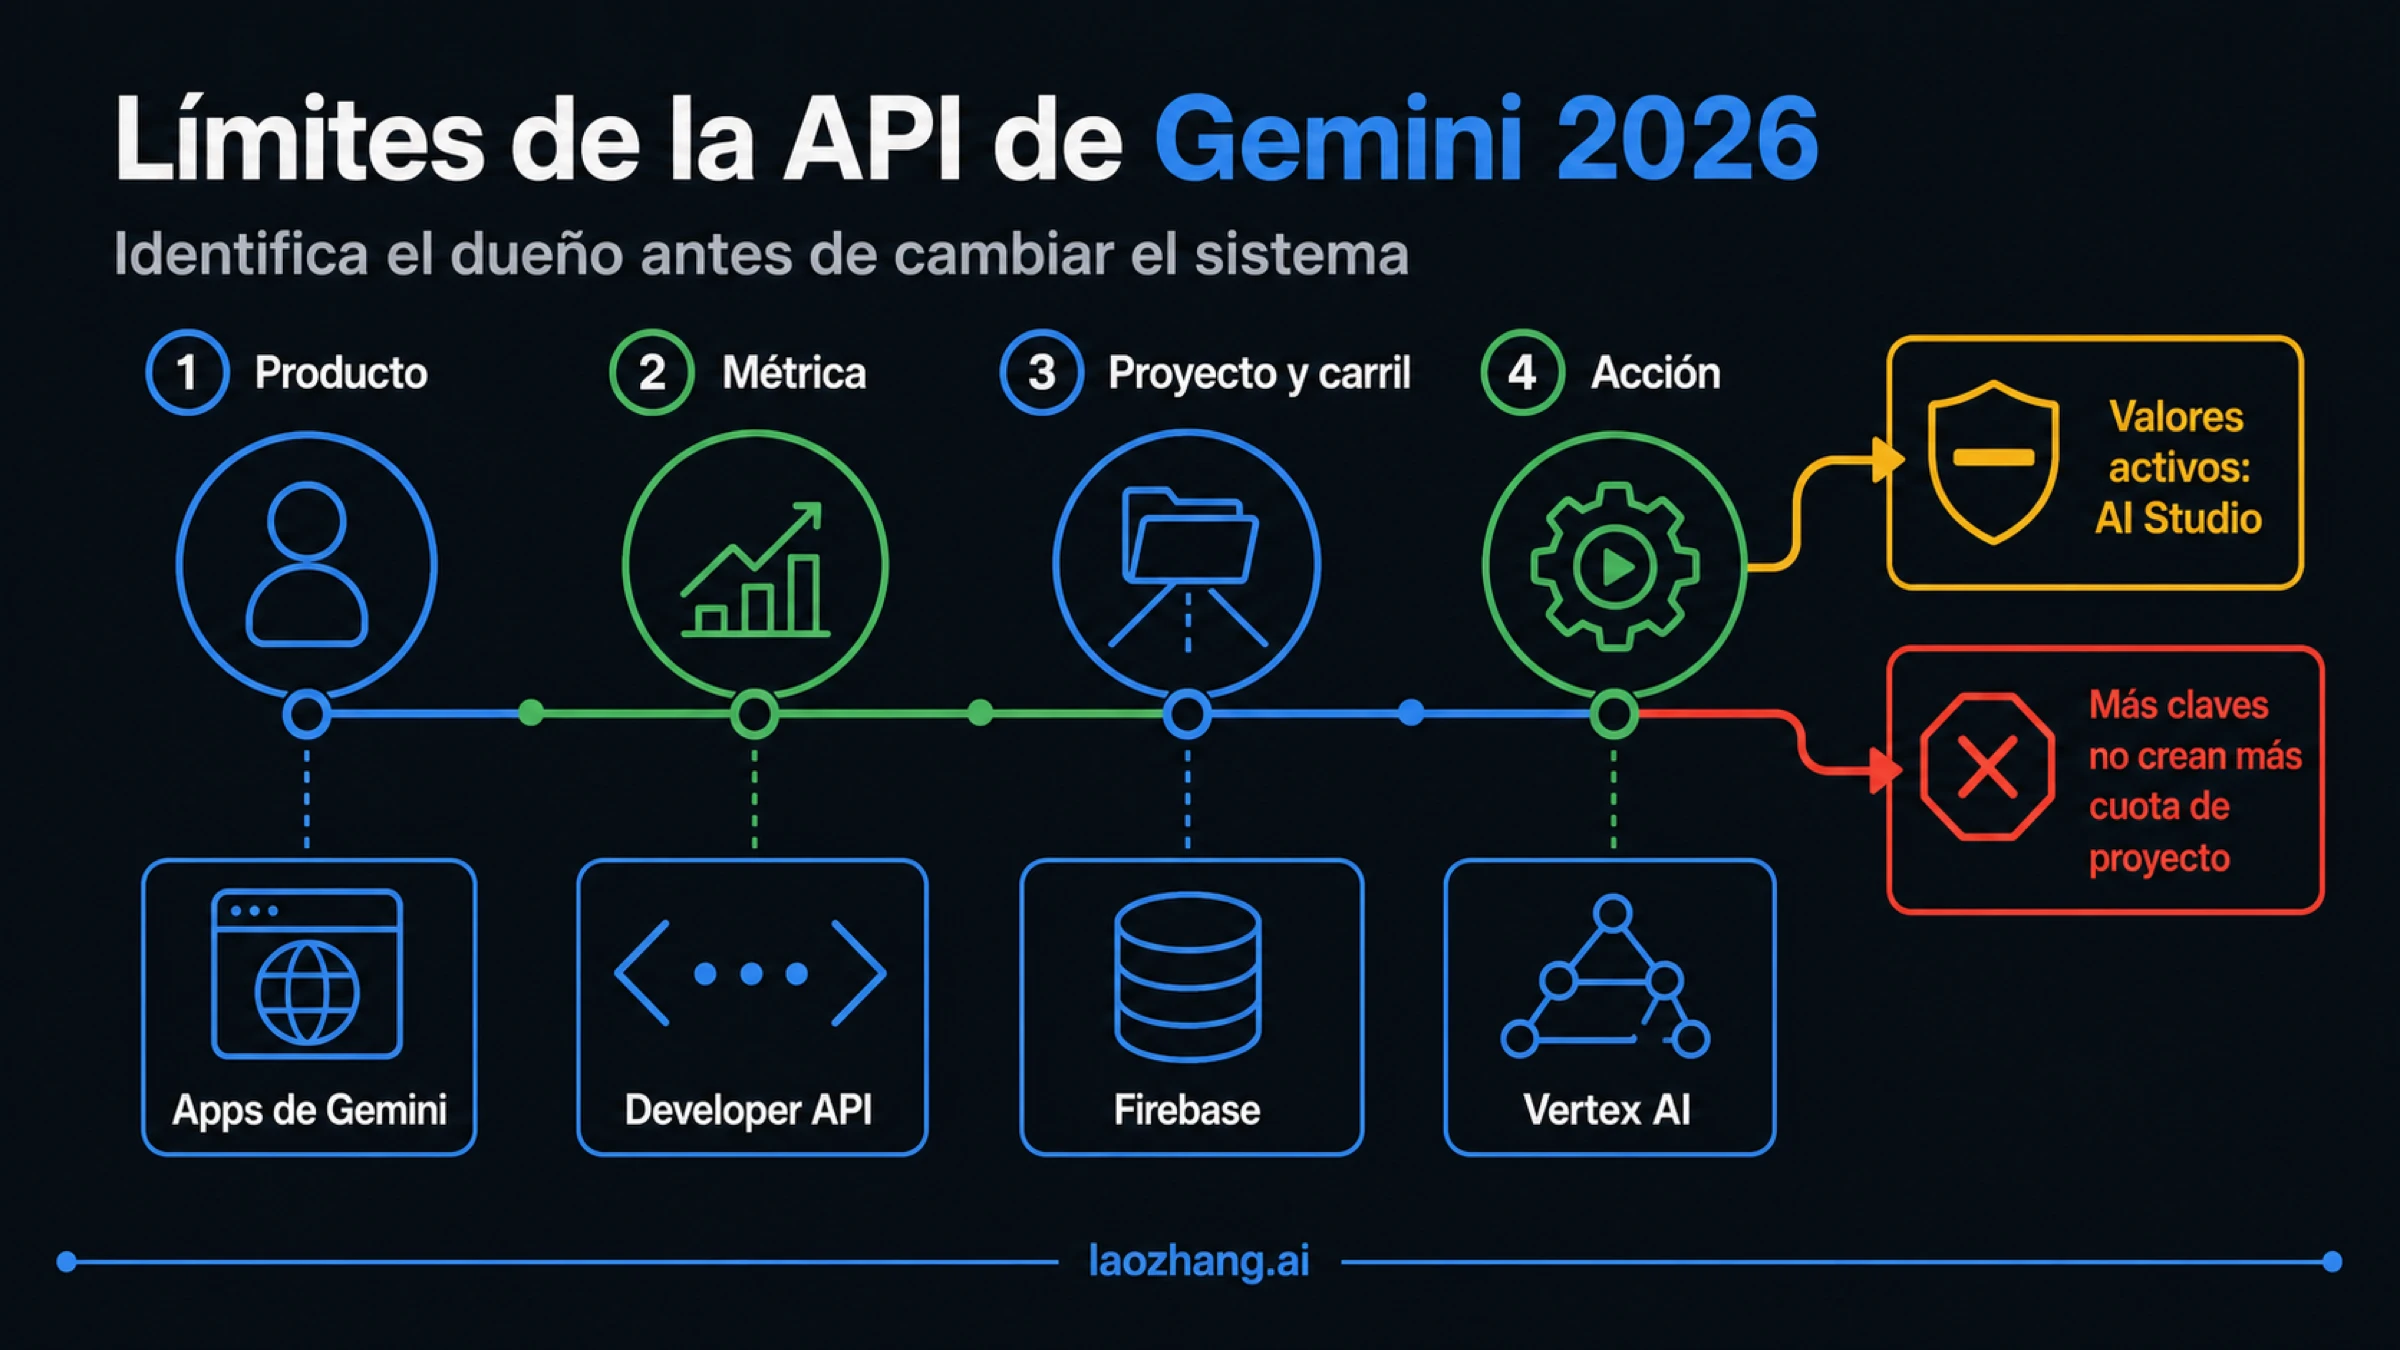
- Más claves no suman cuota. Todas las claves de un proyecto comparten los mismos RPM, TPM y RPD. Producción, pruebas, cuadernos y tareas programadas que usen el mismo proyecto gastan del mismo saldo de peticiones.
- El RPD se reinicia a las 9:00 en la España peninsular (8:00 en Canarias), que es la medianoche del Pacífico. En las semanas en que Estados Unidos y Europa no han cambiado aún de hora a la vez, a finales de marzo y entre finales de octubre y principios de noviembre, el reinicio llega una hora antes: a las 8:00 en la península.
- Las peticiones fallidas también cuentan. Según la página de facturación, una petición que termina en error 400 o 500 no se cobra, pero sí consume cuota. Un bucle que reenvía peticiones mal formadas agota el RPD sin producir nada.
Los modelos en vista previa y experimentales tienen límites más estrictos que los estables.
Dónde ver tus límites reales: la página de límites de AI Studio
La documentación de Google explica cómo funcionan los límites, pero no imprime los valores de cada modelo: remite a la página aistudio.google.com/rate-limit, donde ves los límites activos del proyecto seleccionado. Esos valores cambian con tu nivel y con el estado de la cuenta, y Google aclara que «los límites especificados no están garantizados y la capacidad real puede variar».
Para saber en qué nivel estás, abre la página de proyectos de AI Studio y mira la columna Billing Tier. Ahí también aparecen los avisos que bloquean el servicio: «Set up billing» (el proyecto no tiene cuenta de facturación), «Set up Prepay» (falta configurar el prepago) y «No credits» (saldo agotado). El consumo se consulta en Dashboard > Usage.
Una tabla de RPM o RPD «por nivel» que no salga de esa página no refleja tu proyecto. Si necesitas una cifra para planificar, tómala de AI Studio el mismo día y deja margen.
Niveles de uso de la API de Gemini: requisitos y tope mensual
El nivel no lo tiene el proyecto ni la clave, sino la cuenta de facturación de Google Cloud a la que está vinculado el proyecto. Todos los proyectos de esa cuenta heredan su nivel, sus límites y sus topes; si mueves un proyecto a otra cuenta de facturación, cambia al nivel de esa cuenta, y si lo desvinculas vuelve al nivel gratuito.
| Nivel | Requisito | Tope mensual de la cuenta | Tope de gasto cada 10 minutos |
|---|---|---|---|
| Gratuito | Proyecto activo o prueba gratuita | No aplica | No aplica |
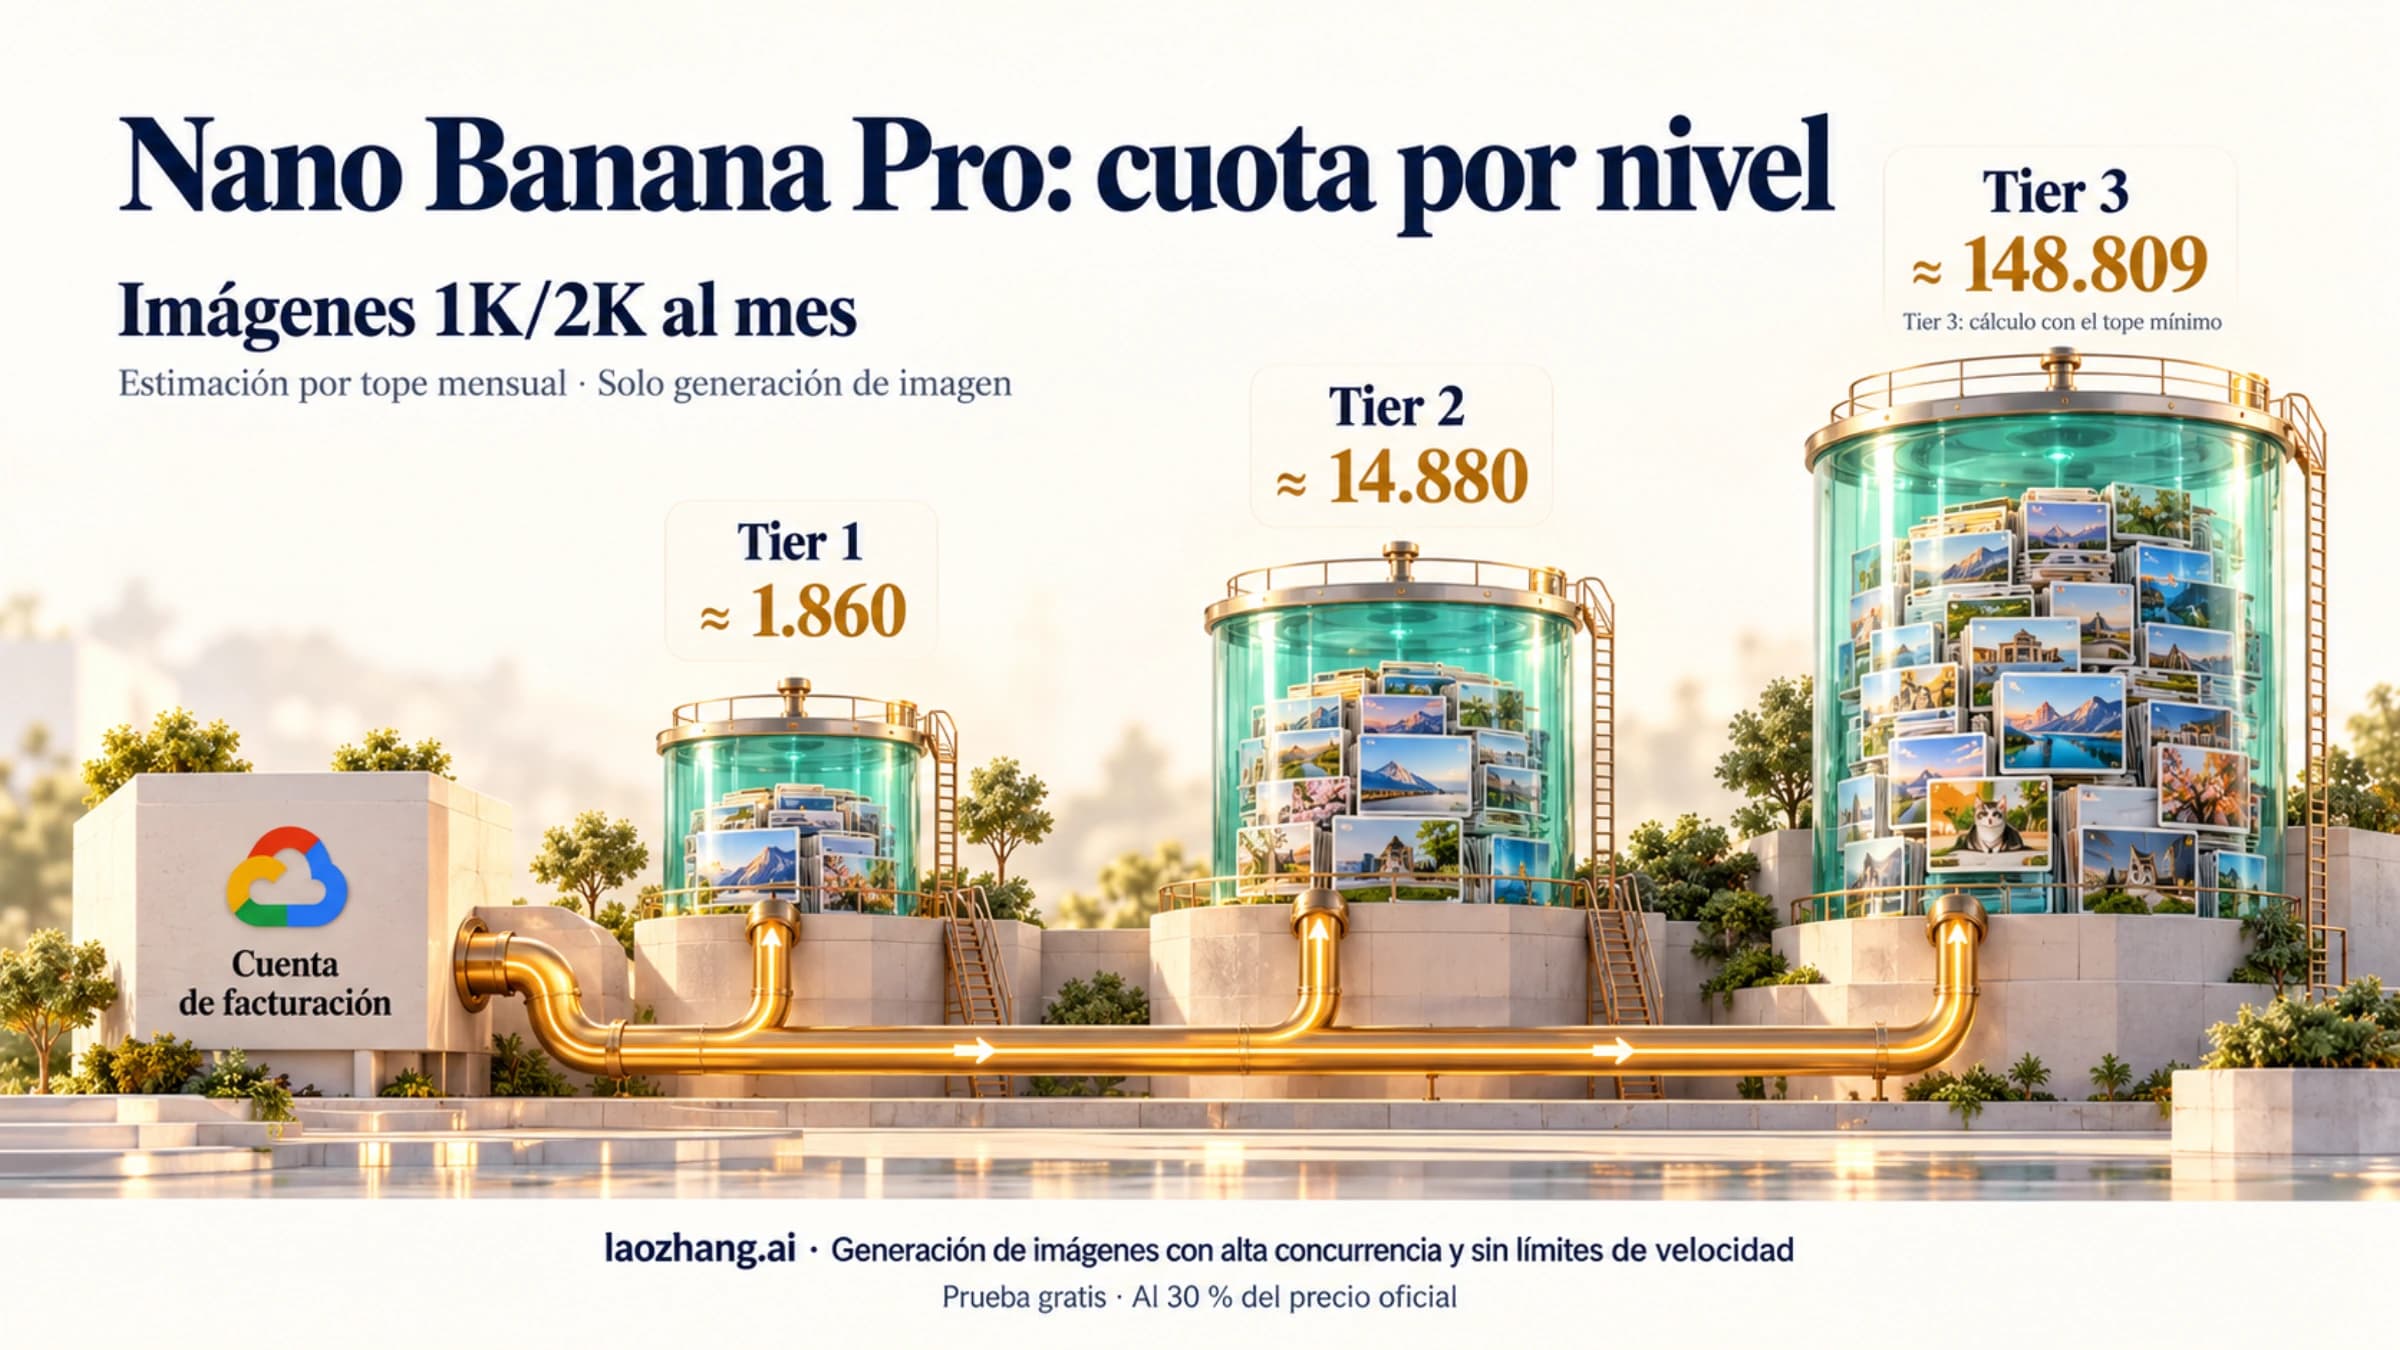
| Tier 1 | Vincular una cuenta de facturación activa | 250 $ | 10 $ |
| Tier 2 | 100 $ pagados y 3 días desde el primer pago correcto | 2.000 $ | 50 $ |
| Tier 3 | 1.000 $ pagados y 30 días desde el primer pago correcto | De 20.000 a más de 100.000 $ | 200 $ |
Fuente: páginas de límites (actualizada el 2 de septiembre de 2026) y de facturación (28 de septiembre de 2026) de Google.
Lo que conviene saber de esta tabla:
- El gasto que cuenta para subir es el de todo Google Cloud en esa cuenta de facturación, no solo el de la API de Gemini.
- Para pasar a Tier 1 se configura la facturación desde AI Studio («Set up billing» en la página de claves o de proyectos). Desde el 23 de marzo de 2026 las cuentas nuevas usan por defecto el plan de prepago, que exige comprar al menos 5 $ de créditos; algunas cuentas reciben pospago o pueden elegir. Los detalles de prepago y pospago están en la guía de facturación de Gemini API: prepago, pospago y niveles.
- La subida es automática. De gratuito a Tier 1 suele ser inmediata; las siguientes se aplican en unos 10 minutos desde que cumples los requisitos. Google añade que, en casos raros, una subida puede denegarse tras revisar otros factores.
- El crédito de bienvenida de 300 $ de Google Cloud no sirve para la API de Gemini ni para AI Studio en cuentas abiertas después del 2 de marzo de 2026, así que no ayuda a cumplir requisitos de pago con la API.
Si cumples los requisitos y el nivel no cambia, no es un caso aislado: en el foro de desarrolladores de Google hubo en abril de 2026 usuarios atascados en Tier 1 con casi 2.000 $ gastados, y en agosto de 2026 varias cuentas bajaron de Tier 3 a Tier 1 sin aviso; un empleado de Google habilitó un formulario para esos casos y dijo haber corregido las solicitudes recibidas. Son informes de desarrolladores, no un fallo reconocido en la documentación. Según esos desarrolladores, lo que lo resolvió fue enviar el formulario oficial de aumento que aparece más abajo. El camino concreto hacia Tier 3 para generar imágenes está en cómo subir la cuota de Nano Banana Pro API.
Topes de gasto: 10 minutos para frenar picos, un mes para toda la cuenta
Además de RPM y TPM, la API aplica límites basados en gasto para evitar cargos inesperados. Funcionan a dos escalas distintas y conviene no confundirlas, porque una se resuelve esperando minutos y la otra no se resuelve hasta el mes siguiente.
Tope de gasto en ventana móvil de 10 minutos. Es de 10 $ en Tier 1, 50 $ en Tier 2 y 200 $ en Tier 3, y no existe en el nivel gratuito. Que se aplique o no a tu cuenta depende de tu historial de facturación y del estado de la cuenta. Al alcanzarlo, la API devuelve 429 RESOURCE_EXHAUSTED. Google recomienda esperar y reintentar, reducir las peticiones caras (contextos más cortos, salidas más breves) y, si lo alcanzas con uso normal, pedir un aumento.
Para hacerte una idea con imágenes: Nano Banana Pro cuesta 0,134 $ por imagen 1K o 2K, así que 10 $ / 0,134 $ ≈ 74 imágenes por ventana de 10 minutos en Tier 1, contando solo la salida de imagen. El cálculo completo por modelo y nivel está en error 429 de Gemini en imágenes: qué límite saltó y qué hacer.
Tope mensual de la cuenta de facturación. Son los 250 $, 2.000 $ y 20.000–100.000 $ de la tabla de niveles. El gasto se suma entre todos los proyectos vinculados que tengan la API de Gemini activada, y cuando el total llega al tope el servicio se pausa en todos esos proyectos hasta el día 1 del mes siguiente. Esperar unos minutos no sirve; la vía es pedir un aumento del tope. Un desarrollador citó en el foro de Google este mensaje de error: «Your billing account has exceeded its monthly spending cap. Please go to AI Studio at https://ai.studio/billing to manage your billing».
Tope por proyecto (experimental). Puedes fijar tú mismo un tope mensual por proyecto en la página Spend de AI Studio (Monthly spend cap > Edit spend cap), con rol de editor, propietario o administrador del proyecto. Sirve para repartir el tope de la cuenta entre varios proyectos. Como el procesamiento de facturación tarda unos 10 minutos, el gasto puede pasarse algo del tope, sobre todo con trabajos largos de Batch o agentes. No está disponible para cuentas con facturación por factura.
Saldo de prepago a cero. No es un límite de frecuencia, pero corta igual: cuando el saldo de prepago de la cuenta llega a 0 $, dejan de funcionar todas las claves de todos los proyectos vinculados y las peticiones fallan con HTTP 402 hasta que añades créditos. La recarga automática, en la página Billing de AI Studio, evita ese corte.
Qué error indica qué límite: 429, 402 y tope mensual
La página de errores de la API distingue varios 429 por su código. Esos nombres son los de la Interactions API; con generateContent recibes el estado HTTP y RESOURCE_EXHAUSTED, y el mensaje indica qué métrica se superó.
| Lo que recibes | Qué límite saltó | ¿Reintentar? | Qué hacer |
|---|---|---|---|
429 rate_limit_exceeded | Peticiones o tokens por minuto (o por segundo) | Sí, con espera exponencial | Suavizar picos y limitar la concurrencia |
429 too_many_requests | Demasiadas peticiones en poco tiempo | Sí, con espera exponencial | Igual que el anterior |
429 quota_exceeded | Cuota diaria (RPD) | No antes del reinicio | Esperar a la medianoche del Pacífico o pedir aumento |
429 RESOURCE_EXHAUSTED con el gasto reciente cerca de tu tope de 10 minutos | Tope de gasto de 10 minutos | Sí, tras unos minutos | Reducir peticiones caras; si se repite con uso normal, pedir aumento |
402 payment_required | Saldo de prepago agotado | No | Añadir créditos o activar la recarga automática |
| Mensaje de «monthly spending cap» | Tope mensual de la cuenta de facturación | No hasta el día 1 | Pedir aumento del tope |
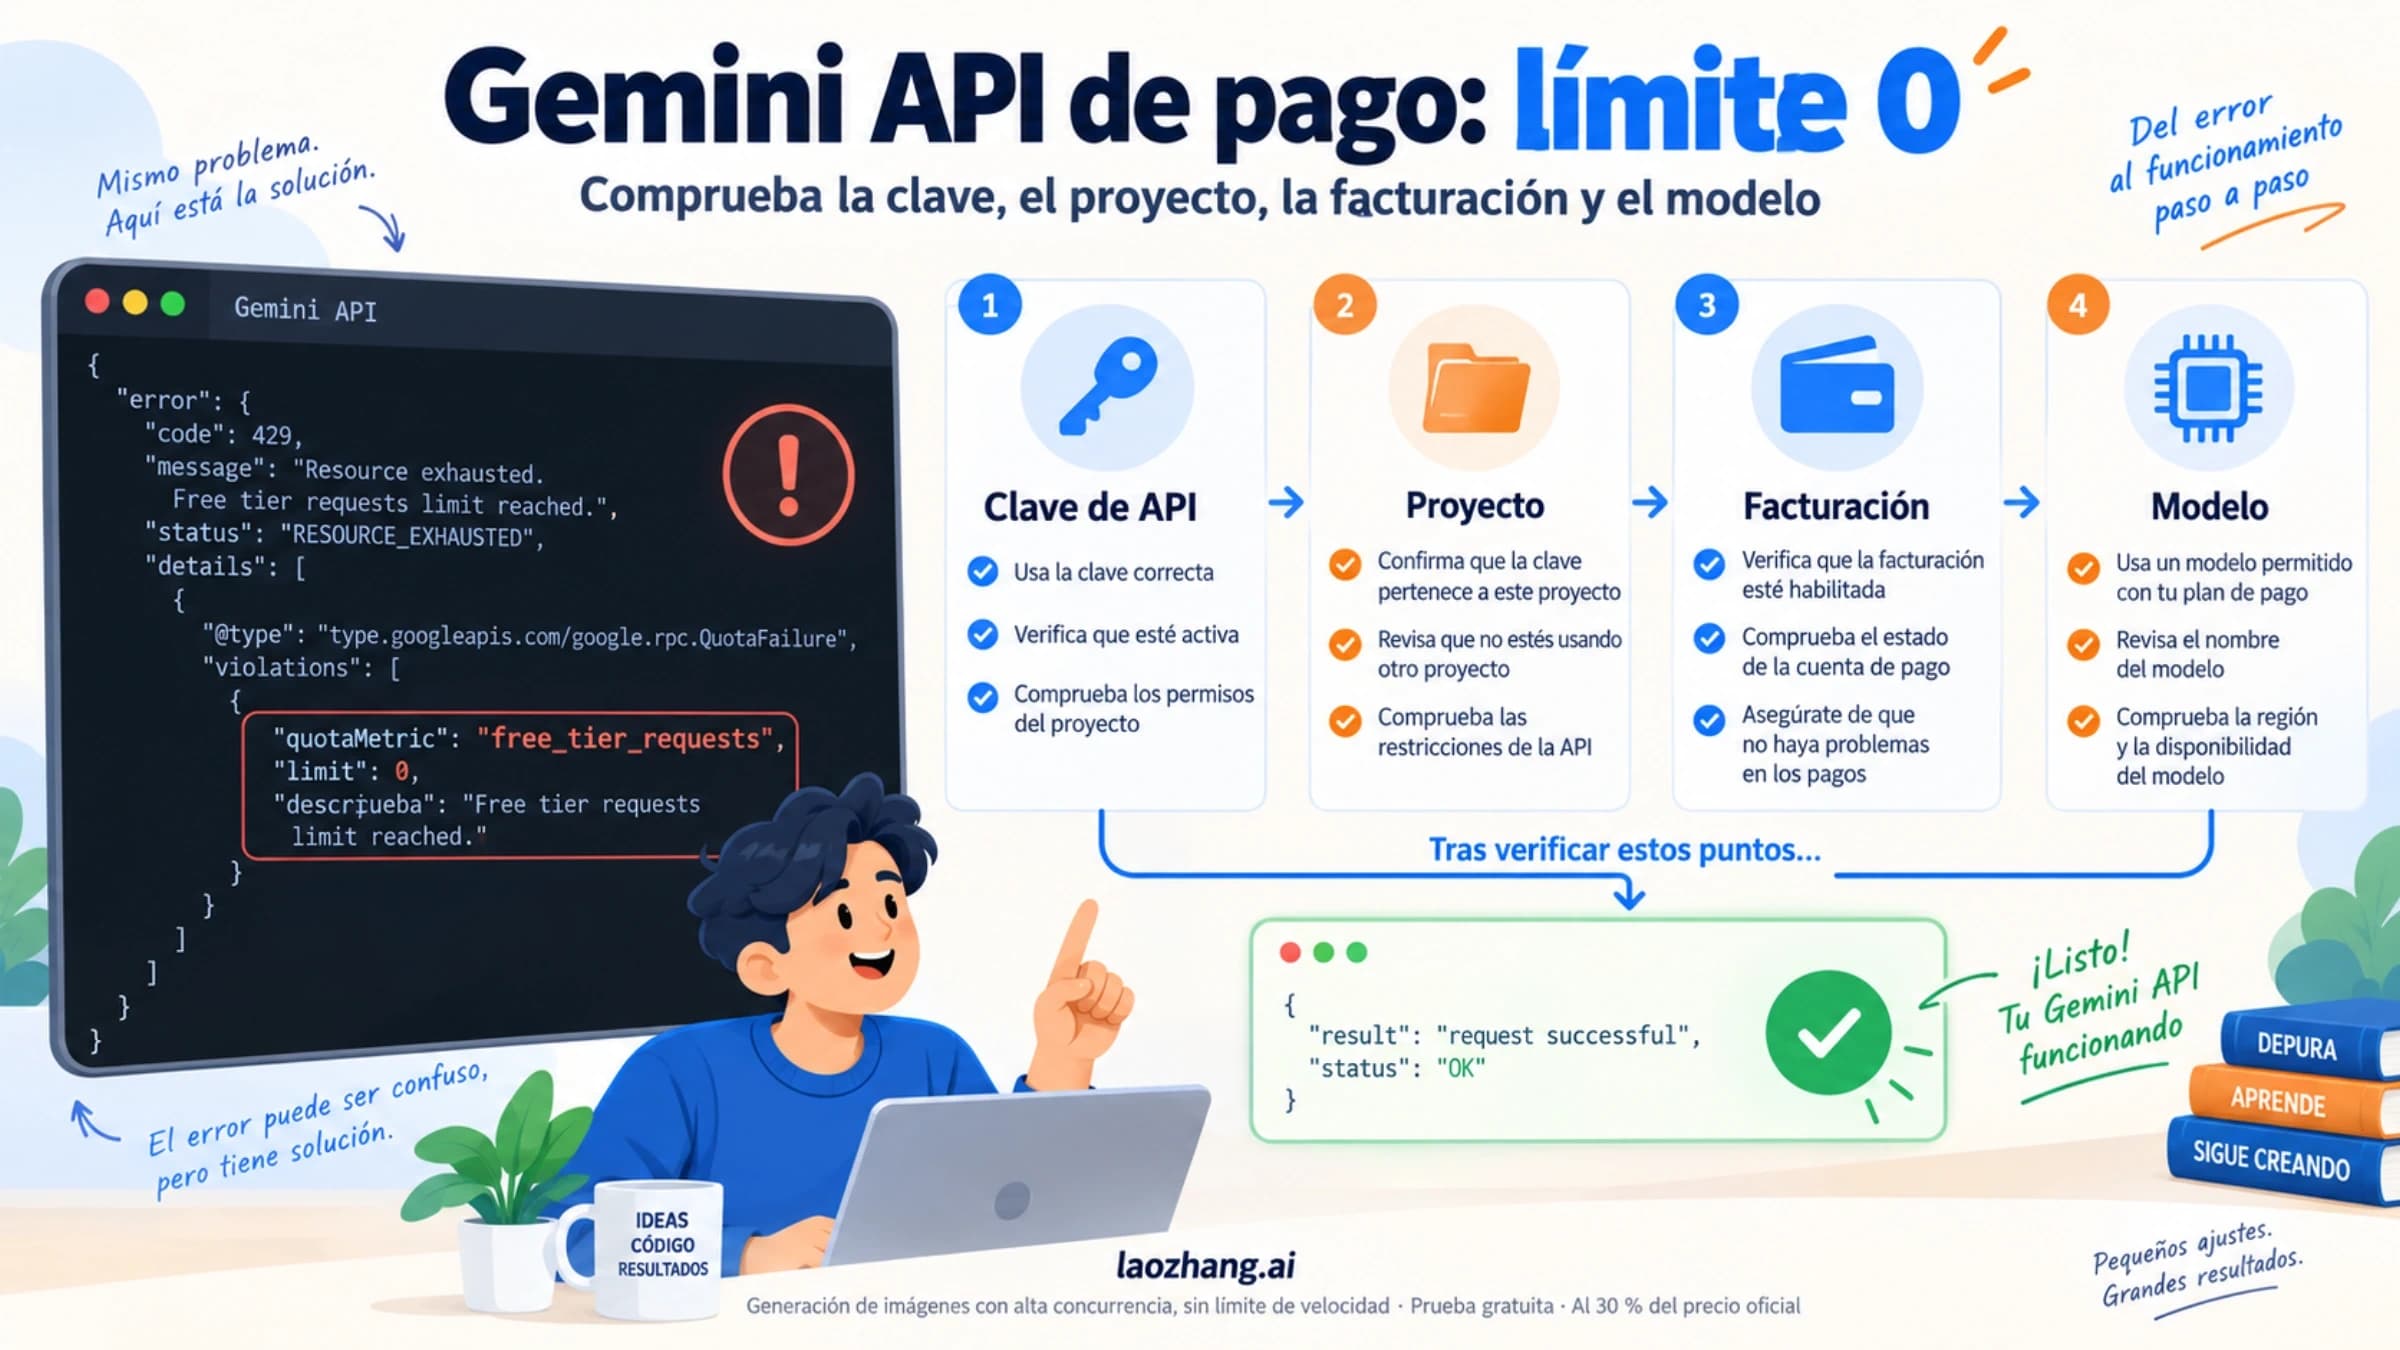
429 con free_tier_requests y limit: 0 | El proyecto no tiene cuota de pago para ese modelo | No | Ver Gemini API de pago con free_tier_requests limit 0 |
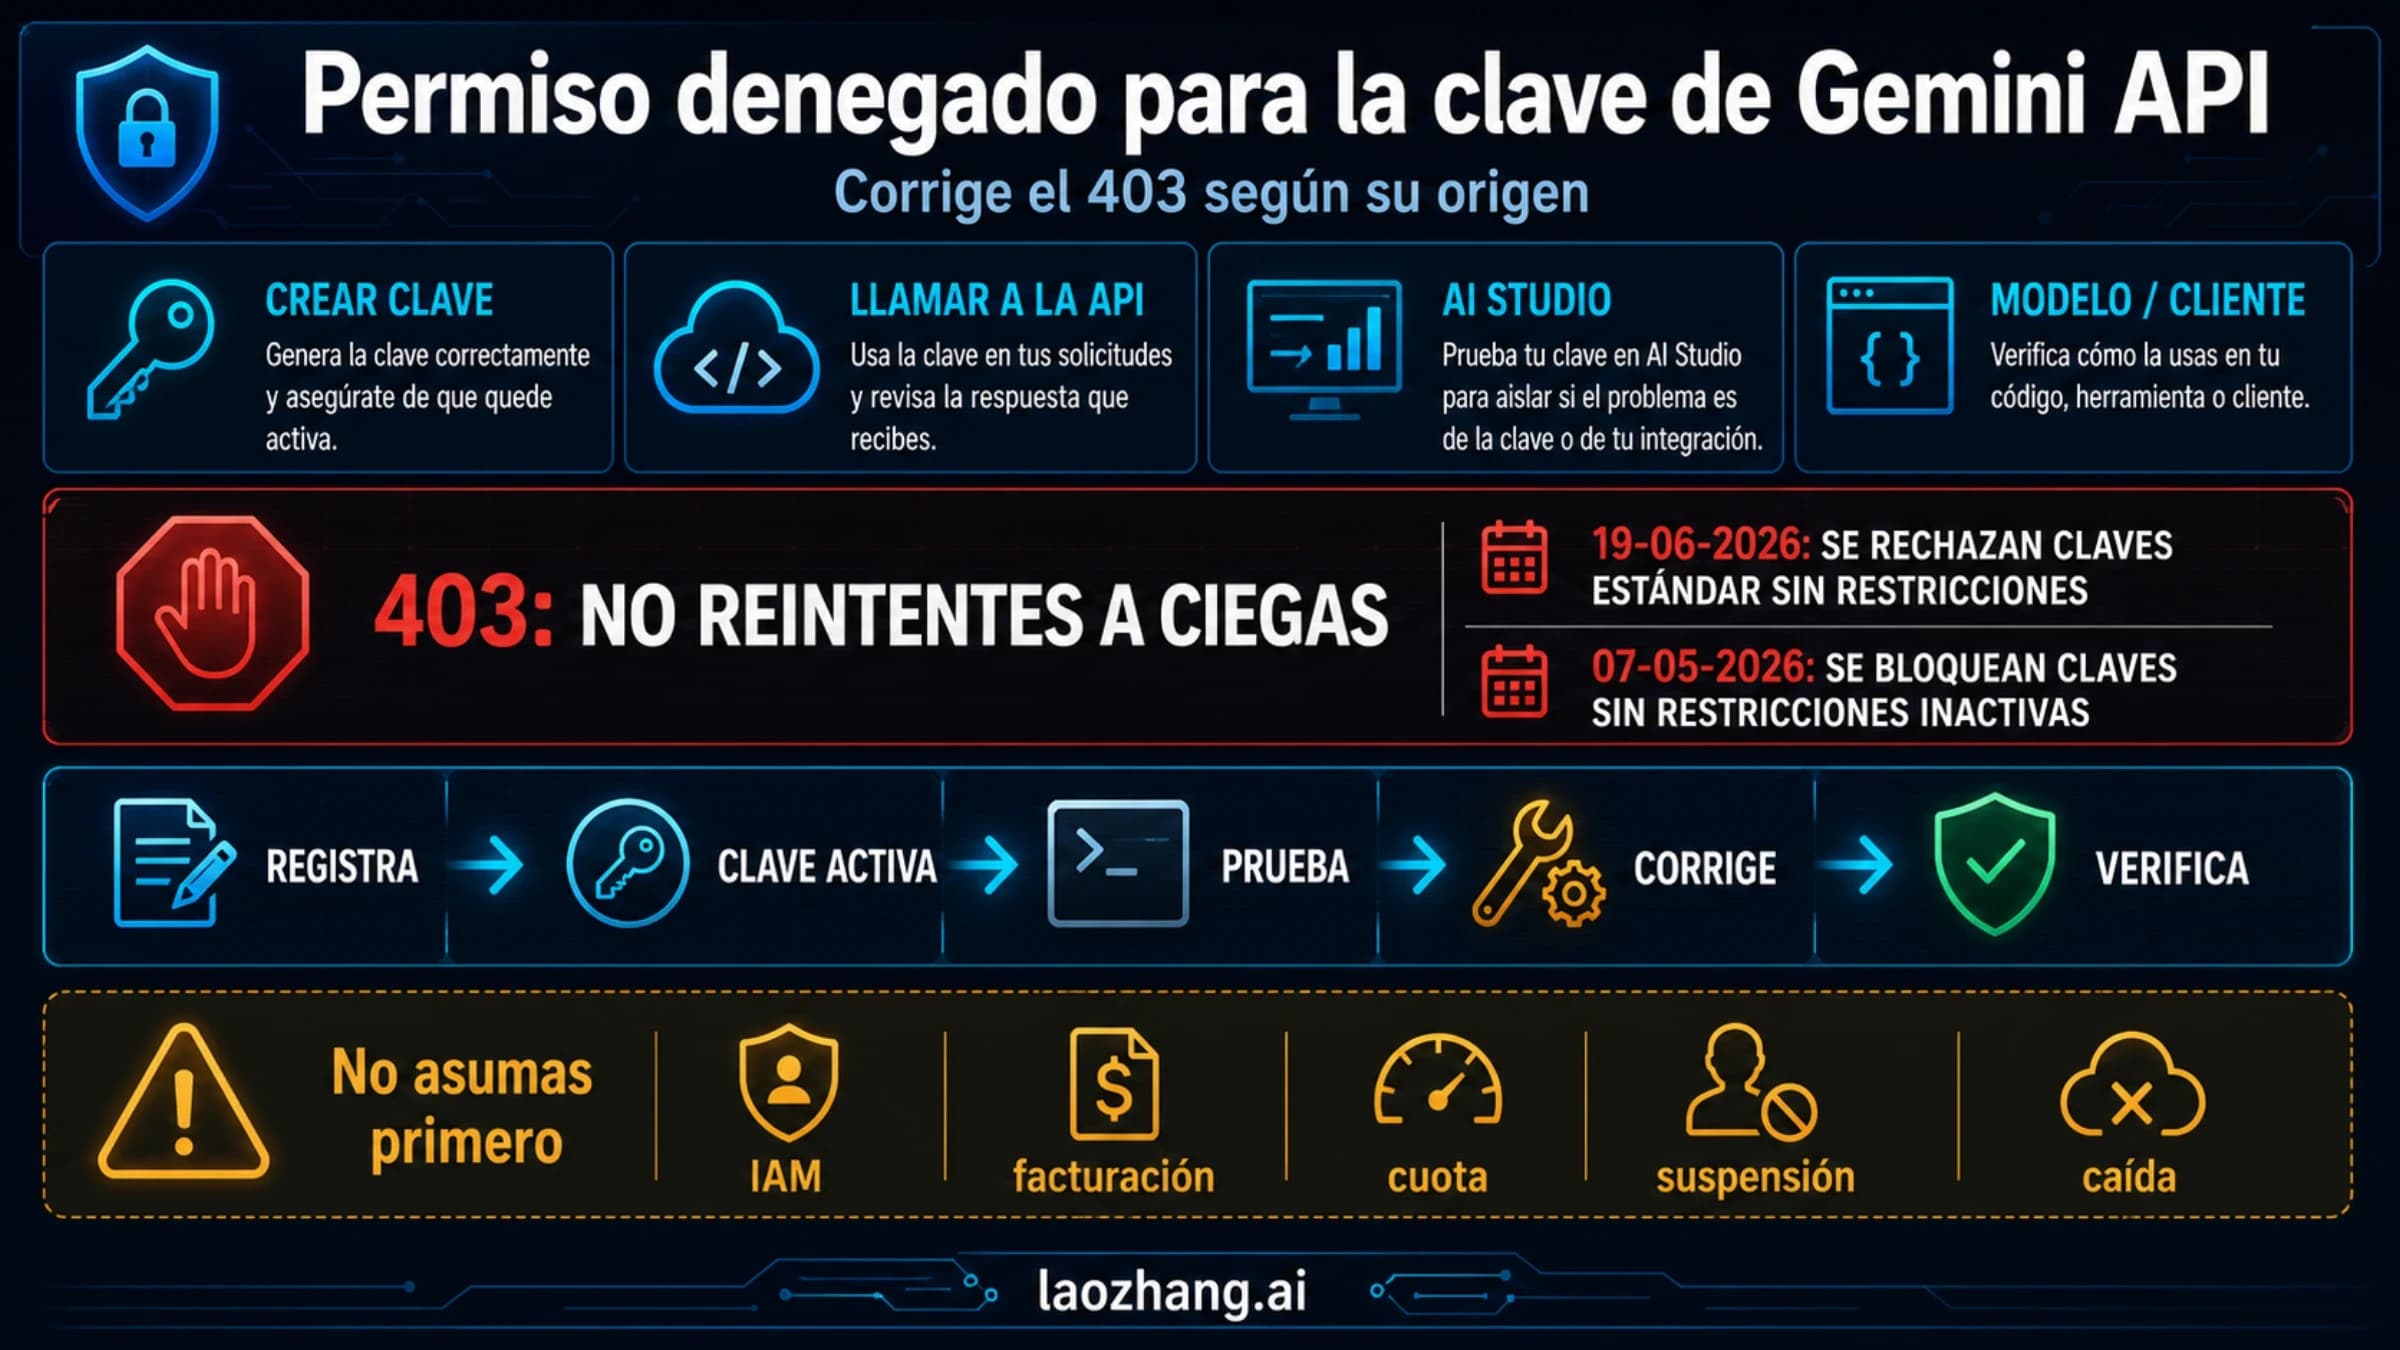
Según la guía de solución de problemas, solo se reintentan los errores transitorios (429, 408 y 5xx), nunca 400, 402 o 403, y siempre con espera exponencial (por ejemplo 1, 2, 4 y 8 segundos), algo de aleatoriedad y un número máximo de intentos.
Batch y Priority: límites propios aparte del tráfico interactivo
Batch API. Las peticiones por lotes tienen sus propios límites, separados de las llamadas normales: hasta 100 lotes simultáneos, archivos de entrada de hasta 2 GB, 20 GB de almacenamiento de archivos y un máximo de tokens en cola por modelo, sumando todos tus lotes activos. A 5 de octubre de 2026, la página de límites lista para los modelos de imagen:
| Modelo (nombre tal como aparece en la página) | Tier 1 | Tier 2 | Tier 3 |
|---|---|---|---|
| Gemini 3.1 Flash Image Preview | 1.000.000 | 250.000.000 | 750.000.000 |
| Gemini 3.1 Flash Lite Image | 2.000.000 | 270.000.000 | 1.000.000.000 |
| Gemini 3 Pro Image Preview | 2.000.000 | 270.000.000 | 1.000.000.000 |
La página aún usa los nombres con «Preview», aunque los identificadores gemini-3-pro-image-preview y gemini-3.1-flash-image-preview se retiraron el 25 de junio de 2026; hoy se llaman gemini-3-pro-image y gemini-3.1-flash-image. Los tokens en cola incluyen los de entrada, así que convertirlos en número de imágenes solo da una aproximación. Batch cobra la mitad por imagen y es la forma más directa de procesar grandes volúmenes sin tocar el RPM interactivo; el coste detallado está en Nano Banana Pro Batch API: precio, fórmula y punto de equilibrio.
Priority. La inferencia prioritaria tiene límites propios, por defecto 0,3 veces el límite estándar de cada modelo y nivel, y además cuenta para los límites del tráfico interactivo. No es una forma de conseguir más capacidad, sino de dar preferencia a una parte de tus peticiones dentro de la que ya tienes.
Cómo conseguir más capacidad en la API de Gemini
Ninguna de estas vías pasa por crear más claves en el mismo proyecto, que no añaden cuota.
- Aprovecha mejor lo que tienes. Reparte las peticiones en el tiempo con una cola, limita la concurrencia, cachea respuestas repetidas y recorta contexto: bajar los tokens de entrada alivia el TPM y el tope de gasto.
- Pasa a Batch lo que puede esperar. Evaluaciones, enriquecimiento de datos o generación masiva de imágenes van a un carril con límites propios y a mitad de precio.
- Sube de nivel. La subida llega sola al cumplir el gasto acumulado y los días desde el primer pago; compruébala en la página de proyectos de AI Studio.
- Pide un aumento. En la página de límites, el enlace «Request paid tier rate limit increase» abre el formulario oficial de aumento de cuota y de tope de facturación. Es solo para el nivel de pago, y Google indica que no garantiza el aumento, aunque revisará la solicitud. El mismo formulario sirve para pedir más tope mensual.
- Reintenta solo lo transitorio. Los reintentos con espera exponencial recuperan los 429 de un pico breve, pero no crean RPD ni saldo.
Reintentos con google-genai: generate_content no reintenta solo
La guía de solución de problemas de Google afirma que el SDK de Python reintenta automáticamente los errores transitorios hasta cuatro veces. En una prueba con google-genai 2.28.0 contra un servidor local que respondía 429 RESOURCE_EXHAUSTED, un genai.Client() sin opciones envió una sola petición con client.models.generate_content y lanzó la excepción al momento. Con HttpRetryOptions envió 5 peticiones (4 reintentos, unos 17 segundos en total, con esperas que crecen desde 1 segundo y un máximo de 60). En cambio, client.interactions.create sí reintentó con el cliente por defecto: 4 peticiones antes de lanzar RateLimitError. Los SDK de JavaScript, Go y Java no se probaron.
Si usas generate_content, activa los reintentos de forma explícita:
from google import genai
from google.genai import types

client = genai.Client(
    http_options=types.HttpOptions(
        retry_options=types.HttpRetryOptions()  # por defecto, 5 intentos en total
    )
)

response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="Resume este texto en tres frases: ...",
)
print(response.text)
HttpRetryOptions acepta attempts, initial_delay, max_delay, exp_base, jitter y http_status_codes. Entre los códigos que reintenta por defecto están 408, 429, 500, 502, 503 y 504. Ten en cuenta que reintenta cualquier 429: ante un quota_exceeded diario o un tope mensual, los reintentos solo retrasan el error. Si trabajas con varios procesos a la vez, pon un límite de concurrencia por delante para que no reintenten todos en el mismo segundo.
Nivel gratuito de la API de Gemini: mismos límites por proyecto
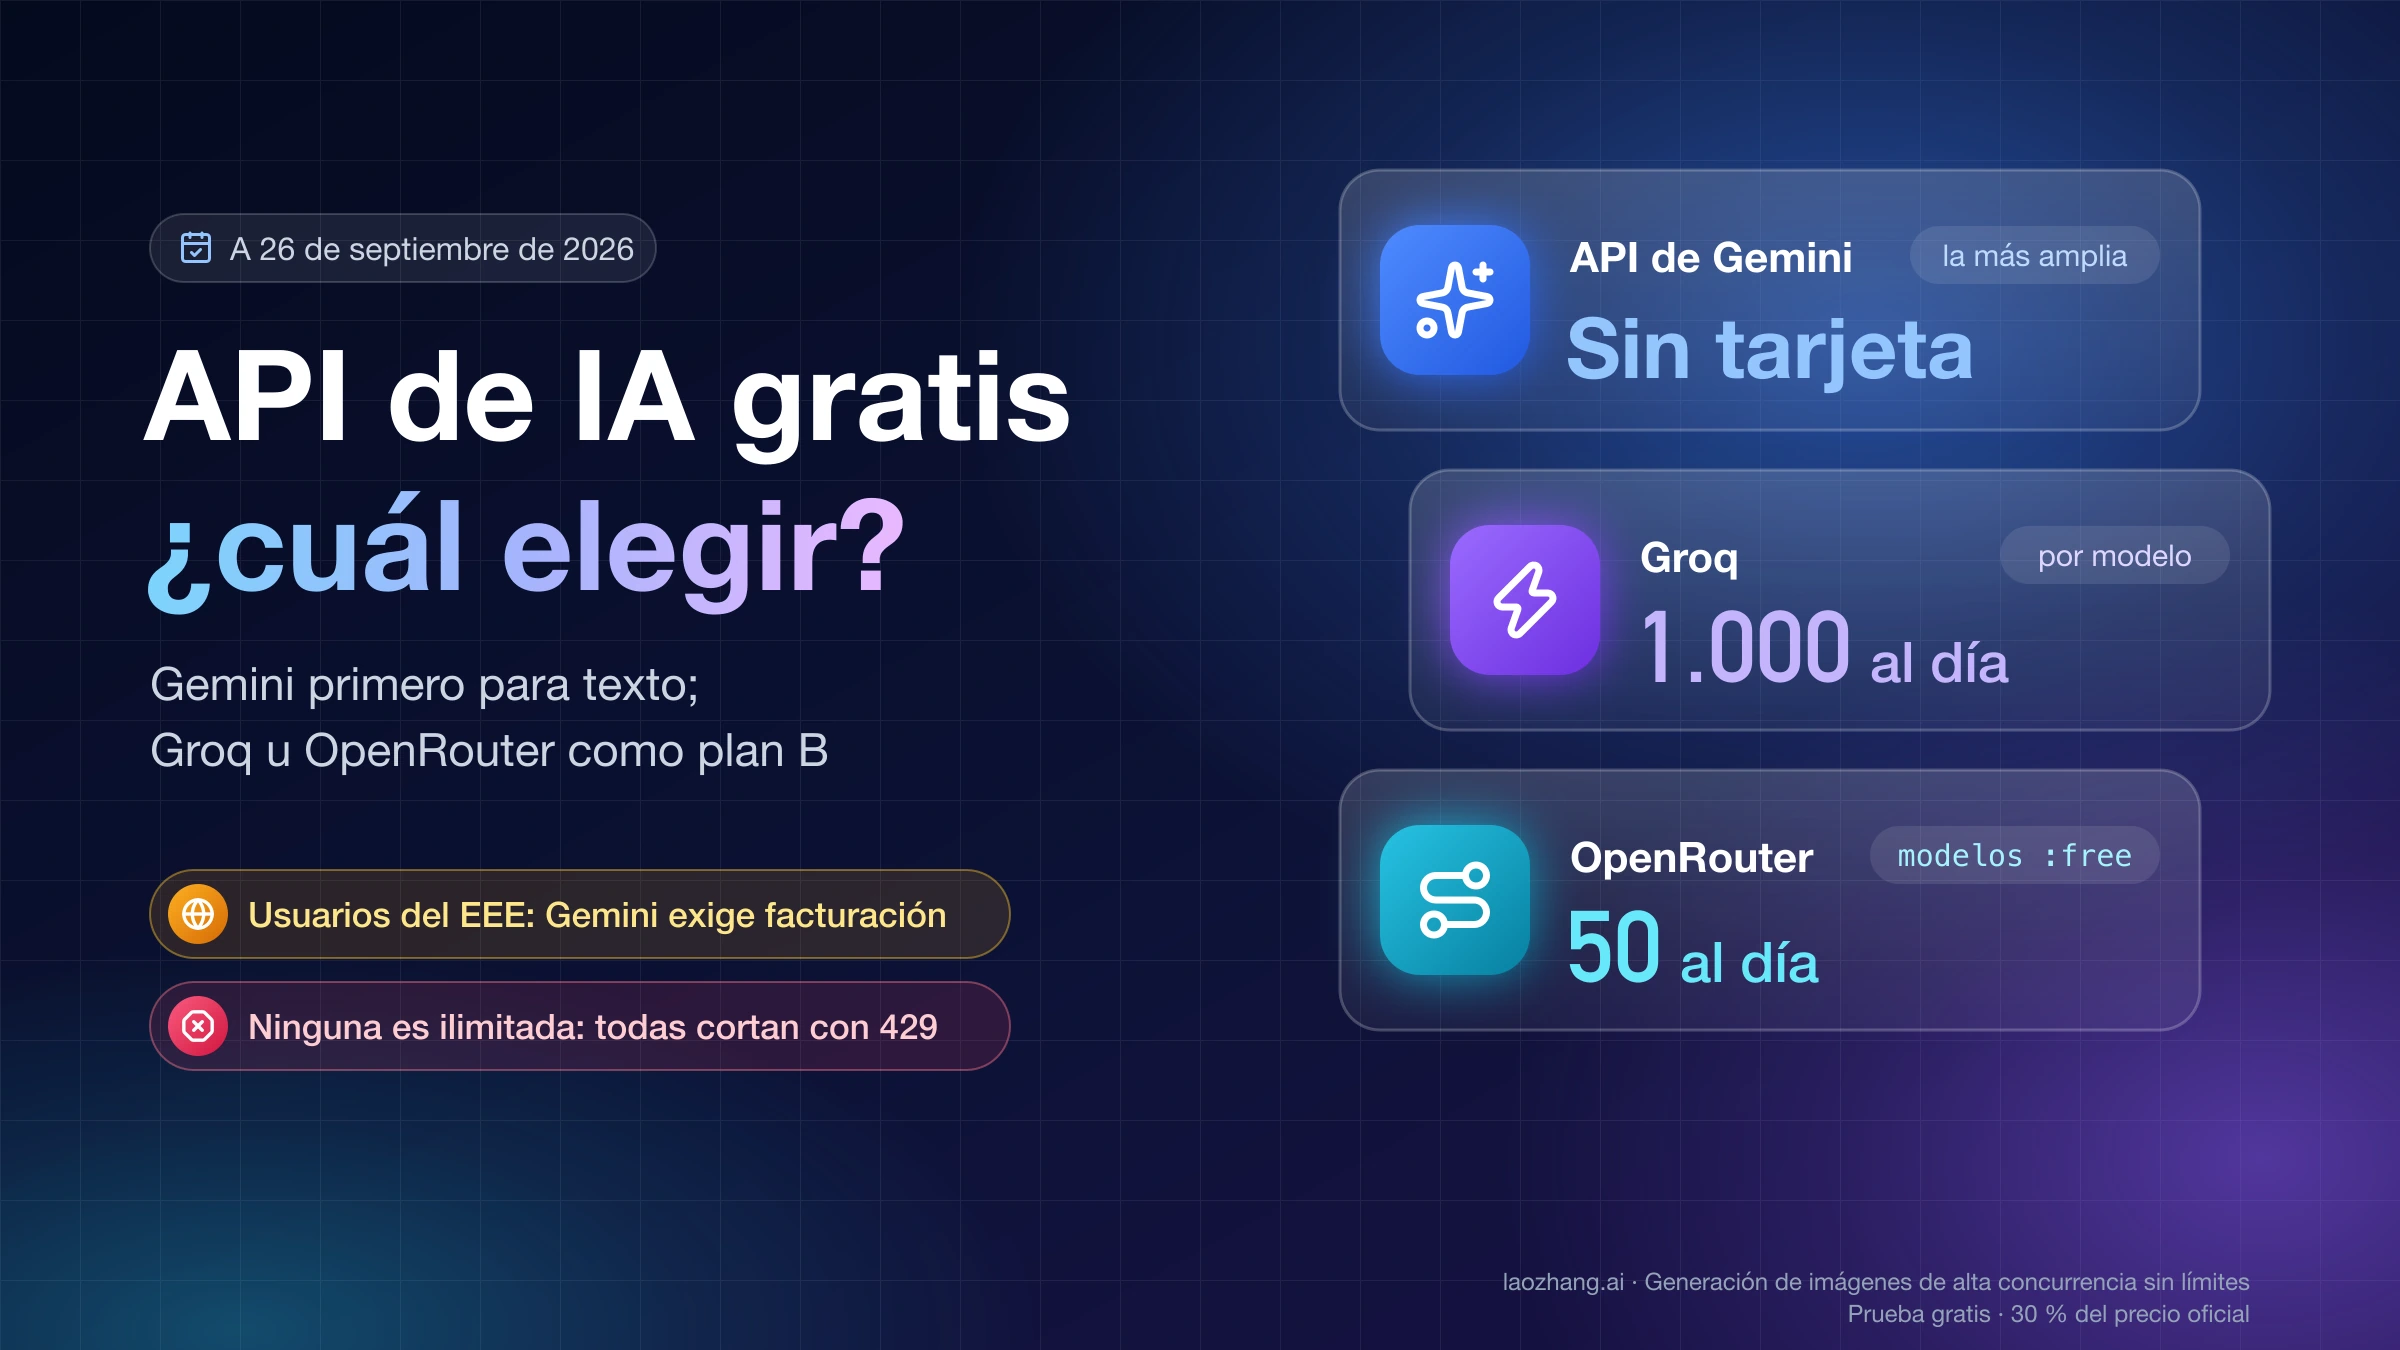
En el nivel gratuito rigen las mismas reglas (límites por proyecto, RPD que se reinicia a medianoche del Pacífico, cifras visibles solo en AI Studio), con valores más bajos y solo para algunos modelos. No hay topes de gasto porque no hay gasto. La salida de imagen no tiene nivel gratuito en ningún modelo de imagen actual: una petición de imagen desde un proyecto gratuito falla por cuota. Qué modelos siguen siendo gratis y con qué límites se detalla en límites del nivel gratuito de la API de Gemini, y la creación de la clave en clave API de Google AI Studio: crear, proteger y probar la primera llamada.
Firebase AI Logic, Vertex AI y la app Gemini tienen límites distintos
Un 429 no siempre viene de la Developer API. Antes de tocar nada, comprueba por qué producto pasó la llamada.
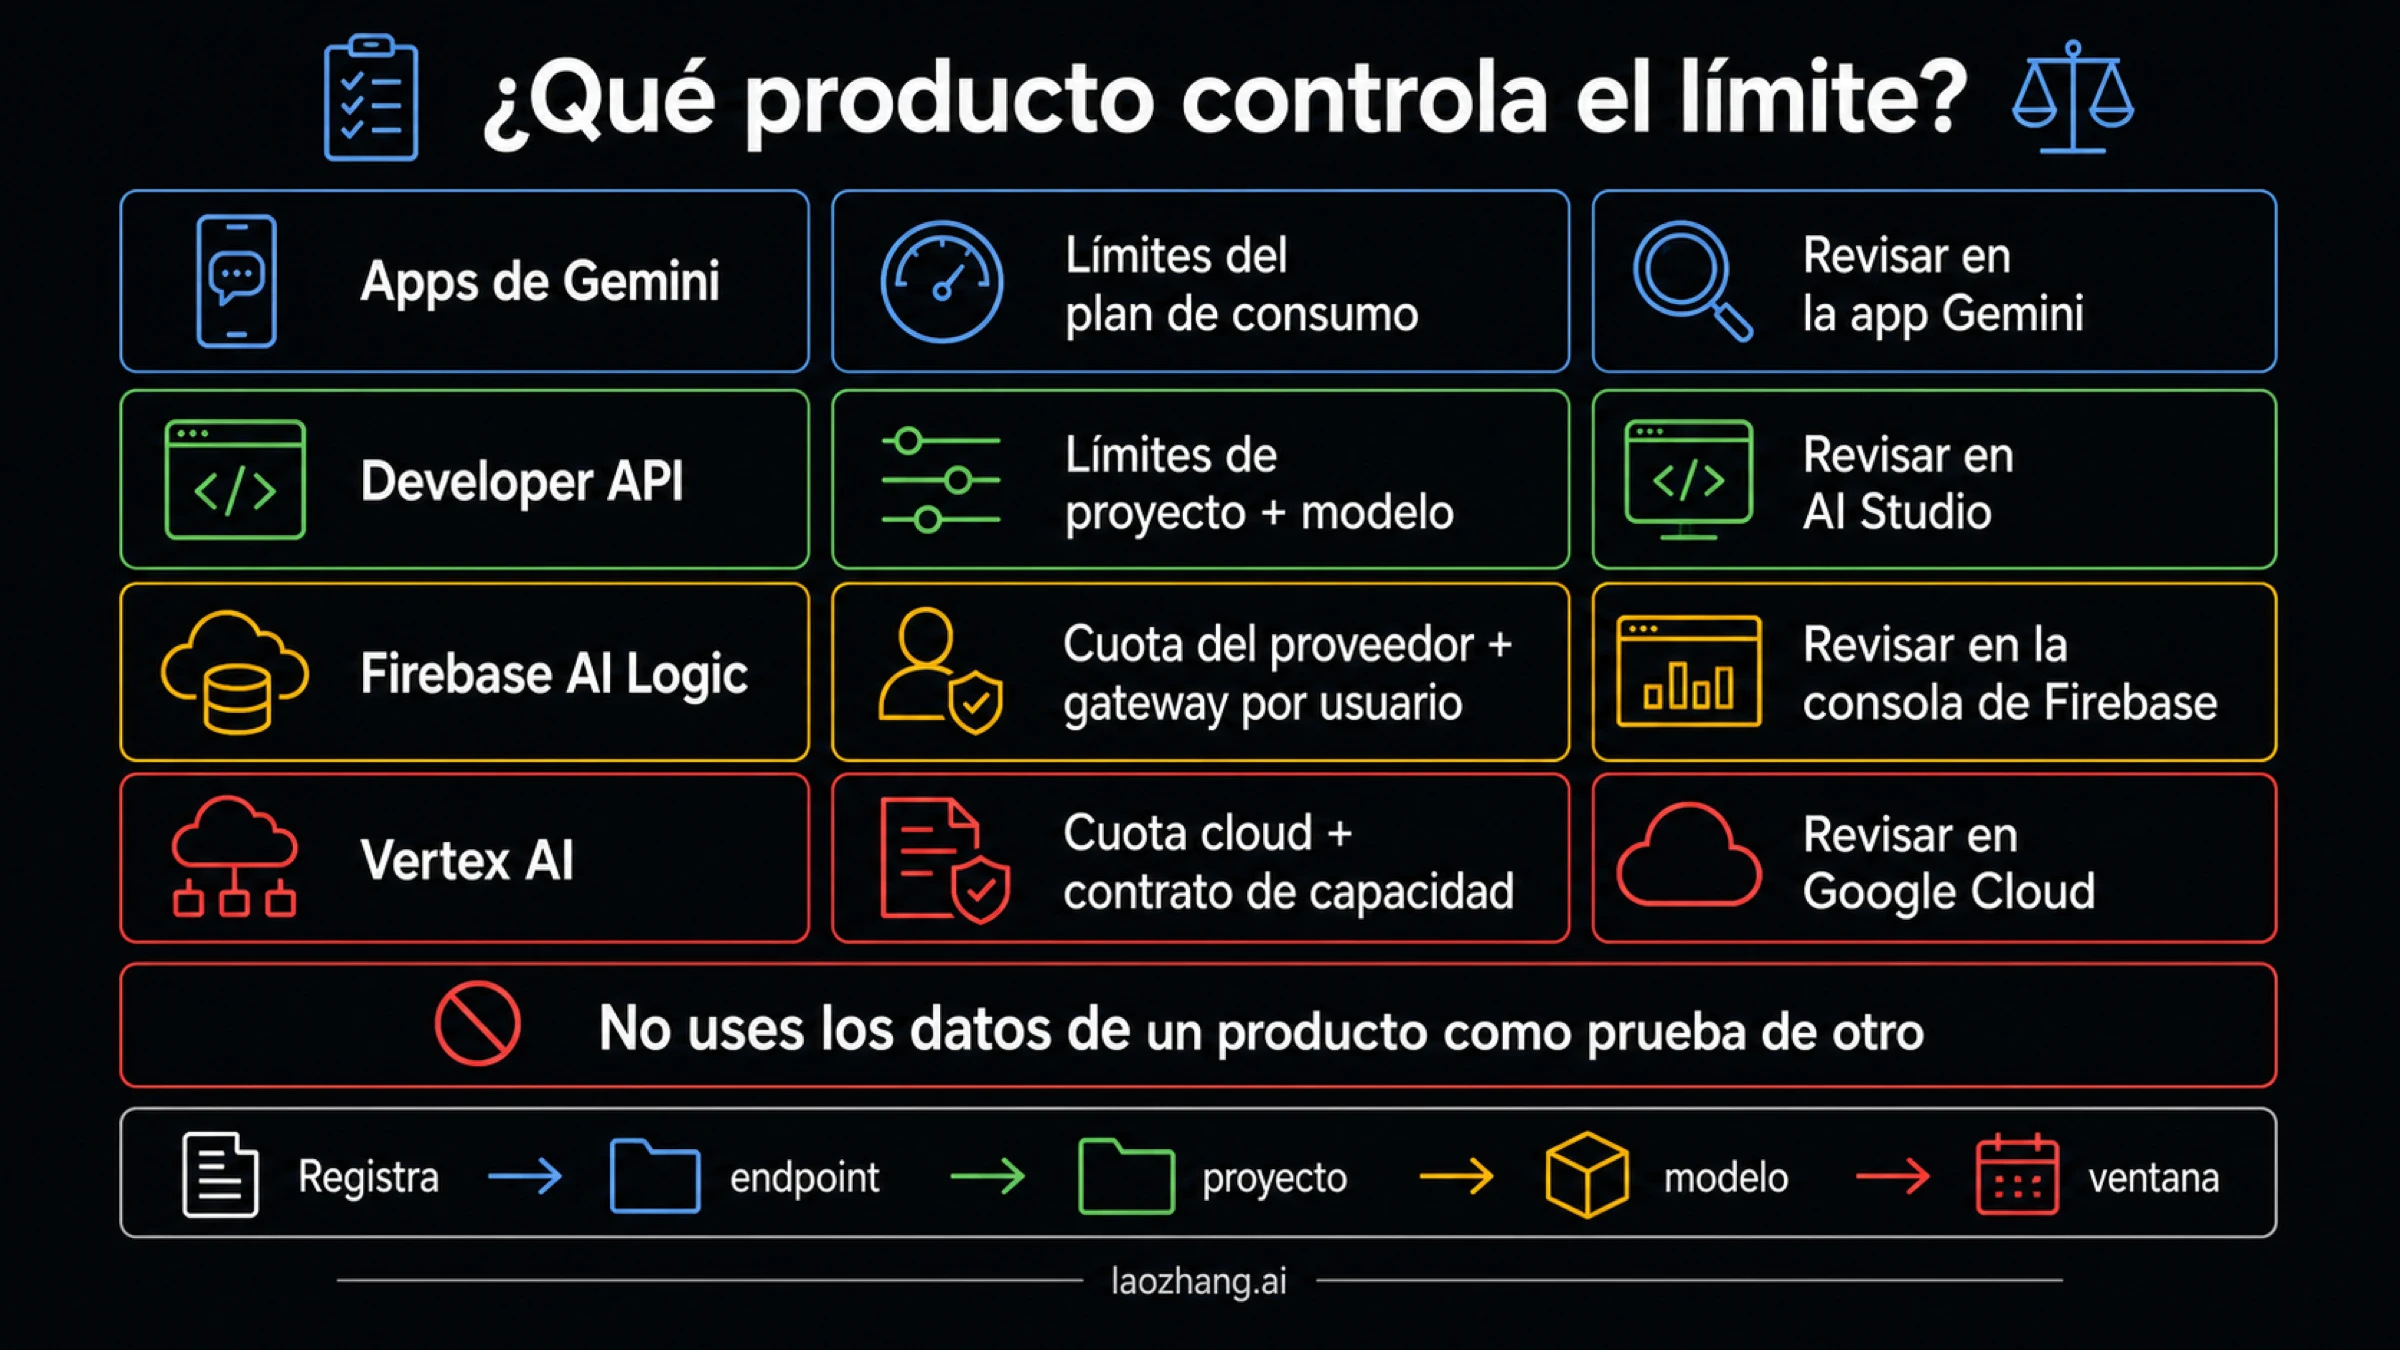
Firebase AI Logic. Si llamas a Gemini desde una app con los SDK de Firebase, tienes dos capas. Los límites del proveedor (la Developer API o Vertex AI) se siguen aplicando y mandan sobre todo lo demás. Encima, la API de Firebase AI Logic actúa como pasarela y su cuota sirve como límite por usuario: por defecto, 100 RPM por usuario, ajustable con permisos de propietario o editor del proyecto. Firebase recomienda bajarlo a lo que necesita un usuario real, para que ninguno agote el límite que comparten todos. Según las cuotas de Firebase AI Logic, desde el 2 de noviembre de 2026 será obligatorio usar Firebase App Check con Firebase AI Logic.
Vertex AI. Usa cuotas de Google Cloud por proyecto y región, no los límites de AI Studio. Su página sobre el error 429 distingue entre pago por uso y Provisioned Throughput, recomienda el endpoint global y espera exponencial truncada, y avisa de límites ante subidas bruscas de tráfico. Para decidir entre las dos plataformas, consulta Gemini API o Vertex AI: cómo elegir, comparar costes y migrar.
App Gemini. La app de consumo tiene límites por plan que se renuevan cada 5 horas hasta un límite semanal, y no tienen relación con la cuota de tu proyecto de API. Están en la ayuda de Gemini sobre límites.
Preguntas frecuentes sobre los límites de la API de Gemini
¿Cuántos límites de uso tiene la API de Gemini?
Tres de frecuencia en casi todos los modelos (RPM, TPM de entrada y RPD), más IPM en los modelos de imagen y TPD en algunos. Encima van los límites de dinero: el tope de gasto de 10 minutos y el tope mensual de la cuenta de facturación. Para Batch hay límites aparte. Los valores por modelo solo aparecen en la página de límites de AI Studio.
¿Varias claves de API aumentan el límite de la API de Gemini?
No. Los límites se aplican por proyecto, y todas las claves de un proyecto comparten RPM, TPM y RPD. Las claves tampoco tienen facturación propia: heredan el nivel del proyecto y su gasto se suma al tope del proyecto y al de la cuenta de facturación.
¿A qué hora se reinicia el límite diario de la API de Gemini en España?
A las 9:00 en la península y a las 8:00 en Canarias, que corresponde a la medianoche del Pacífico. En las semanas de desfase entre el cambio de hora europeo y el estadounidense (finales de marzo y finales de octubre) se adelanta una hora. Solo se reinicia el RPD; los topes mensuales se reinician el día 1.
¿Es gratuita la API de Gemini?
Hay un nivel gratuito con límites bajos para algunos modelos, pero no incluye generación de imágenes. Para el nivel de pago necesitas vincular una cuenta de facturación y, en el plan de prepago, comprar al menos 5 $ de créditos. Usar AI Studio en el navegador sigue siendo gratis mientras no vincules una clave de pago.
¿Cuánto cobra la API de Gemini?
Cobra por tokens de entrada, de salida y de caché, con precios distintos por modelo, publicados en la página de precios. Lo que limita cuánto puedes gastar es tu nivel: como máximo 250 $ al mes en Tier 1 y 2.000 $ en Tier 2, salvo que pidas un aumento.
¿Cuánto tarda en aplicarse el cambio de nivel en la API de Gemini?
El paso de gratuito a Tier 1 suele ser inmediato tras configurar la facturación; los siguientes, unos 10 minutos después de cumplir los requisitos. Si tras ese plazo la página de proyectos de AI Studio sigue mostrando el nivel anterior, envía el formulario oficial de aumento de cuota y de tope de facturación.
Fuentes12
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 5 oct 2026.
Fuentes12
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 5 oct 2026.
- 1.página de límites de AI Studioaistudio.google.com/rate-limit
- 2.límites de frecuenciaai.google.dev/gemini-api/docs/rate-limits
- 3.facturaciónai.google.dev/gemini-api/docs/billing
- 4.página de proyectos de AI Studioaistudio.google.com/projects
- 5.ai.studioai.studio/billing
- 6.página de errores de la APIai.google.dev/gemini-api/docs/api-errors
- 7.guía de solución de problemasai.google.dev/gemini-api/docs/troubleshooting
- 8.formulario oficial de aumento de cuota y de tope de facturaciónforms.gle/ETzX94k8jf7iSotH9
- 9.cuotas de Firebase AI Logicfirebase.google.com/docs/ai-logic/quotas
- 10.página sobre el error 429docs.cloud.google.com/gemini-enterprise-agent-platform/models/deploy/error-code-429
- 11.ayuda de Gemini sobre límitessupport.google.com/gemini/answer/16275805
- 12.página de preciosai.google.dev/gemini-api/docs/pricing