Guía de GLM-5.3-Flash: Ox Alpha, precio de la API y ejecución local
Empieza por la API oficial salvo que tus GPU puedan alojar unos 305,8 GiB de pesos FP8 más la memoria del proceso y la caché. Los 18B activos no son el requisito de VRAM.
En esta página
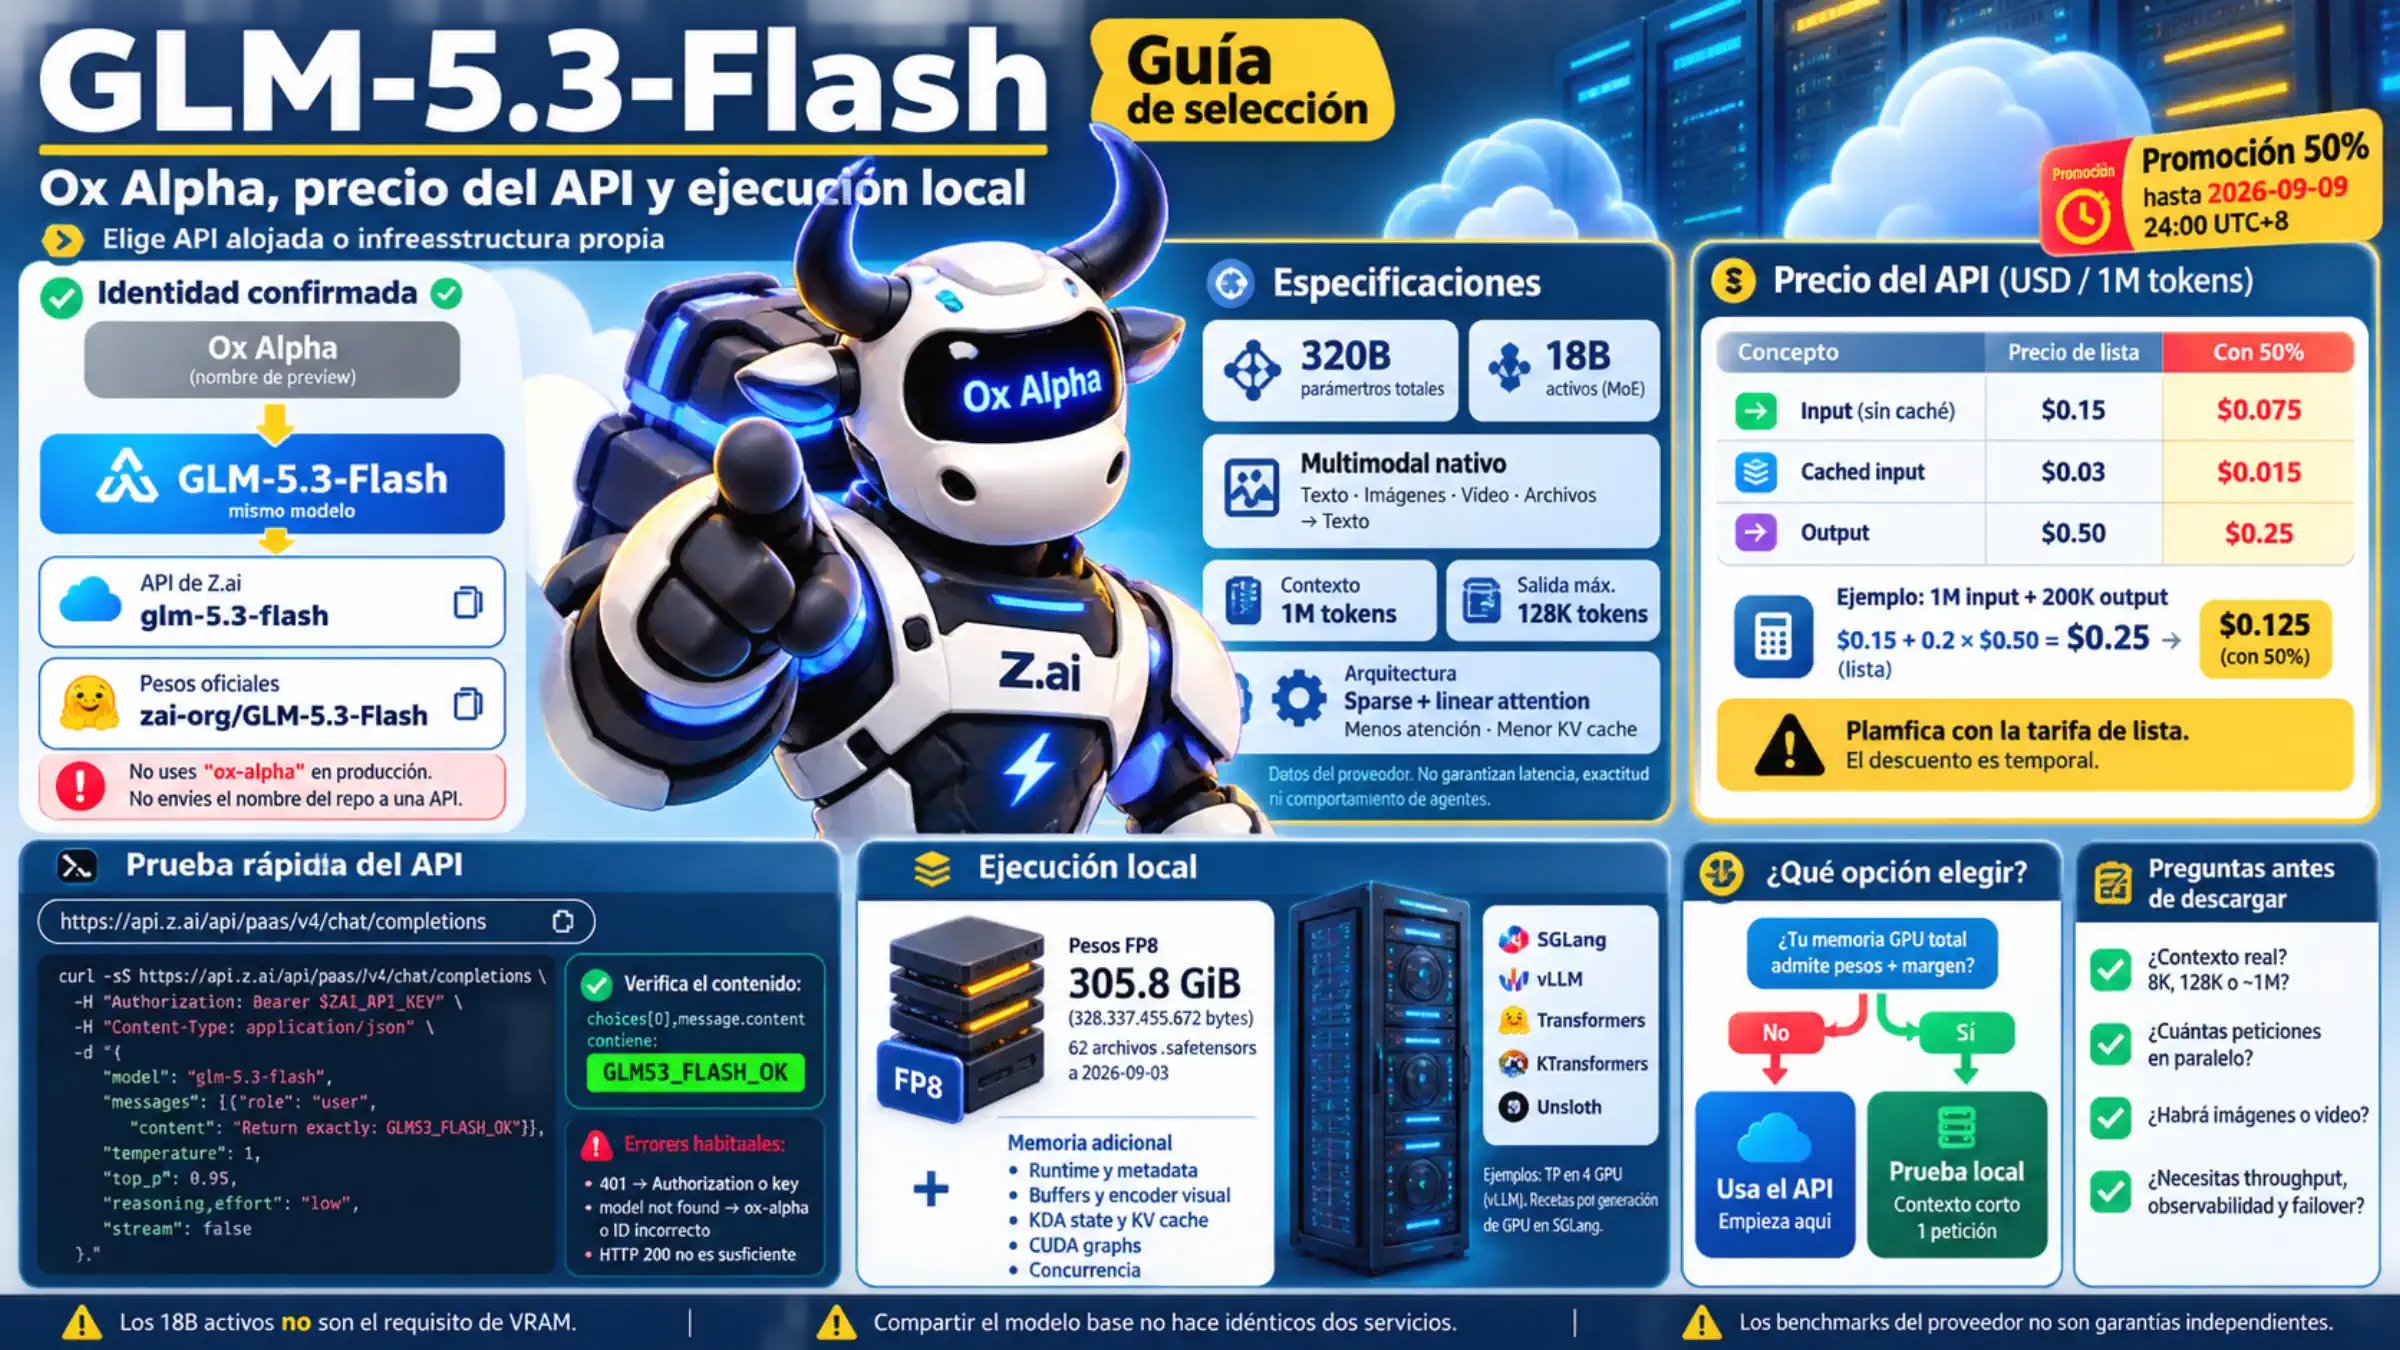
Ox Alpha ya no es un modelo misterioso ni un identificador que convenga guardar en producción. Z.ai confirmó que el modelo probado con ese nombre en OpenCode y OpenRouter era GLM-5.3-Flash. En la API oficial se usa glm-5.3-flash; para los pesos abiertos, el repositorio es zai-org/GLM-5.3-Flash.
Para una persona o un equipo pequeño, la mejor primera comprobación suele ser la API alojada. Solo los archivos de pesos FP8 ocupan unos 305,8 GiB. La cifra de 18B parámetros activos describe qué parte del modelo MoE participa en el cálculo de cada token, no un modelo de 18B que quepa en una GPU doméstica.
El nombre de la versión preliminar no es el ID de producción
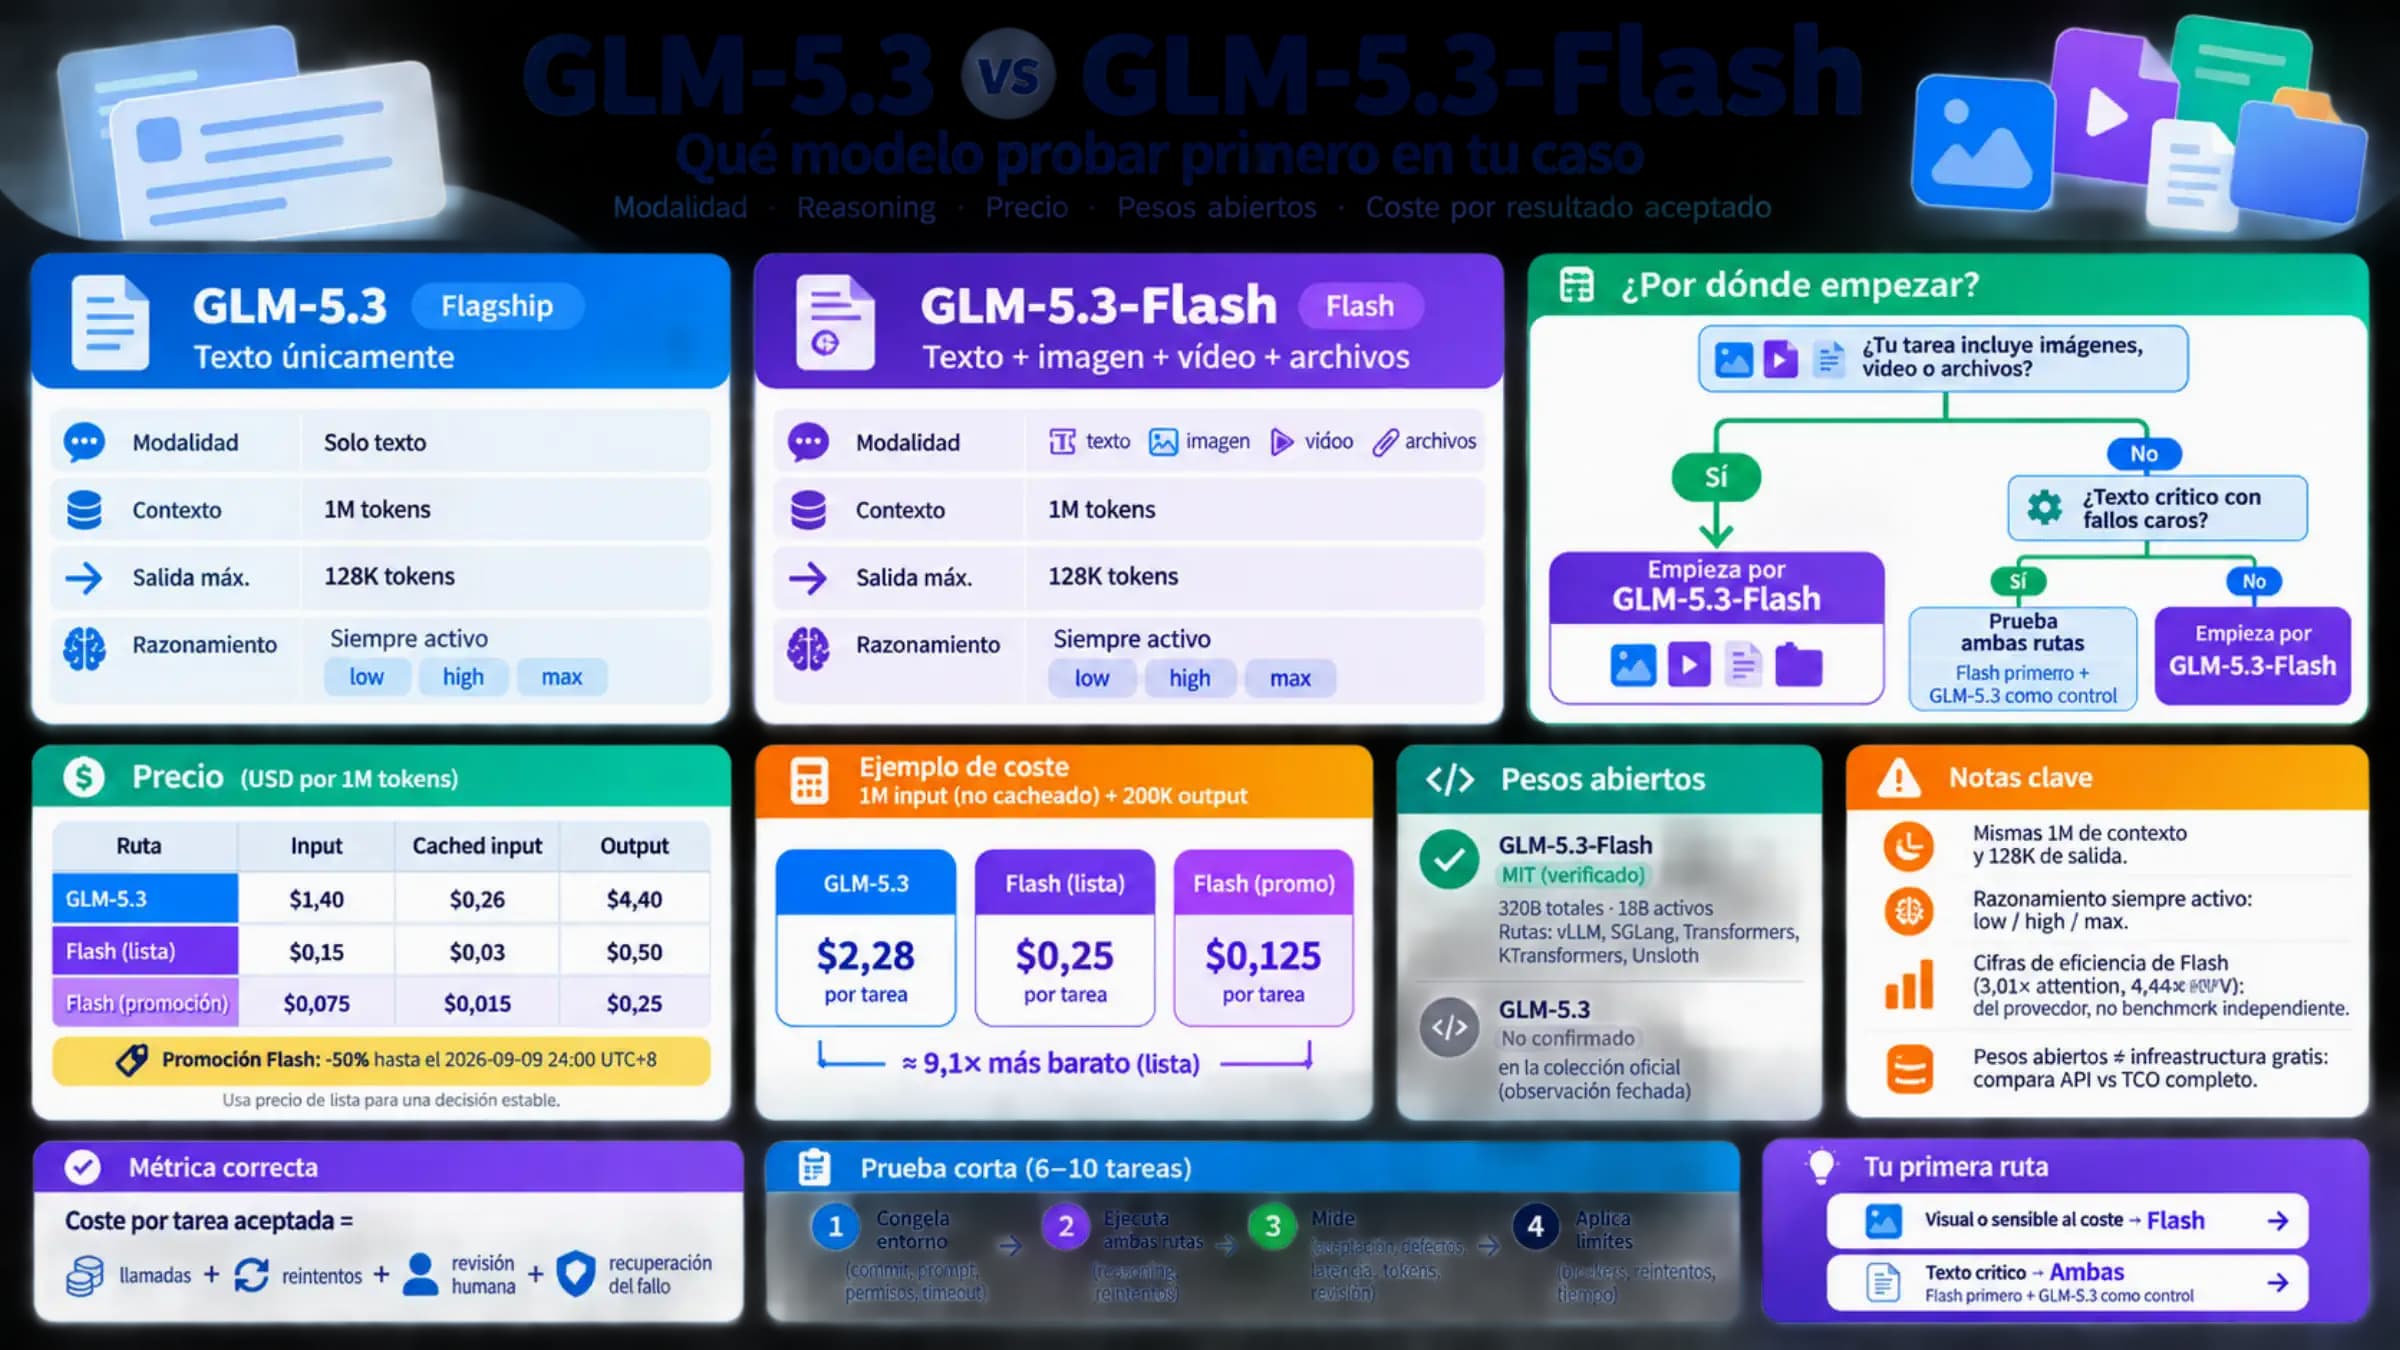
La documentación oficial de GLM-5.3-Flash presenta un MoE con 320B parámetros totales y 18B activos. Es el primer modelo multimodal nativo de la familia GLM-5: acepta texto, imágenes, vídeo y archivos, y produce texto. El contexto documentado es de 1M tokens y el máximo de salida, 128K tokens.
Z.ai también informa de una arquitectura híbrida de atención dispersa y lineal, con menos cálculo de atención y una caché KV menor que GLM-5.3. Es una explicación y una medición del proveedor; no garantiza la latencia, la exactitud ni el comportamiento de agentes en tu sistema.
Cada acceso necesita su propio identificador:
| Dónde se ejecuta | Identificador inicial | Error habitual |
|---|---|---|
| API de Z.ai | glm-5.3-flash | conservar ox-alpha |
| Pesos oficiales | zai-org/GLM-5.3-Flash | enviar el nombre del repositorio a cualquier API |
| Proveedor externo | su ID vigente | heredar precio y límites de Z.ai |
Una pasarela puede cambiar parámetros, límite de contexto y tratamiento de errores. Compartir el modelo base no hace idénticos dos servicios.
El presupuesto debe sobrevivir al fin de la promoción
A 3 de septiembre de 2026, la tarifa oficial de Z.ai muestra precios en USD por 1M tokens:
| Concepto | Precio de lista | Promoción del 50 % anunciada hasta el 9 de septiembre |
|---|---|---|
| Entrada sin caché | $0,15 | $0,075 |
| Entrada en caché | $0,03 | $0,015 |
| Salida | $0,50 | $0,25 |
La promoción estaba anunciada hasta el 9 de septiembre de 2026 a las 24:00 UTC+8. Una decisión a largo plazo debe usar la tarifa de lista; el descuento sirve para conciliar el consumo del periodo promocional.
Un conjunto hipotético de solicitudes que sume 1M tokens de entrada sin caché y 200K de salida cuesta $0,25 antes de reintentos y herramientas:
$0,15 + 0,2 × $0,50 = $0,25
Durante el descuento serían $0,125. Para producción importa más el coste por tarea aceptada: todas las llamadas, reintentos, revisión humana y recuperación de fallos. Tres intentos y una corrección manual reducen rápidamente la ventaja aparente del token barato.
Una primera llamada debe validar el contenido
Una aplicación general usa el endpoint https://api.z.ai/api/paas/v4 que aparece en la introducción a la API. Coding Plan utiliza https://api.z.ai/api/coding/paas/v4, pero está reservado para herramientas de programación compatibles; no es una cuota para cualquier web, bot, SDK o SaaS.
Esta petición comprueba la clave, el endpoint y el ID del modelo:
curl -sS https://api.z.ai/api/paas/v4/chat/completions \
  -H "Authorization: Bearer $ZAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {"role": "user", "content": "Return exactly: GLM53_FLASH_OK"}
    ],
    "temperature": 1,
    "top_p": 0.95,
    "reasoning_effort": "low",
    "stream": false
  }'
No basta con HTTP 200. Verifica que exista choices[0].message.content y contenga la marca pedida. Un 401 apunta primero a la cabecera Authorization o a una clave de otra plataforma. Ante “model not found”, busca ox-alpha, el nombre del repositorio de Hugging Face o un alias que solo acepte otro proveedor.
reasoning_effort admite low, high y max. Según la documentación oficial, si se omite o recibe otro valor, vuelve a max. Fija el mismo nivel al medir coste y latencia para no atribuir al modelo una diferencia causada por el parámetro.
Para imágenes, messages[].content[] incluye un bloque type: image_url y la URL o Data URL Base64 en image_url.url. Aceptar contenido multimodal no significa generar imágenes o vídeo: la salida documentada es texto.
El cálculo local empieza en 305,8 GiB
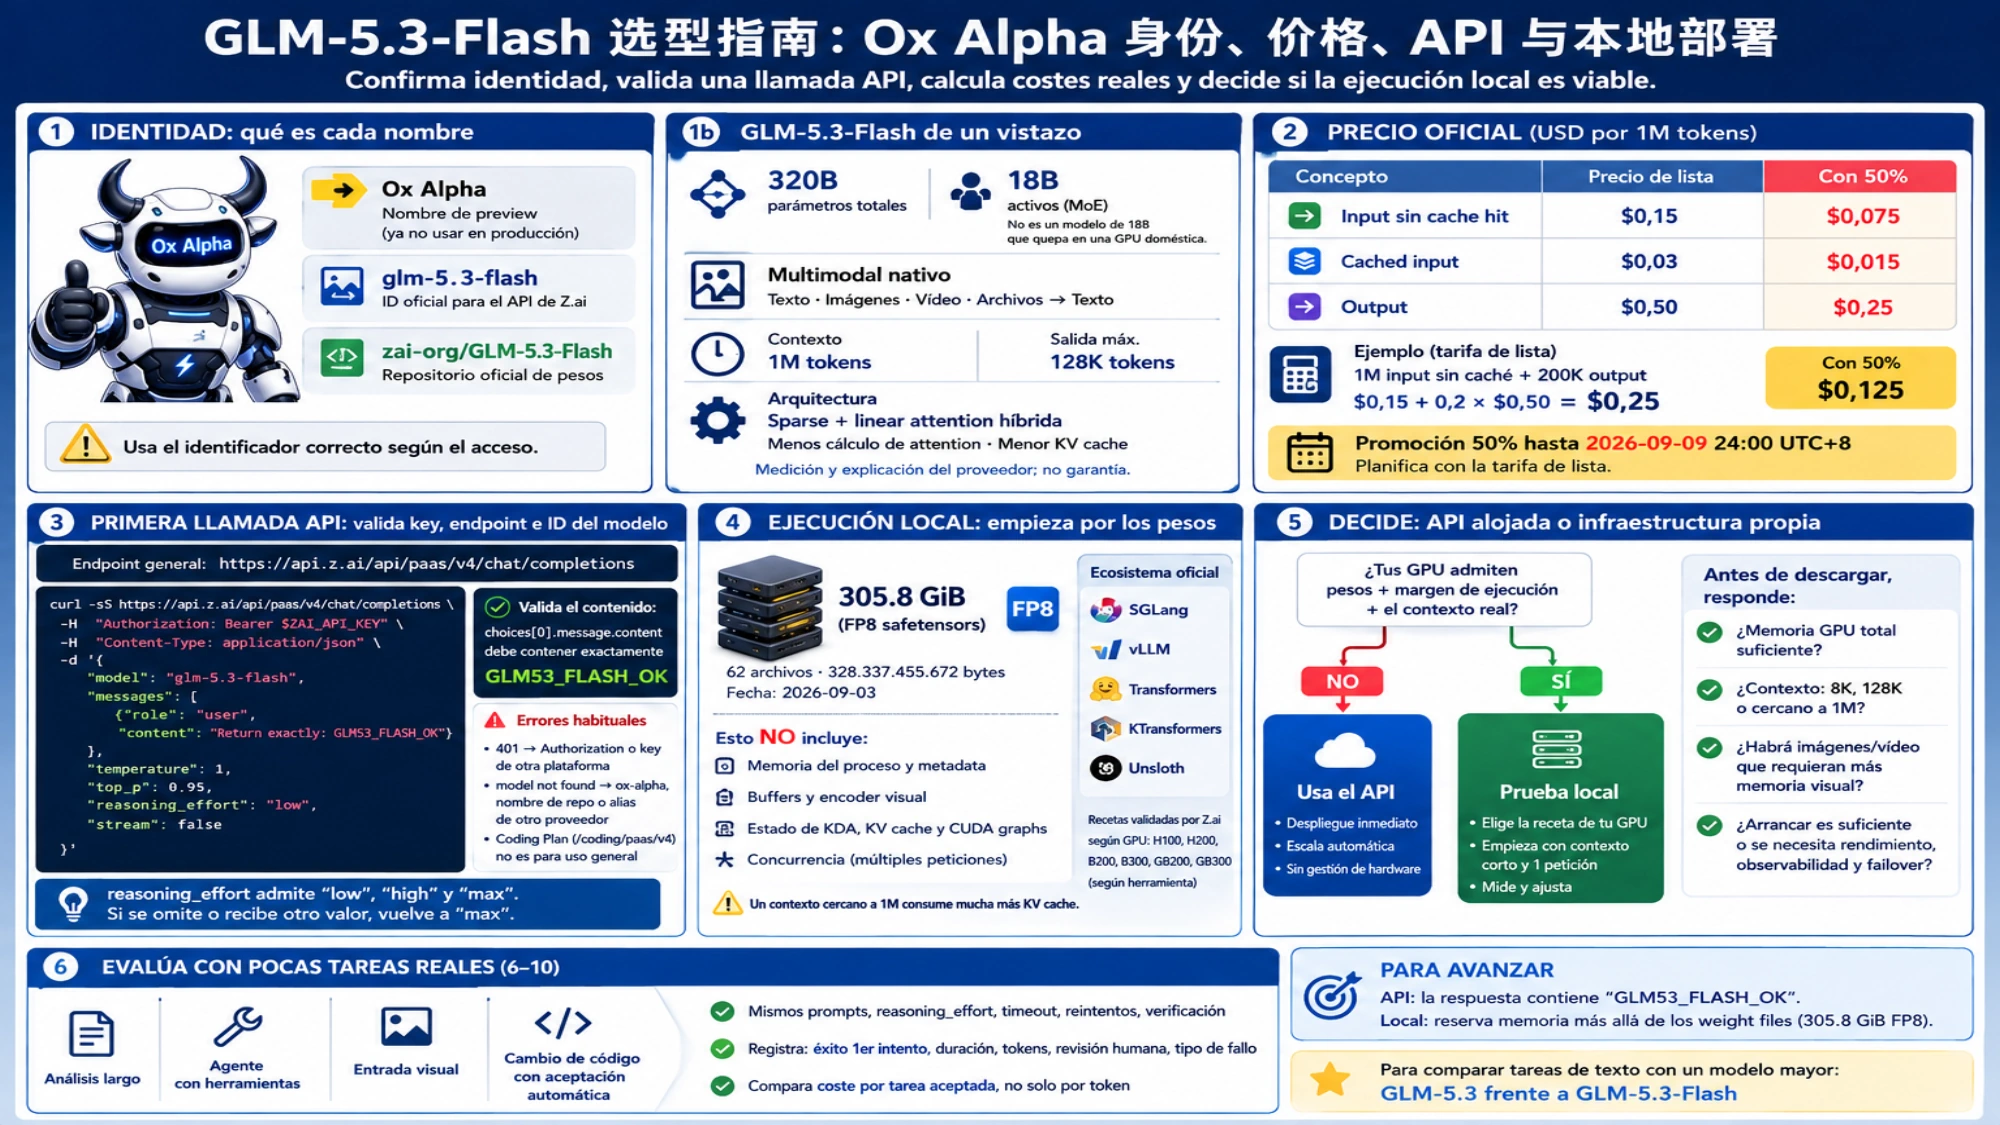
La ficha oficial en Hugging Face marca licencia MIT y enlaza soporte para SGLang, vLLM, Transformers, KTransformers y Unsloth. El 3 de septiembre, la API del repositorio enumeraba 62 archivos FP8 .safetensors con 328.337.455.672 bytes en total, unos 305,8 GiB.
Ese dato solo responde si caben los pesos. Un servidor necesita memoria adicional para metadatos, búferes, codificador visual, estado KDA, caché KV, grafos CUDA y solicitudes simultáneas. Un contexto cercano a 1M consume mucha más caché que una prueba corta. Descargar parte a RAM o disco puede permitir el arranque y, a la vez, producir una latencia inicial o un rendimiento inútiles.
La receta actual de vLLM también parte de unos 306 GiB FP8 antes de añadir la memoria de ejecución y la caché KV; su primer ejemplo usa paralelismo tensorial en cuatro GPU de gama alta. La receta de SGLang ofrece configuraciones para H100, H200, B200, B300, GB200 y GB300, con estado de validación para cada combinación.
Antes de descargar, responde:
- ¿La memoria GPU total admite pesos y margen de ejecución?
- ¿El contexto real será 8K, 128K o cercano a 1M, y cuántas peticiones coincidirán?
- ¿Habrá imágenes o vídeo que necesiten espacio visual adicional?
- ¿Basta con arrancar o hacen falta capacidad sostenida, monitorización, actualizaciones y recuperación ante fallos?
Si los pesos ya superan la capacidad, usa la API. Si caben, elige la receta de la generación exacta de GPU y comienza con contexto corto y una petición. No copies opciones de caché KV en FP8, paralelismo tensorial o decodificación especulativa desde otro acelerador. Un arranque correcto tampoco demuestra que la configuración soporte la carga de producción.
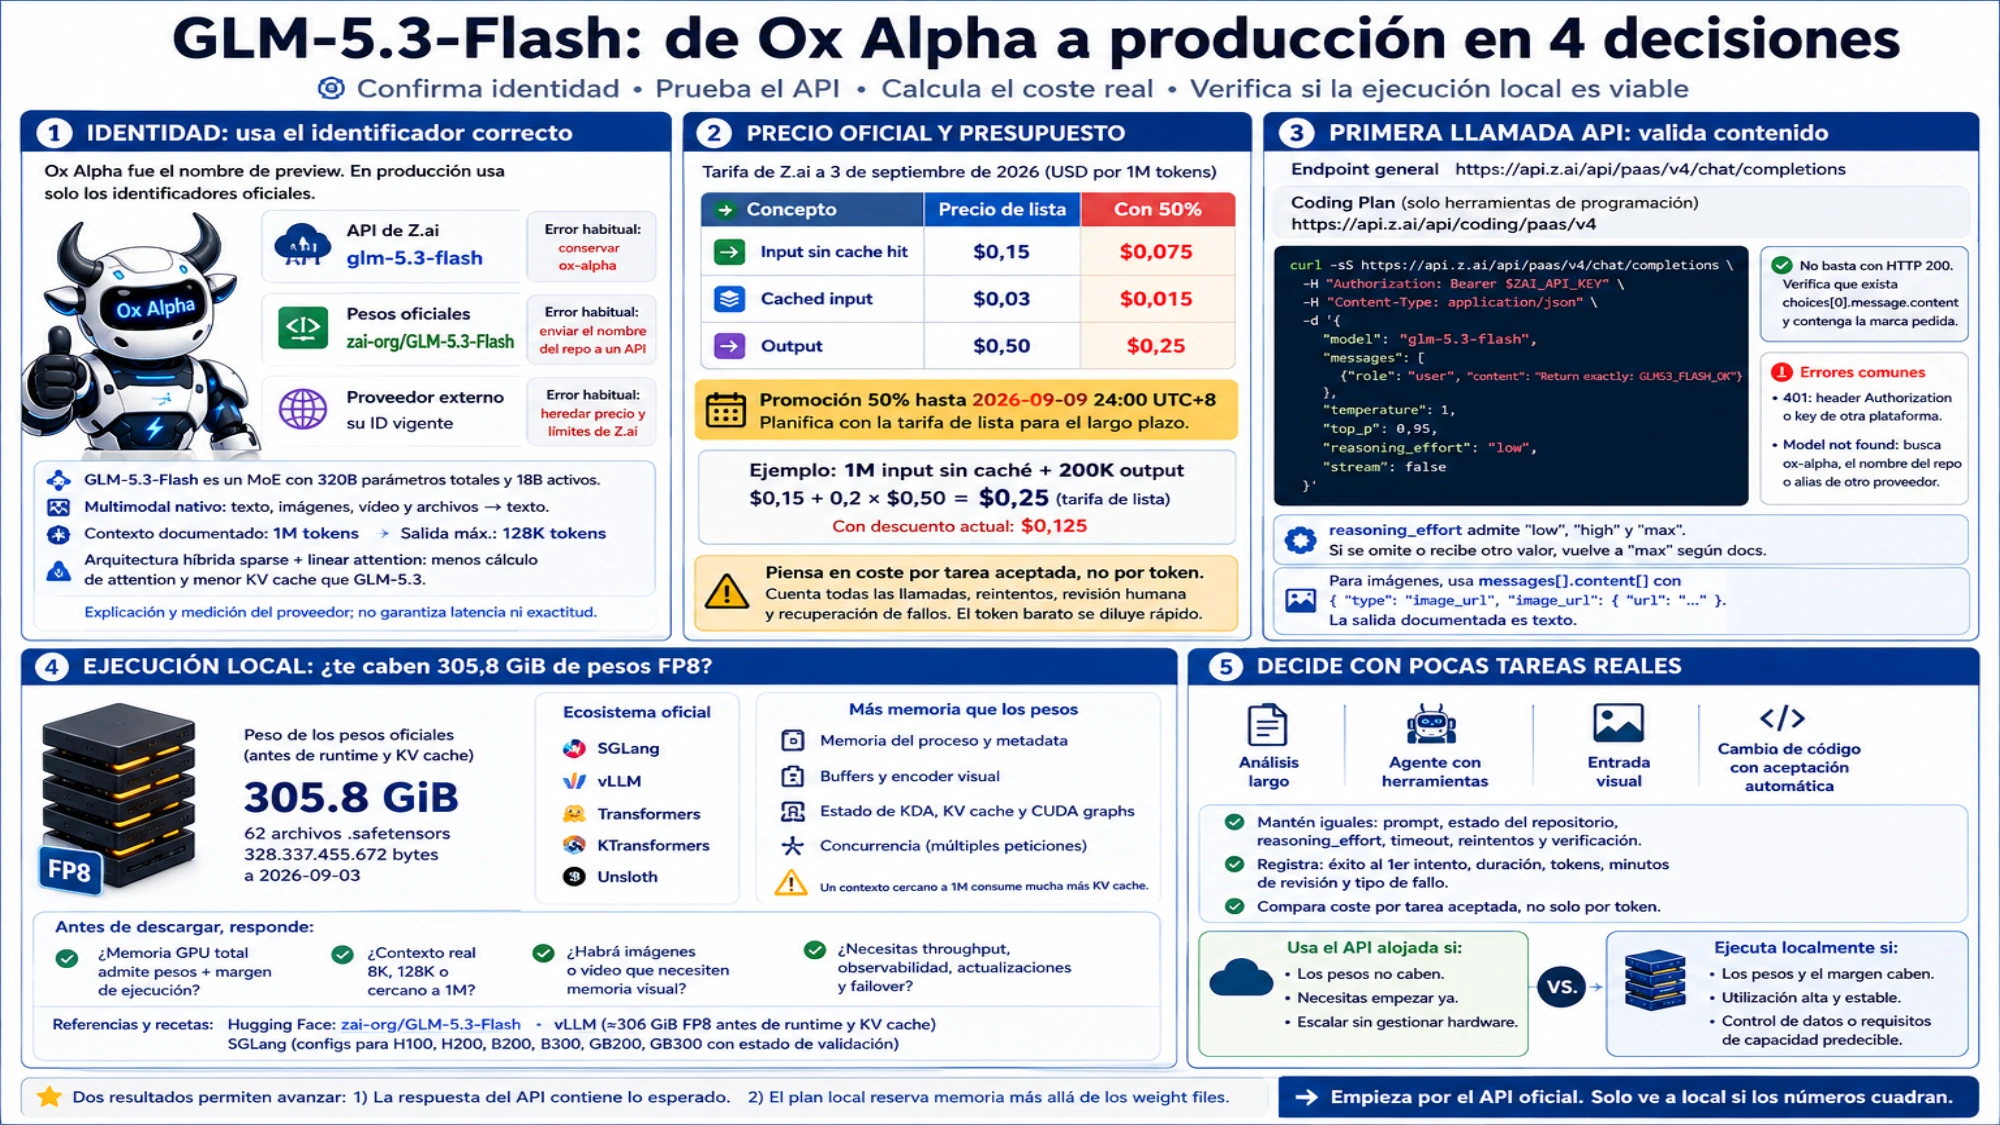
Decide con pocas tareas reales
Selecciona entre 6 y 10 tareas del trabajo real: un análisis largo, un agente con herramientas, una entrada visual y un cambio de código con aceptación automática. Mantén iguales las instrucciones, el estado del repositorio, reasoning_effort, tiempo máximo de espera, reintentos y comandos de verificación. Registra éxito al primer intento, duración, tokens, minutos de revisión y tipo de fallo.
La API alojada permite descubrir pronto si el modelo merece tráfico. La infraestructura propia cobra sentido cuando el control de datos, una utilización alta y estable o una capacidad previsible compensan hardware y mantenimiento. Las GPU inactivas también forman parte del coste.
Si aún necesitas comparar tareas de texto con un modelo mayor, consulta la comparativa de GLM-5.3 y GLM-5.3-Flash. Para adoptar Flash por API, comprueba que la respuesta contiene lo esperado y evalúa tareas representativas. Si vas a ejecutarlo en tu infraestructura, reserva además memoria suficiente para los pesos, la caché y el proceso.
Fuentes6
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 3 sept 2026.
Fuentes6
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 3 sept 2026.
- 1.documentación oficial de GLM-5.3-Flashdocs.z.ai/guides/vlm/glm-5.3-flash
- 2.tarifa oficial de Z.aidocs.z.ai/guides/overview/pricing
- 3.introducción a la APIdocs.z.ai/api-reference/introduction
- 4.ficha oficial en Hugging Facehuggingface.co/zai-org/GLM-5.3-Flash
- 5.receta actual de vLLMrecipes.vllm.ai/zai-org/GLM-5.3-Flash
- 6.receta de SGLangdocs.sglang.io/cookbook/autoregressive/GLM/GLM-5.3-Flash