GLM-5.3 o GLM-5.3-Flash: qué modelo probar primero
Prueba Flash primero para entradas visuales o trabajo sensible al coste. Conserva GLM-5.3 como referencia de calidad en ingeniería de texto con fallos caros.
En esta página
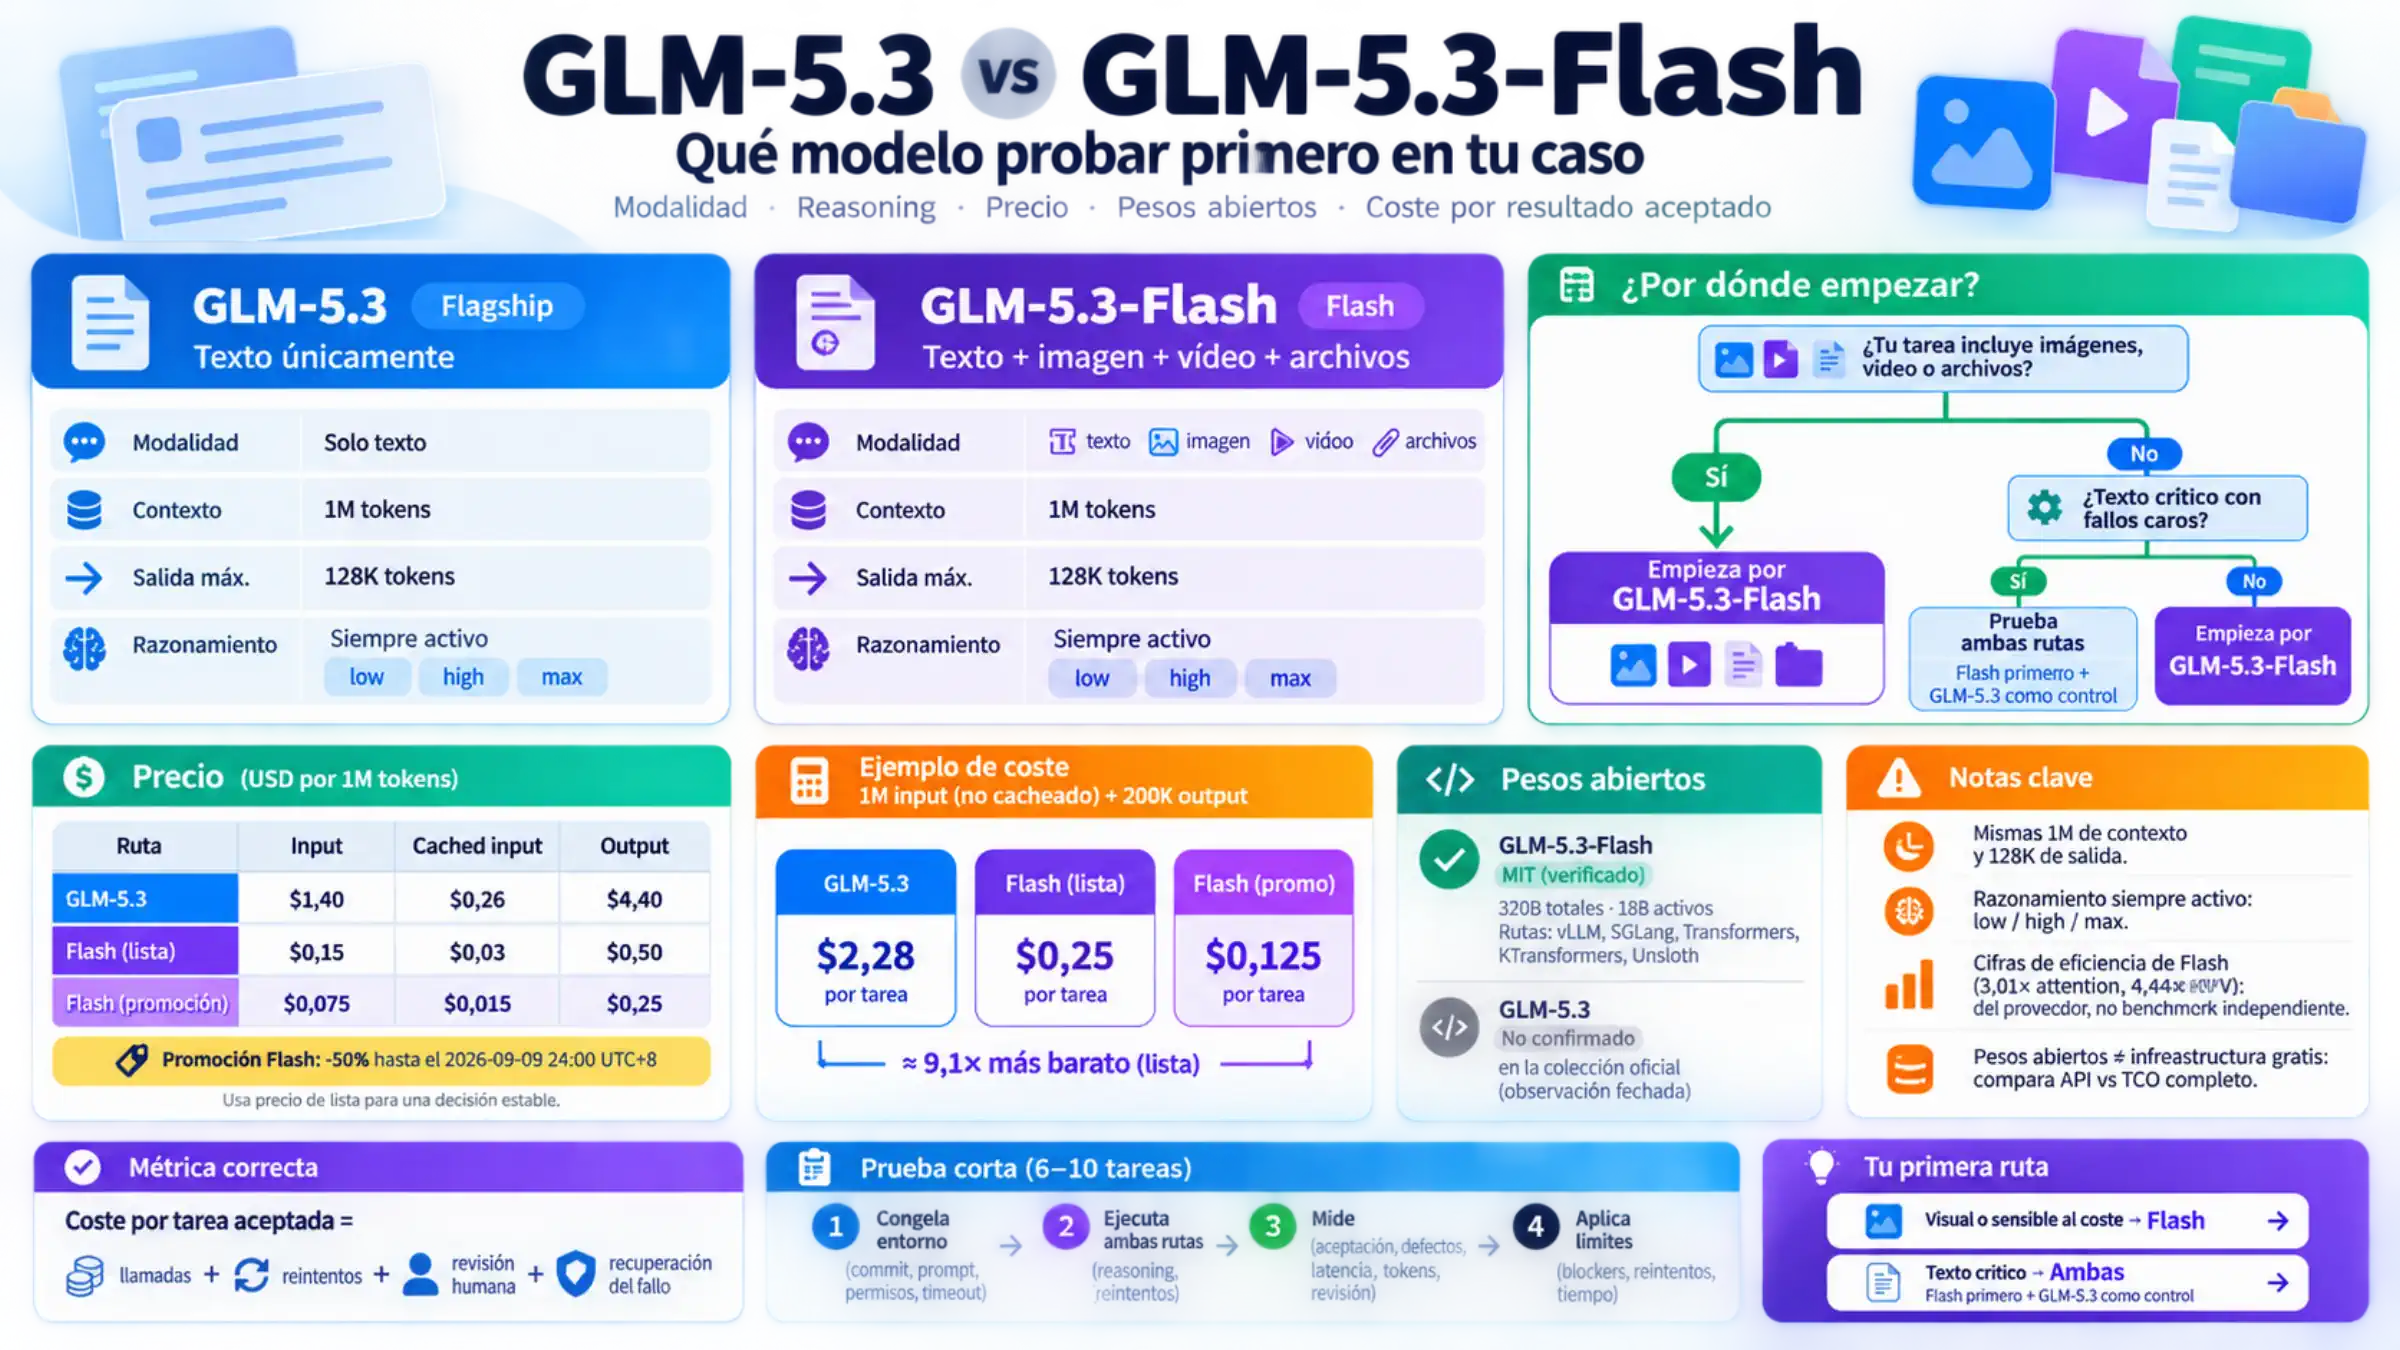
Si la tarea contiene imágenes, vídeo o archivos, empieza por glm-5.3-flash: según la documentación oficial consultada, glm-5.3 solo acepta texto. En ingeniería de texto compleja y de larga duración, prueba Flash como candidato económico y GLM-5.3 como referencia para comparar la calidad.
Ese orden no declara un ganador universal. Las especificaciones permiten descartar opciones incompatibles; las pruebas de aceptación de tu sistema deciden cuál merece tráfico real.
El tipo de entrada determina qué modelo puedes usar
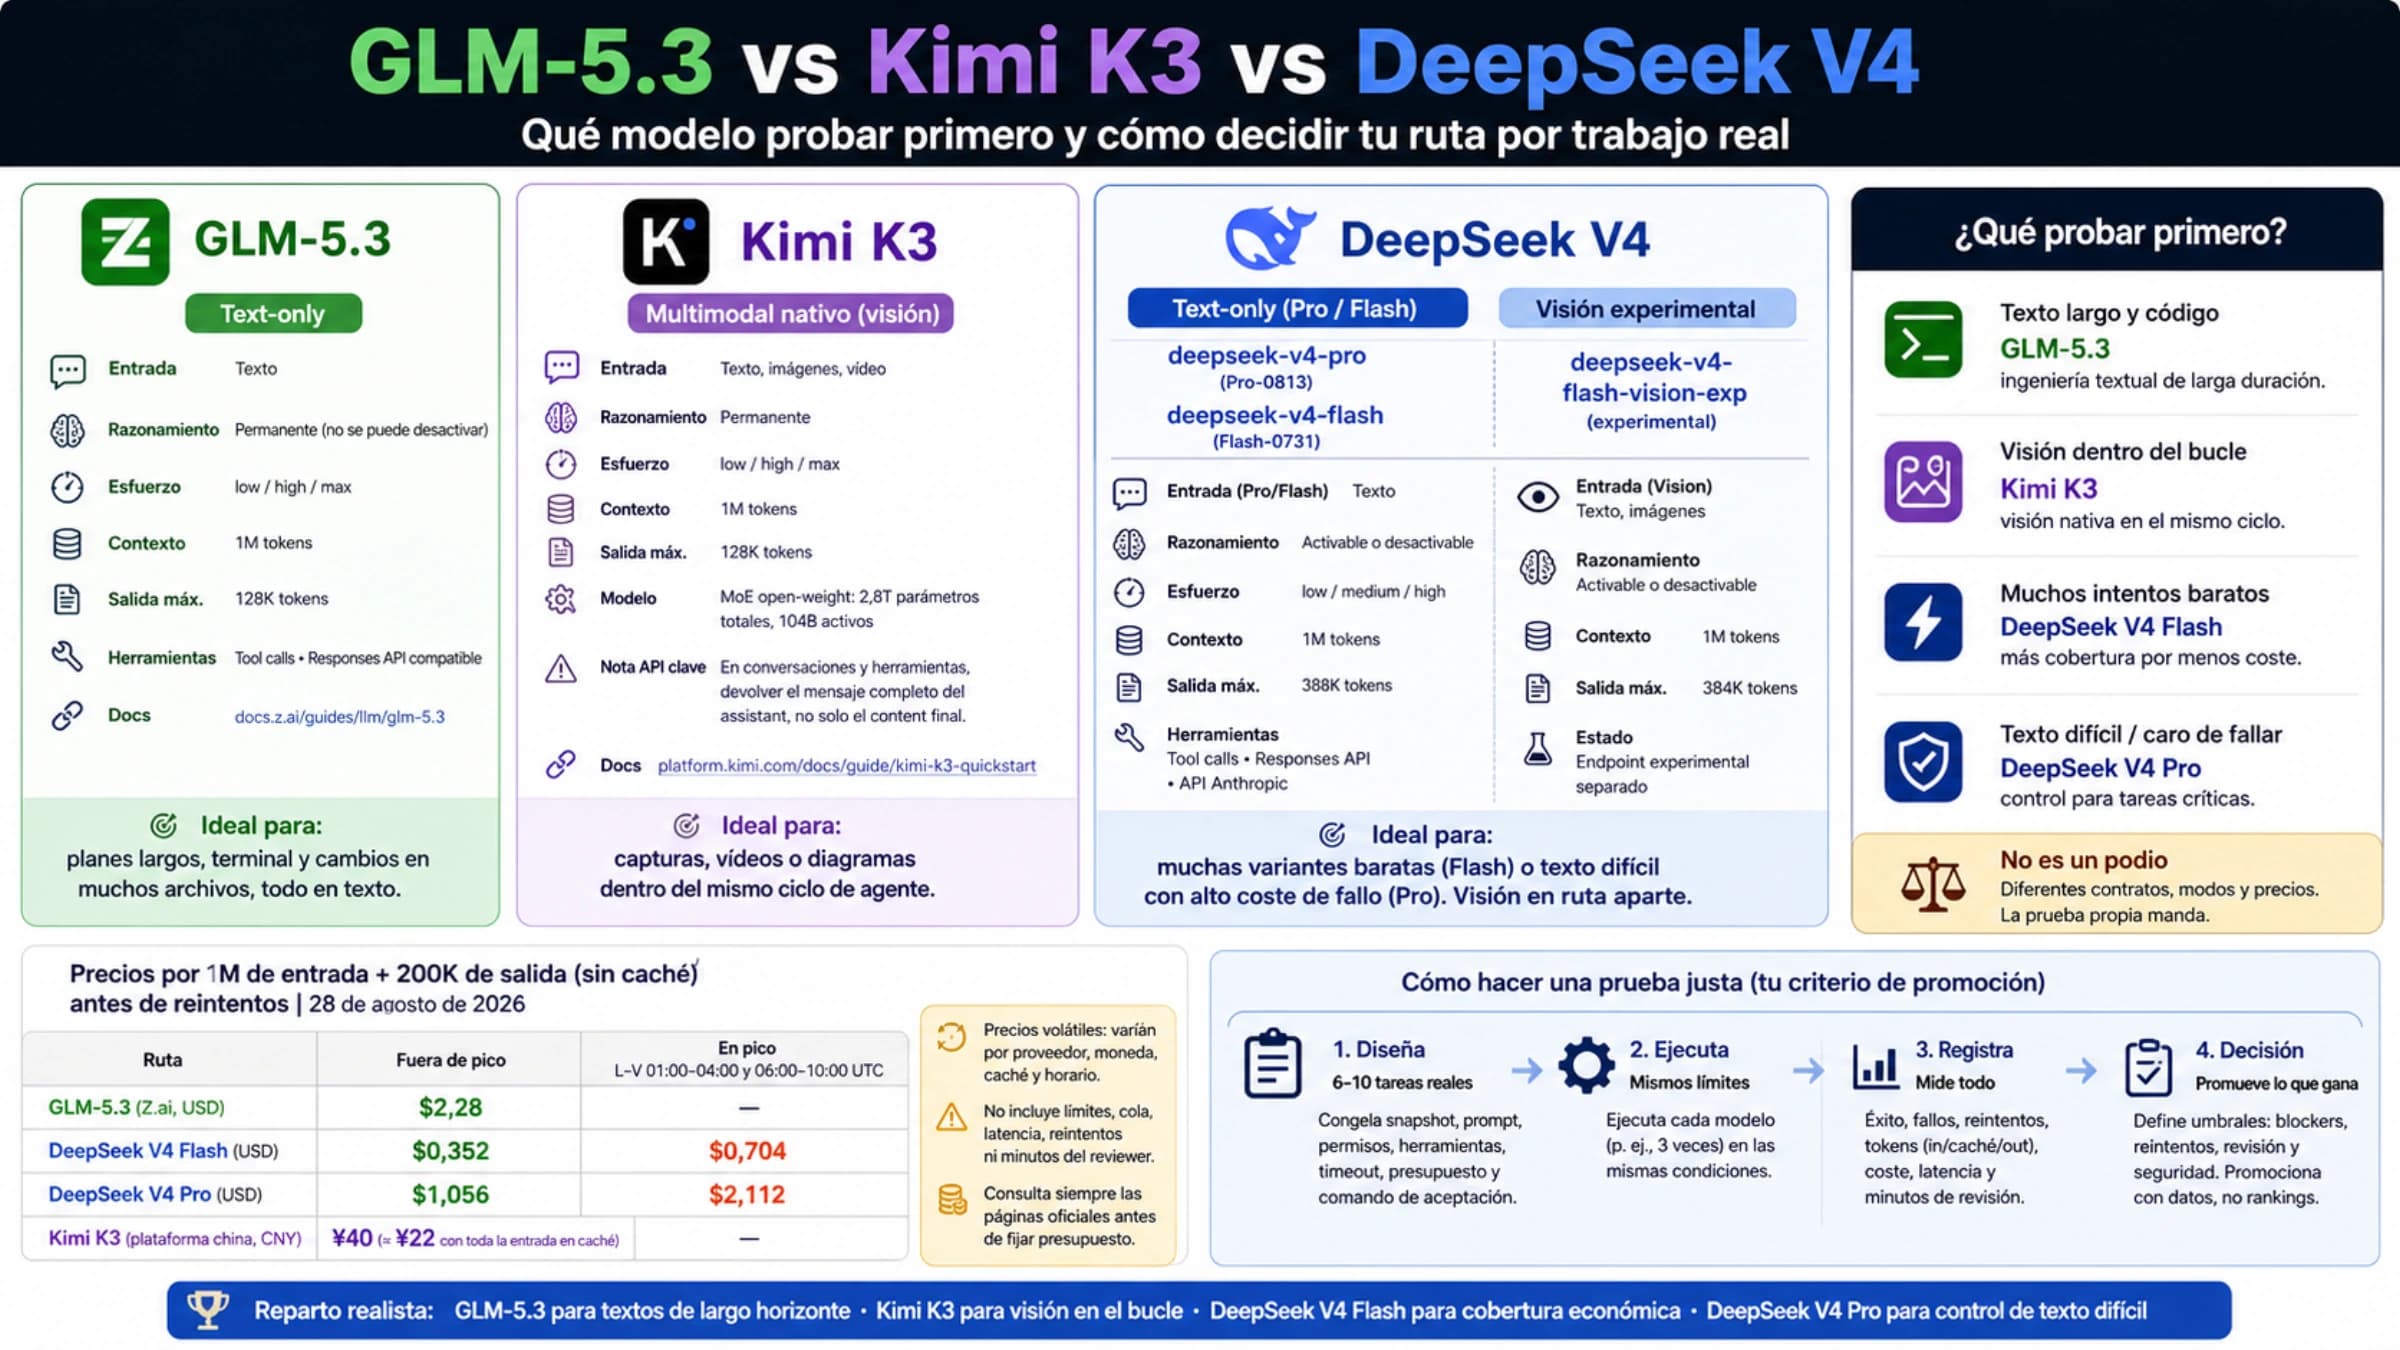
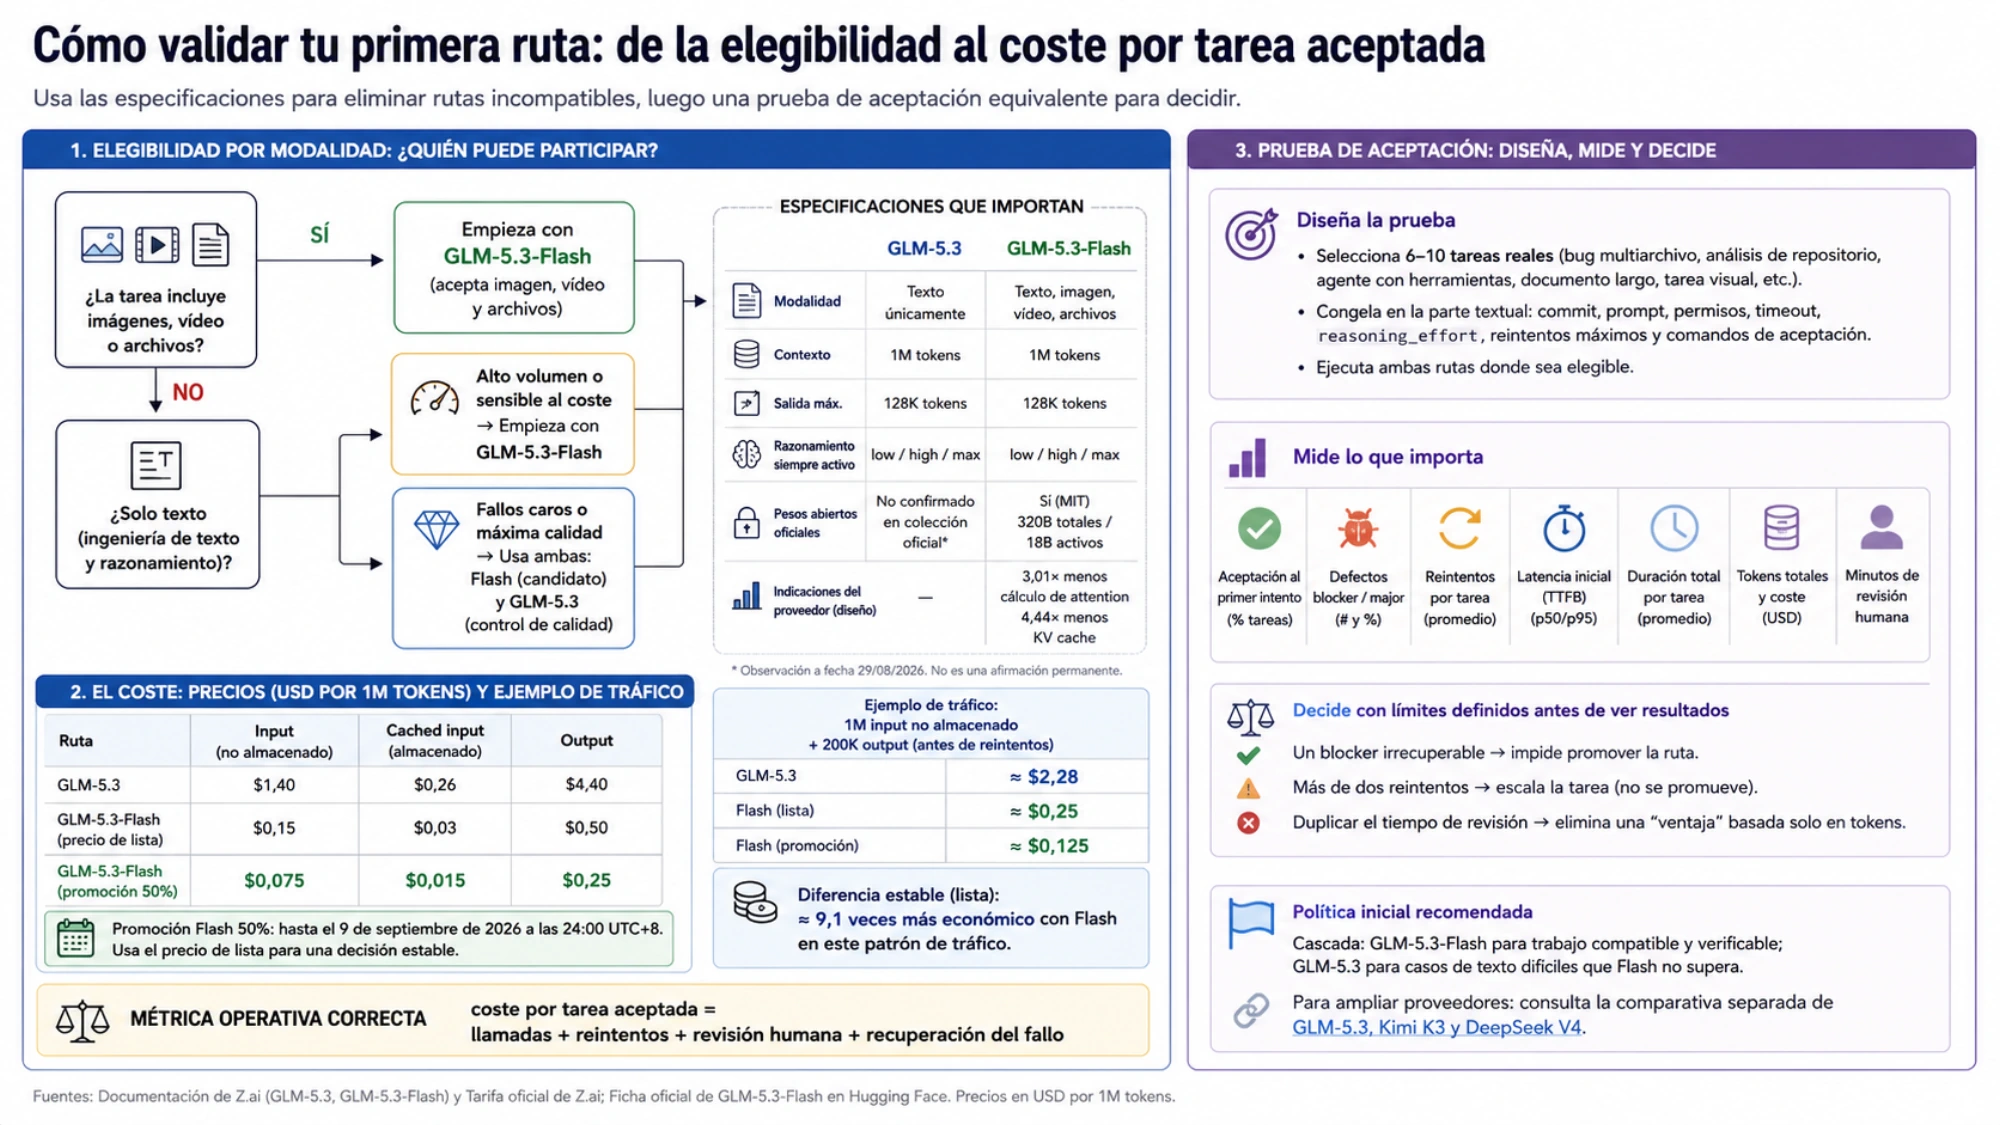
Según la documentación de GLM-5.3, el modelo acepta texto, dispone de 1M tokens de contexto y hasta 128K tokens de salida. El razonamiento siempre está activo y admite low, high y max.
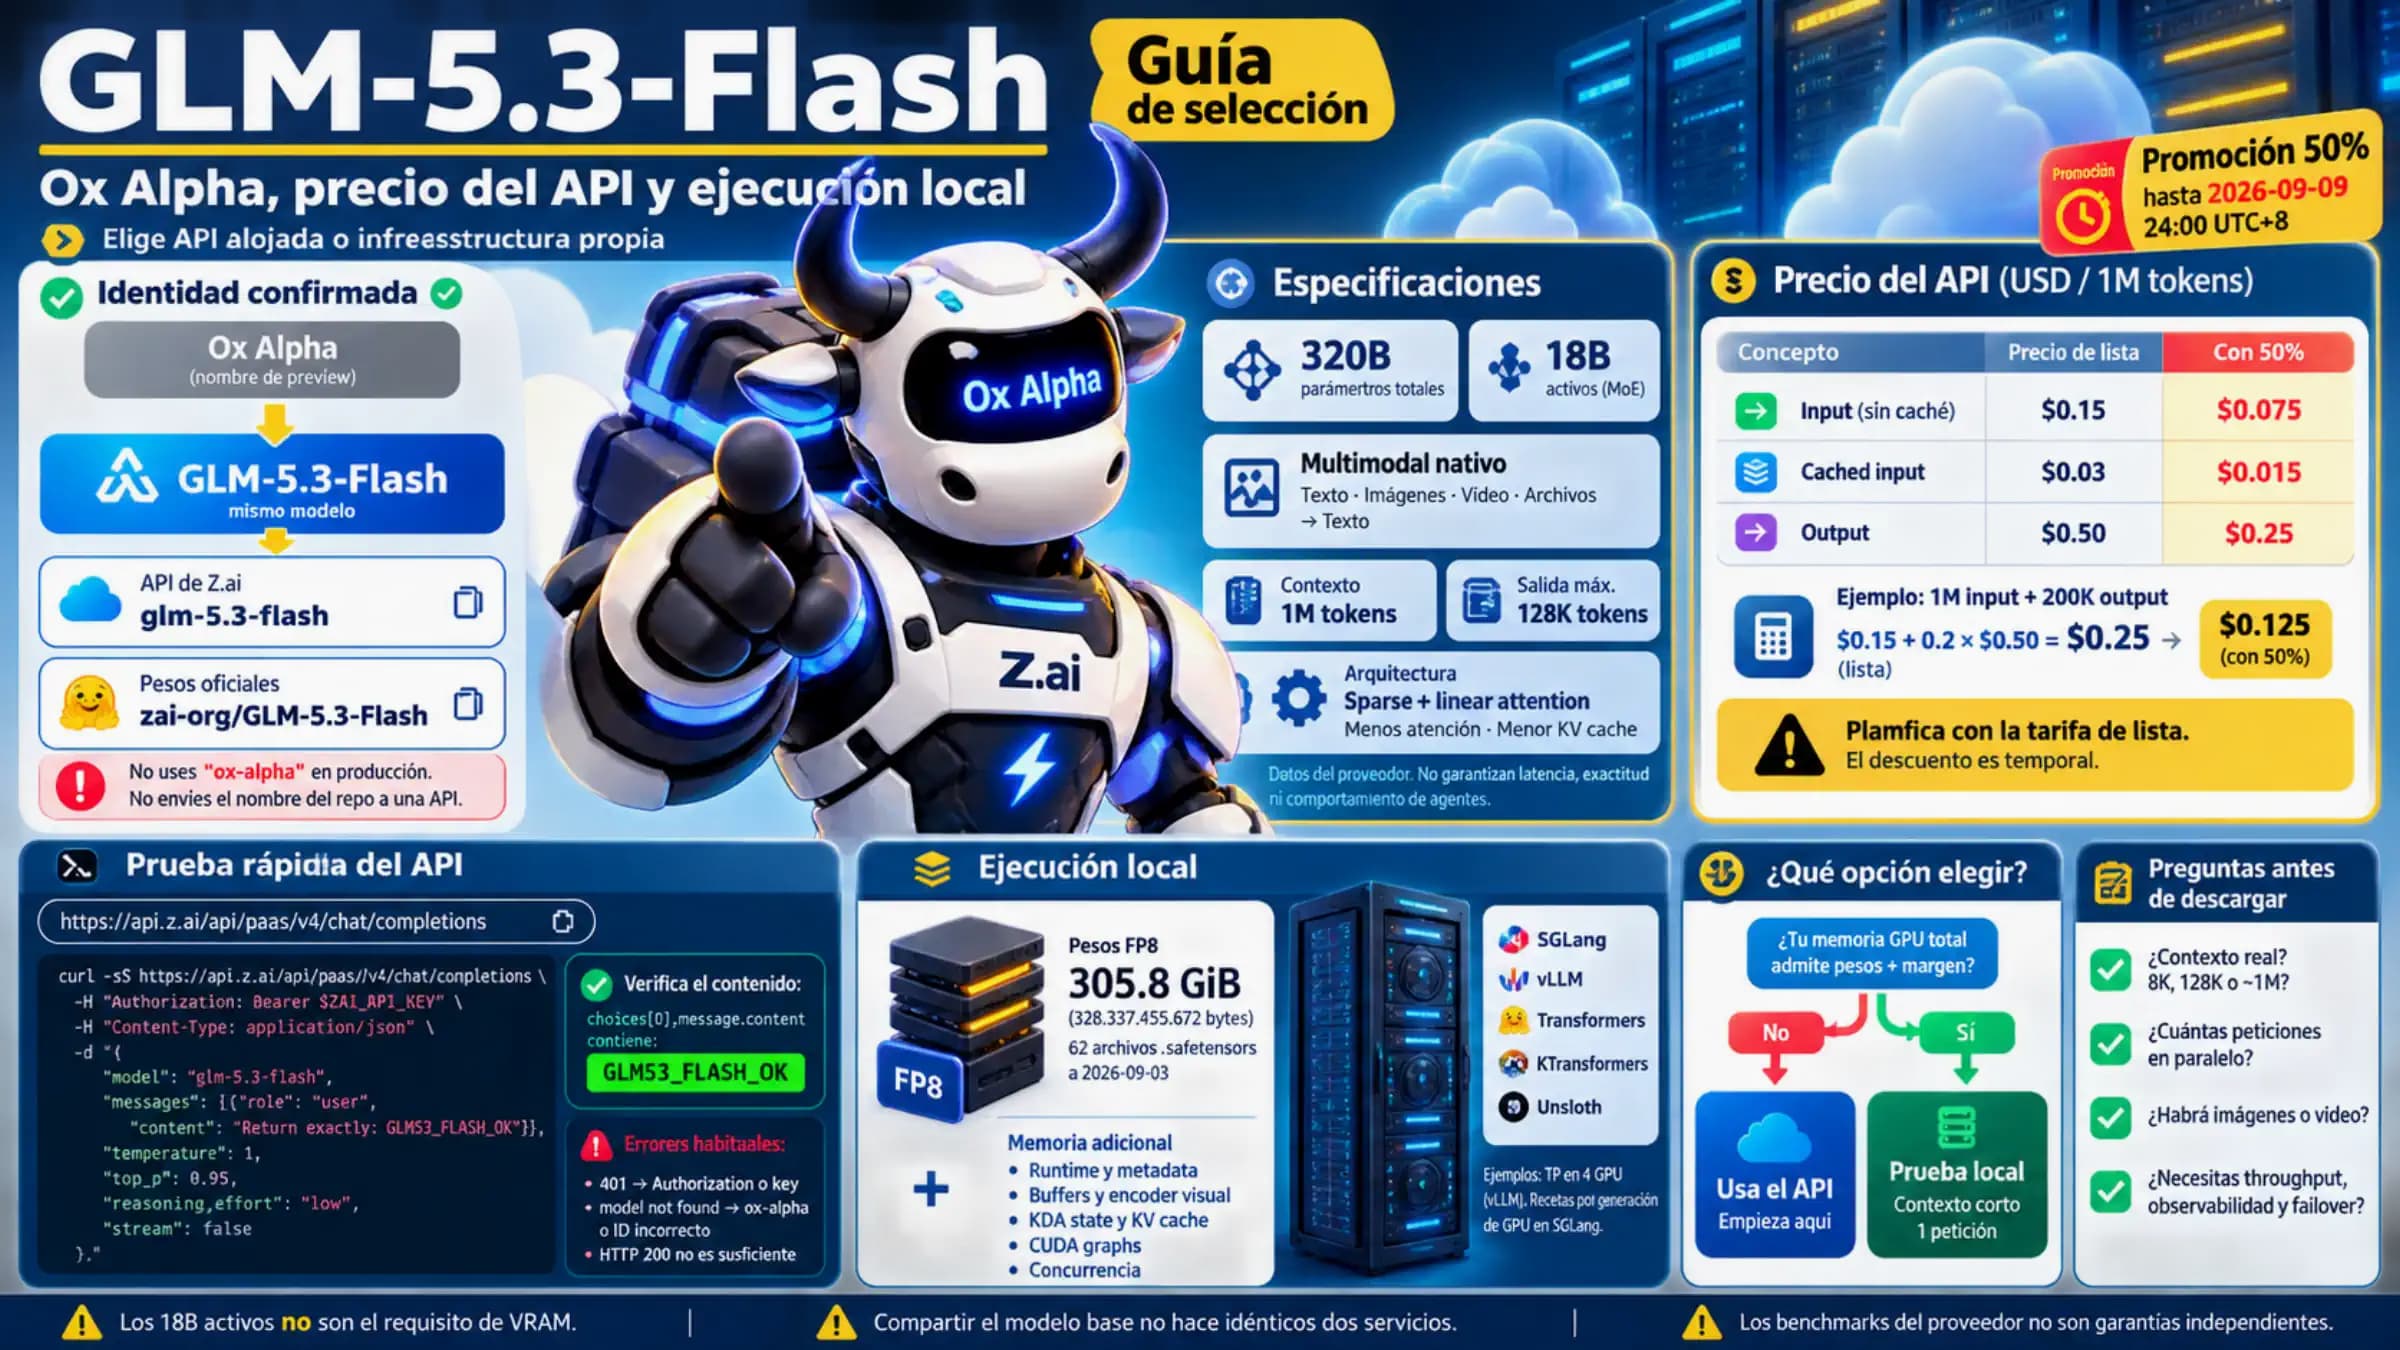
La documentación de GLM-5.3-Flash mantiene esos límites y añade imagen, vídeo y archivos. El ID exacto de la API es glm-5.3-flash.
| Necesidad | Primera opción |
|---|---|
| Leer una captura, gráfico, vídeo o documento sin transcripción manual | Flash |
| Procesar mucho volumen con verificación automática | Flash |
| Ingeniería de texto donde un fallo contamina el estado posterior | Ambas; GLM-5.3 como control |
| Ejecución propia con pesos oficiales | Ambas; revisar licencia y capacidad |
Z.ai publica para Flash 320B parámetros totales y 18B activos. También informa de unas reducciones de 3,01 veces en el cálculo de atención y 4,44 veces en la caché KV frente a GLM-5.3. Son cifras del proveedor sobre el diseño, no una medición independiente de tu latencia o calidad.
El presupuesto debe sobrevivir al descuento
La tarifa oficial de Z.ai se expresa en USD por 1M tokens:
| Modelo y tarifa | Entrada | Entrada en caché | Salida |
|---|---|---|---|
| GLM-5.3 | $1,40 | $0,26 | $4,40 |
| Flash, precio de lista | $0,15 | $0,03 | $0,50 |
| Flash, promoción | $0,075 | $0,015 | $0,25 |
La promoción del 50 % estaba anunciada hasta el 9 de septiembre de 2026 a las 24:00 UTC+8 en la documentación consultada el 31 de agosto. No hemos comprobado una posible prórroga; usa el precio de lista para planificar a largo plazo.
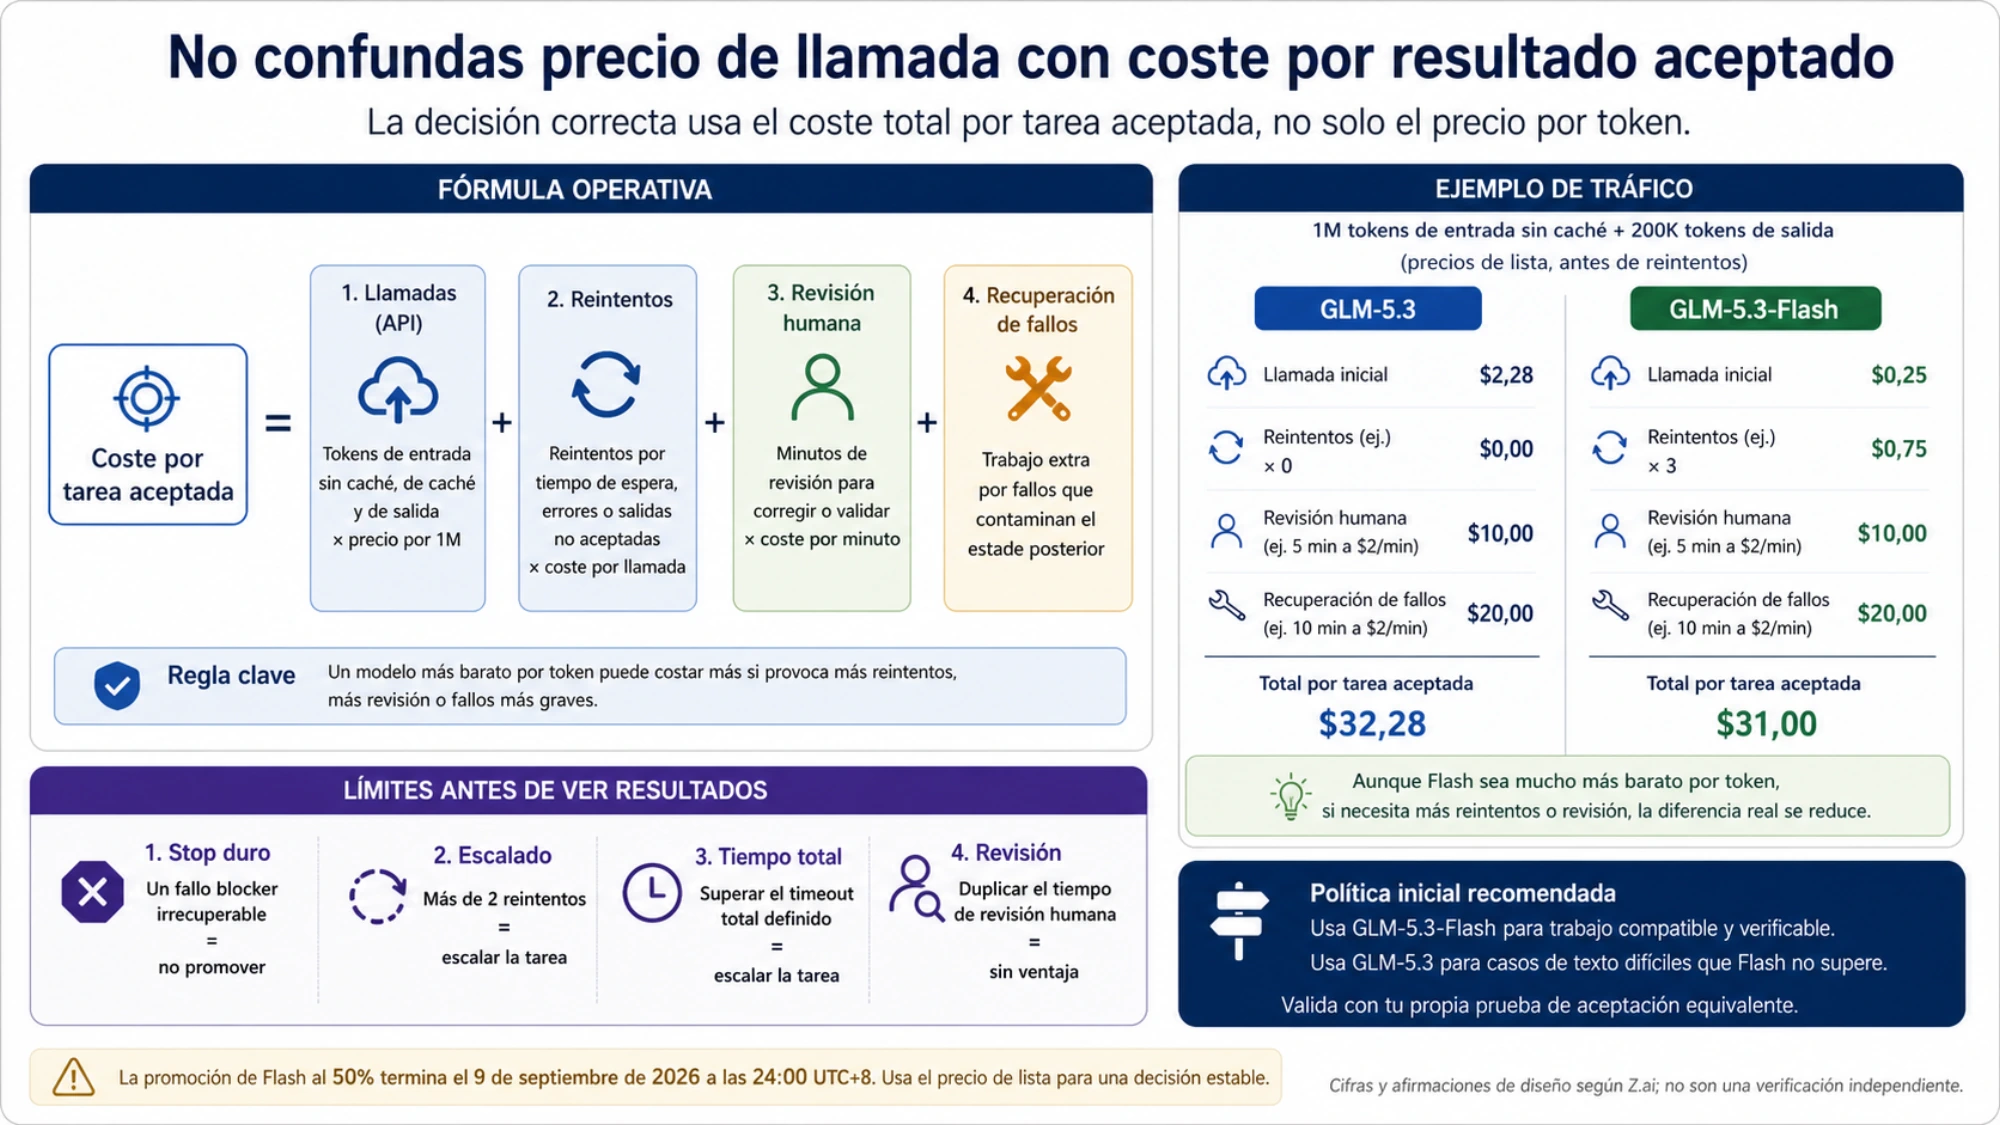
En un conjunto hipotético de solicitudes que sume 1M tokens de entrada sin caché y 200K de salida, el coste antes de reintentos es aproximadamente $2,28 con GLM-5.3, $0,25 con el precio de lista de Flash y $0,125 durante la promoción. Con esa mezcla de tokens, la diferencia estable ronda 9,1 veces.
La métrica operativa correcta es más amplia:
coste por tarea aceptada =
  (gasto total de API + horas de revisión y recuperación × coste por hora)
  / tareas aceptadas
El gasto total de API ya incluye los intentos facturados y los reintentos: no los sumes una segunda vez. Convierte el tiempo humano a la misma moneda y registra el gasto por separado si no obtienes ninguna tarea aceptada.
Si Flash supera las pruebas a la primera, mantiene su ventaja. Si necesita tres intentos y una corrección manual, la distancia disminuye. GLM-5.3 debe justificar la prima con menos defectos o menor riesgo, no solo con su etiqueta.
Pesos abiertos no significan infraestructura gratis
La ficha oficial de GLM-5.3-Flash ofrece pesos 321B bajo MIT y rutas con vLLM, SGLang, Transformers, KTransformers y Unsloth.
La ficha oficial de GLM-5.3 publica ahora una ruta de pesos 753B y guías para los mismos frameworks principales; su licencia figura como GLM-5.3, no MIT. Por tanto, controlar el despliegue ya no selecciona Flash por sí solo. Compara licencia, modalidad, tamaño, memoria, cuantización, capacidad de pico, monitorización y mantenimiento dentro del coste total de operación.
Una prueba corta produce una decisión útil
Selecciona entre 6 y 10 tareas reales: un bug que toca varios archivos, análisis de repositorio, un agente con herramientas, un documento largo y una tarea visual. En la parte textual mantén fijos la revisión del código, las instrucciones, los permisos, el tiempo máximo de espera, reasoning_effort, el máximo de reintentos y los comandos de aceptación.
Registra aceptación al primer intento, defectos que impidan entregar y otros errores graves, reintentos, latencia inicial, duración total, tokens y minutos de revisión. Define límites antes de ver resultados: un fallo que impida entregar debe detener la adopción de esa configuración; fija un máximo de reintentos y un coste de revisión acorde al valor del trabajo. Estos límites dependen de tu aplicación, no de una cifra universal.
Una política inicial razonable es una cascada: Flash para trabajo compatible y verificable; GLM-5.3 para casos de texto difíciles que Flash no supera. Cuando necesites ampliar proveedores, usa la comparativa separada de GLM-5.3, Kimi K3 y DeepSeek V4.
Fuentes5
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 31 ago 2026.
Fuentes5
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 31 ago 2026.
- 1.documentación de GLM-5.3docs.z.ai/guides/llm/glm-5.3
- 2.documentación de GLM-5.3-Flashdocs.z.ai/guides/vlm/glm-5.3-flash
- 3.tarifa oficial de Z.aidocs.z.ai/guides/overview/pricing
- 4.ficha oficial de GLM-5.3-Flashhuggingface.co/zai-org/GLM-5.3-Flash
- 5.ficha oficial de GLM-5.3huggingface.co/zai-org/GLM-5.3