GPT-5.5 vs Claude Opus 4.7: qué API elegir y cuánto cuesta
GPT-5.5 encaja como primera prueba si ya usas Responses; Opus 4.7, si ya usas Messages o procesas entradas muy largas. Ambas API siguen disponibles: decide con el coste y los resultados de tu propia tarea.
En esta página
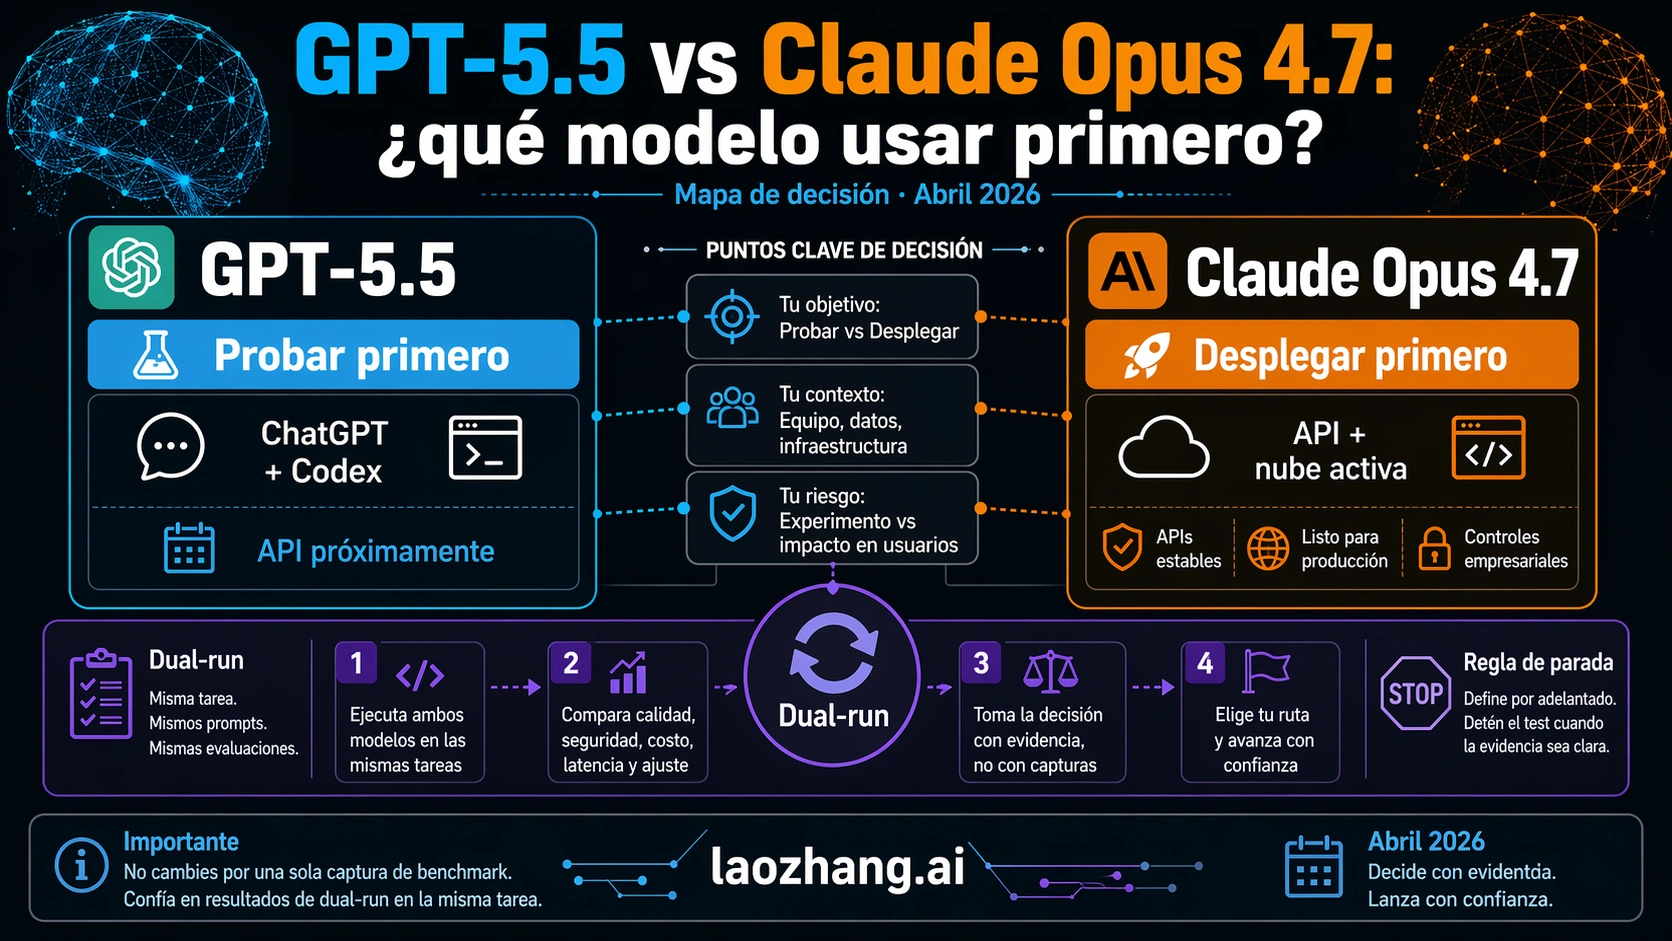
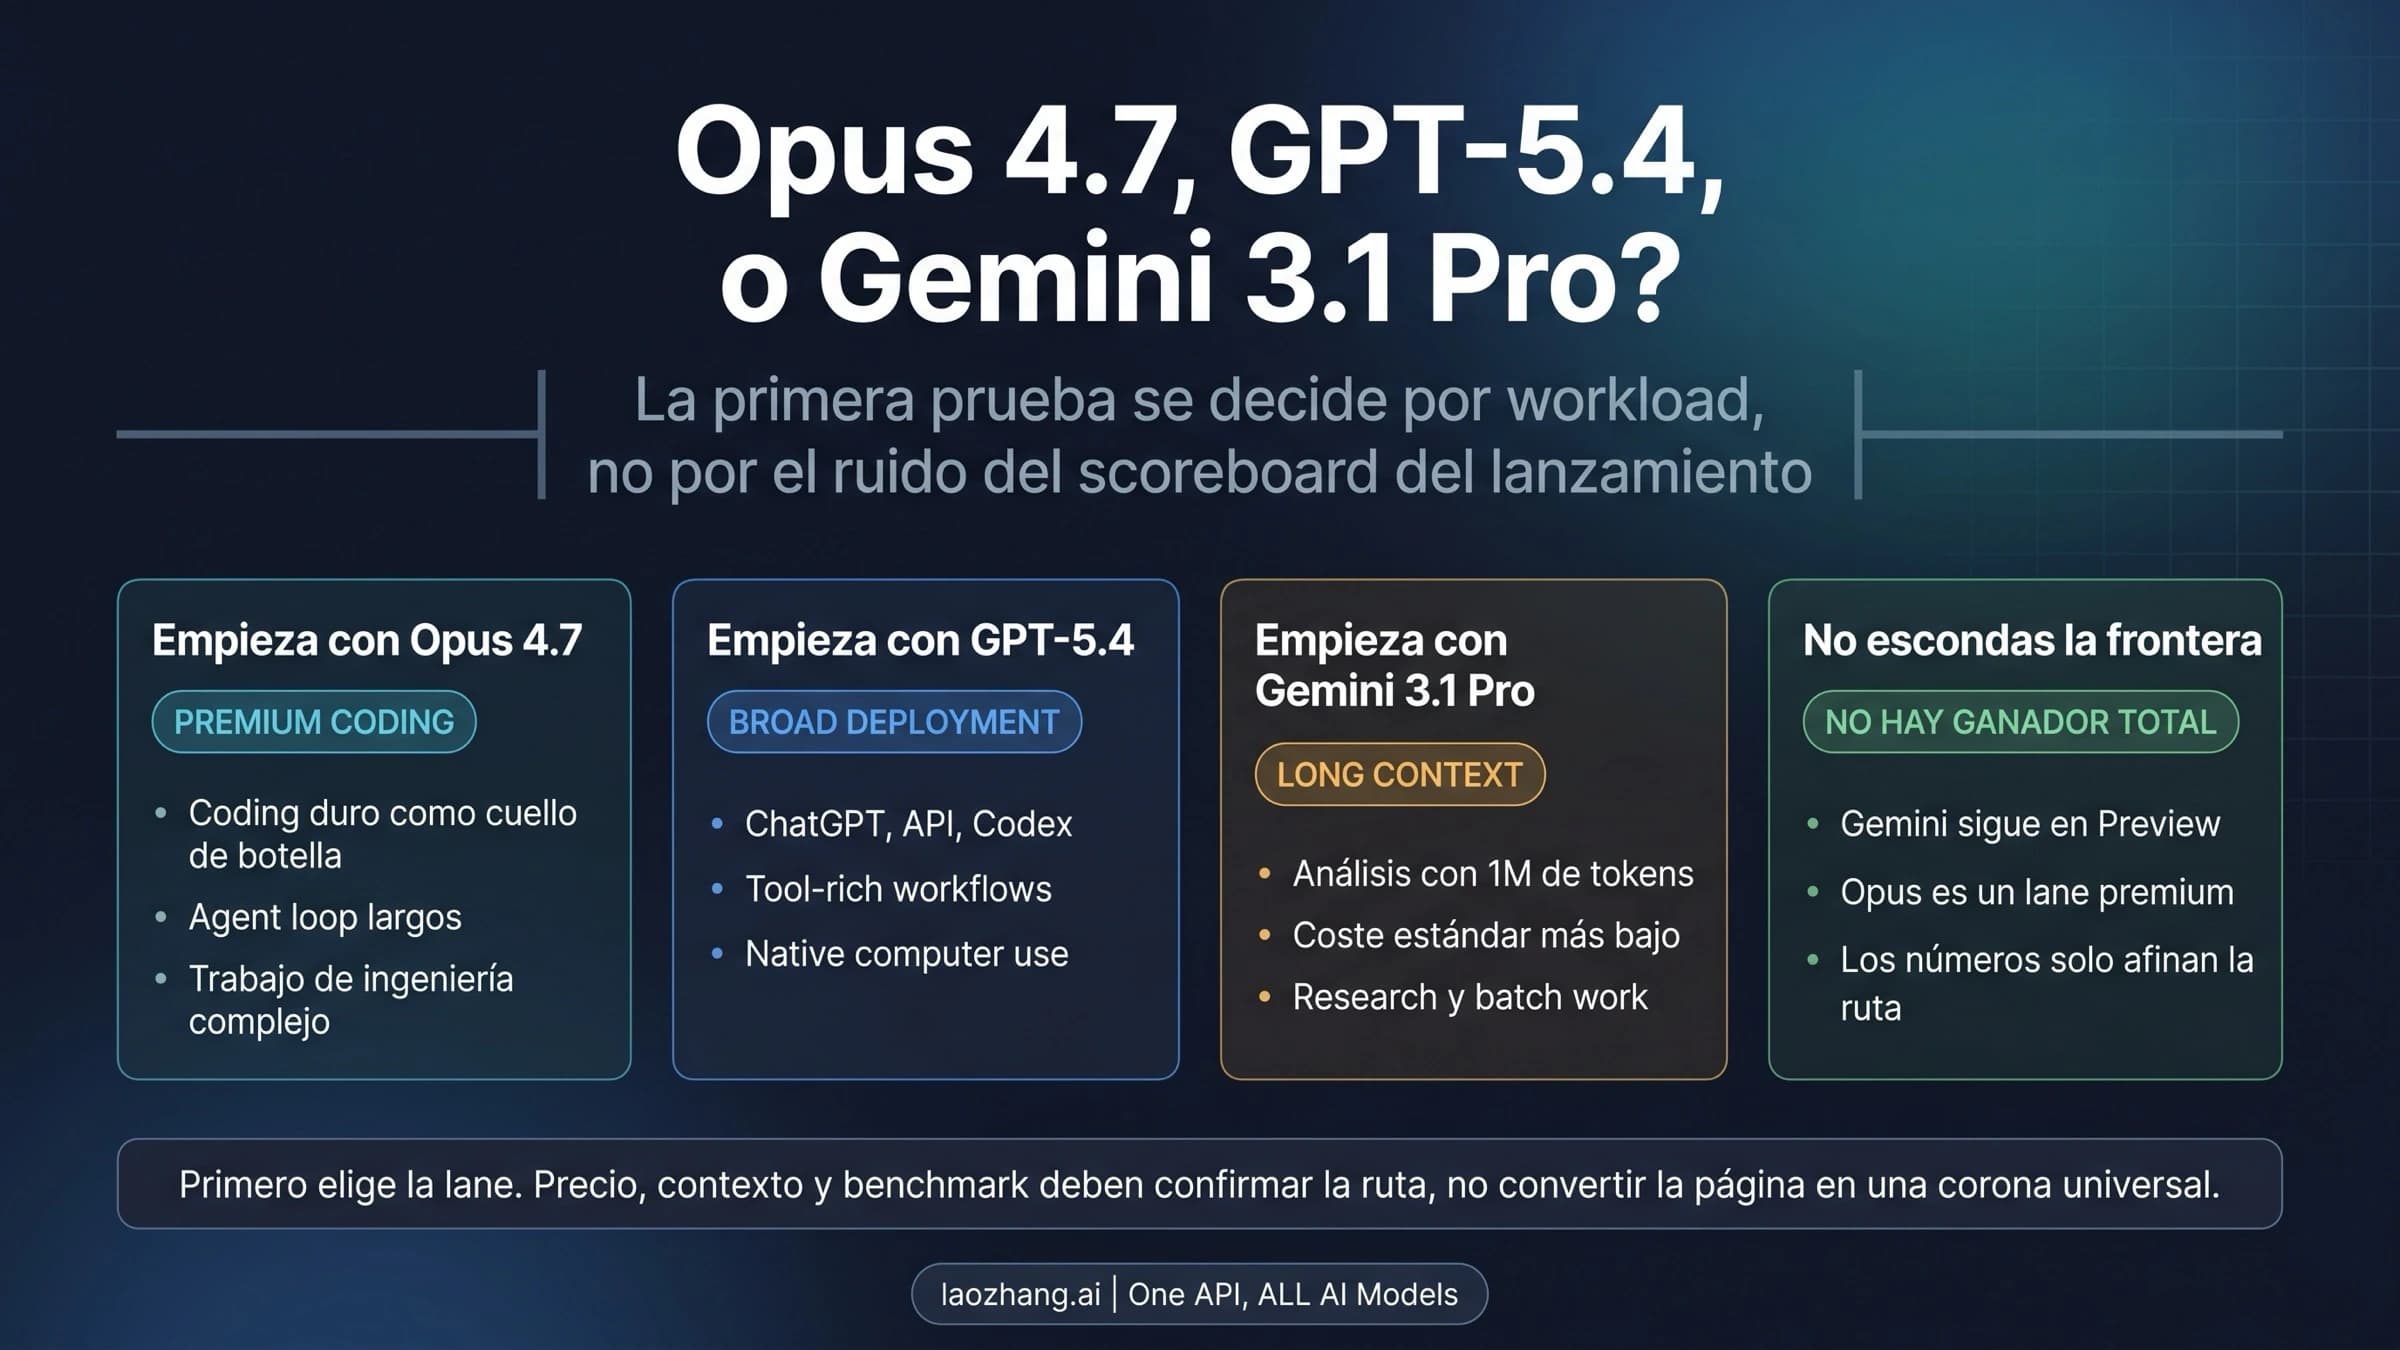
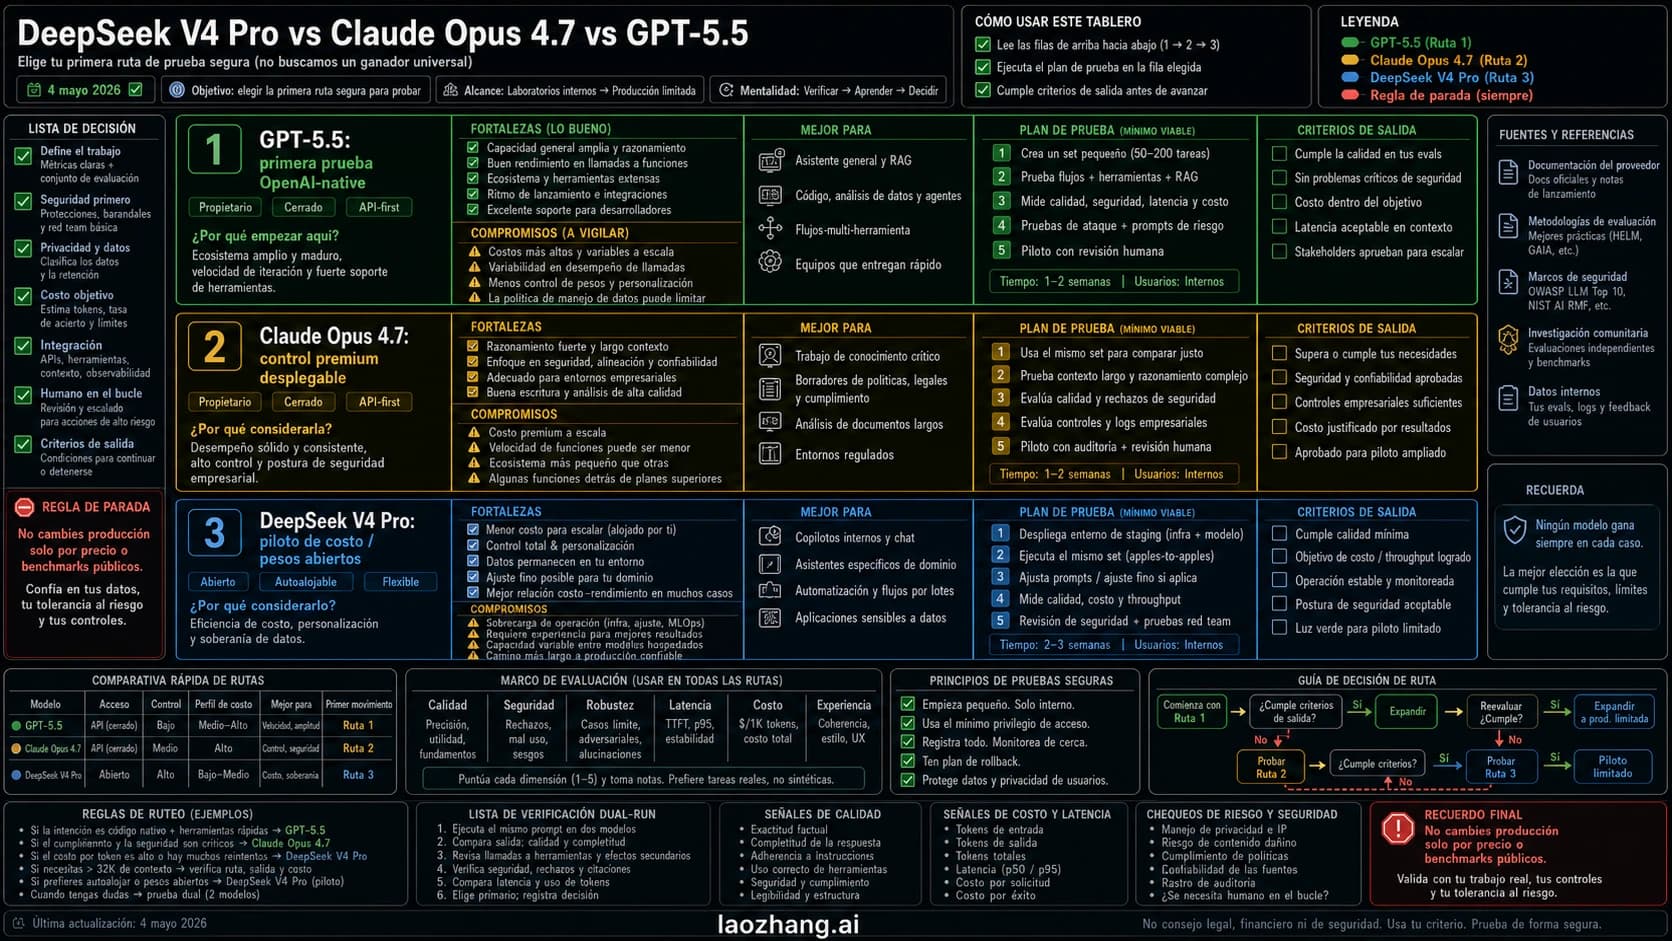
Prueba GPT-5.5 primero si tu aplicación ya usa Responses de OpenAI; prueba Claude Opus 4.7 primero si trabaja con Messages de Anthropic o necesita entradas superiores a 272.000 tokens con tarifa estándar. Para programación y agentes, esa es una forma práctica de empezar, no una clasificación universal: la elección final depende de cuántas tareas resuelva cada modelo, cuánto cueste corregir sus fallos y qué herramientas admita tu integración.
A 13 de octubre de 2026, las dos API están disponibles. OpenAI anuncia la retirada de GPT-5.5 de ChatGPT, ChatGPT Work y Codex el 14 de octubre, pero excluye expresamente la API. Opus 4.7 figura como activo y de generación anterior, con retirada no antes del 16 de abril de 2027 en las plataformas operadas por Anthropic. Son condiciones distintas que conviene comprobar antes de cambiar un modelo por defecto. Aviso de OpenAI, estado de Opus 4.7.
Qué modelo probar primero según tu aplicación
Si ambos cumplen tus requisitos, empezar por el proveedor que ya tienes integrado reduce el trabajo de adaptar peticiones, respuestas e historial. Mi recomendación para esta pareja es la siguiente:
| Tu situación | Primera prueba | Qué puede cambiar la decisión |
|---|---|---|
| Ya usas Responses, herramientas de OpenAI y un conjunto de pruebas estable | GPT-5.5 | Más reintentos, respuestas incompletas o más revisión que con Opus |
| Ya usas Messages y herramientas de Anthropic | Opus 4.7 | GPT completa las mismas tareas con menos coste total, incluida la adaptación |
| Analizas documentos con más de 272.000 tokens de entrada | Opus 4.7 como referencia inicial de coste | La calidad de recuperación y el número de llamadas necesarias pueden favorecer a GPT |
| Generas informes o código con mucha salida | Calcula Opus primero; compara ambos | Los tokens de razonamiento, la caché y los resultados descartados pueden invertir el ahorro |
| Trabajas en ChatGPT o Codex con inicio de sesión de ChatGPT | Revisa el sustituto disponible para esa interfaz | La continuidad de GPT-5.5 por API no mantiene su selector en esas aplicaciones |
Esta tabla propone un orden de evaluación basado en compatibilidad y facturación. No afirma que un modelo programe mejor en todos los repositorios ni que el otro sea superior para cualquier documento. Para mantener una ruta que ya funciona, conserva sus criterios de aceptación y compara el candidato antes de trasladarle todo el tráfico.
Disponibilidad, contexto y nombres exactos
Para una aplicación que llama directamente al proveedor, estos son los contratos publicados de la pareja:
| Característica | GPT-5.5 | Claude Opus 4.7 |
|---|---|---|
| Identificador nativo | gpt-5.5; versión fijada gpt-5.5-2026-04-23 | claude-opus-4-7 |
| Interfaz de los ejemplos de esta guía | Responses | Messages |
| Ventana de contexto | 1.050.000 tokens | 1 millón de tokens |
| Salida máxima ordinaria | 128.000 tokens | 128.000 tokens |
| Entradas y salida | Texto e imágenes → texto | Texto e imágenes → texto |
| Situación de la API | Disponible | Activo, de generación anterior (legacy) |
Fuentes: ficha de GPT-5.5 y ficha de Opus 4.7, comprobadas el 13 de octubre. Una ventana de contexto grande requiere reservar espacio para la generación y el razonamiento; no significa que puedas sumar la entrada máxima y la salida máxima en una sola petición. Tampoco demuestra que el modelo encuentre correctamente todos los datos de un expediente largo.
El nombre de Claude no lleva fecha, pero identifica una versión fijada: no cambia automáticamente a Opus 5.5. Anthropic distingue los pesos del modelo de la infraestructura que lo sirve, que sí puede cambiar. Identificadores y versiones.
Para Opus 4.7, legacy significa que ya no recibirá actualizaciones y puede pasar a estar obsoleto en el futuro; no significa que las peticiones fallen hoy. La fecha “no antes del 16 de abril de 2027” tampoco es una fecha de cierre confirmada. Bedrock y Google Cloud tienen calendarios propios. Ciclo de vida de Claude.
La disponibilidad del catálogo no asegura permisos o capacidad para tu cuenta. En concreto, la ficha de GPT-5.5 marca el nivel gratuito como no compatible. Comprueba el acceso y los límites de la ruta que realmente vas a utilizar; una suscripción de ChatGPT no sustituye esa comprobación. Límites de GPT-5.5.
Precios de API: cuándo se amplía la diferencia
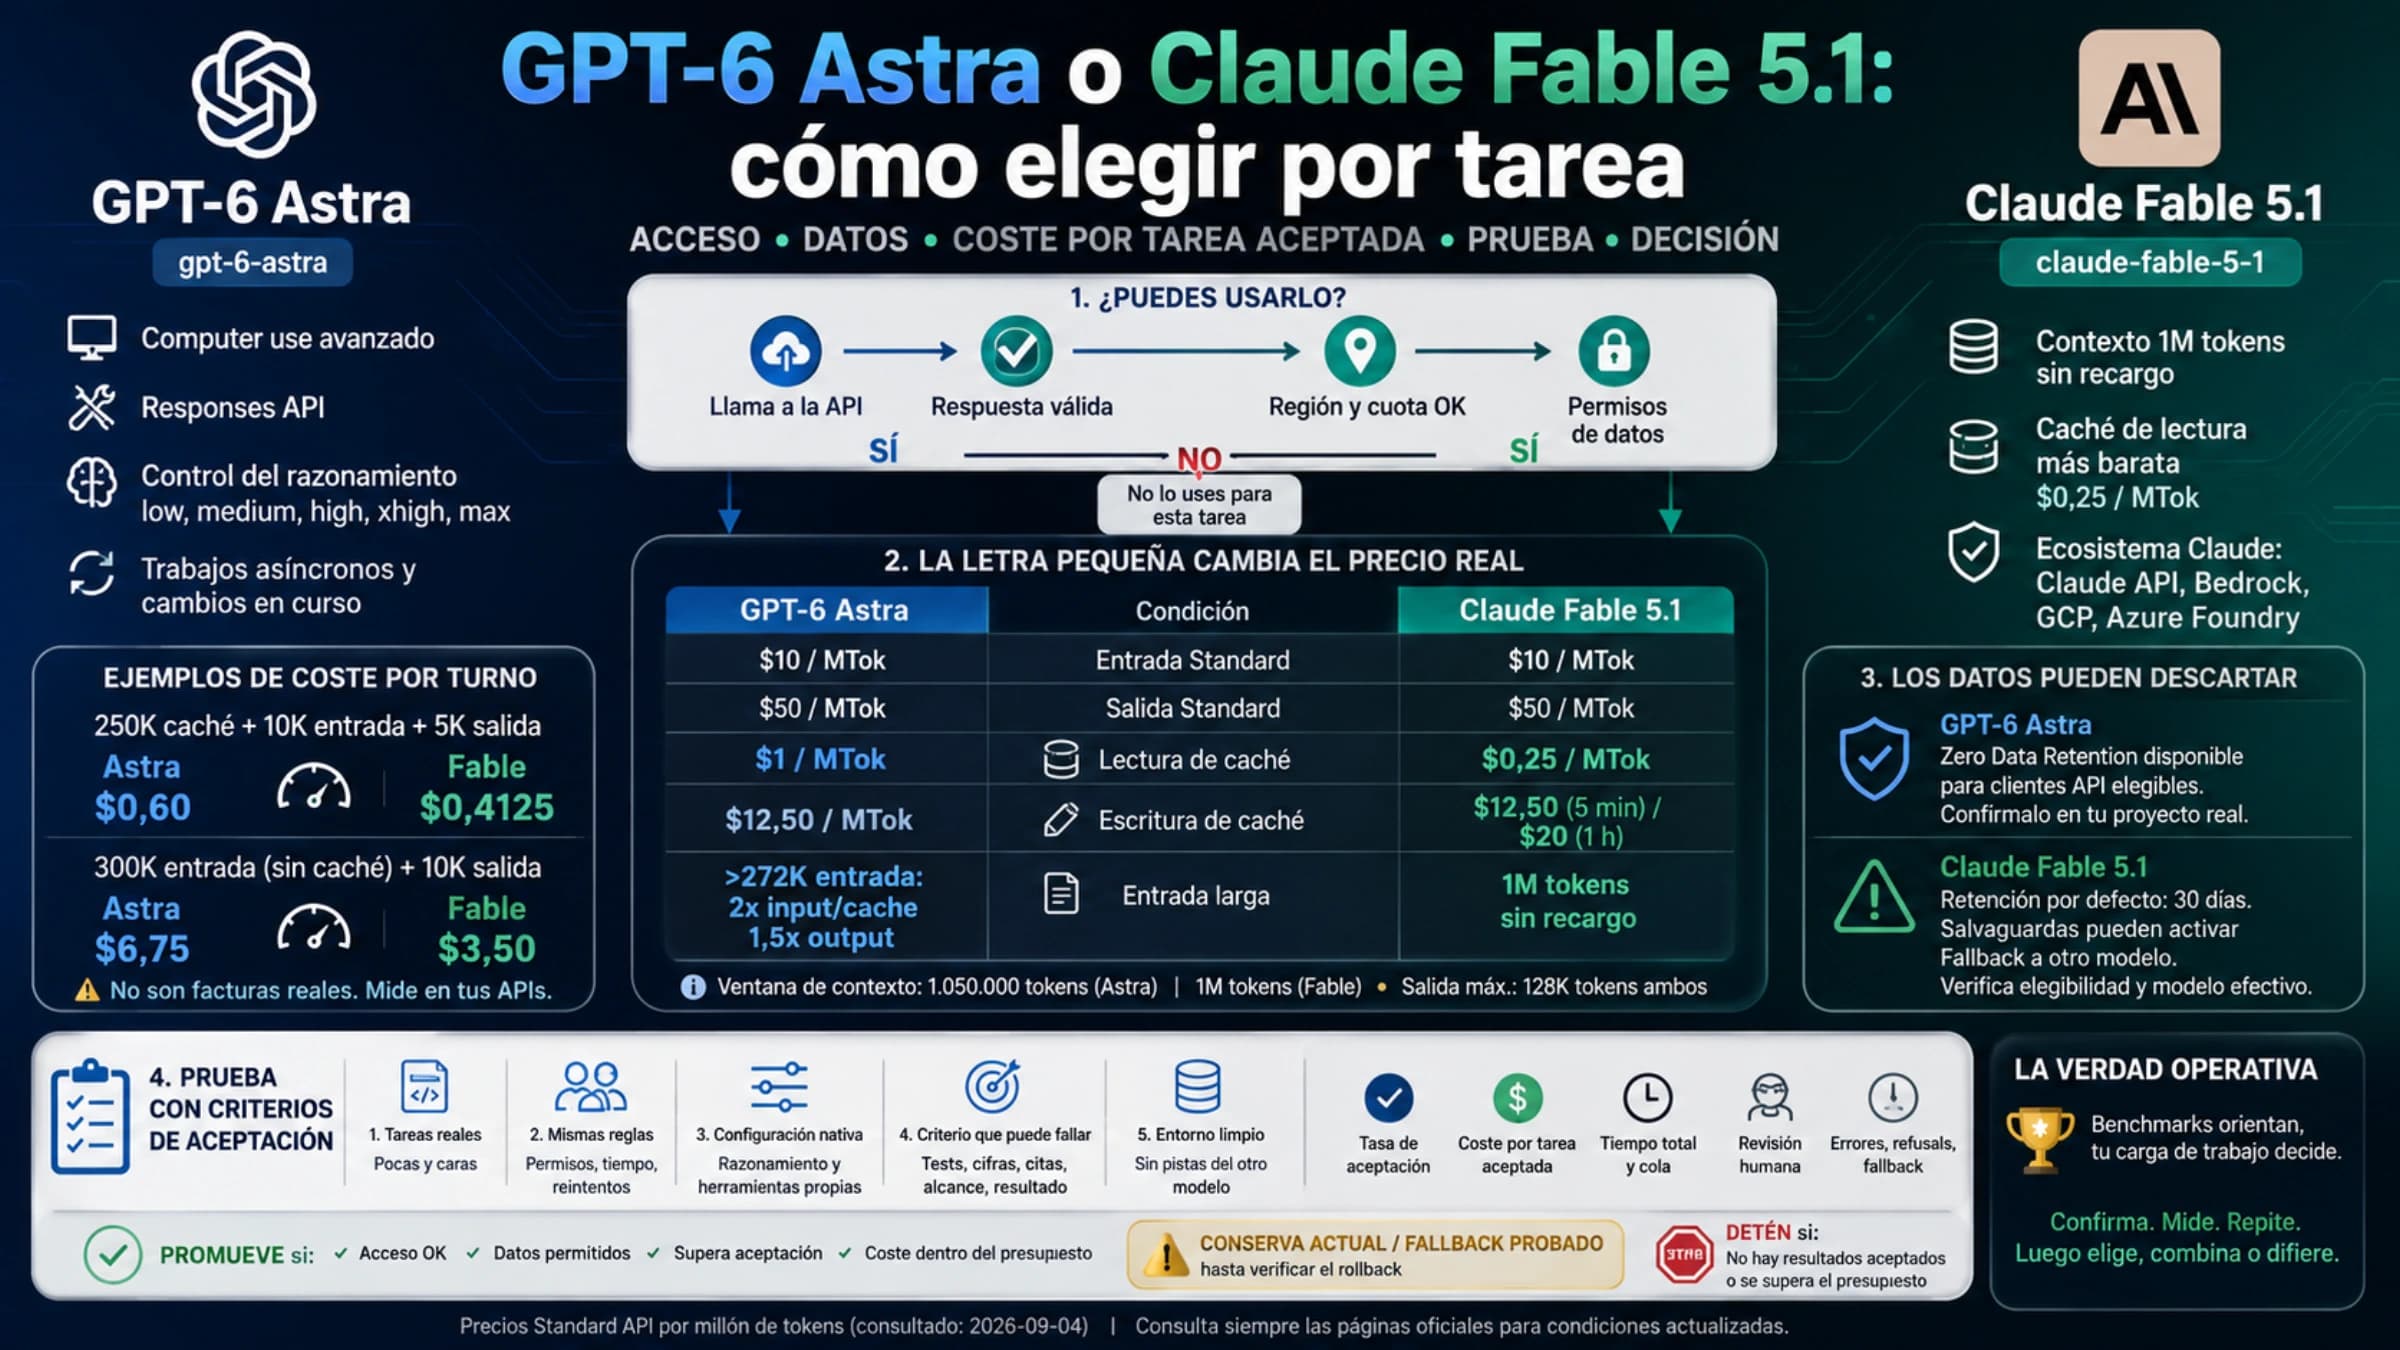
Estas son tarifas directas estándar en USD por millón de tokens, no cuotas mensuales ni precios de un intermediario. En GPT-5.5, el tramo largo comienza al superar 272.000 tokens de entrada; OpenAI aplica el incremento a la sesión completa, no solo al exceso. Opus 4.7 mantiene la tarifa estándar en toda su ventana de un millón. Precios de OpenAI, precios de Anthropic.
| Categoría | GPT-5.5: hasta 272.000 de entrada | GPT-5.5: más de 272.000 de entrada | Opus 4.7 |
|---|---|---|---|
| Entrada sin caché | 5 USD | 10 USD | 5 USD |
| Entrada recuperada de caché | 0,50 USD | 1 USD | 0,50 USD |
| Generación facturable | 30 USD | 45 USD | 25 USD |
| Escritura de caché | Sin recargo adicional | Sin recargo adicional | 6,25 USD a 5 minutos; 10 USD a 1 hora |
La salida de Opus cuesta un 16,67 % menos que la de GPT en el tramo corto: (30 − 25) / 30. Expresado en la dirección contraria, GPT cuesta un 20 % más que Opus. Ambas frases usan una base distinta; decir que Opus es “un 20 % más barato” con esas tarifas sería incorrecto.
Dos cuentas que puedes reproducir
Supongamos una sola petición estándar, sin caché, con 8.000 tokens de generación facturable, incluido el razonamiento. Excluimos herramientas de pago, recargos regionales, reintentos y revisión humana. Son ejemplos calculados con cantidades iguales, no resultados obtenidos con los modelos; el mismo texto puede producir recuentos distintos en cada proveedor.
| Entrada supuesta | Cálculo de GPT-5.5 | Cálculo de Opus 4.7 |
|---|---|---|
| 120.000 tokens | 0,12 × 5 + 0,008 × 30 = 0,84 USD | 0,12 × 5 + 0,008 × 25 = 0,80 USD |
| 320.000 tokens | 0,32 × 10 + 0,008 × 45 = 3,56 USD | 0,32 × 5 + 0,008 × 25 = 1,80 USD |
Con la entrada corta, la diferencia por intento es pequeña. Si uno requiere una segunda llamada para corregir un dato y el otro entrega un resultado válido a la primera, el orden puede cambiar. Con la entrada larga, el recargo de GPT pesa mucho más: para justificarlo tendría que aportar una ventaja en la tarea, evitar otras llamadas o aprovechar suficiente caché.
Calcula después coste por resultado aceptado = gasto de todos los intentos / resultados aceptados. Añade por separado el tiempo de revisión y corrección. Una respuesta barata que se descarta también forma parte del gasto.
Caché, Batch y región
La caché de GPT-5.5 es automática, no admite puntos de corte explícitos y no tiene recargo de escritura. Para agrupar peticiones con un prefijo estable puedes usar prompt_cache_key. La opción de retención es 24h, pero la duración descrita es normalmente de unos 30 minutos y hasta 24 horas; no garantiza una reutilización durante todo ese periodo. El mínimo cacheable depende de la petición. Diferencias de caché entre modelos.
En Opus, distingue entrada nueva, escritura y lectura. Por ejemplo, almacenar 100.000 tokens durante cinco minutos cuesta 0,625 USD; leerlos en una petición posterior con acierto de caché cuesta 0,05 USD, antes de otros modificadores. No apliques el precio de lectura a la primera escritura. Facturación de caché.
Para trabajo por lotes, GPT-5.5 Batch cuesta 2,50 USD de entrada y 15 USD de salida en el tramo corto; Opus Batch, 2,50 y 12,50 USD. GPT también publica Flex a 2,50/15 USD y Fast a 12,50/75 USD para el tramo corto. Son modalidades con condiciones diferentes: no sustituyas automáticamente una petición interactiva por otra modalidad solo por su precio. Fast no está disponible en Opus 4.7. OpenAI, Anthropic.
OpenAI añade un 10 % para procesamiento regional de GPT-5.5. En la API de Claude, inference_geo: "us" aplica un multiplicador de 1,1 a todas las categorías de tokens de Opus 4.7; el modo global usa la tarifa estándar. Los precios regionales de plataformas de terceros se comprueban en su propio contrato. Ficha de GPT, residencia de datos de Claude.
Programación, herramientas y documentos: qué dicen las mediciones
La comparación de Artificial Analysis consultada el 13 de octubre enfrenta GPT-5.5 High con Opus 4.7 Max. Son configuraciones diferentes. En su índice v4.3.2, GPT obtiene 37 y Opus figura con 41 estimado, pendiente de evaluación independiente. Esa cifra no permite presentar a Opus como ganador confirmado del índice.
La misma página muestra 84 % frente a 79 % en AA-LCR v1.1 y 45 % frente a 42 % en Humanity’s Last Exam, a favor de GPT en esas mediciones. Para rendimiento, publica 88 frente a 51 tokens por segundo, pero el tiempo calculado para una respuesta de 500 tokens es 36,20 frente a 33,38 segundos. GPT genera más deprisa una vez iniciada la salida; Opus tiene menor espera inicial en esa configuración. Una cifra de tokens por segundo no resuelve por sí sola cuál responde antes al usuario.
La página deja vacías las celdas de coste por tarea y tokens por tarea de Opus. No equivalen a cero ni permiten calcular una ventaja de gasto. Sus precios combinados de 4,35 y 3,85 USD emplean una mezcla 7:2:1 de caché, entrada y salida; no son tarifas universales de API.
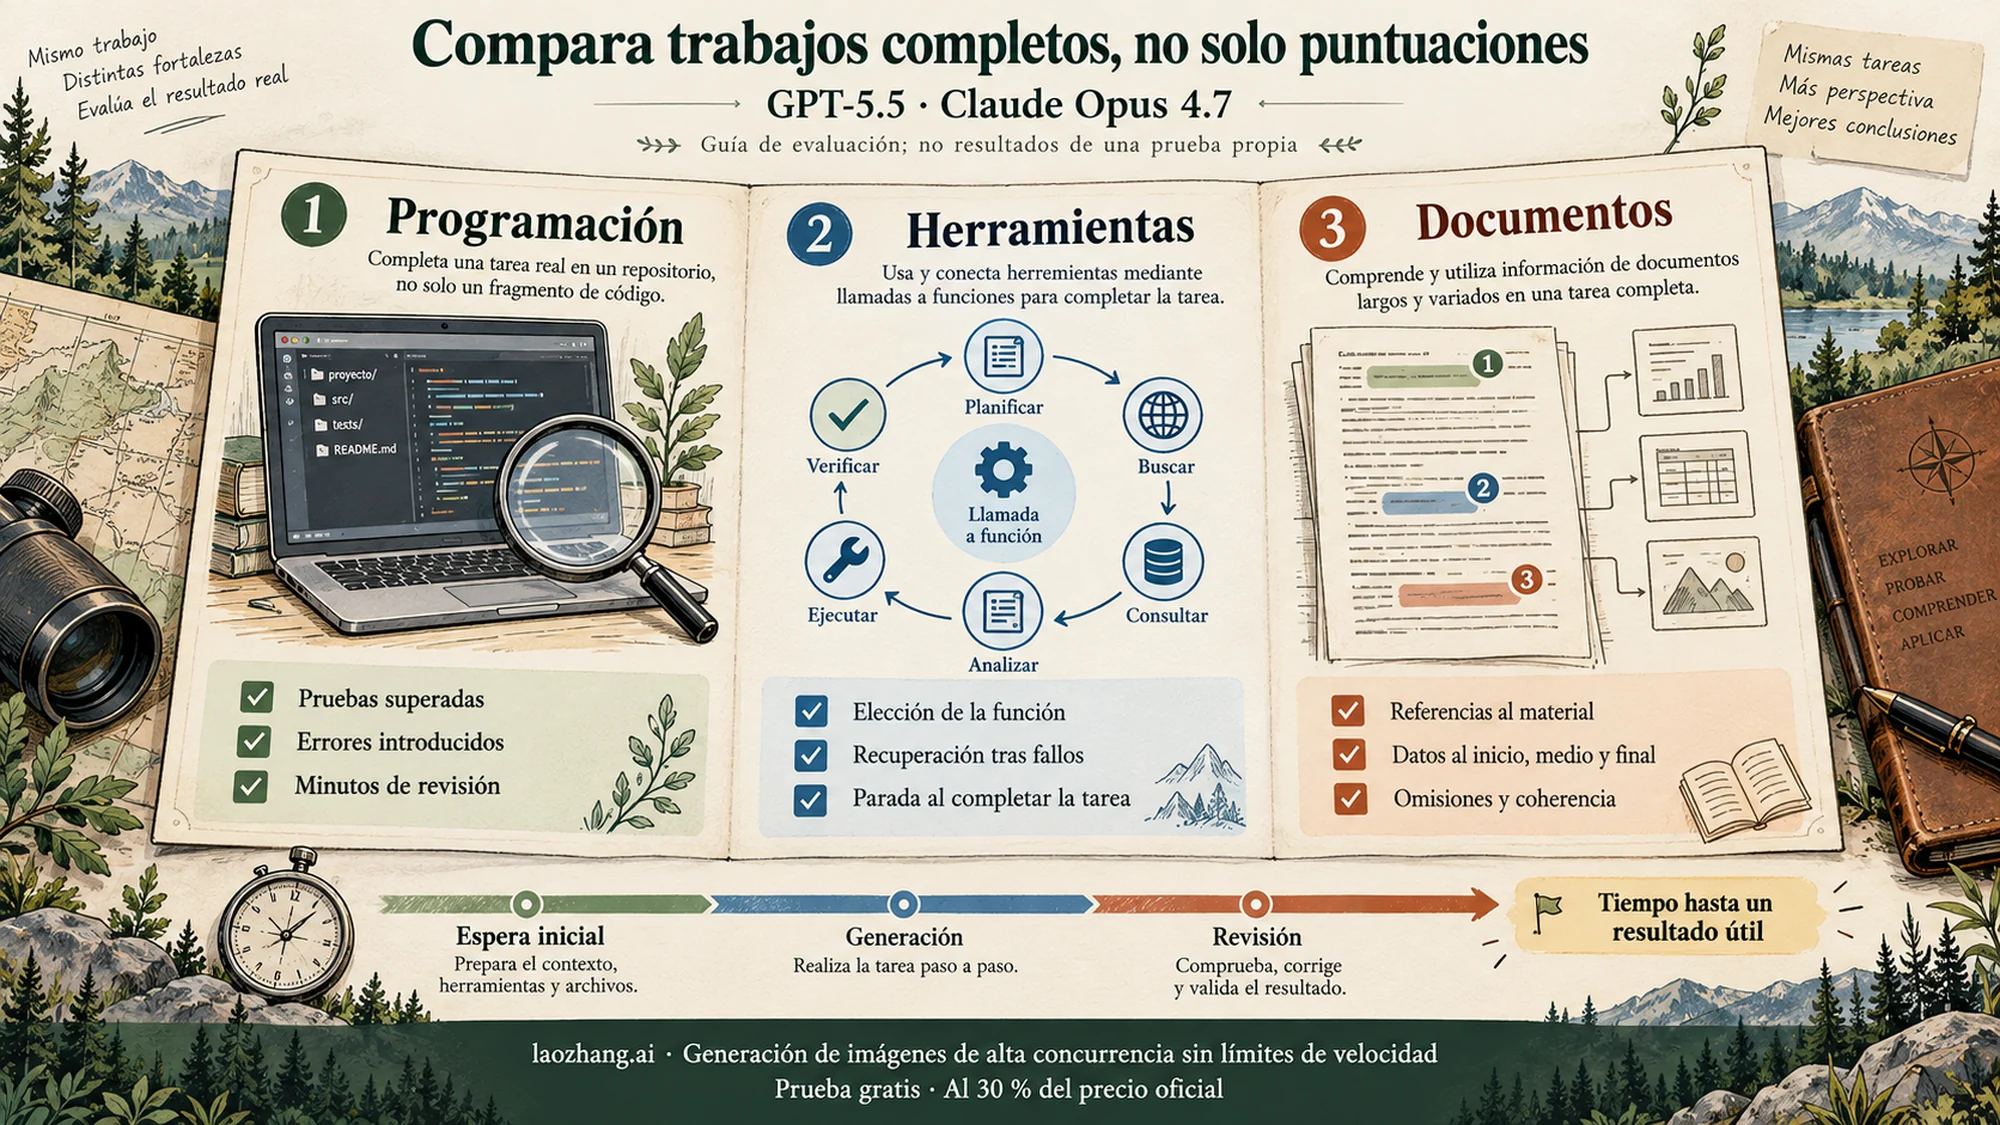
Para programación en repositorios, compara cambios que pasen las pruebas existentes, errores introducidos y minutos de revisión. Para agentes con herramientas, comprueba si el modelo selecciona la herramienta adecuada, conserva el contexto después de un fallo y se detiene al cumplir el objetivo. El soporte de herramientas no le concede por sí solo acceso al sistema de archivos ni memoria persistente entre sesiones: eso lo aporta tu aplicación.
Para documentos largos, exige respuestas con referencias al material y comprueba datos que aparezcan al principio, en medio y al final. Si necesitas imágenes, ambos aceptan entrada visual y producen texto; no deduzcas de ello capacidad nativa para generar audio o vídeo. La salida de imágenes mediante herramientas es una función distinta, con su propia integración. GPT-5.5, Opus 4.7.
Estas recomendaciones describen cómo decidir; esta guía no incluye pruebas propias de calidad, latencia ni facturación. Los benchmarks de abril que circulan en otras comparativas tampoco deben mezclarse con versiones posteriores del mismo test.
Cómo configurar las dos API sin confundir sus parámetros
Los niveles de esfuerzo orientan el comportamiento; no representan una cantidad fija de tokens y un high de OpenAI no equivale a un high de Anthropic.
| Control | GPT-5.5 | Opus 4.7 |
|---|---|---|
| Campo de esfuerzo | reasoning.effort | output_config.effort |
| Valores admitidos | none, low, medium, high, xhigh | low, medium, high, xhigh, max |
| Esfuerzo por defecto | medium | high |
| Activación del pensamiento | Configuración de razonamiento de Responses | thinking: {"type": "adaptive"}; desactivado si se omite |
| Límite de generación por petición | max_output_tokens | max_tokens |
OpenAI aconseja subir el esfuerzo cuando una evaluación muestre una mejora que compense el coste. Para agentes de programación con Opus 4.7, Anthropic recomienda comenzar con xhigh y reservar espacio suficiente de generación; su guía propone partir de 64.000 tokens y ajustar después. Para tareas acotadas, high o medium pueden ser puntos de comparación más económicos. Guía de GPT-5.5, esfuerzo de Opus 4.7.
En Opus 4.7, el antiguo thinking.type: "enabled" con budget_tokens devuelve un error 400; utiliza el modo adaptativo. Deja temperature sin especificar: está obsoleto y solo acepta su valor por defecto incluso con el pensamiento desactivado. Configuraciones de pensamiento, uso de la API.
Ejemplos nativos en Python para una tarea pequeña
Los siguientes ejemplos requieren Python, el SDK oficial correspondiente y acceso autorizado a la API elegida. Los clientes leen OPENAI_API_KEY y ANTHROPIC_API_KEY del entorno; guarda las claves en el servidor. Las guías de OpenAI y Anthropic explican esos requisitos. Aquí se muestran peticiones basadas en la documentación, sin ejecución propia.
La tarea es detectar casos de prueba para una función de descuentos, sin conectar herramientas ni modificar archivos. El límite de 8.192 tokens es un ejemplo para esta petición breve; no es un presupuesto recomendado para un agente de programación largo.
from openai import OpenAI

client = OpenAI()
resultado = client.responses.create(
    model="gpt-5.5-2026-04-23",
    input=(
        "Una función aplica un descuento a un precio y redondea a dos "
        "decimales. Propón cinco casos de prueba, incluidos límites e "
        "entradas inválidas. Explica qué decisión de negocio falta definir."
    ),
    reasoning={"effort": "medium"},
    text={"verbosity": "low"},
    max_output_tokens=8192,
)
print("Estado:", resultado.status)
print("Uso:", resultado.usage)
if resultado.status == "completed":
    print(resultado.output_text)
else:
print("No aceptar como respuesta final:", resultado.incomplete_details)import anthropic
client = anthropic.Anthropic()
resultado = client.messages.create(
model="claude-opus-4-7",
max_tokens=8192,
thinking={"type": "adaptive"},
output_config={"effort": "high"},
messages=[{
"role": "user",
"content": (
"Una función aplica un descuento a un precio y redondea a dos "
"decimales. Propón cinco casos de prueba, incluidos límites e "
"entradas inválidas. Explica qué decisión de negocio falta definir."
),
}],
)
print("Motivo de parada:", resultado.stop_reason)
print("Uso:", resultado.usage)
if resultado.stop_reason == "end_turn":
for bloque in resultado.content:
if bloque.type == "text":
print(bloque.text)
else:
print("No aceptar como respuesta final; revisar el motivo de parada.")En una respuesta normal obtendrás los casos propuestos y el uso registrado; aún debes comprobar que cumplan tu criterio. En Responses, status: "incomplete" con motivo max_output_tokens indica agotamiento del límite. Puede ocurrir sin texto visible y generar coste. En Messages, stop_reason: "max_tokens" indica truncamiento: no aceptes el texto parcial como trabajo terminado. Ambos límites incluyen pensamiento y salida. Razonamiento de OpenAI, truncamiento en Claude.
Para contar el gasto de Responses, utiliza usage.input_tokens, la parte cacheada en usage.input_tokens_details.cached_tokens y usage.output_tokens. El razonamiento de output_tokens_details.reasoning_tokens ya está incluido en la salida: no lo sumes otra vez. En Claude, separa entrada, creación y lectura de caché y salida cuando estén presentes en usage. Uso de Responses, categorías de Claude.
Si incorporas herramientas, estos ejemplos dejan de ser un bucle completo. Debes resolver las llamadas, devolver resultados y conservar los bloques necesarios. Messages exige enviar el historial explícitamente; Responses tiene su propio manejo de estado. Cambiar solo model en un cliente de OpenAI no convierte la API nativa de Anthropic en una interfaz compatible. Guía de GPT, Messages.
Cómo cambiar el modelo sin perder el control del gasto
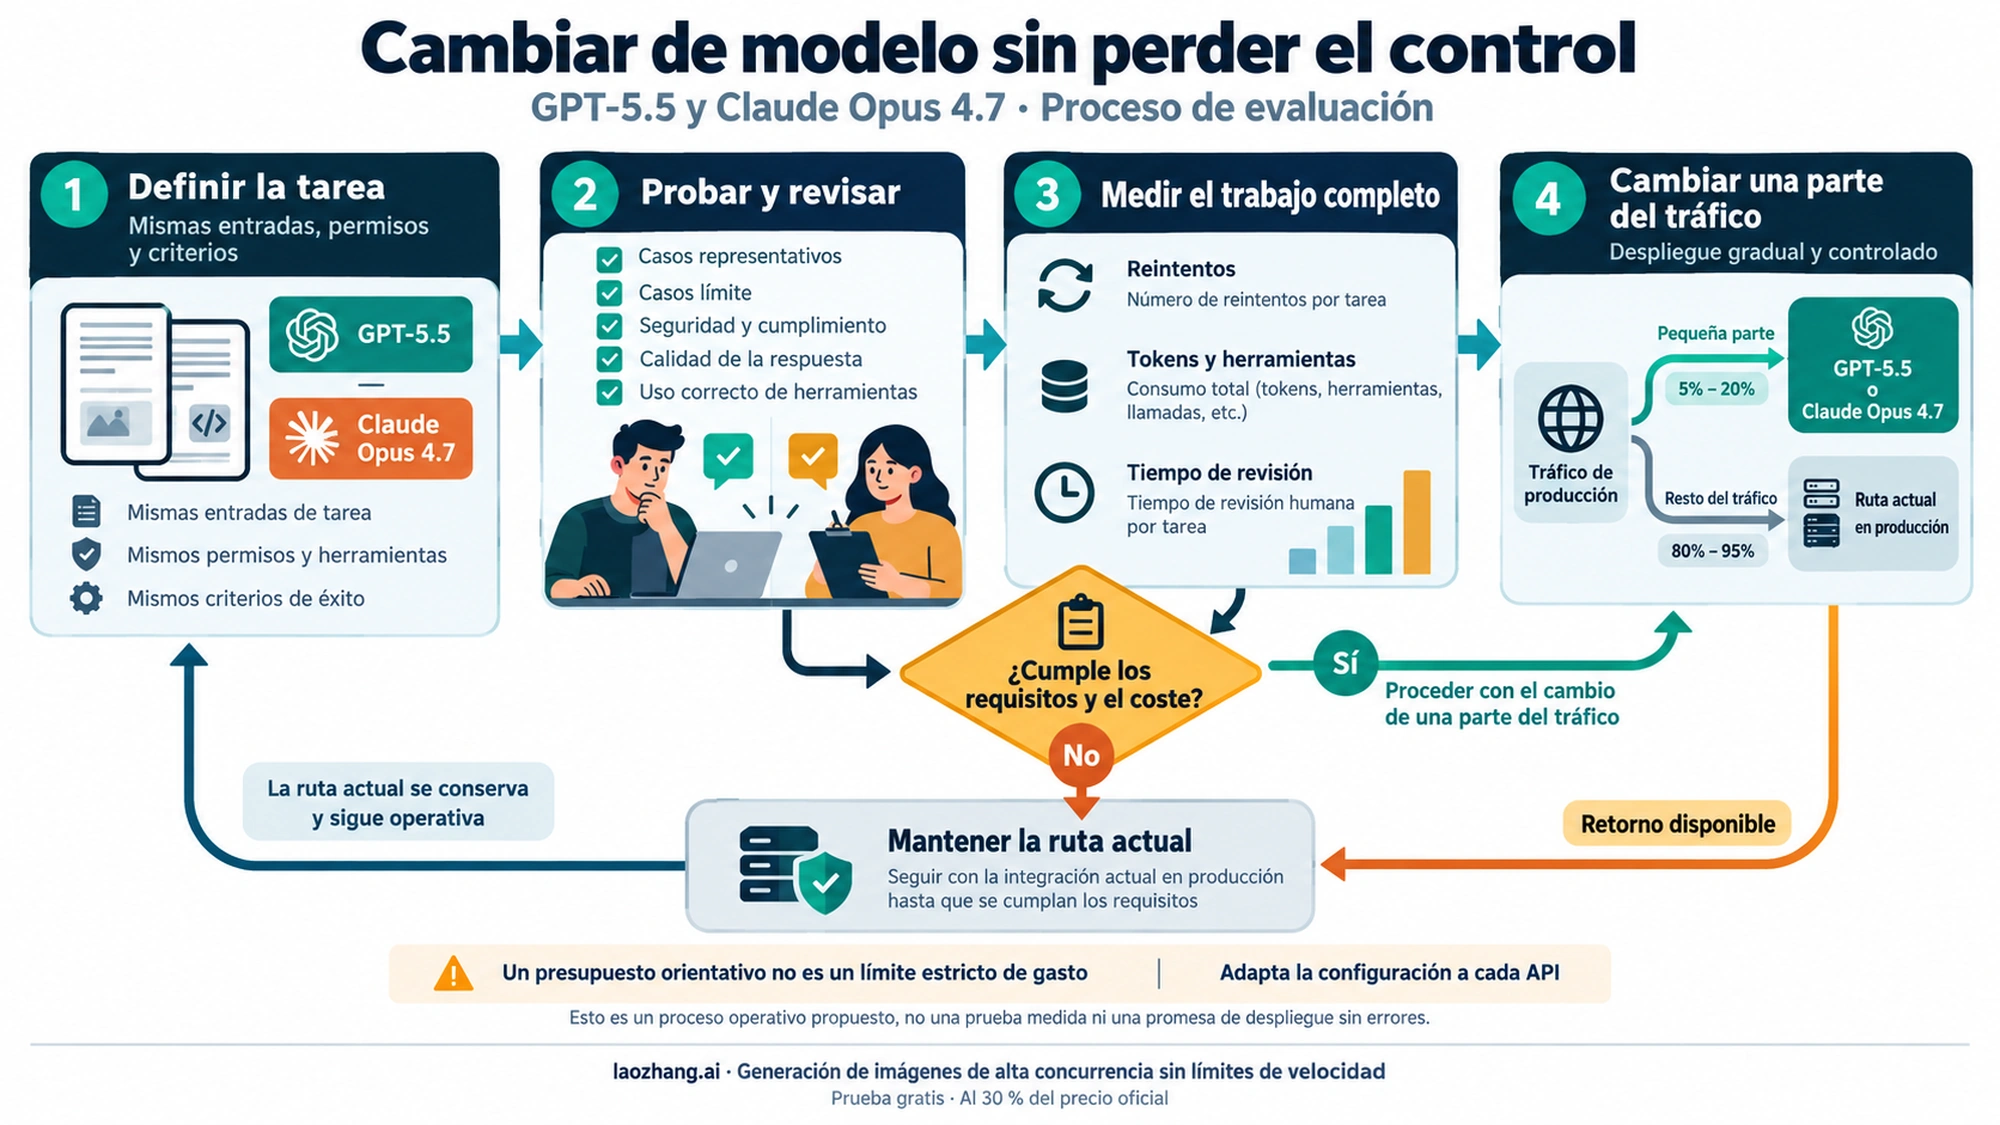
Antes de comparar, define qué significa terminar: una corrección que pasa pruebas, un informe con datos trazables o una llamada a herramientas cuyo resultado se puede verificar. Usa las mismas entradas, permisos y criterios con ambos modelos, pero adapta la configuración a cada API; copiar parámetros incompatibles perjudica la comparación.
Registra por tarea el resultado aceptado, llamadas, reintentos, uso de tokens por categoría, tiempo total y correcciones humanas. Si el candidato consume menos pero incumple un requisito, no lo promociones. Si mejora los resultados con un coste asumible, cambia primero una parte acotada del trabajo y conserva una ruta de retorno que siga disponible.
Los presupuestos de tarea de Opus 4.7 son orientativos. La beta task-budgets-2026-03-13 permite indicar output_config.task_budget, con un mínimo de 20.000 tokens. Abarca un turno de agente que puede incluir varias peticiones, pensamiento, llamadas y resultados de herramientas; el modelo puede superar el objetivo. El servidor no devuelve el presupuesto restante en usage, y max_tokens sigue limitando solo cada petición. La función se usa en Messages, no en Claude Code o Cowork. Presupuestos de tarea.
Por tanto, controla también el número de pasos, los reintentos y el gasto acumulado desde tu aplicación. Un objetivo de tokens para el modelo y un límite de generación por llamada no constituyen un techo estricto de factura para todo un agente.
Si tu decisión incluye además GPT-5.4 o Gemini, la comparación de esas tres API tiene otra selección de candidatos. Aquí la decisión sigue siendo entre GPT-5.5 y Opus 4.7.
Preguntas frecuentes
¿Tengo que esperar para usar GPT-5.5 por API?
No: la ficha actual de GPT-5.5 ya documenta su API, con gpt-5.5 y la versión fijada gpt-5.5-2026-04-23. Necesitas acceso autorizado; el nivel gratuito figura como no compatible. La retirada del 14 de octubre de 2026 de ChatGPT, Work y Codex no afecta a la API.
¿Cuál es mejor para programar: GPT-5.5 u Opus 4.7?
Si ya tienes una integración de OpenAI, empieza evaluando GPT-5.5; si usas Anthropic, empieza con Opus 4.7. Para elegir el ganador, compara correcciones aceptadas, pruebas, uso de herramientas y revisión en tu repositorio. La comparación High frente a Max de Artificial Analysis tiene un índice estimado para Opus y no demuestra un vencedor universal en programación.
¿Opus 4.7 cuesta un 20 % menos que GPT-5.5?
No con esa base de cálculo: 25 USD de salida frente a 30 USD son un 16,67 % menos. GPT cuesta un 20 % más tomando 25 como base. Son tarifas estándar por millón de tokens en el tramo corto de GPT; por encima de 272.000 tokens de entrada, GPT cobra 10 USD de entrada y 45 USD de salida. OpenAI, Anthropic.
¿GPT-5.5 Pro es lo mismo que una suscripción Claude Pro?
No. gpt-5.5-pro es otro modelo de API: admite Responses y Batch, carece de descuento de entrada cacheada y cuesta 30/180 USD por millón de tokens de entrada/salida estándar en el tramo corto. Claude Pro es un plan de suscripción. Evalúa GPT-5.5 Pro por separado si una mejora verificable en tus resultados justifica ese coste. Ficha de Pro, precios de OpenAI.
¿Los planes Claude Max y Team incluyen créditos de API?
Sí, con condiciones: Max 5x incluye 100 USD mensuales y Max 20x, 200 USD; Team aporta 20 USD por puesto estándar o 100 USD por puesto premium, agrupados con un máximo de 500 USD. Requieren un plan elegible activo durante siete días, los roles adecuados y vincular una organización de Console. Caducan por ciclo, no se acumulan ni aumentan los límites del plan. No cubren Claude Code interactivo ni plataformas asociadas; Free, Pro y Enterprise no son elegibles. La oferta efectiva y el saldo de cada cuenta deben comprobarse. Condiciones de los créditos mensuales.
¿Qué modelo elegir para imágenes o documentos muy largos?
Ambos aceptan texto e imágenes y producen texto. Para entradas de más de 272.000 tokens, Opus 4.7 ofrece una referencia de coste favorable porque mantiene tarifas estándar en su ventana de un millón; decide después según la precisión de recuperación y lectura visual en tus archivos. La capacidad publicada no garantiza calidad equivalente en todos los documentos. GPT-5.5, Opus 4.7, precio de contexto largo de Claude.
Fuentes19
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 13 oct 2026.
Fuentes19
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 13 oct 2026.
- 1.Aviso de OpenAIlearn.chatgpt.com/docs/models
- 2.estado de Opus 4.7platform.claude.com/docs/en/models/opus-4-7/overview
- 3.ficha de GPT-5.5developers.openai.com/api/docs/models/gpt-5.5
- 4.Identificadores y versionesplatform.claude.com/docs/en/about-claude/models/model-ids-and-versions
- 5.Ciclo de vida de Claudeplatform.claude.com/docs/en/about-claude/model-deprecations
- 6.Precios de OpenAIdevelopers.openai.com/api/docs/pricing
- 7.precios de Anthropicplatform.claude.com/docs/en/about-claude/pricing
- 8.Diferencias de caché entre modelosdevelopers.openai.com/api/docs/guides/prompt-caching
- 9.Artificial Analysis consultada el 13 de octubreartificialanalysis.ai/models/comparisons/gpt-5-5-high-vs-claude-opus-4-7
- 10.Guía de GPT-5.5developers.openai.com/api/docs/guides/latest-model
- 11.esfuerzo de Opus 4.7platform.claude.com/docs/en/build-with-claude/effort
- 12.Configuraciones de pensamientoplatform.claude.com/docs/en/build-with-claude/thinking-troubleshooting
- 13.uso de la APIplatform.claude.com/docs/en/claude_api_primer
- 14.OpenAIdevelopers.openai.com/api/docs/quickstart
- 15.Anthropicplatform.claude.com/docs/en/get-started
- 16.Razonamiento de OpenAIdevelopers.openai.com/api/docs/guides/reasoning
- 17.Presupuestos de tareaplatform.claude.com/docs/en/build-with-claude/task-budgets
- 18.Ficha de Prodevelopers.openai.com/api/docs/models/gpt-5.5-pro
- 19.Condiciones de los créditos mensualessupport.claude.com/en/articles/17154008-monthly-api-credits-for-max-and-team-plans