Fable 5.2 vs GPT-6 Astra: niveles equivalentes y coste por tarea
Claude Fable 5.2 en medium casi iguala a GPT-6 Astra en max (56 frente a 57 en AA) y cuesta un 39 % menos por tarea. En trabajo fácil, Astra sale más barato.
En esta página
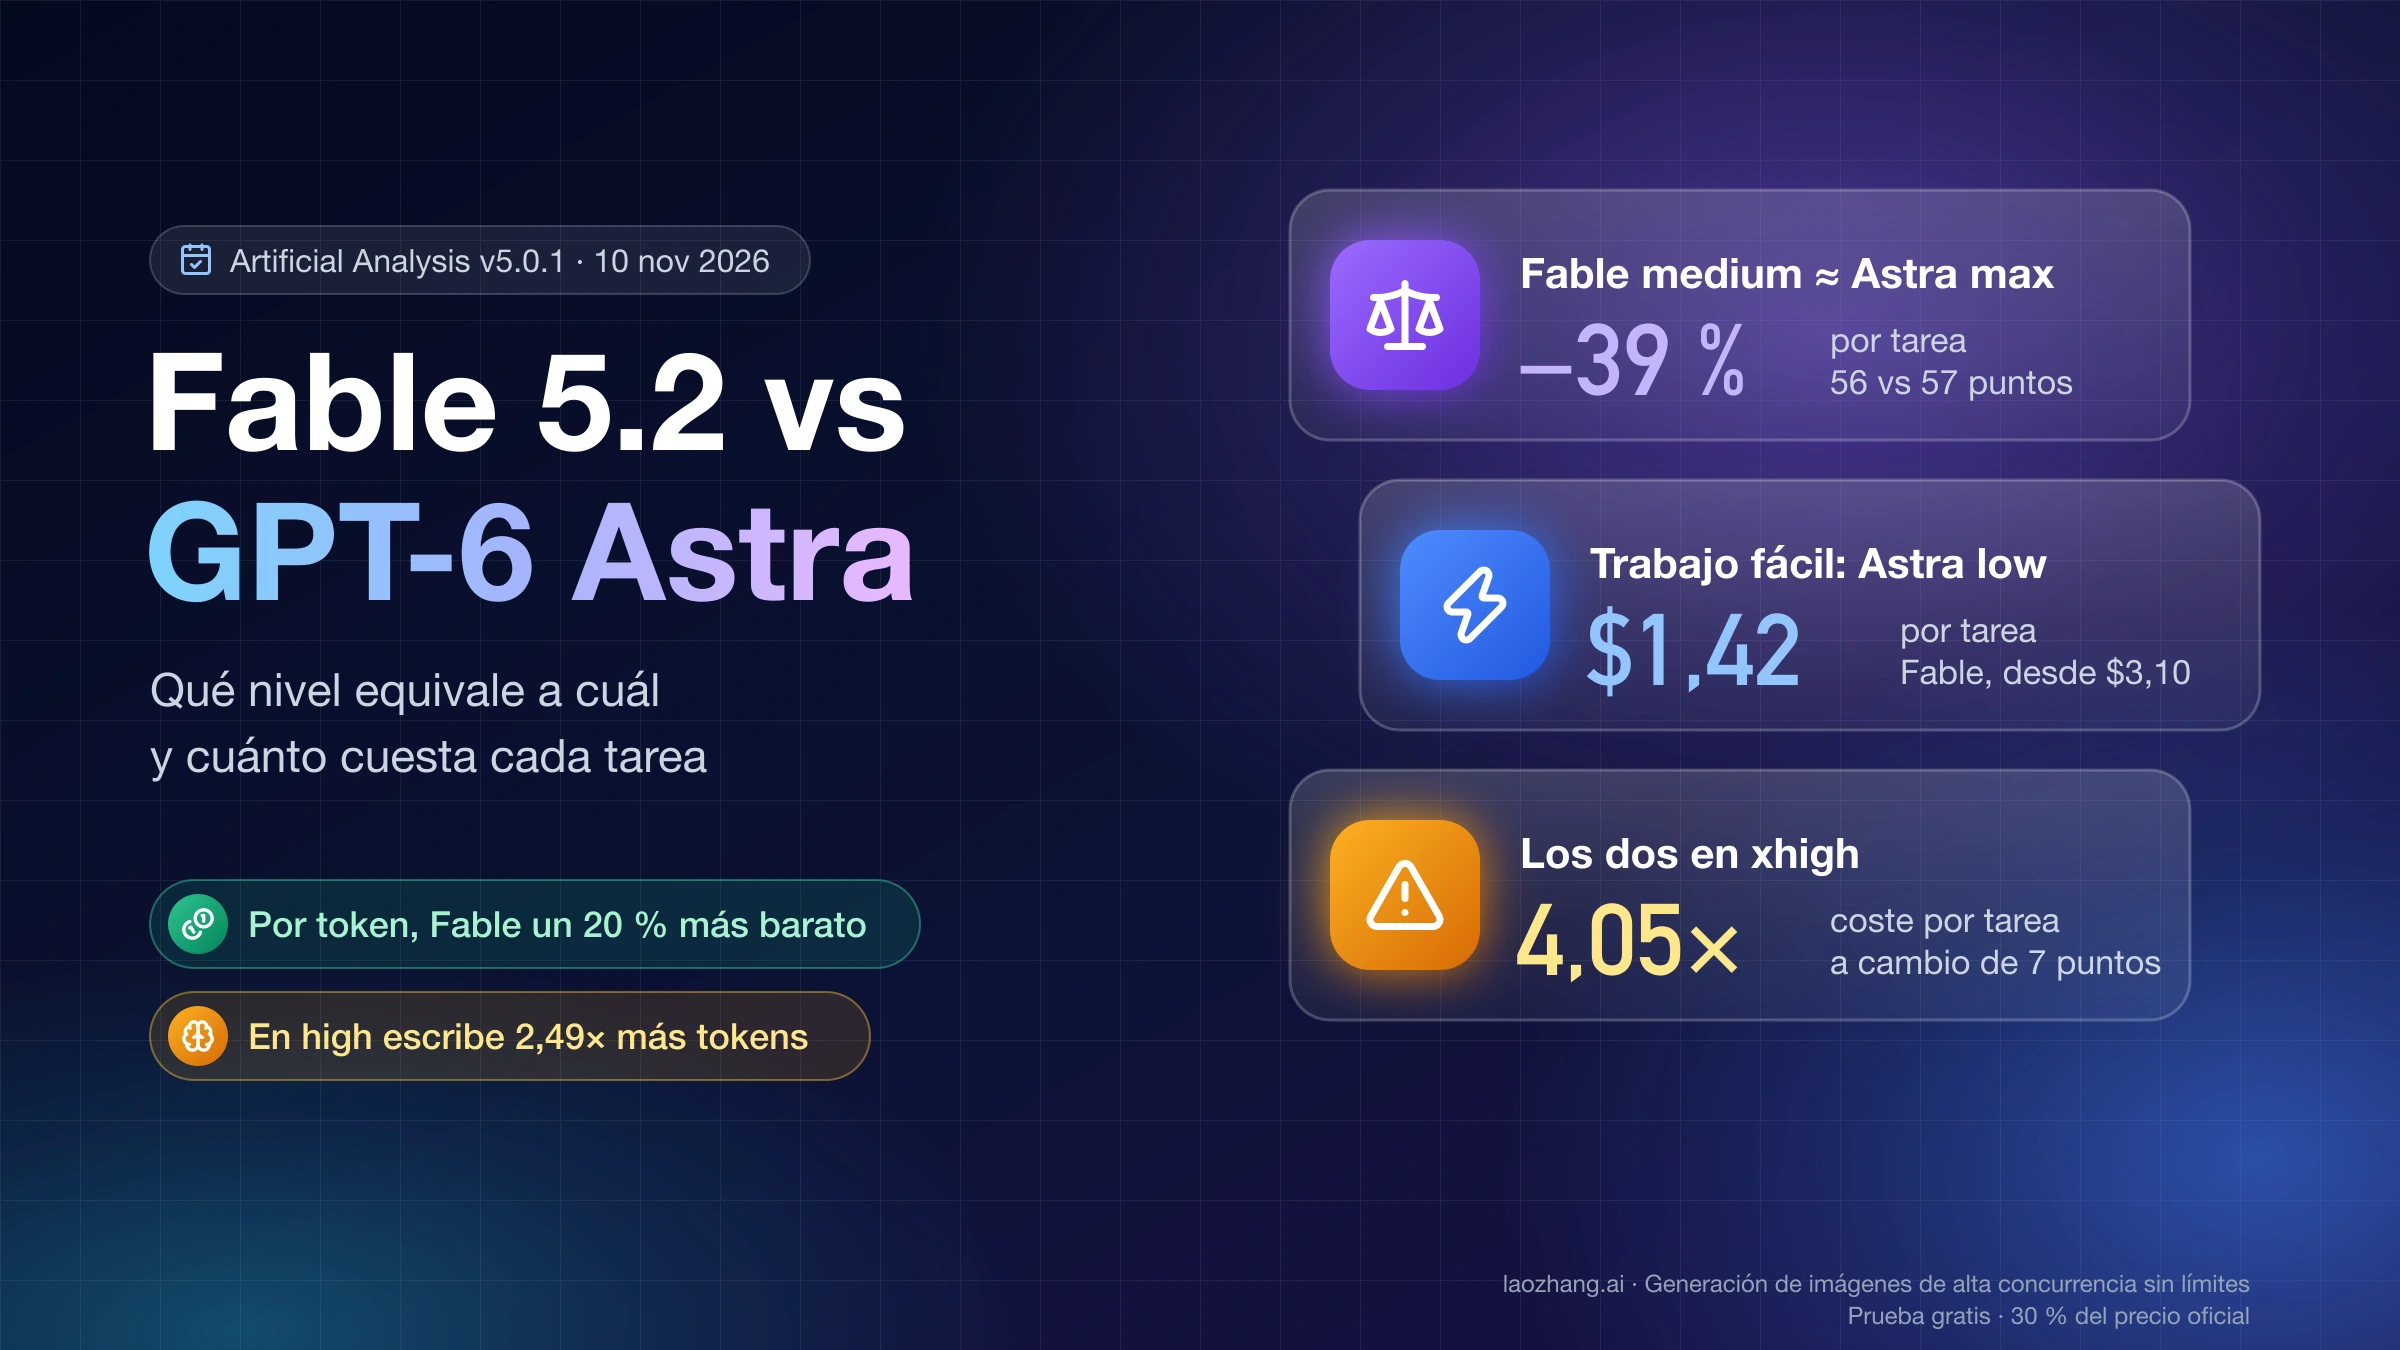
Claude Fable 5.2, que Anthropic publicó el 9 de noviembre de 2026, cobra $8 / $40 por millón de tokens de entrada y salida, un 20 % menos que GPT-6 Astra ($10 / $50), y en el índice de inteligencia de Artificial Analysis (versión 5.0.1, a 10 de noviembre de 2026) llega a 65 puntos frente a 57. Si tu trabajo es difícil, del que hoy mandas a Astra en max o que Astra no termina de resolver, pon por defecto claude-fable-5-2 en medium: saca 56 puntos, uno menos que Astra en max, por $3,80 por tarea frente a $6,24 y en 8,3 minutos frente a 22,6. Si tu trabajo es de volumen y Astra en low o medium ya lo resuelve, quédate con gpt-6-astra, porque Fable no tiene ningún nivel tan barato: su low cuesta $3,10 por tarea y el de Astra, $1,42.
No compares niveles con el mismo nombre. El nivel de razonamiento (effort) no equivale a la misma cantidad de trabajo en los dos proveedores, y «los dos en xhigh» pone a Fable a 4,05 veces el coste por tarea de Astra a cambio de 7 puntos. Una prueba con 11 tareas pequeñas hecha el 10 de noviembre de 2026, con los dos modelos en high, lo muestra en la práctica: ambos acertaron todo, pero Fable 5.2 escribió 2,49 veces más tokens de salida y costó 1,74 veces más a precio de lista, en prácticamente el mismo tiempo. Si quieres usar Fable para lo fácil, bájalo a low o medium; en high estás pagando razonamiento que esas tareas no necesitan.
Antes de mirar la calidad, revisa lo que descarta a uno de los dos. Fable 5.2 bloquea la mayor parte del trabajo de ciberseguridad y de biología de investigación, exige retención de datos de 30 días, rechaza las llamadas a herramientas forzadas y no acepta temperature. Además, en español el mismo texto cuenta 1,88 veces más tokens en Fable que en Astra, así que la entrada sin caché te sale un 50 % más cara pese a la tarifa más baja; cuando el contexto se relee desde caché, en cambio, Fable cuesta menos de la mitad.
Qué cambió el 9 de noviembre: Fable 5.2 baja de precio y sube a 65 puntos
Hasta el 9 de noviembre de 2026, la pareja era Fable 5.1 y GPT-6 Astra: los dos cobraban $10 / $50 por millón de tokens, y en la versión 4.3.2 del índice de Artificial Analysis (AA) empataban a 53 puntos. Fable 5.2 cambia las dos cosas. Anthropic bajó la tarifa un 20 % y la lectura de caché de $0,25 a $0,20, según la guía de migración a Claude Fable 5.2, y en la versión 5.0.1 del índice Fable 5.2 en max saca 65 puntos frente a los 57 de Astra en max; la página de comparación de AA muestra 49 para Fable 5.1 en max. El «mismo precio» de Fable y Astra vale, por tanto, para Fable 5.1 y deja de valer desde el 9 de noviembre.
«Astra 6» no es otro modelo: es la forma abreviada de GPT-6 Astra (gpt-6-astra), que OpenAI publicó el 3 de septiembre de 2026 y que sigue siendo su modelo general más alto. La página de precios de la API de OpenAI lista, a 10 de noviembre de 2026, gpt-6-astra, gpt-6.1-sol, gpt-6.1-terra y gpt-6-luna, y ningún GPT-6.2. Del lado de Anthropic, el identificador es claude-fable-5-2; Fable 5.1 queda como modelo heredado que sigue en servicio, y Claude Mythos 5.2 es el mismo modelo con menos salvaguardas, reservado a organizaciones verificadas. Si de momento sigues con Fable 5.1, la comparación que te sirve es GPT-6 Astra o Claude Fable 5.1: cómo elegir por tarea y coste.
Qué nivel de Fable 5.2 equivale a cada nivel de GPT-6 Astra
Empareja los niveles por resultado, no por nombre. En el índice de AA v5.0.1, a 10 de noviembre de 2026, el nivel de Fable 5.2 que alcanza a Astra max es medium, y el que alcanza a Astra high y xhigh es low. Astra low no tiene equivalente barato en Fable, y por encima de los 57 puntos de Astra max solo quedan niveles de Fable. La tabla recoge la puntuación, el coste por tarea del índice a precios de lista de la API y los minutos por tarea:
| GPT-6 Astra | Índice | Coste por tarea | Minutos | Fable 5.2 más cercano | Índice | Coste por tarea | Minutos |
|---|---|---|---|---|---|---|---|
low | 43 | $1,42 | 3,8 | ninguno tan barato; el mínimo es low | 54 | $3,10 | 6,5 |
medium | 52 | $2,73 | 6,9 | low | 54 | $3,10 | 6,5 |
high | 55 | $3,24 | 9,9 | low | 54 | $3,10 | 6,5 |
xhigh | 55 | $3,66 | 11,6 | low | 54 | $3,10 | 6,5 |
max | 57 | $6,24 | 22,6 | medium | 56 | $3,80 | 8,3 |
| sin equivalente | — | — | — | high | 62 | $9,08 | 17,7 |
| sin equivalente | — | — | — | xhigh | 62 | $14,83 | 26,3 |
| sin equivalente | — | — | — | max | 65 | $26,54 | 44,1 |
Los datos son de la comparación de GPT-6 Astra y Claude Fable 5.2 en Artificial Analysis, que calcula el coste con $8 / $40 para Fable y $10 / $50 para Astra; los emparejamientos y porcentajes salen de dividir sus columnas. A un punto de distancia, Fable cuesta menos y termina antes: medium frente a Astra max, un 39 % menos y en algo más de un tercio del tiempo; low frente a Astra high, un 4 % menos, y frente a Astra xhigh, un 15 % menos. Frente a Astra medium, Fable low saca dos puntos más y cuesta un 14 % más. Y si necesitas pasar de 57, Fable high llega a 62 por 1,46 veces el coste de Astra max y el 78 % de su tiempo.
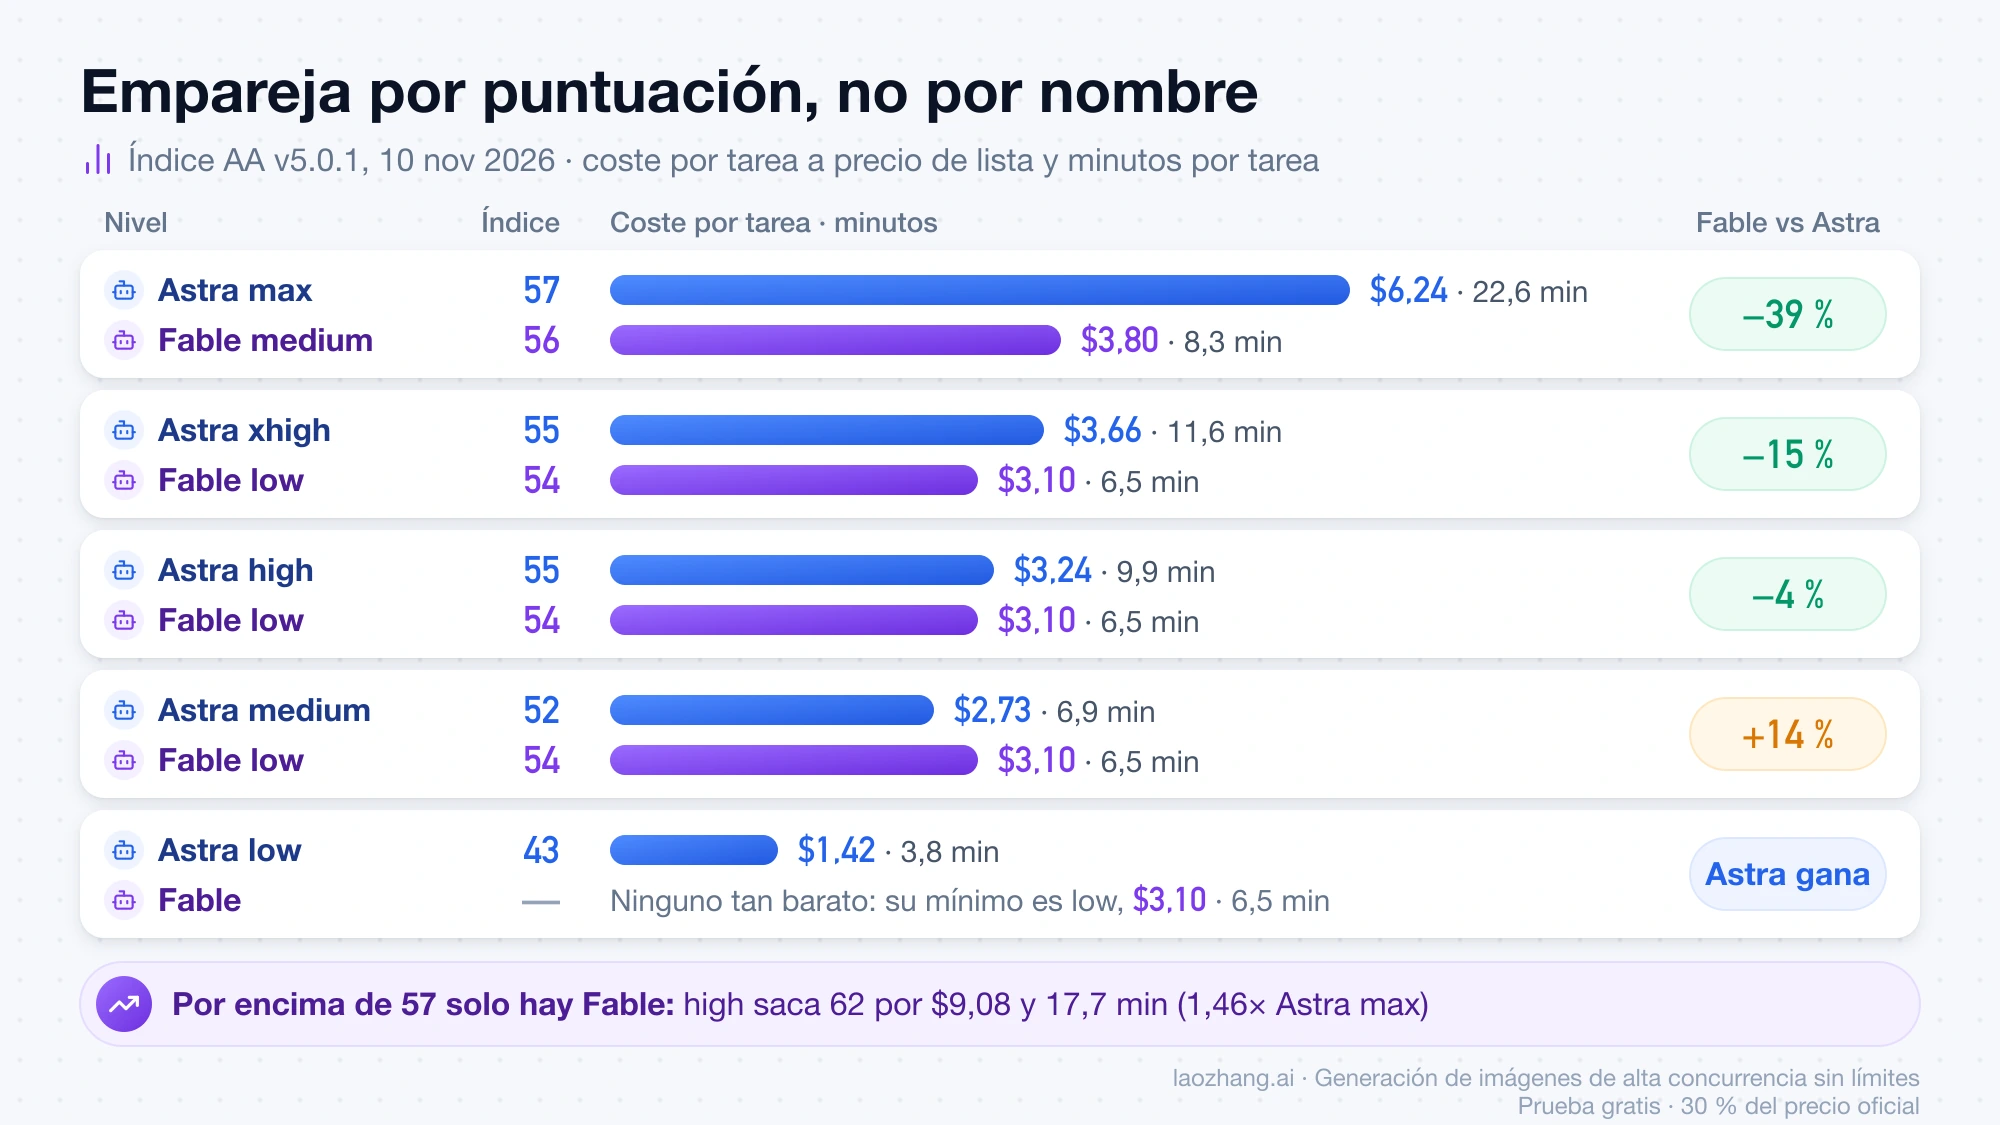
Por eso «los dos en xhigh» no es una comparación justa de coste. En xhigh, Fable saca 62 puntos por $14,83 y 26,3 minutos por tarea; Astra, 55 por $3,66 y 11,6 minutos, así que Fable gana 7 puntos a 4,05 veces el coste y 2,3 veces el tiempo. Nivel con nivel, Fable cuesta entre 1,39 veces (medium) y 4,25 veces (max) lo que Astra, por entre 4 y 11 puntos más. En este índice, además, el xhigh de Fable no supera a su high (62 los dos) y cuesta 1,63 veces más. Encaja con lo que recomienda la documentación de effort de Anthropic: empezar en high, donde «ya está la mayor parte de la ganancia», subir a xhigh solo donde hayas medido una mejora y dejar max para casos raros, porque es más lento y caro, «a menudo por una ganancia pequeña».
Fíjate también en el nivel que usas sin haberlo elegido. La API de Fable 5.2 trabaja en high por defecto, pero Claude Code y las apps de Claude usan medium, según el anuncio de Claude Fable y Mythos 5.2. OpenAI no documenta el nivel por defecto de Astra en la API, y en Codex es el que fije tu configuración. Recuerda que el índice es una media de muchas evaluaciones, no tus tareas, y que AA puede revisar sus cifras sin previo aviso; tómalo como punto de partida para elegir qué niveles probar.
Prueba del 10 de noviembre: mismo acierto, Fable 1,74 veces más caro
El 10 de noviembre de 2026 se dieron las mismas 11 tareas a GPT-6 Astra en Codex CLI 0.166.0 y a Claude Fable 5.2 en Claude Code, dos ejecuciones por modelo, los dos en high y cada uno con una cuenta de suscripción de su proveedor. Las 44 respuestas corregidas pasaron, 11 de 11 en cada ejecución. Con el mismo acierto, Fable 5.2 escribió 2,49 veces más tokens de salida y su ejecución equivalió a 1,74 veces el coste de Astra a precio de lista, en prácticamente el mismo tiempo.
Las tareas eran cuatro ejercicios pequeños corregidos con tests ocultos, un resumen en cinco puntos de un artículo de 6.723 palabras, un evaluador de expresiones, un analizador de líneas CSV, un problema de conteo resuelto sin código, un comparador de rangos semver, un cálculo con tres notas escondidas en un documento largo y una pregunta sobre la biblioteca estándar que incluía dos funciones inventadas. Los tests y los criterios de corrección estaban escritos antes de que existiera ninguna respuesta.
| Media por ejecución | Fable 5.2, high, Claude Code | GPT-6 Astra, high, Codex CLI | Fable ÷ Astra |
|---|---|---|---|
| Tareas superadas | 11 de 11 | 11 de 11 | — |
| Tokens de salida | 24.052 | 9.645 | 2,49 |
| De ellos, de razonamiento | 8.426 | 1.044 | 8,07 |
| Tiempo total | 221,8 s | 236,0 s | 0,94 |
| Coste de la salida | $0,96 | $0,48 | 2,00 |
| Coste del contexto | $1,19 | $0,75 | 1,58 |
| Total a precio de lista | $2,15 | $1,24 | 1,74 |
Los dólares son el equivalente a precio de lista de los tokens gastados, no una factura, porque los dos modelos corrieron con suscripción. La salida se calcula como tokens × tarifa: 24.052 × $40 / 1.000.000 = $0,96 para Fable y 9.645 × $50 / 1.000.000 = $0,48 para Astra. El contexto de Fable es entrada × $8 + lecturas de caché × $0,20 + escrituras de 5 minutos × $10, por millón; el de Astra, entrada sin caché × $10 + entrada en caché × $1. Codex no informó de escrituras en caché y no se cuentan; por API, OpenAI cobra esas escrituras por defecto, así que el total de Astra sería algo mayor.
Casi toda la diferencia está en el razonamiento: con la misma etiqueta high, Fable generó 8,1 veces más tokens de razonamiento que Astra. Su tarifa de salida un 20 % más baja deja el coste de la salida en el doble, no en 2,5 veces. El tiempo salió parejo, con Fable un 6 % más corto, porque genera tokens bastante más deprisa.
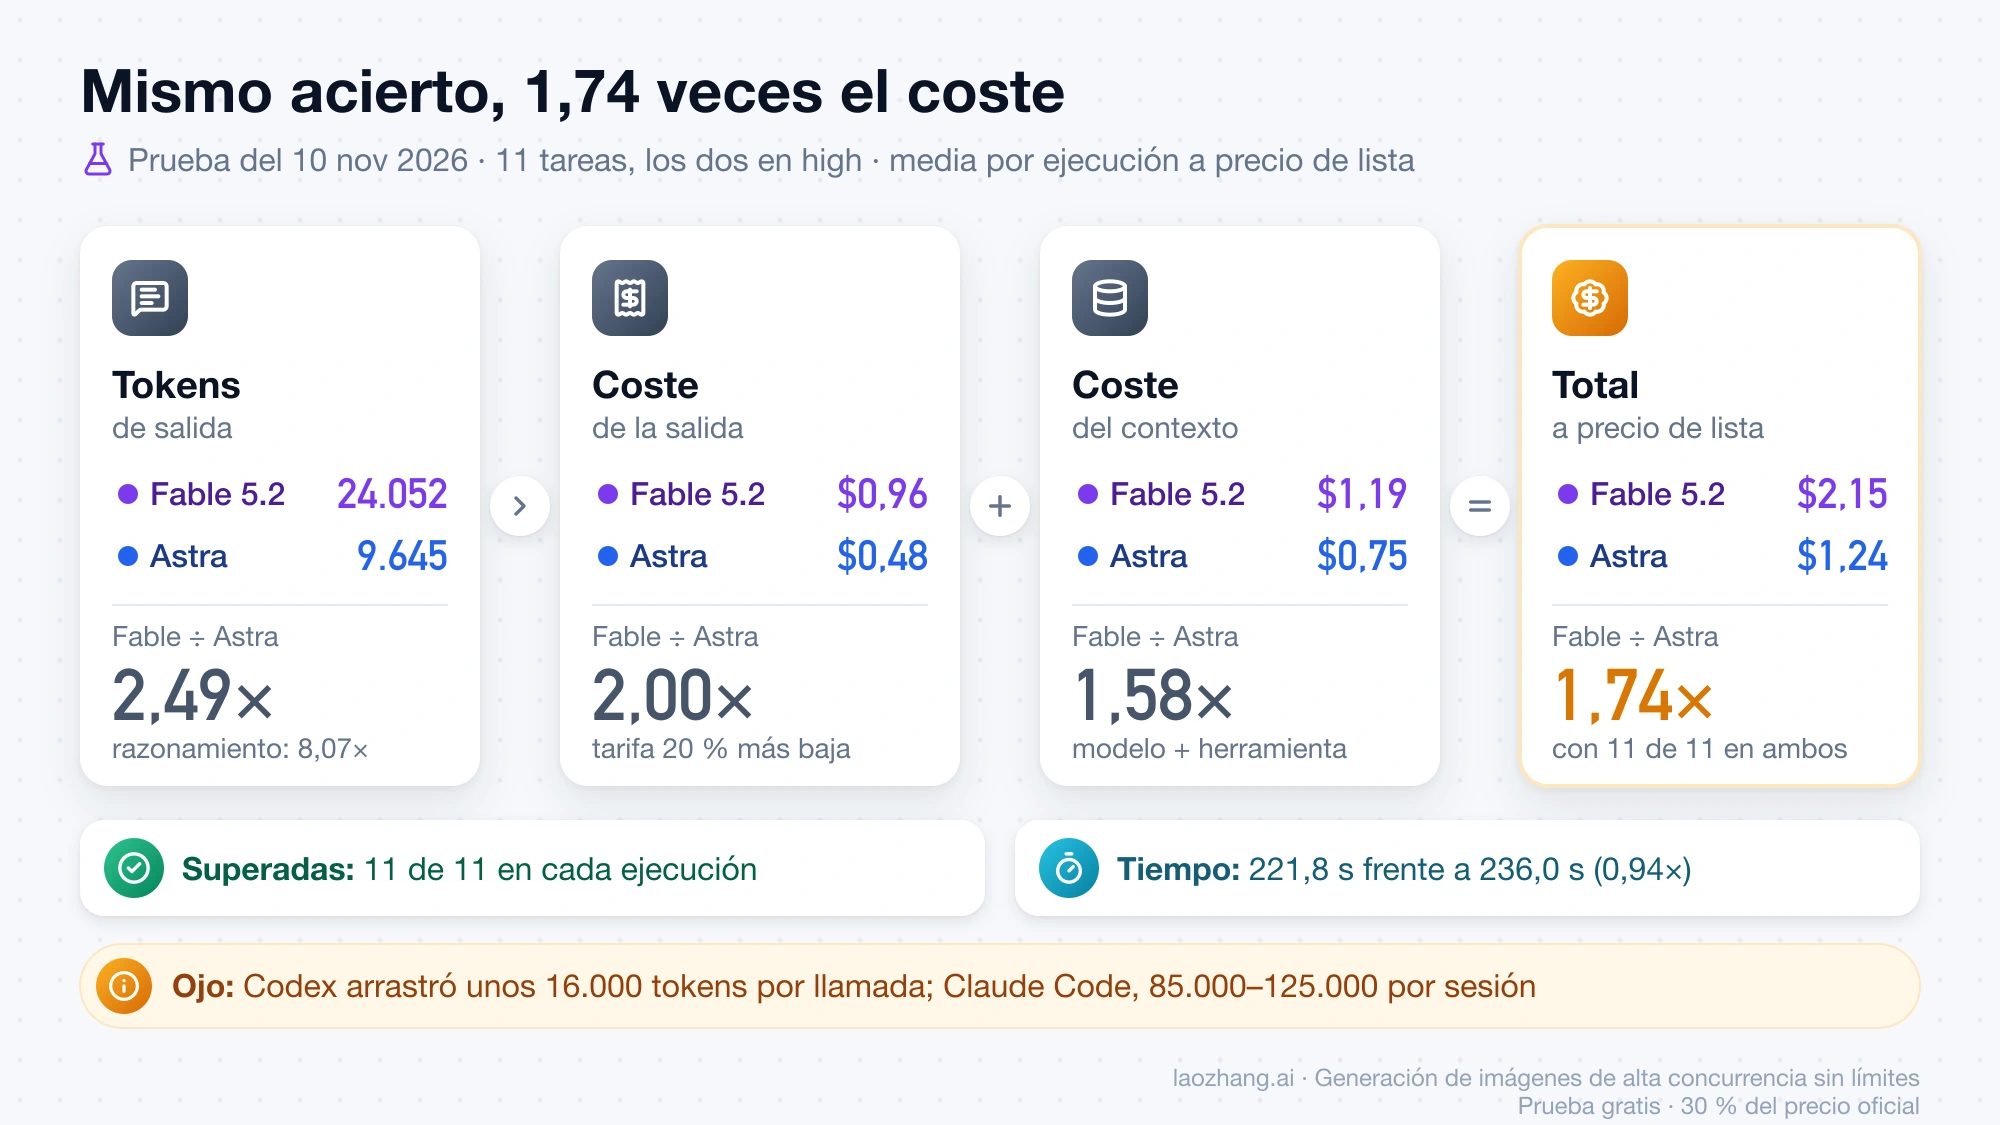
La prueba tiene límites que conviene decir claro. Son dos agentes distintos, con instrucciones de sistema, herramientas y contexto propios: Codex arrastró unos 16.000 tokens de contexto por llamada y Claude Code entre 85.000 y 125.000 por sesión, así que el coste del contexto mezcla modelo y herramienta, y los tokens de salida, los aciertos y el tiempo son la comparación más limpia. Son tareas pequeñas y bien especificadas que los dos resuelven, con dos muestras por modelo y un solo nivel; no dicen nada del trabajo difícil o largo, donde la referencia es la tabla de AA, ni de Fable en medium o low, que no se probaron.
¿Fable 5.2 es un 20 % más barato? Por token sí, por tarea no siempre
El 20 % es la diferencia de tarifa por token, no de coste por tarea. Lo que pagas por una tarea depende además de cuántos tokens escribe cada modelo, de cómo cuenta cada uno el mismo texto y de cuánto contexto se relee desde caché. Estas son las tarifas de la API directa, en dólares por millón de tokens:
| USD por millón de tokens | Fable 5.2 | GPT-6 Astra, hasta 272K de entrada | GPT-6 Astra, más de 272K de entrada |
|---|---|---|---|
| Entrada | $8 | $10 | $20 |
| Salida | $40 | $50 | $75 |
| Lectura de caché | $0,20 | $1,00 | $2,00 |
| Escritura en caché | $10 (5 min), $16 (1 h) | $12,50 (30 min), $25 (12 h) | $25 (30 min), $50 (12 h) |
| Batch | $4 / $20 | mitad de la tarifa | mitad de la tarifa |
Fuentes: precios de la API de Claude y precios de la API de OpenAI, a 10 de noviembre de 2026; las filas de contexto largo y Batch de Astra, a 26 de octubre de 2026. Fable 5.2 factura toda su ventana de contexto de 1M tokens a la misma tarifa, sin escalón.
En la salida, a igual número de tokens Fable cuesta 0,8 veces lo que Astra, pero solo si escribe lo mismo. En la prueba anterior, en high, escribió 2,49 veces más tokens y su salida costó el doble. En agentes que razonan mucho por cada respuesta, ese efecto pesa más que la rebaja de tarifa.
La caché inclina la cuenta hacia Fable cuando el contexto se relee muchas veces, porque su lectura es la quinta parte de la de Astra. Funciona distinto en cada proveedor: OpenAI cachea Astra automáticamente y cobra la escritura (1,25 veces la entrada en la de 30 minutos, 2,5 veces en la de 12 horas), salvo que pongas prompt_cache_options.mode: "explicit"; Anthropic solo cachea donde la petición marca cache_control, con escritura a 1,25 veces (5 minutos) o 2 veces (1 hora) la entrada. Aplicando el recuento de tokens de la sección siguiente, releer un contexto en inglés cuesta en Fable 1,45 × $0,20 = $0,29 por cada millón de tokens que contaría Astra, frente a $1,00; en español, 1,88 × $0,20 = $0,38. La primera escritura, en cambio, sale más cara en Fable: 1,45 × $10 = $14,50 en inglés (1,16 veces los $12,50 de Astra) y 1,88 × $10 = $18,80 en español (1,50 veces), y dura 5 minutos. Cómo marcar la caché está en Claude prompt caching: cómo activarlo, precio y cuándo sale caro.
El contexto largo sin caché también favorece a Fable. Cuando una petición pasa de 272.000 tokens de entrada, Astra cobra toda la petición a la tarifa de contexto largo, y el umbral se cuenta en tokens de Astra. Un prompt en inglés de 300.000 tokens de Astra cuesta en Astra 0,3 × $20 = $6,00 de entrada; en Fable ese texto son unos 435.000 tokens, que a $8 por millón dan $3,48 (0,58 veces). Si el texto está en español, son unos 564.000 tokens y $4,51 (0,75 veces). Los niveles de caché, Batch y modo Fast de Astra están en Precio de la API de GPT-6 Astra: coste con caché y contexto largo.
El mismo prompt en español cuenta 1,88 veces más tokens en Fable
Fable y Astra no cuentan igual el mismo texto, y el español es de los idiomas donde más se nota. El 26 de octubre de 2026 se envió el mismo fragmento a las dos API y, en español, Fable contó 1,88 veces los tokens de entrada que contó Astra. Con las tarifas actuales ($8 frente a $10), la misma entrada sin caché cuesta en Fable 1,88 × 0,8 = 1,50 veces lo que en Astra:
| Idioma del texto | Tokens en Fable ÷ tokens en Astra | Coste de entrada sin caché, Fable 5.2 ÷ Astra |
|---|---|---|
| Español | 1,88 | 1,50 |
| Inglés | 1,45 | 1,16 |
| Chino | 1,50 | 1,20 |
| Ruso | 1,56 | 1,25 |
| Coreano | 1,90 | 1,52 |
| Japonés | 1,23 | 0,98 |
El recuento se midió con Fable 5.1, a partir de los campos de uso de cada API. Se aplica a Fable 5.2 porque Anthropic indica que usa el mismo tokenizador que sus otros modelos actuales, el que llegó con Opus 4.7 y cuenta en torno a un 30 % más de tokens que el anterior. Hay un fragmento por idioma, de entre 246 y 799 caracteres, y la proporción cambia con el tipo de contenido: un artículo en inglés de 6.723 palabras dio 15.335 tokens en Fable frente a 10.106 en Astra (1,52 veces). Si tu entrada es sobre todo código o mezcla idiomas, envía un par de peticiones reales a cada modelo y compara el campo de uso. Con Fable 5.1, que costaba $10 de entrada, la misma entrada salía entre 1,23 y 1,90 veces más cara que en Astra.
¿En qué sigue siendo mejor GPT-6 Astra? GDP.pdf, CritPt y el nivel low
Astra conserva ventajas concretas en los datos de AA v5.0.1, a 10 de noviembre de 2026, y la más útil es el precio mínimo: su low resuelve las tareas del índice por $1,42 con 43 puntos, y nada de Fable baja de $3,10. En la evaluación GDP.pdf, Astra saca entre el 30,4 y el 32,2 % en todos los niveles, frente al 21,4–26,8 % de Fable. En CritPt v2 (subconjunto difícil), Astra de medium a max (70,5–72,0 %) supera a Fable en low y medium (60,0 y 61,5 %), aunque Fable en high, xhigh y max (73,0–76,5 %) vuelve a quedar por delante. En Terminal-Bench 4.0 empatan: Astra en xhigh y Fable en high y max sacan el mismo 59,6 %, y solo Fable en xhigh sube a 61,6 %.
Donde Fable saca más distancia en la misma tabla es en AA-Omniscience v1.1 (63–67 frente a 40–45 en todos los niveles), HLE-Diamond (80,2 % frente a 63,8 % en max), AutomationBench-AA (76,4 % frente a 68,5 % en max), AA-Briefcase v1.1 (1.785 frente a 1.569 de Elo en max) y FrontierCode 2.0, donde Fable en high (49,1 %) supera a Astra en max (42,4 %).
La tabla que Anthropic publicó en el lanzamiento va en la misma dirección, con cada modelo en su nivel más alto salvo indicación: FrontierSWE v2 69,9 % frente a 65,5 %, Remote Labor Index 41,3 % (Fable en high) frente a 20,8 %, Humanity's Last Exam con herramientas 74,2 % frente a 57,2 %, OSWorld 2.1 89,3 % frente a 79,5 % y Chartography 73,4 % frente a 71,0 %. Anthropic añade que en FrontierCode 2.0 Fable en high (45,3 %) supera la mejor puntuación de Astra (42,8 %) «a un coste parecido». Son cifras del propio fabricante, elegidas por él, y OpenAI no ha publicado ninguna comparación con Fable 5.2.
¿Cuál es más rápido? Fable escribe más del doble de tokens por segundo
Depende de qué midas, y hay tres medidas que no conviene mezclar. En velocidad de generación, Fable 5.2 es claramente más rápido: AA mide entre 87 y 103 tokens por segundo frente a 38–44 de Astra. En tiempo por tarea a igual puntuación también gana Fable, con 8,3 minutos en medium frente a 22,6 de Astra en max, y 6,5 en low frente a 9,9 de Astra en high. Pero nivel con nivel tarda más, porque piensa más: en high, 17,7 minutos frente a 9,9.
En la prueba del 10 de noviembre el tiempo total salió parejo (221,8 s frente a 236,0 s) aunque Fable escribió 2,5 veces más tokens, que es lo que cabe esperar con esa diferencia de velocidad. Si lo que te importa es cuánto tarda en empezar a responder, AA mide 3,4 segundos hasta el primer token de respuesta en Astra low y 6,5 en Fable low. El «hasta un 30 % más rápido» que anuncia Anthropic compara Fable 5.2 con Fable 5.1, no con Astra. Los dos tienen modos rápidos de pago: Fable 5.2 con speed: "fast", hasta 2,5 veces la velocidad de salida a $16 / $80, y Astra con Fast al doble de precio o Ultrafast a 6 veces, este solo en la Responses API.
Qué descarta a Fable 5.2 o a GPT-6 Astra antes de mirar la calidad
Algunas condiciones de tu trabajo o de tu código deciden antes que cualquier puntuación. Repasa esta lista con tu integración actual: cada punto es independiente y uno solo basta para descartar un modelo o para obligarte a cambiar código antes de probarlo. Los de Fable salen de la ficha de Claude Fable 5.2 y de su guía de migración; los de Astra, de la documentación de la API de OpenAI.
- Si trabajas en ciberseguridad de alto riesgo o en biología de investigación, Fable 5.2 bloquea la mayoría de esas tareas. En las apps, la consulta bloqueada la responde Opus 4.8 u Opus 5; en la API llega una respuesta HTTP 200 con
stop_reason: "refusal"que tu código tiene que tratar. Mythos 5.2 cubre esos usos solo para organizaciones verificadas. - Si tu organización trabaja con retención cero de datos (ZDR), Fable 5.2 no está disponible salvo autorización expresa de Anthropic: exige retención de 30 días, y sin ella la API devuelve 400
invalid_request_error. - Si tu código fuerza llamadas a herramientas con
tool_choicede tipoanyotool, Fable 5.2 devuelve 400; solo admiteautoynone. - Si fijas
temperature,top_potop_k, tienes que quitarlos para Fable 5.2. Tampoco puedes desactivar el razonamiento:thinking: {type: "disabled"}devuelve 400. - Si vienes de Fable 5.1, ten en cuenta que Fable 5.2 tiene sus propios límites de velocidad (rate limits), separados de los de 5.1.
- Si llamas a funciones por Chat Completions, Astra no te sirve tal cual: las llamadas a funciones de
gpt-6-astrasolo funcionan en la Responses API. - Si tus peticiones pasan de 272.000 tokens de entrada, Astra factura la petición entera a tarifa de contexto largo.
- Si necesitas residencia de datos con Astra, los endpoints regionales cuestan un 10 % más.
Acceso con suscripción: Claude Pro, Max y ChatGPT Plus
A 10 de noviembre de 2026, Fable 5.2 está en todos los planes de pago de Claude, no en el gratuito, y nunca es el modelo por defecto: tienes que elegirlo en el selector, o con /model fable en Claude Code. En Max, Ultra y los puestos premium está incluido, pero como mucho el 50 % del límite semanal puede ir a modelos Fable. En Pro y en los puestos estándar de Team se paga con créditos de uso, salvo durante la semana de lanzamiento: hasta el 16 de noviembre de 2026 a las 23:59, hora del Pacífico, está incluido hasta el 50 % del límite semanal. Las condiciones están en el artículo del centro de ayuda de Claude sobre los modelos Fable en tu plan y en el de la promoción de lanzamiento de Fable 5.2.
En ChatGPT, con datos a 26 de octubre de 2026, Free y Go reciben GPT-6 Luna, no Astra. Plus y Business estándar tienen aproximadamente entre 5 y 45 mensajes locales de Astra cada 5 horas en Work y Codex; Pro no tiene límite de 5 horas, y en Enterprise y Edu lo tiene que activar un administrador. Qué planes pueden elegir Astra en el chat normal no lo ha confirmado OpenAI; fuentes de terceros hablan de Pro, Business y Enterprise.
Si usas una pasarela de terceros, mira su lista de modelos antes de cambiar el identificador, porque puede no servir todavía el modelo nuevo. El 10 de noviembre de 2026, la lista de laozhang.ai (GET /v1/models) incluía gpt-6-astra, claude-fable-5-1 y claude-fable-5, pero no claude-fable-5-2.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Cómo fijar el modelo por defecto y rehacer la estimación de coste
La regla se decide por la dificultad del trabajo. Para trabajo de volumen que Astra en low o medium resuelve bien, deja gpt-6-astra por defecto: es la opción más barata de las dos y Fable no tiene nada equivalente. Si hoy usas Astra en high o xhigh, prueba claude-fable-5-2 en low; si usas Astra en max, prueba Fable en medium, y sube a Fable high solo cuando medium falle, sin pasar a xhigh salvo que lo hayas medido. Manda trabajo de Fable a Astra cuando toque ciberseguridad o biología, cuando tu organización tenga ZDR, cuando tu código fuerce herramientas o cuando la tarea sea sencilla y Fable la esté resolviendo en high; mándalo de Astra a Fable cuando Astra en max no lo resuelva o cuando la entrada pase de 272.000 tokens sin caché.
La estimación de coste conviene hacerla con tu propio trabajo, porque el idioma, la caché y la cantidad de razonamiento cambian el resultado más que la tarifa:
- Elige entre 10 y 20 tareas reales que puedas comprobar de forma objetiva: tests, valores esperados o una rúbrica.
- Ejecuta Astra en tu nivel actual y Fable en el nivel equivalente de la tabla de AA, con el mismo prompt y, si puedes, por API o con la misma herramienta.
- Guarda de cada ejecución los campos de uso: entrada sin caché, lecturas y escrituras de caché, y tokens de salida.
- Calcula el coste por tarea aceptada y quédate con el modelo más barato entre los que aprueban lo que necesitas.
coste = (entrada × P_entrada + lecturas_caché × P_lectura
         + escrituras_caché × P_escritura + salida × P_salida) / 1.000.000
coste por tarea aceptada = coste total ÷ tareas aprobadas

Fable 5.2:   P_entrada 8   P_lectura 0,20   P_escritura 10 (5 min)     P_salida 40
GPT-6 Astra: P_entrada 10  P_lectura 1      P_escritura 12,50 (30 min) P_salida 50   (hasta 272K de entrada)
Con las cifras de la prueba del 10 de noviembre, $2,15 ÷ 11 = $0,20 por tarea aprobada con Fable y $1,24 ÷ 11 = $0,11 con Astra, en tareas sencillas y con los dos en high. Si aún no tienes los tokens de Fable, estima su entrada multiplicando los de Astra por la proporción de tu idioma de la tabla anterior y vuelve a medir en cuanto puedas.
Si ninguno de los dos te sale a cuenta, hay escalones más baratos dentro de cada proveedor. En OpenAI, GPT-6.1 Sol vs Astra vs GPT-6 Sol: cuál usar y si Astra compensa; en Claude, Claude Sonnet 5.5 vs GPT-6 Astra: cuándo cambiar y qué pagas. La propia Anthropic recomienda empezar la mayoría del trabajo de programación con Opus 5.5 y subir a Fable cuando haga falta; la comparación entre ambos, escrita para la versión anterior, está en Claude Fable 5.1 vs Opus 5.5: cuál compensa y cuándo pagar más.
Fuentes9
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 10 nov 2026.
Fuentes9
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 10 nov 2026.
- 1.guía de migración a Claude Fable 5.2platform.claude.com/docs/en/models/fable-5-2/migration-guide
- 2.página de precios de la API de OpenAIdevelopers.openai.com/api/docs/pricing
- 3.comparación de GPT-6 Astra y Claude Fable 5.2 en Artificial Analysisartificialanalysis.ai/models/releases/comparisons/gpt-6-astra-vs-claude-fable-5-2
- 4.documentación de effort de Anthropicplatform.claude.com/docs/en/build-with-claude/effort
- 5.anuncio de Claude Fable y Mythos 5.2anthropic.com/claude-fable-and-mythos-5-2
- 6.precios de la API de Claudeplatform.claude.com/docs/en/about-claude/pricing
- 7.ficha de Claude Fable 5.2platform.claude.com/docs/en/models/fable-5-2/overview
- 8.los modelos Fable en tu plansupport.claude.com/en/articles/15424964
- 9.promoción de lanzamiento de Fable 5.2support.claude.com/en/articles/17506494