Kimi K3.1 Pro 和 GPT-6.1 Sol 对比:同标价,单任务成本差 2.9 倍
标价同为每百万 token $2/$10,AA 测试中 K3.1 Pro 每任务 $2.11、Sol 最高档 $0.72;超长提示用 K3.1 Pro,缓存循环、批处理用 Sol。
文章目录
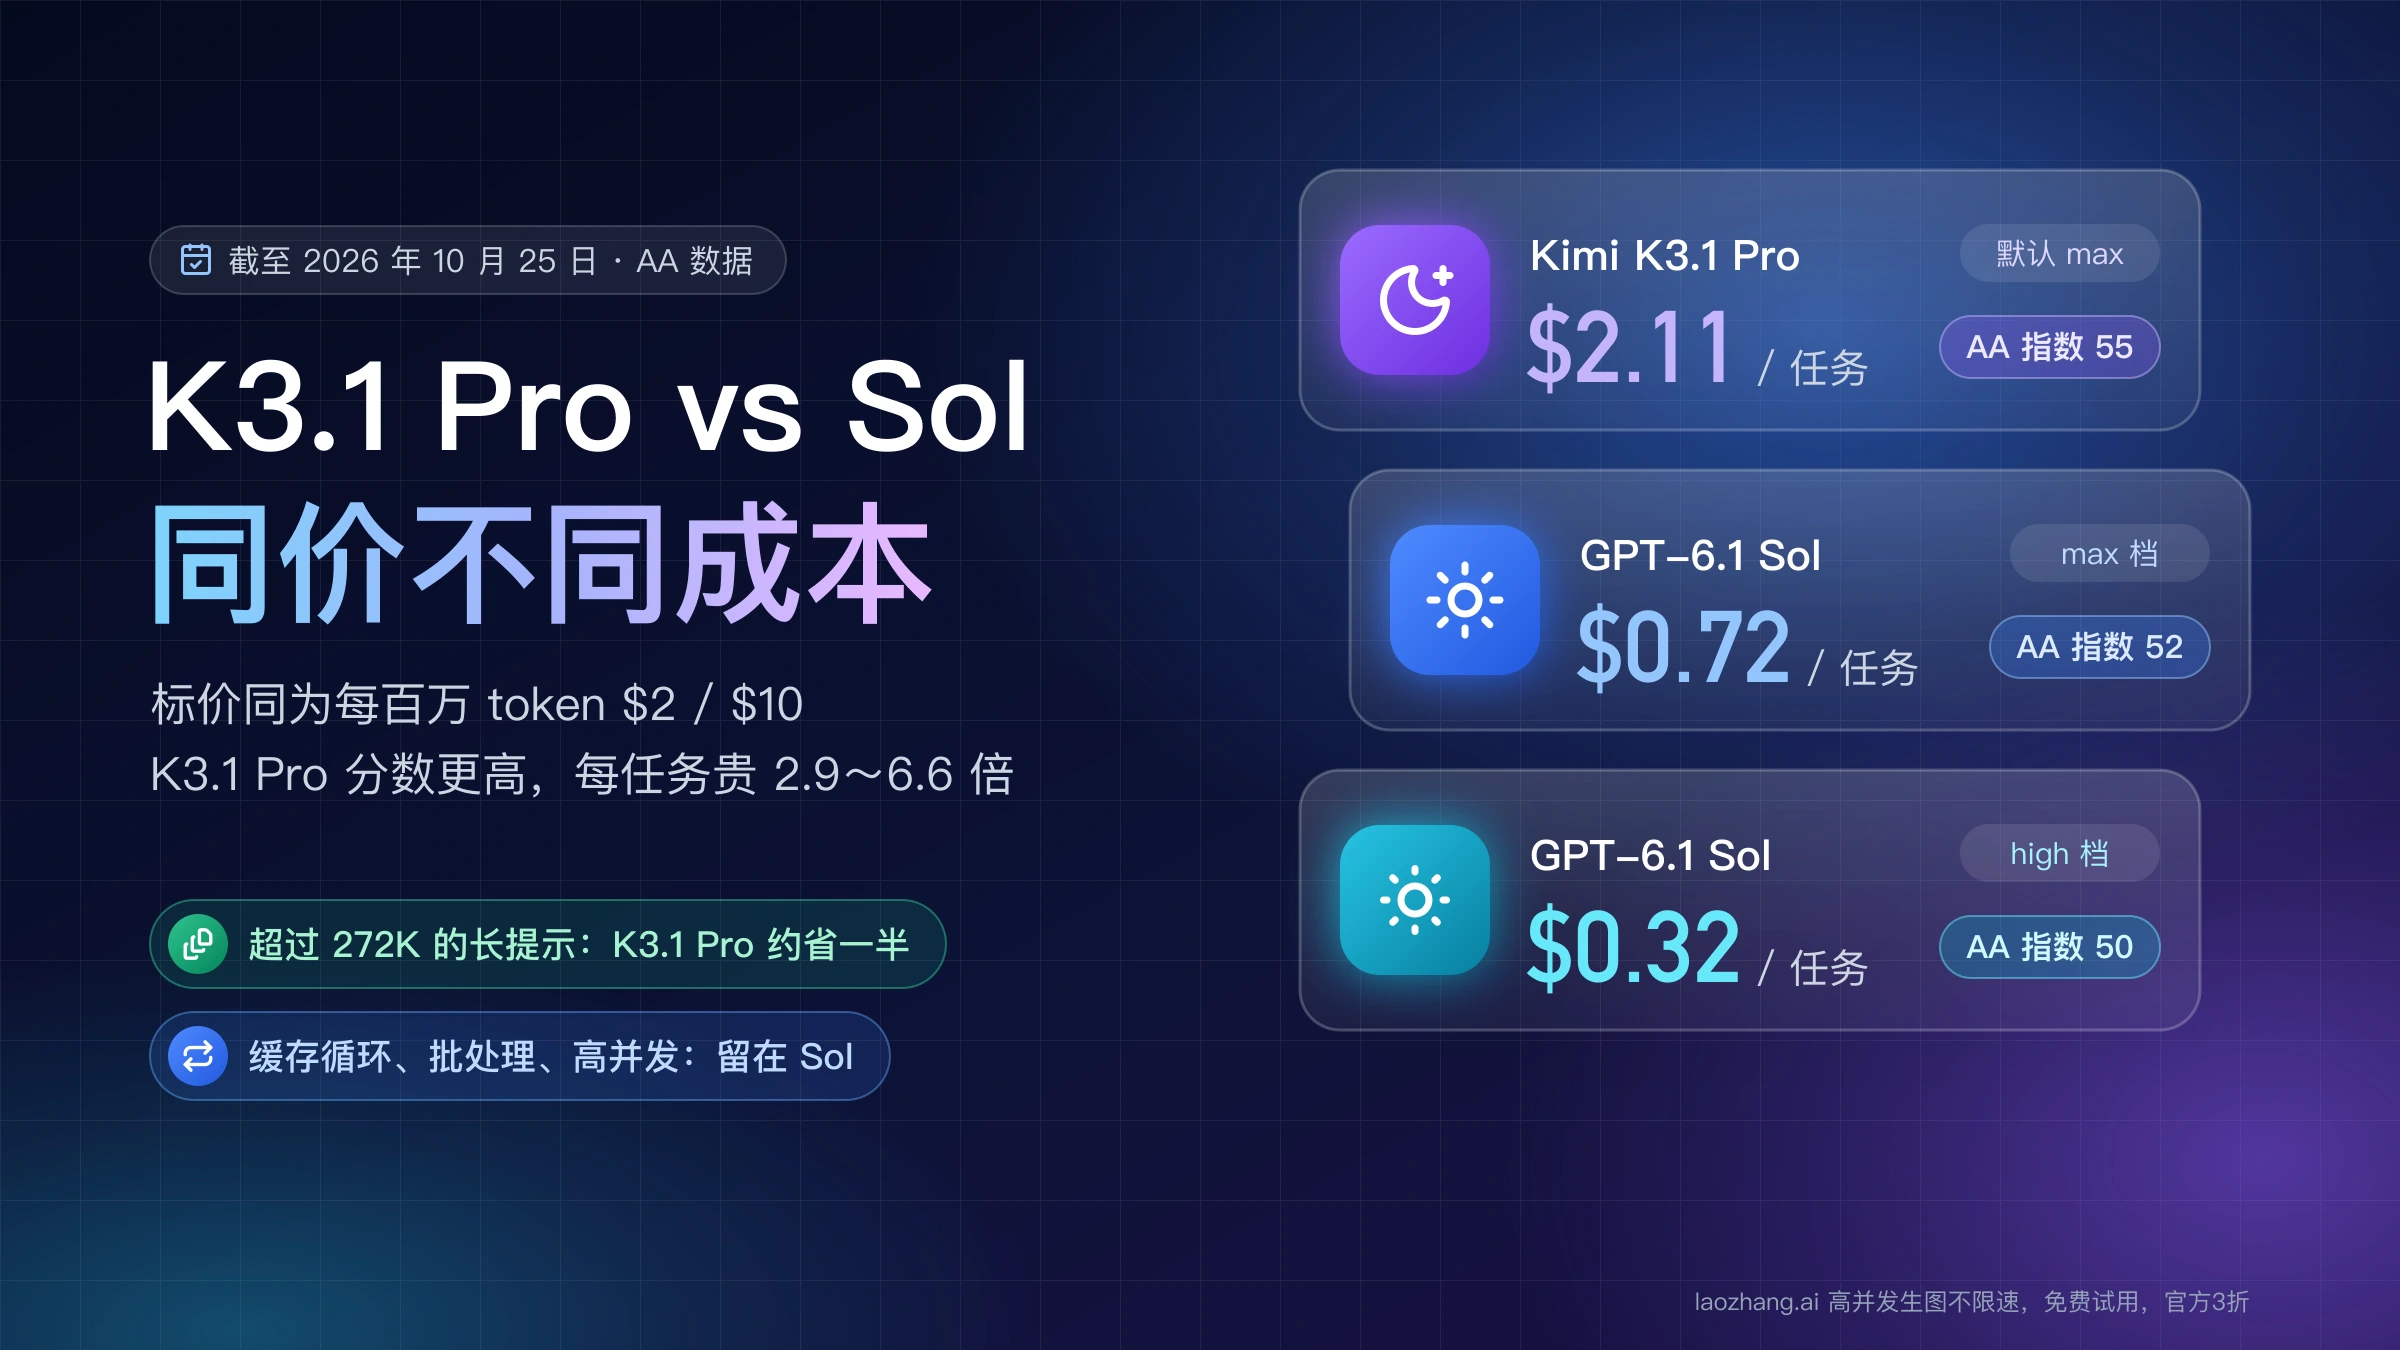
截至 2026 年 10 月 25 日,Kimi K3.1 Pro(kimi-k3.1-pro,10 月 23 日发布)和 GPT-6.1 Sol(gpt-6.1-sol)的 API 标价完全一样:每百万 token 输入 $2、输出 $10。差别在每个任务花掉多少 token。Artificial Analysis(下称 AA)用同一套方法测了两者:K3.1 Pro 在默认的 max 推理强度下智能指数 55,每道题成本 $2.11;Sol 推理强度开到 max 是 52 分、$0.72,开到 high 是 50 分、$0.32。K3.1 Pro 的分数确实高过 Sol 的每一档,代价是每任务贵 2.9 倍(对 Sol max)到 6.6 倍(对 Sol high)。
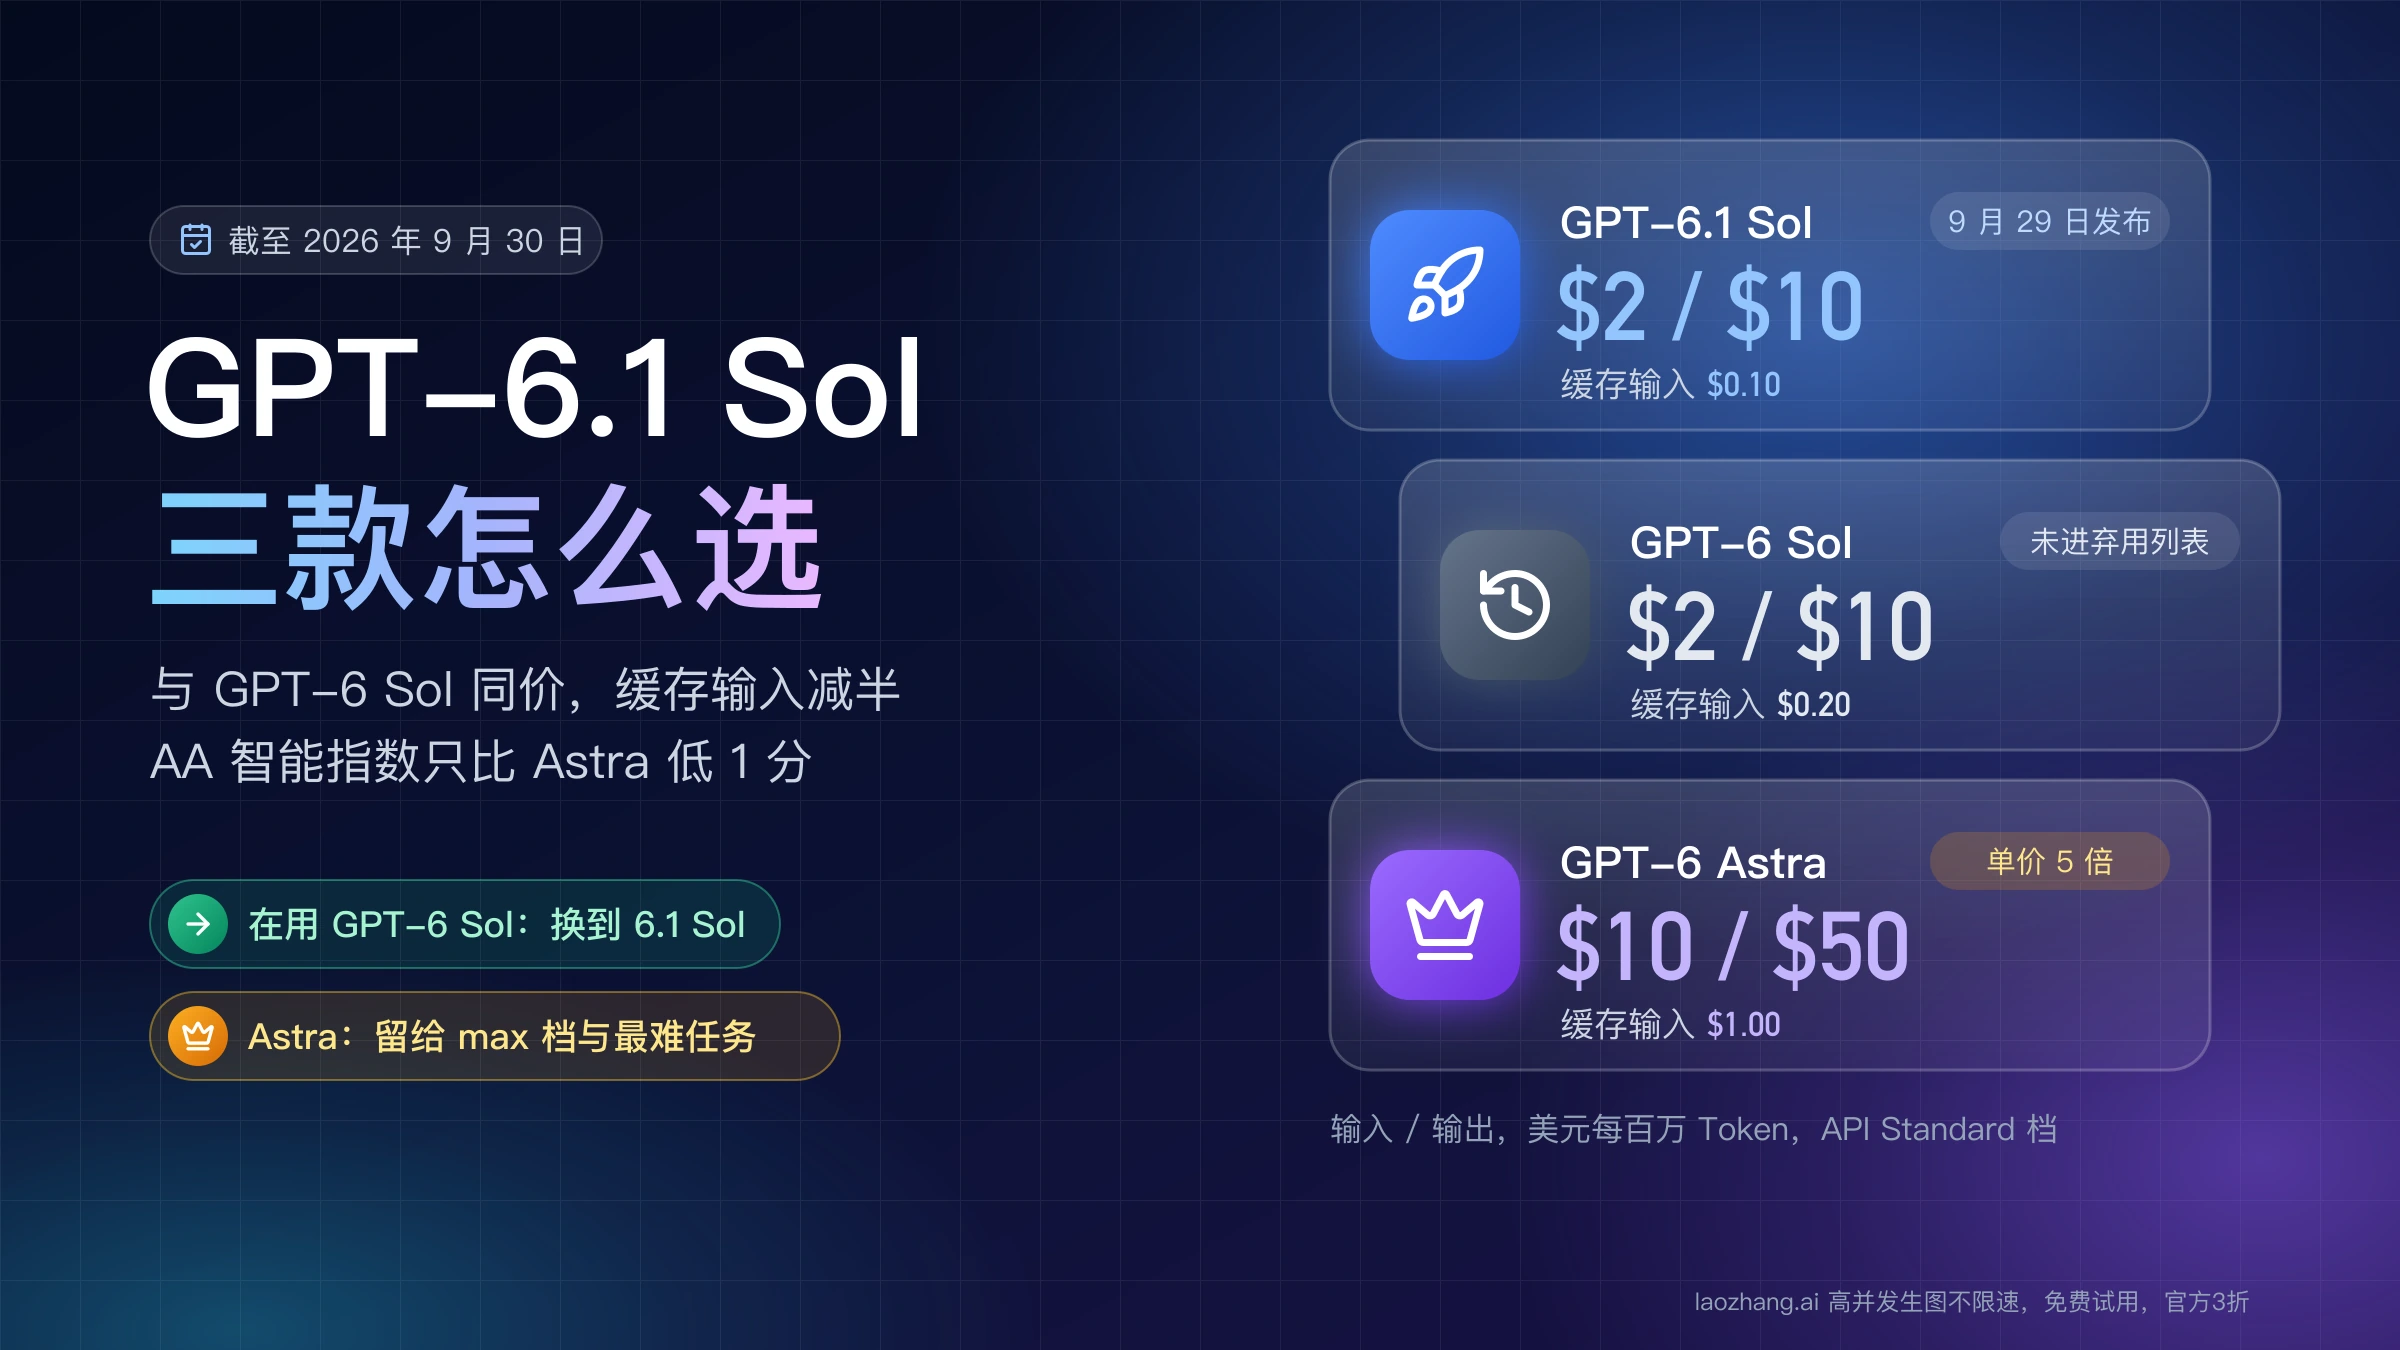
所以,已经在用 gpt-6.1-sol 跑 API 或 Codex 的话,不必整体迁移:把 Sol 留作默认,只把两类任务分给 kimi-k3.1-pro。一类是 Sol 提高推理强度后仍然做不好的 Agent 长任务,AA 的 Terminal-Bench 4.0 里 K3.1 Pro 是 67%,Sol max 是 56%;另一类是单次输入超过 272K token 的长提示,Sol 在这里整单涨价而 K3.1 Pro 不涨,同样 500K 的提示便宜约一半。带缓存的多轮循环、能走批量接口的离线任务、需要高并发的服务,继续用 Sol 更省。在国内直接调用时,OpenAI API 的支持地区里没有中国大陆和香港;K3.1 Pro 可以在 Kimi 国内平台充值 10 元后按人民币计费使用。
实际跑过的只有三项,都在 2026 年 10 月 25 日:读取 OpenRouter 公开 API 里两个模型的托管端点,用本机脚本按两家标价复算几种负载的成本,读取 laozhang.ai 的模型列表。没有拿同一批提示对两个模型做质量测试,下文的分数和速度都来自 AA,条件随每处数字给出。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
同样 $2/$10,K3.1 Pro 每任务 $2.11、Sol 最高档 $0.72
每 token 同价不等于每个任务同价,因为两者完成同一道题输出的 token 数差很多,而输出里包含推理 token。按 AA 截至 2026 年 10 月 25 日的 Kimi K3.1 Pro 与 GPT-6.1 Sol 对比页,K3.1 Pro 平均每道题输出约 55,000 个 token(其中约 35,000 个是推理),Sol max 约 38,000 个,Sol high 只有约 13,000 个。AA 的每任务成本按两家标价把输入、缓存命中、缓存写入、推理和回答 token 都算了进去。
| 配置 | AA 智能指数 | 每任务成本 | 每任务输出 token | 每任务耗时 |
|---|---|---|---|---|
K3.1 Pro,默认 max | 55 | $2.11 | 约 55,000 | 618 秒 |
Sol max | 52 | $0.72 | 约 38,000 | 680 秒 |
Sol xhigh | 51 | $0.39 | 约 18,000 | 342 秒 |
Sol high | 50 | $0.32 | 约 13,000 | 257 秒 |
Sol medium(默认) | 48 | $0.21 | 约 8,000 | 168 秒 |
Sol low | 42 | $0.13 | 约 4,000 | 83 秒 |
表里有两个容易看错的地方。第一,AA 只测了 K3.1 Pro 的默认档 max,它的 low 和 high 花多少钱、得多少分都没有公布,所以“同一推理强度下谁更便宜”目前没有可比数据;Sol 没有任何一档到 55 分。第二,“默认对默认”并不是同强度:K3.1 Pro 默认 max,Sol 默认 medium,代码里不写推理强度时,K3.1 Pro 每任务的花费约是 Sol 的 10 倍($2.11 对 $0.21),分数高 7 分。
K3.1 Pro 的 3 分领先值不值,可以换算成通过率来判断。每个合格结果的成本等于每任务成本除以通过率,所以在你的任务上,K3.1 Pro 的通过率至少要达到 Sol max 的 2.93 倍、Sol high 的 6.6 倍,每个合格结果才不比 Sol 贵。比如 Sol max 只能做对 30% 的任务,K3.1 Pro 要做对约 88% 才打平;Sol max 能做对约 34% 以上(对 high 约 15% 以上)的任务时,K3.1 Pro 即使全部做对,每个合格结果也比 Sol 贵。只有在一次失败的返工代价远高于 API 费用时,这条线才可以放宽。
速度上,AA 测得 K3.1 Pro 2.97 秒开始输出推理,约 30 秒才出现第一个回答 token;Sol max 的首个 token 要 162 秒,因为它的推理过程不作为回答流式输出。K3.1 Pro 和 Sol max 跑完一道题都要 10 分钟左右,对延迟敏感的对话场景,Sol 的 low、medium 每任务 83 秒和 168 秒更合适;K3.1 Pro 降到 low 后的耗时 AA 没有测。Kimi 另有一个模型 ID kimi-k3.1-pro-highspeed,官方称速度是 K3.1 Pro 的 2~3 倍,价格翻倍,它是单独的模型,不是请求里的开关。
“超越 GPT-6”说的是谁:AA 子项里 K3.1 Pro 赢 Agent,Sol 赢知识可靠性
“多项测试超越 GPT-6”出自 Kimi 发布时的成绩表,那张表对比的是 GPT-6 Astra 和 Claude Opus 5.5,没有 GPT-6.1 Sol。比如厂商公布的 Terminal-Bench 4.0 成绩是 K3.1 Pro 65.7%、GPT-6 Astra 58.2%,测法和 AA 不同,不能拿来和 AA 给 Sol 的分数直接比。能把 K3.1 Pro 和 Sol 放在同一套方法下比较的,截至 2026 年 10 月 25 日只有 AA:总分 55 对 52,K3.1 Pro 在 AA 的 215 个模型配置里排第 4,Sol max 排第 13。
| AA 子项 | K3.1 Pro | Sol max | 领先方 |
|---|---|---|---|
| GDPval-AA v2.1 | 1846 | 1596 | K3.1 Pro |
| AA-Briefcase v1.1 | 1678 | 1555 | K3.1 Pro |
| AutomationBench-AA | 73% | 65% | K3.1 Pro |
| Terminal-Bench 4.0 | 67% | 56% | K3.1 Pro |
| SciCode | 61% | 54% | K3.1 Pro |
| AA-LCR v1.1(长文阅读推理) | 86% | 83% | K3.1 Pro |
| Humanity's Last Exam | 52% | 53% | 基本持平 |
| GDP.pdf | 31% | 31% | 持平 |
| CritPt(物理研究级推理) | 25% | 32% | Sol |
| AA-Omniscience(知识可靠性) | 30 | 42 | Sol |
K3.1 Pro 的优势集中在 Agent 类任务:AA-Briefcase 是 AA 自己做的 Agent 知识工作测试,Terminal-Bench 考的是在终端里完成任务,加上同属 Agent 类的 GDPval-AA 和 AutomationBench,K3.1 Pro 在这四项上全部领先,Terminal-Bench 差了 11 个百分点。Sol 领先的两项方向不同:AA-Omniscience 是 AA 的知识可靠性指数,同时看答对率和不编造的比例,Sol 高 12 分;CritPt 是研究级物理推理,Sol 高 7 个百分点。如果你的任务以查事实、写需要引用的报告为主,K3.1 Pro 的总分领先不一定兑现。
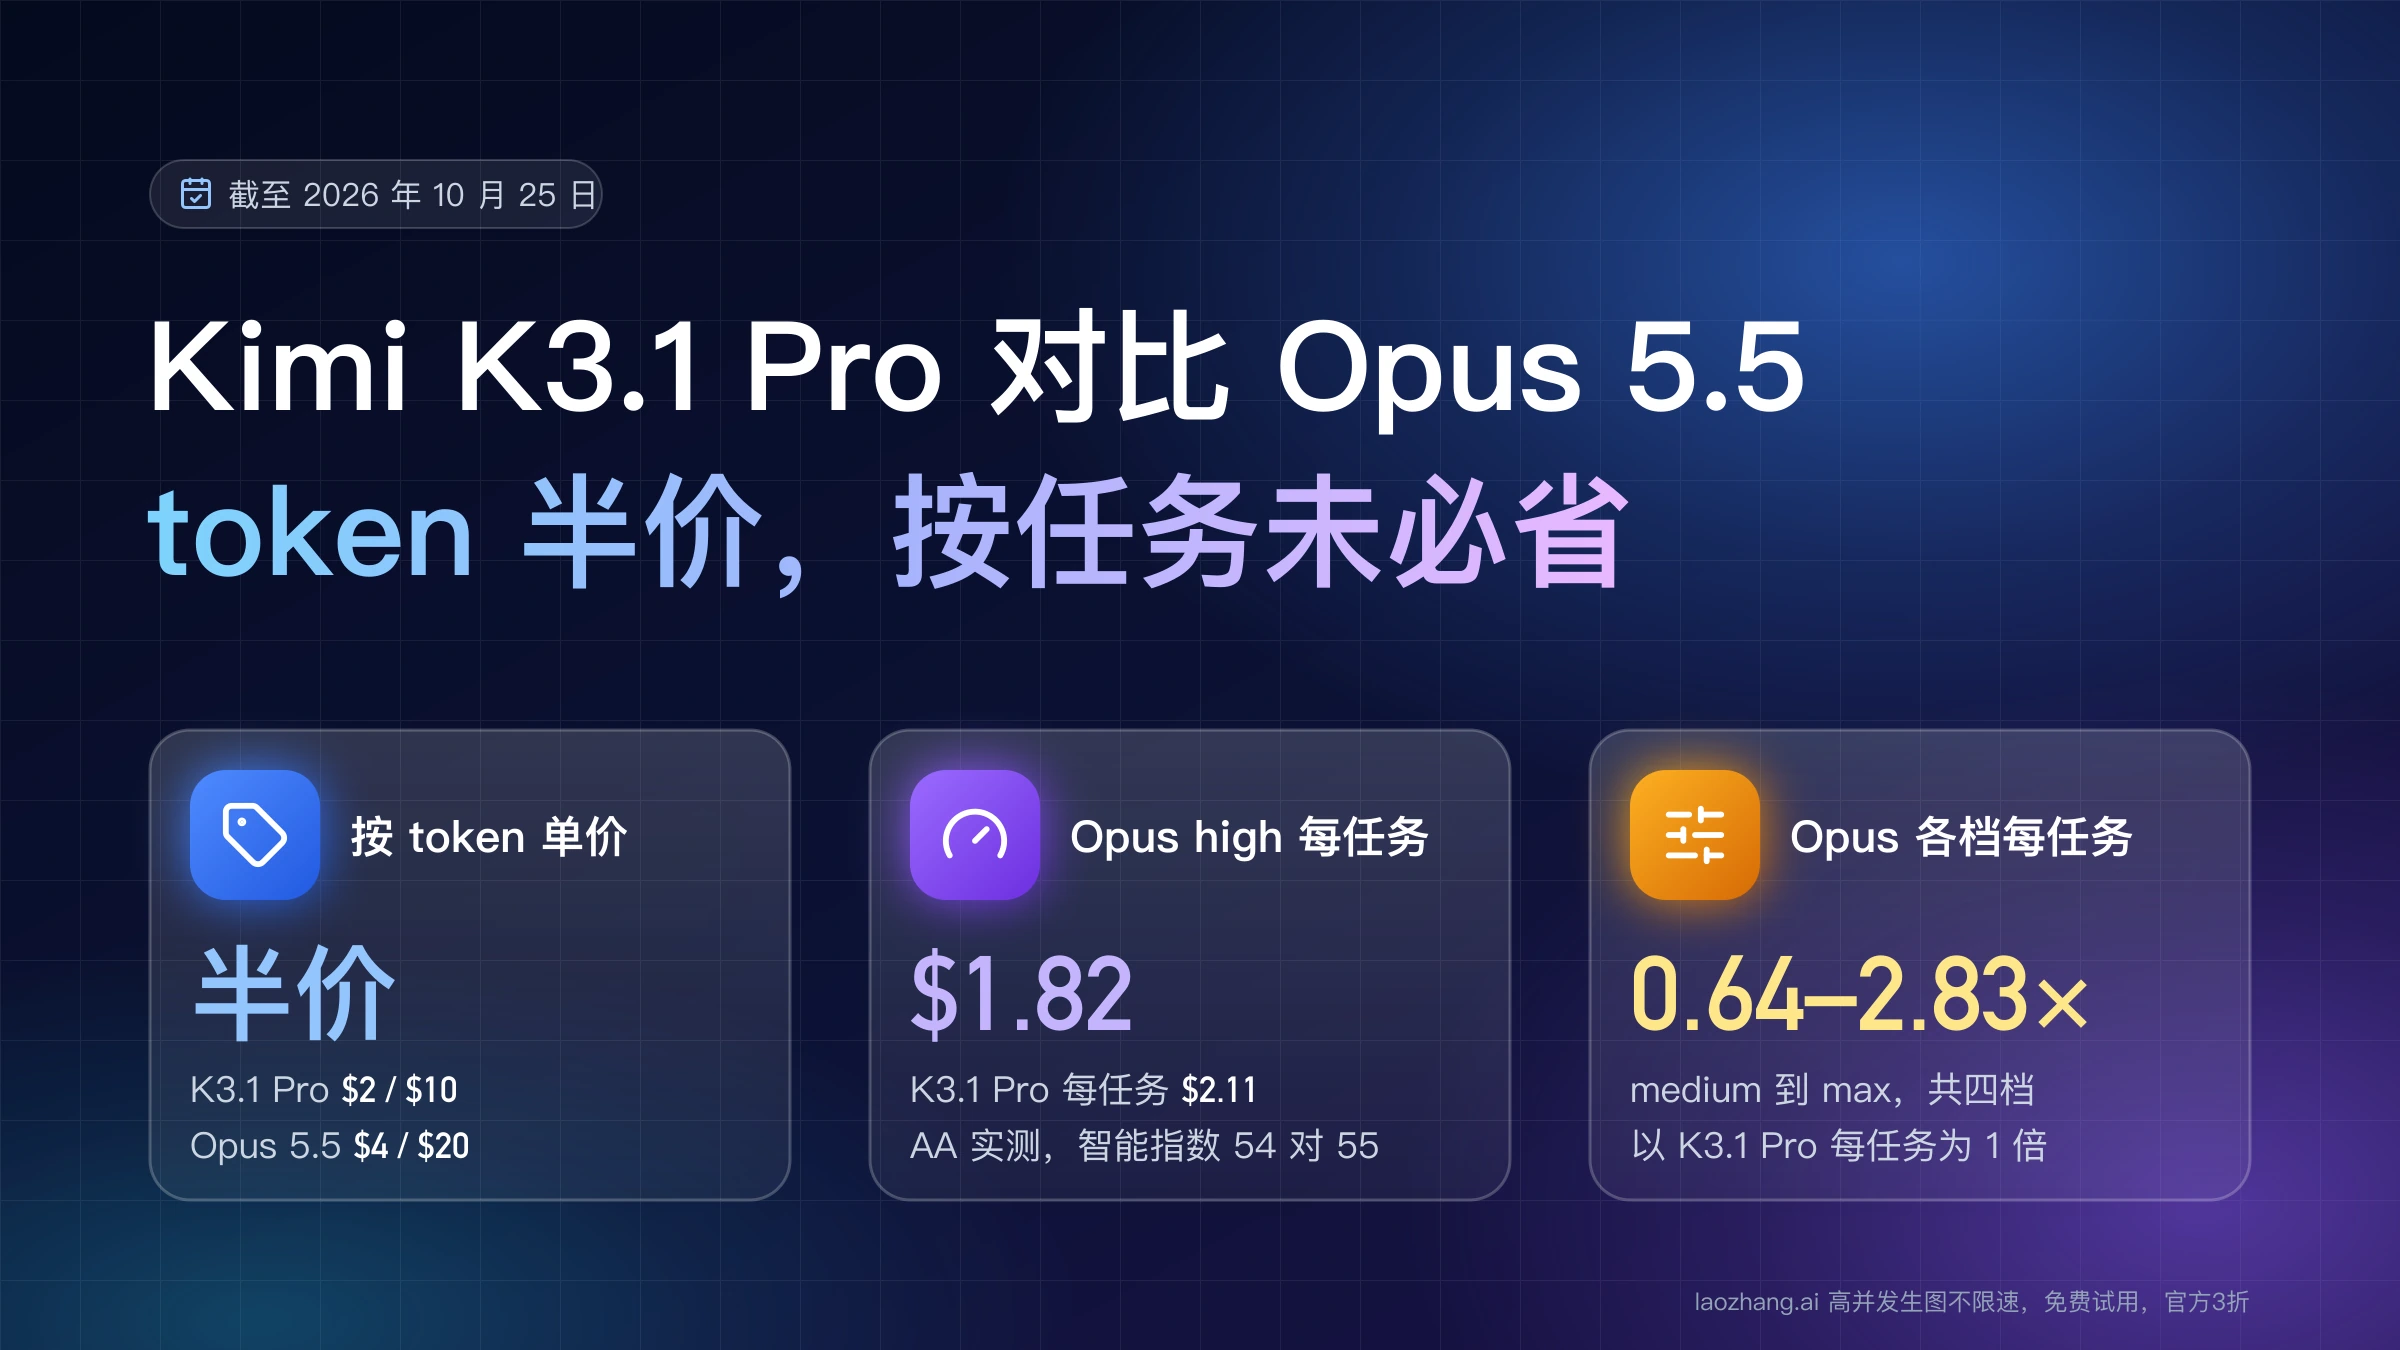
另外,社区帖里流传的“K3.1 Pro 55 分超过 GPT-6 Sol 52 分”写错了型号:AA 的 52 分属于 GPT-6.1 Sol 的 max 档,GPT-6 Sol 是它之前的上一个型号。如果你要比的是 K3.1 Pro 和 Opus 5.5,同样按每任务成本算的对比见Kimi K3.1 Pro 对比 Claude Opus 5.5:token 半价,按任务未必省。
哪些负载 K3.1 Pro 反而便宜:超过 272K 的提示约省一半
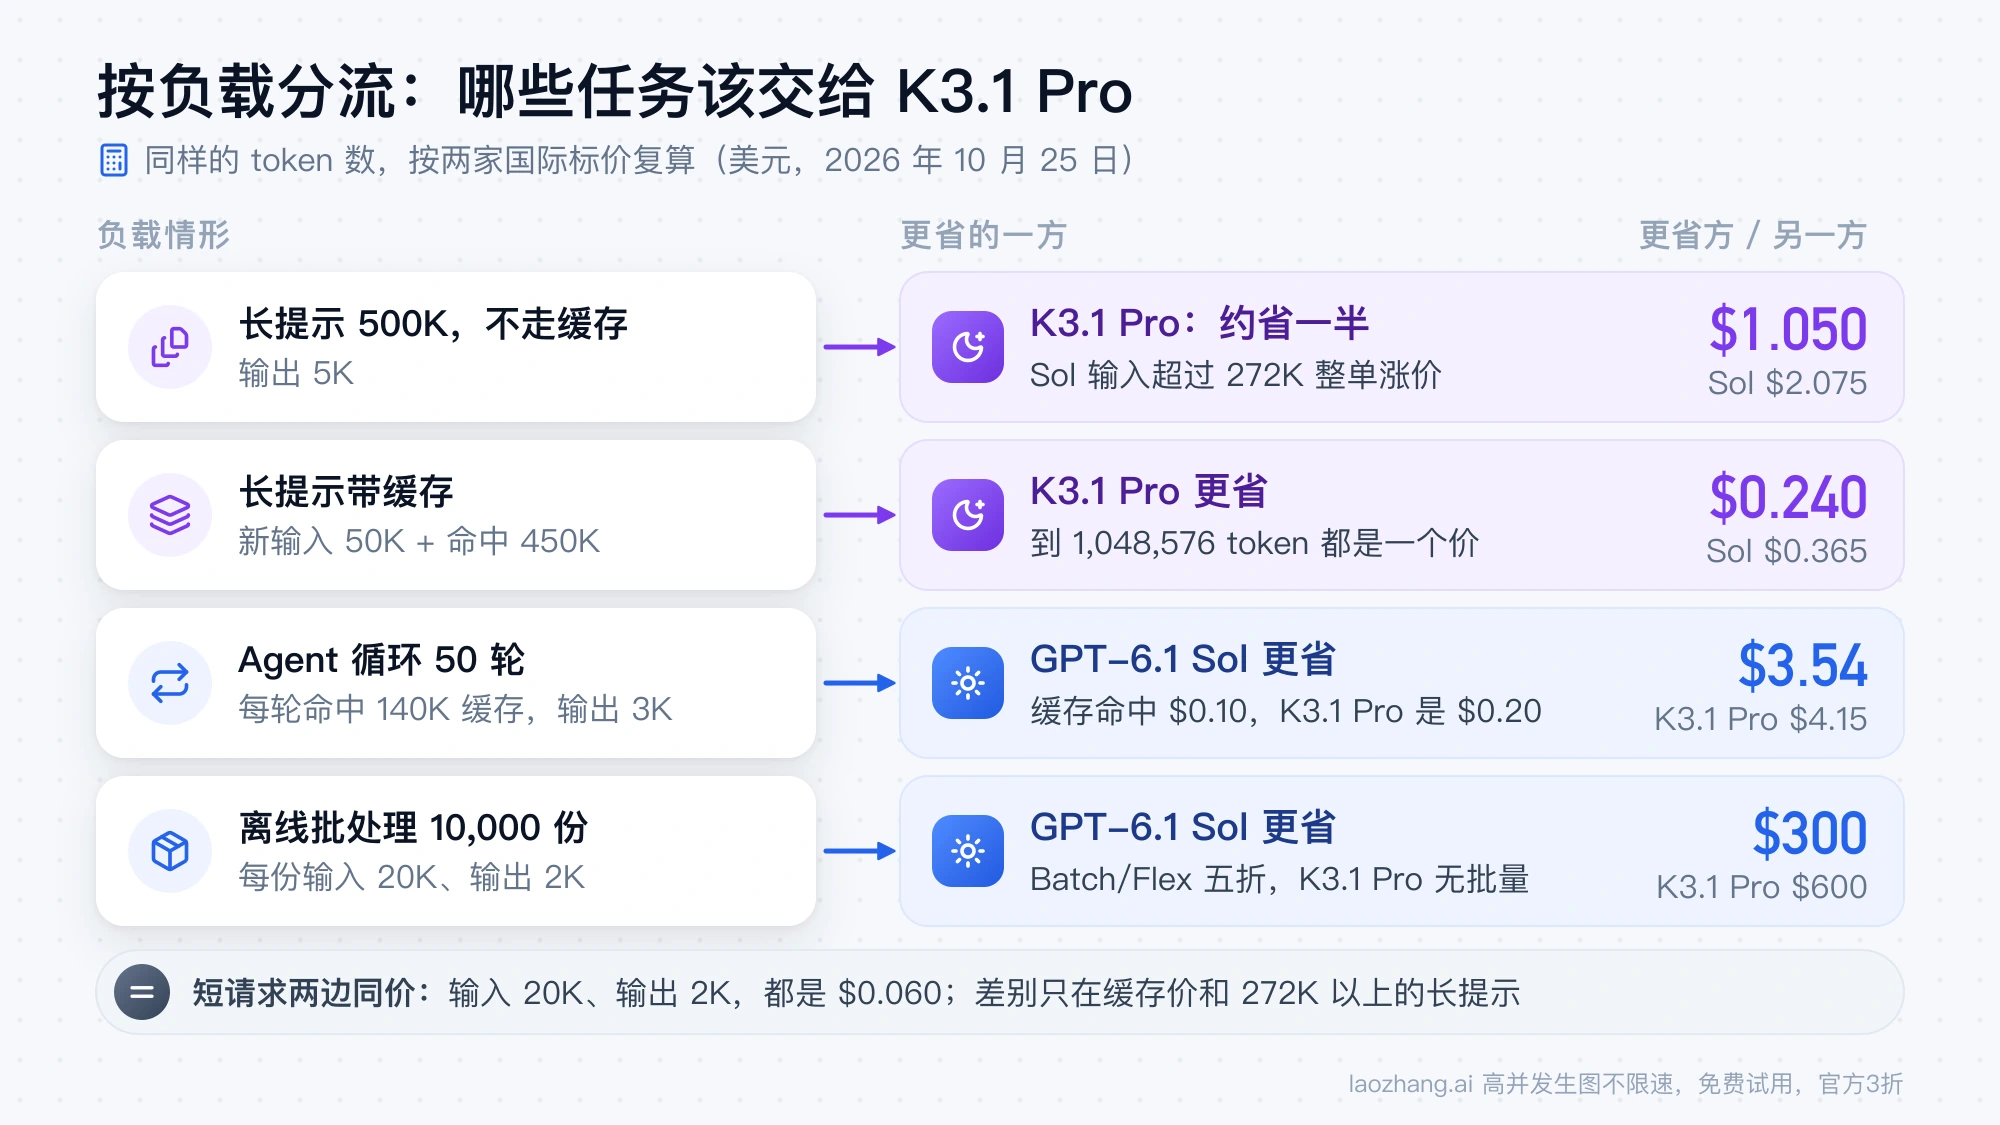
同一批 token 下,两者只在三个地方算出不同的账:缓存命中价、缓存写入价,以及 Sol 超过 272K 输入后的整单涨价。2026 年 10 月 25 日用本机脚本按两家国际标价复算了几种典型负载,token 数相同、只看计价规则,结果如下(美元,Sol/K3.1 小于 1 表示 Sol 更便宜):
| 负载情形 | K3.1 Pro | GPT-6.1 Sol | Sol/K3.1 |
|---|---|---|---|
| 短请求:输入 20K,输出 2K | $0.060 | $0.060 | 1.00 |
| Agent 中间轮:新输入 10K + 缓存命中 140K,输出 3K | $0.078 | $0.064 | 0.82 |
| Agent 首轮:写入 140K 前缀缓存,新输入 10K,输出 3K | $0.330 | $0.400 | 1.21 |
| 长提示:输入 500K 不走缓存,输出 5K | $1.050 | $2.075 | 1.98 |
| 长提示带缓存:新输入 50K + 命中 450K,输出 5K | $0.240 | $0.365 | 1.52 |
| 50 轮会话,两边每轮都输出 3K | $4.15 | $3.54 | 0.85 |
50 轮会话,Sol 按 max 的输出比例每轮约 2.1K | $4.15 | $3.07 | 0.74 |
50 轮会话,Sol 按 high 的输出比例每轮约 0.7K | $4.15 | $2.39 | 0.58 |
| 离线批处理 10,000 份,每份输入 20K、输出 2K | $600 | $300(Batch/Flex) | 0.50 |
这张表的假设都摆在明面上:价格是 Kimi 国际平台和 OpenAI 直连 Standard 档的标价;两边的输出 token 都包含推理 token;50 轮会话指首轮写入 140K 前缀,之后 49 轮每轮命中这 140K 并新增 10K 输入。“按 max 的输出比例”是把 K3.1 Pro 每轮 3K 输出乘以 AA 的 38/55,“按 high”乘以 13/55,只是示意,你的任务输出比例要自己量。表里任何一行都能按这些规则自己重算,例如长提示一行:K3.1 Pro 是 500K × $2 + 5K × $10,每百万计,等于 $1.05;Sol 因为超过 272K,整单按输入 $4、输出 $15 计,等于 $2.075。
读这张表可以得到三条规则。第一,Agent 循环大部分输入都命中缓存时,Sol 便宜,因为它的缓存命中价是每百万 $0.10,K3.1 Pro 是 $0.20;即使两边输出一样多,50 轮下来 Sol 也便宜约 15%;按 AA 的输出比例,Sol 每轮输出更少,差距会拉大到 26%~42%。第二,单次输入超过 272K 时 K3.1 Pro 便宜,因为 Sol 的规则是“输入超过 272K 的请求,整单输入和缓存按 2 倍、输出按 1.5 倍计”,而 K3.1 Pro 到 1,048,576 token 都是一个价;需要把整个代码仓库或几百页文档一次塞进去的任务,这一条比指数差更重要。Sol 各档价格和 272K 规则的完整说明见GPT-6.1 Sol 怎么用:价格变化、迁移改动与可用入口。第三,能等几个小时出结果的离线任务应该留在 Sol:OpenAI 的 Batch 和 Flex 都打五折,而 Kimi Batch API 的计价说明写明它只支持 kimi-k2.7-code 和 kimi-k2.6,不支持 K3.1 Pro,K2 系列还将从 10 月 31 日起停止对新用户开放。
缓存的写入规则也不一样,会影响首轮和长间隔的成本。按 Kimi 上下文缓存文档,重复前缀自动缓存,默认保留 5 分钟,写入价等于普通输入价 $2;请求里加 prompt_cache_options: {"mode": "implicit", "ttl": "1h"} 可以保留 1 小时,写入价 $4,缓存时长在首次写入时就锁定。按 OpenAI 提示缓存指南,Sol 默认保留 30 分钟,写入价是输入价的 1.25 倍即 $2.50,设成 12 小时写入价 $5.00,最少 1,024 token 才缓存。所以 Agent 两次调用之间常隔 5 到 30 分钟(例如等人工确认)的话,K3.1 Pro 的默认缓存会过期重写,要么开 1 小时档,要么接受这部分差价。
从 gpt-6.1-sol 换到 kimi-k3.1-pro,代码要改哪些地方
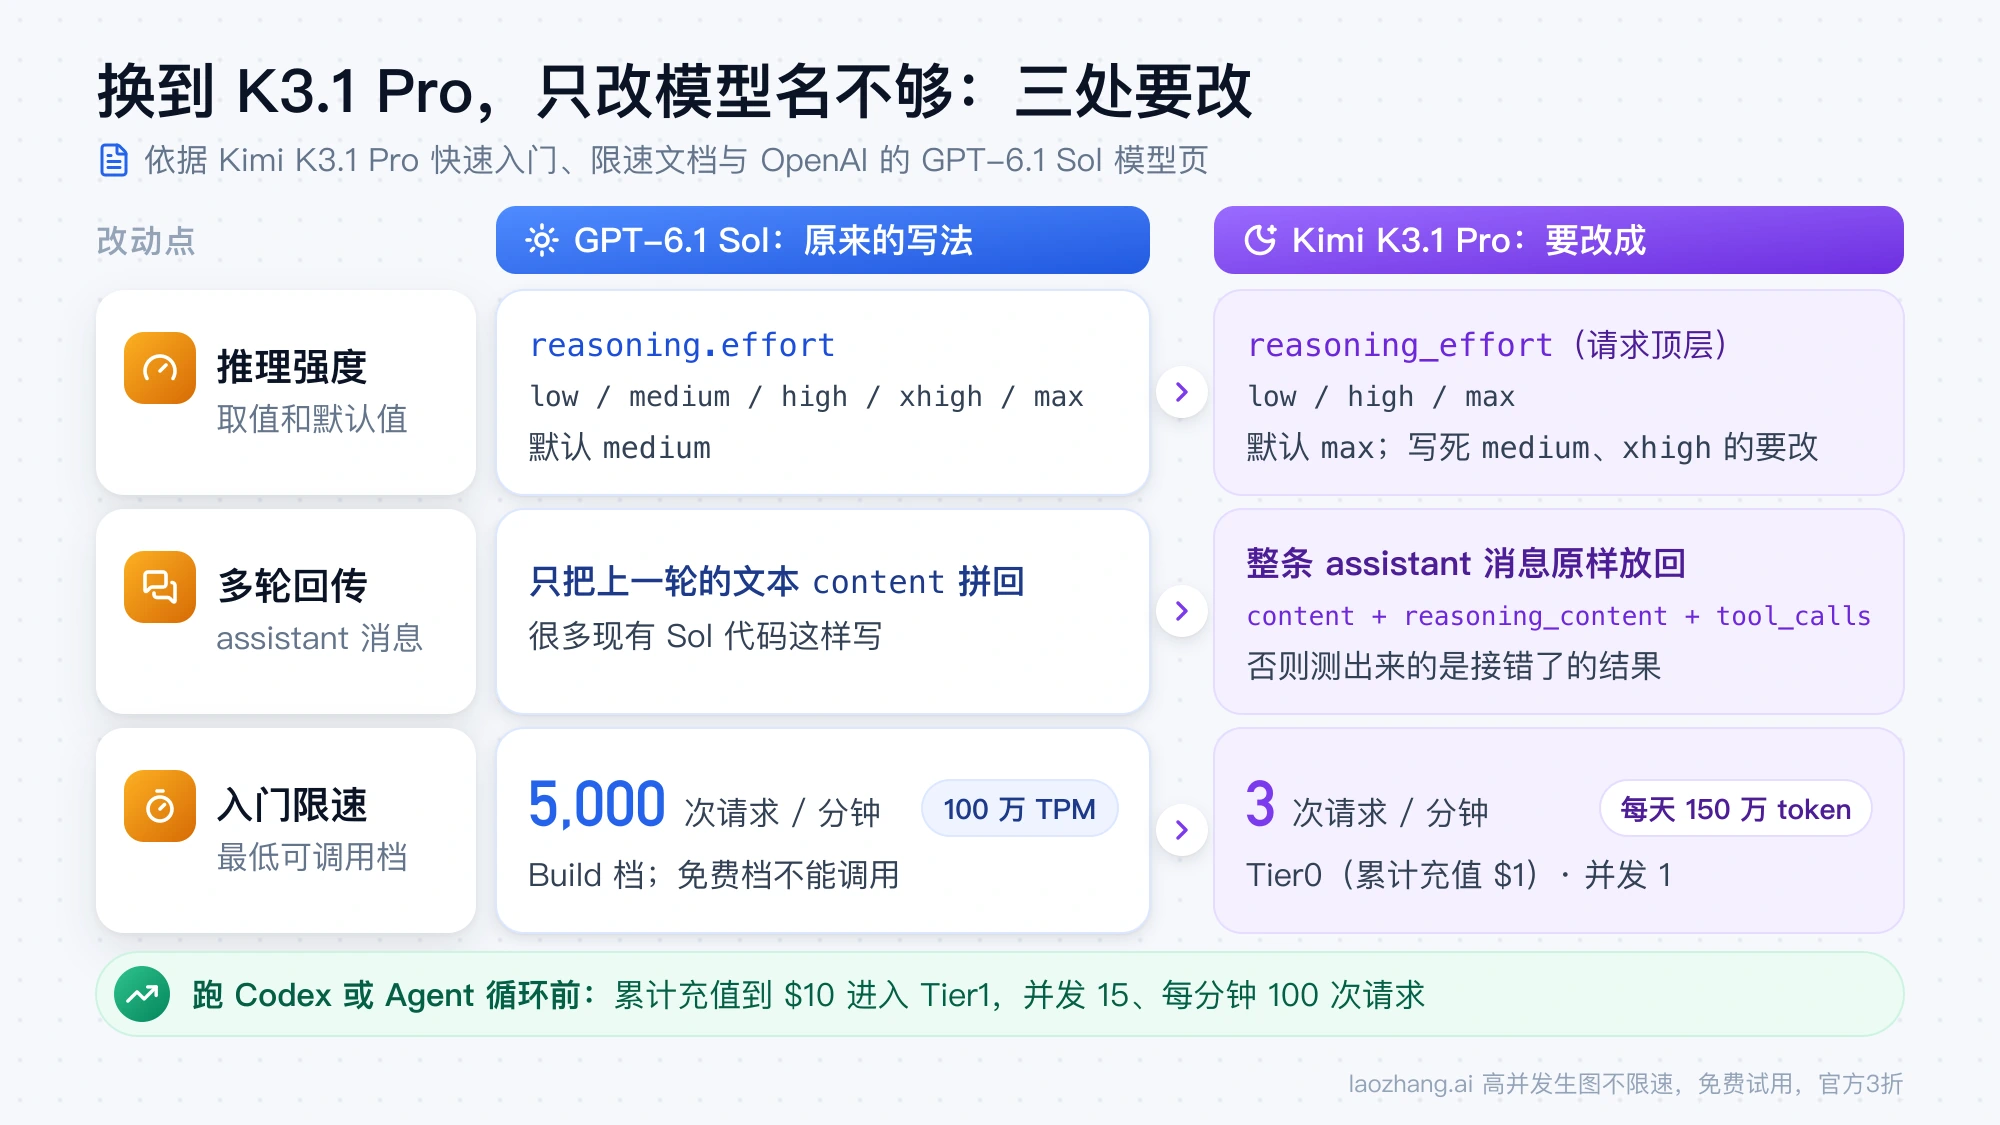
两者都能用 OpenAI 风格的 SDK 调用,但只改模型名不够:推理强度的参数位置和取值不同,K3.1 Pro 的多轮请求必须原样回传完整的 assistant 消息,入门账号的限速也差了三个数量级。下表把迁移时要逐项核对的地方列在一起,Kimi 一列来自 Kimi K3.1 Pro 快速入门和推理强度、缓存、限速文档,Sol 一列来自 OpenAI 的 GPT-6.1 Sol 模型页与价格页。
| 维度 | Kimi K3.1 Pro | GPT-6.1 Sol |
|---|---|---|
| 模型 ID | kimi-k3.1-pro;高速版是另一个 ID kimi-k3.1-pro-highspeed | gpt-6.1-sol |
| 推理强度 | 请求顶层 reasoning_effort:low、high、max,默认 max;思考模式始终开启,关不掉 | reasoning.effort:low、medium、high、xhigh、max,默认 medium;不支持 none、minimal |
| 接口 | Chat Completions(支持工具调用)、Responses API、兼容 Anthropic Messages 的接口 | 工具调用要走 Responses API;Chat Completions 可用,但不支持工具调用 |
| 采样参数 | temperature=1.0、top_p=0.95 等是固定值,官方建议不要传;OpenRouter 的端点不提供 temperature、top_p、seed | 2026 年 10 月 5 日的一次测试中,Chat Completions 传 temperature: 0.2 被拒绝,提示只支持默认值 1 |
| 上下文与最大输出 | 上下文 1,048,576 token;max_completion_tokens 默认 131,072,最大可设 1,048,576 | 上下文 1,050,000 token,最大输出 128,000 |
| 长提示计价 | 整个上下文范围一个价 | 输入超过 272K,整单输入和缓存按 2 倍、输出按 1.5 倍计 |
| 缓存 | 自动;默认 5 分钟,可选 1 小时;命中 $0.20 | 默认 30 分钟,可选 12 小时;命中 $0.10 |
| 批量与低价档 | Batch API 不支持 K3.1 Pro | Batch、Flex 五折 |
| 入门限速 | 国际平台累计充值 $1:并发 1、每分钟 3 次请求、每天 150 万 token | Build 档:每分钟 5,000 次请求、100 万 TPM;免费档不能调用 |
| 托管方 | OpenRouter 上 2 个端点,都由 Moonshot AI 提供 | OpenRouter 上 8 个端点:OpenAI 四档、Azure 三个、Amazon Bedrock 一个 |
| 模型权重 | 官方称 11 月 4 日前发布完整权重 | 不开放 |
推理强度的映射要特别注意。Sol 的默认 medium 在 K3.1 Pro 上没有对应值,代码里写死了 medium 或 xhigh 的,迁移时要改成 low、high 或 max 之一;反过来,K3.1 Pro 不写推理强度就是 max,这是它每任务成本高的主要原因,想压低成本就显式传 high 或 low,再用自己的任务确认质量还够不够。多轮回传是另一个常见坑:很多 Sol 的代码只把上一轮的文本 content 拼回对话,在 K3.1 Pro 上要连同 reasoning_content 和 tool_calls 整条放回。
限速对 Agent 循环的影响最直接。按 Kimi 国际平台的充值与限速说明,只充了 $1 的账号是 Tier0,并发 1、每分钟 3 次请求、每天 150 万 token;用 AA 每道题约 55,000 个输出 token 粗算,一天只够跑约 27 个同等规模的任务,这还没算输入 token。累计充值到 $10 进入 Tier1,并发 15、每分钟 100 次请求、每日 token 不限;累计充值满 $5 送的 $5 代金券不计入累计金额。
托管方的差别来自 2026 年 10 月 25 日调用 OpenRouter 公开 API(/api/v1/models/{id}/endpoints,不需要 key)的结果:K3.1 Pro 只有 Moonshot AI 自己的标准和 highspeed 两个端点,OpenRouter 标注的单次最大输出是 943,718 token;Sol 有 OpenAI 的标准、flex、fast、ultrafast 四档,加上 Azure、Azure EU、Azure US 和 Amazon Bedrock us-east-1,后三者标价 $2.20/$11。也就是说,现在用 K3.1 Pro 只能依赖 Moonshot 一家的容量,权重发布之后托管方可能会增加。
Codex 里接 Kimi K3.1 Pro:config.toml 怎么写
Codex 可以直接换成 K3.1 Pro。Kimi 的 Codex 接入指南说明,Kimi 开放平台原生支持 Codex 使用的 Responses API,不需要协议转换或本地代理。先把 key 放进环境变量 KIMI_API_KEY(不要写进配置文件),再在 ~/.codex/config.toml(Windows 是 %USERPROFILE%\.codex\config.toml)里加入下面的配置,已有的 model 和 model_provider 直接替换:
model = "kimi-k3.1-pro"
model_provider = "kimi"
model_context_window = 1048576

[model_providers.kimi]
name = "Kimi"
base_url = "https://api.moonshot.ai/v1"
env_key = "KIMI_API_KEY"
wire_api = "responses"
这段配置照搬自 Kimi 文档,Codex 接 Kimi 的组合没有实际运行过。改完要完全退出再重启 Codex,桌面版的模型选择器可能显示为“Custom”,CLI 启动时提示 Model metadata for kimi-k3.1-pro not found 都属正常;model_context_window 不能省,否则 Codex 会按默认元数据处理上下文。在 platform.kimi.ai 创建的 key 只能配 https://api.moonshot.ai/v1,混用会报 401。国内平台另有一份Kimi 国内平台的 Codex 接入指南,配置相同,只是 base_url 换成 https://api.moonshot.cn/v1,wire_api 仍是 "responses";在 platform.kimi.com 创建的 key 只能配这个地址。配好后先发一句 hello 确认能正常回复,再跑真正的任务。最容易遇到的是 429:Tier0 账号并发只有 1,Codex 一次任务会连续调用很多次,最好先充到 Tier1。
如果你现在是用 ChatGPT 的 Plus、Pro 等订阅在 Codex 里用 Sol,改成 Kimi 之后就从订阅额度变成按 token 付费,上面的每任务成本要全部自己承担,先算清楚再换,可以参考Codex API Key 和 ChatGPT 订阅怎么选?额度与 credits 按美元算。Base URL、鉴权报错等通用的自定义 provider 问题,见Codex 自定义 API 配置:Key、Base URL 与 Provider 怎么选。
国内怎么用:K3.1 Pro 充值 10 元解锁,代金券不能用
在国内用 K3.1 Pro,走 Kimi 国内平台 platform.kimi.com,按人民币计价。截至 2026 年 10 月 24 日的 Kimi 国内平台模型推理价格说明,K3.1 Pro 每百万 token 输入 ¥13、输出 ¥68,缓存命中 ¥1.30,缓存写入 5 分钟档 ¥13、1 小时档 ¥26;Highspeed 版输入 ¥26、输出 ¥136。国内快速入门写明,完成充值(最低 10 元)后才解锁调用,新用户注册认证送的 15 元代金券不能用于 K3.1 Pro。国内平台的限速等级同样由累计充值决定,但具体数值和国际平台不一定相同,以 Kimi 国内平台充值与限速页为准。人民币价和上文的美元价是两张独立的价目表,不要按汇率互相换算后比较。
GPT-6.1 Sol 这边,截至 2026 年 10 月 25 日,OpenAI API 支持的国家和地区列表里没有中国大陆和香港。Sol 也可以通过 ChatGPT 的 Plus、Pro、Business、Enterprise、Edu 套餐在 ChatGPT 工作模式和 Codex 里使用。另外,laozhang.ai 的 /v1/models 列表有 gpt-6.1-sol,2026 年 10 月 25 日又上架了 kimi-k3.1-pro 和 kimi-k3.1-pro-highspeed,价格与 Kimi 国际平台标价一致(分别为每百万 token $2/$10 和 $4/$20,缓存读取 $0.20,缓存写入 5 分钟 $2、1 小时 $4),通过 Chat Completions 调用,一个 key 就能同时调用两个模型。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
换之前用自己的任务测一轮:按合格结果算成本
AA 的分数只能告诉你平均水平,值不值得换要看你自己的任务。Kimi 国际平台充值 $1 就能开始测,不过 Tier0 每分钟只有 3 次请求,测试要串行跑,几十个任务按 K3.1 Pro 每题十分钟左右估算,要留出大半天。
- 挑 20~50 个真实任务,一半是 Sol 现在做得好的,一半是 Sol 做不好、你考虑换模型的原因;每个任务先写好验收标准,例如测试通过、字段完整、结论有出处。
- Sol 分别用
high和max跑一遍,K3.1 Pro 用默认max跑一遍,想压成本再加一轮high;K3.1 Pro 的多轮任务记得回传完整 assistant 消息,否则测出来的是接错了的结果。 - 每次请求记下 API 返回的输入、缓存命中、输出 token 数(输出含推理 token)和耗时,按各自标价算出每任务成本。
- 用“总成本 ÷ 通过数”算每个合格结果的成本,再分别看两组任务:Sol 已经做得好的那一半通常没理由换,Sol 做不好的那一半如果 K3.1 Pro 的合格成本更低,就只把这类任务路由给它。
- 上线前按真实并发再压一次,确认 Kimi 账号等级的并发和每分钟请求数够用,不够就先提升充值等级。
Kimi K3.1 Pro 和 GPT-6.1 Sol 的其他问题
Kimi K3.1 Pro 是开源模型吗,能自己部署吗? 截至 2026 年 10 月 25 日还不能。Kimi 官方表示完整模型权重将在 11 月 4 日前发布,在那之前 AA 把它标为非开放权重,OpenRouter 上也只有 Moonshot AI 自己提供的端点。AA 给出的规模是总参数 2.8T、激活 104B,权重发布后要自己部署,硬件门槛也很高。
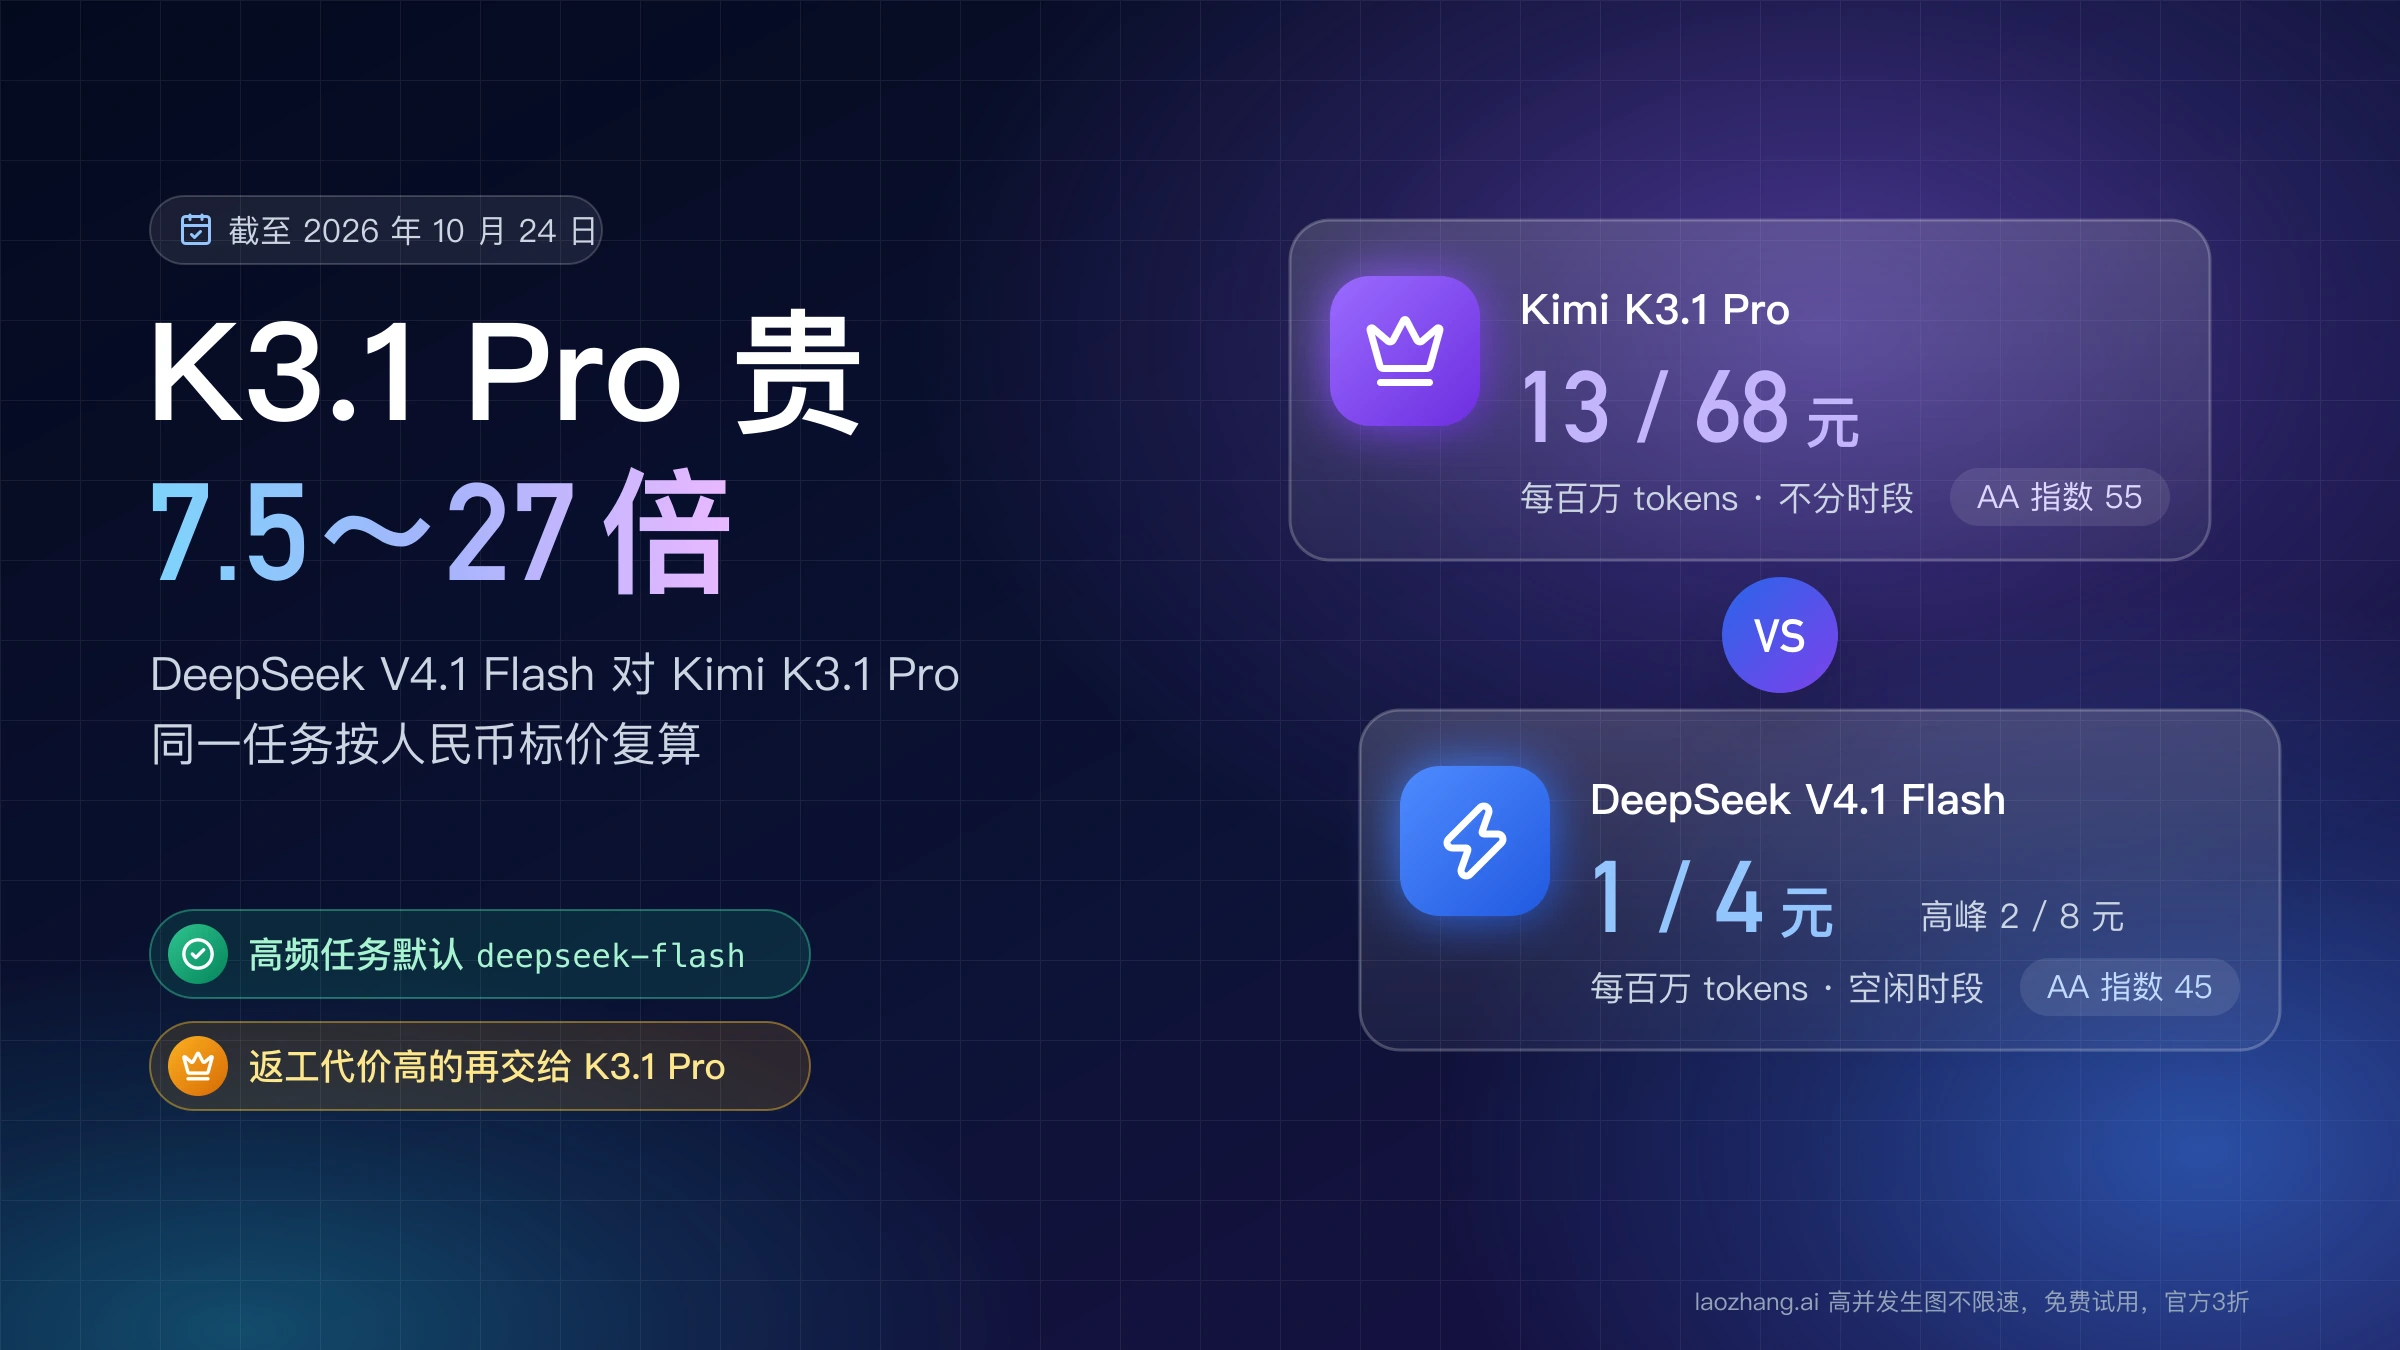
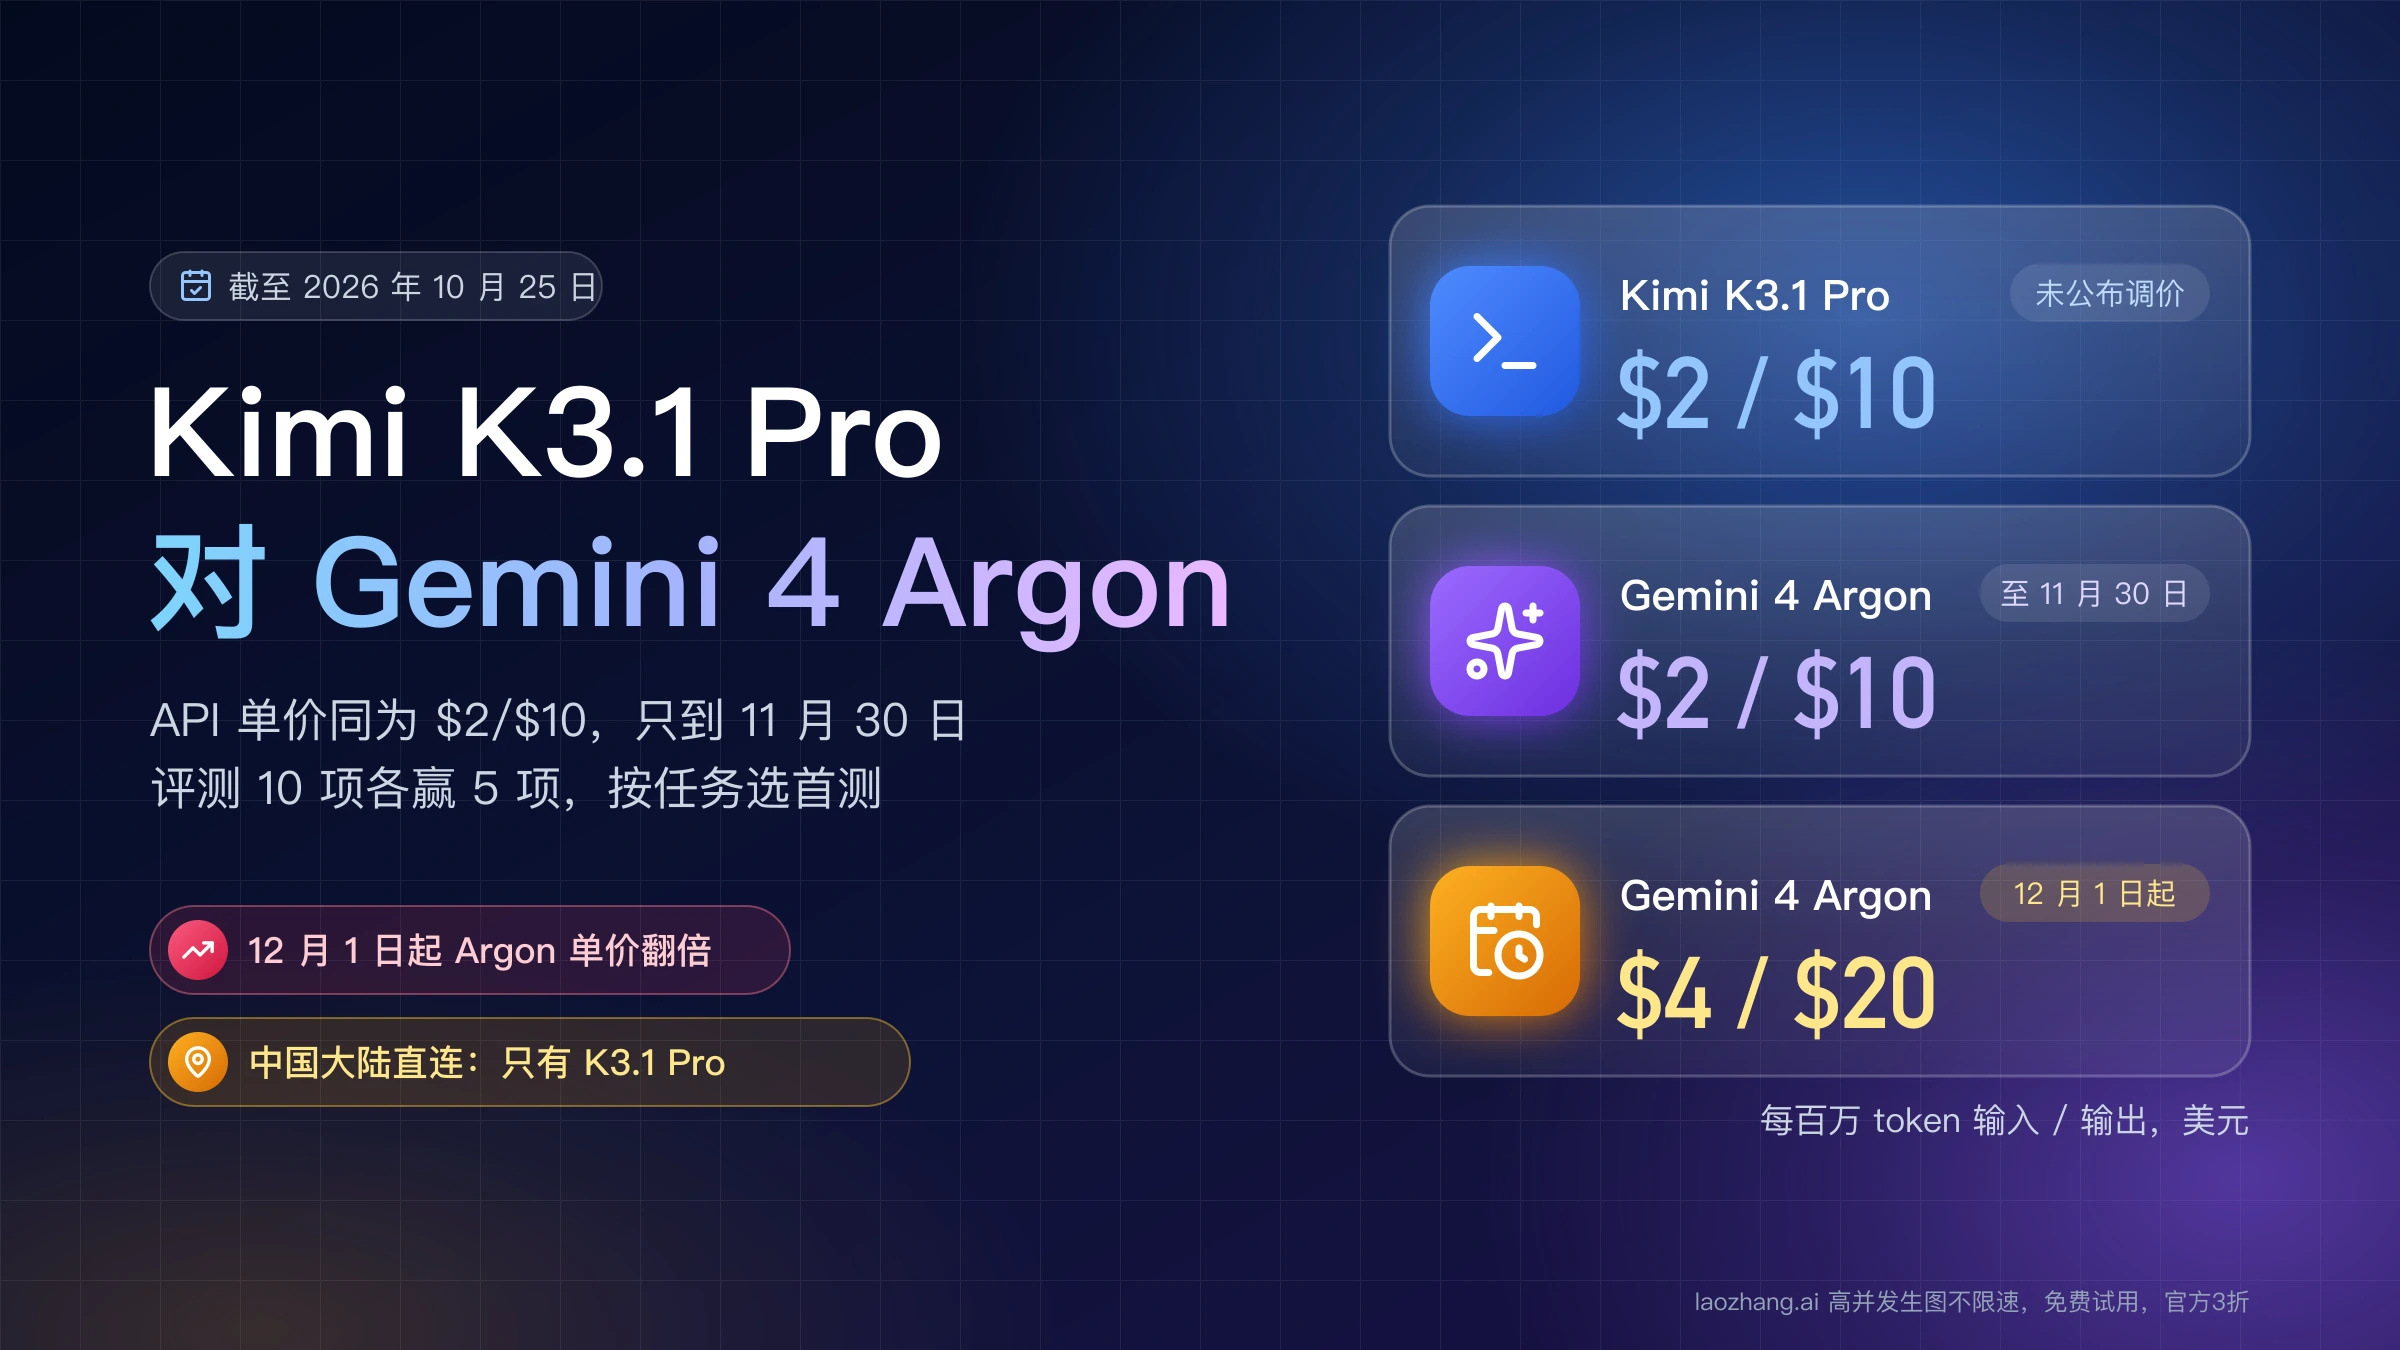
嫌 K3.1 Pro 每任务太贵,有便宜一档的替代吗? 有。想要明显更便宜的档位,可以看 DeepSeek V4.1 Flash,它和 K3.1 Pro 的价格与能力对比见DeepSeek V4.1 和 Kimi K3.1 哪个好:Flash 对 Pro,贵 7.5~27 倍。如果想在同价位的其他旗舰里找 Sol 的替代,见Gemini 4 Argon、Opus 5.5、GPT-6.1 Sol 对比:已开放,12 月起涨价。
K3.1 Pro 比上一代 kimi-k3 便宜吗?
标价便宜三分之一。Kimi 国际平台上 kimi-k3 每百万 token 输入 $3、输出 $15、缓存命中 $0.30,K3.1 Pro 是 $2、$10、$0.20(截至 2026 年 10 月 25 日)。Kimi 的推理强度文档对 K3 同样要求用请求顶层的 reasoning_effort,多轮和工具调用时原样回传完整的 assistant 消息,所以从 kimi-k3 升级时这两处写法不用改;各档取值和默认值以 K3.1 Pro 的文档为准。
参考来源12
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月25日。
参考来源12
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月25日。
- 1.Kimi K3.1 Pro 与 GPT-6.1 Sol 对比页artificialanalysis.ai/models/comparisons/kimi-k3-1-pro-vs-gpt-6-1-sol
- 2.Kimi Batch API 的计价说明platform.kimi.ai/docs/pricing/batch
- 3.Kimi 上下文缓存文档platform.kimi.ai/docs/guide/context-caching
- 4.OpenAI 提示缓存指南developers.openai.com/api/docs/guides/prompt-caching
- 5.Kimi K3.1 Pro 快速入门platform.kimi.com/docs/guide/kimi-k3-1-pro-quickstart
- 6.OpenAI 的 GPT-6.1 Sol 模型页developers.openai.com/api/docs/models/gpt-6.1-sol
- 7.Kimi 国际平台的充值与限速说明platform.kimi.ai/docs/pricing/limits
- 8.Kimi 的 Codex 接入指南platform.kimi.ai/docs/guide/codex-kimi
- 9.Kimi 国内平台的 Codex 接入指南platform.kimi.com/docs/guide/codex-kimi
- 10.Kimi 国内平台模型推理价格说明platform.kimi.com/docs/pricing/chat
- 11.Kimi 国内平台充值与限速页platform.kimi.com/docs/pricing/limits
- 12.OpenAI API 支持的国家和地区列表developers.openai.com/api/docs/supported-countries