Gemini 400 报错 Requests ending with a model turn 怎么解决
Gemini 3.6 Flash 起(含 Argon),请求以 model 回合结尾就报 400:删掉它或补一条 user 消息,预填充改用系统指令,别重试。
文章目录
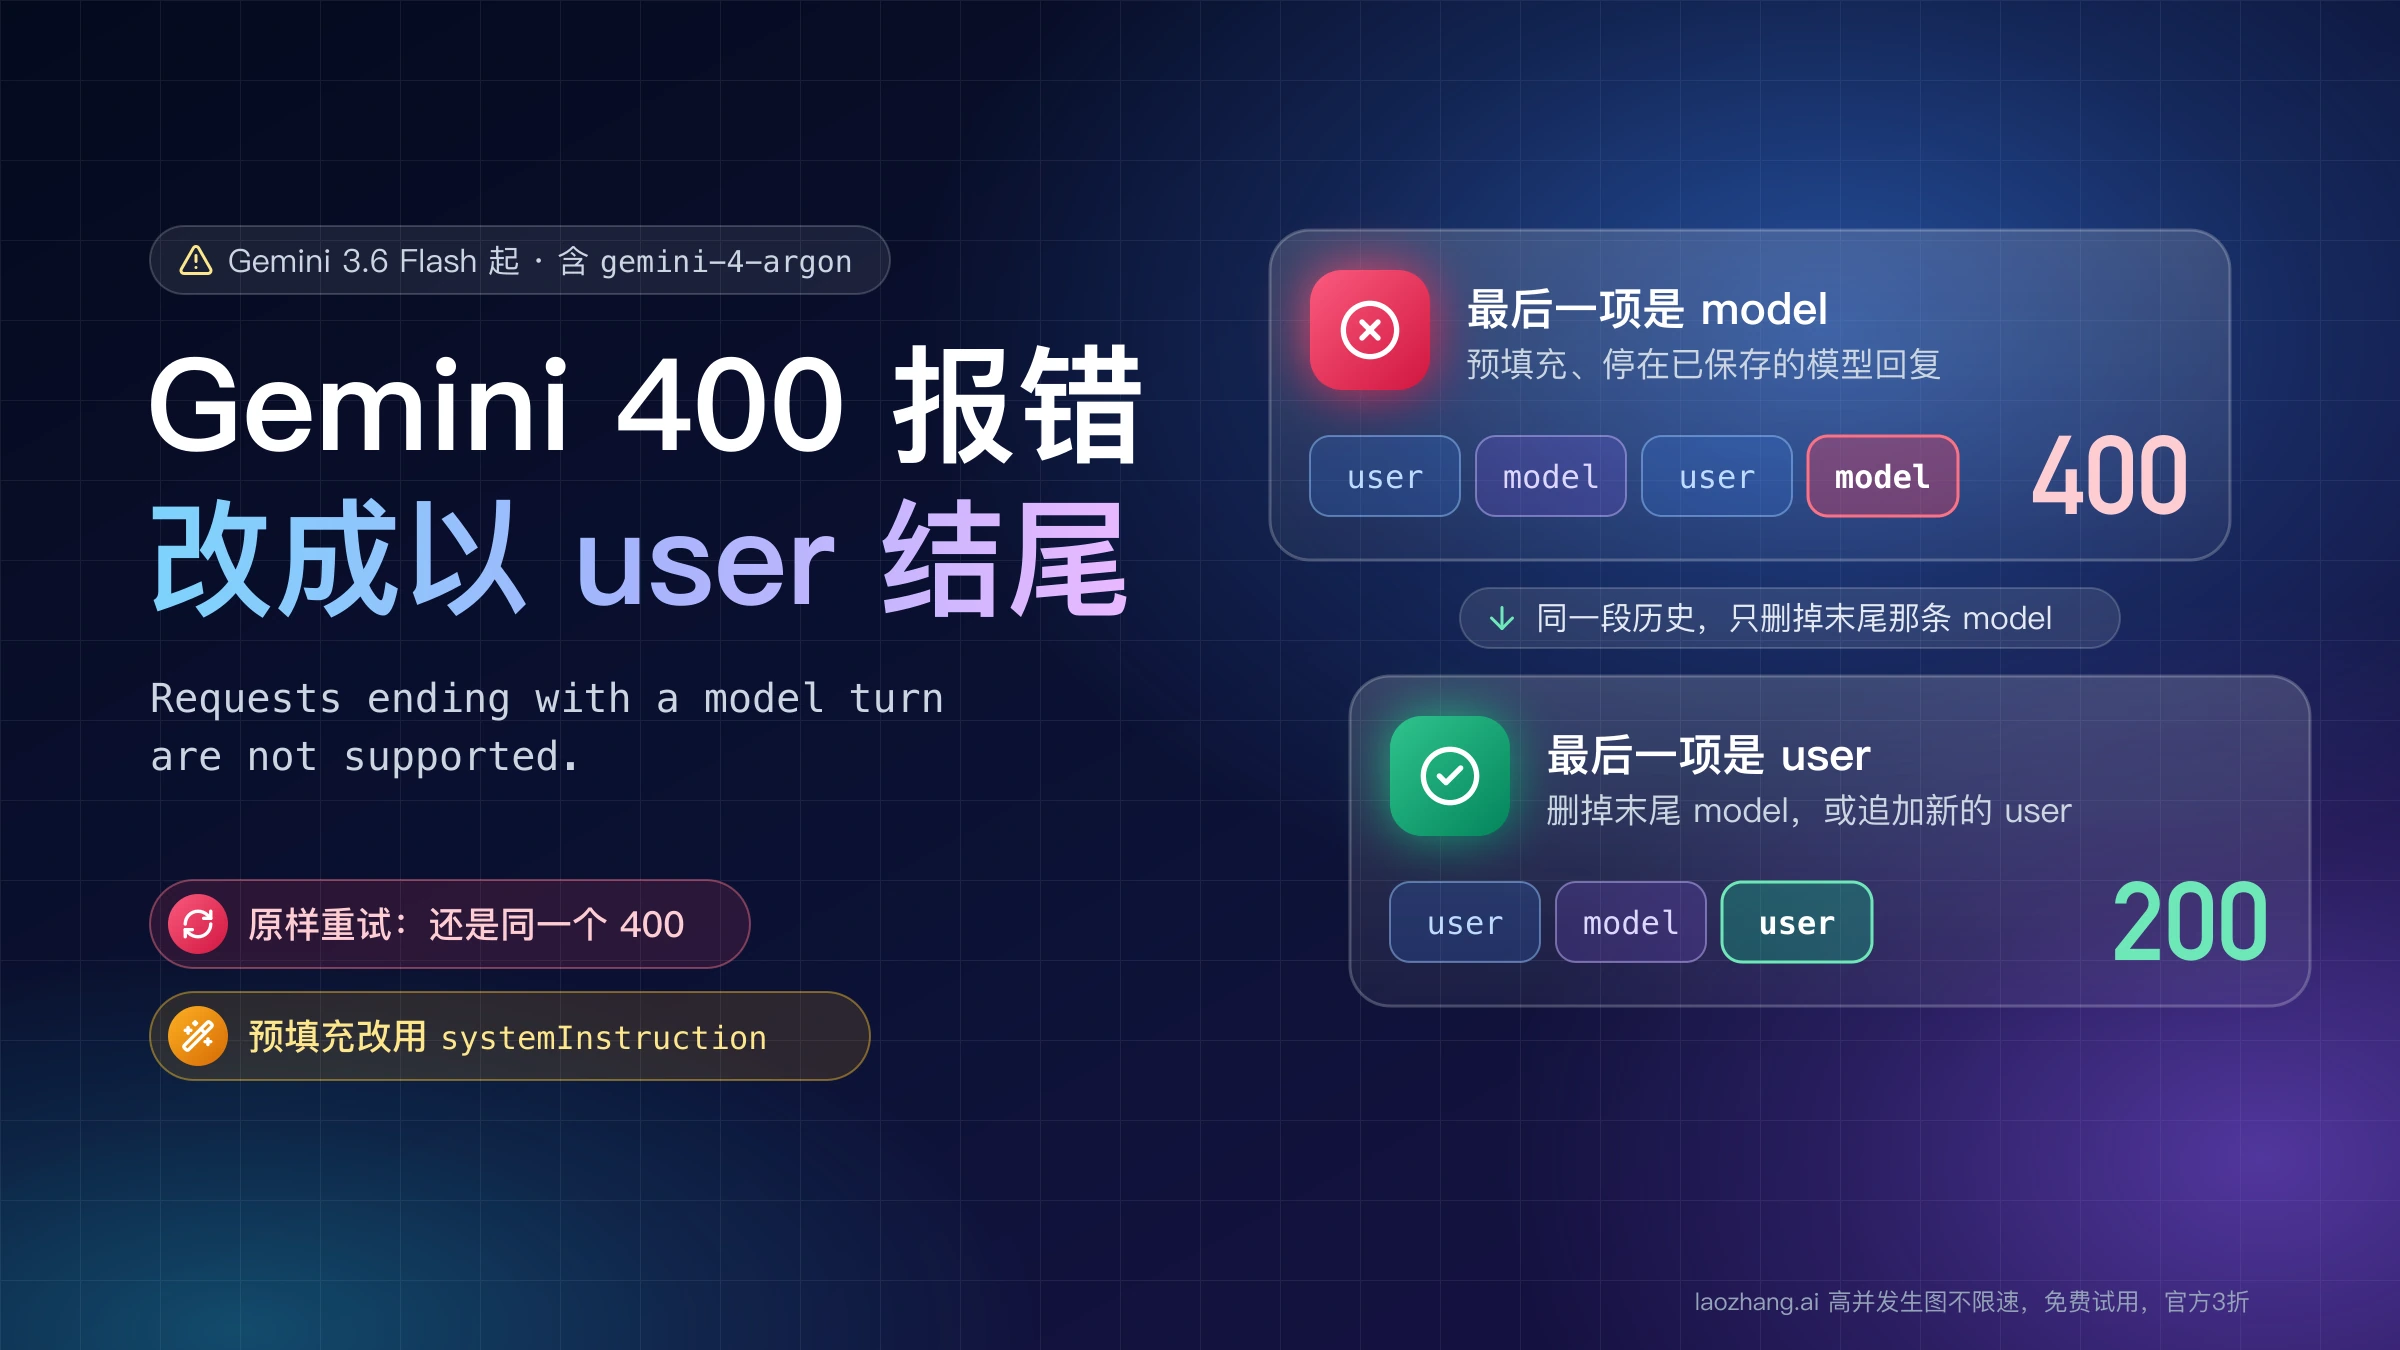
Requests ending with a model turn are not supported. 是 Gemini API 返回的 400 INVALID_ARGUMENT,意思是 Google 收到的请求里,contents 最后一个非空回合的 role 是 model,也就是 OpenAI 格式里的 assistant 消息。改法只有一个方向:让请求以 user 回合结尾。删掉末尾那条 model 回合,或者在它后面追加新的 user 消息;原来用 model 回合做预填充(prefill)来定开头、逼出 JSON 的,改用 systemInstruction 或结构化输出;工具调用停在模型返回的 functionCall 上时,先执行工具,把 functionResponse 作为 user 回合发回去。
这条规则从 Gemini 3.6 Flash 和 3.5 Flash-Lite 开始,对之后发布的所有 Gemini 模型生效,gemini-4-argon 也在其中,所以换了新模型之后,原来能跑的续写、打断后的会话会突然报错。它是请求格式错误,原样重试只会得到同一个 400。如果你是在酒馆(SillyTavern)、Gemini CLI、opencode 这类工具里看到它,多半是工具拼历史时把 model 回合留在了最后:Gemini CLI 升级到 v0.65.0 或更高,酒馆先关掉预填充、续写一类设置再试。
有两种情况不那么直观。在 Vertex AI 上,工具结果后面紧跟一段文字、两者放在同一个 user 回合里,也会报这句;对一段以模型回复结尾的历史调用 countTokens,Gemini 4 Argon 上也有返回这个 400 的报告。
Requests ending with a model turn 是什么意思:最后一个回合是 model
Gemini 的对话用 contents 数组表示,每一项是一个回合(turn),role 只有 user 和 model 两种取值。报错里的 model turn 就是 role 为 model 的那一项,也就是模型说过的话;工具调用时模型返回的 functionCall 同样属于 model 回合,工具执行结果 functionResponse 则放在 user 回合里。Google 的 Gemini 3.6 Flash 与 3.5 Flash-Lite 更新说明写明,预填充 model 回合不再支持,请求里最后一个非空回合是 model 回合时,API 返回 400。
受影响的模型是 Gemini 3.6 Flash、Gemini 3.5 Flash-Lite,以及之后发布的所有 Gemini 模型。Gemini 4 Argon 的迁移清单没有单独列出这一条,但它在"之后所有模型"的范围内。更早的模型不受这条规则约束:LINUX DO 上 2026 年 7 月 22 日的帖子「Gemini 3.6 Flash 不再支持模型预填充续写」提到,同样以 model 结尾的续写请求在 3.5 Flash 上仍然可用。
同一条规则在不同入口显示成几种样子,处理方法相同。直连 Gemini API 通常是 400 INVALID_ARGUMENT 加上面那句;AI Studio 和部分反代返回更长的 Requests ending with a model turn are not supported unless the last part is a function response.,前面可能带 [original: beyond::dependency::INVALID_ARGUMENT];反代会包成 PROXY ERROR 400: {...};OpenRouter 只显示 Provider returned error,Google 的原文在 error.metadata.raw 里。
聊天窗口里最后一条是你发的消息,不代表发出去的请求以 user 结尾。前端在发送前可能追加预填充或续写内容、调整历史顺序,或者把你的消息和工具结果合并成一个回合,所以判断时要看实际发出的请求体,而不是界面。
我是哪种情况:按触发方式对照现象和改法
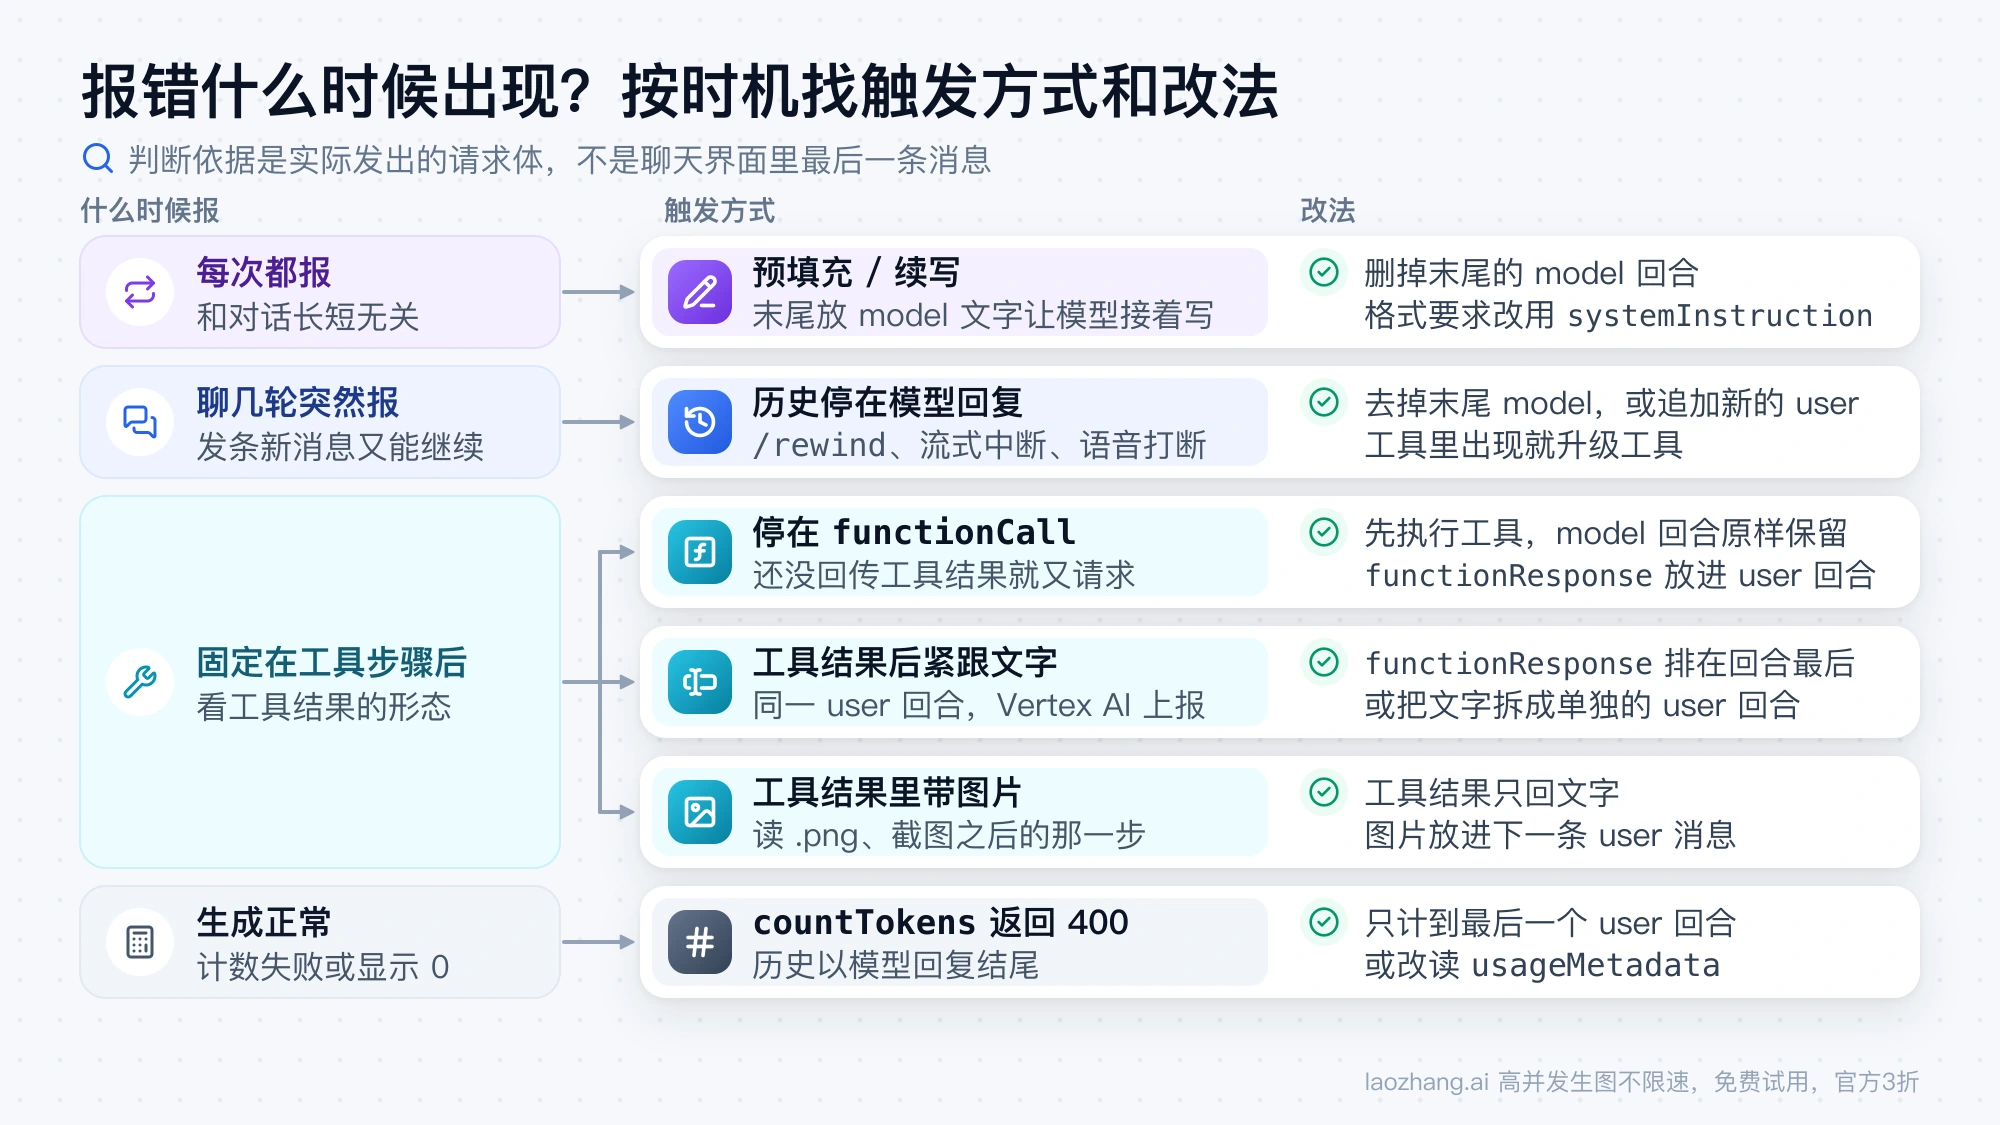
先看报错出现的时机。第一次请求就报、每次都报,基本是预填充;聊了几轮突然报、发一条新消息又能继续,是历史停在了模型回复上;固定在某个工具步骤之后报,要看工具结果的形态。下表按触发方式列出现象和改法。
| 触发方式 | 你会看到什么 | 改法 |
|---|---|---|
| 预填充或续写:在末尾放一段 model 文字让模型接着写(定开头、逼出 JSON、续写被截断的回答) | 每次请求都报,和对话长短无关 | 删掉末尾的 model 回合;格式要求写进 systemInstruction 或改用结构化输出;要续写就把已有内容放进新的 user 消息 |
历史停在已保存的模型回复:/rewind、流式输出被中断、语音打断后截断的回复、步骤上限提示被当成 assistant 消息追加 | 聊了几轮后突然报,发一条新消息常常就能继续 | 发请求前检查最后一项,是 model 就去掉,或追加新的 user 回合;工具里出现就升级工具 |
工具流程停在 functionCall:模型要求调用工具,还没回传结果就又发了请求 | 工具调用那一步报 | 先执行工具,把 functionResponse 放进 user 回合再请求,模型那一回合原样保留 |
工具结果后面紧跟文字:同一个 user 回合里是 [functionResponse, text] | Vertex AI 上报;提醒、补充说明被注入在工具结果之后时常见 | 让 functionResponse 排在这个回合最后,或把文字拆成下一个单独的 user 回合 |
| 工具结果里带图片:读取 .png、截图类工具 | 读图之后的那一步固定报,纯文字步骤正常 | 工具结果只回文字,图片放进下一条 user 消息 |
对以模型回复结尾的历史调用 countTokens | 生成正常,token 计数失败或显示 0 | 只计到最后一个 user 回合,或改读响应里的 usageMetadata.promptTokenCount |
第四类最容易被误判,因为请求明明以 user 回合结尾。senpi 项目的 #3633 报告(2026 年 10 月 18 日,Vertex AI 上的 Gemini 4 Argon)每次只改一个变量:末尾 user 回合只有 [functionResponse] 时返回 200,变成 [functionResponse, text] 就返回这个 400,换成 [text, functionResponse] 又是 200。2026 年 10 月 28 日,同一 issue 下的用户 AgentSMLA 通过 LiteLLM 1.101.0 调用 Google Cloud Express 上的 gemini-4-argon,把工具结果和文字拆成两个独立的 user 回合后也得到 200。
2026 年 10 月 29 日 Gemini 4 Argon 实测:8 种请求形态的状态码
2026 年 10 月 29 日 03:00 至 03:05(UTC),通过 laozhang.ai 的 Gemini 原生接口(/v1beta/models/gemini-4-argon:generateContent,直接发 REST 请求,不经 SDK,thinkingLevel 设为 low)对 gemini-4-argon 发了下面这些请求,每次只改一个变量。结果和 Google 的规则一致:以 user 回合结尾的都返回 200,以 model 回合结尾的都返回 400,报错原文是 Requests ending with a model turn are not supported.。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
| 请求的 contents(最右边是最后一项) | 结果 |
|---|---|
[user] | 200 |
[user, model "Rain"],即预填充 | 400;03:13 重发一次,仍是 400 |
[user, model, user, model],刚保存完模型回复的历史 | 400 |
| 上一行去掉末尾的 model 回合,最后一项是新的 user 消息 | 200 |
[user] 加工具定义 | 200,返回带 thoughtSignature 的 functionCall |
[user, model(functionCall)],还没有工具结果 | 400 |
[user, model(functionCall), user(functionResponse)] | 200 |
[user, model(functionCall), user(functionResponse, 文字)] | 200 |
第三行和第四行是同一段历史,只差末尾那一条 model 回合,状态码就从 400 变成 200,修复的要点全在这里。每个 200 响应里的 modelVersion 都是 gemini-4-argon;400 的响应体不带 modelVersion,归到 Argon 的依据是请求里的模型 ID 和 Google 写明的规则。
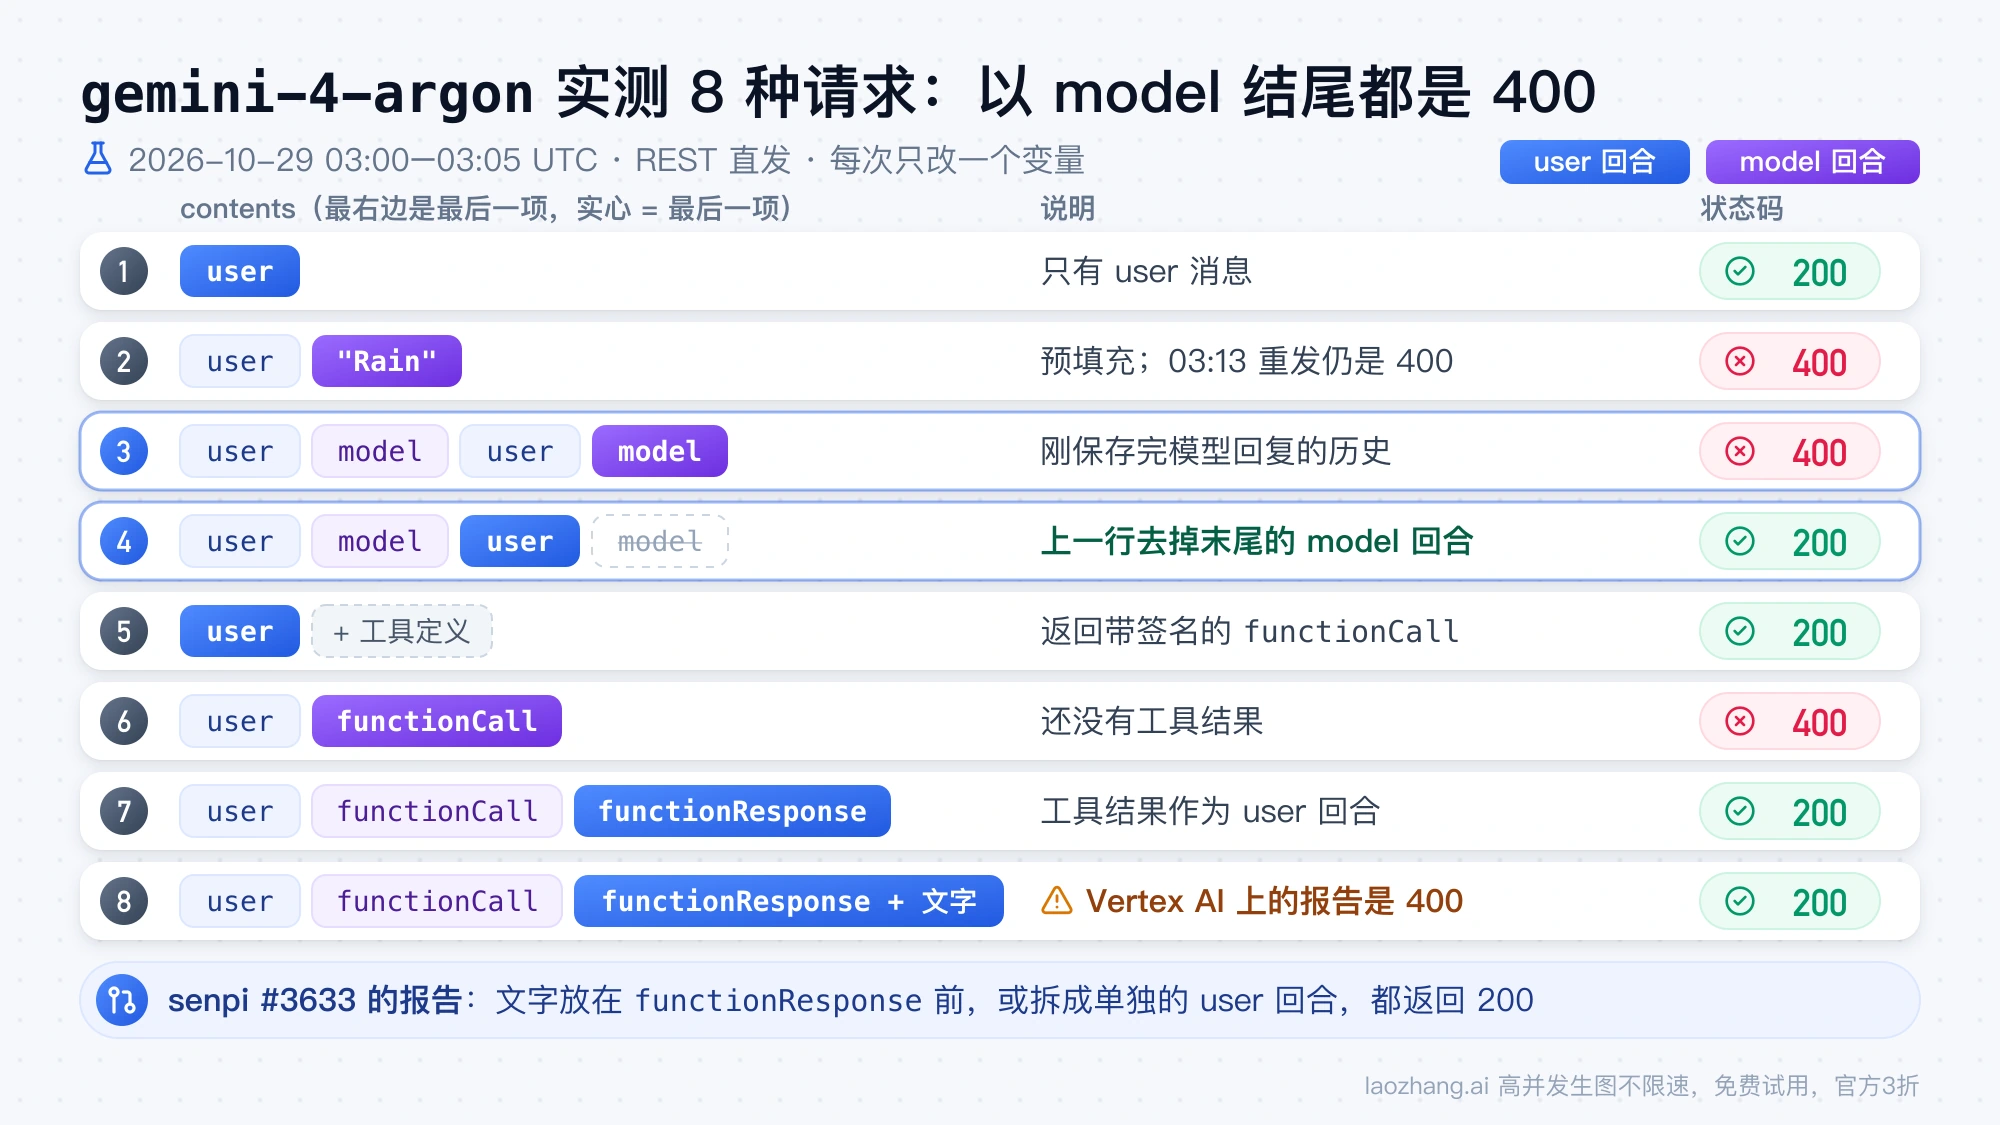
最后一行要按线路看。functionResponse 后面跟一段文字,在这条线路上返回 200,而上一节 senpi #3633 在 Vertex AI 上、AgentSMLA 在 Google Cloud Express 上得到的都是 400。两边的结果只代表各自的线路,你的代码只要有可能跑在 Vertex AI 上,就按会报 400 来写。
这组测试只覆盖一条线路、一天、每种形态一次(预填充两次)。把文字放在 functionResponse 前面、把工具结果和文字拆成两个 user 回合、用 systemInstruction 或 JSON schema 代替预填充,这几种这一轮没有拿到 Argon 的结果,下一节对应的写法依据 Google 的文档和上面的 Vertex 报告。空的 model 回合(parts: [{"text": ""}])这一轮返回的是线路自身的 500,得不出结论。
代码怎么改:发请求前保证最后一个回合是 user
不管属于哪一类,修复都落在同一个位置:contents 组装好、请求发出之前。先加一道末尾检查,再按用途替换预填充、调整工具结果的写法。通过 OpenAI 兼容格式调用时,对应的检查对象是 messages 最后一条不能是 assistant。
发送前检查 contents 的最后一项
下面这个函数在最后一项是 model 回合时,要么追加你准备发的 user 消息,要么去掉那条模型回复(重新生成上一条回答时就是这种情况)。如果最后是 functionCall,说明工具还没执行,直接拦下来,不要把它删掉。
def ensure_user_last(contents, next_user_text=None):
    """返回一份以 user 回合结尾的 contents。"""
    last = contents[-1]
    if last["role"] != "model":
        return contents
    if any("functionCall" in part for part in last["parts"]):
        raise ValueError("最后是 functionCall:先执行工具,再把 functionResponse 作为 user 回合发回")
    if next_user_text:
        return contents + [{"role": "user", "parts": [{"text": next_user_text}]}]
    # 重新生成:去掉旧的模型回复,让模型针对上一条 user 消息重新回答
    return contents[:-1]
预填充改成 systemInstruction 或结构化输出
Google 给的替代是:原来用预填充去掉开场白或逼出 JSON 的,改用 system instruction 或结构化输出。去开场白、定语气、规定开头写进 systemInstruction:
{
  "systemInstruction": {"parts": [{"text": "只输出译文,不要任何开场白。"}]},
  "contents": [
    {"role": "user", "parts": [{"text": "把 Hello world 翻译成西班牙语。"}]}
  ]
}
要固定 JSON,就在 generationConfig 里声明 MIME 类型和 schema,不再往 model 回合里放一个 {。字段写法以 Gemini API generateContent 的结构化输出文档为准;用 Interactions API 时,对应的是 system_instruction 和 response_format。
{
  "contents": [{"role": "user", "parts": [{"text": "给出一个城市和它所在的国家。"}]}],
  "generationConfig": {
    "responseMimeType": "application/json",
    "responseJsonSchema": {
      "type": "object",
      "properties": {"city": {"type": "string"}, "country": {"type": "string"}},
      "required": ["city", "country"]
    }
  }
}
续写被截断的回答,也不能再把半截内容放在 model 回合里,改成放进新的 user 消息,请模型从断开的地方接着写。Argon 的长输出另有官方续写机制,见 Gemini 4 Argon API finish_reason 怎么处理:长输出续写与中转实测。
工具调用:functionResponse 发回去,放在回合最后
模型返回 functionCall 后,下一次请求要把模型那一回合原样带上,包括其中的 thoughtSignature,不要删掉,也不要自己生成;Gemini 4 Argon 的迁移清单同样要求多轮和函数调用请求带上包括思考签名在内的完整历史。之后接一个 user 回合放 functionResponse。需要附加提示文字时,让 functionResponse 排在回合最后,或者像下面这样把文字拆成单独的 user 回合;工具结果里有图片时,同样把图片移到下一条 user 消息。
"contents": [
  {"role": "user", "parts": [{"text": "巴黎现在多少度?用工具查。"}]},
  {"role": "model", "parts": [{
    "functionCall": {"name": "get_weather", "args": {"city": "Paris"}, "id": "call_74181"},
    "thoughtSignature": "原样回传模型返回的值"
  }]},
  {"role": "user", "parts": [{
    "functionResponse": {"name": "get_weather", "id": "call_74181", "response": {"temperature_c": 14}}
  }]},
  {"role": "user", "parts": [{"text": "用一句话回答。"}]}
]
这个 400 不要放进重试逻辑
Gemini API 排障文档写明只对 429、408、5xx 这类临时错误重试,400 属于请求本身的问题,不要重试;senpi 维护者 2026 年 10 月 20 日也要求把这个 400 归为请求错误,不触发冷却或切换备用模型。不排除它,就会出现 LiveKit Agents 的 #2108 里那样的情况:同一段坏历史被循环重试,语音 agent 再也不说话。
Gemini 4 Argon 调 countTokens 返回 400:多半是同一条规则
2026 年 10 月 27 日,Obsidian 插件 Gemini Scribe 的维护者 allenhutchison 在 obsidian-gemini 的 #1708 报告:用 gemini-4-argon 作为聊天模型时,新会话第一轮的 models.countTokens 返回 400 INVALID_ARGUMENT,日志里的报错被截成 Requests ending wi…are not supported.,同样的流程换成 gemini-flash-latest 不报错。报告里的报错文字中间被截断,作者推测完整文字是 Requests ending with a model turn are not supported,原因是回复刚保存时会话历史停在模型回合,Argon 拒收 contents 以 model 结尾的 countTokens 请求,他在报告里把这两点都标为未经验证。上面 2026 年 10 月 29 日的 generateContent 结果里,以 model 结尾的请求同样被拒,和这个推测一致,但不能证明 countTokens 返回的就是这句。
改法和生成请求一样:计数时只传到最后一个 user 回合,或者先把即将发送的 user 消息加到末尾再计数,后者本来就更接近真正要发出的请求。
last_user = max(i for i, c in enumerate(history) if c["role"] == "user")
result = client.models.count_tokens(model="gemini-4-argon", contents=history[: last_user + 1])
另一个有文档支持的办法是直接读生成响应里的 usageMetadata.promptTokenCount。Firebase AI Logic 的 token 计数文档说明,usageMetadata 每次响应都会返回,本身不消耗 token、不收费;countTokens 也免费,上限 3,000 RPM,支持列表里有 gemini-4-argon,输入计数包含系统指令和工具定义。这份报告里插件出问题的正是兜底:新会话还没有 usageMetadata,token 显示和上下文压缩阈值都按 0 计算。
经过中转时还会遇到另一种 400。2026 年 10 月 29 日,前面实测用的那条中转线路上,:countTokens 不论 contents 以 user 还是 model 结尾,都返回 400 unsupported action: countTokens:这是中转层不提供这个接口,和 Google 的规则无关。所以 countTokens 报 400 时先看报错文字,是 unsupported action 一类,就改读 usageMetadata 或在本地估算;是 Requests ending with a model turn,按上面的办法裁掉末尾的 model 回合。
酒馆、Gemini CLI、opencode 里报错:截至 2026 年 10 月 29 日的修复状态
通过工具间接调用时,请求由工具拼装,你能做的通常是升级、改设置,或者在会话里发一条新消息,让最后一个回合重新变成 user。截至 2026 年 10 月 29 日,各工具的已知触发场景和状态如下。
| 工具 | 触发场景 | 状态与处理 |
|---|---|---|
| 酒馆(SillyTavern)等角色扮演前端,填 AI Studio key 或走反代 | 预设或设置里有 assistant 预填充、续写、让回复以固定内容开头之类的选项,或提示词后处理改了消息顺序 | 新开一个对话,以真实的 user 消息结尾测试;关掉预填充、续写类设置和预设末尾的 assistant 条目,不报了再逐项加回,找出是哪一项 |
| Gemini CLI | /rewind、流式输出被中断、连按 Ctrl-C 之后,或 ReadFile 读取 .png 之后 | 修复 PR #29612(2026-10-07 合并)和 #29728(2026-10-13 合并)都包含在 2026-10-20 发布的 v0.65.0 里,升级到 v0.65.0 或更高 |
| opencode | 子代理设了 steps,到上限时的提示被当成 assistant 消息追加(#45359);经 OpenRouter 用 Argon 时,read 读图之后的那一步(#55694) | #45359 已关闭,但 1.18.31 仍有人遇到,后续修复 PR #55382 没有确认的发布版本;#55694 仍开放。临时办法是发一条新消息继续 |
| LangChain(langchain-google 的 vertexai) | 工具结果 ToolMessage 和紧随其后的 HumanMessage 被合并成同一个 user content(#1995) | 仍开放;在工具结果之后不要紧跟 HumanMessage,先让模型对工具结果作答 |
| LiteLLM | Vertex AI 上 Gemini 3.7 Flash 的历史以纯文字 assistant 消息结尾(#38537) | 仍开放;调用前自己检查 messages 末尾 |
| OpenRouter(如 Hermes Agent) | 带图片的工具结果作为最后一条消息;界面只显示 Provider returned error | 原文在 error.metadata.raw;按上文把图片移出工具结果,报告里这样改后返回 200 |
| LiveKit Agents(JS) | 语音打断后,截断的 assistant 消息排到了用户转写之后(#2108,3.6 Flash 和 3.5 Flash-Lite 都复现) | 仍开放;400 被循环重试,在框架修复前要自己排除这个错误 |
| instructor | 结构化输出 reask 的请求以 model 回合结尾(#2631) | 仍开放 |
Gemini CLI 的修复记录见 gemini-cli 的 #29530,opencode 的步骤上限问题见 opencode 的 #45359,OpenRouter 上带图片工具结果的复现见 Hermes Agent 的 #139313。用 npm 升级 Gemini CLI 的方法见 Gemini CLI 安装教程:全平台 npm 安装,个人 Google 登录已停用。酒馆的菜单名随版本和预设变化,找不到对应开关时,就用新对话加真实 user 消息的办法逐项排除。
Requests ending with a model turn 的相关问题
和 "role system is not supported" 是同一个报错吗?
不是。那条 400 说的是 system、developer、tool 这类角色不被当前模型或接口接受,要改的是角色和指令字段;这里的问题只在于最后一个回合是谁。排查方法见 修复 API 400 角色不受支持错误,不破坏系统提示词。
Claude 也有类似的预填充报错吗?
有。Anthropic 从 Claude 4.6 起的模型同样拒收以 assistant 消息结尾的请求,报错文字和替代办法见 Claude 预填充(prefill)400 报错:4.6 起模型全拒收,按用途替换。
Gemini 4 Argon 还有哪些 400 和这个不是一回事?
截至 2026 年 10 月 29 日至少还有三种。按 Google 的 Argon 迁移清单,显式缓存 cachedContents 在 Argon 上不支持,会返回错误;Function call is missing a thought_signature 说的是回传的 functionCall 缺少思考签名;Vertex AI 上也有用户报告 Thinking budget is not supported。这几种报错文字不同,裁掉末尾的 model 回合解决不了它们。
参考来源12
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月29日。
参考来源12
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月29日。
- 1.Google 的 Gemini 3.6 Flash 与 3.5 Flash-Lite 更新说明ai.google.dev/gemini-api/docs/whats-new-gemini-3.6
- 2.Gemini 3.6 Flash 不再支持模型预填充续写linux.do/t/topic/2631609
- 3.senpi 项目的 #3633 报告github.com/code-yeongyu/senpi/issues/3633
- 4.Gemini API generateContent 的结构化输出文档ai.google.dev/gemini-api/docs/generate-content/structured-output
- 5.Gemini 4 Argon 的迁移清单ai.google.dev/gemini-api/docs/generate-content/latest-model
- 6.Gemini API 排障文档ai.google.dev/gemini-api/docs/troubleshooting
- 7.LiveKit Agents 的 #2108github.com/livekit/agents-js/issues/2108
- 8.obsidian-gemini 的 #1708github.com/allenhutchison/obsidian-gemini/issues/1708
- 9.Firebase AI Logic 的 token 计数文档firebase.google.com/docs/ai-logic/count-tokens
- 10.gemini-cli 的 #29530github.com/google-gemini/gemini-cli/issues/29530
- 11.opencode 的 #45359github.com/anomalyco/opencode/issues/45359
- 12.Hermes Agent 的 #139313github.com/NousResearch/hermes-agent/issues/139313