Antigravity Argon 一直 Retrying (1/9):大文件修改被 60 秒截断
Gemini 4 Argon 改大文件时,内容整段生成超过约 60 秒就被断开,九次重试只是重发同一请求。看到 1/9 就停,在原对话里按每次 100 行以内分批改。
文章目录
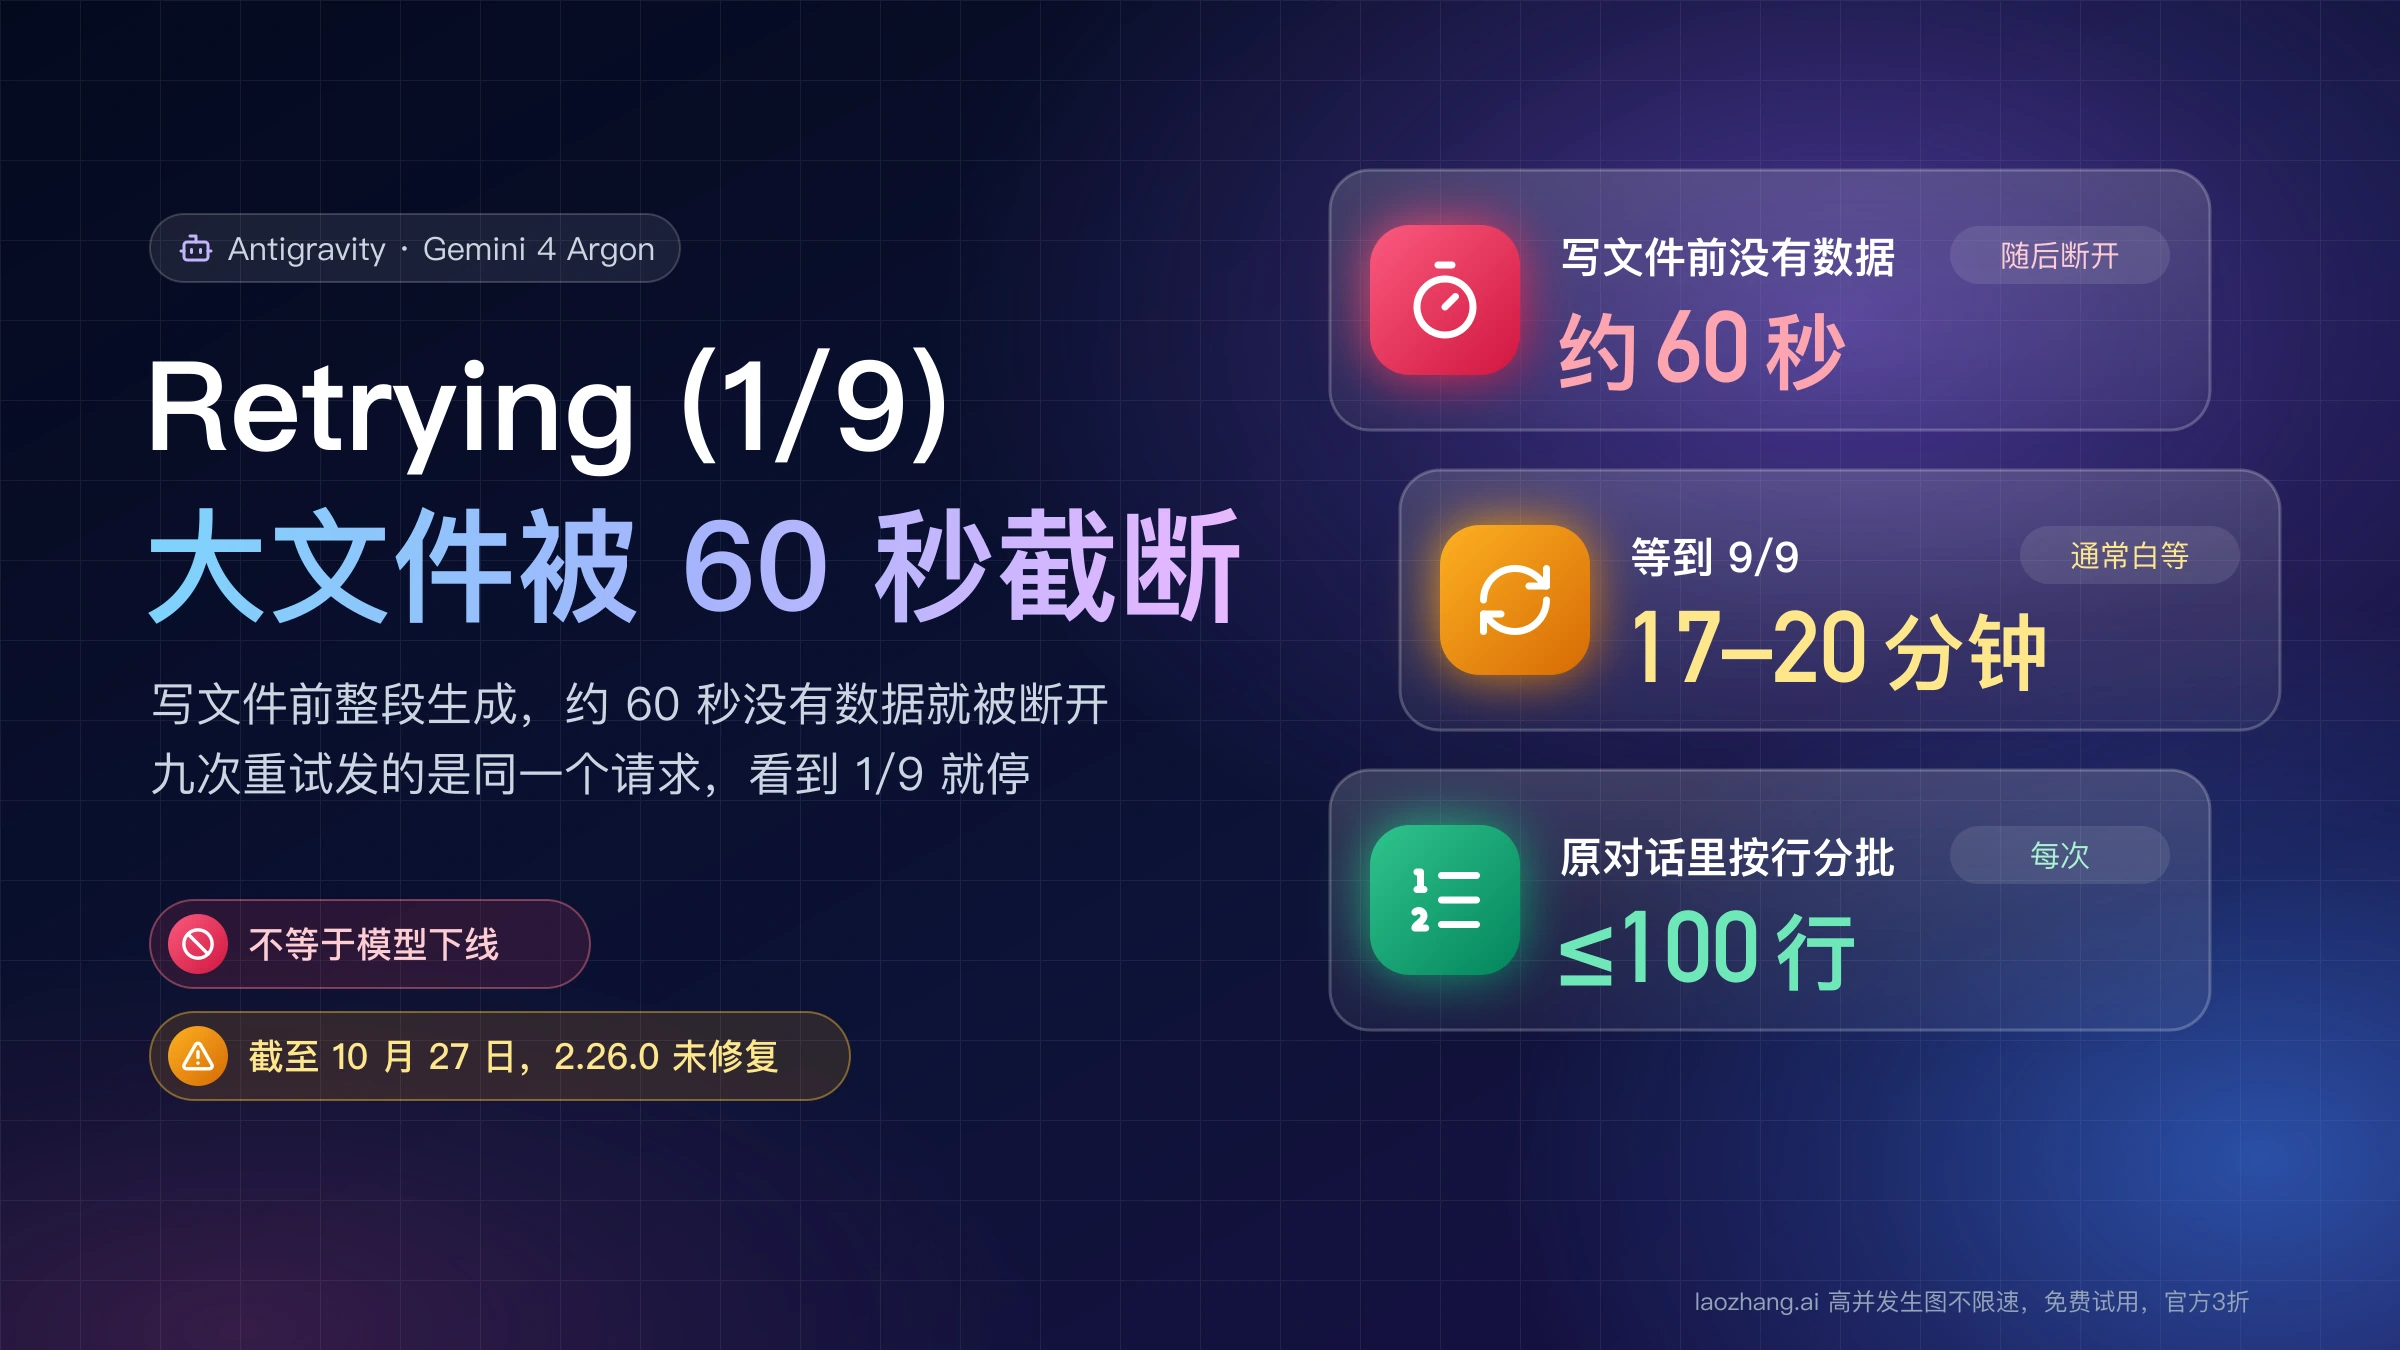
在 Antigravity App(或 IDE 扩展、CLI)里用 Gemini 4 Argon 时,某一步显示 Model unavailable, retrying in 4s (attempt 1/9),Windows 客户端上是更短的 Retrying (1/9)…,一路数到 9/9 后,对话以 "Agent execution terminated due to error" 结束。这个提示并不表示模型下线了,额度用完、模型容量不足、网络断开都会触发同样的倒计时。Argon 上报告最多的一种,发生在 Agent 写文件、改文件的那一步:Argon 要把整段文件内容生成完才一次发出,生成期间连接上没有任何数据,满约 60 秒就被断开,而重试只是把同一个请求原样再发一遍,所以九次通常都失败,白等 17–20 分钟。
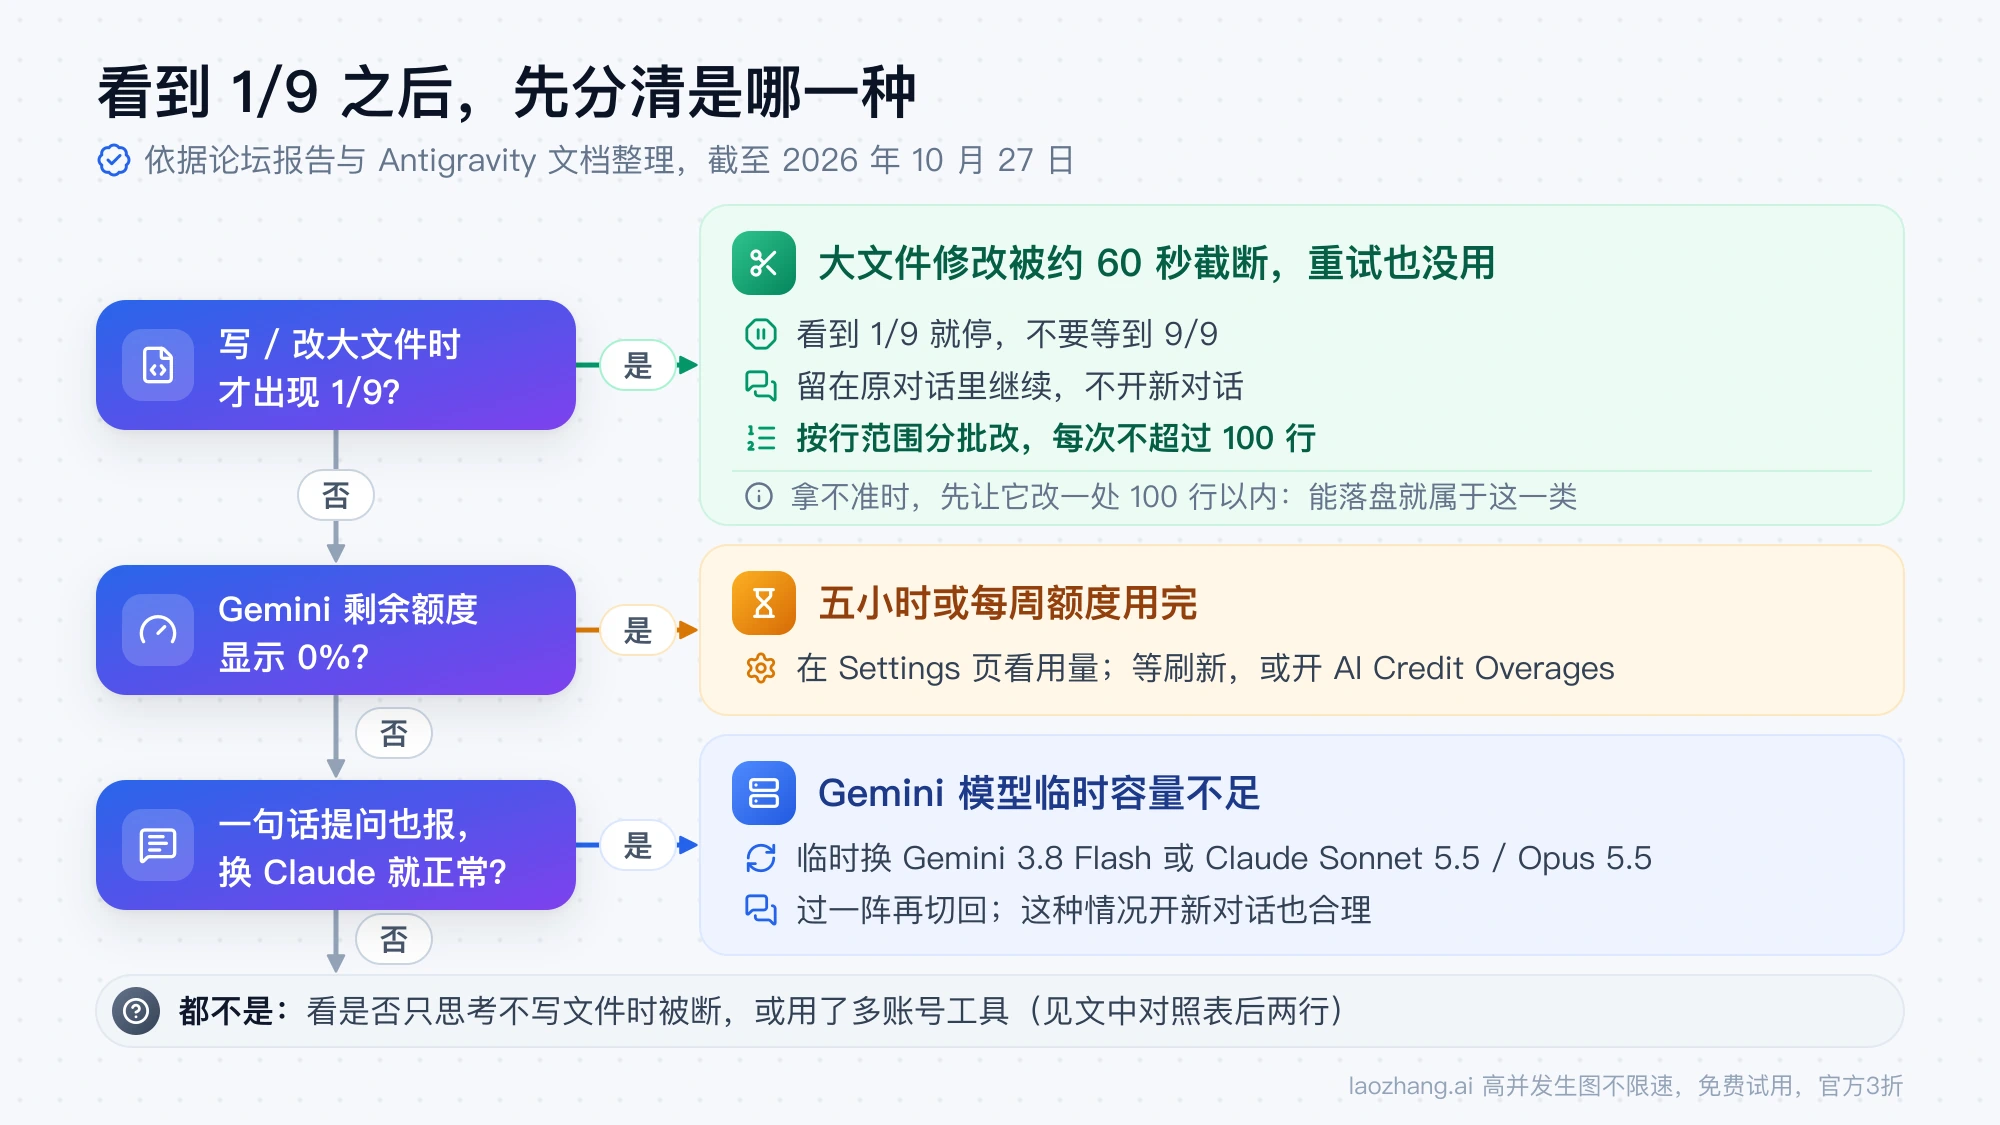
所以,如果提示出现在 Agent 新建或修改一个大文件的时候,看到 1/9 就停下,不要开新对话,在原对话里告诉它:"把刚才那次文件修改按行范围拆成几次 replace_file_content,每次不超过 100 行。"如果连一句话的提问都报、所有 Gemini 模型都报而 Claude 正常,多半是 Gemini 模型临时容量不足,临时换 Gemini 3.8 Flash 或 Claude Sonnet 5.5 / Opus 5.5;Settings 页面里 Gemini 剩余额度显示 0%,就是额度用完了,等刷新或打开 AI Credit Overages。截至 2026 年 10 月 27 日,Antigravity App 最新的 2.26.0 更新日志里没有针对这个 60 秒截断的修复。
实际跑过的有两项,都在 2026 年 10 月 27 日:一是在论坛用户 Xiphiros 公开的排查日志上重跑他的分析脚本,结果与他发布的数据完全一致;二是通过第三方网关直接调用 Gemini 4 Argon,对比"一次工具调用写文件"和"纯文本输出"时数据是怎么到达的。没有在 Antigravity 里复现这个提示,下文关于 Antigravity 内部的现象来自 Google AI 开发者论坛的用户报告和 Antigravity 官方文档。
Model unavailable, retrying (attempt 1/9) 是什么意思:不等于模型下线
attempt 1/9 的意思是:这一步的模型请求失败了,Antigravity 正在自动重试,最多试 9 次,retrying in 4s 是距离下一次重试的倒计时。这个带次数的倒计时是 App 2.16.0 加上的功能,更早的 2.14.0 把"一次临时服务错误就结束会话"改成了"按退避间隔重试大约十二分钟"(Antigravity 更新日志)。九次都失败后,日志里记的是 stream reading error: unexpected EOF,界面上显示 "Agent execution terminated due to error"。中文社区说的"反重力一直 retry",指的就是这个循环。
关键在于,"Model unavailable" 是 Antigravity 给所有"请求没拿到结果"的情况贴的同一个标签。Google 的文档没有解释这段提示文字,论坛里的报告显示,它至少覆盖了五种不同的失败:大文件修改被截断、模型临时容量不足、额度用完、长推理中途停顿被断,以及第三方多账号工具引起的账号问题。前两种最容易混淆,因为提示一模一样,处理方法却相反。Antigravity 只是回复慢、没有出现重试计数的,见 Gemini 3.8 Flash 在 Antigravity 中很慢?先分清四种卡顿再处理。
Antigravity 一直 retry 是哪一种:五种情况对照
分辨的依据是三件事:失败发生在哪一步、换个小请求或换个模型会不会好、额度还剩多少。下表按这三件事对号入座:
| 你看到的情况 | 最可能的原因 | 先做什么 |
|---|---|---|
| Agent 新建或修改大文件的那一步,约 60 秒后出现 1/9;额度还有,别的提问正常 | 文件内容整段生成期间连接上没有数据,约 60 秒被断开,重试发的是同一个请求 | 停在 1/9,在原对话里让它按行范围分批改,每次不超过 100 行 |
| 连一句话的提问都报;所有 Gemini 模型都报而 Claude 正常;或提示 "Our servers are experiencing high traffic" | Gemini 模型临时容量不足;论坛里回帖的用户是这样解释的,Google 没有正式说明 | 临时换 Gemini 3.8 Flash(Medium 或 Low)或 Claude Sonnet 5.5 / Opus 5.5,过一阵再切回;这种情况开新对话也合理 |
| Settings 页面里 Gemini 剩余额度为 0%,或刚连续跑了很重的任务 | 五小时额度或每周额度用完 | 等额度刷新,或在 AI Credit Overages 里改用 AI credits |
| 不写文件,只是长时间思考,约 60 秒或 120 秒后出现 "The stream was interrupted" | 推理过程中数据停顿太久,连接在某一环节被断开,具体是哪一环不清楚;代理、VPN 或公司防火墙的空闲超时是可能的原因之一 | 降低思考等级、把任务拆小;开着代理、TUN 或公司防火墙的,可以先不经过它们再试一次 |
| 用了 Antigravity Tools、Antigravity-Manager 这类多账号工具,同一台电脑换个账号就好或就坏 | 第三方工具访问违反 Antigravity 条款,账号可能被限制 | 停用这类工具,只用官方客户端登录自己的账号 |
拿不准是第一行还是第二行时,只需要试一次:让同一个 Agent 做一个不超过 100 行的小修改。小修改顺利落盘,说明触发条件是请求太大,按第一行处理;连小修改、连一句话的提问都失败,再看第二、三行。这个判断方法是从上面几类报告推出来的,没有在 Antigravity 里实际验证过。容量问题临时换成 3.8 Flash 要放弃哪些能力、成本差多少,见 Gemini 4 Argon 和 3.8 Flash 区别:实测成本差多少,哪些任务该换。
大文件怎么改得过去:按行范围分批,每次不超过 100 行
只要 Agent 每一次写文件的内容足够小,生成时间就落在 60 秒以内,连接不会被断。下面的做法来自 Google AI 开发者论坛 Antigravity 2.23.0 "Model unavailable" 重试循环排查帖 里几位用户的报告:有人在 Windows 上把每次修改限制在 60–80 行后不再重试,另一位用户在 macOS 的 App 2.24.0、Argon(High)上照做后同样有效。
- 提示出现在写文件那一步时,看到第一个
attempt 1/9(或Retrying (1/9))就停止这一轮,不要等它数到 9/9。 - 留在同一个对话里,直接发一句:"刚才那次文件修改太大,被中断了。请把它拆成几次
replace_file_content,按行范围分批修改,每次不超过 100 行;新建的大文件先写前 100 行,再分段追加。" - 要求里写明行范围或行数上限,不要只说"改小一点"或"大约写 400 行",因为模型对篇幅的估计并不准。
- 后面的任务在第一条消息里就写上"每次工具调用修改不超过 100 行",不要等出了错再拆。
- 分批之后仍在某一批失败,就把那一批再拆小;连小修改也失败,回到上一节的对照表看是不是别的原因。
100 行这个数是这样来的。2026 年 10 月 27 日的 Argon 实测里,模型每秒大约输出 95–116 个 token,按 60 秒算,一次工具调用最多能生成约 5,700–7,000 个 token(60 × 95、60 × 116),在那次测试的 Python 文件里相当于 600–700 行;写 135 行用了 20.8 秒,约占 60 秒的三分之一;按比例算,100 行大约 15 秒,只用到 60 秒的四分之一左右。同一次测试里,要求"约 400 行",模型实际写了 551–773 行,这就是第 3 步要写明行数的原因。这是用 5 次调用算出来的经验值,不同语言、不同文件的每行 token 数不一样。
分批能减少失败,但不能保证不再出现。Xiphiros 的对照实验里,把 1,200 行的文件分成 12 次、每次 100 行来写,3 次里只成功了 1 次:一次在第 9 批出现了 60.2 秒没有数据;另一次是第 5 批报了另一种错误 proto: unexpected EOF,此前约 46 秒没有收到数据,之后也没有再重试(Xiphiros 公开的排查数据仓库)。Antigravity 里的推理是流式输出的,截断发生在最后一批数据到达之后约 60 秒:dllhell 的日志里,每次断开都正好在最后一段流式输出的思考或状态文字之后 60.0 秒,让 Argon 在调用前先输出一句状态文字来保持连接也没有用(Google AI 开发者论坛上 dllhell 关于 Argon 重试的长帖)。所以工具调用之前的推理不占这 60 秒;每次 100 行仍然失败的原因没有查明,Xiphiros 列出的一种可能是服务端偶尔响应变慢。
该等到 9/9、点 Cancel 还是开新对话
如果失败发生在写大文件的那一步,等下去没有意义,因为每次重试发的都是同一个请求,会在同样的位置被断开。等待的代价也不小:从 Xiphiros 公开的重试记录看,第 1 次失败后等 4 秒再试,之后的等待大致逐次翻倍,最长的两次等待在第 8 次和第 9 次尝试之前,也就是界面显示 7/9、8/9 的时候,每次约 2.4–4 分钟;他的日志里有 12 轮把九次全部用完,从第一次失败到最终停下用了 16.7–20.2 分钟。Antigravity 更新日志里写的是"大约十二分钟",那是 Google 自己的说法,Xiphiros 日志里实际记录的时间更长。
停下之后,大文件这种情况最好留在原对话里继续。论坛用户 dllhell 记录过一段长对话:每次被断开后,对话记录里都会追加一行 "Error: The stream was interrupted. Please continue the task you were working on.",Argon 在第 6 次尝试时看到前面连续几次中断,自己把修改拆成了按行范围的小块,后面的修改也一直保持分块(Google AI 开发者论坛上 dllhell 关于 Argon 重试的长帖)。开新对话会丢掉这些上下文,新的 Agent 拿到同样的任务,往往会再尝试一次同样大的修改。
容量问题正好相反。所有提问都失败、换模型就好的时候,Google AI 开发者论坛上一位经常回帖的用户给的建议就是开一个新对话、换一个模型,并把之前的进度用几句话交代给新对话。社区里流传的"自动点 Retry"脚本对两种情况都没有帮助:它只是让同一个请求更快地再发一遍。
为什么改文件会断、聊天不会:Argon 写文件前 60 秒没有任何数据
Antigravity 的 Agent 通过一条流式连接接收 Argon 的输出。推理过程和普通文字是一小段一小段陆续到达的,连接上一直有数据;"工具调用"就是 Agent 写文件、改文件那一步(write_to_file、replace_file_content),要写入的整段内容是一个参数,模型生成完之后才一次性发出来。Xiphiros 在 Linux 上用 App 2.23.0 和 Argon(High)记录的日志里,2026 年 10 月 14 日到 15 日共有 136 次被重试的失败,没有一条是 503、UNAVAILABLE、RESOURCE_EXHAUSTED 或 "No capacity" 这类服务端错误;其中有计时的 79 次"没收到任何响应"的请求,全部在开始后 60.27–61.08 秒被关闭。他的对照实验里,一次写入 1,200 行的新文件 3 次都在约 60.3 秒被断,而长时间推理、写约 1,500 个英文单词的文章,即使持续三四分钟也能正常完成。他在 App 2.23.1 和 2.25.0 上复测,结果一样。
连接是被谁关掉的,目前没有定论。Xiphiros 根据日志推测是 Google 前端负责加密连接的那一层,但他也说明还需要抓包才能确认,公开文档里也找不到哪个 googleapis.com 接口写了 60 秒的限制;Google 没有对此作出确认。
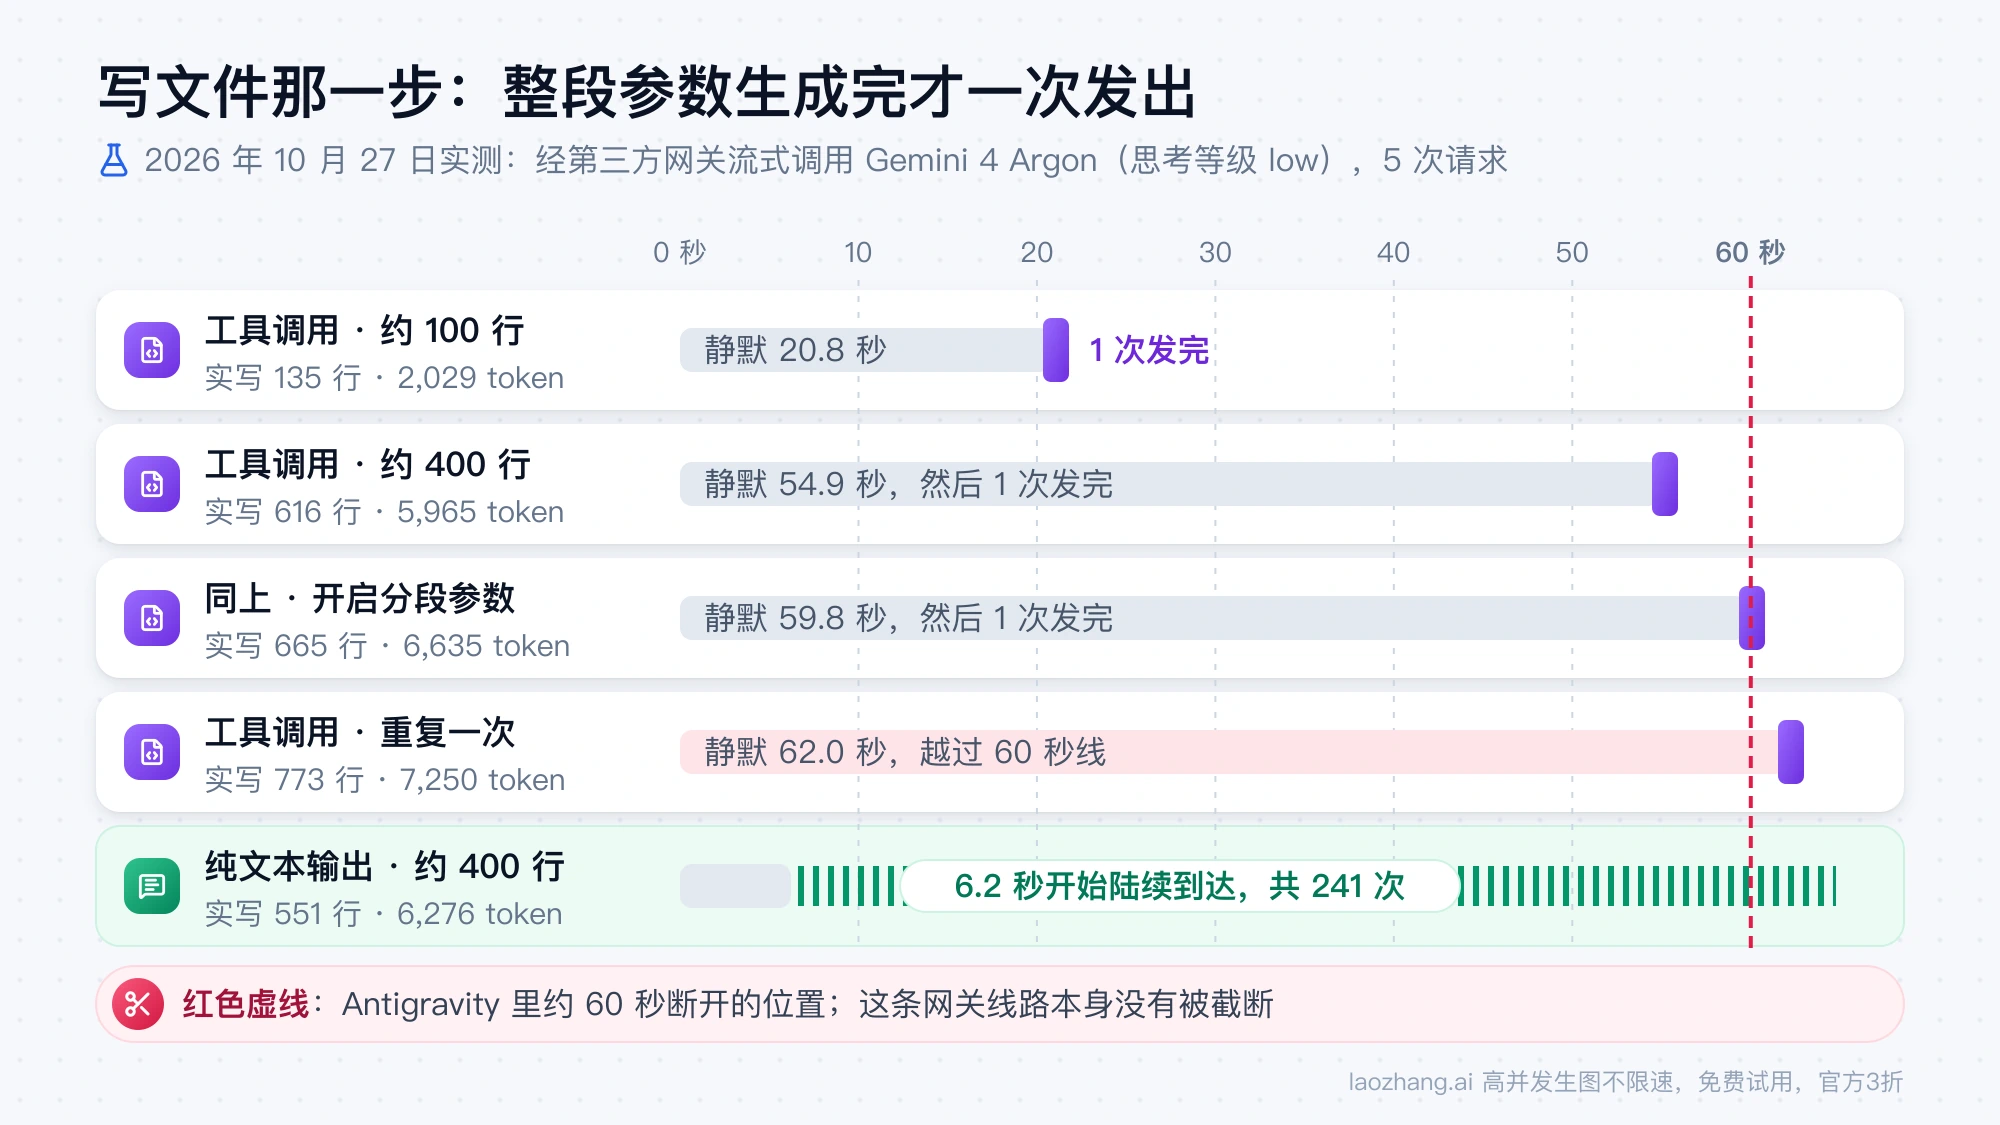
2026 年 10 月 27 日,通过 laozhang.ai 的 Gemini 原生流式接口调用 Gemini 4 Argon,思考等级设为 low,只给它一个 write_to_file(path, content) 函数,要求把一个 Python 文件放在一次函数调用里写完,再要求把同样的文件直接作为文字输出。这条线路不是 Antigravity 使用的接口,测试过程中也没有被 60 秒截断,它能说明的只是 Argon 返回工具调用参数的方式:
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
| 请求方式 | 实际写出行数 | 输出 token | 第一批数据到达 | 数据分几次到达 |
|---|---|---|---|---|
| 一次工具调用,要求约 100 行 | 135 | 2,029 | 20.8 秒 | 1 次 |
| 一次工具调用,要求约 400 行 | 616 | 5,965 | 54.9 秒 | 1 次 |
同上,并开启 streamFunctionCallArguments | 665 | 6,635 | 59.8 秒 | 1 次 |
| 一次工具调用,要求约 400 行(重复) | 773 | 7,250 | 62.0 秒 | 1 次 |
| 纯文本输出,要求约 400 行 | 551 | 6,276 | 6.2 秒 | 241 次 |
每次工具调用都是在静默 20.8–62.0 秒之后,把 6.9–30.3 KB 的整段参数一次发完;同样的内容用纯文本输出,6.2 秒就开始陆续到达,之后最长的间隔也没有超过这个数。最后一行工具调用静默了 62.0 秒,放在 Antigravity 里就会撞上 60 秒的截断。5 次调用按 Google 标价合计约 $0.28。
论坛里有 Windows 用户说,同样的操作 Claude 模型很少出这个错,Gemini 模型却反复报。社区给出的解释集中在 Gemini 整段返回工具调用参数这一点上;Claude 在 Antigravity 里怎样传送工具调用参数,公开资料里没有可对照的说明。
自己用 Gemini API 写 Agent 的开发者也会遇到同样的静默期。Vertex AI 的函数调用文档提供了一个预览参数:在 toolConfig.functionCallingConfig 里把 streamFunctionCallArguments 设为 true,参数就会边生成边以 partialArgs 分段返回,适用于 Gemini 3 及以后的模型(Vertex AI 函数调用文档)。上表第三行在第三方网关上开启它,请求正常返回却没有任何变化,网关有没有把这个参数转发给 Google 不得而知,自己的代码里要直接对 Vertex AI 测一次。Antigravity 用户无法打开这个参数。代码里遇到这类失败时什么时候该重试、什么时候该换模型,见 大模型 API 该重试还是切备用模型?先过这五道门。
是额度用完、号被风控,还是节点问题
这三种说法在中文社区里最常见,各自对应对照表里的一行,判断条件不同。
额度用完:先在 Settings 里看 Gemini 用量
Antigravity 的 Google AI Pro 额度每五小时刷新一次,直到达到每周上限;Ultra 的额度更高,同样每五小时刷新;Google 没有公布具体数字,只说用量和 Agent 实际做的工作量相关(Antigravity 套餐与额度文档)。各模型的基础额度用量在 Settings 页面里能看到。基础额度用完后,AI Credit Overages 设为 Never 就等刷新,设为 Always 就自动扣你购买的 AI credits。Reddit 上一条关于 Argon 重试的高赞回答说,自己只在五小时额度剩余 0% 时才遇到这个提示,这条只看到了搜索摘要。用量还有剩余时,就不是额度问题。
额度耗尽时 App 会不会也显示重试倒计时,文档没有写;CLI 1.3.3 起,达到个人额度会直接提示,不再重试。另外要确认你的账号能用 Argon:截至 2026 年 10 月 27 日的模型列表里,Free 和 Google AI Plus 不能用,Google AI Pro 需要付费订阅或符合条件的高端设备试用,Ultra 和 Enterprise 可以;Pro 试用账号也用不了 Claude Sonnet 5.5 和 Opus 5.5(Antigravity 模型列表文档)。
号被风控:多账号工具本身违反 Antigravity 条款
NodeSeek 上有用户报告,用 Antigravity Tools 后一直 retry,换一个没用过这类工具的账号就正常;GitHub 上 Antigravity-Manager 项目也有"Pro 账号提问会一直 retry"的 issue。这些报告都在 Argon 发布之前,只看到了摘要,原因没有得到 Google 证实。Google 的立场写在 Antigravity 常见问题里:用第三方软件、工具或服务访问 Antigravity 违反服务条款,可能导致账号被暂停或终止;消费者套餐也不支持自动轮换账号(Antigravity 常见问题)。所以这类工具和换号脚本不在建议之列。另一方面,大文件修改被截断和账号无关,换一个账号,同样大的请求照样会在 60 秒被断。
换节点有没有用:代理可能断开长连接,但换节点解决不了截断
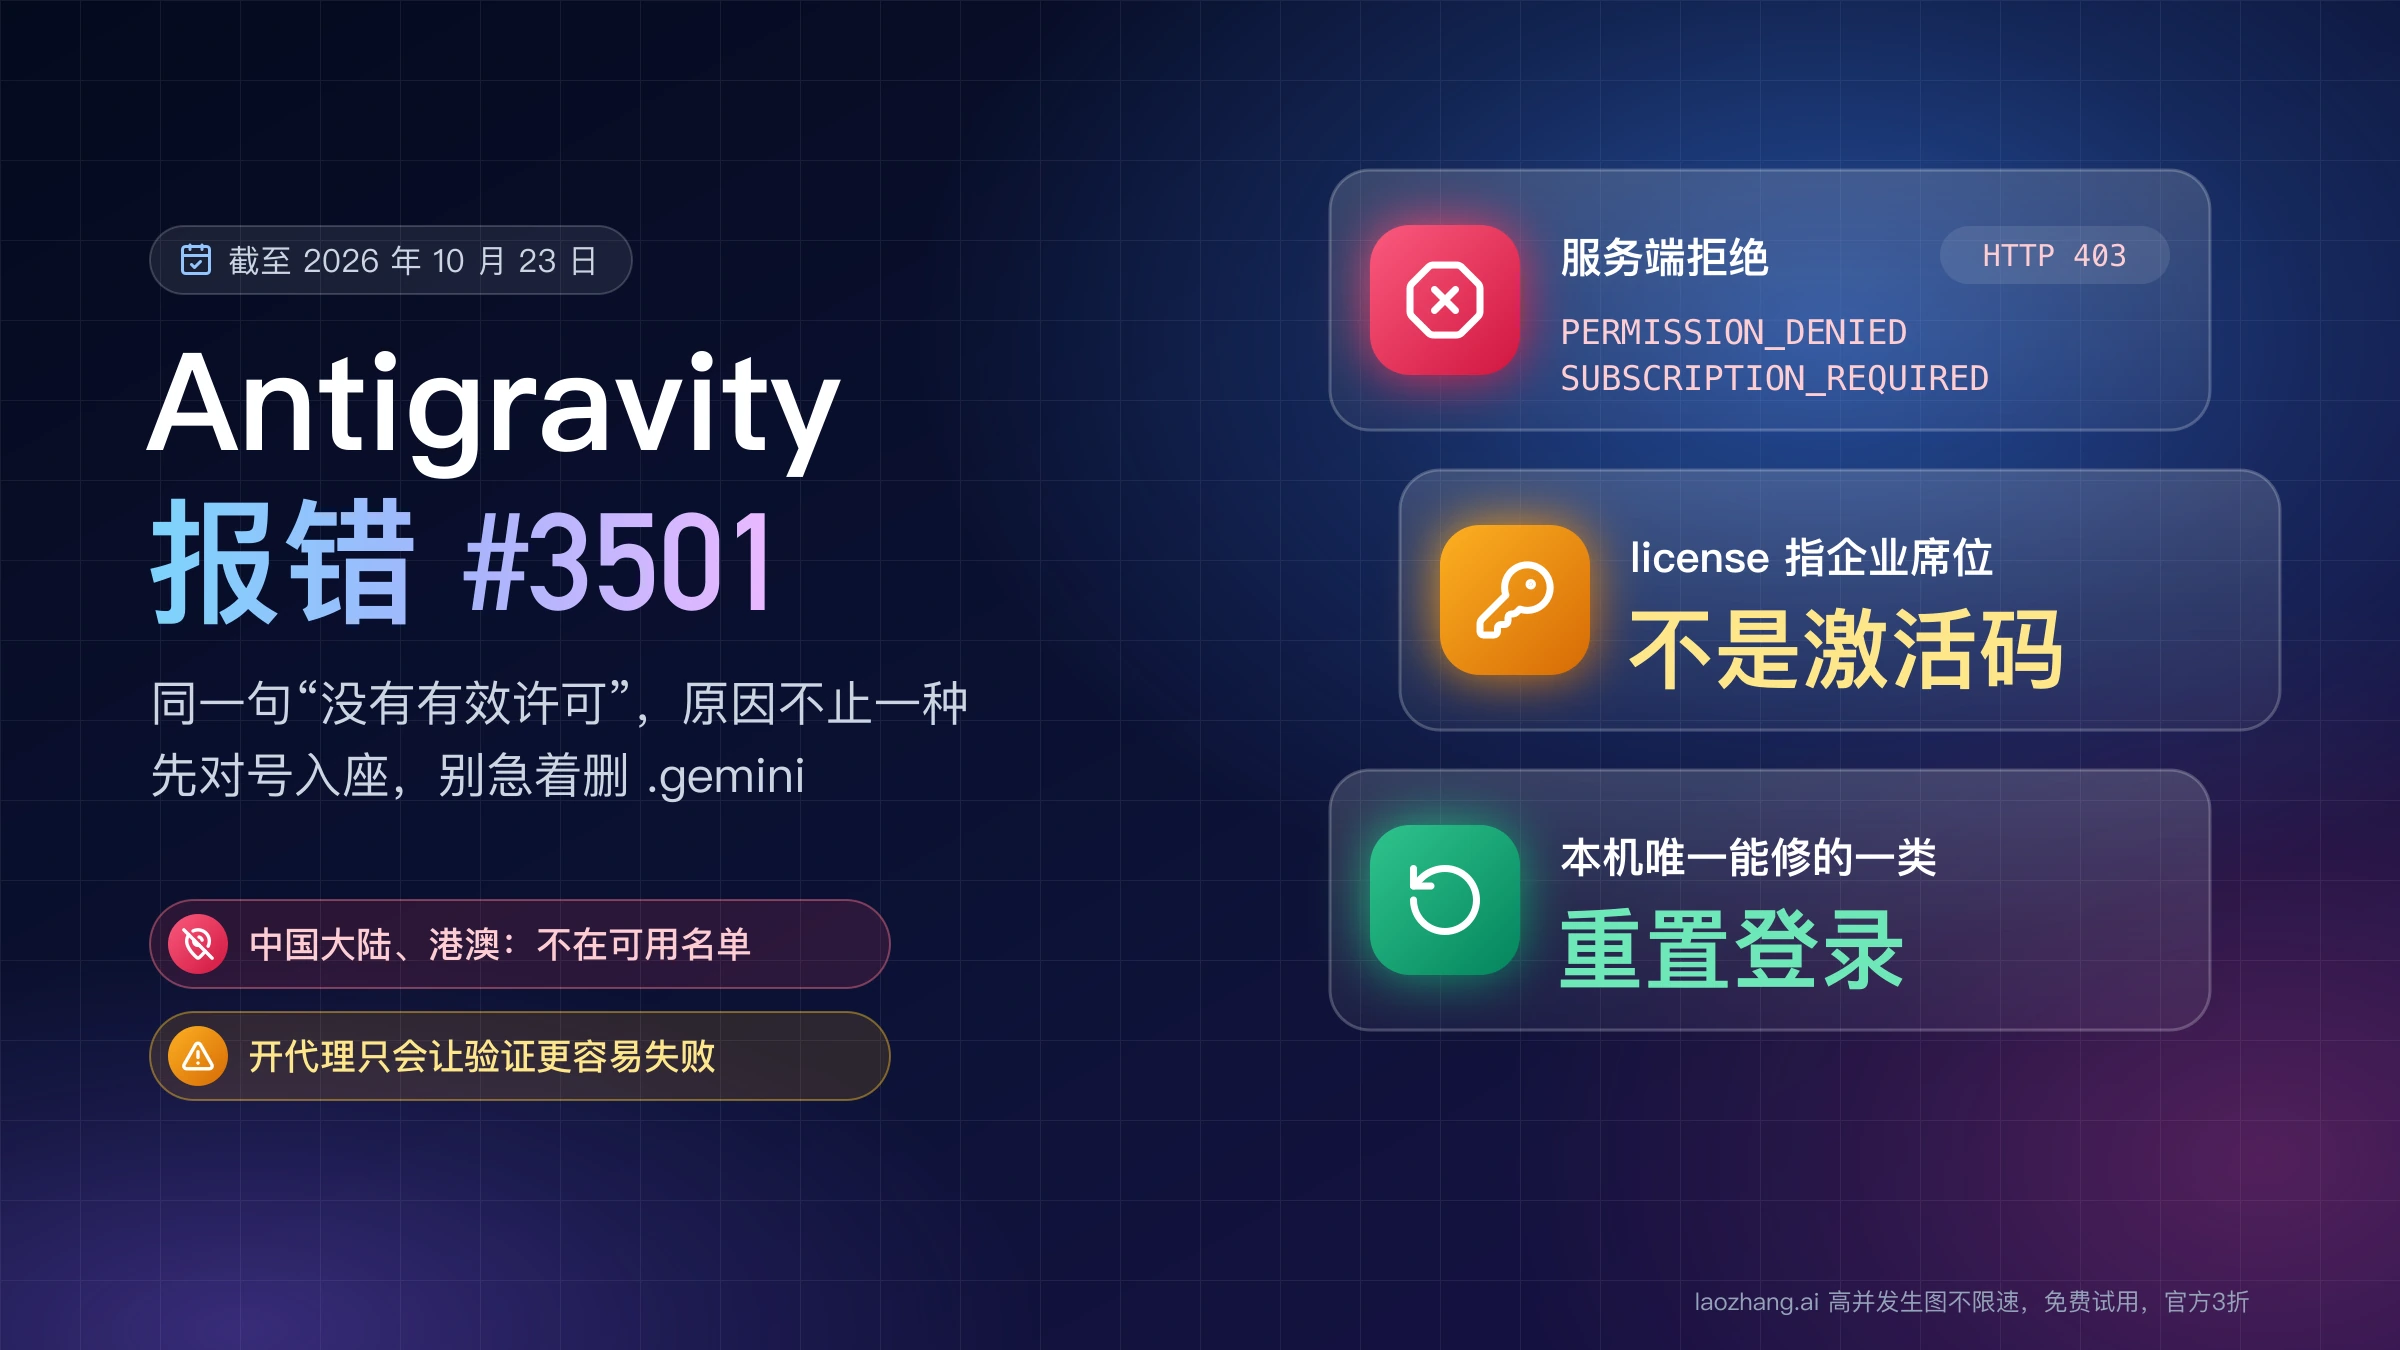
在一个"长推理约 120 秒就被打断"的报告下,帖子里的回复建议先不经过 VPN、代理或公司防火墙试一次,因为有些网络会断开看起来空闲了约 2 分钟的连接(Google AI 开发者论坛里关于推理约 120 秒被打断的帖子)。所以开着代理、TUN 模式时出现的长推理中断,代理的空闲超时是可能的原因之一。大文件那种情况不同:断开发生在连接的另一端,Linux、Windows、macOS 上都有人报告,换节点改变不了"整段内容生成超过 60 秒"这个事实。还要说明的是,Antigravity 常见问题里的可用地区名单没有中国大陆,登录阶段的地区和账号问题见 Antigravity 报错 #3501 无法登录:先查地区和账号,别删 .gemini。
Google 修了没有:截至 10 月 27 日,App 2.26.0 未见相关修复
截至 2026 年 10 月 27 日,Xiphiros 排查时用的 2.23.0(10 月 12 日发布)之后,App 又发布了 2.23.1(10 月 13 日)、2.24.0(10 月 15 日)、2.25.0(10 月 20 日)和 2.26.0(10 月 22 日),更新日志里都没有关于工具调用参数分段返回、保活数据或 60 秒截断的条目。帖子里的第一条回复是建议升级到 2.23.1,那个版本只修了登录时的许可证选择;Xiphiros 在 10 月 22 日用 2.25.0 复测,三次 1,200 行写入仍然在 60.21–60.38 秒被断,一个文件都没写成。2.26.0 修复的是"电脑睡眠唤醒或切换 Wi-Fi 后,连接断开导致 Agent 停止而不是自动重试",和这个问题不是一回事,论坛里也还没有人在 2.26.0 上复测。
CLI 那边有两处相关改动:1.3.4 起自动重试之间最多等 30 秒,不再长达 4 分钟;1.3.6 起连续 5 分钟没有数据就取消请求并自动重试。它们缩短的是等待时间,并没有改变大请求被截断这件事。Google 的更新会分批推送,几天内才到所有用户,所以升到最新版没有坏处,只是不要指望升级本身解决问题,按行分批改仍然是现在能做的办法。
怎么查自己的 language_server.log、怎么报告给 Google
想确认自己遇到的是不是同一种截断,可以用 Xiphiros 公开仓库里的 reconstruct_attempts.py 分析 Antigravity 的 language_server.log,只需要 Python 3.10 以上。2026 年 10 月 27 日在 macOS 26.1、Python 3.12.1 上,对他公开的日志重跑了一次,输出和他发布的 CSV 逐字节一致:
git clone https://github.com/Xiphiros/antigravity-stream-cutoff-rca
cd antigravity-stream-cutoff-rca
python3 scripts/reconstruct_attempts.py logs/baseline-log-excerpt.txt \
    --utc-offset=-04:00 --year 2026 > recon.csv
# [INFO] 136 failed attempts in 21 runs
# [INFO] no response headers: 104 total, 79 timed, min 60.270 s, median 60.352 s, max 61.075 s
# [INFO] stream cut mid-body: 32 total, 25 timed, min 67.449 s, median 73.216 s, max 106.123 s
仓库说明里写的是 --utc-offset -04:00,用空格分隔的负数时区会报 "expected one argument",要写成带等号的 --utc-offset=-04:00。分析自己的日志时,把文件路径换成你的日志,时区换成日志所用的本地时区,北京时间写 --utc-offset=+08:00。Linux 上的日志路径是 ~/.config/Antigravity/logs/language_server.log;macOS 和 Windows 上的位置,仓库和 Antigravity 文档里都没有写。结果里 no response headers 这一类失败如果集中在略高于 60 秒的位置,说明你遇到的是同一种截断。
向 Google 报告时,在 Google AI 开发者论坛的 Google Antigravity 分类发帖,或者回复上面那个排查帖,附上 Xiphiros 在报告里提供的这几项,服务端才能查到对应的请求:
- 每次失败的时间,换算成 UTC
- 日志里的 ResponseID 和 Trace ID(没收到任何响应的失败没有 ResponseID,写明即可)
- Antigravity 客户端版本和操作系统
- 模型和思考等级,例如 Gemini 4 Argon(High)
- 当时的任务,例如"一次
write_to_file写一个 1,200 行的新文件"
Antigravity 里 Argon 重试的其他问题
对话太长、上下文太大,会导致一直 retry 吗? 对大文件截断这种情况,上下文大小不是原因。dllhell 记录的对话累积到 268,140 个 token 时仍然能正常修改文件,Xiphiros 的对照实验则用的是全新的 Agent,一次写 1,200 行照样在 60 秒被断。不过在 2026 年 10 月 1 日的一个 Gemini 3.7 Flash High 容量问题帖里,帖子里的回复提到过很长的对话有时会在某个模型上反复失败,建议把进度总结一下开新对话继续。
Antigravity IDE 里为什么找不到 Gemini 4 Argon? 截至 2026 年 10 月 27 日,Antigravity 模型列表写明 Gemini 4 Argon 不在 Antigravity IDE 里提供,只能在 Antigravity App、Antigravity CLI 和 IDE 扩展里使用。在 IDE 里看到的 retry 提示,来自你当时选的其他模型。
Windows 上点 Cancel 后显示 "task cancelled by user",是又出了新错误吗?
不是。论坛里的 Windows 用户报告,在 Retrying (5/9) 时点 Cancel,界面就会显示 "task cancelled by user",它只是确认你手动停止了这一轮。之后在同一个对话里让 Agent 分批修改即可。
参考来源9
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月27日。
参考来源9
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月27日。
- 1.Antigravity 更新日志antigravity.google/docs/changelog
- 2.Antigravity 2.23.0 "Model unavailable" 重试循环排查帖discuss.ai.google.dev/t/189559
- 3.Xiphiros 公开的排查数据仓库github.com/Xiphiros/antigravity-stream-cutoff-rca
- 4.Google AI 开发者论坛上 dllhell 关于 Argon 重试的长帖discuss.ai.google.dev/t/189747
- 5.Vertex AI 函数调用文档docs.cloud.google.com/vertex-ai/generative-ai/docs/multimodal/function-calling
- 6.Antigravity 套餐与额度文档antigravity.google/docs/plans
- 7.Antigravity 模型列表文档antigravity.google/docs/models
- 8.Antigravity 常见问题antigravity.google/docs/faq
- 9.Google AI 开发者论坛里关于推理约 120 秒被打断的帖子discuss.ai.google.dev/t/186367