Claude 预填充(prefill)400 报错:4.6 起模型全拒收,按用途替换
Claude 4.6 起的模型拒收以 assistant 消息结尾的请求,报预填充 400;Sonnet 4.5 仍接受。按原用途改用结构化输出、系统提示词或 user 消息。
文章目录
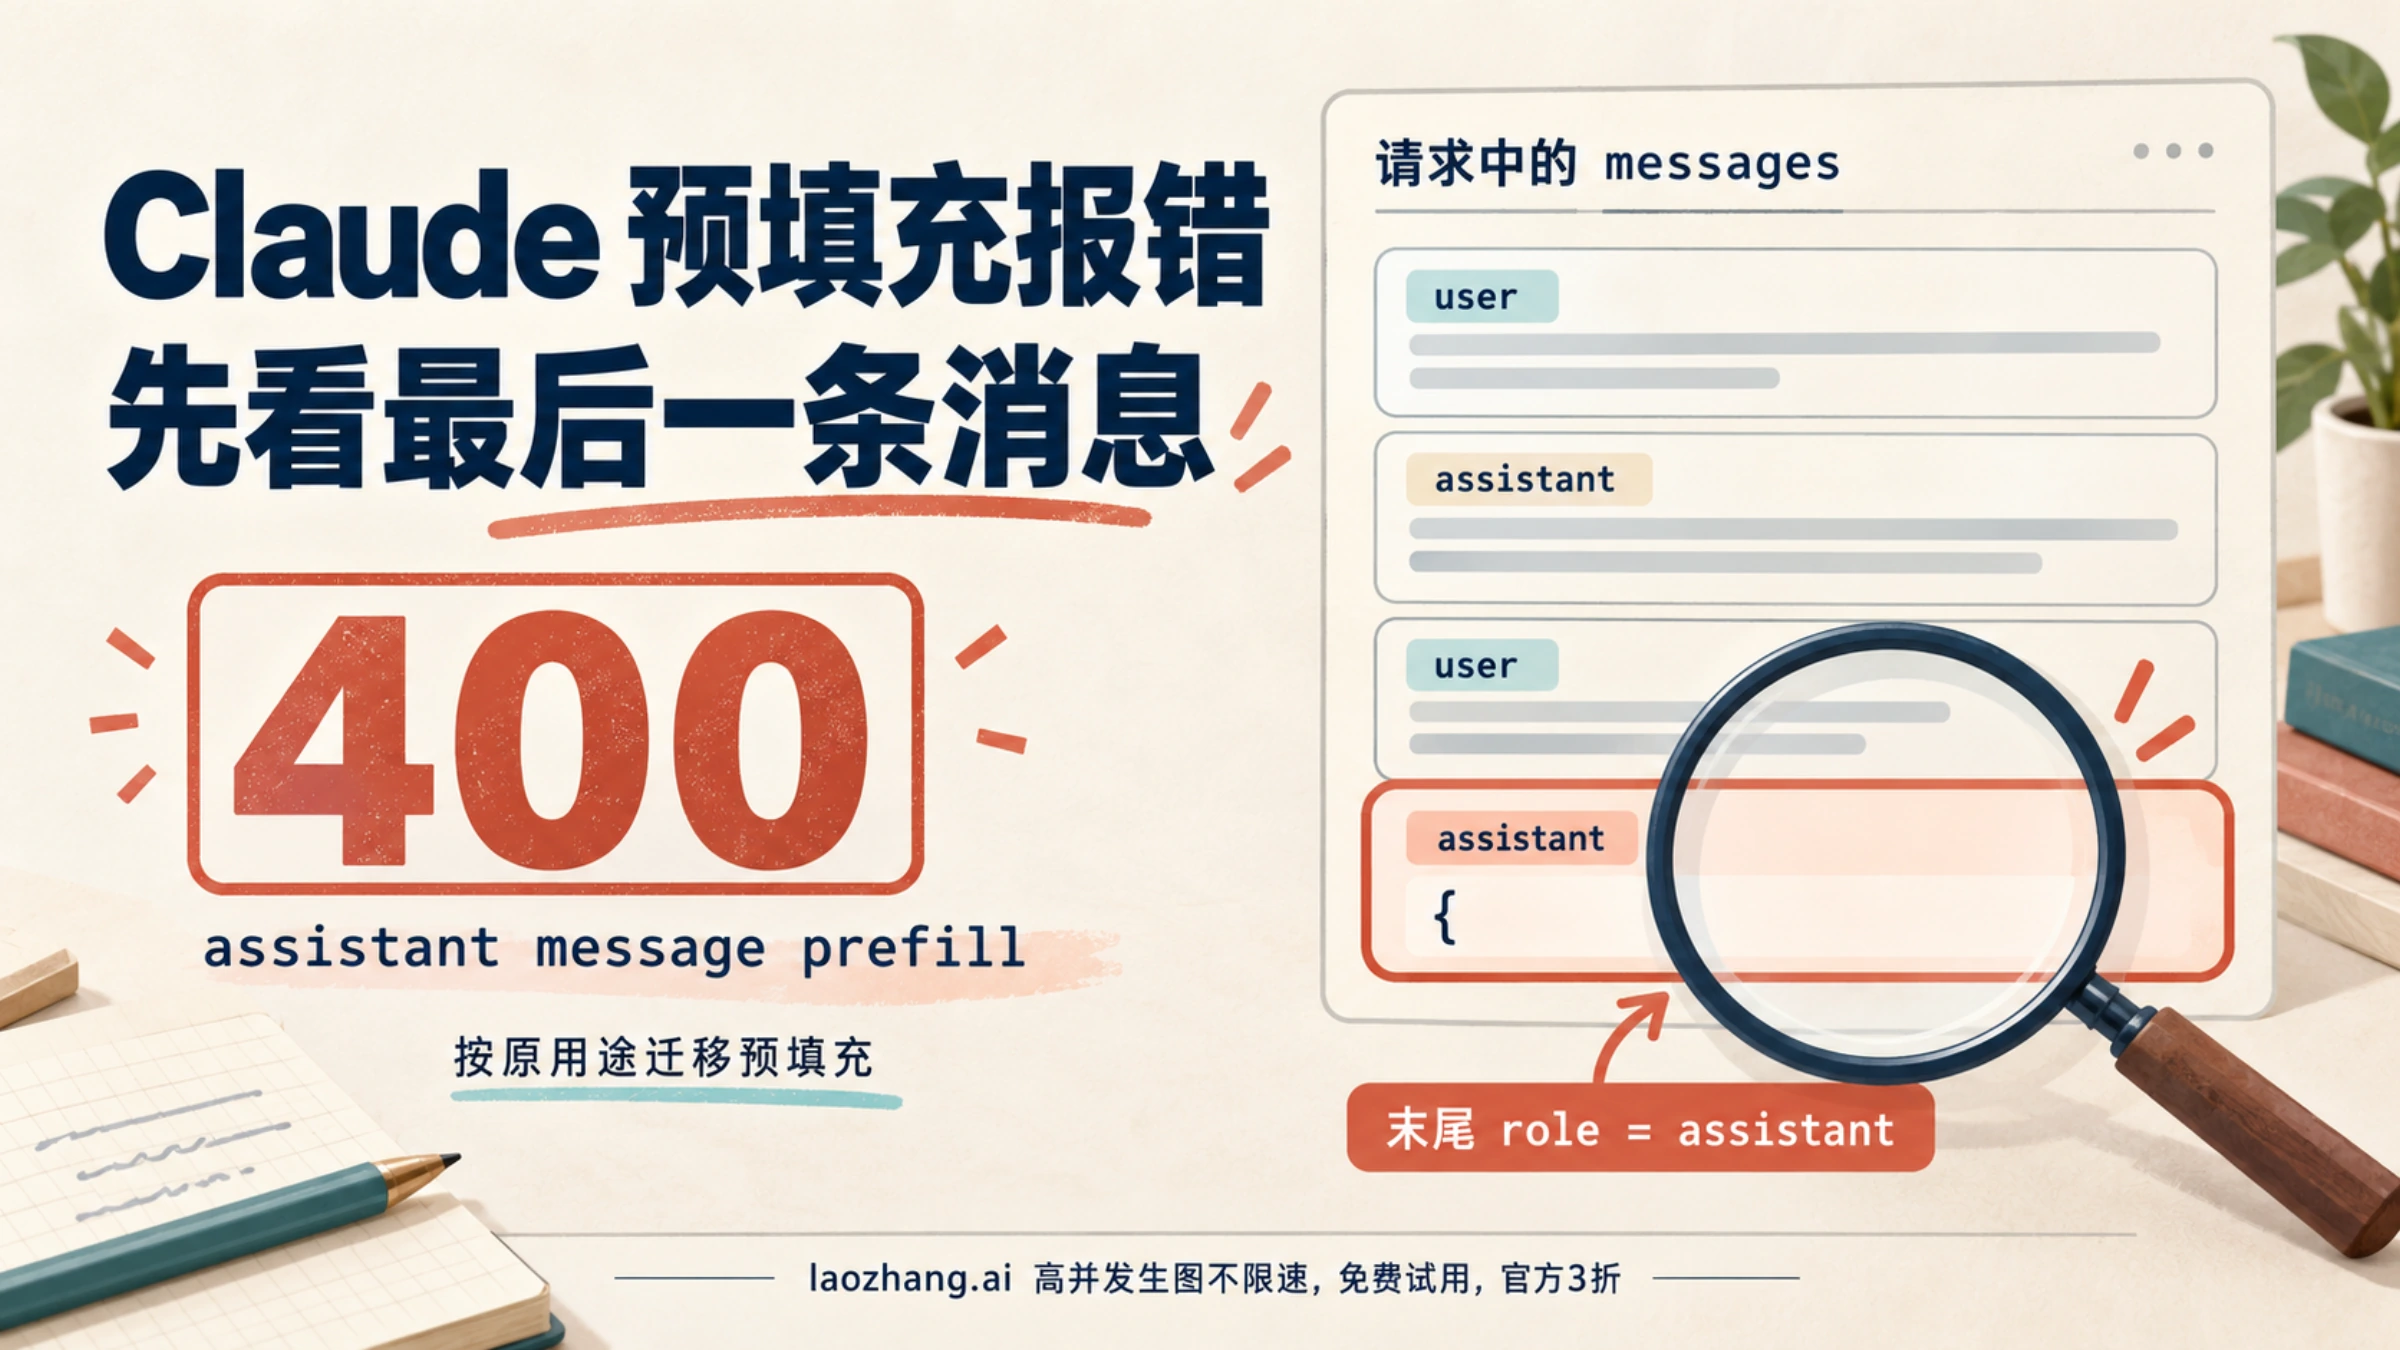
This model does not support assistant message prefill. The conversation must end with a user message. 这条 400 invalid_request_error 只说明一件事:发给模型的 messages 最后一条,role 是 assistant。这种写法叫预填充(prefill)。按 Anthropic 的错误文档,Claude 4.6 及之后的模型都不接受它:Opus 4.6 起的所有 Opus、Sonnet 4.6 起的所有 Sonnet,以及 Fable 和 Mythos 系列。Claude Sonnet 4.5、Haiku 4.5 和更早的模型仍然接受。
修法取决于请求是谁发的:
- 你自己的代码或 SDK 封装:删掉末尾那条 assistant 消息,再按它原本的用途换写法。要固定 JSON 结构就用
output_config.format,要去掉开场白就写进系统提示词,要接着写被截断的回答就把半截内容放进 user 消息。 - Copilot、opencode、Antigravity 这类你改不了请求的工具:问题出在工具组装请求的方式上。你能做的是更新工具、在工具里换一个模型、开新会话,并把报错交给工具方。
报错原文说的是什么:请求最后一条消息是 assistant
预填充是一个旧技巧:在 messages 末尾放一条你自己写的 assistant 消息,模型会把它当成回答的开头接着往下写。最常见的用法是只填一个 {,让回答从 JSON 开始;也有人用它预先写好标题、跳过客套话,或者让模型从某句话继续。
# 以 assistant 消息结尾 = 预填充
response = client.messages.create(
    model="claude-haiku-4-5-20251001",  # Haiku 4.5 仍接受
    max_tokens=1024,
    messages=[
        {"role": "user", "content": "List the top 3 programming languages"},
        {"role": "assistant", "content": "{"},  # 预填充
    ],
)
同样的请求发给 claude-sonnet-5-5、claude-opus-4-6 这类模型,API 不会开始生成,直接返回:
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "message": "This model does not support assistant message prefill. The conversation must end with a user message."
  }
}
后半句 The conversation must end with a user message 就是修复方向:让请求以 user 消息结尾。
经过网关或框架转发时,这句话常被包在别的报错里。判断标准很简单:在完整的响应体或日志里搜 assistant message prefill,搜得到就是这个问题。
| 你看到的报错 | 出现的位置 |
|---|---|
litellm.BadRequestError: AnthropicException - {"type":"invalid_request_error","message":"This model does not support assistant message prefill. ..."} | LiteLLM 路由(PR #30242 中的原文) |
ValidationException: This model does not support assistant message prefill... | Amazon Bedrock |
Provider returned error,日志里是上游 Anthropic 返回的 400 和同一句话 | OpenRouter(opencode 用户 2026 年 5 月的报告) |
"code":"invalid_request_body",message 是同一句话 | GitHub Copilot(opencode 会话导出) |
如果框架只记录了状态码 400、丢掉了响应体,先让它把完整的错误 JSON 打出来,否则很容易和下文那几种同样是 400 的报错混在一起。
哪些 Claude 模型拒收预填充:4.6 及之后全部拒收
截至 2026 年 10 月 5 日,Anthropic 的错误文档、Sonnet 5.5 迁移指南、Opus 5.5 迁移指南和 Fable 5.1 迁移指南给出的口径一致:
| 模型 | 模型 ID 示例 | 以 assistant 消息结尾的请求 |
|---|---|---|
| Claude Opus 4.6、4.7、4.8、5、5.5 | claude-opus-4-6、claude-opus-5-5 | 400,拒收 |
| Claude Sonnet 4.6、5、5.5 | claude-sonnet-4-6、claude-sonnet-5-5 | 400,拒收 |
| Claude Fable 5、5.1 | claude-fable-5-1 | 400,拒收 |
| Claude Mythos Preview、5、5.1(仅对获批客户开放) | claude-mythos-5-1 | 400,拒收 |
| Claude Opus 4.5 | claude-opus-4-5-20251101 | 接受 |
| Claude Sonnet 4.5 | claude-sonnet-4-5-20250929 | 接受 |
| Claude Haiku 4.5 | claude-haiku-4-5-20251001 | 接受 |
| 更早的 Claude 模型 | 以模型列表里仍可用的为准 | 接受 |
几点会影响你的判断:
- 这不是新模型才有的变化。 Opus 5.5 迁移指南写明,预填充在 Opus 4.6 上就已经返回 400,只有从 Opus 4.5 或更早版本升级的人才会第一次碰到;Sonnet 这条线的分界是 Sonnet 4.5 到 4.6。所以从 Opus 4.7 升到 Opus 5.5 时还报这条错,说明预填充一直没删干净,或者某条代码路径在动态拼出它。
- 换回 Sonnet 4.5、Haiku 4.5 只是缓兵之计。 它们接受预填充,但这条路随着旧模型退役会走到头。而且在这些模型上,预填充同样不能和结构化输出里的 JSON 输出(
output_config.format)同时使用,两者在结构化输出文档里列为不兼容。 - 按模型名做开关容易过时。 新模型发布后,硬编码的"不支持预填充模型列表"会漏掉它。LiteLLM 就漏掉过
sonnet-4-6(见下文)。更稳的做法是在发请求前检查最后一条消息的 role,而不是维护名单。
从 Opus 4.6 升到 4.7 还牵涉哪些请求变化,见 Claude Opus 4.7 vs Claude Opus 4.6:2026 年现在该不该升级。
预填充原本用来做什么,现在就换成什么
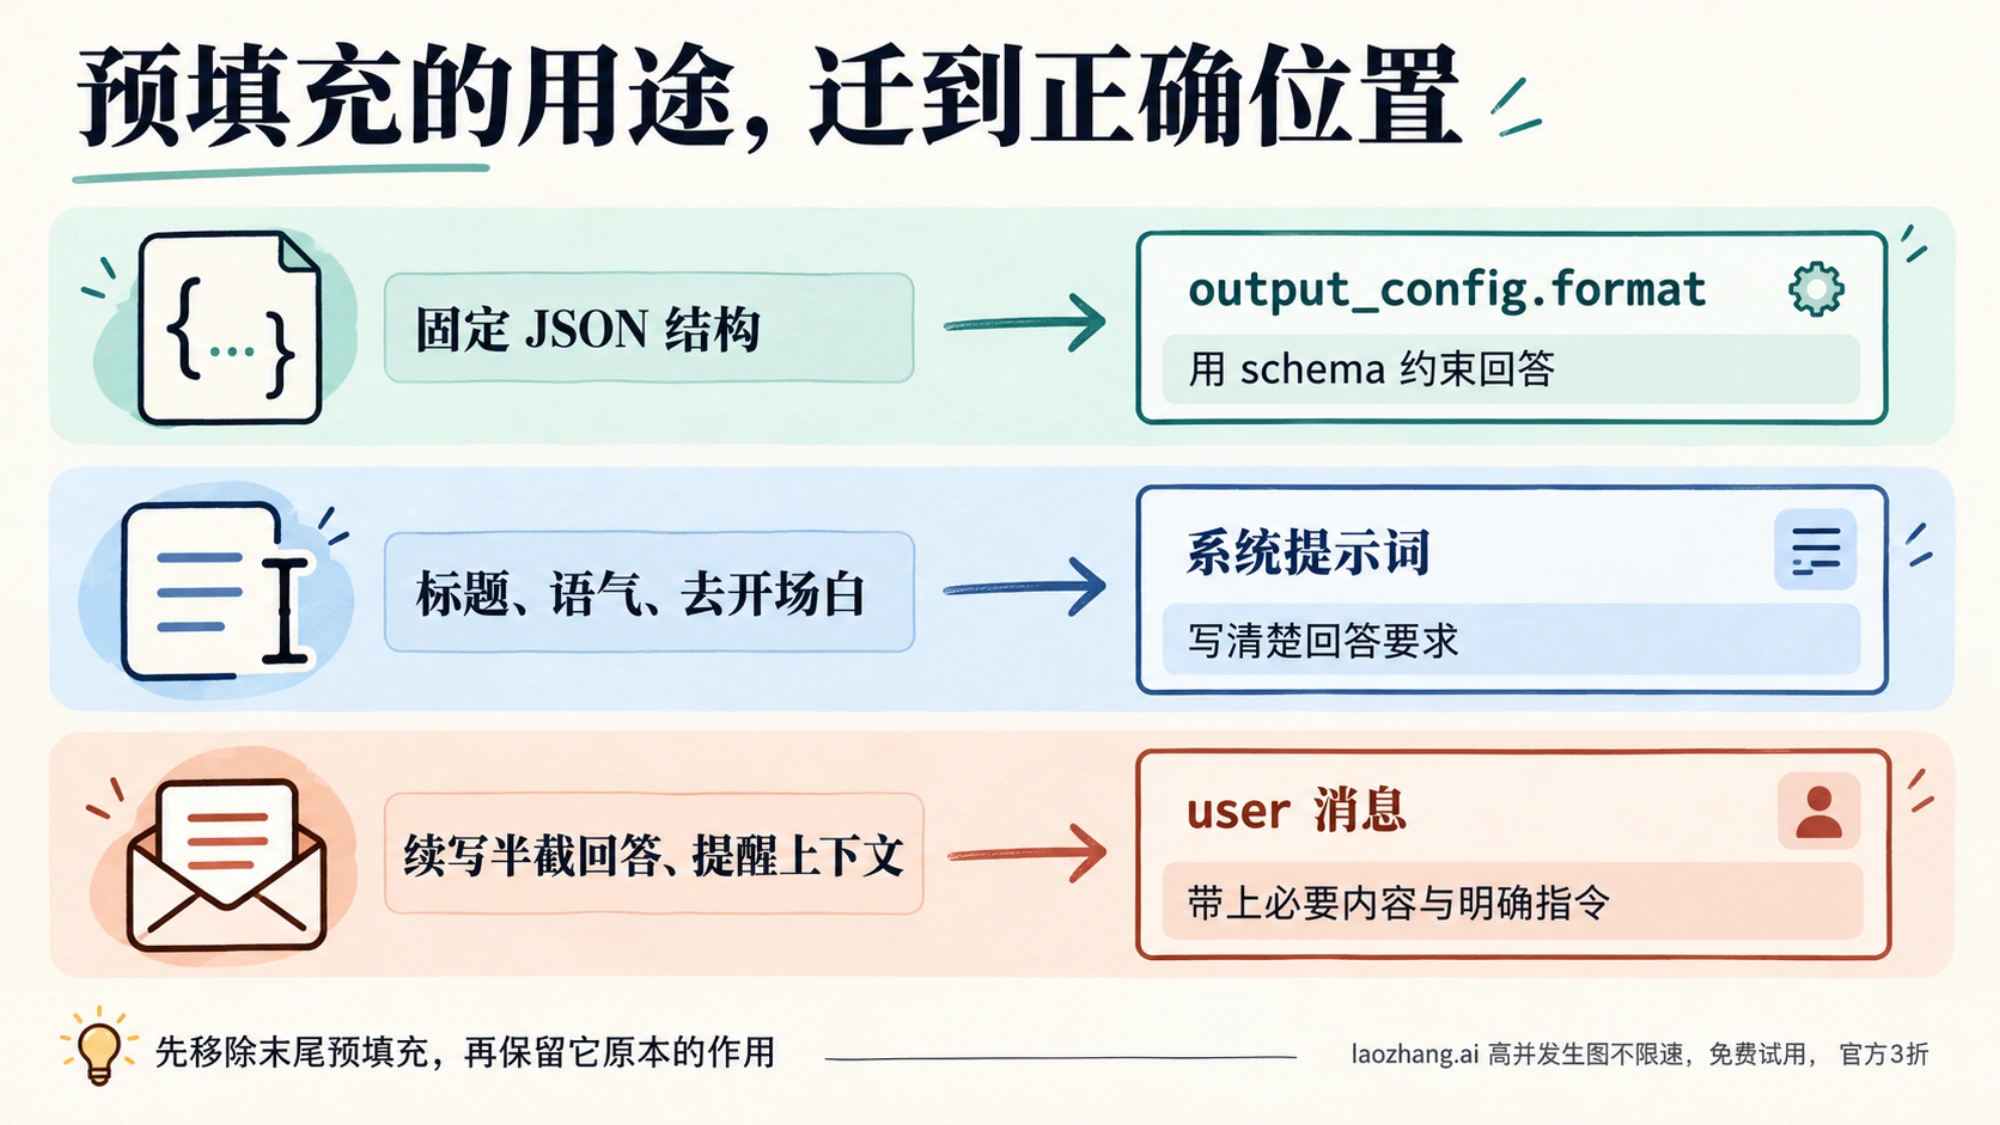
删掉那条 assistant 消息只是第一步。预填充原本承担的功能,要换个地方实现。Sonnet 5.5 迁移指南按用途给了对应关系:
| 预填充原本的用途 | 典型写法 | 现在的替代 |
|---|---|---|
| 固定输出格式 | 预填 { 或 JSON 片段 | 结构化输出:output_config.format 约束回答本身;分类任务也可用带 enum 字段的工具(tool_choice 保持 auto) |
| 去掉开场白 | 预填标题或正文第一句 | 在系统提示词里要求直接作答 |
| 避免不必要的拒答 | 预填一句"好的,下面是…" | 在 user 消息里把要求写清楚,通常就够了 |
| 接着写被中断的回答 | 把半截回答作为 assistant 消息 | 放进 user 消息:说明上次回答在哪里中断,请从那里继续 |
| 提醒上下文 | 在 assistant 消息里复述约束 | 放进 user 轮次 |
Fable 5.1 迁移指南对预填充只给了一条建议:改用系统提示词指令。结构化输出也支持 Fable 5.1,需要固定 JSON 时照样可以用。
代码库里预填充散落在很多地方时,可以让工具先扫一遍。Opus 5.5、Sonnet 5.5 和 Fable 5.1 的迁移指南都提到,Claude Code 里自带的 Claude API skill 会替换模型 ID、处理有破坏性的参数变化、替换预填充,最后给出一份需要人工确认的清单,例如:
/claude-api migrate this project to claude-opus-5-5它会先让你确认迁移范围(整个工作目录、某个子目录或指定文件),再开始改文件。
固定 JSON 输出:用 output_config.format 代替预填的左大括号
以前预填一个 {,只能让回答"大概率"是 JSON。结构化输出把 schema 放进请求,在生成阶段约束输出,返回的文本块能直接解析。下面的请求写法来自 Anthropic 的结构化输出文档,只把示例内容换成了前面的编程语言列表。
改之前(在 4.6 及之后的模型上返回 400):
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    messages=[
        {"role": "user", "content": "List the top 3 programming languages by popularity"},
        {"role": "assistant", "content": "{"},  # 400
    ],
)
改之后:
import json
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    messages=[
        {"role": "user", "content": "List the top 3 programming languages by popularity"}
    ],
    output_config={
        "format": {
            "type": "json_schema",
            "schema": {
                "type": "object",
                "properties": {
                    "languages": {
                        "type": "array",
                        "items": {
                            "type": "object",
                            "properties": {
                                "name": {"type": "string"},
                                "rank": {"type": "integer"},
                            },
                            "required": ["name", "rank"],
                            "additionalProperties": False,
                        },
                    }
                },
                "required": ["languages"],
                "additionalProperties": False,
            },
        }
    },
)

# 按类型取文本块:新模型的回复里 thinking 块可能排在前面
text = next(block.text for block in response.content if block.type == "text")
data = json.loads(text)
print(data["languages"][0]["name"])
旧代码常写 response.content[0].text。在 Opus 5.5 这类默认开启思考的模型上,第一个内容块可能是 thinking,所以官方示例都按 block.type == "text" 取文本。
用 Pydantic 的话,Python SDK 的 client.messages.parse() 会根据模型生成 schema、作为 output_config.format 发出去,并把结果校验后放进 parsed_output:
from pydantic import BaseModel
import anthropic

client = anthropic.Anthropic()

class Language(BaseModel):
    name: str
    rank: int

class LanguageList(BaseModel):
    languages: list[Language]

response = client.messages.parse(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    messages=[
        {"role": "user", "content": "List the top 3 programming languages by popularity"}
    ],
    output_format=LanguageList,  # SDK 辅助参数,发出去的是 output_config.format
)

for lang in response.parsed_output.languages:
    print(lang.rank, lang.name)
TypeScript 用 Zod 时,把 schema 包进 zodOutputFormat() 再交给 output_config.format,不要直接塞 Zod 对象:
import Anthropic from "@anthropic-ai/sdk";
import { z } from "zod";
import { zodOutputFormat } from "@anthropic-ai/sdk/helpers/zod";

const client = new Anthropic();

const LanguageList = z.object({
  languages: z.array(z.object({ name: z.string(), rank: z.number() })),
});

const response = await client.messages.parse({
  model: "claude-sonnet-5-5",
  max_tokens: 1024,
  messages: [
    { role: "user", content: "List the top 3 programming languages by popularity" },
  ],
  output_config: { format: zodOutputFormat(LanguageList) },
});

console.log(response.parsed_output);
不用 SDK 时的 cURL 写法:
curl https://api.anthropic.com/v1/messages \
  -H "content-type: application/json" \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -d '{
    "model": "claude-sonnet-5-5",
    "max_tokens": 1024,
    "messages": [
      {"role": "user", "content": "List the top 3 programming languages by popularity"}
    ],
    "output_config": {
      "format": {
        "type": "json_schema",
        "schema": {
          "type": "object",
          "properties": {
            "languages": {
              "type": "array",
              "items": {
                "type": "object",
                "properties": {
                  "name": {"type": "string"},
                  "rank": {"type": "integer"}
                },
                "required": ["name", "rank"],
                "additionalProperties": false
              }
            }
          },
          "required": ["languages"],
          "additionalProperties": false
        }
      }
    }
  }'
换成结构化输出时,下面这些地方容易出新的错,依据都是同一份结构化输出文档:
- 每个 object 都要写
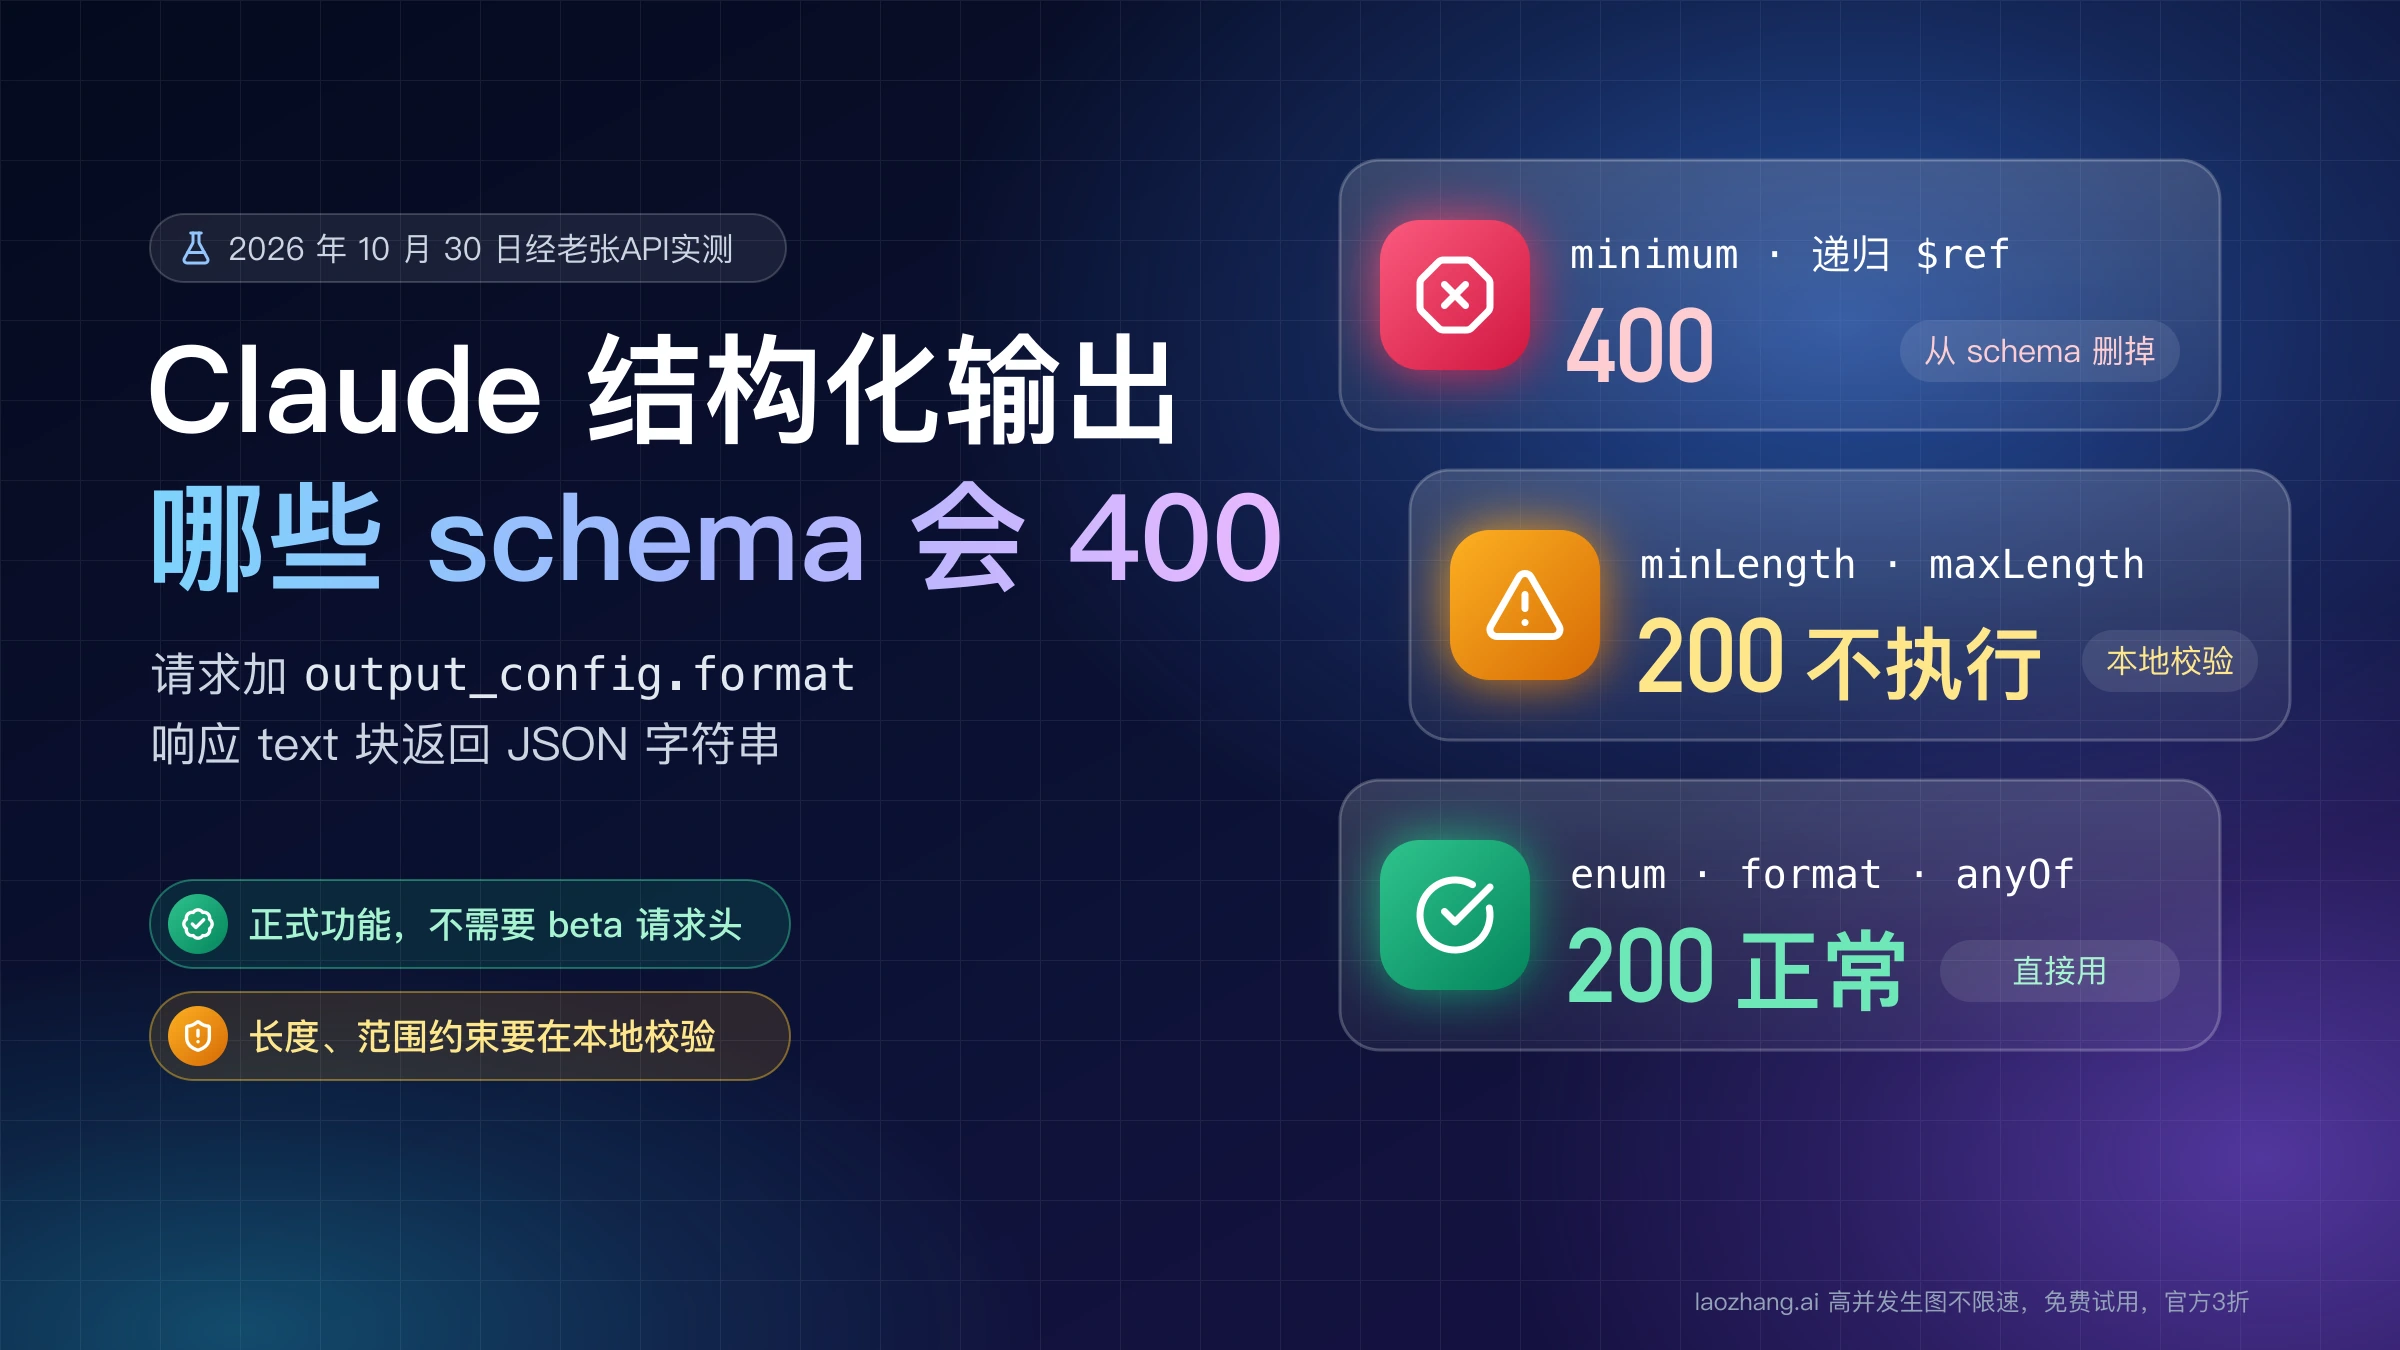
"additionalProperties": false。 不支持的写法(additionalProperties设成别的值、minimum、maxLength、递归 schema 等)会返回 400 并说明原因。SDK 的辅助方法会自动补上additionalProperties: false,并把不支持的约束挪进字段描述;手写 schema 时要自己处理。 - 旧参数
output_format已弃用。 直接写在请求里的output_format不带 beta 头structured-outputs-2025-11-13会返回 400,Python SDK v1.0 起在client.beta.messages.create()上传它会抛TypeError。上面parse()里的output_format=LanguageList是 SDK 自己的参数,不受影响。 - 和 citations 不能同时开。 开了引用功能再加
output_config.format会返回 400。需要引用时,格式要求改写进系统提示词。 - 第一次使用某个 schema 会慢一些。 schema 要先编译,编译结果在最后一次使用后缓存 24 小时;改 schema 结构会让缓存失效,也会让该会话的提示词缓存失效。
- 流式输出可以用,但要把文本拼完整再解析。
- 少数情况仍可能不符合 schema:
stop_reason为refusal(拒答)或max_tokens(被截断)时,输出可能不完整;enum 字符串的大小写也不保证,比较时忽略大小写。
分类任务:带 enum 字段的严格工具调用
如果你原来用预填充引导模型输出某个分类标签,也可以定义一个带 enum 字段的工具,并加上 strict: true,让工具参数严格符合 schema。
不要用"强制模型调用某个工具"来代替预填充。Opus 5.5、Sonnet 5.5、Fable 5.1 和 Mythos 5.1 不接受强制工具调用:tool_choice 设成 {"type": "any"} 或指定某个工具,会返回另一条 400(tool_choice: type "tool" and "any" are not supported for this model.)。Opus 4.6 到 Opus 5、Sonnet 4.6、Sonnet 5 和 Fable 5 目前仍接受强制工具调用,但代码一换到最新模型就会再出错。稳妥的写法是 tool_choice 保持默认的 auto,配合 strict: true 或结构化输出。
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    messages=[
        {"role": "user", "content": "Classify this ticket: 'I was charged twice this month.'"}
    ],
    tools=[
        {
            "name": "record_category",
            "description": "Record the category of a support ticket",
            "strict": True,
            "input_schema": {
                "type": "object",
                "properties": {
                    "category": {
                        "type": "string",
                        "enum": ["billing", "bug", "feature_request", "other"],
                    }
                },
                "required": ["category"],
                "additionalProperties": False,
            },
        }
    ],
    # tool_choice 保持默认 auto
)

for block in response.content:
    if block.type == "tool_use":
        print(block.input["category"])
tool_choice 为 auto 时模型不一定调用工具。只要一个分类结果、不需要真正执行函数,用 output_config.format 加 enum 字段更直接。智能体里两者可以同时使用:output_config.format 管最终回答,strict: true 管工具参数。
去开场白、避免拒答、提醒上下文:写进系统提示词或 user 消息
这三类用法不需要 schema,把原来写在 assistant 消息里的内容挪到系统提示词或 user 消息即可。
改之前:
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    messages=[
        {"role": "user", "content": "Analyze this code for bugs"},
        {"role": "assistant", "content": "## Bug Analysis\n\n"},  # 400
    ],
)
改之后:
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    system=(
        "You are a code review assistant. Answer directly, without a preamble. "
        "Start with a '## Bug Analysis' heading, list each bug with its severity, "
        "then give a fix for each one."
    ),
    messages=[
        {"role": "user", "content": "Analyze this code for bugs"}
    ],
)
另外两种情况的改法:
- 用预填充绕开拒答的:把任务背景、用途和要求直接写进 user 消息。Sonnet 5.5 迁移指南的说法是"清楚的指令通常就够了"。
- 用 assistant 消息复述约束的(比如"记住,只用中文回答"):把这句话放进最新的 user 消息。
系统提示词只能提高格式稳定性,不能保证。下游程序要解析输出时,还是用上一节的结构化输出。
续写被截断的回答:把半截内容放进 user 消息
以前回答因 max_tokens 被截断时,常见做法是把已经生成的部分作为 assistant 消息发回去,让模型接着写。现在要换成一条 user 消息:说明上次的回答在哪里中断,请模型从那里继续。下面按 Sonnet 5.5 迁移指南给的措辞改写:
question = "Write a migration plan for our billing service"

first = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": question}],
)
partial = "".join(b.text for b in first.content if b.type == "text")

if first.stop_reason == "max_tokens":
    rest = client.messages.create(
        model="claude-sonnet-5-5",
        max_tokens=4096,
        messages=[
            {
                "role": "user",
                "content": [
                    {"type": "text", "text": question},
                    {
                        "type": "text",
                        "text": (
                            "Your previous response was interrupted and ended with:\n\n"
                            f"{partial}\n\n"
                            "Continue from where you left off."
                        ),
                    },
                ],
            }
        ],
    )
    continuation = "".join(b.text for b in rest.content if b.type == "text")
    full_text = partial + continuation  # 拼接前检查接缝处有没有重复
半截回答很长时,可以只放最后一段,让模型知道从哪里接上。这和不少框架后来的修法一致:Dyad 在 PR #3027(2026 年 3 月 23 日合并)里把续写重试从 assistant 消息改成了"带上半截回答、请模型继续"的 user 消息。
Amazon Bedrock 上怎么替代:Claude in Amazon Bedrock 没有结构化输出
Bedrock 上的预填充报错通常是 ValidationException,原因相同。不同的是替代方案:按结构化输出文档的说明,结构化输出只在旧版集成 "Amazon Bedrock (Opus 4.6 and earlier)" 上提供,覆盖 Opus 4.6、Sonnet 4.6、Sonnet 4.5、Opus 4.5 和 Haiku 4.5;新的 "Claude in Amazon Bedrock" 集成上没有。
所以在 Claude in Amazon Bedrock 上,output_config.format 这条路走不通,只能:
- 用工具定义来约束结构化数据;
- 或者把格式要求写进系统提示词和 user 消息,自己解析和校验输出。
Bedrock 上各模型的支持情况变化较快,动手前先对照 AWS 当前的文档。Bedrock 上其他 400 的排查顺序见 AWS Claude 报 400 怎么办:按报错原文逐条排查。
Agent 框架和路由为什么会发出预填充:续写回退与残留的 assistant 轮次
很多人并没有写预填充,报错来自框架内部拼出来的消息列表。公开的修复记录里有两种常见成因。
成因一:用预填充做续写或回退。 LiteLLM 路由在流式输出中途失败、切到备用模型时,会把已经生成的部分作为 assistant 消息附在末尾,让下一个模型接着写。对 Sonnet 4.6、Opus 4.6 及之后的模型,回退链上的每一跳都会返回这条 400,本来可以恢复的超时变成了整条链失败。修复 PR #30242(2026 年 6 月 11 日提交,截至 2026 年 10 月 5 日尚未合并)做了两件事:给所有 sonnet-4-6 条目补上 supports_assistant_prefill: false(Opus 4.6、4.7、4.8 的条目原本就标了),并把半截回答改成放进末尾的 user 消息。PR 里还列出了 livekit/agents、crewAI、agno 上报告的同类问题。上一节 Dyad 的修复属于同一种。
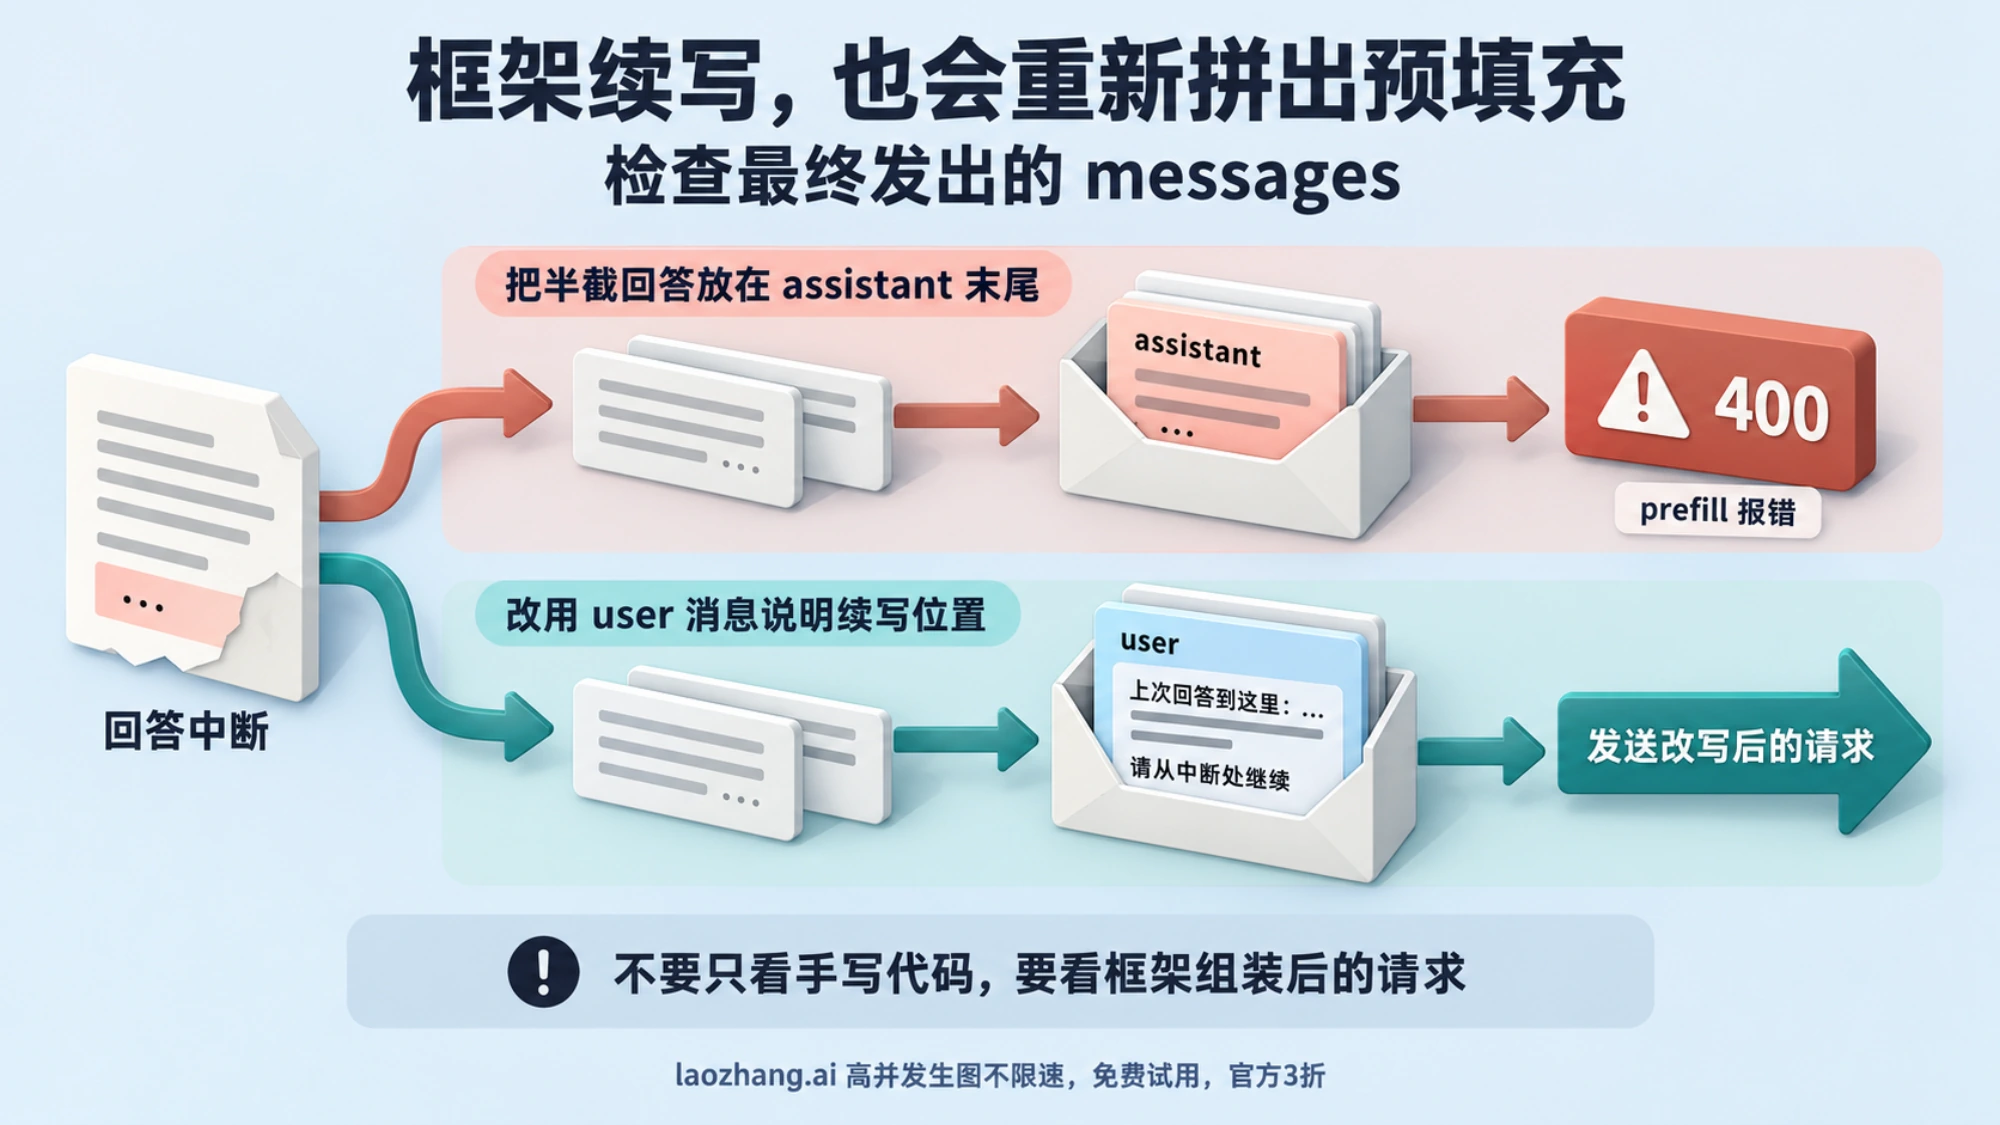
成因二:会话末尾残留一条 assistant 轮次。 OpenClaw 的修复 PR #69268(2026 年 5 月 1 日关闭,未合并)记录了这种情况:心跳、系统事件之后没有新的用户输入,会话记录以 assistant 轮次结尾,框架照样把它发了出去。PR 后续还发现两种变体:只有 thinking 内容的空 assistant 轮次,以及出错后网关往会话里插入的、带错误文字的 assistant 消息。
如果你维护的是框架、网关或聊天客户端,可以在发请求前加一道检查,不依赖模型名单:
def ensure_user_tail(messages):
    """发请求前确认最后一条是 user 消息。"""
    msgs = list(messages)

    # 去掉末尾内容为空的 assistant 轮次
    while msgs and msgs[-1]["role"] == "assistant" and not msgs[-1].get("content"):
        msgs.pop()

    if not msgs or msgs[-1]["role"] != "user":
        # 末尾仍是有内容的 assistant 消息:这是续写或预填充,
        # 要按用途改写,而不是静默删掉
        raise ValueError("messages must end with a user message")
    return msgs
末尾那条 assistant 消息有内容时,说明代码确实在依赖预填充,直接删掉会改变结果,要回到前面的用途表逐条替换。
Copilot、opencode、Antigravity 里报这条错:改不了代码时怎么办
这条报错在公开渠道里有不少来自普通用户,请求是工具发出的,用户改不了:
- GitHub Copilot:Microsoft 开发者社区有 Visual Studio 中 Copilot 搭配 Opus、Sonnet 4.6 报这条错的帖子。
- opencode:issue #13768 于 2026 年 2 月 15 日提出(Copilot 搭配 Opus 4.6),9 月 2 日因 60 天无活动被机器人自动关闭;10 月 2 日仍有用户留言说在 Opus 5.5 上照样出现。
- Antigravity:Google AI 开发者论坛 2026 年 3 月 29 日有帖子反映所有 Claude 模型都报 HTTP 400;LINUX DO 上也有用户在 4 月提到最新版用不了 Claude 模型、思考结束就报错。
- 另有 Databricks Foundation Model API(2026 年 5 月)、LibreChat 智能体(2026 年 5 月)和 OpenHands 使用
claude-opus-5-5(2026 年 9 月)的报告。
这些报告说明了问题出在哪类工具,但多数没有给出根因。作为用户,按这个顺序处理:
- 先更新工具。 修复往往在工具的新版本里,比如上一节 LiteLLM、Dyad 那类改动。
- 在工具里换模型。 如果工具还提供 Claude Sonnet 4.5 或 Haiku 4.5,它们接受预填充,可以先顶上;也可以换成非 Claude 的模型。opencode 的 issue 里就有用户暂时换了别的模型。
- 开一个新会话。 问题由会话末尾残留的 assistant 轮次引起时,新会话能避开。有用户反映在原会话里再发一句"继续"有时能恢复,但并不稳定。
- 把报错交给工具方。 带上完整的报错原文、使用的模型、工具版本,以及日志或响应头里的请求 ID,并引用工具仓库里已有的同类 issue。issue 被自动关闭不代表问题已修复,新开一个时附上旧链接。
别和这些 400 混淆:thinking 块、强制工具调用、采样参数
它们同样是 400 invalid_request_error,只是 message 不同,修法也不同:
| 报错信息里的关键句 | 原因 | 去哪里看 |
|---|---|---|
does not support assistant message prefill | 请求以 assistant 消息结尾 | 本页 |
`thinking` or `redacted_thinking` blocks in the latest assistant message cannot be modified | 最新一条 assistant 消息里的 thinking 块被改过、重排或过滤后再发回 | 原样回传 thinking 块,工具调用场景尤其要注意 |
tool_choice: type "tool" and "any" are not supported for this model. | 在 Opus 5.5、Sonnet 5.5 等模型上强制工具调用 | 改用 auto,见上文分类任务一节 |
"thinking.type.enabled" is not supported for this model. | 在 Claude 4.7 及之后的模型上用了手动思考预算 | 改用自适应思考和 output_config.effort |
和 temperature、top_p 有关的报错 | Opus 4.7 起不接受非默认的采样参数 | Claude Opus 4.7 的 temperature 参数报错:别调数值,先删字段、Claude Code 报 top_p deprecated?别先换渠道,先按 Opus 4.7 的新请求规则排 |
工具调用之后缺少对应的 tool_result | 消息顺序不完整 | 补上与 tool_use 对应的结果 |
预填充报错是请求格式问题,重试不会好转。如果拿到的是 500 一类服务端错误,处理方式完全不同,见 Claude API 500 内部服务器错误:有限重试与失败处理。
Claude 预填充报错的常见问题
Claude Sonnet 4.6 支持 assistant 预填充吗?
不支持。Sonnet 4.6、Sonnet 5 和 Sonnet 5.5 都会对以 assistant 消息结尾的请求返回这条 400。Sonnet 这条线上最后一个接受预填充的是 Sonnet 4.5。
在 Sonnet 4.5 或 Haiku 4.5 上,预填充能和 output_config.format 一起用吗?
不能。结构化输出文档把 JSON 输出和消息预填充列为不兼容。要用 output_config.format,就把预填充删掉;这样代码以后换到新模型也不用再改。
opencode 或 Copilot 里打一句"继续"为什么时好时坏?
新发一条消息会让会话重新以 user 消息结尾,所以有时能恢复;但如果工具在内部续写或重试时又拼出了 assistant 结尾的请求,报错还会回来。可靠的解决只能来自工具本身的修复,用户这边能做的是更新、换模型或开新会话。
参考来源9
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月5日。
参考来源9
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月5日。
- 1.错误文档platform.claude.com/docs/en/api/errors
- 2.PR #30242github.com/BerriAI/litellm/pull/30242
- 3.Sonnet 5.5 迁移指南platform.claude.com/docs/en/models/sonnet-5-5/migration-guide
- 4.Opus 5.5 迁移指南platform.claude.com/docs/en/models/opus-5-5/migration-guide
- 5.Fable 5.1 迁移指南platform.claude.com/docs/en/models/fable-5-1/migration-guide
- 6.结构化输出文档platform.claude.com/docs/en/build-with-claude/structured-outputs
- 7.PR #3027github.com/dyad-sh/dyad/pull/3027
- 8.PR #69268github.com/openclaw/openclaw/pull/69268
- 9.issue #13768github.com/anomalyco/opencode/issues/13768