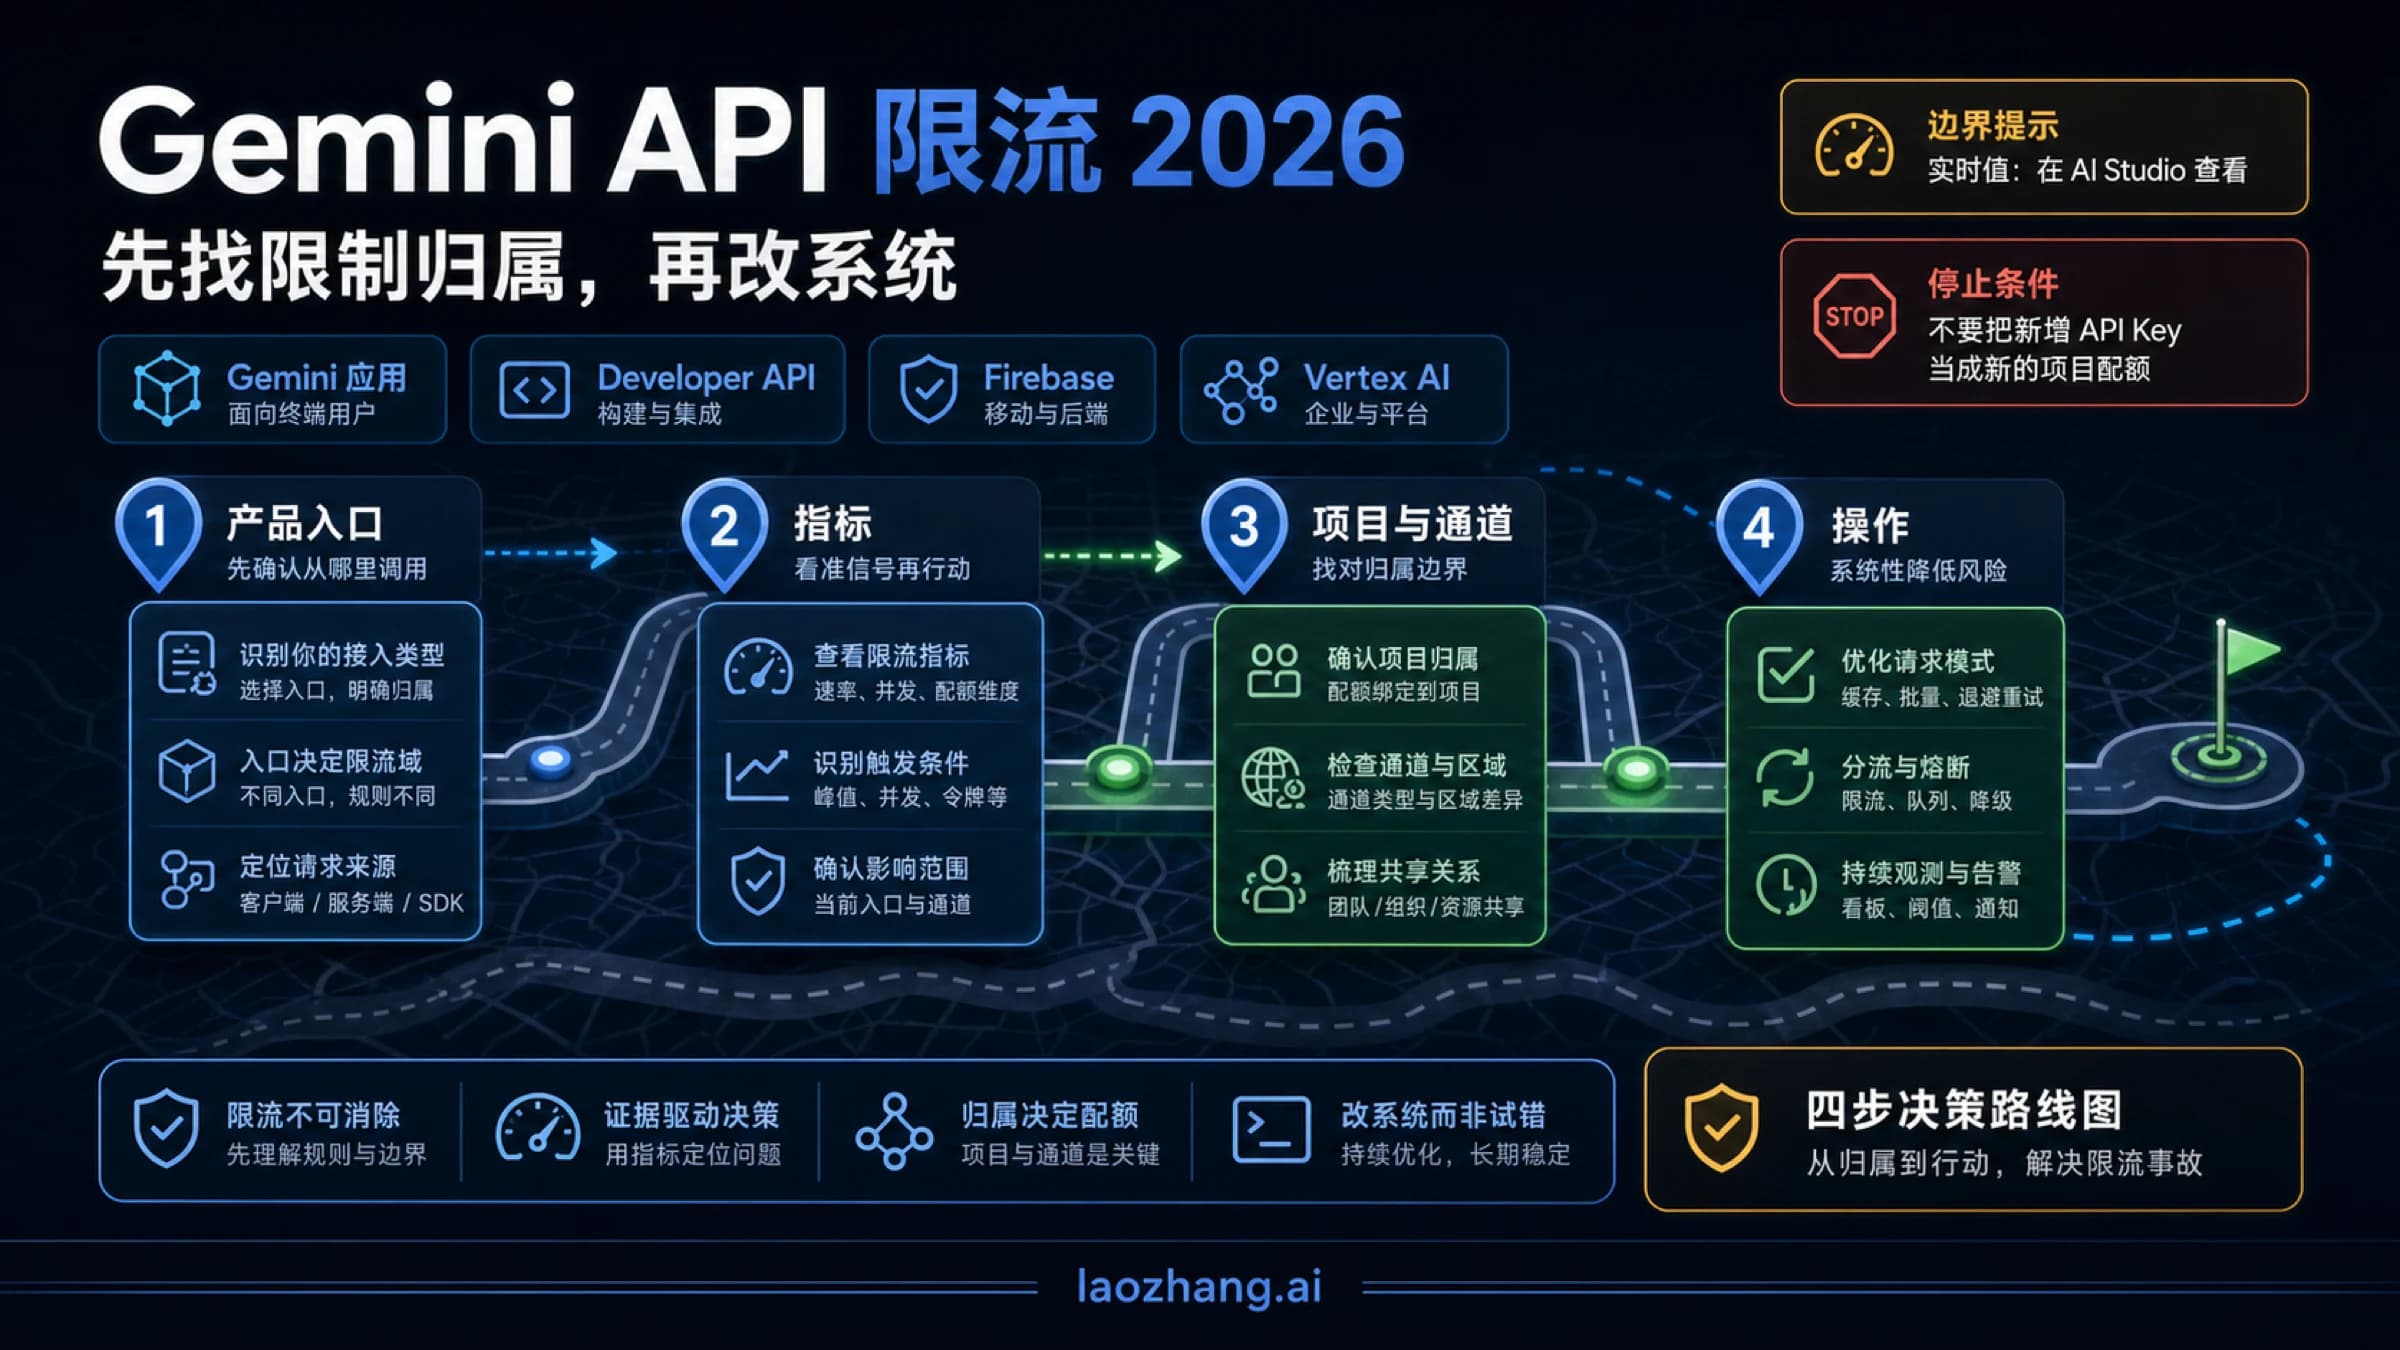
Gemini API 429、503 怎么解决:查配额、读错误与正确重试
遇到 Gemini API 429 或 503,先暂停批量发送,再检查错误正文和项目额度。本文给出从 QuotaFailure、RetryInfo 到有限重试的完整例子,说明何时降速、何时等额度恢复,以及怎样避免重试放大故障。
文章目录
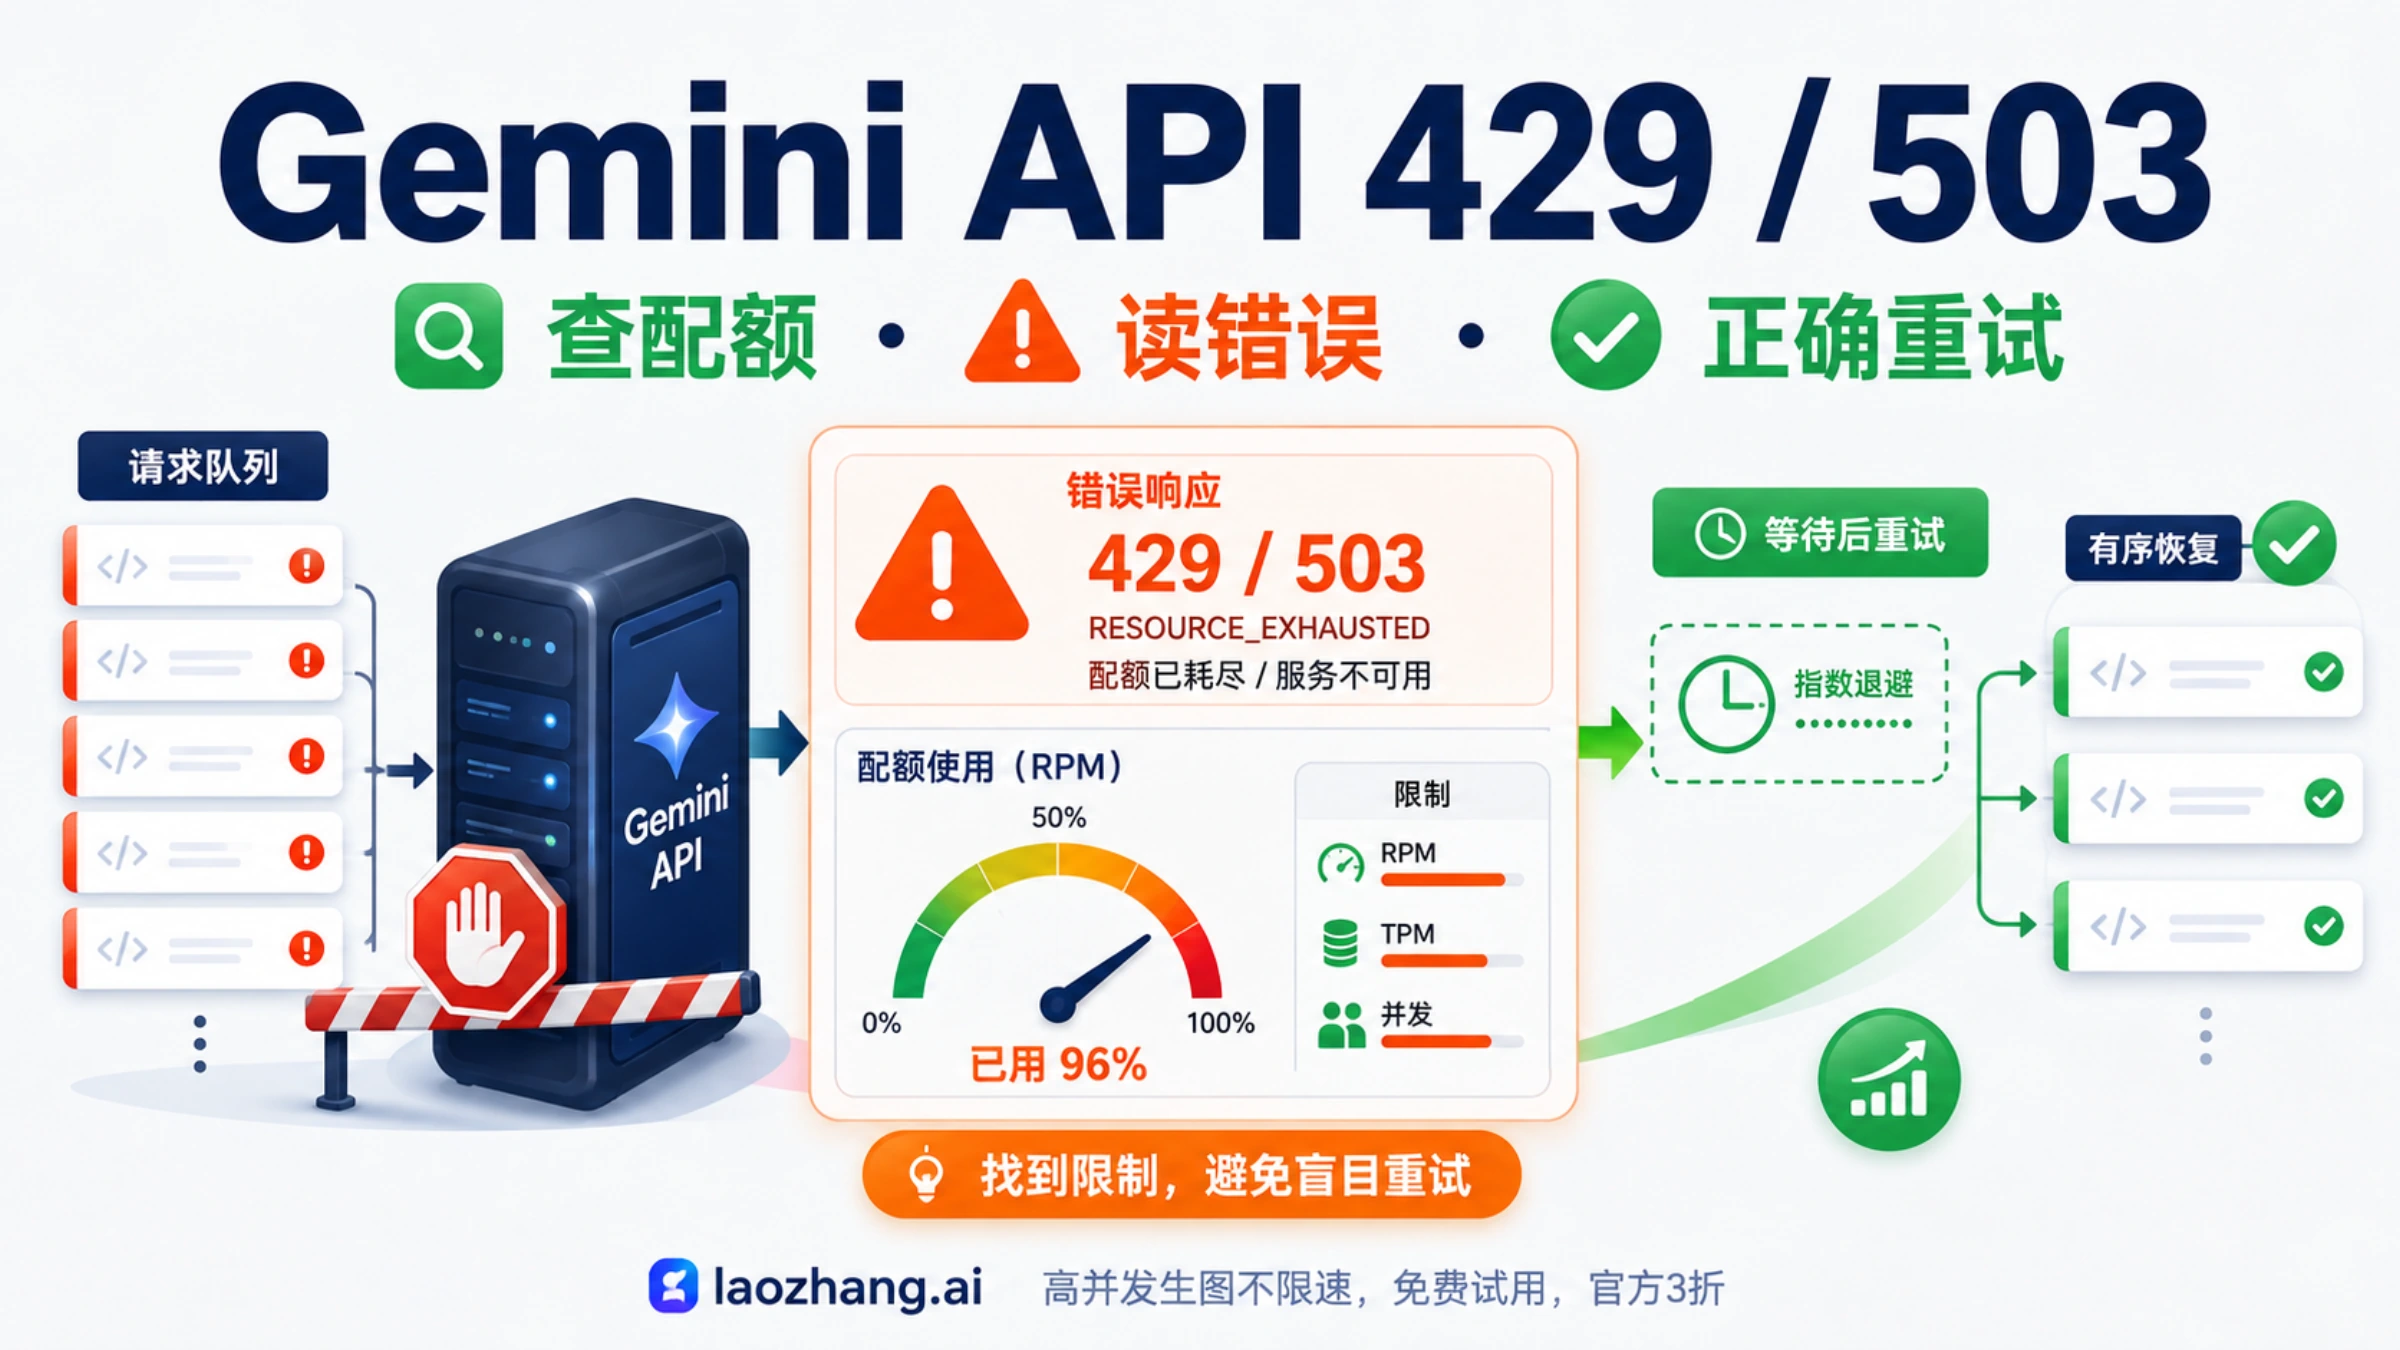
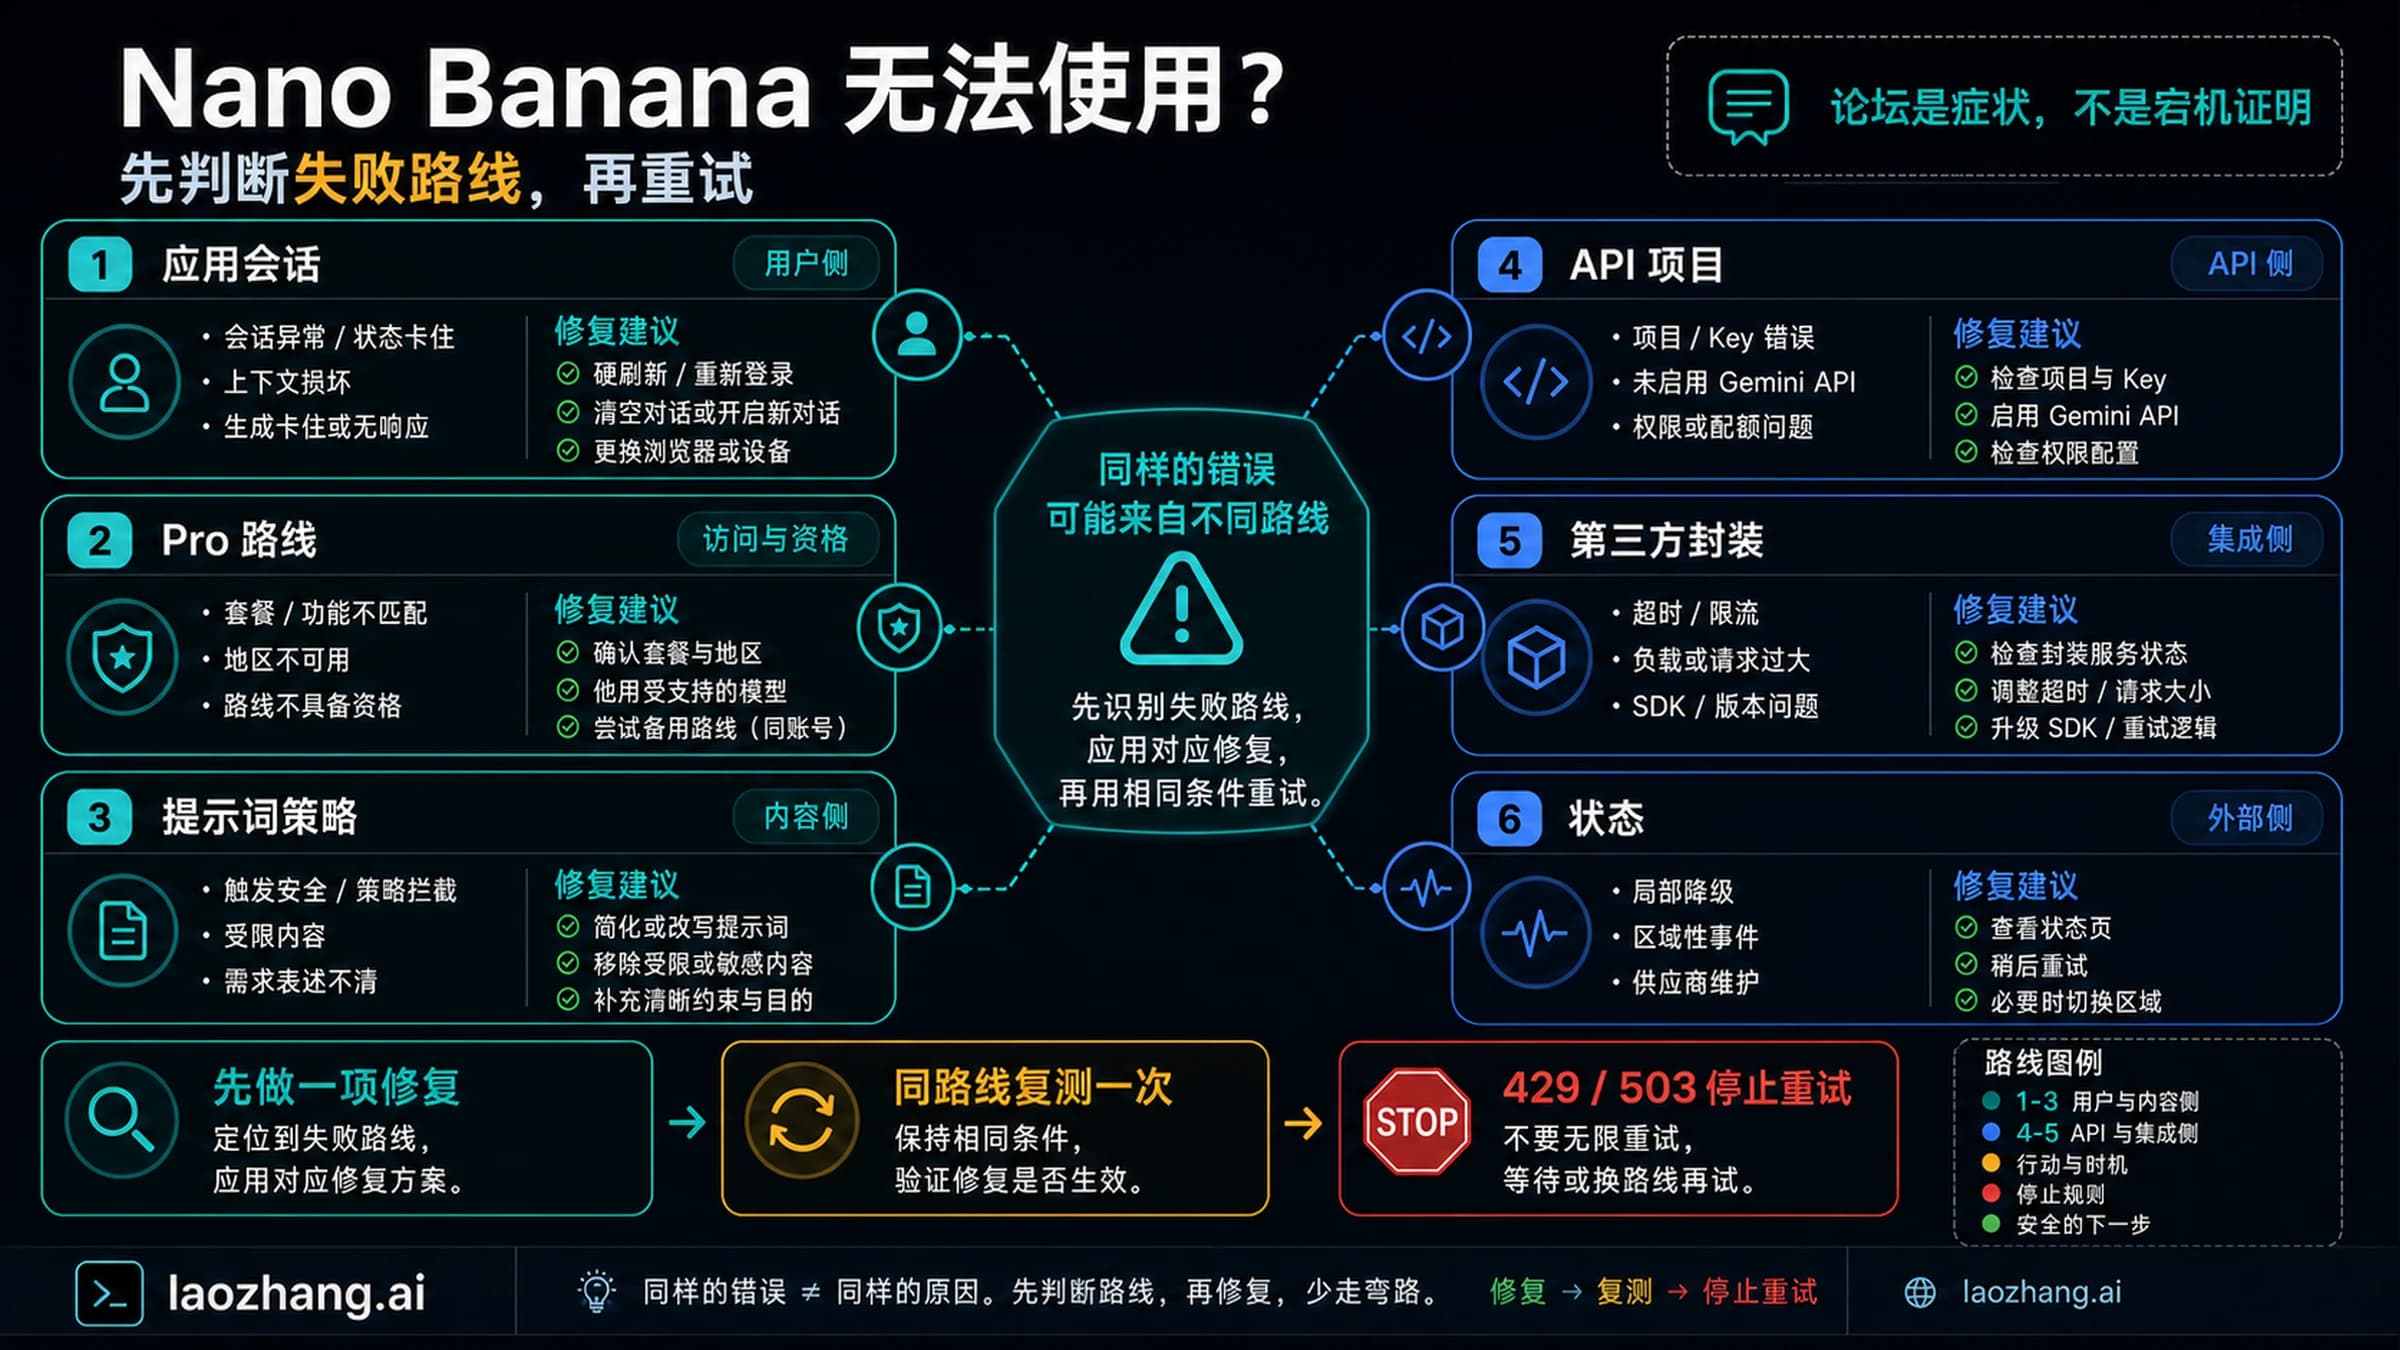
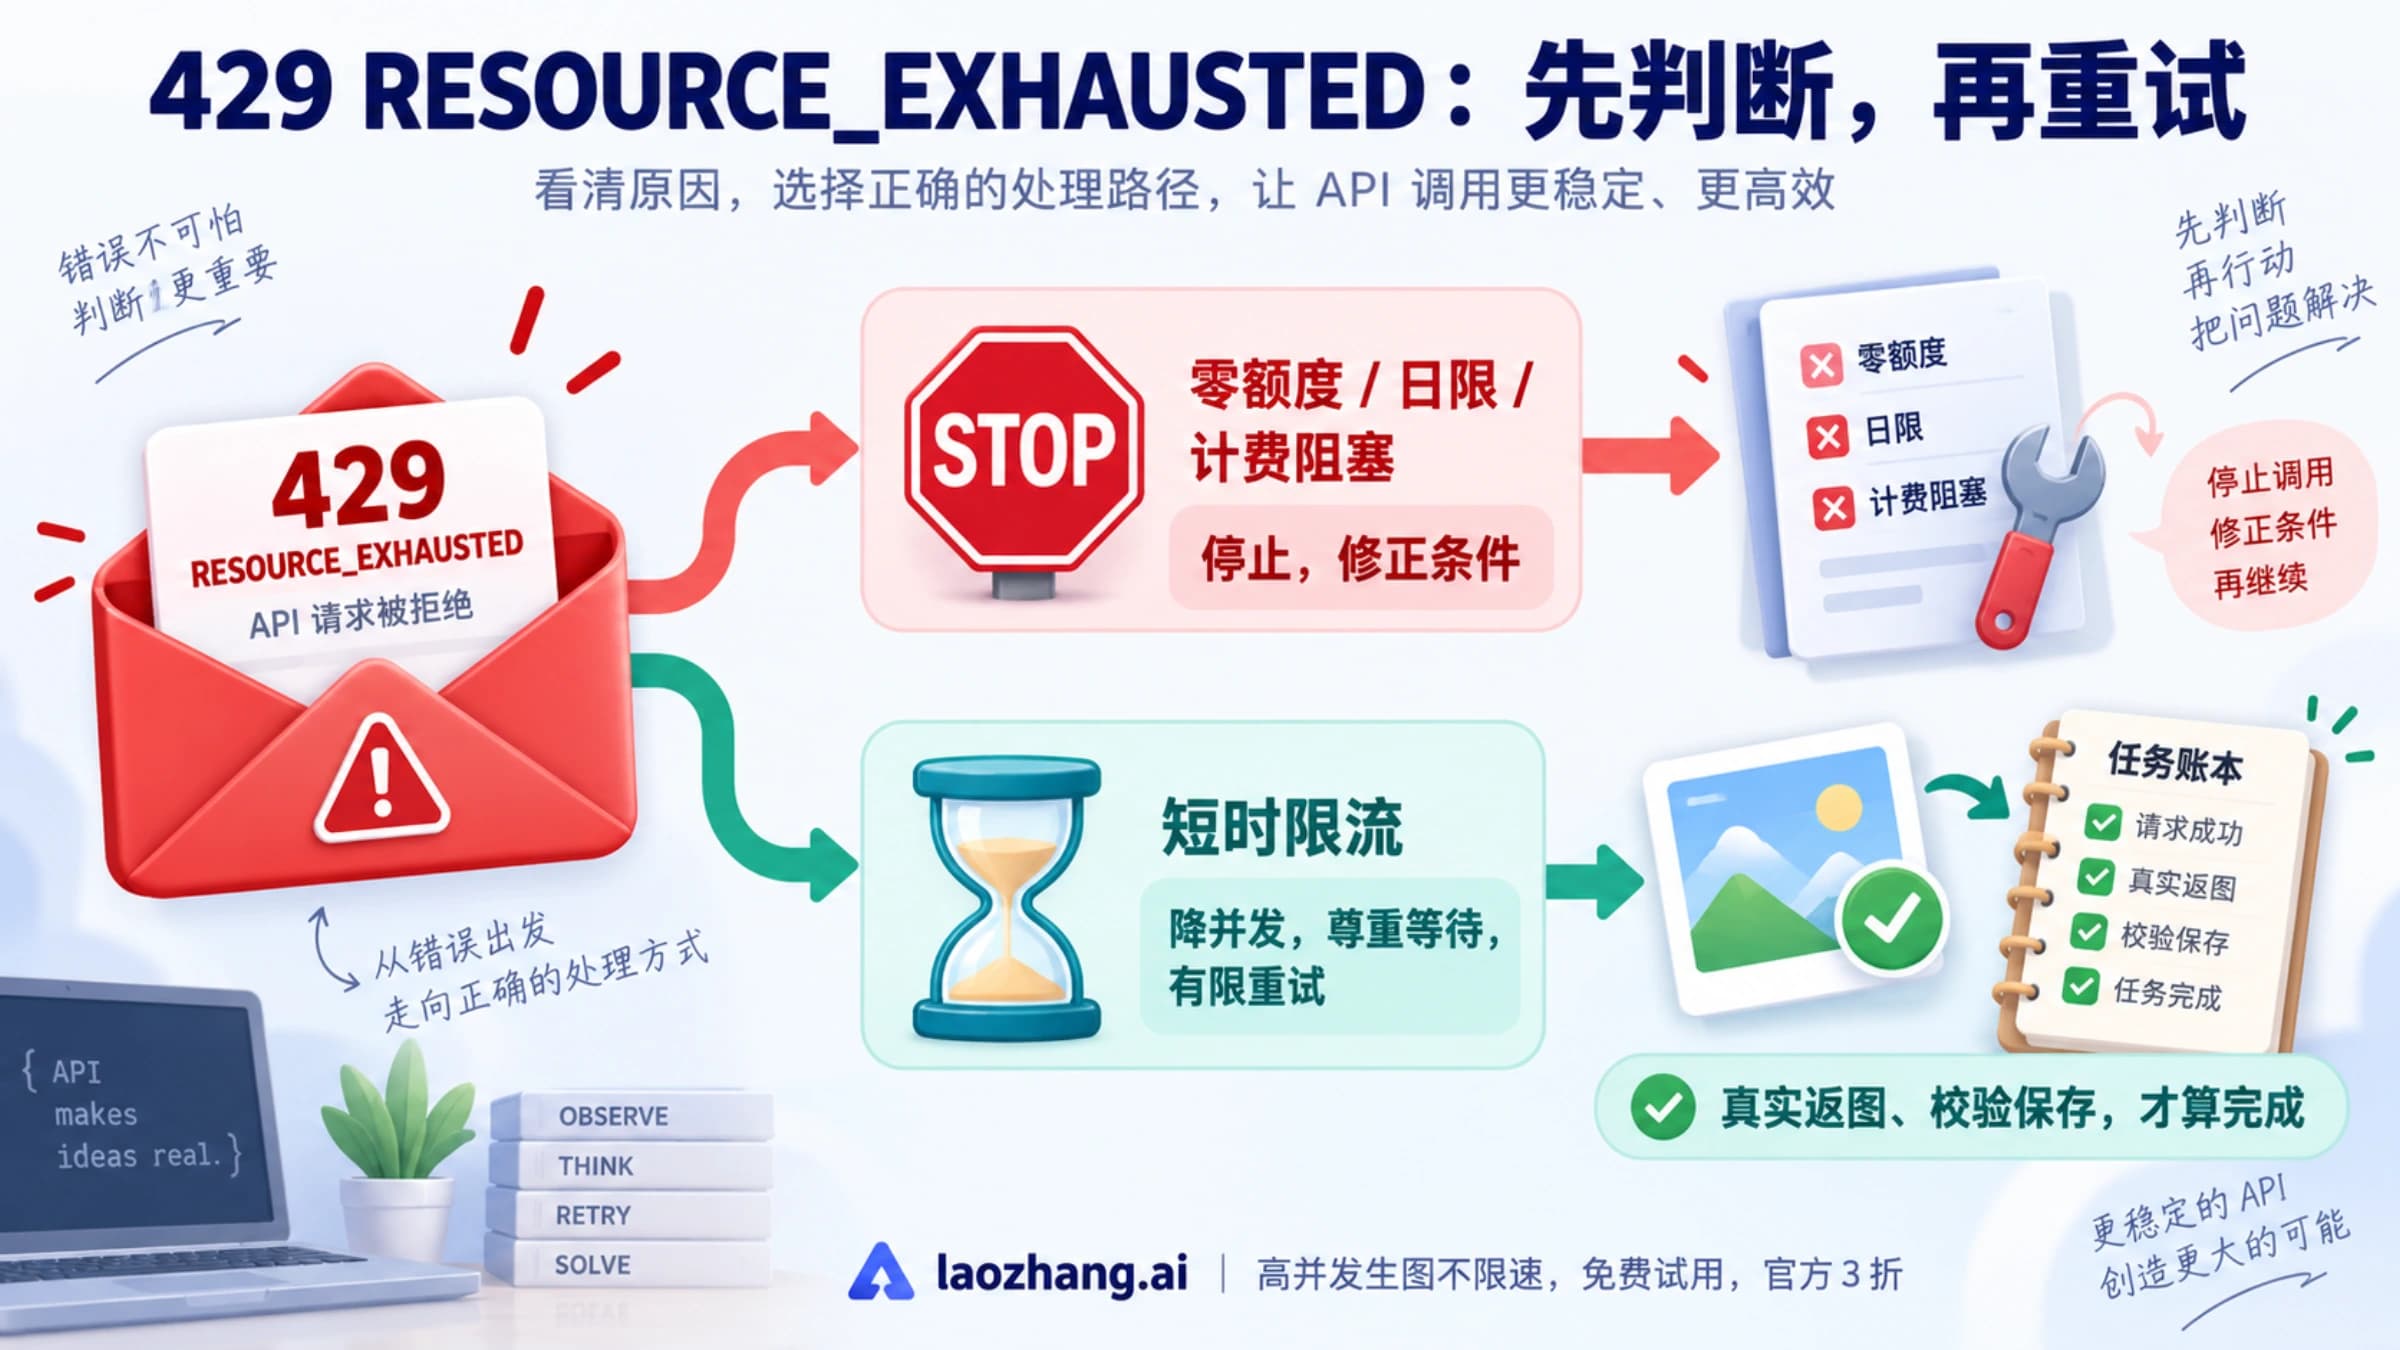
Gemini API 提示“服务器容量已达上限”时,先暂停批量请求,保留一条请求的 HTTP 状态码与完整错误正文。 如果确认每日额度已经耗尽,就停止秒级重试;如果是短时限流,降低发送速率并退避;如果返回 503,先做有限重试,再结合服务状态决定是否切换已经验证过的备用方案。
最快的排查顺序是:看错误详情,查对应项目的有效额度,单并发验证,再逐步恢复流量。 本文针对 Google AI Studio 项目使用的 Gemini Developer API,官方规则核验于 2026 年 9 月 8 日。Vertex AI、Gemini 网页版以及网盘存储容量应查看各自的设置。
先完成这四步,避免越重试越严重
- 暂停队列自动重发。 保留一个人工控制的测试请求,暂时把并发降到 1。先弄清楚失败原因,再恢复积压任务。
- 记录实际调用条件。 包括时间与时区、项目、模型 ID、接口地址、HTTP 状态、错误正文,以及响应提供的请求标识和等待提示。
- 打开 AI Studio 的有效速率限制。 选择真正处理请求的项目和型号,对照错误里的额度名称。入口可从官方速率限制页进入,避免拿旧文章中的固定 RPM 表代替自己的当前额度。
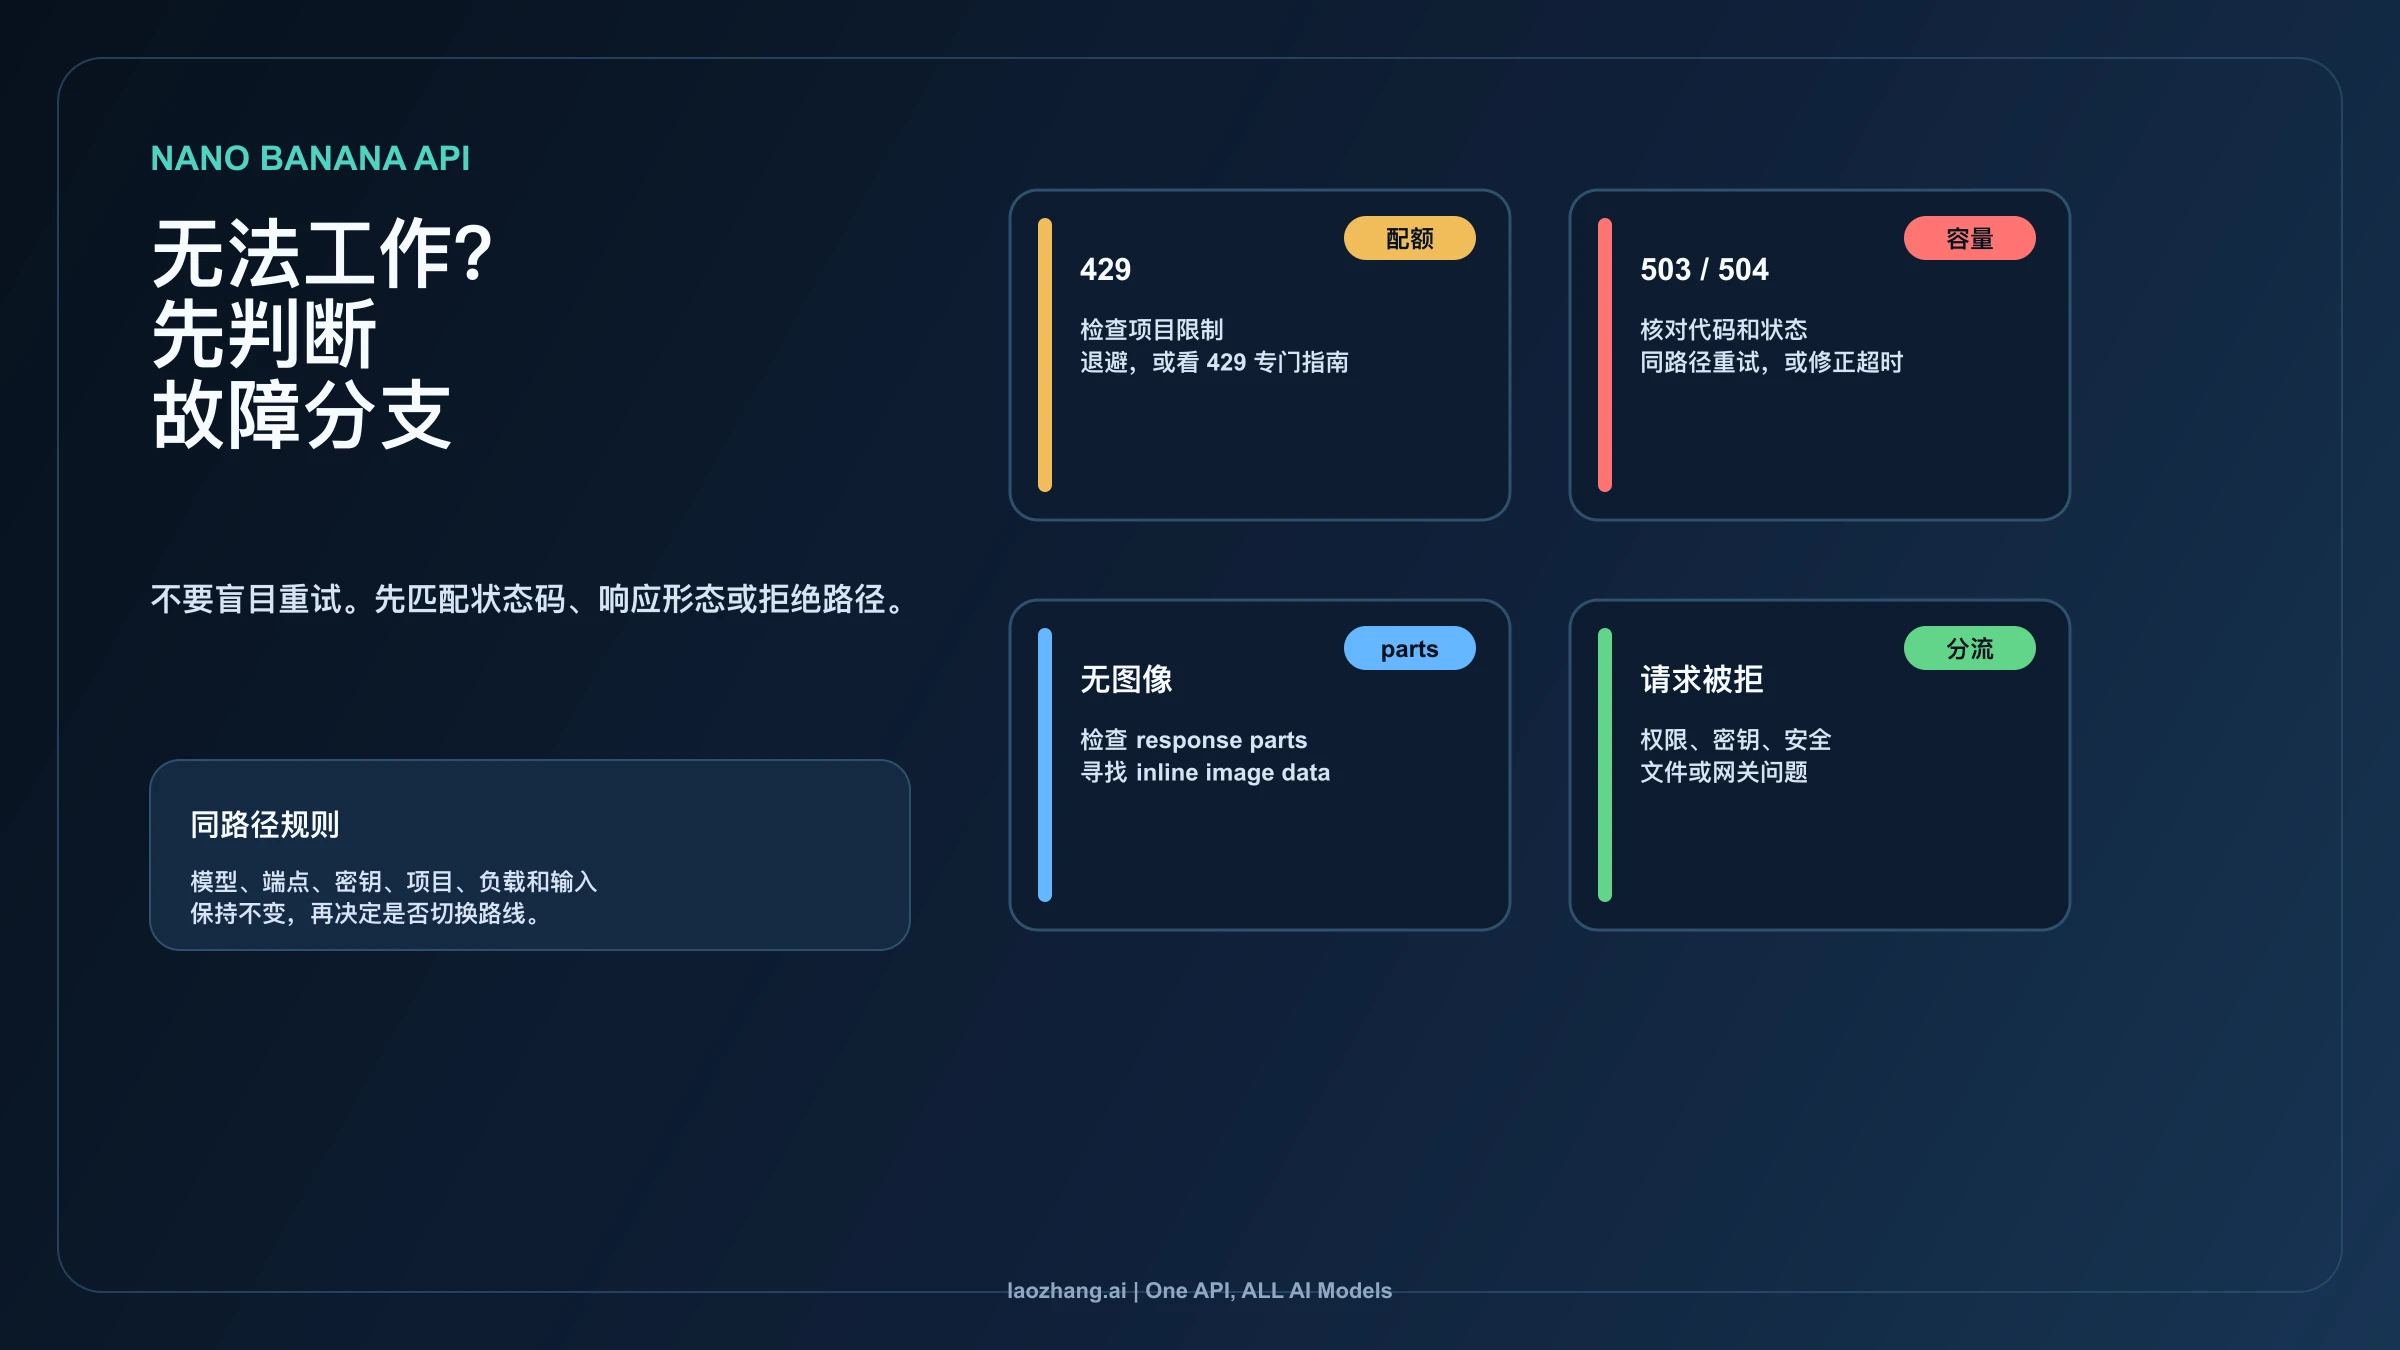
- 根据下表处理。 每次只改变一个因素,记录是否恢复。不要同时换网络、模型和密钥,导致结果无法解释。
| 你看到的证据 | 现在采取的动作 | 恢复条件 |
|---|---|---|
| 429,明确为每日请求或每日 token 额度 | 停止短周期重试,核对额度重置或调整安排 | 相应额度恢复后再发 |
| 429,明确为每分钟请求或输入 token 限制 | 降低队列发送速率,必要时缩短输入,有限退避 | 降载后最小请求能完成 |
| 429,命中滚动支出窗口 | 减少短时间内的高成本请求,等待窗口腾出空间 | 当前用量回到有效限制内 |
| 429,原因不明确 | 保留日志,对照项目额度和服务情况 | 原因查明后选择恢复方法 |
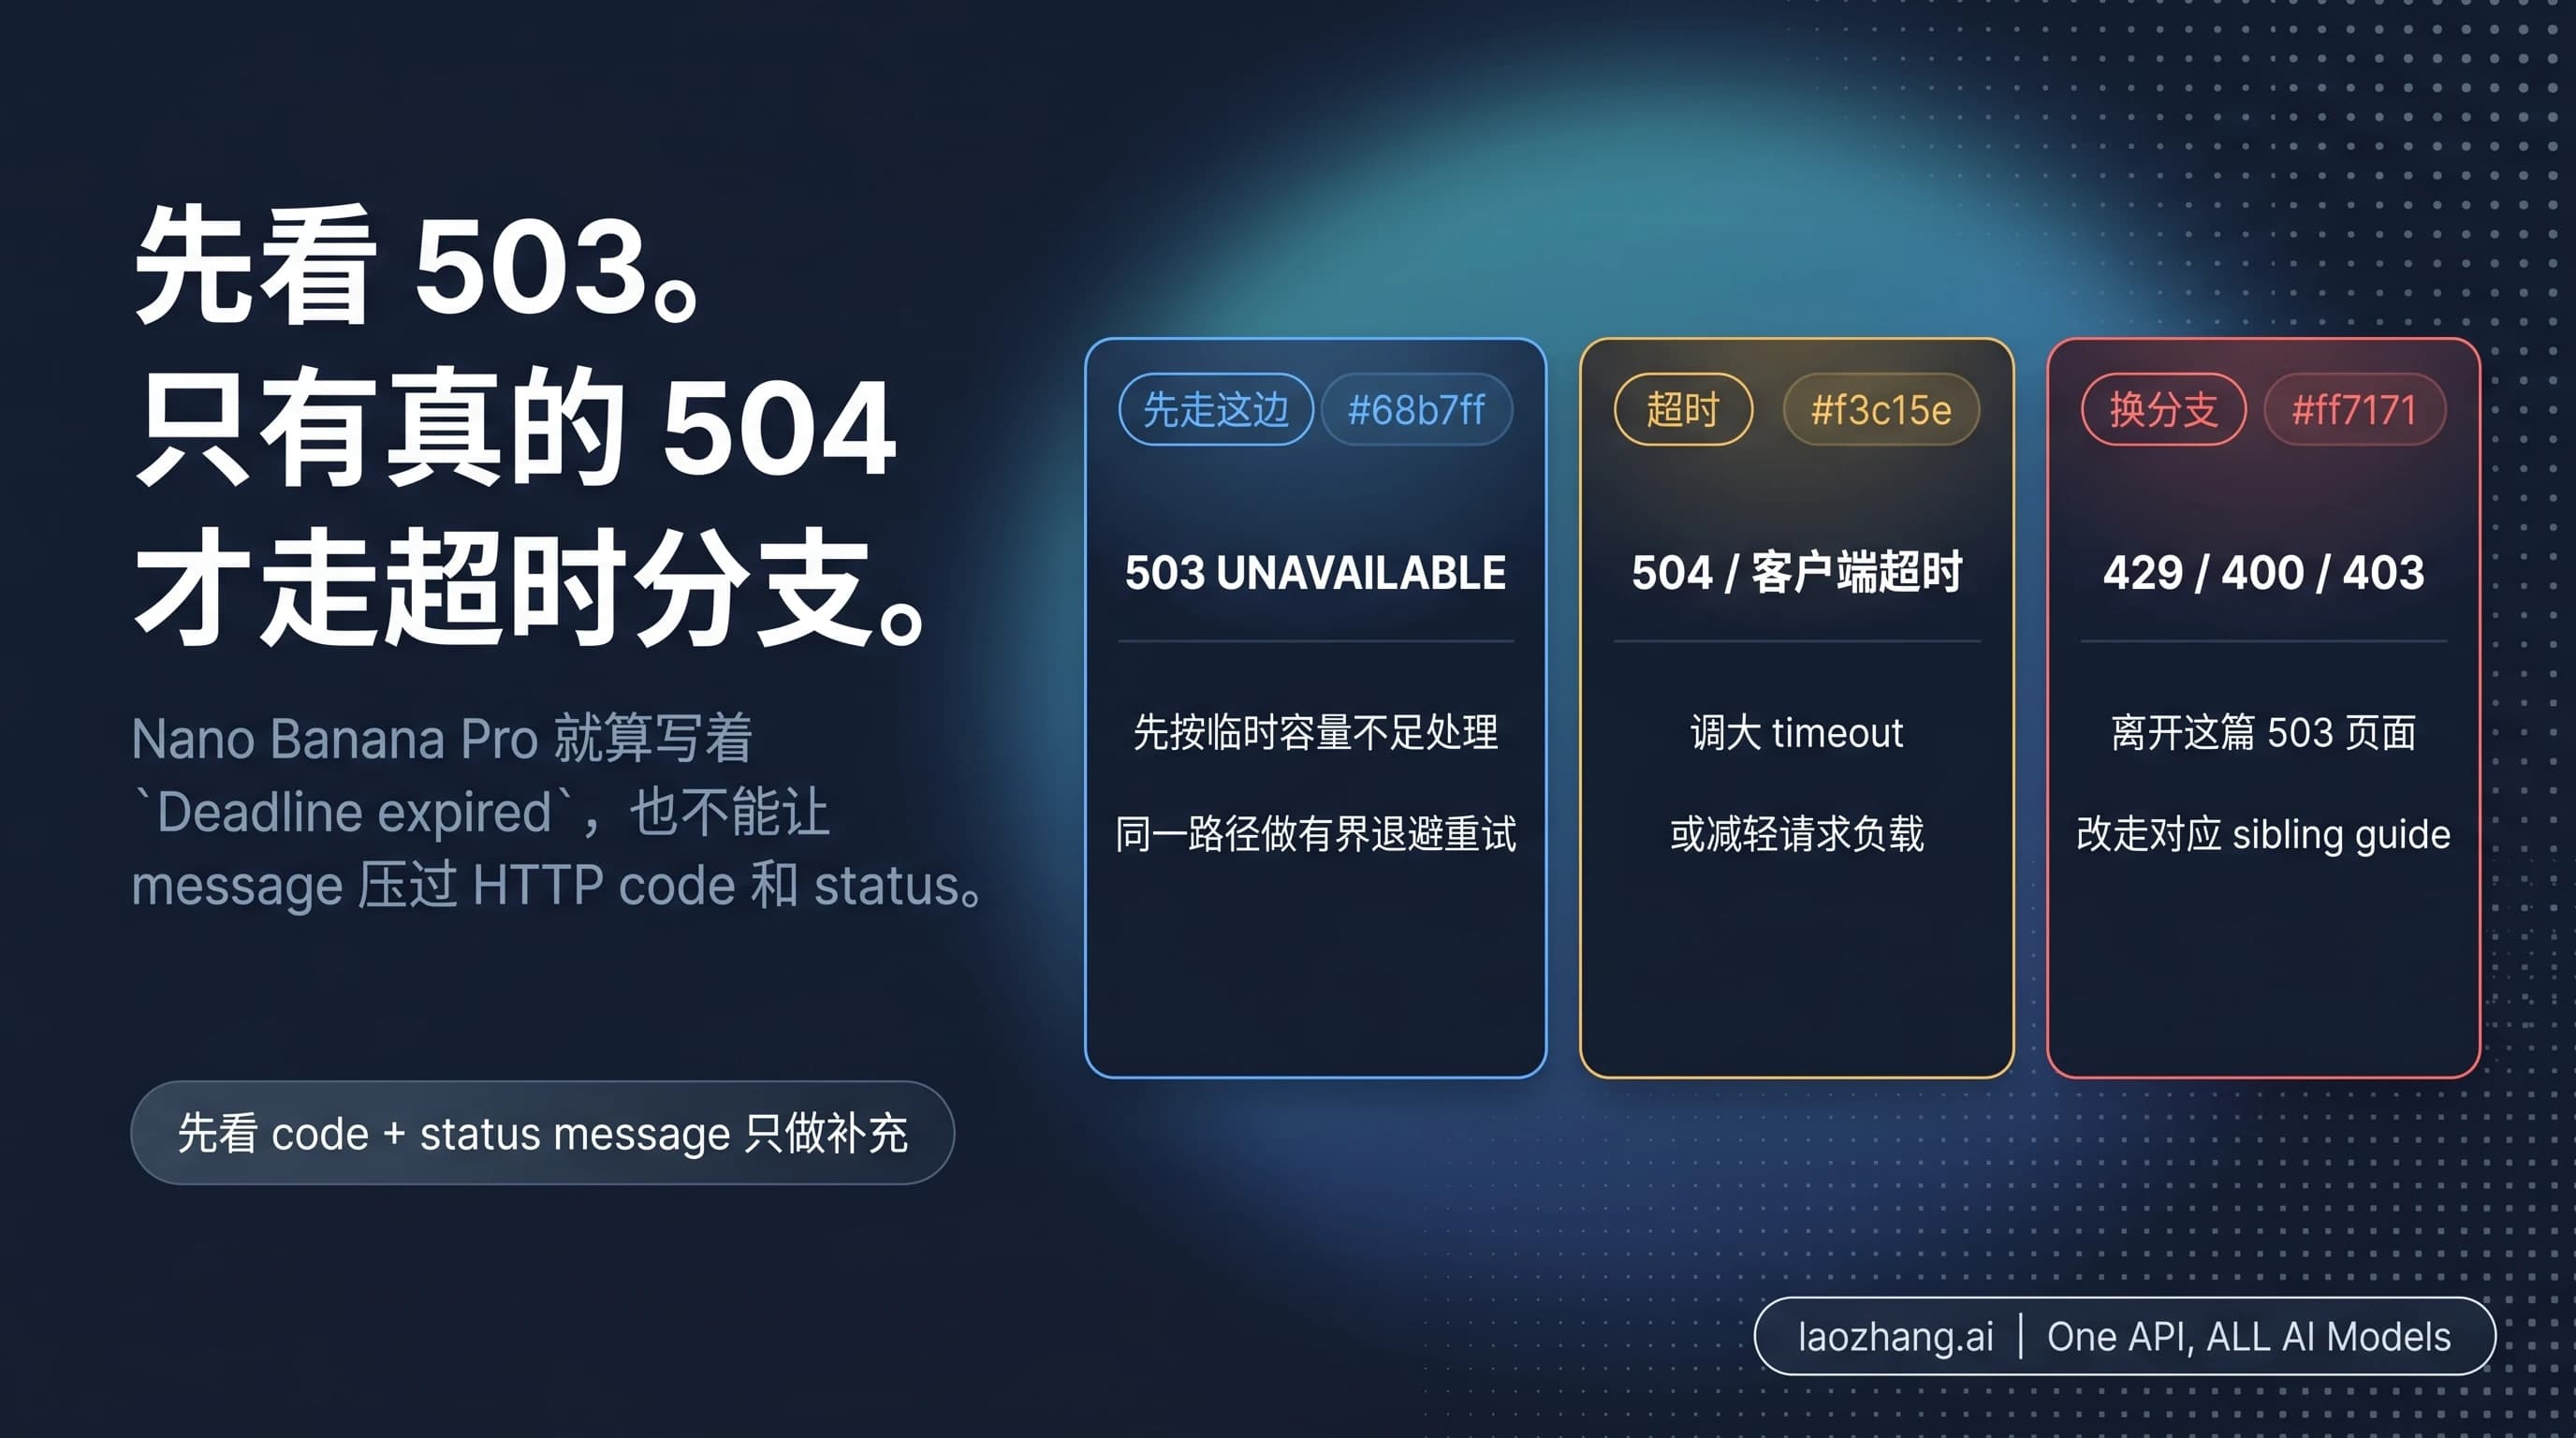
| 503,服务暂时不可用 | 有限退避,查看官方状态,保留备用方案 | 探测完成后逐步放量 |
| 400、401、403、404 | 检查参数、密钥、权限或模型名称 | 修正具体配置后再试 |
Google 排障指南建议对暂时性错误使用指数退避、随机抖动和次数上限。一条 503 响应说明这次请求无法完成,不能单独证明整个模型对所有用户都不可用。
从错误正文中找到额度和等待时间
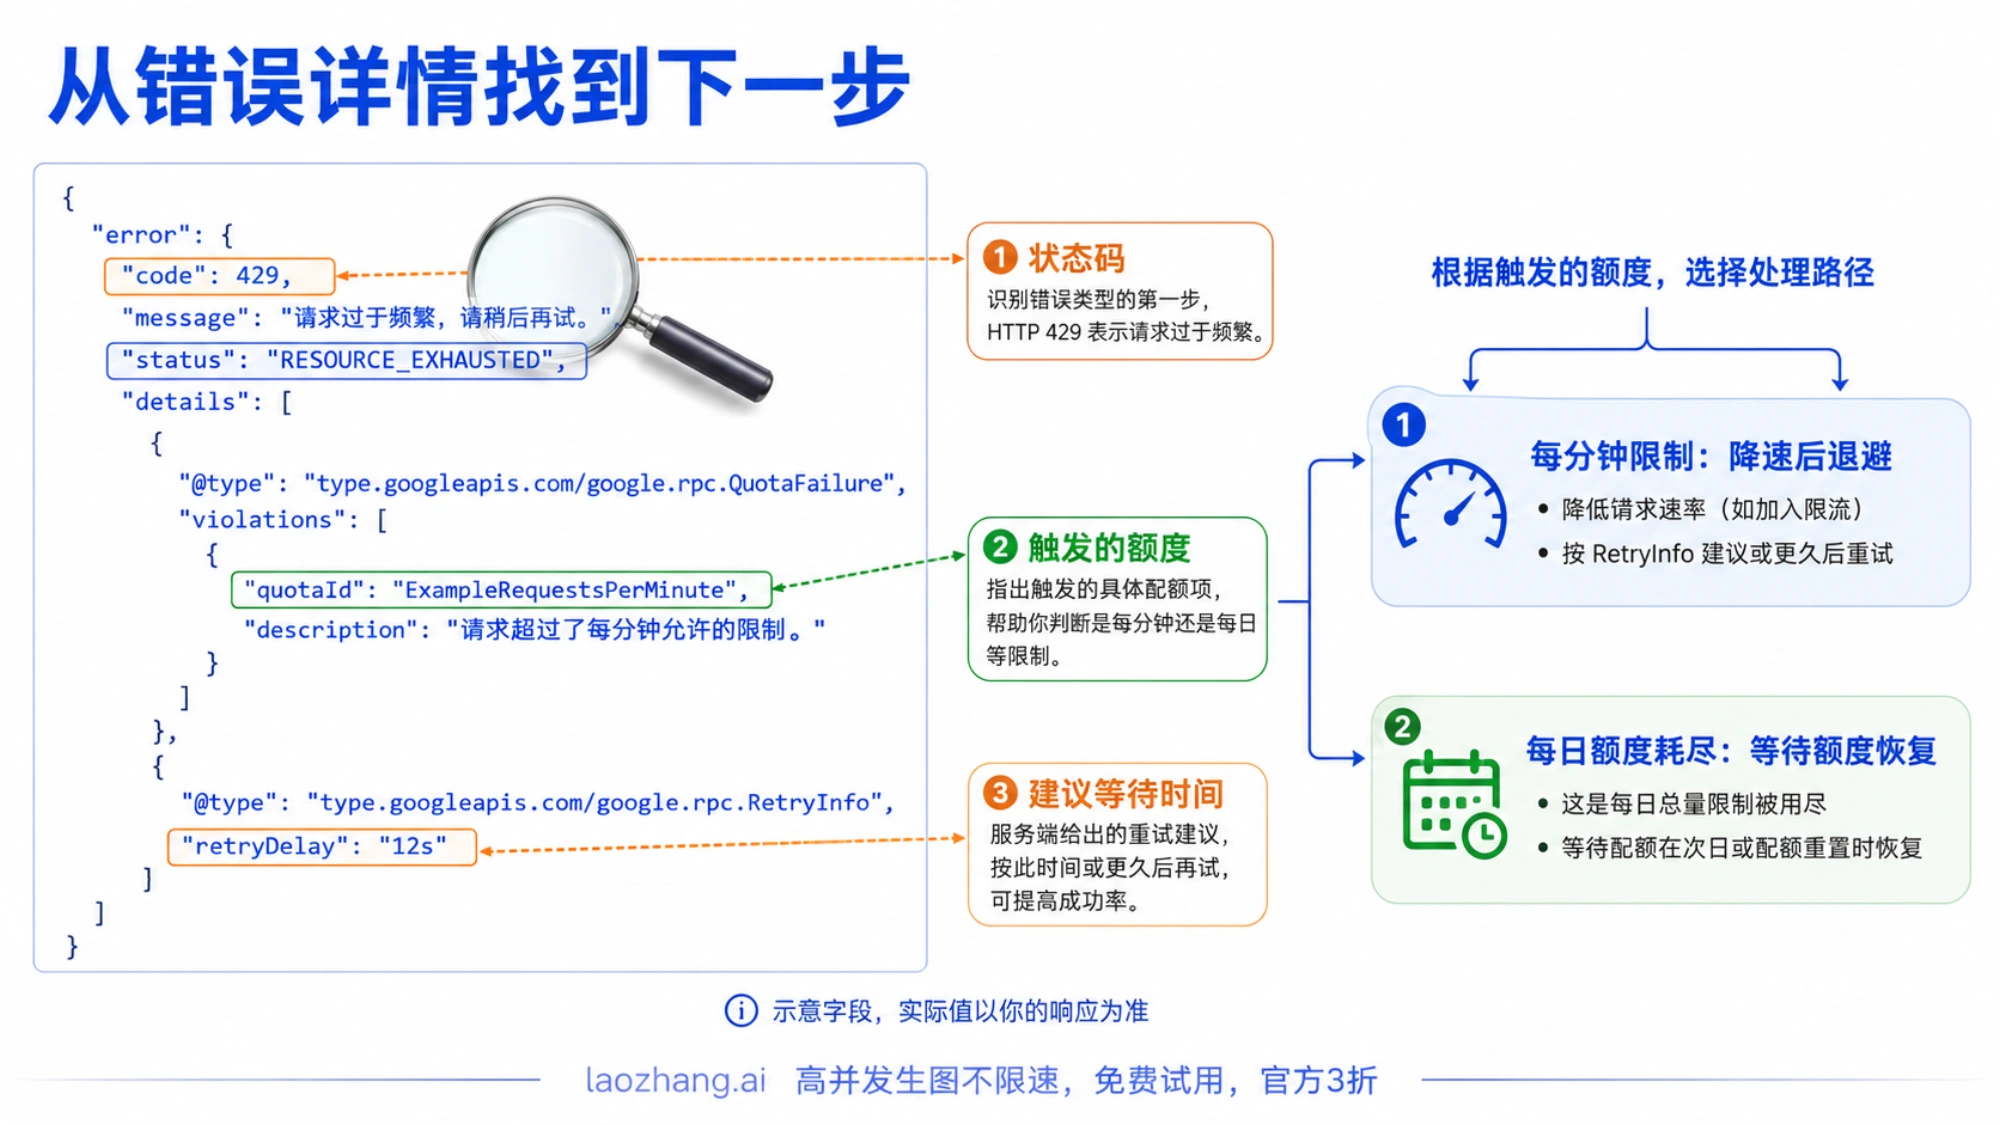
直接使用 generateContent 时,应保留 error.code、error.status 和 error.details。下面是合成教学示例,展示字段位置;额度名称、数量和等待时间都要以你的实际响应为准。
{
  "error": {
    "code": 429,
    "status": "RESOURCE_EXHAUSTED",
    "message": "Quota exceeded",
    "details": [
      {
        "@type": "type.googleapis.com/google.rpc.QuotaFailure",
        "violations": [
          {
            "quotaId": "ExampleRequestsPerMinute",
            "quotaValue": "20"
          }
        ]
      },
      {
        "@type": "type.googleapis.com/google.rpc.RetryInfo",
        "retryDelay": "12s"
      }
    ]
  }
}
这里的 quotaId 帮你定位触发的限制,quotaValue 是响应列出的额度,retryDelay 表示再次尝试前至少等待多久。字段定义可见 Google 的 QuotaFailure 与 RetryInfo。某次响应可能没有这些详情,不能因此自行补出一个“每日额度已满”的结论。
如果详情同时指向每日限制和短时间等待提示,先处理每日限制。等待十几秒不会增加已经耗尽的每日额度。也不要仅凭 message 里出现单词 quota 就把它归类为每日额度。
Interactions 使用另一套错误对象。 它的 error.code 是 rate_limit_exceeded、quota_exceeded 等字符串;官方错误页分别将它们解释为短时限流和每日额度超限。不要把该字符串字段直接套到上面的 generateContent JSON。
请求很少,为什么仍会遇到 429?
Gemini API 会分别检查多个限制,最先触发的那一项就能拦住请求。最常见的误判是只数调用次数,忽略每次输入大小。
假设某项目的有效限制是 60 RPM、120,000 输入 TPM,每次请求平均输入 8,000 token。仅按 token 维度计算,理论上每分钟最多容纳 120,000 ÷ 8,000 = 15 次请求,已经低于 60 RPM。按 60 次发送仍会超限。这里是便于理解的假设额度,不能复制成某个模型的官方配额。
实际队列还要给输入波动和其他程序留余量。固定间隔发送、限制积压任务释放速度,比只设置“最多 10 个并发”更直接地控制每分钟请求数。并发限制控制同时在途的数量,无法独自约束一批很快完成的小请求。
另外还要检查:
- 同项目的其他应用。 官方限制按项目应用,不按 API 密钥应用。另建同项目密钥,不能增加总额度。
- 长对话与附件。 后续请求携带的历史、文件和工具结果都会影响输入用量,最后一句话很短也可能是一个大请求。
- 滚动支出限制。 当前部分账号存在按 10 分钟窗口计算的支出限制,是否适用取决于结算记录和账号状态。
- 每日请求数。 RPD 在太平洋时间午夜重置,不是从报错时刻开始再等 24 小时,也不固定在北京时间零点。
以上规则来自官方速率限制文档。模型、层级和账号状态会改变有效额度;详细的层级与额度检查可继续看Gemini API 速率限制指南。
一个能直接连接请求的 Python 有限重试示例
下面使用 Python 3 标准库,直接调用非流式 generateContent,最多实际发送 4 次,累计主动等待不超过 30 秒。它读取 RetryInfo 和 Retry-After,对已识别的每日限制立即停止,未知 429 留给人工核对。没有再叠加 SDK 的自动重试。
把以下代码保存为 gemini_retry.py,在自己的环境配置 GEMINI_API_KEY 后运行。每次实际生成请求都可能产生用量。额度名称匹配只覆盖含 PerDay、PerMinute 的明确标识;其他命名会停在待查分支,需要按实际额度补充,而不是猜测。
import json
import math
import os
import random
import re
import time
import urllib.error
import urllib.request
from datetime import datetime, timezone
from email.utils import parsedate_to_datetime


def error_policy(status, body):
    error = body.get("error", {}) if isinstance(body, dict) else {}
    details = error.get("details", []) if isinstance(error, dict) else []
    quota_ids, delays = [], []
    details = details if isinstance(details, list) else []
    for item in details:
        if not isinstance(item, dict):
            continue
        if item.get("@type") == "type.googleapis.com/google.rpc.QuotaFailure":
            violations = item.get("violations", [])
            if not isinstance(violations, list):
                violations = []
            for violation in violations:
                quota_ids.append(str(violation.get("quotaId", ""))
                                 if isinstance(violation, dict) else "")
        if item.get("@type") == "type.googleapis.com/google.rpc.RetryInfo":
            value = str(item.get("retryDelay", ""))
            if re.fullmatch(r"\d+(?:\.\d{1,9})?s", value):
                delays.append(float(value[:-1]))
    if status == 429:
        if any("perday" in q.lower() for q in quota_ids):
            return "quota_reset", 0
        if not quota_ids or not all("perminute" in q.lower() for q in quota_ids):
            return "inspect_quota", 0
    elif status not in (500, 502, 503, 504):
        return "fix_request", 0
    return "retry", max(delays, default=0)


def retry_after(value):
    if value is None:
        return 0
    try:
        seconds = float(value)
    except ValueError:
        try:
            seconds = (parsedate_to_datetime(value) - datetime.now(timezone.utc)).total_seconds()
        except (TypeError, ValueError, OverflowError):
            return 0
    return max(0, seconds) if math.isfinite(seconds) else 0


def generate(payload, model="gemini-3.1-pro-preview"):
    waited = 0.0
    for attempt in range(4):
        request = urllib.request.Request(
            f"https://generativelanguage.googleapis.com/v1beta/models/{model}:generateContent",
            data=json.dumps(payload).encode(),
            headers={"Content-Type": "application/json",
                     "x-goog-api-key": os.environ["GEMINI_API_KEY"]},
            method="POST"
        )
        try:
            with urllib.request.urlopen(request, timeout=20) as response:
                return json.load(response)
        except urllib.error.HTTPError as error:
            raw = error.read().decode("utf-8", errors="replace")
            try:
                body = json.loads(raw)
            except json.JSONDecodeError:
                body = {}
            action, hint = error_policy(error.code, body)
            print(f"第{attempt + 1}次,HTTP {error.code},处理:{action}")
            if action != "retry" or attempt == 3:
                raise RuntimeError(raw) from error
            delay = max(hint, retry_after(error.headers.get("Retry-After")),
                        random.uniform(0, min(8, 2 ** attempt)))
            if waited + delay > 30:
                raise RuntimeError("建议等待时间超出本轮预算,停止发送") from error
        time.sleep(delay)
        waited += delay
    raise RuntimeError("尝试次数已耗尽")


if __name__ == "__main__":
    result = generate({
        "contents": [{"parts": [{"text": "请只回复:连接检查完成"}]}],
        "generationConfig": {"thinkingConfig": {"thinkingLevel": "LOW"}}
    })
    candidates = result.get("candidates", [])
    if not candidates or candidates[0].get("finishReason") != "STOP":
        raise RuntimeError("生成未正常结束,请检查返回正文")
    parts = candidates[0].get("content", {}).get("parts", [])
    text = "".join(p.get("text", "") for p in parts if not p.get("thought"))
    if not text.strip():
        raise RuntimeError("没有最终文本,请检查返回正文")
    print(text)
    print("实际用量:", result.get("usageMetadata", {}))
30 秒限制的是代码主动退避的累计等待,单次连接另设 20 秒超时,二者不能相加当成严格的整轮截止时间。若业务要求“用户等待最多 30 秒”,应在调用层增加可取消的总超时,并停止后续尝试。
这份例子不会自动重发网络断连或已返回 200 但内容无法解析的请求,因为服务端可能已经完成生成。应先记录这种不确定结果,再决定如何处理。重试循环也不应包住订单写入、发邮件等业务操作;这些动作需要独立去重。
如果使用官方 SDK,先检查版本及重试配置。当前排障文档说明 SDK 自带部分暂时性错误重试。外层 3 轮、内层每轮 5 次实际发送,就可能变成 15 次请求;保留一层主要重试,才能看清真实尝试次数。
503 持续出现时,怎样恢复业务?
先检查官方服务状态,并用模型停用表确认模型仍受支持。然后保留同一项目、模型和接口,去掉复杂附件或可选工具,用一条简短输入观察。一次成功只说明小请求可完成,恢复正常负载后还要继续观察。
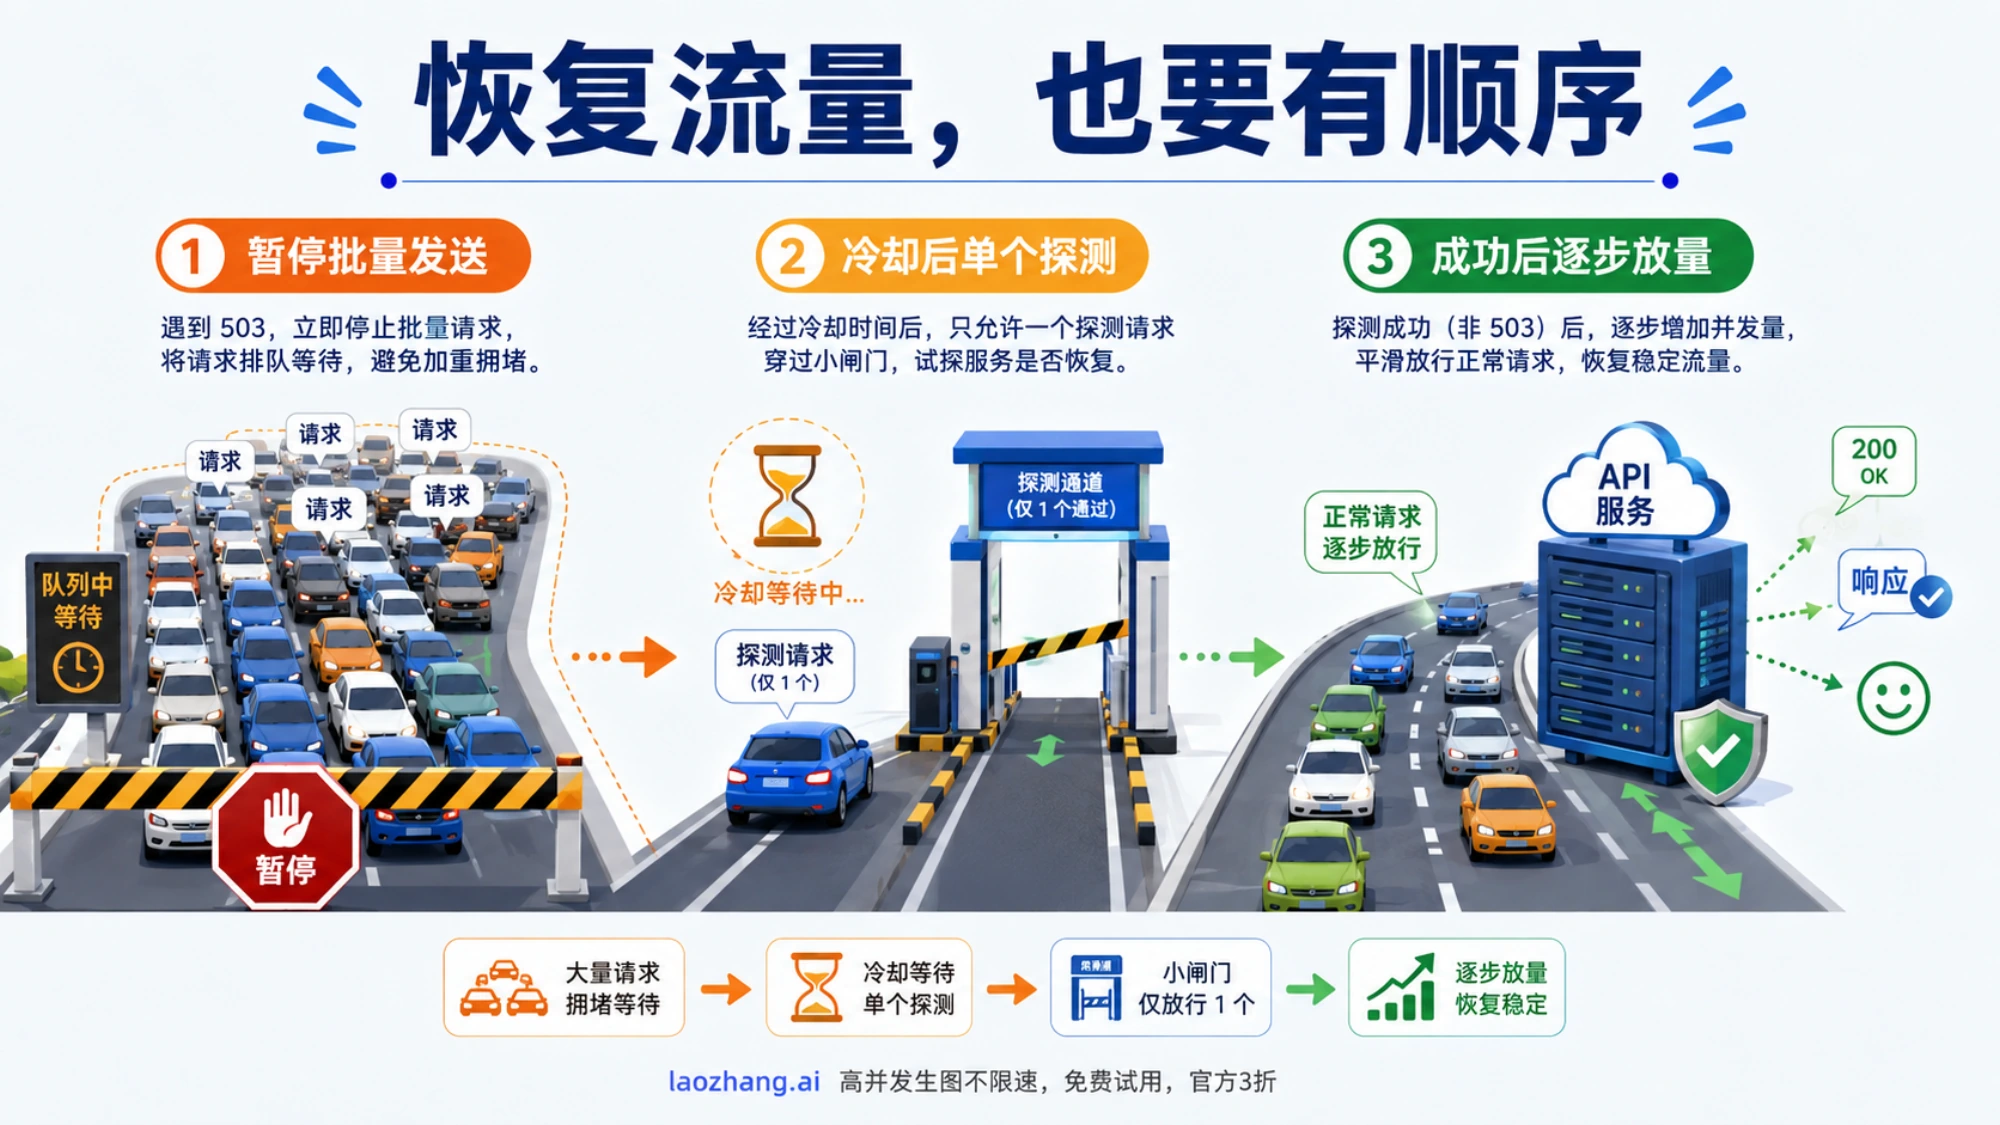
可以把恢复过程分成三个动作:暂停普通流量,冷却后只放行一个探测,成功后逐档增加发送速率。多线程程序需要共享探测许可,不能每个请求各建一个断路器;多进程或多台服务器则要通过共享存储或任务队列协调。本地线程锁不能限制整个集群。
若备用模型能够满足相同任务,在正常时期就验证它的输入、工具、输出结构和费用。切换后也要检查实际结果,不能只看状态码成功。图像任务可参考Gemini 图像生成过载排查;文本任务无需套用图片专属配置。
更换应用服务器的地理位置,不等于为 Gemini Developer API 选择了一份独立区域容量。第三方入口也可能使用同一上游。备用方案是否有效,要靠该方案当时实际完成请求来判断。
怎样确认这次修复真的有效?
本文的重试例使用合成响应离线检查:每日额度立即停止,未知 429 不盲重试,分钟限额和暂时性 5xx 尊重等待提示,超出等待预算或发送次数后结束。这些检查验证的是示例控制逻辑,没有进行付费故障实测。
在自己的服务上,保存恢复前后相同条件的记录:实际发送次数、触发额度、等待时间、最终结束状态、结果是否符合任务要求,以及恢复正常流量后是否再次失败。流式接口还应检查最终事件,建立 HTTP 连接不等于生成完成。
如果低负载下仍持续失败,向支持提供发生时间、项目与模型、错误详情、请求标识和最小复现步骤。移除密钥及私人输入后再共享日志。这样支持方能核对具体请求,你也能区分额度问题、配置问题与服务端故障。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年9月8日。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年9月8日。
- 1.官方速率限制页ai.google.dev/gemini-api/docs/rate-limits
- 2.Google 排障指南ai.google.dev/gemini-api/docs/troubleshooting
- 3.QuotaFailure 与 RetryInfogithub.com/googleapis/googleapis/blob/master/google/rpc/error_details.proto
- 4.官方错误页ai.google.dev/gemini-api/docs/api-errors
- 5.官方服务状态aistudio.google.com/status
- 6.模型停用表ai.google.dev/gemini-api/docs/deprecations