DeepSeek V4.1 Flash vs Gemini 3.8 Flash 对比:实测花费差 3~6 倍
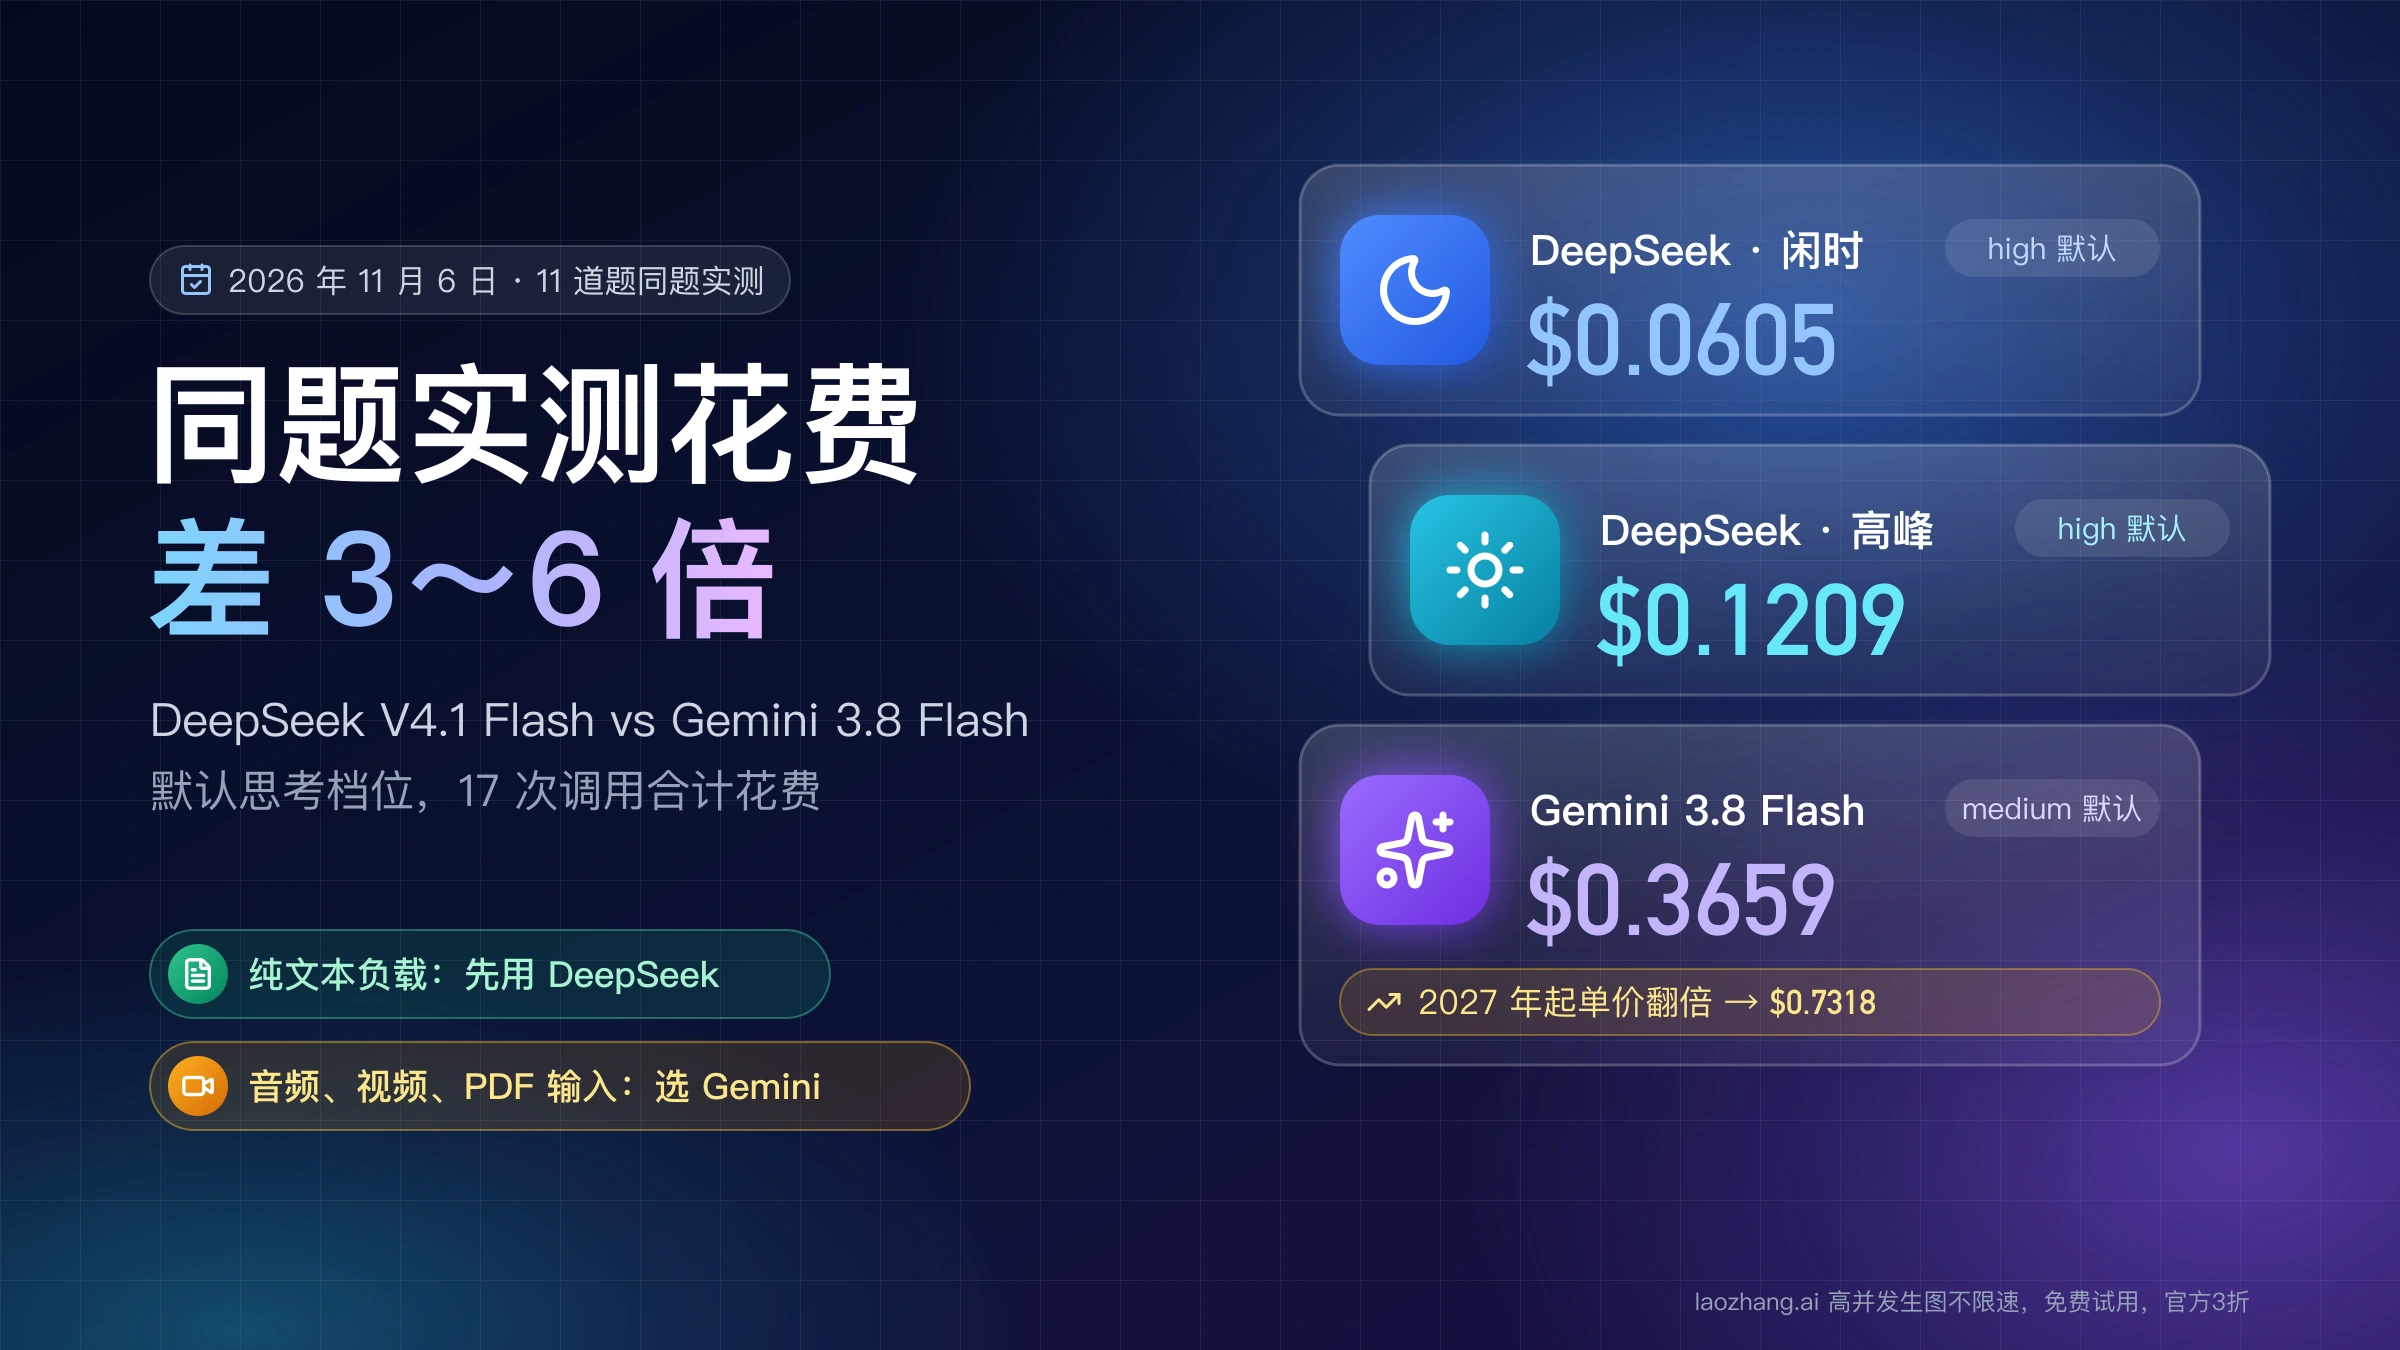
11 道题同题实测:默认档位下 Gemini 3.8 Flash 花费是 DeepSeek V4.1 Flash 闲时的 6 倍、高峰的 3 倍,纯文本负载先用 DeepSeek。
文章目录
只处理文本的 API 负载,比如客服对话、批量摘要、编程助手,先用 DeepSeek V4.1 Flash:模型名填 deepseek-flash(现在由 10 月 17 日更新的 1017 快照提供服务),思考保持默认的 reasoning_effort: "high",能等的批量任务排到北京时间的闲时。输入里有音频、视频或 PDF,或者答案主要靠模型自己记得的事实和科学推理,再换成 Gemini 3.8 Flash(gemini-3.8-flash),思考档位保持默认的 medium,同时把 maxOutputTokens 放宽到 65,536。
2026 年 11 月 6 日(周五)北京时间晚上,用同一个 LaoZhang 网关 key 给两个模型发了同样的 11 道题,各调用 17 次。两边都用默认档位,按返回的用量乘官方标价,Gemini 3.8 Flash 一共花 $0.3659,DeepSeek V4.1 Flash 按闲时价是 $0.0605、按高峰价是 $0.1209,Gemini 分别贵 6 倍和 3 倍;Gemini 3.8 Flash 从 2027 年 1 月 1 日起单价翻倍,倍数会变成 12 倍和 6 倍。DeepSeek 17 次全部通过;Gemini 唯一失手的是一道 npm 版本范围(semver)编程题,2 次里有 1 次没在 32,000 token 的输出预算内写完代码,放宽预算重跑后通过,但每次约 $0.115,是 DeepSeek 同题的 8 倍左右。每题只有 1~2 个样本,这是一次同条件对照,不是基准测试。
用 Gemini 3.8 Flash 还有一个前提:截至 2026 年 11 月 6 日,Google 的 Gemini API 可用地区列表里没有中国大陆和香港,在这两地使用需要可用地区的账号或第三方线路。DeepSeek 的高峰是北京时间工作日 9:00–12:00 和 14:00–18:00,白天的客服流量大多落在高峰里,这时两边的差距按 3 倍估更接近实际。
按负载选 DeepSeek V4.1 Flash 还是 Gemini 3.8 Flash
多数纯文本负载先用 DeepSeek V4.1 Flash,只有三种情况该换成 Gemini 3.8 Flash:输入是音频、视频或 PDF 而你不想先转成文字;问题要靠模型自身的事实知识或科学推理来答,又没有检索资料兜底;你已经在用 Google 的代码执行、文件搜索或搜索依据这类配套功能。反过来,单次要输出超长内容时只能选 DeepSeek。下面的表把常见负载和改选条件放在一起,依据分别在后面几节。
| 负载 | 先用 | 什么情况改用另一个 |
|---|---|---|
| 客服、对话后端(纯文本) | DeepSeek V4.1 Flash,默认 high | 回答主要靠模型记住的事实、又接不了知识库检索时,换 Gemini 3.8 Flash |
| 批量摘要、分类、信息抽取 | DeepSeek V4.1 Flash,排到闲时跑 | 原始材料是 PDF、录音或视频时用 Gemini 3.8 Flash,不急就走它的 Batch |
| 编程助手、按规格写代码 | DeepSeek V4.1 Flash,默认 high | 要用 Gemini 的代码执行等功能时可以换,但要调高 maxOutputTokens |
| 不接检索的事实问答、科学推理 | Gemini 3.8 Flash,默认 medium | 预算紧、能补上检索资料时,回到 DeepSeek |
| 输入含音频、视频、PDF | Gemini 3.8 Flash | 先自行转写成文本,就能回到 DeepSeek |
| 单次输出超过 Gemini 的上限 | DeepSeek V4.1 Flash | 任务能拆成多次调用时,两边都能用 |
两家 API 单价:DeepSeek 分峰谷,Gemini 2027 年翻倍
按每百万 token 计,Gemini 3.8 Flash 现在的标价是 DeepSeek V4.1 Flash 闲时价的 5 倍(输入)和 6.25 倍(输出),对高峰价是 2.5 倍和 3.1 倍。两家都把思考 token 按输出价计费,所以账单主要由输出价和模型想了多少决定。DeepSeek 的闲时价按官方定义就是高峰价的一半,周末和法定节假日全天都是闲时,见 DeepSeek 中文模型与价格页;Gemini 3.8 Flash 的现价执行到 2026 年 12 月 31 日,见 Gemini API 价格页。
| 每百万 token | 输入(未命中缓存) | 输入(命中缓存) | 输出(含思考) |
|---|---|---|---|
| DeepSeek V4.1 Flash,闲时 | $0.15 / 1 元 | $0.003 / 0.02 元 | $0.60 / 4 元 |
| DeepSeek V4.1 Flash,高峰 | $0.30 / 2 元 | $0.006 / 0.04 元 | $1.20 / 8 元 |
| Gemini 3.8 Flash,到 2026 年底 | $0.75 | $0.075 | $3.75 |
| Gemini 3.8 Flash,2027 年起 | $1.50 | $0.15 | $7.50 |
DeepSeek 的人民币价是官方价目页单独列出的,不是按汇率换算的;Gemini 只有美元价。Gemini 的显式上下文缓存另收存储费,现价每百万 token 每小时 $0.50,2027 年起 $1.00。不急的任务可以走 Gemini 的 Batch 或 Flex,现价是标准价的一半,即输入 $0.375、输出 $1.875,仍高于 DeepSeek 的高峰价。Gemini 免费层的输入输出不收费,但每天能用多少没有公布,见 Gemini API Key 免费额度与速率限制 2026:哪些还免费、去哪看限额;完整价目和调价细节见 Gemini API Key 购买前先看:价格、免费额度与 2027 年 Flash 涨价。
同一段中文在两家算出的 token 数也不一样。2026 年 11 月 6 日把同一段 3,000 字符的中文分别发给两个模型,DeepSeek 计 1,668 个输入 token,Gemini 计 1,839 个,多 10.3%;同样长度的英文,Gemini 多 10.9%。这个差距改变不了上面的价差,但按字数估中文账单时,Gemini 那一侧要多留一成。DeepSeek 错峰怎么排、账单怎么拆,见 DeepSeek API 峰谷价格:几点调用更省、账单怎么算。
同题实测花费:默认档位下 Gemini 是 DeepSeek 闲时的 6 倍
两边都用默认思考档位,11 道题每个配置共调用 17 次,Gemini 3.8 Flash(medium)的花费是 DeepSeek V4.1 Flash(high)闲时价的 6.0 倍、高峰价的 3.0 倍;把 Gemini 开到 high,变成 10.0 倍和 5.0 倍。合计的倍数接近输出单价差,但拆到每一轮就不同了:简单题上 Gemini 想得少,倍数低于单价差;难题上它想得多,倍数高于单价差。
测试在 2026 年 11 月 6 日北京时间 20:50 到 21:30 前后进行,全程处于 DeepSeek 闲时。两个模型经同一个 LaoZhang 网关 key 流式调用:DeepSeek 走 OpenAI 兼容的 /v1/chat/completions,开启思考并设 reasoning_effort: "high",每次返回的模型都是 deepseek-v4-1-flash-261017;Gemini 走原生的 streamGenerateContent,thinkingLevel 分别设为 medium 和 high,只统计每个分块都标着 gemini-3.8-flash 的调用。两边输出上限都设 32,000 token,不加系统提示、工具和温度参数。这条线路有两次在 Gemini 响应里混进了标着 3.1-flash-lite-05-2026 的分块,还有一次流在 300 秒没有输出后断开,这三次都作废重跑。只测了这一条线路、这一天,DeepSeek 官方 API 和 Google AI Studio 直连没有测,延迟数字可能受网关影响。
第 1 轮是 8 道有标准答案或隐藏测试的题:文字应用题、区间合并、时长字符串解析、词频统计、把一篇 6,723 词的英文长文写成 5 条摘要,以及 3 道较难的题(不用 eval 的表达式求值、CSV 行解析、统计 100 万以内数位和为 27 的整数个数)。较难的 3 道各跑 2 次,所以每个配置 11 次。第 2 轮是 3 道能拉开差距的题,各跑 2 次,结果在下一节。花费 =(输入 − 缓存命中)× 未命中单价 + 缓存命中 × 命中单价 + 输出 × 输出单价,单价按每百万 token。
| 配置 | 第 1 轮 8 题(11 次) | 第 2 轮 3 题(6 次) | 两轮合计 | 2027 年起两轮合计 |
|---|---|---|---|---|
| DeepSeek V4.1 Flash high,闲时价 | $0.0286,11/11 通过 | $0.0319,6/6 通过 | $0.0605 | 未公布调价 |
| DeepSeek V4.1 Flash high,高峰价 | $0.0572 | $0.0637 | $0.1209 | 未公布调价 |
| Gemini 3.8 Flash medium(默认) | $0.1236,11/11 通过 | $0.2423,5/6 通过 | $0.3659 | $0.7318 |
| Gemini 3.8 Flash high | $0.3028,11/11 通过 | $0.3017,4/6 通过 | $0.6045 | $1.2091 |
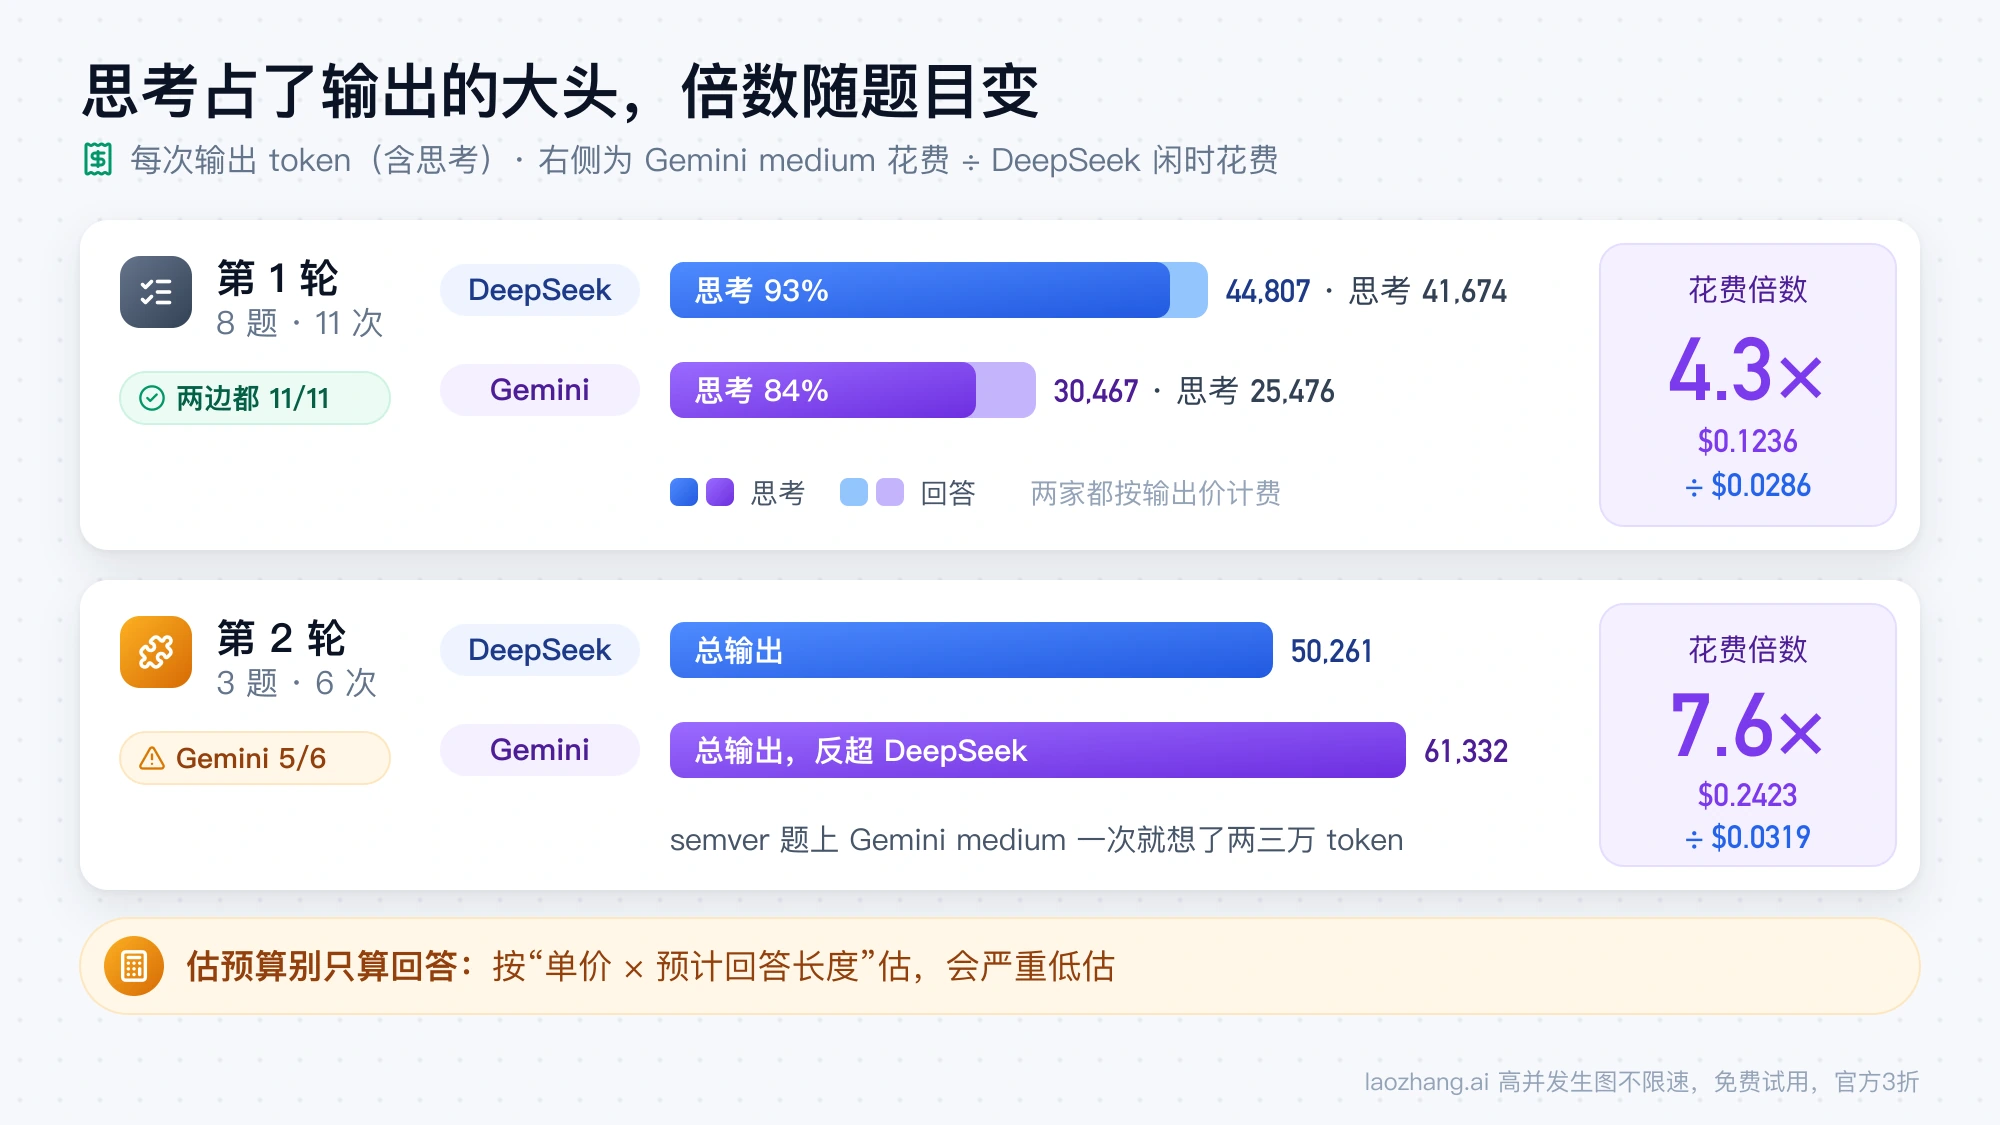
第 1 轮 Gemini medium 只比 DeepSeek 闲时价贵 4.3 倍,因为它的输出是 30,467 token(其中思考 25,476),比 DeepSeek 的 44,807(其中思考 41,674)少三成。第 2 轮变成 7.6 倍:semver 题上 Gemini medium 一次就想了两三万 token,总输出 61,332,反超 DeepSeek 的 50,261。第 1 轮里思考占了两边输出的 84%~93%,回答本身只是零头,所以按"单价 × 预计回答长度"估预算会严重低估。
同一道题两次调用的花费也可能差一倍多。表达式求值题上,DeepSeek 两次完全相同的调用分别用了 8,708 和 19,986 个输出 token($0.0053 和 $0.0120),Gemini high 是 16,326 和 22,490 个。输入重的题差距最大:长文摘要 DeepSeek 花 $0.0025,Gemini medium 花 $0.0176,约 7 倍,因为除了输入单价差 5 倍,Gemini 在这道题上还想得更多(2,266 对 1,379 个思考 token),同一篇英文算出的输入 token 也多 8.8%。
重复发送的长提示两边都会自动走缓存,不用另做设置。同一个 10,387 token 的长文提示发第二次,DeepSeek 报告 10,368 个缓存命中,单次花费从 $0.0019 降到 $0.0004;Gemini 的隐式缓存命中 11,300 个里的 8,168 个,从 $0.0107 降到 $0.0054。客服这类每次都带同一段长系统提示的负载,缓存部分的价差要单独算:命中价 Gemini 是 DeepSeek 闲时的 25 倍。
Gemini 这边的数字能复现。2026 年 10 月 26 日用同一个 key、同样 8 道题、非流式调用 Gemini 3.8 Flash high,11 次全部通过,输出 80,277 token,花费 $0.3104;11 月 6 日这次是 78,258 token、$0.3028,相差不到 3%。另外,经 LaoZhang 网关调用时,deepseek-flash 按平台报价每百万 token 输入 $0.44、输出 $1.32 计,不分峰谷,高于 DeepSeek 官方任何时段的价格;gemini-3.8-flash 与 Google 标价相同。按这组价,第 1 轮 DeepSeek 花 $0.0643,Gemini medium 是它的 1.9 倍。
semver 难题:Gemini 3.8 Flash 卡在 32,000 输出预算,不是写错
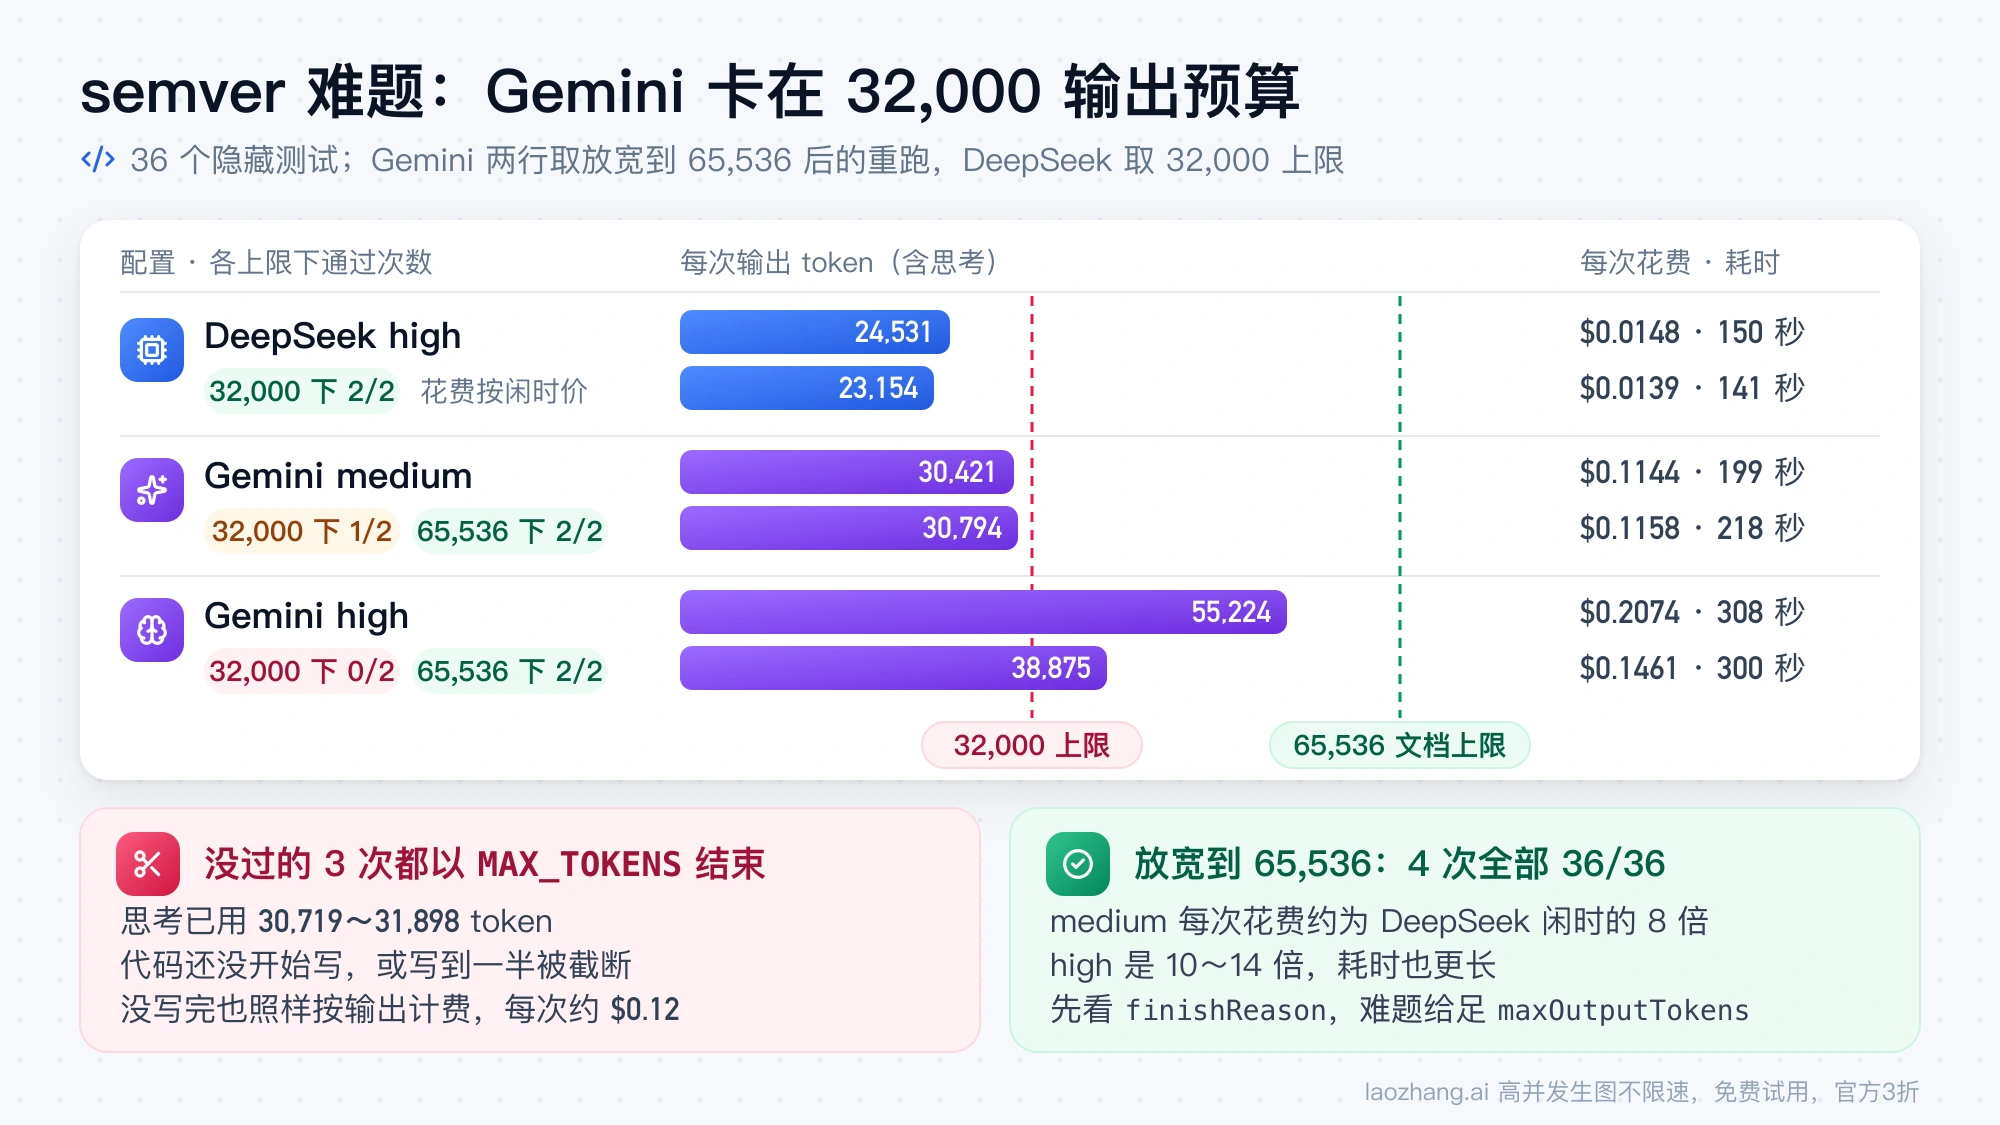
第 2 轮的三道题里,只有 semver 这一道拉开了差距,而 Gemini 3.8 Flash 输在输出预算,不在代码对错。这道题要求按 npm 规则判断版本号是否满足范围,包括 ^、~、连字符范围、|| 和预发布版本的特殊规则,用 36 个隐藏测试判分。在 32,000 token 的输出上限下,DeepSeek V4.1 Flash 两次都是 36/36;Gemini medium 2 次过 1 次,high 2 次都没过。没过的 3 次都以 finishReason: MAX_TOKENS 结束,思考已经用掉 30,719~31,898 token,代码要么还没开始写,要么写到一半被截断。
把 Gemini 的 maxOutputTokens 放宽到文档上限 65,536,medium 和 high 各再跑 2 次,4 次全部 36/36 通过。下表 Gemini 两行取的是放宽后的重跑,DeepSeek 取 32,000 上限下的两次:
| 配置 | 32,000 上限下通过 | 放宽到 65,536 后通过 | 每次输出 token | 每次花费 | 每次耗时 |
|---|---|---|---|---|---|
| DeepSeek V4.1 Flash high | 2/2 | 无需重跑 | 24,531 / 23,154 | $0.0148 / $0.0139(闲时) | 150 / 141 秒 |
| Gemini 3.8 Flash medium | 1/2 | 2/2 | 30,421 / 30,794 | $0.1144 / $0.1158 | 199 / 218 秒 |
| Gemini 3.8 Flash high | 0/2 | 2/2 | 55,224 / 38,875 | $0.2074 / $0.1461 | 308 / 300 秒 |
所以 Gemini 3.8 Flash 写得出这段代码,只是需要更大的输出预算,每次花费约是 DeepSeek 闲时价的 8 倍(medium)到 10~14 倍(high),耗时也更长。如果你给 Gemini 设了较小的 maxOutputTokens,难题上"答不完"多半是预算问题,先看 finishReason。没写完的那几次也照样按输出计费,每次约 $0.12。
另外两道题两边都没失手,8 次 Gemini 回答和 4 次 DeepSeek 回答全部正确。一道把三段"项目备注"藏在 6,723 词的长文里,其中一段事后把预算上调 25%,要算出最终金额 $76.80;另一道问 Python 3.13 标准库,里面混了两个并不存在的函数 statistics.winsorized_mean 和 functools.memoize_method,所有回答都说不存在,没有编造用法,而同一道题在 10 月 26 日的测试里,MiniMax M3.1 Flash 4 次都编出了用法。semver 只是一道难的编程规格题,每个配置 2 个样本,说明不了谁的编程能力全面更强。
Gemini 3.8 Flash 更聪明吗:AA 指数默认档位只差 1 分
按 Artificial Analysis(AA)智能指数 v5.0.1,两边默认档位几乎打平:DeepSeek V4.1 Flash 1017 的 high 是 29 分,Gemini 3.8 Flash 的 medium 是 30 分;各自开到最高档,DeepSeek max 33 分,Gemini high 31 分;关掉思考的 DeepSeek 只有 19 分,Gemini low 23 分。差别在强项:终端编程任务 Terminal-Bench 4.0 上 DeepSeek high 28.8%、max 33.8%,Gemini high 19.7%;科学推理和事实知识反过来,HLE-Diamond 上 DeepSeek max 25.3% 对 Gemini high 33.1%,CritPt v2 上 25.0% 对 46.5%,考察事实答得准不准、拿不准时会不会乱答的 AA-Omniscience 上,DeepSeek 只有 1~2 分,Gemini 是 23~24 分。数据截至 2026 年 11 月 6 日,见 Artificial Analysis 的 DeepSeek V4.1 Flash 1017 与 Gemini 3.8 Flash 对比页。
AA 算出的单题花费差距比上面的实测大得多:每道指数题 DeepSeek high 花 $0.46,Gemini medium 花 $6.26,约 13.6 倍,而且 AA 用的是 DeepSeek 高峰价,换成闲时价 DeepSeek 一侧大约减半。AA 的成本把输入、缓存命中和缓存写入都算进去,题目里有 Terminal-Bench 这类多轮任务,输入量远大于单轮提问;Gemini 的输入价和缓存命中价分别是 DeepSeek 高峰价的 2.5 倍和 12.5 倍,输入越重,差距越往这个量级靠。这是按价目推出的原因:单轮问答更接近上面实测的 3~6 倍,多轮、长上下文的智能体负载,差距可能大得多。
DeepSeek 在 1017 更新说明里自报 Terminal-Bench 4.0 从首发版的 31.2 提到 42.3,这是厂商自测,不是独立成绩,见 DeepSeek API 更新日志。落到选型上:客服、摘要、按规格写代码这类有材料可依的任务,上面 11 道题里两边几乎一样能做对,按价钱和输入类型选就行;要模型凭自身知识回答事实或科学问题、又没有检索兜底时,Gemini 3.8 Flash 的领先是实打实的。
首字多久出来:DeepSeek 先流出思考,Gemini 默认等到回答
在这批题上,DeepSeek V4.1 Flash 大约 2.6 秒就开始流出思考文本,第一个回答 token 的中位数是 9~11 秒;Gemini 3.8 Flash 默认不返回思考,流里的第一个 token 就是回答,medium 的中位数是 22~27 秒。DeepSeek "开始得更快",很大一部分是因为它把思考过程放在 reasoning_content 里直接流出来,界面上可以先显示思考内容。
| 配置 | 首个 token 中位数(第 1 轮) | 首个回答 token 中位数(第 1 轮 / 第 2 轮) | 单次总耗时中位数(第 1 轮) | 第 1 轮 11 次总耗时 |
|---|---|---|---|---|
| DeepSeek V4.1 Flash high | 2.6 秒 | 10.9 / 9.4 秒 | 12.3 秒 | 363 秒 |
| Gemini 3.8 Flash medium | 22.0 秒 | 22.0 / 27.0 秒 | 24.1 秒 | 301 秒 |
| Gemini 3.8 Flash high | 27.9 秒 | 27.9 / 42.1 秒 | 30.1 秒 | 584 秒 |
第 2 轮给 Gemini 打开了思考摘要(includeThoughts: true),首个 token 的中位数降到 4~5 秒,但第一个回答 token 并没有提前。DeepSeek 第 1 轮的 11 次总耗时比 Gemini medium 还长,是因为其中一次表达式求值调用跑了 153.5 秒;单次耗时的中位数仍只有 Gemini medium 的一半。
换一批任务,回答开始的先后会反过来。AA 在自己的指数任务上测得,DeepSeek high 的第一个回答 token 要 24.11 秒,Gemini medium 只要 10.01 秒;输出速度 DeepSeek 每秒 175 个 token,Gemini 116 个;每道指数题平均用时 10.5 分钟对 11.8 分钟。上面的实测是经网关的短小单轮请求,AA 是长任务,两者思考时长差别很大,所以首字延迟要拿你自己的提示在实际要用的线路上测。
网上的对比数字为什么对不上:日期、价格来源、档位
各处看到的 DeepSeek V4.1 Flash 对 Gemini 3.8 Flash 数字互相矛盾,多半出在三件事上。第一是日期:DeepSeek 在 2026 年 10 月 17 日把 deepseek-flash 换成 1017 快照,调用方式和价格不变,但更新说明称缩短了任务运行时间和输出长度,在这之前的测试和榜单描述的是 9 月 10 日首发的版本。第二是价格来源:聚合平台列出的常是某个第三方服务商的价格或缓存命中价,不是 DeepSeek 官方价目页上的价格,拿它算出的倍数自然不同。第三是档位:拿 DeepSeek max 比 Gemini medium,或者拿关掉思考的 DeepSeek 比 Gemini high,分数和花费都会偏向一边。
输出长度这一点对成本影响最大。第三方平台 aimlapi 在 10 月初、1017 之前让两边一次性写 6 个 three.js 3D 场景,DeepSeek V4.1 Flash 用了约 16.8 万个输出 token、花 $0.27,单个最长约 3 分钟,Gemini 3.8 Flash 只用约 2.1 万个、花 $0.11,每个不到 25 秒,见 aimlapi 在 X 上发布的测试。11 月 6 日这批题里,DeepSeek 第 1 轮的输出是 Gemini medium 的 1.47 倍。题目不同,不能直接对比,但 8 倍那种输出差距已经看不到了,所以 1017 之前得出的"DeepSeek 单价低但输出多,算下来不省",要按新快照重新算。
音频、视频、PDF 输入和超长输出:两家的硬边界
输入里有音频、视频或 PDF,只能选 Gemini 3.8 Flash。它的模型页列出的输入是文本、图片、视频、音频和 PDF,而 DeepSeek 价目页列出的多模态能力只有图片理解(Vision)。反过来,单次要输出很长的内容时 DeepSeek 更宽:最大输出 384K token,Gemini 3.8 Flash 是 65,536,而且 Gemini 的思考 token 也占这个额度,上面的 semver 题就是卡在这里。两边的上下文都在 100 万 token 左右。规格见 DeepSeek 模型与价格页 和 Gemini 3.8 Flash 模型页。
其余功能两边各有侧重。DeepSeek 除了 OpenAI 兼容格式,还直接支持 Anthropic API 格式和 Responses API,有 JSON 输出和工具调用,并发上限 2,500;代码补全用的 FIM 只能在关掉思考时用。Gemini 3.8 Flash 有 Batch、上下文缓存、代码执行、函数调用、文件搜索和计算机使用,还能"使用 Google 搜索建立依据",每月 5,000 次免费(共用额度),之后每 1,000 次 $14。DeepSeek 的联网搜索单独计费,见 DeepSeek 联网搜索 API 价格:5 元/千次,Claude Code 搜一次多少钱。
思考档位怎么设:DeepSeek 默认 high,Gemini 默认 medium
两家 API 默认都开着思考,不改参数时比的就是 DeepSeek high 对 Gemini medium,上面的实测和 AA 都显示这一组质量最接近,多数负载不必改。DeepSeek V4.1 Flash 的 reasoning_effort 只认 low、high、max 三档,其他写法会被映射:minimal 当 low,medium 和 xhigh 当 high,ultra 当 max,所以从别家代码里带过来的 medium 实际跑的是 high。关掉思考写 {"thinking": {"type": "disabled"}};思考模式下 temperature、presence_penalty、frequency_penalty 不报错,但也不生效。Gemini 3.8 Flash 的档位是 low、medium、high,没有 minimal。见 DeepSeek 思考模式文档 和 Gemini API 思考文档。
把 Gemini 从 medium 提到 high,在第 1 轮 8 道题上没有多做对一道,两档都是 11/11,输出 token 却变成 2.6 倍,花费 2.45 倍,单次耗时中位数也更长;在 32,000 上限下它还更容易把预算想光。要开 high,就同时把 maxOutputTokens 提到文档上限。DeepSeek 的 max、low 和 Gemini 的 low 这次没有测,只能参考 AA:DeepSeek max 比 high 多 4 分,每题成本从 $0.46 涨到 $0.60;关掉思考的 DeepSeek 掉到 19 分,省下的钱不多,每题 $0.43。
下面是这次测试实际发送的请求体,DeepSeek 用 OpenAI 兼容格式,Gemini 用原生格式(maxOutputTokens 取放宽后的值):
{
  "model": "deepseek-flash",
  "messages": [{"role": "user", "content": "..."}],
  "thinking": {"type": "enabled"},
  "reasoning_effort": "high",
  "max_tokens": 32000,
  "stream": true,
  "stream_options": {"include_usage": true}
}{
"contents": [{"role": "user", "parts": [{"text": "..."}]}],
"generationConfig": {
"maxOutputTokens": 65536,
"thinkingConfig": {"thinkingLevel": "medium", "includeThoughts": true}
}
}includeThoughts 不改变计费,但能让 Gemini 在长时间思考时也有数据流出。经过有空闲超时的代理或网关时这一点有用:这次就有一次没开思考摘要的调用,在 300 秒没有输出后被断开。Google 新的 Interactions API 里,对应的参数叫 thinking_level 和 thinking_summaries。
在 Gemini 和 DeepSeek 之间切换前要改的地方
换模型时,除了模型名,最容易漏的是思考参数、输出上限和用量字段。漏了往往不报错,只会悄悄多花钱或拿到截断的答案,所以切换前逐项核对:
- 把模型名改成
deepseek-flash或gemini-3.8-flash,接口格式跟着换:DeepSeek 用 OpenAI 兼容或 Anthropic 格式,Gemini 用原生的generateContent。旧名deepseek-v4-flash和deepseek-v4-flash-vision-exp仍可调用,同样由 1017 快照提供、按 Flash 价计费。 - 把
thinkingConfig.thinkingLevel和reasoning_effort互相换算时,记住 DeepSeek 没有 medium,传medium会按 high 跑。DeepSeek 带tools的多轮对话,要把之前各轮的reasoning_content一起传回去。 - 重设输出上限:Gemini 的
maxOutputTokens包含思考,难题要给足;同时检查finishReason(Gemini)或finish_reason(DeepSeek),截断的回答不能当成功处理。 - 改写计费统计:DeepSeek 的
completion_tokens已经包含思考 token;Gemini 的思考在thoughtsTokenCount,回答在candidatesTokenCount,两者都按输出计费。这次有一个触顶的 Gemini 流把candidatesTokenCount报成和thoughtsTokenCount一样的数,用totalTokenCount − promptTokenCount算输出更稳。 - 删掉对 DeepSeek 无效的采样参数,思考模式下调
temperature不会有任何效果。 - 经第三方线路调用时,逐个检查响应里返回的模型名(DeepSeek 的
model、Gemini 的modelVersion),不对就丢弃重试。 - 重排时间和预算:DeepSeek 的批量任务挪到闲时,Gemini 的预算按明年 1 月起翻倍提前留出。
还在比其他模型:GLM-5.3-Flash、Sonnet 5.5、Gemini 4 Argon
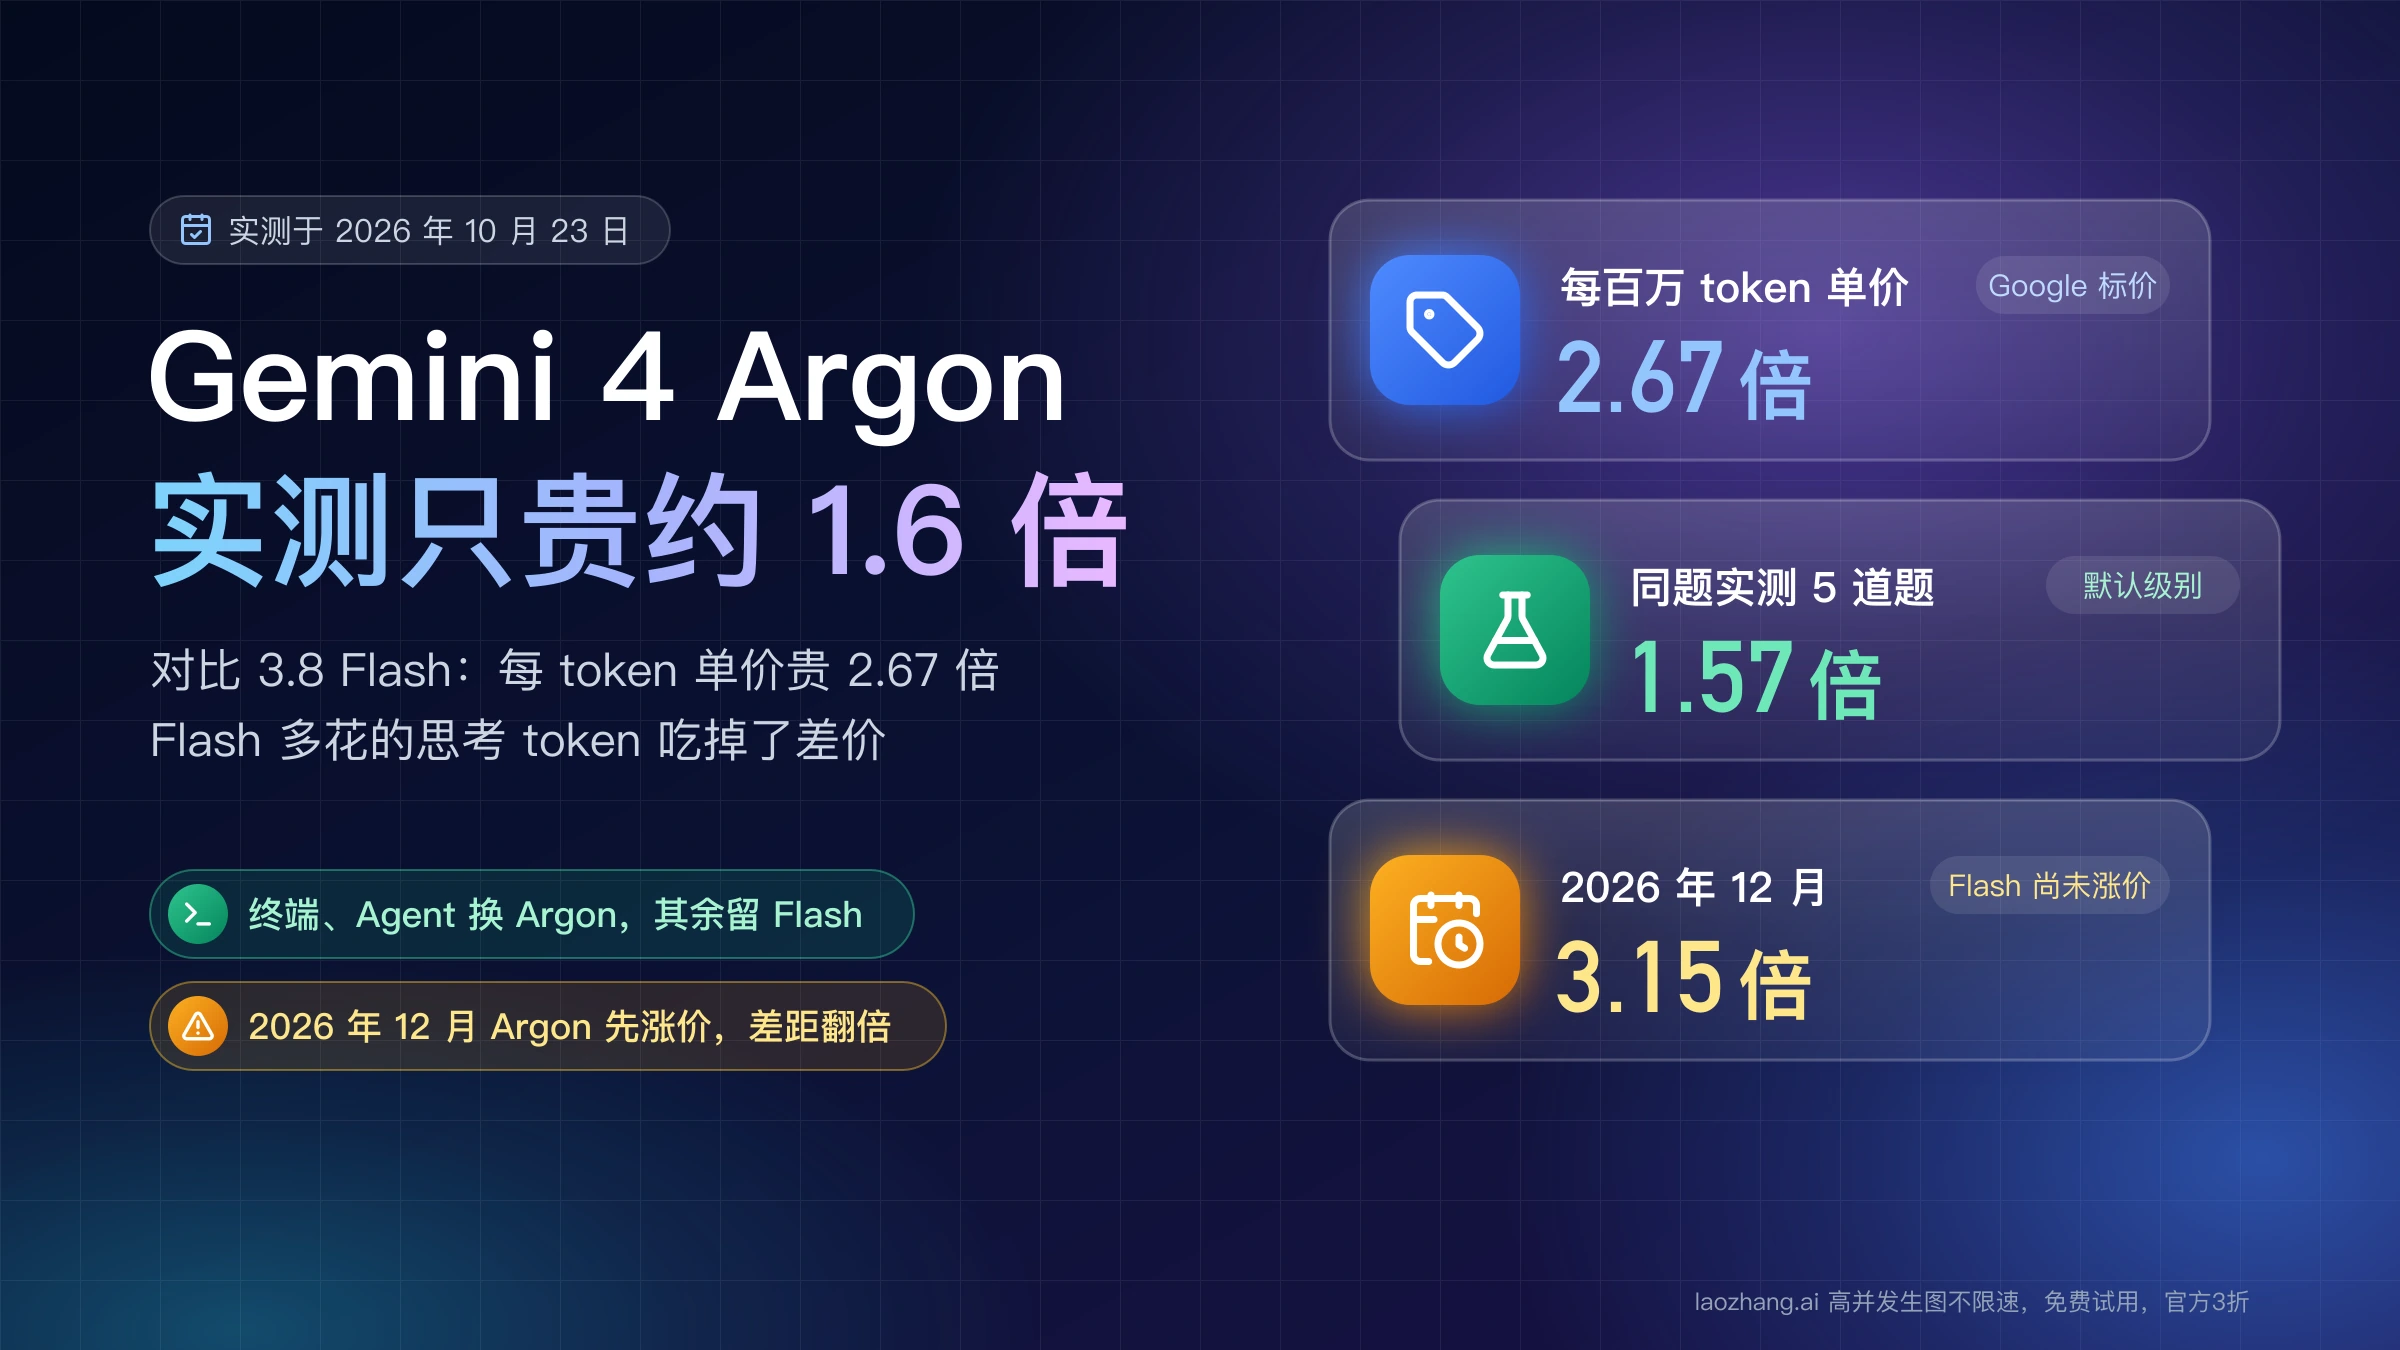
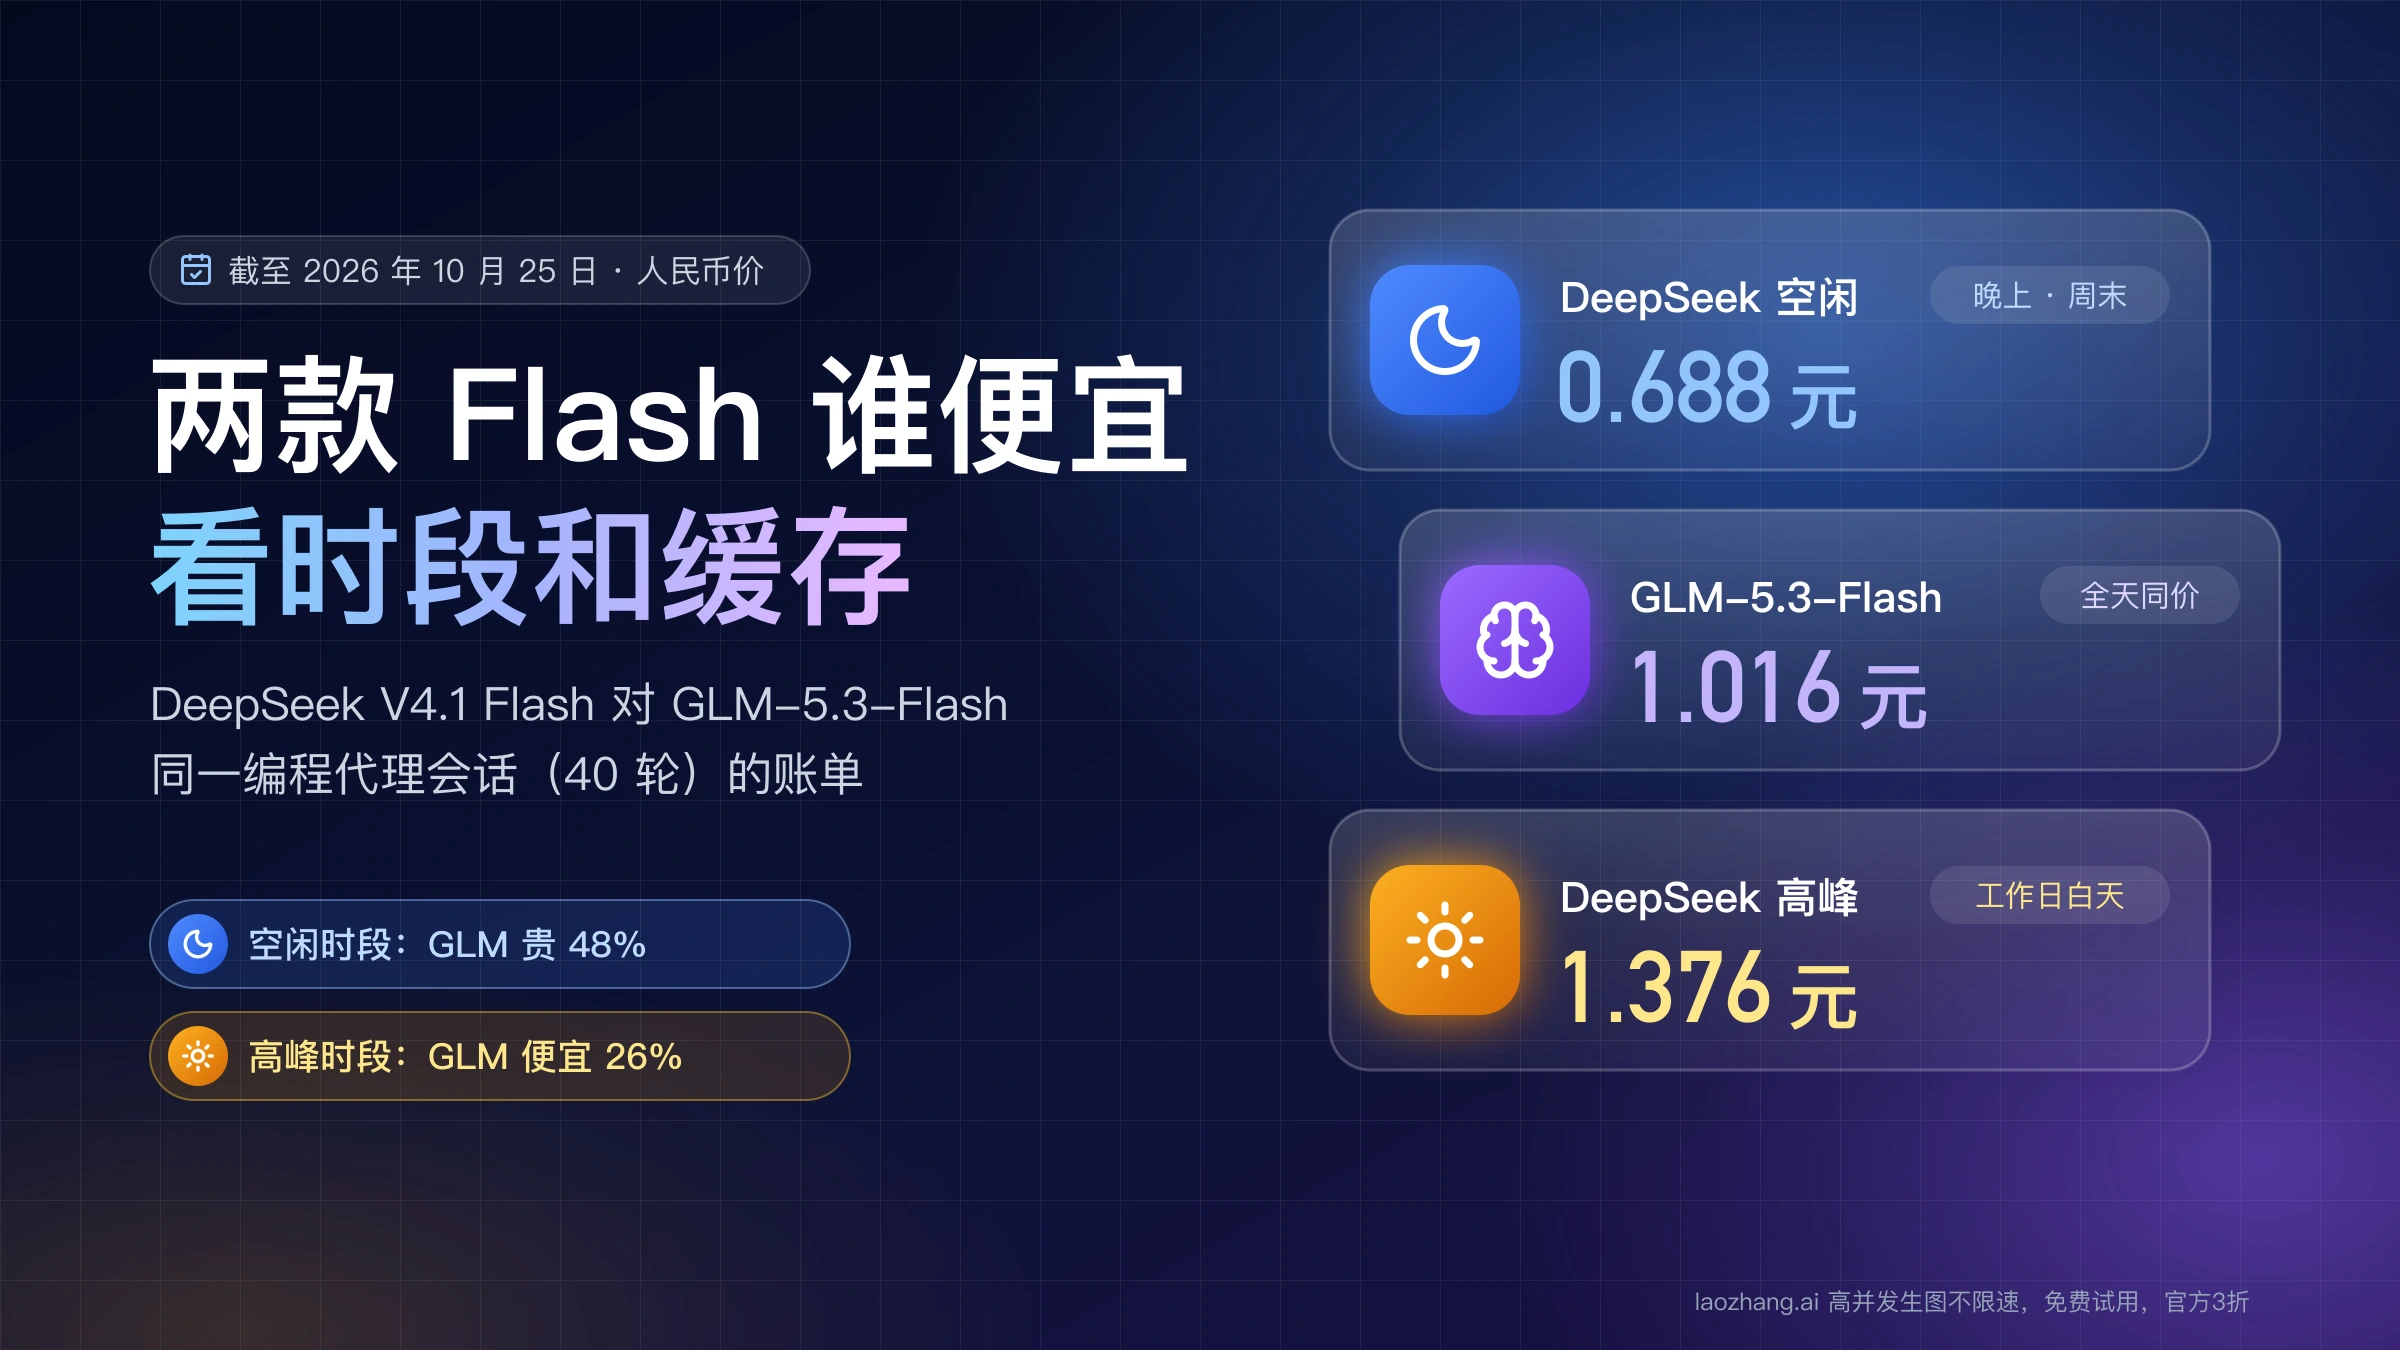
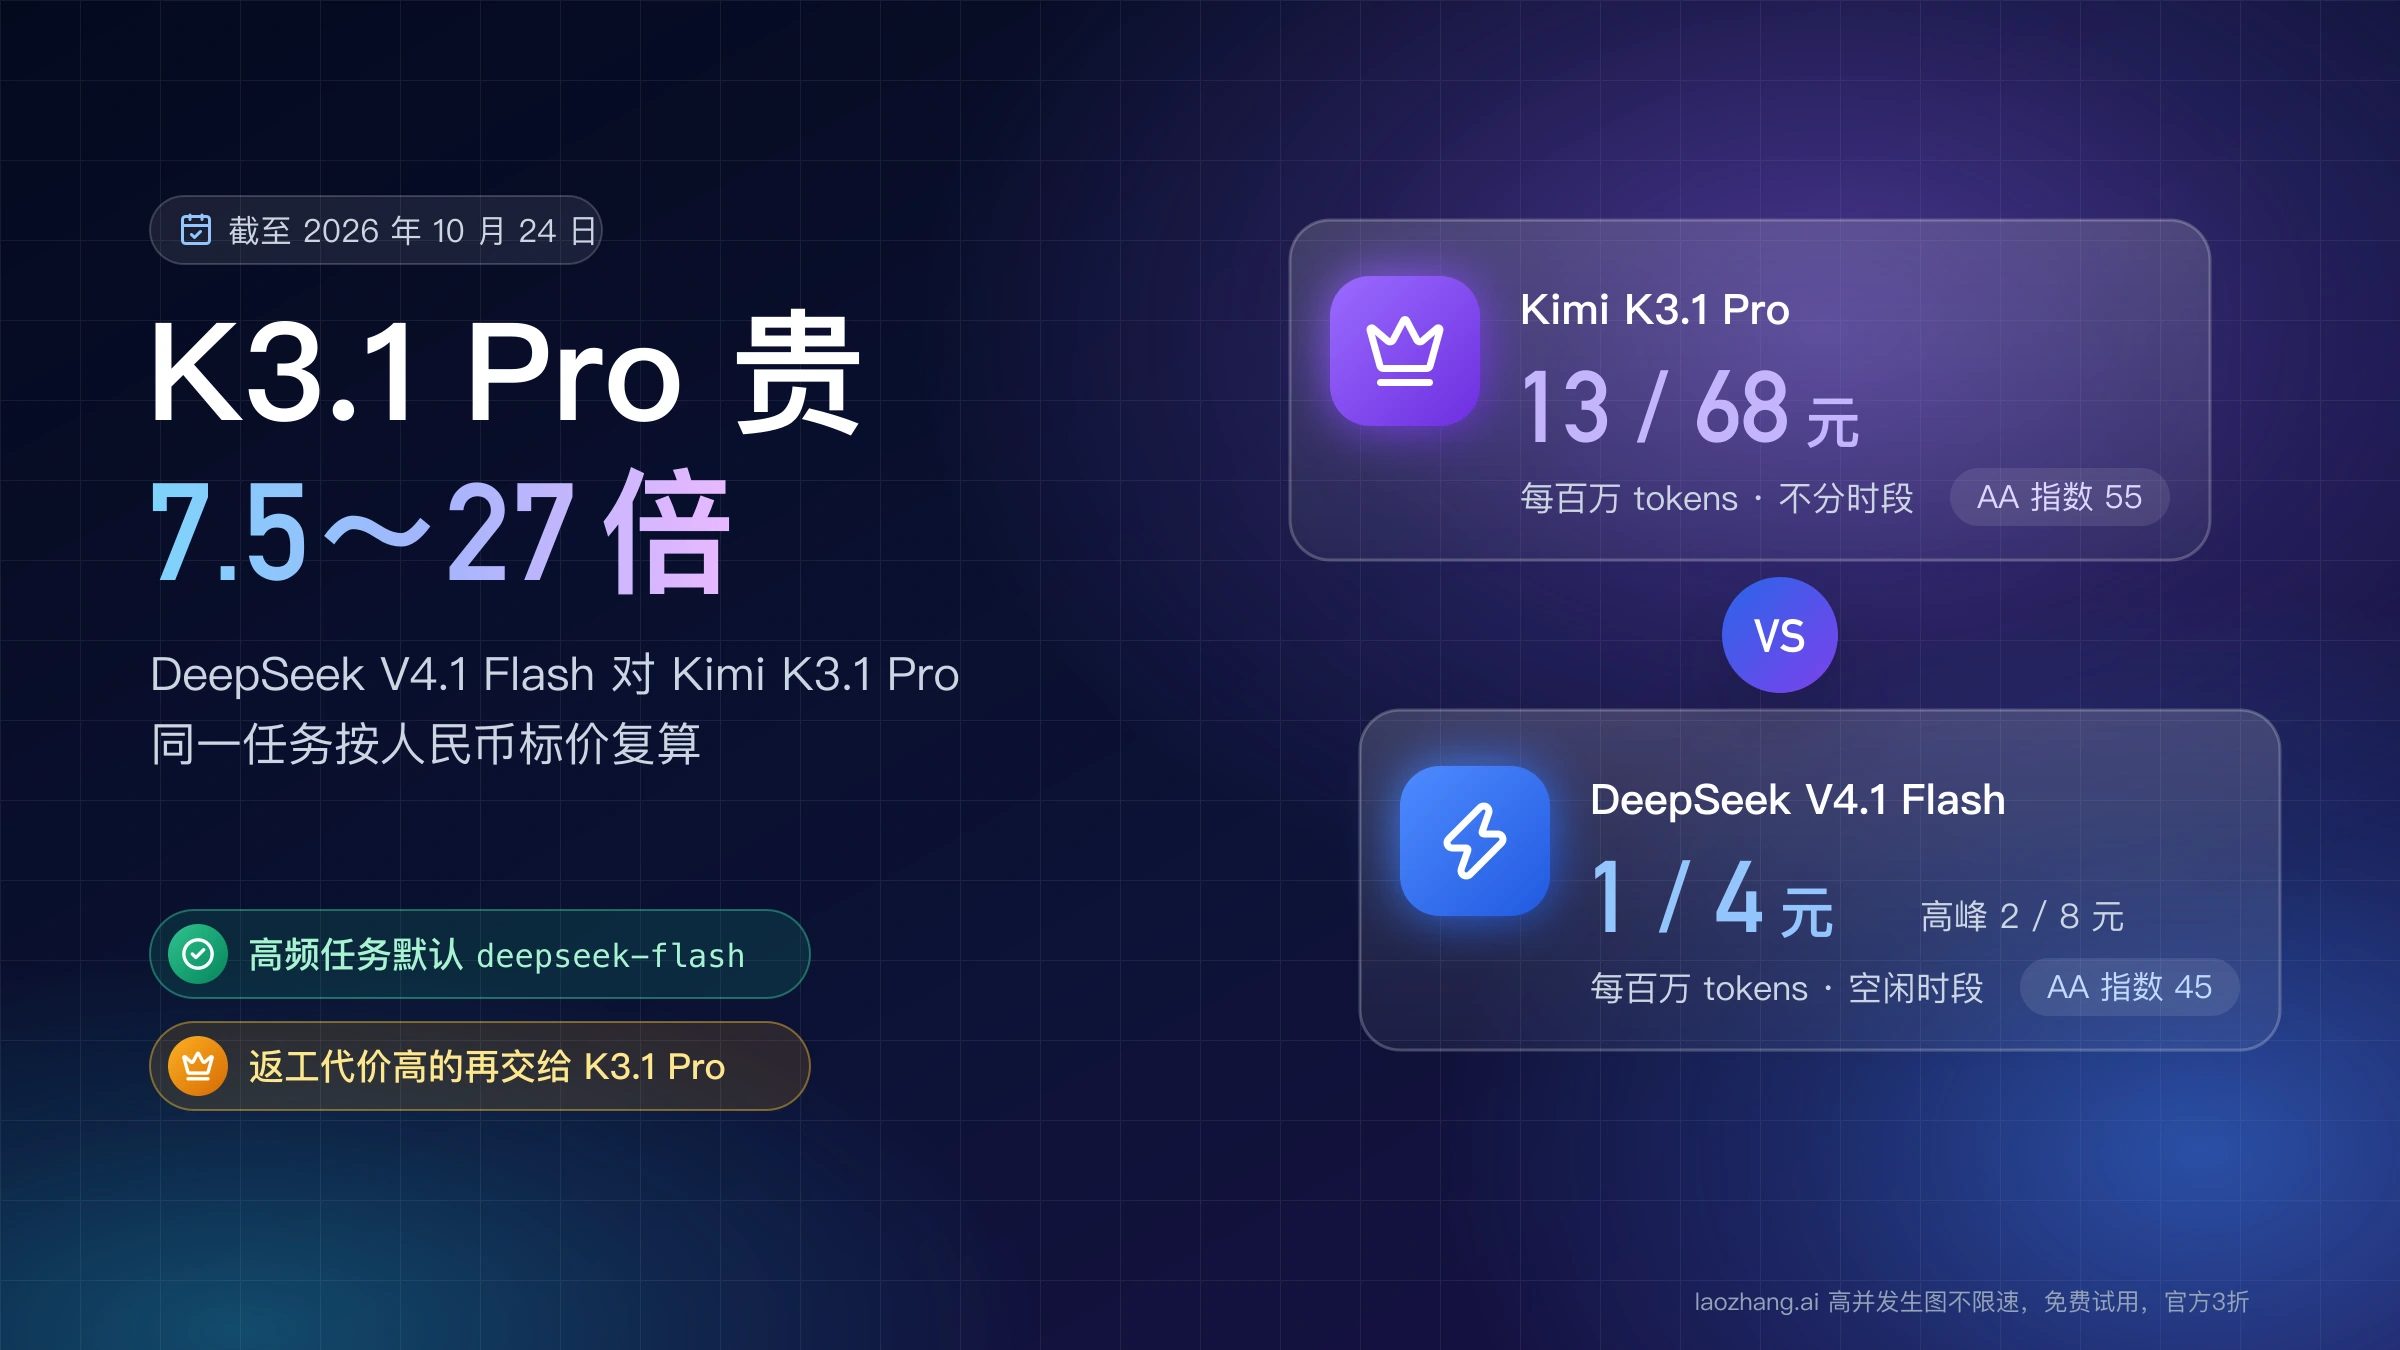
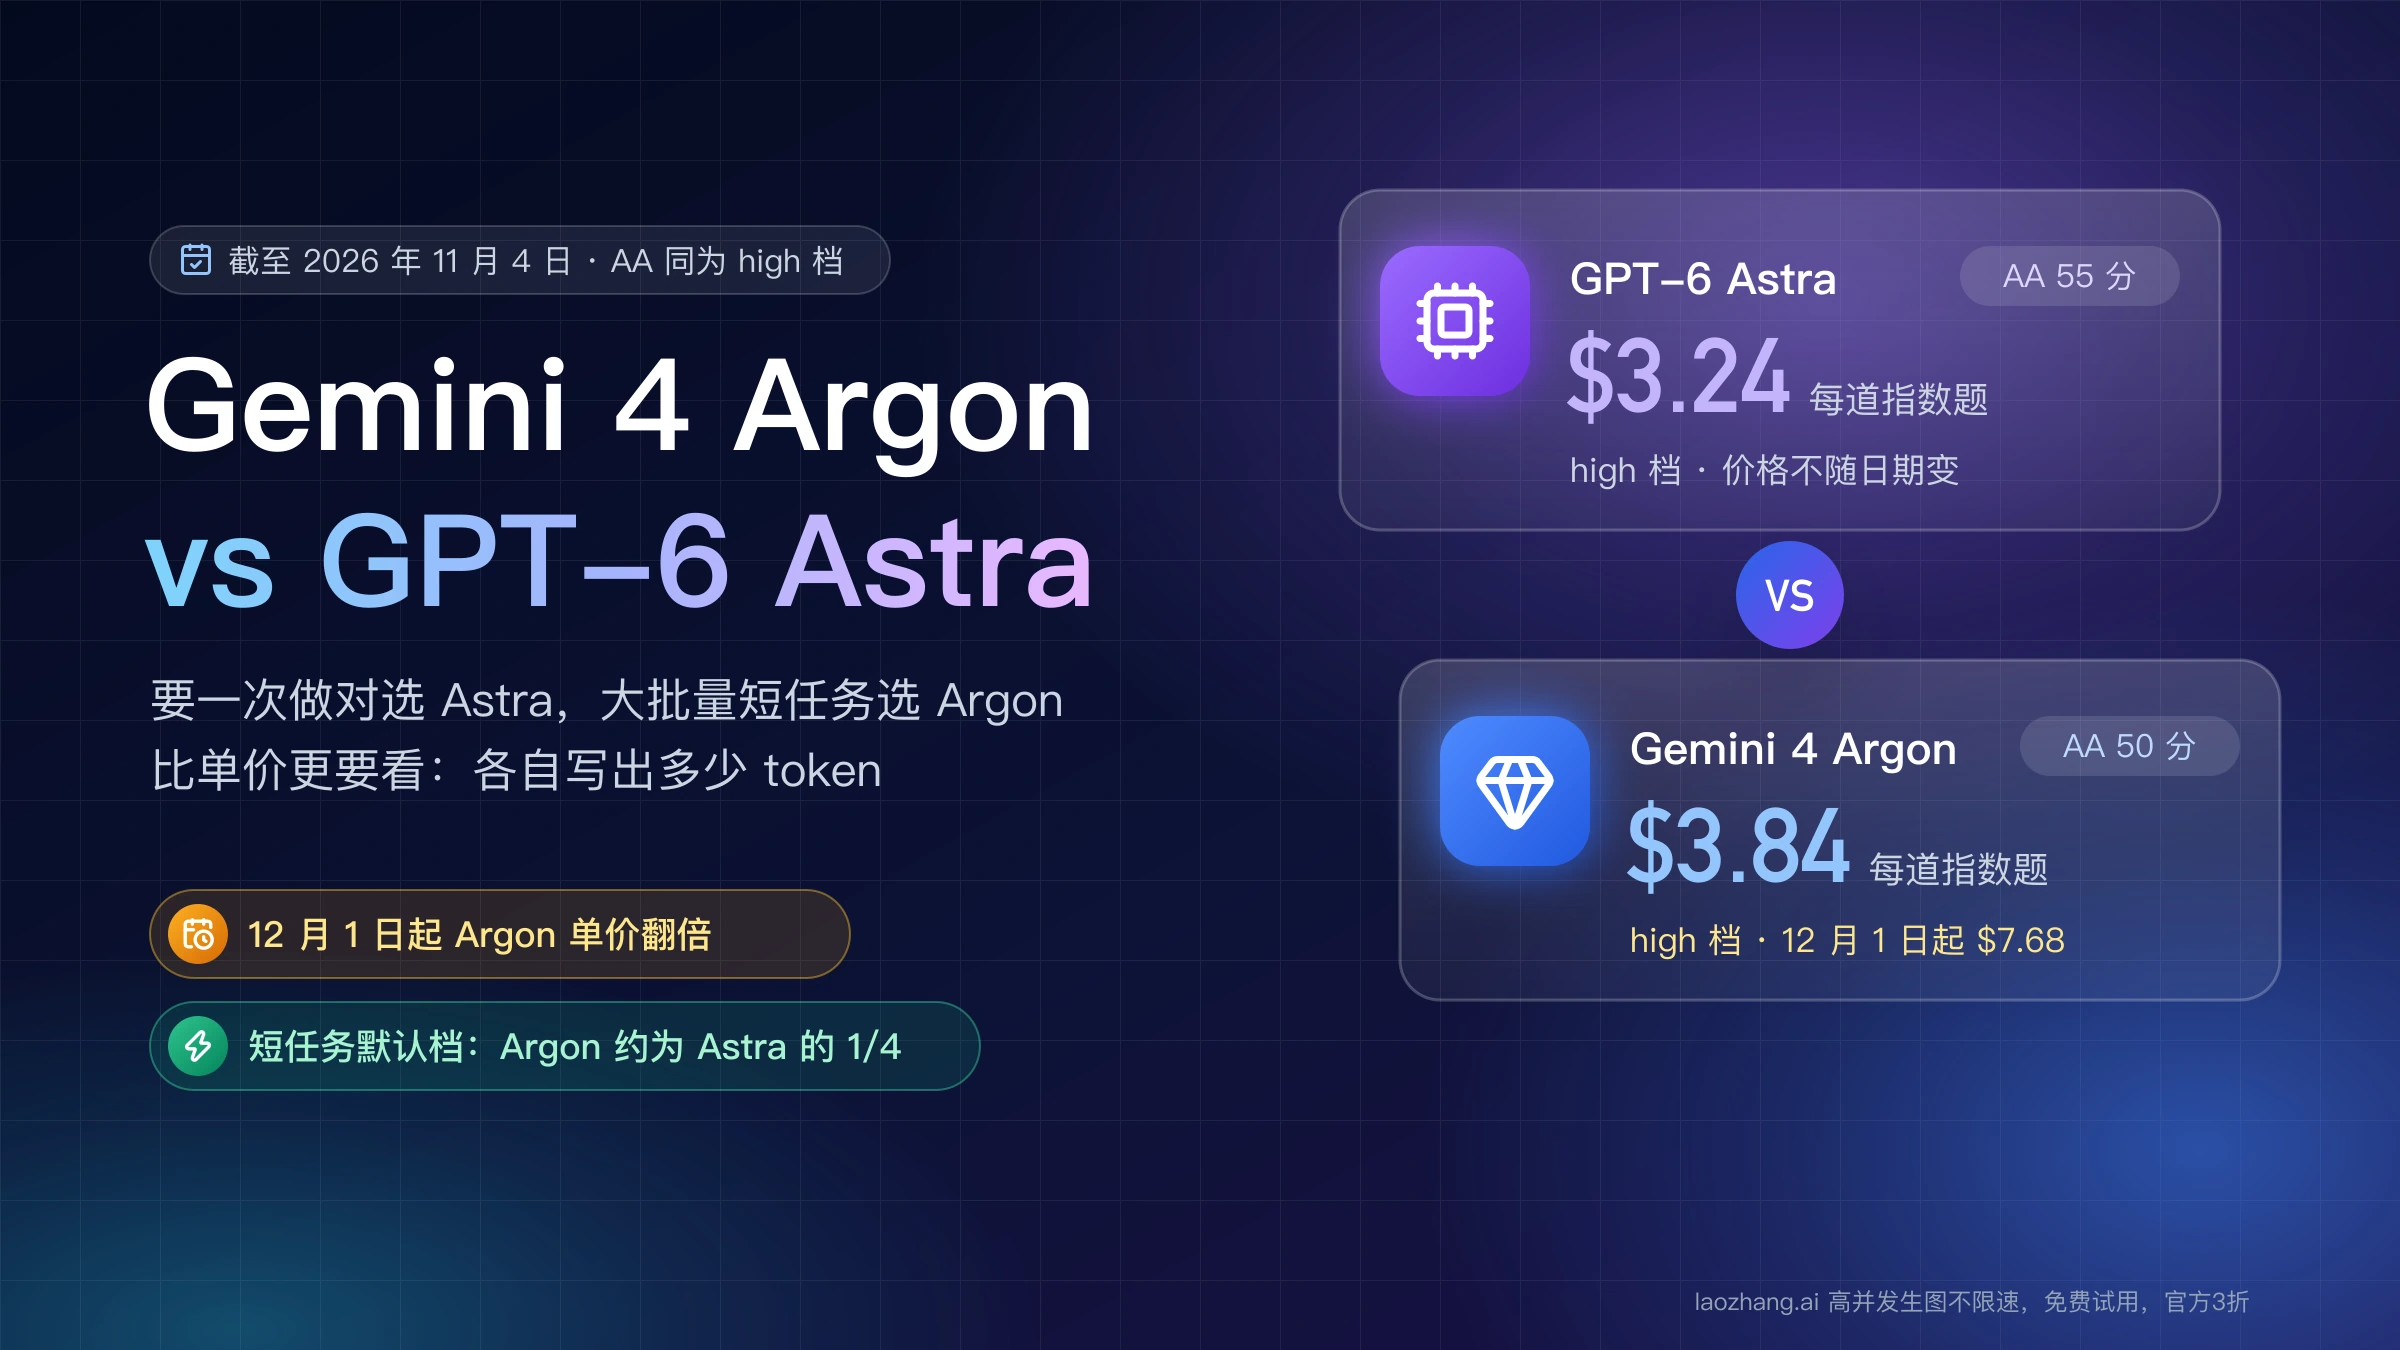
如果候选里还有别的模型,这几组另有专门的对比:DeepSeek 对另一款便宜的 Flash 模型,看 DeepSeek V4.1 Flash 和 GLM-5.3-Flash 对比:谁便宜看时段和缓存;Gemini 3.8 Flash 对更贵的 Claude,看 Claude Sonnet 5.5 vs Gemini 3.8 Flash 对比:单价低 63% 未必更省;考虑从 3.8 Flash 升级,看 Gemini 4 Argon 和 3.8 Flash 区别:实测成本差多少,哪些任务该换;DeepSeek Flash 对 Pro 级模型,看 DeepSeek V4.1 和 Kimi K3.1 哪个好:Flash 对 Pro,贵 7.5~27 倍。更大范围的价格排序见 AI API 价格对比:国内外大模型谁最便宜、月费怎么算。
参考来源10
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月6日。
参考来源10
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月6日。
- 1.Gemini API 可用地区列表aistudio.google.com/docs/available-regions
- 2.DeepSeek 中文模型与价格页api-docs.deepseek.com/zh-cn/quick_start/pricing
- 3.Gemini API 价格页aistudio.google.com/docs/pricing
- 4.Artificial Analysis 的 DeepSeek V4.1 Flash 1017 与 Gemini 3.8 Flash 对比页artificialanalysis.ai/models/releases/comparisons/deepseek-v4-1-flash-1017-vs-gemini-3-8-flash
- 5.DeepSeek API 更新日志api-docs.deepseek.com/updates
- 6.aimlapi 在 X 上发布的测试x.com/aimlapi/status/2098056487465578894
- 7.DeepSeek 模型与价格页api-docs.deepseek.com/quick_start/pricing
- 8.Gemini 3.8 Flash 模型页aistudio.google.com/docs/models/gemini-3.8-flash
- 9.DeepSeek 思考模式文档api-docs.deepseek.com/guides/thinking_mode
- 10.Gemini API 思考文档aistudio.google.com/docs/thinking