Gemini 4 Argon、Fable 5.2、GPT-6 Astra 对比:单价最低不等于最省
同题实测 Gemini 4 Argon 默认档最省;它开 High 在 AA 只有 50 分,难题先用 Fable 5.2 medium,12 月起 Argon high 最贵。
文章目录
截至 2026 年 11 月 11 日,要在 Gemini 4 Argon、Claude Fable 5.2 和 GPT-6 Astra 之间定一个默认模型,要求写得清楚、结果能自动校验的日常任务先用 gemini-4-argon,不设思考档,让它走 API 默认的 medium;需要更强推理和编码质量的难题换 claude-fable-5-2 的 medium 档,预算紧先试 low;已经在 OpenAI 上开发的团队,gpt-6-astra 的 high 档分数和成本都与之接近。不要指望把 Argon 调到 high 去做难题:截至同日的 Artificial Analysis 智能指数 v5.0.1 只给 Argon 的 High 档打了分,Gemini 4 Argon (High) 50 分,Fable 5.2 medium 56 分,每任务成本还更低,即使按 Argon 11 月 30 日前的半价折算也是如此。
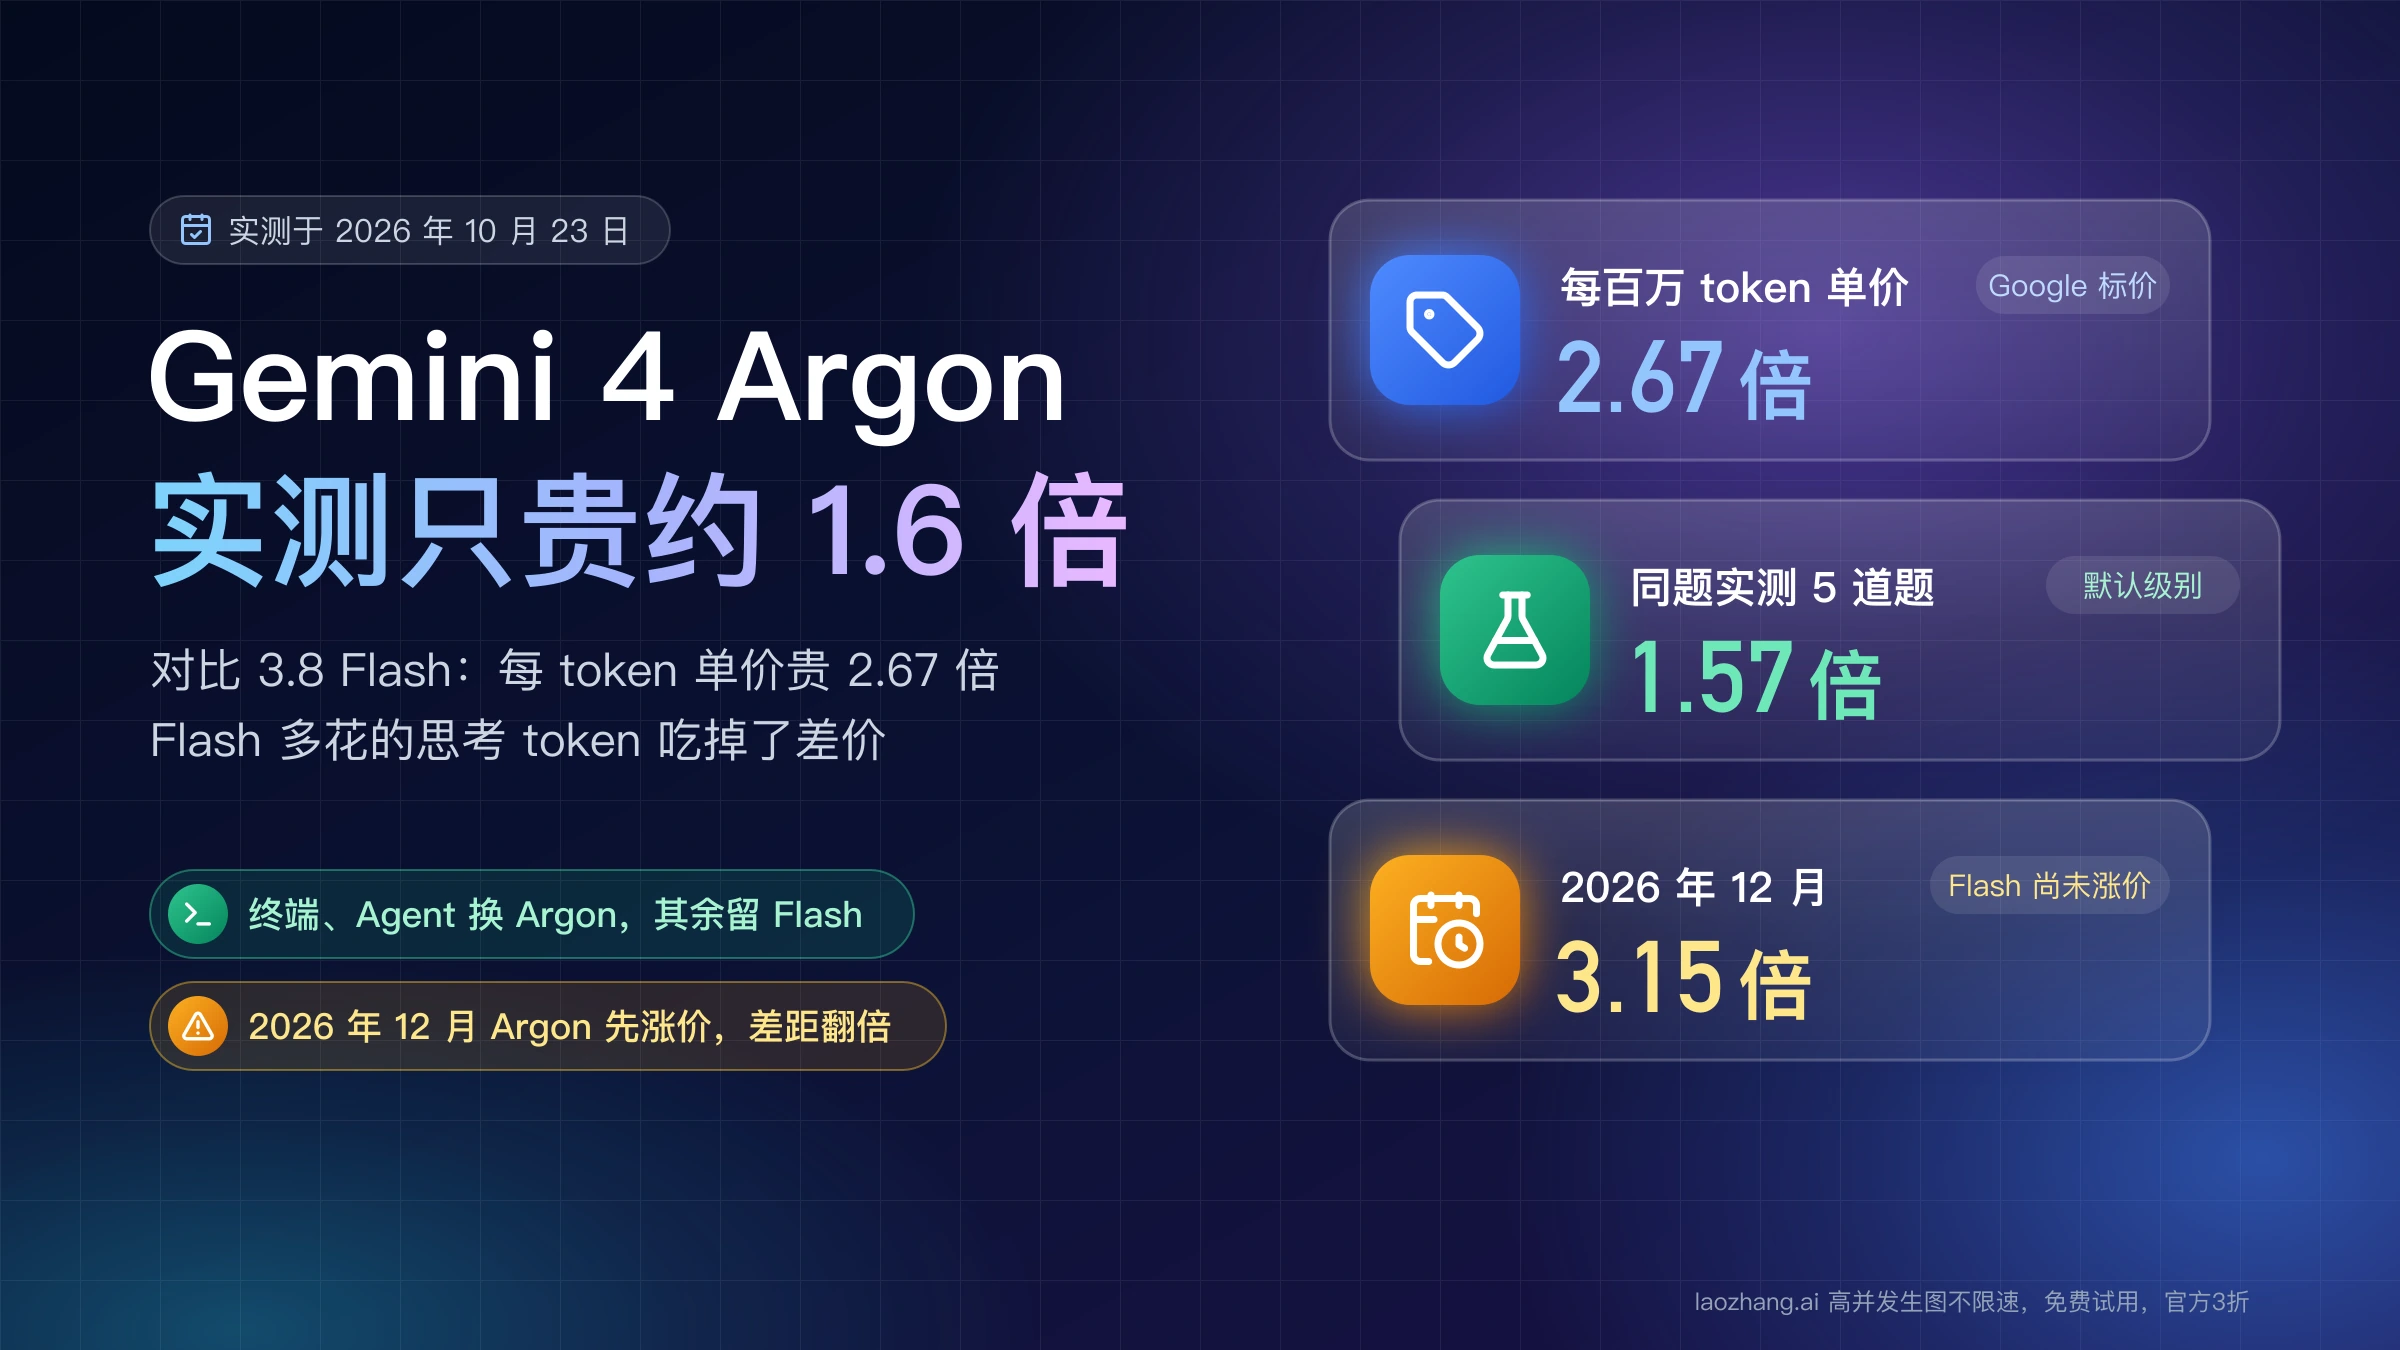
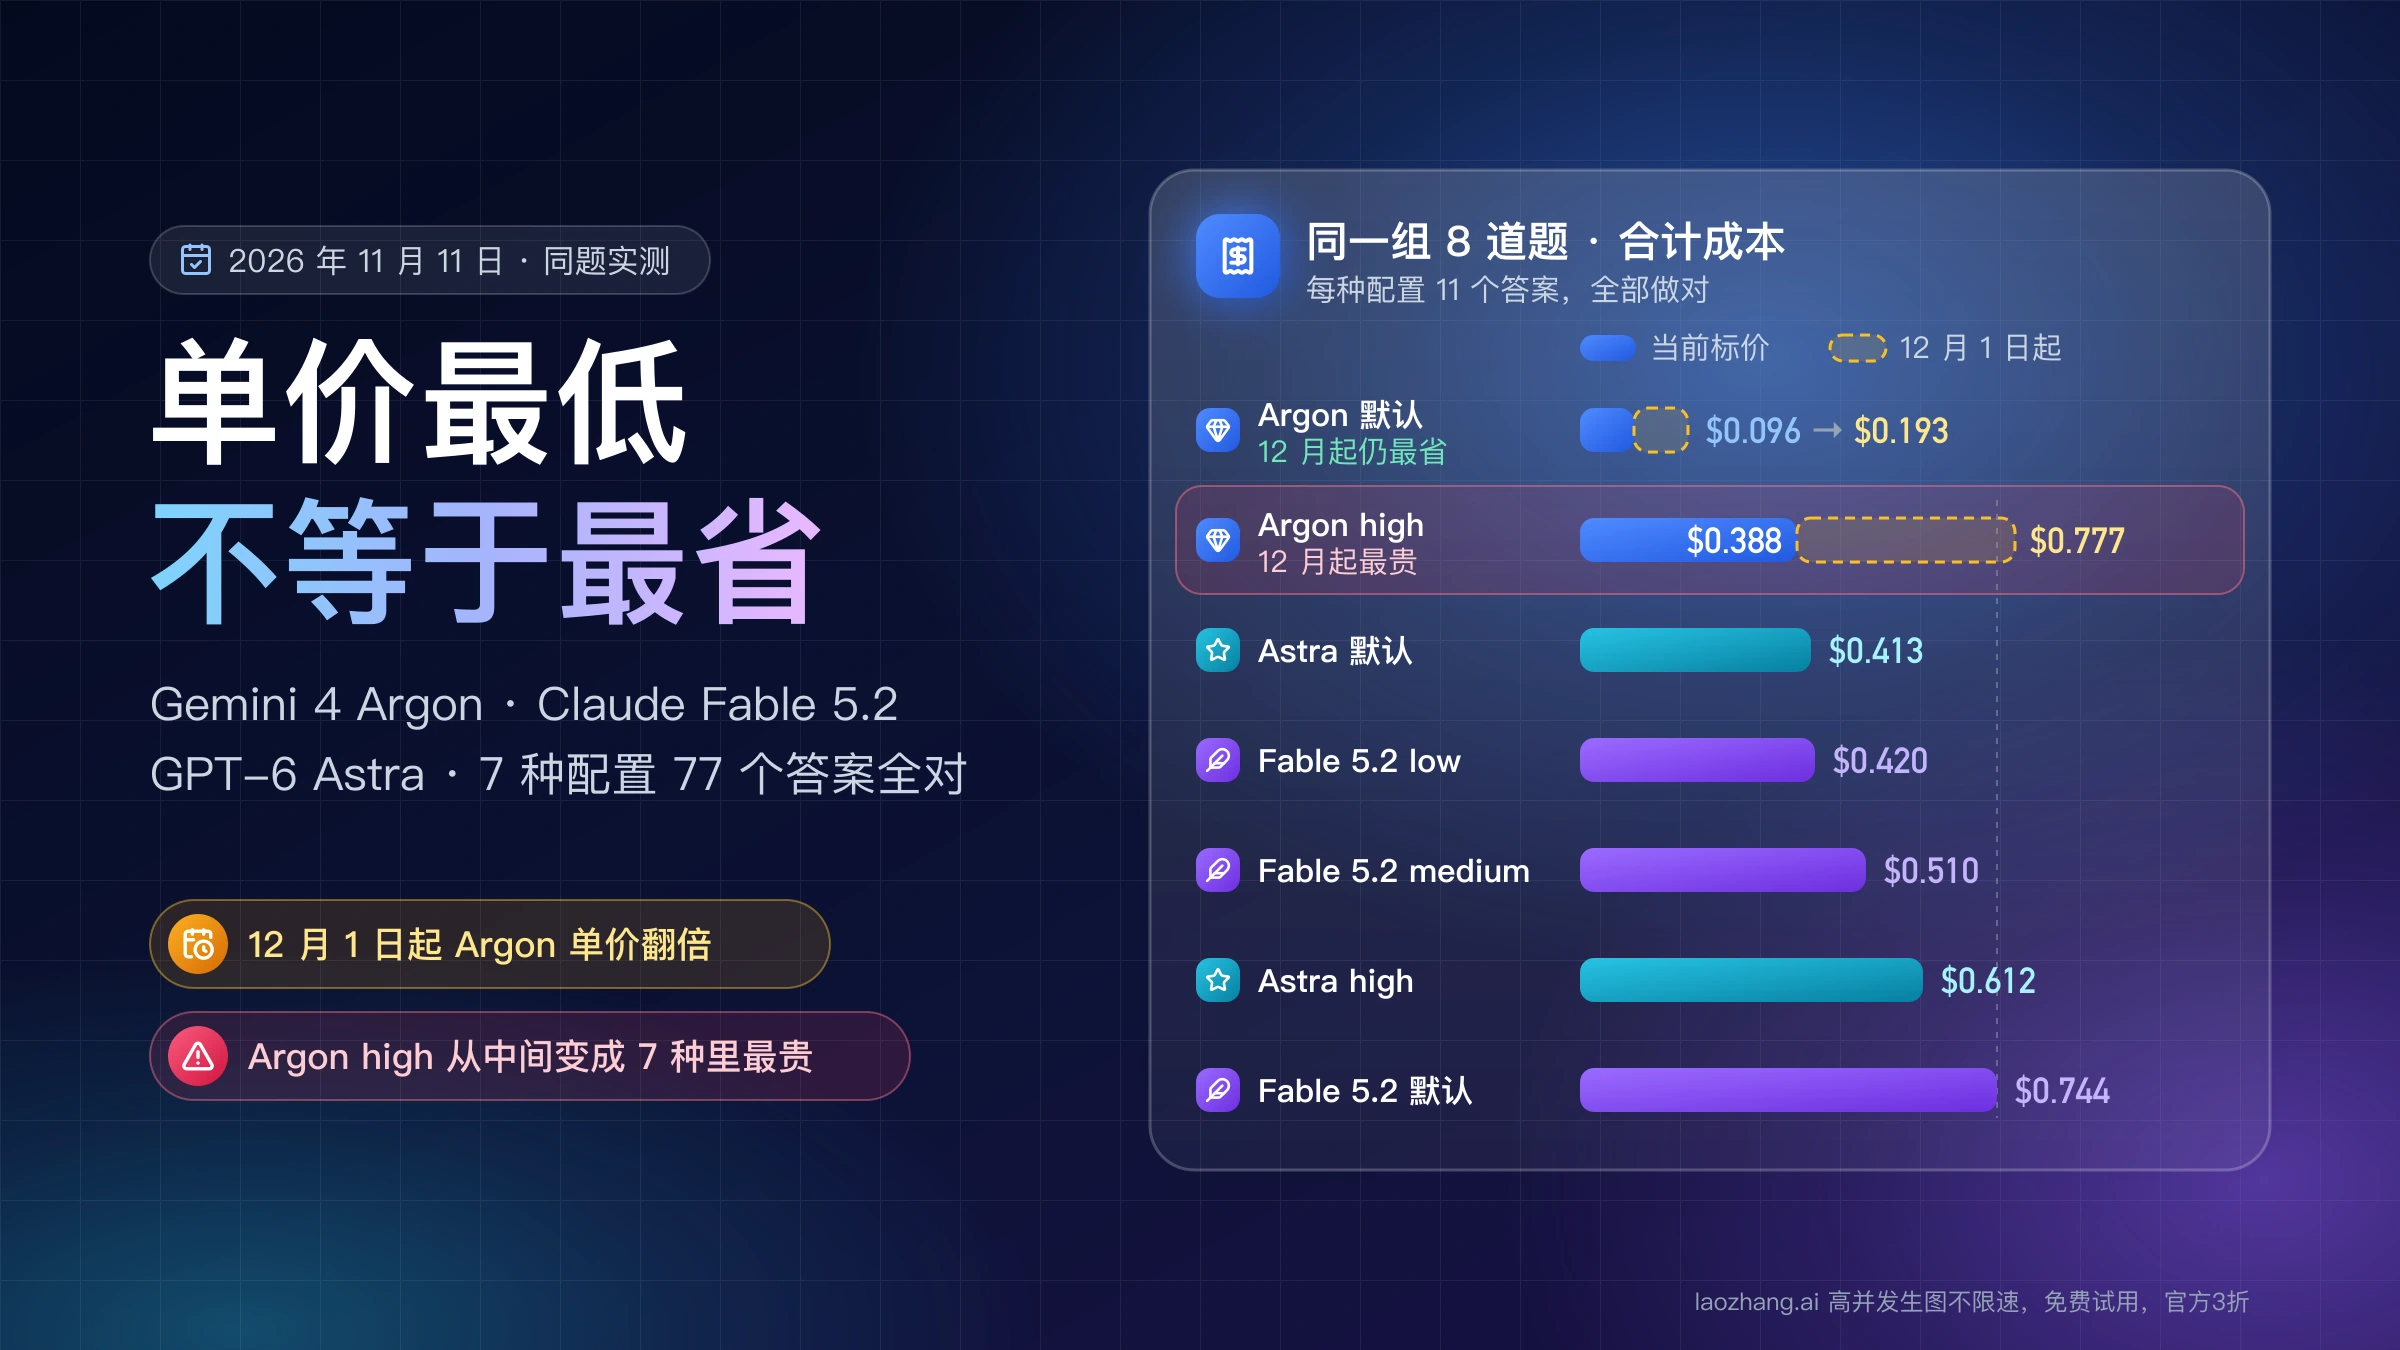
2026 年 11 月 11 日,同一组 8 道题(其中 3 道各问两遍,共 11 个评分答案)交给三款模型的 7 种配置,77 个答案全部做对,花的钱却差很多:Argon 默认档合计 $0.096,Astra 默认档 $0.41、Fable 5.2 low $0.42,都是它的 4 倍多,Fable 5.2 不设 effort(API 默认 high)$0.74,是它的 7.7 倍。Argon 开到 high 要 $0.39,今天还略低于 Astra 默认档和 Fable 5.2 low;12 月 1 日 Argon 单价从每百万 token 输入 $2、输出 $10 翻倍到 $4、$20 之后,默认档仍是 7 种配置里最省的,high 档则变成最贵的。
有三种情况要先绕开上面的顺序。要输入视频或音频,三款里只有 Argon 支持;内容涉及高风险网络安全或多数生物研究,Fable 5.2 的安全分类器会拦截;要在很长的输入里数准数字时不要用 Argon 默认档,同一天让三款数 146 KB 日志里的错误,Argon 默认档 22 秒交卷、5 个错误计数全部偏少,Astra 默认档 26 秒全对,Argon 开 high 并用流式输出也能全对,但要 329 秒。
三款先试哪一款、思考强度开哪一档
三家都让你控制模型在回答前"想多少",叫法和档数却不同:Argon 叫 thinking level,只有 low、medium、high 三档,API 默认 medium;Fable 5.2 叫 effort,从 low 到 max 五档,API 默认 high,Claude Code 和 Claude 应用默认 medium,思考不能关闭;Astra 叫 reasoning effort,也是 low 到 max 五档,OpenAI 文档没有写明 API 默认是哪一档。下文统一称"思考强度(effort)"。名字相同的档位不代表工作量相同,所以选档要按"做出同样结果花多少"来比,不按档名对齐。
按这个口径,分工可以这样定。较难的推理、编码和分析先用 Fable 5.2 medium,在 AA 指数上它比 Astra 的 high、xhigh 高 1 分,花费相近;要求接近现有最高水平时只能往上开 Fable 5.2 的 high,因为 57 分以上只有 Fable 有档位,再往上的 xhigh、max 每任务成本成倍上升。要求明确、量大、能自动判对错的任务交给 Argon 默认档:它的单价只有 Fable 5.2 的四分之一、Astra 的五分之一,同题测试里做对同样 11 个答案的花费约为 Fable 5.2 low 和 Astra 默认档的 23%,12 月 1 日涨价后也不到一半;一旦它在这类任务上出错,先换 Fable 5.2 low 或 Astra 默认档,而不是把 Argon 调到 high。在长日志、长表格里做精确计数和比对,用 Astra 默认档或 Fable 5.2 medium。输入里有视频或音频时只能用 Argon。
如果你本来就在 Claude 的模型里挑,还有一个比 Fable 5.2 便宜的选项,档位怎么对应、同题差多少见 Fable 5.2 和 Opus 5.5 怎么选:哪档对哪档,同题实测贵 1.86 倍。
同题实测:77 个答案全对,花费最多相差 7.7 倍
2026 年 11 月 11 日,同一组 8 道题经 laozhang.ai 的同一个 API key 发给三款模型,每家用自己的原生请求格式:Argon 用 Gemini 的 generateContent(非流式),Fable 5.2 用 Anthropic Messages(流式),Astra 用 Chat Completions(流式);没有系统提示,不带工具。题目包括一道应用题、三个用隐藏测试评分的小 Python 函数、把一篇 6,723 词的英文文章总结成 5 条要点、一个表达式求值器(25 个隐藏测试)、一个 CSV 行解析器(16 个隐藏测试)和一道不写代码的计数题,后三道各问两遍,所以每个配置交 11 个答案。只计入返回的模型名与请求一致的响应,不一致的重新请求。7 种配置的 77 个答案全部通过。成本按每次返回的 token 用量乘以当天官方标价计算,不是账单。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
| 配置 | 输入 token | 输出 token(其中思考) | 当前标价成本 | 按 12 月 1 日起价格 | 用时 | 相对 Argon 默认档(当前 / 12 月起) |
|---|---|---|---|---|---|---|
Argon 不设思考档(默认 medium) | 12,712 | 7,085(1,806) | $0.096 | $0.193 | 148 秒 | 1.0 / 1.0 倍 |
Argon high | 12,712 | 36,291(30,842) | $0.388 | $0.777 | 463 秒 | 4.0 / 4.0 倍 |
| Astra 不设档(默认) | 11,407 | 5,471(1,964) | $0.413 | $0.413 | 92 秒 | 4.3 / 2.1 倍 |
Fable 5.2 low | 17,202 | 7,063(未单列) | $0.420 | $0.420 | 97 秒 | 4.4 / 2.2 倍 |
Fable 5.2 medium | 17,202 | 9,317(未单列) | $0.510 | $0.510 | 122 秒 | 5.3 / 2.7 倍 |
Astra high | 11,407 | 9,455(6,042) | $0.612 | $0.612 | 142 秒 | 6.4 / 3.2 倍 |
Fable 5.2 不设 effort(默认 high) | 17,202 | 15,151(未单列) | $0.744 | $0.744 | 173 秒 | 7.7 / 3.9 倍 |
这张表说明的是"结果相同时各花多少",不是哪款更聪明:题目小、要求明确,三款都能做对,分不出能力高低,能力差距要看下一节的第三方指数。Argon 默认档的输出量和 Astra、Fable 5.2 low 差不多,便宜几乎全靠单价;开到 high 后输出变成默认档的 5.1 倍,今天的 $0.388 只比 Astra 默认档和 Fable 5.2 low 略低,12 月 1 日起的 $0.777 则高过表里所有配置,包括 Fable 5.2 默认档。Fable 5.2 和 Astra 之间,Fable 5.2 的输入 token 比 Astra 多 51%,单价低 20%,两者大致抵消,差别主要在输出:Fable 5.2 low 和 Astra 默认档只差 2%,不设 effort 时 Fable 5.2 的输出是 Astra 默认档的 2.8 倍,花费高出 80%。
几点限制要一起看。Fable 5.2 的思考 token 算在输出里,不单独列出;Astra 的成本里含它默认写入缓存的 10,104 个 token(按 $12.50 每百万计)。Argon 是非流式调用,重新请求的那些是逐个补跑的,它的用时只能作粗略参考,token 数和对错不受影响。经网关调用时,"不设档"是否等于文档里的默认档,从返回结果里无法证实;每个配置只有 1 到 2 个样本,一个网关,一天。
Artificial Analysis 指数逐档对比:Gemini 4 Argon (High) 只有 50 分
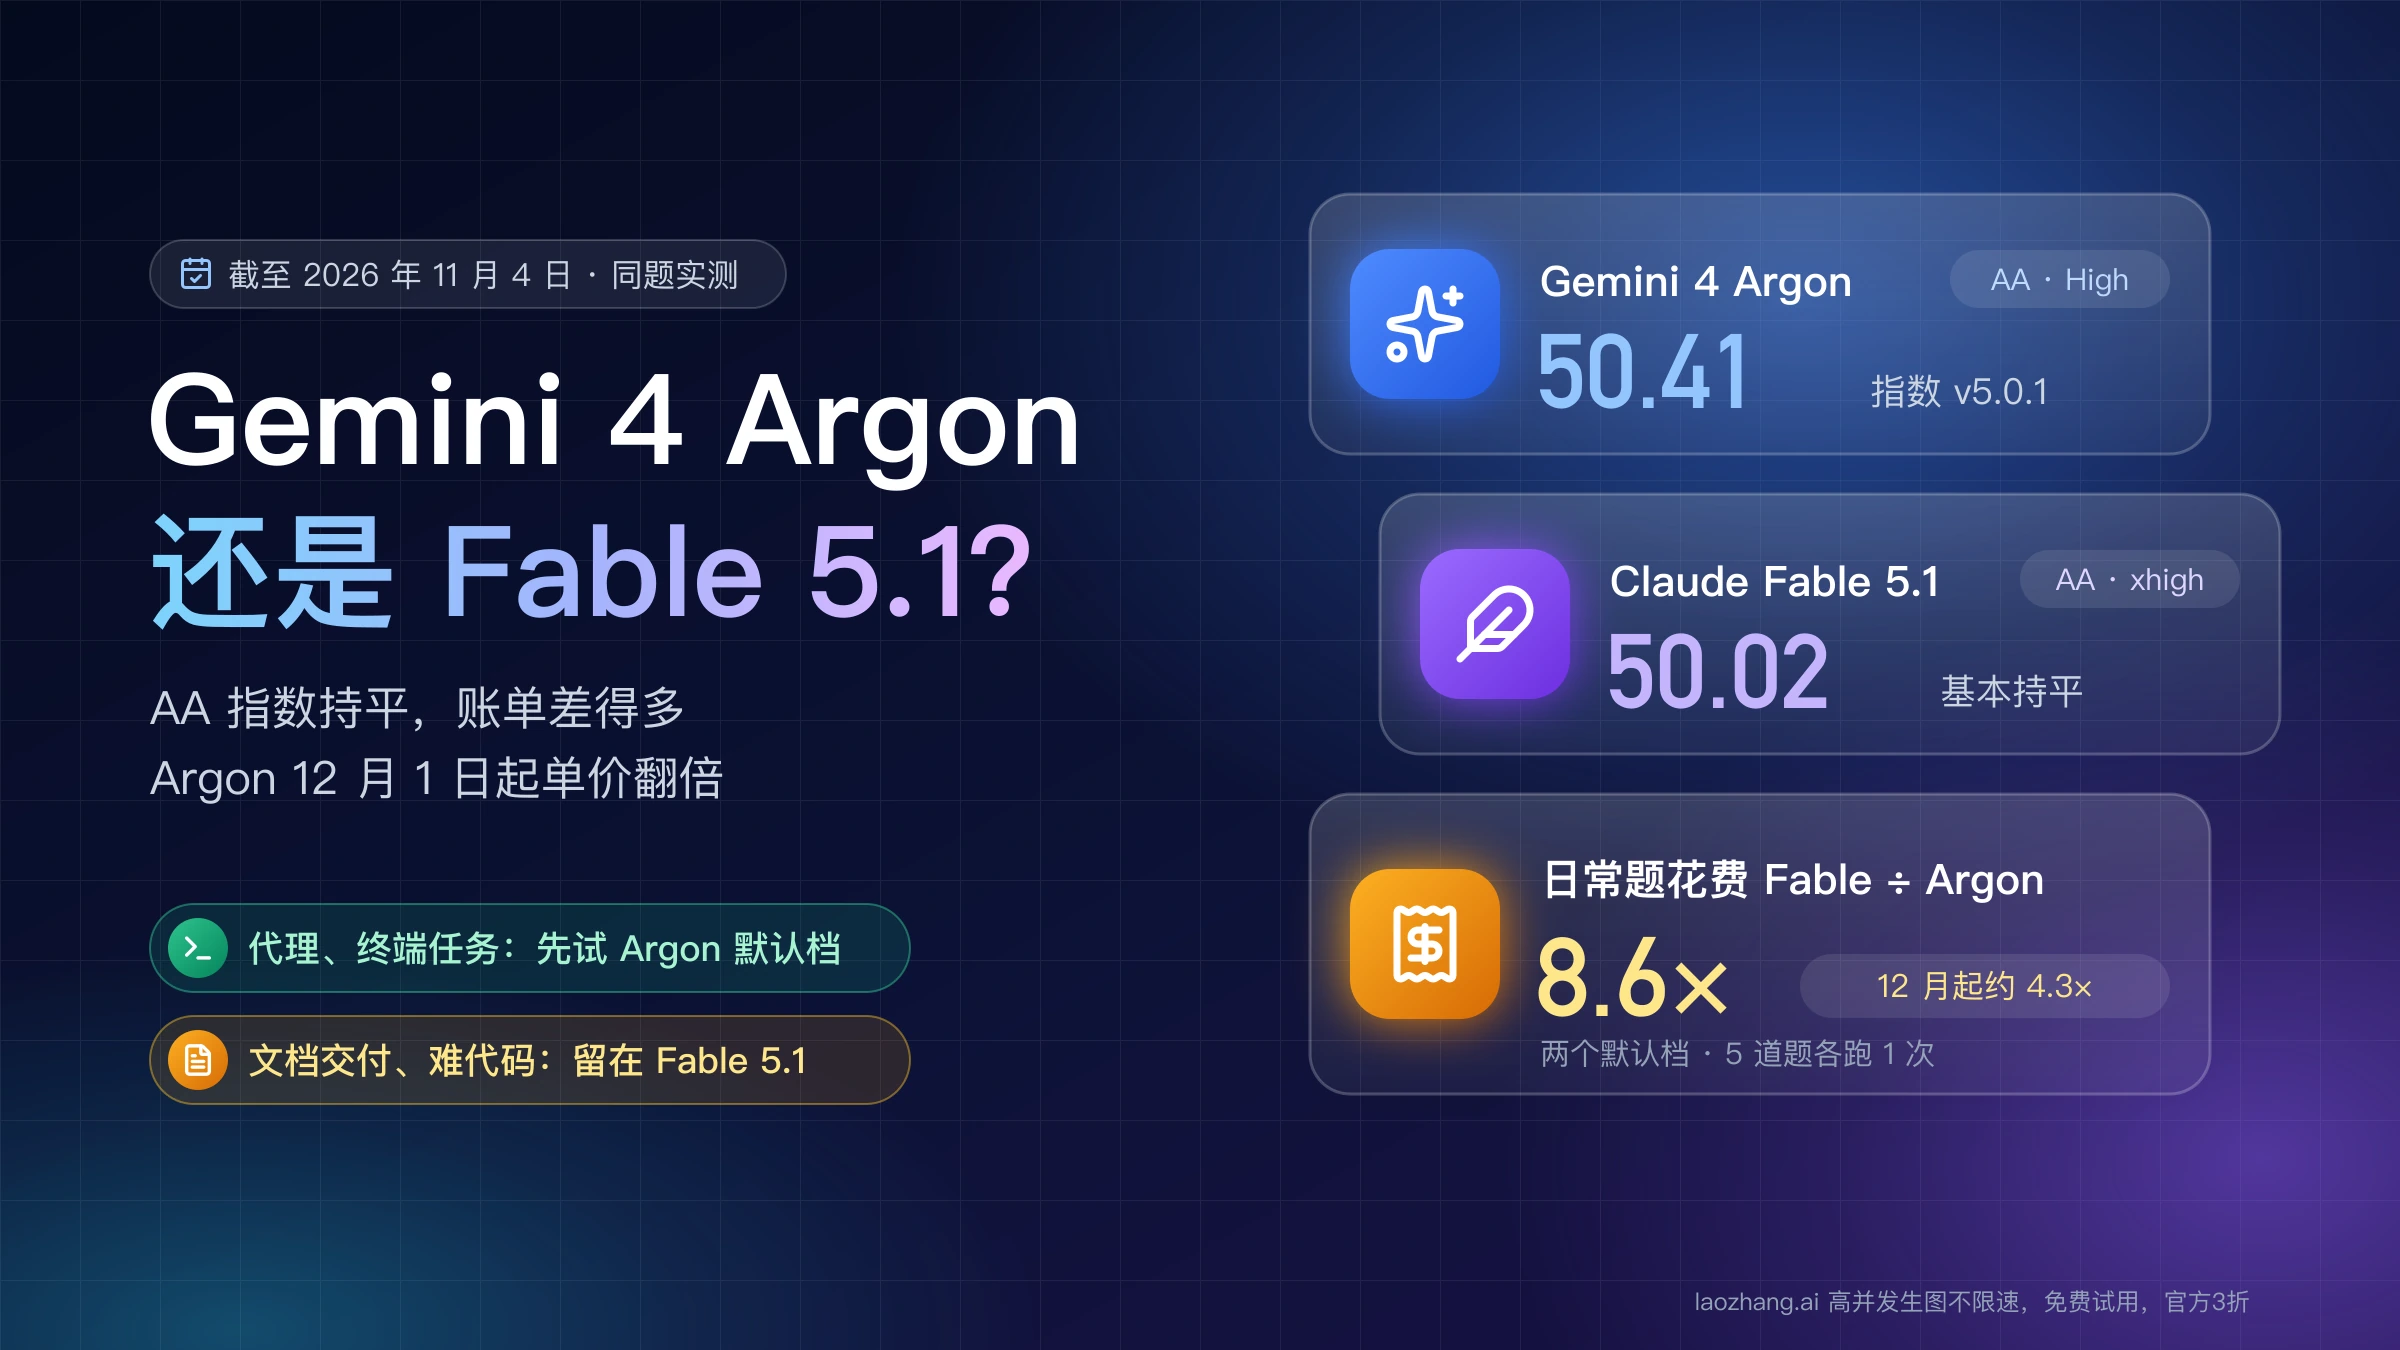
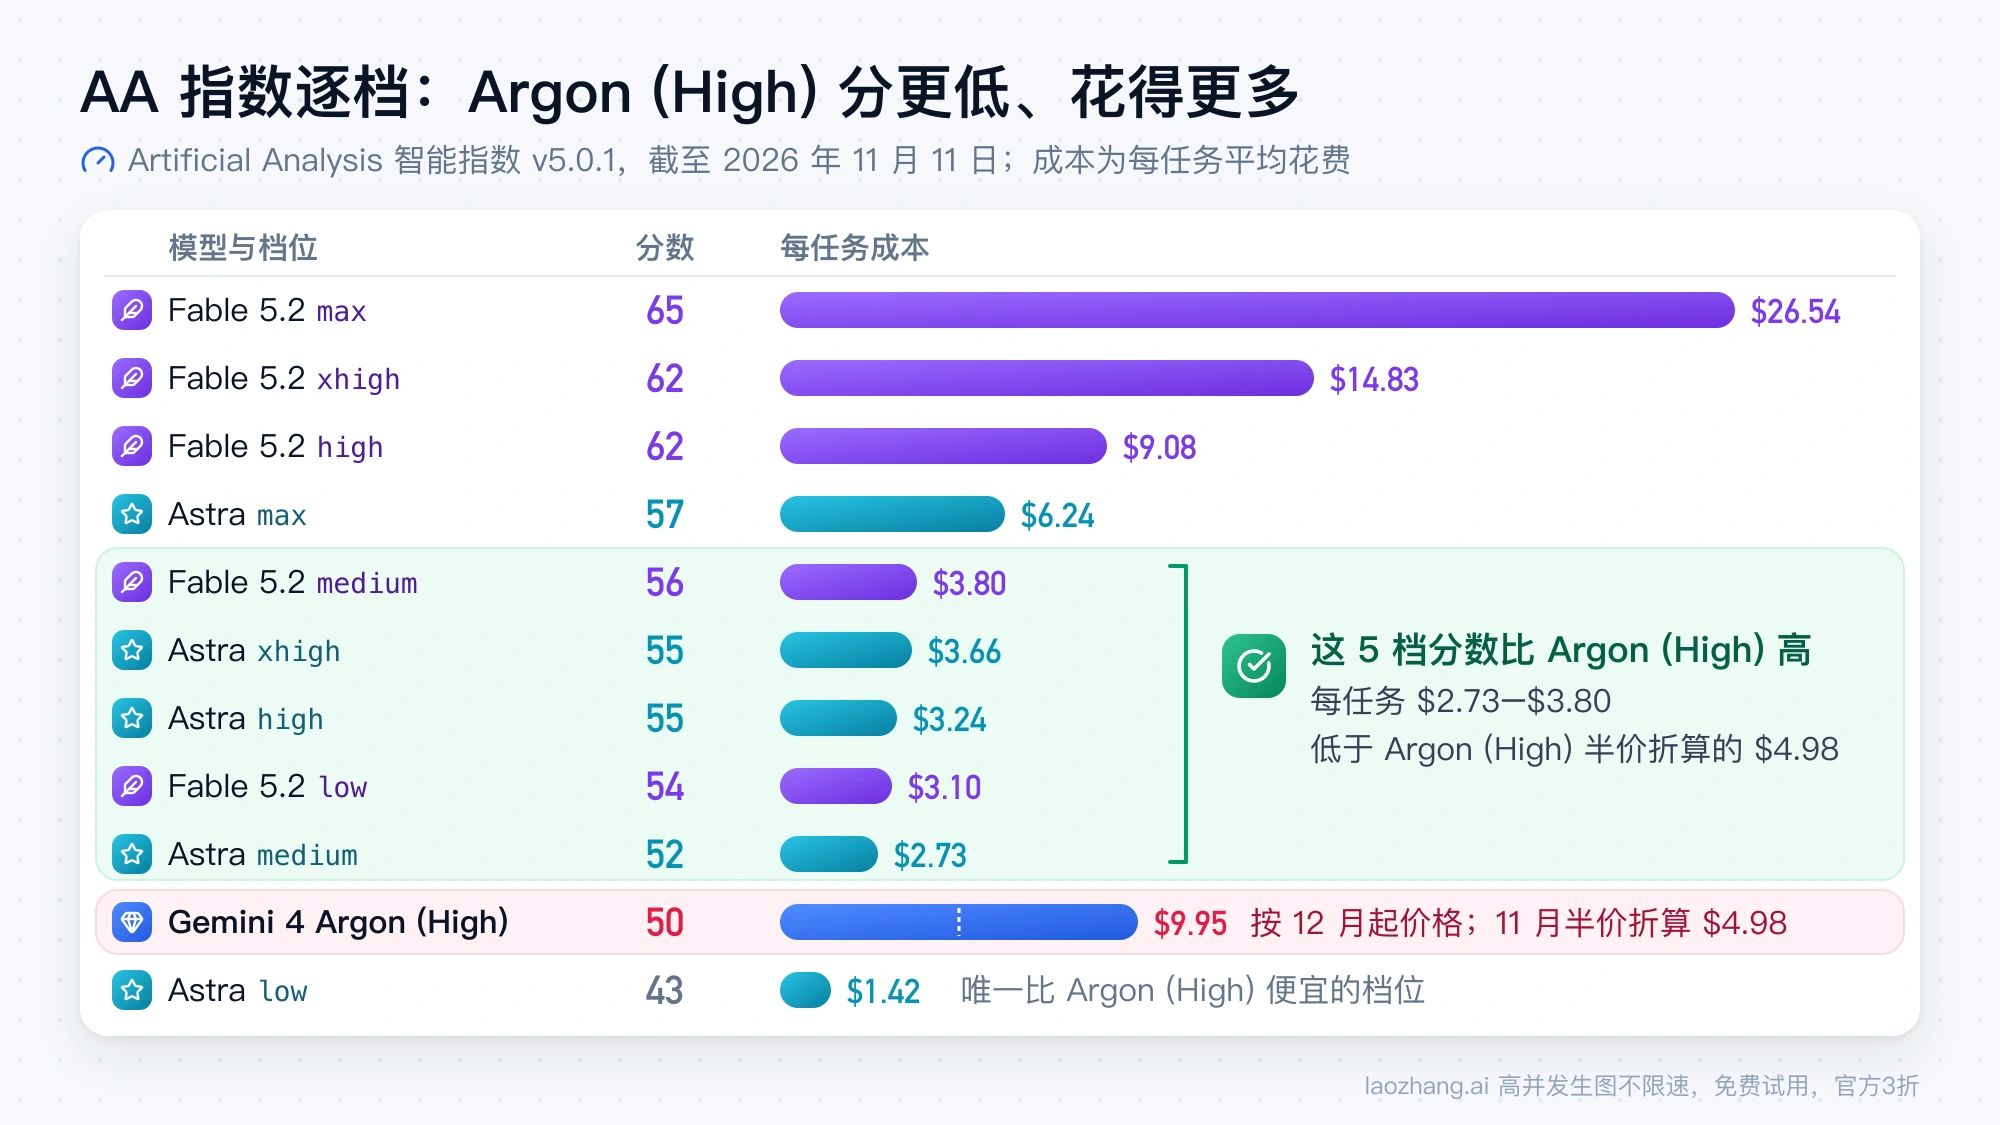
截至 2026 年 11 月 11 日,Artificial Analysis 智能指数 v5.0.1 给 Fable 5.2 和 Astra 各公布了五档成绩,Argon 只公布了 High 一档,没有 API 默认的 medium 和 low。下表按分数排列,成本是跑一道指数题的平均花费,按各家 API 标价计;AA 对 Argon 用的已经是 12 月 1 日起的 $4 / $20,括号里是按 11 月 30 日前的半价折算,AA 页面上没有这个数。来源是 Artificial Analysis 的 Gemini 4 Argon 与 Claude Fable 5.2 对比页和 GPT-6 Astra 与 Claude Fable 5.2 分档对比页。
| 模型与档位 | 智能指数 | 每任务成本 | 每任务用时 |
|---|---|---|---|
Fable 5.2 max | 65 | $26.54 | 44.4 分钟 |
Fable 5.2 xhigh | 62 | $14.83 | 26.1 分钟 |
Fable 5.2 high | 62 | $9.08 | 17.5 分钟 |
Astra max | 57 | $6.24 | 23.0 分钟 |
Fable 5.2 medium | 56 | $3.80 | 7.9 分钟 |
Astra xhigh | 55 | $3.66 | 11.4 分钟 |
Astra high | 55 | $3.24 | 9.8 分钟 |
Fable 5.2 low | 54 | $3.10 | 6.4 分钟 |
Astra medium | 52 | $2.73 | 7.1 分钟 |
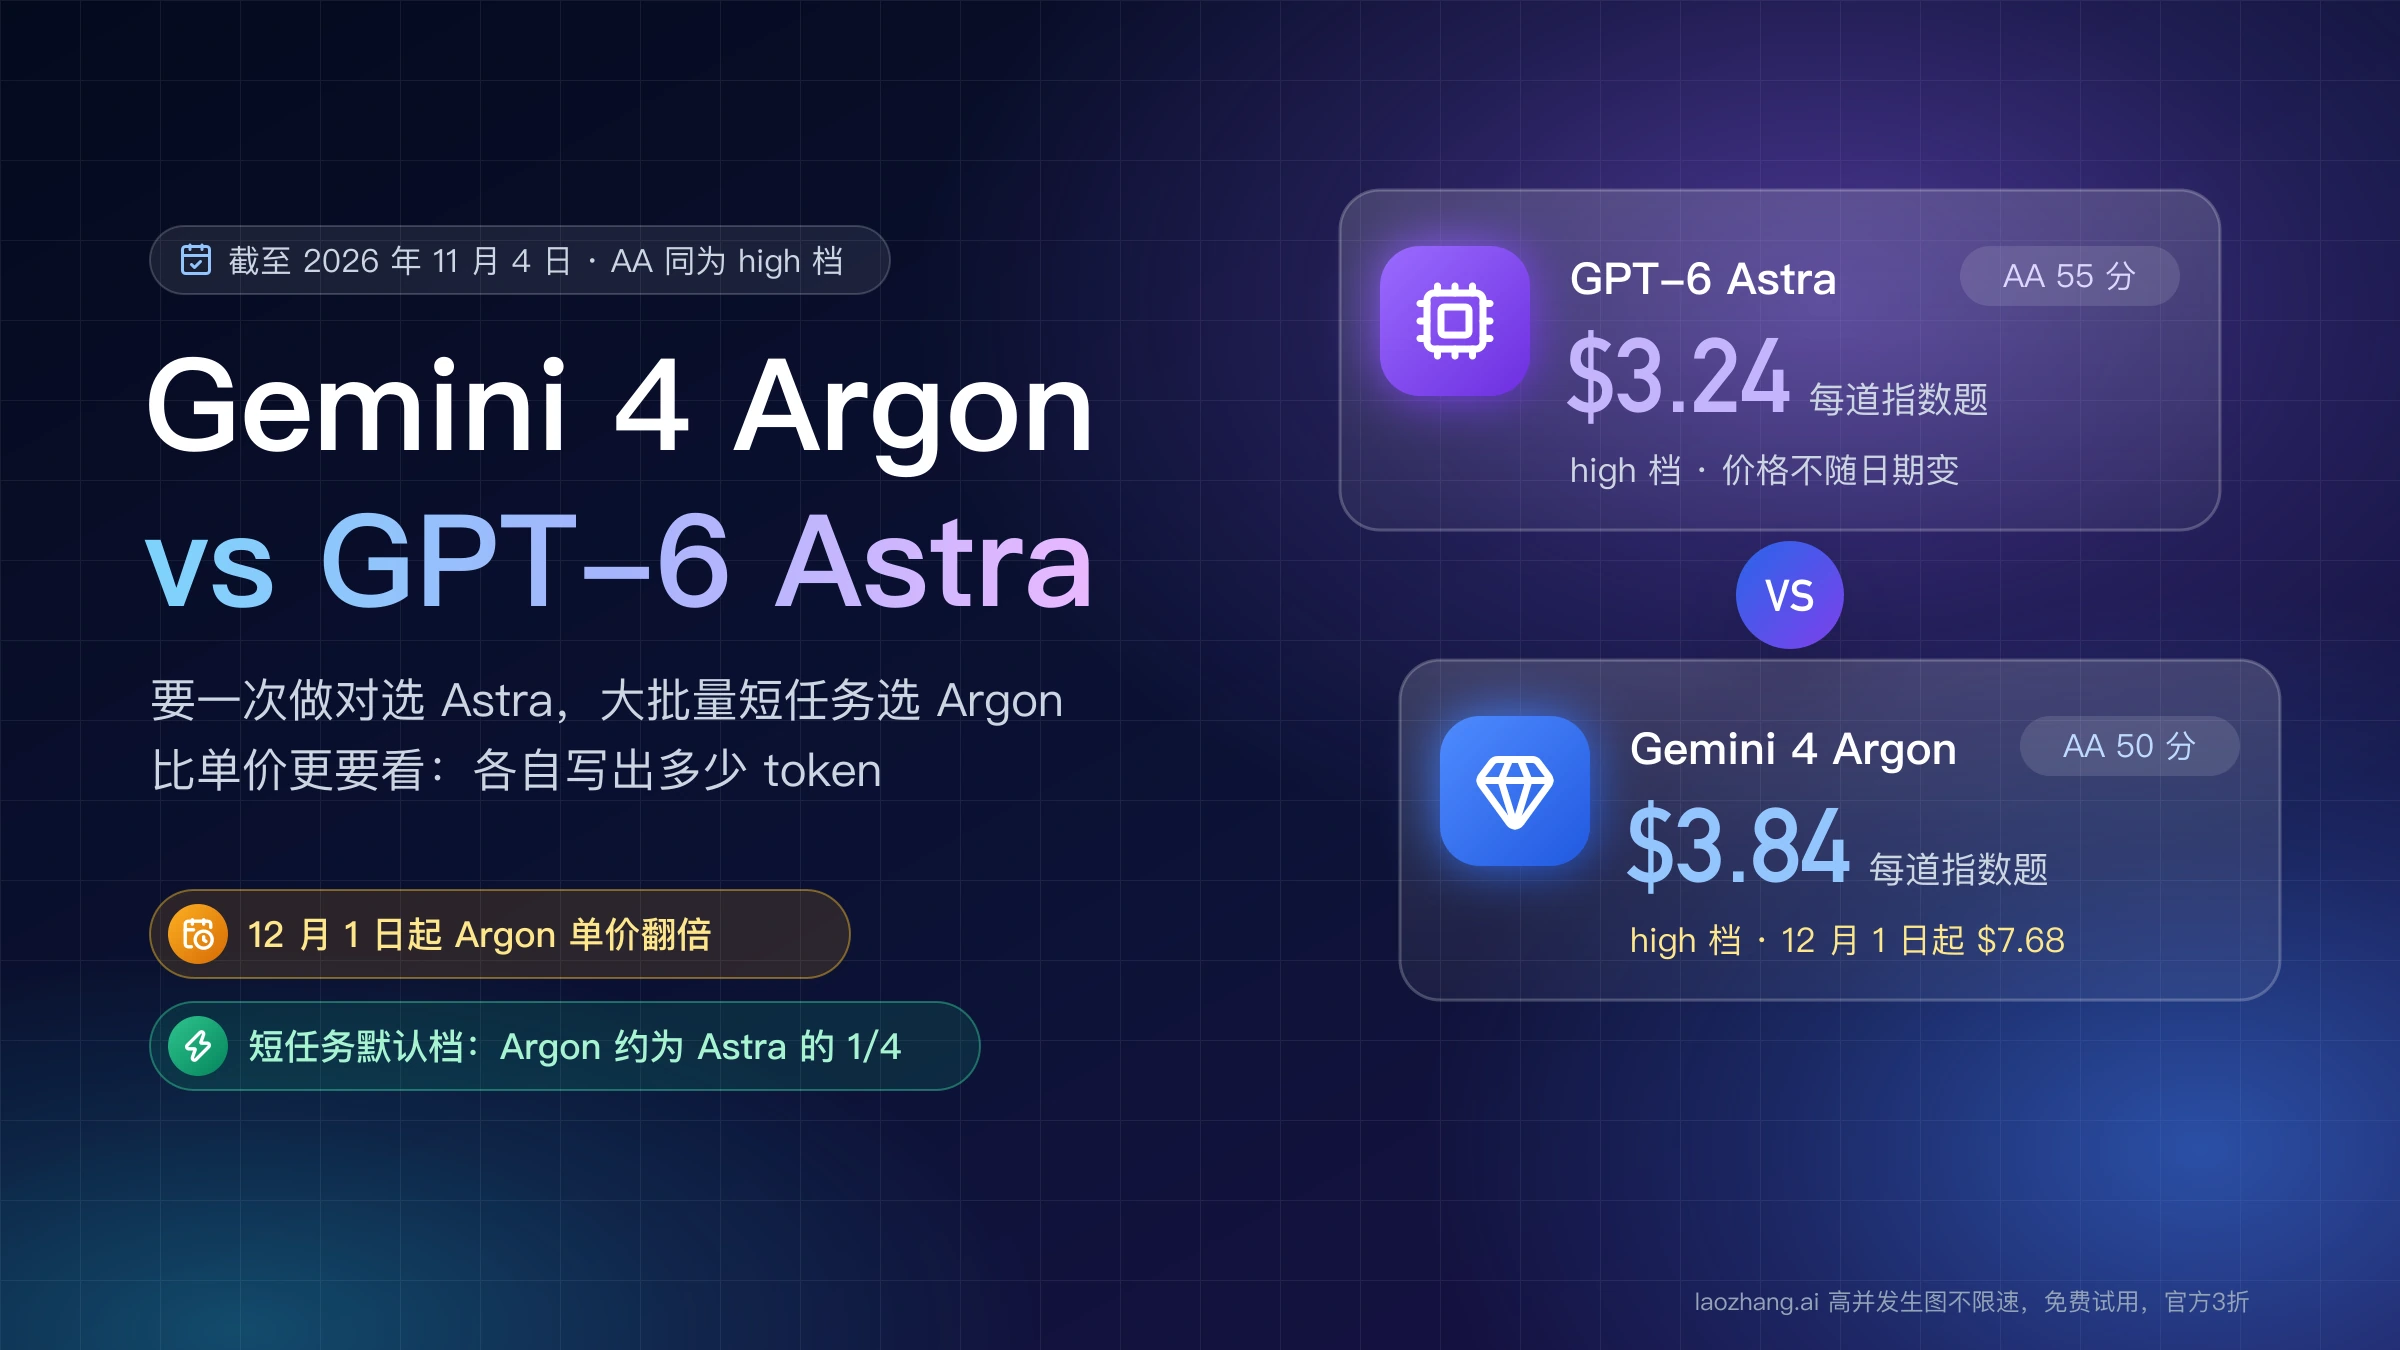
| Gemini 4 Argon (High) | 50 | $9.95(半价折算 $4.98) | 28.6 分钟 |
Astra low | 43 | $1.42 | 3.8 分钟 |
按同分来读,结论很直接:比 Argon (High) 分数高的档位里,Astra medium、high、xhigh 和 Fable 5.2 low、medium 每任务都在 $2.73 到 $3.80 之间,比 Argon (High) 按今天半价折算的 $4.98 还低;12 月 1 日后 Argon (High) 的 $9.95 甚至高过 Astra max(57 分)和 Fable 5.2 high(62 分)。比它便宜的只有 Astra low,分数是 43。也就是说,在这套指数的难度上,花钱让 Argon 多想,不如换一款模型。这个结论不涉及 Argon 的 medium,AA 没有给这一档打分,而在上一节的同题测试里,它的花费只有 high 档的四分之一。
Argon 这一行的成本在 AA 页面上变过。2026 年 11 月 4 日同一页面显示 Gemini 4 Argon (High) 50 分、每任务 $7.68,11 月 11 日变成 $9.95、28.6 分钟,版本号仍是 v5.0.1,价格基准仍是 $4 / $20,页面没有说明原因。Gemini 4 Argon vs GPT-6 Astra 对比:实测成本与 12 月涨价后怎么选写于 11 月 4 日,用的是 $7.68;网上还在流传的"每任务 1.99 美元""成本仅为 Astra 的 60%"来自更早的 v4.x 指数,已经不能和现在的数字放在一起比。
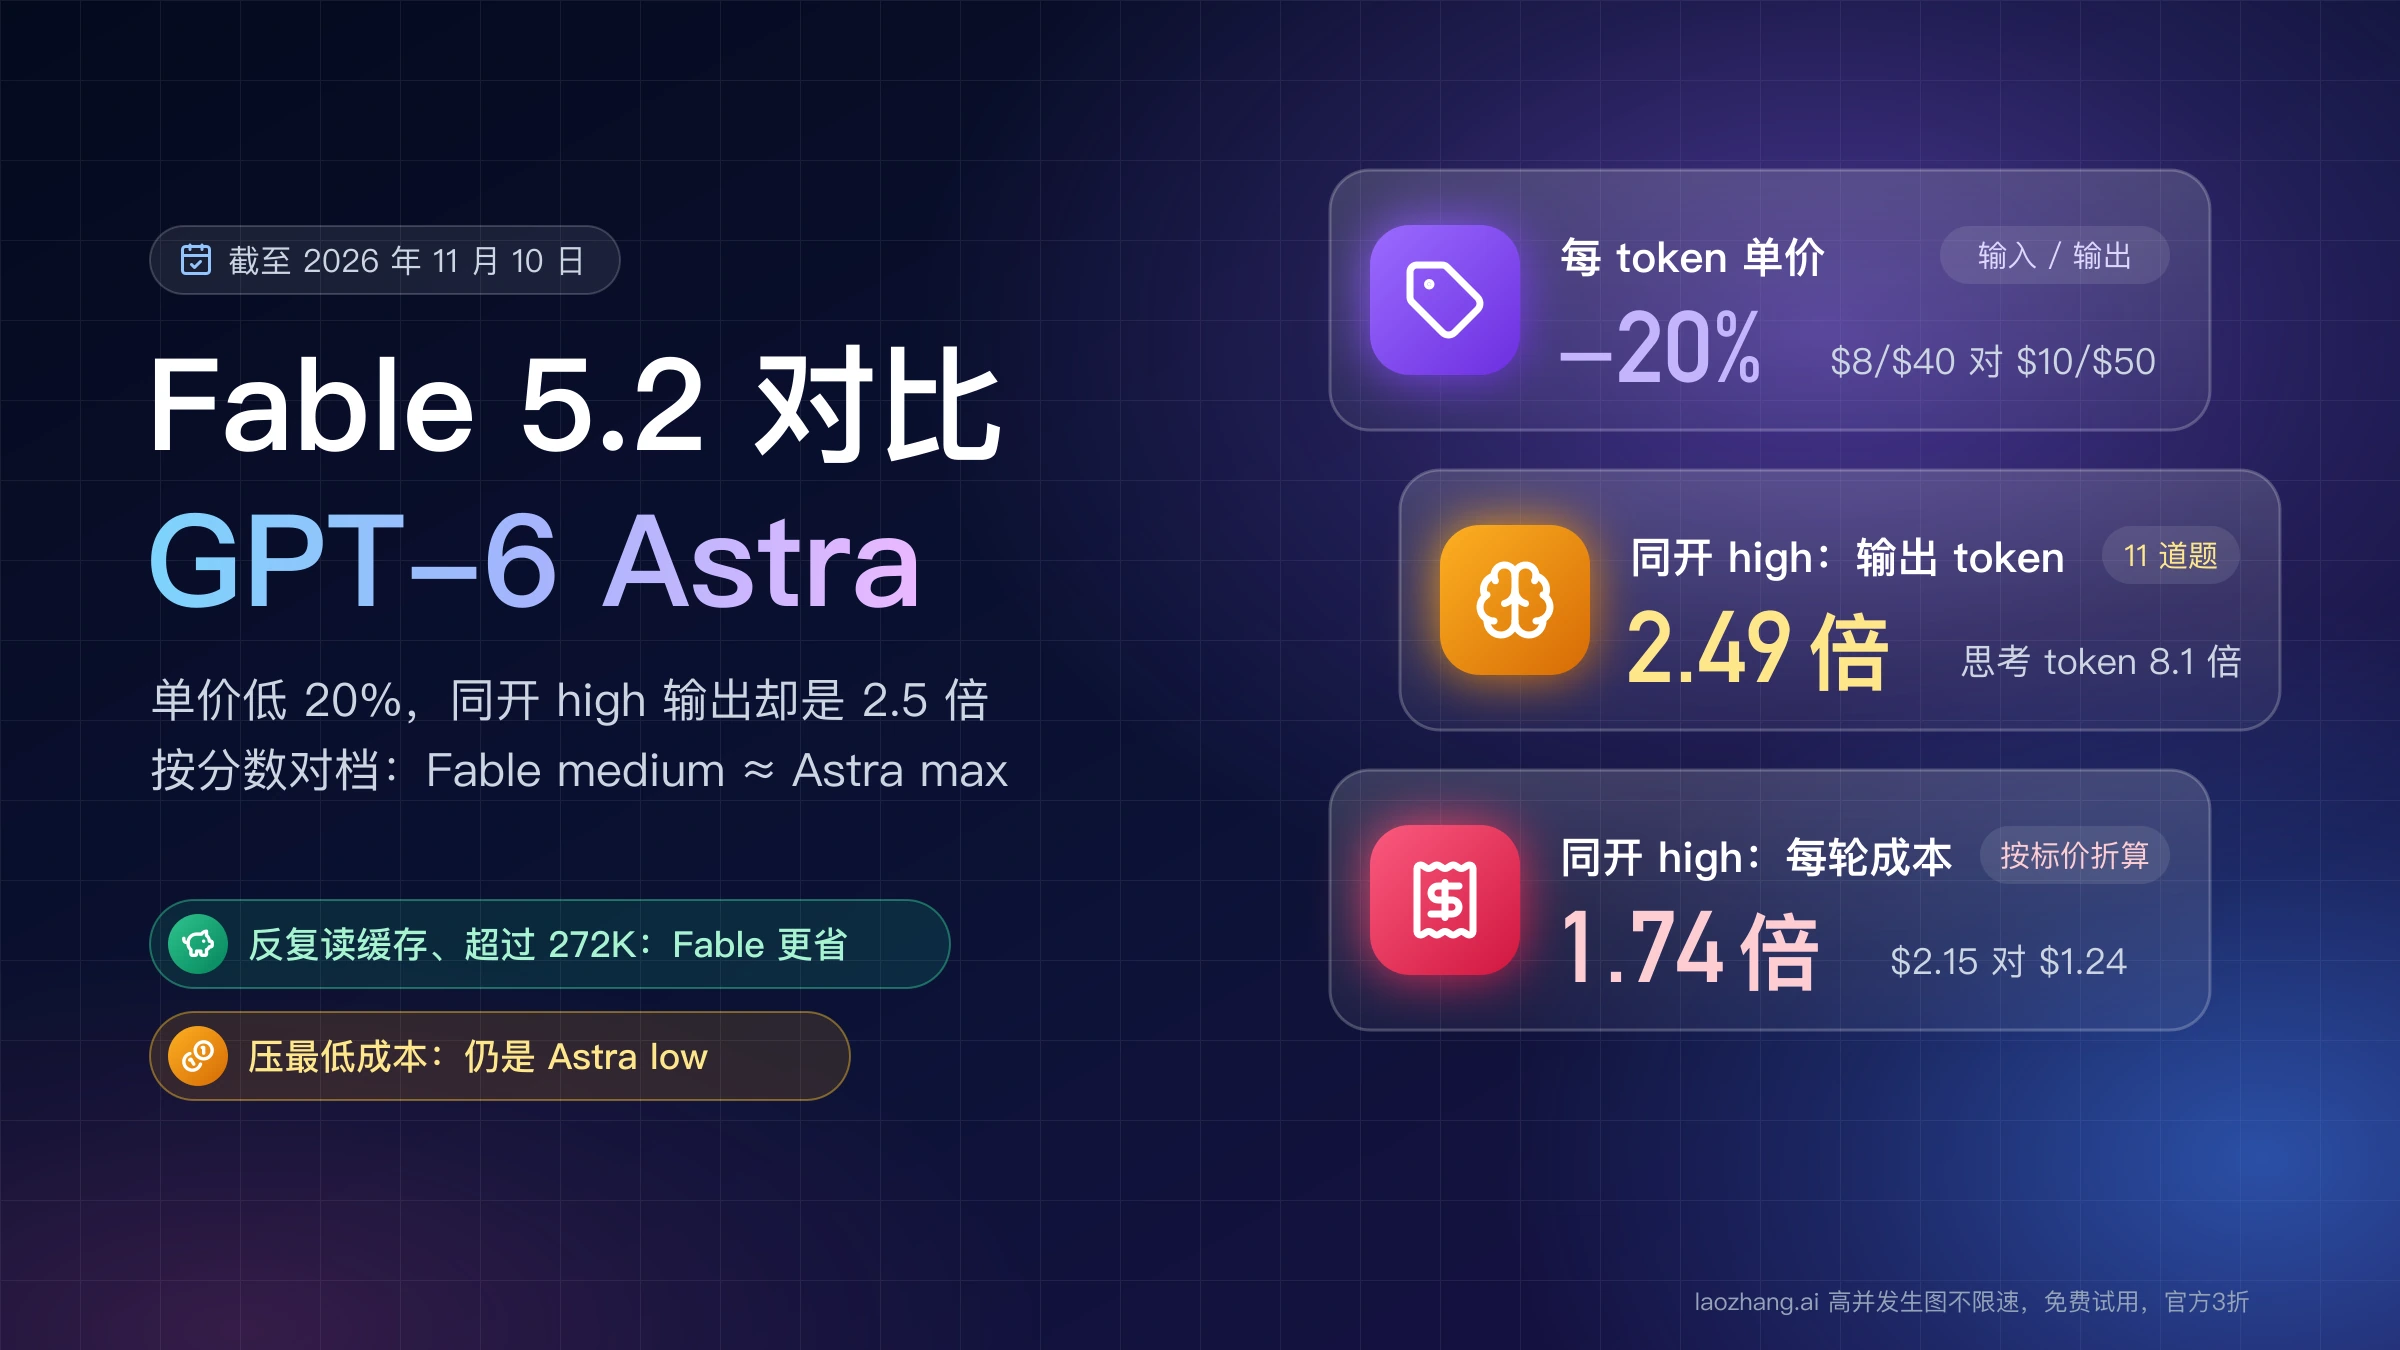
Fable 和 Astra 之间,Fable 5.2 medium 比 Astra max 只低 1 分,成本低 39%,用时约三分之一;Fable 5.2 low 比 Astra high、xhigh 低 1 分,便宜 4% 到 15%;57 分以上只有 Fable 有档位,最高的 max 65 分,每任务 $26.54,是 Astra max 的 4.25 倍。社交平台上流传的"Fable 5.2 65 分、Gemini 4 Carbon 60 分、GPT-6 Astra 57 分"是各模型最高档的成绩,所以"Astra 比 Fable 强吗"的回答是:在这套指数上,同等成本下 Fable 5.2 的档位分数更高,Astra 只在最低成本一端(low,$1.42)没有对手。两款逐档怎么对应、在各自编码 CLI 里的实测,见 Fable 5.2 和 GPT-6 Astra 对比:单价低 20%,同题输出却是 2.5 倍。
长日志精确计数:Argon 默认档 22 秒答错,开 high 要 5 分半
2026 年 11 月 11 日的另一项测试专门考长输入,三款模型都参加,调用方式和同题测试相同,Argon 开 high 时改用流式输出。输入是一份 146 KB、1,500 行的日志,其中 326 行是 ERROR,WARN 行里混着同样的错误码做干扰,要求报出 7 个精确值(5 个错误码各出现几次、某个错误码涉及多少个不同用户、重试次数最多的请求 ID),标准答案在调用前由脚本生成。
| 配置 | 7 个值全对 | 用时 | 输出 token(其中思考) | 当前标价成本 |
|---|---|---|---|---|
Fable 5.2 不设 effort(默认 high) | 是 | 74 秒 | 9,792(未单列) | $1.02 |
Fable 5.2 medium | 是 | 64 秒 | 8,156(未单列) | $0.95 |
| Astra 不设档(默认) | 是 | 26 秒 | 2,423(2,374) | $0.82 |
| Argon 不设思考档 | 否 | 22 秒 | 85(0) | $0.16 |
Argon high,流式输出 | 是 | 329 秒 | 44,980(44,895) | $0.46 |
Argon 默认档只输出了 85 个 token,没有任何思考,5 个错误计数全部偏少 18% 到 38%(比如 E503 报 58 次,实际 94 次),不同用户数报 46,实际 78,只有请求 ID 对了。11 月 4 日用同一份日志测过,结果一样:默认档两次都错、都没有思考 token;开 high 但不用流式时,调用在 32,768 个输出 token 处停止,还在思考阶段,没有答案,照样计费 $0.49;改成流式后两次都对,用时 271 到 402 秒。所以 Argon 开 high 时建议用流式请求。
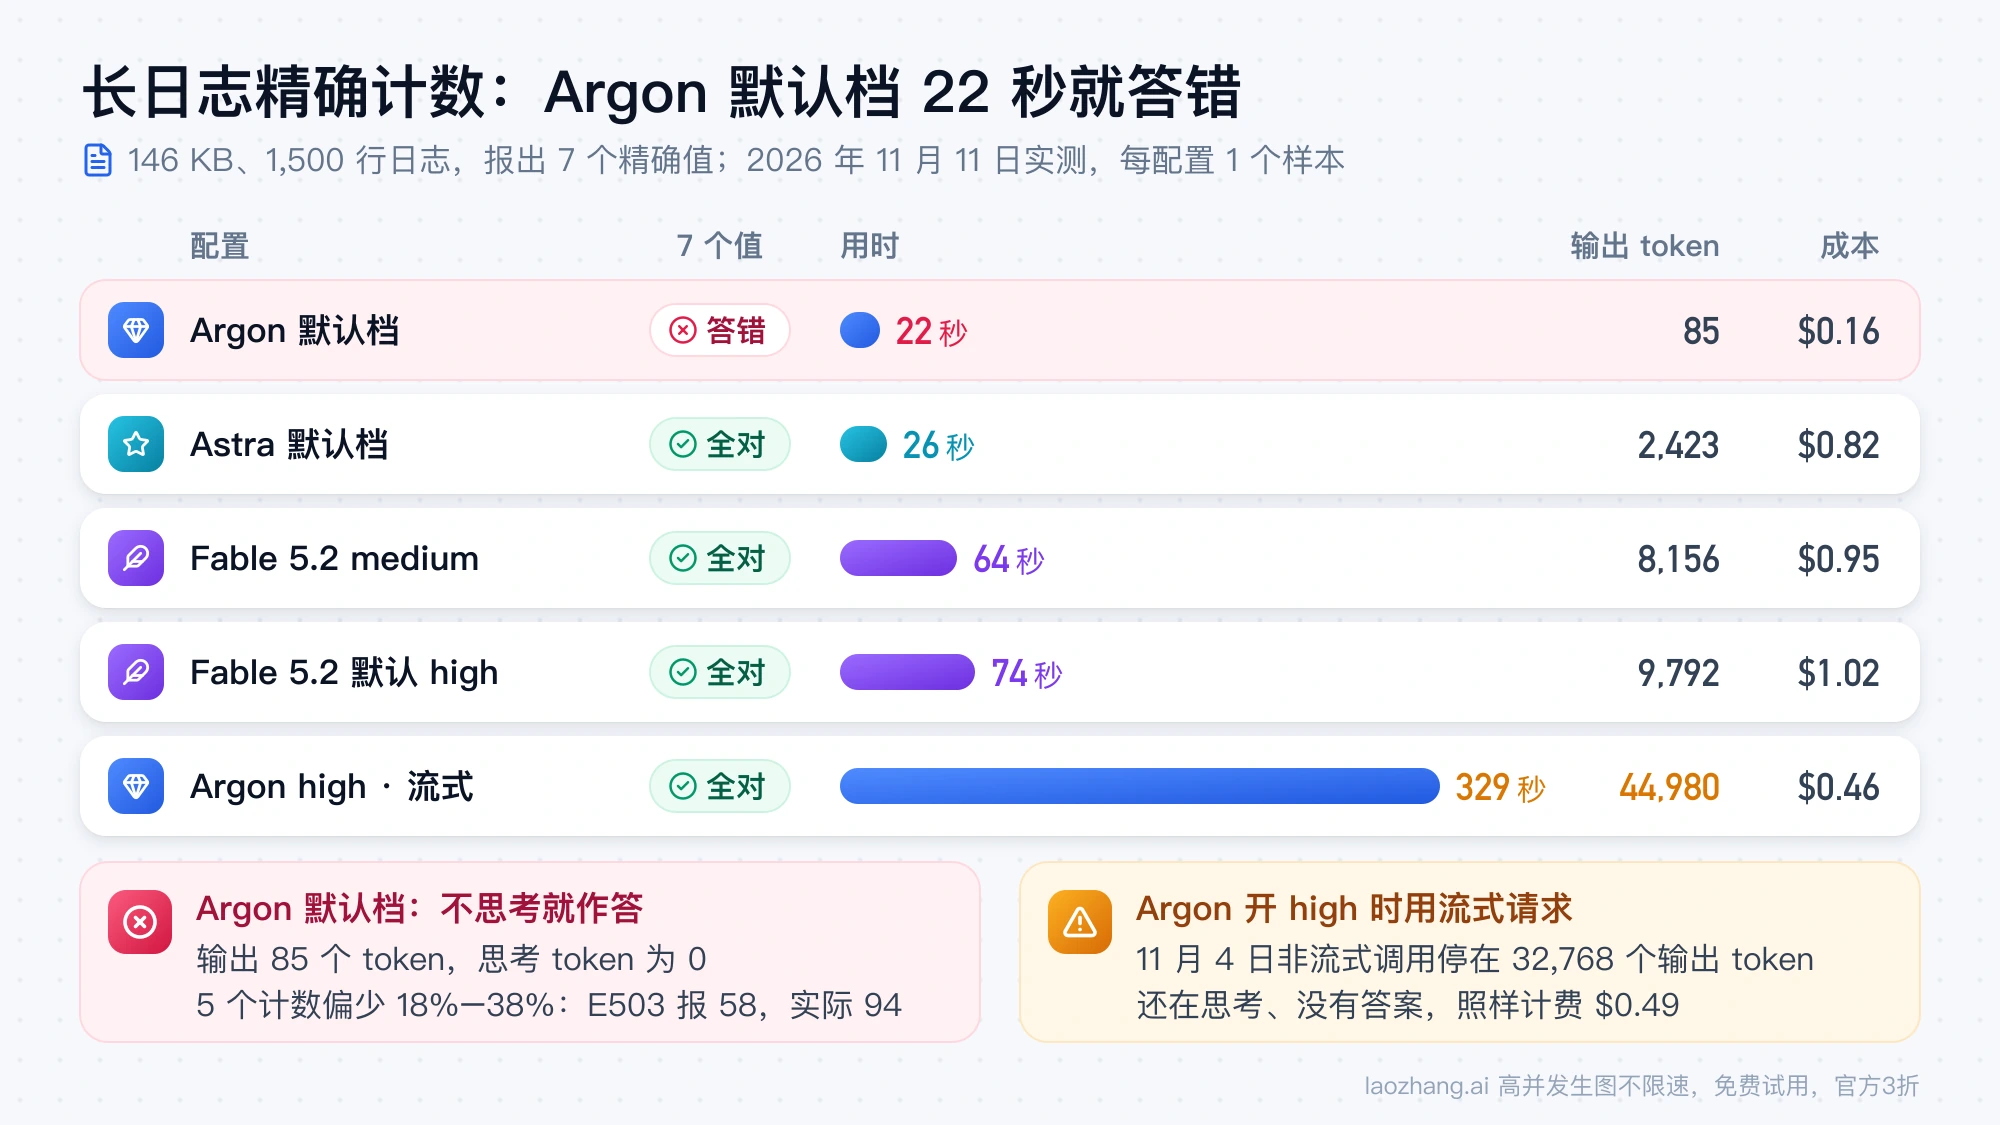
high 档这次的 $0.46 偏低,因为几分钟前的默认档调用在 Google 那边留下了隐式缓存,77,258 个输入 token 按缓存价计费;不命中缓存约 $0.61,12 月 1 日起约 $1.22。Astra 的 $0.82 里含把整段日志写入缓存的费用(按 $12.50 每百万计),30 分钟内重复同样的输入会按 $1 每百万读取。这项测试只有一种任务、每个配置一个样本,不能当作综合排名,但能说明一个实际问题:Argon 默认档面对长输入时可能不思考就作答,又快又错,需要精确结果时要么换模型,要么开 high、用流式、等几分钟。
为什么单价最低的 Argon,开到 high 反而不省
每次调用的花费等于 token 数乘单价,思考 token 按输出价计费。截至 2026 年 11 月 11 日,Argon 每百万 token 输入 $2、输出 $10,只有 Fable 5.2 的四分之一、Astra 的五分之一;只要它写出的 token 比别人多出四五倍,单价优势就没有了,而开到 high 正是这样。在 8 道题的测试里,Argon high 写出 36,291 个输出 token,其中 30,842 个是思考,是 Fable 5.2 medium(9,317 个)的 3.9 倍。按百万 token 折算,Argon high 的输出部分约 $0.363,Fable 5.2 medium 约 $0.373,几乎打平;今天 Argon 总价 $0.388 仍低于 Fable 5.2 medium 的 $0.510,差额全来自输入便宜(12,712 × $2 约 $0.025,对 17,202 × $8 约 $0.138)。12 月 1 日单价翻倍后,同样的用量变成 $0.777,反超 Fable 5.2 medium 一半以上。
日志题上差得更多。Argon 开 high 写出 44,980 个输出 token,是 Fable 5.2 medium(8,156)的 5.5 倍、Astra 默认档(2,423)的 18.6 倍。不命中缓存时是 79,312 × $2 + 44,980 × $10,约 $0.159 + $0.450 = $0.61,其中输出部分 $0.45,比 Fable 5.2 medium 的输出部分(8,156 × $40,约 $0.33)和 Astra 的(2,423 × $50,约 $0.12)都高。今天它总价仍最低,靠的是输入便宜;12 月 1 日起同样的用量要 $1.22,比这道题上任何一个答对的配置都贵,还要多等 5 分钟。
AA 指数上的情况相同,只是表现在分数上:Gemini 4 Argon (High) 每道指数题平均输出 11.6 万 token,其中 6.83 万是思考,花了 28.6 分钟,换来 50 分;Fable 5.2 medium 和 Astra high 用更少的时间和钱拿到了更高的分数。所以"Argon 每百万 token 最便宜"和"Argon 每个合格结果最便宜"是两件事,前者只在它不需要多想、默认档就能做对的任务上才成立。
价格与规格:12 月 1 日 Gemini 4 Argon 单价翻倍
截至 2026 年 11 月 11 日,三款的官方 API 标价和主要规格如下,单位是美元每百万 token。Argon 的 $2 / $10 是 Google 定价页标明"截至 2026 年 11 月 30 日"的价格,12 月 1 日起变成 $4 / $20;Fable 5.2 在整个 1M 上下文内价格不变;Astra 单次输入超过 272K token 时,整次请求按更高的价格计费。价格来自 Gemini API 定价页、Claude API 定价页和 OpenAI API 定价页。
| 项目 | Gemini 4 Argon | Claude Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| 模型 ID | gemini-4-argon | claude-fable-5-2 | gpt-6-astra |
| 发布 | 2026 年 10 月 13 日正式开放 | 2026 年 11 月 9 日 | 2026 年 9 月 3 日 |
| 输入 | $2,12 月 1 日起 $4 | $8 | $10,超过 272K 为 $20 |
| 输出(含思考) | $10,12 月 1 日起 $20 | $40 | $50,超过 272K 为 $75 |
| 缓存读取 | $0.10,12 月 1 日起 $0.20 | $0.20 | $1.00 |
| 缓存写入 | 只有隐式缓存,不能显式创建 | 5 分钟 $10,1 小时 $16,需主动开启 | 30 分钟 $12.50(默认写入),12 小时 $25 |
| 上下文 | 1,048,576,输入输出共用 | 1M | 1,050,000(输入最多 922,000) |
| 最大输出 | 65,536(同步),长输出模式可到 1,048,576 | 128K | 128K |
| 输入类型 | 文字、图片、视频、音频、PDF | 文字、图片 | 文字、图片 |
| 思考强度 | low、medium、high,默认 medium | low 到 max,API 默认 high | low 到 max |
按单价算,11 月 30 日前 Argon 是 Fable 5.2 的四分之一、Astra 的五分之一,12 月 1 日起变成二分之一和五分之二。到那天,Argon 的每百万 token 单价仍是三款最低,同题测试里默认档也仍是最省的配置,但 high 档会从比 Astra 默认档略便宜变成最贵。AA 的数字不会变,因为它已经按 $4 / $20 计算,失效的只是"半价折算 $4.98"这个参考值。Gemini 4 Carbon 的 $2 / $10 优惠价也到 11 月 30 日为止。Fable 5.2 的 Batch 是 $4 / $20,Astra 的 Batch 是标准价的一半;Astra 在 272K 门槛、两档缓存写入和 Batch 下的完整算法见 GPT-6 Astra API 定价与成本计算:价格表、272K 与两档缓存写入,还在用 Fable 5.1 的话可以先看 Claude Fable 5.2 和 5.1 区别:单价降 20%,high 以上每任务更贵。
型号名称上,Anthropic 没有发布 Fable 5.5,OpenAI 的定价页也没有 GPT-6.2;搜索里的"Astra 6"指的就是 GPT-6 Astra。Mythos 5.2 和 Fable 5.2 是同一个模型,安全限制更少,只开放给通过验证的组织。
同一段中文,三家计的 token 数不一样
每百万 token 的单价不能直接相除,因为三家的分词器给同一段文字算出的 token 数不同。以 GPT-6 Astra 为 1.00,一段中文短文 Fable 算出 1.50 倍、Argon 算出 0.84 倍;一段英文短文分别是 1.45 倍和 1.00 倍。乘上单价之比(Fable 5.2 是 Astra 的 0.8 倍,Argon 当前 0.2 倍、12 月起 0.4 倍),同样一段不命中缓存的中文输入,Fable 5.2 收的钱是 Astra 的 1.20 倍,Argon 在 11 月 30 日前是 0.17 倍,12 月 1 日起 0.34 倍;英文输入则是 1.16 倍、0.20 倍和 0.40 倍。中文对 Argon 有利、对 Fable 不利,中文任务的实际差距会比单价表示的更大一些。
这些短文倍数来自更早的测试:Fable 的是 2026 年 10 月 26 日在 Fable 5.1 上测的,Anthropic 说明 5.2 用同一个分词器,11 月 11 日 Fable 5.2 给那篇 6,723 词英文文章算出的 15,335 个 token 也和 5.1 当时完全一样;Argon 的是 11 月 4 日测的。同一篇英文文章,Argon 算 11,110、Fable 5.2 算 15,335、Astra 算 10,106,即 1.10 倍和 1.52 倍,和短文的比例接近。每种语言只用了一段几百字的文字,换成代码、日志、ID 列表,比例会变:11 月 11 日那份 146 KB 日志,Argon 算 79,312、Fable 5.2 算 78,537、Astra 算 55,843,Argon 反而和 Fable 一样多,是 Astra 的 1.42 倍。所以估算自己的成本时,要用自己的真实输入去数,不要套用一个固定倍数。
写代码选哪个:三家的跑分表各缺一款
没有任何一家厂商把这三款放进同一张表。Google 9 月 30 日发布 Argon 时的对比表里有 Astra、Fable 5.1 和 Opus 5.5,没有 Fable 5.2;Anthropic 11 月 9 日发布 Fable 5.2 时比的是 Astra 和 Gemini 4 Carbon,没有 Argon;OpenAI 没有发布和这两款的对比。两张表都有的编码项目是 FrontierSWE v2:Fable 5.2 69.9、Astra 65.5(Anthropic 的表),Argon 55.0(Google 的表)。这是两家各自的测试设置,只能粗略对照,但方向和第三方数据一致。
第三方的 AA v5.0.1 分项(截至 2026 年 11 月 11 日,Gemini 4 Argon (High) 对 Fable 5.2 max 对 Astra max):FrontierCode-AA 2.0 是 25.7% / 48.8% / 42.4%,Argon 落后最多;Terminal-Bench 4.0 是 57.1% / 59.6% / 59.1%,三款接近;AutomationBench-AA 是 77.5% / 76.4% / 68.5%,这是 Argon 唯一排第一的分项。Google 自己的表上 Argon 在 AutomationBench 也比 Astra 高(51.3 对 41.4),Anthropic 的表上 Fable 5.2 是 51.4,和 Argon 基本持平。需要注意,这组分项拿的是 Argon 唯一的一档去比另外两款的最高档,换成 Fable、Astra 的低档位差距会缩小。
落到选择上:难的编码题、要从头写复杂实现时,先试 Fable 5.2;以终端操作、自动化流程为主的代理任务,三款差距不大,Argon 的单价优势这时才有意义;Astra 在 AA 的 GDP.pdf 上三款最高,31.0%,对比 Argon (High) 21.8%、Fable 5.2 max 24.2%。还要考虑速度:AA 测得 Astra 每秒输出 38 到 43 个 token,Fable 5.2 是 91 到 103 个,Argon 68 个,开高档位时 Astra 的等待最长。
Gemini 4 Carbon 和 Argon 怎么选
Gemini 4 Carbon 是 Google 现在能力最强的推理模型,2026 年 11 月 10 日起在付费 Gemini API 和 Google AI Studio 正式开放(Gemini API 更新日志),免费档没有。它和 Argon 同价(11 月 30 日前 $2 / $10),同样是 1M 上下文、low / medium / high 三档、默认 medium。Google 的说法是 Carbon 每轮花更多思考 token 去探索和自查,用量和延迟都比 Argon 高;Argon 适合多数高阶软件工程和知识工作,回答更快、每轮 token 更少。11 月 10 日之前 Carbon 只给经过审核的网络安全防御方使用,写于那之前的文章还在说"用不上"。
在 AA 智能指数 v5.0.1 上(截至 2026 年 11 月 11 日),Gemini 4 Carbon (High) 60 分、每任务 $7.76、24.9 分钟,Gemini 4 Argon (High) 是 50 分、$9.95、28.6 分钟,两者都按 $4 / $20 计。不过同一页面上跑完整个指数的总成本是 Carbon $8,240、Argon $7,620,方向相反,所以只能说两者开 High 时花费相近,Carbon 分数高出 10 分(AA 的 Carbon 与 Argon 对比页)。如果你打算让 Google 的模型开 high 去做难题,Carbon 比 Argon 更值得试;日常任务用 Argon 默认档的理由不变。Carbon 不在上面两项测试里,因为 11 月 11 日测试所用网关的模型列表里还没有 gemini-4-carbon。
先排除:哪些条件会让某一款直接用不了
下面这些限制与质量无关,碰上就会让某一款出局或多花钱,定默认模型前逐条对照自己的使用场景。除最后两行中注明的测试观察外,依据是截至 2026 年 11 月 11 日三家的官方文档。
| 你的情况 | 受影响的模型 | 会发生什么 |
|---|---|---|
| 输入包含视频或音频 | Fable 5.2、Astra | 只收文字和图片,只能选 Argon |
| 高风险网络安全或多数生物研究内容 | Fable 5.2 | 安全分类器会拦截 |
| 合同要求零数据保留 | Fable 5.2 | 需要 30 天数据保留,获得授权才能免除 |
| 代码里强制指定工具调用 | Fable 5.2 | 返回 400 错误 |
请求里带 temperature、top_p 或 top_k | Fable 5.2 | 这些参数必须去掉 |
| 单次输入超过 272K token | Astra | 整次请求按输入 $20、输出 $75 计费 |
| 用 Chat Completions 做函数调用 | Astra | 函数调用只在 Responses API 上可用 |
| 依赖显式创建的上下文缓存 | Argon | 只有隐式缓存,命中与否不能指定 |
开 high 且用非流式请求 | Argon | 2026 年 11 月 4 日的日志测试里,调用在 32,768 个输出 token 处停止、没有答案,high 档建议用流式 |
地区方面,中国大陆不在 Google、OpenAI 和 Anthropic 三家公布的 API 支持地区名单里。
订阅里能用到哪款:Gemini、Claude 和 ChatGPT 套餐
不走 API 的话,能用到哪款取决于你已经在付的套餐。Argon 在 Google AI Pro 和 Ultra 的 Gemini 应用与 AI 模式里可用,Antigravity 要付费的 Pro、Ultra 或企业版,免费的 Gemini 应用没有,0 元路线和单次成本见 Gemini 4 Argon 怎么用?免费版不含,0 元路线与实测单次成本。截至 2026 年 11 月 10 日,Fable 5.2 在所有付费 Claude 套餐里都能选,Free 没有;Max、Ultra 和高级席位最多可用到每周额度的 50%,Pro 和标准 Team 席位要另付用量额度,只有发布周到 11 月 16 日太平洋时间 23:59 例外;Claude Code 里用 /model fable 切换。ChatGPT 的 Free 和 Go 用的是 GPT-6 Luna,Plus 和标准 Business 在 Work / Codex 里每 5 小时大约有 5 到 45 条 Astra 消息,Pro 没有 5 小时限制。套餐额度变动频繁,这些规则会比 API 价格变得更快。
用自己的任务验证:按每个合格结果算成本
上面的测试题小而明确,你的任务未必一样,最可靠的办法是拿自己的任务重跑一遍,按"每个合格结果花多少"来比。
- 从真实工作里挑 10 到 20 个任务,每个都要能自动判断对错,比如单元测试、标准答案或固定格式校验,并在调用前准备好答案。
- 每款至少跑两档:Argon 不设思考档和
high(流式),Fable 5.2low和medium,Astra 默认档和high。每个配置每题跑两次,看结果是否稳定。 - 记下每次返回的模型名、输入、输出和缓存 token 数,按单价算出每次的花费;Argon 同时算一列 12 月 1 日起的价格。
- 用总花费除以合格答案数,得到每个合格结果的成本,再结合用时决定默认配置和转交条件。
计算公式是:花费 = 输入 token × 输入单价 + 输出 token × 输出单价 + 缓存读写 token × 对应单价,单价按每百万 token 折算。以测试里的 Astra 默认档为例,11,407 个输入 token 中有 10,104 个按缓存写入价 $12.50 计、其余 1,303 个按 $10 计,5,471 个输出按 $50 计,合计约 $0.126 + $0.013 + $0.274 = $0.413,和表里一致。自己算的时候要注意 Astra 默认会写缓存并按 1.25 倍输入价收费,Fable 5.2 只有在请求里加了 cache_control 才缓存,Argon 的隐式缓存命中与否由 Google 决定。经过第三方网关调用时,还要核对返回的模型名和版本字段,确认实际应答的就是你请求的模型。某个配置在你的任务上开始出错,那一档的每个合格结果成本就会被重试和返工拉高,这才是决定默认模型的数字。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月11日。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月11日。
- 1.Gemini 4 Argon 与 Claude Fable 5.2 对比页artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-claude-fable-5-2
- 2.GPT-6 Astra 与 Claude Fable 5.2 分档对比页artificialanalysis.ai/models/releases/comparisons/gpt-6-astra-vs-claude-fable-5-2
- 3.Gemini API 定价页aistudio.google.com/docs/pricing
- 4.Claude API 定价页platform.claude.com/docs/en/about-claude/pricing
- 5.OpenAI API 定价页developers.openai.com/api/docs/pricing
- 6.Gemini API 更新日志aistudio.google.com/docs/changelog
- 7.AA 的 Carbon 与 Argon 对比页artificialanalysis.ai/models/comparisons/gemini-4-carbon-vs-gemini-4-argon