DeepSeek V4.1 和 Kimi K3.1 哪个好:Flash 对 Pro,贵 7.5~27 倍
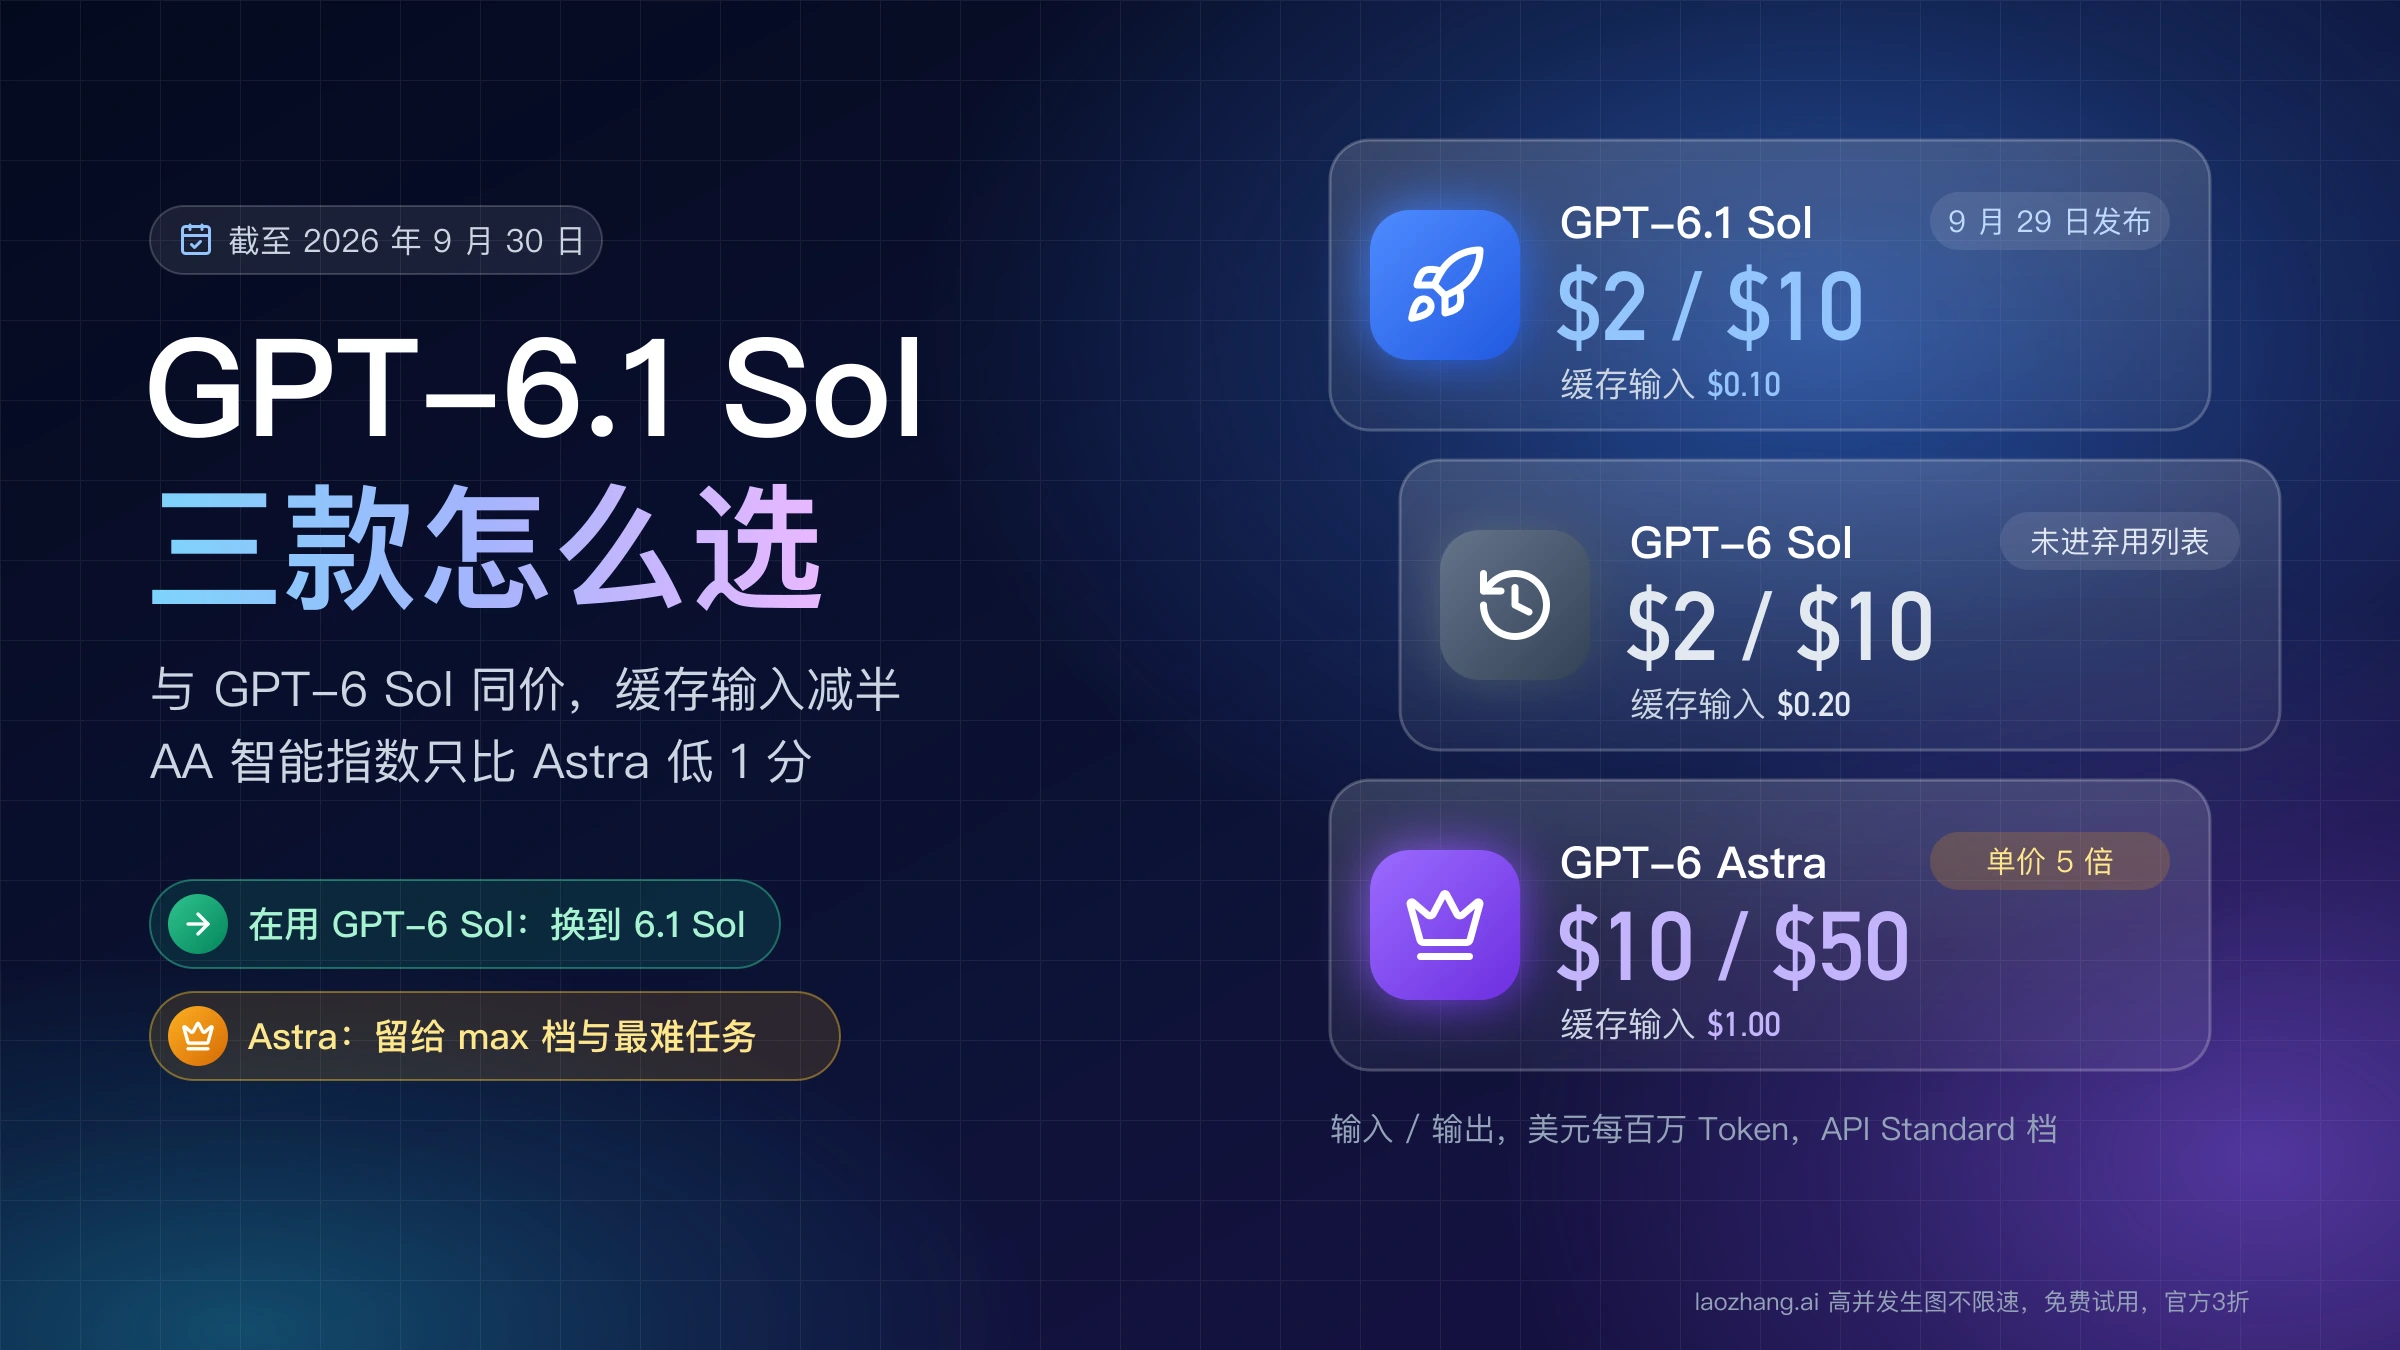
V4.1 只有 Flash,K3.1 只有旗舰 Pro。按人民币标价算任务,K3.1 Pro 贵 7.5~27 倍,倍数看 DeepSeek 峰谷时段;AA 指数 55 比 45。
文章目录
2026 年 10 月 24 日实际做过的只有三项:读取 OpenRouter 公开接口里两款模型的端点数据,按 DeepSeek 与 Kimi 的官方价目表复算四种假设任务的费用,读取 laozhang.ai 的模型列表。两款模型没有用同一组题目对跑过,所以下文关于质量的判断只引用 Artificial Analysis(下称 AA)的独立测评和两家厂商自己公布的成绩。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
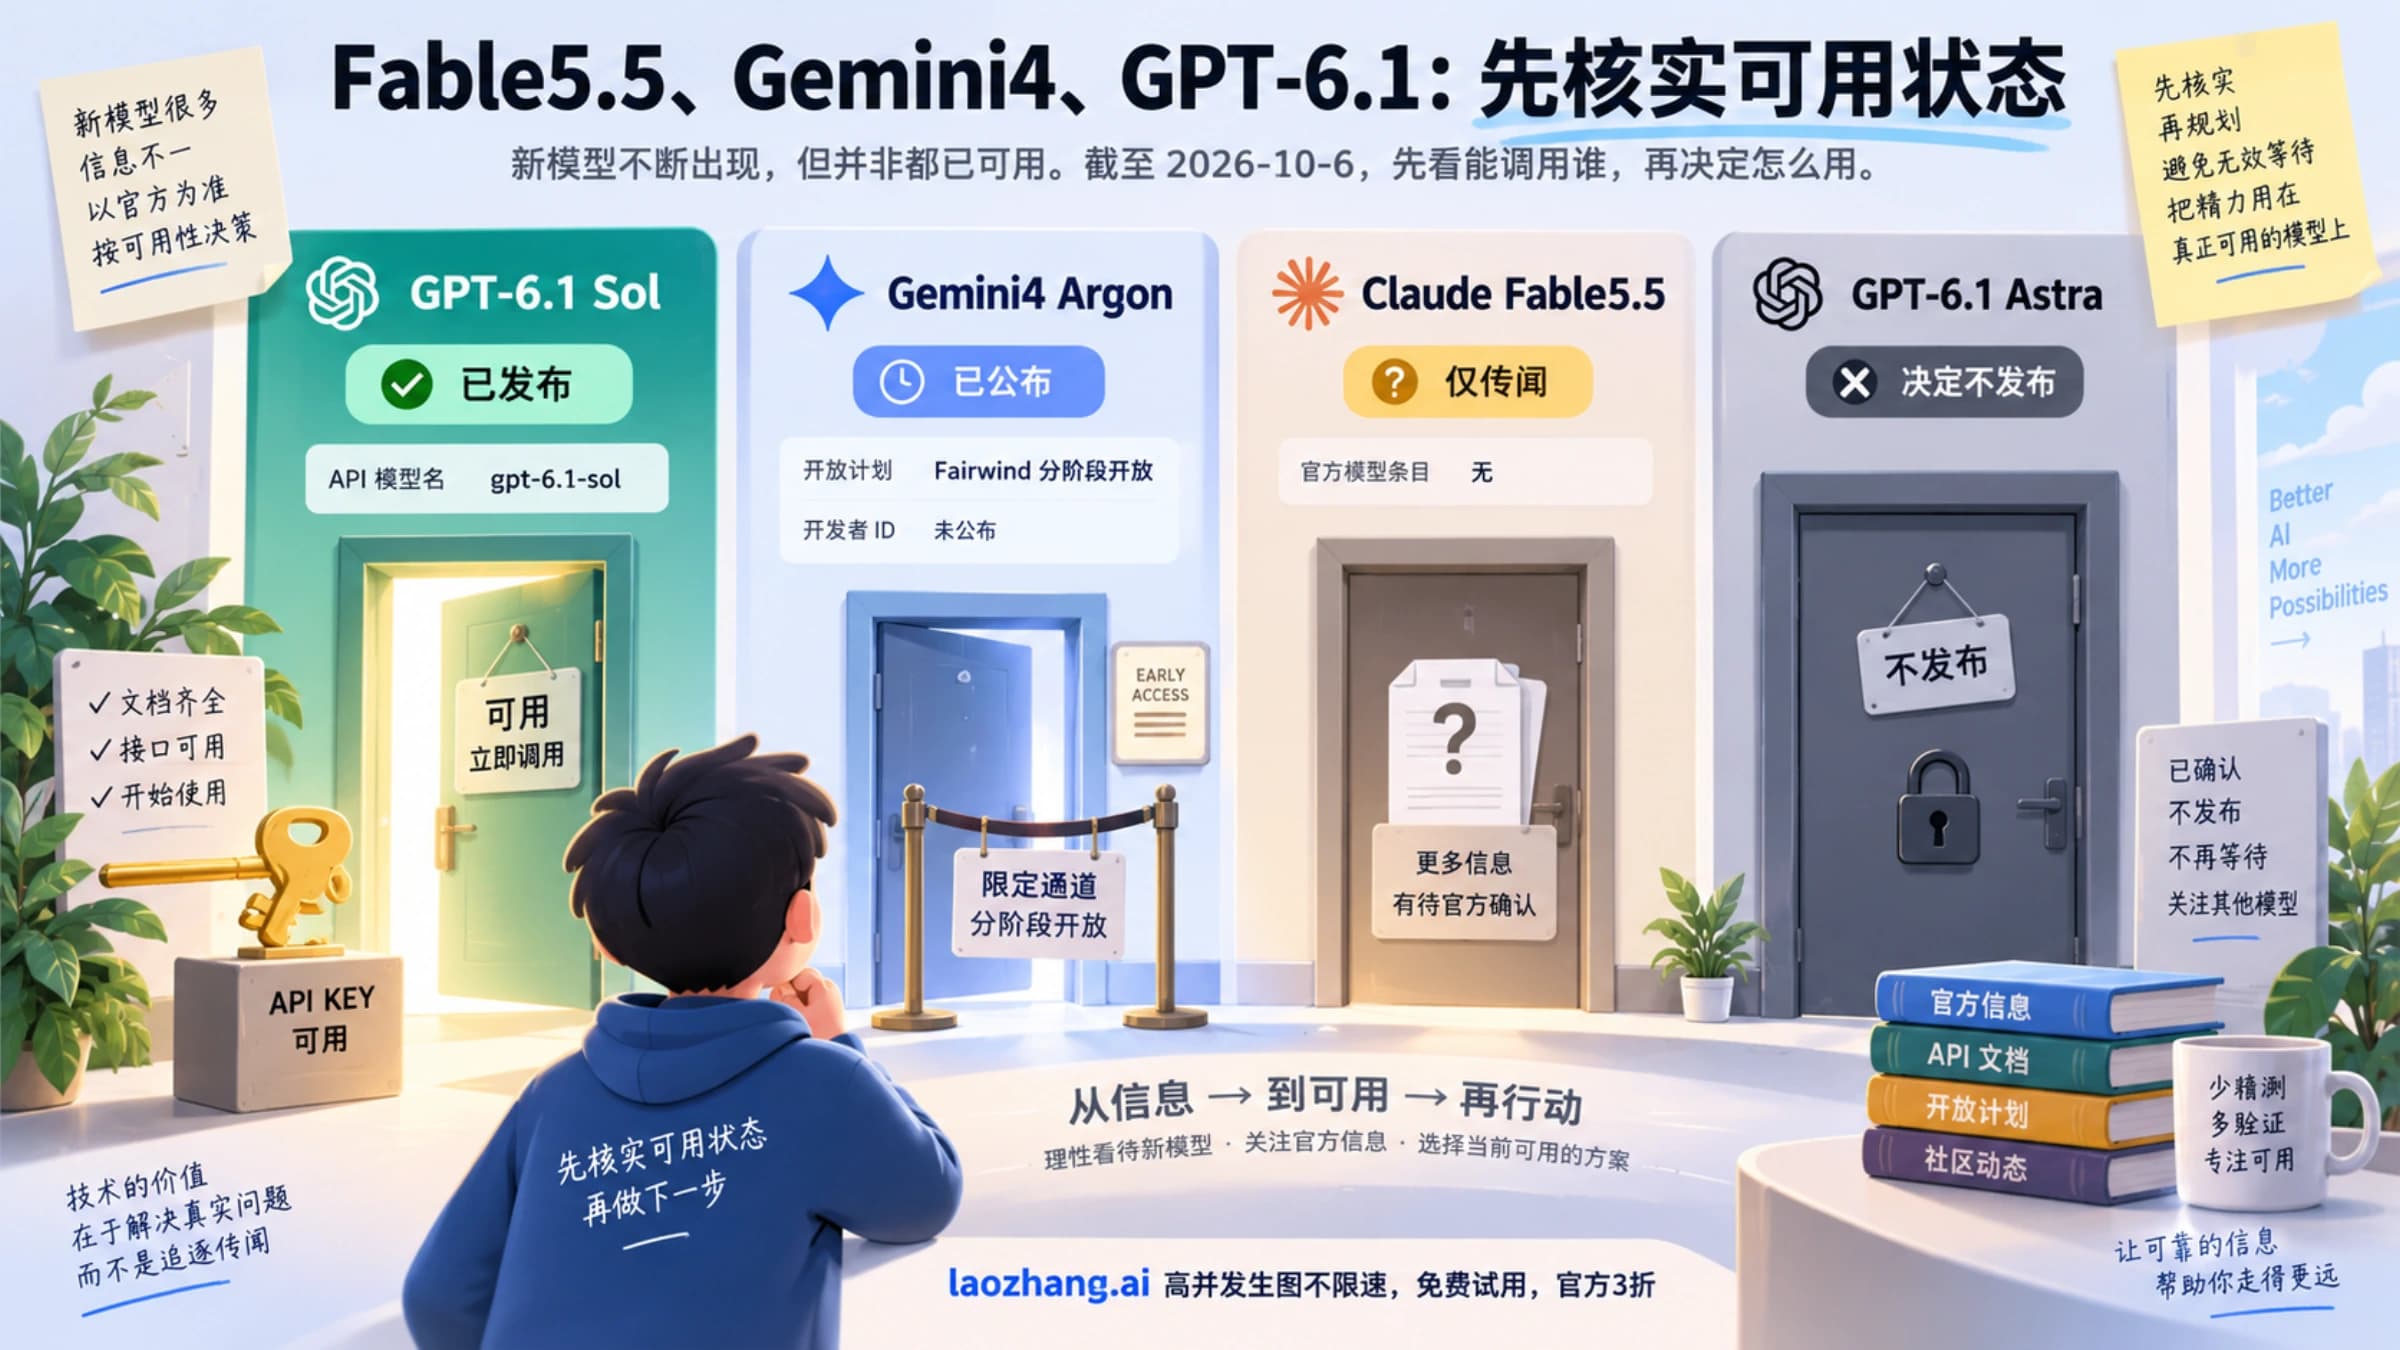
先纠正一个前提:截至 10 月 24 日,“V4.1”只有 DeepSeek 的 Flash 一款,API 模型名是 deepseek-flash,背后是 DeepSeek-V4.1-Flash-1017;“K3.1”只有月之暗面 10 月 23 日发布的旗舰 Kimi K3.1 Pro,模型 ID 是 kimi-k3.1-pro。这不是同档对决,而是 DeepSeek 的小模型对 Kimi 的旗舰,既没有 DeepSeek V4.1 Pro 可调,也没有 Kimi K3.1 的非 Pro 版本。
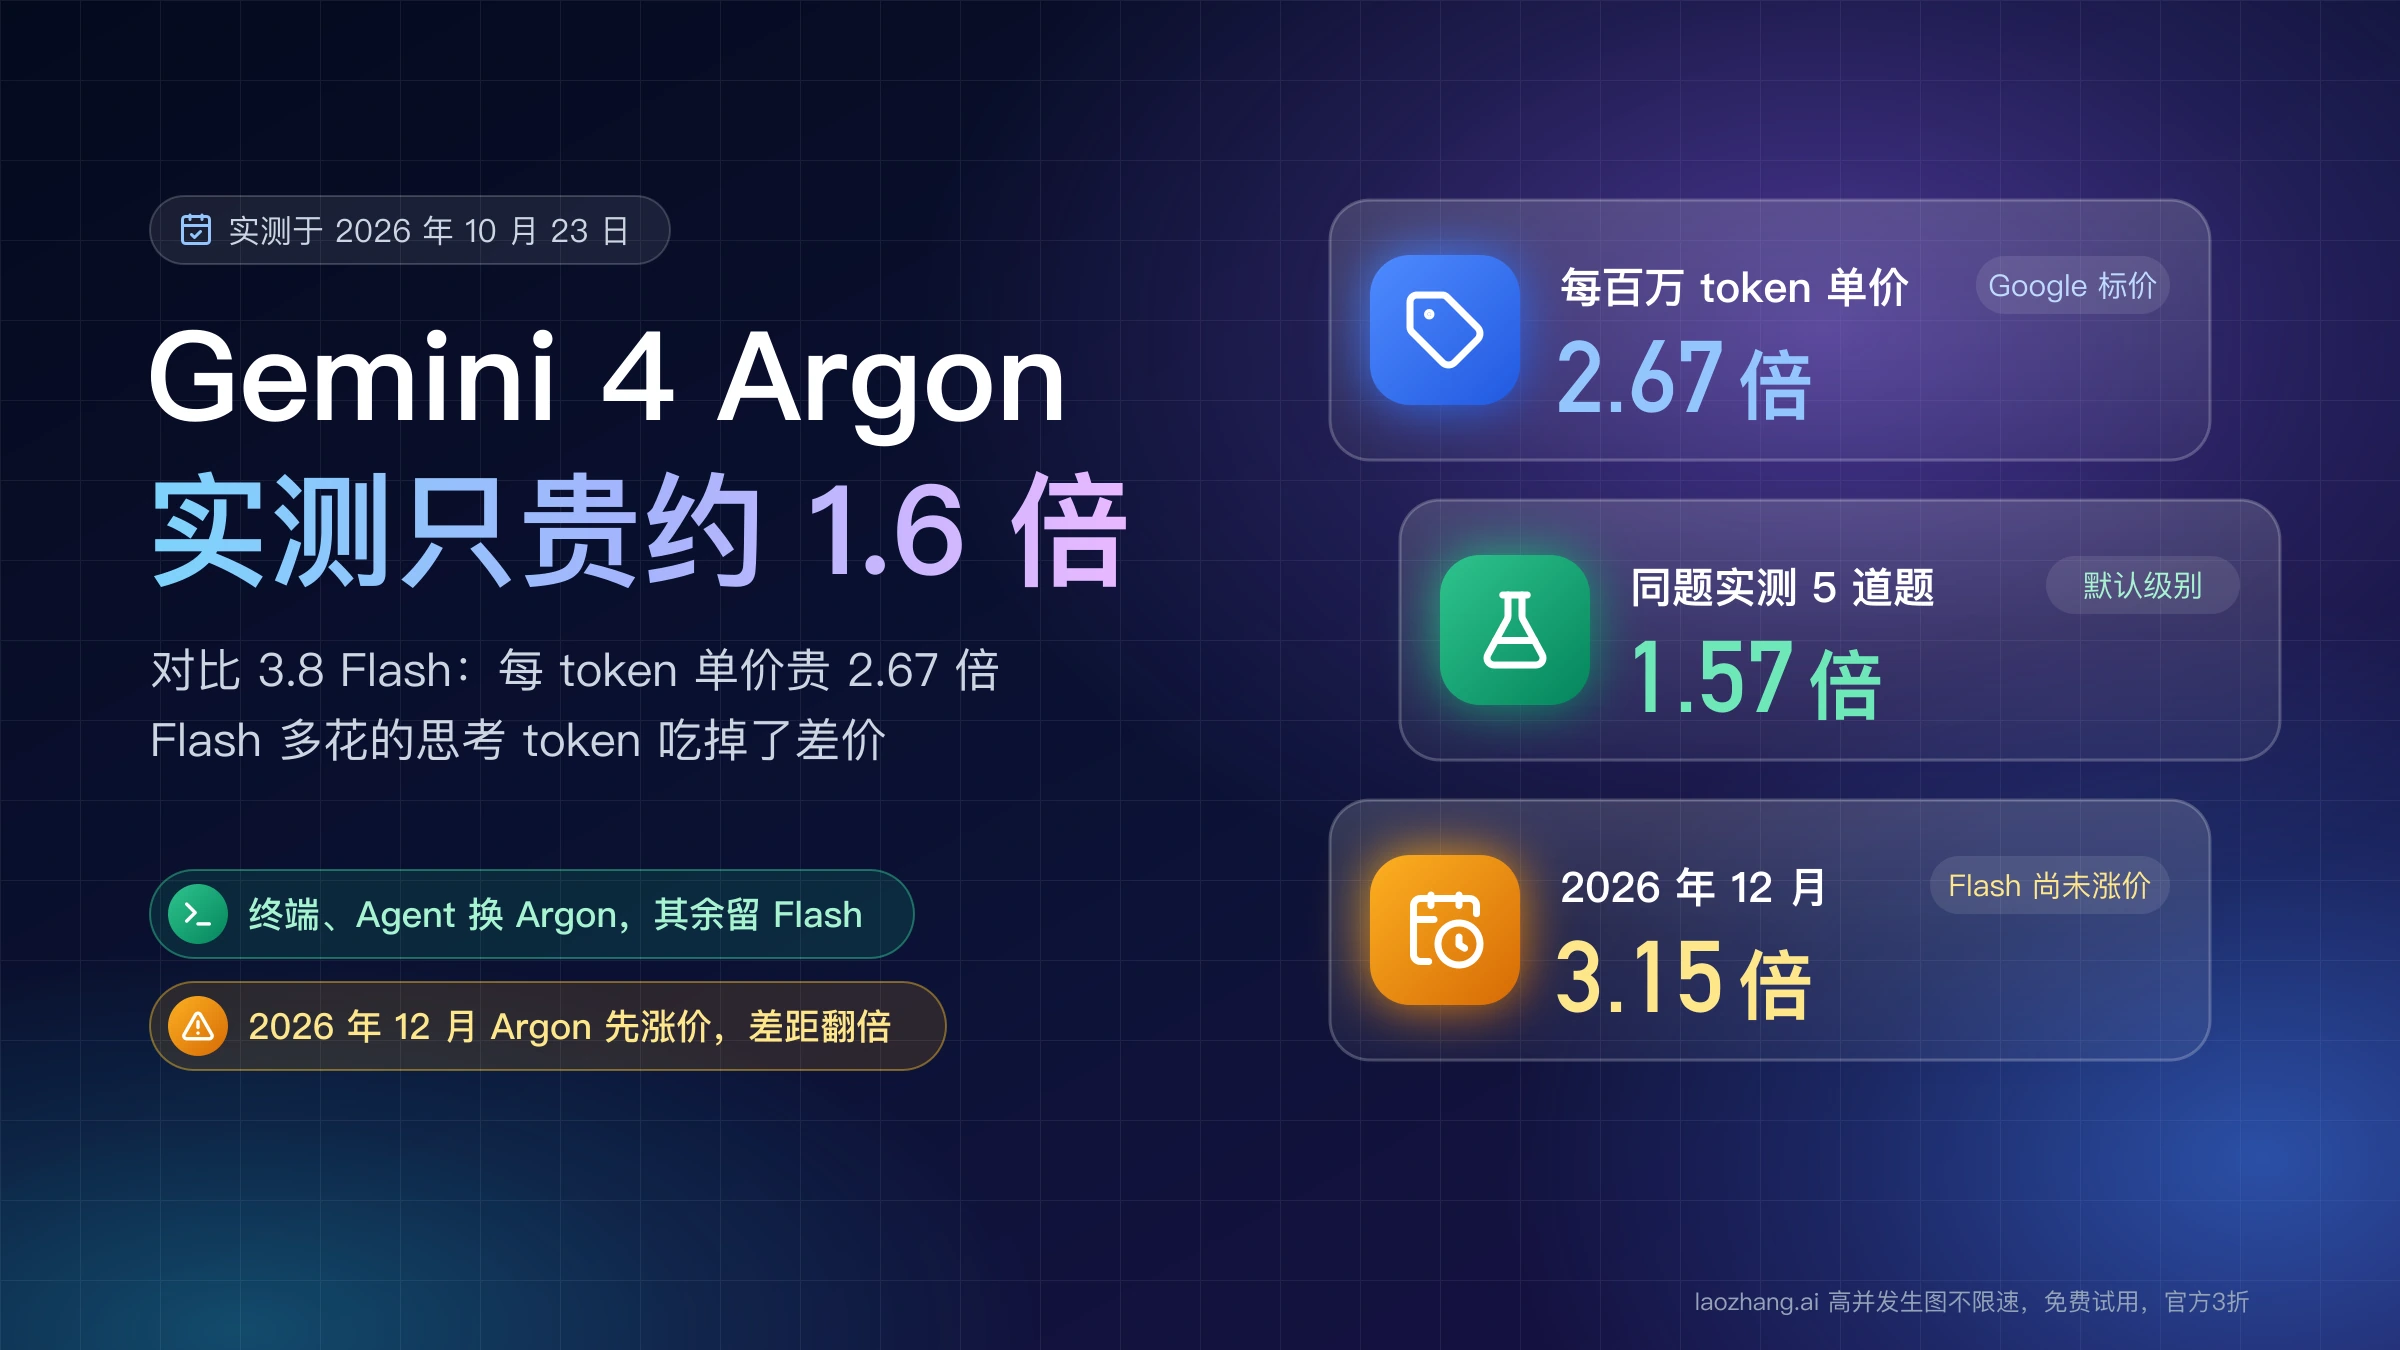
按人民币标价算,同一个任务交给 K3.1 Pro,比 DeepSeek 空闲时段贵 15~27 倍,比北京时间工作日高峰时段贵 7.5~14 倍;AA 智能指数上 K3.1 Pro 是 55 分,V4.1 Flash 是 45 分。所以默认把调用量大的 Agent 循环、长文档问答和批量任务放在 deepseek-flash,只把你自己的任务里 Flash 反复做不好、返工代价又高于这笔差价的那一部分交给 kimi-k3.1-pro。
V4.1 只有 Flash,K3.1 只有 Pro:现在能调用的模型 ID
截至 2026 年 10 月 24 日,DeepSeek API 只有两个模型名:deepseek-flash 对应 DeepSeek-V4.1-Flash-1017,deepseek-v4-pro 对应 DeepSeek-V4-Pro-0813。旧名 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 还能用,但原来的模型已经下线,请求实际由 V4.1-Flash-1017 响应、按 Flash 价格计费,DeepSeek 建议改成 deepseek-flash,见 DeepSeek 中文价格页。所以代码里写的还是 deepseek-v4-flash 的话,你现在用的其实已经是 V4.1 Flash。
V4.1 Flash 是 9 月 10 日发布的,DeepSeek 称它是新架构家族里最小的模型:5,520 亿参数的 MoE,输入侧激活 80 亿、输出侧激活 160 亿参数,原生支持图片理解,权重已在 Hugging Face 开放。10 月 17 日升级为 1017 版,模型名和价格不变,DeepSeek 的说法是成绩更好、输出更短,见 DeepSeek API 更新日志。
想找和 K3.1 Pro 同档的 DeepSeek 模型,现在只有 V4 Pro。它的人民币标价是缓存未命中输入 4.5 元、输出 13.5 元(每百万 tokens,空闲时段,高峰翻倍),不支持图片输入,每账户并发上限 500,Flash 是 2,500。DeepSeek 自己的文档在这里有矛盾:9 月 10 日的新闻页仍写着 9 月 14 日起 deepseek-v4-pro 的请求全部转给 V4.1 Flash,直到 V4.1 Pro 发布;同一天的更新日志则说继续提供 V4 Pro、计费不变,当前价格页也按 Pro 价格列出 V4-Pro-0813。以后者为准,V4 Pro 仍在服务,V4.1 Pro 没有公布日期。
Kimi K3.1 Pro 是 K3.1 系列的第一个模型,月之暗面称它是在 K3 基础上大幅增加强化学习算力后训练出来的,1M 上下文,输入支持文本、图片和视频。它比 K3 便宜:人民币输入从 20 元降到 13 元、输出从 100 元降到 68 元(每百万 tokens)。同时上线的高速版是另一个模型 ID kimi-k3.1-pro-highspeed,不是开关,价格翻倍。完整权重要到 11 月 4 日前才发布,AA 目前把它标为闭源模型,所以现在还不能把 K3.1 Pro 当开源模型自己部署,见 Kimi 开放平台 K3.1 Pro 介绍。
按任务算账:K3.1 Pro 贵 15~27 倍,高峰时段 7.5~14 倍
按 DeepSeek 空闲时段算,两家单价差 13~65 倍,整笔差多少取决于你的请求里哪一项占得多。下表是 2026 年 10 月 24 日两家人民币价目表上的单价(每百万 tokens),来自 DeepSeek 中文价格页 与 Kimi 开放平台模型定价页。
| 计费项 | Kimi K3.1 Pro | V4.1 Flash 空闲时段 | V4.1 Flash 高峰时段 | 倍数(对空闲时段) |
|---|---|---|---|---|
| 输入,缓存未命中 | 13 元 | 1 元 | 2 元 | 13 倍 |
| 输入,缓存命中 | 1.30 元 | 0.02 元 | 0.04 元 | 65 倍 |
| 输出 | 68 元 | 4 元 | 8 元 | 17 倍 |
| 缓存写入(5min) | 13 元 | 无此项 | 无此项 | — |
| 缓存写入(1h) | 26 元 | 无此项 | 无此项 | — |
缓存命中差得最多,所以反复带着同一段长前缀的任务,差距会比单次请求大。为了看清这一点,2026 年 10 月 24 日按上面的人民币单价复算了四种任务。token 数是为说明缓存行为而设的假设,不是实测流量;两款模型都默认思考,表里的输出 token 包含思考部分。Kimi 价格页没有写思考 token 是否按输出计费,这里按输出算。
| 任务(假设的 token 数) | Kimi K3.1 Pro | V4.1 Flash 空闲 | V4.1 Flash 高峰 | 倍数(空闲 / 高峰) |
|---|---|---|---|---|
| A 编码 Agent 会话:60K 仓库与系统前缀,40 轮,每轮新输入 4K、输出 3K | 14.06 元 | 0.75 元 | 1.49 元 | 18.8 / 9.4 |
| B 长文档问答:400K 文档,5 分钟内问 10 个问题,每问新输入 300、输出 1,500 | 10.94 元 | 0.54 元 | 1.07 元 | 20.4 / 10.2 |
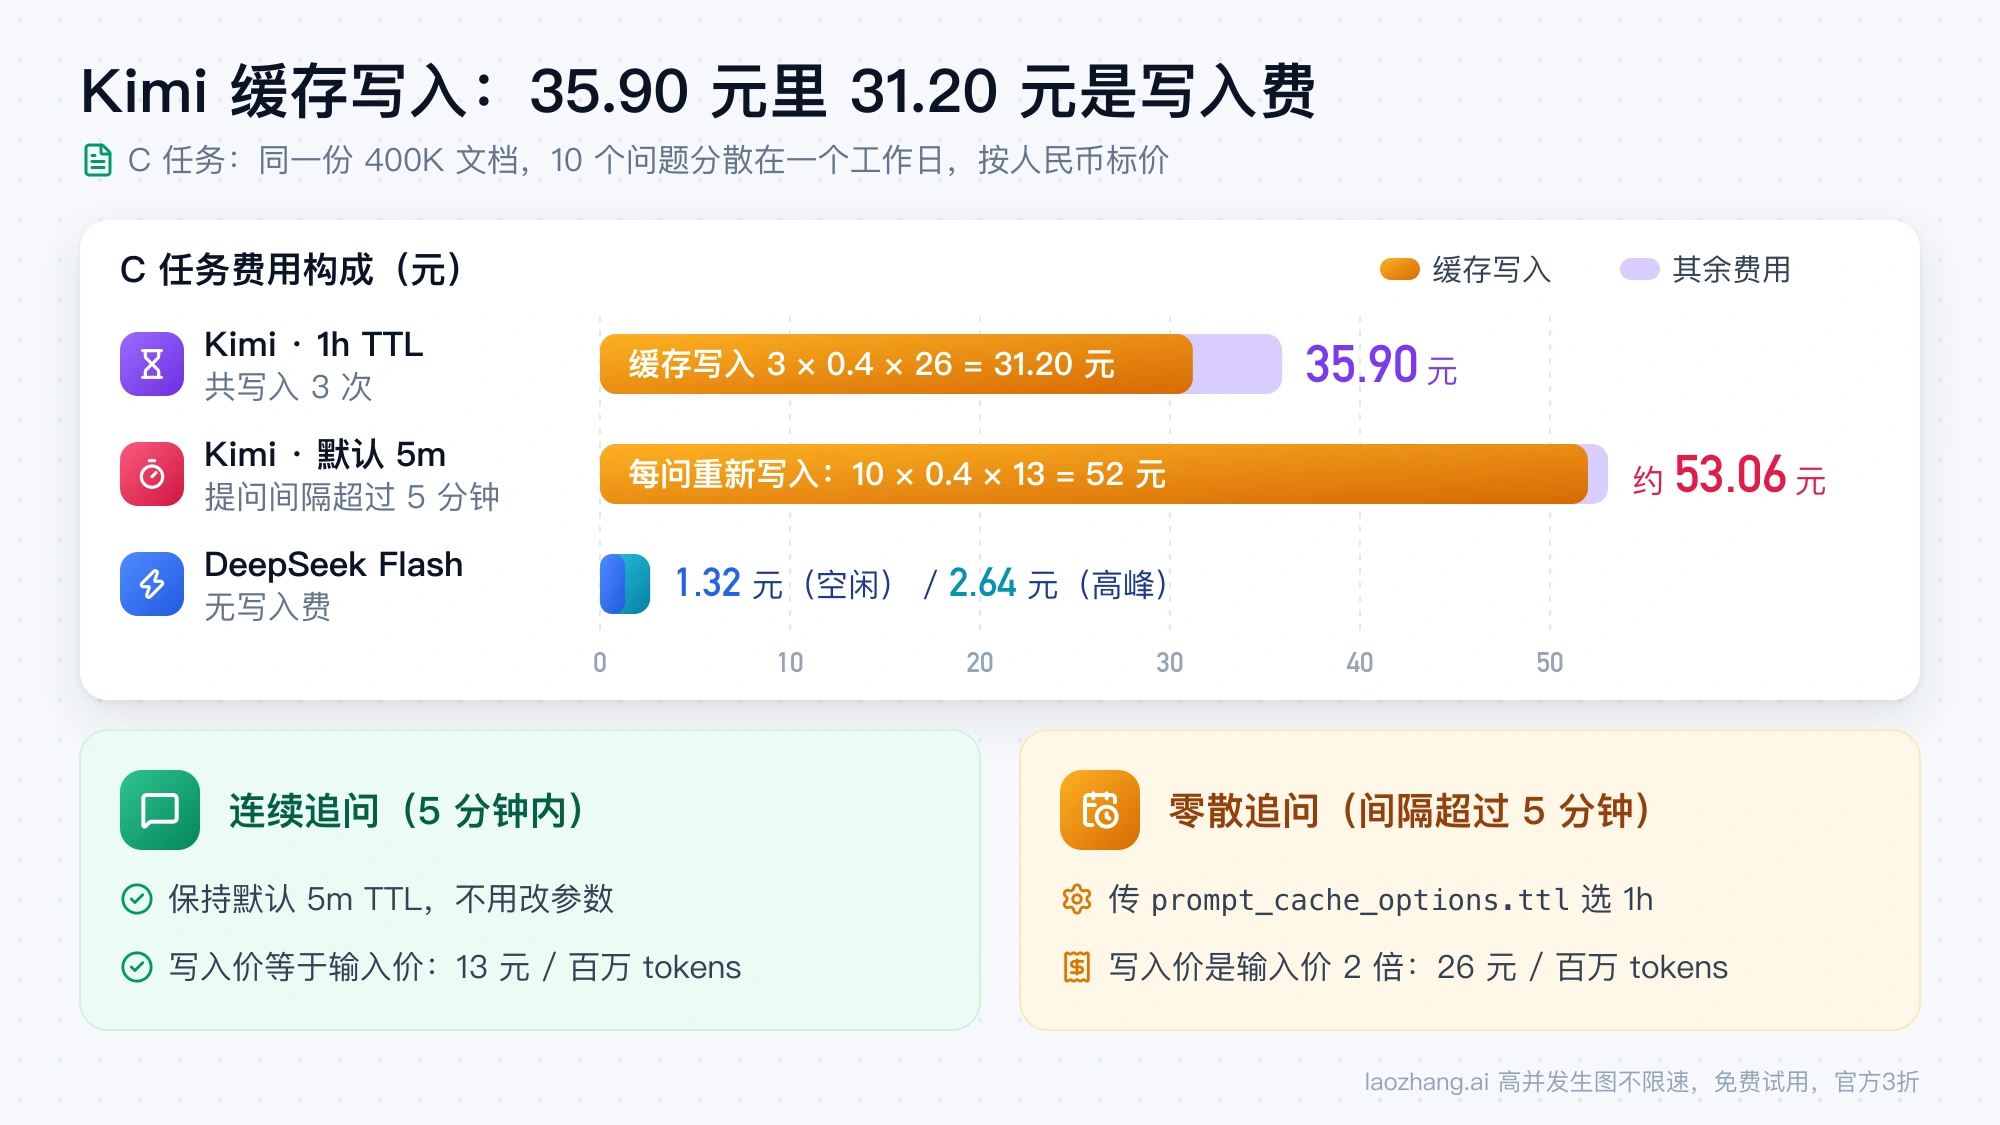
| C 同一份文档,10 个问题分散在一个工作日:Kimi 用 1h TTL,中途重写 2 次缓存;DeepSeek 同样按 2 次重新未命中算 | 35.90 元 | 1.32 元 | 2.64 元 | 27.2 / 13.6 |
| D 单次冷请求:输入 8K、输出 2K,没有缓存 | 0.24 元 | 0.016 元 | 0.032 元 | 15 / 7.5 |
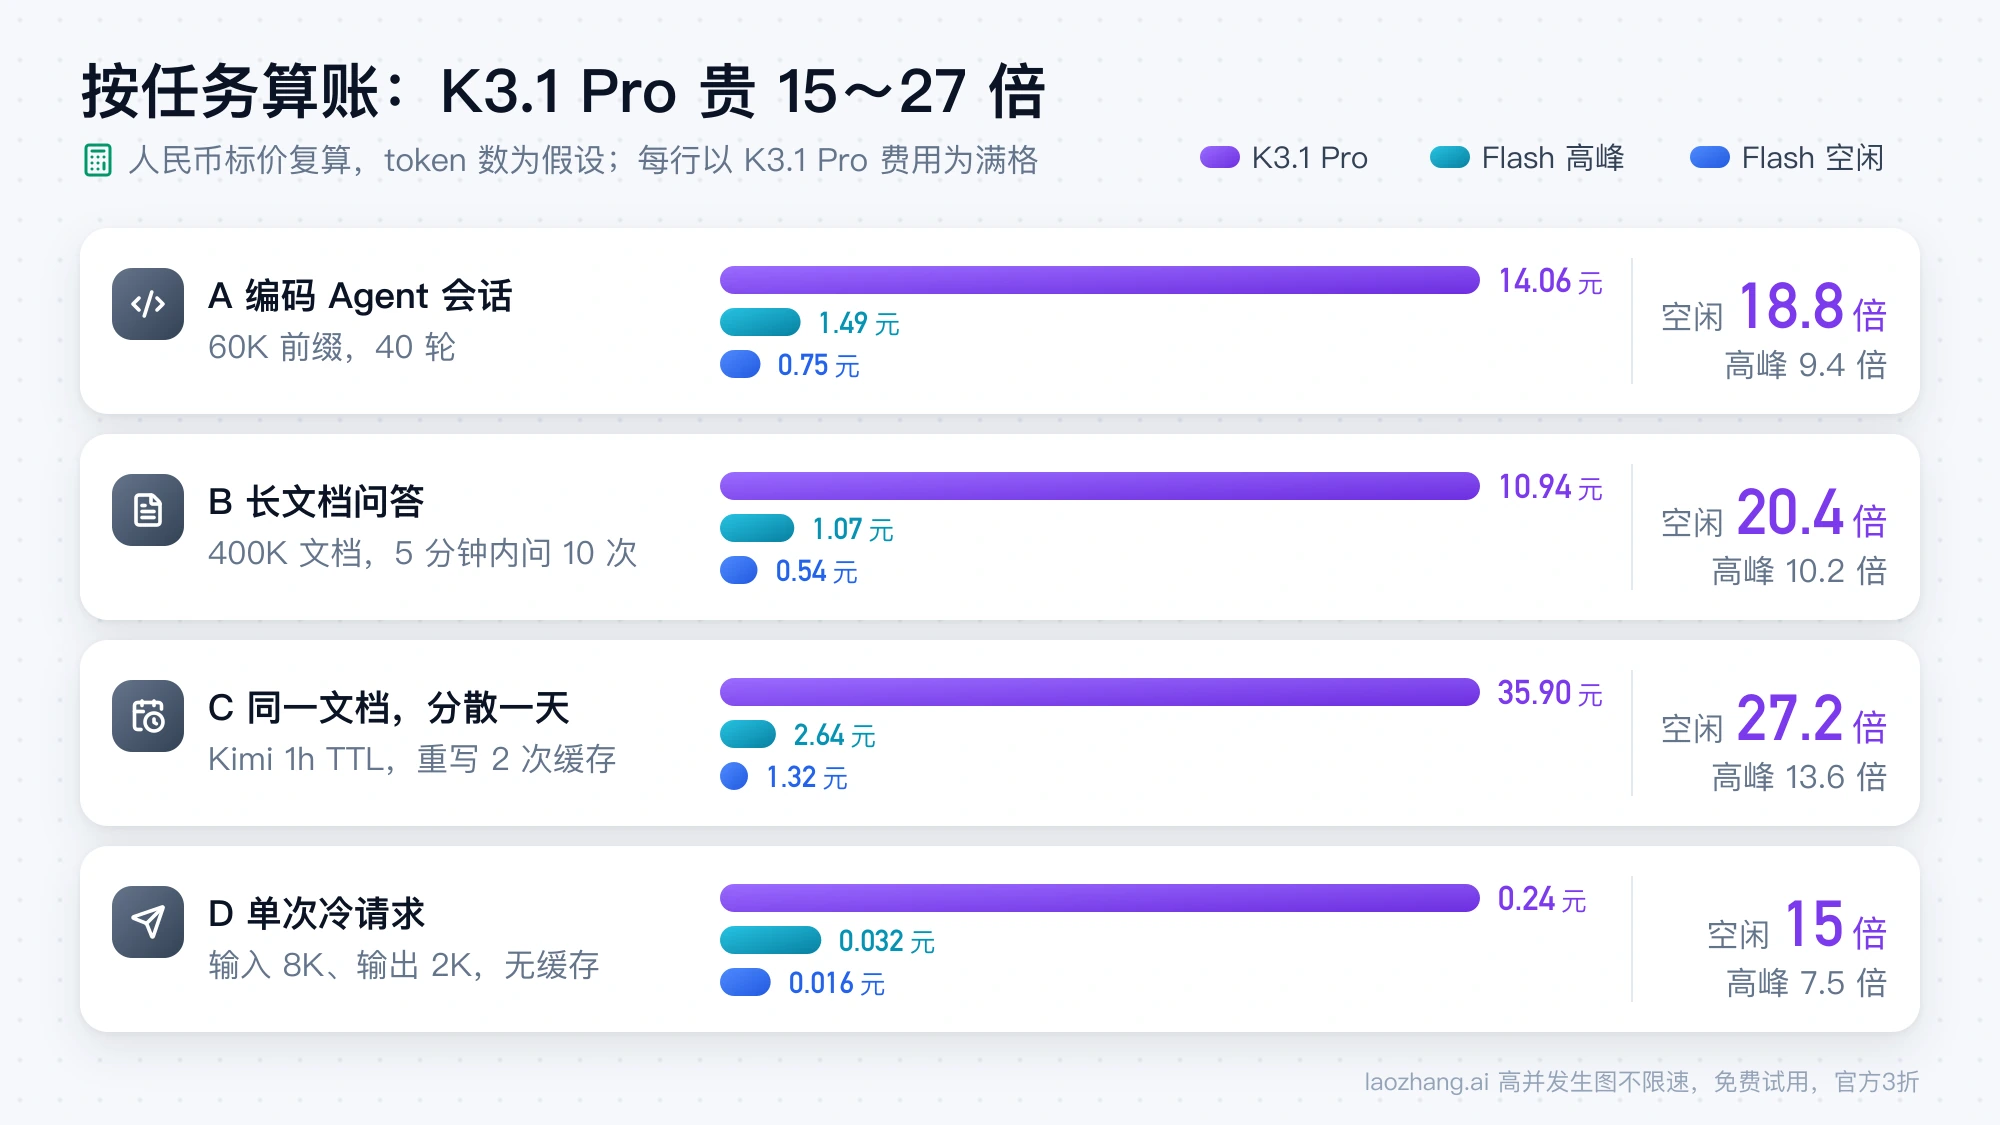
以 A 为例,把 token 数换算成百万再乘单价。Kimi K3.1 Pro:第一轮把 60K 前缀写入 5min 缓存,0.06 × 13 = 0.78 元;其余 39 轮命中缓存,39 × 0.06 × 1.30 = 3.04 元;新输入 40 × 0.004 × 13 = 2.08 元;输出 40 × 0.003 × 68 = 8.16 元;合计 14.06 元。DeepSeek 空闲时段没有写入费,第一轮前缀按未命中算 0.06 元,其余 39 轮命中 0.05 元,新输入 0.16 元,输出 0.48 元,合计 0.75 元。改用两家的美元价目表算,倍数基本一致,A 是 18.8 倍,C 是 27.9 倍。
这张表有三处简化:DeepSeek 没有公布缓存能保留多久,C 只能给它同样的 2 次重新未命中;Kimi 的缓存按块存储,不满一整块的部分按未命中计费,表里没有扣除;两款模型实际写出的思考长度不同,下一节会讲它怎么影响结果。
什么情况下倍数会变:高峰时段、Kimi 缓存写入、思考长度
第一个变量是调用时间。DeepSeek 在北京时间周一至周五(不含法定节假日)9:00–12:00、14:00–18:00 按高峰价收费,其余时段半价,Kimi 不分时段。国内团队上班时间里的交互式调用基本都落在高峰时段,应该看上表的高峰列;只有能挪到晚上和周末跑的批任务,才对应空闲列的倍数。怎么把批任务排到空闲时段,可以看 DeepSeek API 峰谷价格:几点调用更省、账单怎么算。
第二个变量是 Kimi 的缓存写入。Kimi 自动缓存重复的请求前缀,但写入要单独付费:默认 TTL 是 5 分钟,写入价等于输入价;用 prompt_cache_options.ttl 选 1 小时,写入价是输入价的 2 倍,即 26 元每百万 tokens。C 任务里三次写入 400K 前缀是 3 × 0.4 × 26 = 31.20 元,占了 35.90 元的大头。如果这份文档的提问间隔超过 5 分钟又没改 TTL,每问都会重新写入,10 次写入就是 10 × 0.4 × 13 = 52 元,加上新输入和输出约 53.06 元。所以零散追问长文档时要传 1h TTL,连续追问保持默认 5m 即可。DeepSeek 的价目表没有写入这一项,前缀第一次发送按未命中计费。
第三个变量是思考长度。K3.1 Pro 始终开启思考,reasoning_effort 默认 max;DeepSeek 默认开启、默认 high,也可以关掉。默认设置下 Kimi 想得更深,但这不等于它一定写出更多 token:AA 跑智能指数时,V4.1 Flash(Max 档)共输出 2.1 亿个 token,K3.1 Pro 是 1.5 亿个,Flash 反而多写了 40%,每道题的成本仍是 0.26 美元对 2.11 美元,约 8.1 倍。AA 页面上列的 DeepSeek 价格是高峰价,这个 8 倍落在上表高峰列的范围里。到了你的任务上,思考长度最好直接从响应的 token 用量里读。
K3.1 Pro 比 V4.1 Flash 强多少:AA 指数 55 比 45
能放在同一把尺子上比的只有 AA。截至 2026 年 10 月 24 日,AA 智能指数 v4.3.2(10 项评测的综合分)里,Kimi K3.1 Pro 得 55 分,在 215 个模型中排第 4;DeepSeek V4.1 Flash 1017 的 Max 档得 45 分,在 121 个开放权重模型中排第 2。两个名次来自不同的比较池,真正可比的是 10 分的差距。速度上 Flash 每秒输出约 198 个 token,K3.1 Pro 约 81 个。K3.1 Pro 发布才一天,AA 的数字在头几天可能修订。
10 分是综合分上实打实的差距,但要用约 8 倍的单题成本、不到一半的输出速度去换。这笔交换值不值,取决于失败的代价:一次失败要人工返工半天的任务,8 倍的 API 费用可能微不足道;每天几千次、错了能自动重试的调用,Flash 的成本和速度优势更实在。
两家厂商自己的成绩不能拿来正面对比。DeepSeek 公布 V4.1-Flash-1017 在 Terminal-Bench 4.0 上得 42.3,注明用的是 Claude Code 框架;Kimi 中文页写 K3.1 Pro 在同一测试上得 65.7%,没有说明框架,框架不同的分数相减没有意义。Kimi 的中英文页面本身也不一致:10 月 24 日英文页的 Terminal-Bench 4.0 分数还是“[xx.x%]”占位符,金融基准的提升幅度中文页写“提高 14%”“提升 20%”,英文页写的是 7.2 和 11.6 个百分点。这些只能当方向参考。
中文长文写作哪个更顺,目前也没有可比的数据:AA 智能指数和两家厂商公布的成绩里,都没有单独的中文写作分数。如果你主要用它写中文长文,就把几篇真实的写作任务放进下文的自测题里,按自己的验收标准比,比如结构是否完整、事实有没有出错、要改几遍才能用。
和 K3 相比,Kimi 公布的改进主要有两项:内部的 Kimi Code Bench 3.0 Long-horizon 从 55.95% 升到 61.2%;在一组刻意挑选易错情形的事实准确性压力测试里,单项事实陈述错误率从 23.35% 降到 6.85%,Kimi 注明这个错误率不代表日常使用的整体水平。
两个一起用:Kimi K3.1 Pro 做规划,DeepSeek 做执行
可以分工,前提是按调用频率和失败代价来分,而不是按“谁更聪明”。按上面 A 任务的算法,一次 K3.1 Pro 会话的钱够跑约 19 次 Flash 空闲时段会话,所以把一个任务里调用次数少、出错代价大的环节交给 K3.1 Pro,比如大改动开工前的方案、交付前的最终审查、Flash 连续两次没修好的问题,其余高频的读文件、改代码、跑测试循环留在 deepseek-flash,总费用增加有限,最难的那几步又能用上更强的模型。
实现上,两边不要共用一份消息历史。DeepSeek 在带 tools 的多轮里要求回传之前每轮的 reasoning_content,Kimi 要求原样回传完整的 assistant message,两种格式混在一份历史里很容易让其中一边报错。更稳的做法是让 K3.1 Pro 用结构化输出(json_schema 加 strict: true)给出计划,只解析 content,再把计划当作一条普通的 user 消息交给 DeepSeek。还要算上缓存:每换一次模型,对方那边的前缀都要重新缓存,在 Kimi 上这意味着又一笔写入费,规划调用之间隔得久的话,用 1h TTL。
从 DeepSeek 换到 Kimi K3.1 Pro,代码要改哪些地方
两家都兼容 OpenAI SDK,换模型名和 Base URL 就能发出第一个请求,但真正容易出问题的是思考模式、采样参数、多轮历史和图片输入这四处。下表按 2026 年 10 月 24 日的 DeepSeek 价格页、DeepSeek 思考模式文档 和 Kimi K3.1 Pro 快速开始 整理。
| 项目 | DeepSeek V4.1 Flash | Kimi K3.1 Pro |
|---|---|---|
| 模型名 | deepseek-flash;旧名 deepseek-v4-flash 仍可用 | kimi-k3.1-pro;高速版 kimi-k3.1-pro-highspeed |
| Base URL | https://api.deepseek.com;Anthropic 格式用 https://api.deepseek.com/anthropic | 国内站 https://api.moonshot.cn/v1;国际站 https://api.moonshot.ai/v1 |
| 思考模式 | 默认开启,可用 {"thinking":{"type":"disabled"}} 关闭 | 始终开启,不能关闭 |
reasoning_effort | low、high、max,默认 high | low、high、max,默认 max |
| 采样参数 | 思考模式下 temperature、presence_penalty、frequency_penalty 不生效也不报错 | temperature=1.0、top_p=0.95、n=1、两个 penalty 为 0,都是固定值,建议不传 |
| 多轮与工具调用 | 带 tools 时必须回传之前每轮的 reasoning_content,否则返回 400 | 原样回传完整 assistant message,不能只保留 content |
| 最大输出 | 384K | max_completion_tokens 默认 131072,最大 1048576 |
| 上下文 | 1M | 1M |
| 图片输入 | 支持 | 支持图片和视频;不接受公网图片 URL,要用 base64 或 ms://<file-id>,content 必须是数组 |
| 结构化输出 | JSON Output | json_schema 加 strict: true |
| 上下文缓存 | 自动,没有写入费,没有 TTL 选项 | 自动,写入按 TTL 计费,默认 5m,可选 1h |
| 计价方式 | 分高峰、空闲时段 | 统一价,不分时段,也不按上下文长度分段 |
| 并发与限速 | 每账户并发 2,500 | 按累计充值的账户等级决定并发、RPM、TPM、TPD |
| 联网搜索 | Search、Fetch API 各按每 1,000 次成功请求 5 元收费 | 官方联网搜索工具正在更新,近期不建议用于生产 |
改代码时最容易漏的是采样参数和历史回传。原来给 DeepSeek 传了 temperature 的代码不会报错,只是参数不生效;搬到 Kimi 时应该把这些参数整组删掉。2026 年 10 月 24 日读到的 OpenRouter 接口数据也印证了这一点:moonshotai/kimi-k3.1-pro 的端点支持参数里没有 temperature、top_p、seed 和 logprobs。另一个是图片:习惯直接传图片链接的代码,在 Kimi 上要先转成 base64 或上传成文件再引用。
国内开通 Kimi K3.1 Pro:最低充值 10 元,15 元代金券不能用
K3.1 Pro 是旗舰模型,在国内站 Kimi 开放平台完成至少 10 元的充值后才会解锁;国内注册并完成认证的新用户获赠的 15 元代金券不能用于 K3.1 Pro。所以想先试一下,也得实际充值,代金券只能留给其他模型。国际站 platform.kimi.ai 的门槛是至少充值 1 美元。
累计充值金额还决定账户等级,并发、RPM、TPM、TPD 都随等级提高,具体额度见 Kimi 开放平台的充值与限速页。要跑高并发的 Agent 任务,充值额要按限速档位来定,不只是够付账单。另外,开放平台只有按量计费,Kimi 明确说它和 Kimi 会员、Kimi Code 是不同的产品,API 调用要在开放平台单独付费。
第三方渠道:K3.1 Pro 只有 Moonshot 一家,V4.1 Flash 有 29 家
2026 年 10 月 24 日读取 OpenRouter 的公开接口,moonshotai/kimi-k3.1-pro 只有 2 个端点,都由 Moonshot AI 提供:一个是标准版,每百万 tokens 输入 2 美元、输出 10 美元,另一个是高速版,价格翻倍;上下文 1,048,576,单次最多输出 943,718 个 token。deepseek/deepseek-v4.1-flash-1017 则有 29 家提供方的 34 个端点,包括 DeepSeek 自己,量化方式有 fp4、fp8、mxfp4 和未标注几种,单次最大输出从 131,072 到 943,718 不等。
这意味着 K3.1 Pro 现在只有一个供应方,Moonshot 限速或故障时没有别家可以切换;等 11 月 4 日前权重发布,提供方可能会增加。V4.1 Flash 是开放权重,渠道多,但第三方的量化精度和输出上限各不相同,接入某一家之前,先看它的量化方式和最大输出,别默认它和 DeepSeek 官方一样。
同一天 laozhang.ai 的模型列表(/v1/models)里有 kimi-k3、kimi-k2.7-code、kimi-k2.6、kimi-k2.5、deepseek-v4-flash、deepseek-v4-flash-vision-exp、deepseek-v4-pro 和 deepseek-v3.2,还没有 kimi-k3.1-pro 和 deepseek-flash。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
换模型之前,用自己的 20~30 个任务测一遍
AA 的分数和上面的成本表都不是你的任务。决定迁不迁之前,用自己的任务按下面的顺序做一次小测试,K3.1 Pro 部分需要先在 Kimi 开放平台充值。
- 从日志里挑 20~30 个真实任务,覆盖你最常见的任务形态,给每个任务写好验收标准,比如测试通过、字段正确、引用能核对。按 A 类会话约 14 元一次算,30 次 K3.1 Pro 会话约 420 元,预算紧就先用短任务筛一遍。
- 两边先都用默认推理强度跑一轮,也就是 Kimi 的
max、DeepSeek 的high;再把 DeepSeek 调到max跑一轮,看 Flash 开满之后的差距还剩多少。 - 每次调用记录响应里的 token 用量,分开记缓存命中、未命中和输出,按各自价目表算出费用;DeepSeek 的调用还要记下是高峰还是空闲时段。
- 统计每个模型通过验收的任务数和每个通过任务的平均费用,按完成一个任务花多少钱比较,不按每百万 tokens 的单价比较。
- 只把 Flash 没通过、K3.1 Pro 通过的那一类任务迁过去,隔一两天再跑一次,结果稳定再改生产配置。
DeepSeek V4.1 与 Kimi K3.1 的其他问题
在 Claude Code 里用 DeepSeek V4.1 Flash,11 月 1 日以后会多出什么费用?
通过 DeepSeek Harness、Claude Code 或 Codex 使用 DeepSeek API 时,服务端工具会调用 Search 和 Fetch API,目前免费;根据 DeepSeek 中文价格页,从北京时间 2026 年 11 月 1 日 00:00 起按次收费,每 1,000 次成功请求 5 元。在 Claude Code 里接 V4.1 Flash 的配置方法,见 Claude Code 连接 OpenRouter 和 DeepSeek:路线选择、配置与首错排查。
kimi-k3.1-pro-highspeed 值得用吗?
高速版和标准版是两个模型 ID,按 2026 年 10 月 24 日的 Kimi 人民币价目表,高速版输入 26 元、输出 136 元(每百万 tokens),都是标准版的 2 倍,缓存命中同为 1.30 元。Kimi 称两者智能相同,高速版输出速度约为 2~3 倍。只有延迟直接影响体验的交互场景才值得多付这一倍;批任务用标准版即可。
还在用 Kimi K2,要不要现在迁?
根据 Kimi 开放平台定价页的公告,K2 系列从 2026 年 10 月 31 日起不再向新注册用户开放,已注册用户不受影响,所有 K2 模型计划在 2026 年 12 月底下线。K2 老用户年底前必须迁走,可以把 K3.1 Pro 和 V4.1 Flash 一起放进上面的测试里比一遍。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月24日。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月24日。
- 1.DeepSeek 中文价格页api-docs.deepseek.com/zh-cn/quick_start/pricing
- 2.DeepSeek API 更新日志api-docs.deepseek.com/updates
- 3.Kimi 开放平台 K3.1 Pro 介绍platform.kimi.com/docs/guide/kimi-k3-1-pro-quickstart
- 4.Kimi 开放平台模型定价页platform.kimi.com/docs/pricing/chat
- 5.Kimi K3.1 Proartificialanalysis.ai/models/kimi-k3-1-pro
- 6.DeepSeek V4.1 Flash 1017artificialanalysis.ai/models/deepseek-v4-1-flash-1017
- 7.DeepSeek 思考模式文档api-docs.deepseek.com/guides/thinking_mode