Sonnet 5.5 和 Opus 5.5 怎么选:半价未必更省
Sonnet 5.5 单价是 Opus 5.5 的一半,但缓存读取同价,max 档下单任务可能更贵。范围清楚的任务用 Sonnet 配低档,开放式难题先用 Opus。
文章目录
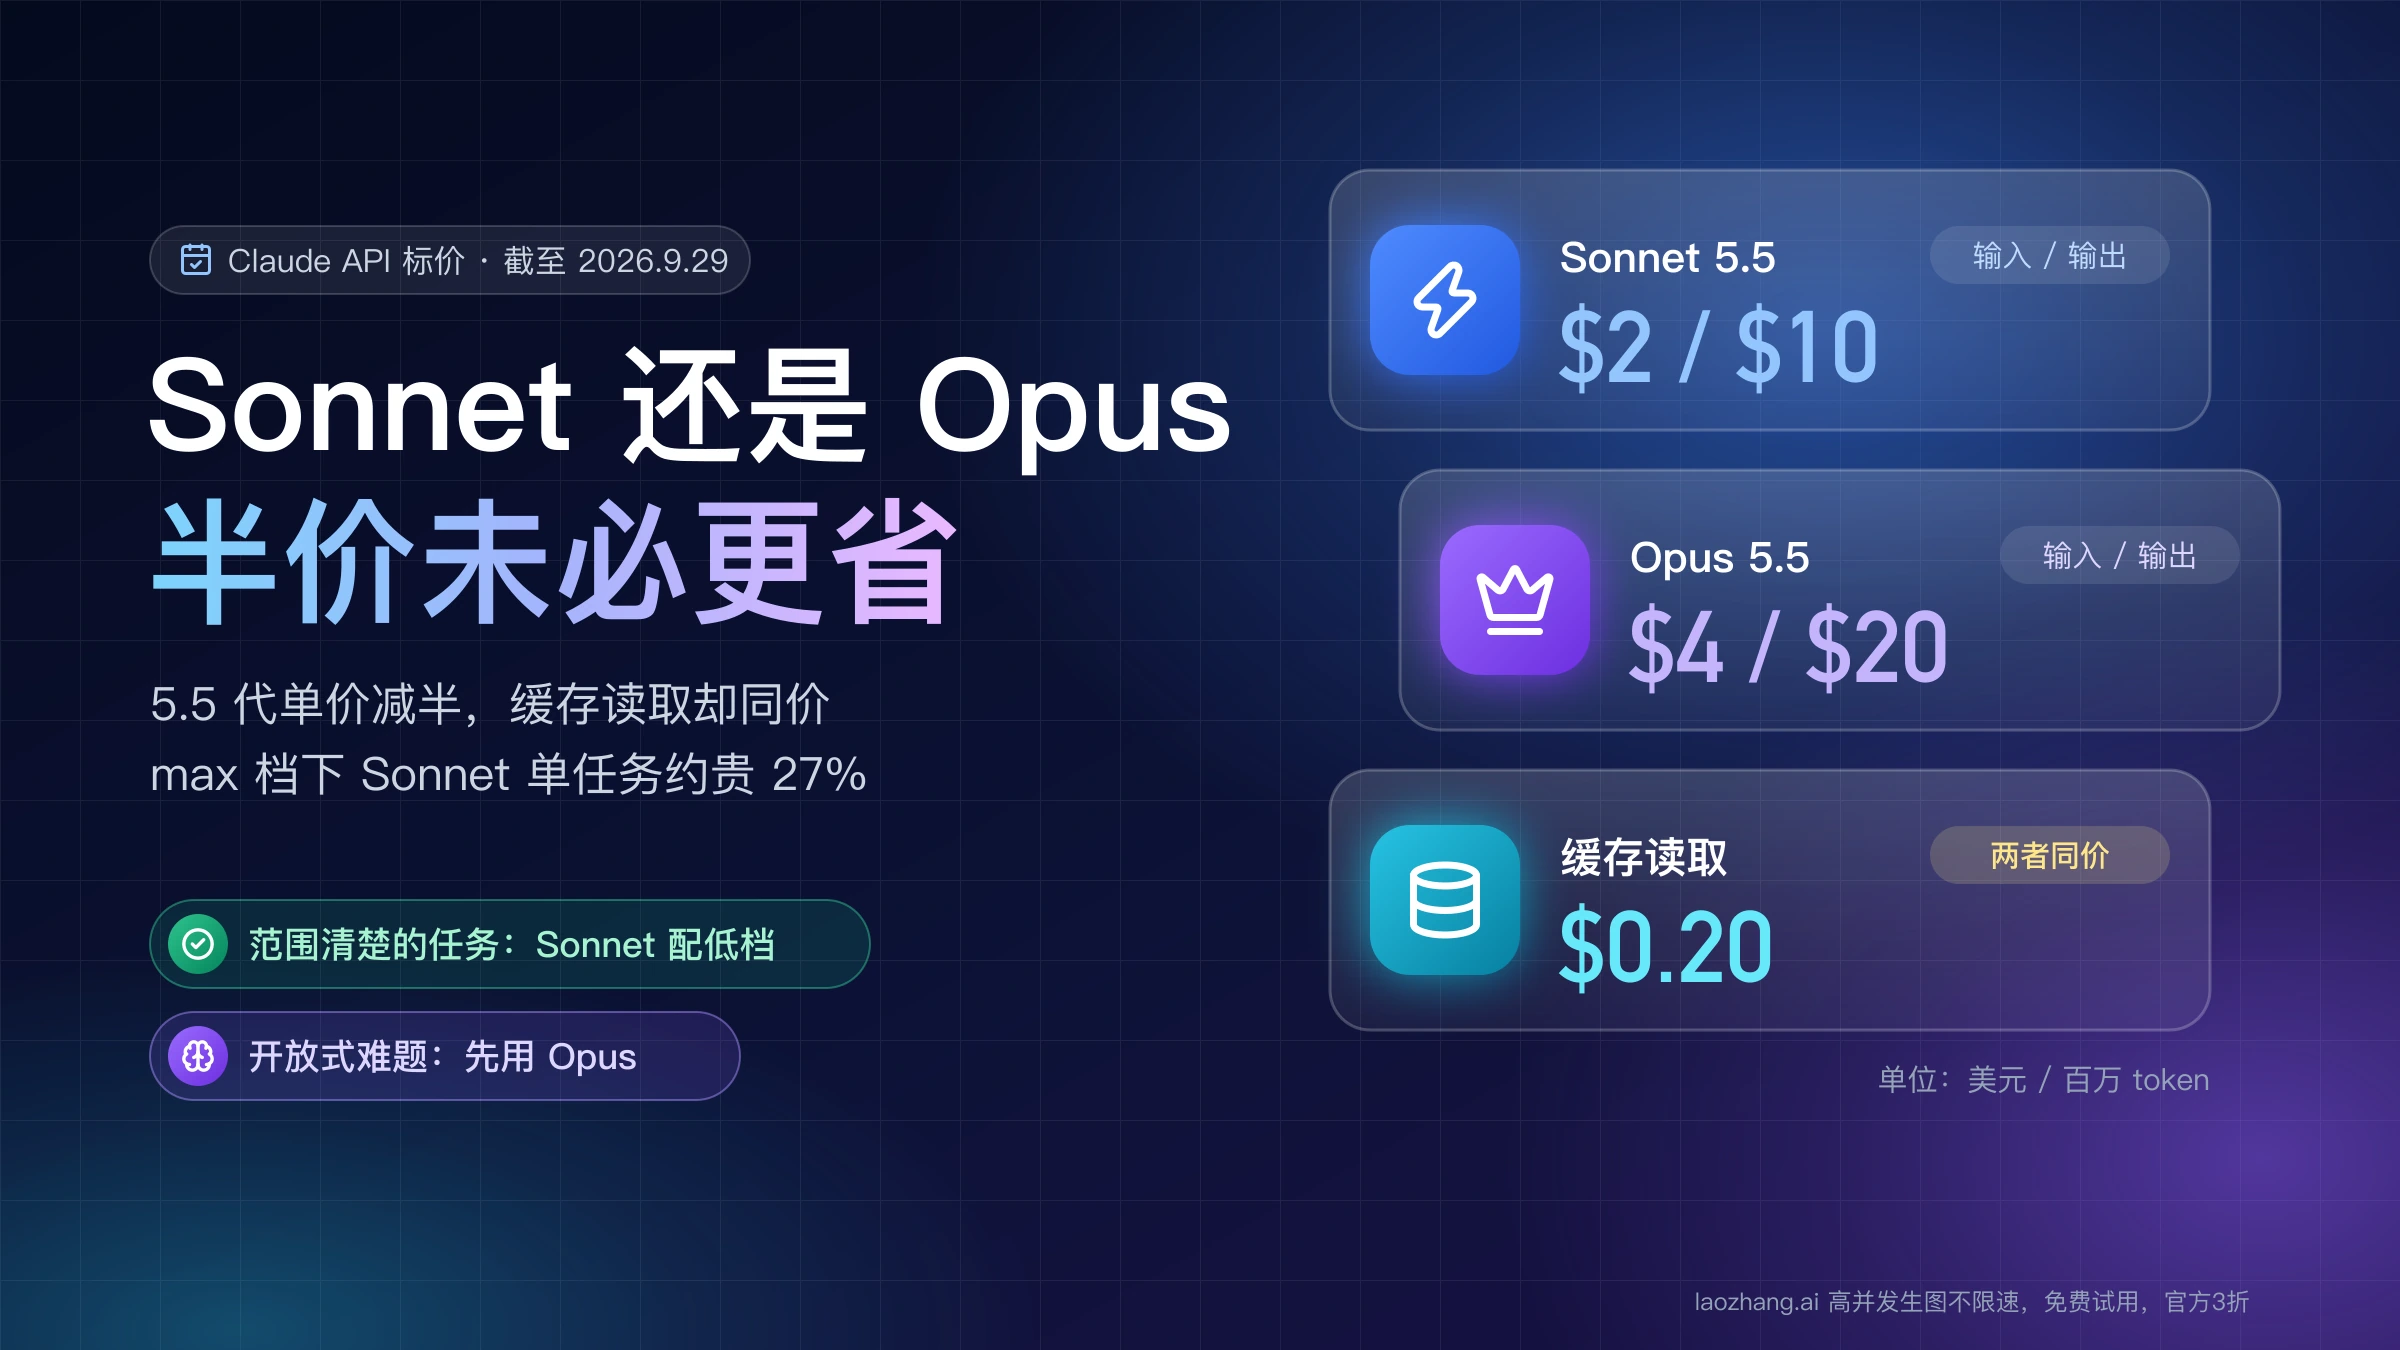
Claude Sonnet 5.5 于 2026 年 9 月 28 日发布,比 Opus 5.5 晚六天。按 API 标价,它的输入、输出和缓存写入都正好是 Opus 5.5 的一半,只有缓存读取两者同为每百万 token $0.20。选哪个,可以先按这三条走:
- 范围清楚、能用测试或规则自动判断对错、需要大量跑或快速来回修改的工作,比如修 bug、按需求改代码、做文档和表格,默认用 Sonnet 5.5,思考力度(effort)从
low或medium起步。 - 开放式、需要持续判断、一条链路要跑很久的工作,比如架构取舍、大范围重构、没有标准答案的调研,先用 Opus 5.5 的默认档
medium。 - 拿不准时,Anthropic 模型总览页给的默认建议是先用 Opus 5.5。模型总览
「一半价格」说的是每个 token,「账单暴涨」说的是每个任务,两句话并不矛盾。effort 开得越高,Sonnet 5.5 用的 token 和轮次越多;第三方评测机构 Artificial Analysis 在 max 档下测到它的单任务成本比 Opus 5.5 高约 27%。真正该比的是每个合格交付花多少钱,这个数可以用自己的任务算出来。
两个模型哪里一样,哪里不一样
截至 2026 年 9 月 29 日的官方规格与 Claude API 标价(美元 / 百万 token):
| 项目 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| API 模型 ID | claude-sonnet-5-5 | claude-opus-5-5 |
| 发布日期 | 2026 年 9 月 28 日 | 2026 年 9 月 22 日 |
| 官方定位 | 速度与智能的最佳组合;擅长范围清楚的日常任务、修 bug、做文档、幻灯片和表格 | 长时间运行的智能体编码与知识工作;需要细致判断的复杂任务 |
| 官方相对延迟标签 | Fast | Moderate |
| 输入 / 输出 | $2 / $10 | $4 / $20 |
| 5 分钟 / 1 小时缓存写入 | $2.50 / $4 | $5 / $8 |
| 缓存读取 | $0.20 | $0.20 |
| 批处理(输入 / 输出) | $1 / $5 | $2 / $10 |
| 上下文 / 最大输出 | 100 万 / 12.8 万 token | 100 万 / 12.8 万 token |
| 思考方式 | 自适应思考,可用 between_tools 关掉前置思考 | 自适应思考,始终开启 |
| Claude API 默认 effort | high | medium |
| Claude Code 默认 effort | medium | medium |
| Fast mode | 不支持 | 支持(研究预览,$8 / $40,仅 Claude API) |
来源:模型总览、价格页、Sonnet 5.5 发布公告、Claude Code 模型配置文档。延迟标签是 Anthropic 给的相对说法,不是实测秒数。
几处容易看漏的细节:
- Opus 5.5 的缓存读取按其输入价的 0.05 倍计费,是一个特价(其他模型一般是 0.1 倍),所以两者在这一项上打平。账单里缓存读取占比越高,Sonnet 5.5 的价差优势越小,下一节会算给你看。
- 两者用满 100 万上下文都按标准价计费,没有长上下文加价;可缓存的最短提示都是 512 token。
- Sonnet 5.5 沿用 Sonnet 5 的全部价目,价格变化经过见Claude Sonnet 5 取消涨价:现行 API 价格与预算重算。Opus 5.5 的账单算法与订阅用量重置见Claude Opus 5.5 价格与用量重置:API 账单怎么算,重置卡怎么用。
- Anthropic 对两者的分工写得很直白:Sonnet 5.5 是 Opus 5.5「更快、更低成本的补充」;在多项评测里 Sonnet 5.5 开到 Max 能与 Opus 5.5 相当,但在需要持续判断的复杂开放式工作上,Opus 5.5「仍明显更强」。Sonnet 5.5 发布公告
从 Sonnet 5 升级过来的读者还可以记一个对比:官方称 Sonnet 5.5 输出速度比 Sonnet 5 快 30% 以上,单任务成本最多低 30%。这些都是厂商自测结论。
半价为什么还会更贵
原因有三个,叠在一起就会出现「单价减半、账单反涨」。
第一,effort 决定 token 用量。effort 分 low、medium、high、xhigh、max 五档,档位越高,模型思考、调用工具和自查的次数越多。Anthropic 在 Sonnet 5.5 公告里说得很具体:它在 Low 或 Medium 档与 Opus 5.5 配合最好,单任务更便宜;到了较高档位,它能做到相近的水平,但成本也相近。
第二,max 档下 Sonnet 5.5 生成的 token 明显更多。Artificial Analysis 把两者都开到 max 档跑它的 Intelligence Index v4.3.2(10 项评测):
| 截至 2026 年 9 月 29 日,max 档 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| 综合得分 | 56 | 58 |
| 每个评测任务的平均成本 | $7.60 | $5.98 |
| 跑完整套评测生成的 token | 4.1 亿 | 2.6 亿 |
| 输出速度 | 每秒 139 token | 每秒 94 token |
数据来自 Artificial Analysis 的 Sonnet 5.5 与 Opus 5.5 页面。$7.60 ÷ $5.98 ≈ 1.27,也就是 Sonnet 5.5 单任务贵了约 27%,同时每秒出字快约 1.5 倍。这只是 max 档的结果,不代表 Claude Code 默认的 medium 或 API 默认的 high;成本里还包括多跑几轮带来的输入 token,不能只用输出量来解释差距。数据是发布次日的快照,之后可能更新。
第三,缓存读取不打折。编码智能体每一轮都要把系统提示、工具定义、仓库上下文和历史对话重新读一遍,这部分大多走缓存读取,而这一项两者同价。
保本倍数:Sonnet 5.5 最多能多用多少 token
把一个任务的费用拆开(单价均为美元 / 百万 token):
单轮费用 = 缓存读取 token × 0.20
         + 新输入 token × 输入单价
         + 缓存写入 token × 缓存写入单价
         + 输出 token × 输出单价
除缓存读取外,其他各项 Sonnet 5.5 都是 Opus 5.5 的一半。设 r 为缓存读取在 Opus 5.5 账单里所占的比例,那么同样的 token 量下:
Sonnet 5.5 费用 = Opus 5.5 费用 × (1 + r) ÷ 2
保本倍数 = 2 ÷ (1 + r)
保本倍数的意思是:只要 Sonnet 5.5 完成同一任务所用的 token(各类 token 同比例增加)不超过 Opus 5.5 的这个倍数,它就更便宜。三个示例,token 数为假设值,价格按标价计算,不含批处理和 fast mode:
| 每轮 token 构成 | Opus 5.5 | Sonnet 5.5 | 缓存读取占 Opus 账单 | 保本倍数 |
|---|---|---|---|---|
| 无缓存:5k 输入 + 6k 输出 | $0.140 | $0.070 | 0% | 2.0 倍 |
| 工具循环:10 万缓存读取 + 5k 新输入 + 6k 输出 | $0.160 | $0.090 | 12.5% | 约 1.78 倍 |
| 反复读大上下文:50 万缓存读取 + 2k 新输入 + 3k 输出 | $0.168 | $0.134 | 约 60% | 约 1.25 倍 |
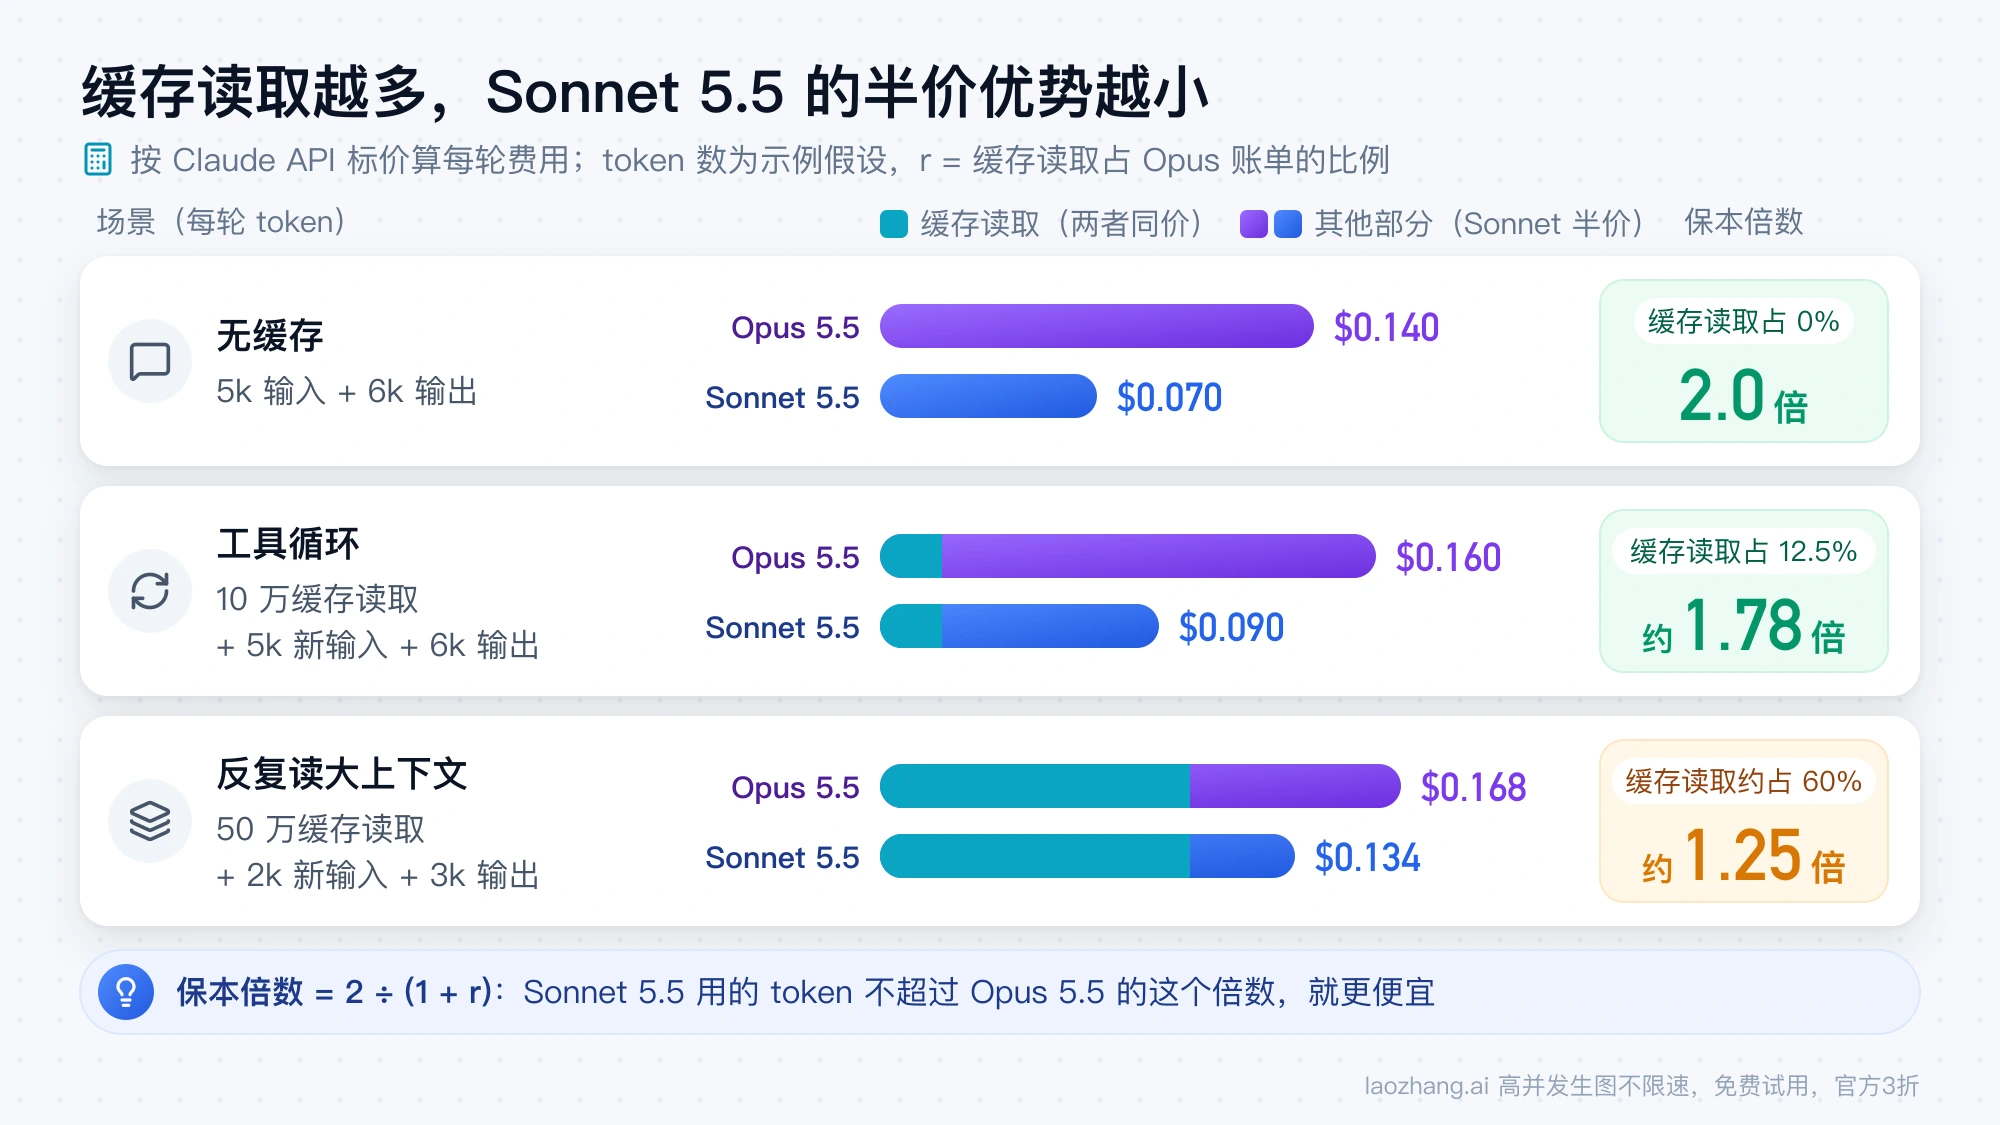
以第三行为例:Opus 5.5 的费用是 500,000 × 0.20 + 2,000 × 4 + 3,000 × 20 = 168,000(单位:百万分之一美元),即 $0.168;Sonnet 5.5 是 100,000 + 8,000 + 30,000,即 $0.134。在这种重读上下文的场景里,Sonnet 5.5 只要比 Opus 5.5 多跑 25% 的轮次,价差就没了。上面 Artificial Analysis 的 max 档结果,就是 Sonnet 5.5 多用的 token 超过了保本倍数。
这也解释了为什么只看价目表的结论不可靠:同一个模型,在纯问答里能省一半,放进长时间运行的编码智能体里可能只省一两成,开到高档还可能倒贴。
Sonnet 5.5 在编码上真的赢了 Opus 5.5 吗
在 Anthropic 公布的表里,Sonnet 5.5 只在 Terminal-Bench 4.0 这一项上高于 Opus 5.5;其余编码与知识工作评测都是 Opus 5.5 略高或持平。
| 评测(Anthropic 公布) | Sonnet 5.5 | Opus 5.5 | 读数时注意 |
|---|---|---|---|
| Terminal-Bench 4.0(终端智能体编码) | 70.6% | 66.4% | Opus 5.5 取的是 xhigh 档,也是它在这项上的最高分 |
| FrontierCode 1.1 (Main) | xhigh 档 52.1%,max 档 46.2% | 54.4% | Sonnet 5.5 在 max 档更常调用 Claude Code 的代码审查技能,导致超时和越界修改,分数反而更低 |
| CursorBench 4.0 | 55.5% | 57.8% | Sonnet 5.5 的最好成绩与 Opus 5.5 相差约 2 个百分点 |
| GDPval-AA v2.1 | 1844 | 1846 | 由 Artificial Analysis 在发布前的版本上运行,当时有一个已修复的结构化输出问题 |
| AA-Briefcase v1.1 | 1811 | 1822 | 同上 |
| Humanity's Last Exam(带工具) | 64.5% | 67.7% | |
| OSWorld 2.1(部分) | 80.1% | 81.8% | |
| Chartography(无工具) | 61.6% | 64.4% |
来源:Sonnet 5.5 发布公告。Anthropic 的 Opus 5.5 公告说明,除非另有注明,Opus 5.5 的成绩都在 max 档下取得。这些是厂商自测,不是独立评测。
有两处比较容易读错:
- Opus 5.5 公告里还给了默认
medium档的成绩:FrontierCode 54.6%,CursorBench 52.5%。把 Sonnet 5.5 的 CursorBench 55.5% 与 Opus 5.5 的 52.5% 放在一起,是拿 Sonnet 的高档成绩去比 Opus 的默认档,不能得出「Sonnet 5.5 编码更强」的结论。 - 「多项指标逼近」和「单任务更便宜」不是同一个档位的事。高分大多出自 max 或 xhigh 档,而这正是 Sonnet 5.5 单任务成本追上甚至超过 Opus 5.5 的区间。
第三方的小样本测试也指向同一方向。代码审查服务 CodeRabbit 用 13 个高难度 PR 做了测试:
| CodeRabbit 13 个难例 | 找出的已知问题 | 可操作建议的准确率 |
|---|---|---|
| Sonnet 5.5(开思考) | 6/13 | 41.2% |
| Sonnet 5.5(关思考) | 5/13 | 38.5% |
| Opus 5.5 Standard | 8/13 | 66.7% |
| Opus 5.5 Max | 10/13 | 52.0% |
Opus 5.5 的数据来自 CodeRabbit 9 月早些时候在同一批案例上的测试。Sonnet 5.5 每次审查的调用成本约 $0.46–0.47,Sonnet 5 是 $1.16。CodeRabbit 还用 Claude Code 让两者各做了一次同样的构建:Sonnet 5.5 用时 29 分 27 秒,Opus 5.5 用时 44 分 50 秒,结果几乎一样,Opus 5.5 的还原度略高;CodeRabbit 自己也说明这只是一次运行,不是基准测试。13 个案例只能看方向。CodeRabbit 测试
合起来看:在难例审查这类需要判断力的任务上,Opus 5.5 找得更全、更准;在有明确终点的构建任务上,Sonnet 5.5 快得多,质量差距不大。
按工作类型选模型和 effort
| 工作形态 | 起步配置 | 什么时候调整 |
|---|---|---|
| 范围清楚、有测试或规则可校验:修 bug、按规格改代码、格式转换 | Sonnet 5.5,medium | 同类任务反复不过测试,先升到 high;还不行再换 Opus 5.5 |
| 人在旁边快速来回改:调样式、改文案、做文档、表格和幻灯片 | Sonnet 5.5,low 或 medium | 需要跨文件保持一致或反复出现理解偏差时,改用 Opus 5.5 |
| 大批量、不赶时间:分类、摘要、数据抽取 | Sonnet 5.5 + 批处理($1 / $5) | 抽样与 Opus 5.5 对比,合格率差距明显再换 |
| 开放式、要持续判断:架构方案、大范围重构、没有标准答案的调研 | Opus 5.5,medium | 质量不够先升 high 或 xhigh |
| 多小时自主运行的编码智能体 | Opus 5.5,medium | 流程中可以明确切出的执行步骤,再考虑交给 Sonnet 5.5 |
| 延迟最敏感的交互 | Sonnet 5.5,low | 必须用 Opus 5.5 时可评估 fast mode(仅 Claude API,价格翻倍) |
这张表是根据官方定位与 effort 建议整理的使用规则,不是各类任务的实测胜率。Anthropic 对 Sonnet 5.5 的原始建议是:智能体编码和多步工具调用,范围明确的任务从 medium 起,难度更高或更长的任务再上 high;聊天和延迟敏感的场景用 medium 或 low;xhigh 和 max 只在你的评测显示有质量提升时才用。Sonnet 5.5 的 effort 说明
由此可以推出一条实用规则:如果某类任务要把 Sonnet 5.5 开到 xhigh 或 max 才够用,先试 Opus 5.5 的 medium。按官方说法和 Artificial Analysis 的 max 档数据,Sonnet 5.5 在高档位已经没有成本优势,而 Opus 5.5 在默认 medium 档的 FrontierCode 成绩(54.6%)已经高于 Sonnet 5.5 在 xhigh 档的 52.1%。
使用入口也会改变起点:
- Claude Code 里两者默认都是
medium(其他支持 effort 的模型默认high),直接对比是公平的。 - Claude API 里不写 effort 时,Sonnet 5.5 跑
high,Opus 5.5 跑medium。只换模型 ID 就开始比较,Sonnet 5.5 会多花一档的 token,显得比实际更贵。两边都把 effort 显式写出来。 - Claude 应用里 Sonnet 5.5 默认也是 Medium。
如果连 Opus 5.5 开高档都不够,下一步是前沿模型,参见Claude Fable 5.1 和 Opus 5.5 怎么选?性能、价格与切换建议。还在 Claude 与 OpenAI 之间比较的,可以看Claude Opus 5.5 对比 GPT-6 Sol:先看任务,再算每次合格交付的成本。面向高并发、成本敏感场景的 Haiku 5.5,Anthropic 只说会在未来几周加入 5.5 系列。
在 Claude Code 里切换模型和 effort
Claude Code 里两个模型的 effort 都有 low、medium、high、xhigh、max 五档,默认都是 medium,会话标题会显示当前档位(例如 with low effort)。
在 Claude Code 会话内:
/model:打开模型菜单,选择后立即生效;菜单里用左右方向键可以同时调整 effort。继承主模型的子代理也会跟着换。/effort medium:直接设定 effort;不带参数的/effort会打开滑块,/effort auto清除为当前模型保存的档位。/status:查看当前用的是哪个模型。
在终端里启动时指定,或写成长期默认:
# 只对这一次会话生效
claude --model claude-sonnet-5-5 --effort medium
claude --model claude-opus-5-5

# 写入 shell 配置,作为以后所有会话的默认值(bash 用户改成 ~/.bashrc)
echo 'export ANTHROPIC_MODEL="claude-sonnet-5-5"' >> ~/.zshrc
echo 'export CLAUDE_CODE_EFFORT_LEVEL=medium' >> ~/.zshrc
source ~/.zshrc
想让两个模型各用不同的默认档位,可以在 Claude Code 设置文件的 modelSettings 里按模型分别设,或用 effortLevel 给没有单独设置的模型定一个默认值。设置文件不接受 max:用 /effort max 只对当前会话有效,想长期用 max 只能写进 CLAUDE_CODE_EFFORT_LEVEL 环境变量。
也可以用别名代替完整 ID:sonnet 指最新的 Sonnet,opus 指最新的 Opus。但别名解析到哪个版本取决于接入方式:
| Claude Code 接入方式 | opus 对应 | sonnet 对应 |
|---|---|---|
| Anthropic API | Opus 5.5 | Sonnet 5.5 |
| Claude Platform on AWS | Opus 5.5 | Sonnet 4.6 |
| Amazon Bedrock、Google Cloud | Opus 5.5 | Sonnet 4.5 |
| Microsoft Foundry | Opus 4.6 | Sonnet 4.5 |
通过云服务商使用时,写 sonnet 拿到的不是 Sonnet 5.5,要把 claude-sonnet-5-5(或该云服务商的模型 ID)写死。来源:Claude Code 模型配置文档、Claude 帮助中心:切换 Claude Code 模型。
会话中途:调 effort 便宜,换模型贵
- 调 effort 基本没有额外成本。用 API key 或 Claude 订阅登录时,在 Opus 5.5 和 Sonnet 5.5 上改 effort 会保留提示缓存,直接生效,不再询问;在 Bedrock、Google Cloud 或 Claude apps gateway 上不适用这条。Claude Code 提示缓存文档
- 换模型要付一次全量重读。每个模型的提示缓存各自独立,用
/model换模型后,下一次请求要把整段对话重新读一遍,一次缓存都不命中;缓存还有效时,Claude Code 会先让你确认。对话越长,这笔钱越多:本来按 $0.20 缓存读取价计的上下文,这一轮要按输入价或缓存写入价重新计费。 - 换模型后,前面的推理过程很可能接不上。API 文档写明,Sonnet 5.5 不读 Opus 5.5 的 thinking 块,Opus 5.5 也不读 Sonnet 5.5 的,读不了的块会被丢掉,只剩对话文字。Claude Code 文档没有单独说明
/model切换时 thinking 块怎么处理,这一点是按 API 规则推断的。
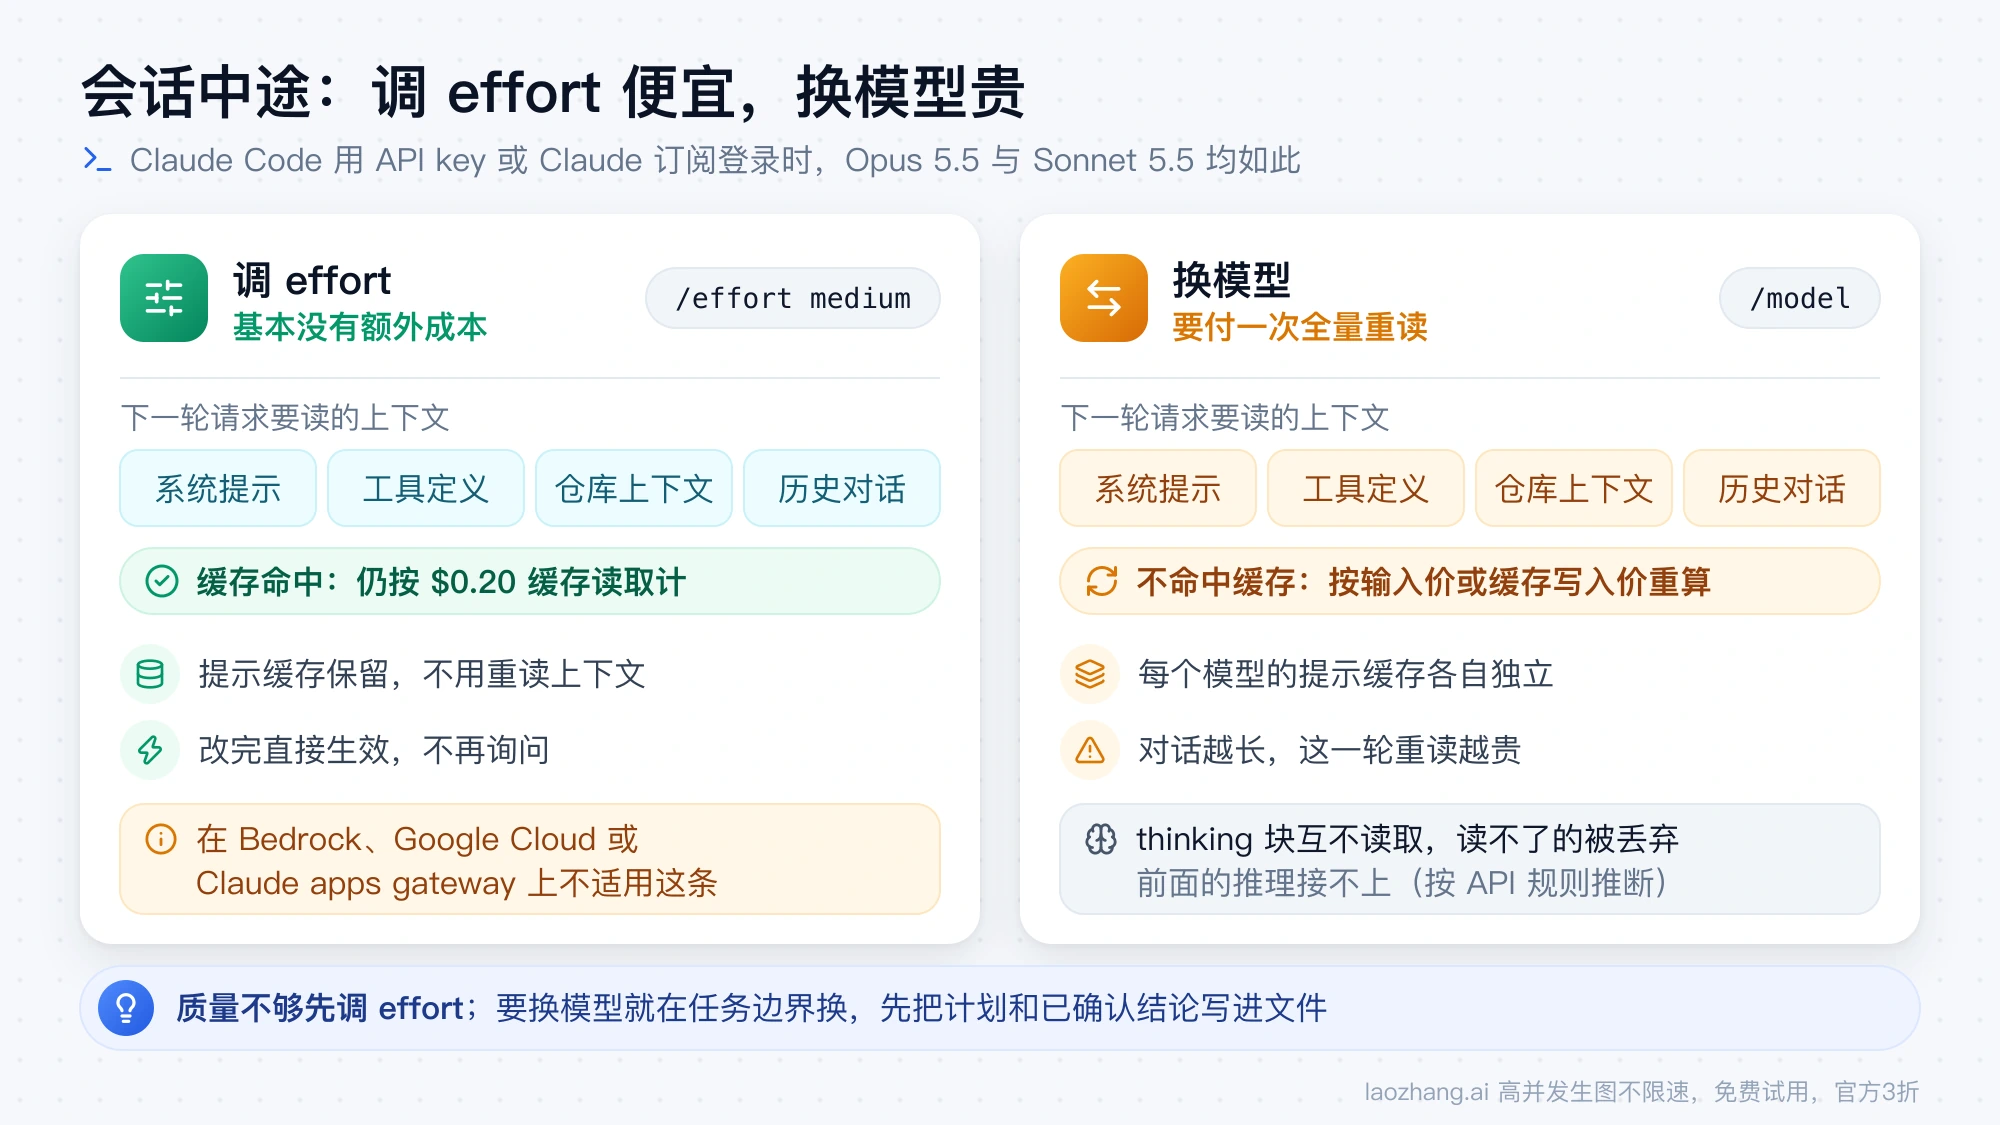
所以同一个任务里,觉得质量不够先调 effort;确实要换模型,就在任务边界换,或者先让当前模型把计划和已确认的结论写进文件,再开新会话换模型接着做。
另外,在 Claude 应用里,安全机制可能自动换模型。Sonnet 5.5 是第一个带网络安全回退的 Sonnet:被判定为高风险的攻击性安全请求(如编写漏洞利用、基于二进制的漏洞扫描、渗透测试)和部分前沿模型开发请求会回退到 Sonnet 5,生物和「提取推理过程」类请求直接拦截;Opus 5.5 的网络安全回退到 Opus 4.8,生物类回退到 Opus 5。回退后这段对话会一直停在回退模型上,直到你手动切回。扫描源代码找漏洞这类常规安全编码不受影响。Sonnet 5.5 回退说明
API 里只改模型 ID 会出什么错
两个 5.5 模型相对前代都有破坏性变更,彼此之间也不完全一样。从一个换到另一个之前,逐项对一遍:
| 差异点 | Sonnet 5.5 | Opus 5.5 | 怎么改 |
|---|---|---|---|
thinking: {"type": "disabled"} | 返回 400,改用 between_tools | 返回 400,思考无法关闭 | Sonnet 用 between_tools;Opus 降低 effort |
between_tools | 支持,但只能在 low/medium/high 档;用它时不能中途改 effort | 不适用 | 要开 xhigh/max 就用自适应思考 |
手动 budget_tokens | 返回 400 | 返回 400 | 用 effort 控制思考深度 |
tool_choice 设为 any 或 tool | 返回 400 | 返回 400 | 保持 auto,配合 strict tool use 或结构化输出,并在提示里写清何时调用工具 |
非默认的 temperature/top_p/top_k | 返回 400 | 返回 400(Opus 4.7 起均如此) | 去掉这些参数或保持默认值,用提示词引导输出风格 |
| 不写 effort 时的默认档 | high | medium | 两边都显式设置 output_config.effort |
Fast mode(speed: "fast") | 不支持 | 支持,仅 Claude API | 从 Opus 换到 Sonnet 时去掉 |
| 跨模型读 thinking 块 | 不读 Opus 5.5 的 | 不读 Sonnet 5.5 的 | 请求照常成功,读不了的块被丢弃且不计费,但推理接不上 |
| 改动历史消息 | 2026 年 8 月 31 日及以后创建的账号,改了 thinking 块之前的 system、tools 或消息会返回 400 | 同左 | 对话只追加不改写;或用 beta 头配置 drop_block |
| 工具调用之间的文字 | 以 thinking 块返回,默认 display: "omitted" 时为空 | 同左 | 界面要展示进度,就设置 thinking.display |
computer_20251124 工具 | Claude API 与 Google Cloud 上返回 400 | 同左 | 改用 computer_toolset_20260801;Bedrock 仍接受旧工具 |
来源:Sonnet 5.5 新变化、Opus 5.5 新变化、Opus 5.5 迁移指南。另外,Sonnet 5.5 的 thinking 块只在生成它的账号或关联账号里有效,换账号发送会被丢弃。
对比测试时,把 effort 和 max_tokens 都写死,避免默认值不同带来的偏差:
import anthropic

client = anthropic.Anthropic()

for model in ["claude-sonnet-5-5", "claude-opus-5-5"]:
    response = client.messages.create(
        model=model,
        max_tokens=16000,  # 思考也计入 max_tokens,高档位要留足
        output_config={"effort": "medium"},
        messages=[{"role": "user", "content": "你的真实任务"}],
    )
    print(model, response.usage)
两者分工:Opus 出主意,Sonnet 干活
Claude API 的 advisor 工具(beta)支持这种组合:Sonnet 5.5 作为执行者跑主循环,遇到难做的决定时去问 Opus 5.5。大部分 token 按 Sonnet 的价格计费,只有咨询按 Opus 的价格。要注意,Sonnet 5.5 作为执行者时只接受 Opus 5.5、Opus 5、Fable、Mythos 系列或它自己当顾问,用 Opus 4.8、Opus 4.7 或 Sonnet 5 当顾问会返回 400;顾问的建议以加密形式返回,你的程序读不到内容。Claude Code 也有 advisor 模式。
这种分工能不能省钱,Anthropic 的成本指南给了几条判断依据:
- 顾问模型的单价要明显高于执行者才划算。Opus 5.5 只比 Sonnet 5.5 贵一倍,价差不算大,省下的空间有限。
- 执行者要真的去问。effort 调低后,执行者可能察觉不到自己卡住了,几乎不再咨询,结果反而不如单独用执行者。
- 先算一个基准:顾问模型自己在
low档单独跑要花多少钱,组合方案必须比这个便宜。
截至 2026 年 9 月 29 日,Anthropic 还没有公布 Sonnet 5.5 执行、Opus 5.5 当顾问的实测数据。成本与智能优化指南
在 Claude Code 里,这种分工有现成的写法:别名 opusplan 在计划模式(plan mode)下用 opus,进入执行后切到 sonnet。
claude --model opusplan用之前注意三点:
- 它依赖别名解析。直连 Anthropic API 时对应 Opus 5.5 和 Sonnet 5.5;通过 Bedrock、Google Cloud 或 Claude Platform on AWS 时,
sonnet解析到的是 Sonnet 4.5 或 4.6,执行阶段用的并不是 Sonnet 5.5(见前面 Claude Code 一节的别名表)。 - 从计划切到执行等于换一次模型:执行的第一轮要把整段对话重新读一遍,不命中缓存;按 API 规则推断,Sonnet 5.5 也看不到 Opus 5.5 的思考过程,能接上的只有写出来的计划文字。所以计划要写完整,包括文件范围、验收条件和已排除的方案。
opusplan配 5.5 模型的成本,Anthropic 没有公布实测数据。按上面的成本指南,它是否比单独用 Opus 5.5medium更省,要用自己的任务测。
不想依赖别名,也可以手动分工:先用 Opus 5.5 开一个会话讨论方案,把计划写进文件;再用 claude --model claude-sonnet-5-5 开新会话按计划实现。
用自己的任务算一次单任务成本
价目表回答不了哪个模型更适合你的工作。截至 2026 年 9 月 29 日,也没有公开数据比较两者在同一 medium 档下的单任务成本:Artificial Analysis 只测了 max 档,Anthropic 公告里按档位画的成本曲线没有给出具体数值。最可靠的办法是自己测一次,按 Anthropic 成本指南的方法:
- 从实际工作里挑 10 到 20 个任务,比例贴近平时的工作量,再单独挑出其中最难的一成。账单往往由便宜模型做不好的那部分任务决定:失败了照样收 token,还要重试。
- 给每个任务写好验收条件:测试通过、工单关闭、数据行数正确。
- Sonnet 5.5 跑
low、medium、high,Opus 5.5 跑low、medium。每个档位单独开会话,避免前面的上下文和缓存状态影响对比;用 API 测时,中途改顶层 effort 还会让缓存失效。 - 按每次响应的
usage算费用,把同一任务的所有请求加起来,再除以通过验收的任务数,得到每个合格交付的成本。 - 输出能自动校验时,再试一种策略:全部先用低档跑,只把失败的重跑到
high。Anthropic 在 Opus 5.5 上用 SWE-bench Pro 子集测过:low加失败重跑的通过率约 97%,每题约 $0.17;全部用high是 95.3%,每题 $0.29。这是 Anthropic 内部在 Opus 5.5 上的结果,Sonnet 5.5 需要自己验证。
第 4 步可以直接用下面的函数,价格为截至 2026 年 9 月 29 日的 Claude API 标价:
PRICES = {  # 美元 / 百万 token
    "claude-sonnet-5-5": {"input": 2.00, "output": 10.00, "cache_read": 0.20},
    "claude-opus-5-5": {"input": 4.00, "output": 20.00, "cache_read": 0.20},
}

def request_cost(model: str, usage) -> float:
    p = PRICES[model]
    cc = usage.cache_creation
    write_5m = (getattr(cc, "ephemeral_5m_input_tokens", 0) or 0) if cc else 0
    write_1h = (getattr(cc, "ephemeral_1h_input_tokens", 0) or 0) if cc else 0
    return (
        usage.input_tokens * p["input"]
        + write_5m * p["input"] * 1.25   # 5 分钟缓存写入
        + write_1h * p["input"] * 2.0    # 1 小时缓存写入
        + (usage.cache_read_input_tokens or 0) * p["cache_read"]
        + usage.output_tokens * p["output"]  # 思考 token 计入输出
    ) / 1_000_000
结果怎么用:选每个合格交付成本最低、且合格率达到要求的组合。如果 Sonnet 5.5 在 medium 下合格率接近 Opus 5.5,且账单里缓存读取占比不高,它就是更划算的默认模型;如果它要开到 high 以上才追平,或最难那一成总是失败,默认留给 Opus 5.5 更省心。
订阅用户、免费用户与地区
截至 2026 年 9 月 29 日,claude.com 价格页的模型表显示:
| 套餐 | Sonnet | Opus |
|---|---|---|
| Free | 可用 | 不可用 |
| Pro($20/月,年付折合 $17/月) | 可用 | 可用 |
| Max 5x / Max 20x($100/月起) | 可用 | 可用 |
这张表没有写版本号。Sonnet 5.5 是当前的 Sonnet,所以免费版大概率用的是它,但具体以应用内的模型菜单为准。Claude 价格页
订阅里的 Max 是套餐名,effort 里的 max 是思考档位,两者无关:订了 Max 套餐,Claude Code 里两个模型的默认 effort 仍是 medium,想开到 max 档要自己调。Opus 5.5 发布时,Anthropic 提高了 Pro、Max、Team 和按席位计费的 Enterprise 的 5 小时用量上限。在 Pro 和 Max 之间犹豫的,可以看Claude Pro vs Max 怎么选(2026):价格、Claude Code 限制与 Max 是否值得。
地区方面,截至 2026 年 9 月 29 日,Anthropic 支持的国家和地区列表里没有中国大陆和中国香港,这一限制同时适用于 Claude 应用和 Anthropic API。两个模型也通过 Amazon Bedrock、Google Cloud 和 Microsoft Foundry 提供,可用范围按各云服务商的条款和区域执行。Anthropic 支持的国家和地区