Opus 5.5 降智了吗?降智测试未测出下降,先查 effort 和换模型
截至 2026 年 10 月 21 日,两个降智测试都没测出 Claude Opus 5.5 有超出波动的下降。觉得变笨,先查思考力度、自动换模型和 Claude Code 版本。
文章目录
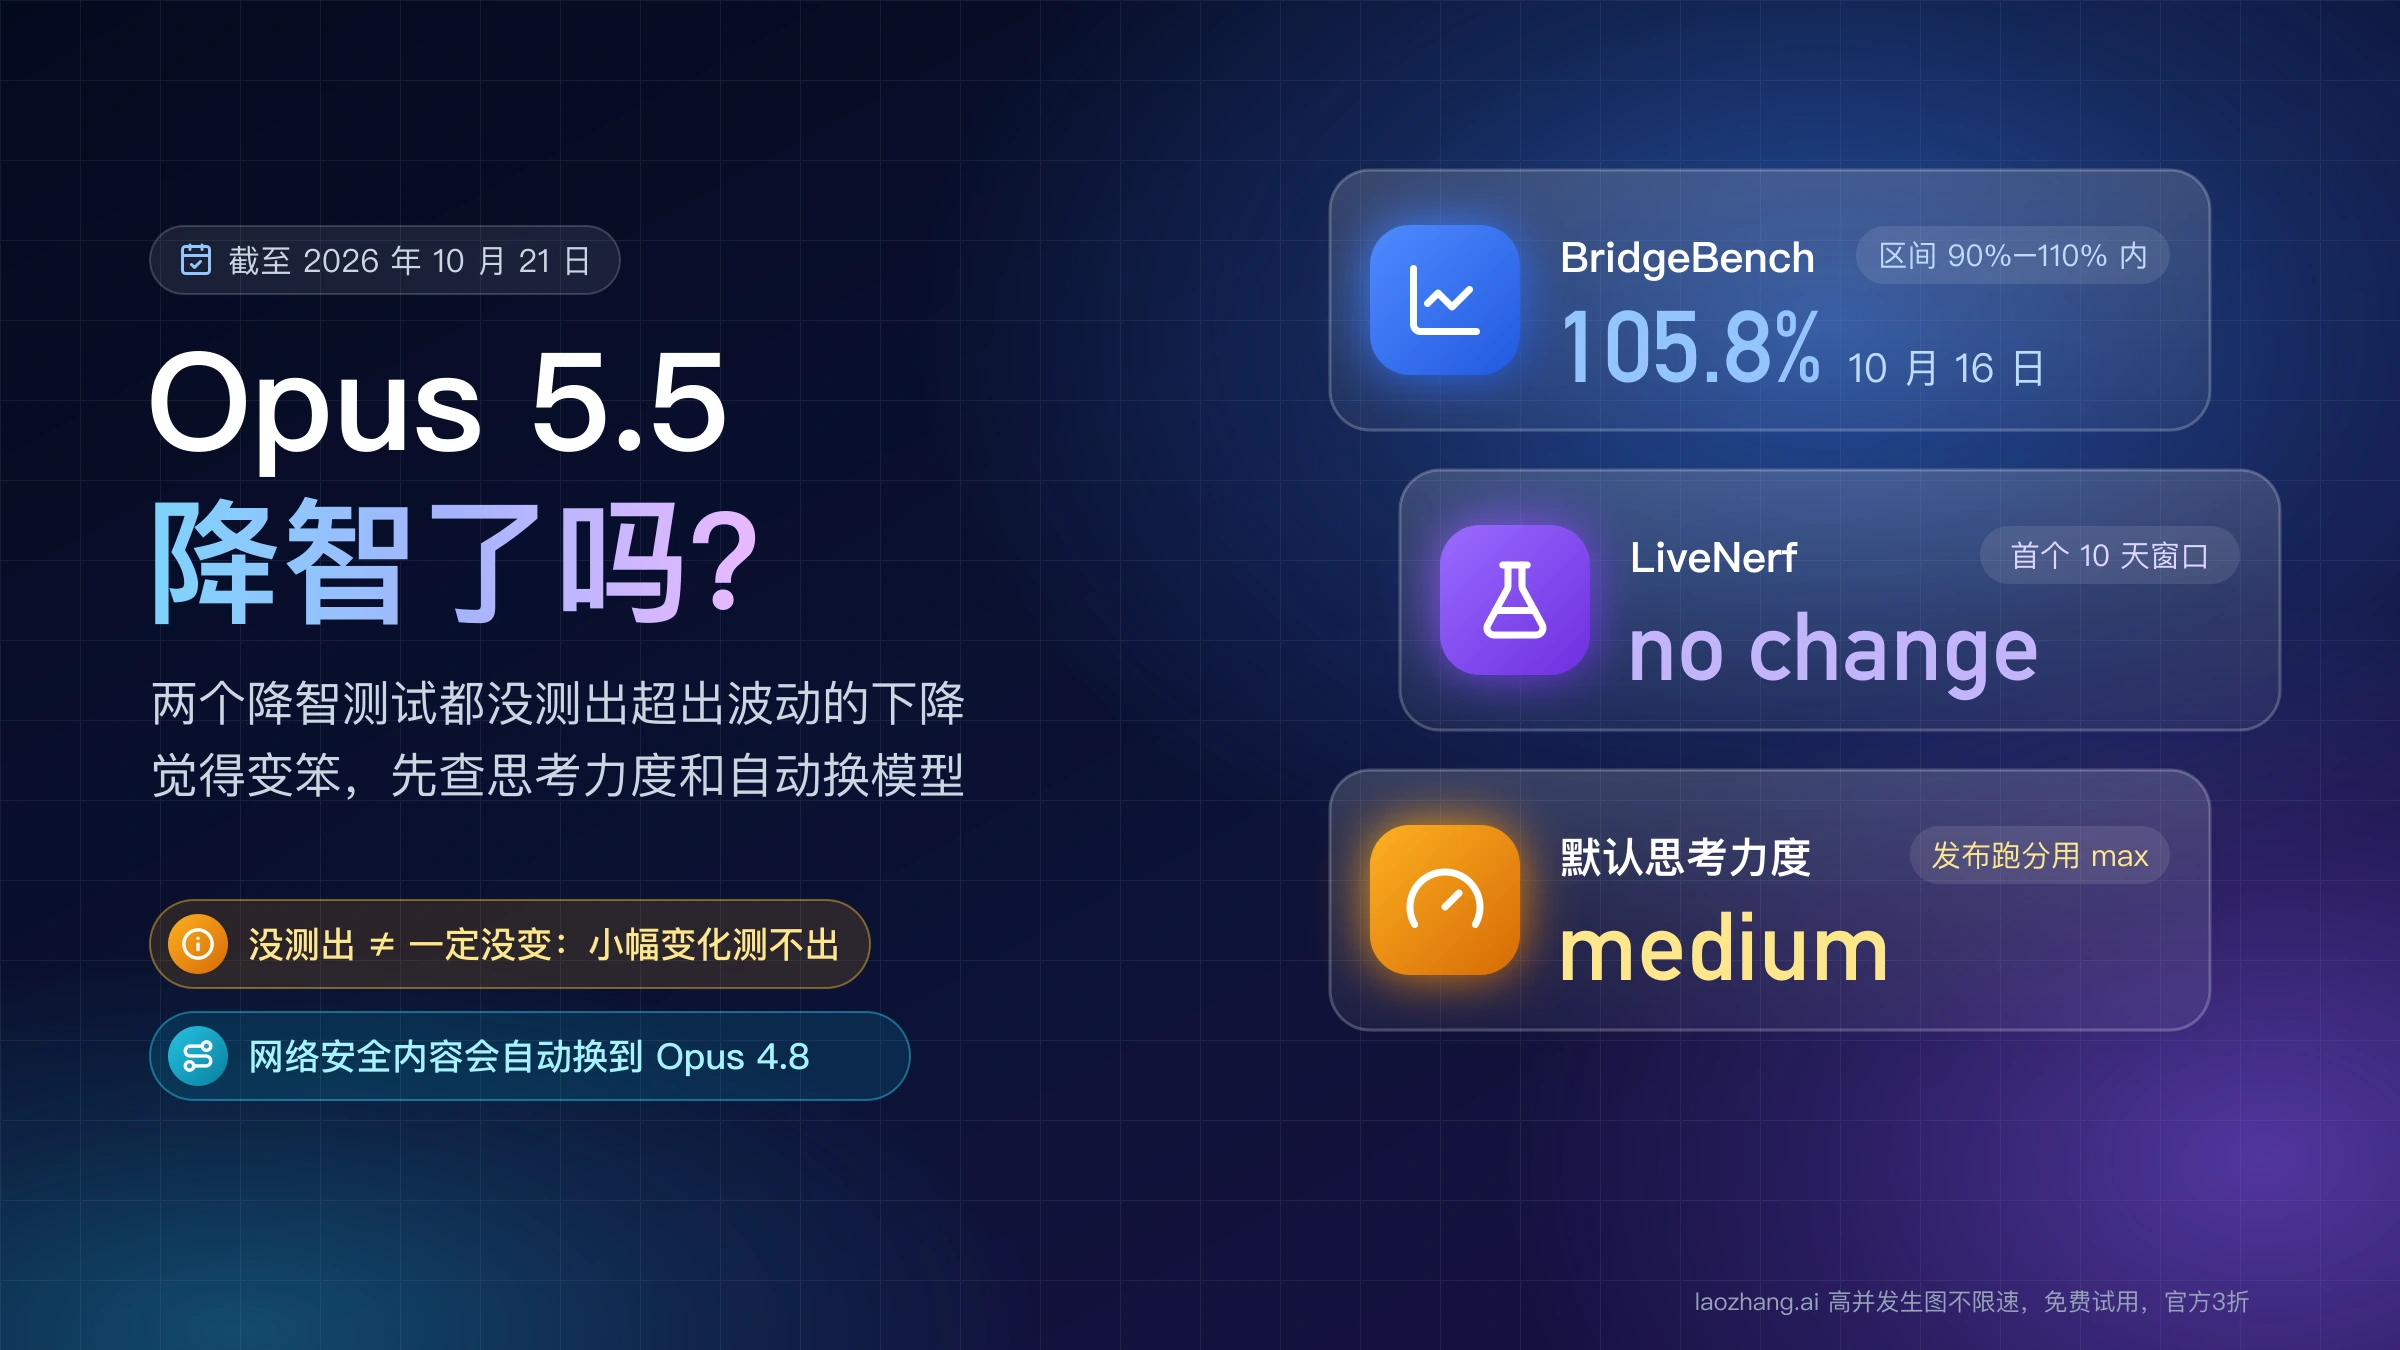
截至 2026 年 10 月 21 日,没有证据表明 Claude Opus 5.5 整体降智:两个持续跑分的测量项目 BridgeBench Nerf Bench 和 LiveNerf 都没有测出超出正常波动的下降,Anthropic 也没有发布任何关于 Opus 5.5 输出质量的说明、事故报告或修复公告。但"没测出"不等于"一定没变",这两个项目都测不出几个百分点以内的小变化。
你感觉它变笨了,多半能在自己这边找到更具体的原因。按下面的顺序排查,每一步都能用命令或界面确认:
- 先分清是额度还是质量:额度掉得快和回答变差是两件事,用
claude -p /usage看消耗。 - 查思考力度(effort):Opus 5.5 在 Claude Code 和 API 里默认是
medium,发布会上的跑分用的是max;旧版全局保存的high对 Opus 5.5 不生效。 - 查是不是被换了模型:Claude Code 遇到网络安全内容会把整个会话换到 Opus 4.8,生物内容换到 Opus 5,换了之后会一直留在那个模型上。
- 查 Claude Code 版本和会话长度:2.1.287 到 2.1.293 之间修过丢失思考内容、压缩后重做已完成工作的问题。
- 用第三方中转的,回官方入口用同一个任务对照。
- 以上都排除了还觉得变差,就用固定任务前后对比,别凭印象比。
Opus 5.5 的发布日期是 2026 年 9 月 22 日(Anthropic 发布页和平台更新日志的日期),部分中文页面写成 21 日或 23 日,是时区和转载日期造成的。
Opus 5.5 降智了吗:截至 10 月 21 日,两个测量项目都没测出下降
公开能查到的持续测量只有两个,结论都指向"没有测出变化",但两者能测出的变化幅度不同:
| 项目 | 怎么测 | 截至 2026 年 10 月 21 日的读数 | 能测出多大变化 |
|---|---|---|---|
| BridgeBench Nerf Bench 的 Opus 5.5 页面 | 50 道私有编程和推理题,每题 3 次,单次回答、不用工具;以第一次测试为 100% | 10 月 16 日为发布时的 105.8%,在 90%–110% 正常波动区间内 | 区间外的结果要连续两次才算数;通过率约 70% 的模型,单靠运气分数就可能上下浮动约 9 分 |
| LiveNerf 开源测量项目 | 每天用 claude -p 在 Max 订阅上跑 78 道"模型时对时错"的题,effort high,Claude Code 固定在 2.1.280,以 Opus 5 作对照 | 第一个 10 天窗口(10 月 4 日起)相对基线 +0.007 ± 0.018,结论 "no change" | 每个 10 天窗口约 6.6 个百分点;30 天序列最早约 10 月 24 日给出结论 |
两个读数都会继续更新,看最新值直接打开上表的两个链接:BridgeBench 看页面顶部的百分比和"Every test"列表,LiveNerf 看 README 里的 Results 表。
BridgeBench 跌到 94.2% 算不算实锤
不算。中文社区流传的"疑似降智,评测得分跌至发布时的 94.2%",来自 BridgeBench 10 月 2 日那一次测试。Opus 5.5 在这个项目里的全部读数如下(相对 9 月 22 日首测的百分比):
| 日期 | 9 月 22 日 | 9 月 27 日 | 10 月 1 日 | 10 月 2 日 | 10 月 4 日 | 10 月 9 日 | 10 月 16 日 |
|---|---|---|---|---|---|---|---|
| 读数 | 100.0% | 99.2% | 103.8% | 94.2% | 96.5% | 95.7% | 105.8% |
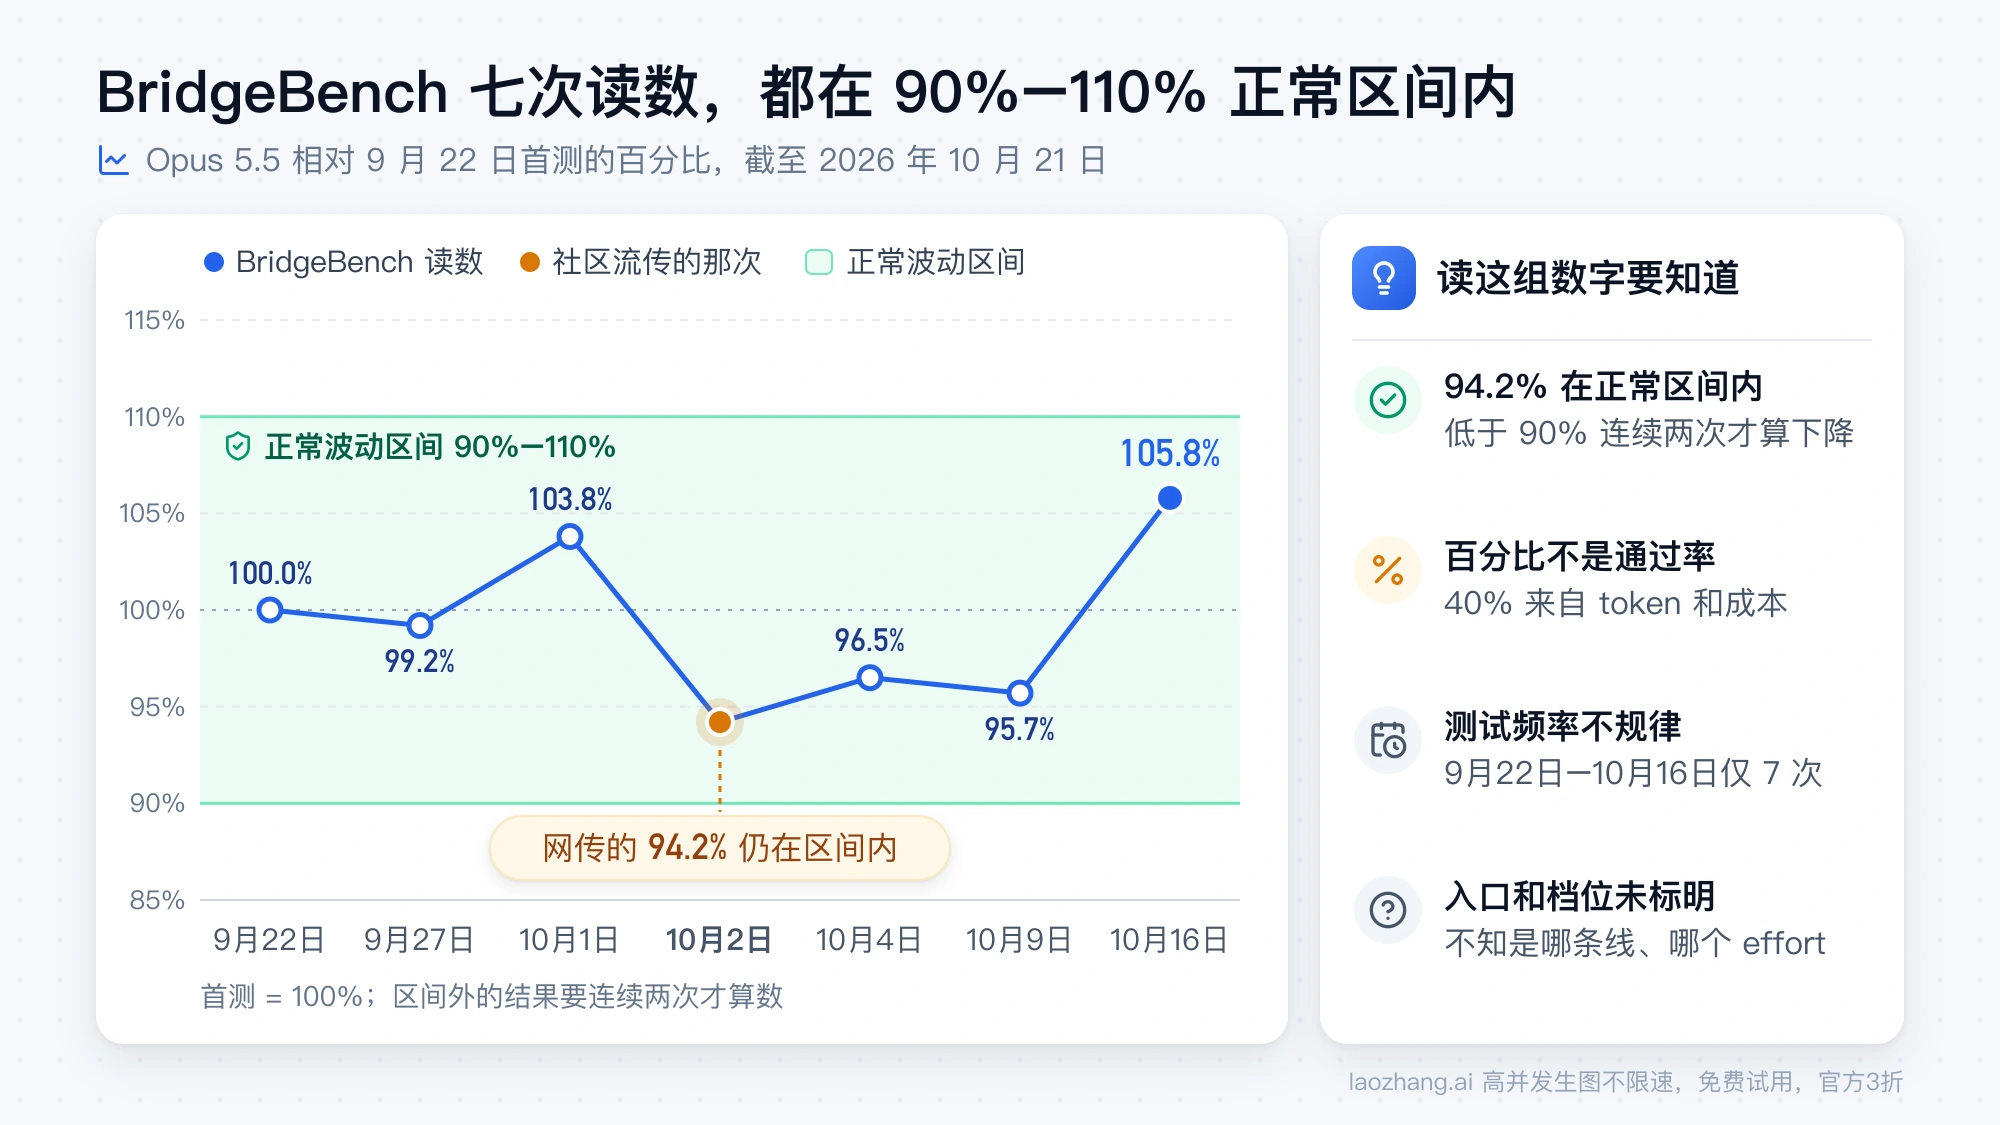
读这组数字要知道四件事:
- 94.2% 在正常区间内。BridgeBench 自己把 90%–110% 定为正常波动,Nerf Bench 方法说明写明,一个通过率 70% 左右的模型,单靠运气分数就可能上下浮动约 9 分;低于 90% 还要连续两次才会公布为下降。X 账号 @bridgemindai 10 月 2 日公布这个读数时也说,它"还在正常波动内,还不能叫 nerf"。
- 这个百分比不是通过率。它的算法是 100 ×(0.6 × 通过率比 + 0.2 × 输出 token 比 + 0.2 × 成本比),有 40% 来自 token 和成本。回答变短、变便宜,分数会上升,哪怕通过率没变;反过来也一样。
- 测试频率不规律。方法说明承诺每个模型每周至少三次,但 Opus 5.5 页面 9 月 22 日到 10 月 16 日只有 7 次测试。
- 页面没写这条曲线用的是哪个入口和哪个 effort 档位。BridgeBench 分别通过 OpenRouter、Claude Code、Codex 测模型,各成一条线;Opus 5.5 页面没标明是哪一条。
10 月 16 日它比 10 月 9 日高了 10.1 个百分点,也同样在区间内,同样不能证明"变聪明了"。
LiveNerf 的 "no change" 能说明什么
能说明"在它测得出的范围内没有变化",不能说明"证明没降智"。LiveNerf 的设计比较严格:题目是从 2,336 道 GPQA Diamond、MMLU-Pro、竞赛数学和 AIME 题里筛出的 78 道,Opus 5.5 有时答对有时答错;Claude Code 版本固定、不带工具和 CLAUDE.md;每天跑同一套题,再按事先登记的统计方法判断。截至 2026 年 10 月 20 日,30 天里已经跑了 27 天。
它的局限写在自己的 README 里:
- 每个 10 天窗口能测出的变化约 6.6 个百分点,更小的下降测不出来。
- 在验证阶段,把 Opus 5.5 换成 Opus 5,结果是 −3.8 ± 6.3 个点,在 99% 的置信水平上分不出来。也就是说,同一家族里差距这么小的模型被悄悄替换,它不一定看得出。
- 它测的是
high档、不带工具的单题问答,和你在 Claude Code 里用默认medium跑长任务不是同一种使用方式。
它在验证时还量出了 effort 的影响:相对 high,low 档输出 token 少 62%、准确率低 8.3 ± 4.5 个点;medium 档 token 少 26%、准确率低 4.2 ± 3.9 个点。这组数字下一节会用到。
Anthropic 没有说法,过去两次变差都出在模型之外
截至 2026 年 10 月 21 日,Anthropic 没有就 Opus 5.5 的质量发过任何说明。Claude 状态页在 9 月 22 日之后只记录了一次 Opus 5.5 相关事故:10 月 6 日 12:24–12:43(UTC)的"Elevated errors",这是报错增多,不是回答质量。Anthropic 员工在 X 上公开能找到的回应只涉及额度(见下一节),没有涉及模型质量。
Anthropic 的模型 ID 与版本文档说,同一个模型 ID 的权重和配置不会更新;但模型周围的服务设施会变,包括请求路由、安全分类器和采样逻辑,这些更新"偶尔会带来可观察的细微行为差异"。所以"权重没换"和"体验完全不会变"不是一回事。
过去确实发生过两次大家觉得"降智"、后来被官方承认的情况,原因都不在模型权重:
- 2025 年 9 月的事故复盘:8 月到 9 月初有三个基础设施 bug,约 30% 的 Claude Code 用户至少有一条消息被路由错。Anthropic 在复盘里写道,他们"从不因为需求、时段或服务器负载降低模型质量"。
- 2026 年 4 月 23 日的事故复盘:Claude Code 在 3 月 4 日把默认 effort 从
high改成medium,4 月 7 日改回,官方称这是"错误的取舍";另有一个清掉思考内容的 bug 从 3 月 26 日持续到 4 月 10 日,以及 4 月 16 日加进系统提示词、4 月 20 日撤回的一句压缩输出长度的指令。复盘写明 API 没有受影响。
这两次都是事后几周才被确认。它们说明的是:真的变差时,原因更可能在 Claude Code、默认档位或基础设施上,而这些恰好是你能自己检查的地方。它们不是 Opus 5.5 这次的证据。
额度掉得快不是降智:先用 /usage 看是谁在消耗
很多"降智"帖子说的其实是额度。10 月 20 日在 X 上传播最广的那条"Opus 5.5 just got nerfed"(约 71.7 万次浏览),配图是 Claude 的用量面板:5 小时额度用了 95%、每周额度用了 41%,回复里讨论的也是额度掉得快,图里没有任何回答质量的信息。
额度这一块,Claude Code 负责人 Boris Cherny 10 月 11 日回复"Max 20x 套餐 19 小时就用完了"的用户时说"我们这边没有改动"(Boris Cherny 关于额度的 X 回复),并让对方运行 claude -p /usage | pbcopy 把用量记录贴出来一起排查。他在另一条回复里说,最常见的原因是"某个效率很低的 skill"。这是员工在 X 上的回复,不是正式文档。发布公告里还写了 Pro、Max、Team 和按席位计费的 Enterprise 套餐 5 小时额度提高、并重置过一次额度。
在终端里运行:
claude -p /usagepbcopy 只在 macOS 上有,其他系统可以用 claude -p /usage > usage.txt 存成文件。在 Claude Code 2.1.306 上,输出大致是这样的结构(百分比因人而异):
Current session: 8% used · resets Oct 21 at 5:30pm (Asia/Shanghai)
Current week (all models): 62% used · resets Oct 21 at 9pm (Asia/Shanghai)

What's contributing to your limits usage?
Approximate · sessions on this machine only · shares overlap

Last 24h · 2406 requests · 25 sessions
  70%  Start fresh when you switch tasks · run /clear
  37%  Give "general-purpose" subagents a cheaper model
  Top skills: ...
  Top subagents: ...
  Top MCP servers: ...
重点看 "What's contributing" 下面几行:提示"切换任务时用 /clear 重开"占比高,说明长会话在反复消耗;子代理、skill、MCP 服务器各占多少也列得清楚。额度怎么归因、缓存和 MCP 怎么算,看 Claude Code 用量查看与 Token 审计;各套餐的 5 小时和每周额度在哪里看,看 Claude 用量限制总表。
额度问题和质量问题可能同时出现,但要分开查:额度靠 /usage,质量靠下面几节。
发布时更强、现在变笨:Opus 5.5 默认思考力度是 medium
这是最容易被忽略的一条。Opus 5.5 在 Claude Code 和 API 里的默认思考力度都是 medium,而 Opus 5 默认是 high。Opus 5.5 新特性文档写明:API 请求不带 effort 时按 medium 运行,同样的请求在 Opus 5 上是 high。发布公告里的跑分,脚注写的是"全部使用 max effort 的自适应思考"。
所以你在发布第一周看到的图表、视频评测和你日常默认用到的,很可能不是同一个档位。
Claude Code 里还有一个容易踩的坑。Claude Code 模型配置文档写明,用户设置文件里旧式的全局 effortLevel 对 Opus 5.5 不生效:你以前在 Opus 5 上用 /effort 存过 high 或 xhigh,换到 Opus 5.5 后它会从自己的默认 medium 起步,直到你单独为它选一次档位。2.1.280(9 月 22 日)的更新日志也写了这条改动。另外,2.1.293 之前,在 /model 里用左右方向键调 effort 越过最高或最低档时会绕回去,可能意外把 Low 存成默认档位。
检查和修改:
# 在会话里查看当前生效的档位
/effort status

# 在会话里改档位(也可以在 /model 选择器里改)
/effort

# 启动时直接指定
claude --effort high

# 或者用环境变量
export CLAUDE_CODE_EFFORT_LEVEL=high
档位从低到高是 low、medium、high、xhigh、max。medium 比 high 差多少,几份数据方向一致,幅度是几个点:
- Anthropic 的成本指南:在 SWE-bench Pro 的一个子集上,Opus 5.5 的
medium比high低约 2.5 个点,成本约为high的 70%。 - LiveNerf 的验证:
medium比high准确率低 4.2 ± 3.9 个点,输出 token 少 26%。 - Artificial Analysis 智能指数(Opus 5.5 各档):
low42、medium51、high54、xhigh56、max58。
几个点的差距,在简单任务上看不出来,在一个跑几十步的长任务上就可能体现为"漏了一步""改完编译不过"。如果你觉得它从某一天开始变差,先确认那天前后档位有没有变。档位越高,消耗的额度越多;Opus 5.5 和 Sonnet 5.5 在各档位上怎么取舍,看 Sonnet 5.5 和 Opus 5.5 怎么选。
在 claude.ai 网页版和 App 里,上面这些档位规则来自 Claude Code 和 API 文档,不能直接套用;网页版用户判断有没有变化,最可靠的仍是后面的固定任务对比。
被悄悄换了模型?网络安全内容换 Opus 4.8,生物内容换 Opus 5
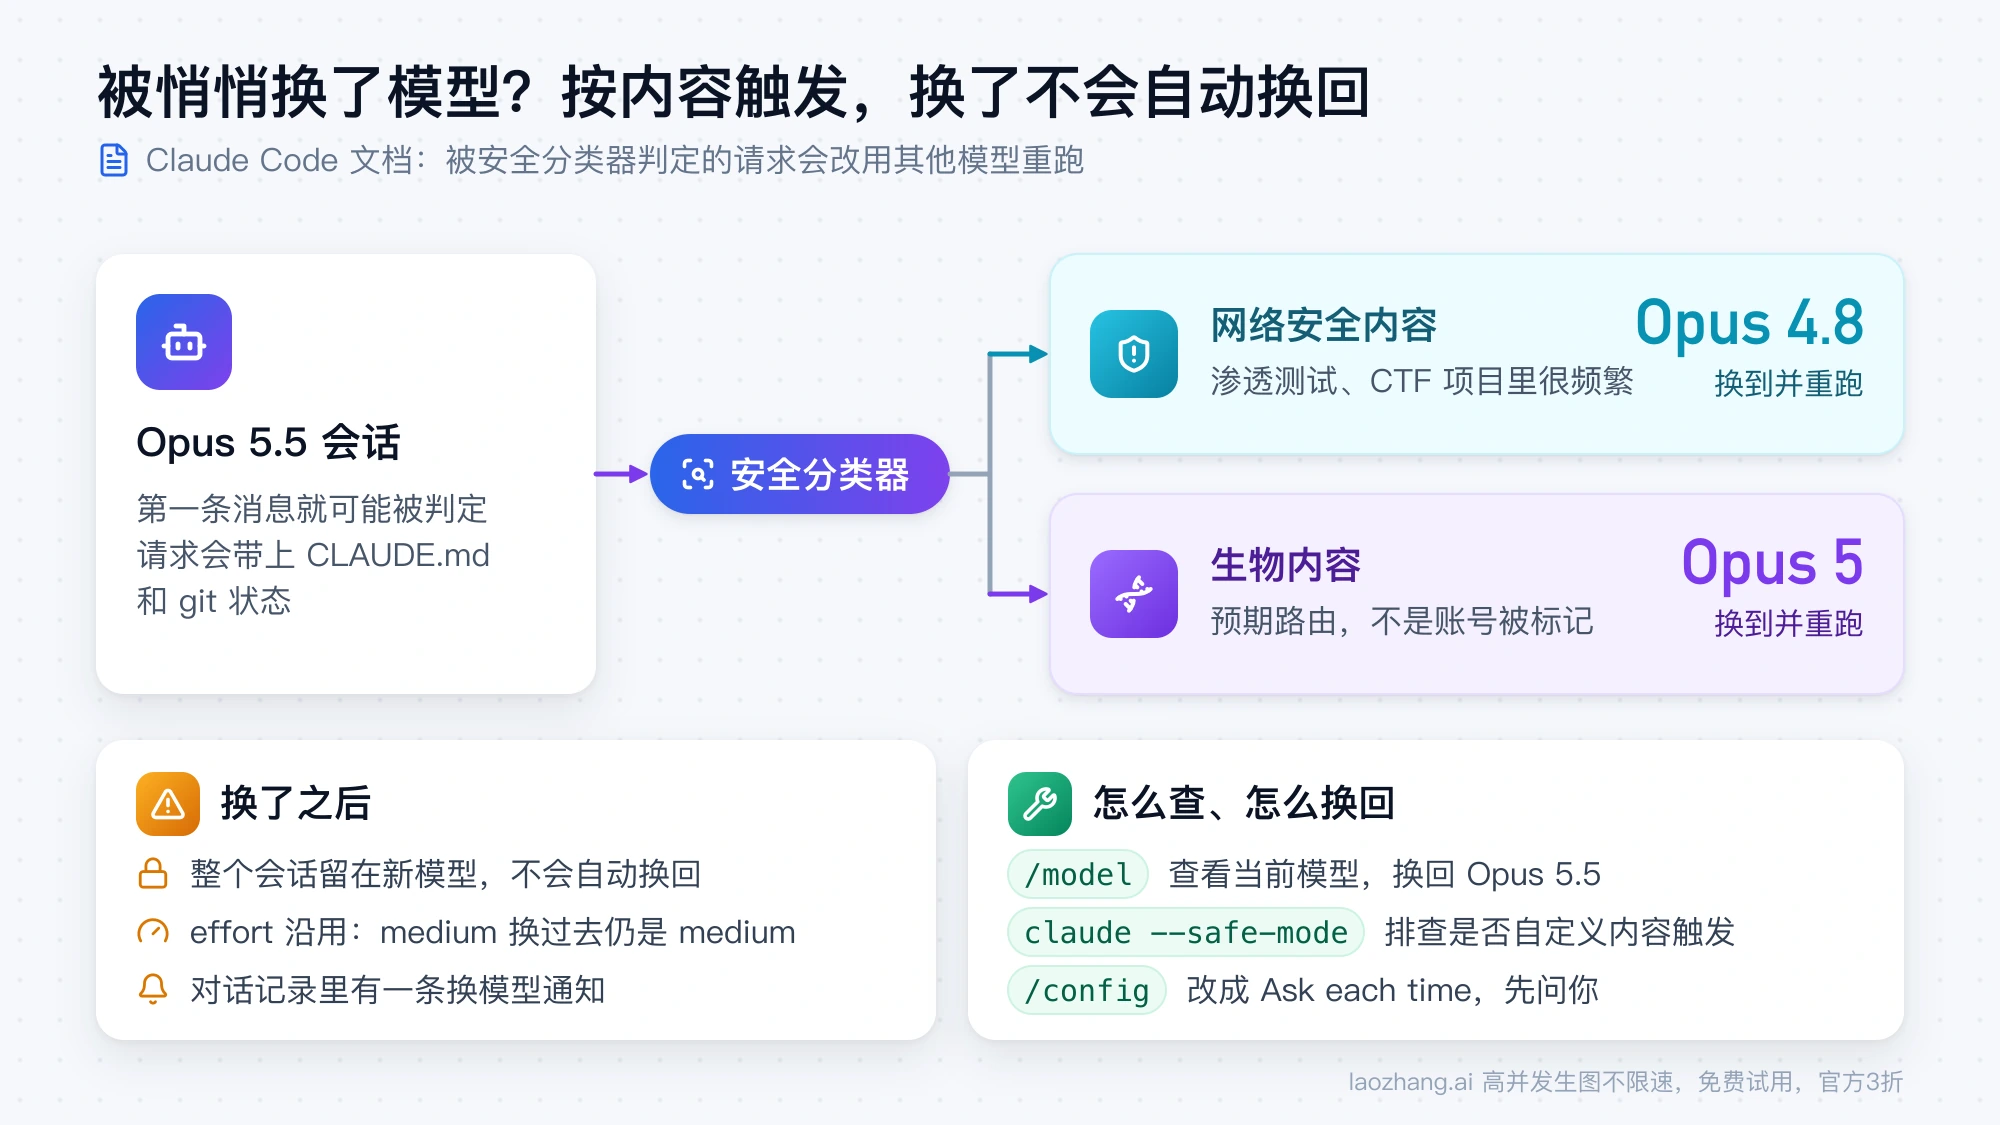
有可能,而且这是有文档的。Opus 5.5 带有安全分类器,Claude Code 文档写明:被判定为网络安全相关的请求会改用 Opus 4.8 重跑,生物相关的请求改用 Opus 5 重跑。发布公告里也说,大部分网络安全任务会被转到 Opus 4.8。
几个关键细节:
- 换了之后整个会话都留在新模型上,不会自动换回。要换回 Opus 5.5,运行
/model重新选。 - 会话第一条消息就可能触发。第一条请求会带上 CLAUDE.md 内容和 git 状态,仓库里有安全或生物相关材料,光凭这些上下文就可能被判定。
- effort 会沿用。Opus 5.5 默认
medium,换到 Opus 4.8 后仍是medium,虽然 Opus 4.8 自己默认是high。 - 界面会提示。主会话里会在对话记录中显示一条换模型的通知,很容易在长输出里被刷过去。
排查方法:
- 往回翻对话记录,找换模型的通知;或者直接运行
/model看当前模型。 - 用
claude --safe-mode启动一次。它会关掉 CLAUDE.md、skill、MCP 服务器和 hook,如果这样就不再换模型,说明是这些自定义内容触发的。git 状态和目录名不算自定义内容,仍然会发送。 - 想每次被标记时先问你,运行
/config,把 "Switch models when a message is flagged" 改成 "Ask each time",或在设置文件里把switchModelsOnFlag设为false。 - 无界面模式(
claude -p)下可以加--output-format json,返回结果里的modelUsage以实际回答的模型为键,比如claude-opus-5-5,同时带thinkingTokens(思考 token 数)。
如果你做渗透测试、CTF 或生物相关的项目,被换模型会很频繁,文档原话是:这是这些领域的预期路由,"不是账号被标记"。
是降智还是被风控了:按账号或 IP 降级没有文档
中文社区常把两件事混在一起说:"风控降智"指的是账号或 IP 被风控后,被悄悄换成更弱的模型。截至 2026 年 10 月 21 日,没有任何 Anthropic 文档、公告或员工说法支持"按账号或 IP 降智"。有文档的是上面这种按内容触发的换模型,它会在界面上提示,也能用 /model 换回。
所以遇到"突然变笨",先排查换模型的通知和 modelUsage,而不是先假设账号出了问题。用自建梯子连官方服务,只改变网络出口,请求仍然发到 Anthropic,前面几节的排查都适用。
Claude Code 版本与长会话:2.1.287 到 2.1.293 修过丢思考和重做
Opus 5.5 发布后,Claude Code 的更新日志里有几条修复,修复前的表现很像"变笨"(日期为 npm 发布日):
| 版本 | 日期 | 修了什么 |
|---|---|---|
| 2.1.287 | 10 月 1 日 | 在 Opus 5.5 和 Sonnet 5.5 之间切换时,可能丢掉之前的扩展思考内容 |
| 2.1.288 | 10 月 2 日 | 恢复 2.1.286 及更早版本开始的对话时,丢掉模型之前的思考内容 |
| 2.1.290 | 10 月 5 日 | 恢复的子代理和队友丢掉之前的思考内容和提示缓存 |
| 2.1.293 | 10 月 7 日 | 上下文压缩后,Claude 有时把压缩前最后做的操作当成没做,撤回或重做已经完成的工作 |
| 2.1.299 | 10 月 14 日 | 新增空闲压缩:20 万 token 以上的对话闲置约 54 分钟,会在一小时提示缓存过期前被自动压缩 |
"前后矛盾""把改好的又改回去"这类症状,和 2.1.293 修掉的那个问题很像。用 claude --version 看版本,低于 2.1.293 先升级再判断。空闲压缩是新功能而不是 bug,但它意味着你离开一小时回来,接着聊的是压缩后的摘要,细节可能丢失;不想要可以在 /config 的 Idle compaction 一栏关掉(2.1.302 起),或在 settings.json 里设 "idleCompaction": false。
长会话本身也会让效果变差:上下文越长,早期的约定越容易被压缩掉。换任务时用 /clear 重开,/usage 的建议里也有这一条。压缩时报错,按报错原文排查见 Claude Code 压缩失败:Error compacting conversation。
用第三方中转时:同一任务回官方入口对照
通过第三方中转或 API 代理使用 Opus 5.5 时,整条线路由中转方控制:请求最终发给哪个模型、用什么参数、返回里的 model 字段填什么,都由它决定。所以从中转自己的返回里,证明不了你用的就是 Opus 5.5、用的是哪个档位。
能做的是对照:把同一组任务、同样的提示词,分别在中转和官方入口(Claude Code 订阅或 Anthropic API)上各跑几次,比较通过率、输出长度和思考 token。差距明显且稳定,问题在线路上,不在模型本身。这一点对所有中转都一样,和哪一家无关。
Claude Code 2.1.301 还修过一个相关问题:在返回的模型名和请求不一致的 LLM 网关后面,对话会在你没选的模型上被反复压缩。走网关或中转的,至少升级到这个版本。
怎么测试 Claude 是否降智:固定任务、固定档位、前后对比
凭印象比较"上个月好像更聪明"不可靠:任务不同、上下文不同、档位可能也不同。能测出变化的做法有四条要求:
- 任务固定:同样的题、同样的提示词,最好有自动判分(跑测试、比对答案),不靠主观感觉。
- 条件固定:模型、effort、Claude Code 版本都写下来,每次一样;不带工具、MCP 和 CLAUDE.md,减少干扰。
- 记录实际回答的模型:用
--output-format json的modelUsage确认这次没有被换模型。 - 题目要让模型时对时错:每次都全对或全错的题,模型变好变差都看不出来。LiveNerf 就是从 2,336 道题里专门挑出 78 道"有时答对"的题。
一个可以直接跑的检查脚本:nerf_check.py
下面这个脚本用 claude -p 跑三道自动判分的 Python 小题,每次运行在日志里追加一行 JSON:时间、请求的模型、实际回答的模型、effort、是否全部通过、输出 token 和思考 token。隔几天用同样的参数再跑一次,比较日志,而不是比较记忆。需要 Python 3 和已登录的 Claude Code(下面的结果在 2.1.306 上跑出)。
#!/usr/bin/env python3
"""Fixed-task drift check for Claude Code (claude -p).

Runs the same small, auto-graded coding tasks with a pinned model and effort,
and appends one JSON line per run: date, requested model, model actually used,
effort, pass/fail, output and thinking tokens. Rerun it later (same tasks, same
flags) and compare the lines instead of comparing memories.

Usage: python3 nerf_check.py --model opus --effort high --repeat 2 --log runs.jsonl
"""
import argparse, json, re, subprocess, datetime, traceback

TASKS = {
    "intervals": {
        "prompt": (
            "Write a Python 3 function merge_close(intervals, gap) that takes a list of "
            "[start, end] integer pairs (start <= end, any order) and an integer gap >= 0. "
            "Merge intervals that overlap or whose distance is <= gap (distance = next.start - prev.end). "
            "Return a sorted list of [start, end] lists. Empty input returns []. "
            "Output only one ```python code block, no explanation."
        ),
        "tests": [
            ("merge_close([], 0)", []),
            ("merge_close([[5,7],[1,3]], 0)", [[1,3],[5,7]]),
            ("merge_close([[5,7],[1,3]], 2)", [[1,7]]),
            ("merge_close([[1,10],[2,3],[11,12]], 1)", [[1,12]]),
            ("merge_close([[1,1],[3,3],[6,6]], 2)", [[1,3],[6,6]]),
            ("merge_close([[0,0]], 5)", [[0,0]]),
        ],
    },
    "duration": {
        "prompt": (
            "Write a Python 3 function parse_duration(s) that converts strings like '1h30m', '2d', '45s', "
            "'1h 5m 3s', '-15m', '1.5h' into an integer number of seconds. Units: d, h, m, s (lowercase only). "
            "Spaces between parts are allowed. A leading '-' negates the whole value. Decimal numbers are allowed; "
            "round the final total to the nearest integer with round(). Each unit may appear at most once and units "
            "must appear in the order d, h, m, s. Raise ValueError for an empty string, unknown units, repeated "
            "or out-of-order units, a number without a unit, or any other text. "
            "Output only one ```python code block, no explanation."
        ),
        "tests": [
            ("parse_duration('1h30m')", 5400),
            ("parse_duration('2d')", 172800),
            ("parse_duration('1h 5m 3s')", 3903),
            ("parse_duration('-15m')", -900),
            ("parse_duration('1.5h')", 5400),
            ("parse_duration('0.5s')", 0),
            ("_raises(lambda: parse_duration(''))", True),
            ("_raises(lambda: parse_duration('5m1h'))", True),
            ("_raises(lambda: parse_duration('5m5m'))", True),
            ("_raises(lambda: parse_duration('10'))", True),
            ("_raises(lambda: parse_duration('3w'))", True),
            ("_raises(lambda: parse_duration('1H'))", True),
        ],
    },
    "roman": {
        "prompt": (
            "Write a Python 3 function roman_strict(s) that converts a Roman numeral string to an int, accepting "
            "only canonical (standard modern) forms for 1..3999 in uppercase. Reject non-canonical forms such as "
            "'IIII', 'VV', 'IC', 'XM', 'IIX', 'MMMM', 'VX', 'LC', 'DM', 'IL', empty string and lowercase by raising "
            "ValueError. Output only one ```python code block, no explanation."
        ),
        "tests": [
            ("roman_strict('MCMXCIV')", 1994),
            ("roman_strict('MMMCMXCIX')", 3999),
            ("roman_strict('XLIX')", 49),
            ("roman_strict('CDXLIV')", 444),
            ("_raises(lambda: roman_strict('IIII'))", True),
            ("_raises(lambda: roman_strict('IC'))", True),
            ("_raises(lambda: roman_strict('IIX'))", True),
            ("_raises(lambda: roman_strict('MMMM'))", True),
            ("_raises(lambda: roman_strict('VX'))", True),
            ("_raises(lambda: roman_strict('XCX'))", True),
            ("_raises(lambda: roman_strict('CMC'))", True),
            ("_raises(lambda: roman_strict('xiv'))", True),
            ("_raises(lambda: roman_strict(''))", True),
        ],
    },
}


def _raises(fn):
    try:
        fn()
    except ValueError:
        return True
    except Exception:
        return False
    return False


def grade(code, tests):
    ns = {"_raises": _raises}
    try:
        exec(code, ns)
    except Exception:
        return 0, len(tests), "exec error: " + traceback.format_exc(limit=1).strip().splitlines()[-1]
    ok = 0
    fails = []
    for expr, want in tests:
        try:
            got = eval(expr, ns)
        except Exception as e:
            got = f"<{type(e).__name__}>"
        if got == want:
            ok += 1
        else:
            fails.append(f"{expr} -> {got!r}")
    return ok, len(tests), "; ".join(fails)[:400]


def run_one(task, model, effort, timeout):
    cmd = ["claude", "-p", TASKS[task]["prompt"], "--model", model, "--effort", effort,
           "--output-format", "json", "--tools", "", "--strict-mcp-config",
           "--disable-slash-commands", "--no-session-persistence"]
    p = subprocess.run(cmd, capture_output=True, text=True, timeout=timeout, stdin=subprocess.DEVNULL)
    d = json.loads(p.stdout)
    m = re.search(r"```(?:python)?\n(.*?)```", d.get("result", ""), re.S)
    code = m.group(1) if m else d.get("result", "")
    ok, total, fails = grade(code, TASKS[task]["tests"])
    used = d.get("modelUsage", {})
    name = next(iter(used), None)
    mu = used.get(name, {}) if name else {}
    return {
        "time": datetime.datetime.now().isoformat(timespec="seconds"),
        "task": task, "model_requested": model, "model_used": list(used.keys()),
        "provider": mu.get("provider"), "effort": effort,
        "passed": ok == total, "score": f"{ok}/{total}", "fails": fails,
        "output_tokens": mu.get("outputTokens"), "thinking_tokens": mu.get("thinkingTokens"),
        "cost_usd_list": d.get("total_cost_usd"), "duration_ms": d.get("duration_ms"),
        "fallback_credit": d.get("usage", {}).get("fallback_credit"),
    }


if __name__ == "__main__":
    ap = argparse.ArgumentParser()
    ap.add_argument("--model", default="opus")
    ap.add_argument("--effort", default="high")
    ap.add_argument("--repeat", type=int, default=2)
    ap.add_argument("--tasks", default=",".join(TASKS))
    ap.add_argument("--log", default="runs.jsonl")
    ap.add_argument("--timeout", type=int, default=300)
    a = ap.parse_args()
    for _ in range(a.repeat):
        for t in a.tasks.split(","):
            try:
                row = run_one(t, a.model, a.effort, a.timeout)
            except Exception as e:
                row = {"time": datetime.datetime.now().isoformat(timespec="seconds"), "task": t,
                       "effort": a.effort, "error": f"{type(e).__name__}: {e}"[:300]}
            with open(a.log, "a") as f:
                f.write(json.dumps(row) + "\n")
            print(json.dumps(row))
保存为 nerf_check.py,在一个空目录里运行:
python3 nerf_check.py --model opus --effort low --repeat 2
python3 nerf_check.py --model opus --effort high --repeat 2脚本会执行模型返回的代码来判分,所以放在一个没有重要文件的空目录里跑。--tools "" 关掉了工具,模型不会在你的机器上执行命令;关掉工具也能省下会话启动的开销:同一台机器上,带默认工具发一句"Reply with OK"就写入了 26,297 个缓存 token,按标价约合 $0.21。
2026 年 10 月 21 日的一次运行:12 次全过,思考 token 差 3–4 倍
运行条件:2026 年 10 月 21 日 13:48–13:50(北京时间),一台 macOS 机器,Claude Code 2.1.306,Max 订阅,Opus 5.5 在 low 和 high 两档各跑 2 轮,每轮 3 题,共 12 次。
| 题目 | 结果 | low 思考 token(2 次) | high 思考 token(2 次) | 耗时 |
|---|---|---|---|---|
| 区间合并 intervals | 4 次全部通过 6/6 | 0 / 0 | 0 / 0 | 两档都在 3–8 秒 |
| 时长解析 duration | 4 次全部通过 12/12 | 292 / 273 | 1,109 / 876 | low 约 10 秒,high 约 17–18 秒 |
| 严格罗马数字 roman | 4 次全部通过 13/13 | 0 / 0 | 136 / 138 | low 约 4 秒,high 约 8 秒 |
12 次的 modelUsage 都是 claude-opus-5-5、provider 为 firstParty,没有发生换模型。12 次按标价合计约 $0.29;订阅用户这笔不扣钱,扣的是额度。
能从这次运行看出的:
- effort 确实改变思考量。最难的时长解析题上,
high的思考 token 是low的 3–4 倍(1,109 ÷ 292 ≈ 3.8,876 ÷ 273 ≈ 3.2),耗时也接近翻倍。 - 这三道题太简单,分不出质量。两档都是 12 次全过,即使 Opus 5.5 真的变差几个点,这组题也测不出来。
看不出的:这次运行只有一台机器、一天、每格 2 次,不是跑分,不能用来说明 Opus 5.5 降智或没降智。它演示的是方法:同样的命令,过一周再跑一次,比较两份日志。
把题换成 Opus 5.5 时对时错的题
脚本真正有用,要换上你自己的题。挑题办法:
- 从你的项目里找几个能用测试自动判对错的任务(写一个函数、修一个有测试覆盖的 bug),照脚本里
TASKS的格式加进去:prompt是提示词,tests是"表达式 → 期望值"的列表。 - 用你平时的档位,每题先跑 5 次左右,留下有时通过、有时不通过的题;每次都全过或全错的题删掉。
- 记下当前 Claude Code 版本(
claude --version),以后对比时版本最好一致。Claude Code 更新本身也会改变结果,LiveNerf 为此把版本固定在 2.1.280。 - 每隔几天用同样的参数跑一次,比较通过率、思考 token 和
model_used。样本少时,一两次的差异说明不了问题,至少看几轮的趋势。
如果思考 token 明显变少、通过率同时下降,而模型、档位、版本都没变,这才是值得拿出来讨论的证据。把日志和条件一起贴出来,比一句"感觉变笨了"有说服力得多。
避开高峰期、等 Fable 5.5:几个降智说法的依据
避开美国高峰期用 Claude 能避免降智吗?
没有依据。这个说法在中文论坛流传很久,但 Anthropic 在 2025 年 9 月的事故复盘里明确说过,"从不因为需求、时段或服务器负载降低模型质量",当时的问题来自基础设施 bug。高峰期可能更容易遇到报错或排队,那是可用性问题,和回答质量是两回事。
"下周要出 Fable 5.5,所以先降智"有依据吗?
没有。这是 X 和自媒体上的猜测,没有任何公告或数据支持。截至 2026 年 10 月 21 日,BridgeBench 和 LiveNerf 在这段时间都没测出超出波动的下降。
网上的"降智测试""降智雷达"类网站该怎么看?
看任何一个这类网站的分数前,先确认三件事:测的是哪个入口和哪个 effort 档位;正常波动区间有多大、多少样本才算一次结果;有没有对照组。BridgeBench 的 94.2% 就是一个例子:单看数字像是降了,放回它自己的波动区间里就不算。
Claude Code 变笨了,换回 Opus 5 有用吗?
先别急着换。Opus 5 默认是 high,Opus 5.5 默认是 medium,你感觉到的差别可能主要来自档位。更直接的试法是把 Opus 5.5 调到 high,用同一个任务对比。LiveNerf 在验证时把 Opus 5.5 换成 Opus 5,结果是 −3.8 ± 6.3 个点,统计上分不出两者。API 价格和额度重置怎么算,见 Claude Opus 5.5 价格与用量重置。
Opus 4.6 那次"变笨"和这次一样吗?
不完全一样。Opus 4.6 时期那一波,Anthropic 在 2026 年 4 月 23 日的复盘里承认了三处原因:Claude Code 默认 effort 被下调、一个清掉思考内容的 bug、一句损害编程质量的系统提示词,都已修复或撤回。Opus 5.5 目前没有类似的官方说明。Opus 4.6 时期怎么排查思考模式、上下文和路由,见 Claude Opus 4.6 变笨了?。
参考来源11
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月21日。
参考来源11
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月21日。
- 1.BridgeBench Nerf Bench 的 Opus 5.5 页面bridgebench.ai/nerf-bench/claude-opus-5-5
- 2.LiveNerf 开源测量项目github.com/ninjahawk/livenerf
- 3.Nerf Bench 方法说明bridgebench.ai/blog/the-methodology-of-nerfbench
- 4.Claude 状态页status.claude.com
- 5.模型 ID 与版本文档platform.claude.com/docs/en/about-claude/models/model-ids-and-versions
- 6.2025 年 9 月的事故复盘anthropic.com/engineering/a-postmortem-of-three-recent-issues
- 7.2026 年 4 月 23 日的事故复盘anthropic.com/engineering/april-23-postmortem
- 8.Boris Cherny 关于额度的 X 回复x.com/bcherny/status/2109426207658066360
- 9.Opus 5.5 新特性文档platform.claude.com/docs/en/models/opus-5-5/whats-new-opus-5-5
- 10.Claude Code 模型配置文档code.claude.com/docs/en/model-config
- 11.Claude Code 的更新日志github.com/anthropics/claude-code/blob/main/CHANGELOG.md