Opus 5.5 能生成视频吗:它写代码,画面靠渲染
Claude Opus 5.5 只输出文本,不直接产出视频。流传的片子是它写的动画代码,经无头浏览器逐帧截图、FFmpeg 合成;动态图形适合这样做,写实真人镜头仍要用视频模型。
文章目录
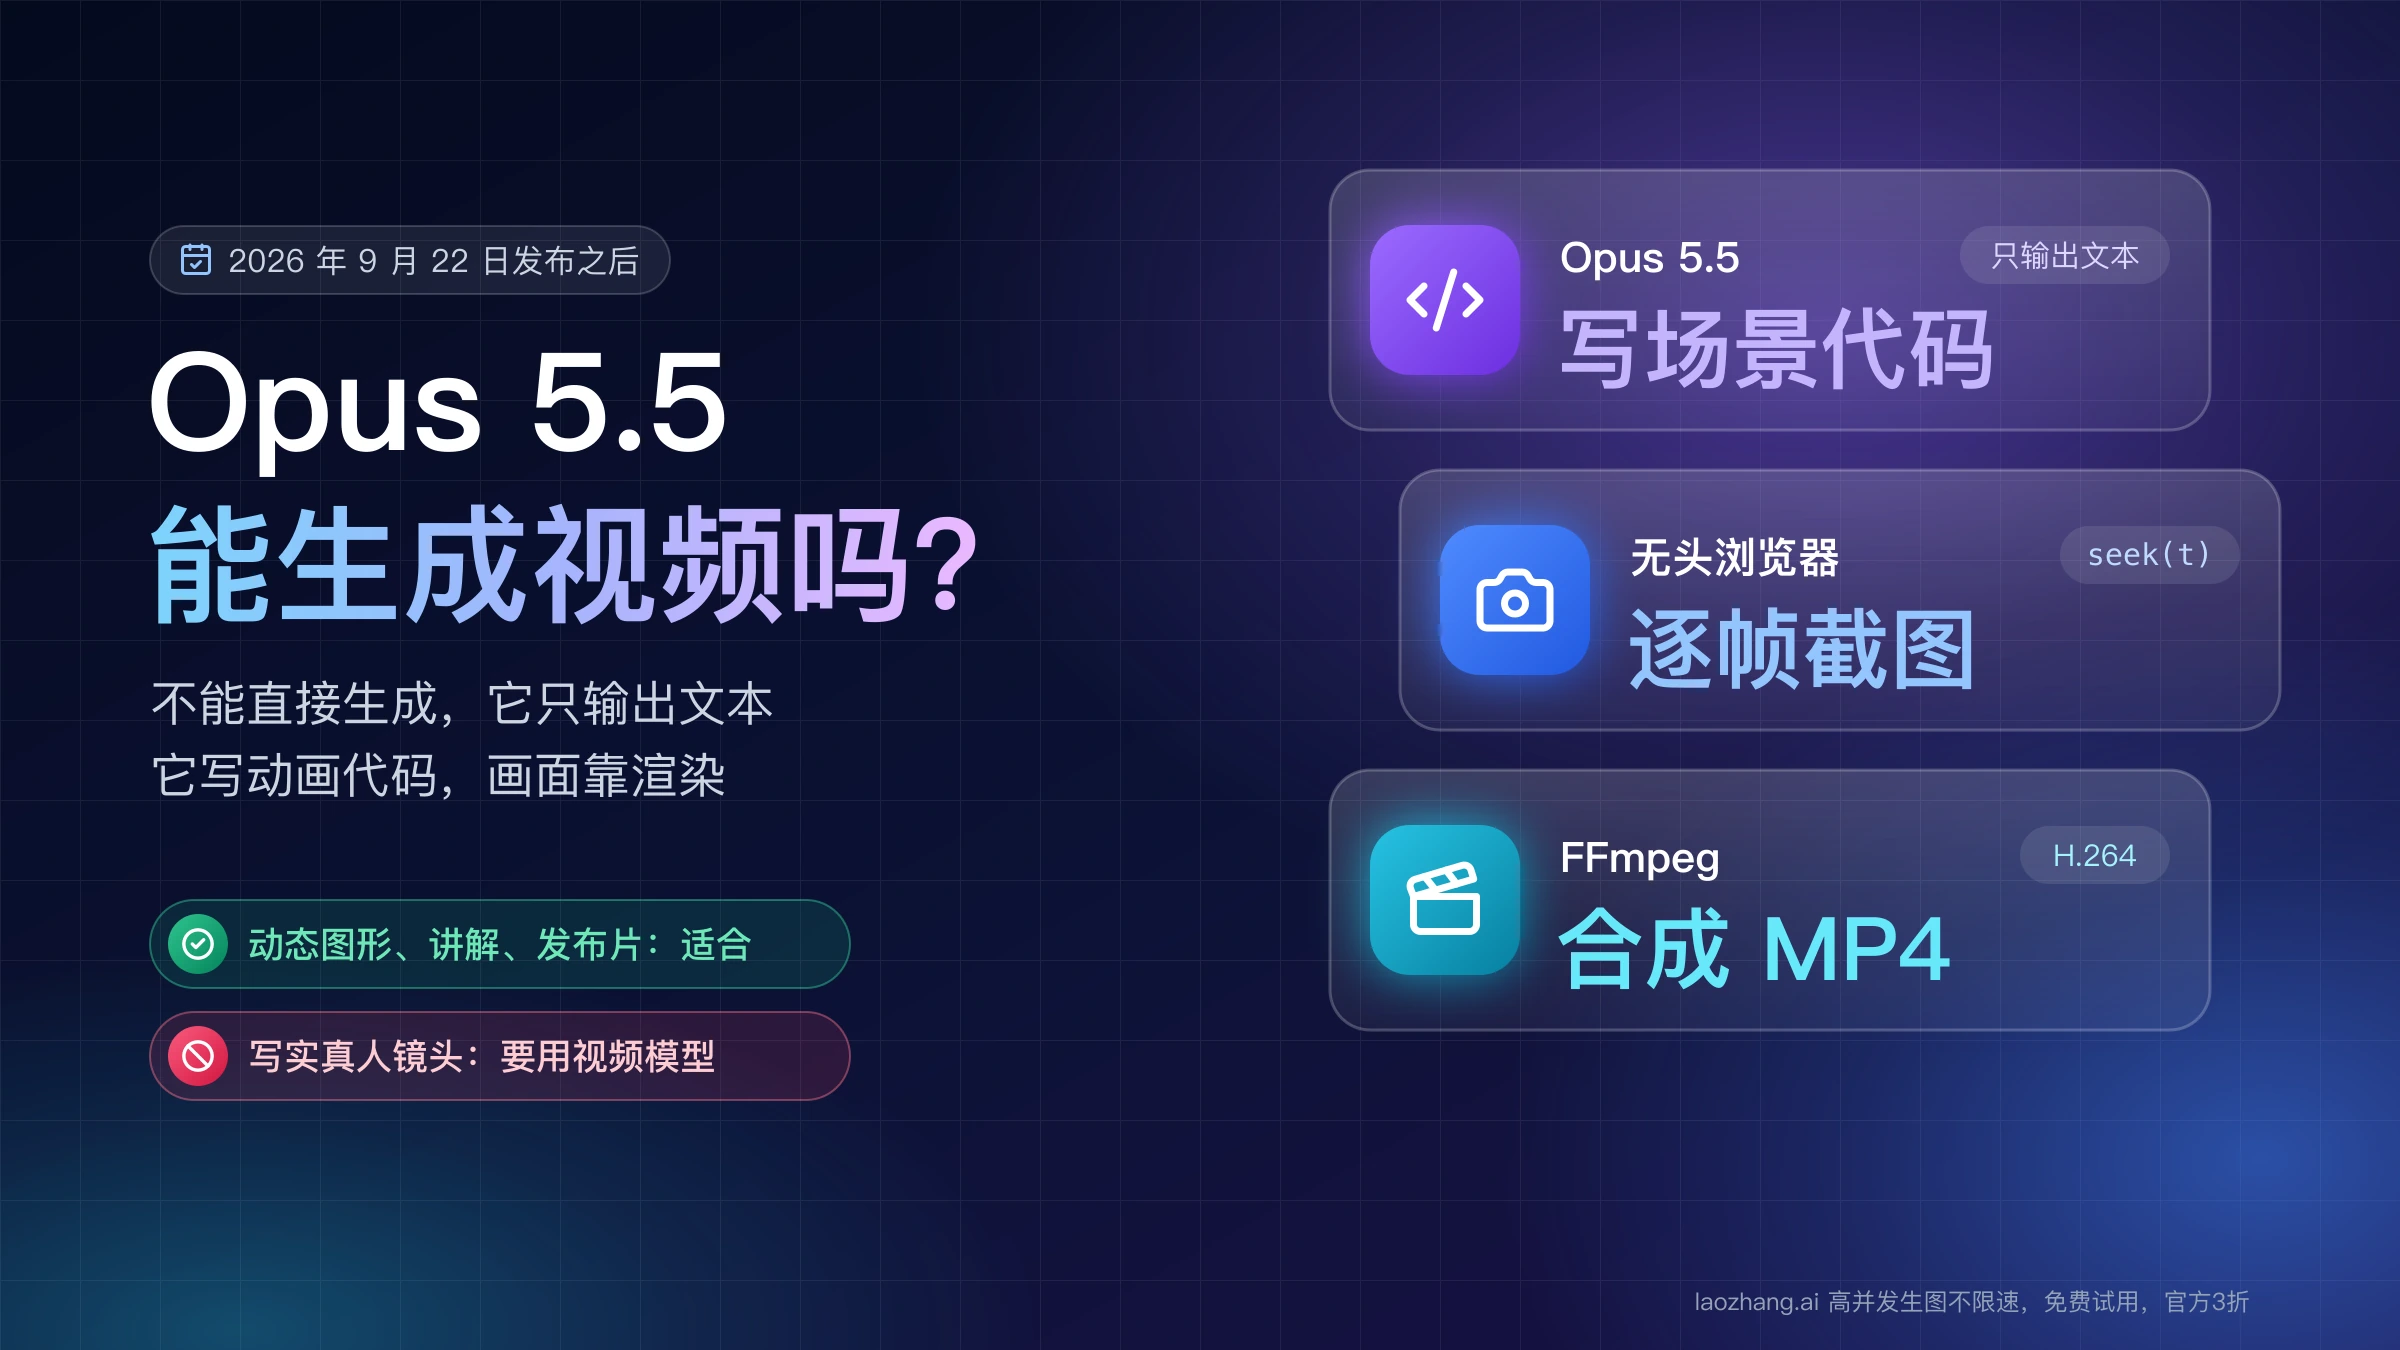
Claude Opus 5.5 不能像 Seedance、Runway 那样直接生成视频。它和所有现行 Claude 模型一样,输入是文本和图片,输出只有文本,这是 Anthropic 模型总览里写明的。2026 年 9 月 22 日发布之后流传的那些“Opus 5.5 做的视频”,模型交出来的是一份动画代码,画面是浏览器或其他渲染器按这份代码算出来的,再由 FFmpeg 压成 MP4。有人说它“一帧都没生成”,这个说法是准确的。
这件事直接决定了它能做什么片子:
- 画面能用代码描述的片子,比如动态图形、产品发布片、科普讲解、数据图表、歌词 MV,可以走这条路,而且每个元素都能改、能重渲染。
- 写实的真人镜头、自然口型、实拍质感,代码画不出来,要用视频生成模型。常见的搭配是视频模型出素材,Opus 5.5 负责编排和剪辑。
- 想自己试,需要的是 Claude Code 之类能读写文件、跑命令的环境,加上本机的 Node.js、Chrome 和 FFmpeg。一台 Apple M4 上,12 秒、30 fps 的 1080p 成片从截图到出 MP4 用了约半分钟,过程和数字见下文。
Opus 5.5 交出来的是代码,不是视频文件
“生成视频”在这里指两件不同的事。视频生成模型根据提示词直接算出像素,你拿到的是一段不能拆开的画面。Opus 5.5 生成的是文字,具体来说是一份 HTML、JavaScript 或 Python 程序,程序里写着每个时刻画面上有什么、在哪里、是什么颜色。把这份程序交给渲染器跑一遍,才有画面。
Anthropic 自己并没有把这当成一项功能来宣传。Opus 5.5 的发布公告通篇没有出现视频、动画或动态图形,这种用法是用户在发布后几天里自己摸索出来的。和它最接近的官方说法在 Claude 帮助中心谈图片的那篇说明里:Claude 不会像图片生成工具那样生成照片或插画,但可以用 HTML 和 SVG 做出图表和可交互的可视化。视频是同一个思路往前走一步,把“一张用代码画的图”换成“一串用代码画的图”。Claude 在图片这一侧到底能输出什么,可以看Claude能生成图片吗?Claude视觉能力完全指南(2026)。
公开的实现里,LaunchVideo(仓库名是 shipvideo)把这个过程写得最直白。它的 README 开头就是“No video model”:Opus 5.5 把整部片子写成一个 1920×1080 的 HTML 文档,服务端在无头 Chromium 里逐帧渲染,用 FFmpeg 编码,产出一条 20 到 40 秒的产品发布片。渲染之前还有一步检查,把场景加载起来,在几个时间点上报告 JavaScript 错误和画面上可见的文字,有问题先改再渲染。
所以整条流水线是四段:
- 模型写场景代码,并约定好“给一个时间 t,就画出 t 时刻的画面”。
- 无头浏览器打开场景,把时间拨到第 0 帧、第 1 帧、第 2 帧……每拨一次截一张图。
- 截图按顺序送进 FFmpeg,编码成 H.264 的 MP4。
- 抽几帧出来看,有问题就改代码重渲染。
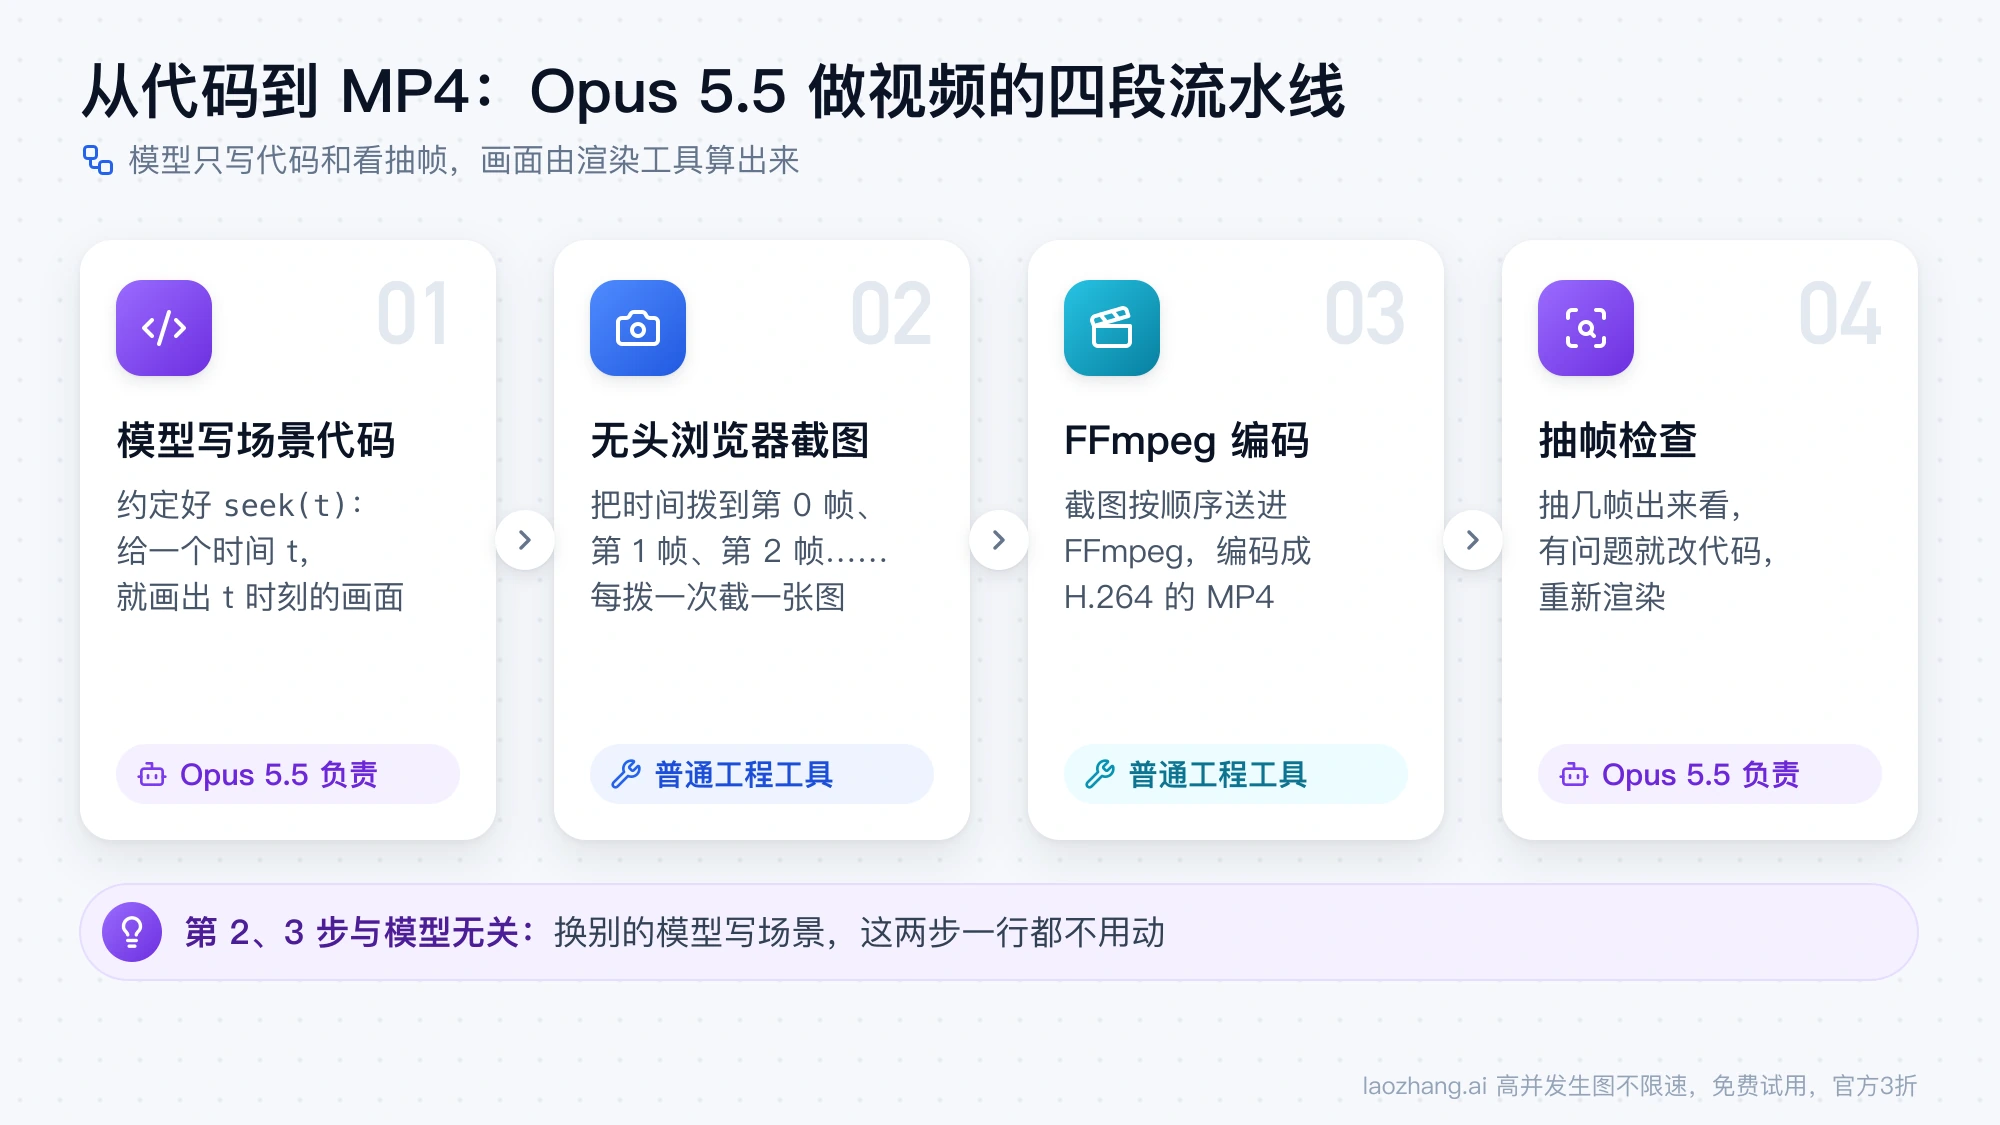
模型的能力体现在第 1 步和第 4 步:画面设计、动效节奏、代码正确性,以及看了抽帧之后知道该改哪里。第 2、3 步是普通的工程工具,换成别的模型写场景,这两步一行都不用动。
哪些片子适合这样做,哪些必须用视频模型
判断标准只有一条:画面能不能用形状、文字、路径、图表和数学公式描述出来。
GitHub 上收集案例和提示词的仓库 joeseesun/opus-video-prompts 对 9 月 22 日到 25 日的公开案例做过归纳:擅长的是动态图形、手绘、线稿和水墨风格的动画、科普讲解、产品发布片、歌词 MV,不擅长写实的真人镜头;需要写实画面时,常见做法是让它调用 Seedance、Runway、Higgsfield 这类视频模型,自己负责编排和剪辑。这是整理者基于案例的判断,不是评测结论,但和这套做法的原理吻合。
另一个仓库 awesome-opus-5-5-videos 给了一份量化的样本。截至 2026 年 9 月 26 日,它从 X 上抓到 1,401 个视频文件,其中 1,119 个被分类器标为与 Opus 5.5 有关或很可能有关;主要风格里,动态图形与界面类 350 个,3D 渲染类 324 个,合计占 60.2%;题材排前三的是游戏与交互(230 个)、广告与发布(215 个)、讲 AI 本身的内容(201 个);预览时长的中位数是 39.20 秒。仓库自己提醒,标签是 Gemini 3.8 Flash 根据帖子文字和九张抽帧打的,不能证明模型调用和作者身份,样本也不是随机抽取。它能说明的是大家公开晒出来的片子长什么样:短,以图形和 3D 为主,很少是实拍质感。
落到自己的片子上,可以这样分:
| 你要做的片子 | 该走哪条路 | 原因 |
|---|---|---|
| 产品发布片、功能演示、界面动效 | 代码渲染 | 文字、界面、图形都能精确描述,品牌色和文案可以逐字控制 |
| 科普讲解、数学或论文讲解、数据图表动画 | 代码渲染 | 数字和公式必须准确,代码画的图不会画错数字 |
| 歌词 MV、线稿或水墨风格动画 | 代码渲染 | 风格化画面可以用笔刷库和程序化绘制实现 |
| 真人出镜、自然口型、实拍质感的空镜 | 视频生成模型 | 这类像素没法用代码描述 |
| 写实素材加字幕、图形包装和剪辑 | 两者配合 | 视频模型出素材,Opus 5.5 写剪辑和包装的代码 |
代码渲染还有两个视频模型给不了的性质。一是可改:第 8 秒的标题错了一个字,改一行代码重渲染即可,其余画面不会跟着变。二是可重复:同一份代码渲染出来的结果每次相同,后面的测试里两次渲染的 MP4 大小都是 915,183 字节。反过来,它的上限也受代码约束,画面再精致也是“设计出来的动画”,不会有实拍的光影和偶然性。
如果你的片子落在视频模型那一侧,Seedance 2.5 API 接入指南:模型 ID、Python 与 Node.js讲的是用代码调用真正的视频生成模型,成片要花多少钱可以看AI 视频生成要多少钱:每秒价格、订阅与成片成本。
在自己电脑上渲染出第一条 MP4
最省事的环境是 Claude Code:模型可以自己写文件、跑渲染命令、抽帧查看、再改代码。opus-video-prompts 仓库给的起步配置是 Claude Code 里选 Opus 5.5,effort 调到 high 或 xhigh(Opus 5.5 的默认档是 medium),本机装好 Node.js、Chrome 和 FFmpeg。在聊天应用里也能让它写出场景代码,但渲染这一步得你自己在本机跑。
下面这套做法不依赖任何视频框架,只有一个场景文件和一个渲染脚本。
先和模型约定场景怎么写
让模型写场景时,把这几条写进要求里:
- 整部片子是一个 HTML 文件,画布 1920×1080。
- 暴露
window.DURATION,值是片长的秒数。 - 暴露
window.seek(t):传入秒数 t,画出 t 时刻的完整画面。画面只取决于 t,不取决于这个函数被调用过几次、什么时候调用。 - 不用
performance.now()、Date.now()或requestAnimationFrame推进动画。 - 需要随机效果时用带固定种子的伪随机函数,不用
Math.random()。 - 不引用外部图片和网络字体。
实测用的场景是 Opus 5.5 在 Claude Code 里一次写成的 Canvas 2D 动画,没有人工修改。关键的几行是这样的(节选):
// 每个像素都是时间 t(秒)的纯函数
window.DURATION = 12;

// 带种子的伪随机:每次渲染粒子位置都一样
function rng(seed) {
  return () => {
    seed = (seed * 1664525 + 1013904223) >>> 0;
    return seed / 4294967296;
  };
}
const r = rng(55);

window.seek = async (t) => {
  ctx.clearRect(0, 0, W, H);
  bg(t);
  title(t);
  pipeline(t);
};bg、title、pipeline 三个函数分别画背景粒子、标题和流程图,它们都只接收 t。淡入淡出也不靠 CSS 过渡,而是按 t 算出透明度。
渲染脚本
渲染脚本做的事很少:打开场景,按帧调用 seek,截图,把截图通过管道送给 FFmpeg。它通过 playwright-core 驱动本机已安装的 Chrome,不需要另外下载浏览器。
// node render.mjs scene.html out.mp4 [fps] [png|jpeg]
import { chromium } from "playwright-core";
import { spawn } from "node:child_process";
import { once } from "node:events";
import { createHash } from "node:crypto";
import { statSync } from "node:fs";
import path from "node:path";
import { pathToFileURL } from "node:url";

const [scene, out, fpsArg = "30", type = "png"] = process.argv.slice(2);
if (!scene || !out) throw new Error("Usage: node render.mjs scene.html out.mp4 [fps] [png|jpeg]");
const fps = Number(fpsArg);
const started = Date.now();
const browser = await chromium.launch({ channel: "chrome", headless: true });
const page = await browser.newPage({ viewport: { width: 1920, height: 1080 }, deviceScaleFactor: 1 });
await page.goto(pathToFileURL(path.resolve(scene)).href);
await page.waitForFunction(() => typeof window.seek === "function");
await page.evaluate(() => document.fonts.ready);
const total = Math.round((await page.evaluate(() => window.DURATION)) * fps);

const ff = spawn("ffmpeg", ["-y", "-loglevel", "error", "-f", "image2pipe", "-framerate", String(fps), "-i", "-",
  "-c:v", "libx264", "-pix_fmt", "yuv420p", "-crf", "18", "-movflags", "+faststart", out],
  { stdio: ["pipe", "inherit", "inherit"] });
const hash = createHash("sha256");
const shotOpts = type === "jpeg" ? { type: "jpeg", quality: 92 } : { type: "png" };
const captureStart = Date.now();
for (let i = 0; i < total; i++) {
  await page.evaluate((t) => window.seek(t), i / fps);
  const buf = await page.screenshot(shotOpts);
  hash.update(buf);
  if (!ff.stdin.write(buf)) await once(ff.stdin, "drain");
}
const captureMs = Date.now() - captureStart;
ff.stdin.end();
const [code] = await once(ff, "close");
await browser.close();
if (code !== 0) throw new Error(`ffmpeg exited with ${code}`);
console.log(JSON.stringify({
  scene, out, fps, frames: total, shot: type,
  capture_seconds: +(captureMs / 1000).toFixed(2),
  total_seconds: +((Date.now() - started) / 1000).toFixed(2),
  ms_per_frame: +(captureMs / total).toFixed(1),
  mp4_bytes: statSync(out).size,
  frames_sha256: hash.digest("hex").slice(0, 16),
}));
把它存成 render.mjs,和 scene.html 放在同一个目录,然后:
npm install playwright-core
node render.mjs scene.html out.mp4 30 png
脚本结束时会打印一行 JSON,里面有帧数、截图耗时、每帧毫秒数、MP4 字节数,以及所有截图合在一起的哈希。这个哈希后面用来判断两次渲染是否一致。
检查成片
渲染完别急着看整条片子,先做三件事:
# 1. 规格对不对:编码、分辨率、帧率、帧数、时长
ffprobe -v error -select_streams v:0 \
  -show_entries stream=codec_name,width,height,r_frame_rate,nb_frames,duration out.mp4

# 2. 抽一帧出来看画面
ffmpeg -ss 9.5 -i out.mp4 -frames:v 1 f.png

# 3. 解码后的逐帧校验值,两次渲染应当完全相同
ffmpeg -v error -i out.mp4 -f framemd5 -
第 2 步最有用。在场景里留一个显示帧号和时间的调试文字,抽出来的那一帧显示的时间应该正好等于你抽帧的位置。实测里在 9.5 秒处抽帧,画面上写的是 frame 285 / 360、t = 9.500 s,285 正好是 9.5 × 30。对不上,就说明场景没有老老实实按 t 画。在 Claude Code 里,这一步可以让模型自己抽帧自己看,文字重叠、元素出画之类的问题它能看出来。
实测:12 秒成片的帧数、耗时与文件大小
下面的数字来自 2026 年 10 月 1 日的一次本机测试,条件如下:Apple M4(10 核)、16 GB 内存、macOS 26.1,Node 24.11.0,playwright-core 1.63.0 驱动 Chrome 154 无头模式,视口 1920×1080,FFmpeg 8.0.1(libx264,crf 18,yuv420p)。场景是上一节那个 12 秒的 Canvas 2D 动画,30 fps,没有音频。
| 截图格式 | 帧数 | 截图耗时 | 每帧 | 全程耗时 | MP4 大小 |
|---|---|---|---|---|---|
| PNG,第 1 次 | 360 | 25.93 秒 | 72 毫秒 | 33.46 秒 | 915,183 字节 |
| PNG,第 2 次 | 360 | 25.80 秒 | 71.7 毫秒 | 27.24 秒 | 915,183 字节 |
| JPEG,质量 92 | 360 | 11.51 秒 | 32 毫秒 | 12.72 秒 | 1,093,045 字节 |
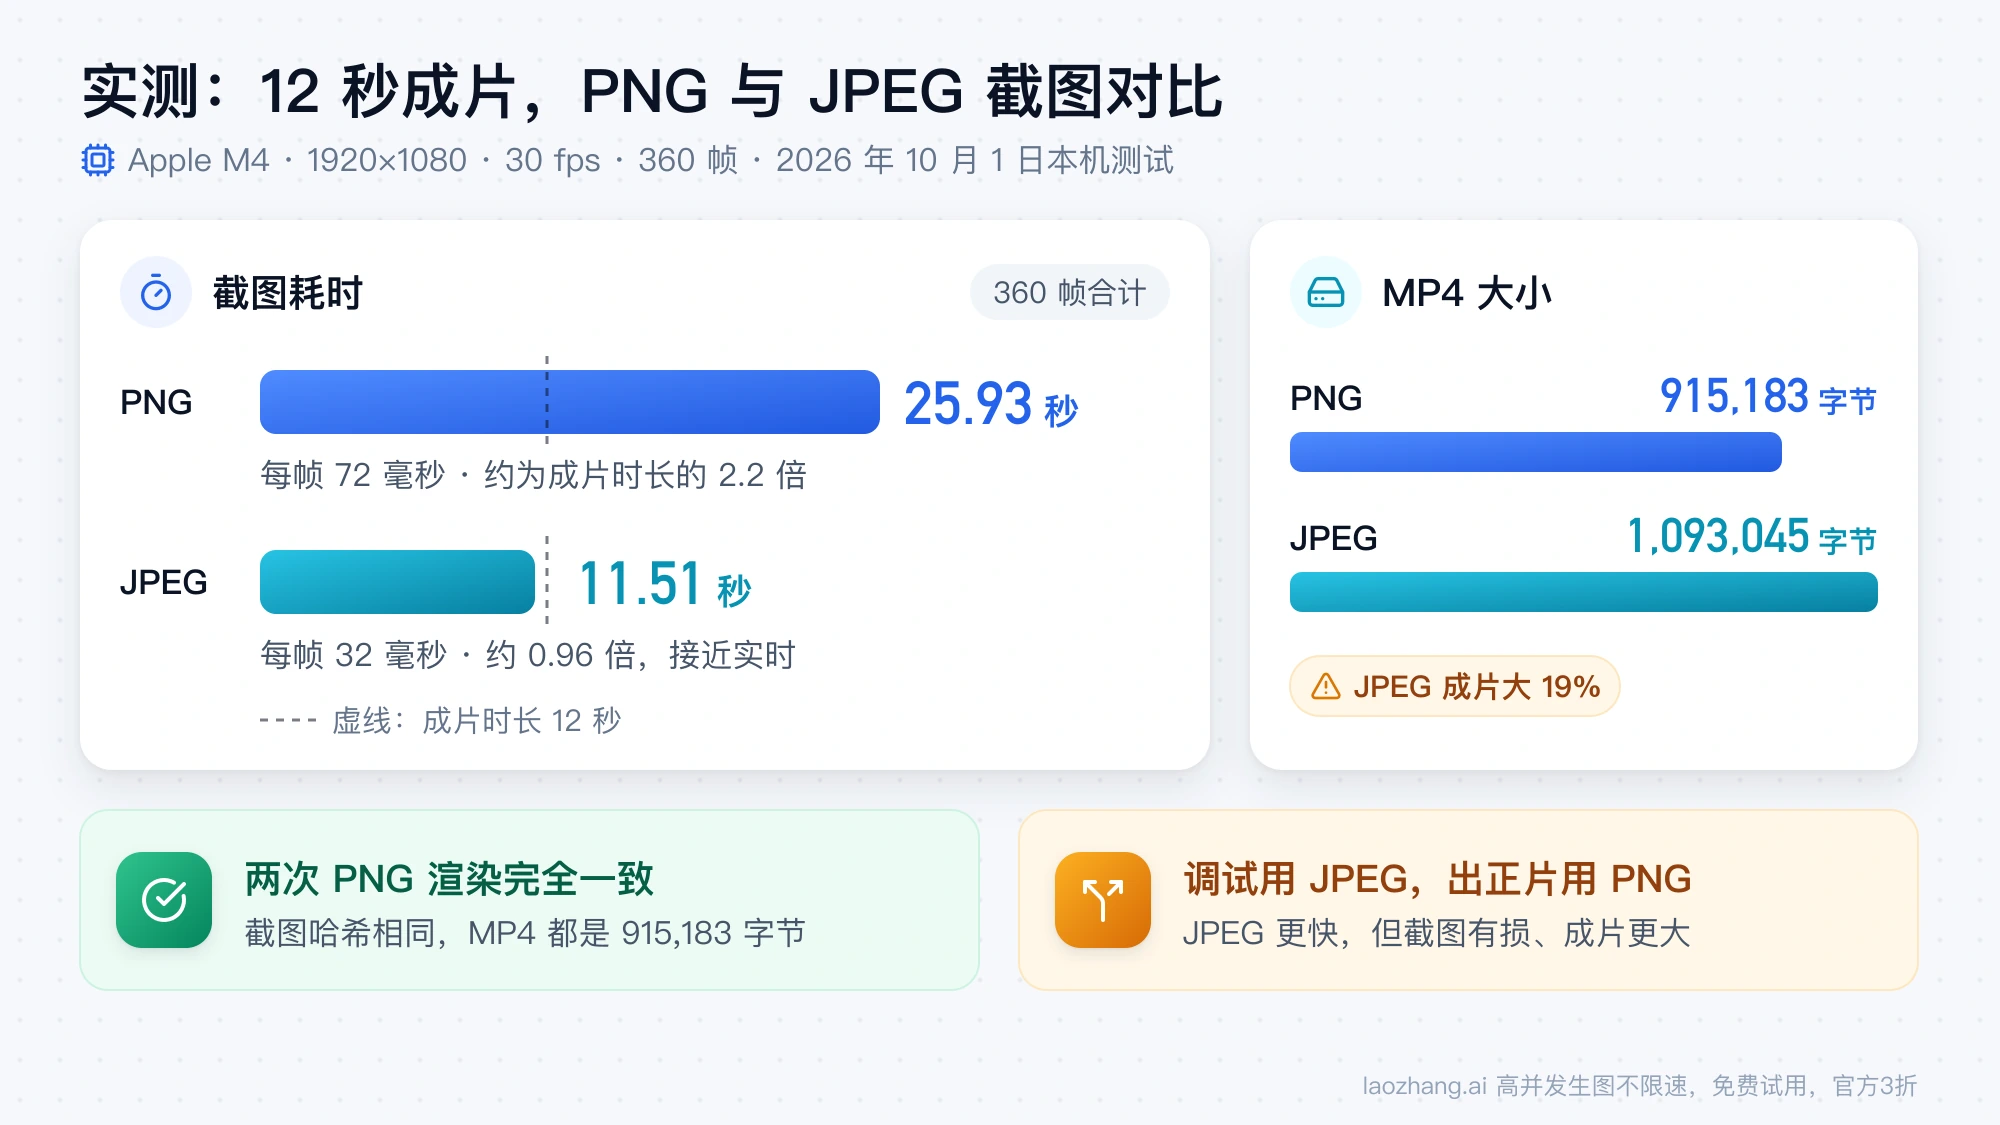
能读出三点。
第一,速度的量级。PNG 截图时,截图耗时约为成片时长的 2.2 倍(25.93 ÷ 12);换成 JPEG 截图约为 0.96 倍,接近实时。LaunchVideo 的 README 说它用 JPEG 截图,30 秒的片子渲染 30 到 40 秒,量级相近,不过那是它在自己服务器上的自述数字。按同样的每帧速度推算,一条 30 秒的片子是 900 帧,PNG 约 65 秒,JPEG 约 29 秒;这是推算,不是实测。
第二,PNG 与 JPEG 的取舍。JPEG 的截图耗时不到 PNG 的一半,但成片大了 19%(1,093,045 对 915,183 字节),而且截图本身是有损的,送进编码器之前已经压过一次。调试阶段用 JPEG 省时间,出正片用 PNG 更稳妥。
第三,两次 PNG 渲染完全一致。截图哈希相同,MP4 都是 915,183 字节,解码后的逐帧校验值也相同。这就是“确定性”的意思:同一份代码,无论渲染多少次、机器当时忙不忙,每一帧都一模一样。它是这套做法能用的前提,下一节会看到失去它之后的样子。
这组数字的适用范围很窄:一台机器、一个简单的 2D 场景、没有音频、没有 3D、没有加载字体。Three.js 的 3D 场景、粒子很多的画面,每帧会慢得多。写这个场景消耗了多少 token 也没有计量。
场景读真实时间,逐帧截图就会出错
模型写网页动画时最顺手的写法,是用 requestAnimationFrame 配 performance.now() 让画面随真实时间流动。在浏览器里直接打开看,这样写完全没问题;拿去逐帧截图就不行,因为截图的节奏和真实时间的节奏对不上。
为了看清会错成什么样,用同一个渲染脚本渲染了一个故意写错的 3 秒场景:动画由 requestAnimationFrame 和 performance.now() 驱动,粒子位置用没设种子的 Math.random(),seek(t) 是个空函数。渲染两次,结果是:
- 两次的截图哈希不同,解码后的逐帧校验值也不同。
- 两个 MP4 大小不同,一个 115,816 字节,一个 131,033 字节。
- 在视频 1.5 秒处抽帧,画面上自己显示的时间是 t = 1.572 s,偏了 72 毫秒。
这次的片子看上去速度“差不多对”,但只是巧合:这个场景很简单,每帧截图恰好用了 33.6 到 38 毫秒,接近 30 fps 的帧间隔 33.3 毫秒。成片里每一帧固定占 1/30 秒,而场景里的时间按截图实际花掉的时间往前走。如果每帧像上一节的 PNG 截图那样要 72 毫秒,场景每帧就前进 72 毫秒,成片里的动作会快约 2.2 倍(72 ÷ 33.3)。这一点是由上面的数字推出来的,没有单独渲染验证。
也就是说,这类错误在简单场景上会藏起来,画面一复杂、截图一慢才暴露,而且每次渲染的结果都不一样,很难排查。避开它有两种办法:
- 让场景只认
seek(t),就是前面那份约定。场景代码要守规矩,渲染器可以很简单。 - 让渲染器接管时间。LaunchVideo 的做法是往页面里注入一个虚拟时钟,
requestAnimationFrame、定时器、Date以及 CSS 和 Web Animations 动画全部由渲染器的__seek(t)驱动;它同时不让场景使用 video、audio、iframe 标签,并在提示词里禁掉 CSS 过渡、Math.random和外部图片,README 给的理由是让渲染结果保持确定。这样模型可以按普通网页动画的习惯写,代价是渲染器复杂得多。
不管用哪种,都值得把“渲染两次、比较校验值”和“抽帧核对时间”当成固定检查。两次结果不一样,就是还有东西在读真实时间或用了没设种子的随机数。
几条渲染路线怎么选
自己写脚本只是其中一条路。公开案例里常见的有下面几种,除第一种外,其余的信息来自各项目自己的文档和上面两个案例仓库。
| 路线 | 场景怎么写 | 适合谁 | 要注意的条件 |
|---|---|---|---|
| 单个 HTML 加自写渲染脚本 | Canvas、SVG 或 DOM,自己暴露 seek(t) | 想弄懂原理、片子不长、不想引入框架的人 | 确定性靠场景自己保证;音频要另外合成和混流 |
| HyperFrames | HTML、CSS,动画可用 GSAP、CSS 动画、Lottie、Three.js 等 | 想要现成渲染器、又想继续写 HTML 的人 | 需要 Node 22 及以上;Apache 2.0 许可,README 写明没有按次渲染费用,也没有商用门槛 |
| Remotion | React 组件 | 已有 React 项目和组件库的团队 | 许可对个人、不超过 3 名员工的营利组织和非营利组织免费,其他情况需要公司许可 |
| Manim、p5.js、Blender 脚本 | Python 或 JavaScript | 数学与论文讲解、手绘风格、程序化 3D | 各自有独立的安装和渲染流程 |
| 接入视频生成模型 | 模型写调用和剪辑代码 | 片子里必须有写实画面 | 视频模型按秒或按次另外计费 |
选的时候看三个条件。
团队规模。 个人和三人以内的小公司,Remotion 和 HyperFrames 都可以免费用,按你更熟悉 React 还是原生 HTML 来选。公司员工超过 3 人又要用 Remotion,得先把公司许可算进成本;不想处理许可问题,HyperFrames 的 Apache 2.0 没有这层限制。
你想让谁保证确定性。 自写脚本要求场景守约定,出了问题你得自己查。HyperFrames 的 README 说它的渲染器在无头 Chrome 里逐帧定位再用 FFmpeg 编码,相同输入产出相同视频,相当于把这件事交给了框架。它还提供 Claude Code 插件,安装方式是:
claude plugin marketplace add heygen-com/hyperframes
claude plugin install hyperframes@hyperframes
装好后在 Claude Code 里用 /hyperframes:hyperframes 调用。
片子要不要声音和 3D。 案例仓库里的做法是配乐用 Web Audio 或 Python 合成,旁白接语音合成,3D 用 Three.js 或 Blender 脚本。这几项以及 Remotion、HyperFrames、Manim 的实际渲染表现,都不在前面那次本机测试的范围内,上手前按各项目的文档再确认一遍。
如果只是想先看到一条自己的片子,从单个 HTML 加自写脚本开始最快,依赖最少,出了问题也最容易看懂。片子变长、要加声音、要多人协作时,再换到框架上。
一条片子要花多少钱
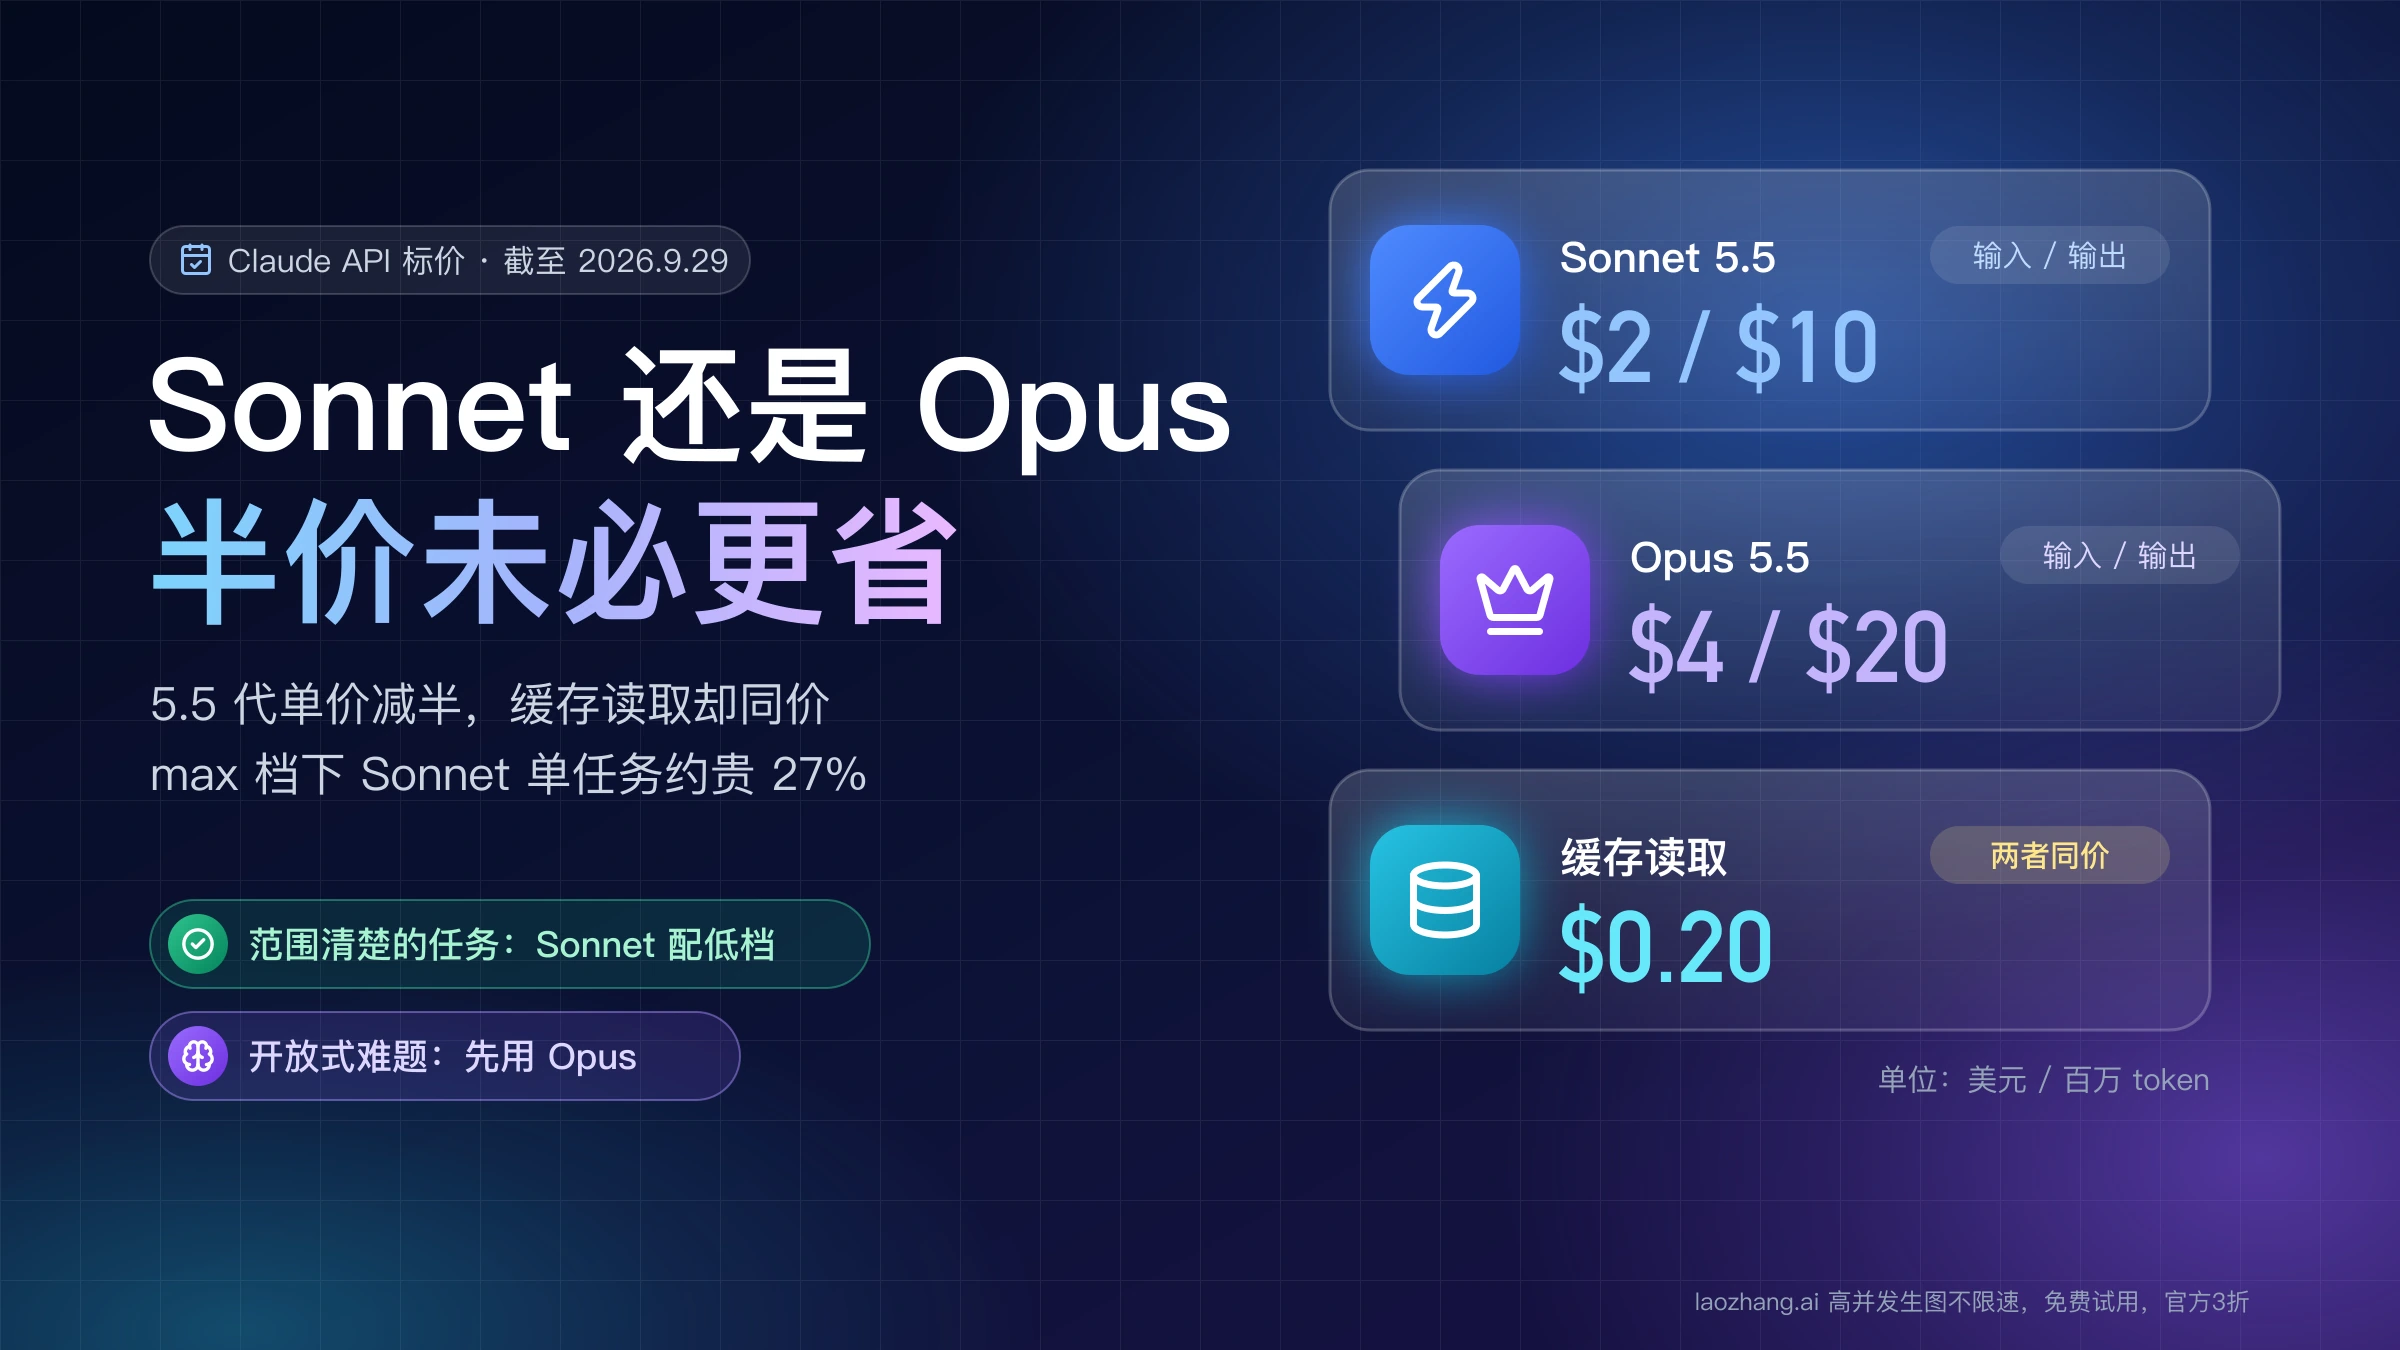
渲染在你自己的电脑上跑,不花钱。花钱的是模型写代码和改代码消耗的 token。按 API 计费时,Opus 5.5 的标价是输入每百万 token $4,输出每百万 token $20,公式是:
费用 = 输入 token ÷ 1,000,000 × 4 + 输出 token ÷ 1,000,000 × 20 (美元,未用缓存)目前没有官方或独立测量的“一条片子要多少 token”,能找到的只有创作者各自报出来的数字,彼此差得很远:
- Hugging Face 社区的一篇文章转述 LaunchVideo 作者的说法:每条片子约 4 分钟、约 90,000 输入 token 加 15,000 输出 token,并注明这是对方的数字。LaunchVideo 自己的 README 里没有这组数字。代入公式是 0.36 + 0.30 = 0.66 美元。
- opus-video-prompts 仓库收录了 Deedy Das 的一句话提示词“make a modern slick and punchy video for a modern startup that works on inference”,并记录作者自述用时约 1 分钟、花费约 2 美元。
- 同一个仓库收录的一条动画 MV 案例,记录的是 effort
xhigh、初版 45 分钟、约 200 美元。
从不到 1 美元到 200 美元,差别主要来自四处:
- 修改轮数。 每次“抽帧、发现问题、改代码”都是一轮新的请求,之前的代码和对话会作为输入再算一遍。
- effort 档位。 Opus 5.5 的思考始终开启,思考消耗的 token 按输出价计费。档位越高,思考越多,输出侧的费用越高。
- 片长和复杂度。 30 个镜头的片子和一个镜头的片子,代码量不是一个量级。
- 看图。 让模型自己看抽帧,每张图都算输入 token。
估算自己的花费,最可靠的办法是先做一条短的,记下这一条实际消耗的输入和输出 token,代入公式,再按你预计的修改轮数放大。
还有两点会改变算法。用 Claude 订阅(Pro 或 Max)在 Claude Code 里做,不按 token 出账单,消耗的是套餐的用量额度。opus-video-prompts 收录的一条 156.6 秒、约 3,760 帧的 MV,作者自述用掉了 Max 5x 周额度的 10%;两种计费方式的细节见Claude Opus 5.5 价格与用量重置:API 账单怎么算,重置卡怎么用。另外,公式只覆盖模型这一项,语音合成的旁白、配乐、从视频模型买的素材都要另算。
常见问题
Opus 5.5 是视频生成模型吗?
不是。Opus 5.5 是语言模型,模型 ID 是 claude-opus-5-5,输出只有文本。它能“做视频”,是因为它写的动画代码可以被浏览器等渲染器逐帧画出来,再由 FFmpeg 合成 MP4。视频文件是这套工具产出的,不是模型直接输出的。
在 Claude 应用里聊天能直接拿到 MP4 吗?
模型本身不输出视频文件,能不能拿到 MP4 取决于它所处的环境有没有执行代码的能力,以及环境里有没有浏览器和 FFmpeg。在 Claude Code 里,这些都在你自己的电脑上,流程最可控。opus-video-prompts 收录的 Deedy 论文讲解案例则记录为在网页对话里完成,由 Claude 自己选用 Manim、语音合成和 FFmpeg。在不能执行代码的对话里,你拿到的是场景代码,渲染要自己在本机完成。
Sonnet 5.5 或旧版 Opus 能做同样的事吗?
原理上可以,因为所有现行 Claude 模型都能输出代码,而渲染环节与模型无关。差别在于写出来的画面设计、动效和代码一次跑通的概率,这方面公开资料里没有不同模型的对照数据,只能自己用同一句提示词各跑一次比较。两个 5.5 模型在价格和任务成本上的区别,见Sonnet 5.5 和 Opus 5.5 怎么选:半价未必更省。
为什么我渲染出来的片子速度不对,或者每次都不一样?
多半是场景在读真实时间,或用了没设种子的随机数。检查场景里有没有 performance.now()、Date.now()、requestAnimationFrame、CSS 过渡和 Math.random(),把它们改成只依赖 seek(t) 传入的时间和固定种子的伪随机。改完渲染两次,逐帧校验值相同才算修好。