Claude Sonnet 5.5 缓存读取价格降到 $0.10:省多少看缓存占比
Claude Sonnet 5.5 缓存读取自 10 月 7 日起从每百万 token $0.20 降到 $0.10,其余价格不变;少付的比例约为旧价下缓存读取占总花费比例的一半。
文章目录
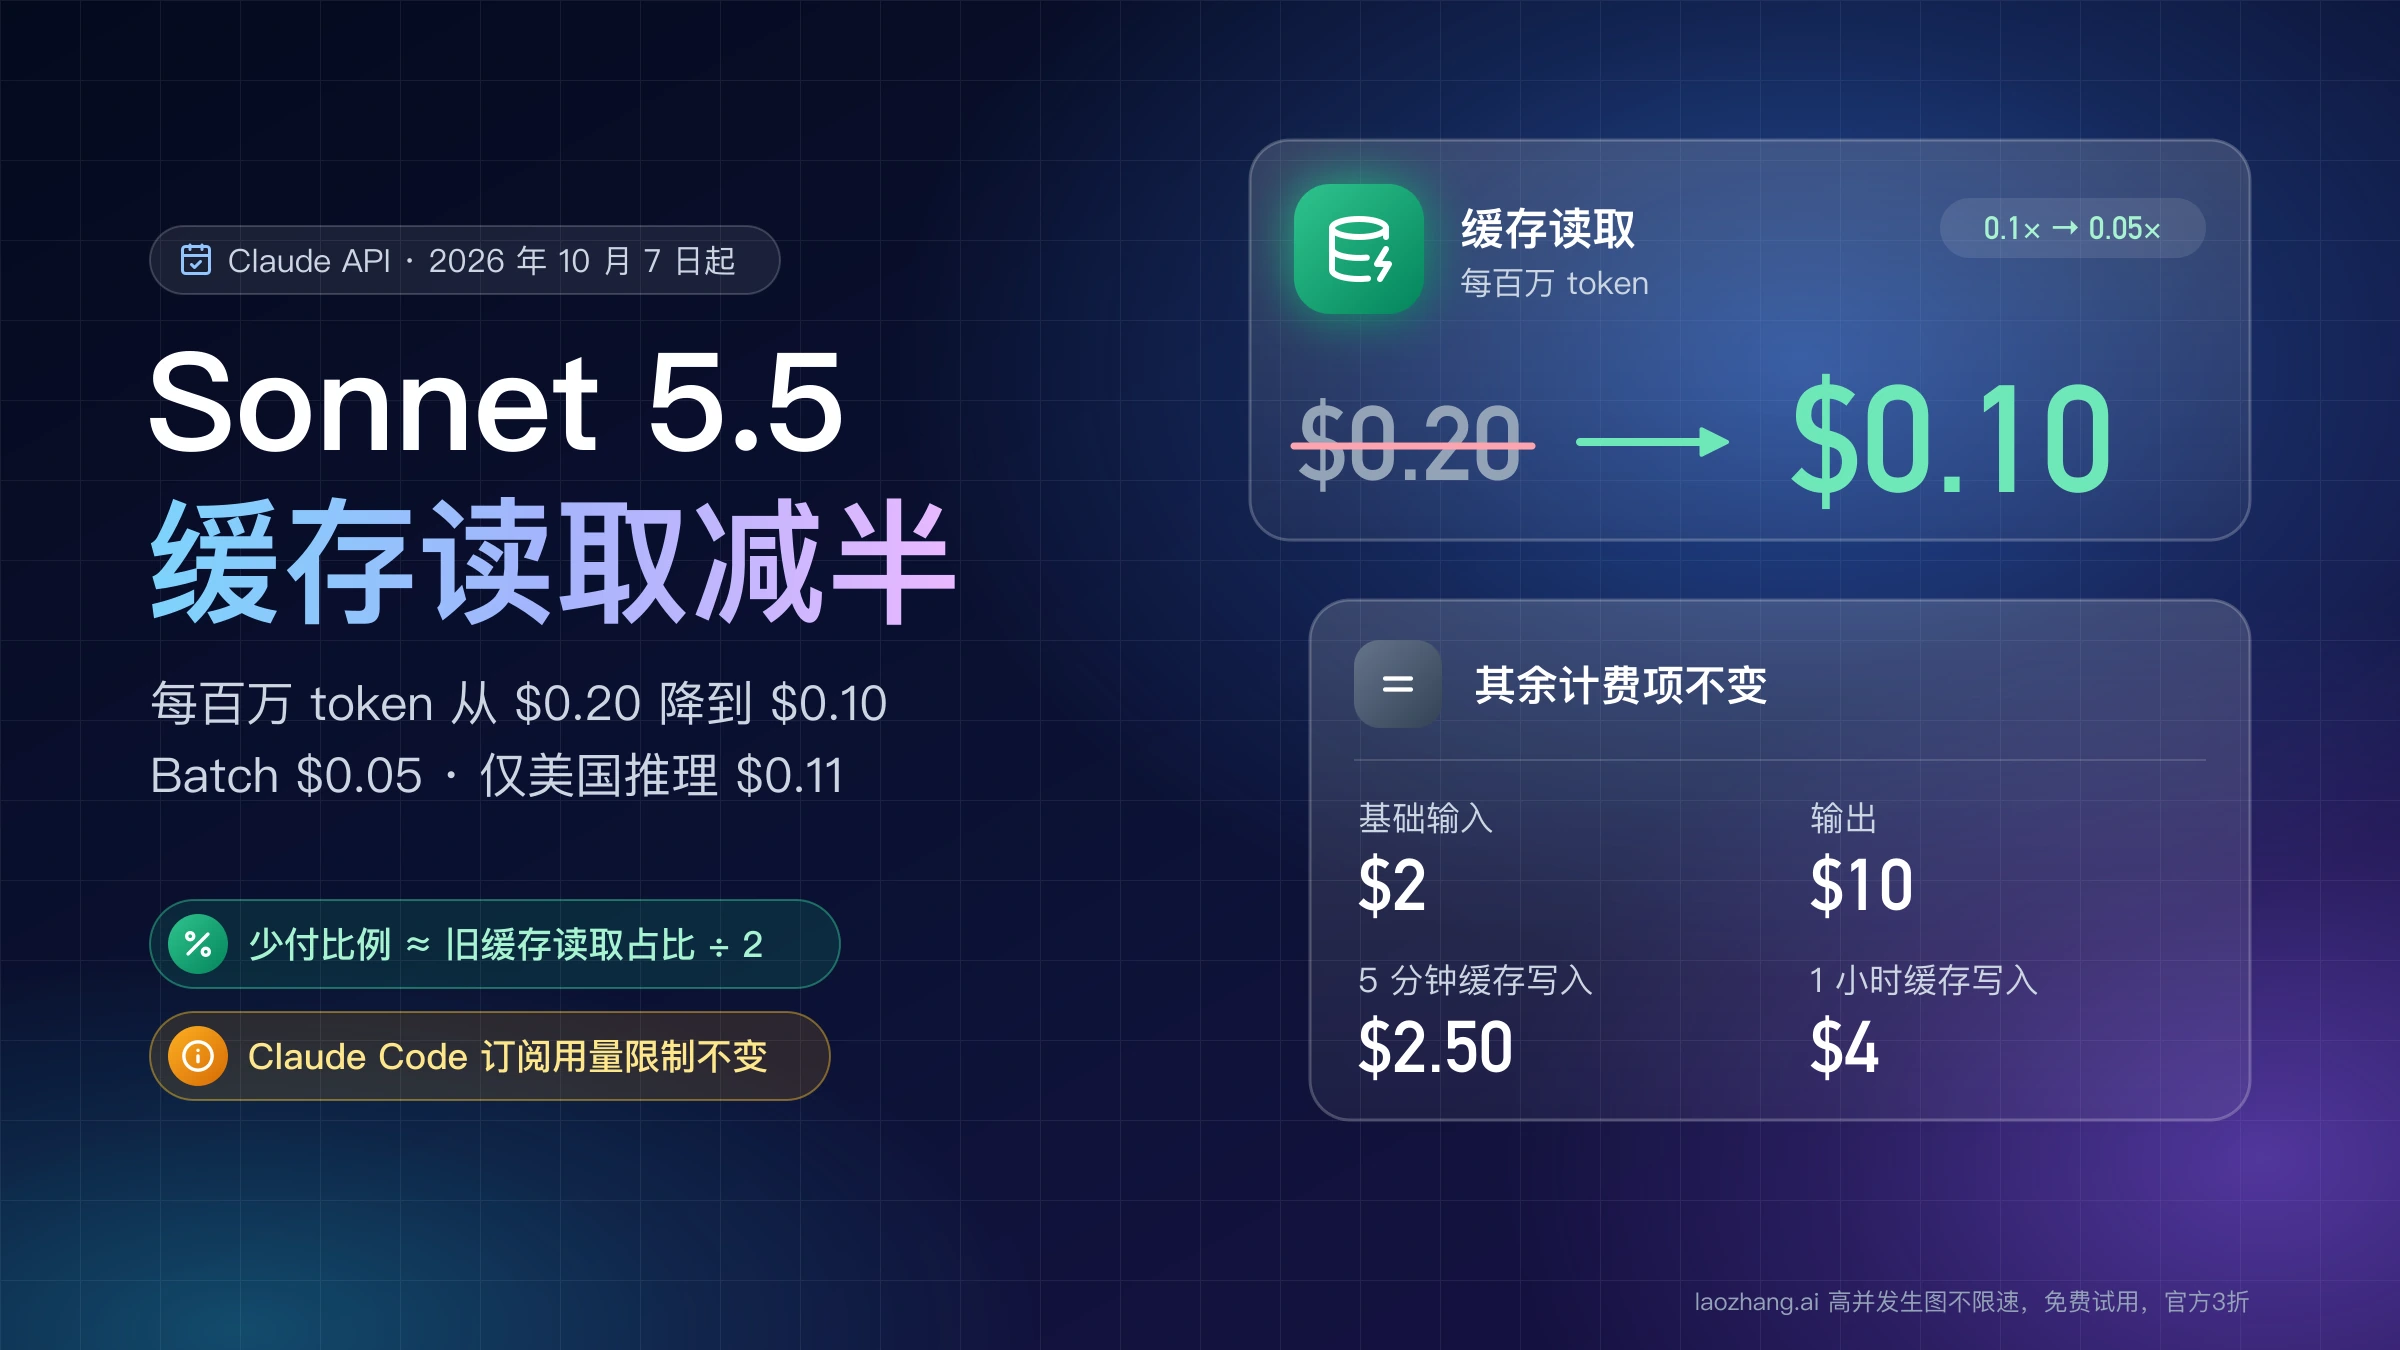
Claude Sonnet 5.5 的缓存读取从 2026 年 10 月 7 日起是每百万 token $0.10,原来是 $0.20。 倍率从基础输入价的 0.1 倍改成 0.05 倍;输入 $2、输出 $10、5 分钟缓存写入 $2.50、1 小时缓存写入 $4 都没有变。见 Anthropic 10 月 7 日的 API 更新记录。
这一行在不同地方叫法不同:官方中文定价页写作"缓存命中和刷新",乘数表里叫"缓存读取(命中)",API 返回的字段是 cache_read_input_tokens,Amazon Bedrock 的 Converse API 叫 cacheReadInputTokens,Google Cloud 价目表叫 Cache Hit。它们是同一笔费用。
Anthropic 说降价后 Sonnet 5.5 在"大多数 Agent 任务"上便宜约 20%,这是它对典型负载的估算,不是整张账单统一打八折。你实际少付的比例,约等于旧价下缓存读取占总花费比例的一半:只有这一行减半,其他行原样计费。Claude Pro、Max、Team 订阅里 Claude Code 的用量限制也没有因此放宽。
Claude Sonnet 5.5 现行价格:只有缓存读取从 $0.20 变成 $0.10
截至 2026 年 10 月 12 日,Anthropic 定价页上 Claude API 的标准价格如下,单位是美元 / 每百万 token:
| 计费项 | Sonnet 5.5 降价前 | Sonnet 5.5 现在 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|---|
| 基础输入 | $2 | $2 | $2 | $4 |
| 5 分钟缓存写入 | $2.50 | $2.50 | $2.50 | $5 |
| 1 小时缓存写入 | $4 | $4 | $4 | $8 |
| 缓存读取(缓存命中和刷新) | $0.20 | $0.10 | $0.20 | $0.20 |
| 输出 | $10 | $10 | $10 | $20 |
几点会影响你怎么读这张表:
- "命中和刷新"是一笔钱。 每次从缓存读取前缀,同时也会把这条缓存的有效期重新计时,没有单独的刷新费。
- 5 分钟和 1 小时是两档写入价,分别是基础输入的 1.25 倍和 2 倍,不是按时间收的存储费。
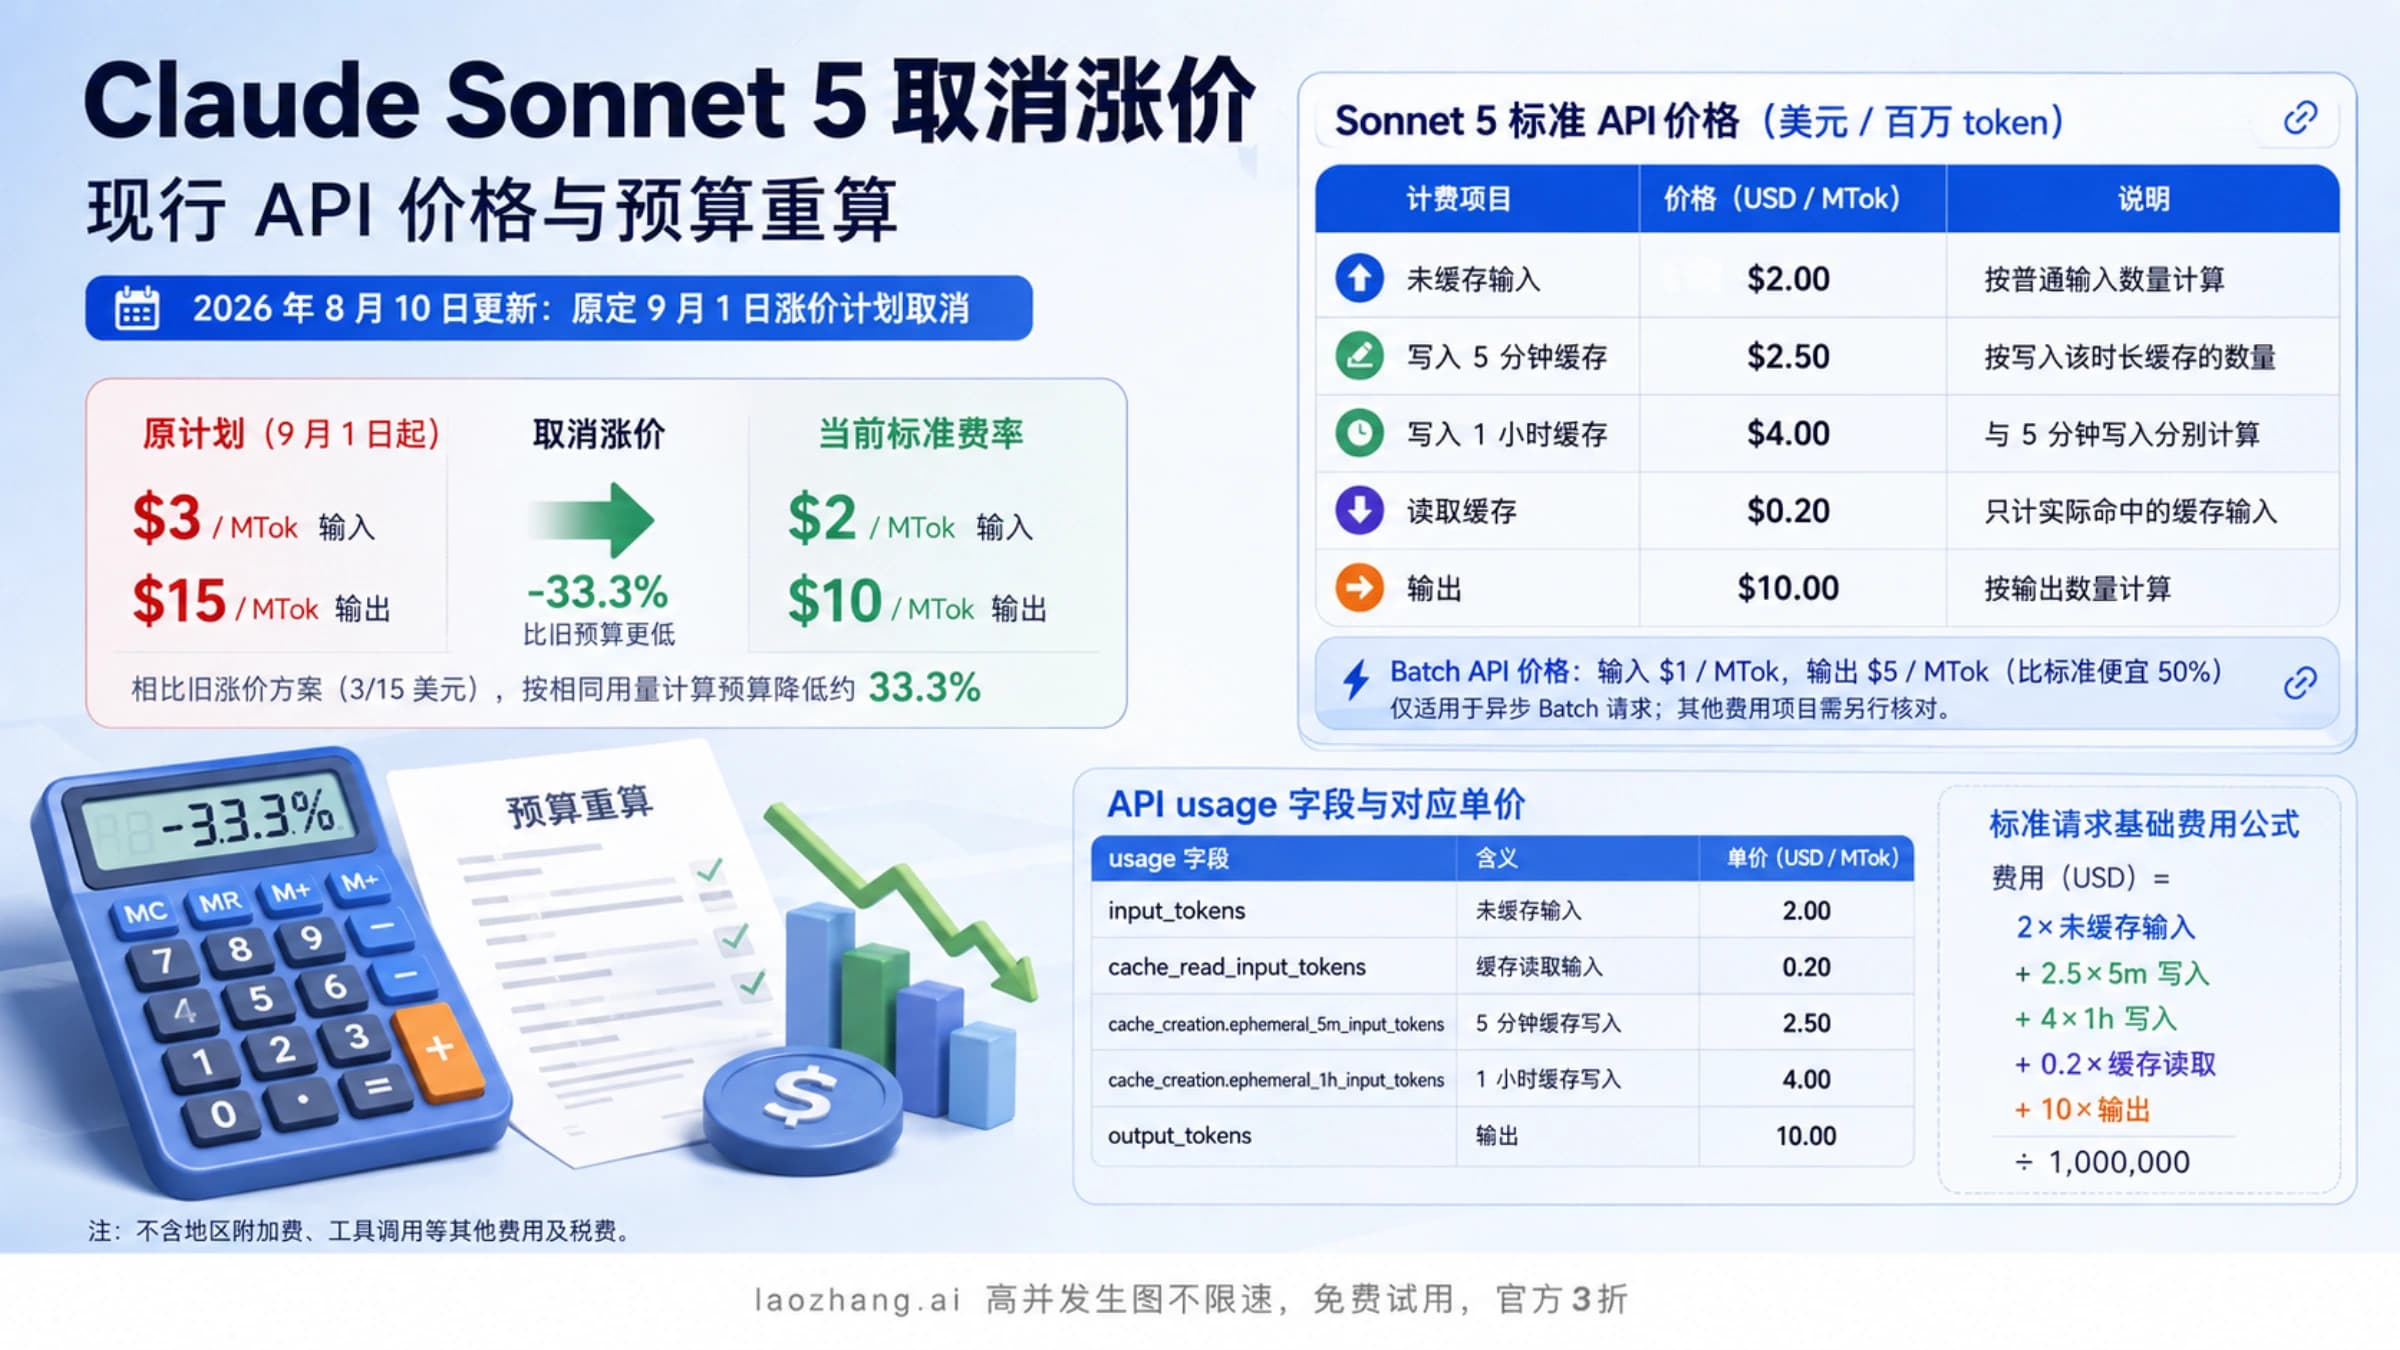
- Opus 5.5 的缓存读取本来就是 0.05 倍,$0.20 对应它 $4 的输入价;Sonnet 5 仍按 0.1 倍收 $0.20。Sonnet 5 的完整价格见Claude Sonnet 5 取消涨价:现行 API 价格与预算重算。
- 公告只写了从 10 月 7 日起的新单价。核算 10 月 7 日之前的用量时,按 $0.20 算。
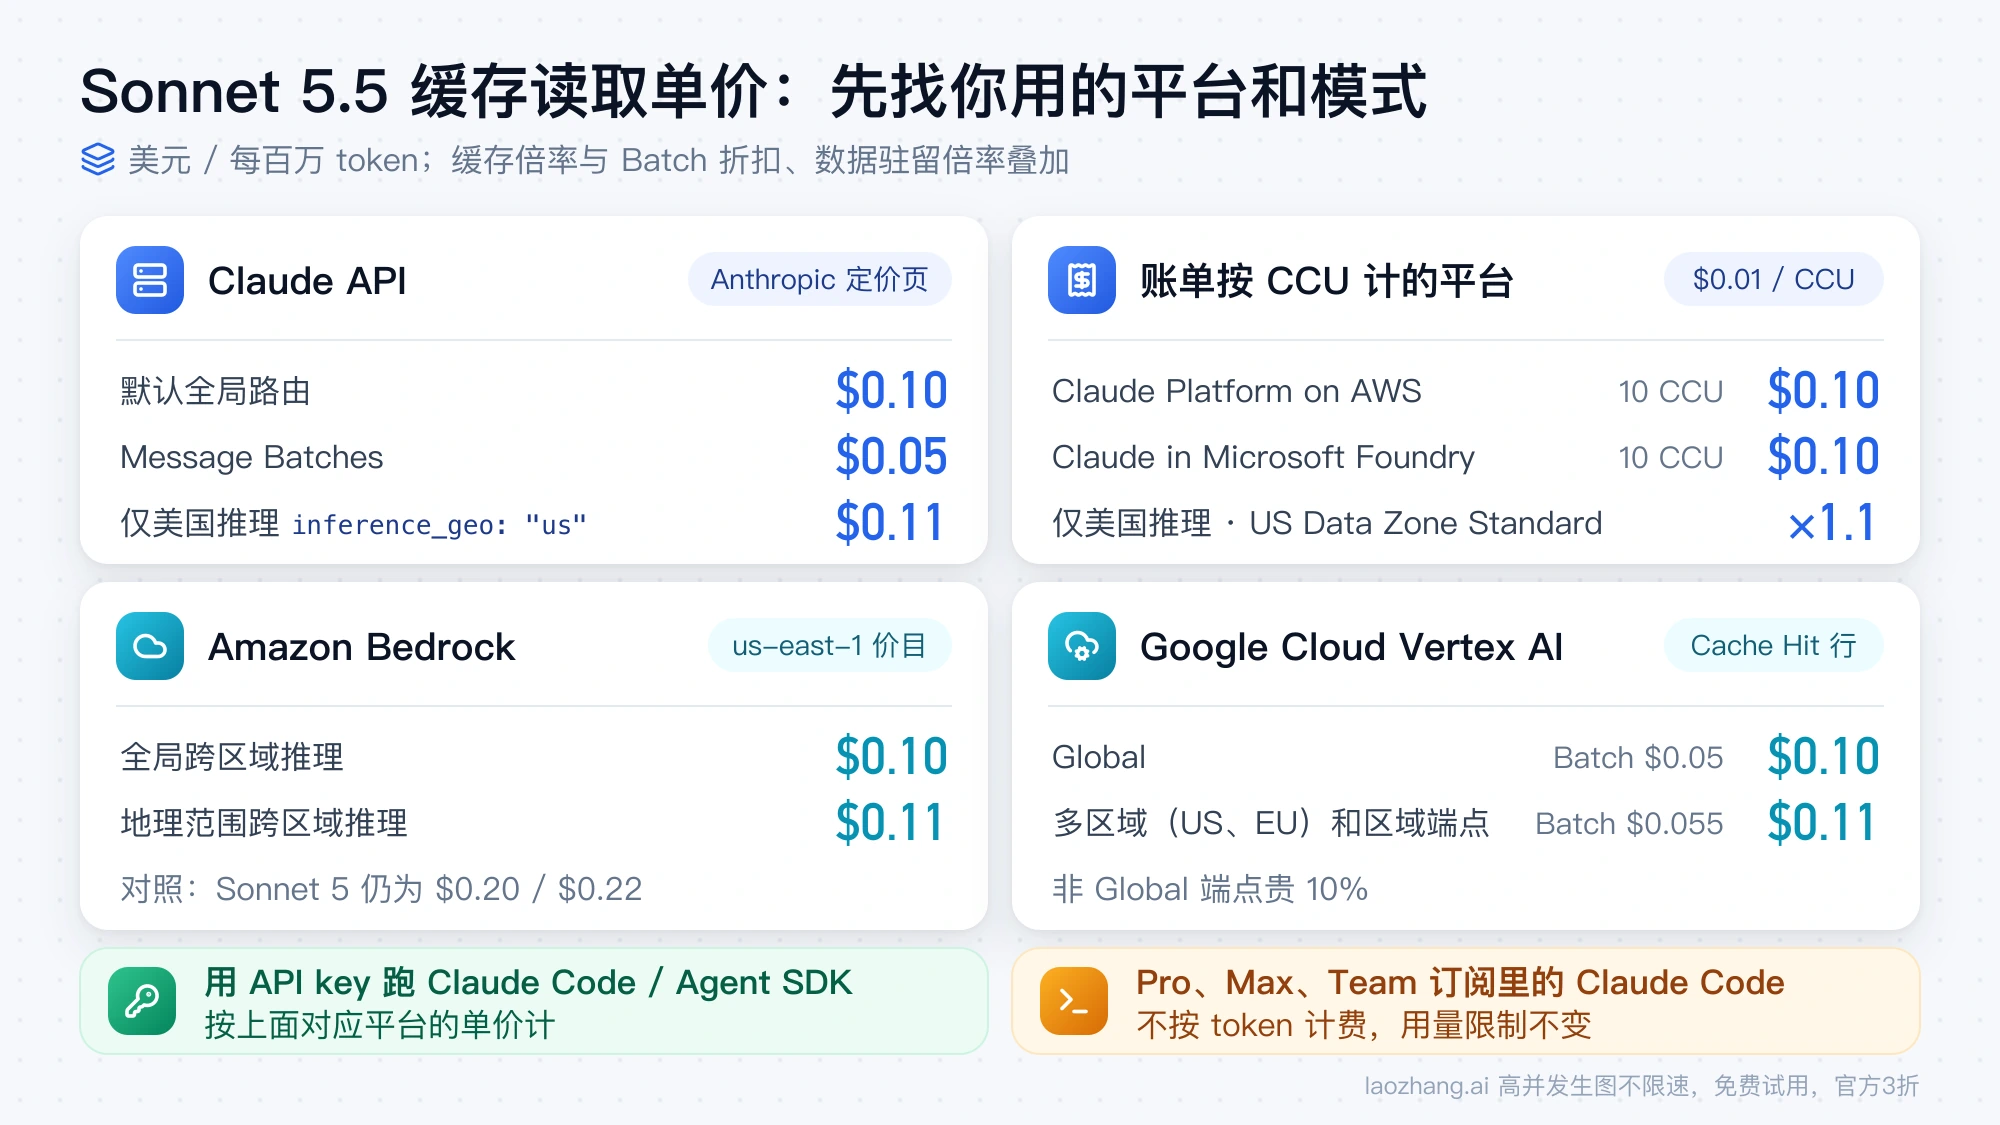
各平台的缓存读取单价:Batch $0.05,仅美国推理 $0.11
Anthropic 定价页写明,缓存倍率会和 Batch 折扣、数据驻留倍率叠加。按这条规则,以及 Google Cloud 和 AWS 各自的价目,Sonnet 5.5 在各处的缓存读取单价如下(美元 / 每百万 token):
| 用在哪里 | 缓存读取单价 | 依据 |
|---|---|---|
| Claude API,默认全局路由 | $0.10 | Anthropic 定价页 |
| Claude API,Message Batches | $0.05 | Batch 输入、输出五折,再乘 0.05 倍(按叠加规则推算) |
Claude API,inference_geo: "us" 仅美国推理 | $0.11 | 所有计费项乘 1.1,含缓存读取 |
| Claude Platform on AWS | $0.10,记为 10 CCU | 按 Claude API 标准价计价,再按 $0.01 / CCU 换算;仅美国推理同样乘 1.1 |
| Claude in Microsoft Foundry | $0.10,记为 10 CCU | 同上;US Data Zone Standard 部署乘 1.1 |
| Amazon Bedrock,全局跨区域推理(global cross-Region inference) | $0.10 | us-east-1 价目,Sonnet 5 仍为 $0.20 |
| Amazon Bedrock,地理范围跨区域推理(geographic cross-Region inference) | $0.11 | us-east-1 价目,Sonnet 5 为 $0.22 |
| Google Cloud Vertex AI,Global | $0.10;Batch $0.05 | Google Cloud 价目表 Cache Hit / Batch Cache Hit 两行 |
| Google Cloud Vertex AI,多区域(US、EU)和区域端点 | $0.11;Batch $0.055 | 同一价目表的非 Global 标签页 |
| 用 API key 跑 Claude Code 或 Agent SDK | 按上面对应平台计 | 走的是 API 计费 |
| Claude Pro、Max、Team 订阅里的 Claude Code | 不按 token 计费 | 用量限制不变 |
Claude Platform on AWS 和 Microsoft Foundry 的账单只有一行 CCU(Claude Consumption Unit)。Anthropic 先按 Claude API 标准价算出美元,扣掉协议折扣,再按每 CCU $0.01 折算,所以 10 月 7 日之后同样的缓存读取量,CCU 数会少一半;签了私有报价的账户以折扣后的数字为准。
Amazon Bedrock 的数字来自 DevelopersIO 2026 年 10 月 9 日的实测文章:作者用 AWS Price List API 查询 us-east-1 的 "Claude Sonnet 5.5 (Amazon Bedrock Edition)",全局跨区域推理的输入 / 输出是 $2 / $10,地理范围跨区域推理是 $2.20 / $11,缓存读取分别为 $0.10 和 $0.11;文章还提到 AWS 定价页注明了 10 月 7 日起缓存读取降价 50%。其他区域以 Amazon Bedrock 定价页为准。Google Cloud 的数字见 Vertex AI 生成式 AI 价目表的 Claude 部分,非 Global 端点贵 10%,与 Anthropic 定价页对区域和多区域端点的说明一致。
"便宜约 20%"怎么来的:少付比例 = 旧价下缓存读取占比的一半
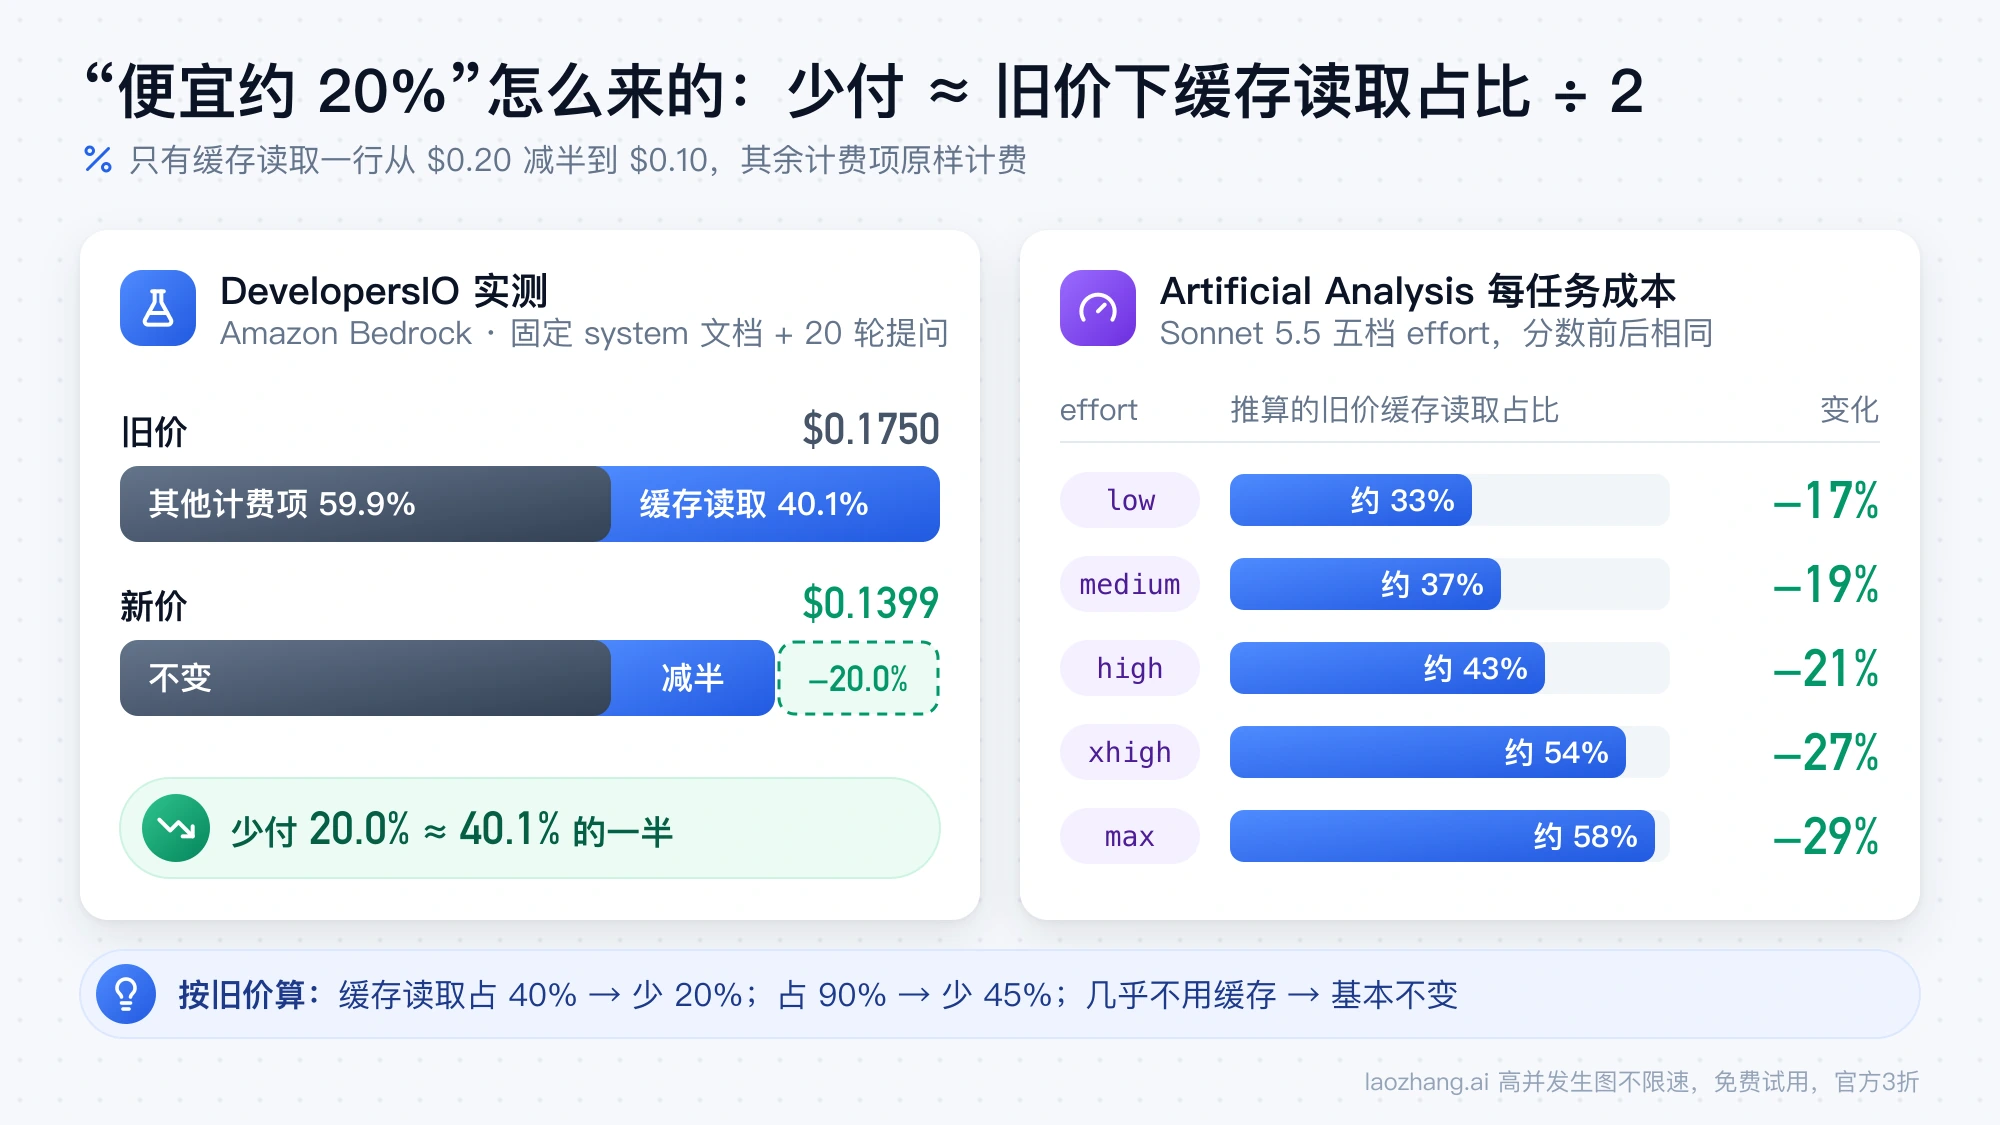
降价只动了一行,所以总花费的变化完全取决于这一行原来占多少。设旧价下缓存读取占你总花费的比例是 s,降价后这部分减半,总花费就少了 s ÷ 2。缓存读取占 40%,就少 20%;占 90%,就少 45%;几乎不用缓存的请求,基本没有变化。
DevelopersIO 在 Amazon Bedrock 上做了一组可以复算的测试:约 16,400 token 的固定 system 文档,连续问 20 个短问题,每轮读一次缓存。20 轮累计读取 350,380 token、写入 20,681 token、输出 5,302 token,按旧价是 $0.1750,按新价是 $0.1399,正好少了 20.0%。缓存读取原来占这组费用的 40.1%,一半就是 20%。这组测试只代表"长 system 提示 + 多轮对话"这种形态。
用两个假设的 Agent 单轮请求(token 数为示例,非实测)可以看出差距从哪里来:
| 单轮请求 | 旧价 | 新价 | 少付 |
|---|---|---|---|
| 读取 100,000、写入 5 分钟缓存 3,000、输出 2,000 | $0.0475 | $0.0375 | 21% |
| 读取 500,000、写入 5 分钟缓存 1,000、输出 1,000 | $0.1125 | $0.0625 | 44% |
第一行的新价是 100,000 × $0.10 + 3,000 × $2.50 + 2,000 × $10,再除以 100 万,即 $0.0100 + $0.0075 + $0.0200 = $0.0375;旧价把第一项换成 $0.0200。缓存读取在旧价里占 $0.0200 ÷ $0.0475 ≈ 42%,一半约 21%。第二行读取占旧价的 89%,所以少付 44%。
Artificial Analysis 的 Claude Sonnet 5.5 模型页上的智能指数(Intelligence Index)每任务成本也体现了这条规律。它的成本按输入、缓存命中、缓存写入、推理和回答 token 分别乘价计算;下表的旧价是 2026 年 10 月 5 日的数据,新价是 10 月 12 日的数据,五档分数前后相同:
| Sonnet 5.5 effort | 分数 | 旧价每任务 | 新价每任务 | 变化 | 推算的旧价缓存读取占比 |
|---|---|---|---|---|---|
| low | 36 | $0.42 | $0.35 | −17% | 约 33% |
| medium | 41 | $0.59 | $0.48 | −19% | 约 37% |
| high | 47 | $1.12 | $0.88 | −21% | 约 43% |
| xhigh | 52 | $2.75 | $2.01 | −27% | 约 54% |
| max | 56 | $7.67 | $5.46 | −29% | 约 58% |
变化 = 新价 ÷ 旧价 − 1,最后一列是变化幅度的 2 倍。effort 越高,降得越多,较可能的原因是高 effort 下工具调用循环更长,同一段缓存上下文被反复读取。low 档的 −17% 和 max 档的 −29% 都只是这套评测题的结果,你的任务里缓存读取占多少,要用自己的用量算。
用 usage 字段算自己少付多少
Claude API 每次响应的 usage 里有四个与输入相关的数:input_tokens(最后一个缓存断点之后、未缓存的部分)、cache_creation_input_tokens(本次写入缓存的部分,cache_creation 对象里再分 ephemeral_5m_input_tokens 和 ephemeral_1h_input_tokens)、cache_read_input_tokens(从缓存读取的部分),以及 output_tokens。三项输入相加才是这次请求的全部输入,字段说明见 Anthropic 提示缓存文档的 Tracking cache performance 一节。
Sonnet 5.5 在 Claude API 全局路由下,单次请求的费用(美元)是:
费用 = (input_tokens × 2
      + ephemeral_5m_input_tokens × 2.50
      + ephemeral_1h_input_tokens × 4
      + cache_read_input_tokens × R
      + output_tokens × 10) ÷ 1,000,000

R = 0.20(10 月 7 日之前)或 0.10(10 月 7 日起)
少付的美元 = cache_read_input_tokens × 0.10 ÷ 1,000,000
Message Batches 把所有项乘 0.5,仅美国推理乘 1.1。少付的美元金额只取决于读取量:每读取 1,000 万 token 缓存,少付 $1。
如果你把每次响应的 usage 存成每行一个 JSON 的日志,下面的脚本能直接算出同一批请求在旧价和新价下各是多少:
import json
import sys

# Claude API 上的 Claude Sonnet 5.5,全局路由,美元 / 百万 token
PRICE = {"input": 2.00, "write_5m": 2.50, "write_1h": 4.00, "output": 10.00}
CACHE_READ = {"before": 0.20, "after": 0.10}  # 10 月 7 日之前 / 之后

def cost(u, period, multiplier=1.0):
    """multiplier:Batch 传 0.5,inference_geo 为 "us" 传 1.1"""
    split = u.get("cache_creation") or {}
    w1h = split.get("ephemeral_1h_input_tokens", 0)
    w5m = split.get("ephemeral_5m_input_tokens",
                    u.get("cache_creation_input_tokens", 0) - w1h)
    usd = (u.get("input_tokens", 0) * PRICE["input"]
           + w5m * PRICE["write_5m"]
           + w1h * PRICE["write_1h"]
           + u.get("cache_read_input_tokens", 0) * CACHE_READ[period]
           + u.get("output_tokens", 0) * PRICE["output"]) / 1_000_000
    return usd * multiplier

before = after = 0.0
with open(sys.argv[1], encoding="utf-8") as f:  # 每行一个 usage 对象
    for line in f:
        u = json.loads(line)
        before += cost(u, "before")
        after += cost(u, "after")

print(f"旧价 ${before:.4f}  新价 ${after:.4f}  少付 {1 - after / before:.1%}")
把上一节第一行示例写成 {"input_tokens": 0, "cache_creation_input_tokens": 3000, "cache_read_input_tokens": 100000, "output_tokens": 2000} 存进 usage.jsonl,脚本存为 cache_saving.py,运行 python3 cache_saving.py usage.jsonl 输出 旧价 $0.0475 新价 $0.0375 少付 21.1%;两条示例放在一起时输出 旧价 $0.1600 新价 $0.1000 少付 37.5%。没有 cache_creation 拆分的旧日志,脚本把全部写入按 5 分钟价计。
Amazon Bedrock 的 Converse API 对应字段是 inputTokens、cacheWriteInputTokens、cacheReadInputTokens、outputTokens,改一下键名即可;用地理范围跨区域推理时 multiplier 传 1.1。这里的结果不含税费、赠送额度和协议折扣。
Sonnet 5.5、Sonnet 5、Opus 5.5 怎么选:Opus 现在每一行都是 2 倍
降价之前,Opus 5.5 和 Sonnet 5.5 的缓存读取同为 $0.20,缓存读得越多,两者的价差就越小。现在 Opus 5.5 的输入、输出、两档写入、缓存读取都正好是 Sonnet 5.5 的 2 倍,按 token 算,无论缓存占比多高,Opus 都贵一倍。
按 token 贵一倍,不等于按结果也贵一倍。Artificial Analysis 的 Sonnet 5.5 与 Opus 5.5 对比页(截至 2026 年 10 月 12 日,已用 $0.10 计 Sonnet 5.5 的缓存读取)给出的每任务成本是:
| effort | Sonnet 5.5 分数 / 每任务 | Opus 5.5 分数 / 每任务 |
|---|---|---|
| low | 36 / $0.35 | 42 / $0.55 |
| medium | 41 / $0.48 | 51 / $1.34 |
| high | 47 / $0.88 | 54 / $1.82 |
| xhigh | 52 / $2.01 | 56 / $3.46 |
| max | 56 / $5.46 | 58 / $5.98 |
同一 effort 下 Sonnet 5.5 都更便宜。但跨档看,Opus 5.5 high 拿到 54 分只花 $1.82,比 Sonnet 5.5 xhigh(52 分、$2.01)分数高、花费少;Opus 5.5 xhigh 以 $3.46 拿到 56 分,Sonnet 5.5 要开到 max、花 $5.46 才到同一分数。如果你习惯把 Sonnet 5.5 开到 xhigh 或 max,值得拿 Opus 5.5 的低一档 effort 在自己的任务上对比一次;在 medium 及以下,Sonnet 5.5 的性价比优势很明显。
和 Sonnet 5 比,降价改变的主要是 max 档。按 Artificial Analysis 2026 年 10 月 5 日的 Sonnet 5 数据(Sonnet 5 价格未变),Sonnet 5.5 现在每任务成本在 low 低 31%、medium 低 52%、high 低 51%、xhigh 低 30%;max 档从降价前贵 51% 变成只贵 7%($5.46 对 $5.09),而分数是 56 对 38。按这组数据,缓存很重的 Agent 任务留在 Sonnet 5 已经很难省钱,除非你依赖它特有的行为。
如果你在考虑把部分任务换到更便宜的 Haiku 5.5,分档价格和分数对比见Claude Haiku 5.5 和 Sonnet 5.5 区别:标价差 20 倍,同分只差 4 倍。
缓存设置要不要改:回本次数不变,未命中更显眼
不需要因为这次降价改 TTL 或断点的位置。设缓存前缀为 P 个 token,按基础输入价计:
- 5 分钟缓存:写入 1.25P,之后每次读取 0.05P;不缓存时每次都付 1P。读取 1 次时是 1.30P 对 2P,读 1 次就回本。
- 1 小时缓存:写入 2P,读 n 次共 2P + 0.05nP,不缓存是 (1 + n)P,n 大于 1.05 才划算,也就是读 2 次回本。
这两个门槛和 0.1 倍时一样,Anthropic 定价页提示缓存一节写的"5 分钟读 1 次、1 小时读 2 次回本"仍然成立。变化在长期:每次重复读取的价格从基础输入价的 10% 变成 5%,相当于省 95%。
另一面是,写入价没降,同样的 token,一次 5 分钟写入现在相当于 25 次读取(原来 12.5 次),一次 1 小时写入相当于 40 次读取(原来 20 次)。缓存未命中、被迫重写时,在账单上会比以前更显眼。降价后更值得检查的是这几处:
- 长度不够不会缓存。 Sonnet 5.5 的最低可缓存长度是 512 token(Sonnet 5 是 1,024);更短的提示即使加了
cache_control也会按普通输入处理,而且不报错。cache_creation_input_tokens和cache_read_input_tokens同时为 0,就说明没有缓存上。 - 中途改 system 会让缓存失效。 在 Sonnet 5.5 上,可以往
messages里追加一条{"role": "system"}消息来补充指令,而不去改顶层system字段,这样已缓存的前缀保持不变;Sonnet 5 不支持这种写法。 - 1 小时 TTL 只在间隔超过 5 分钟时才值得。 每次读取都会刷新有效期,请求间隔在 5 分钟以内时,5 分钟缓存一直不会过期,写入还比 1 小时档每百万 token 便宜 $1.50。
Claude Code 订阅额度没变:Pro、Max 用户能得到什么
Anthropic 开发者账号 @ClaudeDevs 在 2026 年 10 月 9 日说明,这次降价"只针对 API,Claude Code 的用量限制没有变化"(原文 API only, no change to Claude Code usage limits)。也就是说,Pro、Max、Team 订阅里 Claude Code 能用的额度不会因为缓存读取降价而变多。
会拿到新价的是按 token 计费的用法:在 Claude Code 或 Agent SDK 里配置 API key、走 Claude API 或上面表格里各云平台的请求,缓存读取都按 $0.10(或对应平台的单价)计。
10 月 7 日的同一份更新里,Anthropic 还宣布给 Max 和 Team 订阅每月发放 API 额度:Max 5x 每月 $100,Max 20x 每月 $200,Team 最多 $500、团队共用,可以在 Claude Platform 上用于任意模型,见 Claude Haiku 5.5 发布文。用这笔额度调用 Sonnet 5.5 时,缓存读取同样按 $0.10 扣。领取方法和适用范围见 API credits for Max and Team plans 说明。
Claude Sonnet 5.5 缓存降价的常见问题
Claude Sonnet 5.5 降价后,输入和输出价格变了吗?
没有。Claude API 上 Sonnet 5.5 仍是输入每百万 token $2、输出 $10,5 分钟缓存写入 $2.50、1 小时缓存写入 $4;10 月 7 日只调整了缓存读取,从 $0.20 降到 $0.10。
Claude Sonnet 5.5 的 Batch 缓存读取是多少钱?
$0.05 / 每百万 token。Claude API 的 Batch 输入、输出都是五折,缓存倍率在 Batch 价格上叠加;Google Cloud Vertex AI 的价目表直接列出 Global 端点 Batch Cache Hit 为 $0.05。
Sonnet 5.5 缓存降价后,我的账单为什么没有少 20%?
20% 是 Anthropic 对大多数 Agent 任务的估算。你的降幅约等于旧价下缓存读取占总花费比例的一半:缓存读取占 30% 的负载只会少约 15%,不用缓存的请求几乎不变。用上面的公式或脚本代入自己的 usage 记录,就能得到自己的数字。
参考来源11
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月12日。
参考来源11
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月12日。
- 1.Anthropic 10 月 7 日的 API 更新记录platform.claude.com/docs/en/release-notes/overview
- 2.Anthropic 定价页platform.claude.com/docs/en/about-claude/pricing
- 3.DevelopersIO 2026 年 10 月 9 日的实测文章dev.classmethod.jp/articles/bedrock-sonnet-5-5-cache-read-price-cut
- 4.Amazon Bedrock 定价页aws.amazon.com/bedrock/pricing
- 5.Vertex AI 生成式 AI 价目表的 Claude 部分cloud.google.com/vertex-ai/generative-ai/pricing
- 6.Artificial Analysis 的 Claude Sonnet 5.5 模型页artificialanalysis.ai/models/claude-sonnet-5-5
- 7.Anthropic 提示缓存文档的 Tracking cache performance 一节platform.claude.com/docs/en/build-with-claude/prompt-caching
- 8.Artificial Analysis 的 Sonnet 5.5 与 Opus 5.5 对比页artificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-claude-opus-5-5
- 9.@ClaudeDevsx.com/ClaudeDevs
- 10.Claude Haiku 5.5 发布文anthropic.com/news/claude-haiku-5-5
- 11.API credits for Max and Team plans 说明platform.claude.com/docs/en/about-claude/api-credits-for-subscribers