Claude Batch API 价格与用法:五折怎么算,缓存何时叠加更省
Claude Batch API 对所有 token 打五折,多数批次 1 小时内完成、最长 24 小时。前缀长的任务,普通调用加缓存可能比不开缓存的 Batch 还便宜。
文章目录

Claude Batch API 的官方名称是消息批处理 API(Message Batches API):把一批普通的 Messages 请求一次提交到 POST /v1/messages/batches,由 Anthropic 异步处理,输入、输出、缓存读取和缓存写入全部按标准价的 50% 计费。截至 2026 年 10 月 30 日,Anthropic 的 Claude 批处理文档写明多数批次 1 小时内完成,最长 24 小时,到期还没处理的请求作废、不收费。所以评测、分类、信息抽取、批量改写、夜间报表这类等得起的任务适合交给它;要实时返回或流式输出的,继续用同步的 Messages API。
五折不等于账单减半。按 2026 年 10 月 30 日的官方标价复算 1 万条共享 3,000 token 前缀的 Sonnet 5.5 请求,普通调用加提示缓存(几乎全部命中)要 $44.00,不开缓存的 Batch 要 $50.50,前者反而便宜;在 Batch 里开 5 分钟缓存,命中率要超过约 21% 才不亏,命中 98% 时降到 $22.72。先拿自己任务的前缀长度、输出占比和模型对照下面的成本表决定怎么提交,提交后用 custom_id 把每条结果对回去:expired 和服务器错误直接重发,invalid_request_error 先改请求再发。
这个折扣只在提供该端点的渠道上有:Claude 官方 API、Claude Platform on AWS,以及由 Anthropic 托管的 Claude Models on Google Cloud;Amazon Bedrock 和 Google Vertex AI 是各自的批量推理产品,条款另算。Anthropic 的支持地区不包括中国大陆和香港,没有实现这个端点的中转服务也拿不到五折。另外,Claude Code 里的 /batch 命令是把代码改动拆给多个子代理并行完成的技能,和 Batch API 不是一回事。
Claude Batch API 价格:所有 token 按标准价五折
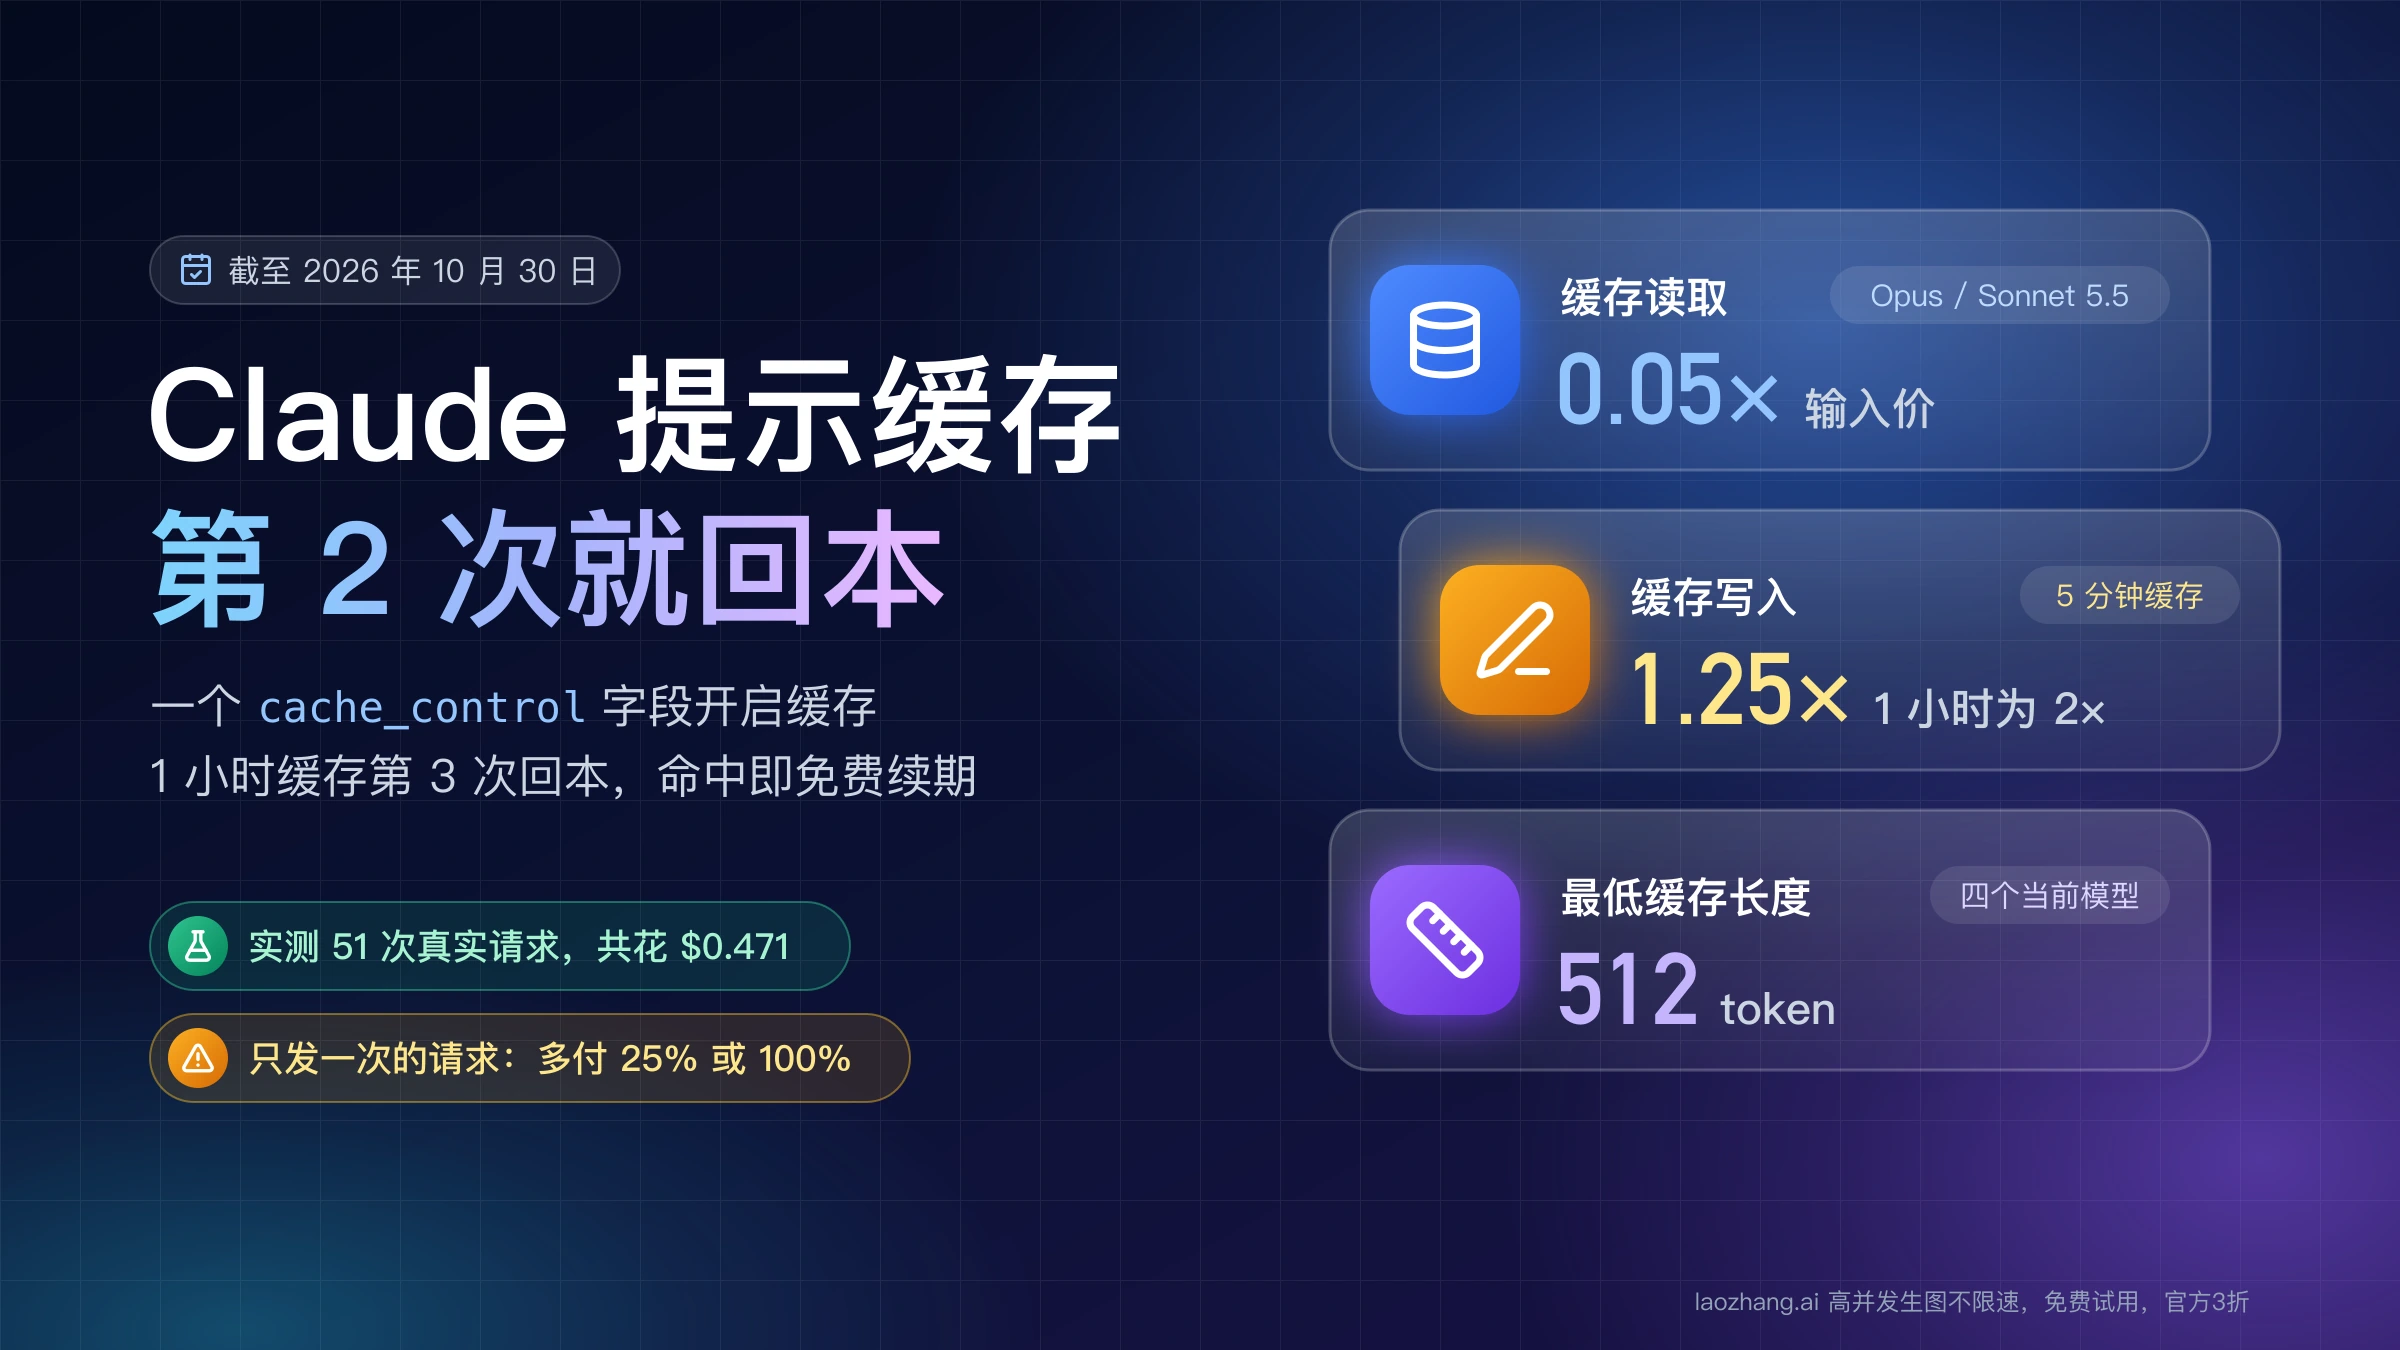
Batch 的折扣作用于每一类 token,而不只是输入。Anthropic Claude 定价页写明折扣覆盖输入、输出和"任何特殊 token",缓存倍率还会和 Batch 折扣叠加:缓存读取是基础输入价的 0.1 倍(Opus 5.5、Sonnet 5.5 为 0.05 倍,Fable 5.1 为 0.025 倍),5 分钟缓存写入 1.25 倍,1 小时缓存写入 2 倍。截至 2026 年 10 月 30 日,当前四个主力模型的价格如下,单位是美元 / 百万 token,缓存两列是用倍率乘以 Batch 输入价算出来的。
| 模型 | 标准输入 / 输出 | Batch 输入 / 输出 | Batch 缓存读取 | Batch 5 分钟缓存写入 |
|---|---|---|---|---|
| Claude Haiku 5.5(提示不超过 10 万 token) | $0.10 / $0.50 | $0.05 / $0.25 | $0.005 | $0.0625 |
| Claude Sonnet 5.5 | $2 / $10 | $1 / $5 | $0.05 | $1.25 |
| Claude Opus 5.5 | $4 / $20 | $2 / $10 | $0.10 | $2.50 |
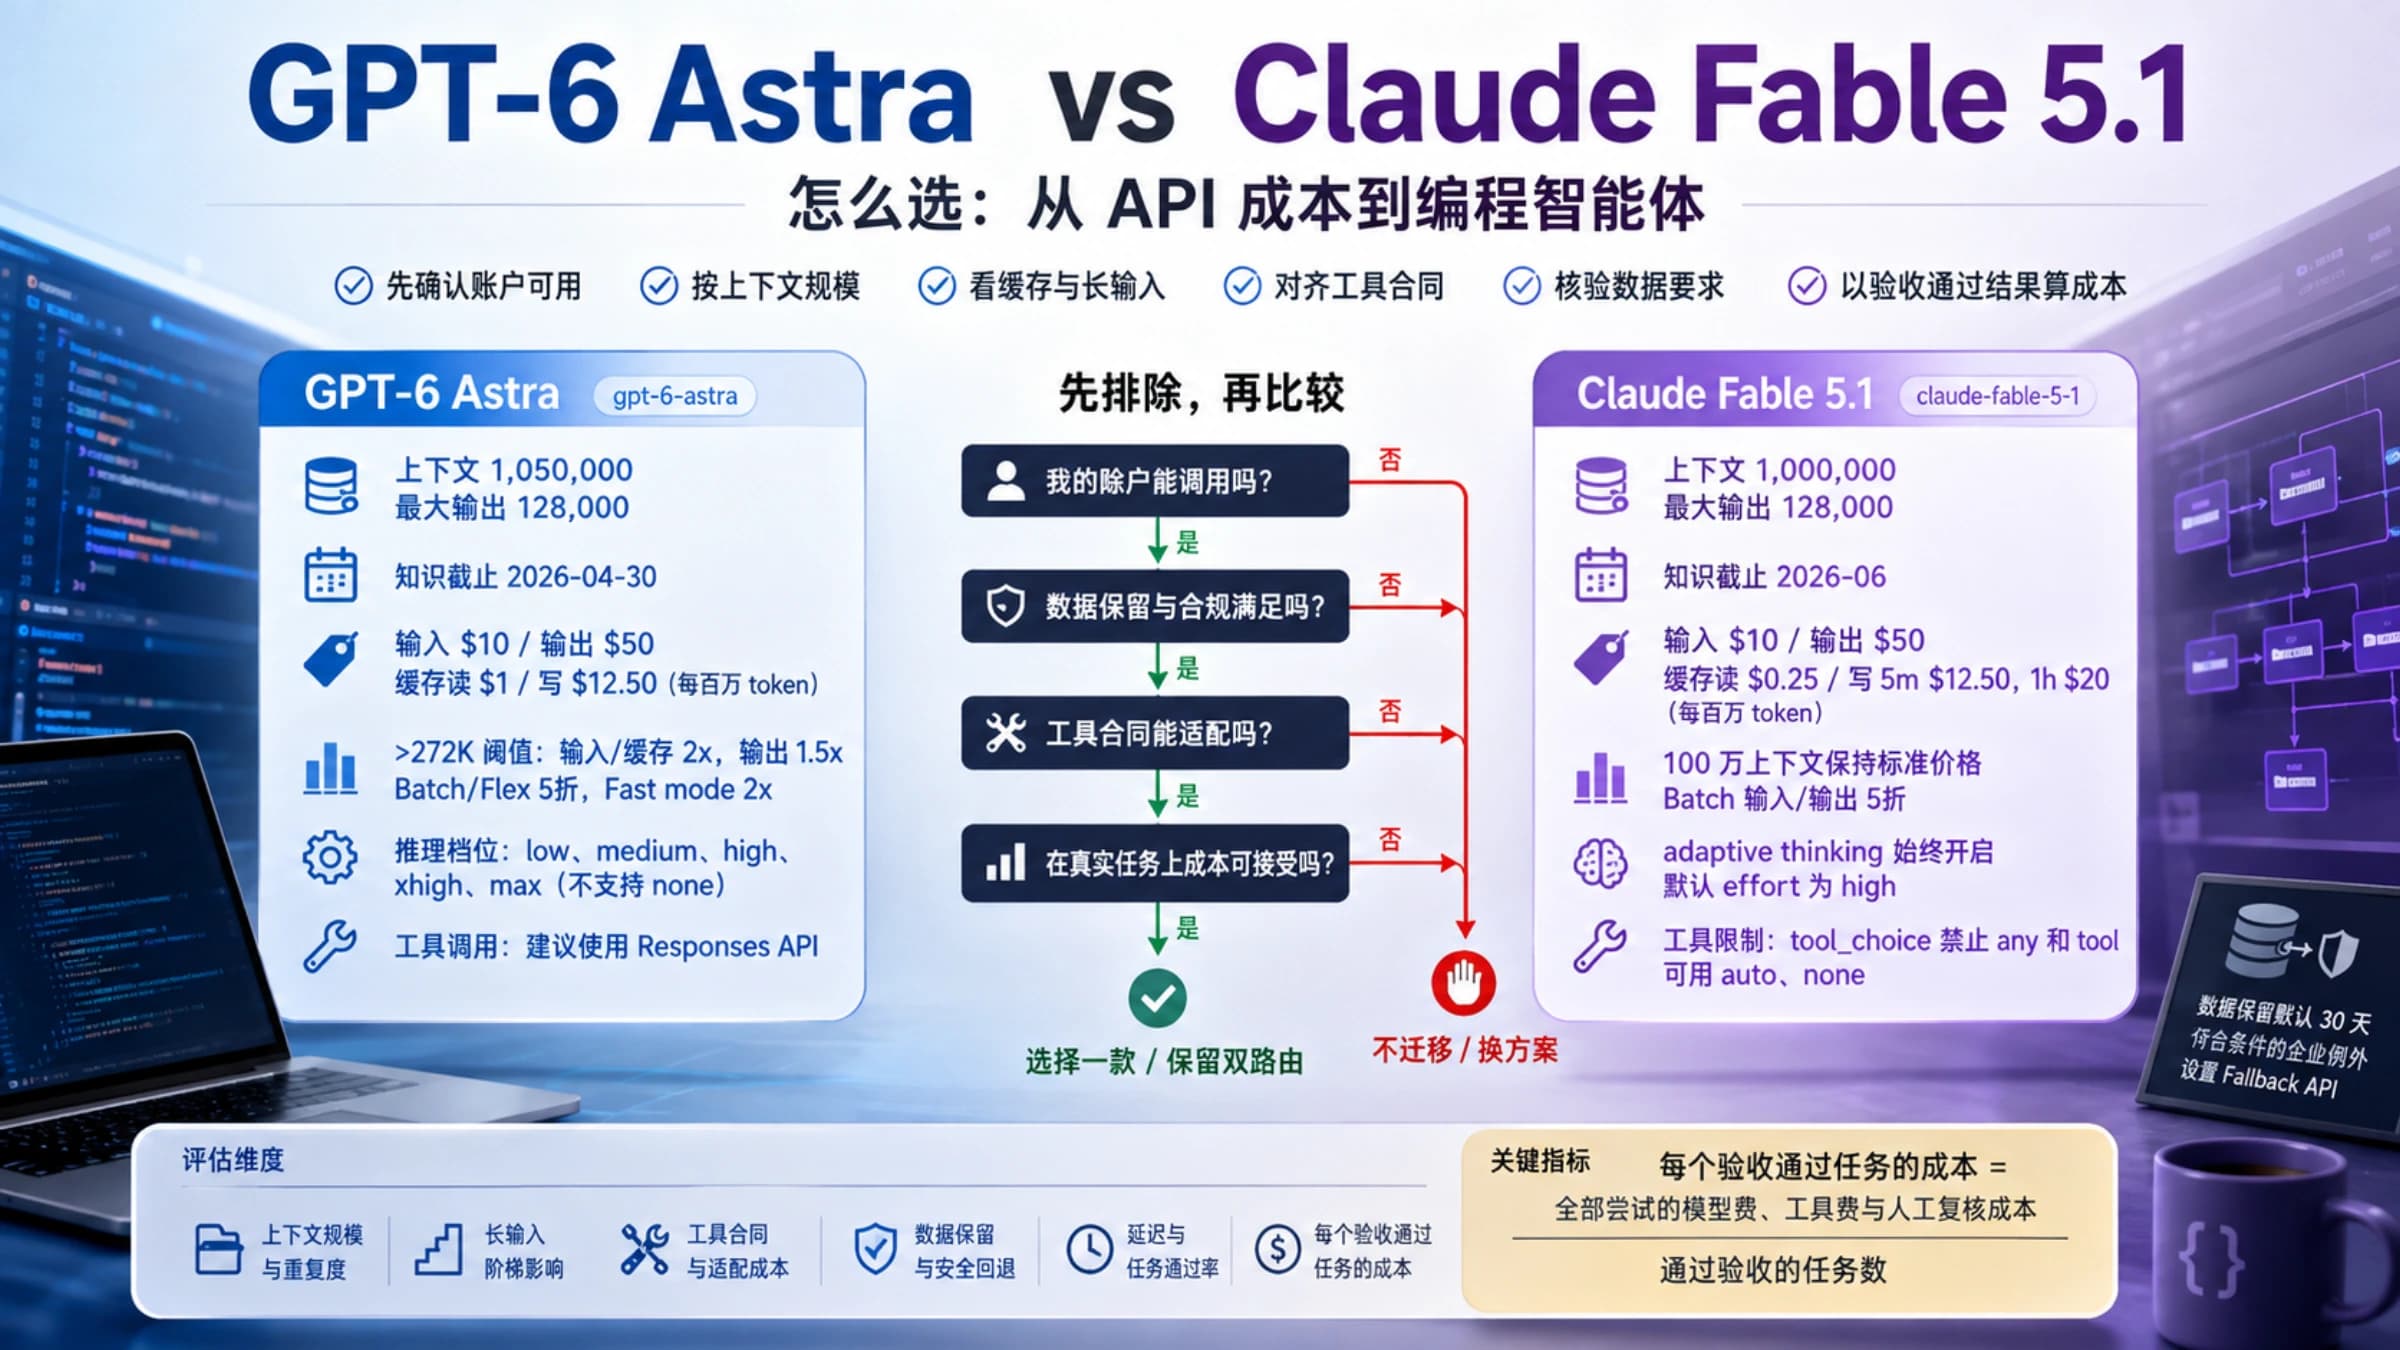
| Claude Fable 5.1 | $10 / $50 | $5 / $25 | $0.125 | $6.25 |
旧型号同样五折:Opus 5、4.8、4.7、4.6、4.5 的 Batch 价是 $2.50 / $12.50,Sonnet 5 是 $1 / $5,Sonnet 4.6 和 4.5 是 $1.50 / $7.50,Haiku 4.5 是 $0.50 / $2.50;Haiku 5.5 的提示超过 10 万 token 时,Batch 价是 $0.25 / $1.25。叠加规则也照常生效:指定 inference_geo: "us" 的美国境内推理对 Claude 4.6 及以后的模型所有 token 乘 1.1,和 Batch 折扣相乘;Claude 4.6 及以后的模型(Haiku 5.5 除外)整个 100 万 token 上下文都按标准单价计,Batch 折扣同样覆盖整个窗口;fast mode 不能和 Batch API 一起用。单个模型的价格变化细节见《Claude Fable 5.1 API 价格:降了什么,省多少》和《Claude Sonnet 5.5 缓存读取价格降到 $0.10:省多少看缓存占比》。
普通调用、缓存和 Batch 怎么选:1 万条任务的四种账单
决定省多少的是任务形状,不是折扣本身。下面这张表按 2026 年 10 月 30 日的官方标价复算同一批任务:1 万条请求,每条带 3,000 token 的共享前缀(系统提示、说明和示例)、800 token 的独立输入,输出 250 token;不用美国境内推理;缓存未命中时按写入价重新写一次前缀;"普通调用 + 缓存"假设请求依次发送、几乎全部命中。
| 做法 | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| 普通调用,不开缓存 | $5.05 | $101.00 | $202.00 | $505.00 |
| 普通调用 + 5 分钟缓存,约 100% 命中 | $2.35 | $44.00 | $88.00 | $212.50 |
| Batch,不开缓存 | $2.52 | $50.50 | $101.00 | $252.50 |
| Batch + 5 分钟缓存,命中 30% | $2.38 | $47.20 | $94.40 | $234.88 |
| Batch + 5 分钟缓存,命中 98% | $1.21 | $22.72 | $45.44 | $109.92 |
| Batch + 1 小时缓存,命中 30% | $3.17 | $62.95 | $125.90 | $313.62 |

以 Sonnet 5.5 为例,单条普通调用不开缓存的成本是 (3,800 × $2 + 250 × $10) ÷ 100 万 = $0.0101,乘 1 万条得 $101.00;开缓存后前缀按 0.05 倍读取,变成 (3,000 × $0.10 + 800 × $2 + 250 × $10) ÷ 100 万 = $0.0044,1 万条 $44.00。不开缓存的 Batch 是 $101.00 的一半,$50.50,比普通调用加缓存贵 $6.50。四个模型都是这个方向:每 1,000 条,Sonnet 5.5 是 $4.40 对 $5.05,Haiku 5.5 是 $0.235 对 $0.253。
所以规则可以这样定。如果你的请求几乎没有共享前缀,每条输入都不一样,缓存没什么可省,Batch 就是直接打五折,等得起就用它。如果前缀很长、你已经在同步调用里开了缓存并且命中稳定,单纯换成 Batch 不一定更便宜,要在 Batch 里也把缓存用起来才划算:在上面这个工作量下,Sonnet 5.5 的批内命中率要到约 39%,Batch 加缓存才追平普通调用加缓存(把上一段的单条成本公式里前缀部分换成 3,000 × $1 ×(0.05 × 命中率 + 1.25 × 未命中率)即可复算)。输出占比越高,Batch 越占优:这个工作量里输出占无缓存账单的 24.8%,缓存省不到这部分,Batch 却能把它砍半。同步调用开缓存还要面对普通接口的速率限制,排查方法见《Claude API 提示速率限制已达到:先找限制归属再重试》。
Batch 里开提示缓存何时划算:5 分钟缓存命中率过 21%
批内请求是并发、乱序处理的,缓存命中只能尽力而为。Anthropic 的批处理文档说,用户的批内命中率通常在 30% 到 98% 之间,取决于流量模式,所以开缓存之前要先知道自己的命中率至少要到多少才不亏。每次未命中都要按写入倍率 w 付一次前缀,每次命中只付读取倍率 r,和不开缓存(1 倍)相比,命中率要大于 (w − 1) ÷ (w − r) 才省钱。
代入 2026 年 10 月 30 日的官方倍率,5 分钟缓存(w = 1.25)的盈亏点是:Haiku 5.5 21.7%,Sonnet 5.5 和 Opus 5.5 20.8%,Fable 5.1 20.4%。1 小时缓存(w = 2)写一次的成本翻倍,盈亏点升到 52.6%、51.3%、50.6%。这就是上表里"Batch + 1 小时缓存,命中 30%"四个模型都比不开缓存的 Batch 还贵的原因。
Anthropic 给的做法是:每条请求放完全相同的 cache_control 块,尽量让请求共享更多内容,保持请求连续不断,避免 5 分钟的缓存条目在批次处理中途过期;批次有共享上下文时可以考虑 1 小时缓存。1 小时缓存能不能把命中率抬过 51%,没法事先算出来,先用几百条请求跑一小批,看结果里每条 message 的 usage 中缓存读取和缓存写入各占多少 token,再决定整批用哪种。批内不允许用 max_tokens: 0 预热缓存。缓存本身怎么开、TTL 怎么选,见《Claude Prompt Caching 提示缓存怎么用:各模型价格与命中实测》。
怎么提交、轮询和取结果:用 custom_id 对回每一条
Batch 的流程是创建、轮询、取结果三步,最容易出错的是请求格式和结果顺序。批内参数校验是异步的,格式错误要等整批结束才报出来;结果文件也不按提交顺序排列,只能靠 custom_id 对回。Python SDK anthropic 2.3.0 和 TypeScript SDK @anthropic-ai/sdk 1.3.0(都在 2026 年 10 月 23 日发布)提供 messages.batches 下的 create、retrieve、list、cancel、delete、results 方法。还没有 API key 的,先看《Claude API Key 怎么购买:官方充值、价格与免费额度,共享密钥避坑》。
- 用同步 Messages API 先发一条和批内请求同样形状的请求,确认模型名、参数和工具定义都能通过。
- 给每条请求一个批内唯一的
custom_id,只能用 1–64 位字母、数字、-和_;params里写普通 Messages 参数,max_tokens至少为 1,不带stream、speed、fallbacks。 - 调用
create提交,记下返回的批次 ID。 - 每隔一段时间调用
retrieve,直到processing_status从in_progress变成ended。文档里没有回调通知,官方示例就是轮询;结束前request_counts里成功、失败、过期等计数一直是 0,只有processing有数。 - 用
results流式读取.jsonl结果,按custom_id存好成功的内容,把需要重发和需要修改的请求分开。 - 在批次创建后的 29 天内取走结果,不再需要时可以用
DELETE /v1/messages/batches/{id}删除。

下面是按这套流程写的代码,run_batch 返回三组结果:成功内容、可以直接重发的 custom_id、要先改请求的 custom_id。
import time
import anthropic

client = anthropic.Anthropic()  # 读取环境变量 ANTHROPIC_API_KEY

def make_request(custom_id: str, text: str) -> dict:
    return {
        "custom_id": custom_id,  # 1–64 位:字母、数字、- 和 _,批内不能重复
        "params": {
            "model": "claude-haiku-5-5",
            "max_tokens": 300,
            "messages": [{"role": "user", "content": text}],
        },
    }

def run_batch(requests: list[dict], poll_seconds: int = 60):
    batch = client.messages.batches.create(requests=requests)
    print("已创建", batch.id, batch.processing_status)
    while batch.processing_status != "ended":
        time.sleep(poll_seconds)
        batch = client.messages.batches.retrieve(batch.id)
        print("状态", batch.processing_status, batch.request_counts)
    done, retry, fix = {}, [], []
    for item in client.messages.batches.results(batch.id):  # 顺序不保证,按 custom_id 对回
        r = item.result
        if r.type == "succeeded":
            done[item.custom_id] = r.message.content[0].text
        elif r.type == "expired":
            retry.append(item.custom_id)   # 24 小时内没轮到,没有调用模型,不计费
        elif r.type == "errored" and r.error.error.type == "invalid_request_error":
            fix.append(item.custom_id)     # 请求本身有问题,原样重发还会失败
        elif r.type == "errored":
            retry.append(item.custom_id)   # 服务器端错误,可以原样重发
    return done, retry, fix

# 用法:第一轮跑完后,只把 retry 里的请求原样再提交一次
# reqs = {cid: make_request(cid, text) for cid, text in tasks.items()}
# done, retry, fix = run_batch(list(reqs.values()))
# done2, retry2, fix2 = run_batch([reqs[cid] for cid in retry])
2026 年 10 月 30 日,这段代码用 anthropic Python SDK 2.3.0,在本机对着一个按官方文档响应格式搭的模拟服务跑通了完整流程。它不是 Anthropic 的服务器,所以不能说明真实的处理时间、校验报错内容或计费。5 条请求里 2 条 succeeded;1 条 api_error 和 1 条 expired 进入第二批重发后都成功;1 条 invalid_request_error 被单独留出等待修改。模拟服务故意把结果倒序返回,代码靠 custom_id 全部对上;批次结束前每次读取状态,request_counts 都是 processing=5、其余为 0。
succeeded、errored、canceled、expired:哪些重发,哪些不计费
只有 succeeded 计费,其余三种结果都不收钱,所以重发的成本只是重新排队的时间。一条请求失败不影响同批的其他请求;errored 要看 result.error 里的错误类型再决定,Anthropic 的示例代码把 invalid_request_error 当作"先改请求体",其他错误当作可以直接重试。
| 结果类型 | 含义 | 计费 | 怎么处理 |
|---|---|---|---|
succeeded | 请求完成,结果里带完整的 message | 按 Batch 价计费 | 按 custom_id 保存;用了服务器工具时检查 stop_reason 是否为 pause_turn |
errored,类型 invalid_request_error | 请求体有问题,例如参数不合法 | 不计费 | 修改请求后再提交,原样重发还会失败 |
errored,其他类型 | 服务器内部错误 | 不计费 | 原样重发 |
canceled | 批次被取消时这条还没处理 | 不计费 | 需要结果就重新提交 |
expired | 24 小时内没有轮到处理 | 不计费 | 重新提交;量大时留出更多时间 |
pause_turn 只在用了网页搜索、代码执行这类服务器工具时出现,意思是这一轮还没做完,把暂停时的 assistant 内容接上再发一次(批量或同步都可以)就能继续。结果使用创建批次那次请求的 API 版本。
Claude Batch API 上限:每批 10 万条或 256 MB,24 小时过期
截至 2026 年 10 月 30 日,Anthropic 的批处理文档规定单个批次最多 100,000 条请求或 256 MB,先到哪个算哪个,超过会收到 413 request_too_large;Batch API 刚推出时的公告写的是每批 10,000 条,这个数字已经不适用。批次创建时就定下 expires_at,即创建后 24 小时,到时没处理完的请求记为 expired;所有请求处理完或满 24 小时,先到哪个就可以下载结果。结果保留 29 天,从批次的 created_at 起算,不是从结束时间算,所以跑满 24 小时的批次实际只剩 28 天左右可以取。批次和结果只在创建它的 Console Workspace 内可见,换个 Workspace 的 key 查不到。
Batch 有自己的速率限制,所有模型共用,并且不占用同步 Messages API 的额度。按 Anthropic 速率限制文档,各层级的数值如下;新组织可能先处在更低的 Evaluation 层级,那一层的 Batch 数值没有公布,Custom 层级要联系销售。
| 层级 | 每分钟请求数(RPM) | 处理队列中的批量请求总数 | 每批最多请求数 |
|---|---|---|---|
| Start | 1,000 | 200,000 | 100,000 |
| Build | 2,000 | 300,000 | 100,000 |
| Scale | 4,000 | 500,000 | 100,000 |
同步调用遇到 529 过载的处理方法不同,见《Claude API 529 overloaded_error 怎么解决:重试设置与过载排查》。
批次跑了几个小时或过期:处理速度取决于当时的负载
Batch 没有处理时间承诺。Anthropic 的批处理文档只说多数批次 1 小时内完成,同时写明处理速度会"根据当前需求和你的请求量"变慢,变慢时会有更多请求在 24 小时后过期。所以要按批次的处理期限来安排流程,而不是按"通常 1 小时":结果必须在一两个小时内拿到的任务,不适合交给 Batch。
公开记录里能找到的只有零散数据。截至 2026 年 10 月 30 日,status.claude.com 的事故历史里,2025 年和 2026 年没有一条提到 Batch,Message Batches 相关的只有 2024 年 11 月 4 日的错误率升高,以及 11 月 6 日至 7 日的处理延迟;没有事故记录不等于没有变慢。Hacker News 用户 erans 在 2026 年 4 月 27 日提到,他把 agent 的每一轮都改走 Batch API 后,只有 1 条请求的批次通常也要 90–120 秒,Haiku 的批次常常感觉比 Sonnet、Opus 更慢,他自己也说这不是严格测量。另外,用 output-300k-2026-03-24 beta 头把单条输出提到 30 万 token 时,官方说这样一条生成可能超过 1 小时。
遇到过期就把 expired 的 custom_id 挑出来重新提交,它们没有调用模型,不产生费用;已经成功的结果照常下载,不用整批重跑。
哪些请求能放进 Claude 批次:工具和多轮可以,流式和 fast mode 不行
普通 Messages API 能做的事,大部分都能放进批次,不同类型的请求也可以混在同一批里。真正的限制有两类:一类是几个参数直接不支持,带上就校验失败;另一类是批内一条请求就是一次 Messages 调用,不能停下来等你本地工具的返回。
| 功能 | 能否放进批次 | 说明 |
|---|---|---|
| 图片输入、系统提示、多轮对话 | 可以 | 多轮对话把历史消息写进 messages 即可 |
| 客户端工具调用 | 可以,但一条请求只走一轮 | 模型返回 tool_use 后,要在本地执行工具,再把结果作为下一次请求提交 |
| 服务器工具(网页搜索、网页抓取、代码执行、MCP 连接器、工具搜索等) | 可以 | 批内可以比同步调用多跑几轮再返回 pause_turn;网页搜索在批内按组织限流并自动重试 |
| 扩展思考和大多数 beta 功能 | 可以 | 30 万 token 输出的 beta 只在 Batch 提供,限 Claude API 和 Claude Platform on AWS |
stream: true | 不可以 | 校验失败 |
speed(fast mode)、fallbacks(服务器端回退) | 不可以 | 校验失败 |
max_tokens: 0 | 不可以 | 每条请求的 max_tokens 至少为 1 |
国内能用 Claude Batch API 吗:先看渠道有没有这个端点
Batch 的五折只在提供 Message Batches API 的渠道上拿得到,按 Anthropic 的批处理文档,截至 2026 年 10 月 30 日是 Claude 官方 API、Claude Platform on AWS 和 Anthropic 托管的 Claude Models on Google Cloud,三者都是正式可用状态。其中官方 API 要用 Anthropic 的 Console 账号,而按 Anthropic 截至 2026 年 10 月 22 日的支持地区列表,中国大陆、香港、俄罗斯、白俄罗斯和委内瑞拉不在支持范围内,只有身处支持地区的用户才能创建和使用账号。
Amazon Bedrock 和 Google Vertex AI 上的 Claude 走的是云厂商自己的批量推理产品,格式、上限和价格都跟着各自的平台。AWS 的 Amazon Bedrock 定价页说部分 Anthropic 模型的批量推理比按需调用便宜 50%;输入是放在 S3 里的 JSONL,每行一个 recordId 和 modelInput,Claude 模型每个任务至少 100 条记录,最多 100,000 条、5 GB。截至 2026 年 10 月 30 日,Bedrock 支持批量推理的模型列表里,Claude 列到的是 Opus 5、Opus 4.6、Sonnet 4.6 和 Haiku 4.5,没有 5.5 系列和 Fable;用 Converse 格式提交时批内不能做工具调用,要改用 InvokeModel 格式。Google 的 Vertex AI Claude 批量预测文档(2026 年 10 月 28 日更新)已列出 Sonnet 5.5、Opus 5.5、Haiku 5.5、Fable 5.1 和 Fable 5,输入可以是 BigQuery 表或 Cloud Storage 里的 JSONL,不支持全局端点,每个项目默认最多 4 个并发批量任务;Vertex 上的批量价格要以 Google Vertex AI 价格页对你所用模型的标注为准。
API 中转服务能不能给你 Batch 折扣,取决于它有没有实现 /v1/messages/batches。2026 年 10 月 30 日 13:56(UTC),用一个按量计费的 laozhang.ai 密钥请求它的 GET /v1/messages/batches、POST /v1/messages/batches 和按批次 ID 查询,三个都返回 HTTP 404 "Invalid URL",没有产生费用。也就是说,通过它调用 Claude 只能走同步 Messages 接口,按平台报价计费,拿不到 Batch 的五折;这种情况下能压成本的是提示缓存。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
Claude Batch API 的其他问题
已经提交的批次能修改吗?
不能。按 Anthropic 的批处理文档,批次提交后无法修改,只能调用 POST /v1/messages/batches/{id}/cancel 取消,状态先变成 canceling,再变成 ended;取消不一定立刻生效,已经处理完的请求会照常返回结果,没处理的记为 canceled,不计费。改好后再提交新批次。
批次花费会超过 Workspace 设置的支出上限吗?
可能会略微超过。Anthropic 的批处理文档说明,因为吞吐量高、并发处理,批次可能稍微超出 Console 里为 Workspace 设置的支出上限,所以预算卡得很紧时要留一点余量。
Claude Max 送的 API 额度能用来跑 Batch 吗?
可以。按 Claude 帮助中心截至 2026 年 10 月 8 日的说明,Max 5x 每月 $100、Max 20x 每月 $200、Team 标准席位每席 $20、高级席位每席 $100 的 API 额度适用于 Claude API,包括 Message Batches;订阅满 7 天后,关联一个 Console 组织即可领取。账号本身仍受上面的支持地区限制。两种产品怎么分工,见《Claude API 和 Claude Code 区别:该用哪个,Max 的 API 额度管什么》。
Claude Code 能把任务交给 Batch API 跑吗?
内置的 /batch 不行。按 Claude Code 文档,它会先研究代码库,把改动拆成 5 到 30 个独立单元,确认后为每个单元在单独的 git worktree 里启动一个后台子代理,各自实现、测试并提交。想让 Claude Code 把工作发到 Batch API,需要第三方工具,例如开源的 claude-batch-toolkit(MCP 服务加技能,2026 年 2 月 9 日创建),它在内置 /batch 出现后把自己的命令改名为 /batchy,默认模型仍是较旧的 claude-opus-4-6。
Batch 的请求数据会保留多久?
批次结果从创建时起保留 29 天,期间只有同一 Workspace 的 API 请求和有权限的 Console 用户能看到;处理结束后可以用 DELETE /v1/messages/batches/{id} 提前删除。按 Anthropic 的批处理文档,Batch API 因为需要异步存储,不在零数据保留(ZDR)的适用范围内。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月30日。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月30日。
- 1.Claude 批处理文档platform.claude.com/docs/en/build-with-claude/batch-processing
- 2.Claude 定价页platform.claude.com/docs/en/about-claude/pricing
- 3.速率限制文档platform.claude.com/docs/en/api/rate-limits
- 4.支持地区列表support.claude.com/en/articles/8461763-where-can-i-access-claude
- 5.Amazon Bedrock 定价页aws.amazon.com/bedrock/pricing
- 6.Vertex AI Claude 批量预测文档docs.cloud.google.com/vertex-ai/generative-ai/docs/partner-models/claude/batch