Claude API 500 内部服务器错误:有限重试与失败处理
500 api_error 表示 Claude API 内部发生意外错误。保存实际响应和请求 ID,对可安全重复的请求做有限退避;仍然失败时,结束当前调用、保留任务与失败记录,等待恢复或联系实际服务方。
文章目录
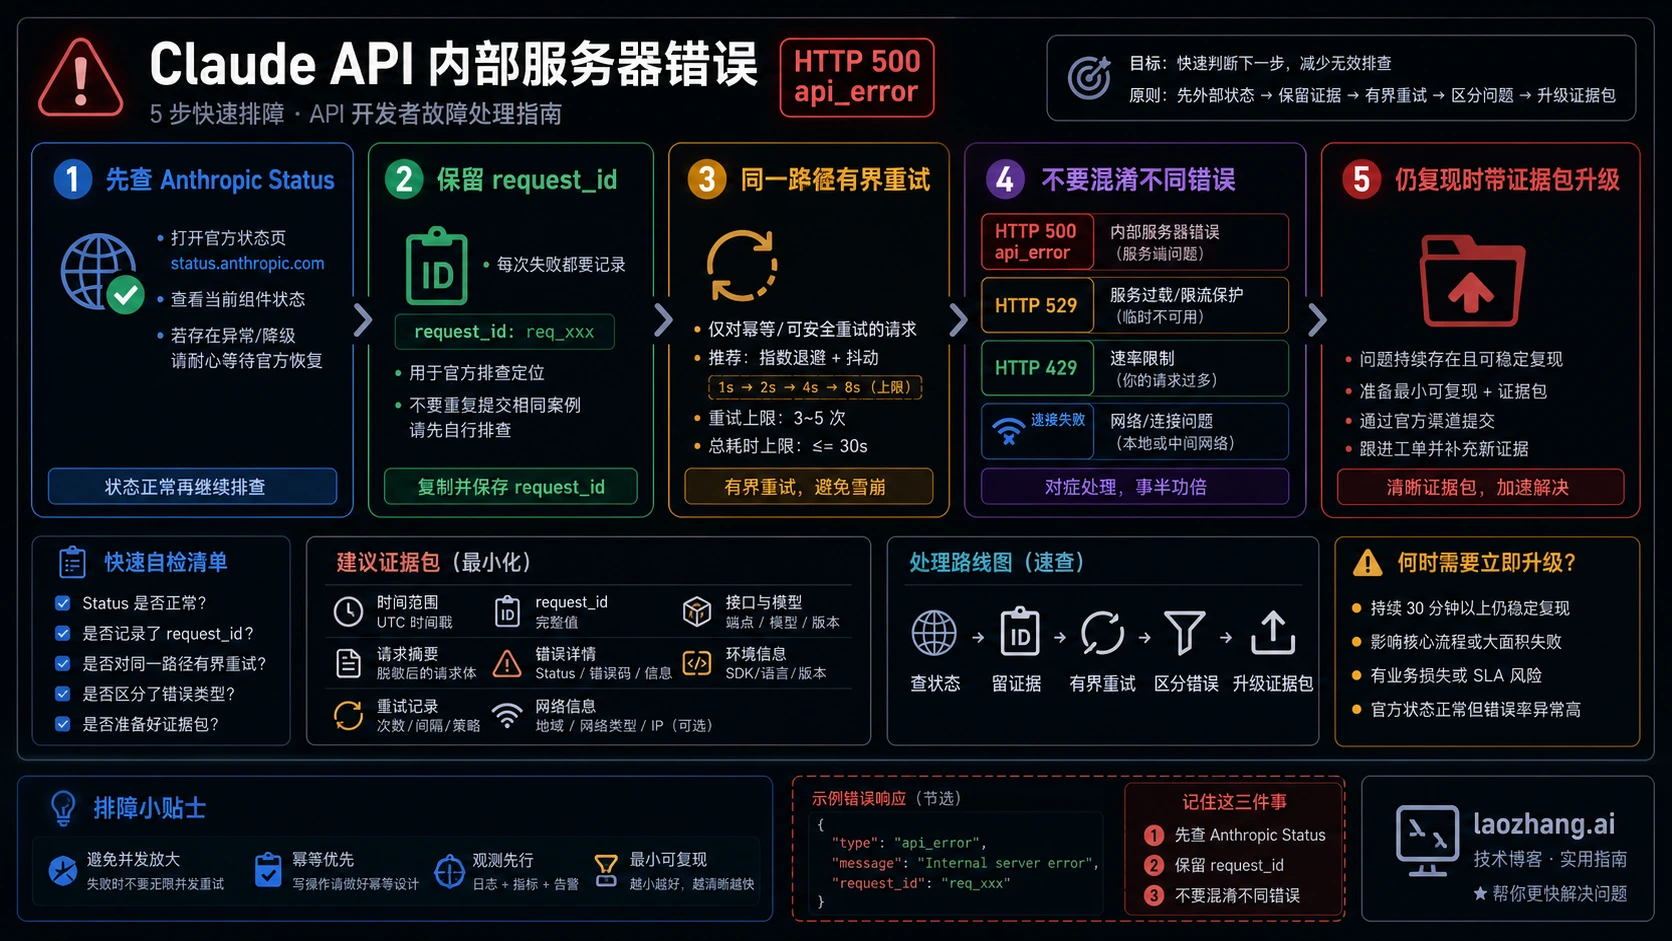
Claude API 返回 500 api_error,表示 API 内部发生意外错误。先保存错误响应、发生时间和请求 ID,再对可以安全重复的请求做有上限的指数退避。有限重试后仍然返回 500,就结束当前调用,把仍有价值的任务延期,带失败证据联系对应服务方。 不需要先轮换密钥、充值或重写提示词;这些动作需要各自的错误依据。
Anthropic API 错误参考明确区分 500 api_error、529 overloaded_error、429 rate_limit_error 和 504 timeout_error。本文处理程序已经收到的 API 500,不把所有“内部服务器错误”都套进同一套修复步骤。
如果你看到的是终端中的 API Error: 500 Internal server error. This is a server-side issue, usually temporary — try again in a moment.,先进入 Claude Code 报错后的会话恢复与进度核对。Code 已有自己的自动重试,而且工具可能已经执行;普通 Python SDK 的设置不能直接照搬到 Code。
先确认收到的是 API 500,还是网关返回的错误
先读 HTTP 状态码和错误正文,再决定处理方式。直连 Anthropic 的错误 JSON 包含 error.type、error.message 和 request_id,例如下面这个示意响应:
{
  "type": "error",
  "error": {
    "type": "api_error",
    "message": "Internal server error"
  },
  "request_id": "<实际返回的请求 ID>"
}
其中的请求 ID 是占位符,不是失败实测。实际记录时应保存原值。官方说明,响应头的 request-id 与错误正文的 request_id 对应同一次请求;支持方可以据此追踪失败。见错误格式与请求 ID 说明。
| 实际收到的信号 | 本轮应该做什么 |
|---|---|
Anthropic API 的 HTTP 500,正文为 api_error | 保存响应证据,按本文配置有限重试和最终失败处理 |
| 网关返回 HTTP 500、HTML 错误页,或没有上游错误类型 | 保存网关响应和网关 ID,让网关确认出错的那一跳;不能直接认定 Anthropic 返回了 api_error |
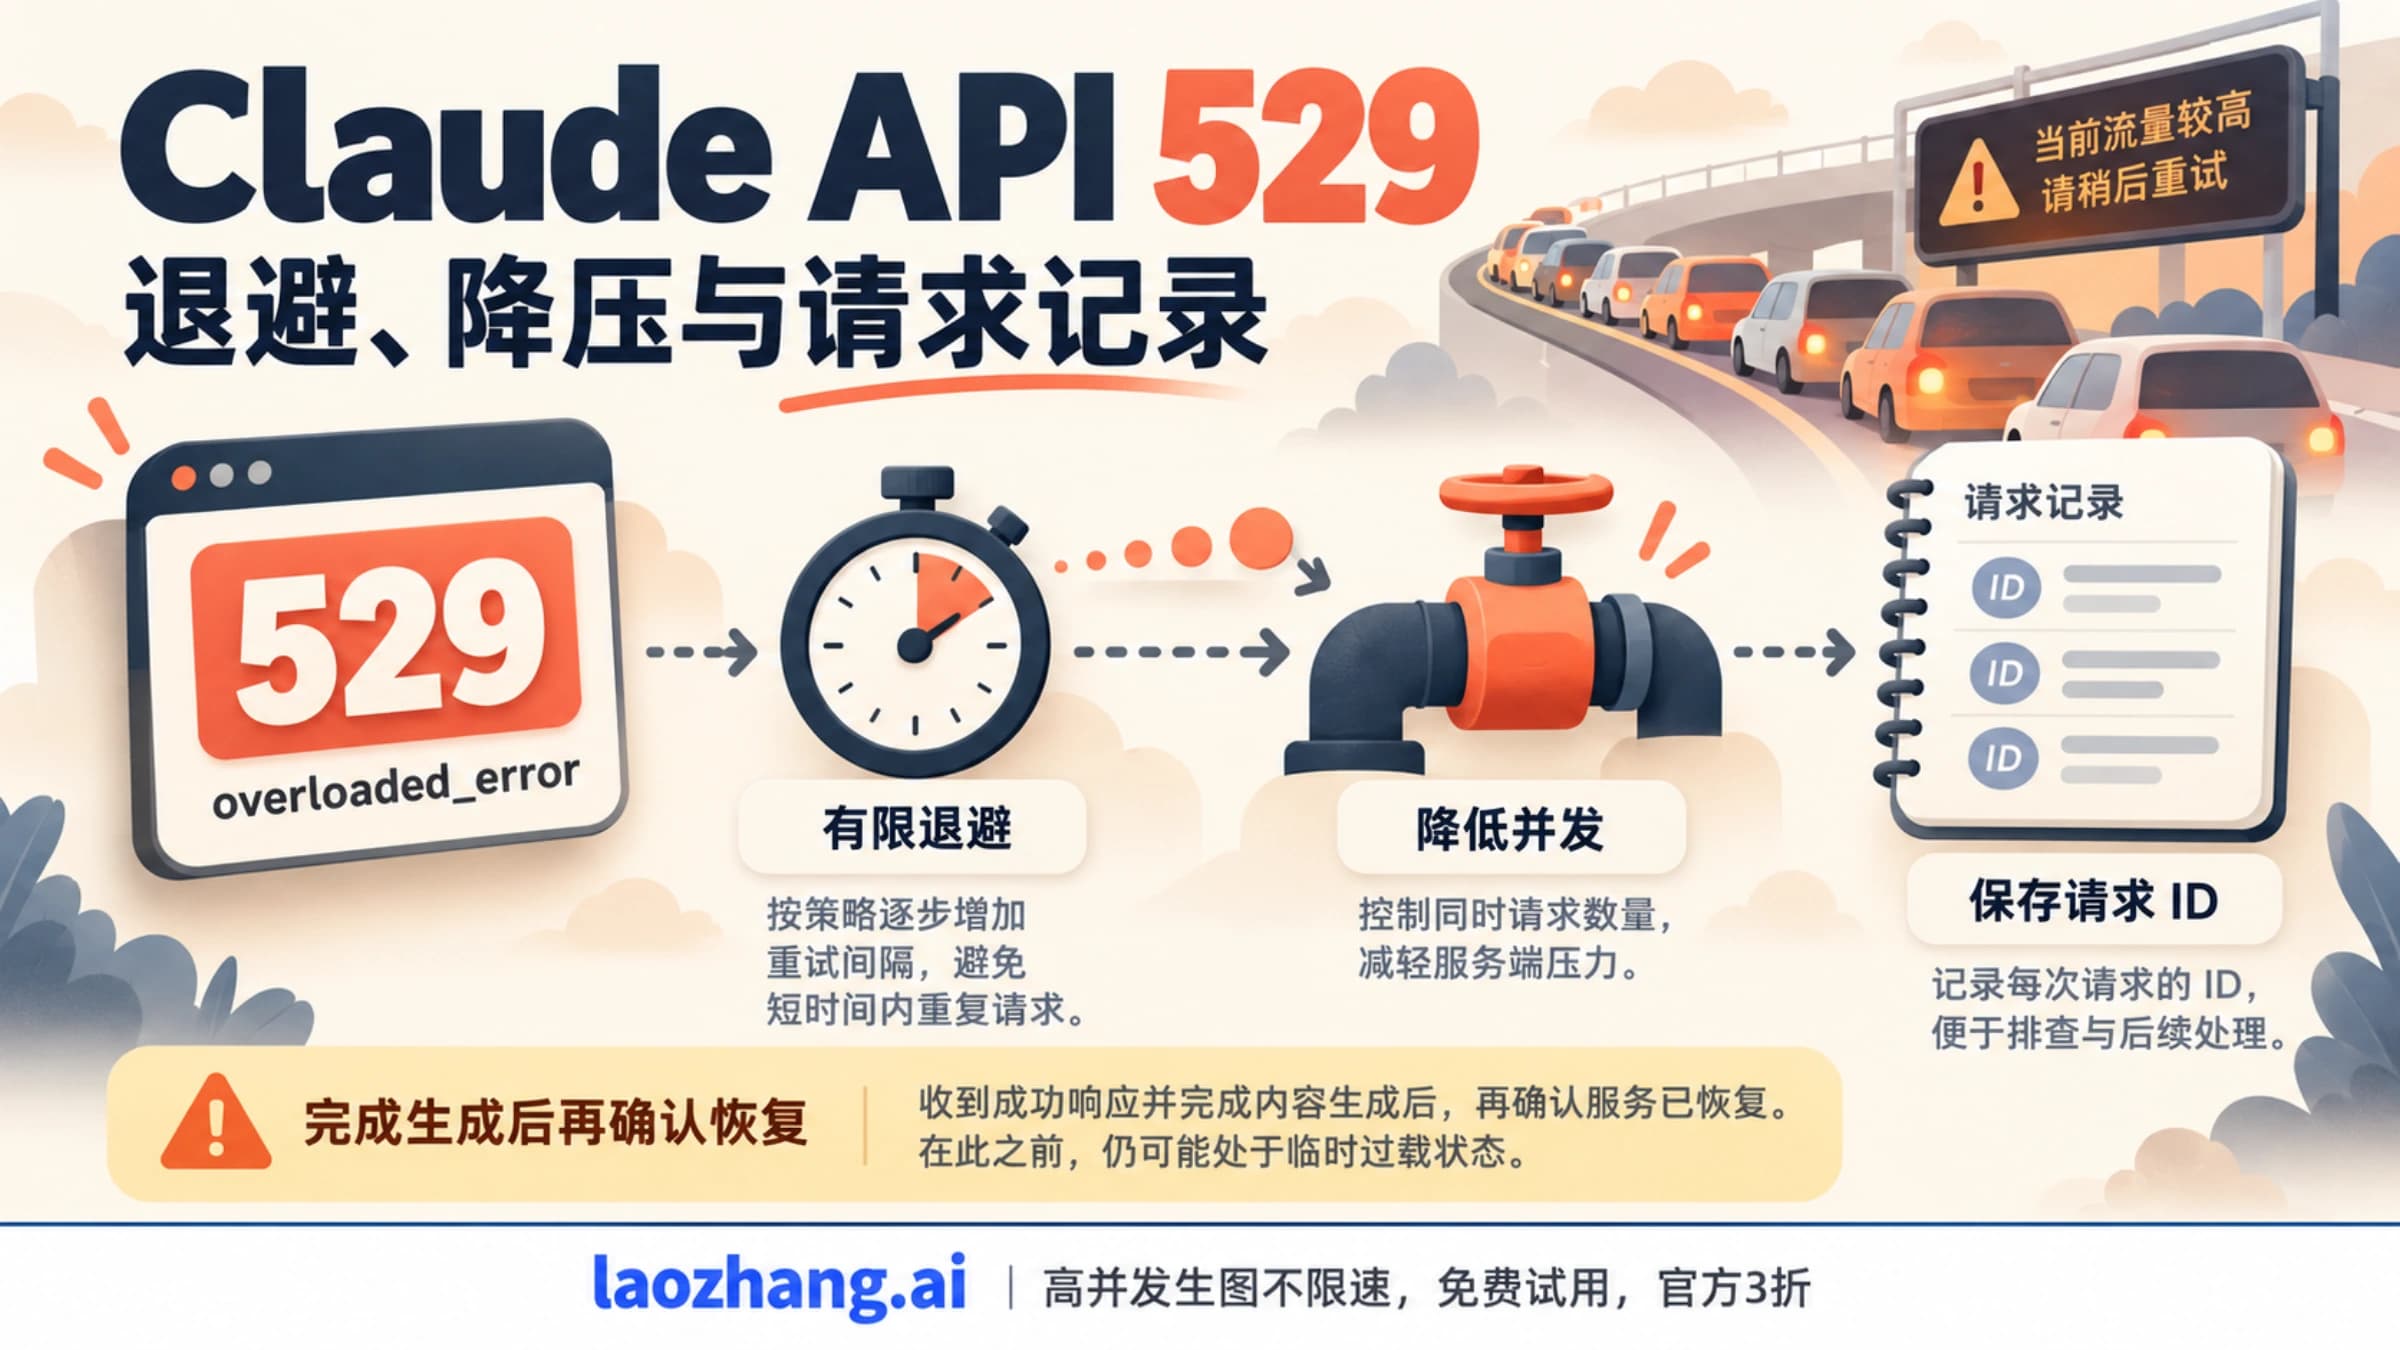
529 overloaded_error | 按API 529 过载处理退避、降低并发和验证恢复 |
429 rate_limit_error | 阅读正文及响应头,区分速率限制和支出上限;支出上限不能靠连续重试解除 |
504 timeout_error | 检查请求耗时与已有结果,长任务再考虑流式接口或拆分 |
| 连接异常,未取得可用 HTTP 响应 | 查实际端点、代理、TLS 和超时;它不能证明 API 返回过 500 |
HTTP 分类和支出上限条件来自官方错误参考。如果只有网页或第三方应用的一句报错,先用 Claude 网页、Code 与 API 的错误入口确认所在环境。
没有请求 ID,也不能反推“请求没到 API”。 网关可能没有透传标头,应用可能没有暴露字段,日志也可能漏记。只要已取得 HTTP 响应,就保留实际状态、正文和服务方;是否缺少某一个标识,不应取代这些证据。
Python SDK 怎样接住重试后的最终 500?
让一个地方负责重试最容易控制。对于简单的非流式文本请求,可以交给官方 SDK;应用接住 SDK 最终抛出的异常,给业务层明确结果,而不是再套一个无限循环。
Python SDK 文档说明,连接错误、408、409、429 和 500 及以上的内部错误默认额外重试两次,并使用短暂的指数退避。max_retries=2 通常意味着首次请求加至多两次重试,不能理解成总共只有两次,也不是 Claude Code 的十次策略。可用 max_retries=0 关闭 SDK 重试,或用 with_options 为某个请求单独设置。
下面是完整的非流式纯文本示例,显式使用 Anthropic 直连地址。它读取已有的 ANTHROPIC_API_KEY,不输出密钥;模型 ID 由运行参数提供。先安装 anthropic 包,把代码保存为 handle_500.py,再准备 UTF-8 文本文件。实际运行会调用 API 并可能计费;这里仅做了离线分支验证,没有执行真实请求。
import argparse
import json
from datetime import datetime, timezone
from importlib.metadata import version
from pathlib import Path

import anthropic


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("prompt_file", type=Path)
    parser.add_argument("--model", required=True)
    parser.add_argument("--job-id", required=True)
    args = parser.parse_args()
    prompt = args.prompt_file.read_text(encoding="utf-8")
    record = {
        "job_id": args.job_id,
        "time_utc": datetime.now(timezone.utc).isoformat(),
        "model": args.model,
        "endpoint": "https://api.anthropic.com/v1/messages",
        "sdk_version": version("anthropic"),
        "configured_max_retries": 2,
    }

    def finish(state, exit_code, **details):
        print(json.dumps({**record, "state": state, **details},
                         ensure_ascii=False))
        return exit_code

    with anthropic.Anthropic(
        base_url="https://api.anthropic.com",
        max_retries=2,
        timeout=20.0,
    ) as client:
        try:
            message = client.messages.create(
                model=args.model,
                max_tokens=512,
                messages=[{"role": "user", "content": prompt}],
            )
        except anthropic.APITimeoutError:
            return finish("unconfirmed", 2, reason="timeout")
        except anthropic.APIConnectionError:
            return finish("unconfirmed", 2, reason="connection_error")
        except anthropic.APIStatusError as exc:
            body = exc.body if isinstance(exc.body, dict) else {}
            error = body.get("error")
            error_type = error.get("type") if isinstance(error, dict) else None
            request_id = (exc.response.headers.get("request-id")
                          or body.get("request_id"))
            details = {
                "status_code": exc.status_code,
                "error_type": error_type,
                "request_id": request_id,
            }
            if exc.status_code == 500:
                return finish("deferred", 75, **details)
            return finish("failed", 2, **details)

        text = "".join(block.text for block in message.content
                       if block.type == "text")
        complete = message.stop_reason == "end_turn" and bool(text.strip())
        return finish(
            "completed" if complete else "needs_review",
            0 if complete else 2,
            request_id=message._request_id,
            stop_reason=message.stop_reason,
            text=text,
        )


if __name__ == "__main__":
    raise SystemExit(main())
调用形式如下;把模型占位符换成当前账号实际可用的准确 ID。job-id 是你自己的任务标识,同一业务任务延期时保留它,不把它当作 Anthropic 的请求 ID。
python handle_500.py prompt.txt --model "<实际模型 ID>" --job-id "job-001"示例让精确的 HTTP 500 返回 state: deferred 和退出码 75;其余 HTTP 状态返回 failed,连接与超时返回 unconfirmed。这些是示例给业务层的约定:它不会自动创建队列、提交工单或稍后重新执行。 调用方需要先保存这条结果,再决定任务是否值得延期。别让调度器把所有非零退出都立即重跑,否则又会叠加一层重试。
异常分支使用 APIStatusError.status_code,而非从报错文字里找“500”。官方 SDK 的基础 APIError 不保证具有这个字段;也不要把所有 InternalServerError 都写成精确的 500。本文核对的 Python SDK 当前 main 源码会把多个服务端状态归入异常类别,并单独处理 529;main 快照不代表你安装的发行版,排查时保留实际版本。
示例只输出适合关联的最小字段,没有打印原始提示词或完整错误正文。它只能取得最终失败的请求 ID,configured_max_retries 也只是配置值,不能冒充实际尝试次数。若要给支持方每次尝试的时间和 ID,需要在自己的客户端或网关中保存相应的脱敏记录。
重试有上限,为什么用户仍然等了很久?
先检查 SDK、应用循环、任务队列和网关是否都在重试。SDK 一次调用已经可能发出多次请求,应用再调用它三次,就会放大尝试数量。把重试责任收敛到一个地方,再设置其他层的停止或延期条件。
timeout=20.0 也不能承诺整个任务在 20 秒内返回。Python SDK 文档说明默认请求超时是十分钟,超时异常本身也会默认重试两次。请求等待、退避间隔以及服务器要求的等待都可能增加总耗时。
服务器提供 retry-after 时,先遵循等待要求;如果它超出当前用户或任务能等的时间,应停止当前等待并延期,而不是缩短等待后马上重发。2026 年 10 月 4 日核对的 SDK main 退避实现还会处理 retry-after-ms 和 x-should-retry,这些细节须按实际安装版本确认,不能假设每个响应都有这些标头。
对于前台请求,产品层可以先向用户返回“暂时无法生成,任务已保留”,并限制后台工作继续占用资源。对于后台任务,可以设置最晚有效时间,超过时限后取消,而不是不断延期。要真正强制整个任务的截止时间,还需要调用方能够取消进行中的网络操作或终止执行任务;仅在每次调用前看一下时钟、设置 SDK timeout,并不构成硬性总时限。
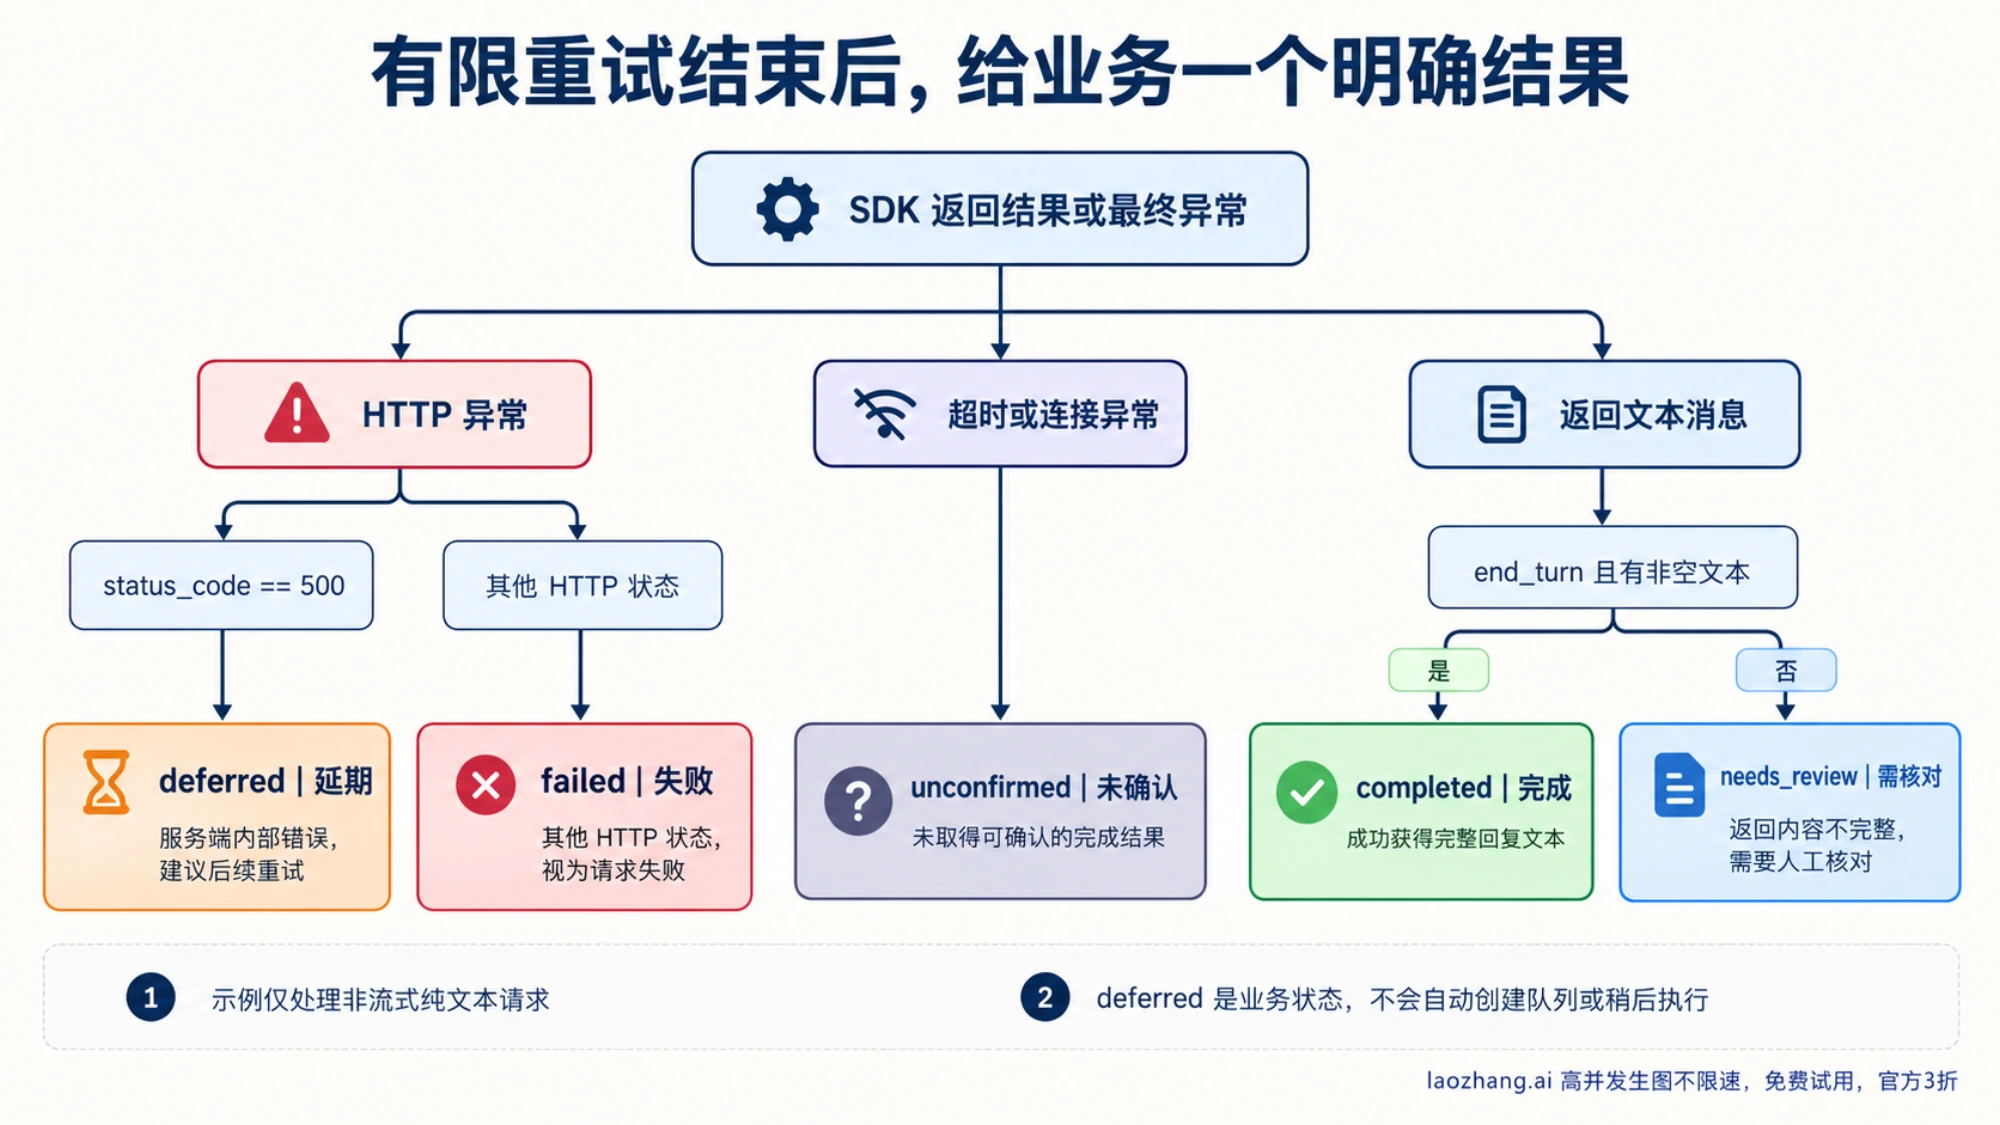
图用于理解恢复步骤。具体次数和等待时间按你的业务约束与实际响应设置,不从示意图推导服务恢复时间或通用阈值。
持续 500 后,怎样停止、延期和恢复任务?
持续失败的处理应当保住任务和已有工作。一次调用停止后,先保存失败结果,再让业务状态进入明确出口:
- 用户还在等结果:结束本轮生成,显示暂时失败或已延期。给出可用的后续入口,例如查询任务状态或稍后重试;后台是否继续执行应与提示一致。
- 后台工作仍有价值:保留输入的安全存储位置、业务任务 ID、失败时间和证据,延后排队。设置下一次允许尝试的时间及最晚有效时间,避免多个工作进程同时重跑同一任务。
- 已有外部写入或状态不明:先核对数据库、工具执行、通知或其他业务结果。只续做未完成的步骤,不能把“API 报错”当作整项工作都没执行。
- 任务已经过期或无法安全重复:标为取消或人工处理,给调用方明确原因。停止可以是正确的最终结果,不必把所有任务都留在无限等待中。
这些是应用层的处理建议,不是 Anthropic API 自动完成的功能。业务任务 ID 用来关联同一项工作;每次请求返回的 request_id 用来追踪具体尝试,二者都要保存。也不要假设给 Messages API 加一个 Idempotency-Key 就能替你去重所有业务操作,本文所依据的错误文档没有提供这样的通用保证。
随后检查 Claude Status,记录查看时间和相关事件。公开状态绿色不能证明某个模型、项目、网关或请求已经恢复;单次 500 也不能证明所有用户都遇到了事故。若有相关事故,可以按事故进展等待;若无公开事故,同一路径持续失败,则用证据包联系支持。
恢复时先放行少量可安全重复的任务,确认拿到完整结果,再恢复正常流量。成功标准包括返回内容可解析、满足当前任务,以及需要的业务结果已经确认。切换模型或服务商可以作为已评估的临时替代,但要保留原始失败记录;“换了以后成功”不足以证明原来的根因。
已经收到部分流式输出,还能重发吗?
先保存部分输出,确认请求是否完成以及应用有没有执行工具动作。API 错误参考明确说明,SSE 流可能在 HTTP 200 之后发生错误,此时不会完全沿用普通 HTTP 错误处理方式。因此,上面的非流式示例不能直接当作完整的流式恢复实现。
不要把新一轮输出直接追加到旧结果,也不要重新执行已经完成的工具动作。将已有结果标为不完整,核对实际状态后,再决定重新生成、续做剩余步骤或人工处理。Code 会话的具体恢复方法由原会话恢复指南承接。
同一路径仍然失败,给支持方哪些证据?
先保留原始失败,再形成一份简短的脱敏记录。同一路径指实际模型、端点、SDK 或网关、请求形状保持可比较;不需要为了“证明稳定复现”再发大量请求。
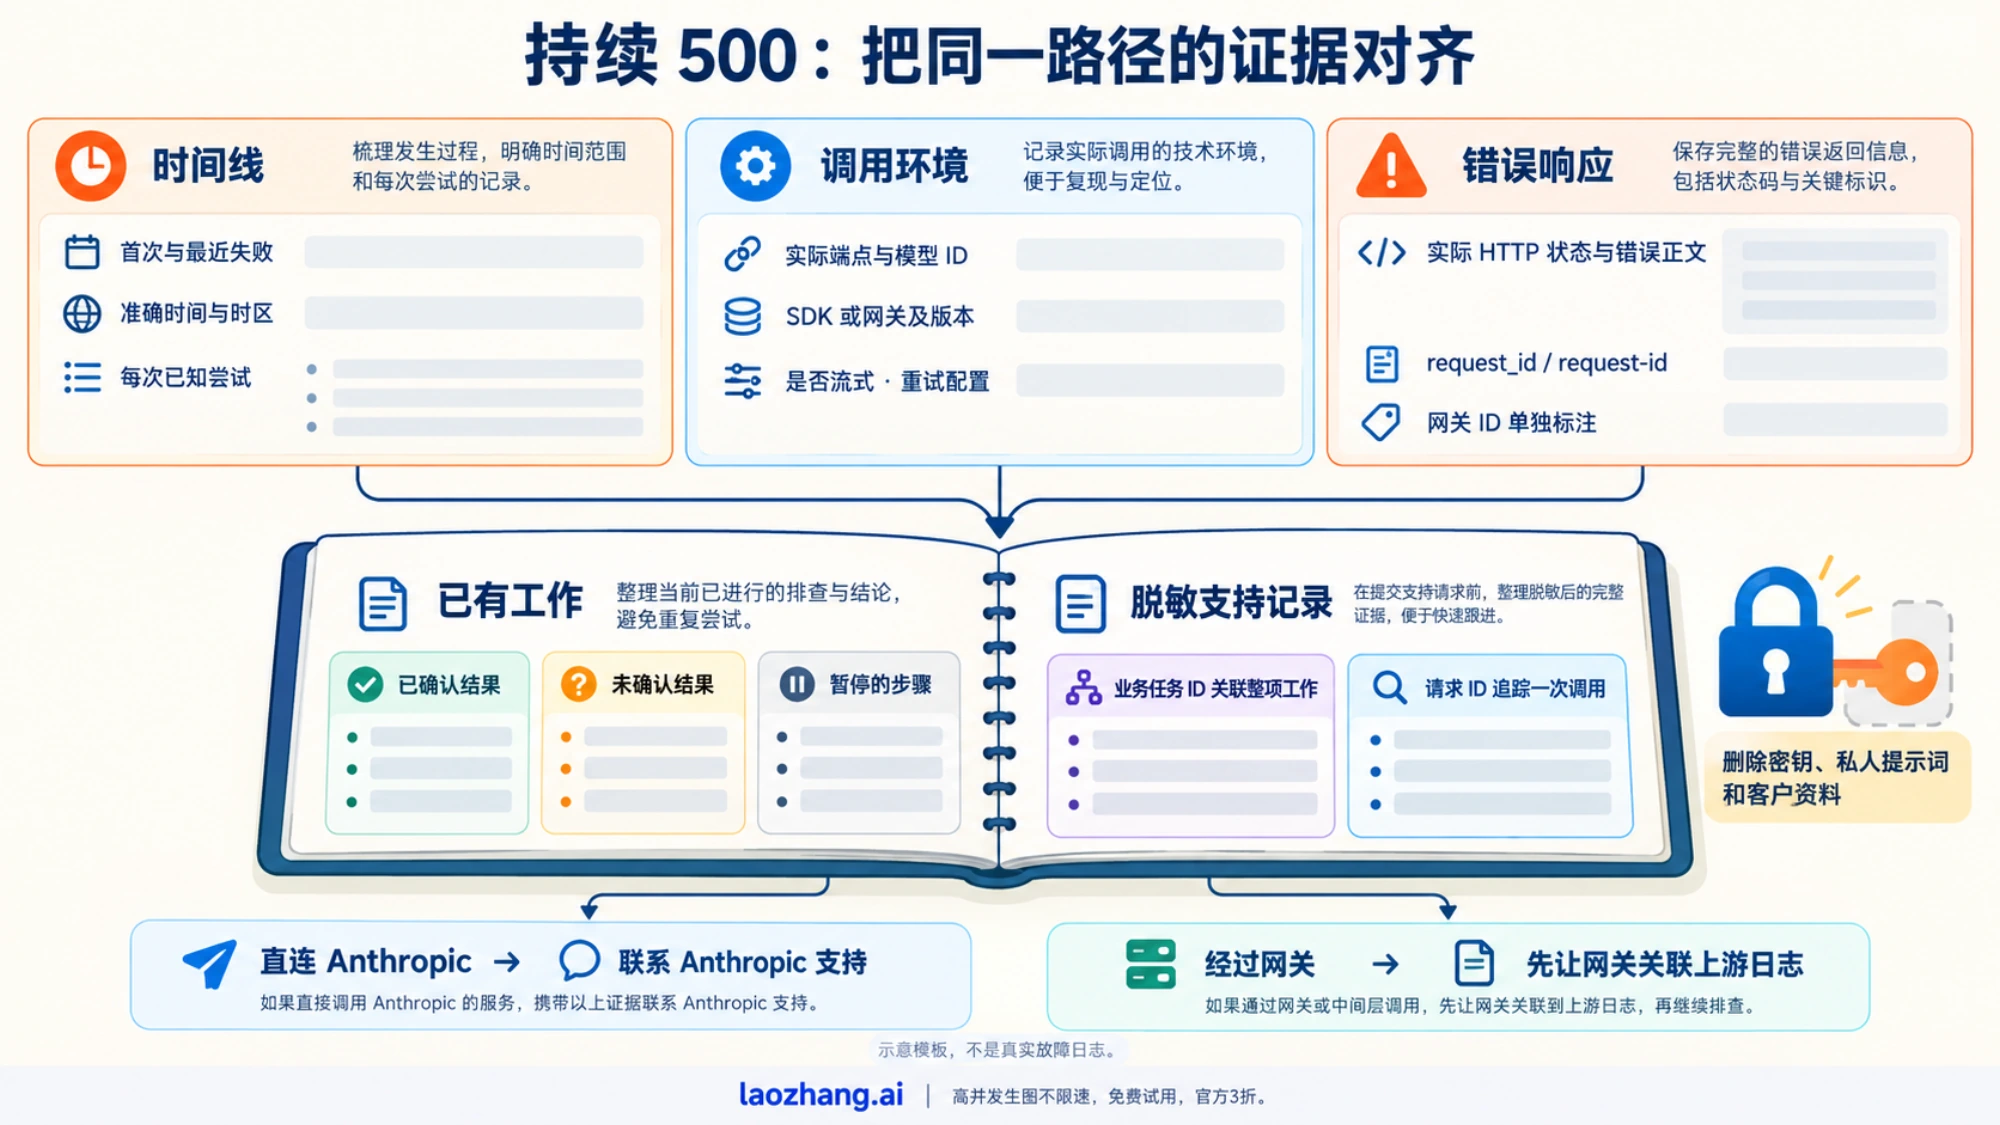
下面是可复制的工单材料模板,不是真实故障日志。已有几次失败就记录几次,不编造请求 ID、状态页结果或恢复时间。
问题与影响:<哪类任务失败,当前是否停止/延期>
首次与最近失败:<准确时间与时区>
实际调用:<直连 Anthropic / 云平台 / 网关;端点及模型 ID>
客户端:<SDK 版本、运行环境、是否流式>
HTTP 状态:<实际值>
错误类型与消息:<error.type;已脱敏的 error.message>
请求标识:<request-id / request_id;网关 ID 单独标注>
尝试记录:<每次时间与结果;哪些次数已知,哪些未知>
重试设置:<SDK、应用、队列、网关各自的配置>
服务状态:<检查时间、相关事件链接;未检查则写未检查>
复现材料:<最小有效请求形状;删除密钥和私人内容>
已完成工作:<已确认结果、尚未确认结果、接下来暂停的步骤>
直连 Anthropic 的 500 api_error,按官方错误页的支持指引附请求 ID 联系 Anthropic。经过网关时,先找能够查看上游日志的服务商,请它关联网关 ID、实际上游状态与上游请求 ID;只有应用侧 500 时,不要假造上游标识。如果客户端没暴露 ID,就说明缺失情况,并提供已经取得的状态、错误、准确时间和版本。
最小复现应当是合法且能代表失败的请求,不能通过删除必需字段把 500 变成 400。若已经保存了失败样本,先用它说明问题;确实需要新对照时,保持模型和请求条件可比较,单独记录改变的变量。工单不要贴 API key、完整私有提示词、客户资料或环境变量全量输出。
常见问题
Claude API 500 是 API key 或余额问题吗?
500 api_error 本身不支持这个判断。Anthropic 将认证、权限、支付及限额错误分别定义;先处理已返回的服务器错误,再依据实际出现的其他状态去排查密钥或账户。见官方错误分类。
500 和 529 都要重试,为什么要分开?
500 是内部意外错误,529 是 API 暂时过载。两者都可以使用有限退避,但 529 还需要重点处理并发压力和集中重发;对应操作见 529 过载排查。不能看到所有 5xx 就认定容量不足。
状态页正常,同一个请求一直 500 怎么办?
停止本轮无限等待,保存已有请求证据和失败时间线。任务仍有价值且可安全重复时延期;没有公开事故也可以联系支持,不需要等满某个固定分钟数才报告。公开组件状态不能代替该请求的实际结果。
SDK 已经重试两次,我还要手动再试两次吗?
不必默认追加。Python SDK的默认设置已经包含额外两次重试。先决定唯一的重试责任方和业务停止条件;需要外层控制时,明确关闭或计入 SDK 重试,而不是把每层次数各算各的。
请求 ID 没有显示,能联系支持吗?
可以说明情况并提供现有证据,但追踪可能更困难。先查已取得的响应头、错误正文及网关日志;仍找不到就记录“未取得”,不要自行生成一个 ID,也不要据此断言服务没有收到请求。
参考来源5
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月5日。
参考来源5
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月5日。
- 1.Anthropic API 错误参考platform.claude.com/docs/zh-CN/api/errors
- 2.Python SDK 文档platform.claude.com/docs/en/api/sdks/python
- 3.Python SDK 当前 main 源码github.com/anthropics/anthropic-sdk-python/blob/main/src/anthropic/_client.py
- 4.SDK main 退避实现github.com/anthropics/anthropic-sdk-python/blob/main/src/anthropic/_base_client.py
- 5.Claude Statusstatus.claude.com