Claude API 529 overloaded_error 怎么解决:重试设置与过载排查
529 overloaded_error 表示 Claude API 暂时过载。先确认实际响应和服务状态,让 SDK 或应用统一负责有限重试,再降低并发、验证完整结果;等待超出业务时限时停止本轮请求,持续失败则带请求 ID 寻求支持。
文章目录
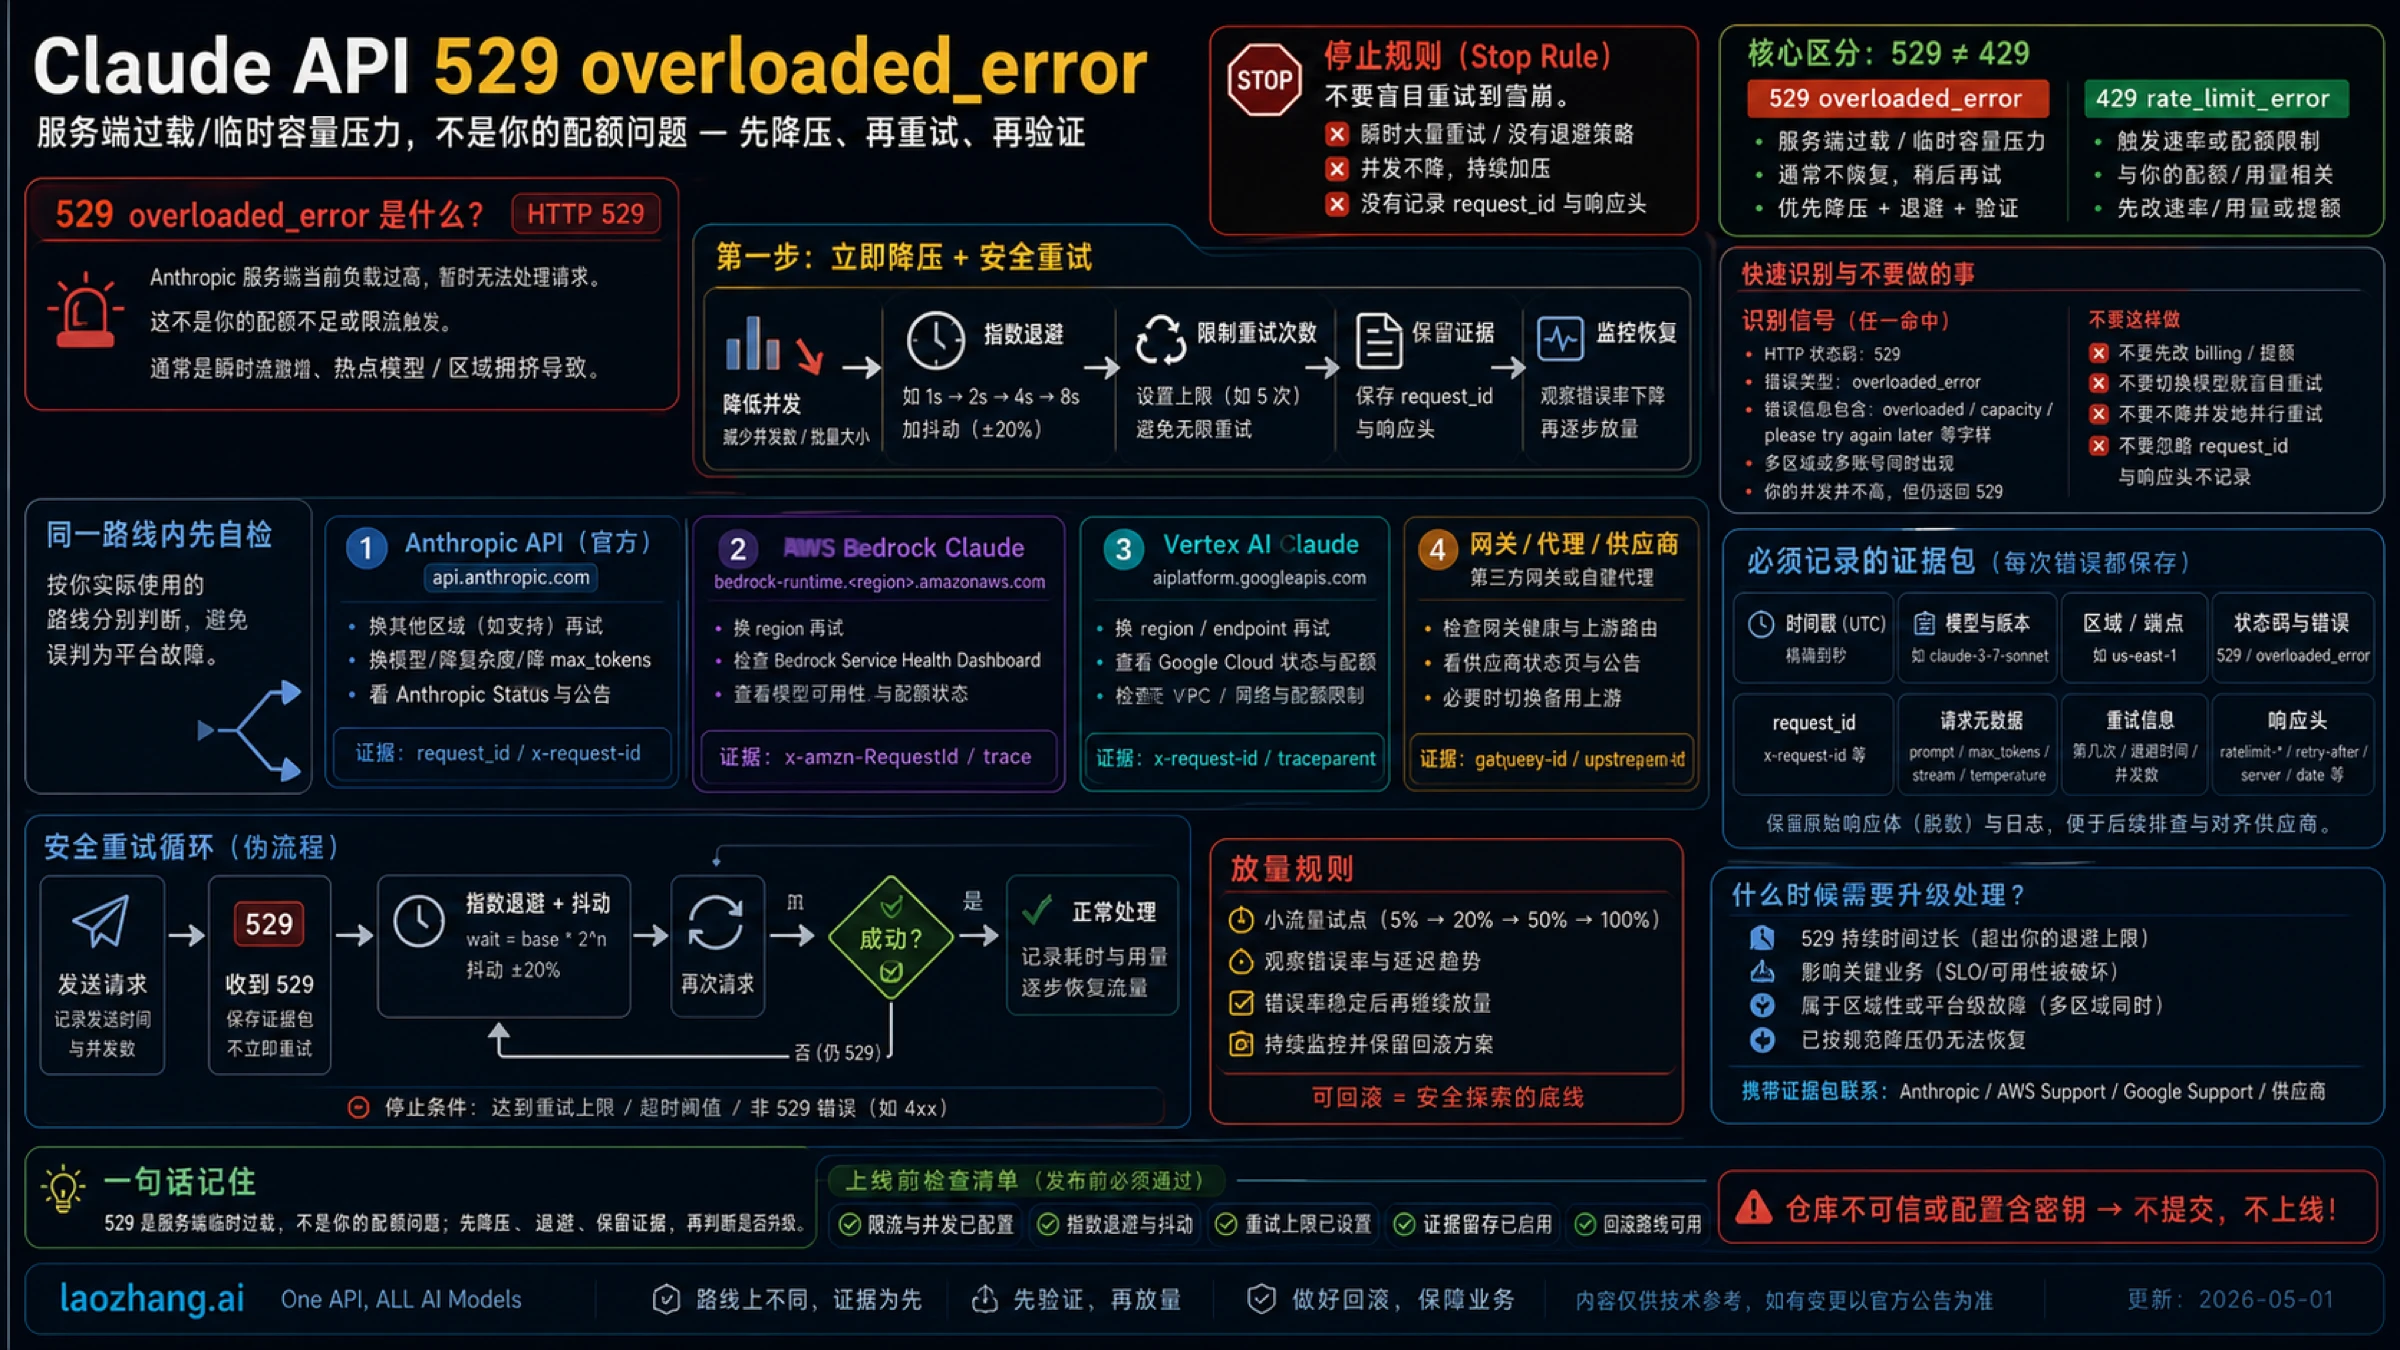
Claude API 返回 529 overloaded_error,表示 API 暂时过载。可用的处理顺序是:保存错误与请求 ID,检查当前服务状态,按已配置的预算退避重试,同时降低自己控制的并发;成功后确认拿到了完整结果,再逐步恢复流量。重试次数或业务等待时间耗尽,就结束本轮调用或把仍有价值的任务延后排队。
先确认你收到的是 HTTP 529 或 API 错误体中的 overloaded_error。一句“发送失败”不能直接定性为过载,529 也不能推导出密钥失效、需要充值或升级套餐。它与 429 rate_limit_error 的恢复条件不同;以上分类来自 Anthropic API 错误参考。
先分清 529、429、超时和连接失败
排查第一步是读实际响应,而不是连续点击重发。日志中优先保存 HTTP 状态、error.type、error.message、发生时间与 request_id;如果经过网关,还要确认这是上游 Anthropic 的响应,还是网关自己返回的错误。
| 实际信号 | 判断与下一步 |
|---|---|
529 overloaded_error | API 暂时过载。查服务状态,退避重试,降低并发;本轮预算耗尽就停止。 |
429 rate_limit_error | 可能是速率限制,也可能是用量等级的月度支出上限或 Claude Code 工作区支出限制。读正文与响应头,按对应恢复条件处理。 |
500 api_error | API 内部发生意外错误。保存请求 ID,按有限退避处理;详见 Claude API 500 排障。 |
504 timeout_error | 服务端处理超时。检查请求时长与已有输出,长请求可考虑流式接口或拆分任务。 |
APIConnectionError、连接被拒绝或重置,未取得 HTTP 响应 | 先查网络、代理、TLS 和实际端点;还不能据此认定 Anthropic 返回了 529。 |
| 只有网页或应用里的泛化报错 | 先按 Claude 网页、Code 与 API 的错误入口分流。 |
表中的 HTTP 分类依据 API 错误参考。尤其是用量等级的支出上限 429:官方说明它没有 retry-after,访问恢复前会继续失败,不能把它当作等几秒就能解除的限流。
随后打开 Claude Status,记录检查时间与相关服务状态。直连 Anthropic 看对应 API 状态,云平台或第三方网关还需看实际服务方。绿色状态是当时的公开信号,不能证明你的模型、请求或网关路径已经恢复;同样,单次 529 也不足以证明所有用户都遇到了故障。
Python SDK 怎样配置 529 重试?
如果应用没有自己的重试调度,可以先让官方 SDK 负责退避,把最终成功或失败交回业务层。若应用、队列或网关已经负责重试,就明确各层次数,避免同一个失败被反复放大。
截至 2026 年 10 月 4 日,Python SDK 文档说明,连接错误、408、409、429 和 5xx 等适用失败默认自动重试 2 次,采用指数退避。这里的“两次”不包含最初调用:一次 SDK 调用最多可产生 3 次 HTTP 尝试;提前成功或不允许重试时会更少。
max_retries 可以在创建客户端时设置,也可以通过 with_options 对单次调用覆盖:
| 你的重试安排 | SDK 设置 | 业务层收到最终失败后 |
|---|---|---|
| 由 SDK 处理短暂失败 | 显式设置 max_retries=2,或选定其他有限次数 | 返回暂不可用,或交给延后队列;不要立刻再套同样的循环。 |
| 应用调度器统一处理次数、等待与任务过期 | max_retries=0 | 调度器决定下一次是否仍值得发起,并遵循服务端等待要求。 |
| SDK、网关、队列都有重试 | 先核对各层配置与日志,再确定负责调度的一层 | 将所有实际尝试计入同一个业务任务,避免每层重新获得完整预算。 |
例如,外层调用 SDK 3 次,每次 SDK 最多重试 2 次,在每次都满足重试条件且没有提前停止的假设下,可能产生 3 × (2 + 1) = 9 次 HTTP 尝试。这是按配置计算的上限示例,不是本次实测流量;网关若再次重试,次数还会变化。
用状态码接住最终 529,并给业务层明确结果
下面是可接入现有项目的函数。前提是已安装官方 Python SDK,并由你的应用准备好 client、可用模型、消息和输出上限;函数不包含凭据配置,也不增加外层重试。
import anthropic


def create_message(client, *, model, messages, max_tokens=1024):
    try:
        message = client.with_options(
            max_retries=2,
            timeout=20.0,
        ).messages.create(
            model=model,
            messages=messages,
            max_tokens=max_tokens,
        )
    except anthropic.APIStatusError as exc:
        if exc.status_code != 529:
            raise
        return {
            "status": "overloaded",
            "request_id": exc.request_id,
        }
    return {
        "status": "completed",
        "message": message,
        "request_id": message._request_id,
    }
返回 completed 时交付完整的非流式消息;返回 overloaded 时结束当前回合,向用户说明暂不可用,或按任务过期时间延后处理。其他 HTTP 错误原样抛出,由对应分支处理;连接错误与 APITimeoutError 也应由调用方单独处理,不能统一标为 529。这个示例已做离线模拟检查,未进行真实 API 调用,也不代表某次过载已经恢复。
这里使用 APIStatusError 加 status_code == 529,而不只捕获 InternalServerError。2026 年 10 月 4 日核对的 Python SDK 主分支源码把 529 映射为 OverloadedError;它与 InternalServerError 分别继承 APIStatusError。这说明主分支当时的实现,不能证明你的已安装版本有同名专用类。部署前应核对实际 SDK 版本;按状态码分支同时符合文档所示接口与该源码快照。
timeout、Retry-After 和业务时限怎样配合?
timeout=20.0 是 SDK 请求超时设置,不能保证整个业务在 20 秒内结束。排队、多次尝试和退避等待都会占用时间,传输中的超时也不等于应用的硬性总截止时间。Python SDK 文档给出的默认请求超时为 10 分钟,并说明超时抛出 APITimeoutError,默认也会重试两次。
因此,前面的函数适合由 SDK 负责有限重试的集成;如果用户等待窗口很短,应改为 max_retries=0,把调度交给理解业务时限的应用。应用需要管理任务进入队列的时间、失效时间、取消和最终结果;仅在调用前检查一次时间,无法在调用过程中强制终止整个任务。
服务端有等待要求时,先判断能不能等,不能把等待时间缩短后提前重试。2026 年 10 月 4 日的 SDK 主分支等待逻辑优先读取 retry-after-ms,再解析 retry-after 的秒数或 HTTP 日期;正值等待时间会被遵循,仅有平台休眠上限,不是统一截断到 60 秒。没有有效正值时才按退避与随机抖动计算等待。这是源码快照,实际发行版与网关行为仍须核对。
如果自己实现调度,至少把这些条件写清楚:
- 尝试次数包含首次请求。 每次失败先判断是否还有机会;已经是最后一次,就立即交付失败结果,不再额外休眠。
- 等待窗口放得进剩余时间才安排下一次。 假设服务端要求等 30 秒,但业务只剩 10 秒,应结束或延后任务,不能等 10 秒就提前再发。
- 下一次调用也需要时间。 剩余时间不能只覆盖休眠,还要留出请求及处理结果的空间;用户取消或任务已过期时停止调度。
- 明确的不重试信号优先。 当前主分支会遵循
x-should-retry: false;该头不保证一定存在。自定义处理应保留实际响应与适用服务方的规则,不能把所有失败都无限循环。
这组规则是应用调度建议。真正需要硬性总时限时,应在应用执行与取消机制中落实,并核对网关的等待、超时及上游重试;本例没有实现或验证这类硬总时限。
连续 529 时,怎样降低压力并恢复流量?
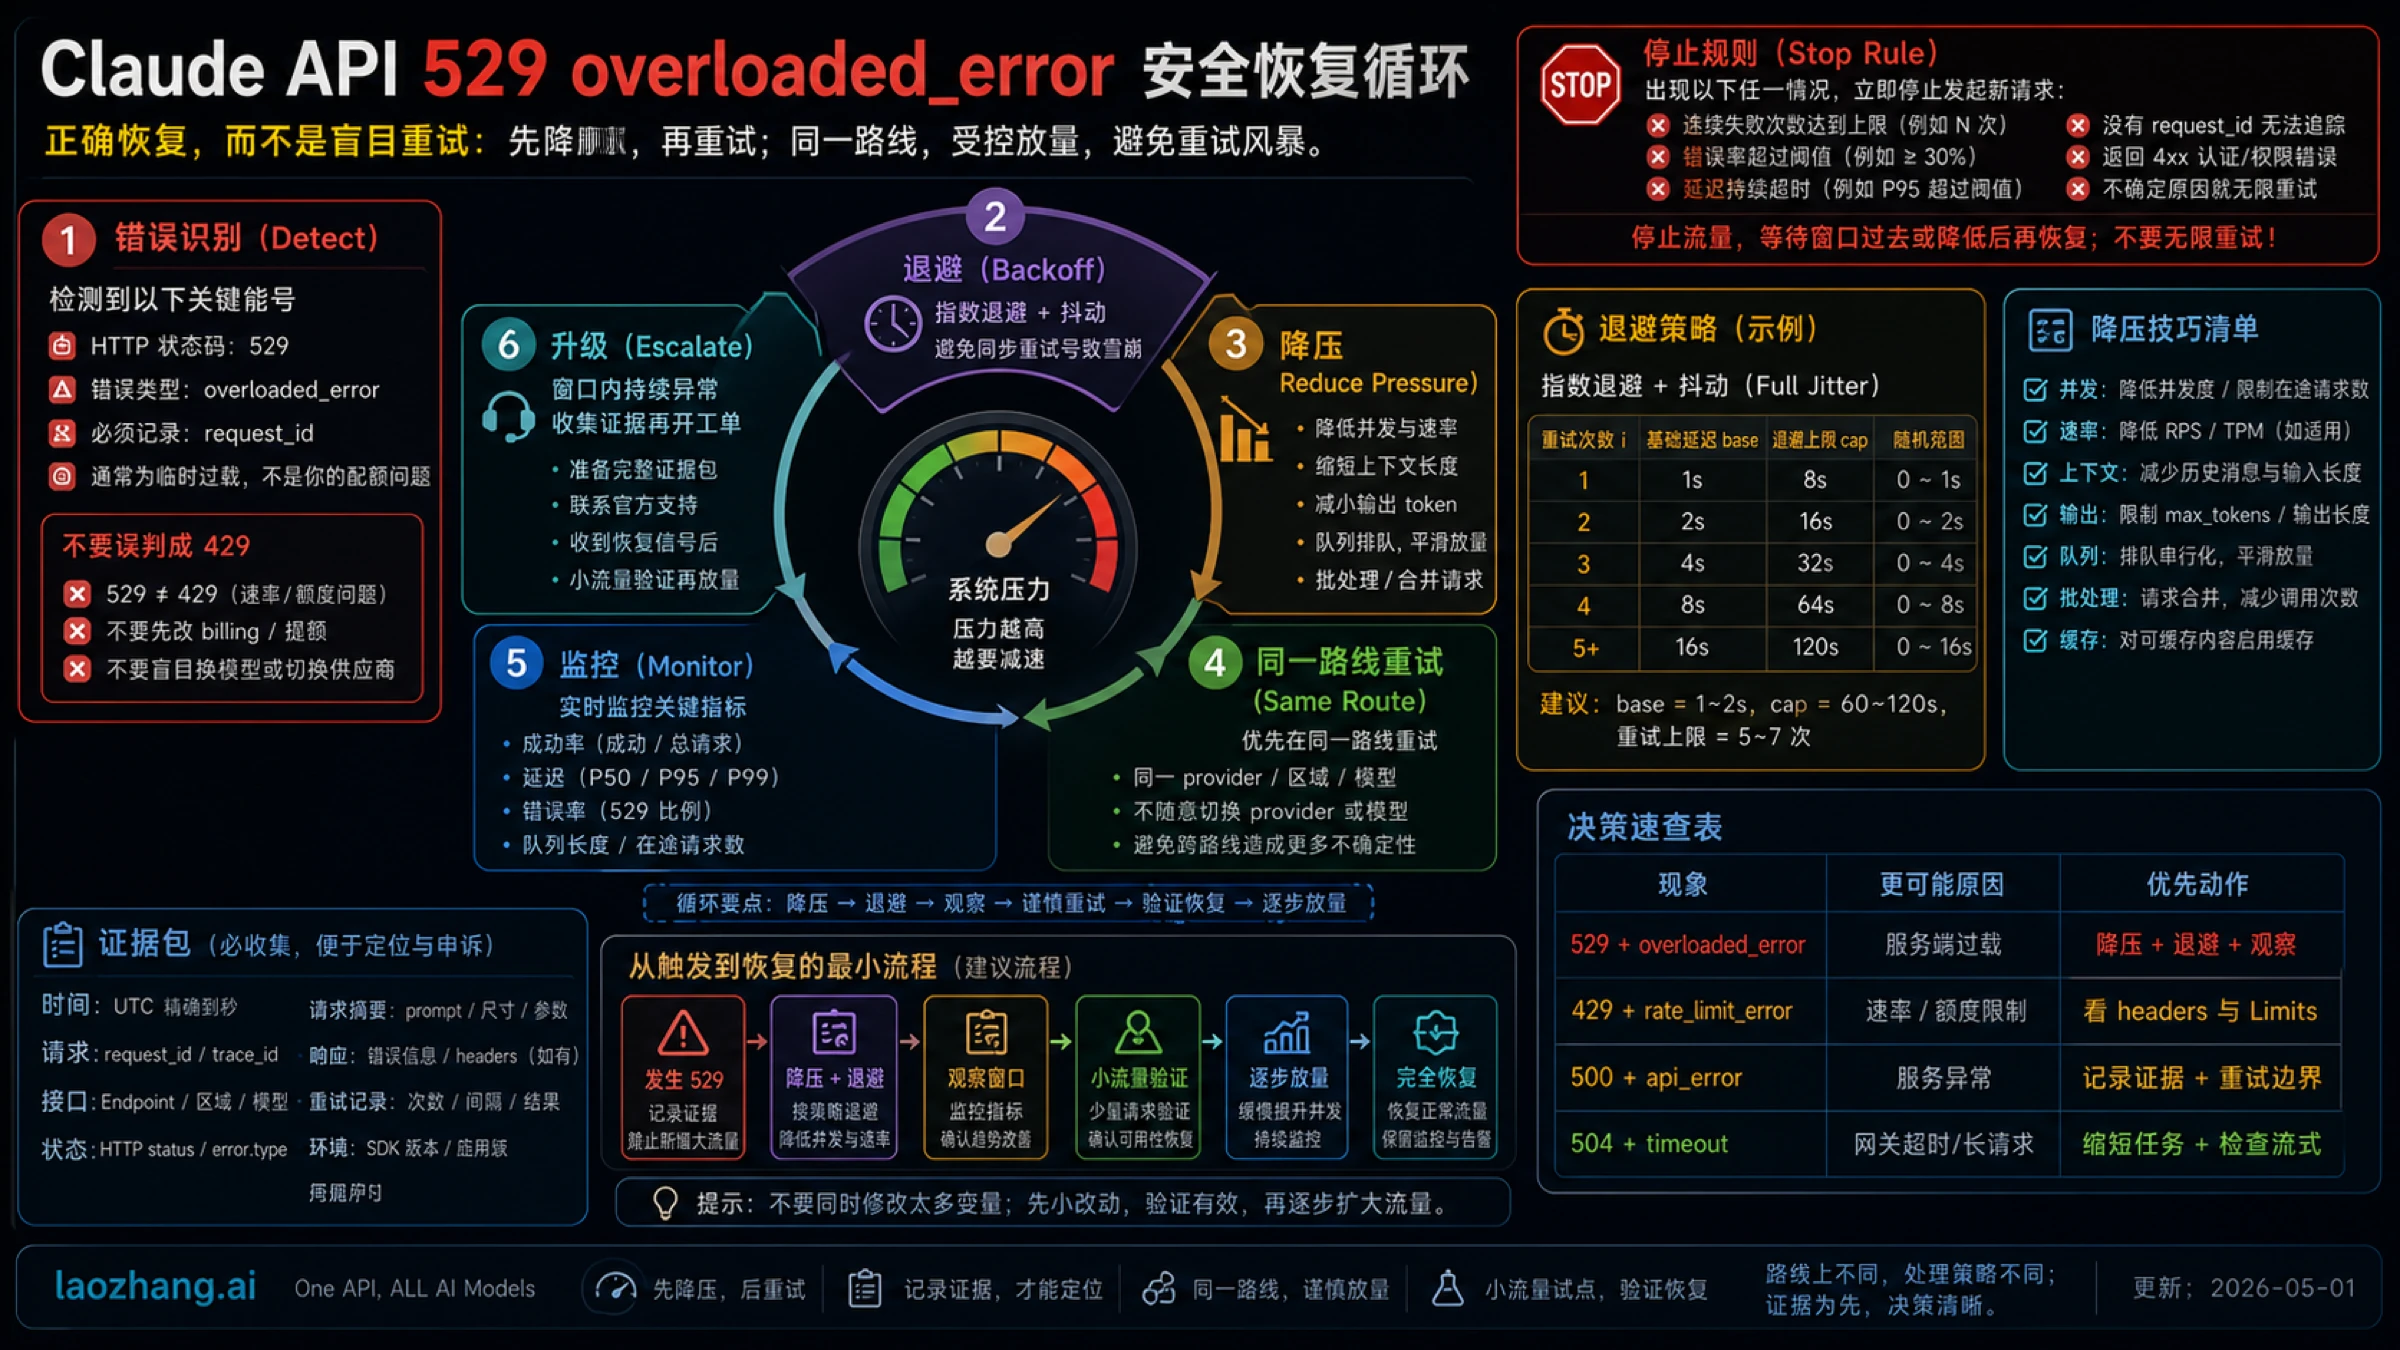
先减少同时在途的请求,暂停非紧急批处理,让队列承接仍有价值的工作。并发限制应覆盖重试请求,否则原始流量降下来了,重试仍可能持续占满连接。队列也要有容量和过期处理:不能把已失去价值的聊天回合一直积压到服务恢复后再发送。
没有有效服务端等待提示时,采用有上限的指数退避并加入随机抖动,避免大量客户端固定间隔同时重发。退避不是恢复保证;它的用途是减少失败期间的额外压力。具体次数、间隔与熔断阈值由业务等待能力决定,没有适用于所有场景的“安全重试五次”。
当一个观察窗口内持续出现 529,可以暂时停止向失败路径发送非必要请求,让少量探测请求判断恢复情况。恢复后逐步提高并发,观察完整成功率、529 比例、耗时和队列长度;再次恶化就暂停放量。此处是基于临时失败机制的生产控制建议,不能据此声称测得了某个恢复率或延迟改善。
更换模型或服务方可以是业务降级方案,但需先确认目标模型可用,任务、工具、输出格式与数据处理要求兼容,且能接受结果和成本变化。另一把 key 不代表独立容量;换路径成功也不能证明原路径恢复。若缩短输入或降低 max_tokens,应确保仍能完成原任务,而不是只拿到一段更短的残缺答案。
怎样确认恢复?流式 HTTP 200 还不够
先用少量请求验证原先失败的模型、端点、鉴权方式和网关路径。保持请求形状可比,观察是否完成生成、耗时是否可接受,以及队列是否开始消退。一次成功只能证明那一次请求成功,不足以支持立即恢复全部批处理。
如果要比较不同路径,记录这次只改变了哪个条件。自建代理还应分别记录排队时间、上游等待和下游响应:网关排队或连接池拥塞可能与上游 529 同时存在,不能将两段时间混成一次“Anthropic 故障”。
流式调用需要等完整响应结束再判断成功。API 错误参考明确说明,SSE 流可能在 HTTP 200 之后报错;只检查初始 HTTP 状态会漏掉生成中途的失败。保存已收到的完整内容块和工具结果,先核对是否已有业务动作完成,再决定重发还是处理剩余工作。不要把两次生成的片段直接拼成一个完整答案,也不要把重新发起请求称为自动断点续传。
若你是在 Claude Code 终端看到 529 或“响应可能不完整”,请转到 Claude Code 中断后的原会话恢复与已完成工作核对。终端自身的自动重试与会话恢复规则,不能直接套用到你编写的 SDK 调用上。
仍然返回 529,给支持方哪些材料?
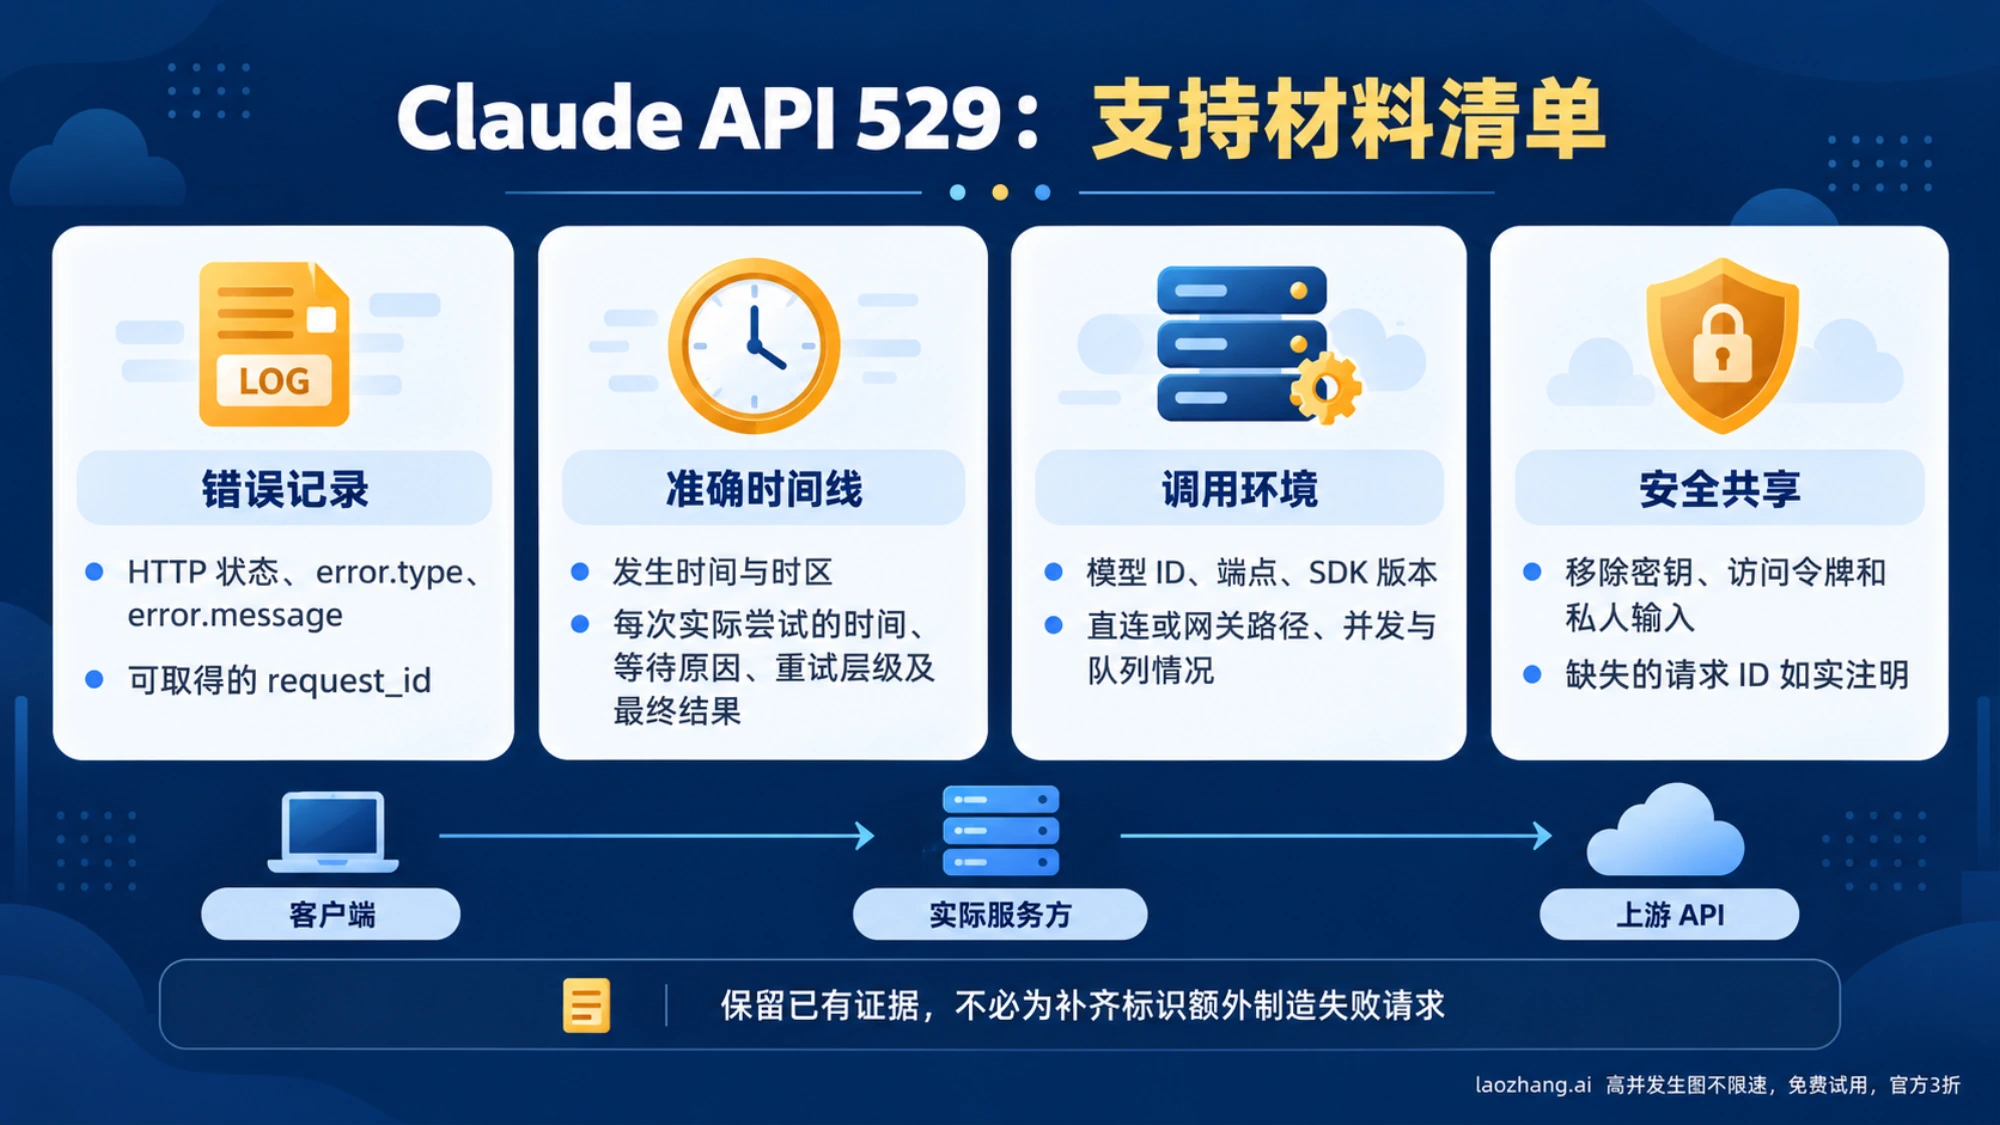
同一路径在有限重试、等待和降压后仍失败,或故障影响重要业务,就保留已有证据并联系对应服务方。直连调用提供 Anthropic 请求 ID;云平台或网关调用先由对应支持方确认失败的一跳。缺少某个 ID 时如实注明,继续提供已取得的错误与时间线,不需要为了“凑完整”再制造大量失败请求。
一份可用的记录包括:
- 错误 HTTP 状态、
error.type、error.message和可取得的request_id。 - 发生时间与时区、模型 ID、端点、SDK 版本、直连或网关路径。
- 每次实际尝试的时间、等待原因、重试层级和最终结果。
- 当时并发、队列长度、请求大小级别、流式或非流式方式,以及有没有收到完整结果。
- 状态页检查时间、相关事件与业务影响;附脱敏后的最小请求结构。
官方请求 ID 说明指出,错误正文的 request_id 与响应头 request-id 用于定位请求,Python 成功响应提供 _request_id。不同尝试的请求 ID 可能不同,可用自己的业务任务 ID 把它们串起来;网关也可能改写或省略字段。共享材料时移除密钥、访问令牌和私人输入。
常见问题
HTTP 529 是个人额度用完了吗?
在直接 Anthropic API 中,529 表示暂时过载,不是个人额度耗尽的定义。429 才可能涉及速率限制或某些支出上限,具体要看错误正文与适用账户条件。分类见 API 错误参考;第三方服务返回的文字还需由该服务方解释。
SDK 默认重试两次,为什么程序仍然请求了很多次?
检查外层循环、任务队列和网关。SDK 的两次重试不含首次调用;外层每重新调用一次 SDK,都可能再获得该次调用的重试次数。应记录实际尝试,并明确由哪一层统一控制任务预算。默认值与配置方式见 Python SDK 文档。
timeout 设为 20 秒,能保证 20 秒内返回吗?
不能据此保证整个业务的耗时。SDK 的请求超时不包含全部排队和退避预算,适用超时还可能自动重试。需要总时限时由应用管理过期与取消,不要只设置 timeout。该参数与默认超时重试见 Python SDK 文档。
状态页正常,但我的请求一直 529,怎么办?
记录当时状态,按原模型和路径做有限验证,并检查网关与调用方的并发和重试配置。等待或次数耗尽后停止本轮任务;持续失败时用实际错误和请求 ID 寻求支持。绿色状态不能替代请求完成结果。
开启 streaming 能解决 529 吗?
不能保证。流式接口可帮助处理长请求,但不会凭空增加服务端容量,而且可能在 HTTP 200 后失败。应确认完整生成结束,再决定交付、重发或核对已有动作;这一边界见 API 错误参考。
参考来源5
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月5日。
参考来源5
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月5日。
- 1.Anthropic API 错误参考platform.claude.com/docs/en/api/errors
- 2.Claude Statusstatus.claude.com
- 3.Python SDK 文档platform.claude.com/docs/en/api/sdks/python
- 4.Python SDK 主分支源码github.com/anthropics/anthropic-sdk-python/blob/main/src/anthropic/_client.py
- 5.SDK 主分支等待逻辑github.com/anthropics/anthropic-sdk-python/blob/main/src/anthropic/_base_client.py