Qwen 4 Max vs Opus 5.5: сравнение на 12 задачах, цена и ожидание
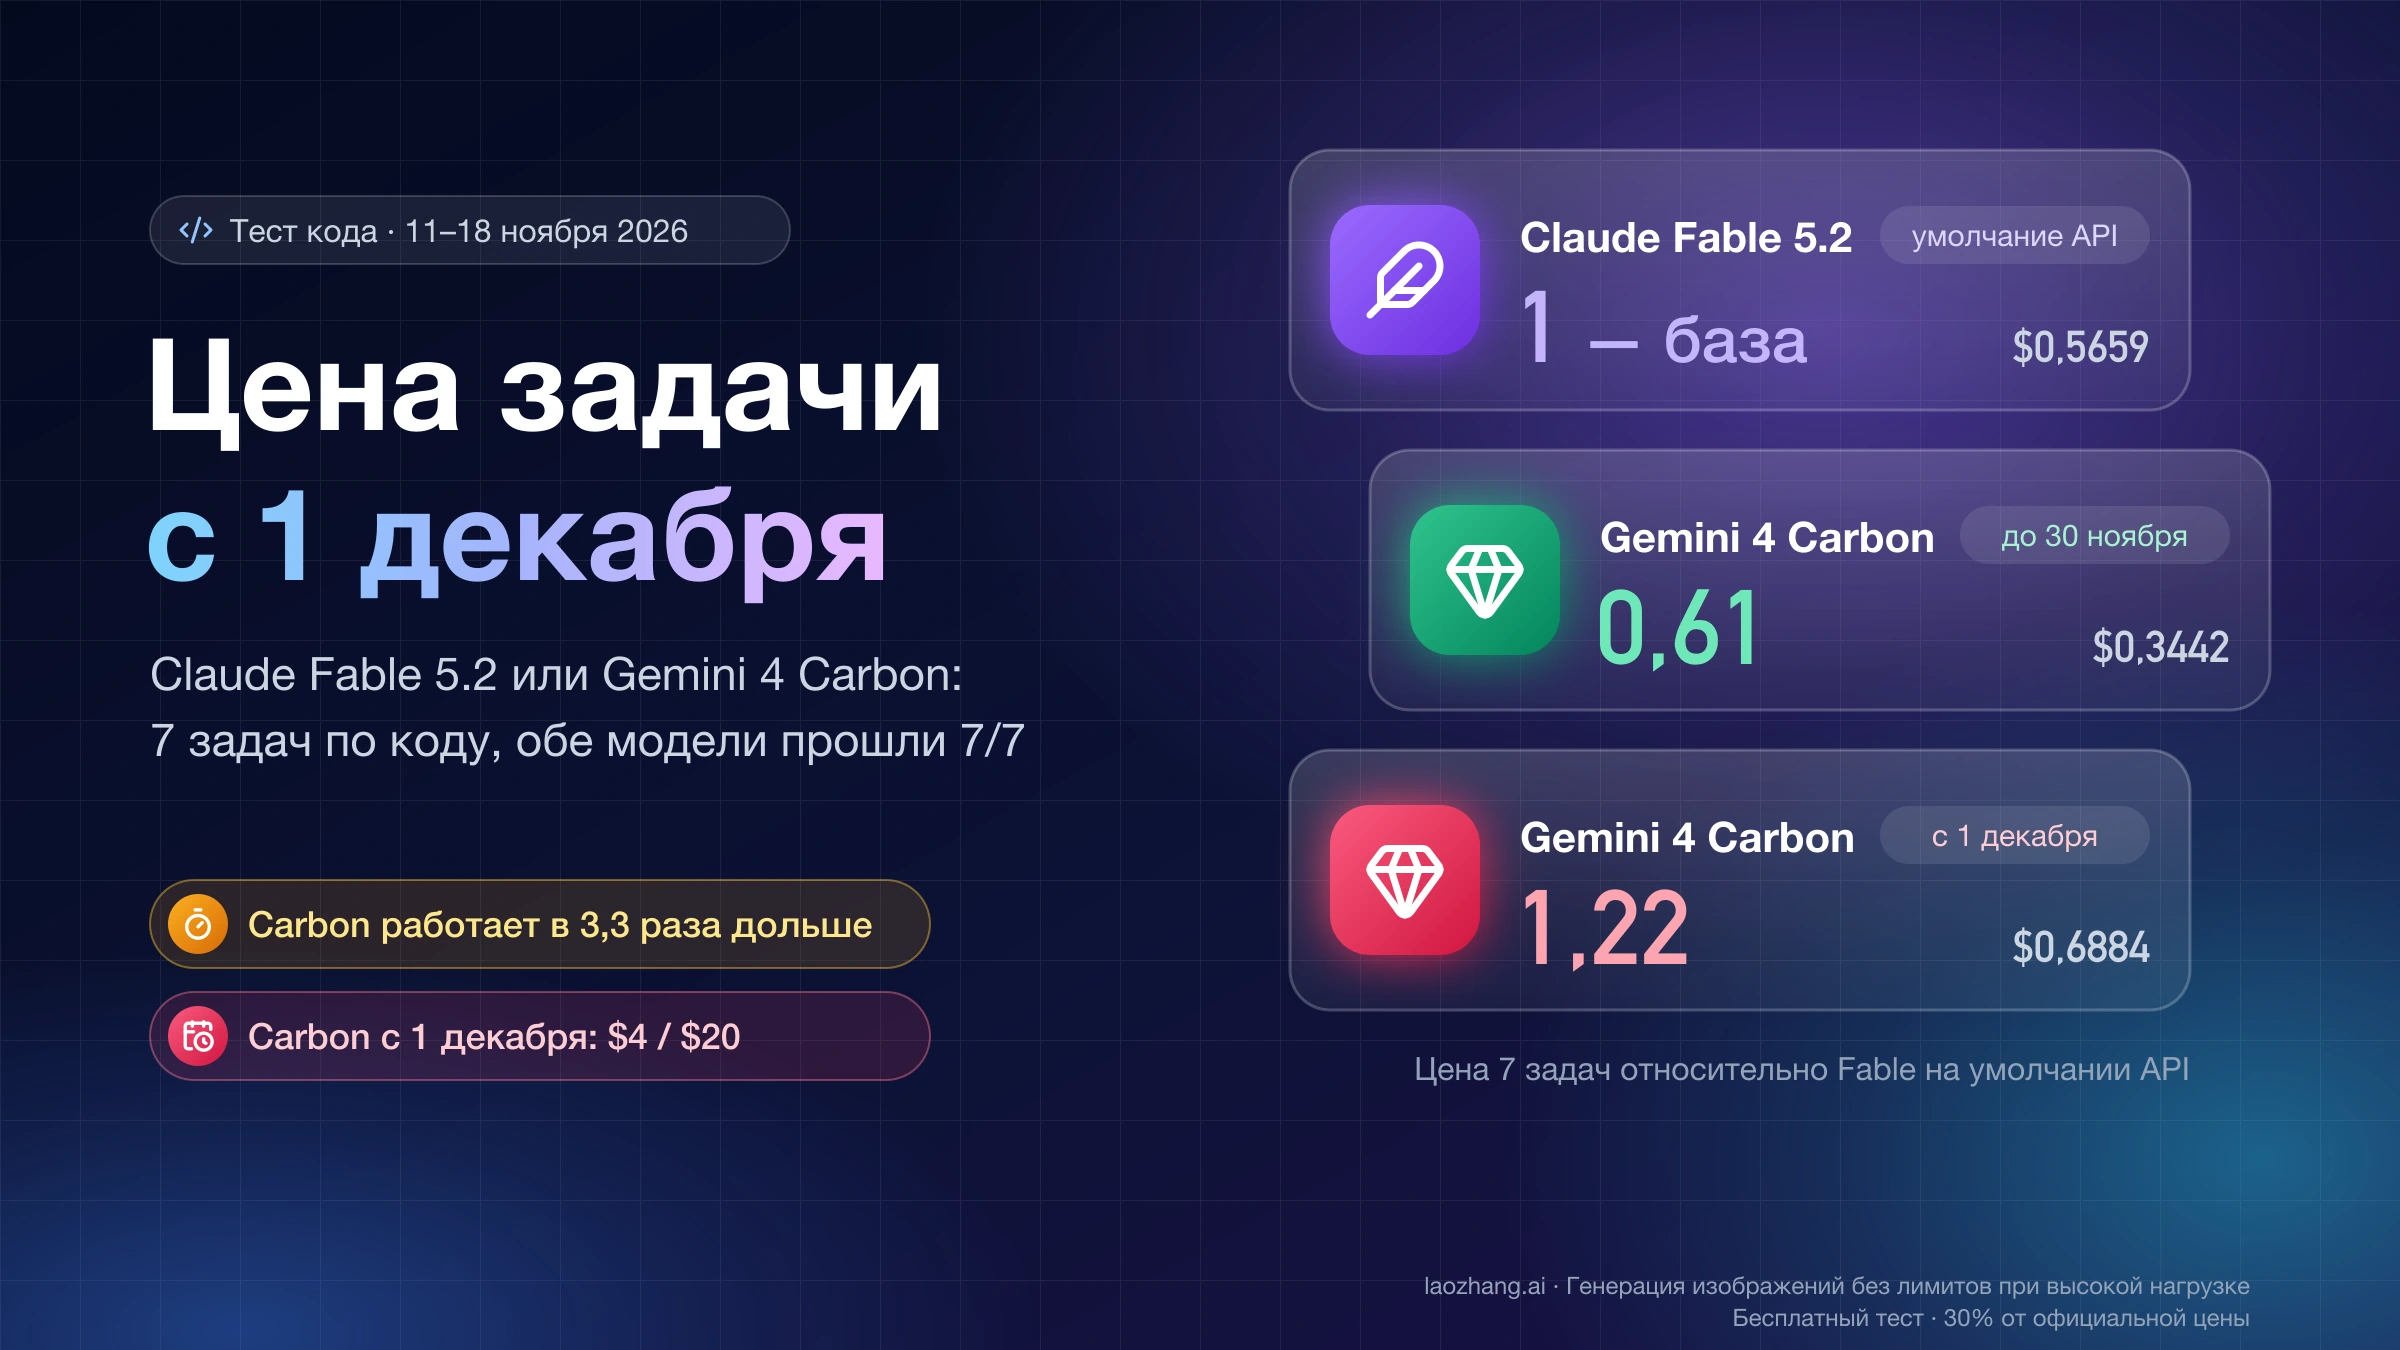
Qwen4-Max решил 12 задач теста 18 ноября 2026 года в 3,4 раза дешевле Opus 5.5 medium, но вчетверо дольше; у Artificial Analysis его задача дороже Opus medium.
Содержание
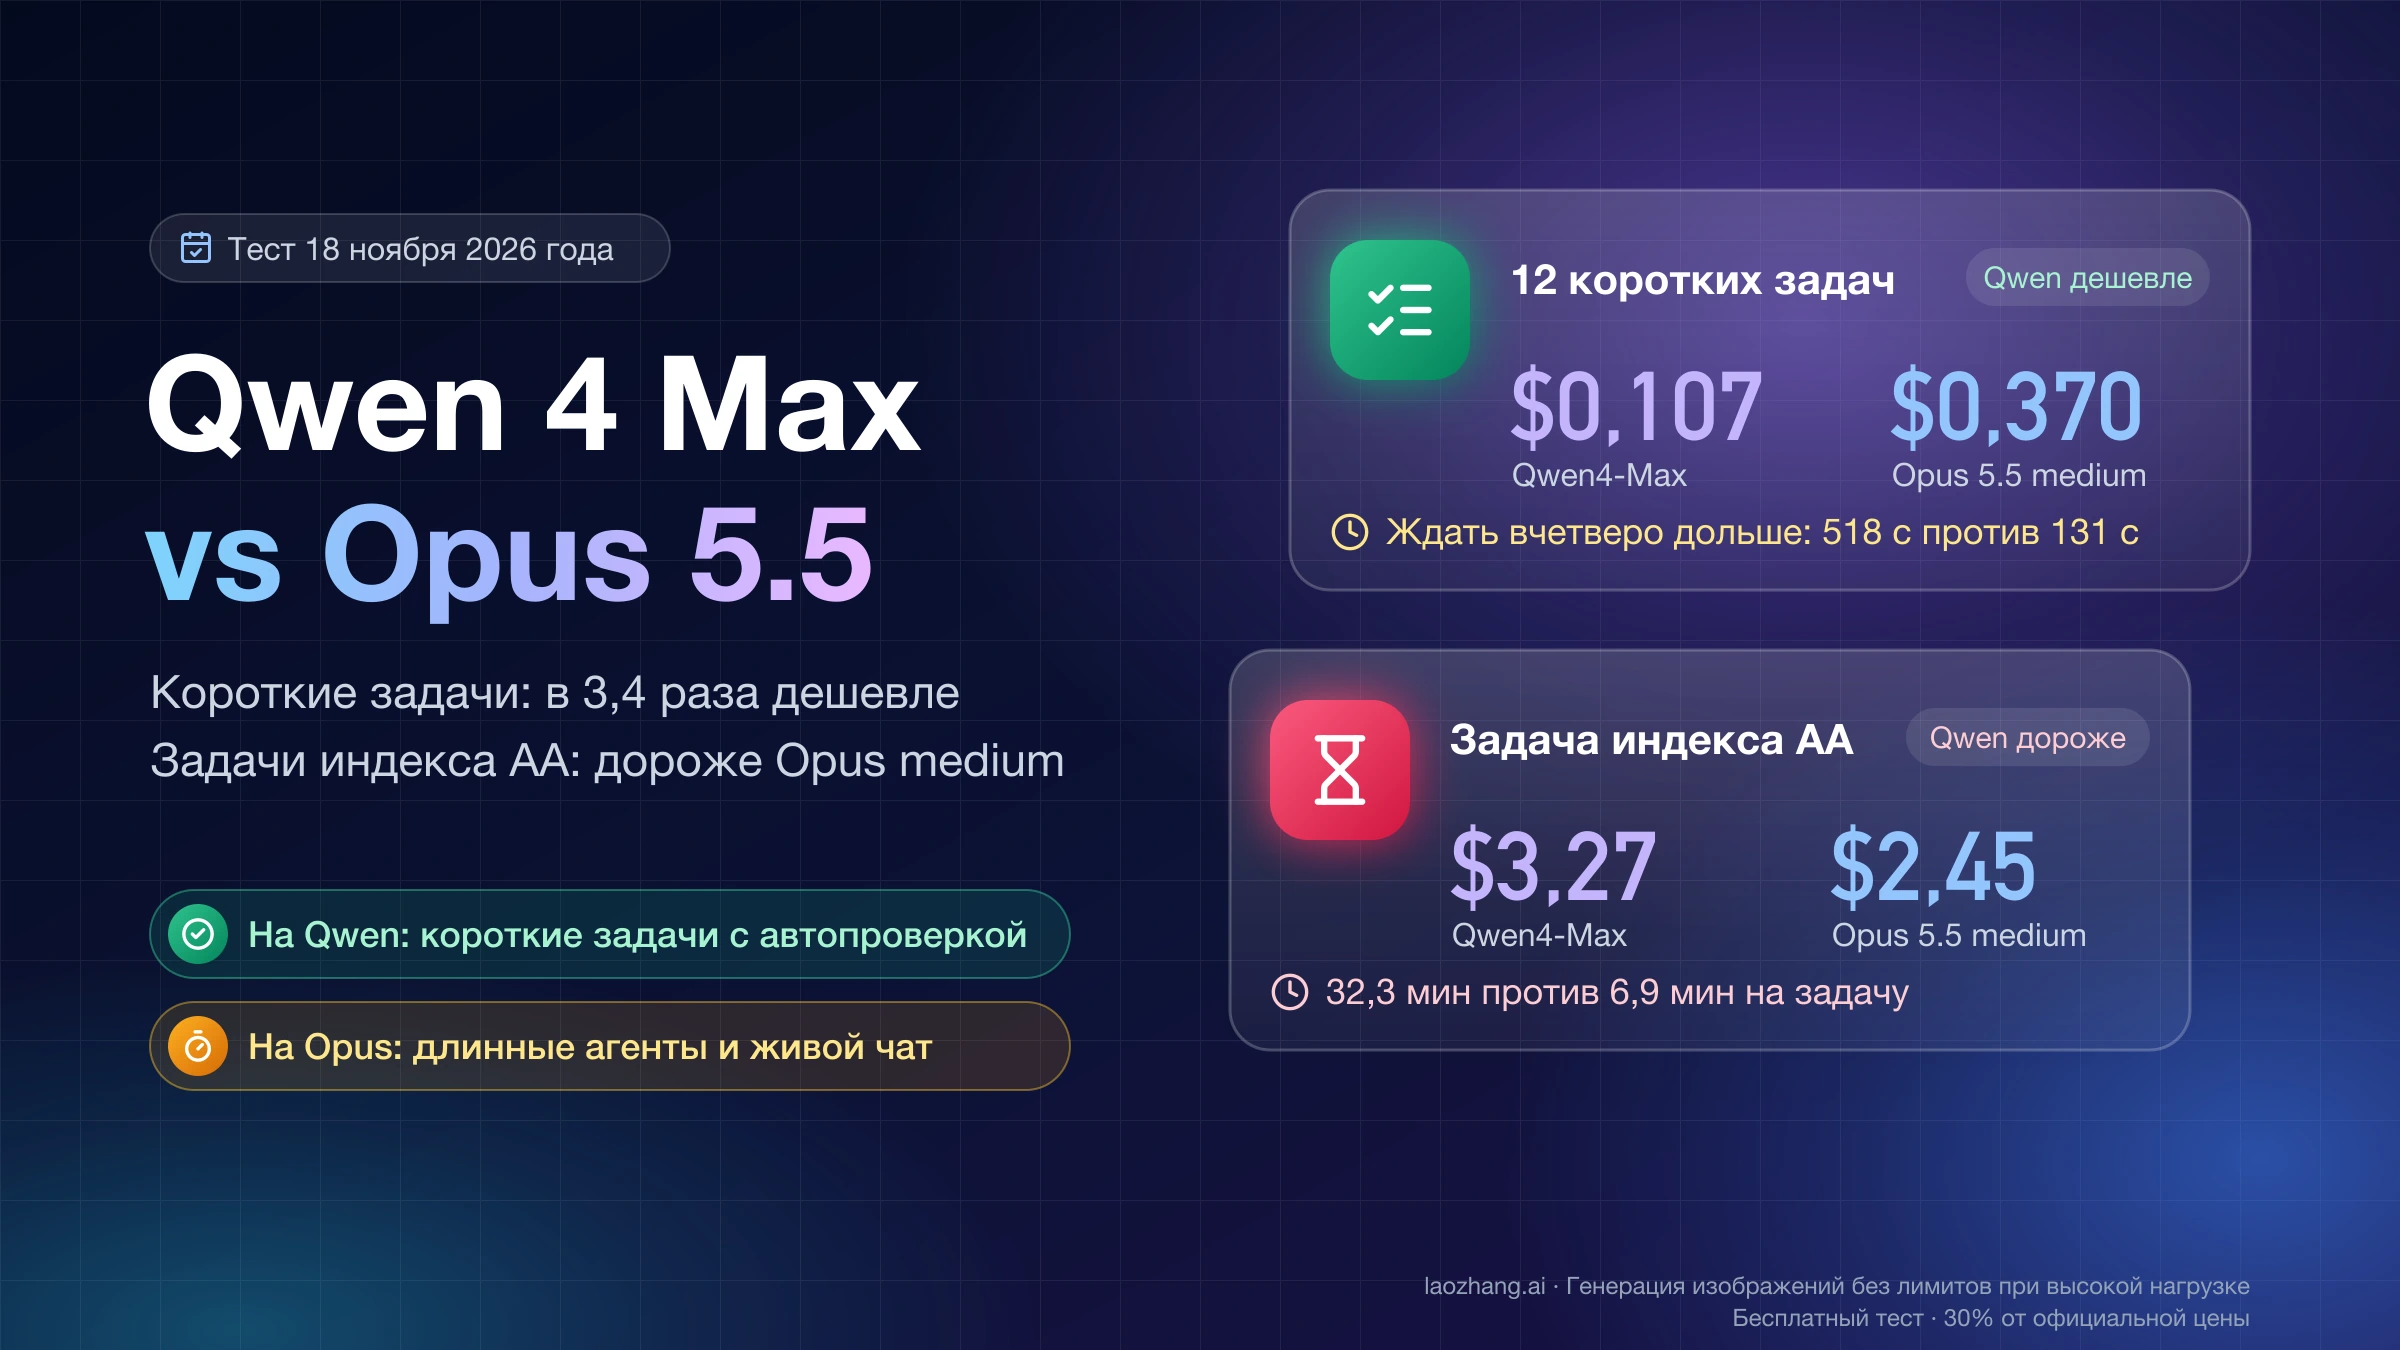
Если вы платите за Claude Opus 5.5 по токенам и присматриваетесь к вышедшему 16 ноября 2026 года Qwen4-Max (qwen4-max, в поиске его чаще пишут как Qwen 4 Max), переводите на него короткие, чётко поставленные запросы, которые проверяются автоматически и могут подождать: пакетную обработку, извлечение данных, небольшие функции с тестами, сводки документов. Длинные агентные задачи, трудные рассуждения и интерактивную работу, где человек сидит и ждёт ответа, оставьте на claude-opus-5-5 с уровнем medium. В тесте 18 ноября 2026 года на 12 одинаковых задачах обе модели решили всё, но Qwen4-Max с настройками по умолчанию обошёлся в 3,4 раза дешевле Opus 5.5 medium ($0,107 против $0,370 по прайсу), а ответов пришлось ждать вчетверо дольше: 518 секунд против 131 на весь набор.
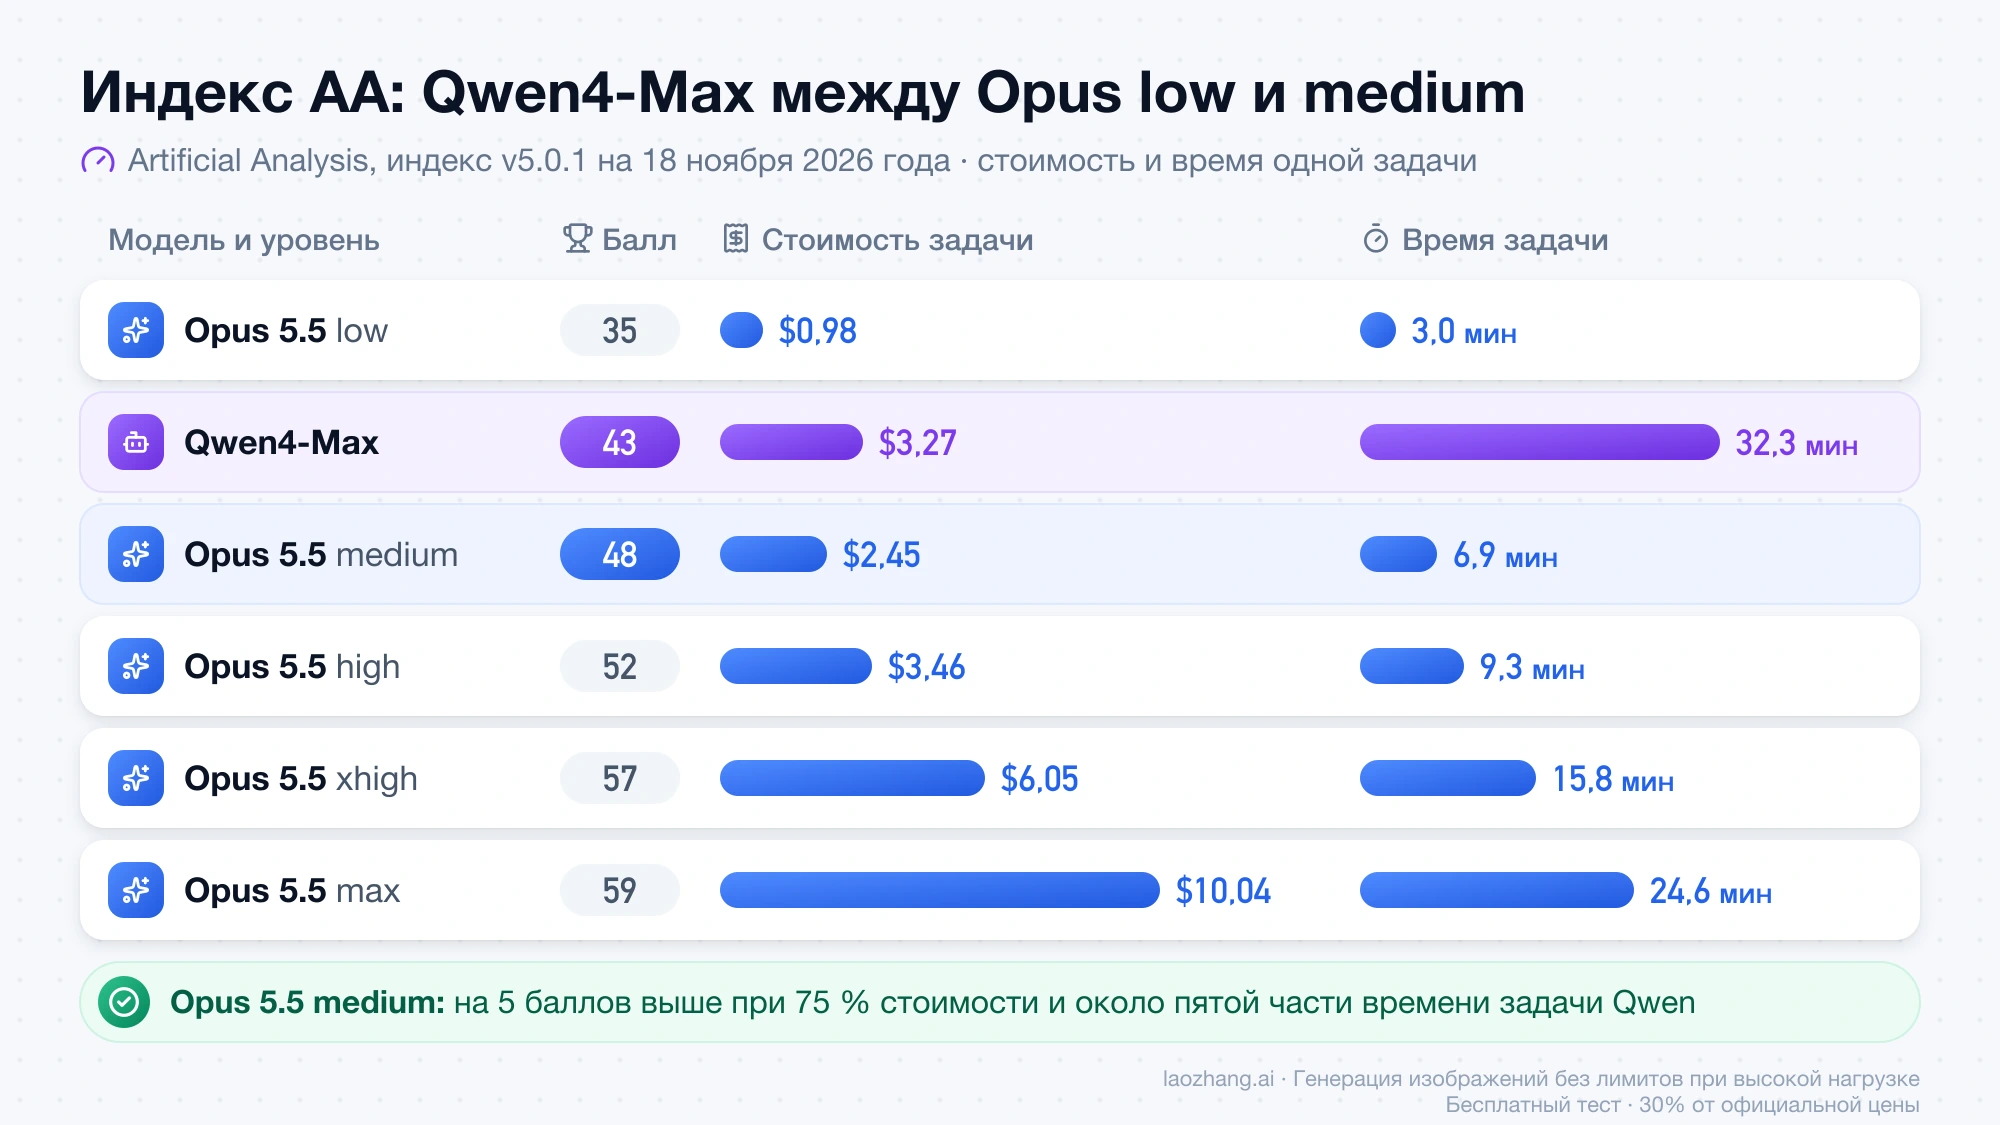
Расхожее «Qwen в 3 раза дешевле» верно за токен и на коротких задачах, но не на наборе длинных и трудных задач Artificial Analysis. Qwen4-Max по умолчанию размышляет на уровне high, и Alibaba берёт за токены размышлений как за вывод. На наборе Artificial Analysis Intelligence Index v5.0.1 (по состоянию на 18 ноября 2026 года) задача на Qwen4-Max стоит $3,27 и идёт 32,3 минуты при индексе 43, а Opus 5.5 medium набирает 48 баллов за $2,45 и 6,9 минуты: дешевле, быстрее и выше одновременно.
Если переходите, сразу ограничьте размышления Qwen параметром enable_thinking: false или thinking_budget: уровень low в тесте не сэкономил ничего. Учтите и доступ: Россия не входит в список стран, где Anthropic разрешает пользоваться Claude, включая облака и реселлеров, а Qwen4-Max продаётся через Alibaba Cloud Model Studio (International) и OpenRouter. Проходит ли там оплата из России, тест не проверял.
Что переводить на Qwen 4 Max, а что оставить на Opus 5.5
Решает не «какая модель умнее», а длина задачи и то, ждёт ли ответа человек. На коротких задачах с понятной проверкой Qwen4-Max даёт тот же результат за треть цены, на длинных и трудных задачах индекса Artificial Analysis его размышления съедают разницу в цене за токен, а в интерактивной работе мешает время до первого слова ответа. Таблица — стартовая точка на 18 ноября 2026 года; основания для каждой строки разобраны в следующих разделах.
| Тип работы | С чего начать | Почему |
|---|---|---|
| Короткие запросы с автоматической проверкой: функции с тестами, извлечение полей, классификация, сводки | Qwen4-Max с ограниченными размышлениями | В тесте 12 задач тот же результат за 0,29 стоимости Opus 5.5 medium |
| Разбор логов и документов без спешки, где ответ может подождать минуты | Qwen4-Max | На логе 146 КБ — 0,40 стоимости Opus medium, но почти 6 минут вместо минуты |
| Чат, правки кода в IDE, агент, за которым следит человек | Opus 5.5 medium | В тесте около 11 секунд на задачу против 43 у Qwen |
| Длинные агентные цепочки, терминал, трудный код и научные задачи | Opus 5.5 medium или high | У Artificial Analysis Opus medium дешевле за задачу, в 4,7 раза быстрее и выше по индексу (48 против 43); в стороннем агентном тесте он дороже Qwen, но в 6 раз быстрее |
| Автоматизация рабочих процессов, финансовые и операционные задачи | Проверить Qwen4-Max на своих данных | В AutomationBench-AA выше всех уровней Opus, в AA-Briefcase и финансовом индексе AA выше Opus medium |
| Видео во входных данных | Qwen4-Max | Opus 5.5 принимает только текст и изображения |
Opus 5.5 на уровне low формально ещё дешевле: у Artificial Analysis $0,98 за задачу и 3 минуты, но всего 35 баллов, ниже Qwen4-Max. Если цель — снизить счёт, не уходя от Claude, сравните сначала младшую модель той же линейки: разбор есть в статье «Claude Sonnet 5.5 или Opus 5.5: разница, цена задачи и выбор». Другой китайский флагман против Opus 5.5 с тем же вопросом «за токен или за задачу» разобран в «Сравнение Kimi K3.1 Pro и Opus 5.5: вдвое дешевле лишь за токен».
Тест на 12 задачах: Qwen в 3,4 раза дешевле и вчетверо медленнее
18 ноября 2026 года Qwen4-Max прогнали через API-шлюз laozhang.ai (Chat Completions с потоковой выдачей) на 12 однотуровых задачах со скрытыми тестами или точными ответами: текстовая задача, слияние интервалов, разбор длительности, частотный подсчёт слов, сводка документа примерно на 11 тысяч токенов в пять пунктов, вычислитель выражений, разбор строки CSV, рассуждение о сумме цифр, сравнение и диапазоны версий semver, арифметика по заметкам и задача только на стандартной библиотеке. Qwen запускался в двух вариантах: по умолчанию (уровень high) и с reasoning_effort: "low". Строки Opus 5.5 medium и high взяты из прогонов тех же задач с теми же проверками: восемь задач — 11 ноября 2026 года, четыре — 18 ноября. Те же 12 задач и те же цифры Opus использованы в сравнении «GPT-6.2 Sol vs 6.1 Sol vs Opus 5.5: тест 12 задач и что выбрать».
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
| Конфигурация | Решено | Выходных токенов (из них размышления) | Суммарное время вызовов | Стоимость по прайсу |
|---|---|---|---|---|
| Qwen4-Max по умолчанию (high) | 12 из 12 | 15 915 (10 465) | 518,2 с | $0,1074 |
Qwen4-Max low | 12 из 12 | 16 924 (11 237) | 567,3 с | $0,1119 |
| Opus 5.5 medium | 12 из 12 | 11 833 (не сообщается) | 130,5 с | $0,3698 |
| Opus 5.5 high | 12 из 12 | 13 674 (не сообщается) | 159,3 с | $0,4067 |
Раз все четыре конфигурации решили всё, тест сравнивает не способности, а стоимость, расход токенов и ожидание на задачах, которые обе модели заведомо тянут. Qwen4-Max потратил на треть больше выходных токенов, чем Opus medium (15 915 против 11 833), и две трети из них ушли на размышления. Но выходной токен у него в 4,4 раза дешевле ($4,50 против $20 за 1 млн), поэтому весь набор обошёлся в 3,44 раза дешевле, чем на Opus medium, и в 3,79 раза дешевле, чем на Opus high. В пересчёте на 1 000 прогонов такого набора это около $107 на Qwen4-Max и $370 на Opus medium.
Как считается одна строка, видно на сводке документа: 10 931 входной токен × $1,50 / 1 млн + 820 выходных × $4,50 / 1 млн ≈ $0,0201 у Qwen4-Max против $0,0907 у Opus medium на том же документе. Самая «разговорчивая» задача, диапазоны semver, потребовала от Qwen 5 317 выходных токенов и 113,9 секунды против 2 503 токенов и 22,6 секунды у Opus medium, и даже там Qwen вышел вдвое дешевле: $0,0246 против $0,0528.
Ожидание — обратная сторона. В среднем задача шла на Qwen4-Max 43 секунды, на Opus medium — 11, и около 444 из 518 секунд у Qwen ушли на время до первого слова ответа, то есть на размышления. Время здесь — полное время вызова через шлюз: Qwen обслуживался через канал в материковом Китае, строки Opus сняты в другие дни и частично без потоковой выдачи, поэтому кратность 4 — ориентир, а не замер задержки самой модели. Независимые цифры Artificial Analysis указывают в ту же сторону: 54 токена в секунду у Qwen4-Max против 105–117 у Opus 5.5 и 148,6 секунды до первого токена ответа на их наборе.
Уровень low на этом наборе не дал экономии: стоимость 1,04 от уровня по умолчанию, токены 1,06, время 1,09. В каждой ячейке по одному прогону, а одна и та же задача у Qwen сильно колеблется от прогона к прогону, поэтому разница в несколько процентов — шум. Стоимость посчитана по прайсу Alibaba International из возвращённых счётчиков токенов; по тарифу шлюза тот же набор на Qwen обошёлся бы в $0,1022.
Лог на 146 КБ: Qwen в 2,5 раза дешевле, но ждать почти 6 минут
Длинный вход сдвигает соотношение в пользу Opus, но не переворачивает его. В задаче на подсчёт по логу из 1 500 строк (146 КБ, около 76 тысяч входных токенов, семь точных чисел в ответе) обе модели на обоих уровнях нашли все семь чисел верно, а Qwen4-Max по умолчанию обошёлся в 0,40 стоимости Opus 5.5 medium и думал в 6,1 раза дольше.
| Конфигурация | Дата | Все 7 чисел верно | Входных токенов | Выходных токенов | Время | Стоимость по прайсу |
|---|---|---|---|---|---|---|
| Qwen4-Max по умолчанию | 18 ноября 2026 | да | 76 037 | 16 767 | 352,5 с | $0,1895 |
Qwen4-Max low | 18 ноября 2026 | да | 76 037 | 21 158 | 364,1 с | $0,2093 |
| Opus 5.5 medium | 11 ноября 2026 | да | 78 537 | 7 699 | 57,6 с | $0,4681 |
| Opus 5.5 high | 11 ноября 2026 | да | 78 537 | 8 136 | 59,0 с | $0,4769 |
Счёт Opus здесь на две трети состоит из ввода: 78 537 × $4 / 1 млн ≈ $0,314, плюс 7 699 × $20 / 1 млн ≈ $0,154. У Qwen наоборот: ввод стоит около $0,114, а 16 767 выходных токенов (почти все — размышления) ещё $0,075, то есть Qwen выдал в 2,2 раза больше токенов, чем Opus, и всё равно остался дешевле за счёт цены ввода. Уровень low и здесь увеличил расход, а не сократил его. Около 76 тысяч токенов — далеко от миллионного контекста обеих моделей, так что о поведении на по-настоящему длинных входах этот тест ничего не говорит.
Почему в индексе Artificial Analysis задача на Qwen 4 Max дороже
Потому что задачи индекса длинные и трудные, и на них Qwen4-Max размышляет очень много. Artificial Analysis (AA) по состоянию на 18 ноября 2026 года называет его «заметно медленным на задачу и очень многословным»: на прогон индекса Qwen4-Max сгенерировал 127 млн токенов при медиане 65,1 млн у сопоставимых моделей. Когда размышления растягиваются на десятки тысяч токенов, четырёхкратная разница в цене вывода перестаёт спасать, а в коротких задачах теста выше размышления занимали в среднем меньше тысячи токенов на задачу, и решала цена за токен.
| Модель и уровень | Индекс AA v5.0.1 | Стоимость задачи | Время задачи |
|---|---|---|---|
| Qwen4-Max (единственная запись, уровень не указан) | 43 | $3,27 | 32,3 мин |
| Opus 5.5 low | 35 | $0,98 | 3,0 мин |
| Opus 5.5 medium | 48 | $2,45 | 6,9 мин |
| Opus 5.5 high | 52 | $3,46 | 9,3 мин |
| Opus 5.5 xhigh | 57 | $6,05 | 15,8 мин |
| Opus 5.5 max | 59 | $10,04 | 24,6 мин |
Opus 5.5 medium набирает на 5 баллов больше за 75 % стоимости задачи Qwen и примерно за пятую часть времени. При почти равной цене задачи ($3,46 против $3,27) Opus high получает 52 балла против 43 и справляется за 9,3 минуты вместо 32,3: об этом и видео с заголовком «Alibaba's Qwen 4 Max Loses to Opus at the Same Cost». Положение Qwen между Opus low и medium совпадает с наблюдением из ветки r/LocalLLaMA «Наблюдения по результатам Qwen 4 max»: «немного уступает Opus 5.5 medium… точно выше Opus low».
Уровни у моделей разные, поэтому корректно сравнивать «Qwen по умолчанию против Opus medium», а не «одинаковый уровень». У Qwen4-Max их три — low, high и xhigh, по умолчанию high, а значение medium API превращает в high; у Opus 5.5 пять — от low до max. Какой уровень Qwen запускала AA, на странице не указано; в API по умолчанию это high. Кроме того, AA пересчитывает данные, а её цифры сняты через два дня после выхода модели.
Вывод «за задачу дороже» относится к набору Artificial Analysis, а не к любой длинной задаче. В стороннем тесте atomicagent.io (Qwen4-Max прогнан 16 ноября 2026 года, Opus 5.5 — 9 ноября, через OpenRouter) на одной многошаговой агентной задаче по программированию — около 1 400 строк Python, 13 внесённых ошибок и 59 скрытых тестов, по три прогона — обе модели прошли все тесты, а Qwen на уровне high обошёлся примерно в $0,65 против $0,97 у Opus medium, то есть на четверть–треть дешевле, но работал 25 минут вместо 4,2. Авторы связывают экономию с неявным кэшем на стороне Alibaba: за полностью записанный прогон Qwen прочитал из кэша около 2,7 млн входных токенов, и без этого один ввод стоил бы больше $4. Неявный кэш у Qwen4-Max работает во всех регионах, поэтому в длинных агентных сессиях с повторяющимся контекстом счёт может оказаться ближе к этому тесту, чем к AA; отставание по скорости видно в обоих замерах.
Громкие кратности из новостей и соцсетей посчитаны на другой основе. «На 62 % дешевле за задачу» — заявление Alibaba о сравнении с собственным Qwen3.8-Max на внутренней оценке Work360, а не с Opus. «На 50 % меньше токенов» из постов в соцсетях расходится с замером AA, где Qwen4-Max выдал почти вдвое больше токенов, чем медианная модель. «В 11 раз дешевле» ($6,53 против $72,28) — одна генерация из поста пользователя в X. На вашей нагрузке надёжнее всего кратность за задачу на ваших же запросах.
Бенчмарки Qwen 4 Max и Opus 5.5: где Qwen впереди, где отстаёт
По независимым замерам Artificial Analysis Qwen4-Max сильнее Opus 5.5 medium в автоматизации рабочих процессов (AutomationBench-AA) и в AA-Briefcase, а заметно слабее в научных рассуждениях, коде и фактических знаниях. В таблице подоценки индекса v5.0.1 по состоянию на 18 ноября 2026 года; Opus max дан как потолок.
| Тест | Qwen4-Max | Opus 5.5 medium | Opus 5.5 max |
|---|---|---|---|
| AutomationBench-AA | 72,6 % | 61,2 % | 69,5 % |
| AA-Briefcase | 1686 | 1617 | 1800 |
| GDP.pdf | 26,2 % | 25,6 % | 26,2 % |
| Terminal-Bench 4.0 | 48,5 % | 52,5 % | 59,6 % |
| FrontierCode-AA 2.0 | 26,5 % | 33,1 % | 46,4 % |
| HLE-Diamond | 44,9 % | 51,4 % | 67,9 % |
| CritPt v2 | 43,0 % | 54,0 % | 68,0 % |
| Terminal-Bench-Science | 23,3 % | 43,3 % | 59,0 % |
| AA-Omniscience | 28 | 40 | 48 |
В AutomationBench-AA Qwen4-Max лучший из всех шести записей, включая Opus max. По отраслевым индексам AA он чуть выше Opus medium в финансах (54 против 51) и стратегии и операциях (57 против 56), вровень в юриспруденции (50 и 50) и ниже в инженерии (50 против 54), экономике (51 против 53) и медицине (48 против 51). Фраза «в задаче по медицине Qwen4-Max догнала Opus 5.5» из новостей относится к собственным тестам Alibaba; у AA разрыв в 3 балла в пользу Opus medium.
Заявления самой Alibaba стоит читать отдельно. По данным, которые компания привела при запуске, в DeepSWE v1.1 Qwen4-Max набирает 75,7 — больше всех сравниваемых моделей, включая Opus 5.5, а в Terminal-Bench 4.0 отстаёт: 48,5 против 59,6. Модель описана как разреженная MoE примерно на 2,4 трлн параметров, из которых около 71 млрд активны на каждый токен. Цифры «Qwen4 обошёл Opus 5.5, 49,9 против 47,2», которые ходили до релиза, относятся к ранней сборке Qwen-4-Flash, а не к Max.
Цена Qwen 4 Max и Opus 5.5 за 1 млн токенов и где купить API
За токен Qwen4-Max дешевле: ввод в 2,67 раза, вывод в 4,44 раза. Цены ниже — по странице модели Qwen4-Max в документации Alibaba Cloud Model Studio (регион International, Сингапур) и странице цен Claude API по состоянию на 18 ноября 2026 года, за 1 млн токенов, в долларах США. У обеих моделей токены размышлений оплачиваются как вывод.
| Статья счёта | Qwen4-Max (International) | Claude Opus 5.5 | Opus дороже в |
|---|---|---|---|
| Ввод | $1,50 | $4 | 2,67 раза |
| Вывод, включая размышления | $4,50 | $20 | 4,44 раза |
| Чтение из кэша | $0,075 | $0,20 | 2,67 раза |
| Batch: ввод / вывод | нет в International; $0,707 / $2,12 только в регионе China (Beijing) | $2 / $10 | — |
Цена кэша Qwen4-Max взята у Artificial Analysis и OpenRouter (5 % от ввода): в тексте страницы Model Studio её нет. Явный и неявный кэш у Qwen4-Max есть во всех регионах, а пакетная обработка (Batch) — нет: Model Studio поддерживает её только в регионе China (Beijing), так что у аккаунта International пакетного режима для Qwen4-Max нет. Пекинский пакетный тариф $0,707 / $2,12 — это временная скидка 50 % от пекинской цены $1,413 / $4,24; столько же, $1,413 / $4,24, стоит обычный вызов в регионах Гонконг, Франкфурт, Вирджиния и Токио (Global). OpenRouter продаёт qwen/qwen4-max по $1,425 / $4,275. В регионе International есть бесплатный миллион токенов в течение 90 дней после активации. У Opus 5.5 запись в кэш стоит $5 на 5 минут и $8 на час, быстрый режим (fast mode) — $8 / $40; подробнее о цене и лимитах подписки — в статье «Claude Opus 5.5: цена API и как сбросить лимит подписки».
По контексту модели равны: у обеих 1 млн токенов. Qwen4-Max выдаёт до 131 072 токенов ответа, а в режиме размышлений до 262 144, принимает текст, изображения и видео, совместим с API OpenAI и Anthropic и умеет вызывать инструменты, искать в интернете и возвращать структурированный вывод. Opus 5.5 принимает текст и изображения.
Купить доступ к Qwen4-Max можно через API Alibaba Cloud Model Studio (International) или подписку Token Plan, а также через OpenRouter. В Qwen Chat 18 ноября 2026 года без входа в аккаунт в списке моделей были только Qwen3.7-Plus и Qwen3.8-Max; про тарифы и лимиты самого чата — в статье «Лимиты Qwen: что бесплатно, тарифы от 349 ₽ и сообщения о лимите». Opus 5.5 доступен через Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry, в Claude Code и в платных тарифах приложений Claude, но Россия, как и материковый Китай с Гонконгом, в списке поддерживаемых стран Anthropic отсутствует; что из этого следует на практике, разобрано в статье «Claude Opus 5.5: как пользоваться, можно ли бесплатно и в России». Тест выше шёл через laozhang.ai, где qwen4-max и claude-opus-5-5 вызываются одним ключом; Qwen4-Max там стоит около $1,43 / $4,29 за 1 млн токенов.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
Как сократить размышления Qwen 4 Max: thinking_budget вместо low
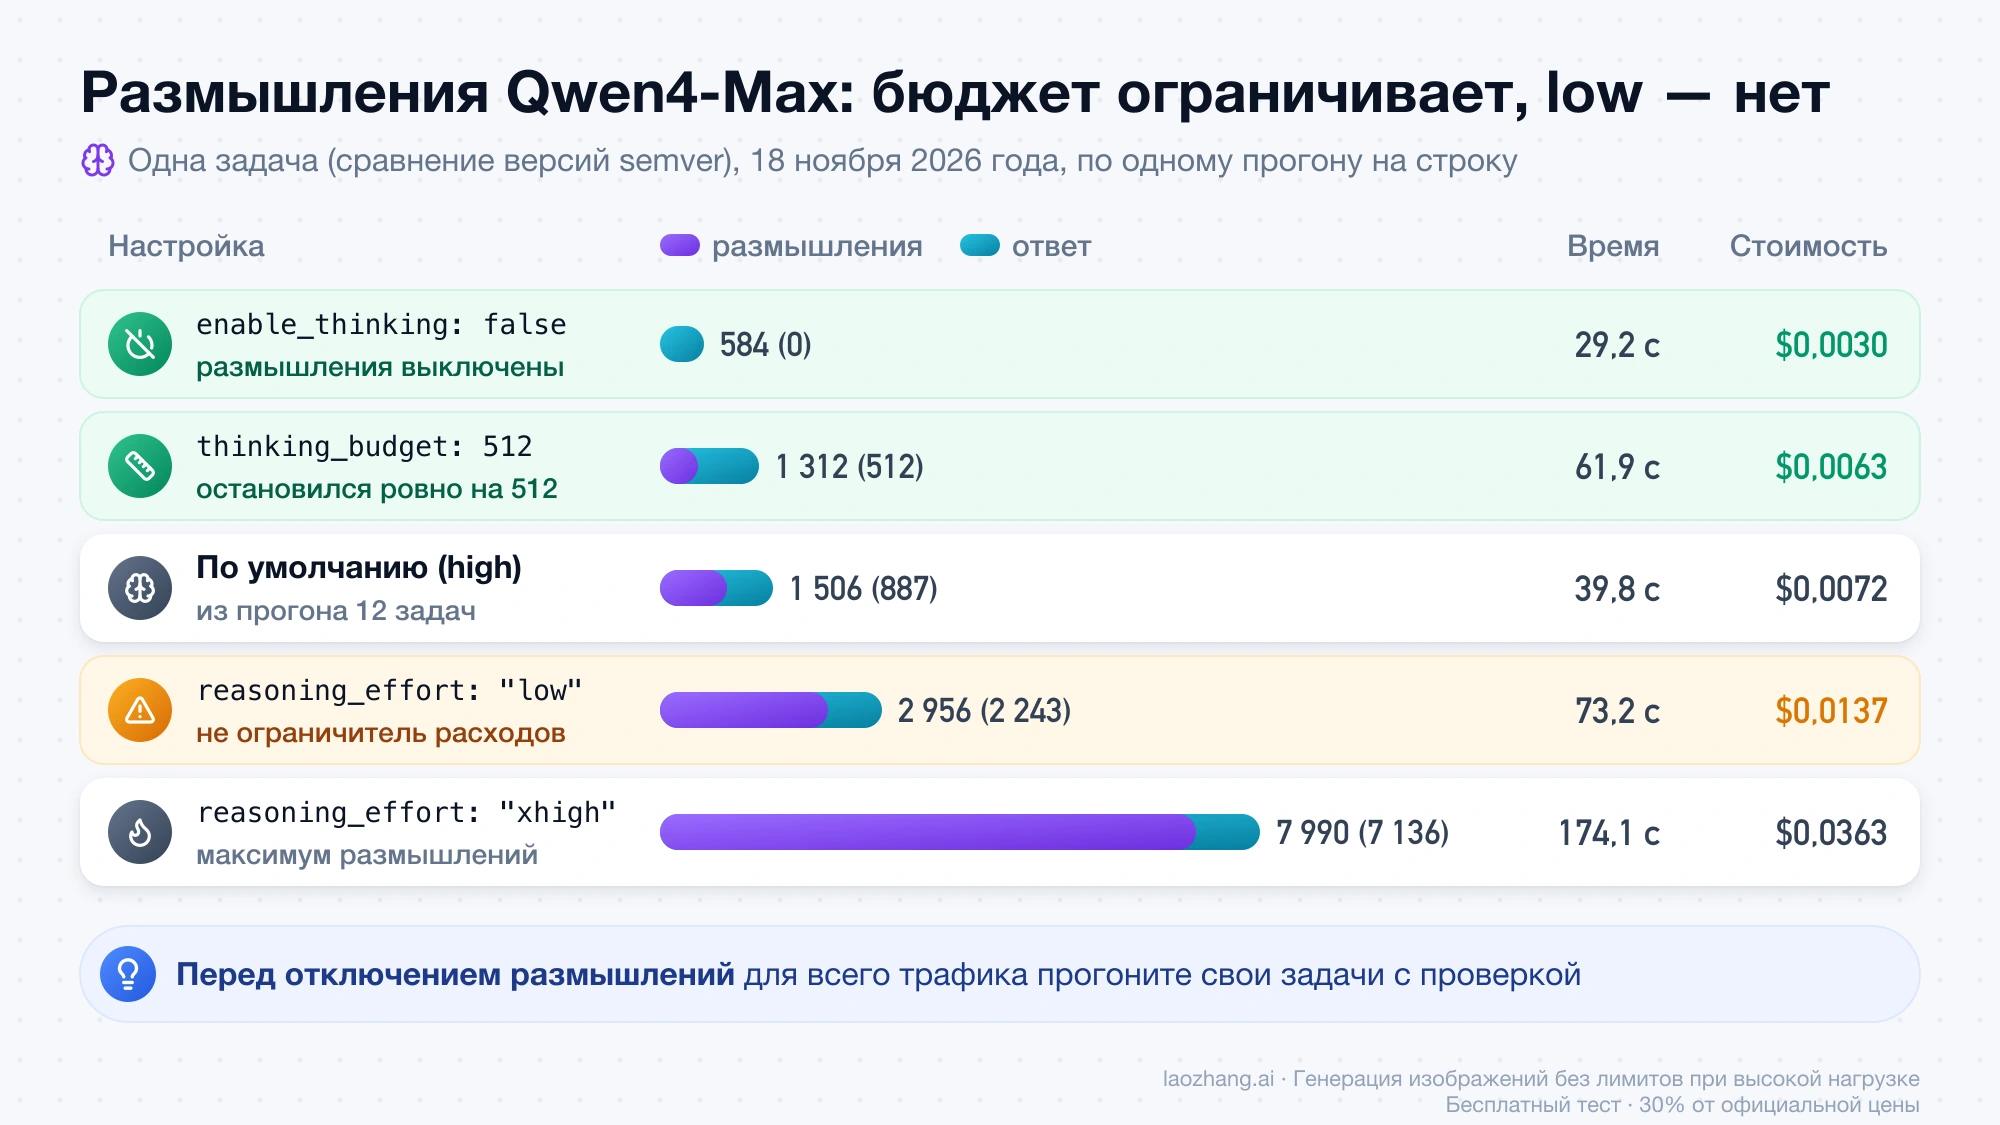
По умолчанию у Qwen4-Max включены размышления (enable_thinking: true), уровень high и бюджет thinking_budget в 131 072 токена, поэтому даже простой запрос он сначала обдумывает. Сократить их надёжно позволяют два параметра: enable_thinking: false выключает размышления совсем, а thinking_budget ограничивает их точным числом токенов. 18 ноября 2026 года оба параметра проверили через тот же шлюз на одной задаче — сравнении версий semver; заодно выяснилось, что поле уровня доходит до Alibaba без изменений: заведомо неверное значение вернуло ошибку 400 invalid_parameter_error.
| Настройка | Выходных токенов (из них размышления) | Время | Стоимость |
|---|---|---|---|
enable_thinking: false | 584 (0) | 29,2 с | $0,0030 |
thinking_budget: 512 | 1 312 (512) | 61,9 с | $0,0063 |
| По умолчанию, из прогона 12 задач | 1 506 (887) | 39,8 с | $0,0072 |
reasoning_effort: "low" | 2 956 (2 243) | 73,2 с | $0,0137 |
reasoning_effort: "xhigh" | 7 990 (7 136) | 174,1 с | $0,0363 |
Бюджет сработал точно: размышления остановились ровно на 512 токенах. Заметно и то, что даже без размышлений вызов через шлюз занял 29 секунд, так что часть ожидания в тесте приходится на маршрут, а не на саму модель. Уровень low в этом отдельном прогоне дал вдвое больше токенов, чем уровень по умолчанию в общем прогоне, хотя там та же задача на low заняла 949 токенов: один и тот же уровень даёт большой разброс между прогонами, и рассчитывать на него как на ограничитель расходов нельзя. В каждой строке по одному прогону. Ответ без размышлений на этой задаче был, но его правильность не оценивалась, поэтому перед тем как выключать размышления для всего трафика, прогоните свои задачи с проверкой.
В запросе Chat Completions оба параметра передаются полями верхнего уровня тела запроса. В OpenAI Python SDK их кладут в extra_body: 18 ноября 2026 года SDK версии 2.24.0 передал через шлюз и enable_thinking: false, и thinking_budget (на простом запросе это подтверждает передачу полей, но не качество ответов). Тело запроса выглядит так:
{
  "model": "qwen4-max",
  "messages": [{"role": "user", "content": "..."}],
  "stream": true,
  "thinking_budget": 512
}
Для коротких задач с автоматической проверкой можно начать с выключенных размышлений и включать небольшой бюджет там, где падает доля верных ответов. Для задач, где размышления нужны, задайте бюджет под свою нагрузку: именно неограниченные размышления делают задачу Qwen4-Max у Artificial Analysis дороже, чем у Opus 5.5 medium.
Вопросы о Qwen 4 Max и Opus 5.5
Можно ли запустить Qwen 4 Max локально?
Нет. Веса Qwen4-Max закрыты, модель доступна только через облако Alibaba и площадки вроде OpenRouter; дообучение и развёртывание собственных копий Model Studio для неё не поддерживает. Alibaba обещает позже открыть веса младших моделей Qwen4, но дату по состоянию на 18 ноября 2026 года не называет. Opus 5.5 тоже работает только через API и приложения Anthropic и её облачных партнёров.
Qwen 4 Max, Qwen4-Max и qwen4-max — это одна модель?
Да, это одна модель: qwen4-max — её идентификатор в API, в поиске и новостях её пишут как Qwen 4 Max или Qwen4-Max. Предварительная версия qwen4-max-preview вышла 11 ноября 2026 года, общая — 16 ноября. «Qwen 4» без уточнения может означать и Qwen4-Flash или Qwen4-27B: до релиза Max в новостях ходили именно их цифры, например стоимость задачи $0,4 у Qwen4-Flash против $2,6 у Opus 5.5, и к Qwen4-Max они не относятся.
Источники2
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 18 нояб. 2026 г..
Источники2
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 18 нояб. 2026 г..